

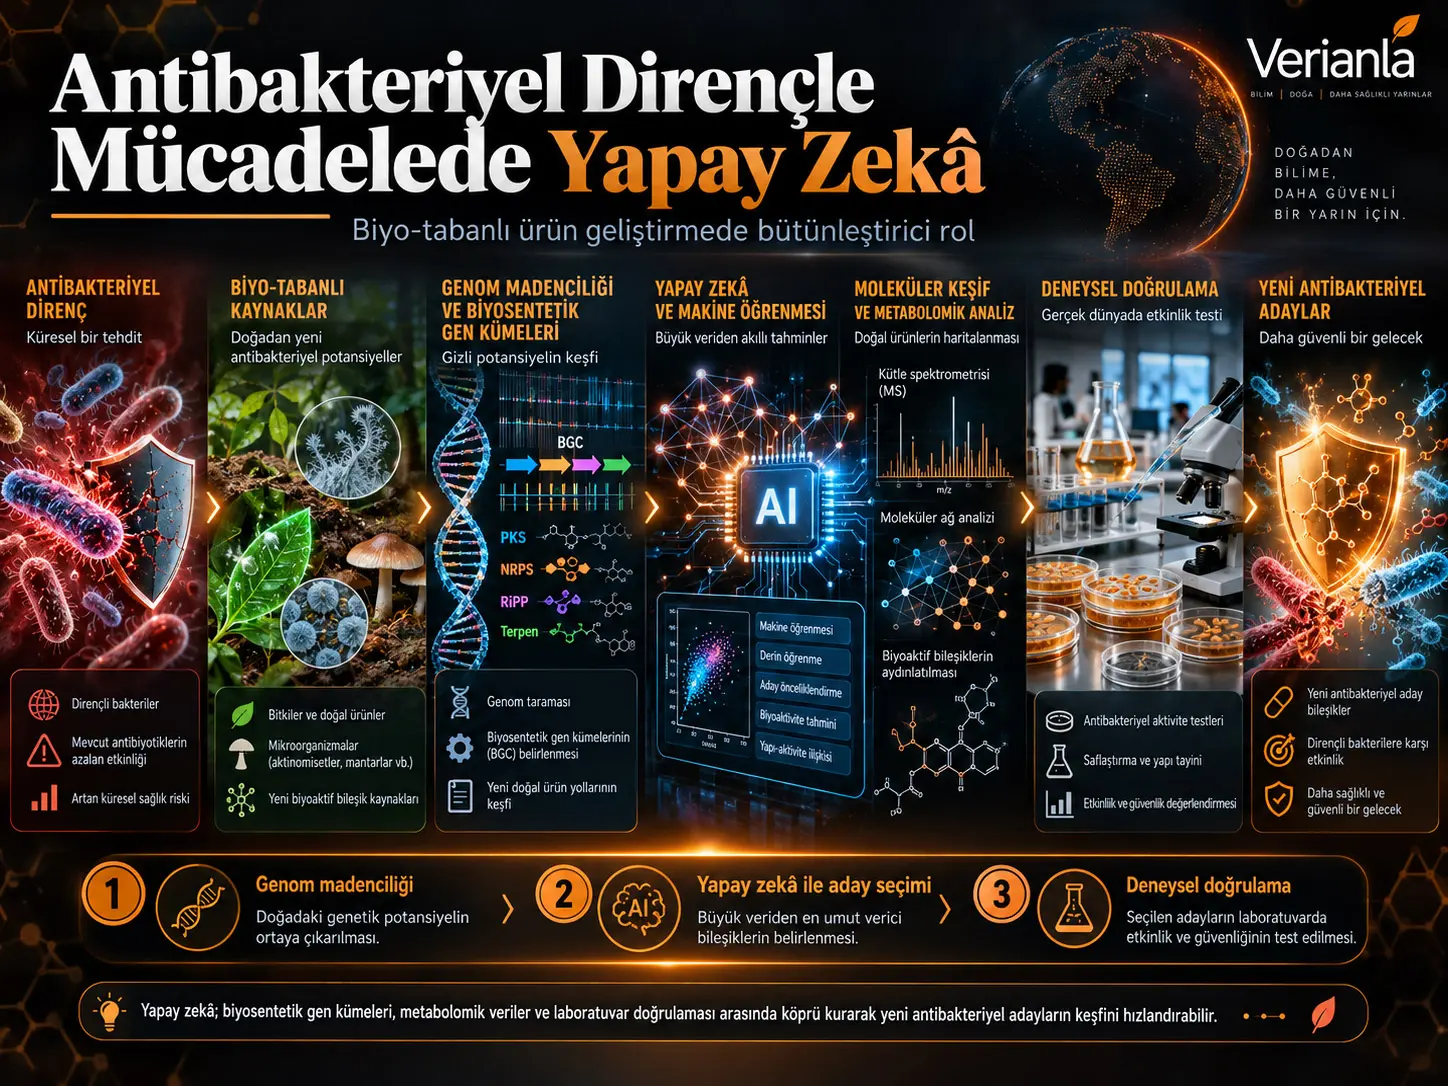
Yapay zekâ destekli doğal ürün keşfi, mikroorganizma veya başka biyolojik kaynakların genomik ve kimyasal çeşitliliğini hesaplamalı yöntemlerle tarayarak yeni antibakteriyel adayları önceliklendirmeyi amaçlayan bir ilaç keşfi yaklaşımıdır. Bu kapsamlı derleme; antibakteriyel direncin moleküler temellerinden başlayarak geleneksel doğal ürün keşfinin darboğazlarını, biyosentetik gen kümesi madenciliğini, makine öğrenmesi ve derin öğrenme tabanlı bioaktivite tahminini, sanal taramayı, dereplikasyonu, metabolomik–kemoinformatik entegrasyonunu, üretici modelleri ve hesaplamalı adayların in vitro ve in vivo doğrulanmasını birlikte incelemektedir. Kaynak yeni bir deney veya klinik çalışma gerçekleştirmemiş; farklı araştırmalardaki yöntemleri, modelleri ve deneysel doğrulama sonuçlarını derlemiştir.
Derlemenin ana bilimsel mesajı, yapay zekânın antibakteriyel keşifte tek bir algoritma veya tek bir tahmin modeli olarak değil, keşif zincirinin birçok noktasını birbirine bağlayan hesaplamalı bir katman olarak kullanılabildiğidir. AI destekli genom madenciliği büyük genom koleksiyonlarında daha önce incelenmemiş biyosentetik gen kümelerini belirleyebilir; makine öğrenmesi aday moleküllerin bioaktivitesini tahmin edebilir; kütle spektrometrisi ve kemoinformatik araçları bilinen bileşikleri daha hızlı ayırabilir; metabologenomik yaklaşımlar genetik potansiyeli gerçek metabolitlerle bağlayabilir; üretici modeller ise yeni molekül veya antimikrobiyal peptit adayları önerebilir.
Kaynakta e-DeepBGC'nin 5666 bakteriyel genomda 170.685 biyosentetik gen kümesi belirlemesi, BioAct-Het'in belirli bioaktivite tahmin görevinde %88,5 doğruluğa ulaşması ve ultra-büyük transfer-learning taramasında deneysel olarak test edilen seçilmiş adayların %54'ünde antibakteriyel aktivite görülmesi gibi dikkat çekici sonuçlar aktarılmaktadır. Ancak bu değerler birbirinden farklı görev, veri seti ve deney tasarımlarına aittir. Tek bir genel “AI başarı oranı” olarak birleştirilemez.
Derlemenin en önemli yorum sınırı, yüksek model performansının klinik antibiyotik başarısı anlamına gelmemesidir. Modelin önerdiği adayın gerçek bir ilaç olabilmesi için kimyasal doğrulama, in vitro aktivite, seçicilik ve toksisite, etki mekanizması, farmakokinetik ve farmakodinamik özellikler, uygun hayvan modelleri ve sonunda insan klinik araştırmaları gibi ardışık doğrulama basamaklarından geçmesi gerekir. Kaynak ayrıca yeniden üretilebilirlik, yayın yanlılığı, veri kalitesi, standardize benchmark eksikliği ve in vivo verilerin sınırlılığı gibi temel sorunları açıkça kabul etmektedir.
Antibakteriyel direnç neden yeni keşif yöntemleri gerektiriyor?
Antibakteriyel direnç, bakterilerin antibiyotiklerin etkisinden kaçmasına olanak sağlayan kalıtsal veya kazanılmış mekanizmaların klinik düzeyde tedaviyi güçleştirmesidir. Kaynakta AMR'nin küresel yükü anlatılırken 4,95 milyon ölümün dirençli enfeksiyonlarla ilişkili olduğu ve yaklaşık 1,27 milyon ölümün dirençli enfeksiyonlara doğrudan atfedildiği ayrımı yapılmaktadır. Bu iki sayı aynı epidemiyolojik kavram değildir.
Direnç sorunu yalnız daha fazla antibiyotik kullanılarak çözülebilecek bir problem değildir. Mevcut antibakteriyel sınıflar aynı anda birden fazla moleküler savunma mekanizmasıyla karşılaşmaktadır. β-laktamazlar ve karbapenemazlar antibiyotiği parçalayabilir; hedef moleküllerdeki değişiklikler antibiyotiğin bağlanmasını azaltabilir; efflux pompaları ilacı hücre dışına çıkarabilir; porin kaybı ilacın hücreye girişini sınırlayabilir; bazı bakteriler ise inhibe edilen metabolik basamağı alternatif enzimlerle aşabilir.
| Mekanizma | Biyolojik mantık | Kaynakta verilen örnekler | Sonuç |
|---|---|---|---|
| Enzimatik parçalama veya modifikasyon | Antibiyotik etkili hedefe ulaşmadan kimyasal olarak değiştirilir veya parçalanır | β-laktamazlar, ESBL'ler, KPC, NDM, OXA, IMP, VIM, aminoglikozid-modifiye edici enzimler | Bir veya birden fazla antibiyotik sınıfının aktivitesi azalabilir |
| Hedef değişikliği | Antibiyotiğin bağlandığı yapı değiştirilirken temel hücresel işlev korunur | mecA/PBP2a, gyrA, gyrB, parC, parE, vanA/vanB/vanC, rpoB | İlacın hedef afinitesi azalır |
| Efflux | Antibiyotik aktif taşıma sistemleriyle hücre dışına çıkarılır | MexAB-OprM, AcrAB-TolC ve başka RND/MFS/SMR sistemleri | Hücre içi etkin ilaç konsantrasyonu düşer |
| Azalmış geçirgenlik | Dış zar giriş kanalları azalır veya değiştirilir | ompF, ompC, ompK35/36 | Özellikle Gram-negatif bakterilerde antibiyotik girişi sınırlanır |
| Metabolik bypass | Engellenen metabolik adım alternatif dirençli enzimlerle sürdürülür | sul1, sul2 ve dfr genleri | İnhibe edilen yolun işlevsel alternatifi korunur |
Doğal ürün keşfi neden tarihsel olarak önemli?
Penisilin, tetrasiklin ve vankomisin gibi birçok önemli antibakteriyel doğal veya biyolojik kökenli keşiflerden doğmuştur. Mikroorganizmalar, bitkiler, mantarlar ve deniz organizmaları çok geniş bir kimyasal çeşitlilik üretir. Buna rağmen klasik doğal ürün keşfi yalnız biyolojik materyalin toplanması ve aktivite testi yapılmasından ibaret değildir.
Bir ekstraktta binlerce kimyasal sinyal bulunabilir. Araştırmacının bunlardan hangisinin daha önce bilinen molekül, hangisinin gerçekten yeni yapı, hangisinin biyolojik aktivite taşıyan bileşik ve hangisinin laboratuvar koşullarında üretilemeyen genomik potansiyel olduğunu ayırt etmesi gerekir.
Kaynakta doğal ürün keşfinin temel darboğazları; bilinen bileşiklerin tekrar keşfi, düşük tarama hit oranı, kültüre alınamayan mikroorganizmalar, laboratuvar koşullarında sessiz kalan biyosentetik gen kümeleri, sınırlı dereplikasyon kapasitesi, uzun hit-to-lead süreci ve yüksek geliştirme maliyeti olarak ele alınmaktadır.
| Darboğaz | Kaynakta verilen nicel bağlam | Bilimsel sonuç |
|---|---|---|
| Bilinen bileşiklerin yeniden bulunması | LC-MS tabanlı untargeted metabolomikte özelliklerin yaklaşık %95–98'i güvenle tanımlanamayabilir | Yeni yapılar ile bilinen kimyasal sinyallerin ayrımı güçleşir |
| Düşük geleneksel hit oranları | Kaynakta bazı doğal ürün taramalarında yaklaşık %0,3; sentetik kütüphanelerde <%0,001 gibi örnekler aktarılmaktadır | Çok büyük kütüphanelerin deneysel taranması gerekir |
| Kültüre alınamayan mikrobiyal çeşitlilik | Kaynak yaklaşık %99,9'un standart tekniklerle kültüre alınamadığını aktarmaktadır | Biyosentetik çeşitliliğin büyük bölümü klasik kültür tabanlı keşfin dışında kalabilir |
| Sessiz BGC'ler | Birçok genomda standart laboratuvar koşullarında ifade edilmeyen kümeler bulunur | Genomda bulunan kimyasal üretim kapasitesi kültürde görünmeyebilir |
| Dereplikasyon | Kaynak geleneksel LC-MS anotasyon oranlarını yaklaşık %2–5 düzeyinde tartışmaktadır | Bilinen yapıları erken ayıklamak güçleşir |
| Zaman ve maliyet | Kaynak keşiften pazara 10–20 yıllık süreçlerden ve çok yüksek geliştirme maliyetlerinden söz etmektedir | Her adayın deneysel olarak aynı derinlikte incelenmesi sürdürülebilir değildir |
Biyosentetik Gen Kümesi Nedir ve AI Neden Burada Kullanılıyor?
Biyosentetik gen kümesi (biosynthetic gene cluster, BGC), belirli bir doğal ürünün veya özel metabolitin biyosentezinde birlikte görev yapan genlerin genom üzerinde işlevsel olarak gruplanmış bölgesidir; AI modelleri büyük genom koleksiyonlarında bu bölgeleri tanımak, sınırlarını belirlemek, ürün sınıflarını tahmin etmek ve deneysel çalışma için en ilginç kümeleri önceliklendirmek amacıyla kullanılmaktadır.
DeepBGC ve e-DeepBGC
DeepBGC, genom boyunca protein aileleri ve sekans bağlamını analiz ederek potansiyel BGC bölgelerini tanımlamak için çift yönlü LSTM tabanlı derin öğrenme kullanır. Model ayrıca Random Forest sınıflandırıcılarıyla ürün sınıfı ve potansiyel kimyasal aktivite tahmini sağlayabilir.
e-DeepBGC bu yapıyı doğrulanmış BGC'ler, Pfam protein aileleri, Pfam işlevleri ve clan bilgileriyle genişletmiştir. Kaynağa göre 5666 RefSeq bakteriyel genomunda 170.685 BGC belirlemiş ve genom başına ortalama 30,1 küme raporlamıştır.
Self-supervised modeller
BiGCARP gibi self-supervised modeller, etiketlenmemiş veya sınırlı anotasyonlu genomik veriden protein domainlerinin bağlamsal düzenini öğrenir. Kaynakta BiGCARP'ın 127.294 BGC üzerinde ön eğitildiği; 773 anotasyonsuz bakteriyel genomda 4287 küme belirlediği aktarılmaktadır.
Bu yaklaşımın potansiyel avantajı, yalnız bilinen bir BGC motifini ezberlemek yerine biyosentetik organizasyonun genel dilini öğrenmeye çalışmasıdır. Ancak eğitim veri dağılımından çok farklı yeni BGC sınıflarında genellenebilirlik hâlâ temel sınırlılıklardan biridir.
BGC'yi biyolojik bir “cümle” gibi okumak
Kaynakta bazı NLP modelleri protein domainlerini kelimeler, BGC yapısını ise biyolojik bir cümle gibi temsil etmektedir. BGCCGB, BERT benzeri dikkat mekanizmalarını Graph Convolutional Networks ile birleştirirken BGC-Prophet transformer encoder kullanmaktadır.
Bu benzetme yalnız anlatım kolaylığı değildir. Bir genin BGC içindeki anlamı yalnız kendi kimliğinden değil, komşu genler ve daha uzaktaki biyosentetik bileşenlerle olan bağlamından da kaynaklanabilir.
Klasik makine öğrenmesi hâlâ neden önemli?
Derin öğrenme her problemde otomatik olarak üstün değildir. RFBGCPred, Word2Vec temsilleri, supervised UMAP ve Random Forest ile BGC sınıflandırması yapmış; dengeli test kümesinde %98,0 accuracy, MCC 0,9752 ve AUC 0,9928 bildirmiştir. Dengesiz doğrulama kümesinde accuracy %94,8'e düşmekle birlikte model güçlü performansını korumuştur.
Bu sonuç, belirli veri yapılarında iyi tasarlanmış klasik ML'nin derin öğrenmeyle rekabet edebildiğini göstermektedir. Ancak aynı metrikler farklı modeller ve veri kümeleri arasında kontrolsüz biçimde karşılaştırılmamalıdır.
Reinforcement learning neyi düzeltmeye çalışıyor?
Bir BGC'nin yalnız varlığını bulmak yeterli değildir; başlangıç ve bitiş sınırlarının doğru belirlenmesi gerekir. Kaynakta reinforcement learning'in tahmin edilen kümelerde hangi genlerin tutulacağı veya dışlanacağını iteratif olarak öğrenmek için kullanıldığı bir yaklaşım aktarılmaktadır.
Bu yöntem fungiSMASH ve DeepBGC gibi sistemlerde küme precision'ını %25'in üzerinde, bazı araçlarda gen precision'ını %15'in üzerinde artırmıştır. Bu değerler bütün organizmalara genellenen sabit performans artışları değil, ilgili doğrulama koşullarındaki sonuçlardır.
Metagenomik neden daha zor?
Metagenomik örnekler tek bir saf genom yerine çok sayıda mikroorganizmanın DNA'sını içerir. Genom parçalarının montajı eksik veya parçalı olduğunda uzun BGC'lerin tamamını yakalamak güçleşir.
HiFiBGC, üç farklı PacBio HiFi uyumlu metagenom assembler'ından elde edilen montajları birleştiren ensemble yaklaşım kullanmaktadır. Kaynağa göre bu strateji en iyi tek assembler yaklaşımından ortalama %78 daha fazla BGC belirlemiş ve ensemble assembly, geri kazanımı yaklaşık %25 artırmıştır.
Genom tahmini moleküle nasıl bağlanır?
Bir BGC'nin bulunması, hangi kimyasal molekülün gerçekten üretildiğini tek başına göstermez. Bu nedenle Seq2PKS ve Seq2Saccharide gibi araçlar genom madenciliğini kütle spektrometrisiyle birleştirir. Genomdan çok sayıda olası moleküler yapı üretilir; ardından deneysel MS sinyalleri bu yapılarla karşılaştırılarak olası eşleşmeler daraltılır.
Kaynakta Seq2PKS monazomycin, oasomycin A ve 2-aminobenzamide-actiphenol BGC'lerinin belirlenmesinde; Seq2Saccharide ise trestatin B'nin BGC'sinin bulunmasında örneklenmektedir.
Sessiz ve kriptik BGC'ler neden önemlidir?
Bir mikroorganizmanın genomunda belirli bir doğal ürünün üretim potansiyeli bulunabilir ancak ilgili gen kümesi standart laboratuvar koşullarında aktif olmayabilir. Bu tür kümeler “silent” veya “cryptic” olarak tanımlanabilir.
SYNTERUPTOR'ın Streptomyces ambofaciens'te önceki antiSMASH sürümleri tarafından bulunmayan özel metabolit gen kümesini belirlemesi ve daha sonra bu kümenin iki metabolitin biyosentezini yönettiğinin deneysel olarak gösterilmesi, hesaplamalı tahmin ile laboratuvar doğrulamasının neden birlikte gerekli olduğunu gösteren örneklerden biridir.
AI ile yapı ve bioaktivite tahmini
Genom madenciliğinin ardından ikinci büyük problem, moleküler yapıların ve biyolojik aktivitelerin tahmin edilmesidir. Kaynak; Random Forest, SVM, gradient boosting, CNN, RNN, GNN, transformer, transfer learning ve üretici modelleri farklı görevlerde değerlendirmektedir.
BioAct-Het adlı heterogeneous Siamese neural network, kaynakta bioaktivite tahmininde %88,5 accuracy ile örneklenmektedir. Başka modeller AUC, MCC, F1, RMSE, Pearson korelasyonu veya hit rate gibi farklı metriklerle değerlendirilmiştir. Bu ölçütlerin matematiksel anlamları farklı olduğundan aynı “başarı” kavramının değiştirilebilir eşanlamlıları değildir.
Antimikrobiyal peptit keşfi
AMPlify, çift yönlü LSTM, multi-head attention ve context attention kullanarak antimikrobiyal peptit dizilerini sınıflandırır. Kaynakta 3338 eğitim ve 835 test dizisiyle %93,71 accuracy, %92,93 sensitivity, %94,49 specificity, %93,66 F1 ve %98,37 AUROC bildirilmiştir.
Daha sonra kurbağa genomundan önerilen 101 diziden 16 peptit sentezlenmiş ve dört yeni peptit deneysel antibakteriyel aktivite göstermiştir. Bu, test edilen sentezlenmiş adaylar içinde %25 hit oranına karşılık gelir.
Burada önemli ayrım, modelin test kümesi sınıflandırma doğruluğu ile laboratuvarda aktif bulunan yeni adayların hit oranının farklı ölçütler olmasıdır.
D-MPNN ile doğal ürün sanal taraması
Bir Directed Message-Passing Neural Network modeli, 29.537 bileşiğin Burkholderia cenocepacia'ya karşı deneysel taramasından elde edilen verilerle eğitilmiştir. İlk yüksek-throughput taramanın hit oranı yalnız %0,87'dir.
Model daha sonra 1614 FDA onaylı bileşik ve 224.205 doğal ürünü sanal olarak taramış; deneysel olarak değerlendirilen en yüksek sıralı adaylarda sırasıyla %26 ve %12 hit oranı bildirilmiştir. Kaynak bunu başlangıçtaki rastgele/deneysellik ağırlıklı taramaya göre en az 14 kat zenginleşme olarak yorumlamaktadır.
Bir milyardan fazla molekül nasıl taranabilir?
Transfer-learning yaklaşımında GNN'ler önce geniş moleküler veri üzerinde ön eğitilmiş, ardından sınırlı antibakteriyel aktivite verisiyle fine-tune edilmiştir. Bu model ChemDiv ve Enamine kaynaklı bir milyardan fazla sanal molekülü sıralamıştır.
Deneysel test için 156 aday seçilmiş; kaynakta test edilen adayların %54'ünün E. coli'ye karşı MIC ≤10 µg/mL aktivite gösterdiği bildirilmiştir. Bununla birlikte bu %54 oran, bir milyar molekülün %54'ünün antibakteriyel olduğu anlamına gelmez. Modelin yüksek olasılıklı olarak seçtiği küçük, önceliklendirilmiş deneysel alt kümenin hit oranıdır.
Yüksek AI Hit Oranı Klinik Antibiyotik Başarısı Anlamına Gelir mi?
Hayır. Hit rate, hesaplamalı olarak seçilen adayların belirli bir deneysel testte önceden tanımlanan aktivite ölçütünü karşılayan bölümünü ifade eder; klinik antibiyotik başarısı ise insanlarda etkinlik, güvenlik, dozlama, farmakokinetik, farmakodinamik, direnç gelişimi ve klinik sonuçlarla ilgili çok daha ileri bir kanıt düzeyidir.
Model metriği ile deneysel aktivite arasındaki fark
Accuracy veya AUC modelin sınıflandırma davranışını, RMSE sayısal tahmin hatasını, Pearson korelasyonu tahmin ve gerçek değer arasındaki doğrusal ilişkiyi, hit rate ise seçilmiş adayların ne kadarının laboratuvarda etkin çıktığını ölçer.
Bu ölçütlerin hiçbiri tek başına insanlarda tedavi başarısı göstermez. Verianla açısından doğru kanıt zinciri “model skoru → deneysel aday → aktivite → toksisite/seçicilik → mekanizma → in vivo doğrulama → klinik araştırma” şeklinde okunmalıdır.
Out-of-distribution problemi
AI modeli eğitim sırasında gördüğüne benzer moleküllerde yüksek performans gösterip kimyasal uzayın daha önce görmediği bölgelerinde başarısız olabilir. Kaynak bu problemi “unfamiliarity” gibi ölçütlerle ele alan çalışmalar aktarmaktadır.
Bu nedenle kimyasal olarak yeni bir adayın model skoru yüksek olsa bile modelin o yapı sınıfında ne kadar güvenilir olduğunun ayrıca değerlendirilmesi gerekir.
Cell Painting ve fenotipik veri
Molekülün yalnız kimyasal yapısını kullanmak yerine hücrelerde oluşturduğu morfolojik fenotipler de modele dahil edilebilir. Kaynakta Cell Painting ile kimyasal yapı bilgilerinin birlikte kullanıldığı modeller 140 assay boyunca ortalama AUROC 0,744 ± 0,108 vermiş; assay'lerin %62'sinde AUROC ≥0,7, %30'unda ≥0,8 ve %7'sinde >0,9 raporlanmıştır.
Bu yaklaşım yapısal benzerliğin ötesinde hücresel etkiden bilgi çıkarabilir ancak kullanılan assay'lerin tamamı antibakteriyel değildir. Bu sonuç doğal ürün bioaktivite tahmininin metodolojik kapsamını gösterir.
Dereplikasyon Doğal Ürün Keşfinde Neden Kritik Bir Basamaktır?
Dereplikasyon, biyolojik örnekte görülen kimyasal sinyallerin daha önce bilinen bileşiklere ait olup olmadığını mümkün olduğunca erken belirleyerek aynı molekülün yeniden izolasyonuna ayrılacak zamanı ve deneysel kaynağı azaltır; AI ve kemoinformatik burada MS/MS spektrumlarını, moleküler formülleri, yapı adaylarını ve spektral ağları daha hızlı eşleştirmek için kullanılmaktadır.
GNPS ve moleküler ağlar
Global Natural Products Social Molecular Networking (GNPS), benzer MS/MS parçalanma örüntülerini spektral ağlarda birbirine bağlayarak kimyasal ailelerin görünür hale gelmesini sağlar. Bilinen spektruma yakın bilinmeyen sinyaller, ilişkili molekül ailesinin parçası olarak önceliklendirilebilir.
Kaynakta GNPS; deniz kökenli Streptomyces, alg araştırmaları, klinik örnekler, bitki ekstraktları ve mikrobiyom metabolomikleri gibi çok farklı bağlamlarda kullanılmıştır.
SIRIUS ve CSI:FingerID
SIRIUS tandem MS verilerinden moleküler formül tahmini yaparken CSI:FingerID kimyasal yapıya ilişkin parmak izi özelliklerini tahmin edip aday yapı veri tabanlarını sıralayabilir.
Kaynak, bu sistemlerin geniş veri kümelerinde anotasyon kapsamını artırabildiğini ancak nihai yapısal doğrulama için NMR gibi ortogonal yöntemlerin önemini koruduğunu vurgular.
UmetaFlow
UmetaFlow; ön işleme, spektral eşleştirme, moleküler formül ve yapı tahmini ile GNPS tabanlı sonraki analizleri otomatikleştiren bir workflow'dur. Kaynaktaki doğrulamada 100 actinomycete suşundan 1245 ham dosyanın ön işlemesi yaklaşık 1 saat 12 dakika sürmüş; formül ve yapı tahminlerinin tamamlanması yaklaşık 10 gün gerektirmiştir.
Bu örnek AI'nin her zaman “anında” analiz anlamına gelmediğini de gösterir. Büyük DL ve kemoinformatik iş akışları önemli hesaplama altyapısı gerektirebilir.
CSU-MS2 ve kontrastif öğrenme
CSU-MS2, MS/MS spektrumlarıyla moleküler yapıları ortak bir temsil uzayında eşleştirmek için contrastive learning kullanmaktadır. Kaynakta 1047 spektrumun 23 yapı veri tabanından derlenen 1.001.047 aday moleküle karşı değerlendirildiği benchmark'ta Recall@1 %75,45 olarak raporlanmıştır.
Aynı benchmark'ta CFM-ID %68,38, SIRIUS %64,85, MetFrag %48,59 ve CMSSP %30,47 Recall@1 vermiştir. Bu sonuç belirli benchmark koşullarına aittir; bütün metabolomik veri türlerine evrensel üstünlük anlamına gelmez.
Foundation model yaklaşımı
DreaMS, milyonlarca anotasyonsuz tandem kütle spektrumu üzerinde self-supervised ön eğitim kullanan transformer tabanlı bir modeldir. Maskelenmiş spektral tepeleri ve kromatografik tutulma sırasını öğrenerek moleküler yapı bilgisi taşıyan temsiller geliştirmeyi amaçlar.
Kaynak DreaMS Atlas'ın yaklaşık 201 milyon MS/MS spektrumundan oluştuğunu belirtmektedir. Büyük ölçek, anotasyon ve benzerlik aramasında güçlü fırsatlar sunarken veri depolama ve hesaplama gereksinimini de artırır.
NMR neden hâlâ gerekli?
MS/MS parçalanması bir yapı hakkında güçlü bilgi sağlayabilir ancak özellikle stereokimya, izomer ayrımı ve gerçekten yeni yapıların kesin doğrulanmasında tek başına yeterli olmayabilir. Kaynak NMR spektroskopisini 1D ve 2D yöntemlerle nihai yapısal doğrulamanın temel araçlarından biri olarak korumaktadır.
Bu nedenle AI tabanlı yapı tahmini deneysel yapı tayininin otomatik ikamesi değil, deneysel işi daha hedefli hale getiren bir önceliklendirme aracıdır.
Metabolomik ve genomik neden birlikte kullanılıyor?
Genom madenciliği organizmanın ne üretebileceğini, metabolomik ise belirli koşulda hangi moleküllerin gerçekten gözlendiğini gösterir. Metabologenomik bu iki veri katmanı arasında bağlantı kurmaya çalışır.
NPClassScore/NPLinker yaklaşımı doğal ürün ontolojilerini kullanarak BGC ile MS/MS sinyalleri arasındaki olası bağlantıları sıralamıştır. Üç eşleştirilmiş omik veri setinde toplam 189 bakteri suşuyla yapılan doğrulamada aday bağlantı sayısını ortalama %63 azaltırken deneysel olarak doğrulanmış bağlantıların %96'sını korumuştur.
Bu sonuç aday uzayını ciddi biçimde daraltabilir ancak kalan her eşleşmenin kesin biyolojik bağlantı olduğu anlamına gelmez; deneysel doğrulama gereklidir.
AI rehberli hedefli izolasyon
Paulownia tomentosa meyve ekstraktında LC-UV-HRMS/MS ve supervised ML kullanan iş akışı 2687 özellik saptamış, 42'sini referans standartlarla tanımlamış, 214'ünü spektral kütüphane ile anotasyonlamış ve 1805 MS/MS spektrumunu prenillenmiş flavonoid sınıfına atamıştır.
Sonraki önceliklendirme beş bileşiğin hedefli izolasyonuna yol açmış; bunların ikisi doğal kaynakta yeni yapılar olarak raporlanmıştır. Kaynak aday uzayının 2687 özellikten beş izolasyon hedefine düşmesini 537 katlık karakterizasyon azalması olarak ifade eder.
Bu örnek doğal ürün keşfi metodolojisinin gücünü gösterir; doğrudan antibakteriyel klinik etkinlik çalışması değildir.
Üretici yapay zekâ yeni antibiyotik tasarlayabilir mi?
Üretici modeller eğitim verisindeki molekül veya peptit örüntülerini öğrenerek daha önce veri tabanında bulunmayan aday yapılar önerebilir. Kaynakta GAN, recurrent modeller ve latent diffusion özellikle antimikrobiyal peptit tasarımında ele alınmaktadır.
Wang ve arkadaşlarının latent diffusion yaklaşımında 40 aday peptit sentezlenmiş ve 25'i (%62,5) antibakteriyel veya antifungal aktivite göstermiştir. AMP-24 Gram-negatif bakterilere karşı, AMP-29 ise Candida glabrata'ya karşı seçici aktivite göstermiştir.
Üretici modelin bir diziyi üretmesi tek başına tedavi adayı statüsü sağlamaz. Molekül sentezlenmeli, MIC ve spektrum testleri yapılmalı, hemoliz/sitotoksisite değerlendirilmeli ve gerekli durumlarda farmakolojik doğrulamaya ilerlenmelidir.
Çalışmanın Yöntemi ve Bulguları
Bu makalenin kendisi hangi yöntemi kullanıyor?
Kaynak çalışma yeni deneysel veri üretmeyen geniş kapsamlı bir Review makalesidir. AMR'nin küresel yükü ve moleküler direnç mekanizmalarından başlayıp geleneksel doğal ürün keşfinin darboğazlarına, AI modellerine, BGC madenciliğine, sanal taramaya, dereplikasyona, metabolomik–kemoinformatik entegrasyonuna ve preklinik doğrulamaya doğru tematik bir sentez kurmaktadır.
Kaynakta ayrı bir sistematik arama metodolojisi, veri tabanı tarama tarihi, PRISMA akışı veya formel dahil etme/dışlama kriteri raporlanmadığından Verianla makalesi çalışmaları “sistematik olarak seçilmiş meta-analitik korpus” olarak sunmamaktadır.
Kaynağın bilimsel mimarisi
| Katman | Ana soru | Kaynakta öne çıkan yöntemler |
|---|---|---|
| AMR yükü ve mekanizmaları | Neden yeni antibakteriyellere ihtiyaç var? | Epidemiyolojik literatür, direnç mekanizmaları, sınıf özgü sınırlılıklar |
| Geleneksel NPD darboğazları | Klasik doğal ürün keşfi neden yavaşlıyor? | Dereplikasyon, kültüre alınamayan organizmalar, sessiz BGC, maliyet ve zaman |
| AI/ML genel çerçevesi | Hangi model aileleri hangi keşif görevlerinde kullanılabilir? | RF, SVM, KNN, boosting, CNN, RNN, GNN, transformer, RL |
| Genom madenciliği | Genomdaki gizli biyosentetik potansiyel nasıl bulunabilir? | DeepBGC, e-DeepBGC, BiGCARP, BGC-Prophet, RFBGCPred, HiFiBGC |
| Yapı ve aktivite tahmini | Hangi moleküller deneysel teste önceliklendirilmeli? | D-MPNN, transfer learning, attention, GNN, QSAR, Cell Painting |
| Dereplikasyon | Bilinen molekül ile gerçek yenilik nasıl ayrılır? | GNPS, SIRIUS, CSI:FingerID, UmetaFlow, FIDDLE, CSU-MS2 |
| Metabolomik–kemoinformatik | Kimyasal sinyaller ve genomik kaynak nasıl bağlanabilir? | Metabologenomik, molecular networking, BGC–metabolite linking |
| Üretici tasarım | Yeni molekül veya AMP adayları üretilebilir mi? | GAN, dil modelleri, latent diffusion |
| Deneysel doğrulama | Hesaplamalı tahmin biyolojik gerçekliğe dönüşüyor mu? | MIC, time-kill, sitotoksisite, hemoliz, mekanizma ve hayvan modelleri |
AI Tahmininden Deneysel Antibakteriyel Adaya Geçiş Nasıl Doğrulanır?
AI tahmininin gerçek antibakteriyel aday olarak değerlendirilebilmesi için hesaplamalı önceliklendirmenin ardından molekülün sentezi veya izolasyonu, in vitro aktivite testi, hedef/seçicilik ve toksisite değerlendirmesi, mekanizma doğrulaması ve uygun adaylarda in vivo enfeksiyon modelleri gerekir; hayvan modelindeki başarı ise hâlâ insan klinik etkinliği anlamına gelmez.
P076 doğrulama zinciri
GAN ve GCN tabanlı AMPredictor çerçevesinde üretilen P001, P002 ve P076 peptitleri hesaplamalı taramadan deneysel teste ilerlemiştir. Model MIC tahmininde RMSE 0,5348 ve Pearson korelasyon katsayısı 0,7072 bildirmiştir.
Üç peptit sekiz bakteriyel suşa karşı in vitro aktivite göstermiştir. P076, MDR Acinetobacter baumannii'ye karşı MIC 0,21 µM düzeyinde aktivite göstermiş, lipid A bağlanması için Kd 56,1 nM bildirilmiş ve 70 µM'ye kadar hemoliz <%1 olarak raporlanmıştır.
Fare peritoneal MDR A. baumannii enfeksiyon modelinde 2 mg/kg P076 verilen grubun 48 saatlik sağkalımı %50 iken PBS ve siprofloksasin kontrol gruplarında %0 olmuştur. Peritoneal bakteri yükünde yaklaşık 25 kat düşüş raporlanmıştır.
Bu sonuçlar P076 için preklinik deneysel kanıt sağlar; insan tedavisindeki doz, güvenlik veya etkinliği belirlemez.
FtsZ ve OmpW hedefli keşif
Kaynak hedef tabanlı AI keşfine iki farklı örnek verir. Bir çalışmada FtsZ proteinine yönelik sanal tarama T3995 adlı adayın önceliklendirilmesine yol açmıştır. Başka bir çalışmada QSAR ve structure-based screening, A. baumannii'nin dış zar proteini OmpW'yi hedefleyen demethoxycurcumin'i seçmiştir.
OmpW eksik mutantla yapılan doğrulama, tahmin edilen hedef bağlantısını test etmek için özellikle değerlidir. Bu tür genetik veya moleküler kontroller yalnız “bileşik bakteriyi öldürdü” sonucundan daha güçlü mekanistik bilgi sağlar.
In vivo doğrulama örnekleri
Derlemede P12'nin fare S. aureus yara enfeksiyonu modelinde etkinliği ve 400 mg/kg düzeyine kadar ana organlarda düşük toksisite; EME7(7)'nin fare A. baumannii pnömoni modelinde etkinliği ve böbrek hasarı oluşturmaması; AMP-24 ile AMP-29'un deri ve akciğer enfeksiyon modellerindeki aktiviteleri gibi preklinik örnekler aktarılmaktadır.
Bunlar insan klinik araştırmaları değildir. Fare modelinde etkin olan bir aday; emilim, dağılım, metabolizma, dozlama, toksisite ve insan patofizyolojisi açısından ayrıca değerlendirilmelidir.
Halicin örneği
Halicin, mevcut bir molekül kütüphanesinin derin öğrenmeyle yeniden taranması sonucu antibakteriyel aktivitesi önceliklendirilen yapısal olarak farklı bir moleküldür. Kaynakta geniş bakteri spektrumundaki in vitro aktivitesi ve C. difficile ile pan-dirençli A. baumannii fare modellerindeki etkinliği aktarılmaktadır.
Bu vaka AI'nin yalnız mevcut antibiyotiklere benzeyen yapıları aramak zorunda olmadığını ve farklı kimyasal iskeletleri önceliklendirebildiğini gösterir. Bununla birlikte halicin örneği bütün AI tarafından bulunan moleküllerin klinik geliştirmeye başarılı biçimde ulaşacağı anlamına gelmez.
Hit oranı ne kadar artabiliyor?
| Yaklaşım | Başlangıç / aday uzayı | Deneysel sonuç | Yorum sınırı |
|---|---|---|---|
| D-MPNN, B. cenocepacia | İlk 29.537 bileşikte %0,87 hit; ardından FDA ilaçları ve 224.205 doğal ürünün sanal taraması | Seçilmiş adaylarda yaklaşık %26 ve %12 hit | Seçilmiş aday alt kümesinin laboratuvar sonucu |
| Transfer-learning GNN | >1 milyar sanal molekül | Deneysel olarak test edilen adaylarda %54 E. coli aktivitesi | Bir milyar molekülün %54'ünün aktif olduğu anlamına gelmez |
| Latent diffusion AMP | 40 sentezlenen aday | 25/40 (%62,5) antibakteriyel veya antifungal aktivite | İn vitro hit; klinik ilaç başarısı değildir |
| AMPlify | 101 adaydan 16 sentezlenen peptit | 4 aktif yeni AMP; sentezlenenlerde %25 hit | Peptit keşfi bağlamına özgüdür |
Açıklanabilir AI neden önemli?
Bir modelin yüksek tahmin gücü, hangi moleküler özelliğin aktiviteyi oluşturduğunu açıklamayabilir. SHAP ve benzeri açıklanabilir AI araçları amino asit, moleküler fragment, fizikokimyasal özellik veya başka girdilerin model kararına katkısını görünür hale getirebilir.
Kaynak LLAMP örneğinde triptofan, lizin ve fenilalanin gibi amino asit kalıntılarının AMP aktivitesindeki öneminin yorumlanabilirlik analiziyle belirlendiğini ve bu bilginin peptit optimizasyonunda kullanıldığını aktarır.
Bununla birlikte özellik atfı nedenselliğin deneysel kanıtı değildir. Bir özelliğin gerçekten etki mekanizmasının parçası olup olmadığı bağımsız biyolojik doğrulamayla değerlendirilmelidir.
Kaynak şekillerinin bilimsel işlev haritası
| Şekil grubu | Bilimsel içerik | Verianla için uygun yeniden ifade biçimi |
|---|---|---|
| Şekil 1–2 | Compound–protein interaction ve meta-learning örnekleri | AI bioaktivite tahmininin kavramsal açıklaması |
| Şekil 3–7 | BGC tespiti, metagenomik assembly, yapı tahmini ve workflow | Genomdan BGC'ye süreç şeması |
| Şekil 8–12 | AMP, D-MPNN, ön eğitim, ultra-büyük tarama ve fenotipik tahmin | Sanal tarama ve aday önceliklendirme akışı |
| Şekil 13–20 | GNPS, SIRIUS, UmetaFlow ve MS tabanlı dereplikasyon | Spektrumdan molekül adayına iş akışı |
| Şekil 21–24 | Metabolomik–kemoinformatik ve hedefli izolasyon | Örnekten analitik özellik ve hedefli izolasyona akış |
| Şekil 25–26 | ML ve latent diffusion ile AMP üretimi | Peptit tasarımı → filtreleme → doğrulama hattı |
Çalışmanın desteklediği sonuçlar
Derleme, AI'nin doğal ürün ve antibakteriyel keşfin birçok basamağında aday uzayını daraltabildiğini, BGC'leri geniş genom koleksiyonlarında önceliklendirebildiğini, bioaktivite ve moleküler yapı tahminlerini geliştirebildiğini, dereplikasyonu hızlandırabildiğini ve bazı seçilmiş çalışmalarda yüksek deneysel hit oranlarına ulaşan adaylar sağlayabildiğini desteklemektedir.
Ayrıca genomik, metabolomik ve kütle spektrometrisi verilerinin birlikte kullanılmasıyla genomdaki biyosentetik potansiyel ile gözlenen kimyasal molekül arasında daha güçlü bağlantılar kurulabildiğini göstermektedir.
Kaynak, bazı AI tarafından önceliklendirilen antimikrobiyal adayların yalnız in silico aşamada kalmadığını; in vitro aktivite, sitotoksisite/hemoliz, hedef mekanizması ve fare enfeksiyon modellerine kadar ilerleyen doğrulama örnekleri bulunduğunu da desteklemektedir.
Çalışmanın desteklemediği sonuçlar
Derleme AI'nin antibiyotik geliştirme sorununu çözdüğünü veya bir modelin yüksek accuracy/AUC değerinin klinik olarak başarılı yeni bir antibiyotik anlamına geldiğini kanıtlamaz.
Kaynakta yer alan %50'nin üzerindeki hit oranları bütün AI sistemleri, bütün kimyasal kütüphaneler veya bütün bakteriler için genel bir başarı oranı değildir. Bunlar farklı çalışmaların seçilmiş deneysel doğrulama sonuçlarıdır.
Hayvan modellerinde etkinlik insan klinik etkinliği değildir. İn vitro MIC değeri insan dozunu belirlemez. Molekül veya peptit üretimi ilaç onayı anlamına gelmez.
Derleme formal sistematik literatür seçimi ve risk-of-bias değerlendirmesi raporlamadığından, aktarılan başarılı örneklerin bütün AI–antibakteriyel keşif literatüründeki ortalama performansı temsil ettiği sonucuna varılamaz.
Kaynağın kendi sonuç bölümünde de model yeniden üretilebilirliği, standardize benchmark eksikliği, olumlu sonuçlara yönelik yayın yanlılığı ve veri kalitesi sorunlarının AI performansını olduğundan daha iyimser gösterebileceği belirtilmektedir.
Gelecekte hangi adımlar gerekli?
Kaynağın gelecek perspektifi; geniş ve iyi kürate edilmiş veri setleri, açık model/kod paylaşımı, standardize benchmarklar, foundation modeller, daha iyi out-of-distribution güven ölçümü, genomik–transkriptomik–metabolomik çoklu veri entegrasyonu ve AI tahminlerinin deneysel doğrulamayla sıkı biçimde bağlanması üzerinde yoğunlaşmaktadır.
Özellikle in vitro aktivite ile klinik etkinlik arasındaki boşluğu kapatmak için farmakokinetik, farmakodinamik, doku dağılımı, konak bağışıklığı ve in vivo güvenlik verilerinin gelecekteki tahmin modellerine daha sistematik biçimde dahil edilmesi gerekmektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: Combating Antibacterial Resistance: The Integrative Role of Artificial Intelligence in Bio-Based Product Development
Yazarlar: Renuka Gudepu; Swapna Sirikonda; Ravinaik Banoth; Praveen Kumar Annagowni; Swati Dahariya; Aditya Velidandi.
Sorumlu yazar: Aditya Velidandi.
Kurumlar: Department of Microbiology, Pingle Government College for Women (A), Warangal; Department of Pharmaceutics, School of Pharmacy, Anurag University, Hyderabad; Department of Mechanical Engineering, St. Martin's Engineering College, Secunderabad; Department of Pharmaceutical Sciences, Jawaharlal Nehru Technological University, Anantapur; Department of Biochemistry, School of Life Sciences, University of Hyderabad; Department of Biotechnology, Vaagdevi Degree and P.G. College, Warangal, India.
Dergi: Antibiotics.
Yayınevi: MDPI, Basel, Switzerland.
Yayın bilgisi: 2026; cilt 15; sayı 5; makale 478. Yayın tarihi: 8 Mayıs 2026.
DOI: 10.3390/antibiotics15050478
Kaynak türü: Hakemli, açık erişimli Review makalesi. Makalede ayrı bir sistematik literatür tarama yöntemi, PRISMA akışı veya formal dahil etme/dışlama protokolü bulunmadığından Verianla içeriğinde anlatısal/kapsamlı derleme olarak ele alınmıştır.
Lisans: Creative Commons Attribution (CC BY).
Kaynak kapsamı: AMR yükü; moleküler direnç mekanizmaları; mevcut antibiyotik sınıflarının sınırlılıkları; geleneksel doğal ürün keşfi darboğazları; ML/DL yöntemleri; AI destekli BGC madenciliği; moleküler yapı ve aktivite tahmini; sanal tarama; dereplikasyon; metabolomik ve kemoinformatik; metabologenomik; üretici model tabanlı AMP tasarımı; in vitro ve in vivo doğrulama.
Kaynakta yeni deney: Yok. Makale daha önce yayımlanmış çalışmaların sonuçlarını sentezlemektedir.
Yeni veri: Oluşturulmamış veya analiz edilmemiştir.
Etik kurul: Uygulanabilir değil.
Bilgilendirilmiş onam: Uygulanabilir değil.
Finansman: Dış finansman alınmamıştır.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yazar katkıları: Kavramsallaştırma Renuka Gudepu ve Swapna Sirikonda; ilk taslak, gözden geçirme/düzenleme ve görselleştirme altı yazarın tamamı; süpervizyon Aditya Velidandi tarafından gerçekleştirilmiştir.
Yazım aracı beyanı: Yazarlar Grammarly'yi okunabilirlik ve cümle yapısını geliştirmek amacıyla kullandıklarını; çıktıyı kendilerinin gözden geçirip düzenlediklerini ve yayın içeriğinin tüm sorumluluğunu üstlendiklerini belirtmiştir.
Kaynak içi epidemiyolojik not: Abstract'taki yaklaşık 4,95 milyon ölüm ifadesi Verianla metninde Tablo 1'in daha kesin ayrımıyla yorumlanmıştır: yaklaşık 4,95 milyon ölüm AMR ile ilişkili, yaklaşık 1,27 milyon ölüm ise doğrudan dirençli enfeksiyonlara atfedilebilir olarak raporlanmaktadır. Bu iki ölçüt eş anlamlı değildir.
Temel yöntemsel sınırlılıklar: Kaynak formal sistematik derleme metodolojisi raporlamamaktadır. Dahil edilen örnekler model mimarisi, veri kaynağı, görev, metrik, doğrulama seviyesi ve terapötik alan açısından oldukça heterojendir. Bazı metodolojik örnekler doğrudan antibakteriyel keşiften değil, daha geniş doğal ürün ve bioaktivite tahmin literatüründen gelmektedir. Bu nedenle performans değerleri ortak bir meta-analitik sonuç olarak birleştirilemez.
Kaynağın kendi AI sınırlılıkları: Kod ve eğitimli modellerin her zaman açık olmaması, standart benchmark eksikliği, olumlu sonuçlara yönelik yayın yanlılığı, eksik veya tutarsız bioaktivite anotasyonları, deney koşullarının eksik bildirilmesi ve kamu veri tabanlarındaki hatalı veya tekrarlı kayıtlar yeniden üretilebilirlik ve genellenebilirliği sınırlar.
Verianla anlatım yöntemi: Bu içerik özgün makalenin abstract veya conclusion bölümünün yakın çevirisi değildir. Kaynaktaki AMR mekanizmaları, doğal ürün keşfi darboğazları, AI model aileleri, BGC madenciliği, sanal tarama, dereplikasyon, metabolomik–kemoinformatik, üretici AMP tasarımı, Figure 1–26'nın bilimsel görevleri, performans ölçütleri, deneysel doğrulama ve sınırlılıklar ayrı bilimsel katmanlara ayrılmış ve öğretici Türkçe bir yapı içinde yeniden düzenlenmiştir.
Yorum sınırı: Burada aktarılan AI performansı veya antibakteriyel aday verileri bireysel hasta için antibiyotik seçimi veya tedavi önerisi değildir. Model doğruluğu, in vitro aktivite ve hayvan modelindeki etkinlik insan klinik etkinliğinin yerine geçmez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir