

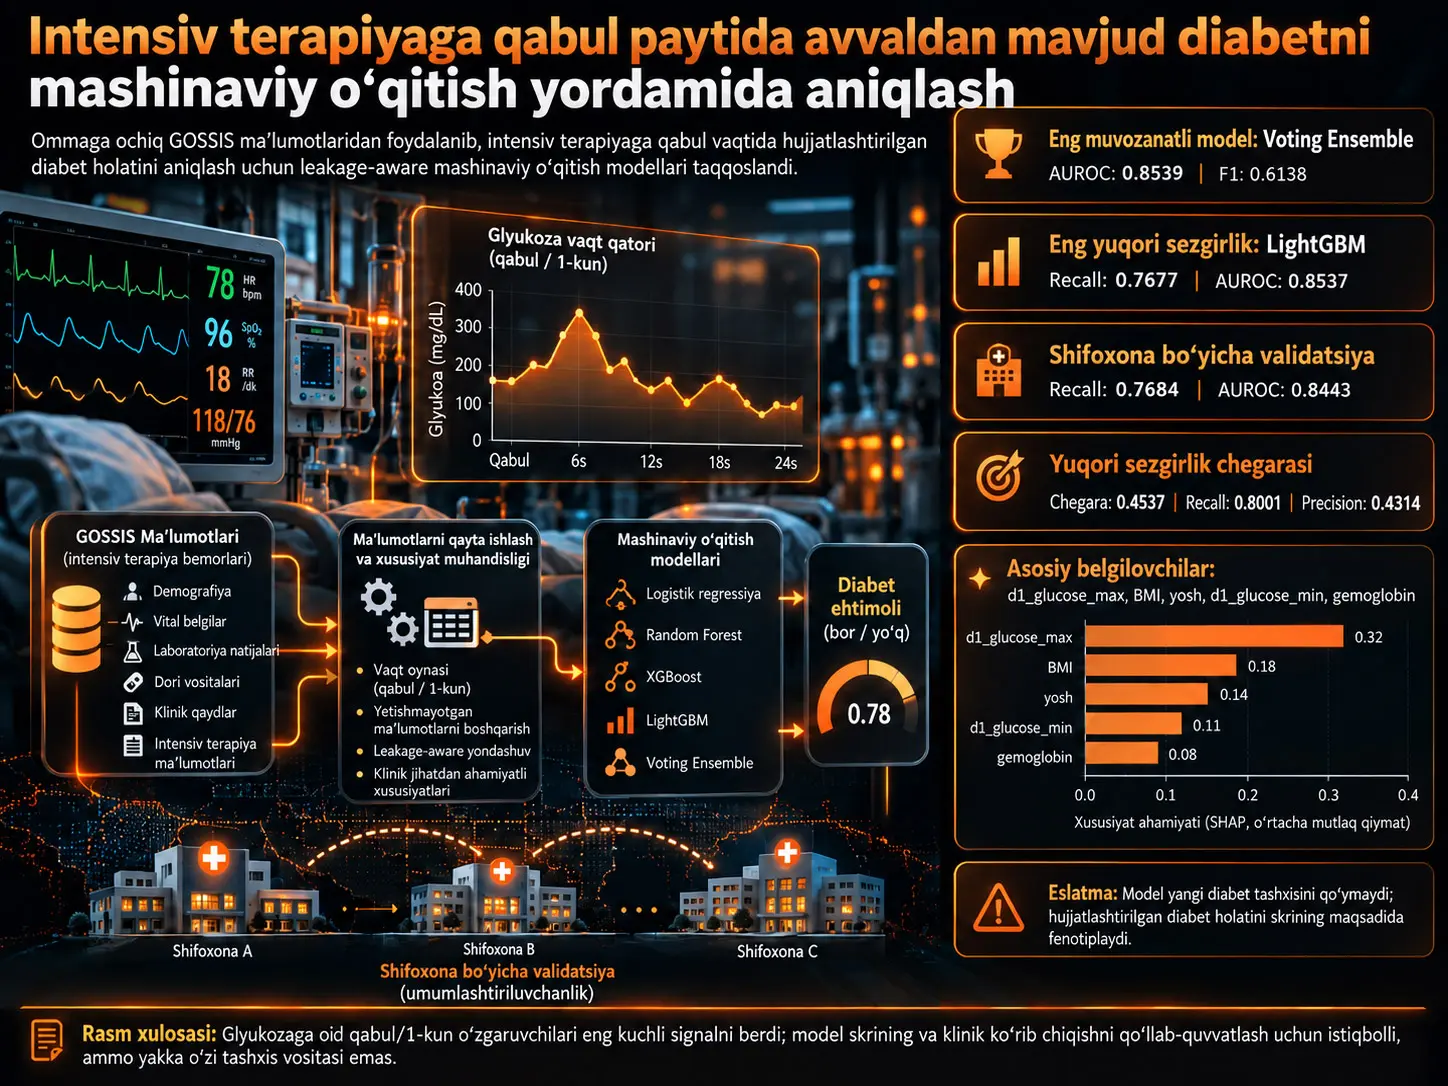
Hisoblanadigan diabet fenotiplash (computable diabetes phenotyping) elektron tibbiy yozuvlardagi tuzilgan oʻzgaruvchilardan foydalanib, shaxsning manba yozuvlarida muayyan klinik fenotipga ega boʻlish ehtimolini algoritmik tarzda aniqlashga qaratilgan tasniflash yondashuvidir. Ushbu tadqiqot ommaga ochiq WiDS Datathon 2021/GOSSIS kritik parvarish maʼlumotlaridan foydalanib, intensiv terapiyaga qabul vaqtida yozuvlarda avvaldan hujjatlashtirilgan diabet holatini aniqlash uchun leakage-aware mashinaviy oʻqitish modellarini taqqosladi. Asosiy tahlilda 125.139 ta yoshi ≥16 ICU yozuvi ishlatildi; CatBoost, Random Forest, XGBoost, LightGBM, Histogram-based Gradient Boosting va uchta boosting modelini birlashtiruvchi soft-voting ensemble baholandi. Leakage-mitigated random validationda voting ensemble AUROC 0,8539, precision 0,5671, recall 0,6690 va F1 0,6138 bilan eng muvozanatli umumiy profilni bergan boʻlsa, tuned LightGBM recall 0,7677 bilan eng yuqori sezgirlikka yoʻnaltirilgan model boʻldi.
Tadqiqotning eng muhim topilmasi model muvaffaqiyati ochiq site yoki APACHE oʻzgaruvchilaridan koʻra erta glyukoza signaliga koʻproq bogʻliq ekanidir. APACHE oʻzgaruvchilari olib tashlanganda samaradorlik faqat cheklangan darajada pasaydi, glyukozaga oʻxshash oʻzgaruvchilar ham olib tashlangan strict reduced ssenariysida esa LightGBM AUROC 0,7432 gacha va voting ensemble AUROC 0,7448 gacha tushdi. SHAP tahlili ham d1_glucose_max va d1_glucose_min oʻzgaruvchilarining ustunligini koʻrsatdi. Biroq intensiv terapiyaning birinchi kunidagi glyukoza oʻlchovlari faqat surunkali diabetni emas, balki oʻtkir stress fiziologiyasini, dori yoki davolash taʼsirlarini, ovqatlanishni qoʻllab-quvvatlashni va oʻlchash intensivligini ham aks ettirishi mumkin.
Kasalxonalar training va validation oʻrtasida toʻliq ajratilgan grouped-site validationda LightGBM recall 0,7684 darajasida saqlanib qoldi, ammo AUROC 0,8443 gacha va precision 0,4546 gacha pasaydi. 0,4537 threshold qiymatida recall 0,8001 gacha oshirilishi mumkin boʻldi, ammo precision 0,4314 boʻldi. Kalibrlash natijalari ham bashorat qilingan ehtimollar klinik mutlaq xavf sifatida ishlatish uchun yetarlicha ishonchli emasligini koʻrsatdi. Shu sababli tizim mustaqil diabet tashxisini qoʻyuvchi vosita emas; chart review, medication reconciliation, cohort enrichment yoki tadqiqot tasnifi uchun yuqori sezgirlikdagi fenotiplash/skrining yordamchisi sifatida talqin qilinishi kerak.
Tadqiqot muammosi
Intensiv terapiyaga qabul vaqtida bemorning diabet tarixini toʻgʻri bilish erta giperglikemiyani qanday talqin qilishga taʼsir qilishi mumkin. Biroq diabet haqidagi maʼlumot muammolar roʻyxati, tashxis kodlari, oldingi murojaatlar, dori yozuvlari, laboratoriya arxivlari yoki muassasalararo transfer hujjatlari kabi turli elektron tibbiy yozuv manbalariga tarqalgan boʻlishi mumkin. Bu yozuvlarning bir qismi qabul paytida mavjud boʻlmasligi mumkin.
Bu muammo ayniqsa intensiv terapiyada muhim, chunki bir xil yuqori glyukoza qiymati turli sabablarga koʻra yuzaga kelishi mumkin. Avvaldan maʼlum diabet, ilgari aniqlanmagan surunkali disglikemiya, oʻtkir stress giperglikemiyasi, glyukokortikoid yoki boshqa dori taʼsirlari, enteral/parenteral oziqlantirish, dekstroza saqlovchi suyuqliklar va erta davolash amaliyotlari bir-biriga oʻxshash glikemik koʻrinishlarni yuzaga keltirishi mumkin.
Shuning uchun tadqiqot savoli “bemor haqiqatan ham diabetikmi?” shaklida yangi klinik tashxis qoʻyish emas. Savol intensiv terapiyaga qabulga yaqin vaqtdagi mavjud tuzilgan maʼlumotlardan foydalanib, manba maʼlumotlar bazasida avvaldan hujjatlashtirilgan diabet holatini qanchalik ishonchli tarzda fenotiplash mumkinligidir.
Bu Model Haqiqatan Ham Diabet Tashxisini Qoʻyadimi?
Yoʻq. Tadqiqotning maqsad yorligʻi manba yozuvlarida intensiv terapiyaga qabuldan oldin yoki qabul vaqtida allaqachon hujjatlashtirilgan diabet holatidir; model yangi diabet tashxisini qoʻyish, stress giperglikemiyasini aniqlash yoki kelajakda paydo boʻladigan diabetni bashorat qilish uchun oʻqitilmagan va manba muallif tizimni mustaqil tashxis vositasi emas, fenotiplash va skrining yordamchisi sifatida chegaralaydi.
Computable phenotyping yondashuvining roli
Computable phenotyping klinik holatni tuzilgan EHR oʻzgaruvchilari orqali qayta taʼriflaydigan algoritmik yondashuv sifatida qaralishi mumkin. Bunday tizimlarda samaradorlik faqat AUROC bilan baholanmasligi kerak. Xuddi shuningdek muhim savollar: ishlatilgan oʻzgaruvchilar yorliqqa sizib kirgan-kirmagani, preprocessing faqat training maʼlumotlaridan oʻrganilgan-oʻrganilmagani, turli kasalxonalarda samaradorlik saqlangan-saqlanmagani, sinf nomutanosibligi qanday boshqarilgani va bashorat ehtimollari kalibrlangan-kalibrlanmaganidir.
Maʼlumot manbai
| Komponent | Yozuv | Xususiyat | Tadqiqotdagi qoʻllanilishi |
|---|---|---|---|
| Yorliqlangan WiDS 2021 fayli | 130.157 ICU stay | 181 | Modelni ishlab chiqish va validation manbai |
| Yoshi ≥16 analitik kohort | 125.139 ICU stay | Preprocessingdan keyin ssenariyga bogʻliq | Asosiy modellashtirish kohorti |
| Yorliqsiz challenge fayli | 10.234 yozuv | 180 | Validation metrikasi, preprocessingni oʻrganish yoki threshold tanlash uchun ishlatilmadi |
Toʻrtta xususiyat ssenariysi
| Ssenariy | Asosiy qoida |
|---|---|
| Full feature set | Odatiy tozalash qoʻllanadi; grouping identifierlar model matritsasidan chiqariladi. |
| Leakage-mitigated original | Yorliqqa bevosita yoki bilvosita juda yaqin boʻlishi mumkin boʻlgan APACHE diagnosis maydonlari va tanlangan surunkali komorbidlik koʻrsatkichlari chiqariladi; boshqa klinik admission/day-1 oʻzgaruvchilari saqlanadi. |
| Exclude all APACHE | Leakage-mitigated chiqarishlarga qoʻshimcha ravishda barcha APACHE bilan bogʻliq oʻzgaruvchilar olib tashlanadi. |
| Strict reduced model | APACHE, site identifier va glyukozaga oʻxshash oʻzgaruvchilar ham chiqariladi. |
Split-aware preprocessing nima uchun muhim edi?
Tadqiqotda maʼlumotlarni preprocessing qoidalari validation maʼlumotidan axborot sizib chiqmasligi uchun faqat training split ustida oʻrganildi. Yorliqsiz challenge fayli ham imputer, kategorik daraja, engineered feature yoki correlation-pruning qarorini ishlab chiqishda ishlatilmadi.
Asosiy random split:
\[ (X_{\mathrm{train}},X_{\mathrm{val}},y_{\mathrm{train}},y_{\mathrm{val}}) = \mathrm{StratifiedSplit}(X,y;\mathrm{test\_size}=0.20,\mathrm{stratify}=y,\mathrm{seed}=40) \]
Bu tenglama barcha katta yoshli yozuvlarni diabetes_mellitus yorligʻi taqsimotini saqlagan holda %80 training va %20 validationga ajratadi. Keyin preprocessing parametrlari faqat training qismidan hisoblanadi:
\[ \Theta=\mathrm{fit}_{\mathrm{train}}(\mathrm{preprocessing}), \qquad X_{\mathrm{val}}^{*}=\mathrm{transform}_{\Theta}(X_{\mathrm{val}}) \]
Bu ketma-ketlik validation maʼlumotlaridagi taqsimot xususiyatlarining training jarayonida modelga bilvosita oʻtishini kamaytirishga qaratilgan.
Qator va sxema darajasidagi tozalash
- Yoshi <16 boʻlgan yozuvlar chiqarildi.
- hospital_admit_source va icu_admit_source kategoriyalari uygʻunlashtirildi.
- Agar bir _min oʻzgaruvchisi tegishli _max qiymatidan katta boʻlsa, ikki qiymatning oʻrni almashtirildi.
- Yetishmayotgan d1_pao2fio2ratio_max uchun mos hollarda pao2_apache/fio2_apache nisbati hisoblandi.
- Barcha h1_ oʻzgaruvchilari chiqarildi.
- Day-1 ekvivalenti mavjud boʻlgan ayrim near-duplicate APACHE maydonlari olib tashlandi.
- encounter_id, readmission_status va indeks ustuni modeldan chiqarildi.
- hospital_id va icu_id faqat grouped validation uchun alohida saqlandi; hech bir feature ssenariysida model kirishi sifatida ishlatilmadi.
Yetishmayotgan qiymatlarni qayta ishlash
Uzluksiz oʻzgaruvchilar training-set oʻrtachasi, kategorik oʻzgaruvchilar esa training-set modasi bilan toʻldirildi. Boʻy, vazn va BMI uchun avval jinsga xos training-set oʻrtachasi ishlatildi; bu qiymat boʻlmasa, umumiy training oʻrtachasiga qaytildi. Kategorik oʻzgaruvchilar faqat training qismida kuzatilgan kategoriyalar asosida one-hot encode qilindi.
Training design matrixda mutlaq Pearson korrelyatsiyasi 0,80 dan oshadigan yuqori uchburchak feature juftlarida ikkinchi feature chiqarildi:
\[ C_{\mathrm{drop}} = \{b:\exists a<b,\ |r_{ab}|>0.80\} \]
Xuddi shu ustun chiqarishlari validation va challenge matritsalariga ham aynan qoʻllandi.
Taqqoslangan modellar
| Model | Rol | Manbada berilgan asosiy konfiguratsiya |
|---|---|---|
| CatBoost | Boosting baseline | 100 boosting iteration; random seed 40 |
| Random Forest | Bagging baseline | 100 daraxt; random_state=40; parallel ishlov |
| Tuned XGBoost | Tuned gradient boosting | 200 estimator; max_depth=8; learning_rate=0,05; subsample=0,8; min_child_weight=10; colsample_bytree=0,8 |
| Tuned LightGBM | Sezgirlikka yoʻnaltirilgan boosting | learning_rate=0,007; colsample_bytree=0,2; reg_alpha=3; reg_lambda=1; scale_pos_weight=4; n_estimators=10.000; random_state=100 |
| HistGradientBoosting | Qoʻshimcha boosting taqqoslagichi | scikit-learn histogram-based gradient boosting; random_state=40 |
| Soft-voting ensemble | Birlashtirilgan probability modeli | XGBoost : LightGBM : HGB = 1 : 3 : 1 |
Sinf nomutanosibligi qanday boshqarildi?
Tadqiqot sintetik minority namunalarini yaratish uchun SMOTEdan foydalanish oʻrniga model ichidagi sinf vaznlashini tanladi. LightGBMda diabetes-positive sinfi uchun scale_pos_weight=4 ishlatildi. Bu tanlov haqiqiy maʼlumot taqsimotini oʻzgartirmasdan ijobiy holatlarni notoʻgʻri tasniflashning training loss ichidagi narxini oshiradi.
Konseptual vaznlangan yoʻqotish:
\[ L=\sum_{i=1}^{n}w_{y_i}\ell(y_i,p_i)+\Omega(F) \]
Bu yerda \(w_{y_i}\) sinf vaznini, \(\ell(y_i,p_i)\) ikkilik tasniflash yoʻqotishini va \(\Omega(F)\) model murakkabligiga qoʻllanadigan regularization hadini ifodalaydi.
Soft-voting ensemble qanday tuzildi?
XGBoost, LightGBM va HGB probability bashoratlari LightGBMga uch baravar vazn beriladigan tarzda birlashtirildi:
\[ p_i^{(\mathrm{ens})} = \frac{ p_i^{(\mathrm{XGB})} + 3p_i^{(\mathrm{LGBM})} + p_i^{(\mathrm{HGB})} }{5} \]
Maqsad LightGBMning yuqori sezgirlik afzalligini saqlagan holda XGBoost va HGBning ehtiyotkorroq ehtimol bashoratlari bilan false-positive yukini muvozanatlashtirishdir.
Tasniflash thresholddi
Har bir model avval diabet-positive sinfi uchun ehtimol bashoratini yaratdi:
\[ p_i^{(m)} = \Pr(y_i=1\mid x_i^{*},M_m) \]
Asosiy taqqoslashda standart threshold \(t=0,50\) ishlatildi:
\[ \hat{y}_i^{(m)}(t) = I\left(p_i^{(m)}\geq t\right) \]
Precision–recall tahlilida esa threshold oʻzgartirilib, turli recall–precision muvozanatlari alohida koʻrib chiqildi.
Samaradorlik metrikalarining roli
Accuracy umumiy toʻgʻri tasniflash ulushini, precision ijobiy deb bashorat qilingan holatlarning qanchasi haqiqatan ijobiy ekanini, recall manba yorligʻida ijobiy boʻlgan holatlarning qanchasi aniqlanganini, F1 esa precision va recallning garmonik oʻrtachasini oʻlchaydi.
Brier skori probability aniqligini oʻlchaydigan va past boʻlishi istaladigan metrikadir:
\[ \mathrm{Brier} = \frac{1}{n_V} \sum_{i\in V} (p_i-y_i)^2 \]
AUROC esa qatʼiy thresholddan mustaqil tartiblash ajratish qobiliyatini ifodalaydi. Model yuqori AUROCga ega boʻlsa ham yomon kalibrlangan boʻlishi mumkinligi sababli manba AUROC va calibration/Brierni alohida baholadi.
Kasalxona Boʻyicha Guruhlangan Validation Nima Uchun Muhim?
Grouped-site validation bir xil kasalxonaga tegishli hech bir yozuvning ham training, ham validation qismida boʻlishiga yoʻl qoʻymagani uchun modelning muayyan muassasalarga xos kodlash, laboratoriya buyurtma qilish, bemor profili yoki hujjatlashtirish naqshlarini yodlab olishidan kelib chiqishi mumkin boʻlgan optimistik samaradorlik bahosini kamaytiradi; biroq bu dizayn hanuz ayni WiDS/GOSSIS maʼlumot versiyasi ichida bajarilgan internal validation boʻlib, mustaqil external validation emas.
Matematik ajratish:
\[ G_{\mathrm{train}}\cap G_{\mathrm{val}}=\varnothing \]
| Validation | Training yozuvi | Validation yozuvi | Kasalxona tuzilishi |
|---|---|---|---|
| Random stratified | 100.111 | 25.028 | Bir xil kasalxonalar ikkala qismda ham boʻlishi mumkin |
| Grouped site | 95.233 | 29.906 | 163 training va 41 validation kasalxonasi; kesishish yoʻq |
Tadqiqot Usuli va Natijalari
Asosiy model taqqoslanishi
| Model | Accuracy | Precision | Recall | F1 | AUROC | Brier |
|---|---|---|---|---|---|---|
| Voting Ensemble | 0,8151 | 0,5671 | 0,6690 | 0,6138 | 0,8539 | 0,1300 |
| LightGBM (Tuned) | 0,7815 | 0,5017 | 0,7677 | 0,6069 | 0,8537 | 0,1508 |
| XGBoost (Tuned) | 0,8288 | 0,6557 | 0,4642 | 0,5436 | 0,8505 | 0,1197 |
| HistGradientBoosting | 0,8251 | 0,6445 | 0,4543 | 0,5330 | 0,8458 | 0,1214 |
| CatBoost | 0,8227 | 0,6317 | 0,4629 | 0,5343 | 0,8403 | 0,1236 |
| Random Forest | 0,8154 | 0,6645 | 0,3225 | 0,4342 | 0,8252 | 0,1286 |
Bu jadval yagona “eng yaxshi model” oʻrniga turli foydalanish maqsadlari uchun turli operatsion profillar mavjudligini koʻrsatadi. Voting ensemble F1 va AUROC boʻyicha eng muvozanatli natijalarni berdi. LightGBM ijobiy holatlarni eng koʻp aniqlagan modeldir; biroq u koʻproq false positive yaratdi. XGBoost esa pastroq recall evaziga eng past Brier skorini berdi.
Figure 1–6: Confusion matrix va feature importance
Manbada Figure 1–6 har bir asosiy model uchun confusion matrixni top-15 feature importance grafigi bilan juftlaydi. CatBoost 18.046 true negative, 1.484 false positive, 2.953 false negative va 2.545 true positive yaratdi. Random Forest false positive sonini atigi 895 gacha kamaytirdi, ammo 3.725 diabet-positive holatni oʻtkazib yubordi.
Tuned XGBoost 2.552 true positive va 1.340 false positive yaratgan paytda LightGBM 4.221 true positivega yetdi; buning evaziga 4.192 false positive yaratdi. HGB 2.498 true positive, 1.378 false positive yaratdi. Voting ensemble 3.678 true positive va 2.808 false positive bilan LightGBM hamda ehtiyotkorroq modellar oʻrtasida oʻrta operatsion profil hosil qildi.
Barcha model oilalarida d1_glucose_max kuchli yoki ustun feature sifatida ajralib turdi. d1_glucose_min, BMI, yosh, kreatinin, pre-ICU length of stay, gemoglobin va boshqa fiziologik/laboratoriya xulosalari turli modellarda takroran yuqori ahamiyatga ega oʻzgaruvchilar boʻldi.
Glyukozaga Oʻxshash Oʻzgaruvchilar Chiqarilganda Samaradorlik Qanday Boʻldi?
Glyukozaga oʻxshash oʻzgaruvchilar APACHE va leakage-prone maydonlari bilan birga chiqarilganda modelning ajratish qobiliyati sezilarli darajada pasaydi: LightGBM AUROC 0,8537 dan 0,7432 gacha, voting ensemble AUROC 0,8539 dan 0,7448 gacha tushdi; aksincha, faqat leakage-prone yoki barcha APACHE oʻzgaruvchilarini chiqarish ancha kichik yoʻqotishlarga olib keldi, demak admission/day-1 glikemik oʻzgaruvchilari modelning asosiy predictive signalidir.
| Ssenariy | LightGBM AUROC | LightGBM Recall | LightGBM Brier | Ensemble AUROC | Ensemble F1 |
|---|---|---|---|---|---|
| Full feature set | 0,8565 | 0,7672 | 0,1491 | 0,8566 | 0,6159 |
| Leakage-mitigated original | 0,8537 | 0,7677 | 0,1508 | 0,8539 | 0,6138 |
| Exclude all APACHE | 0,8508 | 0,7634 | 0,1529 | 0,8514 | 0,6077 |
| Strict reduced model | 0,7432 | 0,6641 | 0,1986 | 0,7448 | 0,4493 |
Bu ablation glyukoza oʻzgaruvchilari “surunkali diabetni sof holda oʻlchashini” isbotlamaydi. Aksincha, modelning kuchli signalining muhim qismi erta glikemik oʻlchovlarga tayanganini koʻrsatgani uchun klinik talqinda yanada ehtiyotkorlik talab etadi.
Kasalxona boʻyicha validation natijalari
| Validation | Accuracy | Precision | Recall | F1 | AUROC | Brier |
|---|---|---|---|---|---|---|
| Random stratified | 0,7815 | 0,5017 | 0,7677 | 0,6069 | 0,8537 | 0,1508 |
| Grouped site | 0,7727 | 0,4546 | 0,7684 | 0,5712 | 0,8443 | 0,1596 |
Grouped-site confusion matrix 18.581 true negative, 5.432 false positive, 1.365 false negative va 4.528 true positive ni oʻz ichiga oladi. Recallning deyarli oʻzgarmay qolishi model turli kasalxonalarda ijobiy yozuvlarni aniqlashda davom etganini; precision va Brierdagi yomonlashuv esa buning kattaroq notoʻgʻri-ijobiy hamda probability reliability xarajati bilan yuz berganini koʻrsatadi.
Precision–recall va yuqori sezgirlik thresholddi
Class imbalance sababli ROC tahliliga qoʻshimcha ravishda precision–recall egri chiziqlari ishlatildi. Random validation average precision 0,622, grouped-site average precision 0,551 dir.
Manba yuqori sezgirlik maqsadini:
\[ t_r= \max\{t:\mathrm{Recall}(t)\geq0.80\} \]
deb taʼriflagan. Grouped-site maʼlumotlarida ushbu shartga javob beradigan hisobotdagi threshold 0,4537 dir; bu nuqtada recall 0,8001 va precision 0,4314 dir.
Bu natija “yuqoriroq recall bepul emas” tamoyilini bevosita koʻrsatadi. Oʻtkazib yuborilgan ijobiy holatlarni kamaytirish uchun threshold pasaytirilganda, ijobiy deb belgilangan, ammo manba yorligʻi salbiy boʻlgan bemorlar soni ortadi.
Modelning Yuqori AUROC Qiymati Ehtimollar Yaxshi Kalibrlanganini Anglatadimi?
Yoʻq. LightGBM AUROC boʻyicha kuchli ajratishni taʼminlasa-da, random va grouped-site kalibrlash egri chiziqlari bashorat ehtimollari, ayniqsa oʻrta-yuqori xavf oraligʻida, kuzatilgan diabet chastotasidan yuqori boʻlishga moyilligini, Brier skorlari ham grouped validation ostida yomonlashganini koʻrsatdi; shu sababli xom model ehtimollari qayta kalibrlashsiz klinik mutlaq xavf ehtimoli sifatida talqin qilinmasligi kerak.
Kalibrlash mantiqi
Mukammal kalibrlangan modelda bashorat ehtimoli \(p\) boʻlgan bemorlar guruhida haqiqiy ijobiylik ulushi ham \(p\) boʻlishi kutiladi:
\[ E[y_i\mid p_i=p]=p \]
Manba kalibrlash egri chizigʻini 10 ta teng ehtimol oraligʻi bilan yaratgan va post hoc recalibration qoʻllamagan. Figure 10 da ikki validation dizaynidagi egri chiziq ideal diagonalning muhim qismida undan pastda qolgan; bu probability overestimation bilan mos keladi.
| Validation | Brier | Kalibrlash talqini |
|---|---|---|
| Random stratified | 0,1508 | Probability overestimation kuzatiladi |
| Grouped site | 0,1596 | Probability reliability biroz yomonroq |
SHAP nima uchun grouped-site modelida hisoblandi?
SHAP tahlilining grouped-site LightGBMda bajarilishi izohni bir xil kasalxonalar ikki fold ichida mavjud boʻlgan osonroq random splitga emas, balki qatʼiyroq kasalxona-ajratilgan model xatti-harakatiga bogʻlash imkonini berdi. Grouped validation namunalari soni 3.000 dan oshsa, SHAP hisoblash takror ishlab chiqarish mumkin boʻlishi uchun sobit seed bilan eng koʻpi 3.000 yozuvgacha namunalandi.
SHAPning additive izoh shakli:
\[ F_G(x_i^{*}) = \phi_0+\sum_{j=1}^{p}\phi_{ij} \]
Bu yerda \(\phi_0\) modelning boshlangʻich/baseline chiqishini, \(\phi_{ij}\) esa bemor \(i\) uchun feature \(j\) ning model chiqishini yuqoriga yoki pastga siljitadigan hissasini ifodalaydi.
Global SHAP topilmalari
| Oʻzgaruvchi | Manbada kuzatilgan asosiy xatti-harakat |
|---|---|
| d1_glucose_max | Yaqqol eng yuqori mean absolute SHAP; yuqori qiymatlar odatda diabetes-positive yoʻnalishida hissa qoʻshadi |
| BMI | Yuqori qiymatlar odatda ijobiy hissa; high-20s atrofida salbiydan ijobiyga oʻtish va yuqori chetda qisman plato |
| Age | Yoshroq davrda salbiy; oʻrta va katta yoshda koʻproq ijobiy; eng katta yoshlarda plato/yengil pasayish |
| d1_glucose_min | Teskari va chiziqli boʻlmagan naqsh; past minima ijobiy yoʻnalishda hissa qoʻshishi mumkin |
| d1_hemoglobin_max | Past-oʻrta qiymatlarda ijobiy hissa, yuqori qiymatlarda tobora salbiy yoʻnalish |
| urineoutput_apache | Kichikroq va tarqoq SHAP kattaliklari; ikkilamchi kontekstual feature |
d1_glucose_max dependence grafigi
Figure 12 ga koʻra d1_glucose_max ning SHAP hissasi taxminan 100–250 mg/dL oraligʻida sezilarli oshgan va juda yuqori qiymatlarda platoga chiqqan. Bu naqsh model xatti-harakati cheksiz chiziqli oʻsishdan koʻra non-linear saturationni oʻz ichiga olishini koʻrsatadi.
Mahalliy SHAP waterfall izohlari
Figure 14–15 true positive, false positive, true negative va false negative guruhlaridan tanlangan vakillik holatlarini izohlaydi. Ijobiy ball olgan misollarda yuqori d1_glucose_max koʻpincha eng katta yuqoriga yoʻnaltirilgan hissadir; salbiy ball olgan misollarda pastroq yoki kamroq ekstremal maksimal glyukoza qiymati kuchli pastga yoʻnaltirilgan hissa berishi mumkin.
Biroq individual bashoratlar bitta featuredan iborat emas. BMI, yosh, gemoglobin, renal kontekst, d1_glucose_min va pre-ICU xususiyatlari kuchli glikemik signalni oshirishi yoki kamaytirishi mumkin.
Tadqiqot qoʻllab-quvvatlaydigan xulosalar
- Public WiDS/GOSSIS structured EHR maʼlumotlari yozuvlarda hujjatlashtirilgan diabet holatini admission-time fenotiplashda ishlatilishi mumkin.
- Gradient-boosted va ensemble tree modellari manba validation dizaynlarida kuchli ajratishni koʻrsatdi.
- Voting ensemble eng muvozanatli F1/AUROC profilini yaratdi.
- LightGBM eng yuqori recallga yoʻnaltirilgan yagona modeldir.
- Reasonable leakage mitigation va barcha APACHE oʻzgaruvchilarini chiqarish samaradorlikni faqat cheklangan darajada pasaytirdi.
- Glyukozaga oʻxshash featurelarni chiqarish ajratish qobiliyatini sezilarli pasaytirdi.
- Grouped-site validationda recall saqlangan holda precision va calibration yomonlashdi.
- SHAP tahlillari dominant glycemic signal bilan kichikroq kontekstual klinik hissalarni koʻrsatadi.
Tadqiqot qoʻllab-quvvatlamaydigan xulosalar
- Model yangi diabet tashxisini qoʻyishini isbotlamaydi.
- Model surunkali diabet bilan stress hyperglycemiani aniq ajratmaydi.
- 0,8539 AUROC klinik deployment uchun oʻzi yetarli emas.
- Grouped-site validation mustaqil tashqi maʼlumotlardagi external validation emas.
- 0,4537 threshold barcha klinik ish oqimlari uchun universal optimal threshold emas.
- SHAP hissalari biologik sababiylikni anglatmaydi.
- Model ehtimollari recalibrationsiz klinik mutlaq xavf ehtimoli sifatida ishlatilmasligi kerak.
- Tadqiqot avtomatik davolash qarori, insulin dozasi yoki klinik ogohlantirish tizimini tasdiqlamagan.
Asosiy cheklovlar
Birinchi cheklov referens yorligʻidir. “Diabetes mellitus” yorligʻi manba maʼlumotlar bazasidagi hujjatlashtirilgan diabet maʼlumotidir; HbA1c, longitudinal outpatient records, dori tarixi va manual chart review bilan qayta adjudike qilingan gold-standard surunkali diabet yorligʻi emas.
Ikkinchi cheklov validation qamrovidir. Kasalxona boʻyicha ajratish random splitga qaraganda qatʼiyroq boʻlsa ham, training va validation yozuvlari bir xil ommaviy maʼlumotlar ekotizimining bir qismidir. Mustaqil ICU maʼlumot toʻplamlarida external validation oʻtkazilmagan.
Uchinchi cheklov glikemik signalning spetsifikligidir. Early ICU glucose qiymatlari surunkali metabolik kasallikni ham, oʻtkir stress, davolash va monitoring jarayonini ham aks ettirishi mumkin.
Toʻrtinchi cheklov calibrationdir. Manba model bashoratlarini qayta kalibrlamagan; calibration tahlili faqat muammoni aniqlagan.
Kelajakdagi tadqiqot yoʻnalishlari
Manba mustaqil ICU maʼlumotlar bazalarida external validation, turli kasalxona va vaqt davrlarida prospektiv baholash, foydalanish maqsadiga xos threshold tanlash va zarur boʻlsa post hoc recalibrationni tavsiya qiladi.
Kuchliroq referens yorliqlar uchun longitudinal EHR, HbA1c, outpatient dori tarixi, muammolar roʻyxati, tashxis kodlari va zarur boʻlsa manual adjudication birgalikda baholanishi mumkin. Shu tariqa avvaldan maʼlum surunkali diabet; ilgari aniqlanmagan diabet, stress hyperglycemia, medication-related hyperglycemia, nutrition-associated dysglycemia va treatment-related glucose oʻzgarishlaridan aniqroq ajratilishi mumkin.
Manba, shuningdek, ayni validation, calibration, ablation va interpretability doirasi ostida TabNet, TabTransformer, FT-Transformer yoki boshqa deep tabular/Transformer asosidagi modellar kelajakda taqqoslanishi mumkinligini bildiradi.
Manba va Usul Haqida Izoh
Asl tadqiqot: Identifying Pre-Existing Diabetes at ICU Admission with Machine Learning on Public GOSSIS Data
Muallif: Lily Popova Zhuhadar.
Mualliflar soni: 1; manba maqola sole-author tadqiqotidir.
Muassasa: Department of Analytics & Information Systems, Center for Applied Data Analytics, Western Kentucky University, Bowling Green, Kentucky, USA.
Masʼul muallif: Lily Popova Zhuhadar.
Jurnal: Diabetology.
Nashriyot: MDPI, Basel, Switzerland.
Jild / son / maqola: 7(5), 100.
DOI: 10.3390/diabetology7050100.
Received: 26 Mart 2026.
Revised: 19 May 2026.
Accepted: 19 May 2026.
Published: 21 May 2026.
Academic Editor: Peter Clifton.
Manba turi: Taqrizdan oʻtgan Original Article; retrospektiv mashinaviy oʻqitish benchmark/fenotiplash tadqiqoti.
Litsenziya: Creative Commons Attribution (CC BY).
Maʼlumot manbai: WiDS Datathon 2021 tabular release; GOSSIS initiative va eICU Collaborative Research Database hosilasi.
Boshlangʻich yorliqlangan maʼlumot: 130.157 ICU stay, 181 feature.
Yorliqsiz challenge fayli: 10.234 yozuv, 180 feature; preprocessingni oʻrganish, threshold tanlash va validation samaradorligi uchun ishlatilmadi.
Yakuniy yoshi ≥16 analitik kohort: 125.139 ICU stay.
Asosiy random split: 100.111 training / 25.028 validation; stratified 80/20; random seed 40.
Grouped-site split: 95.233 training / 29.906 validation; 163 training kasalxonasi / 41 validation kasalxonasi; kasalxonalar kesishmaydi.
Maqsad yorligʻi: Manba yozuvlarida admissiondan oldin yoki uning vaqtida hujjatlashtirilgan pre-existing diabetes mellitus.
Modellar: CatBoost, Random Forest, tuned XGBoost, tuned LightGBM, HistGradientBoosting va soft-voting ensemble.
Class imbalance yondashuvi: Model-intrinsic class weighting va threshold-aware evaluation; sintetik oversampling ishlatilmadi.
Soft-voting vaznlari: XGBoost : LightGBM : HGB = 1 : 3 : 1.
Baholash metrikalari: Accuracy, precision, recall, F1-score, AUROC, Brier score va average precision.
Calibration: 10 uniform probability bin; post hoc recalibration qoʻllanmadi.
Interpretability: SHAP / TreeExplainer; grouped-site LightGBM; zarur boʻlsa eng koʻpi 3.000 grouped-validation yozuvi.
Ablation: Full feature set, leakage-mitigated original, exclude all APACHE va strict reduced model.
Asosiy natija: Voting ensemble leakage-mitigated random splitda AUROC 0,8539 va F1 0,6138 bilan eng muvozanatli umumiy profil; tuned LightGBM recall 0,7677 bilan eng sezgir yagona model.
Grouped-site asosiy natija: LightGBM recall 0,7684, AUROC 0,8443, precision 0,4546 va Brier 0,1596.
Yuqori sezgirlikdagi grouped threshold: t=0,4537; recall 0,8001; precision 0,4314.
Dominant model signali: d1_glucose_max va glyukoza bilan bogʻliq boshqa day-1 oʻzgaruvchilari.
Moliyalashtirish: Tashqi moliyalashtirish yoʻq.
Etika kengashi: Not applicable; de-identified public ICU data ishlatilgan.
Axborotli rozilik: Not applicable.
Maʼlumotlarning mavjudligi: WiDS Datathon 2021 tabular dataset Kaggle orqali ommaga ochiq ekani bildirilgan.
Kod/analitik material: Muallif natijalarni qayta ishlab chiqarishga moʻljallangan Google Colab manbasini bildirgan; manbada kirish sanasi 12 Mart 2026-yil.
Manfaatlar toʻqnashuvi: Muallif manfaatlar toʻqnashuvi yoʻqligini bildirgan.
Asosiy klinik chegara: Model yozuvlarda hujjatlashtirilgan diabet fenotipini tasniflaydi; adjudike qilingan surunkali diabet tashxisi, stress hyperglycemia ajratishi yoki davolash qarorini yaratmaydi.
Asosiy deployment chegarasi: External validation, recalibration, workflow-specific thresholding va confirmatory clinical review bajarilmasdan mustaqil tashxis yoki davolash qarori vositasi sifatida ishlatilmasligi kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan