

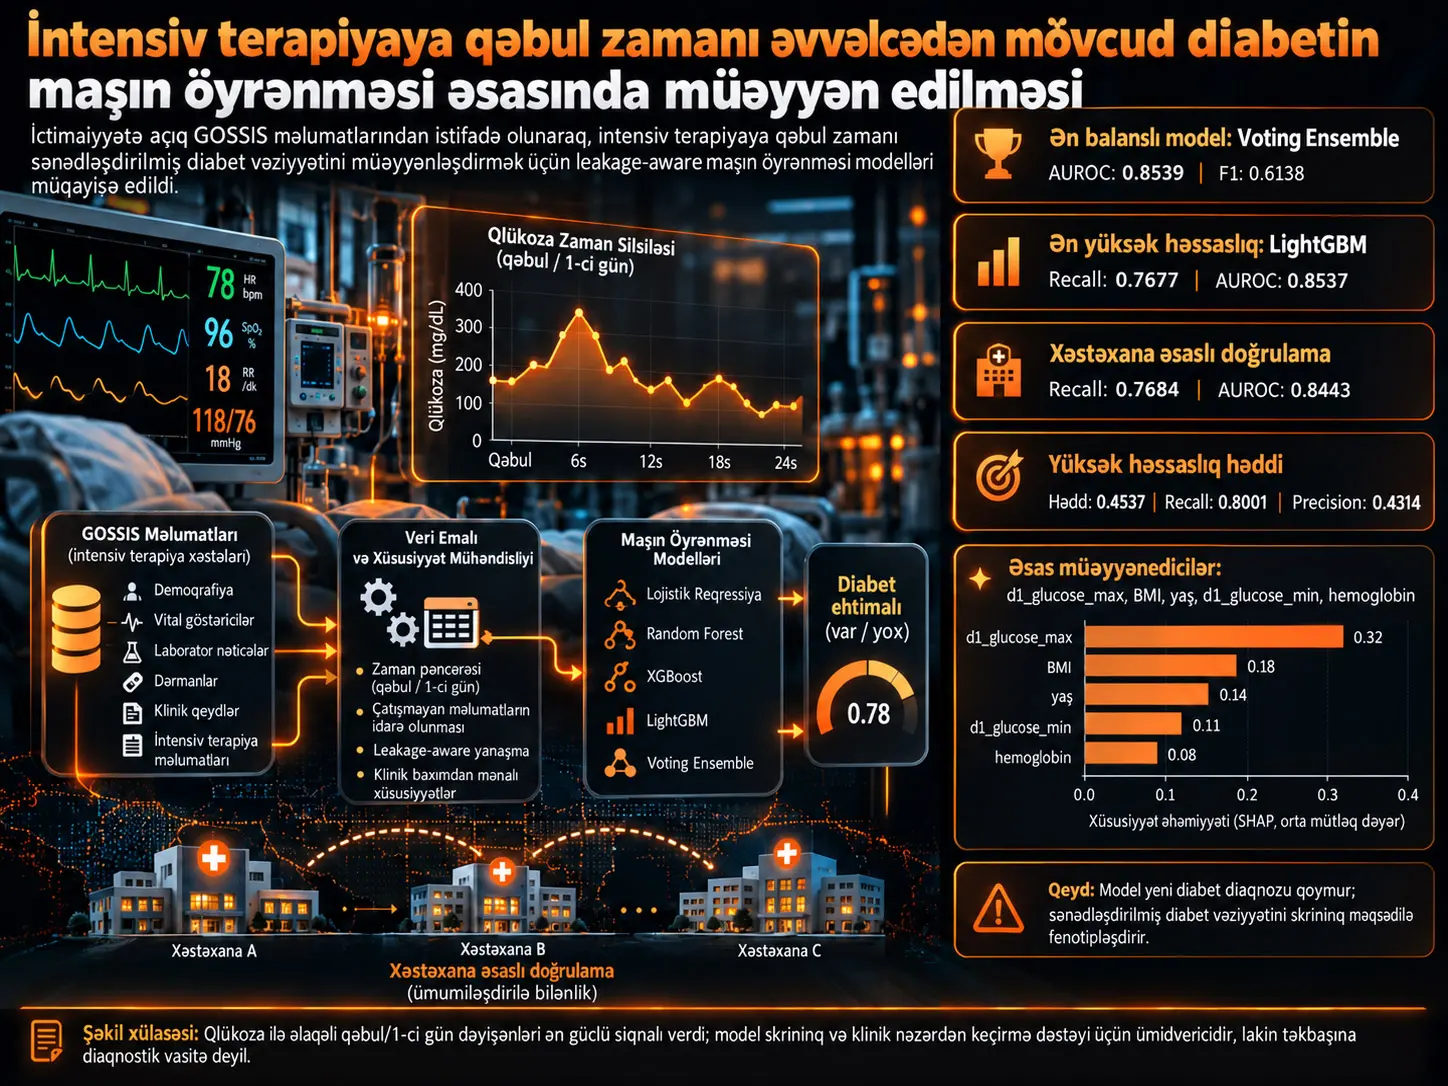
Hesablana bilən diabet fenotipləşdirilməsi (computable diabetes phenotyping), elektron sağlamlıq qeydlərindəki strukturlaşdırılmış dəyişənlərdən istifadə etməklə şəxsin mənbə qeydlərində müəyyən klinik fenotipə malik olma ehtimalını alqoritmik şəkildə müəyyənləşdirməyə çalışan təsnifat yanaşmasıdır. Bu tədqiqat ictimaiyyətə açıq WiDS Datathon 2021/GOSSIS kritik qayğı məlumatlarından istifadə edərək intensiv terapiyaya qəbul zamanı qeydlərdə əvvəlcədən sənədləşdirilmiş diabet vəziyyətini müəyyən etmək üçün leakage-aware maşın öyrənməsi modellərini müqayisə etmişdir. Əsas analizdə 125.139 yaş ≥16 ICU qeydi istifadə edilmiş; CatBoost, Random Forest, XGBoost, LightGBM, Histogram-based Gradient Boosting və üç boosting modelini birləşdirən soft-voting ensemble qiymətləndirilmişdir. Leakage-mitigated random doğrulamada voting ensemble AUROC 0,8539, precision 0,5671, recall 0,6690 və F1 0,6138 ilə ən balanslı ümumi profili göstərmiş, tuned LightGBM isə recall 0,7677 ilə həssaslıq yönümlü ən yüksək model olmuşdur.
Tədqiqatın ən kritik tapıntısı model uğurunun açıq site və ya APACHE dəyişənlərindən daha çox erkən qlükoza siqnalından asılı olmasıdır. APACHE dəyişənləri çıxarıldıqda performans yalnız məhdud dərəcədə azalarkən, qlükozaya bənzər dəyişənlərin də çıxarıldığı strict reduced ssenarisində LightGBM AUROC 0,7432-yə və voting ensemble AUROC 0,7448-ə düşmüşdür. SHAP analizi də d1_glucose_max və d1_glucose_min dəyişənlərinin üstünlüyünü göstərmişdir. Bununla belə, intensiv terapiyanın ilk günündəki qlükoza ölçmələri yalnız xroniki diabeti deyil, kəskin stress fiziologiyasını, dərman və ya müalicə təsirlərini, qidalanma dəstəyini və ölçmə intensivliyini də əks etdirə bilər.
Xəstəxanaların training və validation arasında tam ayrıldığı grouped-site validation-da LightGBM recall 0,7684 səviyyəsində qorunmuş, lakin AUROC 0,8443-ə və precision 0,4546-ya düşmüşdür. 0,4537 hədd dəyərində recall 0,8001-ə qaldırıla bilmiş, lakin precision 0,4314 olmuşdur. Kalibrasiya nəticələri də proqnozlaşdırılan ehtimalların klinik mütləq risk kimi istifadə ediləcək qədər etibarlı olmadığını göstərmişdir. Buna görə sistem müstəqil diabet diaqnozu qoyan alət deyil; chart review, medication reconciliation, cohort enrichment və ya tədqiqat təsnifatı üçün yüksək həssaslıqlı fenotipləşdirmə/skrininq köməkçisi kimi şərh edilməlidir.
Tədqiqat problemi
İntensiv terapiyaya qəbul zamanı pasiyentin diabet tarixçəsinin düzgün bilinməsi erkən hiperqlikemiyanın necə şərh ediləcəyinə təsir göstərə bilər. Bununla belə, diabet məlumatı problem siyahısı, diaqnoz kodları, əvvəlki müraciətlər, dərman qeydləri, laboratoriya arxivləri və ya müəssisələrarası transfer sənədləri kimi müxtəlif elektron sağlamlıq qeydi mənbələrinə səpələnmiş ola bilər. Bu qeydlərin bir hissəsi qəbul anında əlçatan olmaya bilər.
Bu problem xüsusilə intensiv terapiyada vacibdir, çünki eyni yüksək qlükoza dəyəri müxtəlif səbəblərdən yarana bilər. Əvvəldən məlum olan diabet, daha əvvəl tanınmamış xroniki disqlisemiya, kəskin stress hiperqlikemiyası, qlükokortikoid və ya digər dərman təsirləri, enteral/parenteral qidalanma, dekstroza tərkibli mayelər və erkən müalicə müdaxilələri bir-birinə bənzər qlikemik görünüşlər yarada bilər.
Buna görə tədqiqat sualı “pasiyent həqiqətən diabetlidirmi?” formasında yeni klinik diaqnoz qoymaq deyil. Sual intensiv terapiyaya qəbula yaxın vaxtda mövcud strukturlaşdırılmış məlumatlardan istifadə etməklə mənbə verilənlər bazasında əvvəlcədən sənədləşdirilmiş diabet vəziyyətinin nə dərəcədə etibarlı şəkildə fenotipləşdirilə bilməsidir.
Bu Model Həqiqətən Diabet Diaqnozu Qoyurmu?
Xeyr. Tədqiqatın hədəf etiketi mənbə qeydlərində intensiv terapiyaya qəbuldan əvvəl və ya qəbul zamanı artıq sənədləşdirilmiş diabet vəziyyətidir; model yeni diabet diaqnozu qoymaq, stress hiperqlikemiyasını aşkarlamaq və ya gələcəkdə yaranacaq diabeti proqnozlaşdırmaq üçün öyrədilməmişdir və mənbə müəllifi sistemi müstəqil diaqnostik alət deyil, fenotipləşdirmə və skrininq köməkçisi kimi məhdudlaşdırır.
Computable phenotyping yanaşmasının rolu
Computable phenotyping klinik vəziyyəti strukturlaşdırılmış EHR dəyişənləri üzərindən yenidən müəyyən edən alqoritmik yanaşma kimi düşünülə bilər. Bu cür sistemlərdə performans yalnız AUROC ilə qiymətləndirilməməlidir. Eyni dərəcədə vacib suallar istifadə olunan dəyişənlərin etiketə sızıb-sızmaması, preprocessing-in yalnız training məlumatından öyrənilib-öyrənilməməsi, müxtəlif xəstəxanalarda performansın qorunub-qorunmaması, sinif balanssızlığının necə idarə edilməsi və proqnoz ehtimallarının kalibrə olunub-olunmamasıdır.
Məlumat mənbəyi
| Komponent | Qeyd | Xüsusiyyət | Tədqiqatda istifadəsi |
|---|---|---|---|
| Etiketli WiDS 2021 faylı | 130.157 ICU stay | 181 | Modelin hazırlanması və doğrulama mənbəyi |
| Yaş ≥16 analitik kohort | 125.139 ICU stay | Preprocessing-dən sonra ssenaridən asılı | Əsas modelləşdirmə kohortu |
| Etiketsiz challenge faylı | 10.234 qeyd | 180 | Validation metrikası, preprocessing öyrənilməsi və ya hədd seçimi üçün istifadə edilmədi |
Dörd xüsusiyyət ssenarisi
| Ssenari | Əsas qayda |
|---|---|
| Full feature set | Rutin təmizləmə tətbiq olunur; grouping identifier-lar model matrisindən çıxarılır. |
| Leakage-mitigated original | Etiketə birbaşa və ya dolayı olaraq çox yaxın ola bilən APACHE diagnosis sahələri və seçilmiş xroniki komorbidlik göstəriciləri çıxarılır; digər klinik admission/day-1 dəyişənləri qorunur. |
| Exclude all APACHE | Leakage-mitigated çıxarışlara əlavə olaraq bütün APACHE ilə əlaqəli dəyişənlər silinir. |
| Strict reduced model | APACHE, site identifier və qlükozaya bənzər dəyişənlər də çıxarılır. |
Split-aware preprocessing nə üçün vacib idi?
Tədqiqatda məlumatların preprocessing qaydaları validation məlumatından informasiya sızdırmayacaq şəkildə yalnız training split üzərində öyrənilmişdir. Etiketsiz challenge faylı da imputer, kateqorik səviyyə, engineered feature və ya correlation-pruning qərarı yaratmaq üçün istifadə edilməmişdir.
Əsas random split:
\[ (X_{\mathrm{train}},X_{\mathrm{val}},y_{\mathrm{train}},y_{\mathrm{val}}) = \mathrm{StratifiedSplit}(X,y;\mathrm{test\_size}=0.20,\mathrm{stratify}=y,\mathrm{seed}=40) \]
Bu tənlik bütün yetkin qeydləri diabetes_mellitus etiket paylanmasını qoruyaraq %80 training və %20 validation olaraq ayırır. Daha sonra preprocessing parametrləri yalnız training hissəsindən hesablanır:
\[ \Theta=\mathrm{fit}_{\mathrm{train}}(\mathrm{preprocessing}), \qquad X_{\mathrm{val}}^{*}=\mathrm{transform}_{\Theta}(X_{\mathrm{val}}) \]
Bu ardıcıllıq validation məlumatındakı paylanma xüsusiyyətlərinin training zamanı modelə dolayı yolla daşınmasını azaltmağı məqsəd qoyur.
Sətir və sxem səviyyəsində təmizləmə
- Yaş <16 qeydləri çıxarıldı.
- hospital_admit_source və icu_admit_source kateqoriyaları harmonizasiya edildi.
- Bir _min dəyişəni müvafiq _max dəyərindən böyükdürsə, iki dəyərin yeri dəyişdirildi.
- Çatışmayan d1_pao2fio2ratio_max üçün uyğun olduqda pao2_apache/fio2_apache nisbəti hesablandı.
- Bütün h1_ dəyişənləri çıxarıldı.
- Day-1 ekvivalenti olan bəzi near-duplicate APACHE sahələri silindi.
- encounter_id, readmission_status və indeks sütunu modeldən çıxarıldı.
- hospital_id və icu_id yalnız grouped validation üçün ayrıca saxlanıldı; heç bir feature ssenarisində model girişi edilmədi.
Çatışmayan dəyərlərin idarə edilməsi
Davamlı dəyişənlər training-set ortalaması, kateqorik dəyişənlər isə training-set modu ilə dolduruldu. Boy, çəki və BMI üçün əvvəlcə cinsə xas training-set ortalamasından istifadə edildi; bu dəyər yoxdursa ümumi training ortalamasına qayıdıldı. Kateqorik dəyişənlər yalnız training hissəsində müşahidə olunan kateqoriyalardan istifadə etməklə one-hot encode edildi.
Training design matrix üzərində mütləq Pearson korrelyasiyası 0,80-i aşan yuxarı üçbucaqlı feature cütlərində ikinci feature çıxarıldı:
\[ C_{\mathrm{drop}} = \{b:\exists a<b,\ |r_{ab}|>0.80\} \]
Eyni sütun çıxarışları validation və challenge matrislərinə də eynilə tətbiq edildi.
Müqayisə edilən modellər
| Model | Rol | Mənbədə verilən əsas konfiqurasiya |
|---|---|---|
| CatBoost | Boosting baseline | 100 boosting iteration; random seed 40 |
| Random Forest | Bagging baseline | 100 ağac; random_state=40; paralel emal |
| Tuned XGBoost | Tuned gradient boosting | 200 estimator; max_depth=8; learning_rate=0,05; subsample=0,8; min_child_weight=10; colsample_bytree=0,8 |
| Tuned LightGBM | Həssaslıq yönümlü boosting | learning_rate=0,007; colsample_bytree=0,2; reg_alpha=3; reg_lambda=1; scale_pos_weight=4; n_estimators=10.000; random_state=100 |
| HistGradientBoosting | Əlavə boosting müqayisəçisi | scikit-learn histogram-based gradient boosting; random_state=40 |
| Soft-voting ensemble | Birləşdirilmiş probability modeli | XGBoost : LightGBM : HGB = 1 : 3 : 1 |
Sinif balanssızlığı necə idarə edildi?
Tədqiqat sintetik minority nümunələri yaratmaq üçün SMOTE istifadə etmək əvəzinə modeldaxili sinif çəkiləndirməsinə üstünlük vermişdir. LightGBM-də diabetes-positive sinfi üçün scale_pos_weight=4 istifadə edilmişdir. Bu seçim real məlumat paylanmasını dəyişmədən pozitiv halların yanlış təsnif edilməsinin training loss daxilindəki xərcini artırır.
Konseptual çəkili itki:
\[ L=\sum_{i=1}^{n}w_{y_i}\ell(y_i,p_i)+\Omega(F) \]
Burada \(w_{y_i}\) sinif çəkisini, \(\ell(y_i,p_i)\) ikili təsnifat itkisini və \(\Omega(F)\) model mürəkkəbliyinə tətbiq olunan regularization terminini təmsil edir.
Soft-voting ensemble necə yaradıldı?
XGBoost, LightGBM və HGB probability proqnozları LightGBM-ə üçqat çəki veriləcək şəkildə birləşdirildi:
\[ p_i^{(\mathrm{ens})} = \frac{ p_i^{(\mathrm{XGB})} + 3p_i^{(\mathrm{LGBM})} + p_i^{(\mathrm{HGB})} }{5} \]
Məqsəd LightGBM-in yüksək həssaslıq üstünlüyünü qoruyarkən XGBoost və HGB-nin daha konservativ ehtimal proqnozları ilə false-positive yükünü tarazlaşdırmaqdır.
Təsnifat həddi
Hər model əvvəlcə diabet-pozitiv sinfi üçün ehtimal proqnozu yaratmışdır:
\[ p_i^{(m)} = \Pr(y_i=1\mid x_i^{*},M_m) \]
Əsas müqayisədə standart hədd \(t=0,50\) istifadə edilmişdir:
\[ \hat{y}_i^{(m)}(t) = I\left(p_i^{(m)}\geq t\right) \]
Precision–recall analizində isə hədd dəyişdirilərək müxtəlif recall–precision balansları ayrıca araşdırılmışdır.
Performans metriklərinin rolu
Accuracy ümumi düzgün təsnifat nisbətini, precision pozitiv proqnozlaşdırılmış halların nə qədərinin həqiqətən pozitiv olduğunu, recall mənbə etiketində pozitiv olan halların nə qədərinin aşkarlandığını, F1 isə precision ilə recall-un harmonik ortasını ölçür.
Brier skoru probability dəqiqliyini ölçən və aşağı olması arzu edilən metrikdir:
\[ \mathrm{Brier} = \frac{1}{n_V} \sum_{i\in V} (p_i-y_i)^2 \]
AUROC isə sabit həddən asılı olmayan sıralama ayrışdırmasını təmsil edir. Model yüksək AUROC-a malik olsa belə zəif kalibrə oluna bildiyi üçün mənbə AUROC ilə calibration/Brier göstəricilərini ayrıca qiymətləndirmişdir.
Xəstəxana Əsaslı Qruplaşdırılmış Doğrulama Nə Üçün Vacibdir?
Grouped-site validation eyni xəstəxanaya aid heç bir qeydin həm training, həm də validation hissəsində olmasına imkan vermədiyi üçün modelin müəyyən müəssisələrə xas kodlaşdırma, laboratoriya sifarişi, pasiyent profili və ya sənədləşdirmə nümunələrini əzbərləməsindən yarana bilən nikbin performans qiymətləndirməsini azaldır; lakin bu dizayn hələ də eyni WiDS/GOSSIS məlumat versiyası daxilində aparılan internal validation-dır və müstəqil external validation deyil.
Riyazi ayrım:
\[ G_{\mathrm{train}}\cap G_{\mathrm{val}}=\varnothing \]
| Doğrulama | Training qeydi | Validation qeydi | Xəstəxana strukturu |
|---|---|---|---|
| Random stratified | 100.111 | 25.028 | Eyni xəstəxanalar hər iki hissədə ola bilər |
| Grouped site | 95.233 | 29.906 | 163 training və 41 validation xəstəxanası; üst-üstə düşmə yoxdur |
Tədqiqatın Metodu və Nəticələri
Əsas model müqayisəsi
| Model | Accuracy | Precision | Recall | F1 | AUROC | Brier |
|---|---|---|---|---|---|---|
| Voting Ensemble | 0,8151 | 0,5671 | 0,6690 | 0,6138 | 0,8539 | 0,1300 |
| LightGBM (Tuned) | 0,7815 | 0,5017 | 0,7677 | 0,6069 | 0,8537 | 0,1508 |
| XGBoost (Tuned) | 0,8288 | 0,6557 | 0,4642 | 0,5436 | 0,8505 | 0,1197 |
| HistGradientBoosting | 0,8251 | 0,6445 | 0,4543 | 0,5330 | 0,8458 | 0,1214 |
| CatBoost | 0,8227 | 0,6317 | 0,4629 | 0,5343 | 0,8403 | 0,1236 |
| Random Forest | 0,8154 | 0,6645 | 0,3225 | 0,4342 | 0,8252 | 0,1286 |
Bu cədvəl tək bir “ən yaxşı model” əvəzinə müxtəlif istifadə məqsədləri üçün fərqli əməliyyat profillərinin olduğunu göstərir. Voting ensemble F1 və AUROC baxımından ən balanslı nəticələri vermişdir. LightGBM pozitiv halları ən çox aşkarlayan modeldir; lakin daha çox false positive yaratmışdır. XGBoost isə daha aşağı recall müqabilində ən aşağı Brier skorunu vermişdir.
Figure 1–6: Confusion matrix və feature importance
Mənbədə Figure 1–6 hər bir əsas model üçün confusion matrix ilə top-15 feature importance qrafikini uyğunlaşdırır. CatBoost 18.046 true negative, 1.484 false positive, 2.953 false negative və 2.545 true positive yaratmışdır. Random Forest false positive sayını yalnız 895-ə endirmiş, lakin 3.725 diabet-pozitiv halı qaçırmışdır.
Tuned XGBoost 2.552 true positive və 1.340 false positive yaradarkən LightGBM 4.221 true positive-yə çatmış; bunun müqabilində 4.192 false positive yaratmışdır. HGB 2.498 true positive, 1.378 false positive yaratmışdır. Voting ensemble 3.678 true positive və 2.808 false positive ilə LightGBM və daha konservativ modellər arasında orta əməliyyat profili formalaşdırmışdır.
Bütün model ailələrində d1_glucose_max güclü və ya dominant feature kimi önə çıxmışdır. d1_glucose_min, BMI, yaş, kreatinin, pre-ICU length of stay, hemoqlobin və digər fizioloji/laboratoriya xülasələri müxtəlif modellərdə təkrar-təkrar yüksək əhəmiyyətli dəyişənlər olmuşdur.
Qlükozaya Bənzər Dəyişənlər Çıxarıldıqda Performans Necə Dəyişdi?
Qlükozaya bənzər dəyişənlər APACHE və leakage-prone sahələrlə birlikdə çıxarıldıqda modelin ayrışdırma qabiliyyəti nəzərəçarpacaq dərəcədə çökmüşdür: LightGBM AUROC 0,8537-dən 0,7432-yə, voting ensemble AUROC 0,8539-dan 0,7448-ə düşmüşdür; bunun əksinə yalnız leakage-prone və ya bütün APACHE dəyişənlərinin çıxarılması daha kiçik itkilər yaratmışdır, buna görə admission/day-1 qlikemik dəyişənləri modelin əsas predictive siqnalıdır.
| Ssenari | LightGBM AUROC | LightGBM Recall | LightGBM Brier | Ensemble AUROC | Ensemble F1 |
|---|---|---|---|---|---|
| Full feature set | 0,8565 | 0,7672 | 0,1491 | 0,8566 | 0,6159 |
| Leakage-mitigated original | 0,8537 | 0,7677 | 0,1508 | 0,8539 | 0,6138 |
| Exclude all APACHE | 0,8508 | 0,7634 | 0,1529 | 0,8514 | 0,6077 |
| Strict reduced model | 0,7432 | 0,6641 | 0,1986 | 0,7448 | 0,4493 |
Bu ablasiya qlükoza dəyişənlərinin “xroniki diabeti saf şəkildə ölçdüyünü” sübut etmir. Əksinə, modelin güclü siqnalının mühüm hissəsinin erkən qlikemik ölçmələrə əsaslandığını göstərdiyi üçün klinik şərhdə daha çox ehtiyat tələb edir.
Xəstəxana əsaslı doğrulama nəticələri
| Doğrulama | Accuracy | Precision | Recall | F1 | AUROC | Brier |
|---|---|---|---|---|---|---|
| Random stratified | 0,7815 | 0,5017 | 0,7677 | 0,6069 | 0,8537 | 0,1508 |
| Grouped site | 0,7727 | 0,4546 | 0,7684 | 0,5712 | 0,8443 | 0,1596 |
Grouped-site confusion matrix 18.581 true negative, 5.432 false positive, 1.365 false negative və 4.528 true positive ehtiva edir. Recall-un demək olar dəyişmədən qalması modelin müxtəlif xəstəxanalarda pozitiv qeydləri aşkarlamağa davam etdiyini; precision və Brier göstəricilərindəki pisləşmə isə bunun daha böyük yanlış-pozitiv və probability reliability xərci ilə baş verdiyini göstərir.
Precision–recall və yüksək həssaslıq həddi
Class imbalance səbəbilə ROC analizinə əlavə olaraq precision–recall əyrilərindən istifadə edilmişdir. Random validation average precision 0,622, grouped-site average precision 0,551-dir.
Mənbə yüksək həssaslıq hədəfini:
\[ t_r= \max\{t:\mathrm{Recall}(t)\geq0.80\} \]
kimi müəyyən etmişdir. Grouped-site məlumatında bu şərti ödəyən hesabatlı hədd 0,4537-dir; bu nöqtədə recall 0,8001 və precision 0,4314-dür.
Bu nəticə “daha yüksək recall pulsuz deyil” prinsipini birbaşa göstərir. Qaçırılan pozitivləri azaltmaq üçün hədd aşağı salındıqda, pozitiv kimi işarələnən, lakin mənbə etiketi neqativ olan pasiyentlərin sayı artır.
Modelin Yüksək AUROC Dəyəri Ehtimalların Yaxşı Kalibrə Olunduğunu Göstərirmi?
Xeyr. LightGBM AUROC baxımından güclü ayrışdırma təmin etsə də, random və grouped-site kalibrasiya əyriləri proqnoz ehtimallarının xüsusilə orta-yüksək risk diapazonlarında müşahidə olunan diabet tezliyini aşmağa meylli olduğunu, Brier skorlarının da grouped validation altında pisləşdiyini göstərmişdir; buna görə xam model ehtimalları yenidən kalibrasiya aparılmadan klinik mütləq risk ehtimalı kimi şərh edilməməlidir.
Kalibrasiya məntiqi
Mükəmməl kalibrə edilmiş model üçün proqnoz ehtimalı \(p\) olan pasiyent qrupunda real pozitivlik nisbətinin də \(p\) olması gözlənilir:
\[ E[y_i\mid p_i=p]=p \]
Mənbə kalibrasiya əyrisini 10 bərabər ehtimal intervalı ilə yaratmış və post hoc recalibration tətbiq etməmişdir. Figure 10-da iki validation dizaynındakı əyri ideal diaqonalın mühüm hissəsində aşağıda qalmışdır; bu, probability overestimation ilə uyğundur.
| Validation | Brier | Kalibrasiya şərhi |
|---|---|---|
| Random stratified | 0,1508 | Probability overestimation müşahidə olunur |
| Grouped site | 0,1596 | Probability reliability bir qədər daha pisdir |
SHAP nə üçün grouped-site modelində hesablandı?
SHAP analizinin grouped-site LightGBM üzərində aparılması izahın eyni xəstəxanaların iki fold-da olduğu daha asan random split əvəzinə daha sərt xəstəxana-ayrılmış model davranışına bağlanmasını təmin etmişdir. Grouped validation nümunə sayı 3.000-i aşarsa, SHAP hesablaması təkrar istehsal oluna bilməsi üçün sabit seed ilə ən çox 3.000 qeydə nümunələnmişdir.
SHAP-ın additive izah forması:
\[ F_G(x_i^{*}) = \phi_0+\sum_{j=1}^{p}\phi_{ij} \]
Burada \(\phi_0\) modelin başlanğıc/baseline çıxışını, \(\phi_{ij}\) isə pasiyent \(i\) üçün feature \(j\)-nin model çıxışını yuxarı və ya aşağı itələyən töhfəsini təmsil edir.
Qlobal SHAP nəticələri
| Dəyişən | Mənbədə müşahidə edilən əsas davranış |
|---|---|
| d1_glucose_max | Açıq fərqlə ən yüksək mean absolute SHAP; yüksək dəyərlər adətən diabetes-positive istiqamətində töhfə verir |
| BMI | Yüksək dəyərlər adətən pozitiv töhfə verir; high-20s ətrafında neqativdən pozitivə keçid və yuxarı həddə qismən plato |
| Age | Gənc yaşlarda neqativ; orta və irəli yaşlarda daha pozitiv; ən irəli yaşlarda plato/yüngül geriləmə |
| d1_glucose_min | Tərs və qeyri-xətti nümunə; aşağı minima pozitiv istiqamətdə töhfə verə bilər |
| d1_hemoglobin_max | Aşağı-orta dəyərlərdə pozitiv töhfə, yüksək dəyərlərdə tədricən neqativ istiqamət |
| urineoutput_apache | Daha kiçik və səpələnmiş SHAP böyüklükləri; ikincil kontekstual feature |
d1_glucose_max dependence qrafiki
Figure 12-yə görə d1_glucose_max-ın SHAP töhfəsi təxminən 100–250 mg/dL arasında nəzərəçarpacaq dərəcədə yüksəlmiş və çox yüksək dəyərlərdə plato yaratmışdır. Bu nümunə model davranışının məhdudiyyətsiz xətti artımdan daha çox non-linear saturation ehtiva etdiyini göstərir.
Yerli SHAP waterfall izahları
Figure 14–15 true positive, false positive, true negative və false negative qruplarından seçilmiş təmsilçi halları izah edir. Pozitiv skor alan nümunələrdə yüksək d1_glucose_max çox vaxt ən böyük yuxarıyönlü töhfədir; neqativ skorlu nümunələrdə daha aşağı və ya daha az ekstremal maksimum qlükoza dəyəri güclü aşağıyönlü töhfə verə bilər.
Bununla belə, fərdi proqnozlar tək feature-dan ibarət deyil. BMI, yaş, hemoqlobin, renal kontekst, d1_glucose_min və pre-ICU xüsusiyyətləri güclü qlikemik siqnalı artıra və ya azalda bilər.
Tədqiqatın dəstəklədiyi nəticələr
- Public WiDS/GOSSIS structured EHR məlumatı qeydlərdə sənədləşdirilmiş diabet vəziyyətinin admission-time fenotipləşdirilməsində istifadə oluna bilər.
- Gradient-boosted və ensemble tree modelləri mənbə doğrulama dizaynlarında güclü ayrışdırma göstərmişdir.
- Voting ensemble ən balanslı F1/AUROC profilini yaratmışdır.
- LightGBM ən yüksək recall yönümlü tək modeldir.
- Reasonable leakage mitigation və bütün APACHE dəyişənlərinin çıxarılması performansı yalnız məhdud dərəcədə azaltmışdır.
- Qlükozaya bənzər feature-ların çıxarılması ayrışdırmanı nəzərəçarpacaq dərəcədə azaltmışdır.
- Grouped-site validation-da recall qorunarkən precision və calibration pisləşmişdir.
- SHAP analizləri dominant glycemic signal ilə daha kiçik kontekstual klinik töhfələri göstərir.
Tədqiqatın dəstəkləmədiyi nəticələr
- Model yeni diabet diaqnozu qoyduğunu sübut etmir.
- Model xroniki diabet ilə stress hyperglycemia-nı qəti şəkildə ayırmır.
- 0,8539 AUROC klinik deployment üçün təkbaşına kifayət deyil.
- Grouped-site validation müstəqil xarici məlumat üzərində external validation deyil.
- 0,4537 həddi bütün klinik iş axınları üçün universal optimal hədd deyil.
- SHAP töhfələri bioloji səbəblilik demək deyil.
- Model ehtimalları recalibration olmadan klinik mütləq risk ehtimalı kimi istifadə edilməməlidir.
- Tədqiqat avtomatik müalicə qərarı, insulin dozası və ya klinik alarm sistemini doğrulamamışdır.
Əsas məhdudiyyətlər
Birinci məhdudiyyət istinad etiketidir. “Diabetes mellitus” etiketi mənbə verilənlər bazasındakı sənədləşdirilmiş diabet məlumatıdır; HbA1c, longitudinal outpatient records, dərman tarixçəsi və manual chart review ilə yenidən adjudike edilmiş gold-standard xroniki diabet etiketi deyil.
İkinci məhdudiyyət validation əhatəsidir. Xəstəxana əsaslı ayırma random split-dən daha sərt olsa da, training və validation qeydləri eyni ictimai məlumat ekosisteminin hissəsidir. Müstəqil ICU məlumat dəstlərində external validation aparılmamışdır.
Üçüncü məhdudiyyət qlikemik siqnalın spesifikliyidir. Early ICU glucose dəyərləri həm xroniki metabolik xəstəliyi, həm də kəskin stressi, müalicəni və monitorinq prosesini əks etdirə bilər.
Dördüncü məhdudiyyət calibration-dır. Mənbə model proqnozlarını yenidən kalibrə etməmişdir; calibration analizi yalnız problemi diaqnostika etmişdir.
Gələcək tədqiqat istiqamətləri
Mənbə müstəqil ICU verilənlər bazalarında external validation, müxtəlif xəstəxana və zaman dövrlərində prospektiv qiymətləndirmə, istifadə məqsədinə xüsusi hədd seçimi və lazım gəldikdə post hoc recalibration tövsiyə edir.
Daha güclü istinad etiketləri üçün longitudinal EHR, HbA1c, outpatient dərman tarixçəsi, problem siyahıları, diaqnoz kodları və uyğun olduqda manual adjudication birlikdə qiymətləndirilə bilər. Beləliklə əvvəlcədən məlum olan xroniki diabet; daha əvvəl tanınmamış diabet, stress hyperglycemia, medication-related hyperglycemia, nutrition-associated dysglycemia və treatment-related glucose dəyişikliklərindən daha aydın şəkildə ayrıla bilər.
Mənbə həmçinin eyni validation, calibration, ablation və interpretability çərçivəsi altında TabNet, TabTransformer, FT-Transformer və ya digər deep tabular/Transformer əsaslı modellərin gələcəkdə müqayisə oluna biləcəyini bildirir.
Mənbə və Metod Qeydi
Orijinal tədqiqat: Identifying Pre-Existing Diabetes at ICU Admission with Machine Learning on Public GOSSIS Data
Müəllif: Lily Popova Zhuhadar.
Müəllif sayı: 1; mənbə məqalə sole-author tədqiqatıdır.
Qurum: Department of Analytics & Information Systems, Center for Applied Data Analytics, Western Kentucky University, Bowling Green, Kentucky, USA.
Məsul müəllif: Lily Popova Zhuhadar.
Jurnal: Diabetology.
Nəşriyyat: MDPI, Basel, Switzerland.
Cild / nömrə / məqalə: 7(5), 100.
DOI: 10.3390/diabetology7050100.
Received: 26 Mart 2026.
Revised: 19 May 2026.
Accepted: 19 May 2026.
Published: 21 May 2026.
Academic Editor: Peter Clifton.
Mənbə növü: Resenziyalı Original Article; retrospektiv maşın öyrənməsi benchmark/fenotipləşdirmə tədqiqatı.
Lisenziya: Creative Commons Attribution (CC BY).
Məlumat mənbəyi: WiDS Datathon 2021 tabular release; GOSSIS initiative və eICU Collaborative Research Database törəməsi.
Başlanğıc etiketli məlumat: 130.157 ICU stay, 181 feature.
Etiketsiz challenge faylı: 10.234 qeyd, 180 feature; preprocessing öyrənilməsi, hədd seçimi və validation performansı üçün istifadə edilmədi.
Yekun yaş ≥16 analitik kohort: 125.139 ICU stay.
Əsas random split: 100.111 training / 25.028 validation; stratified 80/20; random seed 40.
Grouped-site split: 95.233 training / 29.906 validation; 163 training xəstəxanası / 41 validation xəstəxanası; xəstəxana üst-üstə düşməsi yoxdur.
Hədəf etiket: Mənbə qeydlərində admission-dan əvvəl və ya onun zamanı sənədləşdirilmiş pre-existing diabetes mellitus.
Modellər: CatBoost, Random Forest, tuned XGBoost, tuned LightGBM, HistGradientBoosting və soft-voting ensemble.
Class imbalance yanaşması: Model-intrinsic class weighting və threshold-aware evaluation; sintetik oversampling istifadə edilmədi.
Soft-voting çəkiləri: XGBoost : LightGBM : HGB = 1 : 3 : 1.
Qiymətləndirmə metrikləri: Accuracy, precision, recall, F1-score, AUROC, Brier score və average precision.
Calibration: 10 uniform probability bin; post hoc recalibration tətbiq edilmədi.
Interpretability: SHAP / TreeExplainer; grouped-site LightGBM; lazım gəldikdə ən çox 3.000 grouped-validation qeydi.
Ablasiya: Full feature set, leakage-mitigated original, exclude all APACHE və strict reduced model.
Əsas nəticə: Voting ensemble leakage-mitigated random split-də AUROC 0,8539 və F1 0,6138 ilə ən balanslı ümumi profil; tuned LightGBM recall 0,7677 ilə ən həssas tək model.
Grouped-site əsas nəticə: LightGBM recall 0,7684, AUROC 0,8443, precision 0,4546 və Brier 0,1596.
Yüksək həssaslıqlı grouped hədd: t=0,4537; recall 0,8001; precision 0,4314.
Dominant model siqnalı: d1_glucose_max və digər qlükoza ilə əlaqəli day-1 dəyişənləri.
Maliyyələşdirmə: Xarici maliyyələşdirmə yoxdur.
Etik komitə: Not applicable; de-identified public ICU data istifadə edilmişdir.
Məlumatlandırılmış razılıq: Not applicable.
Məlumatların əlçatanlığı: WiDS Datathon 2021 tabular dataset-in Kaggle üzərindən ictimaiyyətə açıq olduğu bildirilmişdir.
Kod/analitik material: Müəllif nəticələrin təkrar istehsalına yönəlmiş Google Colab mənbəyi bildirmişdir; mənbədə giriş tarixi 12 Mart 2026-dır.
Maraqların toqquşması: Müəllif maraqların toqquşmasını bildirməmişdir.
Əsas klinik sərhəd: Model qeydlərdə sənədləşdirilmiş diabet fenotipini təsnif edir; adjudike xroniki diabet diaqnozu, stress hyperglycemia ayrımı və ya müalicə qərarı yaratmır.
Əsas deployment sərhədi: External validation, recalibration, workflow-specific thresholding və confirmatory clinical review aparılmadan müstəqil diaqnostika və ya müalicə qərarı aləti kimi istifadə edilməməlidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib