


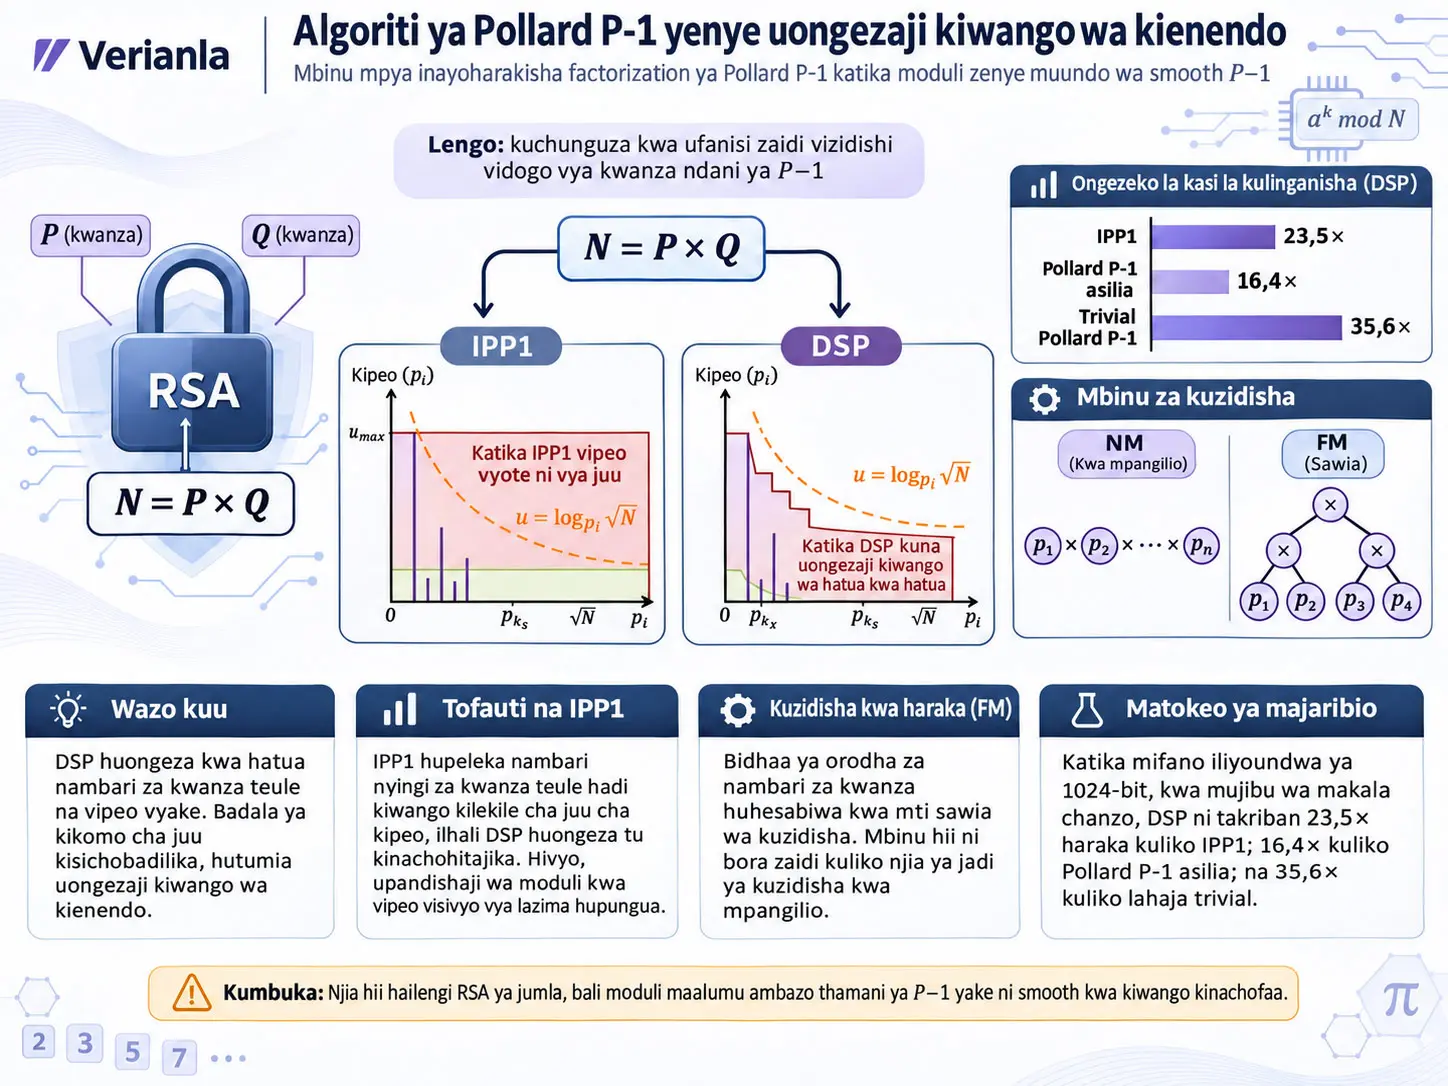
Dynamic Scaling Pollard’s P-1 Algorithm (DSP), ni lahaja ya algoriti inayopanga upya mbinu maalum ya Pollard P-1 ya uchanganuzi wa nambari kamili katika vipengele, ili wagombea wa nambari tasa na vipeo vinavyohitajika waongezwe hatua kwa hatua. Utafiti unalenga hasa hali ambazo kwa kigawe tasa \(N=PQ\) ndani ya moduli ya RSA \(P\), \(P-1\) imeundwa na vigawe tasa vidogo. Lengo kuu la DSP ni kupunguza uteuzi wa smoothness-bound usiobadilika na ukokotoaji usiohitajika wa vipeo vikubwa unaotokea katika mbinu za kawaida za Pollard P-1 na IPP1. Utafiti pia unatengeneza mbinu ya Fast Multiplication (FM) ili kukokotoa zao la orodha kubwa za nambari tasa kwa gharama ndogo zaidi.
Sifa bainifu ya DSP ni kwamba badala ya kukusanya wagombea wa nambari tasa katika safu moja isiyobadilika, inawagawa kwa hatua katika vijiseti kulingana na ukubwa wao na kutumia tena katika vipeo vya baadaye matokeo ya kati yaliyopatikana awali kutoka kwa mazao ya nambari tasa ndogo. Kwa hivyo, badala ya kuinua wagombea wote wa nambari tasa hadi kiwango kilekile cha \(u_{\max}\) kama katika IPP1, nambari tasa ndogo huinuliwa hadi vipeo vya juu zaidi, huku nambari tasa kubwa zikiinuliwa tu hadi vipeo vya chini vinavyohitajika kihisabati. Mbinu hii inalenga hasa kupunguza gharama isiyohitajika ya uinuaji wa kipeo kwa moduli katika hali ambayo mmoja wa vigawe tasa vya \(P-1\) ana kipeo kikubwa lakini wengine hawahitaji kipeo hicho hicho kikubwa.
Katika ulinganisho wa kinadharia wa waandishi, chini ya masharti fulani, wakati nambari tasa kubwa zaidi inayohusika ni \(p_{\sigma_s}\ge64\), uwezekano unaounga mkono kwamba DSP ina gharama ndogo kuliko IPP1 umetolewa kuwa angalau 0,95. Thamani hii haimaanishi kwamba %95 ya funguo za RSA kwa ujumla zinaweza kuvunjwa kwa DSP; ni uwezekano wa kutokulingana maalum kwa gharama ya nadharia ya nambari katika makala.
Katika sehemu ya majaribio, ili kuhakikisha kwamba \(P-1\) inaweza kutatuliwa kwa Pollard P-1, zao la nambari kadhaa nasibu za 30-bit lilitumiwa kuunda nambari tasa za \(P\) za 512-bit, kisha \(Q\) nasibu yenye urefu uleule wa bit ikachaguliwa na moduli za 1024-bit \(N=PQ\) zikazalishwa. Katika ulinganisho kwenye mfumo wa Intel Core i5-9500 unaotumia uzi mmoja, chanzo kinaripoti DSP kuwa haraka kuliko IPP1 kwa takriban mara 23,5, haraka kuliko Pollard P-1 ya awali kwa mara 16,4, na haraka kuliko lahaja trivial kwa mara 35,6.
Mpaka muhimu zaidi wa tafsiri: DSP si algoriti ya matumizi ya jumla ya kuvunja RSA. Familia ya Pollard P-1 huwa na ufanisi tu katika hali maalum ambako kuna udhaifu unaofaa wa smoothness katika thamani ya \(P-1\) au \(Q-1\) ya mmoja wa vigawe tasa. Majaribio ya 1024-bit ya utafiti pia ni moduli za majaribio zilizoundwa mahsusi ili kubeba udhaifu huu.
Tatizo la uchanganuzi wa nambari kamili katika vipengele ni nini?
Moduli ya aina ya RSA:
ni zao la nambari tasa mbili kubwa na tofauti. Wakati \(N\) inajulikana, tatizo la kurejesha \(P\) na \(Q\) linaitwa Integer Factorization Problem (IFP), yaani tatizo la uchanganuzi wa nambari kamili katika vipengele.
Urefu wa bit wa moduli:
huonyeshwa kwa hiyo. \(n_N\) ni idadi ya bit zinazohitajika kuandika \(N\) katika uwakilishi wa binary. Katika uchanganuzi wa chanzo inadhaniwa kwamba \(P\) na \(Q\) zina takriban urefu sawa wa bit; kwa hiyo kila moja ina takriban \(n_N/2\) bit.
Fungsi ya totient ya Euler:
ni kama ilivyoonyeshwa.
Nambari B-smooth ina maana gani?
Kulingana na ufafanuzi wa utafiti wa chanzo, nambari B-smooth ni nambari kamili chanya ambayo vigawe vyake vyote vya nambari tasa ni vidogo kuliko \(B\) au sawa na \(B\).
Kwa mfano:
kwa sababu ina vigawe tasa 2 na 3 pekee, ni nambari 3-smooth. Mfano huu ni wa kufundisha ufafanuzi tu; si matokeo ya majaribio ya utafiti.
Udhaifu unaolengwa na algoriti ya Pollard P-1 ni kwamba \(P-1\) imeundwa na vigawe tasa vidogo vya aina hii.
Kwa nini Pollard P-1 inaweza kufanya kazi?
Kanuni Ndogo ya Fermat inasema kwamba ikiwa \(P\) ni nambari tasa na \(a\) ni coprime na \(P\):
huhusiano huo unashikilia.
Ikiwa kipeo kilichochaguliwa \(z\) ni kizidisho cha \(P-1\):
na hivyo:
huwa kweli.
Katika hali hii:
ukokotoaji unaweza, chini ya masharti yanayofaa:
\[ 1
kutoa kigawe tasa \(P\).
Kwa hiyo tatizo kuu la Pollard P-1 ni kuunda kipeo \(P-1\) chenye utajiri wa kutosha kujumuisha vigawe tasa vya \(z\), lakini kisichokuwa kikubwa kupita kiasi bila sababu.
Notasheni kuu ya chanzo
Kwa kuwa \(P-1\) huwa jozi kila wakati, chanzo hutenganisha kwanza sehemu yake witiri:
kama ilivyoonyeshwa.
\(\gamma\) ni mpaka wa juu wa kimataifa wa orodha ya wagombea wa nambari tasa. Seti ya wagombea:
hufafanuliwa kama ilivyoonyeshwa.
Vigawe tasa halisi ndani ya \(P_{\mathrm{div}}\):
huandikwa kwa namna hiyo.
- \(p_{\sigma_i}\): nambari tasa inayogawa \(P_{\mathrm{div}}\) kwa kweli.
- \(u_{\sigma_i}\): kipeo halisi cha nambari hiyo tasa.
- \(\sigma_1<\sigma_2<\cdots<\sigma_s\): nafasi za nambari hizi tasa katika orodha ya kimataifa ya nambari tasa.
- \(u_{\max}\): thamani ya juu zaidi kati ya vipeo halisi vya nambari tasa.
Chanzo pia hufafanua sehemu kubwa zaidi ya nguvu ya nambari tasa:
kama ilivyoonyeshwa.
Kwa kipeo cha juu kinachowezekana cha nambari tasa \(p_i\), chanzo hutumia:
kama mpaka wa juu. Sababu ni kwamba:
na kwa hiyo nguvu yoyote ya nambari tasa pia haiwezi kuzidi ukubwa huu.
DSP hugawaje wagombea wa nambari tasa?
Chanzo hugawa seti ya wagombea wa nambari tasa katika vijiseti \(k_0\) kulingana na ukubwa wao:
na:
hutumia vipindi vya namna hiyo.
Mipaka hii ya double-exponential inaweza kuonekana isiyo ya kawaida mwanzoni. Lengo ni kuakisi katika muundo wa algoriti ukweli kwamba kadiri ukubwa wa nambari tasa unavyoongezeka, idadi ya juu zaidi ya vipeo ambavyo inaweza kubeba ndani ya \(P-1\) hupungua haraka.
Je, DSP kweli haitumii Smoothness Bound yoyote?
Hapana; moja ya viingizo vya Algorithm 4 ni mpaka wa juu wa kimataifa wa orodha ya nambari tasa unaoitwa \(\gamma\). Faida ya DSP ni kwamba, tofauti na Pollard P-1 ya kawaida au IPP1, mafanikio yake hayategemei kukadiria kwa usahihi mapema mpaka mwembamba wa \(B\): \(\gamma\) inaweza kuwekwa kwenye upeo wa kinadharia na algoriti ikachanganua nafasi ya nambari tasa/kipeo kwa nguvu; ikiwa taarifa ya awali ipo, \(\gamma\) ndogo inaweza kutumika kwa madhumuni ya kuongeza kasi tu.
Thamani inayotarajiwa ya urefu wa bit wa zao la nambari tasa
Chanzo huunda modeli ya orodha inayoitwa \(L(p,n_1,n_2)\) ili kuchanganua gharama ya FM na NM. Kila:
kipengele huchaguliwa kwa kujitegemea kwa uwezekano \(p\).
Urefu wa bit wa kimuundo unaotarajiwa wa zao la nambari zote katika orodha:
hutolewa kama ilivyoonyeshwa.
Formula hii haipimi muda. Ni matokeo ya kati ya kihisabati yanayotumika kukadiria ukubwa wa operand kwa gharama za baadaye za kuzidisha nambari kubwa kamili na uinuaji wa kipeo kwa moduli.
Modeli za msingi za gharama ya operesheni
Chanzo hugawa uchanganuzi wote wa gharama wa DSP/IPP1 katika aina nne kuu za operesheni.
1. Kuzidisha nambari kubwa kamili:
Hapa \(n\) ni urefu wa bit wa operand; \(C_1\) ni konstanti implementation-dependent. Chanzo humodeli kuzidisha nambari kubwa kamili kama \(O(n\log n)\) kwa uchanganuzi wa asymptotic.
2. Uinuaji wa kipeo kwa moduli:
\(l\) ni urefu wa bit wa exponent; \(n\) ni ukubwa wa bit wa base/modulus; na \(w\) ni upana wa sliding-window:
humodeliwa kama ilivyoonyeshwa.
Chanzo hutatua uteuzi wa dirisha bora kwa makadirio ya asymptotic ya fungsi ya Lambert W na kupata:
ukadiriaji huu.
Katika safu ya ukubwa wa exponent iliyochunguzwa, gharama hii hubadilika takriban kwa mstari na urefu wa bit wa exponent \(l\). Huu ni mmoja wa misingi muhimu ya kihisabati ya wazo la DSP la kutumia tena mazao ya kati ya nambari tasa.
3. Uinuaji wa kawaida wa kipeo:
ni modeli ya juu ya gharama inayotumiwa katika chanzo kwa binary exponentiation rahisi.
4. Kigawanyo kikubwa zaidi cha pamoja:
humodeliwa hivyo. \(C_2\) ni konstanti inayotegemea implementation ya GCD.
Algoriti ya awali ya Pollard P-1
Chanzo kinaeleza mbinu ya awali ya Pollard kama muundo wa hatua mbili. Kwa \(1<B_1<B_2\), hali mbili kuu ambazo algoriti inaweza kufanikiwa ni:
- \(P-1\) ni \(B_1\)-smooth.
- \(P-1=Ap\), ambapo \(A\) ni \(B_1\)-smooth na \(B_1<p<B_2\) ni nambari tasa.
Katika hatua ya kwanza, kwa kila nambari tasa:
vipeo vya kutosha huchaguliwa na:
huundwa.
Lahaja trivial ya Bishop
Katika lahaja rahisi ya Bishop inayolinganishwa na chanzo, mwanzoni huchaguliwa kwa nasibu:
na:
operesheni hutekelezwa kwa mfuatano. Katika kila hatua:
hukokotolewa. Ingawa mbinu hii haihitaji kuchagua smoothness bound mapema, kwa sababu huongeza exponent moja baada ya nyingine inachukuliwa katika chanzo kuwa ghali kupita kiasi kwa matumizi ya vitendo.
IPP1 hufanyaje kazi?
IPP1 kwanza huunganisha vipengele vyote vya orodha fulani ya nambari tasa katika zao moja:
na kisha:
hurudia operesheni hii na kuinua nambari tasa zote pamoja kwa idadi ileile ya iteration.
Mbinu hii inaweza kuwa na faida ikiwa vipeo vya nambari tasa viko karibu. Hata hivyo, kipeo halisi cha nambari tasa moja kikiwa kikubwa, wagombea wengine wote wa nambari tasa pia hupitia idadi ileile ya marudio. Hii ndiyo gharama kuu isiyohitajika ambayo DSP inalenga.
Modeli ya kinadharia ya gharama ya IPP1
Katika Theorem 1, chini ya sharti \(p_t\ge p_{\sigma_s}\), chanzo hutoa:
gharama ya juu.
Ikiwa \(p_t=p_{\sigma_s}\) inachaguliwa:
hupatikana.
Neno la kwanza linawakilisha gharama ya zao la orodha ya nambari tasa; la pili gharama ya GCD inayorudiwa; la tatu gharama tawala ya modular exponentiation inayorudiwa.
Algoriti kuu ya DSP
Viingizo vya DSP ni:
- \(N\): moduli ya nambari tasa mbili itakayochanganuliwa katika vipengele.
- \(\gamma\): mpaka wa juu wa kimataifa wa orodha ya wagombea wa nambari tasa.
matokeo ni kigawe tasa kilichopatikana au \(\perp\) kinachoonyesha kutofaulu.
Mwanzoni:
na:
hukokotolewa.
Ikiwa GCD ya kwanza haitoi kigawe non-trivial:
dynamic scaling huanzishwa kwa hiyo.
Kwa \(j<k_0\), kijiseti husika cha nambari tasa:
huundwa.
Zao la nambari tasa katika kipindi hiki:
hukokotolewa.
Exponent ya nguvu:
na accumulator ya hatua inayofuata:
huwa hivyo.
Katika kila duru:
na kisha:
hukokotolewa.
Ikiwa \(d\) non-trivial inapatikana, algoriti hurudisha kigawe. Ikiwa haipatikani, husonga hadi kipimo kinachofuata cha nambari tasa/kipeo.
Kwa nini awamu ya pili ya DSP ni tofauti?
Chanzo kinatoa uchunguzi maalum kwa kijiseti cha mwisho cha nambari tasa \(\mathcal{P}_{k_0}\). Nambari tasa katika kipindi hiki ni kubwa kiasi kwamba kuwepo kwa mbili kati yao kwa wakati mmoja ndani ya \(P_{\mathrm{div}}\) kungepingana na mpaka wa ukubwa. Kwa hiyo, katika kijiseti cha mwisho, badala ya operesheni ghali inayoinua nambari tasa zote hadi vipeo vya juu, mbinu ya Pollard ya shift modular exponentiation hutumiwa.
Kwa nusu ya tofauti kati ya wagombea wa nambari tasa wanaofuatana:
hukokotolewa na:
hukokotolewa mapema. Kwa njia hii, wakati wa kuhamia kwa wagombea wa nambari tasa wanaofuatana, badala ya kufanya exponentiation upya kutoka mwanzo, tofauti katika vipindi vya nambari tasa hutumiwa.
Kwa nini matumizi tena ya matokeo ya kati yanafanya kazi katika DSP?
Example 1 ya chanzo inalinganisha njia mbili za kukokotoa usemi ufuatao kwa nambari tasa mbili \(p_1,p_2\):
.
Katika mbinu ya kwanza:
hukokotolewa mara moja na:
kisha:
hukokotolewa.
Katika mbinu ya pili exponent huundwa kwanza moja kwa moja kama:
na uinuaji mmoja wa kipeo kwa moduli hufanywa.
Kwa kuwa gharama ya modular exponentiation ni takriban ya mstari kwa urefu wa bit wa exponent, gharama za modular exponentiation za mbinu hizo mbili zinaweza kuwa karibu; lakini mbinu ya pili lazima pia izalishe mraba wa exponent kubwa. Hitimisho la chanzo ni kwamba matumizi tena ya zao la kati yanaweza kupunguza gharama ya kuunda exponent.
Modeli ya kinadharia ya gharama ya DSP
Katika Theorem 2, chanzo hutoa gharama ya DSP katika hali husika kama:
ilivyoonyeshwa.
Hapa:
- \(p_{\sigma_s}\): kigawe tasa halisi kikubwa zaidi ndani ya \(P_{\mathrm{div}}\).
- \(p_{\sigma_x}^{u_{\sigma_x}}\): sehemu kubwa zaidi ya nguvu ya nambari tasa.
- \(n_N\): urefu wa bit wa moduli.
- \(C_1\): konstanti ya gharama ya kuzidisha nambari kubwa kamili.
- \(C_2\): konstanti ya gharama ya GCD.
- \(o(\cdot)\): huonyesha istilahi za mpangilio wa chini zinazokua polepole kuliko istilahi tawala.
Theorem hii imeundwa katika chanzo kwa hali inayoweza kufanyiwa factorization kwa mafanikio. Gharama kamili ya hali ya kutofaulu haijajumuishwa katika usemi huu.
Kwa nini DSP inaweza kukokotoa vipeo visivyohitajika vichache kuliko IPP1?
Wakati IPP1 huinua wagombea wote wa nambari tasa katika orodha iliyochaguliwa pamoja hadi idadi ileile ya marudio ya \(u_{\max}\), DSP hutumia ukweli kwamba mpaka wa kipeo kinachowezekana hupungua kadiri ukubwa wa nambari tasa unavyoongezeka na kupima vipindi tofauti vya nambari tasa kwa kasi tofauti; kwa hiyo, kuwa na kipeo kikubwa kwa nambari tasa moja ndogo hakulazimishi wagombea wengine wote kuchukua kipeo hicho hicho kikubwa bila sababu.
Matokeo ya %95 yanapatikanaje?
Chanzo kinapolinganisha gharama za Theorem 1 na Theorem 2 hupata kutokulingana ambako DSP inaweza kuwa na gharama ndogo. Kisha hutumia fungsi \(P-1\) iliyofafanuliwa na Riesel kwa usambazaji wa largest-prime-factor wa \(\rho_1\).
Wakati \(p_{\sigma_s}\ge64\):
na kutoka kwenye matokeo yaliyotumiwa chanzo hunukuu kwamba:
. Kwa kuwa \(\rho_1\) hupungua kwa monotoni, kwa tukio husika:
hufikiwa.
Kwa hiyo kauli “zaidi ya %95” katika makala ni uwezekano wa kinadharia wa kulinganisha gharama. Haimaanishi kiwango cha mafanikio ya kuvunja funguo za RSA, kiwango cha usalama, wala kwamba katika sampuli 100 za majaribio sampuli 95 zilivunjwa.
Je, DSP kwa ujumla ni algoriti ya kuvunja RSA?
Hapana; DSP ni mbinu maalum ya factorization ya familia ya Pollard P-1, na ili iwe na ufanisi \(P-1\) au \(Q-1\) lazima iwe na muundo unaofaa wa smooth unaoundwa na vigawe tasa vidogo; moduli za majaribio za 1024-bit za utafiti zilitengenezwa mahsusi ili muundo huu uwepo.
Tatizo la Fast Multiplication ni nini?
DSP na IPP1 lazima zikokotoe zao la wagombea wengi wa nambari tasa. Katika mbinu rahisi ya Normal Multiplication (NM):
kwa orodha hii, kipengele cha kwanza hutumiwa kama accumulator inayokua kila wakati:
Katika hali hii kila kuzidisha kupya hufanywa kwa nambari kamili kubwa zaidi sana kuliko iliyotangulia.
FM hufanyaje kazi?
Fast Multiplication huoanisha kipengele kidogo zaidi na kikubwa zaidi, cha pili kidogo na cha pili kikubwa katika orodha:
na:
na hivyo hupunguza orodha kwa takriban nusu katika kila duru.
Ikiwa idadi ya vipengele vya orodha ni witiri, 1 isiyoathiri kuzidisha huongezwa mwanzoni. Operesheni hurudiwa hadi zao moja pekee libaki.
Kwa nini Fast Multiplication inaweza kuwa nafuu kuliko Normal Multiplication?
Normal Multiplication huzalisha ukubwa wa operand usio na uwiano kwa sababu huzidisha accumulator moja inayokua daima na vipengele vipya, huku FM ikiunganisha kwa ulinganifu vipengele vikubwa na vidogo na kujenga mti wa kuzidisha wenye uwiano. Katika modeli ya gharama ya nambari kubwa kamili ya chanzo, muundo huu hupunguza gharama ya NM ya takriban kipimo cha \(4^n\) katika zao la orodha ya nambari tasa hadi gharama ya FM ya takriban kipimo cha \(2^n n^2\).
Uchangamano wa Normal Multiplication
Katika Theorem 3:
usemi unatolewa.
Ikiwa \(p=1\):
huwa hivyo.
Wakati msongamano wa takriban wa nambari tasa unazingatiwa kupitia Prime Number Theorem, gharama ya NM ya zao la nambari tasa zote chini ya mpaka wa \(n\)-bit hutolewa katika chanzo kama:
.
Uchangamano wa Fast Multiplication
Theorem 4:
hutoa matokeo haya.
Kwa \(p=1\):
huwa hivyo.
Kwa orodha ya nambari tasa, katika Corollary 2:
hupatikana.
Tunapoweka \(n_1=0,n_2=n\), kipimo cha msingi:
huwa hivyo, huku upande wa NM ukikua kwa \(4^n\). Chanzo kinaonyesha katika Kielelezo 4 kwamba kwa ukubwa wa kigawe tasa cha juu cha 21-26 bit, mikondo ya kinadharia inalingana vizuri na vipimo halisi. Kwa kuwa jedwali la vipimo ghafi halijatolewa, Verianla haitoi muda mahususi kutoka kwenye grafu.
Mbinu na Matokeo ya Utafiti
Jaribio 1: Ulinganisho wa lahaja nne za Pollard P-1
Chanzo kinalinganisha implementation nne:
- DSP + Fast Multiplication.
- IPP1 + Fast Multiplication.
- Pollard P-1 ya awali.
- Lahaja trivial ya Pollard P-1 ya Bishop.
Hifadhi ya msimbo wa jaribio imetolewa katika chanzo kama ifuatavyo:
https://github.com/Summwer/expemeriment_of_pollardpm1
Chanzo kinatoa tarehe ya kufikiwa ya 1 Agosti 2026 kwa kiungo.
Moduli za majaribio za 1024-bit zilitengenezwa vipi?
Waandishi kwanza waliunda \(P\) kwa namna ambayo thamani ya \(P-1\) ni zao la nambari kadhaa nasibu za 30-bit. Kwa hiyo kigawe tasa kikubwa zaidi cha \(P-1\):
huwa hivyo na lengo ni kufanya sampuli za majaribio ziweze kutatuliwa na familia ya Pollard P-1.
Kisha nambari tasa nasibu \(P\) yenye urefu sawa wa bit na \(Q\) huzalishwa na:
hukokotolewa.
Maandishi ya chanzo yanasema kwamba kwa mbinu hii **moduli 10 za 1024-bit \(N\)** zilitengenezwa. Hata hivyo, kwenye mhimili wa x unaoonekana wa Kielelezo 7 cha chanzo kuna instance 1-8 pekee. Chanzo hakielezi tofauti hii.
Vifaa vya jaribio
| Kipengele | Thamani iliyoripotiwa katika chanzo |
|---|---|
| Mfumo wa uendeshaji | Ubuntu 20.04.1 |
| Usanifu | x86-64 |
| CPU | Intel Core i5-9500 @ 3.00 GHz |
| Taarifa ya CPU iliyoandikwa katika chanzo | 6 × Intel Core i5-9500 |
| RAM | 16 GB |
| Utekelezaji | Single thread |
| Moduli | 1024-bit \(N=PQ\) |
| Urefu wa bit wa \(P,Q\) | Takriban 512 bit |
Matokeo makuu ya kasi ya Jaribio 1
| Mbinu iliyolinganishwa | Faida ya kasi ya takriban ya DSP iliyoripotiwa katika chanzo | Muktadha |
|---|---|---|
| IPP1 + FM | 23,5× | Moduli za majaribio za 1024-bit zilizotengenezwa mahsusi |
| Pollard P-1 ya awali | 16,4× | Mpangilio uleule wa jaribio |
| Trivial Pollard P-1 | 35,6× | Mpangilio uleule wa jaribio |
Chanzo kinasema kwamba instance 2, 3, 4, 5 na 8 zenye vipeo vikubwa vya nambari tasa zinafanya tabia hii ionekane wazi. Imeripotiwa kwamba katika instance 2, 3, 4 na 8 IPP1 ilikuwa polepole hata kuliko Pollard P-1 ya awali, lakini DSP iliendelea kuwa haraka kuliko algoriti ya awali.
Tafsiri ya waandishi ni kwamba gharama ya DSP ni nyeti zaidi kwa ukubwa wa kigawe tasa kikubwa zaidi kuliko kwa idadi ya vigawe tasa au indeksi ya mpangilio ya nambari tasa. Hii ni tafsiri ya majaribio na nadharia ya chanzo chenyewe; haipaswi kupanuliwa kuwa matokeo mapya ya jumla kwa miundo yote ya \(P-1\) katika usambazaji mwingine.
Jaribio 2: Kipeo kimoja kikubwa kinaongezwa kwa udhibiti
Katika jaribio la pili \(P\) ya 512-bit huundwa kwa muundo huu:
na:
hutumiwa.
Lengo la muundo huu ni kuongeza kipeo cha nambari tasa 3 huku masharti mengine yakidhibitiwa na kuangalia kwa utaratibu tofauti kati ya IPP1 na DSP.
Kwa kila \(P\), \(Q\) nasibu ya 512-bit huchaguliwa na:
huzalishwa.
Kwa DSP:
- Algorithm 4 implementation halisi,
- Algorithm 6 DSPEst estimator,
- Theorem 2 gharama ya kinadharia
hulinganishwa.
Kwa IPP1:
- Algorithm 3 implementation halisi,
- Algorithm 5 IPP1Est estimator,
- Theorem 1 gharama ya kinadharia
hulinganishwa.
Katika Kielelezo 8, mistari ya gharama za kinadharia, nukta za estimator na nukta halisi za majaribio hufuata kwa karibu mwelekeo uleule wa ukuaji. Matokeo haya yanaunga mkono kwamba modeli za gharama za utafiti zinawakilisha vizuri tabia ya implementation katika usanidi huu uliojaribiwa. Kwa kuwa chanzo hakitoi thamani ghafi za nukta kama jedwali, hakuna thamani mpya za kati zinazozalishwa.
Tafsiri sahihi ya ulinganisho wa kinadharia wa %95
Matokeo ya kinadharia ya chanzo yanatumia pamoja:
- sharti \(p_{\sigma_s}\ge64\),
- fungsi \(\rho_1\) ya Riesel,
- modeli za gharama za Theorem 1 na Theorem 2
.
Kwa hiyo ni makosa kusema “DSP ina kiwango cha mafanikio cha %95”. Chanzo kinasema kwamba chini ya masharti fulani, uwezekano wa tukio linalounga mkono kwamba DSP ina gharama ya chini ya kinadharia ya ukokotoaji kuliko IPP1 ni angalau 0,95.
Matokeo yanayoungwa mkono na utafiti
- DSP ni lahaja mpya inayoshughulikia wagombea wa nambari tasa na vipeo vinavyohitajika vya Pollard P-1 katika mpangilio mmoja wa skani wenye nguvu.
- Kutumia tena mazao ya nambari tasa yaliyokokotolewa awali kunaweza kupunguza gharama ya kuunda exponent kubwa.
- DSP hubadilisha ugawaji wa exponent kulingana na ukubwa wa nambari tasa na kupunguza ukokotoaji usiohitajika unaotokana na IPP1 kuinua wagombea wote hadi \(u_{\max}\).
- Fast Multiplication hutumia mti wa kuzidisha wenye uwiano na katika modeli ya gharama ya chanzo huonyesha tabia bora ya asymptotic kuliko Normal Multiplication.
- Chanzo kinaonyesha katika Kielelezo 4 kwamba modeli za gharama za kinadharia za NM/FM zinalingana vizuri na gharama za majaribio.
- Katika masharti ya kinadharia ya chanzo, wakati \(p_{\sigma_s}\ge64\), uwezekano unaotumiwa kwa gharama ya DSP kuwa chini ya ya IPP1 ni angalau 0,95.
- Katika majaribio yaliyoundwa ya 1024-bit ya chanzo, DSP ni haraka kuliko lahaja tatu za zamani zilizolinganishwa.
- Chanzo kinaripoti kwamba faida ya DSP inaonekana zaidi wakati kuna vipeo vikubwa vya nambari tasa.
- Katika jaribio linalodhibitiwa la \(u_x\), mielekeo ya Theorem 1/2, estimator na gharama za implementation iko karibu.
Matokeo yasiyoungwa mkono na utafiti
- Haiwezi kuhitimishwa kwamba DSP hufanya factorization ya moduli za kawaida za 1024-bit RSA kwa ufanisi.
- Uwiano wa kasi wa 23,5×, 16,4× na 35,6× hauwezi kuenezwa kwa funguo zote za RSA.
- Thamani ya %95 si kiwango cha mafanikio ya factorization ya RSA kwa ujumla.
- Haijajaribiwa kwamba DSP kwa ujumla ni haraka kuliko mbinu za factorization za matumizi ya jumla kama Number Field Sieve.
- Majaribio ya utafiti si ulinganisho wa quantum factoring.
- Theorem za uchangamano hazijumuishi uchanganuzi kamili wa gharama ya hali ya factorization iliyoshindwa.
- Performance ya cores nyingi au iliyoharakishwa kwa GPU haijajaribiwa.
- Haijathibitishwa kwamba uwiano uleule wa kasi utadumishwa katika CPU, arbitrary-precision library au mazingira mengine ya implementation.
- Katika Kielelezo 7, thamani za muda kwa instance 9 na 10 zisizoonekana haziwezi kutolewa kutoka chanzo.
Vikwazo vikuu vya kimetodolojia na uzalishaji upya
- Sampuli za majaribio ziliundwa kwa kuhakikisha mahsusi muundo wa smooth unaoweza kutatuliwa na Pollard P-1.
- Ulinganisho ulifanywa kwenye kompyuta moja binafsi na kwa single-thread.
- Maandishi ya chanzo yanasema moduli 10 za 1024-bit kwa jaribio la kwanza, lakini Kielelezo 7 kinaonyesha instance nane tu.
- Urefu wote wa bar katika Kielelezo 7 haujatolewa kama jedwali.
- Thamani ghafi za majaribio, estimator na nadharia za Kielelezo 8 hazijachapishwa kama jedwali.
- Sehemu ya uchangamano wa kinadharia wa DSP/IPP1 imewekewa wazi mipaka ya solvable situation na failure scenario imeondolewa.
- Toleo la arbitrary-precision arithmetic library lililotumiwa katika majaribio halijaripotiwa kwa undani katika chanzo.
- Makala iko katika muktadha wa nadharia ya nambari ya kawaida na ukokotoaji wa kawaida; haitoi matokeo ya quantum factoring.
Maana ya kriptografia ya utafiti
Algoriti za Pollard P-1 haziondoi ugumu wa jumla wa tatizo kuu la integer-factorization la RSA. Badala yake zinalenga algebraic weakness maalum zinazoweza kutokea wakati wa prime generation. Mchango wa makala pia unalenga kuendesha mchakato wa factorization kwa ukokotoaji mdogo usiohitajika wakati udhaifu huu maalum upo.
Kwa hiyo muhtasari sahihi wa utafiti si “RSA sasa imevunjwa”. Kauli sahihi zaidi ni kwamba mkakati mpya wa traversal/exponent-scaling unaolenga kuharakisha factorization ya Pollard P-1 katika composite maalum zenye muundo wa smooth \(P-1\) au \(Q-1\) umechunguzwa kinadharia na kimajaribio.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Dynamic Scaling Pollard’s P-1 Algorithm
Waandishi: Wenwen Xia; Geng Wang; Dawu Gu.
Mpangilio wa waandishi: Wenwen Xia wa kwanza; Geng Wang wa pili; Dawu Gu wa tatu.
Waandishi wa mawasiliano: Geng Wang na Dawu Gu.
Taasisi: School of Cyber Science and Engineering, Shanghai Jiao Tong University, Shanghai 200240, China.
Mchango sawa: Chanzo hakina tamko la uandishi wa kwanza sawa au mchango sawa.
Jarida: Cryptography.
Mchapishaji: MDPI.
Juzuu / toleo / makala: 10(4), Article 57.
Idadi ya kurasa: 26.
DOI: 10.3390/cryptography10040057.
Academic Editor: Josef Pieprzyk.
Kuwasilishwa: 14 Juni 2026.
Marekebisho: 23 Julai 2026.
Kukubaliwa: 29 Julai 2026.
Kuchapishwa: 13 Agosti 2026.
Dokezo la Version of Record: Katika rekodi rasmi ya MDPI Version Notes, PDF ya kwanza ya Version of Record ilichapishwa 13 Agosti 2026, na toleo lililosasishwa la PDF/HTML lilichapishwa 17 Agosti 2026.
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wenzao; inaunganisha nadharia ya nambari, cryptanalysis ya kawaida, ubunifu wa algoriti, uchanganuzi wa uchangamano wa asymptotic na jaribio la kompyuta linalodhibitiwa.
Mapitio ya wenzao: Cryptography ni jarida la MDPI linalopitiwa na wenzao. Nyenzo za submission za jarida zinaripoti mchakato wa single-anonymized peer review.
Hali ya preprint: Chanzo kilichochakatwa ni Version of Record iliyochapishwa; hakuna preprint tofauti iliyotumika kama msingi wa makala hii.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Kiungo rasmi: https://doi.org/10.3390/cryptography10040057
Maneno muhimu: cryptanalysis; RSA; integer factorization; Pollard’s P-1.
Mchango mkuu wa kisayansi: Dynamic Scaling Pollard’s P-1 (DSP) na Fast Multiplication (FM).
Algoriti zilizolinganishwa: DSP; IPP1; Pollard P-1 ya awali; lahaja trivial ya Pollard P-1 ya Bishop.
Modeli za kinadharia: DSP/IPP1 cost estimator zimetengenezwa kutokana na mchanganyiko wa gharama za large-integer multiplication, sliding-window modular powering, binary normal powering na GCD.
Sifa kuu ya DSP: Kugawa wagombea wa nambari tasa katika vipindi vya ukubwa wa double-exponential, kuinua hatua kwa hatua nambari tasa ndogo hadi viwango vya vipeo vya juu, na kutumia tena mazao ya nambari tasa yaliyokokotolewa awali.
Sifa ya FM: Mti wa multiplication wenye uwiano unaozidisha pairwise vipengele vya mwisho vilivyo sawia katika orodha inayoongezeka na kupunguza orodha kwa takriban nusu kila duru.
Jaribio la kwanza: \(P-1\) imeundwa kuwa zao la nambari kadhaa nasibu za 30-bit; kutokana na \(P\) ya 512-bit na \(Q\) nasibu yenye takriban ukubwa uleule, moduli za majaribio za 1024-bit \(N=PQ\) zimeundwa.
Mazingira ya jaribio la kwanza: Ubuntu 20.04.1; x86-64; Intel Core i5-9500 @ 3.00 GHz; 16 GB RAM; single thread.
Matokeo makuu ya jaribio la kwanza: Chanzo kinaripoti kwamba DSP ni haraka kuliko IPP1 kwa takriban 23,5×, haraka kuliko Pollard P-1 ya awali kwa 16,4×, na haraka kuliko lahaja trivial kwa 35,6×.
Kutolingana kwa ndani ya chanzo katika jaribio la kwanza: Maandishi yanaripoti test instance 10 za 1024-bit, lakini kwenye mhimili wa x unaoonekana wa Kielelezo 7 cha chanzo kuna instance 1-8 pekee. Chanzo hakielezi tofauti hii.
Jaribio la pili: \(P=2\times3^{u_x}\times1073741789\times z+1\), \(u_x\in\{0,20,40,60,80,100\}\); \(Q\) nasibu ya 512-bit; ulinganisho wa nadharia-estimator-jaribio kwa DSP na IPP1.
Matokeo ya kinadharia ya %95: Chini ya sharti \(p_{\sigma_s}\ge64\), katika derivation inayotegemea fungsi \(\rho_1\) ya Riesel, uwezekano wa angalau 0,95 hupatikana kwa sharti la gharama linalotumiwa kwa faida ya DSP. Hiki si kiwango cha mafanikio ya kuvunja RSA.
Hifadhi ya msimbo: https://github.com/Summwer/expemeriment_of_pollardpm1 — chanzo kinatoa tarehe ya kufikiwa 1 Agosti 2026.
Ufadhili: National Cryptologic Science Fund of China, No. 2025NCSF02017.
Upatikanaji wa data: Waandishi wanasema data ghafi inayounga mkono matokeo itapatikana kwa ombi.
Mgongano wa maslahi: Waandishi wanatangaza kwamba hakuna mgongano wa maslahi.
Michango ya waandishi: Conceptualization, methodology, software, validation, formal analysis, investigation, data curation na original draft: Wenwen Xia; resources: Dawu Gu; visualization: Wenwen Xia na Geng Wang; supervision na project administration: Geng Wang na Dawu Gu; funding acquisition: Geng Wang na Dawu Gu.
Kamati ya maadili / ridhaa yenye taarifa: Chanzo hakina tamko tofauti la kamati ya maadili au informed-consent; utafiti ni algoriti ya kihisabati na jaribio la factorization la sintetiki/kikompyuta.
Vikwazo vikuu vya kimetodolojia: Theoretical cost analysis huondoa hali ya kutofaulu; moduli za majaribio zilitengenezwa kwa kuhakikisha muundo wa smooth unaofaa kwa Pollard P-1; ulinganisho ni kwenye mashine moja na single-thread; katika jaribio la kwanza kuna kutolingana kwa idadi ya instance kati ya maandishi na grafu; data ghafi ya nambari ya Kielelezo 7-8 haijatolewa kama jedwali.
Mpaka wa jumla wa tafsiri: Utafiti unaunga mkono kwamba factorization ya Pollard P-1 inaweza kuharakishwa kwa DSP na FM katika moduli zenye muundo unaofaa wa smooth \(P-1\) au \(Q-1\); hauungi mkono hitimisho kuhusu arbitrary RSA modulus, ulinganisho wa jumla wa NFS, au kwamba funguo zote za kisasa za RSA zinaweza kuvunjwa kwa vitendo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *