


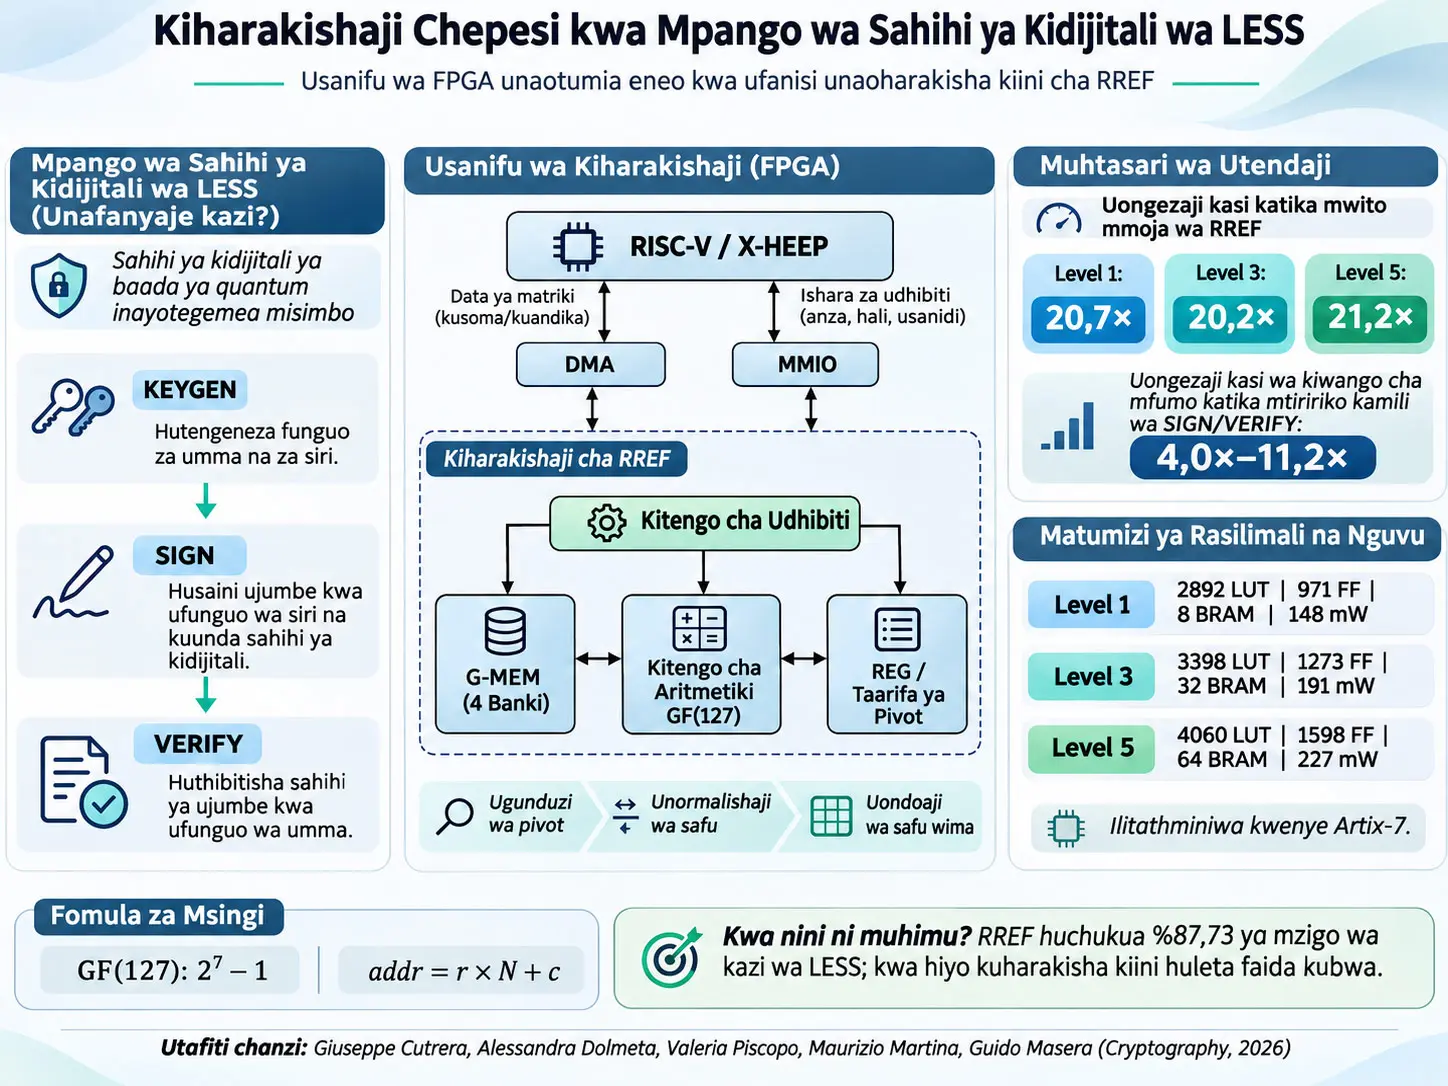
LESS (Linear Equivalence Signature Scheme), ni mpango wa sahihi ya kidijitali wa baada ya quantum unaotegemea misimbo, ambao usalama wake unategemea ugumu wa kupata usawa uliofichwa kati ya misimbo ya mstari. Badala ya kuhamisha LESS nzima kwenye maunzi, utafiti huu unatengeneza usanifu wa FPGA unaolenga matumizi madogo ya eneo, unaoharakisha kiini cha umbo la ngazi la safu lililopunguzwa (Reduced Row Echelon Form, RREF) ambacho ndicho kinachosababisha mzigo mkubwa zaidi wa ukokotoaji katika mtiririko wa kusaini na kuthibitisha. Kiharakishaji kimeunganishwa kwenye mfumo uliopachikwa wa X-HEEP unaotegemea RISC-V kama kifaa cha pembeni cha ramani ya kumbukumbu kilichounganishwa kwa urahisi; data nzito za matriki huhamishwa kwa DMA, huku taarifa za udhibiti na pivot zikisafirishwa kupitia rejista za MMIO.
Katika matokeo ya uprofilishaji wa chanzo, generator_RREF_pivot_reuse kazi hutumia %87,73ya jumla ya mizunguko ya operesheni ya kusaini ya LESS. Kwa hiyo lengo kuu la muundo ni kuharakisha operesheni ya RREF kwa alama ndogo ya maunzi. Katika tathmini iliyofanywa kwenye Xilinx Artix-7 xc7a100tftg256-2 , kwa mwito mmoja wa RREF katika usanidi wa Level 1, Level 3 na Level 5, mtawalia 20,7×, 20,2× na 21,2× za kuharakisha ziliripotiwa. Katika mtiririko kamili wa SIGN na VERIFY, kuharakisha ni kwa kiwango cha chini zaidi kwa sababu hashing, udhibiti na uhamishaji wa data havijahamishwa kwenye maunzi; katika Jedwali 5 la chanzo thamani ya juu zaidi kwa SIGN ni 11,20×, na ya juu zaidi kwa VERIFY ni 9,91× .
Usanifu umejengwa juu ya benki nne sambamba za BRAM za biti 8 zinazohifadhi elementi za matriki, ufikiaji wa neno la biti 32, aritmetiki ya uga wenye kikomo ya njia nne, matumizi tena ya taarifa ya pivot, mashine kuu ya hali zenye kikomo, na uratibu wa programu-maunzi unaotegemea ukatizaji. Uchaguzi wa GF(127) pia ni muhimu kwa upande wa maunzi: kwa kuwa 127 ni nambari ya kwanza ya Mersenne katika umbo la 27−1 , upunguzaji wa matokeo ya kuzidisha modulo 127 unaweza kutekelezwa kwa mantiki ya kukunja biti badala ya saketi ghali za mgawanyo wa matumizi ya jumla.
Nguvu ya utafiti si kasi pekee bali pia gharama ya eneo. Kulingana na Jedwali 6 la chanzo, katika Level 1 kiharakishaji hutumia 2892 LUT, 971 FF na 8 BRAM; katika Level 3 hutumia 3398 LUT, 1273 FF, 32 BRAM na 3 DSP; na katika Level 5 hutumia 4060 LUT, 1598 FF, 64 BRAM na 8 DSP. Makadirio ya jumla ya nguvu ni 148, 191 na 227 mW mtawalia. Hata hivyo, kuna kutokulingana kadhaa kwa namba ndani ya maandishi ya makala yenyewe: kwa Level 5, baadhi ya aya zinasema “chini ya 3700” au “3649 LUT”, huku jedwali zikitoa 4060 LUT; kauli ya 5,58 KeSlice katika sehemu ya hitimisho nayo haipatani na Jedwali 8 na thamani ya takriban 8,7 KeSlice katika muhtasari. Katika uwasilishaji huu wa Verianla, kutokulingana huku hakujafichwa; thamani za jedwali na kauli za maandishi zimetenganishwa.
Utafiti pia hauthibitishi usalama dhidi ya njia za pembeni za kimwili. Mabadiliko ya idadi ya mizunguko kwenye vekta 100 za Known Answer Test (KAT) kubaki kwa kawaida chini ya mizunguko 300 yanaashiria tabia yenye utegemevu mkubwa wa muda; hata hivyo, waandishi wanaeleza wazi kwamba uchanganuzi wa nguvu, uvujaji wa sumakuumeme na ustahimilivu dhidi ya uingizaji wa hitilafu vinahitaji kutathminiwa kando. Hivyo, kile ambacho utafiti huu unaonyesha ni kwamba kiini cha RREF kinaweza kuharakishwa kwa ufanisi kwa maunzi ya FPGA yenye eneo dogo; si uthibitisho kamili wa usalama dhidi ya mashambulizi ya kimwili.
Mpango wa sahihi ya kidijitali hufanya operesheni gani tatu za msingi?
Mfumo wa sahihi ya kidijitali una algoriti tatu kuu. KEYGEN hutengeneza ufunguo wa umma na ufunguo wa siri ambao umeunganishwa kihisabati. SIGN, hutengeneza sahihi kwa kuhusisha ujumbe na ufunguo wa siri. VERIFY hutathmini ujumbe, sahihi na ufunguo wa umma kwa pamoja na kuamua kama sahihi ikubaliwe au ikataliwe. LESS pia hutumia muundo huu wa jumla wa sehemu tatu; utafiti unalenga hasa kiini cha algebra ya mstari kinachofanya kazi mara kwa mara ndani ya SIGN na VERIFY.
Muktadha wa usanifishaji: Utafiti unachukulia LESS kama mojawapo ya mipango inayotegemea misimbo katika mchakato wa “on-ramp” wa NIST wa kutathmini wagombea wa ziada wa sahihi za kidijitali za baada ya quantum. Makala yenyewe pia inasema wazi kwamba LESS haikusonga mbele hadi hatua inayofuata ya tathmini. Kwa hiyo, muundo wa maunzi unaoelezwa hapa haupaswi kusomwa kama “utekelezaji wa LESS uliosanifishwa na NIST”, bali kama utafiti wa kuharakisha unaolenga eneo kwa ajili ya mizigo ya kazi ya baada ya quantum yenye RREF na matriki nyingi.
Msingi wa kihisabati wa LESS: usawa wa misimbo ya mstari
Kitu cha msingi cha kihisabati cha LESS ni matriki zalishi juu ya uga wenye kikomo. Katika chanzo, uga wenye kikomo unaonyeshwa kwa Fq , na matriki zalishi yenye k safu na n nguzo inaonyeshwa kwa G . Vekta ya ujumbe mikizidishwa na G huzalisha neno la msimbo. Katika chanzo nafasi hii ya safu hufafanuliwa kama ifuatavyo:
\[\mathcal{C}(G)=\{mG:m\in\mathbb{F}_q^k\}\subseteq\mathbb{F}_q^n\]
Formula inaeleza nini? \(\mathcal{C}(G)\) huwakilisha msimbo wa mstari unaoundwa na safu za matriki G. \(m\) ni vekta ya ujumbe/koefishienti ndani ya \(\mathbb{F}_q^k\); \(mG\) ni neno la msimbo ndani ya \(\mathbb{F}_q^n\). Hakuna kitengo cha kimwili hapa; ukubwa wote ni elementi bainifu za algebra ya uga wenye kikomo.
Ili matriki mbili zalishi ziweze kuwakilisha muundo uleule wa msimbo au muundo sawia, hutumiwa matriki inayoweza kugeuzwa ya S inayobadilisha msingi wa safu, pamoja na matriki monomial ya Q inayopanga upya na kupima nguzo. Katika chanzo, Tatizo la Usawa wa Mstari linatolewa kwa mlinganyo ufuatao:
\[G'=SGQ \tag{1}\]
Katika mlinganyo huu, \(S\in GL_k(\mathbb{F}_q)\) ni matriki inayoweza kugeuzwa ya \(k\times k\). Kuzidisha S kutoka kushoto hubadilisha msingi wa safu lakini hakubadilishi nafasi ya safu ya msimbo. \(Q\) ni matriki monomial yenye elementi moja tu isiyo sifuri katika kila safu na kila nguzo; chanzo kinaieleza kama muunganiko wa matriki ya permutation na matriki ya diagonal inayoweza kugeuzwa. Kuzidisha Q kutoka kulia hupanga upya na kupima viwianishi.
Dhana ya usalama ya LESS inategemea ugumu wa kurejesha mageuzi ya siri ya monomial wakati G na G′ zimetolewa chini ya vigezo na usambazaji unaofaa. Utafiti hautoi uthibitisho mpya wa usalama wa kriptografia; unaharakisha kwenye maunzi operesheni nzito ya matriki ya muundo uliopo wa LESS.
RREF ni nini?
Umbo la ngazi la safu lililopunguzwa (RREF), ni umbo la kikanoni ambalo matriki hufikishwa kwa operesheni za msingi za safu. Kila elementi inayoongoza inayotumiwa kama pivot hufanywa kuwa 1; elementi nyingine katika nguzo ya pivot hufanywa sifuri; nafasi za pivot huhamia kulia kadiri safu zinavyoshuka, na safu sifuri hukusanywa chini. Kwa sababu matriki mbili zinazoeleza nafasi ileile ya safu hufikia RREF ileile, RREF ni muhimu katika LESS kwa kubadilisha uwakilishi tofauti wa msingi kuwa uwakilishi mmoja wa kikanoni.
Kwa nini LESS inakabiliwa na kikwazo katika ukokotoaji wa RREF?
Kwa sababu LESS hutumia operesheni ya RREF mara nyingi kuleta uwakilishi sawia wa misimbo katika umbo lilelile la kikanoni, operesheni nyingi za safu za uga wenye kikomo hutokea hasa katika hatua za SIGN na VERIFY; katika profaili ya chanzo, generator_RREF_pivot_reuse kazi hutumia %87,73 ya mizunguko ya kusaini, hivyo kufanya kiini hiki kuwa gharama ya ukokotoaji inayotawala kwa mbali.
Kwa nini RREF huondoa matriki S?
Sifa muhimu ya RREF ni kwamba matriki zinazoeleza nafasi ileile ya safu hufikia umbo lilelile la ngazi la safu lililopunguzwa. Kwa kuwa matriki S hubadilisha msingi wa safu pekee, chanzo hutumia uhusiano ufuatao:
\[\operatorname{RREF}(SGQ)=\operatorname{RREF}(GQ)\]
Katika usawa huu, athari ya S hupotea wakati wa ukanonishaji. Hivyo, muundo mkuu unaopaswa kufuatiliwa upande wa uthibitishaji hupunguzwa hadi athari ya monomial ya Q kwenye nguzo. Umbo la kimfumo \([I\mid V]\) linapopatikana, chanzo pia hunormalisha nguzo V zisizo pivot kwa mpangilio wa kileksikografia chini ya upimaji, kisha hutumia upangaji wa kileksikografia. Lengo ni kuzuia uwakilishi tofauti katika darasa moja la usawa kutoa ingizo tofauti kwa digest ya Fiat–Shamir.
Vigezo vya LESS huamua nini?
Chanzo kinafafanua LESS kwa vigezo vya msimbo \((n,k,q)\) na vigezo vya itifaki \((t,\omega,s)\). \(n\) huonyesha urefu wa msimbo, \(k\) kipimo, na \(q\) mpangilio wa uga wenye kikomo. \(t\) ni idadi ya raundi za Σ-protocol zilizosimuliwa. \(\omega\) ni uzito wa Hamming usiobadilika wa changamoto zisizo sifuri ndani ya raundi t. \(s\) ni idadi ya nafasi za changamoto wazi/siri. Kulingana na chanzo, kuongeza t hupunguza hitilafu ya soundness; muundo wa changamoto wenye uzito usiobadilika husaidia kubana transcript; s kubwa inaweza kuongeza ukubwa wa ufunguo wa umma huku ikipunguza ukubwa wa sahihi.
| Seti | n | k | q | t | ω | s | Ufunguo wa umma (KiB) | Sahihi (KiB) |
|---|---|---|---|---|---|---|---|---|
| LESS-1b | 252 | 126 | 127 | 247 | 30 | 2 | 13,7 | 8,4 |
| LESS-1i | 244 | 126 | 127 | 192 | 20 | 4 | 41,1 | 6,1 |
| LESS-1s | 198 | 99 | 127 | 68 | 17 | 8 | 95,9 | 5,2 |
| LESS-3b | 400 | 200 | 127 | 759 | 33 | 2 | 34,5 | 18,4 |
| LESS-3s | 400 | 200 | 127 | 895 | 26 | 3 | 68,9 | 14,1 |
| LESS-5b | 548 | 274 | 127 | 1352 | 40 | 2 | 64,6 | 32,5 |
| LESS-5s | 548 | 274 | 127 | 907 | 37 | 3 | 129,0 | 26,1 |
Jukumu la mtiririko wa KEYGEN, SIGN na VERIFY ndani ya LESS
KEYGEN: Kutoka seed ya umma, matriki msingi G0 huundwa. Kutoka seed za ziada za siri hutolewa vinyume vya mageuzi ya monomial; vinawekwa kwenye G0 , hubadilishwa kuwa RREF na maumbo yake yaliyobanwa huwa sehemu za ufunguo wa umma. Nafasi ya utambulisho Q0=In huchukuliwa kwa njia fiche. Kwa sababu chanzo kinachukulia utengenezaji wa funguo kama operesheni ya usanidi ya mara moja, hakijahamisha hatua hii kwenye kiharakishaji na imebaki kwenye prosesa kuu.
SIGN: Wakati wa kusaini, mageuzi t ya muda ya monomial huundwa na kutoka kwayo huandaliwa ingizo za commitment za kikanoni. Commitment, ujumbe na salt huhashishwa pamoja ili kupata digest d. Digest hii huamua vekta ya changamoto yenye uzito wa Hamming usiobadilika wa ω. Ni majibu ω tu yanayolingana na changamoto zisizo sifuri hujumuishwa kwenye sahihi; nasibu nyingine inaweza kuzalishwa upya na mthibitishaji kupitia muundo wa seed-tree. Ubanaji huu hudhibiti ukubwa wa transcript.
VERIFY: Meydan okuma xi=0, mthibitishaji huzalisha upya mageuzi ya muda ya monomial kutoka kwenye jani husika la seed-tree na kukokotoa ingizo la commitment. xi≠0, jibu lililobanwa hufunguliwa kuwa mageuzi ya monomial, hutumiwa kwenye nafasi ya matriki ya umma, matokeo huletwa kwenye RREF na nguzo zisizo pivot hufanywa za kikanoni. Mwishoni commitment zote zilizozalishwa upya huhashishwa na ujumbe na salt; thamani d′ iliyopatikana inatarajiwa kulingana na d katika sahihi.
Istilahi za kriptografia zilizotumiwa zinapaswa kuelewekaje?
CSPRNG (Cryptographically Secure Pseudorandom Number Generator), ni jenereta ya nambari bandia nasibu inayotarajiwa kutoa matokeo yasiyotabirika kwa matumizi ya kriptografia. Commitment, huwakilisha kwa njia ya kufunga thamani ya kati ya itifaki ambayo itathibitishwa baadaye. Σ-protocol, ni familia ya uthibitisho yenye muundo wa changamoto-jibu inayotumika kuonyesha kwamba siri fulani inajulikana bila kufichua taarifa yenyewe. Mageuzi ya Fiat–Shamir, hubadilisha itifaki kuwa umbo lisiloingiliana linalofaa kwa matumizi ya sahihi kwa kutoa changamoto ya mwingiliano kutoka matokeo ya hash. Salt, ni thamani ya ziada ya nasibu inayozuia ingizo zilezile kuishia lazima kwenye muundo uleule wa digest katika uendeshaji tofauti. Seed-tree , badala ya kubeba seed nyingi za nasibu moja moja, husaidia kuzalisha upya seed ndogo zinazohitajika kupitia muundo wenye matawi unaotokana na seed ya mzizi. Maelezo haya ni kwa ajili ya kuelewa mbinu; si matokeo mapya ya utafiti.
Kwa nini profaili huhamisha kiini cha RREF pekee kwenye maunzi?
| Kazi | Sehemu ya jumla ya mizunguko | Kazi kuu |
|---|---|---|
generator_RREF_pivot_reuse | %87,73 | Kiini cha upunguzaji wa matriki ya RREF |
compute_canonical_form_type4 | %2,52 | Ukokotoaji wa umbo la kikanoni |
compute_canonical_form_type5_popcnt | %2,08 | Ukokotoaji wa umbo la kikanoni |
KeccakF1600_StatePermute | %1,50 | Permutation ya SHA-3/SHAKE |
| Nyingine | %6,17 | Upangaji, usimamizi wa kumbukumbu, hashing |
Chanzo kinatoa idadi ya operesheni za uga wenye kikomo katika ubadilishaji wa kawaida wa RREF wa mfululizo kwa \(G\in\mathbb{F}_q^{k\times n}\) kwa ukuaji wa asimptoti wa \(\mathcal{O}(k^2n)\), na hitaji la kumbukumbu la kideterministi kwa matriki na miundo ya ufuatiliaji kuwa \(\mathcal{O}(kn)\). Kauli hii si idadi halisi ya mizunguko; ni darasa la uchangamano wa asimptoti linaloonyesha jinsi mahitaji ya ukokotoaji na uhifadhi yanavyokua tatizo linapokua.
Usanifu wa kiwango cha juu wa kiharakishaji
Maunzi yamejengwa kuzunguka miundo minne kuu: kitengo kikuu cha Control Unit, ambapo matriki huhifadhiwa G-MEM, kinachofanya operesheni za uga wenye kikomo Arithmetic Unit na REG kizuizi kinachobeba taarifa za pivot/hali za kati. Badala ya njia kubwa ya data ya paralelismu ya juu sana, muundo hutumia njia ya data iliyoserizishwa zaidi yenye paralelismu ya elementi nne, inayodhibitiwa na FSM kuu. Chaguo hili ni mkakati wa kupunguza gharama ya eneo kwa kuacha kiasi fulani cha kilele cha utendaji.
Hatua nne za operesheni katika maunzi ya RREF
- Uchakataji wa awali: Nguzo za pivot zinazojulikana kutoka uendeshaji uliopita huchunguzwa; ubadilishaji wa safu unaohitajika hufanywa ili kuleta elementi zisizo sifuri karibu na nafasi zao za diagonal za kikanoni. Lengo ni kupunguza utafutaji usiohitajika kwa kutumia tena taarifa ya muundo inayojulikana.
- Ugunduzi wa pivot: Kuanzia nafasi hai ya diagonal, elementi isiyo sifuri hutafutwa kwenda chini katika nguzo husika. Ikiwa pivot iko katika safu nyingine, ubadilishaji wa safu wa neno-paraleli hutumika. Ikiwa ramani ya pivot ya awali ni halali, baadhi ya utafutaji unaweza kurukwa.
- Urekebishaji wa safu kuwa kawaida: Kinyume cha kuzidisha cha elementi ya pivot ndani ya GF(127) hupatikana na safu yote ya pivot hupimwa kwa thamani hiyo ili pivot iwe 1 kamili. Kwa njia ya data ya biti 32, elementi nne za uga za biti 8 zinaweza kuchakatwa katika mzunguko mmoja.
- Uondoaji wa nguzo: Safu ya pivot iliyorekebishwa hutumiwa kama marejeo. Kwa kutumia koefishienti ya nguzo ya pivot katika safu nyingine, operesheni za zidisha-toa za uga wenye kikomo hutekelezwa na elementi nyingine katika nguzo ya pivot hufanywa sifuri.
Hatua hizi nne zikitekelezwa katika nguzo zote zinazohitajika, RREF hukamilika. Matriki ya mwisho na ramani za pivot zilizosasishwa hurudishwa kwenye mfumo mkuu.
Kwa nini G-MEM imegawanywa katika benki nne?
Matriki huhifadhiwa kwa mpangilio wa row-major na kila elementi ya GF(127) huhifadhiwa katika baiti moja ya biti 8 kwa uoanifu na miundo ya kawaida ya kumbukumbu. Chanzo kinatoa anwani ya baiti ya elementi \((r,c)\) kwa uanwani rahisi wa mstari ufuatao:
\[\text{addr}_{\text{byte}}=r\times N+c\]
Hapa \(r\) ni indeksi ya safu, \(c\) indeksi ya nguzo, na \(N\) idadi ya jumla ya nguzo katika safu. Formula huzalisha anwani ya kumbukumbu; hakuna kitengo cha kimwili, na matokeo ni nafasi ya baiti.
Katika kumbukumbu halisi, elementi zinazofuatana husambazwa kati ya Bank 0, Bank 1, Bank 2 na Bank 3. Hivyo matokeo ya biti 8 ya benki nne huunganishwa ili kusoma neno la biti 32 na kwa hiyo elementi nne za uga katika mzunguko mmoja. Ikiwa anwani haijapangiliwa kwenye mpaka wa baiti 4, g_addr >> 2 huamua indeksi ya neno, g_addr[1:0] nayo huamua uhamisho wa baiti; mtandao wa kuzungusha/barrel shifter huweka data katika mpangilio sahihi. Katika njia ya kuandika, ishara ya biti 4 ya g_wstrb huwasha baiti zitakazobadilishwa pekee. Chanzo kinafafanua usanifu kwa lengo la ucheleweshaji wa mzunguko mmoja wa kideterministi katika kusoma na kuandika.
Kwa nini aritmetiki ya GF(127) hurahisisha maunzi?
Katika vigezo vya LESS hutumiwa q=127. 127 ni nambari ya kwanza ya Mersenne katika umbo la \(2^7-1\). Kwa hiyo:
\[2^7\equiv 1\pmod{127}\]
Bidhaa inayotokana na kuzidisha elementi mbili za uga za biti 7 inaweza kugawanywa katika sehemu za juu na chini za biti 7. Chanzo kinatoa operesheni ya upunguzaji kama ifuatavyo:
\[x\bmod 127=\big((x\gg 7)+(x\ \&\ 127)\big)\bmod 127\]
Vigezo: \(x\) ni matokeo ya kati ya kuzidisha elementi mbili za GF(127). \(x\gg7\) ni umbo la biti za juu zilizohamishwa nafasi 7 kwenda kulia. \(x\ \&\ 127\) ni umbo lililofunikwa la biti 7 za chini. Jukumu la kihisabati: Kwa sababu ya sifa ya \(2^7\equiv1\), biti 7 za juu hubeba uzito wa \(2^7\), ambao unaweza kukunjwa kwenda sehemu ya chini chini ya mod 127. Maana ya maunzi: hupunguza hitaji la saketi ya mgawanyo wa matumizi ya jumla; upunguzaji wa moduli hufanywa kwa kujumlisha na operesheni rahisi za biti. Chanzo kinasema elementi huhifadhiwa kama biti 8 katika kumbukumbu, lakini kihisabati biti 7 pekee ndizo zenye maana, na matokeo ya kati ya kuzidisha huhifadhiwa kama biti 16 ili kuzuia overflow.
Kitengo cha aritmetiki kina jumlisha/toa moduli, njia nne sambamba za kuzidisha moduli na lookup table/ROM yenye ingizo 128 kwa kinyume cha kuzidisha. Kulingana na chanzo, muundo huu wa kupata kinyume hutoa ufikiaji wenye ucheleweshaji usiobadilika badala ya saketi ngumu zaidi ya hatua nyingi kama algoriti iliyopanuliwa ya Euclid.
Kwa nini kizuizi cha REG kinahitajika?
Muundo wa REG una vekta mbili za pivot za biti N na rejista za kati kwa operesheni za safu. was_pivot, huruhusu prosesa kuu kuhamisha nafasi za pivot zilizojulikana hapo awali kwenda kwa kiharakishaji. is_pivot, hurekodi pivot zilizogunduliwa katika uendeshaji mpya na hatimaye huzirudisha kwenye mfumo mkuu. Pia kuna bafa za maneno zinazotumiwa wakati wa kubadilisha safu na kuondoa, rejista ya upimaji inayohifadhi kinyume cha pivot, rejista zinazohifadhi koefishienti ya uondoaji, na rejista za anwani/indeksi zinazofuatilia nafasi ndani ya matriki.
Ujumuishaji wa X-HEEP: kwa nini njia za udhibiti na data zinatenganishwa?
Kiharakishaji kimeongezwa kwenye mfumo wa X-HEEP RISC-V kama kifaa cha pembeni cha ramani ya kumbukumbu kilichounganishwa kwa urahisi. Wakati ishara ndogo za udhibiti na ramani za pivot hupitia rejista za MMIO, matriki G yenye data nyingi huhamishwa moja kwa moja kwa DMA kwenda kumbukumbu ya ndani ya kiharakishaji. Hivyo CPU hailazimiki kubeba nakala kubwa za matriki kupitia mtiririko wake wa load/store.
Programu ya dereva ina hatua nne: mwanzoni, PLIC (Platform-Level Interrupt Controller) ukatizaji na vigezo vya uendeshaji husanidiwa; kisha DMA hupakia matriki G na metadata ya pivot huhamishwa kwa maneno ya MMIO ya biti 32; kuharakisha kunapoanzishwa, CPU inaweza kuingia katika hali ya kusubiri ukatizaji kwa amri ya wfi ; baada ya ukatizaji wa kukamilika, matriki iliyopunguzwa hurejeshwa kwa uhamishaji wa DMA wa kurudi, maski za pivot husomwa na rejista za hali hukaguliwa kabla ya kurudi kwenye itifaki ya LESS ya kiwango cha juu.
Mbinu na Matokeo ya Utafiti
Jukwaa la jaribio na tathmini
Vipimo vya maunzi vilifanywa kwenye lengo moja la FPGA: Xilinx Artix-7 xc7a100tftg256-2. Kiharakishaji kimefafanuliwa kama RTL inayoweza kusanifiwa na kuunganishwa ndani ya X-HEEP kama kifaa cha pembeni cha MMIO kilichounganishwa kwa urahisi. Muundo wa aritmetiki wa design hautegemei makro maalumu za aritmetiki za mtengenezaji; hata hivyo, matokeo ya kiasi ya timing, routing, ramani ya BRAM na nguvu yanategemea FPGA iliyochaguliwa, kwa hiyo chanzo kinayazuia matokeo haya ya namba kwa mtiririko wa Artix-7.
Msingi wa programu ni rutini asilia ya RREF inayofanya kazi katika mtiririko uleule wa RISC-V uliopachikwa. Lengo la uundaji ni RV32IM, kiwango cha uboreshaji ni -O2. Idadi za mizunguko zilipimwa kwa cycle counter ya jukwaa kwenye vekta 100 za Known Answer Test (KAT) na wastani ukachukuliwa. Kwa hiyo ulinganisho si dhidi ya CPU ya daraja la kompyuta ya mezani wala prosesa ya seva yenye utendaji wa juu, bali dhidi ya msingi wa programu wa RISC-V uliopachikwa uliotumiwa katika utafiti.
Utendaji katika mwito mmoja wa RREF
| Kiwango cha usalama | Ukubwa wa matriki K×N | Mzunguko wa programu | Mzunguko ulioharakishwa | Kuharakisha |
|---|---|---|---|---|
| Level 1 | 126×252 | 86.814.359 | 4.186.854 | 20,7× |
| Level 3 | 200×400 | 310.933.265 | 15.366.401 | 20,2× |
| Level 5 | 274×548 | 792.047.471 | 37.432.087 | 21,2× |
Jedwali hili linatenga kiini cha RREF pekee. Thamani ya 20–21× haimaanishi kwamba itifaki nzima ya sahihi ya kidijitali imeharakishwa kwa uwiano huo huo. Tofauti hii ni muhimu sana katika tafsiri ya makala.
Gharama ya kuhamisha kwenye maunzi na mzigo wa kiolesura
| Kiwango | Maandalizi | Hesabu | Usomaji wa kurudi | Jumla | Mzigo wa kiolesura |
|---|---|---|---|---|---|
| Level 1 | 5.170 | 4.165.080 | 16.604 | 4.186.854 | %0,52 |
| Level 3 | 6.881 | 15.318.702 | 40.818 | 15.366.401 | %0,31 |
| Level 5 | 8.728 | 37.347.405 | 75.954 | 37.432.087 | %0,23 |
Hatua ya maandalizi inajumuisha usanidi wa DMA, kupakia matriki, usanidi wa ukatizaji na uhamishaji wa metadata ya pivot; usomaji wa kurudi unajumuisha kurejesha matriki, kusoma vekta za pivot na uratibu. Jumla ya mzigo wa ziada uliopimwa katika chanzo ni chini ya %1 katika viwango vyote. Matokeo haya yanaonyesha kwamba katika jukwaa hili maalumu na mpangilio wa njia ya data, mawasiliano ya DMA na ukatizaji hayakuunda kikwazo kipya kinachotawala muda wa ukokotoaji wa RREF.
Kwa nini kuharakisha RREF kwa 21× hakumaanishi kuharakisha mtiririko mzima wa sahihi ya LESS kwa 21×?
Kwa kuwa maunzi huharakisha kiini cha RREF pekee, hashing, udhibiti wa itifaki, operesheni za commitment, ukanonishaji na sehemu nyingine za uhamishaji wa data hubaki kwenye programu; kwa hiyo hutokea kikomo kinachofanana na sheria ya Amdahl, na katika Jedwali 5 la chanzo kuharakisha kwa SIGN/VERIFY kamili hubaki chini ya thamani ya takriban 21× ya kiwango cha kiini.
| Kiwango | Kigezo | SIGN (kCC) | VERIFY (kCC) | ||||
|---|---|---|---|---|---|---|---|
| Asili | Iliyoharakishwa | Kuharakisha | Asili | Iliyoharakishwa | Kuharakisha | ||
| 1 | 252_45 | 4.440.308 | 863.666 | 5,14× | 3.041.298 | 736.529 | 4,13× |
| 1 | 252_68 | 6.722.680 | 1.310.237 | 5,13× | 4.605.871 | 1.136.258 | 4,05× |
| 1 | 252_192 | 19.446.265 | 3.578.328 | 5,43× | 12.742.011 | 3.150.238 | 4,04× |
| 3 | 400_102 | 35.357.406 | 5.225.918 | 6,77× | 25.235.481 | 4.461.652 | 5,66× |
| 3 | 400_220 | 76.216.226 | 11.204.989 | 6,80× | 52.253.304 | 9.556.936 | 5,47× |
| 5 | 548_137 | 81.653.259 | 10.411.290 | 7,84× | 87.116.519 | 8.790.875 | 9,91× |
| 5 | 548_345 | 293.009.449 | 26.151.566 | 11,20× | 219.849.144 | 24.854.080 | 8,85× |
Kulingana na dokezo la chanzo, 1 kCC = 1000 clock cyclena idadi za mizunguko katika jedwali hili zinawakilisha wastani wa uendeshaji 100 wa KAT.
Kutokulingana ndani ya chanzo: Ingawa katika Jedwali 5, kwa SIGN, usanidi wa 548_345 unaonyesha wazi kuharakisha kwa 11,20×, maandishi kabla ya jedwali yanaeleza kuharakisha kwa kiwango cha mfumo katika safu ya “4,0× hadi zaidi ya 9,91×”. Kauli hizi mbili hazilingani kikamilifu. Verianla haibadilishi thamani ya jedwali hapa wala haisahihishi kimya kimya kikomo cha juu katika maandishi.
Hakuna matokeo ya utendaji yaliyoripotiwa kwa KEYGEN. Kwa mujibu wa chanzo, ingawa utengenezaji wa funguo hutumia RREF kihisabati, ni hatua ya usanidi ya mara moja, kwa kawaida ya offline; kwa kuwa kiharakishaji kilichopendekezwa kinalenga hasa mzigo unaorudiwa wa generator_RREF_pivot_reuse katika SIGN na VERIFY, KEYGEN haitumii kiharakishaji.
Udeterministi wa muda na mpaka wa usalama
Chanzo kinaeleza design kwa lengo la tabia ya constant-time kwa sababu mtiririko wa FSM haufanyi matawi ya kawaida ya programu kulingana na elementi za siri za uga. Katika vekta 100 tofauti za KAT, mabadiliko ya idadi ya mizunguko kwa kawaida yalibaki chini ya mizunguko 300; mabadiliko haya ni madogo yakilinganishwa na operesheni zenye mamilioni ya mizunguko. Hata hivyo, waandishi wanasisitiza kwamba hili si uthibitisho wa ustahimilivu dhidi ya uchanganuzi wa nguvu, utoaji wa sumakuumeme au uingizaji wa hitilafu.
Je, kiharakishaji hiki kinaweza kuchukuliwa kuwa kinastahimili mashambulizi ya njia za pembeni za kimwili?
Hapana; ingawa utafiti unaonyesha udeterministi mkubwa wa muda kwa idadi ya mizunguko, hautekelezi hatua za wazi dhidi ya uchanganuzi wa nguvu, uvujaji wa sumakuumeme au uingizaji wa hitilafu, na unaacha tathmini tofauti ya leakage/fault kama kazi ya baadaye kwa ustahimilivu dhidi ya aina hizi za mashambulizi.
Viashirio vya rasilimali za FPGA vina maana gani?
FPGA, ni jukwaa la maunzi linaloweza kupangwa ambalo muundo wake wa mantiki unaweza kusanidiwa upya. LUT (Lookup Table) hutekeleza mantiki msingi ya mchanganyiko. FF (Flip-Flop) huhifadhi hali/rejista katika kiwango cha biti. BRAM (Block RAM) ni blok za kumbukumbu zilizojengwa ndani ya FPGA. DSP blok hutengwa hasa kwa kuzidisha na operesheni sawa za aritmetiki. Kuwa “ndogo” kwa design hakupaswi kutathminiwa kwa idadi ya LUT pekee, bali kwa kiwango ambacho rasilimali hizi hutumiwa pamoja.
Matumizi ya eneo
| Kiwango | Seti ya vigezo | LUT | FF | BRAM | DSP |
|---|---|---|---|---|---|
| Level 1 | 252_45/68/192 | 2892 | 971 | 8 | 0 |
| Level 3 | 400_102/220 | 3398 | 1273 | 32 | 3 |
| Level 5 | 548_137/345 | 4060 | 1598 | 64 | 8 |
Kutokulingana ndani ya chanzo: Jedwali 6 kwa Level 5 linatoa 4060 LUT. Hata hivyo, maandishi ya tathmini ya eneo yaliyo kabla yake hutumia kauli “chini ya 3700 LUT”, huku aya ya kulinganisha inayofuata ikitumia 3649 LUT. Nambari hizi tatu katika chanzo kilekile hazipatani. Katika uwasilishaji huu, nambari hazijaunganishwa; thamani ya 4060 LUT katika jedwali imewasilishwa kama data ya jedwali, na kauli nyingine kama kutokulingana katika maandishi ya chanzo.
Matumizi ya nguvu na masafa ya uendeshaji
| Kiwango | Seti ya vigezo | Nguvu tuli (mW) | Nguvu badilifu (mW) | Jumla (mW) | Masafa (MHz) |
|---|---|---|---|---|---|
| Level 1 | 252_45/68/192 | 92 | 56 | 148 | 78,6 |
| Level 3 | 400_102/220 | 93 | 99 | 191 | 76,2 |
| Level 5 | 548_137/345 | 94 | 132 | 227 | 70,8 |
Kiwango cha usalama kinapoongezeka, ukubwa wa matriki na matumizi ya BRAM na DSP huongezeka, kwa hiyo nguvu badilifu pia huongezeka. Katika utekelezaji wa Artix-7 wa chanzo, thamani ya juu zaidi ya jumla ni 227 mW. Thamani hizi za nguvu ni makadirio ya FPGA baada ya placement-routing; haziwezi kudhaniwa kuwa zilezile kwa familia nyingine ya FPGA, volteji, saa, mpangilio au hali za uendeshaji.
Metriki ya KeSlice inakokotolewaje?
Chanzo hutumia metriki ifuatayo kama Equation (2) ili kuunganisha rasilimali tofauti za FPGA katika kiashirio kimoja cha eneo:
\[\mathrm{eSlice}=\max\left\{\frac{\mathrm{LUT}}{8}+128\times\mathrm{BRAM},\frac{\mathrm{FF}}{16}\right\} \tag{2}\]
Formula inakokotoa nini? Hubadilisha matumizi ya LUT, BRAM na flip-flop kuwa kipimo sawia cha slice na kuchagua gharama ya rasilimali inayotawala. Vigezo: LUT ni idadi ya lookup table zilizotumika, BRAM ni kiasi cha block RAM, na FF ni idadi ya flip-flop. Kitengo: eSlice ni idadi ya slice sawia; eSlice elfu moja huonyeshwa kama KeSlice. Jukumu la kihisabati: istilahi ya kwanza inawakilisha gharama ya LUT na BRAM, na ya pili gharama ya FF; kwa kuchukua kiwango cha juu, kizuizi cha eneo kinachotawala huchaguliwa.
Kwa mfano, zikitumiwa thamani za Jedwali 6 la chanzo kwa Level 5, \(4060/8+64\times128=8699,5\) eSlice; \(1598/16\approx99,875\) eSlice. Thamani ya juu ni takriban 8,6995 KeSlicena hii inalingana na Jedwali 8 la chanzo, ambalo linatoa 8,699 KeSlice. Katika muhtasari wa chanzo pia safu inatolewa kama takriban 1,38–8,7 KeSlice.
Kutokulingana ndani ya chanzo: Katika sehemu ya hitimisho imeandikwa kwamba kiwango cha juu zaidi cha usalama kinatumia “hadi 5,58 KeSlices”. Thamani hii hailingani na kikomo cha juu cha 8,7 KeSlice katika muhtasari, wala na Jedwali 8, ambalo linatoa 8,699 KeSlice, wala na hesabu ya moja kwa moja kutoka Equation (2) na nambari za Jedwali 6. Kwa hiyo 5,58 haijawasilishwa kama thamani moja iliyothibitishwa.
Ulinganisho wa eneo na miundo iliyopo ya FPGA
| Rejea / design | LUT | FF | BRAM | DSP | KeSlice | Masafa (MHz) |
|---|---|---|---|---|---|---|
| [10] CROSS-RSDP-1-b | 27.308 | 11.820 | 57,5 | 0 | 19,0 | 111 |
| Mstari wa [24] DILITHIUM-L2/L3/L5 | 29.998 | 10.366 | 11 | 10 | 8,908 | 96,9 |
| Kundi la [22] LESS Level 1 | 54.800 | 39.900 | 59,5 | 0 | 21,3 | 200 |
| Kundi la [22] LESS Level 3 | 76.700 | 57.900 | 102,5 | 0 | 32,3 | 167 |
| Kundi la [22] LESS Level 5 | 104.300 | 76.700 | 167,5 | 0 | 47,5 | 143 |
| Utafiti huu Level 1 | 2892 | 971 | 8 | 0 | 1,386 | 78,6 |
| Utafiti huu Level 3 | 3398 | 1273 | 32 | 3 | 4,521 | 76,2 |
| Utafiti huu Level 5 | 4060 | 1598 | 64 | 8 | 8,699 | 70,8 |
Ulinganisho huu haupaswi kusomwa kama orodha ya “utekelezaji wa FPGA wenye kasi zaidi”. Chanzo kinasema hasa kwamba design ya [22] ni usanifu unaohamisha LESS nzima kwenye maunzi kwa throughput ya juu, ilhali utafiti huu unaharakisha tu kiini kinachotawala cha RREF ndani ya mtiririko wa programu-maunzi wa RISC-V. Kwa kuwa upeo wa kazi zilizotekelezwa na metriki za latency zilizoripotiwa ni tofauti, ulinganisho wa latency kamili haukufanywa. Jedwali limetumiwa hasa kuonyesha mahali design iliyopendekezwa inaposimama kwenye mhimili wa eneo.
Kazi ya baadaye: ulinzi wa njia za pembeni na uwezo wa kupanuka
Mwelekeo wa kwanza wa kazi ya baadaye wa waandishi ni mashambulizi ya kimwili. Usanifu wa sasa hauna masking ya wazi wala hatua ya kukabiliana na fault. Inapendekezwa kuchunguza operesheni ndogo kama ugunduzi wa pivot, matumizi tena ya pivot yenye masharti, kubadilisha safu, kuondoa nguzo, muundo wa ufikiaji wa kumbukumbu na kupata kinyume kwa LUT kwa upande wa nguvu na uvujaji wa sumakuumeme. Chanzo kinataja mbinu ya masking yenye hisa nyingi katika njia za aritmetiki ya uga wenye kikomo na, kama miundo ya seli inayostahimili glitch, Domain-Oriented Masking (DOM) na Threshold Implementation (TI) kama miongoni mwa mwelekeo wa baadaye unaowezekana.
Mwelekeo wa pili ni uwezo wa kuhamisha usanifu kwenye matatizo mengine yanayotegemea matriki. Kumbukumbu ya benki nne, mtandao wa kupanga/kugeuza anwani na matumizi tena ya pivot yanaweza kurekebishwa kwa mizigo mingine yenye Gaussian elimination nyingi. Chanzo kinatoa mifano ya wagombea wengine wa baada ya quantum wenye mzigo mkubwa wa algebra ya mstari yenye vigezo vingi, kama QR-UOV. Hata hivyo, hili si tokeo la utendaji lililothibitishwa. Nyanja kubwa zaidi zenye kikomo zinaweza kuhitaji njia ngumu zaidi za data za mizunguko mingi badala ya aritmetiki rahisi ya mchanganyiko na inversion ROM; katika matriki kubwa zaidi, kipimo data cha kumbukumbu kinaweza kuwa kikwazo kikuu kipya.
Matokeo yanayoungwa mkono na utafiti
- Katika profaili ya programu ya LESS, kiini cha RREF ndicho gharama inayotawala ya ukokotoaji; %87,73 ya mizunguko ya kusaini ilipimwa katika
generator_RREF_pivot_reusekazi. - Kiharakishaji cha RREF cha njia nne kinachozingatia BRAM kilichopendekezwa, kwenye Artix-7, kilitoa kuharakisha kwa takriban 20–21× kwa mwito mmoja wa RREF.
- Mzigo wa ziada wa offload uliopimwa wa ujumuishaji unaotegemea DMA na ukatizaji ulibaki chini ya %1 katika viwango vyote vitatu vya usalama.
- Katika mtiririko kamili wa SIGN na VERIFY, kuharakisha kwa kiwango cha mfumo kulipatikana; lakini ni chini ya kuharakisha kwa kiini kwa sababu sehemu nyingine za itifaki hazikuhamishwa kwenye maunzi.
- Kwa mujibu wa jedwali za chanzo, kutoka Level 1 hadi Level 5, usanifu ulitumia rasilimali katika safu ya 2892–4060 LUT, 8–64 BRAM na 0–8 DSP.
- Katika jedwali la nguvu la chanzo, nguvu ya jumla iko katika safu ya 148–227 mW.
- Katika vekta 100 za KAT, mabadiliko ya idadi ya mizunguko kubaki kwa kawaida chini ya mizunguko 300 yanaunga mkono udeterministi mkubwa wa muda.
Ujumlishaji usioungwa mkono na utafiti
- Kuharakisha RREF kwa 21× hakumaanishi kwamba itifaki nzima ya LESS huharakishwa kwa 21× katika kila seti ya vigezo.
- Utafiti hauhakikishi matokeo yale yale ya mzunguko, nguvu na masafa kwenye CPU za mezani, prosesa za seva au familia nyingine za FPGA.
- Udeterministi wa muda si uthibitisho wa ustahimilivu dhidi ya uchanganuzi wa nguvu, uchanganuzi wa sumakuumeme au uingizaji wa hitilafu.
- Haijaonyeshwa kwa majaribio kwamba usanifu uliopendekezwa utatoa utendaji uleule kwenye QR-UOV au mipango mingine yenye matriki nyingi.
- Thamani zinazokinzana za 3649/4060 LUT na 5,58/8,699 KeSlice ndani ya chanzo haziwezi kupunguzwa kimya kimya kuwa nambari moja kamili.
- Kutofika kwa LESS katika hatua inayofuata ya mchakato wa ziada wa sahihi za kidijitali wa NIST hakumaanishi kwamba utafiti huu wa maunzi ni utekelezaji wa sahihi uliosanifishwa moja kwa moja.
Dokezo la Chanzo na Mbinu
Utafiti asili: A Lightweight Accelerator for the LESS Digital Signature Scheme
Waandishi: Giuseppe Cutrera, Alessandra Dolmeta, Valeria Piscopo, Maurizio Martina, Guido Masera.
Mpangilio wa waandishi: Mpangilio katika PDF ya chanzo umehifadhiwa. Chanzo hakina alama ya mchango sawa/mwandishi wa kwanza sawa.
Waandishi wa mawasiliano: Alessandra Dolmeta na Valeria Piscopo.
Taasisi: Department of Electronics and Telecommunication (DET), Politecnico di Torino, 10129 Torino, Italy.
Jarida: Cryptography.
Mchapishaji: MDPI, Basel, Switzerland.
Juzuu / toleo / nambari ya makala: 2026, 10(4), 45.
DOI: 10.3390/cryptography10040045.
Kuwasilishwa: 17 Nisan 2026.
Marekebisho: 23 Haziran 2026.
Kukubaliwa: 29 Haziran 2026.
Kuchapishwa: 3 Temmuz 2026.
Aina ya chanzo: Article; ni utafiti wa uhandisi unaowasilisha usanifu asili wa maunzi, ujumuishaji wa mfumo na tathmini ya utendaji/rasilimali za FPGA.
Hali ya mapitio: Cryptography ni jarida la kisayansi linalopitiwa na wenzao na kuchapishwa na MDPI. Katika PDF ya makala tarehe za Received, Revised, Accepted na Published pia zimetolewa kando.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0). Hakimiliki ni za waandishi; MDPI ndiye mwenye leseni kama mchapishaji.
Kiungo rasmi: https://doi.org/10.3390/cryptography10040045
Ufadhili: Waandishi wameripoti kwamba utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Imeelezwa kwamba michango asili ya utafiti ipo ndani ya makala na maswali ya ziada yanaweza kuelekezwa kwa waandishi wa mawasiliano.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi.
Michango ya waandishi: Uundaji wa dhana, metodolojia, utekelezaji, uthibitishaji na upangaji wa data G.C., A.D. na V.P.; uandishi wa rasimu ya kwanza G.C., A.D. na V.P.; mapitio/uhariri na uonyeshaji A.D., V.P., M.M. na G.M.; ushauri ulifanywa na M.M. na G.M.
Mpaka mkuu wa kimetodolojia: Matokeo ya kiasi yameripotiwa kwa lengo la Xilinx Artix-7 xc7a100tftg256-2 na msingi wa programu wa RV32IM uliopachikwa. Hayapaswi kujumlishwa moja kwa moja kwa familia nyingine ya FPGA, prosesa nyingine au hali tofauti za saa/mpangilio.
Mpaka wa usalama: Utafiti haukutathmini ustahimilivu dhidi ya njia za pembeni za kimwili au uingizaji wa hitilafu. Udeterministi wa muda ni kipimo tofauti na si sawa na ustahimilivu dhidi ya uvujaji wa kimwili.
Kutokulingana kwa namba ndani ya chanzo: (1) Jedwali 5 lina thamani ya 11,20× kwa SIGN, huku maandishi ya karibu yakieleza kikomo cha juu kuwa takriban 9,91×. (2) Jedwali 6 na Jedwali 8, kwa Level 5, yanatoa 4060 LUT, huku maandishi ya eneo yakitumia chini ya 3700 na aya inayofuata 3649 LUT. (3) Muhtasari na Jedwali 8 zinaonyesha eneo la Level 5 kuwa takriban 8,7/8,699 KeSlice, huku sehemu ya hitimisho ikiandika 5,58 KeSlice. Verianla haijasahihisha tofauti hizi kimya kimya.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *