


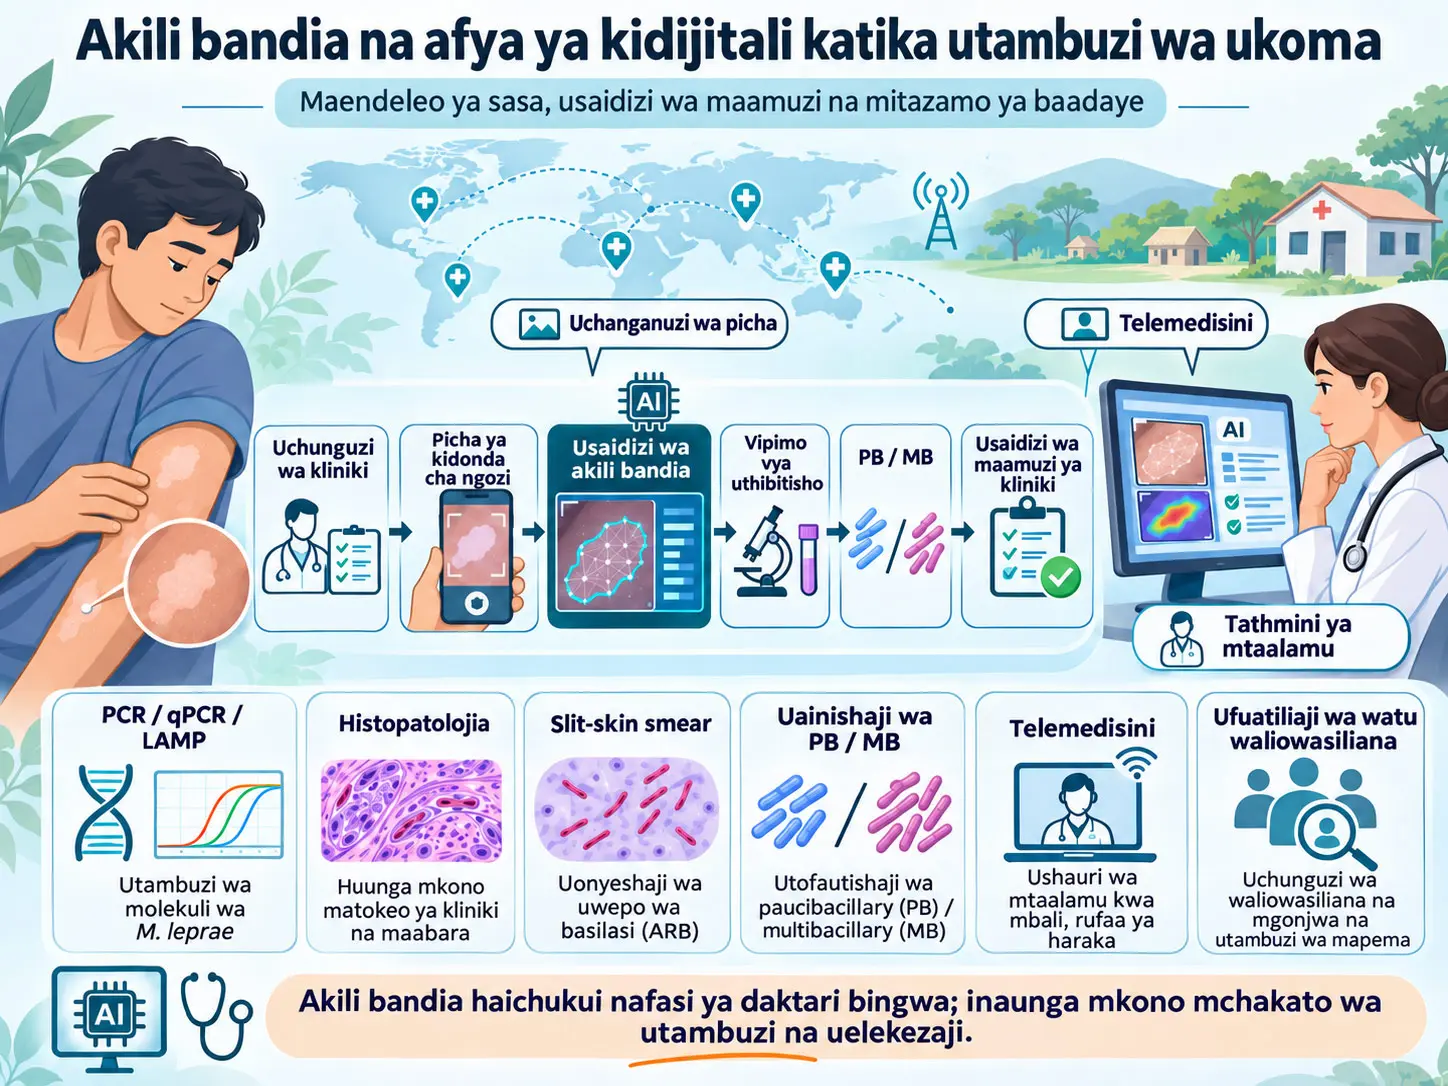
Ukoma (lepra, ugonjwa wa Hansen) ni ugonjwa sugu wa kuambukiza unaohusishwa hasa na Mycobacterium leprae na, mara chache zaidi, Mycobacterium lepromatosis , unaoathiri hasa ngozi na mfumo wa neva wa pembeni. Mapitio haya ya kimasimulizi yaliyopangwa yanatathmini kiwango cha sasa cha ushahidi kuhusu ujifunzaji wa mashine, ujifunzaji wa kina, uoni wa kompyuta, AI ya multimodal, telemedicine na teknolojia za afya ya simu katika utambuzi wa ukoma. Utafiti hautengenezi modeli mpya ya AI wala data mpya za wagonjwa; unatenganisha tafiti zilizochapishwa hapo awali zinazolenga ukoma na ushahidi usio wa moja kwa moja kutoka fasihi ya jumla ya AI katika dermatolojia inapohitajika.
Ujumbe mkuu wa mapitio ni kwamba AI inaweza kuwa zana yenye matumaini ya usaidizi wa maamuzi katika utambuzi wa ukoma, lakini ushahidi uliopo hauungi mkono AI kuchukua nafasi ya tathmini ya kliniki ya mtaalamu. Katika mazingira ya utafiti, baadhi ya modeli zimeripoti accuracy, sensitivity, specificity au AUC za juu; hata hivyo, tafiti hutofautiana kwa kiasi kikubwa katika seti za data, idadi ya wagonjwa, mbinu ya kupata picha, kazi lengwa na namna ya uthibitishaji. Kwa hiyo, viwango vya utendaji vilivyoripotiwa haviwezi kuunganishwa kama “accuracy moja ya AI kwa ukoma”.
Katika mojawapo ya mifano inayolenga ukoma moja kwa moja, mfumo wa de Souza na wenzake unaotegemea random forest na unaotumia rekodi za kliniki na epidemiolojia uliripoti %92,38 accuracy, %93,97 sensitivity na %87,09 specificity katika uainishaji wa paucibacillary na multibacillary. Katika utafiti wa AI4Leprosy, mfumo wa multimodal uliounganisha picha za vidonda vya ngozi na vigezo vya demografia na kliniki uliripoti %90 accuracy na 0,9646 AUC. Katika utafiti wa picha wa Yotsu na wenzake uliojumuisha magonjwa matano ya kitropiki yaliyopuuzwa yanayohusiana na ngozi, kiwango cha jumla cha utabiri sahihi kilikuwa zaidi ya %70 na ResNet-50 ilifanya vizuri kuliko VGG-16. Matokeo ya mwisho si thamani ya utendaji maalumu kwa ukoma pekee.
Nambari hizi haziwezi kulinganishwa moja kwa moja. Utafiti wa kwanza ulitathmini uainishaji wa kiutendaji wa PB/MB kwa data iliyopangwa, wa pili uainishaji wa multimodal wa ukoma kwa picha na data za kliniki, na wa tatu kutofautisha magonjwa matano ya ngozi, ikiwemo ukoma, kutoka kwenye picha. Zaidi ya hayo, kwa kuwa katika Jedwali 1 la mapitio ya chanzo baadhi ya sehemu za uthibitishaji na usanifu wa modeli zina vishikiliaji vya uhariri ambavyo havijakamilika kama “verify in full text” au “architecture to verify”, sehemu hizi hazijakisiwa na Verianla.
Mapitio yanasisitiza kwamba hakuna kipimo kimoja cha maabara chenye sensitivity ya kutosha peke yake katika utambuzi wa ukoma. Tathmini ya kliniki inaweza kutumiwa pamoja na microscopy ya slit-skin smear, histopatholojia, mbinu za molekuli kama PCR/qPCR, vipimo vya serolojia na biomarker. Hasa katika ugonjwa wa paucibacillary (PB) , kiwango cha chini cha bakteria hufanya microscopy ya kawaida na utambuzi wa mapema wa kliniki kuwa mgumu zaidi.
Jukumu linalowezekana zaidi la AI katika muda wa karibu ni kusaidia tathmini ya picha za vidonda vya ngozi, kusaidia uainishaji wa kiutendaji wa PB/MB, kufanya triage ya kesi zisizo wazi, kudhibiti ubora wa picha na kurahisisha rufaa ya teledermatolojia katika maeneo yenye ufikiaji mdogo wa wataalamu. Hata hivyo, uhaba wa seti kubwa za data zilizo na lebo nzuri na zinazojumuisha watu mbalimbali; ukosefu wa uthibitishaji wa nje; upendeleo wa algoriti unaoweza kutokana na rangi ya ngozi, uwakilishi wa kidemografia na hali za upigaji picha; pamoja na matatizo ya uelezekaji na faragha ya data, huzuia matumizi ya kawaida ya kliniki.
Chanzo pia kinabainisha hasa kwamba tafiti zinazolenga ukoma hazikutoa matokeo ya utendaji kulingana na makundi madogo ya rangi ya ngozi. Kwa hiyo, hakuna hitimisho la “AI hufanya vibaya zaidi kwenye ngozi nyeusi” wala “haiathiriwi na rangi ya ngozi” ambalo limethibitishwa na data maalumu za ukoma katika mapitio haya. Hatari hii hujitokeza kama wasiwasi wa kimantiki kutoka fasihi ya jumla ya AI katika dermatolojia na inahitaji uthibitishaji wa prospektivu wa makundi madogo katika ukoma.
Kwa hiyo, utafiti unaweka akili bandia na afya ya kidijitali si kama mfumo wa utambuzi unaojitegemea, bali kama tabaka la usaidizi linalounganisha klinisisti, kipimo cha maabara cha kuthibitisha, telemedicine na mifumo ya rufaa.
Jukumu la Akili Bandia katika Utambuzi wa Ukoma ni Nini?
Katika utambuzi wa ukoma, akili bandia ni tabaka la usaidizi wa kikokotozi linaloweza kutumia mifumo katika picha za kliniki au data za kliniki na epidemiolojia zilizopangwa ili kusaidia utambuzi wa kidonda, uainishaji wa kiutendaji, triage na usaidizi wa maamuzi ya kliniki; ushahidi uliopo unaolenga ukoma unaunga mkono AI kukamilisha, si kuchukua nafasi ya, klinisisti na mbinu za uthibitishaji wa utambuzi.
Kwa nini utambuzi wa mapema wa ukoma ni mgumu?
Muonekano wa kliniki wa ukoma si wa aina moja. Ngozi inaweza kuonyesha maeneo yaliyopungua rangi au yenye erithema, kupoteza hisia, kuhusika kwa neva za pembeni, matatizo ya mwendo, udhaifu wa misuli, kupungua kwa jasho, ngozi kavu, vinundu au kuenea zaidi kwa uvamizi wa ngozi. Tofauti hii huongeza hatari ya kuchanganywa na magonjwa mengine ya ngozi ya uchochezi au ya kuambukiza, hasa katika ugonjwa wa mapema.
Tatizo la pili linalosisitizwa na chanzo ni kipindi kirefu cha incubation. Kwa kuwa dalili za kliniki zinaweza kuonekana muda mrefu baada ya maambukizi, kutambua kesi mapema kunaweza kuwa kugumu zaidi.
Tatizo la tatu ni kutokuwepo kwa kipimo cha maabara kinachotoa sensitivity ya kutosha peke yake katika wigo wote wa ugonjwa. Tathmini ya mwisho ya utambuzi inaweza kutegemea kutathmini pamoja dalili za kliniki, uchunguzi wa bakteria, histopatholojia, mbinu za molekuli na, inapohitajika, biomarker za kinga.
Dalili kuu katika utambuzi wa ukoma
Katika mapitio, msingi wa utambuzi wa kliniki una makundi matatu makuu ya dalili: vidonda vya ngozi vilivyopungua rangi au vyenye erithema vinavyohusishwa na kupoteza hisia, kuhusika kwa neva za pembeni kunakoambatana na matatizo ya hisia au mwendo, na kuonekana kwa basili sugu kwa asidi katika uchunguzi wa slit-skin smear.
Chanzo hakitoi hitimisho kwamba dalili yoyote kati ya hizi imebadilishwa kabisa na uainishaji wa picha wa kiotomatiki. Hasa uchunguzi wa hisia na tathmini ya neva za pembeni ni taarifa za kliniki ambazo haziwezi kupatikana moja kwa moja kutoka picha moja ya ngozi.
Kwa Nini Tofauti kati ya Ukoma wa Paucibacillary na Multibacillary ni Muhimu?
Paucibacillary (PB) na multibacillary (MB) ni makundi mawili yanayotumiwa katika uainishaji wa kiutendaji wa ukoma; katika mapitio haya ugonjwa wa PB ni muhimu hasa kwa sababu kiwango cha chini cha bakteria na dalili za kliniki zisizo wazi sana zinaweza kupunguza sensitivity ya microscopy na mbinu nyingine za utambuzi, na hivyo kufanya utambuzi wa mapema kuwa mgumu zaidi.
Ugonjwa wa Paucibacillary
Katika ugonjwa wa PB, kiwango cha chini cha bakteria kinaweza kufanya uthibitishaji wa kawaida wa bakteria kuwa mgumu zaidi. Chanzo kinasema kwamba microscopy ya slit-skin smear inaweza kuwa na sensitivity ya chini katika ugonjwa wa PB.
Hali hii ni muhimu pia kwa AI. Ikiwa utambuzi wa marejeo wenyewe ni mgumu kupatikana, kutengeneza “lebo sahihi” ambazo modeli ya AI itafundishwa nazo pia huwa kugumu zaidi. Hii ni maelezo ya kimbinu yaliyotolewa na Verianla kutoka matokeo ya chanzo; chanzo hakitoi kiwango kipya cha nambari cha makosa ya lebo.
Ugonjwa wa Multibacillary
Kwa kuwa ugonjwa wa MB unahusishwa na kiwango kikubwa cha bakteria, mbinu za bakteria kama slit-skin smear zinaweza kuwa na manufaa zaidi katika kundi hili. Chanzo kinaripoti kwamba slit-skin smear ina specificity ya juu katika kuthibitisha ugonjwa wa MB na inaweza kubainisha bacterial index.
Je, chanzo kinatoa vizingiti sahihi vya PB/MB?
Mapitio yanazungumzia uainishaji wa kiutendaji wa PB na MB na yanaonyesha madarasa hayo mawili kama hatua ya njia ya utambuzi katika Kielelezo 1. Hata hivyo, matini kuu ya makala hii haiwasilishi vizingiti vya kina vya nambari vya vidonda au neva kwa PB/MB katika mfumo wa jedwali la kufundishia la uainishaji. Kwa hiyo, Verianla haiongezi vizingiti ambavyo havipo katika chanzo kama matokeo ya makala hii.
Microscopy ya slit-skin smear ni nini?
Slit-skin smear ni tathmini ya bakteria ambapo basili sugu kwa asidi hutafutwa kwa microscopy katika nyenzo iliyochukuliwa kutoka ngozi. Mapitio yanasema kwamba mbinu hii hutoa specificity ya juu katika ugonjwa wa MB na husaidia kupima bacterial index, lakini sensitivity inaweza kuwa ya chini katika ugonjwa wa PB.
Utendaji hutegemea kuchukuliwa kwa sampuli inayofaa na wafanyakazi wenye uzoefu. Kwa hiyo, si uwepo wa kiufundi wa mbinu pekee, bali pia ubora wa utekelezaji wake ni sehemu ya uaminifu wa utambuzi.
Kwa nini histopatholojia hutumiwa?
Uchunguzi wa histopatholojia wa biopsy ya ngozi hutoa taarifa za nyongeza kuhusu matokeo kama uchochezi wa granulomatous, kuhusika kwa neva za pembeni na mgawanyo wa basili. Pia inaweza kuchangia mifumo ya histopatholojia/kliniki kama uainishaji wa Ridley–Jopling.
Chanzo pia kinasema kwamba baadhi ya matokeo ya histopatholojia katika ugonjwa wa mapema yanaweza yasiwe mahususi na tafsiri yake huhitaji uzoefu wa dermatopatholojia.
PCR na qPCR hutoa nini?
Polymerase chain reaction (PCR) na quantitative PCR (qPCR) ni mbinu za utambuzi wa molekuli zinazolenga moja kwa moja DNA ya Mycobacterium leprae . Hasa katika kesi za PB zenye kiwango cha chini cha bakteria, ambapo microscopy ya kawaida inaweza kubaki hasi, zina uwezo wa kuongeza usaidizi wa utambuzi.
Hata hivyo, mapitio yanasisitiza kwamba utendaji wa PCR unaweza kutofautiana kulingana na uainishaji wa kliniki, aina ya sampuli, mlolongo lengwa na muundo wa mbinu. Zaidi ya hayo, kwa sababu mbinu za molekuli zinahitaji miundombinu ya kiufundi na gharama, hazipatikani kwa matumizi ya kawaida katika maeneo yote yenye ugonjwa huu.
LAMP ni nini?
Chanzo kinaonyesha LAMP kama mojawapo ya hatua za utambuzi wa molekuli katika Kielelezo 1. LAMP ni kifupi cha “loop-mediated isothermal amplification” na ni mbinu ya ukuzaji wa molekuli inayotegemea kuzidisha asidi nukleiki lengwa katika hali ya joto lisilobadilika. Maelezo haya ni kwa ajili ya kufundisha dhana; mapitio hayaripoti data huru ya utendaji au jaribio jipya la LAMP.
Kikomo cha serolojia ya Anti-PGL-I ni nini?
Mbinu za serolojia zinazolenga kingamwili dhidi ya antijeni ya Phenolic glycolipid-I (PGL-I) zimechunguzwa kwa kutambua kesi au kuainisha hatari kwa watu waliowasiliana na mgonjwa. Hata hivyo, kwa kuwa mwitikio wa kingamwili unahusishwa na kiwango cha bakteria, sensitivity inaweza kuwa ndogo katika ugonjwa wa PB.
Hitimisho muhimu la mapitio ni kwamba kwa sasa hakuna biomarker ambayo peke yake ni kipimo cha utambuzi chenye usahihi wa kutosha katika wigo mzima wa kliniki wa ukoma.
AI ipo wapi katika mtiririko wa utambuzi?
Chanzo hakielezi AI kama “sanduku moja la utambuzi wa kiotomatiki” linalochukua nafasi ya mchakato mzima wa utambuzi baada ya shaka ya kliniki. AI ni zaidi tabaka linaloweza kusaidia uchambuzi wa picha, uainishaji wa kiutendaji, usaidizi wa maamuzi ya kliniki, triage na taratibu za rufaa.
Tofauti hii ni muhimu hasa kwa sababu katika ukoma, taarifa zisizotegemea picha kama uchunguzi wa hisia, tathmini ya neva za pembeni, uchunguzi wa bakteria na uthibitishaji wa molekuli pia ni sehemu za mchakato wa utambuzi.
Telemedicine na afya ya simu zinaweza kutoa nini?
Kupata picha kwa simu janja, teledermatolojia na zana za afya ya simu zinaweza kusaidia tathmini ya mbali ya kesi zinazoshukiwa katika maeneo yenye ufikiaji mdogo wa daktari bingwa.
Mapitio yanachukulia programu ya simu ya WHO Skin NTD kama mojawapo ya mifano ya afya ya kidijitali katika muktadha huu. Maeneo yanayoweza kutumiwa ni pamoja na ushauri wa mbali, kuweka kipaumbele kwa kesi, ufuatiliaji wa epidemiolojia, kufuatilia waliowasiliana na mgonjwa na ufuatiliaji wa matibabu.
Hata hivyo, kuwepo kwa programu si ushahidi wa moja kwa moja wa ufanisi wa kliniki au accuracy ya AI maalumu kwa ukoma. Katika matumizi halisi, uwezo wa kufanya kazi bila mtandao, urahisi wa matumizi, gharama, kushirikiana data, ushirikiano kati ya mifumo na kukamilika kwa mnyororo wa rufaa pia vinapaswa kutathminiwa.
Accuracy, Sensitivity, Specificity na AUC Zinapaswa Kutafsiriwaje?
Accuracy hufupisha uwiano wa jumla wa uainishaji wote sahihi, sensitivity huonyesha ni sehemu gani ya kesi chanya halisi zilizogunduliwa, specificity huonyesha ni sehemu gani ya hasi halisi zilizotengwa kwa usahihi, na AUC hufupisha uwezo wa kutenganisha kati ya sensitivity na false-positive rate katika vizingiti tofauti vya maamuzi; ingawa viwango vya juu vya metrika hizi ni muhimu, havichukui nafasi ya uthibitishaji huru wa nje na uwezo wa kutumika kliniki.
TP, TN, FP na FN zinamaanisha nini?
- TP — True Positive: Mfano ambao kwa kweli ni chanya na modeli imeuainisha kuwa chanya.
- TN — True Negative: Mfano ambao kwa kweli ni hasi na modeli imeuainisha kuwa hasi.
- FP — False Positive: Mfano ambao kwa kweli ni hasi lakini modeli imeuainisha kuwa chanya.
- FN — False Negative: Mfano ambao kwa kweli ni chanya lakini modeli imeuainisha kuwa hasi.
Dokezo muhimu: Milinganyo iliyo hapa chini si milinganyo asilia ya makala ya chanzo. Ni ufafanuzi wa kawaida wa dhana uliotolewa ili kufundisha maana ya metrika za utendaji zilizoripotiwa katika chanzo.
Accuracy — usahihi
Accuracy huonyesha ni sehemu gani ya sampuli zote zimeainishwa kwa usahihi. Hata hivyo, ikiwa madarasa hayana uwiano mkubwa, accuracy ya juu inaweza kupotosha. Kwa mfano, ikiwa sampuli hasi ni nyingi sana, modeli inaweza kupata accuracy ya juu kwa kutabiri kwa usahihi kundi kubwa lakini isiweze kugundua wagonjwa chanya kwa kiwango cha kutosha.
Sensitivity — unyeti
Unyeti huonyesha ni sehemu gani ya sampuli zenye ugonjwa au darasa lengwa kwa kweli zimegunduliwa na modeli. Katika utambuzi, unyeti mdogo unaweza kumaanisha kwamba sehemu muhimu ya wagonjwa halisi inapita bila kutambuliwa.
Specificity — umahususi
Umahususi huonyesha ni sehemu gani ya sampuli ambazo kwa kweli ni hasi zimeainishwa kwa usahihi kuwa hasi. Umahususi mdogo unaweza kusababisha idadi kubwa ya rufaa za chanya za uongo.
AUC ni nini?
AUC ni eneo lililo chini ya mkunjo wa ROC. Mkunjo wa ROC huonyesha uhusiano kati ya true-positive rate na false-positive rate katika vizingiti tofauti vya maamuzi. AUC inapokaribia 1, inaonyesha uwezo wa modeli kutenganisha madarasa katika seti ya data iliyotathminiwa unaongezeka.
Hata hivyo, AUC ya juu haimaanishi kwamba modeli ni muhimu kwa kiwango sawa katika vizingiti vyote vya kliniki. Aidha, modeli hiyo hiyo inaweza kufanya vibaya zaidi katika hospitali mpya, mifumo tofauti ya kamera au idadi tofauti ya watu.
Uthibitishaji wa nje unamaanisha nini?
Uthibitishaji wa nje ni kujaribu modeli katika idadi ya watu au seti ya data huru ambayo haikutumiwa wakati wa kuendeleza modeli. Jaribio hili husaidia kuelewa kama modeli imekariri tu sifa za kituo cha mafunzo au desturi za ukusanyaji wa data.
Katika mapitio, ukosefu wa uthibitishaji wa nje unasisitizwa kama mojawapo ya vikwazo vikuu vya fasihi ya AI kuhusu ukoma.
Kwa nini uthibitishaji wa prospektivu ni wenye nguvu zaidi?
Katika uthibitishaji wa prospektivu, modeli huendelezwa mapema na kisha kutathminiwa katika kesi mpya zinazokutana katika mtiririko halisi wa kliniki. Mpangilio huu unaweza kuwakilisha vizuri zaidi vipengele vya matumizi halisi kama ukusanyaji wa data, tabia ya mtumiaji, mchakato wa rufaa na maamuzi ya kliniki kuliko seti za data za nyuma.
Je, Matokeo ya AI katika Dermatolojia ya Jumla Yanaweza Kuhamishwa Moja kwa Moja kwa Ukoma?
Hapana. Mapitio hutumia matokeo makubwa ya AI katika dermatolojia ya jumla kama ushahidi usio wa moja kwa moja tu kwamba ushirikiano wa binadamu–AI unawezekana; kwa kuwa tafiti za head-to-head za dermatolojisti–AI zinazolenga ukoma hazijajengwa vya kutosha, ongezeko la utendaji lililopatikana katika melanoma au magonjwa mengine ya ngozi haliwezi kutumiwa kwa kiasi kwa utambuzi wa ukoma.
Kwa nini mfano wa PanDerm ni ushahidi usio wa moja kwa moja?
Makala inanukuu kutoka tathmini pana ya dermatolojia ya 2025 kwamba kwa foundation model ya multimodal iitwayo PanDerm kulikuwa na tofauti ya %10,2 dhidi ya klinisisti katika kugundua melanoma mapema, ongezeko la %11 katika accuracy ya klinisisti kwenye uainishaji wa saratani ya ngozi kwa dermoscopy, na ongezeko la %16,5 katika utendaji wa klinisisti wasio dermatolojisti katika utambuzi tofauti wa magonjwa 128 ya ngozi.
Hata hivyo, PanDerm si modeli iliyothibitishwa kwa ukoma. Nambari hizi haziwezi kutumiwa kama makadirio ya utendaji wa utambuzi wa ukoma.
Zaidi ya hayo, matini ya chanzo hutaja matokeo ya PanDerm kwa rejea [19], ilhali katika orodha ya marejeo [19] ni makala ya foundation-model ya Moor na wenzake ya 2023; rekodi ya 2025 ya Nature Medicine inayohusiana moja kwa moja na PanDerm imeorodheshwa kama [21]. Verianla haisahihishi kimya kimya kutolingana huku kwa namba za marejeo ndani ya chanzo.
Je, AI Inaweza Kuchukua Nafasi ya Daktari Bingwa?
Kulingana na mapitio haya, hapana; ushahidi uliopo wa ukoma unaunga mkono AI si kama mfumo wa utambuzi unaojitegemea unaochukua nafasi ya tathmini ya mtaalamu, bali kama teknolojia saidizi ya usaidizi wa maamuzi ya kliniki, triage, uainishaji wa kiutendaji na kurahisisha ufikiaji wa huduma za kitaalamu.
Kwa nini ushahidi hautoshi kwa utambuzi unaojitegemea?
Kwanza, idadi ya tafiti zilizopo zinazolenga ukoma na utofauti wa data ni mdogo. Pili, kazi za utafiti hutofautiana: baadhi ya modeli hufanya uainishaji wa PB/MB, baadhi uainishaji wa ukoma, na nyingine hufanya kazi ya kutofautisha magonjwa mengi ya ngozi.
Tatu, uthibitishaji wa nje na wa prospektivu ni mdogo. Utendaji mkubwa wa modeli katika seti yake ya maendeleo hauhakikishi matokeo yale yale katika eneo jingine la kijiografia, kifaa tofauti cha kamera au utendaji tofauti wa kliniki.
Nne, utambuzi wa ukoma haujumuishi taarifa za kuona pekee. Aina tofauti za data kama kupoteza hisia, kuhusika kwa neva za pembeni, matokeo ya bakteria, histopatholojia na matokeo ya molekuli zinahitaji kutafsiriwa pamoja kliniki.
Automation bias ni nini?
Automation bias ni hatari ya mhudumu wa afya kuamini kupita kiasi pendekezo la mfumo wa kiotomatiki na kuweka tathmini yake ya kliniki nyuma. Mapitio yanapendekeza kwamba tafiti zijazo za human–AI reader studies zitathmini ikiwa AI huongeza utendaji wa wahudumu wa afya wa mstari wa mbele na ikiwa pia huunda automation bias.
Je, upendeleo wa algoriti unaweza kuhusiana na rangi ya ngozi?
Unaweza; lakini chanzo kinaweka kikomo cha tahadhari sana hapa. Rangi na pigmenti ya ngozi ni chanzo kinachowezekana cha distribution shift na utendaji tofauti katika modeli za picha. Hata hivyo, tafiti za msingi zinazolenga ukoma katika mapitio hazitoi matokeo ya utendaji yaliyotenganishwa kwa rangi ya ngozi.
Kwa hiyo, data zilizopo za ukoma hazionyeshi wala kwamba kutokuwa sawa kwa utendaji kunakotokana na pigmenti kunatokea, wala kwamba hakutokei. Suala hili linahitaji tathmini ya prospektivu ya makundi madogo katika idadi tofauti ya watu wenye ukoma.
Kwa nini Explainable AI ni muhimu?
AI inayoelezeka inalenga kumsaidia klinisisti kuelewa vizuri modeli ilitegemea finding au muundo gani wa data ili kutoa pendekezo fulani. Katika matumizi ya afya, sifa hii si udadisi wa kiufundi tu, bali ni muhimu kwa uaminifu, uchunguzi wa makosa, usalama wa mgonjwa na usimamizi wa udhibiti.
Chanzo kinataja uendelezaji wa modeli kwa uwazi, uelezekaji, fairness, faragha ya mgonjwa, ridhaa yenye taarifa, usimamizi salama wa data na uangalizi wa kliniki kama maeneo muhimu kwa AI ya kuaminika.
Mbinu na Matokeo ya Utafiti
Mapitio yaliendeshwaje?
Waandishi wanaeleza utafiti kama “structured narrative review”. PubMed/MEDLINE ilitumika kama hifadhidata kuu ya kibibliografia.
Katika utafutaji wa PubMed, upande wa ukoma uliunganisha “leprosy”, “Hansen disease” au “Mycobacterium leprae”; upande wa teknolojia uliunganisha “artificial intelligence”, “machine learning”, “deep learning”, “convolutional neural network”, “computer vision”, “foundation model”, “digital health”, “telemedicine”, “mobile health” au “clinical decision support”.
Utafutaji ulisasishwa mara ya mwisho tarehe 17 Agosti 2026. Pia ulifanywa utafutaji maalumu kwenye tovuti za wachapishaji na vyanzo vya WHO kuhusu utambuzi wa ukoma na matumizi ya afya ya kidijitali; orodha za marejeo za mapitio na tafiti za msingi zinazofaa zikakaguliwa kwa machapisho ya ziada.
Utafutaji maalumu wa ziada ulifanywa pia kwa utambuzi wa molekuli, biomarker, uthibitishaji wa nje, upendeleo wa algoriti na ulinganisho wa utambuzi wa binadamu–AI.
Ni machapisho gani yalipewa kipaumbele?
Kipaumbele kilitolewa kwa tafiti za msingi zilizopitiwa na wataalamu ambazo zilitathmini moja kwa moja matumizi ya AI au afya ya kidijitali katika ukoma. Katika maeneo yenye ushahidi mdogo wa msingi, mapitio ya kimfumo au ya scoping na miongozo yenye mamlaka yalitumika.
Tafiti zinazoshughulikia uainishaji wa utambuzi, uainishaji wa kiutendaji, uchambuzi wa picha, teledermatolojia, usaidizi wa maamuzi ya kliniki, ujumuishaji wa molekuli/biomarker, uthibitishaji wa nje au matatizo ya utekelezaji zilikubalika.
Tafiti za zamani zilihifadhiwa tu ikiwa zilitoa ushahidi wa msingi katika telemedicine ya ukoma au utambuzi wa mbali.
Kwa nini meta-analysis haikufanywa?
Waandishi wanasema kwamba kazi za kliniki, seti za data, ufafanuzi wa matokeo na metrika za utendaji hutofautiana kwa kiasi kikubwa kati ya tafiti. Kwa sababu ya heterojenia hii, meta-analysis ya kiasi haikuonekana kufaa na matokeo yaliunganishwa kwa njia ya kimasimulizi.
Uamuzi huu pia unaonyesha kwamba metrika tofauti za modeli hazipaswi kubadilishwa moja kwa moja kuwa namba moja iliyounganishwa ya utendaji.
Ulinganisho wa tafiti za AI zilizotumika moja kwa moja katika ukoma
| Utafiti | Kazi | Data | Modeli / mbinu | Utendaji mkuu ulioripotiwa katika chanzo | Kikomo cha tafsiri |
|---|---|---|---|---|---|
| de Souza na wenzake (2021) | Uainishaji wa kiutendaji wa PB / MB | Rekodi za kliniki na epidemiolojia za SINAN Brazil | Random forest na programu ya cross-platform ya usaidizi wa maamuzi | Accuracy %92,38; sensitivity %93,97; specificity %87,09 | Katika jedwali la mapitio ya chanzo, maelezo ya denominator na uthibitishaji wa nje yameachwa na vishikiliaji vya “verify”. |
| Barbieri na wenzake (2022), AI4Leprosy | Uainishaji wa ukoma kwa taarifa za kliniki na picha ya kidonda | Picha 1229 za ngozi kutoka washiriki 222; seti 585 za metadata | Multimodal AI | Accuracy %90; AUC 0,9646 | Chanzo kimeacha usanifu wa modeli katika Jedwali 1 kama “architecture to verify”; Verianla haitungi maelezo ya usanifu. |
| Yotsu na wenzake (2023) | Uainishaji wa picha wa NTD tano za ngozi ikiwemo ukoma | Picha 1709 za wagonjwa 506 kutoka magonjwa matano | ResNet-50 na VGG-16 | Utabiri sahihi wa jumla zaidi ya %70; ResNet-50 bora kuliko VGG-16 | Utendaji ni wa magonjwa yote matano kwa pamoja; si accuracy ya ukoma pekee. |
Modeli ya de Souza na wenzake ilifanya nini?
Utafiti huu uliangalia kazi tofauti na kujaribu kutambua wagonjwa wa ukoma moja kwa moja kwa kuangalia picha pekee. Lengo lilikuwa kusaidia uainishaji wa kiutendaji wa paucibacillary na multibacillary kwa kutumia rekodi za kliniki na epidemiolojia.
Random forest ni mbinu ya ujifunzaji wa mashine inayounganisha miti mingi ya maamuzi na kutoa uainishaji wa pamoja kutoka matokeo ya kila mti. Hapa, mapitio ya chanzo hayatoi tena kwa kina hyperparameter za modeli au hatua zote za maandalizi ya data.
%92,38 accuracy, %93,97 sensitivity na %87,09 specificity zilizoripotiwa ni utendaji wa utafiti wenye matumaini. Hata hivyo, haiwezi kuhitimishwa kwamba viwango hivi vitaonekana vivyo hivyo katika nchi nyingine au katika mitiririko huru ya kliniki.
Kwa nini AI4Leprosy ni multimodal?
Utafiti wa AI4Leprosy uliunganisha picha ya kliniki na vigezo vya demografia na kliniki badala ya kutumia picha ya ngozi pekee. Kwa hiyo, chanzo kinauchukulia kama utafiti wa multimodal AI.
Mapitio ya chanzo yanaripoti picha 1229 za ngozi kutoka washiriki 222 na seti 585 za metadata, na kutoa %90 accuracy na 0,9646 AUC kwa modeli.
Hata hivyo, chanzo kimeacha usemi “architecture to verify” badala ya kueleza usanifu wa modeli kwa uhakika katika Jedwali 1. Kwa hiyo Verianla haikamilishi tabaka za CNN, optimizer, loss function au maelezo mengine ya kiufundi ya usanifu ambayo hayajathibitishwa katika chanzo.
Kwa nini matokeo ya Yotsu na wenzake yanapaswa kusomwa kwa tahadhari?
Utafiti wa Yotsu na wenzake haukuainisha seti ya data iliyojumuisha ukoma pekee. Umetumia jumla ya picha 1709 za wagonjwa 506 kutoka madarasa matano tofauti ya neglected tropical disease zinazohusiana na ngozi.
Mapitio ya chanzo yanatoa matokeo ya “zaidi ya %70 utabiri sahihi” kwa kazi yote ya madarasa mengi. Kuandika upya kiwango hiki kama “zaidi ya %70 accuracy katika utambuzi wa ukoma” si sahihi kisayansi.
Kwa nini utendaji wa tafiti hizi tatu haupaswi kupangwa kwa ubora?
Si sahihi kuweka %92,38, %90 na zaidi ya %70 kando kando na kupanga “modeli ya kwanza ndiyo bora zaidi”. Modeli zimetathmini kazi tofauti, idadi tofauti za watu na aina tofauti za data.
Aidha, accuracy, sensitivity, specificity na AUC si dhana moja ya utendaji. AUC ya modeli moja haiwezi kulinganishwa moja kwa moja kwa ubora wa kiasi na accuracy ya modeli nyingine.
Je, mbinu ya foundation model imethibitishwa katika ukoma?
Hapana. Chanzo kinazungumzia uwezo wa siku zijazo wa foundation model kubwa za multimodal kuunganisha picha za kliniki, dermoscopy, histopatholojia, matini na data za kliniki zilizopangwa katika uwakilishi mmoja.
Hata hivyo, kinasema wazi kwamba manufaa ya kliniki ya foundation model maalumu kwa ukoma bado hayajaonyeshwa.
Ujumuishaji wa data za multimodal unaopendekezwa kwa siku zijazo
Chanzo kinajadili kwamba katika siku zijazo picha za ngozi zilizosawazishwa zinaweza kuunganishwa na matokeo ya hisia, tathmini ya neva za pembeni, vipimo vya molekuli, biomarker za mwitikio wa mwenyeji na data za ufuatiliaji wa muda mrefu.
Muundo huu si zana ya kliniki iliyothibitishwa kwa sasa. Waandishi wanaona ni muhimu kupima kwa njia ya prospektivu kama aina za ziada za data kwa kweli hutoa manufaa zaidi kuliko klinisisti peke yake au modeli rahisi zaidi.
Uwezo wa ujumuishaji wa PCR/qPCR na AI
Vipimo vya molekuli hutoa tabaka la taarifa tofauti na mwonekano wa kimofolojia wa ngozi. Hasa katika ugonjwa wa PB wenye kiwango kidogo cha bakteria, kuongeza ushahidi wa molekuli kwenye picha na data za kliniki kunaweza kinadharia kupunguza kutokuwa na uhakika wa utambuzi.
Mapitio yanaeleza mbinu hii kama mwelekeo wa baadaye unaopaswa kuchunguzwa. Bado haijaonyeshwa kwa njia ya prospektivu kwamba mifumo jumuishi huongeza tija ya utambuzi, hupunguza muda hadi utambuzi, huboresha utabiri wa kuendelea kwa ugonjwa au uainishaji wa hatari kwa waliowasiliana na mgonjwa.
Mifumo ya afya ya kidijitali inapaswa kutathminiwa kwa vipimo gani vya maisha halisi?
Chanzo kinasisitiza kwamba accuracy au AUC pekee haitoshi. Katika tafiti za utekelezaji, vipimo vya huduma za afya za maisha halisi kama urahisi wa matumizi, uwezo wa kufanya kazi bila mtandao, ushirikiano kati ya mifumo, gharama-ufanisi, kukamilika kwa rufaa, muda hadi matibabu na usawa pia vinapaswa kutathminiwa.
Nguvu za utafiti
- Unatenganisha wazi ushahidi wa AI unaolenga ukoma na ushahidi wa AI katika dermatolojia ya jumla.
- Hautazami utambuzi kama uainishaji wa picha pekee, bali unautathmini pamoja na tabaka za kliniki, bakteria, histopatholojia na molekuli.
- Unafanya changamoto maalumu ya utambuzi wa ugonjwa wa PB kutokana na kiwango kidogo cha bakteria ionekane wazi.
- Hautathmini utendaji wa modeli kwa accuracy pekee; pia unaibua uthibitishaji wa nje, calibration na utendaji wa makundi madogo.
- Unajadili masuala ya fairness kama pigmenti ya ngozi na uwakilishi wa kidemografia.
- Unaingiza telemedicine, afya ya simu na mnyororo wa rufaa katika mjadala wa AI.
- Unaeleza wazi kwamba AI inapaswa kulenga usaidizi wa maamuzi, si kuchukua nafasi ya daktari bingwa.
Vikwazo vya utafiti
- Utafiti ni mapitio ya kimasimulizi; si meta-analysis ya kimfumo.
- PubMed/MEDLINE ndiyo hifadhidata kuu; wigo hauko katika kiwango cha mapitio rasmi ya kimfumo yanayotafuta hifadhidata zote za kisayansi kwa ukamilifu.
- Tafiti zilizojumuishwa ni heterojeni kwa kazi, aina ya data na kipimo cha utendaji.
- Idadi ya tafiti za msingi za AI zinazolenga ukoma ni ndogo.
- Uthibitishaji huru wa nje na wa prospektivu kwa ujumla hautoshi.
- Jedwali 1 lina kauli za uhariri ambazo hazijakamilika kama “verify in full text”, “architecture to verify” na “denominator to verify”.
- Mapitio hayatoi data ya utendaji wa AI ya ukoma iliyotenganishwa kwa rangi ya ngozi.
- Matokeo ya PanDerm kutoka dermatolojia ya jumla hayawezi kuhamishwa moja kwa moja kwa ukoma.
- Kuna tatizo la ulinganifu ndani ya chanzo kati ya namba ya marejeo katika paragrafu ya PanDerm na rekodi inayohusika katika orodha ya marejeo.
- Utafiti hauendelezi modeli mpya ya AI wala kufanya uthibitishaji wa prospektivu katika kohorti mpya ya wagonjwa.
- Vipindi vya kuaminika vya pamoja au vipimo vya makosa vya pamoja havijatolewa katika tafiti zote kwa metrika za utendaji.
- Thamani za model calibration hazijaripotiwa kwa kiasi katika tafiti zote za msingi.
- Uwezekano wa kiuchumi na matokeo halisi ya rufaa za kliniki bado hayajathibitishwa vya kutosha.
Matokeo yanayoungwa mkono na yasiyoungwa mkono na utafiti
| Utafiti unaunga mkono | Utafiti hauungi mkono |
|---|---|
| AI inaweza kusaidia usaidizi wa maamuzi, triage na uainishaji wa kiutendaji katika ukoma. | Kwamba AI ni mfumo wa utambuzi wa ukoma unaojitegemea unaoweza kuchukua nafasi ya klinisisti. |
| Baadhi ya modeli maalumu za ukoma zimeripoti utendaji mkubwa katika seti za data za utafiti. | Kwamba utendaji huo utakuwa sawa katika nchi na mifumo yote ya afya. |
| Data za multimodal zinaweza kutoa taarifa za ziada kuliko aina moja ya data. | Kwamba manufaa ya kliniki ya ujumuishaji wa picha + kliniki + molekuli + biomarker yamethibitishwa katika ukoma. |
| Ugonjwa wa PB unaweza kuwa mgumu zaidi kutambua kwa sababu ya kiwango kidogo cha bakteria. | Kwamba AI imeweza kutatua tatizo la PB peke yake. |
| Pigmenti ya ngozi ni chanzo kinachowezekana cha distribution shift kwa AI. | Kwamba kutokuwa sawa kwa utendaji katika rangi fulani za ngozi katika modeli za AI za ukoma kumethibitishwa na mapitio haya. |
| Telemedicine na afya ya simu zinaweza kusaidia ufikiaji wa huduma za kitaalamu. | Kwamba programu za simu zinaondoa hitaji la kipimo cha kuthibitisha au uchunguzi wa mtaalamu. |
| Foundation model za dermatolojia ya jumla hutoa ushahidi usio wa moja kwa moja kwamba ushirikiano wa binadamu–AI unawezekana. | Kwamba PanDerm ni modeli ya utambuzi iliyothibitishwa kwa ukoma. |
| Uthibitishaji wa nje na wa prospektivu ni muhimu kwa uhamishaji kwenda kliniki. | Kwamba accuracy au AUC ya juu peke yake inathibitisha mafanikio ya kliniki katika maisha halisi. |
Vipaumbele vya utafiti wa baadaye
Waandishi wanaweka ushirikiano wa vituo vingi, seti za data za kliniki zilizosawazishwa, uthibitishaji wa nje wa prospektivu, utoaji wa taarifa kwa uwazi na AI inayoelezeka miongoni mwa vipaumbele vikuu.
Kutathmini tofauti utendaji wa makundi madogo katika pigmenti tofauti za ngozi, idadi tofauti za watu wa maeneo yenye ukoma na mazingira tofauti ya huduma za afya ni muhimu kwa mtazamo wa fairness.
Katika modeli za AI, si discrimination pekee bali pia calibration na uncertainty estimation vinapaswa kutathminiwa. Kama kiwango cha utabiri sahihi wa modeli kilivyo muhimu, uwezo wake wa kuonyesha kwa kuaminika wakati haina uhakika ni muhimu pia kwa usalama wa kliniki.
Prospektiv human–AI reader studies zinapaswa kulinganisha utendaji wa AI pekee, klinisisti pekee na klinisisti anayesaidiwa na AI ili kupima mchango halisi wa mfumo.
Lengo la mwisho si zana iliyotengwa ambapo AI humtangaza mgonjwa kiotomatiki kuwa “chanya/hasi”; bali mfumo salama wa usaidizi wa maamuzi ya kliniki unaounganisha kesi inayoshukiwa na kipimo kinachofaa cha kuthibitisha na huduma ya mtaalamu.
Hitimisho kuu la kisayansi la mapitio
Hitimisho kuu la mapitio haya si kwamba “AI hutambua ukoma vizuri kuliko binadamu”. Tafiti zilizopo zinazolenga ukoma zinaonyesha utendaji wenye matumaini katika mazingira ya utafiti; hata hivyo, seti za data ni ndogo au finyu, kazi ni heterojeni na uthibitishaji huru wa prospektivu hautoshi.
Mbinu inayoweza kutetewa zaidi ni AI kutumia picha za ngozi, data za kliniki na mitiririko ya afya ya kidijitali kuwasaidia wahudumu wa afya wa mstari wa mbele, na kuelekeza kesi zisizo wazi au zinazoshukiwa kwenye mbinu za maabara za kuthibitisha na tathmini ya kliniki ya mtaalamu.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Artificial Intelligence and Digital Health in the Diagnosis of Leprosy: Current Advances and Future Perspectives
Waandishi: Gerardo Rivera; Raúl Rubio; Luis Rodríguez; Josefina Rodríguez; Augusto Salinas; David Orozco; Francisco González; María Moreno.
Mwandishi wa mawasiliano: María Moreno.
Mchango sawa: Chanzo hakijataja uandishi mwenza wa kwanza au taarifa ya mchango sawa.
Taasisi 1: Academic Department and Cardiovascular Tissue Bank, Faculty of Medicine, University of Monterrey (UDEM), Monterrey, Nuevo Leon, Mexico.
Taasisi 2: Center for Interdisciplinary Studies and Research, Autonomous University of Coahuila (UAdeC), Saltillo, Coahuila, Mexico.
Taasisi 3: Mexican Social Security Institute (IMSS), Monterrey, Nuevo Leon, Mexico.
Jarida: Acta Microbiologica Hellenica.
Mchapishaji: MDPI kwa niaba ya Hellenic Society for Microbiology.
Aina ya chanzo: Review; kwa maelezo ya mbinu ya waandishi, structured narrative review.
Rekodi ya kibibliografia: Acta Microbiologica Hellenica, 2026, 71(4), Article 44.
DOI: 10.3390/amh71040044
Kiungo rasmi: Rekodi ya mchapishaji kupitia DOI 10.3390/amh71040044.
Mfuatano wa muda wa uchapishaji: Received: 31 Agosti 2026; Revised: 16 Oktoba 2026; Accepted: 20 Oktoba 2026; Published: 22 Oktoba 2026.
Academic Editor: Tomislav S. Kostyanev.
Hali ya mapitio ya kitaalamu: Review iliyochapishwa; Acta Microbiologica Hellenica ni jarida la mikrobiolojia ya tiba linalopitiwa na wataalamu na lenye ufikiaji wazi.
Leseni: Creative Commons Attribution (CC BY).
Hali ya preprint: Chanzo kilichochunguzwa ni toleo la jarida lililochapishwa; chanzo hakijataja kitambulisho tofauti cha preprint.
Mbinu ya kutafuta fasihi: PubMed/MEDLINE kama hifadhidata kuu; utafutaji maalumu kwenye tovuti za wachapishaji na vyanzo vya WHO; ukaguzi wa marejeo ya tafiti zinazofaa; utafutaji maalumu wa ziada kwa utambuzi wa molekuli, biomarker, uthibitishaji wa nje, upendeleo wa algoriti na ulinganisho wa binadamu–AI.
Sasisho la mwisho la utafutaji: 17 Agosti 2026.
Meta-analysis: Haikufanywa. Waandishi walisema kwamba meta-analysis ya kiasi haikufaa kwa sababu ya heterojenia katika kazi za utafiti, seti za data, ufafanuzi wa matokeo na metrika za utendaji.
Data mpya za majaribio: Hakuna.
Modeli mpya ya AI: Hakuna.
Mlinganyo wa kisayansi wenye namba katika chanzo: Hakuna. Milinganyo ya accuracy, sensitivity na specificity imetolewa katika Verianla kama maelezo ya kufundishia ya metrika zilizotumiwa katika chanzo pekee.
Tafiti kuu za ukoma-AI: de Souza na wenzake (2021), Barbieri na wenzake / AI4Leprosy (2022) na Yotsu na wenzake (2023).
Dokezo la uhariri la Jedwali 1 la chanzo: Katika baadhi ya seli, misemo “denominator to verify”, “architecture to verify” na “verify in full text” inaonekana katika chanzo kilichochapishwa. Sehemu hizi hazijajazwa kwa kukisiwa na Verianla.
Dokezo la rejea ya PanDerm: Makala inatumia namba [19] katika paragrafu ya utendaji wa PanDerm; katika orodha ya marejeo [19] ni Moor na wenzake (2023), wakati rekodi ya 2025 ya Nature Medicine inayohusiana moja kwa moja na PanDerm inaonekana kama [21] Yan na wenzake. Ulinganifu huu wa rejea ndani ya chanzo haujabadilishwa kimya kimya.
IRB: Haitumiki; utafiti ni mapitio ya kimasimulizi ya fasihi iliyochapishwa hapo awali na inayopatikana kwa umma.
Ridhaa yenye taarifa: Haitumiki.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Wakati sehemu ya mbinu inasema data zilizochambuliwa zinapatikana katika machapisho yaliyorejelewa, Data Availability Statement ya mwisho inasema data ghafi zinazounga mkono matokeo ya makala zinapatikana kutoka kwa waandishi kwa ombi. Verianla inarekodi kauli zote mbili bila kuzibadilisha.
Migongano ya maslahi: Waandishi hawakuripoti migongano ya maslahi.
Conceptualization: María Moreno na Gerardo Rivera.
Methodology: Gerardo Rivera, María Moreno na Luis Rodríguez.
Software: Raúl Rubio na Augusto Salinas.
Validation: Gerardo Rivera, Josefina Rodríguez na David Orozco.
Formal analysis: Gerardo Rivera, María Moreno na Francisco González.
Investigation: Gerardo Rivera, María Moreno, Raúl Rubio, Luis Rodríguez, Josefina Rodríguez, Augusto Salinas, David Orozco na Francisco González.
Resources: María Moreno na Francisco González.
Data curation: Gerardo Rivera, Luis Rodríguez na Josefina Rodríguez.
Writing — original draft: Gerardo Rivera na María Moreno.
Writing — review & editing: María Moreno, Gerardo Rivera, Raúl Rubio, Luis Rodríguez, Josefina Rodríguez, Augusto Salinas, David Orozco na Francisco González.
Visualization: Gerardo Rivera na David Orozco.
Supervision: María Moreno na Raúl Rubio.
Project administration: María Moreno.
Funding acquisition: María Moreno.
Dokezo la Acknowledgment: Chanzo kinasema kwamba waandishi walipitia na kuhariri matokeo na wakachukua wajibu wa maudhui yaliyochapishwa; hakikutaja zana mahususi ya akili bandia au maelezo ya matumizi yake.
Kikomo kikuu cha tafsiri: Utendaji wa utafiti wa modeli za AI zinazolenga ukoma si ushahidi wa ufanisi wa kliniki katika ulimwengu halisi wala wa uwezo wa kuchukua nafasi ya daktari bingwa. Matokeo ya AI ya dermatolojia ya jumla hayapaswi kuhamishwa kwa kiasi kwenda kwenye ukoma.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *