


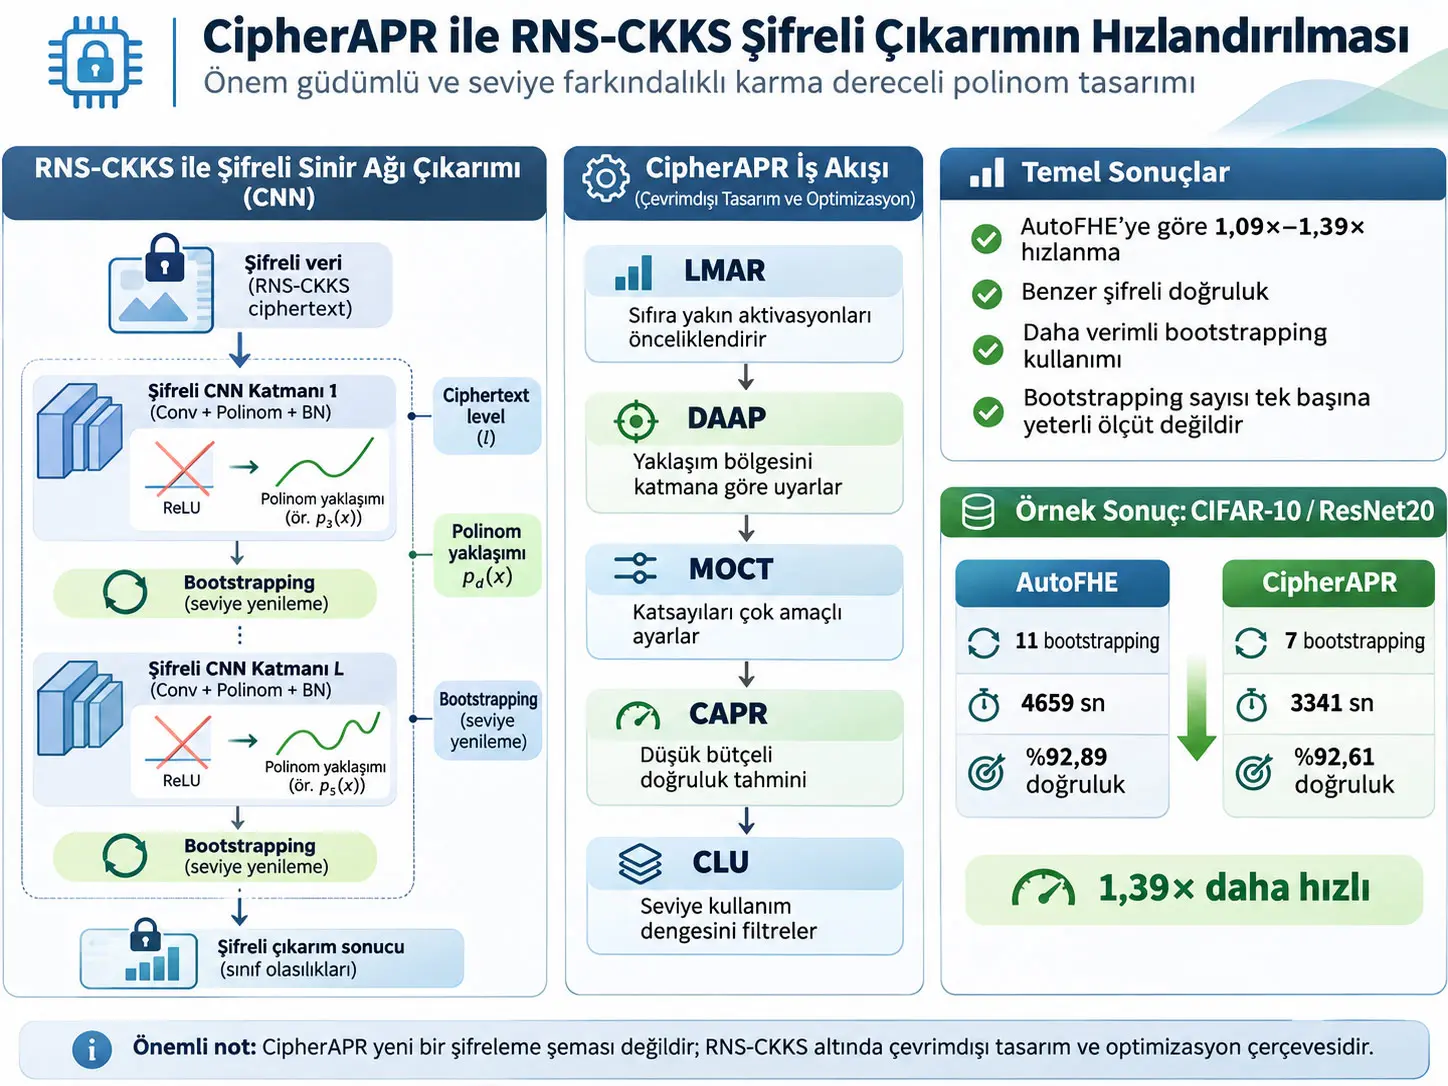
CipherAPR, RNS-CKKS tabanlı tamamen homomorfik şifreleme altında çalışan sinir ağlarında ReLU aktivasyonlarının yerine kullanılacak polinomların derecelerini katman bazında seçen ve bu seçimi ciphertext-level kullanımını dikkate alarak yapan çevrimdışı bir karma-dereceli polinom tasarım çerçevesidir. Çalışmanın temel problemi, yüksek dereceli ReLU yaklaşımlarının doğruluğu korurken daha fazla multiplicative depth tüketmesi ve pahalı bootstrapping işlemlerini artırmasıdır. CipherAPR yalnız bootstrapping sayısını azaltmaya çalışmaz; bootstrapping sonrasında geri yüklenen ciphertext seviyelerinin gerçekten ne kadar verimli kullanıldığını da tasarım kararına dahil eder.
Çerçevenin dört temel bileşeni vardır. Low-Magnitude Activation Ratio (LMAR), girdileri ReLU'nun sıfır çevresindeki kritik bölgesinde yoğunlaşan aktivasyon katmanlarını belirleyerek daha yüksek derece verilmesi gereken katmanlara öncelik sağlar. Domain-Adaptive Approximation (DAAP), her katmanın gözlenen aktivasyon aralığına uygun polinom yaklaşıklaştırma bölgesi kurar. Multi-Objective Coefficient Tuning (MOCT), yaklaşım hatasını azaltırken katsayı büyüklüğü ve dış-bölge davranışını da kontrol etmeye çalışır. Ciphertext-Level Utilization (CLU) ise bootstrapping segmentlerinde geri yüklenen level bütçesini dengesiz kullanan aday yapılandırmaları arama sürecinde geri plana iter.
Çalışmada CIFAR-10 ve CIFAR-100 üzerinde ResNet20, ResNet32, ResNet44 ve VGG11 ağları değerlendirilmiştir. Aynı RNS-CKKS ayarlarında CipherAPR, AutoFHE ile karşılaştırıldığında raporlanan yapılandırmalarda 1,09×–1,39× hızlanma sağlamış ve benzer ciphertext doğruluğunu korumuştur. En belirgin örnekte CIFAR-10/ResNet20 için AutoFHE 11 bootstrapping ve 4659 saniye toplam gecikmeyle %92,89 ciphertext doğruluğu verirken CipherAPR 7 bootstrapping ve 3341 saniye gecikmeyle %92,61 doğruluk vermiştir.
Bu sonuç “daha az bootstrapping her durumda otomatik olarak daha hızlıdır” biçiminde yorumlanmamalıdır. Kaynak, ciphertext'in hangi level'da bulunduğunun rotation, rescaling ve key-switching gibi işlemlerin maliyetini de etkilediğini göstermektedir. Nitekim bazı yapılandırmalarda CipherAPR'ın lineer işlem maliyeti yükselmiş, fakat bootstrapping süresindeki daha büyük azalma toplam gecikmeyi yine düşürmüştür.
CipherAPR yeni bir FHE şifreleme primitive'i değildir ve RNS-CKKS'nin güvenlik mekanizmasını değiştirmez. LMAR, DAAP, MOCT, CAPR ve CLU çevrimdışı model tasarımında plaintext training/calibration aktivasyonları veya public model parametreleri üzerinde çalışır. Çevrimiçi kullanıcı girdileri standart RNS-CKKS altında şifreli kalır; kaynak confidentiality'nin kullanılan RNS-CKKS parametreleri ve Ring Learning With Errors güvenlik varsayımından miras alındığını belirtmektedir.
Problem neden ortaya çıkıyor?
Fully Homomorphic Encryption (FHE), sunucunun kullanıcı verisini açık metne çevirmeden şifreli veri üzerinde hesaplama yapmasını sağlar. Bu özellik Machine Learning as a Service senaryolarında önemlidir: kullanıcı girdisini şifreler, sunucu sinir ağı çıkarımını ciphertext üzerinde yürütür ve kullanıcı yalnız nihai şifreli sonucu kendi tarafında çözer.
Çalışmanın kullandığı RNS-CKKS, yaklaşık gerçek veya karmaşık sayı aritmetiğini destekleyen bir FHE şemasıdır. Bir mesaj vektörü plaintext polynomial \(m(x)\) biçimine kodlanır ve ciphertext olarak şifrelenir. Hesaplama:
cyclotomic ring'i üzerinde yürütülür.
Burada modulus:
şeklindedir. \(\ell\), ciphertext'in kalan multiplicative capacity'sini gösteren ciphertext level değeridir. Her homomorphic multiplication ciphertext'in ölçeğini büyüttüğünden genellikle rescaling gerekir. Rescaling son prime \(q_\ell\)'yi modulus chain'den çıkarır:
ve böylece bir level tüketilir.
Level sıfıra yaklaştığında ciphertext'in daha fazla multiplication taşıyabilmesi için bootstrapping gerekir. Bootstrapping ciphertext'i yeniden kullanılabilir yüksek bir level'a yükseltir; ancak RNS-CKKS encrypted inference içinde çok pahalı bir işlemdir.
Bootstrapping Sayısını Azaltmak Neden Tek Başına Yeterli Değildir?
Bootstrapping sayısı önemli olsa da RNS-CKKS işlem maliyeti ciphertext'in hangi level'da hesaplandığına da bağlıdır; yüksek level daha fazla aktif RNS prime içerdiği için rotation, relinearization, multiplication ve rescaling gibi işlemler daha pahalı olabilir. Bu nedenle CipherAPR yalnız bootstrapping sayısını değil, bootstrapping sonrasında geri yüklenen level bütçesinin segmentler boyunca ne kadar verimli tüketildiğini de dikkate alır.
RNS-CKKS'de level neden işlem maliyetini etkiliyor?
Kaynak aktif RNS basis'i:
olarak tanımlar. Aktif prime sayısı:
olduğundan level yükseldikçe daha fazla modulus limb hesaplamaya katılır.
Level \(\ell\)'deki primitive homomorphic operation maliyetinin toplamı:
şeklinde yazılır.
Burada \(\mathcal{P}\), AddCP, AddCC, MulCP, MulCC, Rot, Relin ve RS gibi primitive operation türlerini; \(n_k\), ilgili işlem sayısını; \(t_k(\ell)\) ise tek bir işlemin level \(\ell\)'deki maliyetini gösterir.
Kaynağın kullandığı yaklaşık level bağımlılığı:
biçimindedir.
\(N\) ring degree'dir. \(\alpha_k\) ve \(\beta_k\) operation-dependent constants'tır. İlk gruptaki işlemler aktif RNS limb sayısıyla yaklaşık doğrusal; key-switching içeren rotation ve relinearization türleri ise kaynak cost modelinde daha güçlü level bağımlılığı gösterir.
Bu nedenle bootstrapping sonrası effective level \(L_{\mathrm{eff}}\)'in düşürülmesi sonraki işlemleri ucuzlatabilir; fakat çok düşük \(L_{\mathrm{eff}}\) yeterli multiplicative-depth bırakmayarak bootstrapping sayısını yeniden artırabilir.
Kaynak toplam inference latency'yi kavramsal olarak:
şeklinde ifade eder.
\(N_{\mathrm{boot}}\) bootstrapping sayısı; \(T_{\mathrm{boot}}\) tek bootstrapping maliyeti; \(T_{\mathrm{seg}}^{(j)}\) ise iki bootstrapping arasındaki segmentin hesaplama maliyetidir. Formül, toplam latency'nin yalnız \(N_{\mathrm{boot}}\)'a bağlı olmadığını açıkça gösterir.
ReLU neden doğrudan hesaplanamıyor?
RNS-CKKS esas olarak addition ve multiplication gibi arithmetic operations sağlar. CNN'lerdeki:
fonksiyonu doğrudan polynomial değildir. Bu nedenle ReLU, homomorphic evaluation'a uygun polynomial approximation ile değiştirilir.
Kaynak ReLU'yu sign function üzerinden:
şeklinde ifade eder.
Sign function, sıfır çevresindeki discontinuity nedeniyle tek bir düşük dereceli polynomial ile yüksek doğrulukta yaklaşıklaştırılması zor bir fonksiyondur. Bu nedenle çalışma composite polynomial:
yapısını kullanır.
Her alt-polynomial'in derecesi:
olarak gösterilir.
Composite polynomial multiplicative depth'i
Baby Step Giant Step (BSGS) polynomial evaluation kullanıldığında kaynak \(i\). sub-polynomial için depth'i:
ile üstten sınırlar.
Toplam composite depth yaklaşık:
olarak hesaplanır.
| Derece kümesi | Depth consumption | Multiplication sayısı |
|---|---|---|
| {3, 7} | 5 | 7 |
| {7, 7} | 6 | 10 |
| {7, 15} | 7 | 13 |
| {15, 15} | 8 | 16 |
| {7, 7, 13} | 10 | 17 |
| {7, 7, 27} | 11 | 20 |
| {7, 15, 27} | 12 | 23 |
| {15, 15, 27} | 13 | 26 |
Daha yüksek degree set genellikle ReLU approximation fidelity'sini artırabilecek daha ifade gücü yüksek bir polynomial üretir; fakat daha fazla multiplicative depth ve dolayısıyla daha sık veya farklı konumlandırılmış bootstrapping gerektirebilir.
CipherAPR hangi problemi optimize ediyor?
Bir encrypted network'te \(L\) activation layer bulunduğunu düşünelim. Katmanlara verilen polynomial dereceleri:
degree vector'üyle gösterilir. \(\mathbb{D}\), kullanılmasına izin verilen polynomial degree set'idir.
Belirli bir degree configuration \(\mathbf{d}\) için mümkün bootstrapping placement'larının kümesi:
olarak tanımlanır. \(\Lambda\), ring degree, modulus chain ve security level gibi sabit cryptographic setting'i temsil eder.
Configuration'ın latency değeri:
olarak tanımlanır.
Burada \(T(\mathbf{d},\pi;\Lambda)\), belirli polynomial degrees ve bootstrapping placement altında uçtan uca encrypted inference latency'dir.
Asıl optimizasyon problemi:
şeklindedir.
Yani CipherAPR yalnız en hızlı configuration'ı aramaz. Minimum kabul edilen accuracy constraint'i koruyarak en düşük encrypted inference latency'yi veren layer-wise degree assignment'ı arar.
CipherAPR'ın üç aşamalı çevrimdışı tasarım süreci
LMAR: Hangi katmanın derece artışına daha çok ihtiyacı var?
ReLU'nun kritik davranışı sıfır çevresindedir. Girdi negatife geçtiğinde ReLU çıkışı sıfır olur; pozitif tarafta ise girdi aktarılır. Polynomial approximation özellikle sıfıra yakın değerlerde sign/gating kararını yanlış temsil etmeye daha yatkındır.
CipherAPR bu nedenle layer \(\ell\) için Low-Magnitude Activation Ratio tanımlar:
Burada \(x_{\ell,i}\), \(\ell\). activation layer'daki \(i\). neuron'un girdisi; \(k_\ell\), o katmandaki toplam neuron sayısı; \(\epsilon\), “sıfıra yakın” bölgeyi tanımlayan eşiktir; \(\mathbf{1}(\cdot)\), koşul doğruysa 1, yanlışsa 0 veren indicator function'dır.
LMAR boyutsuz bir orandır ve 0–1 aralığındadır. Yüksek LMAR, katmandaki activation input'larının daha büyük kısmının sıfır civarında bulunduğunu gösterir. Kaynak bunu, aynı level budget altında daha yüksek polynomial degree'den daha fazla fayda görebilecek katmanları sıralamak için kullanır.
LMAR Neyi Ölçüyor ve Neden Önemlidir?
LMAR, bir aktivasyon katmanındaki girdilerin ne kadarının ReLU'nun sıfır çevresindeki hassas bölgede bulunduğunu ölçen boyutsuz bir orandır; oran yükseldikçe düşük dereceli polinomun gating davranışını yanlış temsil etme riski önem kazanır ve CipherAPR bu katmanları derece artışı için daha yüksek öncelikle değerlendirir.
\(\epsilon\) eşiği nasıl belirleniyor?
Kaynak \(\epsilon\)'yi elle sabitlemek yerine bütün katmanlardaki activation magnitude dağılımına Otsu yöntemi uygular.
Within-class variance:
Between-class variance:
şeklindedir.
\(w_1,w_2\) iki activation-magnitude sınıfının olasılıklarını; \(\mu_1,\mu_2\) sınıf ortalamalarını; \(\sigma_1^2,\sigma_2^2\) sınıf içi varyansları gösterir.
Kaynak optimum \(\epsilon\)'yi:
oranını maksimize eden threshold olarak seçer.
LMAR yalnız deneysel bir heuristic mi?
Appendix A, LMAR sıralamasına teorik bir sınır gerekçesi de verir. \(\ell\). layer pre-activation'ı \(X_\ell\) ve polynomial approximation \(p_d(x)\) olsun. Polynomial, \(|x|\ge\epsilon\) bölgesinde doğru sign'i koruyorsa gating sign inconsistency olasılığı:
ile üstten sınırlandırılır.
Bu denklem LMAR'ın sign inconsistency'nin gerçekleşeceği kesin olasılık olduğunu söylemez. LMAR, belirtilen shape constraint altında risk için bir üst sınırdır.
Kaynak ayrıca approximation error'ın expected loss üzerindeki etkisi için:
sınırını verir.
Burada \(L_\ell\), sonraki sub-network'ün Lipschitz constant'ı; \(L_{\mathrm{loss}}\), loss function'ın Lipschitz constant'ı; \(c_{\epsilon,d}\), sıfıra yakın approximation region içindeki maksimum polynomial sapmasını temsil eder. Kaynağın yorumu, diğer faktörler benzerken yüksek LMAR'ın approximation error'ın expected loss'a katkısını büyütebileceğidir.
Degree update nasıl seçiliyor?
Activation layer'lar LMAR değerlerine göre büyükten küçüğe sıralanır. Katman \(\ell\)'in rank'i \(r_\ell\), toplam layer sayısı \(M\) olduğunda normalized rank score:
olarak hesaplanır.
Yüksek LMAR'lı katmanlar 1'e; düşük LMAR'lı katmanlar 0'a yaklaşır.
IncreaseDegree ve DecreaseDegree için kaynak centered hinge functions kullanır:
Burada \(\tau_c=0.5\), \(m\in[0,0.5)\) ise update selectivity margin'dir.
Action probabilities:
olarak hesaplanır.
ID degree artışı, DD degree düşüşü, KD degree'nin korunmasıdır. Önceki iteration'da değiştirilmiş layer için dynamic coefficients:
ile azaltılır. Kaynak bu cooling mekanizmasını aynı layer'ın ardışık iteration'larda sürekli ileri-geri değiştirilmesini azaltmak için kullanır.
DAAP — approximation domain neden katmana göre değişiyor?
Her layer'ın activation distribution'ı aynı değildir. Aynı geniş approximation domain'i bütün layer'lara uygulamak, bazı layer'larda gereğinden zor bir polynomial fitting problemi doğurabilir.
DAAP, layer \(\ell\)'in empirical activation bounds değerlerini:
olarak alır ve symmetric core radius'u:
şeklinde hesaplar.
\(B>1\) activation-domain normalization için kullanılan global scaling factor'dür. Kaynak özellikle bunun CKKS encryption scale ile aynı büyüklük olmadığını belirtir. \(a>0\), minimum core-domain radius'tur.
Core domain:
extended domain ise:
olarak tanımlanır.
\(\rho_{\mathrm{ext}}>1\), normal core domain dışında kalan fakat karşılaşılması mümkün activation tail'leri için güvenlik payı oluşturur.
DAAP ve MOCT Neden Birlikte Kullanılıyor?
DAAP polinomun yaklaşıklaştırma bölgesini katmanın gerçek aktivasyon dağılımına uyarlarken MOCT aynı polinomun katsayılarını core error, extended-domain davranışı, eğrilik ve katsayı büyüklüğünü birlikte dikkate alarak ayarlar; amaç aynı polynomial degree altında daha düşük approximation error ve ciphertext arithmetic için daha kararlı sayısal davranış elde etmektir.
MOCT loss function
Final ReLU approximation:
şeklindedir.
MOCT dört loss bileşeni kullanır.
Core Error (CE):
core domain içindeki maksimum approximation error'dır.
Extended Domain Constraint (EDC):
extended domain içinde polynomial output'un beklenen güvenli aralığın dışına taşmasını cezalandırır.
Curvature Penalty (CP):
kaynakta polynomial oscillation ve Runge-benzeri davranışı bastırmak için curvature regularization olarak kullanılır.
Coefficient Regularization (CR):
polynomial coefficient büyüklüğünü sınırlar.
Toplam loss:
şeklindedir.
Makaledeki deneylerde:
kullanılmıştır.
MOCT yalnız ilk sub-polynomial \(p_1(x)\)'in odd-degree coefficients değerlerini trainable yapar; diğer katsayılar sabit tutulur. Kaynak 10.000 MOCT epoch kullanmıştır.
CAPR nedir?
Cosine-scheduled Activation Progressive Replacement (CAPR), bir candidate mixed-degree network'ün nihai doğruluğunu tam 300-epoch training yapmadan önce düşük bütçeyle yaklaşık olarak değerlendiren çevrimdışı screening yöntemidir.
Toplam training budget \(T\), stage sayısı \(Q\), minimum stage epoch'u \(M_{\min}\) olsun. Her stage için epoch allocation:
biçiminde verilir.
Kaynak varsayılan olarak:
kullanır.
Stage \(q\)'de değiştirilmesi planlanan activation sayısı:
ve kümülatif değiştirilmiş activation sayısı:
olarak belirlenir.
CAPR nihai accuracy değildir. Makale CAPR'ı yalnız candidate screening için low-budget staged accuracy estimate olarak kullanır; seçilmiş yapılandırmalar daha sonra tam training'e alınır.
Latency proxy ve dynamic programming
CipherAPR her candidate'ı gerçek encrypted inference ile test etmez; aksi hâlde search aşırı pahalı olur. Bunun yerine belirli layer çevrelerinde feasible bootstrapping positions oluşturur ve dynamic programming ile minimum proxy latency'yi arar.
DP state, hangi layer'da bulunulduğunu ve kalan ciphertext level'ı takip eder. Bootstrapping eklenirse level \(L_{\mathrm{eff}}\)'e reset edilir ve bootstrapping cost eklenir.
Lineer operator cost'ları input ciphertext level'a göre hazırlanmış lookup table'dan alınır. Polynomial layer cost'u degree ile ilişkili monotonic cost model kullanır.
Candidate score
Candidate \(\mathbf{d}'\) için score:
şeklindedir.
\(\lambda\) büyüdükçe accuracy tercihinin; küçüldükçe latency tercihinin ağırlığı artar. Çalışma ayrı accuracy-oriented ve latency-oriented candidate pool'ları tutar.
CLU — ciphertext-level utilization
Bootstrapping placements network'ü \(S\) segment'e ayırsın. Segment \(s\)'deki layer set'i \(\mathcal{L}_s\), her layer'ın level consumption değeri \(c_\ell\) ise:
segment depth consumption'dır.
Segment-level utilization:
olarak hesaplanır.
Komşu segmentler arasındaki değişim:
ve adjacent variation:
şeklindedir.
Düşük \(RMS_{\mathrm{adj}}\), bootstrapping segmentleri arasında daha dengeli level tüketimini temsil eder. CLU nihai latency veya accuracy'nin yerine kullanılan bir objective değildir; score preselection'dan geçmiş candidate'lar arasında conservative structural filter olarak kullanılır.
Offline search parametreleri
- Pool width \(W=15\).
- Maximum search iteration \(T_{\max}=30\).
- CLU retention ratio \(\eta_{\mathrm{CLU}}=0.95\).
- Başlangıç accuracy-oriented preference weight: \(\lambda_{\mathrm{acc}}^{(0)}=1.0\).
- Başlangıç latency-oriented preference weight: \(\lambda_{\mathrm{lat}}^{(0)}=0.1\).
- Bir iteration'da duplicate removal sonrası en fazla \(2W=30\) candidate CAPR değerlendirmesine gider.
Çalışmanın Yöntemi ve Bulguları
Deney ortamı
| Aşama | Kaynakta bildirilen ortam |
|---|---|
| Offline training / degree allocation / polynomial instantiation | Python 3.8, PyTorch 1.13.1 |
| Offline GPU | NVIDIA RTX A6000 |
| Offline işletim sistemi | Ubuntu 20.04 |
| Encrypted inference implementation | C++, AutoFHE altyapısı, Microsoft SEAL |
| Encrypted inference CPU | Intel Xeon Platinum 8462Y+ |
| CPU kapasitesi | 128 vCPU |
| Sunucu belleği | 1 TiB |
| Encrypted inference işletim sistemi | Ubuntu 20.04 |
Kaynak özellikle offline design süresi ile online encrypted inference latency'yi birbirinden ayırır. Makaledeki online performans karşılaştırmaları training/search maliyetini inference latency içine eklemez.
Veri setleri
| Veri seti | Training görüntüsü | Test görüntüsü | Görüntü boyutu | Offline hızlı arama alt kümesi |
|---|---|---|---|---|
| CIFAR-10 | 50.000 | 10.000 | 32×32 pixel | 5000 training image |
| CIFAR-100 | 50.000 | 10.000 | 32×32 pixel | 5000 training image |
Offline search süresini düşürmek için 5000-image fast-training subset kullanılmıştır. Nihai ciphertext inference değerlendirmesi ise 10.000-image test set üzerinde yapılmıştır. Metrik top-1 accuracy'dir.
RNS-CKKS parametreleri
| Parametre | Değer |
|---|---|
| Ring degree \(N\) | \(2^{16}\) |
| Numerical scaling factor \(B\) | 80 |
| Total modulus-chain length | 1552 bit |
| Private-key Hamming weight | 192 |
| Security level | 128-bit |
Modulus-chain yapısı kaynakta:
bit biçiminde raporlanmıştır.
Training parametreleri
Original networks:
- Optimizer: SGD.
- Epoch: 200.
- Batch size: 128.
- Initial learning rate: 0,1.
- Learning-rate schedule: cosine decay.
- Momentum: 0,9.
- Weight decay: 0,0005.
- Gradient clipping: 1,0.
Polynomial networks için 300 epoch ve initial learning rate 0,08 kullanılmış; stage başına en az 8 epoch uygulanmıştır.
Final CipherAPR training:
- Batch size: 128.
- Learning rate: 0,01.
- Momentum: 0,9.
- Weight decay: \(5\times10^{-4}\).
- Gradient clipping: 0,1.
- KL-divergence weight: \(\tau=0.9\).
CAPR candidate evaluation için yalnız 20 total epoch ve stage başına minimum 2 epoch kullanılmıştır.
DAAP/MOCT parametreleri
- Approximation-domain minimum: \(a=0.2\).
- Extension factor: \(\rho_{\mathrm{ext}}=1.5\).
- CIFAR-10 domain estimation: 30 image.
- CIFAR-100 domain estimation: 100 image.
- Uniform perturbation: \(\epsilon=0.1\).
- MOCT training: 10.000 epoch.
Ana encrypted inference sonuçları
| Veri seti / Ağ | Yöntem / yapılandırma | #Boot | Cipher Acc. | Latency | Amortized latency |
|---|---|---|---|---|---|
| CIFAR-10 / ResNet20 | MPCNN | 18 | %92,59 | 6299 s | 49,21 s |
| CIFAR-10 / ResNet20 | AutoFHE düşük-BT | 5 | %91,92 | 2751 s | 21,49 s |
| CIFAR-10 / ResNet20 | CipherAPR düşük-BT | 4 | %92,15 | 2291 s | 17,90 s |
| CIFAR-10 / ResNet20 | AutoFHE yüksek-BT | 11 | %92,89 | 4659 s | 36,40 s |
| CIFAR-10 / ResNet20 | CipherAPR yüksek-BT | 7 | %92,61 | 3341 s | 26,10 s |
| CIFAR-10 / ResNet32 | MPCNN | 30 | %93,39 | 10.231 s | 79,93 s |
| CIFAR-10 / ResNet32 | AutoFHE düşük-BT | 8 | %93,46 | 4664 s | 36,44 s |
| CIFAR-10 / ResNet32 | CipherAPR düşük-BT | 7 | %93,14 | 4129 s | 32,26 s |
| CIFAR-10 / ResNet32 | AutoFHE yüksek-BT | 19 | %93,56 | 7294 s | 56,98 s |
| CIFAR-10 / ResNet32 | CipherAPR yüksek-BT | 13 | %93,76 | 6064 s | 47,38 s |
| CIFAR-10 / ResNet44 | MPCNN | 42 | %93,57 | 15.163 s | 118,46 s |
| CIFAR-10 / ResNet44 | AutoFHE düşük-BT | 8 | %92,55 | 5137 s | 40,13 s |
| CIFAR-10 / ResNet44 | CipherAPR düşük-BT | 8 | %93,04 | 4728 s | 36,94 s |
| CIFAR-10 / ResNet44 | AutoFHE yüksek-BT | 22 | %93,65 | 8639 s | 67,49 s |
| CIFAR-10 / ResNet44 | CipherAPR yüksek-BT | 16 | %93,71 | 7250 s | 56,64 s |
| CIFAR-10 / VGG11 | MPCNN | 9 | %90,41 | 3157 s | 24,66 s |
| CIFAR-10 / VGG11 | AutoFHE | 4 | %90,68 | 1931 s | 15,09 s |
| CIFAR-10 / VGG11 | CipherAPR | 4 | %90,67 | 1835 s | 14,34 s |
| CIFAR-100 / ResNet32 | MPCNN | 30 | %70,59 | 10.357 s | 80,91 s |
| CIFAR-100 / ResNet32 | AutoFHE | 16 | %71,34 | 7187 s | 56,15 s |
| CIFAR-100 / ResNet32 | CipherAPR | 12 | %71,48 | 5953 s | 46,51 s |
| CIFAR-100 / VGG11 | MPCNN | 9 | %63,95 | 3200 s | 25,00 s |
| CIFAR-100 / VGG11 | AutoFHE | 7 | %64,31 | 2832 s | 22,12 s |
| CIFAR-100 / VGG11 | CipherAPR | 6 | %64,26 | 2348 s | 18,34 s |
Kaynak bu paired settings üzerinden CipherAPR'ın AutoFHE'ye göre genel hızlanmasını 1,09×–1,39× aralığında raporlamaktadır.
CipherAPR'ın 1,09×–1,39× Hızlanması Ne Anlama Geliyor?
Bu hızlanma, aynı sabit RNS-CKKS cryptographic setting ve karşılaştırılabilir encrypted accuracy hedefleri altında seçilmiş ResNet/VGG yapılandırmalarında AutoFHE'ye göre ölçülen uçtan uca encrypted-inference latency azalmasını ifade eder; sonuç bütün ağlar, bütün FHE parametreleri veya bütün donanımlar için evrensel bir hızlanma garantisi değildir.
Runtime breakdown: neden bazı lineer işlemler pahalılaşıyor?
| Veri seti / Ağ | Yöntem / yapılandırma | #Boot | Total effective levels | Boot | Linear | Polynomial |
|---|---|---|---|---|---|---|
| CIFAR-10 / ResNet20 | MPCNN | 18 | 306 | 4813 s | 786 s | 700 s |
| CIFAR-10 / ResNet20 | AutoFHE düşük-BT | 5 | 85 | 1370 s | 1304 s | 77 s |
| CIFAR-10 / ResNet20 | CipherAPR düşük-BT | 4 | 73 | 1095 s | 1162 s | 34 s |
| CIFAR-10 / ResNet20 | AutoFHE yüksek-BT | 11 | 150 | 2995 s | 1411 s | 253 s |
| CIFAR-10 / ResNet20 | CipherAPR yüksek-BT | 7 | 104 | 1907 s | 1335 s | 99 s |
| CIFAR-10 / ResNet32 | MPCNN | 30 | 498 | 7813 s | 1336 s | 1082 s |
| CIFAR-10 / ResNet32 | AutoFHE düşük-BT | 8 | 96 | 2234 s | 2404 s | 26 s |
| CIFAR-10 / ResNet32 | CipherAPR düşük-BT | 7 | 118 | 1955 s | 2129 s | 45 s |
| CIFAR-10 / ResNet32 | AutoFHE yüksek-BT | 19 | 235 | 5040 s | 1838 s | 416 s |
| CIFAR-10 / ResNet32 | CipherAPR yüksek-BT | 13 | 195 | 3449 s | 2208 s | 407 s |
| CIFAR-10 / ResNet44 | MPCNN | 42 | 690 | 11.638 s | 1893 s | 1632 s |
| CIFAR-10 / ResNet44 | AutoFHE düşük-BT | 8 | 120 | 2171 s | 2940 s | 26 s |
| CIFAR-10 / ResNet44 | CipherAPR düşük-BT | 8 | 131 | 2149 s | 2550 s | 29 s |
| CIFAR-10 / ResNet44 | AutoFHE yüksek-BT | 22 | 277 | 5715 s | 2492 s | 432 s |
| CIFAR-10 / ResNet44 | CipherAPR yüksek-BT | 16 | 234 | 4157 s | 2662 s | 431 s |
| CIFAR-10 / VGG11 | MPCNN | 9 | 160 | 2326 s | 483 s | 348 s |
| CIFAR-10 / VGG11 | AutoFHE | 4 | 72 | 1125 s | 692 s | 114 s |
| CIFAR-10 / VGG11 | CipherAPR | 4 | 68 | 1131 s | 629 s | 75 s |
| CIFAR-100 / ResNet32 | MPCNN | 30 | 498 | 7809 s | 1466 s | 1082 s |
| CIFAR-100 / ResNet32 | AutoFHE | 16 | 230 | 4377 s | 2408 s | 402 s |
| CIFAR-100 / ResNet32 | CipherAPR | 12 | 176 | 3183 s | 2357 s | 413 s |
| CIFAR-100 / VGG11 | MPCNN | 9 | 160 | 2332 s | 511 s | 357 s |
| CIFAR-100 / VGG11 | AutoFHE | 7 | 104 | 1885 s | 719 s | 228 s |
| CIFAR-100 / VGG11 | CipherAPR | 6 | 86 | 1616 s | 611 s | 121 s |
CIFAR-10/ResNet32 yüksek-BT örneği bu etkileşimi açıkça gösterir. AutoFHE 19 bootstrapping ile 5040 s bootstrapping ve 1838 s linear cost üretirken CipherAPR 13 bootstrapping ile bootstrapping süresini 3449 s'ye indirir. Buna karşılık linear cost 2208 s'ye yükselir. Bootstrapping kazancı daha büyük olduğu için toplam latency yine 7294 s'den 6064 s'ye düşer.
Restored-level kullanım örneği
Kaynak CIFAR-10/ResNet32 yüksek-BT yapılandırması için her bootstrapping'in en fazla 16 level restore ettiğini ve input ciphertext'in level 18'den başladığını belirtir.
Toplam kullanılabilir level:
olarak hesaplanır.
AutoFHE için:
level kullanılabilir ve Table 6'da total effective usage 235'tir. Kaynak buna göre 87 level'ın kullanılmadan kaldığını hesaplar.
CipherAPR için:
level kullanılabilir; effective usage 195'tir ve unused budget 31 level'dır.
Kaynağa göre Table 6'daki dokuz paired AutoFHE/CipherAPR setting'in yedisinde CipherAPR daha düşük unused level budget göstermiştir.
LMAR deneysel sonucu
LMAR değerlendirmesi CIFAR-10/ResNet32 üzerinde yapılmıştır. Activation sites'lar kademeli olarak polynomial ile değiştirilirken LMAR sıralaması, Forward ve Reverse-LMAR sıralamalarıyla karşılaştırılmıştır.
Kaynak Şekil 5'in ana sonucu, özellikle az sayıda activation değiştirilmiş erken aşamada LMAR-based ordering'in accuracy'yi daha hızlı geri kazandırmasıdır. Aynı fine-tuning prosedüründe bazı partially replaced modeller %94,05 inference accuracy'ye ulaşmış ve özgün ReLU network baseline'ını hafifçe aşmıştır. Bu değer CipherAPR'ın encrypted-inference ana sonuç tablosunun yerine geçen bir sonuç değildir; LMAR'ın degree-prioritization signal olarak değerlendirilmesine ait ayrı bir supporting experiment'tir.
DAAP + MOCT approximation error sonuçları
| Depth | Minimax MaxE | DAAP w/o MOCT MaxE | DAAP + MOCT MaxE | MOCT iyileşmesi vs Minimax |
|---|---|---|---|---|
| 4 | 6,65×10⁻² | 1,42×10⁻² | 9,72×10⁻³ | %85,39 |
| 5 | 3,44×10⁻² | 7,18×10⁻³ | 6,76×10⁻³ | %80,36 |
| 6 | 1,51×10⁻² | 9,37×10⁻³ | 3,62×10⁻³ | %76,03 |
| 7 | 7,58×10⁻³ | 2,62×10⁻³ | 2,41×10⁻³ | %68,22 |
| 8 | 3,82×10⁻³ | 1,85×10⁻³ | 1,71×10⁻³ | %55,33 |
| 9 | 1,87×10⁻³ | 1,25×10⁻³ | 1,13×10⁻³ | %39,44 |
| 10 | 1,73×10⁻³ | 5,74×10⁻⁴ | 5,72×10⁻⁴ | %66,91 |
| 11 | 9,03×10⁻⁴ | 3,88×10⁻⁴ | 3,82×10⁻⁴ | %57,66 |
| 12 | 4,72×10⁻⁴ | 1,88×10⁻⁴ | 1,82×10⁻⁴ | %61,51 |
Kaynak DAAP + MOCT'un Minimax'a göre MaxE değerini depth'e bağlı olarak %39,44–%85,39 azalttığını bildirir.
DAAP domain trade-off'u
| Depth | Ayar | Core MaxE | Outer MaxE | Max |ai| |
|---|---|---|---|---|
| 6 | \(v=0.12,\rho_{\mathrm{ext}}=1.50\) | 2,85×10⁻³ | 2,19×10⁻³ | 3,89×10² |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| 6 | \(v=0.30,\rho_{\mathrm{ext}}=1.50\) | 2,91×10⁻² | 4,18×10⁻² | 2,54×101 |
| 12 | \(v=0.12,\rho_{\mathrm{ext}}=1.50\) | 1,49×10⁻⁴ | 2,55×10⁻⁷ | 2,77×10⁶ |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 1,88×10⁻⁴ | 4,00×10⁻⁵ | 7,84×10⁴ |
| 12 | \(v=0.30,\rho_{\mathrm{ext}}=1.50\) | 4,28×10⁻⁴ | 6,72×10⁻⁴ | 4,66×10³ |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=1.05\) | 3,87×10⁻³ | 4,21×10⁻³ | 2,46×10² |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=2.50\) | 1,81×10⁻² | 5,37×10⁻² | 1,86×101 |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=1.05\) | 1,61×10⁻⁴ | 1,63×10⁻⁶ | 8,83×10⁵ |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 1,88×10⁻⁴ | 4,00×10⁻⁵ | 7,84×10⁴ |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=2.50\) | 4,27×10⁻⁴ | 1,08×10⁻³ | 4,53×10³ |
Sonuç önemli bir approximation-stability trade-off gösterir. Örneğin depth 6'da \(v\)'yi 0,12'den 0,30'a artırmak maximum coefficient büyüklüğünü \(3,89\times10^2\)'den \(2,54\times10^1\)'e düşürürken Core MaxE'yi \(2,85\times10^{-3}\)'ten \(2,91\times10^{-2}\)'ye yükseltmektedir. Kaynak \(v=0.20,\rho_{\mathrm{ext}}=1.50\) değerlerini dengeli default olarak kullanır.
MOCT weight ablation
| Durum | Core MaxE | Outer MaxE | Max |ai| |
|---|---|---|---|
| DAAP baseline | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| MOCT default | 6,60×10⁻³ | 1,84×10⁻² | 8,45×101 |
| \(w_1=0\) | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| \(w_2=0\) | 6,60×10⁻³ | 1,84×10⁻² | 8,45×101 |
| \(w_3=0\) | 3,40×10⁻³ | 7,12×10⁻² | 1,04×10² |
| \(w_4=0\) | 6,60×10⁻³ | 1,84×10⁻² | 8,45×101 |
\(w_1=0\) sonucunun DAAP baseline'a geri dönmesi Core Error term'inin core-domain update'i sürüklediğini gösterir. \(w_3=0\) ise Core MaxE'yi düşürmesine rağmen Outer MaxE'yi \(7,12\times10^{-2}\)'ye ve maximum coefficient'i \(1,04\times10^2\)'ye çıkarır. Kaynak bunu curvature penalty'nin yalnız core region'a aşırı uyumu engelleyerek outer-domain numerical behavior'a katkı sağladığı biçiminde yorumlar.
Latency proxy, CAPR ve CLU değerlendirmesi
Kaynak Şekil 6a, latency proxy'nin farklı bootstrapping settings içinde gerçek encrypted latency ordering'ini koruduğunu bildirir. Proxy'nin görevi global olarak saniye cinsinden latency kalibrasyonu yapmak değildir; aynı setting içindeki adayları sıralamaktır.
Şekil 6b, CAPR'ın küçük training budget içinde trainable configuration'ları failure regime'den hızlı biçimde ayırabildiğini göstermektedir. Kaynak CAPR'ı final accuracy yerine screening estimate olarak kullanır.
| Pool ayarı | 210 CAPR değerlendirmesi sonrası best-so-far | Normalized final best | CLU-run best'e ulaşmak için CAPR eval | Path-dependent tasarruf |
|---|---|---|---|---|
| Accuracy-oriented | %99,9 / %97,6 | %99,9 / %100,0 | 210 / 330 | %36,4 daha az |
| Latency-oriented | %100,0 / %95,5 | %100,0 / %100,0 | 180 / 330 | %45,5 daha az |
Tablodaki çift değerler `CLU / without CLU` biçimindedir. Kaynak özellikle final best score'ların neredeyse aynı kaldığını belirtir. Dolayısıyla CLU'nun ana etkisi “nihai optimumu dramatik biçimde daha iyi yapmak” değil, aynı düzeydeki best configuration'a giden erken search trajectory'yi daha verimli hâle getirmektir.
Offline search maliyeti
Her candidate, 5000-image fast-training subset üzerinde 20 CAPR epoch ve batch size 128 ile fine-tune edilir. Bu, candidate başına 800 mini-batch update'e karşılık gelir.
Kaynak serial offline search cost'u:
olarak tahmin eder.
\(N_{\mathrm{eval}}\), CAPR ile değerlendirilen candidate configuration sayısı; \(T_{\mathrm{CAPR}}^{20}\), candidate başına 20-epoch CAPR süresidir.
Pilot ölçümlerde candidate başına CAPR süresi ResNet settings için yaklaşık 10–25 dakika, VGG için 20–30 dakika düzeyindedir. Buna göre kaynak 180–210 değerlendirmelik CLU-guided run için ResNet modellerinde yaklaşık 1–3 serial gün, VGG modellerinde yaklaşık 2–4 serial gün tahmin etmektedir.
Önemli sınır: Bunlar uçtan uca ölçülmüş full-search wall-clock süreleri değil, serial cost estimates'tir. Candidate evaluations bağımsız olduğundan yeterli worker bulunduğunda paralel çalıştırma gerçek wall-clock süresini düşürebilir.
Appendix B: karma derece gerçekten katmanlar arasında değişiyor mu?
Evet. Appendix B'deki depth profiles, CipherAPR'ın bütün activation layer'lara tek bir polynomial degree uygulamadığını göstermektedir. Depth değeri 0 olan activation prune/identity; depth 2 shallow polynomial; 2'nin üzerindeki değerler daha derin composite approximations anlamına gelir.
Kaynağın verdiği örnekte CIFAR-10/ResNet32 için depth>2 activation sayısı 7-bootstrapping setting'de 2 iken 13-bootstrapping setting'de 12'ye yükselir. Buna rağmen bazı activation'lar prune edilir veya depth 2'de tutulur. Bu, mixed-degree yaklaşımın gerçekten layer-selective olduğunu gösterir.
Çalışmanın desteklediği sonuçlar
- CipherAPR, sabit RNS-CKKS backend altında polynomial degree design'a restored-level utilization bilgisini dahil eder.
- Değerlendirilen ResNet ve VGG yapılandırmalarında AutoFHE'ye göre 1,09×–1,39× encrypted-inference speedup raporlanmıştır.
- En büyük raporlanan kazanç CIFAR-10/ResNet20 yüksek bootstrapping setting'de 4659 s'den 3341 s'ye düşüştür.
- CipherAPR birçok paired setting'de bootstrapping sayısını azaltmıştır.
- Dokuz paired AutoFHE/CipherAPR setting'in yedisinde daha düşük unused restored-level budget gözlenmiştir.
- LMAR, sınırlı replacement budget altında activation layer önceliklendirmesi için yararlı bir forward-only heuristic olarak desteklenmiştir.
- DAAP + MOCT, aynı approximation depth altında Minimax'a göre MaxE'yi %39,44–%85,39 azaltmıştır.
- CLU final best score'u büyük ölçüde değiştirmeden erken search trajectory'de daha az CAPR evaluation ile aynı CLU-run best düzeyine ulaşılmasını sağlamıştır.
Çalışmanın desteklemediği sonuçlar
- CipherAPR yeni veya daha güvenli bir FHE şifreleme şeması değildir.
- CipherAPR RNS-CKKS encryption/decryption veya bootstrapping primitive'ini değiştirmez.
- 1,09×–1,39× hızlanma bütün ağlar, donanımlar ve cryptographic parameter set'leri için garanti değildir.
- Bootstrapping sayısının tek başına encrypted-inference performansını belirlediği sonucu çıkarılamaz.
- CAPR accuracy estimate nihai fully-trained encrypted-network accuracy değildir.
- Latency proxy gerçek latency'nin bütün setting'ler arasında mutlak saniye tahmincisi değildir; within-setting ranking signal olarak kullanılır.
- CLU'nun final optimum score'u belirgin biçimde iyileştirdiği söylenemez; ana yararı search trajectory'dedir.
- Offline search için verilen 1–4 günlük değerler ölçülmüş end-to-end wall-clock süreleri değil, serial estimates'tir.
- Çalışma compiler-side scheduling'i ikame etmemektedir.
- ResNet/VGG ve CIFAR-10/CIFAR-100 sonuçları Transformer mimarilerine doğrudan genellenemez.
Temel sınırlılıklar ve gelecek çalışma
Çalışma fixed encrypted backend altında offline structural design'a odaklanmaktadır. CipherAPR'ın oluşturduğu mixed-degree polynomial network, compiler-side bootstrapping scheduling'in yerine geçmez. Yazarlar structural design ile compiler scheduling'in birlikte optimize edilmesini doğal bir sonraki çalışma olarak görmektedir.
Daha derin CNN'lerde degree-assignment search space ve CAPR evaluation maliyeti activation layer sayısıyla büyür. Kaynak ResNet-110 gibi daha derin ağlarda daha verimli accuracy proxies veya hybrid importance metrics gerekebileceğini belirtmektedir.
Transformer architecture'lara genişletme de ayrı bir araştırma problemidir. Softmax, layer normalization ve attention blocks, CNN ReLU'larından farklı polynomial approximation ve ciphertext-level consumption özellikleri taşır. Bu nedenle mevcut ResNet/VGG sonuçları Transformer'a otomatik biçimde aktarılamaz.
Güvenlik kapsamı
CipherAPR'ın security discussion'ı standart FHE inference confidentiality ile sınırlıdır. Çevrimdışı aşamada LMAR, DAAP, MOCT, CAPR ve CLU kullanıcı inference ciphertext'lerini görmez. Online aşamada server:
hesabını standart RNS-CKKS üzerinde yürütür.
\(\tilde{f}\), CipherAPR'ın çevrimdışı ürettiği fixed public polynomial network; \(pk\), public evaluation key; \(ct_{\mathrm{in}}\) şifreli kullanıcı girdisi; \(ct_{\mathrm{out}}\) şifreli çıkarım sonucudur.
Kaynak, CipherAPR'ın standard encryption, decryption, key-switching veya bootstrapping mekanizmasına yeni bir cryptographic primitive eklemediğini vurgular. Dolayısıyla confidentiality claim mevcut RNS-CKKS security parameterization ve RLWE hardness assumptions ile sınırlıdır.
Kaynak ve Yöntem Notu
Özgün başlık: CipherAPR: Accelerating RNS-CKKS Encrypted Inference via Importance-Guided and Level-Aware Mixed-Degree Polynomial Design
Yazarlar: Junping Wan; Yucen Liao; Yinglong Liao; Zejiu Tan; Jinming Xu; Zoe L. Jiang; Binxing Fang.
Yazar sırası: Junping Wan birinci; Yucen Liao ikinci; Yinglong Liao üçüncü; Zejiu Tan dördüncü; Jinming Xu beşinci; Zoe L. Jiang altıncı; Binxing Fang yedinci yazardır.
Sorumlu yazarlar: Zoe L. Jiang ve Binxing Fang.
Kurum 1: School of Computer Science and Technology, Harbin Institute of Technology, Shenzhen 518055, China.
Kurum 2: Department of Optoelectronic Engineering, Jinan University, Guangzhou 510632, China.
Kurum 3: College of Control Science and Engineering, Zhejiang University, Hangzhou 310027, China.
Kurum 4: School of Cyberspace Security, Guangzhou University, Guangzhou 510006, China.
Eş katkı: Kaynakta eş birinci yazarlık veya eş katkı beyanı bulunmamaktadır.
Dergi: Cryptography.
Yayıncı: MDPI.
Cilt / sayı / makale: 10(4), Article 44.
Sayfa sayısı: 28.
DOI: 10.3390/cryptography10040044.
Gönderim: 11 Mayıs 2026.
Revizyon: 19 Haziran 2026.
Kabul: 19 Haziran 2026.
Yayın: 2 Temmuz 2026.
Kaynak türü: Hakemli araştırma makalesi; FHE altında encrypted neural-network inference için çevrimdışı algoritmik design/search, polynomial approximation, cryptographic execution benchmark ve ablation/sensitivity analizlerini birleştirmektedir.
Hakemlik: Cryptography hakemli bir MDPI dergisidir; MDPI'nin güncel süreç açıklamasında single-anonymized peer review kullanılmaktadır.
Preprint durumu: Verianla'da işlenen dosya yayımlanmış Version of Record'dur; bu çalışmada ayrı bir preprint temel alınmamıştır.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Anahtar kelimeler: encrypted inference; bootstrapping; ciphertext-level utilization; fully homomorphic encryption; RNS-CKKS.
Ana model ailesi: CIFAR-10 ve CIFAR-100 üzerinde ResNet20, ResNet32, ResNet44 ve VGG11.
Ana karşılaştırmalar: MPCNN ve AutoFHE. DaCapo, Orion ve ReSBM compiler-side execution optimizers olarak tartışılmış, structural-design benchmarkına doğrudan baseline olarak dahil edilmemiştir.
FHE altyapısı: RNS-CKKS; Microsoft SEAL; AutoFHE implementation altyapısı.
Security setting: Ring degree \(2^{16}\); modulus-chain length 1552 bit; private-key Hamming weight 192; 128-bit security.
Offline training donanımı: NVIDIA RTX A6000, Ubuntu 20.04.
Encrypted inference donanımı: Intel Xeon Platinum 8462Y+, 128 vCPU, 1 TiB RAM, Ubuntu 20.04.
Offline yazılım: Python 3.8, PyTorch 1.13.1.
Online encrypted execution: C++ ve Microsoft SEAL.
Ana yöntem bileşenleri: LMAR, probabilistic degree tuning, DAAP, MOCT, latency proxy, CAPR ve CLU.
Ana performans bulgusu: AutoFHE'ye göre değerlendirilen yapılandırmalarda 1,09×–1,39× encrypted-inference speedup; benzer ciphertext accuracy.
En yüksek raporlanan hızlanma örneği: CIFAR-10/ResNet20 yüksek bootstrapping setting'de AutoFHE 4659 s ve 11 bootstrapping; CipherAPR 3341 s ve 7 bootstrapping.
Approximation sonucu: DAAP + MOCT, Table 7'de Minimax'a göre MaxE değerini depth'e bağlı olarak %39,44–%85,39 azaltmıştır.
CLU sonucu: Accuracy-oriented ve latency-oriented search'te CLU final normalized best score'u büyük ölçüde değiştirmeden CLU-run best'e ulaşmak için gereken CAPR evaluations'ı sırasıyla 210/330 ve 180/330 düzeyine indirmiştir.
Finansman: National Key R&D Program of China (2023YFB3106500); National Natural Science Foundation of China (62272131); Shenzhen Social Science Fund (SZ2025B011); Shenzhen Science and Technology Major Project (KJZD20230923114908017).
Veri erişilebilirliği: Çalışmada sunulan verilerin corresponding author'dan makul talep üzerine sağlanabileceği belirtilmiştir. Kullanılan public datasets CIFAR-10 ve CIFAR-100'dür.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmektedir. Kaynak ayrıca funding sponsors'ın çalışma tasarımı, veri toplama/analiz/yorum, makale yazımı veya yayın kararında rol almadığını belirtmektedir.
Yazar katkıları: Conceptualization: Junping Wan, Jinming Xu, Zoe L. Jiang, Binxing Fang; methodology: Junping Wan, Yucen Liao, Yinglong Liao, Zejiu Tan; software: Junping Wan; validation: Junping Wan, Yucen Liao, Zejiu Tan; formal analysis: Junping Wan, Yinglong Liao, Zejiu Tan; investigation ve data curation: Junping Wan; resources: Zoe L. Jiang ve Binxing Fang; original draft: Junping Wan; review/editing: bütün yazarlar; visualization: Yucen Liao, Yinglong Liao ve Zejiu Tan; supervision/project administration/funding acquisition: Zoe L. Jiang ve Binxing Fang.
Etik kurul / bilgilendirilmiş onam: Kaynak PDF'de ayrı bir Institutional Review Board veya Informed Consent beyanı raporlanmamıştır. Çalışma CIFAR benchmarkları ve hesaplamalı şifreli çıkarım deneyleri üzerinde yürütülmektedir.
Temel yöntemsel sınırlar: Çalışma fixed RNS-CKKS backend altında offline structural design'a odaklanır; compiler scheduling'i ikame etmez. Offline search maliyeti activation-layer sayısıyla büyür. CAPR ve latency proxy screening araçlarıdır ve nihai full evaluation'ın yerine geçmez. Verilen 1–4 günlük search değerleri serial estimates'tir. Değerlendirme CIFAR-10/CIFAR-100 ve ResNet/VGG mimarileriyle sınırlıdır; Transformer mimarileri ayrıca araştırılmalıdır.
Security yorum sınırı: CipherAPR'ın güvenlik iddiası yeni bir cryptographic primitive'e ait değildir. Sistem standart RNS-CKKS encryption/decryption/key-switching/bootstrapping mekanizmasını kullanır; confidentiality kullanılan RNS-CKKS parameterization ve RLWE varsayımından miras alınır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir