


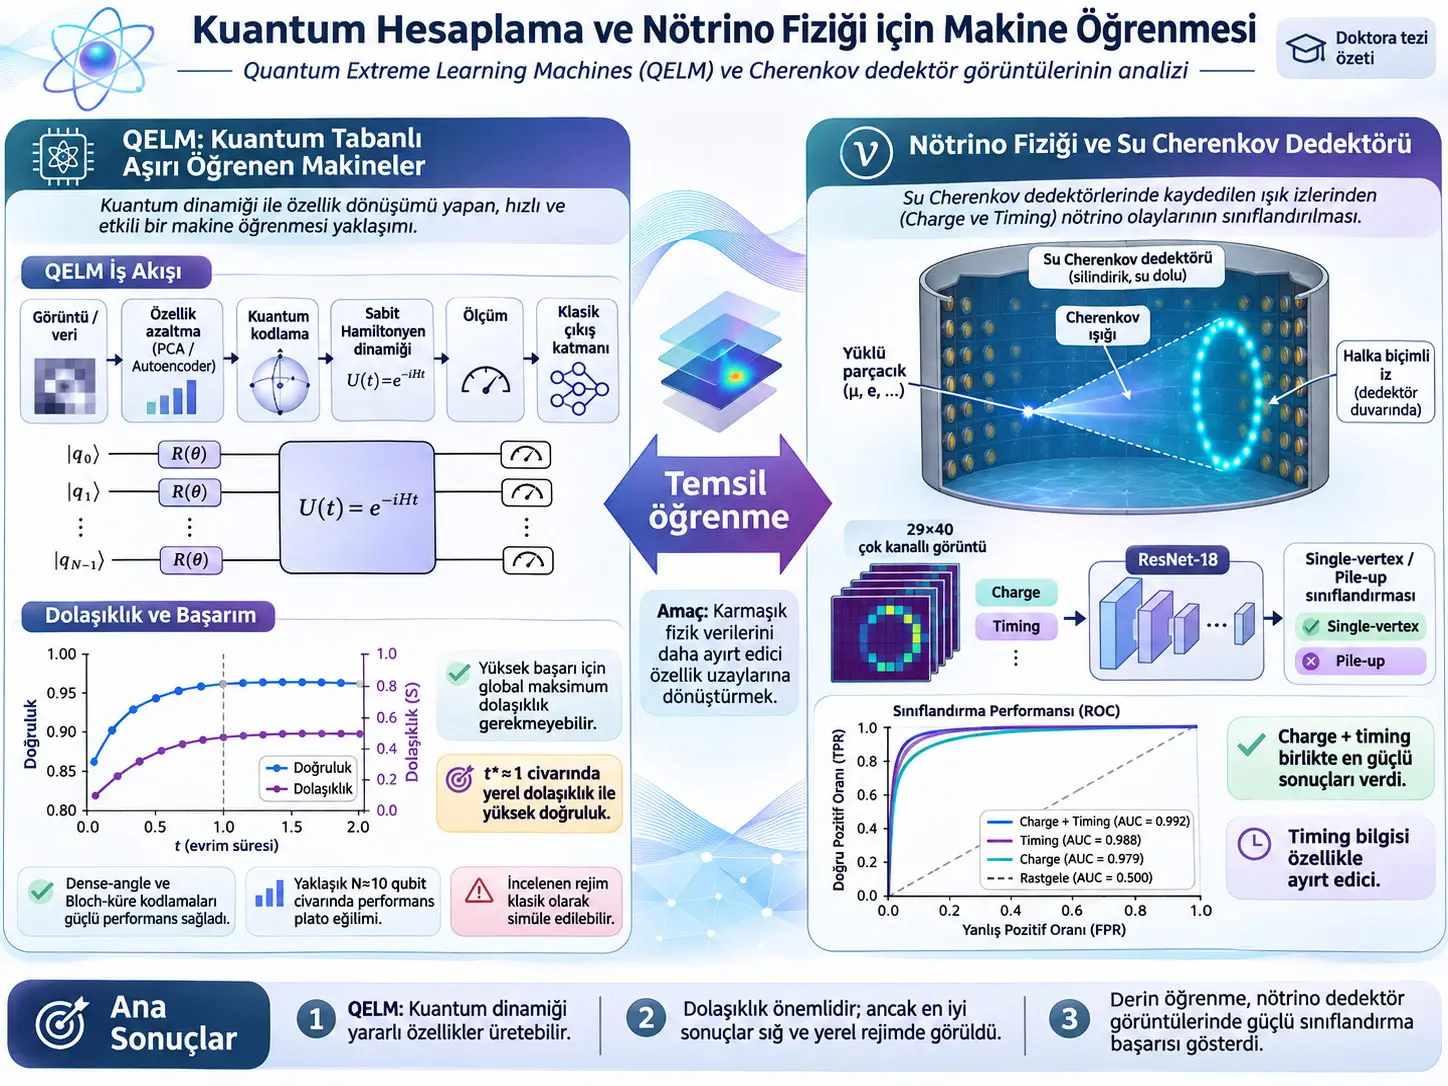
Quantum Extreme Learning Machine (QELM), klasik veriyi bir kuantum durumuna kodlayan, veriyi eğitilmeyen sabit kuantum dinamiğiyle dönüştüren ve yalnız son klasik okuma katmanını eğiten hibrit kuantum–klasik bir makine öğrenmesi mimarisidir. Bu doktora tezi, yüksek boyutlu fizik verilerinden etkili temsil üretme problemini iki farklı alanda inceler. Birinci araştırma hattı QELM'lerin görüntü sınıflandırmasında nasıl çalıştığını, veri sıkıştırma yönteminin, kuantum kodlamanın, Hamiltonyen dinamiğinin, ölçümün, dolaşıklığın ve klasik simüle edilebilirliğin performansı nasıl etkilediğini araştırır. İkinci araştırma hattı ise su Cherenkov nötrino dedektörlerinde ortaya çıkan charge ve timing görüntülerini ResNet-18 ile analiz ederek tek etkileşim noktalı olaylarla aynı okuma penceresinde birden fazla etkileşimin üst üste geldiği pile-up olaylarını ayırmayı inceler.
QELM tarafındaki ilk çalışma MNIST ve Fashion-MNIST görüntülerini önce Principal Component Analysis (PCA) veya convolutional autoencoder ile düşük boyutlu latent vektörlere sıkıştırır. Bu özellikler angle, dense-angle, uniform Bloch-sphere, general veya amplitude encoding kullanılarak qubit durumlarına dönüştürülür. Ardından sabit bir many-body Hamiltonian altında üniter zaman evrimi uygulanır. Computational-basis ölçümünden çıkan olasılık vektörü yalnızca klasik bir shallow output neural network tarafından öğrenilir. Sonuçlar, güçlü sıkıştırma altında nonlinear autoencoder temsillerinin PCA'dan daha etkili olduğunu ve iki özellik/qubit kullanan dense-angle ile uniform Bloch-sphere kodlamalarının performans–uygulanabilirlik açısından özellikle iyi bir denge sağladığını göstermektedir.
İlk QELM çalışmasında qubit sayısı arttıkça sınıflandırma doğruluğu hızla yükselir ve yaklaşık \(N\simeq10\) civarında plato eğilimi gösterir. Etkileşimli Hamiltonyenler yeterli bilgi yayılımı oluşturduğu sürece model performansı Hamiltonyenin mikroskobik ayrıntılarına şaşırtıcı derecede az duyarlıdır. Buna karşılık qubitlerin bağımsız kaldığı non-interacting durumlarda veya güçlü localization nedeniyle bilginin register boyunca yayılamadığı rejimlerde performans belirgin şekilde düşer. Bu sonuç, QELM'de gerekli olan unsurun özel bir “mucize Hamiltonyen” değil, kodlanmış bilgiyi ölçüm uzayında yeniden düzenleyebilen yeterince etkileşimli bir kuantum dinamiği olduğunu destekler.
Tezin ikinci QELM araştırması daha temel bir soruya yönelir: yüksek sınıflandırma başarısına ulaşmak için ne kadar kuantum dolaşıklığı gereklidir ve bu rejim klasik bilgisayarda hâlâ verimli biçimde simüle edilebilir mi? Dense-angle encoding ve periyodik sınır koşullu nearest-neighbour XX Hamiltonyeni sabitlenir; yalnızca evrim zamanı \(t\) değiştirilir. MNIST, Fashion-MNIST ve CIFAR-10 için doğruluk kısa zamanlarda düşük kalır, yaklaşık \(t^\*\sim1\) civarında hızla yükselir ve sonra plato yapar.
En önemli kuantum sonucu, bu geçişin sistemin tamamında volume-law dolaşıklık oluşmasından önce gerçekleşmesidir. Tek-qubit entropileri \(t=O(1)\) ölçeğinde hızla büyürken half-chain entropy'nin global saturation'a ulaşması \(t=O(N)\) zaman ister. XX zinciri için kullanılan birimlerde Lieb–Robinson hızı \(v_{\mathrm{LR}}=1\) olduğundan \(t^\*\sim1\) sırasında bilgi yalnız birkaç komşu siteye yayılmıştır. Buna rağmen QELM sınıflandırma doğruluğu zaten plato değerine ulaşmaktadır.
Bu bulgu “daha fazla dolaşıklık her zaman daha iyi makine öğrenmesi demektir” fikrini desteklememektedir. Tezin sonucuna göre incelenen görevlerde faydalı feature generation için güçlü yerel dolaşıklık yeterlidir; bütün zincirin global olarak scramble olması gerekmez. Dahası bu kısa-zaman dinamiği sabit derinlikli yerel devrelerle yaklaşık uygulanabilir ve Matrix Product State gibi tensor-network yöntemleri için hâlâ erişilebilir bir rejimdedir. Bu nedenle tez genel veya güçlü bir kuantum hesaplama üstünlüğü göstermemektedir.
Nötrino bölümünde temel fiziksel problem farklıdır. Nötrino dedektörde doğrudan görülmez; nötrino etkileşiminin ürettiği yüklü parçacıklar suda yeterince hızlı hareket ettiğinde Cherenkov ışığı üretir. Bu ışığın dedektör duvarındaki fotomultiplier tüplerine ulaşma konumu, miktarı ve zamanı olayın fiziksel topolojisi hakkında bilgi taşır. IWCD'nin silindirik yüzeyi \((\phi,z)\) koordinatlarında açılarak image-like bir 29×40 piksel temsiline dönüştürülür.
Her multi-PMT modülünde 19 ayrı PMT bulunduğundan en ayrıntılı görüntü temsili her piksel için 19 charge ve 19 timing kanalı, yani toplam 38 kanal içerir. ResNet-18 ile yapılan analizde charge ve timing birlikte kullanıldığında No-Physics testinde AUC 0,987, GENIE testinde AUC 0,990 elde edilir. Timing kanalları tek başına charge kanallarından daha ayırt edicidir ve yalnız ortalama/standart sapma kullanan daha kompakt 2Q+2T temsili de tam 19Q+19T temsilinin performansına oldukça yakın kalmaktadır.
Tez aynı nötrino problemine QELM'yi de proof-of-concept olarak uygular. Ancak karşılaştırma koşulları eşit değildir: QELM yalnız 60.000 NEUT olayından oluşan dengeli bir subset kullanır; 29×40 tam görüntüler önce PCA ile yalnız 20 özelliğe sıkıştırılır, sonra 10 qubit'e Bloch-sphere encoding ile kodlanır. En iyi time+charge konfigürasyonunda test AUC 0,6575, accuracy 0,6187 ve F1 0,6286 elde edilir. Bu performans ResNet-18'den belirgin biçimde düşüktür. Tez bunu QELM'nin ResNet'i yenmesi olarak değil, gerçekçi nötrino görüntülerine uygulanabilirliğinin ilk fizibilite gösterimi olarak yorumlar.
Quantum Extreme Learning Machine klasik bir sinir ağından nasıl farklıdır?
QELM'de klasik sinir ağlarının eğitilen derin hidden layer'ları yerine sabit bir kuantum sistemi feature generator olarak kullanılır; veri kuantum durumuna kodlanır, sabit Hamiltonyen altında evrilir ve ölçümden elde edilen olasılıklar yalnız son klasik readout katmanında öğrenilir.
Extreme Learning Machine fikri
Klasik Extreme Learning Machine yaklaşımının ana düşüncesi feature generation ile learning işlemini birbirinden ayırmaktır. Hidden layer parametreleri sabit tutulabilir; yalnız output layer eğitilir. QELM bu düşünceyi kuantum sistemine taşır.
Tezde kullanılan temel QELM pipeline'ı dört adımdan oluşur:
- Yüksek boyutlu klasik veri PCA veya autoencoder ile sıkıştırılır.
- Latent özellikler \(N\) qubit'lik bir kuantum durumuna kodlanır.
- Kuantum durumu sabit bir many-body Hamiltonian altında belirli süre evrilir.
- Computational-basis ölçüm olasılıkları klasik bir shallow classifier'a verilir.
Qubit nedir?
Klasik bit yalnız 0 veya 1 değerini alırken bir qubit'in saf durumu:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle, \qquad |\alpha|^2+|\beta|^2=1 \]
şeklinde yazılır. \(\alpha\) ve \(\beta\) kompleks probability amplitude'lardır. Ölçüm yapıldığında \(|0\rangle\) sonucu \(|\alpha|^2\), \(|1\rangle\) sonucu \(|\beta|^2\) olasılıkla elde edilir.
Bloch küresi kullanıldığında aynı durum:
\[ |\psi\rangle= \cos\left(\frac{\theta}{2}\right)|0\rangle + e^{i\phi} \sin\left(\frac{\theta}{2}\right)|1\rangle \tag{4.9} \]
şeklinde ifade edilir. \(\theta\) kutupsal, \(\phi\) azimut açısıdır. QELM'nin birçok encoding yöntemi klasik özellikleri doğrudan bu iki açıya yerleştirir.
Hilbert uzayı neden önemlidir?
\(N\) qubit'lik sistemin durum uzayı:
\[ \mathcal{H}_N=(\mathbb{C}^2)^{\otimes N} \]
ve boyutu:
\[ \dim(\mathcal{H}_N)=2^N \]
olur.
Bu üstel büyüme, az sayıda qubit ile yüksek boyutlu state representation oluşturulabilmesinin matematiksel temelidir. Ancak \(2^N\) boyutlu state space'in varlığı otomatik olarak kuantum üstünlüğü yaratmaz; bu state'in hazırlanması, evrilmesi, ölçülmesi ve elde edilen bilgilerin sınıflandırma açısından gerçekten yararlı olması gerekir.
Klasik özellikler qubit'lere nasıl kodlanıyor?
Tez, klasik latent özelliklerin qubit genliklerine veya Bloch-küresi açılarına yerleştirildiği beş encoding ailesini karşılaştırır; bu yöntemler qubit başına taşınan özellik sayısı ile state-preparation devre derinliği arasında farklı ödünleşimler oluşturur.
Dense-angle encoding
Dense-angle encoding her qubit'e iki özellik yerleştirir:
\[ |x\rangle = \bigotimes_{i=1}^{\lceil M/2\rceil} \left[ \cos\left(\frac{x_{2i-1}}{2}\right)|0\rangle + e^{ix_{2i}} \sin\left(\frac{x_{2i-1}}{2}\right)|1\rangle \right]. \tag{4.10} \]
Burada \(x_{2i-1}\) polar açıya, \(x_{2i}\) faz açısına dönüştürülür. Böylece tek qubit iki klasik özellik taşır.
Angle encoding
Angle encoding yalnız polar açıyı kullanır:
\[ |x\rangle = \bigotimes_i \left[ \cos\left(\frac{x_i}{2}\right)|0\rangle+ \sin\left(\frac{x_i}{2}\right)|1\rangle \right]. \tag{4.11} \]
Her qubit yalnız bir özellik taşır. Avantajı state preparation'ın oldukça sığ olmasıdır; dezavantajı aynı sayıda özelliği kodlamak için dense-angle'a göre daha fazla qubit gerekebilmesidir.
Uniform Bloch-sphere encoding
Kaynak bu kodlamayı:
\[ |x\rangle = \bigotimes_i \left[ \sqrt{x_{2i-1}}|0\rangle+ e^{ix_{2i}} \sqrt{1-x_{2i-1}}|1\rangle \right] \tag{4.12} \]
şeklinde verir. İlk özellik population ağırlığını, ikinci özellik relative phase'i kontrol eder.
Amplitude encoding
Amplitude encoding:
\[ |x\rangle = \frac{1}{\|x\|_2} \sum_{i=0}^{2^N-1}x_i|i\rangle \tag{4.14} \]
ile \(N\) qubit'e teorik olarak \(2^N\) özellik yerleştirebilir. Qubit sayısı açısından çok kompakt görünse de generic amplitude state preparation derin ve çok-qubit entangling circuit gerektirebilir. Tez bu nedenle amplitude encoding'in NISQ uygulanabilirliğinin angle-tabancı kodlamalara göre daha zor olduğunu vurgular.
| Kodlama | Qubit başına özellik | Tipik devre derinliği | Temel ödünleşim |
|---|---|---|---|
| Angle | 1 | Düşük | Basit state preparation; daha fazla qubit gerekebilir |
| Dense-angle | 2 | Düşük | İki Bloch parametresini kullanır; faz kontrolü gerekir |
| Uniform Bloch-sphere | 2 | Düşük | Population ve fazı birlikte kodlar |
| General | 2 | Düşük | Genliklerin doğrudan normalize parametrizasyonu |
| Amplitude | \(2^N\) toplam özelliğe kadar | Yüksek | Qubit-verimli fakat generic state preparation maliyetli |
İlk görüntü sınıflandırma çalışmasında dense-angle ve uniform Bloch-sphere kodlamaları genel olarak en iyi performans–uygulanabilirlik dengesini verir. General encoding özellikle küçük qubit sayılarında daha kötü sonuç verir. Amplitude encoding ise latent feature sayısı yeterince büyüdüğünde iyileşir; ancak aynı qubit sayısında bütün 784 MNIST pikselinin amplitude encoding ile doğrudan kullanıldığı durumda \(N=10-12\) için test accuracy yaklaşık 0,97 düzeyinde kalır ve dense-angle + compressed latent representation yaklaşımından biraz daha düşük sonuç verir.
QELM'de Hamiltonyen neden eğitilmiyor?
QELM'nin amacı kuantum dinamiğini trainable variational circuit olarak optimize etmek değil, sabit bir fiziksel sistemin klasik veriyi yararlı bir feature space'e dönüştürme kapasitesini incelemektir; bu nedenle Hamiltonyen parametreleri sabit tutulur ve eğitim yalnız klasik output layer'da yapılır.
Kuantum state'in zaman evrimi:
\[ U(t)=e^{-iHt} \tag{4.15} \]
ile tanımlanır. Burada \(H\) Hamiltonyen, \(t\) evrim süresidir. \(\hbar=1\) birimleri kullanıldığında üstel form bu şekilde yazılır.
Kodlanmış başlangıç durumu:
\[ |\psi(t)\rangle=U(t)|\psi_0(z)\rangle \]
olur.
Hamiltonyenin görevi sınıf etiketini “öğrenmek” değildir. Görevi başlangıçtaki yerel veya düşük karmaşıklıklı feature bilgisini register üzerinde yeniden dağıtarak computational-basis measurement'da sınıfları ayırmaya daha elverişli bir probability representation üretmektir.
İlk çalışmada neden altı farklı Hamiltonyen kullanılıyor?
Tez connectivity, integrability, chaos ve localization'ın QELM performansında gerçekten belirleyici olup olmadığını test etmek için birbirinden fiziksel olarak farklı Hamiltonyen ailelerini kullanır.
| Model | Tür | Temel amaç |
|---|---|---|
| \(H_1\) | Periodically driven long-range Ising | Uzun menzilli güçlü karıştırıcı reservoir |
| \(H_2\) | Fully connected disordered transverse-field Ising | Disorder ve tam bağlantılı etkileşimi test etmek |
| \(H_3\) | Chaotic nearest-neighbour Ising | Lokal fakat non-integrable/ergodic dinamik |
| \(H_4\) | Nearest-neighbour XXZ | Anisotropic lokal many-body dinamik |
| \(H_5\) | Integrable XX chain | Basit, lokal ve tam çözülebilir reservoir |
| \(H_6\) | Disordered long-range \(xx\) + random fields | Ergodic, non-ergodic ve localized rejimleri karşılaştırmak |
Long-range Ising \(H_1\)
Kaynakta:
\[ H_1(t)= \begin{cases} B_1\displaystyle\sum_i\sigma_x^{(i)}, & 0\le t<T_1,\\ \displaystyle\sum_{i,j}J_{ij}^{(1)}\sigma_z^{(i)}\sigma_z^{(j)}, & T_1\le t<T, \end{cases} \tag{4.16} \]
ve:
\[ J_{ij}^{(1)}= \frac{J_0}{|i-j|^\alpha} \tag{4.17} \]
kullanılır.
Parametreler \(J_0=0.06\), \(\alpha=1.51\), \(B_1=3.05\) ve \(T=2T_1=1\) olarak verilir. İlk çalışmanın simülasyonunda bu dinamik \(\Delta t=50T\) kadar uygulanır.
Integrable XX modeli \(H_5\)
XX zinciri:
\[ H_5= \frac12 \sum_{i=1}^{N} \left( \sigma_x^{(i)}\sigma_x^{(i+1)} + \sigma_y^{(i)}\sigma_y^{(i+1)} \right) \tag{4.24} \]
ve periyodik sınır koşulu:
\[ \sigma^{(N+1)}\equiv\sigma^{(1)} \]
ile kullanılır.
XX modeli Jordan–Wigner dönüşümüyle free fermion sistemine eşlenebilen integrable bir modeldir. Buna rağmen sınıflandırma için gerekli yerel entanglement ve ballistic information propagation üretebilir. Tezin ikinci QELM çalışmasında özellikle bu model seçilir çünkü fiziksel dinamik ile classification transition arasındaki ilişkiyi daha temiz incelemek mümkündür.
Localized rejim neden kötü performans veriyor?
Bilgi register boyunca yayılmazsa farklı qubit'lere kodlanmış özellikler measurement öncesinde yeterince karışmaz. Non-interacting \(H_2\) limitinde qubitler bağımsız hareket eder. Güçlü many-body localization rejiminde ise etkileşim bulunsa bile başlangıç bilgisinin spatial spreading'i ciddi biçimde bastırılır.
Kaynak her iki durumda da high-accuracy plateau'nun bozulduğunu gösterir. Bu sonuç “chaos zorunludur” dememektedir; integrable XX zinciri de iyi çalışabilir. Gerekli olan, incelenen sınıflandırma görevi için yeterli feature redistribution'dır.
Ölçüm neden kuantum feature map'in kritik bir parçasıdır?
Kuantum state'in kendisi klasik classifier'a doğrudan verilmez; classifier yalnız ölçüm olasılıklarını gördüğü için Hamiltonyen eigenbasis'i ile measurement basis arasındaki ilişki hangi kuantum girişim bilgisinin klasik feature'a dönüşeceğini belirler.
Hamiltonyenin spektral ayrışımı:
\[ H=\sum_n E_n|E_n\rangle\langle E_n| \tag{4.29} \]
olsun. Başlangıç durumu:
\[ |\psi(0)\rangle=\sum_n c_n|E_n\rangle \tag{4.30} \]
ve zamanla:
\[ |\psi(t)\rangle= \sum_n c_ne^{-iE_nt}|E_n\rangle \tag{4.31} \]
şeklinde evrilir.
\(|s_k\rangle\) ölçüm basis'indeki sonuç olasılığı Born kuralıyla:
\[ p_k(t)=|\langle s_k|\psi(t)\rangle|^2 \tag{4.32} \]
olur.
Kaynak bunu açarak:
\[ p_k(t)= \sum_{n,m} \langle s_k|E_n\rangle \langle E_m|s_k\rangle e^{-i(E_n-E_m)t} c_nc_m^\ast \tag{4.33} \]
ifadesini elde eder.
Bu denklem çok önemlidir. Measurement basis Hamiltonyen eigenbasis'le tamamen aynıysa off-diagonal interference contributions kaybolur ve:
\[ p_k(t)=|c_k|^2 \tag{4.34} \]
zamanla değişmez. Böyle bir ölçüm quantum dynamics'in feature enrichment kapasitesini kullanamaz.
Buna karşılık measurement basis ile enerji eigenbasis'i yeterince farklıysa \(E_n-E_m\) enerji farklarından gelen interference terms probability vector'ü zamanla karmaşık biçimde yeniden düzenleyebilir.
QELM'nin klasik çıkış katmanı
Ölçüm probability vector'ü:
\[ \mathbf{p}(t)= \left(p_s(t)\right)_{s\in\{0,1\}^N} \]
klasik feature vector olarak kullanılır.
Çıkış katmanı:
\[ \mathbf{a}=W\mathbf{p}(t)+\mathbf{b} \tag{4.36} \]
logit'lerini üretir ve softmax:
\[ y_c= \frac{e^{a_c}} {\sum_{c'=1}^{C}e^{a_{c'}}} \tag{4.37} \]
ile class probability'lere dönüştürür.
Categorical cross-entropy:
\[ \mathcal{L} = -\sum_{c=1}^{C}t_c\log y_c \tag{4.38} \]
minimize edilir. QELM mimarisinde trainable parametreler \(W\) ve \(b\)'dir; kuantum reservoir'in kendisi eğitilmez.
QELM için çok dolaşıklık mı, doğru miktarda yerel dolaşıklık mı gerekiyor?
Bu tezde incelenen XX-tabanlı QELM için yüksek sınıflandırma doğruluğu global olarak maksimum veya volume-law dolaşık bir state gerektirmiyor; doğruluk platosu komşu qubit'ler arasında yerel dolaşıklığın oluştuğu fakat zincirin tamamının henüz güçlü biçimde dolaşmadığı \(t^\*\approx1\) rejiminde ortaya çıkıyor.
İkinci QELM çalışmasının kontrollü kurulumu
Bu çalışma yorumlamayı kolaylaştırmak için mimariyi büyük ölçüde sabitler:
- feature reduction pipeline sabittir,
- encoding her zaman dense-angle'dır,
- Hamiltonyen periyodik sınır koşullu nearest-neighbour XX zinciridir,
- measurement computational basis'tedir,
- değiştirilen ana continuous hyperparameter yalnız evolution time \(t\)'dir.
XX Hamiltonyeni:
\[ H= \frac12 \sum_{i=1}^{N} \left( \sigma_x^{(i)}\sigma_x^{(i+1)} + \sigma_y^{(i)}\sigma_y^{(i+1)} \right) \tag{6.1} \]
ve:
\[ |\psi_t(z)\rangle = e^{-iHt}|\psi_0(z)\rangle \tag{6.2} \]
kullanılır.
Üç performans bölgesi
MNIST, Fashion-MNIST ve CIFAR-10'da accuracy–time eğrileri genel olarak üç bölge gösterir:
1. Kısa zaman: Dinamik encoded state'i henüz yeterince değiştirmemiştir ve accuracy düşüktür.
2. Geçiş: \(t^\*\sim1\) civarında training ve test accuracy hızla yükselir.
3. Plato: \(t\gtrsim t^\*\) sonrasında accuracy dataset ve \(N\)'ye bağlı plato değerine ulaşır.
Geçiş zamanının incelenen sistem büyüklüklerinde \(N\)'ye neredeyse bağımsız olması özellikle önemlidir. Eğer classification için bütün zincirin global scrambling'i gerekli olsaydı gerekli zamanın sistem boyutuyla büyümesi beklenirdi.
Yerel ve global entanglement zaman ölçekleri
Tek-qubit entropy hızlı yükselir ve:
\[ t=O(1) \]
ölçeğinde doyuma yaklaşır. Bu, her qubit'in yakın çevresiyle dolaşıklık kurduğunu gösterir.
Half-chain entropy ise zincirin yarısını diğer yarısından ayıran bipartition'daki global entanglement'ı ölçer ve volume-law saturation için:
\[ t=O(N) \]
ölçeğine ihtiyaç duyar.
Classification transition \(t^\*\approx1\) ilk zaman ölçeğiyle çakışır, ikinciyle değil.
Lieb–Robinson hızı nedir?
Yerel Hamiltonyenlerde bilgi ve korelasyonların uzayda keyfi biçimde anında yayılmasını engelleyen etkili bir hız sınırı vardır. Bu davranış Lieb–Robinson bound ile tarif edilir.
Tezin XX modeli ve kullanılan birimleri için:
\[ v_{\mathrm{LR}}=1 \]
elde edilir.
Bu nedenle \(t\lesssim1\) olduğunda bir qubit'in bilgisi yalnız yaklaşık bir lattice spacing mertebesindeki komşulara güçlü biçimde ulaşabilir. QELM accuracy'nin aynı zamanda plato yapması, classification için uzak sitelerin global olarak dolaşmasına gerek olmadığını destekler.
Haar-random unitary karşılaştırması
Kaynak, XX evolution'ın plateau accuracy'sini aynı encoded state'lere uygulanan Haar-distributed random unitary'lerle karşılaştırır. Her \(N\) ve dataset için 10 bağımsız Haar-random unitary örneği kullanılır.
XX-QELM'nin \(t\gtrsim t^\*\) plato değeri, numerical uncertainties içinde Haar-random unitary performansıyla örtüşür. Fakat XX modeli Haar-random state kadar global scramble olmadan aynı classification seviyesine ulaşabilmektedir.
Shallow random circuits
Analog XX dynamics ayrıca nearest-neighbour random two-qubit gates kullanan brickwork digital circuit ile karşılaştırılır. Tez, yalnız birkaç layer'ın—tipik olarak yaklaşık dört ila altı katmanın—analog XX plateau'suna çok yakın accuracy üretebildiğini bildirir.
Bu sonuç effective circuit depth'in \(N\) ile büyümediği ve relevant dynamics'in shallow kaldığı yorumunu güçlendirir.
Neden bu sonuç güçlü kuantum üstünlüğü değildir?
Bir boyutlu, kısa derinlikli, yerel dolaşıklığın sınırlı kaldığı kuantum devreleri Matrix Product State gibi tensor-network yöntemleriyle çoğu durumda verimli biçimde simüle edilebilir. Tezin classification için yararlı bulduğu \(t^\*\) rejimi tam olarak bu yapıya yakındır.
Bu nedenle kaynak sonucu “kuantum feature map faydasızdır” değildir. Sonuç daha nüanslıdır: kuantum dinamiği sınıfları daha iyi ayrılabilir feature geometry'ye taşıyabilir; fakat incelenen görevlerde bunun gerçekleştiği dinamik rejim hâlâ klasik olarak erişilebilir olabilir.
Probability polytope ne demektir?
Her input sample için QELM ölçümü:
\[ p_t(s|z)=|\langle s|\psi_t(z)\rangle|^2 \tag{6.7} \]
olasılıklarını verir.
Bütün \(2^N\) bit-string olasılığı:
\[ \mathbf{p}_t(z) = \left( p_t(s_1|z),\ldots,p_t(s_{2^N}|z) \right) \tag{6.6} \]
bir probability simplex içinde bulunur:
\[ \Delta_{2^N-1} = \left\{ \mathbf{p}\in\mathbb{R}^{2^N} \;\middle|\; p_i\ge0,\; \sum_i p_i=1 \right\}. \tag{6.8} \]
Tez bu sample cloud'una “probability polytope” adını verir.
K-means inertia:
\[ I= \sum_{k=1}^{K} \sum_{x_j\in C_k} \|x_j-\mu_k\|_2^2 \tag{6.9} \]
ile cluster compactness ölçülür. \(I\) küçüldükçe cluster'lar centroid çevresinde daha sıkı toplanır.
Çalışma, QELM accuracy transition sırasında probability-space cluster'ların class labels ile daha uyumlu hale geldiğini; buna karşılık tek-site local observables'ın zamanla sınıf bilgisini kaybedebildiğini gösterir. Yani bilgi yok olmamaktadır; local observables'dan global correlation structure'a taşınmaktadır.
Nötrino neden doğrudan görüntülenmiyor ve Cherenkov halkaları nasıl oluşuyor?
Su Cherenkov dedektöründe nötrino doğrudan ışık üretmez; nötrino etkileşiminin oluşturduğu elektrik yüklü parçacıklar suda ışığın faz hızından hızlı hareket ettiğinde koni biçimli Cherenkov radyasyonu üretir ve bu koninin dedektör yüzeyiyle kesişimi PMT'lerde halka-benzeri görüntüler oluşturur.
Cherenkov koşulu
Bir parçacığın suda Cherenkov radyasyonu üretebilmesi için:
\[ v>\frac{c}{n} \]
olmalıdır.
Burada \(v\) parçacık hızı, \(c\) vakumdaki ışık hızı, \(n\) ortamın refractive index değeridir.
Cherenkov açısı:
\[ \cos\theta_C= \frac{1}{\beta n}, \qquad \beta=\frac{v}{c} \]
ilişkisiyle verilir.
Su için optik bölgede yaklaşık \(n\approx1.33\) ve çok relativistik \(\beta\rightarrow1\) parçacıklar için maksimum açı yaklaşık \(42^\circ\)'dir.
PMT'lerde görülen halka yalnız parçacığın varlığını değil; direction, vertex position, propagation length ve light timing gibi olay geometrisine ilişkin bilgileri de taşır.
Single-vertex ve pile-up neden karıştırılabilir?
Single-vertex olay tek neutrino interaction vertex içerir ancak bu interaction birden çok charged particle üretebilir. Dolayısıyla tek-vertex olayda bile birden fazla Cherenkov ring görülebilir.
Pile-up olayında ise aynı detector readout window içinde iki veya daha fazla bağımsız interaction oluşur. Birden fazla vertex'in halkaları birbirine binebilir.
Bu nedenle “bir ring = single vertex, çok ring = pile-up” gibi basit bir kural geçerli değildir. Modelin spatial ve temporal structure'ı birlikte öğrenmesi gerekir.
Charge ve timing neden birbirini tamamlıyor?
Charge, PMT'ye ulaşan ışık miktarıyla ilişkilidir ve event morphology/brightness bilgisini taşır.
Timing, fotonların sensöre ne zaman ulaştığını gösterir ve vertex geometry, particle propagation ve farklı interactions'ın temporal separation'ına duyarlıdır.
Tez sonuçlarında timing-only representation'ın charge-only representation'dan daha iyi classification vermesi, pile-up probleminin güçlü temporal component'ini doğrular.
IWCD görüntüsü yapay sinir ağına nasıl dönüştürülüyor?
Silindirik IWCD yüzeyi \((\phi,z)\) koordinatlarında açılarak her multi-PMT modülünün bir piksele dönüştürüldüğü 29×40 görüntü oluşturulur; her pikseldeki 19 PMT'nin charge ve timing değerleri ayrı kanallar veya özet istatistikleri olarak sinir ağına verilir.
Simülasyon zinciri
Detector response WCSim ile simüle edilir. No-Physics dataset'te neutrino–nucleus interaction generator kullanılmadan final-state particle tracks doğrudan üretilir. Amaç classifier'ın generator-specific ayrıntıları değil, single-vertex/pile-up topolojisini öğrenmesini sağlamaktır.
No-Physics veri kümesinde:
- electron, muon, \(\pi^0\) ve \(\pi^-\) kullanılır,
- track yönleri isotropic örneklenir,
- toplam visible energy en fazla 2000 MeV'dir,
- single-vertex ve pile-up oranı eşittir,
- 5 milyon olay training için,
- 1 milyon bağımsız olay test için kullanılır.
GENIE ve NEUT veri kümeleri gerçekçi neutrino–nucleus interaction generator'ları kullanır. Her biri 1 milyon olay içerir ve yaklaşık %32 single-vertex, %68 pile-up kompozisyonuna sahiptir. Bu kümeler realistic generalization testleri olarak kullanılır.
29×40 piksel neden 38 kanala kadar çıkıyor?
Her multi-PMT modülü bir image pixel'dir. Bir modülde 19 PMT bulunduğundan her PMT için:
19 charge channel + 19 timing channel = 38 channel
elde edilir.
Kaynak notation'ı:
| Gösterim | İçerik |
|---|---|
| 19Q | 19 ayrı charge kanalı |
| 19T | 19 ayrı timing kanalı |
| 19Q+19T | 38 tam kanal |
| 2Q | 19 charge değerinin mean + standard deviation özeti |
| 2T | 19 timing değerinin mean + standard deviation özeti |
| 2Q+2T | Charge ve timing için dört özet kanal |
Double-cover neden gerekli?
Silindirik yüzey düz bir dikdörtgene açıldığında \(\phi=0\) ve \(\phi=2\pi\) fiziksel olarak komşu olmasına rağmen görüntünün sol ve sağ kenarlarına ayrılır. Standart convolution bu iki kenarı uzak noktalar sanabilir.
Double-cover construction görüntünün ilgili kısımlarını çoğaltıp yeniden düzenleyerek periodic cylindrical boundary'yi CNN için daha fiziksel biçimde temsil eder.
ResNet-18 mimarisi
Tez standard ResNet-18'in residual yapısını korur fakat detector images içindeki ince spatial bilgiyi korumak amacıyla giriş stem'ini uyarlar.
Dört residual stage:
| Aşama | Çıkış kanalı | Residual block | İlk block stride |
|---|---|---|---|
| Layer 1 | 64 | 2 | 1 |
| Layer 2 | 128 | 2 | 2 |
| Layer 3 | 256 | 2 | 2 |
| Layer 4 | 512 | 2 | 2 |
Residual block'un temel işlemi:
\[ y=F(x,W)+x \]
şeklindedir. Shortcut connection, öğrenilecek mapping'in tamamını sıfırdan üretmek yerine residual değişimi öğrenmeyi kolaylaştırır ve derin ağlarda gradient flow'u destekler.
Stage sonunda adaptive average pooling her feature map'i 1×1 değere indirir. 512-dimensional vector flatten edilir ve fully connected output layer'a verilir.
ResNet eğitim parametreleri
| Parametre | Değer |
|---|---|
| Optimizer | Adam |
| Learning rate | 0,01 |
| Epoch | 20 |
| Batch size | 512 |
| Görev | İki sınıflı classification |
| Loss | Cross-entropy |
| Training augmentation | Uygulanır |
| Validation / test augmentation | Uygulanmaz |
Çalışmanın Yöntemi ve Bulguları
İlk QELM görüntü sınıflandırma çalışmasında hangi bileşen gerçekten belirleyici oldu?
İlk çalışmada en güçlü etkiler feature reduction ve encoding seçiminden geliyor; nonlinear convolutional autoencoder'lar PCA'dan daha iyi latent representation üretirken dense-angle ve uniform Bloch-sphere encoding iki özellik/qubit kullanarak yüksek performans ve görece sığ state preparation arasında iyi denge sağlıyor.
Veri kümeleri ve ön işleme
İlk QELM çalışmasında MNIST ve Fashion-MNIST 28×28 grayscale görüntüler kullanılır. Piksel değerleri 255'e bölünerek [0,1] aralığına normalize edilir. Ek denoising veya data augmentation uygulanmaz.
PCA kullanıldığında 28×28 görüntü 784-dimensional vektöre flatten edilir ve ilk \(d\) principal component'e project edilir.
Autoencoder kullanıldığında doğal 28×28 tensor encoder'a girer ve yalnız \(d\)-boyutlu bottleneck vector saklanır.
Baseline configuration:
| Bileşen | Referans seçim |
|---|---|
| Feature reduction | Autoencoder AE1 |
| Encoding | Dense-angle |
| Hamiltonyen | Periodically driven long-range \(H_1\) |
| Classical readout | Feed-forward neural network |
| En büyük qubit sayısı | \(N=12\) |
\(N=12\), bu çalışmada full quantum dynamics'in classical simulation açısından pratik sınırı olarak belirtilmektedir. Bu sınır gerçek quantum hardware'ın maksimum qubit sayısı değildir.
PCA ve autoencoder sonucu
AE1 ve AE2 convolutional autoencoder'ları PCA'dan daha iyi classification accuracy sağlar. Daha büyük AE1 daha düşük reconstruction error ve daha iyi latent representation üretir; buna karşılık daha fazla trainable parameter ve training cost taşır.
Kaynak bu sonucu özellikle güçlü sıkıştırma rejiminde yorumlar: quantum layer'a yalnız az sayıda feature gönderilebildiğinde hangi bilginin korunacağı son classification başarısını ciddi biçimde etkiler.
Encoding sonucu
Dense-angle ve uniform Bloch-sphere, training ve test açısından en güçlü single-qubit encoding yöntemleri arasında yer alır. Simple angle bir özellik/qubit kullandığı için aynı \(N\)'de daha az classical information taşır.
Amplitude encoding'in avantajı \(2^N\) özelliğe kadar compact state representation sağlayabilmesidir; dezavantajı generic state preparation'ın experimentally demanding olmasıdır.
Hamiltonyen sonucu
İncelenen interaction Hamiltonian'ların çoğu \(N\) arttıkça birbirine çok yakın performance verir ve yaklaşık \(N\simeq10\) civarında plato yapar.
Bu sonuç integrability veya chaos'un önemsiz olduğunu evrensel biçimde kanıtlamaz. Çalışmanın daha dar sonucu şudur: test edilen image-classification problemleri ve system-size aralığında, bilgi sufficiently spread edildiği sürece Hamiltonian'ın microscopic details'i accuracy üzerinde sınırlı fark yaratmaktadır.
Non-interacting veya strongly localized dynamics ise belirgin biçimde daha kötü sonuç verir.
Classical baseline sınırı
İlk çalışma QELM'yi original 784 pixels ile beslenen tek-layer neural network ve AE1 latent features ile beslenen klasik output network gibi baselines ile karşılaştırır. Daha yüksek \(N\) değerlerinde QELM bu baselines'ın üzerinde performans gösterebilir.
Ancak bundan “QELM bütün klasik makine öğrenmesi modellerini geçmektedir” sonucu çıkarılamaz. Karşılaştırma belirli shallow baselines ile yapılmıştır; daha güçlü modern classical models'in tamamını kapsayan benchmark değildir.
İkinci QELM çalışması neden kuantum üstünlüğü iddiasını sınırlandırıyor?
Çünkü en yüksek classification performance, global volume-law dolaşıklık oluşmadan önce, kısa-zamanlı ve yerel dolaşıklığın baskın olduğu sabit-derinlikli rejimde ortaya çıkıyor; bu rejim tensor-network ve shallow random-circuit yaklaşımlarıyla klasik olarak erişilebilir kalıyor.
Temel sonuçlar:
| Bulgusal öğe | Kaynak sonucu | Yorum |
|---|---|---|
| Accuracy transition | \(t^\*\sim1\) | İncelenen \(N\) değerlerine büyük ölçüde bağımsız |
| Local entanglement | \(t=O(1)\) | Classification transition ile aynı ölçek |
| Half-chain volume-law saturation | \(t=O(N)\) | High accuracy için gerekli değil |
| Lieb–Robinson velocity | \(v_{\mathrm{LR}}=1\) | \(t\sim1\)'de bilgi yalnız yakın çevreye yayılmıştır |
| Haar-random comparison | Plateau accuracy numerical uncertainties içinde uyumlu | XX dynamics random-like useful representation üretebilir |
| Digital random circuits | Tipik 4–6 layer plateau'ya yaklaşabilir | Sığ dinamik yeterli olabilir |
| Classical simulability | Tensor-network ile uyumlu rejim | Generic strong quantum advantage kanıtı yok |
Tezin bu bölümünün desteklediği yorum
Kuantum dinamiği classical data'nın representation geometry'sini yararlı biçimde dönüştürebilir. Entanglement bu dönüşümde rol oynar. Fakat “faydalı entanglement” ile “maksimum/global entanglement” aynı şey değildir.
Tezin bu bölümünün desteklemediği yorum
Bu sonuçlardan fault-tolerant quantum computer advantage, exponential speedup veya classical algorithms için intractability sonucu çıkarılamaz. İncelenen rejim tam tersine classical tractability ile uyumludur.
ResNet-18 nötrino olaylarını ne kadar iyi ayırdı?
Charge ve timing bilgilerinin birlikte kullanıldığı tam 19Q+19T temsili No-Physics dataset'te AUC 0,987 ve GENIE dataset'te AUC 0,990 verir; timing-only temsil charge-only'den daha iyi performans gösterirken 2Q+2T compact temsil tam kanal girdisine çok yakın kalır.
| Konfigürasyon | Loss | Accuracy | F1 | AUC |
|---|---|---|---|---|
| 19Q + 19T | 0,128 | 0,954 | 0,953 | 0,987 |
| 2Q + 2T | 0,136 | 0,951 | 0,950 | 0,986 |
| 19T | 0,142 | 0,949 | 0,948 | 0,985 |
| 19Q | 0,212 | 0,916 | 0,913 | 0,970 |
| Konfigürasyon | Loss | Accuracy | F1 | AUC |
|---|---|---|---|---|
| 19Q + 19T | 0,114 | 0,954 | 0,966 | 0,990 |
| 2Q + 2T | 0,126 | 0,950 | 0,963 | 0,987 |
| 19T | 0,126 | 0,950 | 0,963 | 0,988 |
| 19Q | 0,180 | 0,924 | 0,943 | 0,976 |
Bu sonuçlarda timing information'ın güçlü olması fiziksel olarak anlamlıdır. Pile-up olaylarının temel özelliği yalnız spatial overlap değil, aynı readout window'da farklı zamanlarda oluşabilen bağımsız interactions'dır.
Event vertices spatial ve temporal olarak birbirine yaklaştıkça classification zorlaşır. Detector boundaries yakınındaki events de kısmen kesilen light patterns nedeniyle daha zor sınıflandırılır.
No-Physics üzerinde öğrenilen modelin GENIE ve NEUT gibi daha gerçekçi interaction generators üzerinde benzer ROC davranışı göstermesi, classifier'ın yalnız bir generator'ın yapay özelliklerine ezberlenmediğini destekler. Bununla birlikte bunların tamamı simulated detector datasets'tir; gerçek experimental IWCD data üzerinde nihai saha doğrulaması bu tezde gerçekleştirilmemiştir.
QELM gerçekçi nötrino görüntülerine aktarılabildi mi?
Evet, fakat yalnız ön proof-of-concept düzeyinde: 60.000 dengeli NEUT olayı 20 PCA özelliğine sıkıştırılarak 10-qubit QELM'ye aktarılmış ve random guessing'in üzerinde ayırım elde edilmiştir; performans tam görüntü kullanan ResNet-18'in belirgin biçimde altında kalmıştır.
QELM nötrino kurulumu
Üç 20-dimensional input kullanılmıştır:
Charge only: 20 charge feature.
Time only: 20 timing feature.
Time + charge: 10 timing + 10 charge feature.
Dimensionality reduction PCA ile yapılır. 20-dimensional vector 10-qubit Bloch-sphere encoding'e dönüştürülür. XX-type Hamiltonian altında evrilir. Measurement probability vector tek sigmoid readout'a verilir.
| Girdi | Train AUC | Train Accuracy | Train F1 | Test AUC | Test Accuracy | Test F1 |
|---|---|---|---|---|---|---|
| Charge only | 0,6600 | 0,6159 | 0,6058 | 0,6558 | 0,6110 | 0,6049 |
| Time only | 0,6560 | 0,6131 | 0,6215 | 0,6482 | 0,6112 | 0,6241 |
| Time + charge | 0,6659 | 0,6227 | 0,6288 | 0,6575 | 0,6187 | 0,6286 |
Class-wise recall:
| Girdi | Recall class 0 | Recall class 1 |
|---|---|---|
| Charge only | 0,629 | 0,593 |
| Time only | 0,580 | 0,642 |
| Time + charge | 0,595 | 0,642 |
Train ve test değerlerinin birbirine yakın olması bu kurulumda güçlü overfitting görülmediğini düşündürür. Ancak absolute classification performance sınırlıdır.
ResNet ile QELM neden doğrudan adil karşılaştırma değil?
ResNet tam 29×40 spatial structure ve onlarca channel'ı convolution ile kullanabilir. QELM denemesinde görüntü yalnız 20 PCA feature'a sıkıştırılmıştır. Spatial topology, local pixel correlations ve birçok detay quantum encoding'e ulaşmadan kaybolmaktadır.
Ayrıca QELM 60.000 olaylık dengeli subset kullanırken ResNet değerlendirme zinciri milyonlarca olay içeren daha büyük veri kümeleriyle çalışmaktadır.
Bu nedenle kaynak QELM sonucu için rekabetçi benchmark iddiası yapmaz.
Gelecek çalışma yönleri
Tez nötrino-QELM hattında PCA yerine convolutional autoencoder kullanılması, qubit sayısının artırılması ve yalnız classification accuracy değil training/inference time ile total computational cost'un da karşılaştırılması gerektiğini belirtir.
Kuantum tarafında daha scalable architectures, alternatif encoding yöntemleri ve gerçek NISQ hardware uygulamaları gelecek çalışma alanlarıdır.
Nötrino deep-learning tarafında simulation–real-data farkları, systematic uncertainties, detector effects, robustness ve interpretability daha ileri doğrulama gerektirmektedir.
Çalışmanın desteklediği sonuçlar
Tez, klasik image compression ile sabit kuantum feature generation'ın birlikte kullanıldığı QELM'lerin supervised image classification için işlevsel olduğunu göstermektedir.
Strongly compressed input rejiminde nonlinear autoencoder representation, PCA'ya kıyasla daha iyi classification feature'ları sağlayabilir.
Dense-angle ve uniform Bloch-sphere encoding, incelenen koşullarda performance ile implementation complexity arasında güçlü bir denge sağlar.
Birçok farklı interacting Hamiltonian aynı göreve yeterli information spreading sağladığında birbirine yakın accuracy oluşturabilir; non-interacting ve localized dynamics daha düşük performans verir.
XX-QELM'de classification transition global scrambling'den önce, local entanglement oluşumuyla aynı zaman ölçeğinde gerçekleşmektedir.
Bu yüksek-performans rejimi shallow local circuits ve tensor-network simulability ile uyumludur.
ResNet-18, IWCD benzeri simulated Cherenkov images üzerinde single-vertex/pile-up discrimination için yüksek performans göstermektedir.
Timing information, incelenen olay ayrımında charge information'dan daha güçlü discriminative content taşımaktadır.
QELM gerçekçi NEUT event images'a güçlü compression sonrası proof-of-concept olarak aktarılabilmiştir.
Çalışmanın desteklemediği sonuçlar
Tez QELM için genel bir computational quantum advantage kanıtlamamaktadır.
Tez quantum hardware üzerinde exponential speedup göstermemektedir.
Tez “daha fazla entanglement her zaman daha iyi classification üretir” sonucunu desteklememektedir.
MNIST/Fashion-MNIST/CIFAR-10 sonuçları bütün machine-learning görevlerine otomatik genellenemez.
ResNet sonuçları gerçek IWCD detector data üzerinde nihai experimental performance değildir; temel değerlendirmeler simulated datasets'e dayanmaktadır.
QELM neutrino sonucu ResNet'i geçen veya onunla eşit performans veren bir sonuç değildir.
GENIE ve NEUT üzerinde iyi generalization, gerçek detector systematic uncertainties'ın tamamen çözüldüğünü göstermez.
Tezdeki QELM simulation sonuçları NISQ noise, gate error, readout error ve gerçek quantum-device calibration sorunlarının tümünü deneysel olarak doğrulamamaktadır.
Kaynak ve Yöntem Notu
Özgün başlık: MACHINE LEARNING DEVELOPMENT FOR QUANTUM COMPUTING AND NEUTRINO PHYSICS
Yazar: Annalisa De Lorenzis.
Çalışma türü: Doctoral thesis / doktora tezi.
Alanlar: Quantum machine learning, quantum computing, machine learning, neutrino physics, water Cherenkov detector data analysis.
Derece: Doctor of Physics.
Derece veren kurum: Universitat Autònoma de Barcelona (UAB), Department of Physics. Bu bilgi UAB'nin resmî kurumsal tez kaydıyla doğrulanmıştır.
Danışmanlar: M. Pilar Casado Lechuga; Thorsten Lux; Arnau Riera Graells.
Tutor: M. Pilar Casado Lechuga.
PDF kapak tarihi: 29 Mayıs 2026.
Resmî derece tarihi: UAB kurumsal tez kaydına göre 10 Temmuz 2026.
ArXiv gönderim tarihi: 15 Temmuz 2026.
ArXiv kaydı: arXiv:2607.13699v1 [quant-ph].
Repository DOI: 10.48550/arXiv.2607.13699.
Resmî kayıtlar: arXiv:2607.13699 ve UAB kurumsal tez kaydı, Handle 10803/698010.
Hakemlik durumu: Tezin kendisi doktora tezi ve arXiv tez/preprint kaydıdır; dergi makalesi değildir. Buna karşılık tezdeki ana QELM sonuçlarının önemli bölümü iki ayrı hakemli Physical Review Applied makalesinde yayımlanmıştır.
Tezde listelenen ana yayın 1: Annalisa De Lorenzis, M. P. Casado, M. P. Estarellas, N. Lo Gullo, T. Lux, F. Plastina, A. Riera, J. Settino, “Harnessing Quantum Extreme Learning Machines for Image Classification,” Physical Review Applied 23, 044024, Nisan 2025.
Tezde listelenen ana yayın 2: Annalisa De Lorenzis, M. P. Casado, N. Lo Gullo, T. Lux, F. Plastina, A. Riera, “Entanglement and Classical Simulability in Quantum Extreme Learning Machines,” Physical Review Applied 25, 054052, Mayıs 2026.
Kaynak-içi yayın durumu notu: Tezin ön sayfaları ikinci makaleyi Physical Review Applied 25, 054052, Mayıs 2026 olarak yayımlanmış gösterirken Bölüm 6'nın erken metninde “currently under review” gibi daha eski bir ifade kalmıştır; Bölüm 6'nın sonunda ise çalışma accepted/published durumuyla uyumlu biçimde ele alınır. Bu editoryal zaman farkı bilimsel sonuçları değiştirmez.
Lisans: arXiv kaydı non-exclusive distribution license altında görünmektedir. CC BY lisansı varsayılmamıştır. Kaynakta telifli Physical Review Applied figürleri bulunduğundan Verianla HTML'sinde bu şekiller birebir kullanılmamış, yalnız bilimsel ilişkileri özgün inline SVG ile yeniden kurulmuştur.
Finansman / destek: Tezde ayrı formal funding statement bulunmamakla birlikte acknowledgements bölümünde Qilimanjaro Quantum Tech ve AGAUR'ın doktora sürecindeki desteğine teşekkür edilmektedir.
Yazılım ve hesaplama: QELM çalışmaları klasik olarak simulated quantum dynamics kullanmaktadır. Neutrino detector response WCSim ile oluşturulmuş; image-analysis pipeline WatChMaL framework'üyle ilişkilendirilmiş; ResNet eğitimi PyTorch cross-entropy/Adam düzeninde gerçekleştirilmiştir. QELM klasik readout bölümlerinde Keras/Adam kullanımı belirtilmektedir.
Veri kaynakları: MNIST, Fashion-MNIST, CIFAR-10; WCSim ile üretilmiş No-Physics, GENIE ve NEUT tabanlı IWCD simulations.
Temel QELM sınırlılığı: Full-state simulation qubit sayısını sınırlamaktadır; ilk çalışmada \(N=12\) practical classical-simulation limit olarak kullanılmıştır. Gerçek NISQ hardware üzerinde kapsamlı hardware-error benchmark yapılmamıştır.
Temel quantum-advantage sınırı: XX-QELM'nin high-accuracy rejimi local entanglement ve shallow effective circuit depth ile ilişkilidir ve efficient classical tensor-network simulation ile uyumludur. Bu sonuç güçlü generic quantum advantage iddiasını desteklemez.
Temel nötrino sınırlılığı: ResNet değerlendirmeleri realistic fakat simulated detector datasets'e dayanır. Systematic detector uncertainties ve simulation-to-real-data discrepancies gerçek deney uygulamasında ayrıca ele alınmalıdır.
QELM–ResNet karşılaştırma sınırı: Neutrino QELM 60.000 NEUT event ve 20 PCA feature kullanırken ResNet tam multi-channel images ve çok daha büyük veri kümeleri kullanmaktadır. Performansları eşit input koşullarındaki head-to-head benchmark olarak yorumlanmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir