


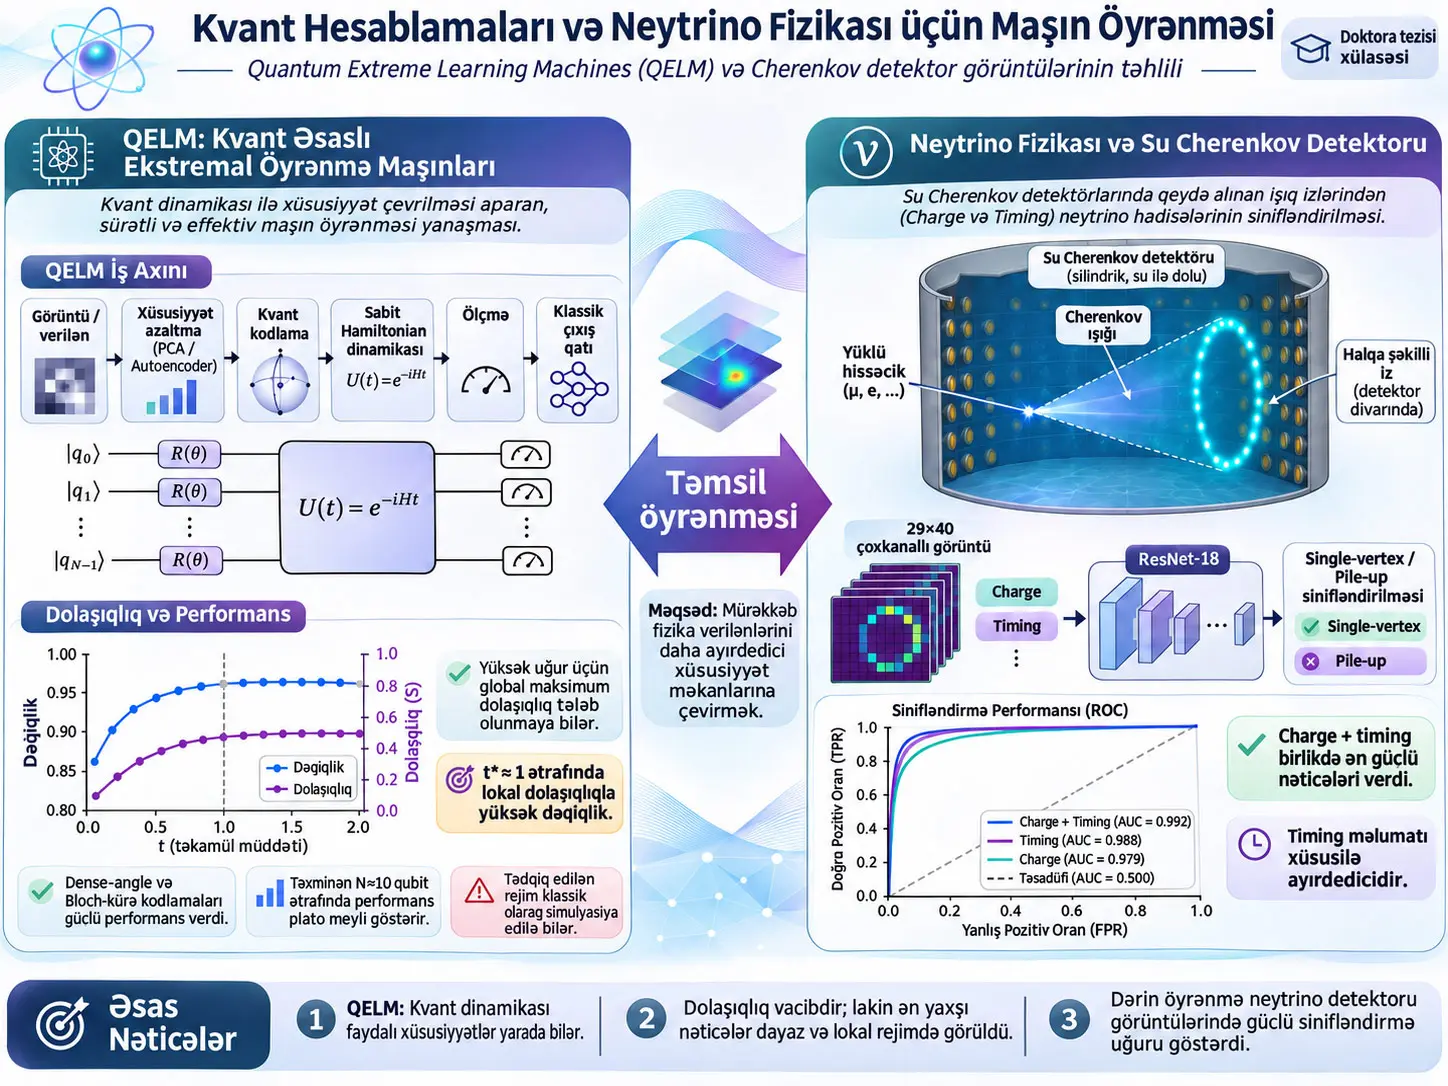
Quantum Extreme Learning Machine (QELM), klassik verilənləri kvant vəziyyətinə kodlayan, verilənləri öyrədilməyən sabit kvant dinamikası ilə çevirən və yalnız son klassik oxuma qatını öyrədən hibrid kvant–klassik maşın öyrənməsi arxitekturasıdır. Bu doktorluq dissertasiyası yüksəkölçülü fizika verilənlərindən effektiv təmsillərin yaradılması problemini iki fərqli sahədə araşdırır. Birinci tədqiqat xətti QELM-lərin görüntü təsnifatında necə işlədiyini, verilənlərin sıxlaşdırılması üsulunun, kvant kodlamasının, Hamiltonian dinamikasının, ölçmənin, dolaşıqlığın və klassik simulyasiya oluna bilmənin performansa necə təsir etdiyini araşdırır. İkinci tədqiqat xətti isə su Cherenkov neytrino detektorlarında yaranan charge və timing görüntülərini ResNet-18 ilə təhlil edərək tək qarşılıqlı təsir nöqtəli hadisələrlə eyni oxuma pəncərəsində bir neçə qarşılıqlı təsirin üst-üstə düşdüyü pile-up hadisələrinin fərqləndirilməsini araşdırır.
QELM istiqamətindəki ilk iş MNIST və Fashion-MNIST görüntülərini əvvəlcə Principal Component Analysis (PCA) və ya convolutional autoencoder vasitəsilə aşağıölçülü latent vektorlara sıxlaşdırır. Bu xüsusiyyətlər angle, dense-angle, uniform Bloch-sphere, general və ya amplitude encoding istifadə edilərək qubit vəziyyətlərinə çevrilir. Daha sonra sabit bir many-body Hamiltonian altında unitar zaman təkamülü tətbiq olunur. Computational-basis ölçməsindən alınan ehtimal vektoru yalnız klassik bir shallow output neural network tərəfindən öyrənilir. Nəticələr güclü sıxlaşdırma şəraitində nonlinear autoencoder təmsillərinin PCA-dan daha effektiv olduğunu və iki xüsusiyyət/qubit istifadə edən dense-angle ilə uniform Bloch-sphere kodlamalarının performans–tətbiqolunma baxımından xüsusilə yaxşı tarazlıq yaratdığını göstərir.
İlk QELM işində qubit sayı artdıqca təsnifat dəqiqliyi sürətlə yüksəlir və təxminən \(N\simeq10\) ətrafında plato meyli göstərir. Qarşılıqlı təsirli Hamiltonianlar kifayət qədər informasiya yayılması yaratdığı müddətdə model performansı Hamiltonianın mikroskopik təfərrüatlarına təəccüblü dərəcədə az həssasdır. Bunun əksinə, qubitlərin müstəqil qaldığı non-interacting hallarda və ya güclü localization səbəbindən informasiyanın register boyunca yayıla bilmədiyi rejimlərdə performans nəzərəçarpacaq dərəcədə azalır. Bu nəticə QELM-də tələb olunan amilin xüsusi bir “möcüzə Hamiltonian” deyil, kodlanmış informasiyanı ölçmə fəzasında yenidən təşkil edə bilən kifayət qədər qarşılıqlı təsirli kvant dinamikası olduğunu dəstəkləyir.
Dissertasiyanın ikinci QELM tədqiqatı daha fundamental bir suala yönəlir: yüksək təsnifat uğuruna çatmaq üçün nə qədər kvant dolaşıqlığı tələb olunur və bu rejim klassik kompüterdə hələ də səmərəli şəkildə simulyasiya edilə bilərmi? Dense-angle encoding və periodik sərhəd şərtli nearest-neighbour XX Hamiltonianı sabitlənir; yalnız təkamül zamanı \(t\) dəyişdirilir. MNIST, Fashion-MNIST və CIFAR-10 üçün dəqiqlik qısa zamanlarda aşağı qalır, təxminən \(t^\*\sim1\) ətrafında sürətlə yüksəlir və sonra plato yaradır.
Ən mühüm kvant nəticəsi bu keçidin bütün sistemdə volume-law dolaşıqlıq yaranmazdan əvvəl baş verməsidir. Tək-qubit entropiyaları \(t=O(1)\) miqyasında sürətlə artdığı halda half-chain entropy-nin global saturation-a çatması \(t=O(N)\) vaxt tələb edir. XX zənciri üçün istifadə edilən vahidlərdə Lieb–Robinson sürəti \(v_{\mathrm{LR}}=1\) olduğuna görə \(t^\*\sim1\) zamanı informasiya yalnız bir neçə qonşu site-a yayılmış olur. Buna baxmayaraq, QELM təsnifat dəqiqliyi artıq plato qiymətinə çatır.
Bu tapıntı “daha çox dolaşıqlıq həmişə daha yaxşı maşın öyrənməsi deməkdir” fikrini dəstəkləmir. Dissertasiyanın nəticəsinə görə, araşdırılan tapşırıqlarda faydalı feature generation üçün güclü lokal dolaşıqlıq kifayətdir; bütün zəncirin qlobal şəkildə scramble olması tələb olunmur. Bundan əlavə, bu qısa-zaman dinamikası sabit dərinlikli lokal dövrələrlə təxmini şəkildə həyata keçirilə bilər və Matrix Product State kimi tensor-network üsulları üçün hələ də əlçatan rejimdədir. Buna görə dissertasiya ümumi və ya güclü kvant hesablama üstünlüyü nümayiş etdirmir.
Neytrino bölməsində əsas fiziki problem fərqlidir. Neytrino detektorda birbaşa görünmür; neytrino qarşılıqlı təsirinin yaratdığı yüklü hissəciklər suda kifayət qədər sürətlə hərəkət etdikdə Cherenkov işığı yaradır. Bu işığın detektor divarındakı fotomultiplier borularına çatma mövqeyi, miqdarı və zamanı hadisənin fiziki topologiyası haqqında informasiya daşıyır. IWCD-nin silindrik səthi \((\phi,z)\) koordinatlarında açılaraq image-like 29×40 piksel təmsilinə çevrilir.
Hər multi-PMT modulunda 19 ayrı PMT olduğuna görə ən detallı görüntü təmsili hər piksel üçün 19 charge və 19 timing kanalı, yəni cəmi 38 kanal ehtiva edir. ResNet-18 ilə aparılan təhlildə charge və timing birlikdə istifadə edildikdə No-Physics testində AUC 0,987, GENIE testində AUC 0,990 əldə olunur. Timing kanalları təkbaşına charge kanallarından daha fərqləndiricidir və yalnız orta/standart kənarlaşmadan istifadə edən daha kompakt 2Q+2T təmsili də tam 19Q+19T təmsilinin performansına olduqca yaxın qalır.
Dissertasiya eyni neytrino probleminə QELM-i də proof-of-concept kimi tətbiq edir. Lakin müqayisə şərtləri bərabər deyil: QELM yalnız 60.000 NEUT hadisəsindən ibarət balanslaşdırılmış subset istifadə edir; tam 29×40 görüntülər əvvəlcə PCA ilə yalnız 20 xüsusiyyətə sıxlaşdırılır, sonra 10 qubit-ə Bloch-sphere encoding ilə kodlanır. Ən yaxşı time+charge konfiqurasiyasında test AUC 0,6575, accuracy 0,6187 və F1 0,6286 əldə olunur. Bu performans ResNet-18-dən nəzərəçarpacaq dərəcədə aşağıdır. Dissertasiya bunu QELM-in ResNet-i üstələməsi kimi deyil, realistik neytrino görüntülərinə tətbiq oluna bilməsinin ilkin fizibilite nümayişi kimi şərh edir.
Quantum Extreme Learning Machine klassik neyron şəbəkəsindən necə fərqlənir?
QELM-də klassik neyron şəbəkələrinin öyrədilən dərin hidden layer-ları əvəzinə sabit kvant sistemi feature generator kimi istifadə olunur; verilənlər kvant vəziyyətinə kodlanır, sabit Hamiltonian altında təkamül edir və ölçmədən əldə olunan ehtimallar yalnız son klassik readout qatında öyrənilir.
Extreme Learning Machine ideyası
Klassik Extreme Learning Machine yanaşmasının əsas ideyası feature generation ilə learning prosesini bir-birindən ayırmaqdır. Hidden layer parametrləri sabit saxlanıla bilər; yalnız output layer öyrədilir. QELM bu ideyanı kvant sisteminə daşıyır.
Dissertasiyada istifadə olunan əsas QELM pipeline-ı dörd addımdan ibarətdir:
- Yüksəkölçülü klassik verilənlər PCA və ya autoencoder ilə sıxlaşdırılır.
- Latent xüsusiyyətlər \(N\) qubit-lik kvant vəziyyətinə kodlanır.
- Kvant vəziyyəti sabit bir many-body Hamiltonian altında müəyyən müddət təkamül edir.
- Computational-basis ölçmə ehtimalları klassik bir shallow classifier-a verilir.
Qubit nədir?
Klassik bit yalnız 0 və ya 1 qiymətini aldığı halda bir qubit-in saf vəziyyəti:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle, \qquad |\alpha|^2+|\beta|^2=1 \]
şəklində yazılır. \(\alpha\) və \(\beta\) kompleks probability amplitude-lardır. Ölçmə aparıldıqda \(|0\rangle\) nəticəsi \(|\alpha|^2\), \(|1\rangle\) nəticəsi \(|\beta|^2\) ehtimalla əldə olunur.
Bloch kürəsindən istifadə edildikdə eyni vəziyyət:
\[ |\psi\rangle= \cos\left(\frac{\theta}{2}\right)|0\rangle + e^{i\phi} \sin\left(\frac{\theta}{2}\right)|1\rangle \tag{4.9} \]
şəklində ifadə olunur. \(\theta\) qütb, \(\phi\) azimut bucağıdır. QELM-in bir çox encoding üsulu klassik xüsusiyyətləri birbaşa bu iki bucağa yerləşdirir.
Hilbert fəzası niyə vacibdir?
\(N\) qubit-lik sistemin vəziyyət fəzası:
\[ \mathcal{H}_N=(\mathbb{C}^2)^{\otimes N} \]
və ölçüsü:
\[ \dim(\mathcal{H}_N)=2^N \]
olur.
Bu eksponensial artım az sayda qubit ilə yüksəkölçülü state representation yaradıla bilməsinin riyazi əsasını təşkil edir. Lakin \(2^N\) ölçülü state space-in mövcudluğu avtomatik olaraq kvant üstünlüyü yaratmır; bu state-in hazırlanması, təkamül etdirilməsi, ölçülməsi və əldə olunan informasiyanın təsnifat baxımından həqiqətən faydalı olması tələb olunur.
Klassik xüsusiyyətlər qubit-lərə necə kodlanır?
Dissertasiya klassik latent xüsusiyyətlərin qubit amplitudlarına və ya Bloch-kürəsi bucaqlarına yerləşdirildiyi beş encoding ailəsini müqayisə edir; bu üsullar qubit başına daşınan xüsusiyyətlərin sayı ilə state-preparation dövrə dərinliyi arasında fərqli kompromislər yaradır.
Dense-angle encoding
Dense-angle encoding hər qubit-ə iki xüsusiyyət yerləşdirir:
\[ |x\rangle = \bigotimes_{i=1}^{\lceil M/2\rceil} \left[ \cos\left(\frac{x_{2i-1}}{2}\right)|0\rangle + e^{ix_{2i}} \sin\left(\frac{x_{2i-1}}{2}\right)|1\rangle \right]. \tag{4.10} \]
Burada \(x_{2i-1}\) qütb bucağına, \(x_{2i}\) faza bucağına çevrilir. Beləliklə, bir qubit iki klassik xüsusiyyət daşıyır.
Angle encoding
Angle encoding yalnız qütb bucağından istifadə edir:
\[ |x\rangle = \bigotimes_i \left[ \cos\left(\frac{x_i}{2}\right)|0\rangle+ \sin\left(\frac{x_i}{2}\right)|1\rangle \right]. \tag{4.11} \]
Hər qubit yalnız bir xüsusiyyət daşıyır. Üstünlüyü state preparation-ın olduqca dayaz olmasıdır; çatışmazlığı isə eyni sayda xüsusiyyəti kodlamaq üçün dense-angle ilə müqayisədə daha çox qubit tələb oluna bilməsidir.
Uniform Bloch-sphere encoding
Mənbə bu kodlamanı:
\[ |x\rangle = \bigotimes_i \left[ \sqrt{x_{2i-1}}|0\rangle+ e^{ix_{2i}} \sqrt{1-x_{2i-1}}|1\rangle \right] \tag{4.12} \]
şəklində verir. Birinci xüsusiyyət population çəkisini, ikinci xüsusiyyət relative phase-i idarə edir.
Amplitude encoding
Amplitude encoding:
\[ |x\rangle = \frac{1}{\|x\|_2} \sum_{i=0}^{2^N-1}x_i|i\rangle \tag{4.14} \]
ilə \(N\) qubit-ə nəzəri olaraq \(2^N\) xüsusiyyət yerləşdirə bilər. Qubit sayı baxımından çox kompakt görünsə də generic amplitude state preparation dərin və çox-qubit entangling circuit tələb edə bilər. Dissertasiya buna görə amplitude encoding-in NISQ tətbiqolunma imkanının angle-əsaslı kodlamalarla müqayisədə daha çətin olduğunu vurğulayır.
| Kodlama | Qubit başına xüsusiyyət | Tipik dövrə dərinliyi | Əsas kompromis |
|---|---|---|---|
| Angle | 1 | Aşağı | Sadə state preparation; daha çox qubit tələb oluna bilər |
| Dense-angle | 2 | Aşağı | İki Bloch parametrindən istifadə edir; faza nəzarəti tələb olunur |
| Uniform Bloch-sphere | 2 | Aşağı | Population və fazanı birlikdə kodlayır |
| General | 2 | Aşağı | Amplitudların birbaşa normallaşdırılmış parametrizasiyası |
| Amplitude | \(2^N\) ümumi xüsusiyyətədək | Yüksək | Qubit-səmərəlidir, lakin generic state preparation baha başa gəlir |
İlk görüntü təsnifatı işində dense-angle və uniform Bloch-sphere kodlamaları ümumilikdə ən yaxşı performans–tətbiqolunma tarazlığını verir. General encoding xüsusilə kiçik qubit saylarında daha zəif nəticə verir. Amplitude encoding isə latent feature sayı kifayət qədər artdıqda yaxşılaşır; lakin eyni qubit sayında bütün 784 MNIST pikselinin amplitude encoding ilə birbaşa istifadə edildiyi halda \(N=10-12\) üçün test accuracy təxminən 0,97 səviyyəsində qalır və dense-angle + compressed latent representation yanaşmasından bir qədər aşağı nəticə verir.
QELM-də Hamiltonian niyə öyrədilmir?
QELM-in məqsədi kvant dinamikasını trainable variational circuit kimi optimallaşdırmaq deyil, sabit fiziki sistemin klassik verilənləri faydalı feature space-ə çevirmə qabiliyyətini araşdırmaqdır; buna görə Hamiltonian parametrləri sabit saxlanılır və təlim yalnız klassik output layer-da aparılır.
Kvant state-in zaman təkamülü:
\[ U(t)=e^{-iHt} \tag{4.15} \]
ilə müəyyən edilir. Burada \(H\) Hamiltonian, \(t\) təkamül müddətidir. \(\hbar=1\) vahidlərindən istifadə edildikdə eksponensial forma belə yazılır.
Kodlanmış başlanğıc vəziyyəti:
\[ |\psi(t)\rangle=U(t)|\psi_0(z)\rangle \]
olur.
Hamiltonianın vəzifəsi sinif etiketini “öyrənmək” deyil. Onun vəzifəsi başlanğıcdakı lokal və ya aşağı mürəkkəblikli feature informasiyasını register üzərində yenidən paylayaraq computational-basis measurement-da sinifləri ayırmaq üçün daha əlverişli probability representation yaratmaqdır.
İlk işdə niyə altı fərqli Hamiltonian istifadə olunur?
Dissertasiya connectivity, integrability, chaos və localization-ın QELM performansında həqiqətən müəyyənedici olub-olmadığını yoxlamaq üçün fiziki baxımdan bir-birindən fərqli Hamiltonian ailələrindən istifadə edir.
| Model | Növ | Əsas məqsəd |
|---|---|---|
| \(H_1\) | Periodically driven long-range Ising | Uzunmənzilli güclü qarışdırıcı reservoir |
| \(H_2\) | Fully connected disordered transverse-field Ising | Disorder və tam bağlı qarşılıqlı təsiri yoxlamaq |
| \(H_3\) | Chaotic nearest-neighbour Ising | Lokal, lakin non-integrable/ergodic dinamika |
| \(H_4\) | Nearest-neighbour XXZ | Anizotrop lokal many-body dinamika |
| \(H_5\) | Integrable XX chain | Sadə, lokal və tam həll olunan reservoir |
| \(H_6\) | Disordered long-range \(xx\) + random fields | Ergodic, non-ergodic və localized rejimləri müqayisə etmək |
Long-range Ising \(H_1\)
Mənbədə:
\[ H_1(t)= \begin{cases} B_1\displaystyle\sum_i\sigma_x^{(i)}, & 0\le t<T_1,\\ \displaystyle\sum_{i,j}J_{ij}^{(1)}\sigma_z^{(i)}\sigma_z^{(j)}, & T_1\le t<T, \end{cases} \tag{4.16} \]
və:
\[ J_{ij}^{(1)}= \frac{J_0}{|i-j|^\alpha} \tag{4.17} \]
istifadə olunur.
Parametrlər \(J_0=0.06\), \(\alpha=1.51\), \(B_1=3.05\) və \(T=2T_1=1\) kimi verilir. İlk işin simulyasiyasında bu dinamika \(\Delta t=50T\) müddətində tətbiq edilir.
Integrable XX modeli \(H_5\)
XX zənciri:
\[ H_5= \frac12 \sum_{i=1}^{N} \left( \sigma_x^{(i)}\sigma_x^{(i+1)} + \sigma_y^{(i)}\sigma_y^{(i+1)} \right) \tag{4.24} \]
və periodik sərhəd şərti:
\[ \sigma^{(N+1)}\equiv\sigma^{(1)} \]
ilə istifadə olunur.
XX modeli Jordan–Wigner çevrilməsi ilə free fermion sisteminə xəritələnə bilən integrable modeldir. Buna baxmayaraq, təsnifat üçün tələb olunan lokal entanglement və ballistic information propagation yarada bilər. Dissertasiyanın ikinci QELM işində məhz bu model seçilir, çünki fiziki dinamika ilə classification transition arasındakı əlaqəni daha aydın araşdırmaq mümkündür.
Localized rejim niyə zəif performans verir?
İnformasiya register boyunca yayılmırsa, fərqli qubit-lərə kodlanmış xüsusiyyətlər measurement-dan əvvəl kifayət qədər qarışmır. Non-interacting \(H_2\) limitində qubit-lər müstəqil hərəkət edir. Güclü many-body localization rejimində isə qarşılıqlı təsir olsa belə, başlanğıc informasiyasının spatial spreading-i ciddi şəkildə basdırılır.
Mənbə hər iki halda high-accuracy plateau-nun pozulduğunu göstərir. Bu nəticə “chaos mütləqdir” demir; integrable XX zənciri də yaxşı işləyə bilər. Tələb olunan, araşdırılan təsnifat tapşırığı üçün kifayət qədər feature redistribution-dır.
Ölçmə niyə kvant feature map-in kritik hissəsidir?
Kvant state-in özü klassik classifier-a birbaşa verilmir; classifier yalnız ölçmə ehtimallarını gördüyü üçün Hamiltonian eigenbasis-i ilə measurement basis arasındakı əlaqə hansı kvant müdaxilə informasiyasının klassik feature-a çevriləcəyini müəyyən edir.
Hamiltonianın spektral ayrılması:
\[ H=\sum_n E_n|E_n\rangle\langle E_n| \tag{4.29} \]
olsun. Başlanğıc vəziyyəti:
\[ |\psi(0)\rangle=\sum_n c_n|E_n\rangle \tag{4.30} \]
və zamanla:
\[ |\psi(t)\rangle= \sum_n c_ne^{-iE_nt}|E_n\rangle \tag{4.31} \]
şəklində təkamül edir.
\(|s_k\rangle\) measurement basis-indəki nəticənin ehtimalı Born qaydası ilə:
\[ p_k(t)=|\langle s_k|\psi(t)\rangle|^2 \tag{4.32} \]
olur.
Mənbə bunu açaraq:
\[ p_k(t)= \sum_{n,m} \langle s_k|E_n\rangle \langle E_m|s_k\rangle e^{-i(E_n-E_m)t} c_nc_m^\ast \tag{4.33} \]
ifadəsini əldə edir.
Bu tənlik çox vacibdir. Measurement basis Hamiltonian eigenbasis-i ilə tam eynidirsə off-diagonal interference contributions yox olur və:
\[ p_k(t)=|c_k|^2 \tag{4.34} \]
zamanla dəyişmir. Belə bir ölçmə quantum dynamics-in feature enrichment qabiliyyətindən istifadə edə bilmir.
Bunun əksinə, measurement basis ilə enerji eigenbasis-i kifayət qədər fərqlidirsə \(E_n-E_m\) enerji fərqlərindən yaranan interference terms probability vector-u zamanla mürəkkəb şəkildə yenidən təşkil edə bilər.
QELM-in klassik çıxış qatı
Ölçmə probability vector-u:
\[ \mathbf{p}(t)= \left(p_s(t)\right)_{s\in\{0,1\}^N} \]
klassik feature vector kimi istifadə olunur.
Çıxış qatı:
\[ \mathbf{a}=W\mathbf{p}(t)+\mathbf{b} \tag{4.36} \]
logit-ləri yaradır və softmax:
\[ y_c= \frac{e^{a_c}} {\sum_{c'=1}^{C}e^{a_{c'}}} \tag{4.37} \]
ilə class probability-lərə çevirir.
Categorical cross-entropy:
\[ \mathcal{L} = -\sum_{c=1}^{C}t_c\log y_c \tag{4.38} \]
minimallaşdırılır. QELM arxitekturasında trainable parametrlər \(W\) və \(b\)-dir; kvant reservoir-in özü öyrədilmir.
QELM üçün çox dolaşıqlıqmı, yoxsa düzgün miqdarda lokal dolaşıqlıqmı tələb olunur?
Bu dissertasiyada araşdırılan XX-əsaslı QELM üçün yüksək təsnifat dəqiqliyi qlobal olaraq maksimum və ya volume-law dolaşıq state tələb etmir; dəqiqlik platosu qonşu qubit-lər arasında lokal dolaşıqlığın yarandığı, lakin bütün zəncirin hələ güclü şəkildə dolaşıq olmadığı \(t^\*\approx1\) rejimində meydana çıxır.
İkinci QELM işinin nəzarətli quruluşu
Bu iş şərhi asanlaşdırmaq üçün arxitekturanı böyük ölçüdə sabit saxlayır:
- feature reduction pipeline sabitdir,
- encoding həmişə dense-angle-dır,
- Hamiltonian periodik sərhəd şərtli nearest-neighbour XX zənciridir,
- measurement computational basis-dədir,
- dəyişdirilən əsas continuous hyperparameter yalnız evolution time \(t\)-dir.
XX Hamiltonianı:
\[ H= \frac12 \sum_{i=1}^{N} \left( \sigma_x^{(i)}\sigma_x^{(i+1)} + \sigma_y^{(i)}\sigma_y^{(i+1)} \right) \tag{6.1} \]
və:
\[ |\psi_t(z)\rangle = e^{-iHt}|\psi_0(z)\rangle \tag{6.2} \]
istifadə olunur.
Üç performans bölgəsi
MNIST, Fashion-MNIST və CIFAR-10-da accuracy–time əyriləri ümumilikdə üç bölgə göstərir:
1. Qısa zaman: Dinamika encoded state-i hələ kifayət qədər dəyişdirməyib və accuracy aşağıdır.
2. Keçid: \(t^\*\sim1\) ətrafında training və test accuracy sürətlə yüksəlir.
3. Plato: \(t\gtrsim t^\*\) sonrasında accuracy dataset və \(N\)-dən asılı plato qiymətinə çatır.
Keçid vaxtının araşdırılan sistem ölçülərində \(N\)-dən demək olar ki, asılı olmaması xüsusilə vacibdir. Əgər classification üçün bütün zəncirin qlobal scrambling-i tələb olunsaydı, lazım olan vaxtın sistem ölçüsü ilə artması gözlənilərdi.
Lokal və qlobal entanglement zaman miqyasları
Tək-qubit entropy sürətlə yüksəlir və:
\[ t=O(1) \]
miqyasında doyuma yaxınlaşır. Bu, hər qubit-in yaxın ətrafı ilə dolaşıqlıq yaratdığını göstərir.
Half-chain entropy isə zəncirin yarısını digər yarısından ayıran bipartition-dakı qlobal entanglement-ı ölçür və volume-law saturation üçün:
\[ t=O(N) \]
miqyasına ehtiyac duyur.
Classification transition \(t^\*\approx1\) birinci zaman miqyası ilə üst-üstə düşür, ikinci ilə deyil.
Lieb–Robinson sürəti nədir?
Lokal Hamiltonianlarda informasiya və korrelyasiyaların fəzada ixtiyari şəkildə ani yayılmasının qarşısını alan effektiv sürət həddi mövcuddur. Bu davranış Lieb–Robinson bound ilə təsvir olunur.
Dissertasiyanın XX modeli və istifadə olunan vahidlər üçün:
\[ v_{\mathrm{LR}}=1 \]
əldə olunur.
Buna görə \(t\lesssim1\) olduqda bir qubit-in informasiyası yalnız təxminən bir lattice spacing miqyasındakı qonşulara güclü şəkildə çata bilər. QELM accuracy-nin eyni zamanda plato yaratması classification üçün uzaq site-ların qlobal şəkildə dolaşıq olmasına ehtiyac olmadığını dəstəkləyir.
Haar-random unitary müqayisəsi
Mənbə XX evolution-ın plateau accuracy-sini eyni encoded state-lərə tətbiq edilən Haar-distributed random unitary-lərlə müqayisə edir. Hər \(N\) və dataset üçün 10 müstəqil Haar-random unitary nümunəsi istifadə olunur.
XX-QELM-in \(t\gtrsim t^\*\) plato qiyməti numerical uncertainties daxilində Haar-random unitary performansı ilə üst-üstə düşür. Lakin XX modeli Haar-random state qədər qlobal scramble olmadan eyni classification səviyyəsinə çata bilir.
Shallow random circuits
Analog XX dynamics həmçinin nearest-neighbour random two-qubit gates istifadə edən brickwork digital circuit ilə müqayisə olunur. Dissertasiya yalnız bir neçə layer-ın—tipik olaraq təxminən dörd-altı qatın—analog XX plateau-suna çox yaxın accuracy yarada bildiyini bildirir.
Bu nəticə effective circuit depth-in \(N\) ilə artmadığı və relevant dynamics-in shallow qaldığı şərhini gücləndirir.
Niyə bu nəticə güclü kvant üstünlüyü deyil?
Birölçülü, qısa dərinlikli və lokal dolaşıqlığın məhdud qaldığı kvant dövrələri Matrix Product State kimi tensor-network üsulları ilə bir çox halda səmərəli şəkildə simulyasiya edilə bilər. Dissertasiyanın classification üçün faydalı hesab etdiyi \(t^\*\) rejimi məhz bu quruluşa yaxındır.
Buna görə mənbənin nəticəsi “kvant feature map faydasızdır” deyil. Nəticə daha nüanslıdır: kvant dinamikası sinifləri daha yaxşı ayrılan feature geometry-yə daşıya bilər; lakin araşdırılan tapşırıqlarda bunun baş verdiyi dinamik rejim hələ də klassik olaraq əlçatan ola bilər.
Probability polytope nə deməkdir?
Hər input sample üçün QELM ölçməsi:
\[ p_t(s|z)=|\langle s|\psi_t(z)\rangle|^2 \tag{6.7} \]
ehtimallarını verir.
Bütün \(2^N\) bit-string ehtimalı:
\[ \mathbf{p}_t(z) = \left( p_t(s_1|z),\ldots,p_t(s_{2^N}|z) \right) \tag{6.6} \]
bir probability simplex daxilində yerləşir:
\[ \Delta_{2^N-1} = \left\{ \mathbf{p}\in\mathbb{R}^{2^N} \;\middle|\; p_i\ge0,\; \sum_i p_i=1 \right\}. \tag{6.8} \]
Dissertasiya bu sample cloud-a “probability polytope” adını verir.
K-means inertia:
\[ I= \sum_{k=1}^{K} \sum_{x_j\in C_k} \|x_j-\mu_k\|_2^2 \tag{6.9} \]
ilə cluster compactness ölçülür. \(I\) kiçildikcə cluster-lar centroid ətrafında daha sıx toplanır.
İş QELM accuracy transition zamanı probability-space cluster-ların class labels ilə daha uyğun hala gəldiyini, buna qarşılıq tək-site local observables-ın zamanla sinif informasiyasını itirə bildiyini göstərir. Yəni informasiya yox olmur; local observables-dan global correlation structure-a daşınır.
Neytrino niyə birbaşa görüntülənmir və Cherenkov halqaları necə yaranır?
Su Cherenkov detektorunda neytrino birbaşa işıq yaratmır; neytrino qarşılıqlı təsirinin yaratdığı elektrik yüklü hissəciklər suda işığın faza sürətindən daha sürətli hərəkət etdikdə konusşəkilli Cherenkov şüalanması yaradır və bu konusun detektor səthi ilə kəsişməsi PMT-lərdə halqaya bənzər görüntülər əmələ gətirir.
Cherenkov şərti
Bir hissəciyin suda Cherenkov şüalanması yarada bilməsi üçün:
\[ v>\frac{c}{n} \]
olmalıdır.
Burada \(v\) hissəciyin sürəti, \(c\) vakuumdakı işıq sürəti, \(n\) mühitin refractive index qiymətidir.
Cherenkov bucağı:
\[ \cos\theta_C= \frac{1}{\beta n}, \qquad \beta=\frac{v}{c} \]
əlaqəsi ilə verilir.
Su üçün optik bölgədə təxminən \(n\approx1.33\) və çox relativistik \(\beta\rightarrow1\) hissəciklər üçün maksimum bucaq təxminən \(42^\circ\)-dir.
PMT-lərdə görünən halqa yalnız hissəciyin mövcudluğunu deyil; direction, vertex position, propagation length və light timing kimi hadisə geometriyasına dair informasiyanı da daşıyır.
Single-vertex və pile-up niyə qarışdırıla bilər?
Single-vertex hadisə tək neutrino interaction vertex ehtiva edir, lakin bu interaction bir neçə charged particle yarada bilər. Buna görə tək-vertex hadisədə belə bir neçə Cherenkov ring görünə bilər.
Pile-up hadisəsində isə eyni detector readout window daxilində iki və ya daha çox müstəqil interaction baş verir. Bir neçə vertex-in halqaları bir-birinin üzərinə düşə bilər.
Buna görə “bir ring = single vertex, çox ring = pile-up” kimi sadə qayda keçərli deyil. Model spatial və temporal structure-u birlikdə öyrənməlidir.
Charge və timing niyə bir-birini tamamlayır?
Charge, PMT-yə çatan işığın miqdarı ilə əlaqəlidir və event morphology/brightness informasiyasını daşıyır.
Timing, fotonların sensora nə vaxt çatdığını göstərir və vertex geometry, particle propagation və fərqli interactions-ın temporal separation-ına həssasdır.
Dissertasiya nəticələrində timing-only representation-ın charge-only representation-dan daha yaxşı classification verməsi pile-up probleminin güclü temporal component-ini təsdiqləyir.
IWCD görüntüsü süni neyron şəbəkəsinə necə çevrilir?
Silindrik IWCD səthi \((\phi,z)\) koordinatlarında açılaraq hər multi-PMT modulunun bir pikselə çevrildiyi 29×40 görüntü yaradılır; hər pikseldəki 19 PMT-nin charge və timing qiymətləri ayrıca kanallar və ya xülasə statistikaları şəklində neyron şəbəkəsinə verilir.
Simulyasiya zənciri
Detector response WCSim ilə simulyasiya edilir. No-Physics dataset-də neutrino–nucleus interaction generator istifadə edilmədən final-state particle tracks birbaşa yaradılır. Məqsəd classifier-ın generator-specific təfərrüatları deyil, single-vertex/pile-up topologiyasını öyrənməsini təmin etməkdir.
No-Physics verilənlər dəstində:
- electron, muon, \(\pi^0\) və \(\pi^-\) istifadə olunur,
- track istiqamətləri isotropic nümunələnir,
- ümumi visible energy ən çox 2000 MeV-dir,
- single-vertex və pile-up nisbəti bərabərdir,
- 5 milyon hadisə training üçün,
- 1 milyon müstəqil hadisə test üçün istifadə olunur.
GENIE və NEUT verilənlər dəstləri realistik neutrino–nucleus interaction generator-lardan istifadə edir. Hər biri 1 milyon hadisə ehtiva edir və təxminən %32 single-vertex, %68 pile-up kompozisiyasına malikdir. Bu dəstlər realistic generalization testləri kimi istifadə olunur.
29×40 piksel niyə 38 kanala qədər çatır?
Hər multi-PMT modulu bir image pixel-dir. Bir modulda 19 PMT olduğuna görə hər PMT üçün:
19 charge channel + 19 timing channel = 38 channel
əldə olunur.
Mənbənin notation-ı:
| Göstəriş | Məzmun |
|---|---|
| 19Q | 19 ayrı charge kanalı |
| 19T | 19 ayrı timing kanalı |
| 19Q+19T | 38 tam kanal |
| 2Q | 19 charge qiymətinin mean + standard deviation xülasəsi |
| 2T | 19 timing qiymətinin mean + standard deviation xülasəsi |
| 2Q+2T | Charge və timing üçün dörd xülasə kanalı |
Double-cover niyə lazımdır?
Silindrik səth düz düzbucaqlıya açıldıqda \(\phi=0\) və \(\phi=2\pi\) fiziki olaraq qonşu olsa da görüntünün sol və sağ kənarlarına ayrılır. Standart convolution bu iki kənarı uzaq nöqtələr hesab edə bilər.
Double-cover construction görüntünün müvafiq hissələrini çoxaldıb yenidən düzərək periodic cylindrical boundary-ni CNN üçün fiziki baxımdan daha düzgün təmsil edir.
ResNet-18 arxitekturası
Dissertasiya standart ResNet-18-in residual quruluşunu qoruyur, lakin detector images daxilindəki incə spatial informasiyanı qorumaq məqsədilə giriş stem-ini uyğunlaşdırır.
Dörd residual stage:
| Mərhələ | Çıxış kanalı | Residual block | İlk block stride |
|---|---|---|---|
| Layer 1 | 64 | 2 | 1 |
| Layer 2 | 128 | 2 | 2 |
| Layer 3 | 256 | 2 | 2 |
| Layer 4 | 512 | 2 | 2 |
Residual block-un əsas əməliyyatı:
\[ y=F(x,W)+x \]
şəklindədir. Shortcut connection öyrəniləcək mapping-in hamısını sıfırdan yaratmaq əvəzinə residual dəyişikliyi öyrənməyi asanlaşdırır və dərin şəbəkələrdə gradient flow-u dəstəkləyir.
Stage sonunda adaptive average pooling hər feature map-i 1×1 qiymətinə endirir. 512-dimensional vector flatten edilir və fully connected output layer-a verilir.
ResNet təlim parametrləri
| Parametr | Qiymət |
|---|---|
| Optimizer | Adam |
| Learning rate | 0,01 |
| Epoch | 20 |
| Batch size | 512 |
| Tapşırıq | İki sinifli classification |
| Loss | Cross-entropy |
| Training augmentation | Tətbiq olunur |
| Validation / test augmentation | Tətbiq olunmur |
Tədqiqatın Metodu və Nəticələri
İlk QELM görüntü təsnifatı işində hansı komponent həqiqətən müəyyənedici oldu?
İlk işdə ən güclü təsirlər feature reduction və encoding seçimindən qaynaqlanır; nonlinear convolutional autoencoder-lar PCA-dan daha yaxşı latent representation yaradarkən dense-angle və uniform Bloch-sphere encoding iki xüsusiyyət/qubit istifadə etməklə yüksək performansla nisbətən dayaz state preparation arasında yaxşı tarazlıq təmin edir.
Verilənlər dəstləri və ilkin emal
İlk QELM işində MNIST və Fashion-MNIST 28×28 grayscale görüntülərindən istifadə olunur. Piksel qiymətləri 255-ə bölünərək [0,1] intervalına normallaşdırılır. Əlavə denoising və ya data augmentation tətbiq olunmur.
PCA istifadə edildikdə 28×28 görüntü 784-dimensional vektora flatten edilir və ilk \(d\) principal component-ə project edilir.
Autoencoder istifadə edildikdə təbii 28×28 tensor encoder-a daxil olur və yalnız \(d\)-ölçülü bottleneck vector saxlanılır.
Baseline configuration:
| Komponent | Referans seçim |
|---|---|
| Feature reduction | Autoencoder AE1 |
| Encoding | Dense-angle |
| Hamiltonian | Periodically driven long-range \(H_1\) |
| Classical readout | Feed-forward neural network |
| Ən böyük qubit sayı | \(N=12\) |
\(N=12\), bu işdə full quantum dynamics-in classical simulation baxımından praktik sərhədi kimi göstərilir. Bu sərhəd real quantum hardware-ın maksimum qubit sayı deyil.
PCA və autoencoder nəticəsi
AE1 və AE2 convolutional autoencoder-ları PCA-dan daha yaxşı classification accuracy təmin edir. Daha böyük AE1 daha aşağı reconstruction error və daha yaxşı latent representation yaradır; bunun müqabilində daha çox trainable parameter və training cost daşıyır.
Mənbə bu nəticəni xüsusilə güclü sıxlaşdırma rejimində şərh edir: quantum layer-a yalnız az sayda feature göndərilə bildikdə hansı informasiyanın qorunacağı son classification uğuruna ciddi şəkildə təsir edir.
Encoding nəticəsi
Dense-angle və uniform Bloch-sphere training və test baxımından ən güclü single-qubit encoding üsulları arasında yer alır. Simple angle bir xüsusiyyət/qubit istifadə etdiyi üçün eyni \(N\)-də daha az classical information daşıyır.
Amplitude encoding-in üstünlüyü \(2^N\) xüsusiyyətədək compact state representation təmin edə bilməsidir; çatışmazlığı isə generic state preparation-ın experimentally demanding olmasıdır.
Hamiltonian nəticəsi
Araşdırılan interaction Hamiltonian-ların çoxu \(N\) artdıqca bir-birinə çox yaxın performance verir və təxminən \(N\simeq10\) ətrafında plato yaradır.
Bu nəticə integrability və ya chaos-un əhəmiyyətsiz olduğunu universal şəkildə sübut etmir. İşin daha dar nəticəsi budur: sınaqdan keçirilən image-classification problemləri və system-size aralığında informasiya sufficiently spread edildiyi müddətdə Hamiltonian-ın microscopic details-i accuracy üzərində məhdud fərq yaradır.
Non-interacting və ya strongly localized dynamics isə nəzərəçarpacaq dərəcədə daha zəif nəticə verir.
Classical baseline sərhədi
İlk iş QELM-i original 784 pixels ilə qidalanan single-layer neural network və AE1 latent features ilə qidalanan klassik output network kimi baselines ilə müqayisə edir. Daha yüksək \(N\) qiymətlərində QELM bu baselines-dan daha yüksək performans göstərə bilər.
Lakin bundan “QELM bütün klassik maşın öyrənməsi modellərini üstələyir” nəticəsi çıxarıla bilməz. Müqayisə müəyyən shallow baselines ilə aparılıb; daha güclü müasir classical models-in hamısını əhatə edən benchmark deyil.
İkinci QELM işi niyə kvant üstünlüyü iddiasını məhdudlaşdırır?
Çünki ən yüksək classification performance qlobal volume-law dolaşıqlıq yaranmazdan əvvəl, qısa-zamanlı və lokal dolaşıqlığın üstün olduğu sabit-dərinlikli rejimdə meydana çıxır; bu rejim tensor-network və shallow random-circuit yanaşmaları ilə klassik olaraq əlçatan qalır.
Əsas nəticələr:
| Nəticə elementi | Mənbə nəticəsi | Şərh |
|---|---|---|
| Accuracy transition | \(t^\*\sim1\) | Araşdırılan \(N\) qiymətlərindən böyük ölçüdə asılı deyil |
| Local entanglement | \(t=O(1)\) | Classification transition ilə eyni miqyas |
| Half-chain volume-law saturation | \(t=O(N)\) | High accuracy üçün tələb olunmur |
| Lieb–Robinson velocity | \(v_{\mathrm{LR}}=1\) | \(t\sim1\)-də informasiya yalnız yaxın ətrafa yayılıb |
| Haar-random comparison | Plateau accuracy numerical uncertainties daxilində uyğundur | XX dynamics random-like useful representation yarada bilər |
| Digital random circuits | Tipik 4–6 layer plateau-ya yaxınlaşa bilər | Dayaz dinamika kifayət edə bilər |
| Classical simulability | Tensor-network ilə uyğun rejim | Generic strong quantum advantage sübutu yoxdur |
Dissertasiyanın bu bölməsinin dəstəklədiyi şərh
Kvant dinamikası classical data-nın representation geometry-sini faydalı şəkildə dəyişdirə bilər. Entanglement bu çevrilmədə rol oynayır. Lakin “faydalı entanglement” ilə “maksimum/qlobal entanglement” eyni şey deyil.
Dissertasiyanın bu bölməsinin dəstəkləmədiyi şərh
Bu nəticələrdən fault-tolerant quantum computer advantage, exponential speedup və ya classical algorithms üçün intractability nəticəsi çıxarıla bilməz. Araşdırılan rejim əksinə classical tractability ilə uyğundur.
ResNet-18 neytrino hadisələrini nə qədər yaxşı ayırdı?
Charge və timing informasiyasının birlikdə istifadə edildiyi tam 19Q+19T təmsili No-Physics dataset-də AUC 0,987 və GENIE dataset-də AUC 0,990 verir; timing-only təmsil charge-only-dən daha yaxşı performans göstərdiyi halda 2Q+2T compact təmsili tam kanal girişinə çox yaxın qalır.
| Konfiqurasiya | Loss | Accuracy | F1 | AUC |
|---|---|---|---|---|
| 19Q + 19T | 0,128 | 0,954 | 0,953 | 0,987 |
| 2Q + 2T | 0,136 | 0,951 | 0,950 | 0,986 |
| 19T | 0,142 | 0,949 | 0,948 | 0,985 |
| 19Q | 0,212 | 0,916 | 0,913 | 0,970 |
| Konfiqurasiya | Loss | Accuracy | F1 | AUC |
|---|---|---|---|---|
| 19Q + 19T | 0,114 | 0,954 | 0,966 | 0,990 |
| 2Q + 2T | 0,126 | 0,950 | 0,963 | 0,987 |
| 19T | 0,126 | 0,950 | 0,963 | 0,988 |
| 19Q | 0,180 | 0,924 | 0,943 | 0,976 |
Bu nəticələrdə timing information-ın güclü olması fiziki baxımdan mənalıdır. Pile-up hadisələrinin əsas xüsusiyyəti yalnız spatial overlap deyil, eyni readout window-da fərqli vaxtlarda baş verə bilən müstəqil interactions-dır.
Event vertices spatial və temporal baxımdan bir-birinə yaxınlaşdıqca classification çətinləşir. Detector boundaries yaxınlığındakı events də qismən kəsilən light patterns səbəbindən daha çətin təsnif olunur.
No-Physics üzərində öyrənilmiş modelin GENIE və NEUT kimi daha realistik interaction generators üzərində oxşar ROC davranışı göstərməsi classifier-ın yalnız bir generator-ın süni xüsusiyyətlərini əzbərləmədiyini dəstəkləyir. Bununla belə, bunların hamısı simulated detector datasets-dir; real experimental IWCD data üzərində yekun sahə təsdiqi bu dissertasiyada həyata keçirilməyib.
QELM realistik neytrino görüntülərinə ötürülə bildimi?
Bəli, lakin yalnız ilkin proof-of-concept səviyyəsində: 60.000 balanslaşdırılmış NEUT hadisəsi 20 PCA xüsusiyyətinə sıxlaşdırılaraq 10-qubit QELM-ə ötürülüb və random guessing-dən yüksək ayırdetmə əldə olunub; performans tam görüntüdən istifadə edən ResNet-18-dən nəzərəçarpacaq dərəcədə aşağı qalıb.
QELM neytrino quruluşu
Üç 20-dimensional input istifadə olunub:
Charge only: 20 charge feature.
Time only: 20 timing feature.
Time + charge: 10 timing + 10 charge feature.
Dimensionality reduction PCA ilə aparılır. 20-dimensional vector 10-qubit Bloch-sphere encoding-ə çevrilir. XX-type Hamiltonian altında təkamül edir. Measurement probability vector tək sigmoid readout-a verilir.
| Giriş | Train AUC | Train Accuracy | Train F1 | Test AUC | Test Accuracy | Test F1 |
|---|---|---|---|---|---|---|
| Charge only | 0,6600 | 0,6159 | 0,6058 | 0,6558 | 0,6110 | 0,6049 |
| Time only | 0,6560 | 0,6131 | 0,6215 | 0,6482 | 0,6112 | 0,6241 |
| Time + charge | 0,6659 | 0,6227 | 0,6288 | 0,6575 | 0,6187 | 0,6286 |
Class-wise recall:
| Giriş | Recall class 0 | Recall class 1 |
|---|---|---|
| Charge only | 0,629 | 0,593 |
| Time only | 0,580 | 0,642 |
| Time + charge | 0,595 | 0,642 |
Train və test qiymətlərinin bir-birinə yaxın olması bu quruluşda güclü overfitting müşahidə olunmadığını düşündürür. Lakin absolute classification performance məhduddur.
ResNet ilə QELM niyə birbaşa ədalətli müqayisə deyil?
ResNet tam 29×40 spatial structure və onlarla channel-ı convolution ilə istifadə edə bilər. QELM sınağında görüntü yalnız 20 PCA feature-a sıxlaşdırılıb. Spatial topology, local pixel correlations və bir çox detal quantum encoding-ə çatmamış itirilir.
Bundan əlavə, QELM 60.000 hadisəlik balanslaşdırılmış subset istifadə etdiyi halda ResNet qiymətləndirmə zənciri milyonlarla hadisə ehtiva edən daha böyük verilənlər dəstləri ilə işləyir.
Buna görə mənbə QELM nəticəsi üçün rəqabətli benchmark iddiası irəli sürmür.
Gələcək iş istiqamətləri
Dissertasiya neytrino-QELM xəttində PCA əvəzinə convolutional autoencoder istifadə edilməli, qubit sayı artırılmalı və yalnız classification accuracy deyil, training/inference time ilə total computational cost da müqayisə edilməlidir.
Kvant tərəfində daha scalable architectures, alternativ encoding üsulları və real NISQ hardware tətbiqləri gələcək iş sahələridir.
Neytrino deep-learning tərəfində simulation–real-data fərqləri, systematic uncertainties, detector effects, robustness və interpretability daha irəli təsdiqləmə tələb edir.
Tədqiqatın dəstəklədiyi nəticələr
Dissertasiya klassik image compression ilə sabit kvant feature generation-ın birlikdə istifadə edildiyi QELM-lərin supervised image classification üçün funksional olduğunu göstərir.
Strongly compressed input rejimində nonlinear autoencoder representation PCA ilə müqayisədə daha yaxşı classification feature-ları təmin edə bilər.
Dense-angle və uniform Bloch-sphere encoding araşdırılan şərtlərdə performance ilə implementation complexity arasında güclü tarazlıq yaradır.
Bir çox fərqli interacting Hamiltonian eyni tapşırıq üçün kifayət qədər information spreading təmin etdikdə bir-birinə yaxın accuracy yarada bilər; non-interacting və localized dynamics daha aşağı performans verir.
XX-QELM-də classification transition global scrambling-dən əvvəl, local entanglement yaranması ilə eyni zaman miqyasında baş verir.
Bu yüksək-performans rejimi shallow local circuits və tensor-network simulability ilə uyğundur.
ResNet-18 IWCD-yə bənzər simulated Cherenkov images üzərində single-vertex/pile-up discrimination üçün yüksək performans göstərir.
Timing information araşdırılan hadisə ayrımında charge information-dan daha güclü discriminative content daşıyır.
QELM realistik NEUT event images-a güclü compression-dan sonra proof-of-concept kimi ötürülə bilib.
Tədqiqatın dəstəkləmədiyi nəticələr
Dissertasiya QELM üçün ümumi computational quantum advantage sübut etmir.
Dissertasiya quantum hardware üzərində exponential speedup göstərmir.
Dissertasiya “daha çox entanglement həmişə daha yaxşı classification yaradır” nəticəsini dəstəkləmir.
MNIST/Fashion-MNIST/CIFAR-10 nəticələri bütün machine-learning tapşırıqlarına avtomatik şəkildə ümumiləşdirilə bilməz.
ResNet nəticələri real IWCD detector data üzərində yekun experimental performance deyil; əsas qiymətləndirmələr simulated datasets-ə əsaslanır.
QELM neutrino nəticəsi ResNet-i üstələyən və ya onunla eyni performans verən nəticə deyil.
GENIE və NEUT üzərində yaxşı generalization real detector systematic uncertainties-ın tam həll edildiyini göstərmir.
Dissertasiyadakı QELM simulation nəticələri NISQ noise, gate error, readout error və real quantum-device calibration problemlərinin hamısını eksperimental olaraq təsdiqləmir.
Mənbə və Metod Qeydi
Orijinal başlıq: MACHINE LEARNING DEVELOPMENT FOR QUANTUM COMPUTING AND NEUTRINO PHYSICS
Müəllif: Annalisa De Lorenzis.
Tədqiqat növü: Doctoral thesis / doktorluq dissertasiyası.
Sahələr: Quantum machine learning, quantum computing, machine learning, neutrino physics, water Cherenkov detector data analysis.
Dərəcə: Doctor of Physics.
Dərəcəni verən qurum: Universitat Autònoma de Barcelona (UAB), Department of Physics. Bu informasiya UAB-nin rəsmi institusional dissertasiya qeydi ilə təsdiqlənib.
Elmi rəhbərlər: M. Pilar Casado Lechuga; Thorsten Lux; Arnau Riera Graells.
Tutor: M. Pilar Casado Lechuga.
PDF üz qabığı tarixi: 29 May 2026.
Rəsmi dərəcə tarixi: UAB institusional dissertasiya qeydinə görə 10 İyul 2026.
ArXiv göndərilmə tarixi: 15 İyul 2026.
ArXiv qeydi: arXiv:2607.13699v1 [quant-ph].
Repository DOI: 10.48550/arXiv.2607.13699.
Rəsmi qeydlər: arXiv:2607.13699 və UAB institusional dissertasiya qeydi, Handle 10803/698010.
Resenziya vəziyyəti: Dissertasiyanın özü doktorluq dissertasiyası və arXiv dissertasiya/preprint qeydidir; jurnal məqaləsi deyil. Bununla belə, dissertasiyadakı əsas QELM nəticələrinin mühüm hissəsi iki ayrı resenziyalı Physical Review Applied məqaləsində dərc olunub.
Dissertasiyada sadalanan əsas nəşr 1: Annalisa De Lorenzis, M. P. Casado, M. P. Estarellas, N. Lo Gullo, T. Lux, F. Plastina, A. Riera, J. Settino, “Harnessing Quantum Extreme Learning Machines for Image Classification,” Physical Review Applied 23, 044024, Aprel 2025.
Dissertasiyada sadalanan əsas nəşr 2: Annalisa De Lorenzis, M. P. Casado, N. Lo Gullo, T. Lux, F. Plastina, A. Riera, “Entanglement and Classical Simulability in Quantum Extreme Learning Machines,” Physical Review Applied 25, 054052, May 2026.
Mənbədaxili nəşr vəziyyəti qeydi: Dissertasiyanın ön səhifələri ikinci məqaləni Physical Review Applied 25, 054052, May 2026 kimi dərc olunmuş göstərdiyi halda Bölüm 6-nın ilkin mətnində “currently under review” kimi daha köhnə ifadə qalıb; Bölüm 6-nın sonunda isə iş accepted/published vəziyyəti ilə uyğun şəkildə təqdim olunur. Bu redaktəvi zaman fərqi elmi nəticələri dəyişmir.
Lisenziya: arXiv qeydi non-exclusive distribution license altında görünür. CC BY lisenziyası fərz edilməyib. Mənbədə müəllif hüquqları ilə qorunan Physical Review Applied fiqurları olduğuna görə Verianla HTML-də bu fiqurlar birbaşa istifadə edilməyib, yalnız elmi əlaqələr orijinal inline SVG ilə yenidən qurulub.
Maliyyələşdirmə / dəstək: Dissertasiyada ayrıca formal funding statement olmasa da acknowledgements bölməsində Qilimanjaro Quantum Tech və AGAUR-a doktorluq prosesi zamanı verdikləri dəstəyə görə təşəkkür edilir.
Proqram təminatı və hesablama: QELM işlərində klassik olaraq simulated quantum dynamics istifadə olunur. Neutrino detector response WCSim ilə yaradılıb; image-analysis pipeline WatChMaL framework-ü ilə əlaqələndirilib; ResNet təlimi PyTorch cross-entropy/Adam quruluşunda həyata keçirilib. QELM klassik readout bölmələrində Keras/Adam istifadəsi qeyd olunur.
Verilənlər mənbələri: MNIST, Fashion-MNIST, CIFAR-10; WCSim ilə yaradılmış No-Physics, GENIE və NEUT əsaslı IWCD simulations.
Əsas QELM məhdudiyyəti: Full-state simulation qubit sayını məhdudlaşdırır; ilk işdə \(N=12\) practical classical-simulation limit kimi istifadə olunub. Real NISQ hardware üzərində geniş hardware-error benchmark aparılmayıb.
Əsas quantum-advantage sərhədi: XX-QELM-in high-accuracy rejimi local entanglement və shallow effective circuit depth ilə əlaqəlidir və efficient classical tensor-network simulation ilə uyğundur. Bu nəticə güclü generic quantum advantage iddiasını dəstəkləmir.
Əsas neytrino məhdudiyyəti: ResNet qiymətləndirmələri realistic, lakin simulated detector datasets-ə əsaslanır. Systematic detector uncertainties və simulation-to-real-data discrepancies real eksperiment tətbiqində ayrıca nəzərə alınmalıdır.
QELM–ResNet müqayisə sərhədi: Neutrino QELM 60.000 NEUT event və 20 PCA feature istifadə etdiyi halda ResNet tam multi-channel images və daha böyük verilənlər dəstlərindən istifadə edir. Onların performansı bərabər input şərtlərində head-to-head benchmark kimi şərh edilməməlidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib