


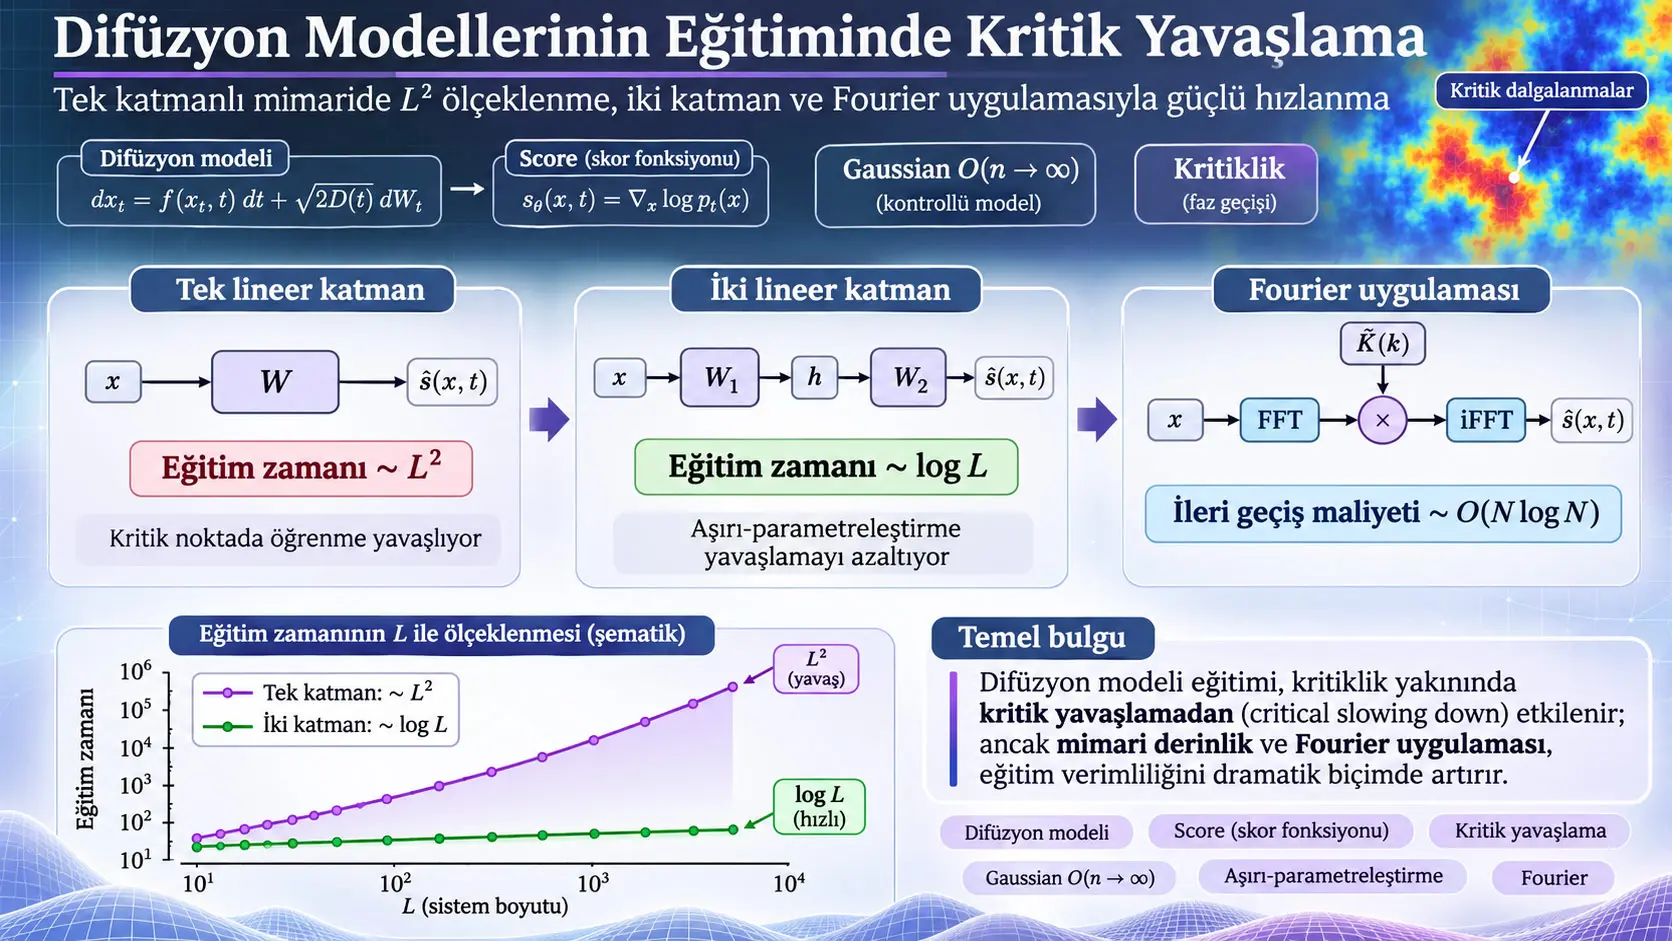
Difüzyon modeli (diffusion model), hedef bir veri dağılımından alınan örnekleri önce kontrollü biçimde gürültüye dönüştüren ve ardından öğrenilmiş bir score fonksiyonunun yardımıyla bu gürültülü dağılımdan geriye doğru ilerleyerek yeni örnekler üreten bir üretken model sınıfıdır. Bu çalışma, difüzyon modellerinin fiziksel bir sistem kritik noktaya yaklaştığında karşılaşılan kritik yavaşlamayı gerçekten aşıp aşamadığını, analitik olarak kontrol edilebilen Gaussian \(O(n\rightarrow\infty)\) istatistiksel alan teorisi modeli üzerinde inceliyor. Araştırmacılar bu sistemde exact score fonksiyonunu analitik olarak bildikleri için, ağ mimarisinin öğrenme dinamikleri üzerindeki etkisini hedef fonksiyon belirsizliği olmadan doğrudan çözebiliyor.
Çalışmanın ilk temel sonucu şaşırtıcıdır: exact score'u fonksiyonel olarak tam temsil edebilen tek lineer konvolüsyon katmanlı bir ağ kullanmak, kritik yavaşlamayı ortadan kaldırmamaktadır. Gradient descent ile eğitimde kritik noktada karakteristik eğitim zamanı sistemin doğrusal boyutu \(L\) ile yaklaşık \(L^2\) ölçeklenmektedir. Bu, aynı Gaussian modelin standart yerel Langevin dinamiğindeki \(z=2\) kritik yavaşlamayla aynı sistem-boyutu ölçeklenmesidir. Eğitimdeki hata daha sonra denoising/generation aşamasına taşınmakta ve üretilen alanların kovaryansının doğru yeniden oluşturulmasını da aynı karakteristik ölçeklenmeyle zorlaştırmaktadır.
İkinci temel sonuç, yalnızca bir ilave lineer katmanın dinamiği nitel olarak değiştirebilmesidir. İki katman da aktivasyon fonksiyonu olmadan lineerdir ve tek katmanlı ağdan daha güçlü bir fonksiyon sınıfı temsil etmek zorunda değildir; buna rağmen uygun başlangıç koşulları altında aşırı-parametreleştirme, gradient-descent eğitim süresinin sistem boyutuyla \(L^2\) yerine yaklaşık \(\log L\) ölçeklenmesini sağlar. Çalışmanın kontrollü modelinde iki-katmanlı yapı böylece kritik eğitim yavaşlamasını ortadan kaldırmaktadır.
Ancak yalnız eğitim zamanının iyileşmesi yeterli değildir. Tüm sistemi kapsayan konvolüsyon çekirdeğinin gerçek uzayda naif uygulanması bir ileri geçiş için \(O(N^2)\) işlem gerektirir. Araştırmacılar konvolüsyonun Fourier uzayında çarpıma dönüşmesi özelliğini kullanarak score hesabını FFT → Fourier-uzayı çarpımı → ters FFT biçiminde uygular. Böylece toplam ileri-geçiş karmaşıklığı \(O(N\log N)\) düzeyine indirilir. Burada \(N=(L/a)^d\), \(d\) uzaysal boyut ve \(a\) kafes aralığıdır.
Bu sonuçların yorum sınırı önemlidir. Çalışma gerçek görüntü, video veya genel amaçlı büyük difüzyon ağı eğitmemektedir. İncelenen sistem Gaussian \(O(n\rightarrow\infty)\) modelidir; score lineerdir, mimariler lineer konvolüsyon katmanlarıdır ve analitik çözüm bilinmektedir. Dolayısıyla \(L^2\rightarrow\log L\) sonucu, bütün modern difüzyon modelleri için evrensel bir eğitim yasası olarak yorumlanamaz. Çalışmanın değeri, kritik yavaşlama ile ağ parametrizasyonu arasındaki ilişkiyi tam kontrol edilebilir bir fiziksel modelde analitik olarak gösterebilmesidir.
Kritik Yavaşlama Nedir ve Bu Çalışmada Neden Önemlidir?
Kritik yavaşlama, bir fiziksel sistem faz geçişinin kritik noktasına yaklaştığında uzun-menzilli korelasyonların ortaya çıkması nedeniyle yerel örnekleme dinamiklerinin giderek daha yavaş dekorrelasyon göstermesidir. İncelenen \(O(n\rightarrow\infty)\) modelinde standart yerel Langevin dinamiğinin karakteristik gevşeme zamanı kritik noktada \(\tau\sim L^2\) ölçeklenir; çalışmanın ana sorusu, öğrenilmiş bir difüzyon örnekleyicisinin aynı darboğazı miras alıp almadığıdır.
Fiziksel başlangıç modeli: \(O(n)\) alan teorisi
Çalışmanın temel fiziksel sistemi \(n\) bileşenli bir alan \(\vec{\phi}(\vec{x})\) için tanımlanan \(O(n)\) modelidir. Kaynağın Eşitlik (1)'de verdiği action:
\[ S(\vec{\phi}) = \frac{1}{2} \int_V d^d\vec{x} \left[ \sum_{\nu=1}^{d}\sum_{a=1}^{n} (\partial_\nu\phi_a)^2 + m^2\sum_{a=1}^{n}\phi_a^2 + \frac{g}{2n} \left( \sum_{a=1}^{n}\phi_a^2 \right)^2 \right]. \tag{1} \]
Burada \(\vec{x}\), \(d\)-boyutlu uzaydaki konumu; \(a\), \(n\) alan bileşeninden hangisinin ele alındığını; \(\partial_\nu\phi_a\), alanın uzaysal değişimini; \(m^2\), modelin davranışını kontrol eden kütle parametresini; \(g>0\) ise dörtlü etkileşimin kuvvetini ifade eder. Çalışma bağlamında \(m\) sıcaklığa benzer bir kontrol parametresi rolündedir.
Büyük-\(n\) limitinde neden problem kolaylaşıyor?
\(n\rightarrow\infty\) limitinde model etkin olarak Gaussian hale gelir:
\[ S_\Lambda(\vec{\phi}) = \frac{1}{2} \int_V d^d\vec{x} \left[ \sum_{\nu=1}^{d}\sum_{a=1}^{n} (\partial_\nu\phi_a)^2 + (m^2+\Lambda g) \sum_{a=1}^{n}\phi_a^2 \right]. \tag{2} \]
\(\Lambda\) kendisiyle tutarlı biçimde:
\[ \Lambda = \frac{1}{(2\pi)^d} \int d^d\vec{k}\, \frac{1}{ \vec{k}\cdot\vec{k}+m^2+\Lambda g }. \tag{3} \]
denklemiyle belirlenir.
Böylece:
\[ m_{\rm eff}^2=m^2+\Lambda g \]
etkin kütlesi modelin davranışını kontrol eden merkezi parametre haline gelir. Kritik nokta:
\[ m_{\rm eff}=0 \]
olarak tanımlanır.
Bu sadeleşme çalışmanın ana avantajıdır. Gaussian dağılımlar için korelasyonlar, score ve difüzyon dinamiği analitik olarak hesaplanabildiğinden araştırmacılar “ağın hedeflediği gerçek score nedir?” sorusunun cevabını tam olarak bilmektedir. Böylece eğitimde görülen yavaşlama, bilinmeyen hedef fonksiyonun karmaşıklığından değil doğrudan optimizasyon ve korelasyon yapısından incelenebilir.
Hedef Boltzmann–Gibbs dağılımı
Amaç şu dağılımdan alan konfigürasyonları üretmektir:
\[ P(\vec{\phi}) = \frac{1}{Z} e^{-S_\Lambda(\vec{\phi})}, \tag{4} \]
burada:
\[ Z = \int D\vec{\phi}\, e^{-S_\Lambda(\vec{\phi})} \]
bölüm fonksiyonudur.
Fiziksel kritik yavaşlamanın ölçüsü
Yerel örnekleyicinin ne kadar hızlı dekorrele olduğunu görmek için çalışma öz-korelasyon fonksiyonunu kullanır:
\[ C(\vec{x},\vec{x};T) = \frac{1}{V} \int_V d^d x\, \left\langle \phi(\vec{x},T)\phi(\vec{x},0) \right\rangle . \tag{5} \]
\(T\), fiziksel örnekleme/simülasyon zamanıdır. Kritik noktaya yaklaşırken korelasyonun sönmesi yavaşlar. Hiper-kübik doğrusal boyutu \(L\) olan sistemde standart yerel dinamik için:
\[ \tau\sim L^z, \qquad z=2. \]
Dolayısıyla:
\[ \tau\sim L^2. \]
Bu \(L^2\) davranışı daha sonra tek-katmanlı score eğitiminin ölçeklenmesiyle doğrudan karşılaştırılmaktadır.
Düşük boyutlarda kritik nokta hakkında önemli sınır
Kaynak \(d\leq2\) için sonlu \(m^2\) değerinde klasik anlamda sonlu-sıcaklık faz geçişinin bulunmadığını belirtmektedir. Örneğin \(d=1\) için:
\[ m_{\rm eff}^2 = m^2 + \frac{g}{2} \frac{1}{\sqrt{m_{\rm eff}^2}}. \tag{6} \]
\(m_{\rm eff}\rightarrow0\) iken \(m^2\)'nin negatif yönde diverge etmesi gerekir. \(d=2\)'de de UV kesmesi sonrasında logaritmik davranış ortaya çıkar. Çalışma bu nedenle sonraki analizlerde doğrudan Gaussian teoriyi ve \(m_{\rm eff}\)'i kontrol parametresi olarak kullanarak kritikliği \(m_{\rm eff}\rightarrow0\) şeklinde incelemektedir.
Difüzyon Modelindeki Score Fonksiyonu Nedir?
Score fonksiyonu, belirli bir diffusion-time \(t\)'deki olasılık dağılımının alan değişkenlerine göre logaritmik türevidir; başka bir ifadeyle modelin mevcut gürültülü konfigürasyonu olasılığın daha yüksek olduğu yönlere nasıl düzeltmesi gerektiğini belirleyen vektör alanıdır. Bu çalışmanın Gaussian sisteminde score lineerdir ve exact biçimde hesaplanabildiği için öğrenilen ağ doğrudan gerçek score ile karşılaştırılabilir.
Forward diffusion: verinin gürültülenmesi
Hedef dağılımdan başlangıç konfigürasyonu alınır:
\[ \vec{\phi}(\vec{x},0) \sim P^\ast(\vec{\phi}). \tag{7} \]
Daha sonra Ornstein–Uhlenbeck süreciyle gürültülenir:
\[ \frac{\partial\vec{\phi}(\vec{x},t)}{\partial t} = -\vec{\phi}(\vec{x},t) + \vec{\zeta}(\vec{x},t). \tag{8} \]
\(\vec{\zeta}\), beyaz Gaussian gürültüdür ve kovaryansı:
\[ \left\langle \zeta(\vec{x},t) \zeta(\vec{x}',t') \right\rangle = 2\, \delta^{(d)}(\vec{x}-\vec{x}') \delta(t-t') \]
biçimindedir.
Reverse diffusion: gürültüden hedef dağılıma dönüş
Kaynak ana analizinde deterministic probability-flow ODE kullanır:
\[ -\partial_t\vec{\phi}(\vec{x},t) = \vec{\phi}(\vec{x},t) + \vec{\mathcal F}_t(\vec{\phi}(\vec{x},t)). \tag{10} \]
Score:
\[ \vec{\mathcal F}_t(\vec{\phi}) = \frac{ \delta\log P_t(\vec{\phi}) }{ \delta\vec{\phi}(\vec{x}) }. \tag{11} \]
Burada \(P_t\), forward diffusion sırasında \(t\) anında oluşan dağılımdır. Score exact ise reverse ODE ideal durumda gürültülü dağılımı hedef dağılıma geri taşır.
Score matching kaybı
Exact score biliniyor olsaydı eğitim kaybı:
\[ \mathcal L_t(\vec{F}_t) = \frac{1}{2} \int D\vec{\phi}\, P_t(\vec{\phi}) \left\| \vec{F}_t(\vec{\phi}) - \vec{\mathcal F}_t(\vec{\phi}) \right\|^2. \tag{12} \]
şeklinde yazılabilir. Burada \(\vec{F}_t\), öğrenilen score; \(\vec{\mathcal F}_t\), exact score'dur.
Pratikte exact score çoğu problemde bilinmediğinden, kaynak denoising score-matching ile eşdeğer formu da verir:
\[ \widehat{\mathcal L}_t(\vec F_t) = \frac{1}{2} \mathbb E_{\vec\phi_0\sim P_0} \int D\vec\phi\, P_t(\vec\phi|\vec\phi_0) \left\| \vec F_t(\vec\phi) + \frac{ \vec\phi-e^{-t}\vec\phi_0 }{ \Delta_t } \right\|^2, \tag{13} \]
burada:
\[ \Delta_t=1-e^{-2t}. \]
Bu çalışmada exact score analitik olarak bilindiğinden eğitim dinamiğinin teorik çözümünde Eşitlik (12) kullanılır.
Forward diffusion sonrası dağılım
Bir alan bileşeni için Fourier uzayında dağılım:
\[ P_t(\widetilde\phi) \propto \exp \left\{ -\frac{(2\pi)^d}{2} \int d^d\vec{k}\, \left[ \frac{ k^2+m_{\rm eff}^2 }{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} } \right] \widetilde\phi(\vec{k}) \widetilde\phi(-\vec{k}) \right\}. \tag{14} \]
Bu ifade Gaussian yapının diffusion süresince korunduğunu gösterir.
Exact score neden bir lineer konvolüsyondur?
Exact score:
\[ \mathcal F_t(\phi) = -\int d^d\vec y\, \mathcal S_t(\vec x,\vec y)\phi(\vec y). \tag{15} \]
biçimindedir. Yani alanın kendisiyle doğrusal bir operatör uygulanır.
Score kernel:
\[ \begin{aligned} \mathcal S_t(\vec x,\vec y) =& \int\frac{d^d\vec k}{(2\pi)^d} \frac{ k^2+m_{\rm eff}^2 }{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} } e^{i\vec k\cdot(\vec y-\vec x)} \\ =& \frac{1}{\Delta_t} \delta^{(d)}(\vec y-\vec x) - \frac{e^{-2t}}{(2\pi)^{d/2}\Delta_t^2} \left( \frac{M_t}{|\vec y-\vec x|} \right)^{d/2-1} K_{d/2-1} \left( M_t|\vec y-\vec x| \right), \end{aligned} \tag{16} \]
burada:
\[ M_t^2 = m_{\rm eff}^2 + \frac{e^{-2t}}{\Delta_t} \]
ve \(K_\nu\), ikinci tür değiştirilmiş Bessel fonksiyonudur.
Score kernel iki bölüm taşır: delta fonksiyonundan gelen kesin yerel parça ve uzamsal olarak yayılan kuyruk. Kısa mesafede bu kuyruk Yukawa-benzeri güç yasası davranışı gösterirken uzun mesafede üstel olarak bastırılır. Kritikliğe doğru \(m_{\rm eff}\rightarrow0\) olduğunda uzun-menzilli yapı önem kazanır.
Fourier uzayında translasyon değişmezliği sayesinde kernel diyagonal hale gelir:
\[ \widetilde{\mathcal S}_t(\vec k) = \frac{ k^2+m_{\rm eff}^2 }{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} }. \tag{17} \]
Bir katman exact score'u temsil edebiliyor; neden yine de sorun var?
Tek-katmanlı yaklaşık score aynı biçimde yazılır:
\[ F_t(\phi) = -\int d^d\vec y\, S_t(\vec x,\vec y) \phi(\vec y). \tag{18} \]
Burada model kapasitesi temel problem değildir: \(S_t\) uygun değere ulaştığında ağ exact \(\mathcal S_t\)'yi temsil edebilir. Araştırmanın bulduğu kritik darboğaz, temsil edilebilirlikten ziyade parametrelerin farklı Fourier modlarında ne kadar hızlı öğrenildiğidir.
Gradient-flow denklemi
Kernel için population loss:
\[ \mathcal L_t = \frac{1}{2} \int D\phi\,P_t(\phi) \left\| \int d^d\vec y\, [S_t(\vec x,\vec y)-\mathcal S_t(\vec x,\vec y)] \phi(\vec y) \right\|^2. \tag{19} \]
Gradient flow:
\[ \frac{ dS_t(\vec x',\vec y') }{ d\bar t } = -\eta \frac{ \delta\mathcal L_t }{ \delta S_t(\vec x',\vec y') }, \tag{20} \]
burada \(\bar t\), eğitim zamanı; \(t\) ise diffusion/noising zamanıdır. İki zaman değişkeni birbirinden farklıdır.
Operatör biçimi:
\[ \frac{dS_t}{d\bar t} = -\eta (S_t-\mathcal S_t)C_t, \tag{21} \]
ve kovaryans:
\[ C_t(\vec x,\vec y) = \langle \phi(\vec x)\phi(\vec y) \rangle_t. \tag{22} \]
Başlangıçta eğitilmemiş \(S_t(0)=0\) için çözüm:
\[ S_t(\bar t) = \mathcal S_t \left( 1-e^{-\eta C_t\bar t} \right). \tag{23} \]
Bu denklem kritik sonucun matematiksel kaynağıdır: farklı kovaryans özdeğerleri farklı hızlarda öğrenilir.
Tek Katmanlı Ağda Eğitim Süresi Neden \(L^2\) Ölçekleniyor?
Tek katmanlı ağda her Fourier modunun öğrenme zamanı o modun kovaryans özdeğerine bağlıdır; kritik noktada en küçük sıfır-dışı momentum \(k_{\min}=2\pi/L\) olduğundan stabil gradient-descent öğrenme oranı yaklaşık \(k_{\min}^2\propto L^{-2}\) ölçeğine sıkışır ve \(k=O(1)\) modlarını öğrenmek için gereken etkin eğitim zamanı \(L^2\) ile büyür.
Fourier-modu kovaryansı
Kaynak:
\[ \langle \widetilde\phi(\vec k) \widetilde\phi(\vec q) \rangle_t = \frac{ \delta^{(d)}(\vec k+\vec q) }{ (2\pi)^d } \widetilde C_t(\vec k), \tag{24} \]
ve:
\[ \widetilde C_t(\vec k) = \frac{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} }{ k^2+m_{\rm eff}^2 }. \tag{25} \]
elde eder.
Karşılık gelen zaman ölçeği:
\[ \tau_t(\vec k) = \frac{ k^2+m_{\rm eff}^2 }{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} }. \tag{26} \]
Uzun noising-time limitinde:
\[ \lim_{t\rightarrow\infty} \tau_t(\vec k) = 1. \tag{27} \]
Yani bütün modların eğitim zamanları birbirine yaklaşır.
Kısa-noising-time limitinde ise:
\[ \lim_{t\rightarrow0} \tau_t(\vec k) = k^2+m_{\rm eff}^2. \tag{28} \]
Bu ifade Langevin dinamiğinin mod-başına zaman ölçeğiyle aynı yapıdadır.
En küçük zaman ölçeği:
\[ \tau_{\min} = k_{\min}^2+m_{\rm eff}^2. \tag{29} \]
Gradient descent'in kararlı kalabilmesi için öğrenme oranı en hızlı moda göre sınırlandırılır. Kaynak minimax-optimal öğrenme oranını:
\[ \eta_{\rm opt} = \frac{ 2 }{ \tau_{\min}^{-1} + \tau_{\max}^{-1} } \tag{30} \]
olarak verir ve maksimum stabil öğrenme oranının aynı ölçeklenmeye sahip olduğunu açıklar.
Score-kernel hata metriği
\[ \varepsilon_S = \frac{ \sum_{x,y} |S(x,y)-\mathcal S(x,y)| }{ \sum_{x,y} |\mathcal S(x,y)| }. \tag{31} \]
Bu, öğrenilen kernel ile exact kernel arasındaki normalize edilmiş mutlak hatadır.
Etkin eğitim zamanı
Küçük noising time için ve maksimum öğrenme oranı ölçeğinde:
\[ \tau^{\rm eff}(\vec k) = \frac{ \tau(\vec k) }{ 2\tau_{\min} } = \frac{ m_{\rm eff}^2+k^2 }{ 2(m_{\rm eff}^2+k_{\min}^2) }. \tag{32} \]
Sonlu bir sistemde sıfır mod ayrı öğrenilebildiği için en küçük sıfır-dışı momentum:
\[ k_{\min} = \frac{2\pi}{L} \]
ve:
\[ \tau_{\min} = \left( \frac{2\pi}{L} \right)^2 + m_{\rm eff}^2. \tag{33} \]
Kritiklikte \(m_{\rm eff}=0\) olduğunda \(k=O(1)\) için:
\[ \tau^{\rm eff} \sim L^2. \]
Sonuç, exact score'u temsil eden tek-katmanlı ağın bile kritik noktada standart yerel örneklemenin \(L^2\) ölçeklenmesini miras almasıdır.
Diğer optimizer'lar sorunu çözüyor mu?
Kaynak, optimally tuned momentum yönteminin kritik ölçeklenmeyi \(L^2\)'den yaklaşık \(L\)'ye iyileştirebildiğini, fakat diverjan sistem-boyutu bağımlılığını tamamen ortadan kaldırmadığını bildirir. Gerçek-uzay optimizasyonunda Adagrad ve Adam ise bu basit convex problemde exact score kernel'e yakınsamamıştır. Dolayısıyla gradient descent özelindeki katsayılar değişebilse de kritik eğitim yavaşlaması yalnız optimizer değiştirmekle otomatik olarak ortadan kalkmamaktadır.
Eğitim hatası üretime nasıl taşınıyor?
Exact score için Fourier modunun reverse-diffusion denklemi:
\[ \partial_t \widetilde\phi^\ast(\vec k,t) = - \widetilde\phi^\ast(\vec k,t) \left[ 1- \frac{ k^2+m_{\rm eff}^2 }{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} } \right]. \tag{34} \]
Bunun exact çözümü:
\[ \widetilde\phi^\ast(\vec k,t;t_{\max}) = \frac{ \sqrt{ e^{-2t}+ \Delta_t(k^2+m_{\rm eff}^2) } }{ \sqrt{ e^{-2t_{\max}}+ \Delta_{t_{\max}} (k^2+m_{\rm eff}^2) } } \, \widetilde\phi^\ast(\vec k,t_{\max}). \tag{35} \]
\(t_{\max}\rightarrow\infty\) limitinde:
\[ \widetilde\phi^\ast(\vec k,t;\infty) = \frac{ \sqrt{ e^{-2t}+ \Delta_t(k^2+m_{\rm eff}^2) } }{ \sqrt{k^2+m_{\rm eff}^2} } \, \widetilde\phi^\ast(\vec k,\infty). \tag{36} \]
Bu çözüm exact \(P_t\) dağılımını yeniden üretir.
Sonlu eğitim zamanındaki yaklaşık score kullanıldığında Eşitlik (37) score'un öğrenilmemiş kısmını:
\[ 1- \exp \left[ -\frac{\eta\bar t}{\tau_t(\vec k)} \right] \]
faktörü üzerinden reverse dinamiğe sokar. Kaynak Eşitlik (38)'de bu denklemin üstel integral \(\operatorname{Ei}\) içeren exact kapalı çözümünü türetir. Üstel integral:
\[ \operatorname{Ei}(x) = - \int_{-x}^{\infty} \frac{e^{-u}}{u}\,du. \tag{39} \]
olarak tanımlanır. Bu uzun kapalı çözümün fiziksel mesajı, score'un belirli modlarda yetersiz eğitilmesinin reverse diffusion sırasında o modların varyansını sistematik biçimde değiştirmesidir.
Generation hatası nasıl ölçülüyor?
Gaussian modelde dağılım ortalaması sıfır olduğundan, üretilen dağılım kovaryans matrisiyle tamamen karakterize edilir. Kaynak normalize Frobenius hatasını kullanır:
\[ \varepsilon_C(\bar t,L) = \frac{ \left\| C_{\rm gen}(\bar t,L) - C^\ast(L) \right\|_F }{ \left\| C^\ast(L) \right\|_F }. \tag{42} \]
\(C^\ast\) hedef kovaryans, \(C_{\rm gen}\) üretilen alanların kovaryansı ve \(\|\cdot\|_F\) Frobenius normudur.
Kritiklikte önde gelen göreli hata davranışı:
\[ \sim \exp \left( -\frac{ \bar t\,t_{\max} }{ L^2 } \right) \]
biçimindedir. Dolayısıyla eğitimdeki \(L^2\) kritik yavaşlama, doğru kovaryansa sahip örneklerin üretilmesini de doğrudan yavaşlatmaktadır.
İkinci Lineer Katman Kritik Yavaşlamayı Nasıl Azaltıyor?
İkinci lineer katman yeni bir nonlineer fonksiyon sınıfı eklemekten çok score kernel'in faktörize edilmiş, aşırı-parametreli bir temsilini oluşturur; bu parametrizasyon gradient-descent yönlerini etkili biçimde yeniden koşullandırarak Fourier modları arasındaki öğrenme-zamanı farkını tek-katmanlı durumdaki doğrusal kovaryans bağımlılığından logaritmik bağımlılığa dönüştürür.
İki-katman score modeli
İki translasyon-değişmez kernel kullanılır:
\[ F_t^{\rm ov}(\phi) = - \int d^d\vec z\,d^d\vec y\, S_t^{(2)}(\vec x,\vec z) S_t^{(1)}(\vec z,\vec y) \phi(\vec y). \tag{46} \]
Gradient-flow denklemleri:
\[ \frac{dS_t^{(1)}}{d\bar t} = -\eta \left(S_t^{(2)}\right)^\dagger \left( S_t^{(2)}S_t^{(1)}C_t-I \right), \tag{47} \]
\[ \frac{dS_t^{(2)}}{d\bar t} = -\eta \left( S_t^{(2)}S_t^{(1)}C_t-I \right) \left(S_t^{(1)}\right)^\dagger. \tag{48} \]
Fourier uzayında her mod bağımsız hale gelir:
\[ \frac{ d\widetilde S_t^{(1)}(\vec k) }{ d\bar t } = -\eta \widetilde S_t^{(2)}(\vec k) \left[ \widetilde S_t^{(2)}(\vec k) \widetilde S_t^{(1)}(\vec k) \widetilde C_t(\vec k) -1 \right], \tag{49} \]
\[ \frac{ d\widetilde S_t^{(2)}(\vec k) }{ d\bar t } = -\eta \left[ \widetilde S_t^{(2)}(\vec k) \widetilde S_t^{(1)}(\vec k) \widetilde C_t(\vec k) -1 \right] \widetilde S_t^{(1)}(\vec k). \tag{50} \]
Fixed point:
\[ \widetilde S_t^{(2)}(\vec k) \widetilde S_t^{(1)}(\vec k) \widetilde C_t(\vec k) = 1. \]
Yani iki layer'ın ayrı ayrı tek bir zorunlu optimumu yoktur; önemli olan çarpımlarının exact score'u vermesidir. Aşırı-parametreleştirme burada tam olarak bu faktörizasyon serbestliğidir.
Dengeli iki-katman durumunda logistic denklem
İki layer başlangıçta eşitse:
\[ s= \widetilde S_t^{(1)}(\vec k) = \widetilde S_t^{(2)}(\vec k), \qquad c= \widetilde C_t(\vec k)>0 \]
ve:
\[ \dot{s} = \eta s(1-cs^2). \tag{51} \]
\[ u=s^2 \]
tanımıyla:
\[ \dot{u} = 2\eta u(1-cu). \tag{52} \]
Bu standart logistic denklemidir ve çözümü:
\[ u(\bar t) = \frac{ u_0 e^{2\eta\bar t} }{ 1-cu_0+cu_0e^{2\eta\bar t} }. \tag{53} \]
Dolayısıyla:
\[ s(\bar t) = \operatorname{sgn}[s(0)] \sqrt{ \frac{ u_0 e^{2\eta\bar t} }{ 1-cu_0+cu_0e^{2\eta\bar t} } }. \tag{54} \]
Kritik fark şudur: tek-katman Eşitlik (23)'te \(c\) üstel yakınsama hızının doğrudan içinde bulunurken iki-katman Eşitlik (53)'te \(e^{2\eta\bar t}\) kısmı \(c\)'den bağımsızdır. Hedef hassasiyete ulaşma süresi böylece \(c\)'ye doğrusal değil logaritmik bağımlılık gösterir.
Başlangıç ağırlıkları neden önemli?
Kaynak bütün modlarda \(\eta=O(1)\) düzeyinde stabil yakınsama için başlangıç layer ağırlıklarının yaklaşık:
\[ s(0)=O(1/L) \]
ölçeğinde seçilmesini ister. Standart Kaiming gibi \(O(1)\) büyüklüğünde başlangıçların sistem boyutu büyüdükçe bu teorik problem için giderek daha sorunlu hale gelebileceğini belirtir.
Layer'lar başlangıçta eşit değilse
Genel durumda:
\[ u(\bar t) = s_1(\bar t)s_2(\bar t), \tag{55} \]
ve layer mismatch:
\[ d_0=s_1^2(0)-s_2^2(0), \qquad \delta=|d_0|, \qquad \alpha=\frac{\delta}{2}. \]
Kaynak ayrıca:
\[ \kappa = c\alpha = \frac{c\delta}{2}, \qquad A = \sqrt{ 1+\kappa^2 } = \sqrt{ 1+\frac{c^2d_0^2}{4} }. \tag{56} \]
tanımlar. Kapalı çözüm Eşitlik (57)'de \(q_0\), \(R_0\), \(R(\bar t)\), \(q(\bar t)\) ve \(u(\bar t)\) zinciriyle verilir. Yakınsamanın üstel kısmı \(A\eta\) tarafından kontrol edilir. Sistem boyutuyla polynomial bozulmayı önlemek için:
\[ d_0 \lesssim \frac{1}{L^2} \]
koşulu gerekir. \(s_1,s_2=O(1/L)\) seçimi bunun için yeterli bir koşuldur.
Nümerik doğrulama
İki mimarinin mod-bazlı score hatası:
\[ \varepsilon_{F_e}(\vec k) = \left[ \frac{ \overline{ \left| F_t^{\rm ov}[\phi_t(\vec k)] - \mathcal F_t[\phi_t(\vec k)] \right|^2 } }{ \overline{ \left| \mathcal F_t[\phi_t(\vec k)] \right|^2 } } \right]^{1/2}. \tag{58} \]
Exact Fourier score:
\[ \mathcal F_t[\phi(\vec k)] = - \widetilde{\mathcal S}_t(\vec k) \widetilde\phi(\vec k). \tag{59} \]
Kaynağın Şekil 5 doğrulamasında \(d=2\), \(m_{\rm eff}=0\), \(a=1\), \(t=0.01\), \(L=16\) koşulları kullanılır. Tek-katmanda karakteristik hata sönüm zamanı \(1/\widetilde C(\vec k)\) ile, iki-katmanda ise yaklaşık \(-\log\widetilde C(\vec k)\) ile değişir. Nümerik deneyler 1024 eğitim konfigürasyonu ve 500 bağımsız simülasyon ortalaması kullanmaktadır.
Daha fazla katman daha da iyi mi?
Kaynak bu soruyu \(N_\ell\) eş katmanlı sadeleştirilmiş modelle analiz eder. \(u=s^{N_\ell}\) için:
\[ \dot u = \eta N_\ell u^{\,2-2/N_\ell} (1-cu). \tag{60} \]
Gerekli başlangıç ölçeği:
\[ s_0 \sim L^{-2/N_\ell}. \tag{61} \]
Karakteristik eğitim zamanı:
\[ \tau_{\rm eff} \sim L^{\,2-4/N_\ell}. \tag{62} \]
\(N_\ell=2\) özel durumunda power-law üs sıfıra iner ve daha ayrıntılı analiz \(\log L\) ölçeklenmesini verir. Fakat \(N_\ell\geq3\) için tekrar pozitif bir \(L\) kuvveti ortaya çıkar. \(N_\ell\rightarrow\infty\) limitinde üs 2'ye yaklaşır. Bu nedenle çalışmanın sadeleştirilmiş dengeli modelinde “daha fazla derinlik daima daha hızlıdır” sonucu çıkmaz; iki layer teorik olarak özel ve en avantajlı durumdur.
Fourier Uzayı Uygulaması Hesaplama Maliyetini Nasıl Değiştiriyor?
Gerçek uzayda bütün sistemi kapsayan bir konvolüsyonun ileri geçişi \(O(N^2)\) işlem gerektirirken aynı translasyon-değişmez konvolüsyon Fourier uzayında noktasal çarpıma dönüşür; FFT ve ters FFT'nin \(O(N\log N)\) maliyeti baskın hale geldiği için çalışma iki-katmanlı score ağının toplam ileri-geçiş karmaşıklığını \(O(N\log N)\) düzeyine indirir.
Neden gerçek-uzay konvolüsyonu pahalı?
Kritik noktada korelasyon uzunluğu diverge ettiği için exact score kernel tüm sistem boyuna yayılabilir. Kernel'i sistem büyüklüğünü kapsayacak şekilde gerçek uzayda doğrudan uygulamak:
\[ O(N^2) \]
işlem gerektirir.
Burada:
\[ N= \left( \frac{L}{a} \right)^d. \]
\(L\) doğrusal sistem boyutu, \(a\) kafes aralığı ve \(d\) uzaysal boyuttur.
FFT tabanlı hesaplama akışı
- Gerçek-uzay konfigürasyonu FFT ile Fourier uzayına dönüştürülür.
- Konvolüsyon kernel'i Fourier uzayında her moda noktasal çarpım olarak uygulanır.
- Sonuç ters FFT ile gerçek uzaya geri taşınır.
Fourier uzayındaki kernel çarpımının maliyeti \(O(N)\) iken FFT maliyeti:
\[ O(N\log N) = O\left( dL^d\log L \right) \]
olduğu için toplam score-call maliyetini FFT belirler.
Donanım doğrulaması
Kaynak Şekil 6, PyTorch gerçek-uzay iki-katmanlı convolutional network ile Fourier implementasyonunun ileri-geçiş wall time'larını karşılaştırır. Deneyler 1024 örnekli batch'ler üzerinde, \(d=1,2,3\) boyutları için ve NVIDIA Tesla V100-SXM2-32GB GPU kullanılarak gerçekleştirilmiştir. Fourier uygulaması ölçülen aralıkta gerçek-uzay convolution'dan daha hızlıdır ve daha elverişli sistem-boyutu ölçeklenmesi gösterir. Kaynak ayrıca bu deney aralığında teorik \(\log L\) düzeltmesinin açıkça çözümlenmediğini belirtmektedir.
Çalışmanın Yöntemi ve Bulguları
Son doğrulama deneyinin kurulumu
Fourier tabanlı iki-katman mimarisinin yalnız teorik eğitim zamanını değil, gerçek oluşturulan konfigürasyonların fiziksel özelliklerini doğru yeniden üretip üretmediğini sınamak için çalışma ayrı bir üretim deneyi gerçekleştirir.
| Parametre | Kaynak değeri | Bilimsel rolü |
|---|---|---|
| Uzaysal boyut | \(d=2\) | İki boyutlu Gaussian alan sistemi |
| Sistem boyutları | \(L=16,32,64,128\) | Sistem-boyutu ölçeklenmesini test eder |
| Etkin kütle | \(m_{\rm eff}=3/L\) | Sistem büyüdükçe kritikliğe yaklaşır |
| Diffusion-time aralığı | \(t_{\max}=5\) → \(t_{\min}=10^{-4}\) | Forward/reverse diffusion zaman aralığı |
| Diffusion-time modelleri | 3000 ayrı zaman noktası | Her \(t\) için bağımsız lineer ağ |
| Eğitim veri kümesi | \(M=4096\) | Her modelin eğitim konfigürasyonları |
| Öğrenme oranı | \(\eta=0.025\) | Gradient-descent adım büyüklüğü |
| Ağırlık başlangıcı | Ortalama 0, standart sapma \(1/L\) Gaussian | Teorik iki-katman yakınsama koşuluyla uyumludur |
| Reverse ODE | 4. mertebe Runge–Kutta | Denoising integrasyonu |
| İntegrasyon adımları | 1500 | Reverse ODE ayrıklaştırması |
| Eğitim epoch sayıları | 175, 200, 225, 250 | Sırasıyla \(L=16,32,64,128\); \(\log L\) beklentisiyle her ikiye katlamada yaklaşık sabit artış |
Güç spektrumu
İlk fiziksel observable:
\[ P(k) = \left\langle |\widetilde\phi(k)|^2 \right\rangle . \tag{63} \]
Bu nicelik farklı dalga sayılarındaki alan dalgalanmalarının ortalama gücünü ölçer. Kritik sistemde özellikle düşük \(k\) modları uzun-menzilli korelasyonları temsil ettiği için önemlidir.
Kaynak düşük-\(k\) bölümünü:
\[ \frac{1}{P(k)} \simeq ak^2+b \tag{64} \]
biçimine fit eder.
Buradan fitted effective mass:
\[ m_{\rm fit} = \sqrt{\frac{b}{a}} \]
olarak elde edilir.
| \(L\) | Hedef \(m_{\rm eff}=3/L\) | Üretilen veriden \(m_{\rm fit}\) | Kaynak yorumu |
|---|---|---|---|
| 16 | 0.188 | 0.189(3) | Hedefle çok iyi uyum |
| 32 | 0.094 | 0.097(2) | Hedefle çok iyi uyum |
| 64 | 0.0469 | 0.0463(8) | Hedefle çok iyi uyum |
| 128 | 0.0234 | 0.0234(4) | Hedefle çok iyi uyum |
Her eğri 20.000 konfigürasyon kullanılarak oluşturulmuştur. Bu test özellikle kritikliğe yaklaşırken düşük-\(k\) spektrumunun doğru üretilip üretilmediğini kontrol etmektedir.
Tam kritik noktadaki üretim testi
Kaynak Şekil 8'de \(m_{\rm eff}=0\) ve \(L=16,32,64,128\) için hedef \(O(n)\) konfigürasyonları ile diffusion model tarafından üretilen konfigürasyonlar karşılaştırılır. Her sistem boyutunda 20.000 konfigürasyon üzerinden:
- tek bir alan bileşeninin dağılımı \(P(\phi)\),
- action dağılımı,
- güç spektrumu \(P(k)\),
- kovaryans matrisi
kontrol edilir. Kaynak, bu gözlenebilirlerde üretilen dağılımların teorik hedeflerden nümerik olarak ayırt edilemediğini belirtmektedir.
Sonlu eğitim veri kümesinin etkisi
Ek B'de eğitim örneği sayısı \(M\) ayrıca incelenir. Discretize sistem \(N\) değişkenle temsil edildiğinde empirical covariance \(\widehat C_0\) üzerinden ideal sonsuz-eğitim-score tahmini:
\[ S_t = \left[ (1-e^{-2t})I + e^{-2t}\widehat C_0 \right]^{-1}. \tag{B1} \]
Gerçek-uzay \(N\times N\) kernel'in her elemanının sonlu örneklem hatası \(M\) büyüdükçe azalır. Kaynağın analizi Frobenius ve \(L_{1,1}\) normlarında toplam hata ölçeklenmelerini inceler.
Translasyon değişmezliği Fourier uzayında kernel'i diagonal yaptığı için, doğrudan momentum uzayında yalnız \(O(N)\) parametre öğrenmek mümkündür. Bu durumda kaynak:
\[ E_{1,1} \sim \frac{N}{\sqrt M}, \tag{B6} \]
ve:
\[ E_F \sim \sqrt{ \frac{N}{M} }. \tag{B7} \]
ölçeklenmelerini verir. Normalize göreli hata için önemli sonuç, sabit doğruluk sağlamak amacıyla \(M\)'nin sistem boyutuyla zorunlu biçimde büyütülmesinin gerekmediğidir. Bu nedenle sonlu örneklem hatası tek-katman kritik yavaşlamasının baskın \(L^2\) sonucunu değiştirmemektedir.
Reverse ODE ayrıklaştırma hatası
Basit Euler ayrıklaştırması:
\[ \frac{ \widetilde\phi(\vec k,t-\delta t) - \widetilde\phi(\vec k,t) }{ \delta t } = \widetilde\phi(\vec k,t) + (2\pi)^d \widetilde\phi(\vec k,t) \widetilde S_t(\vec k). \tag{B8} \]
ve eşdeğer güncelleme:
\[ \widetilde\phi(\vec k,t-\delta t) = \widetilde\phi(\vec k,t) \left[ 1+ \delta t \left( 1-(2\pi)^d\widetilde S_t(\vec k) \right) \right]. \tag{B9} \]
Euler yönteminde son hata \(O(\delta t)\)'dir. Kritik düşük-momentum modunda ve sabit \(\delta t\)'de mutlak hata büyük \(L\) için yaklaşık lineer olarak büyüyebilir. Kaynak bunun daha yüksek dereceli integratörlerle büyük ölçüde azaltılabileceğini gösterir.
Şekil 8'de kullanılan dördüncü mertebe Runge–Kutta yöntemi için gerekli discretization adımının yaklaşık:
\[ L^{1/4} \]
ölçeğinde büyümesinin yeterli olduğu belirtilir. Bu, tek-katmandaki \(L^2\) training darboğazından çok daha zayıf bir sistem-boyutu bağımlılığıdır.
Kritik Noktada Yerel Bir Score Kernel Yeterli midir?
Hayır. Ek C'nin ana sonucu, sınırlı menzilli bir score kernel'in toplam score hatasını belirli koşullarda küçük tutabilmesine rağmen kritik \(m_{\rm eff}\rightarrow0\) sisteminin düşük-momentum yapısını doğru yeniden üretmekte başarısız olabilmesidir; dolayısıyla yalnız toplam score hatasının küçük olması fiziksel kritik davranışın doğru üretildiğini garanti etmez.
Yerel kernel kesmesi
Exact score kernel:
\[ |\vec x-\vec y|>\frac{K}{2} \]
bölgesinde sıfıra ayarlanarak yapay biçimde yerelleştirilir. Tek bir noktadaki score hatası:
\[ \delta F_t^{(R)} = - \int_{|\vec y|>R} d^d\vec y\, \mathcal S_t(0,\vec y) \phi_t(\vec y), \tag{C1} \]
burada \(R=K/2\)'dir.
Kaynağın ölçek analizi toplam yerel hata varyansı için:
\[ {\rm Var}[\delta F_t^{(R)}] \sim R^{-d}, \qquad d\geq3, \tag{C5} \]
\[ {\rm Var}[\delta F_t^{(R)}] \sim \frac{\log L}{R^2}, \qquad d=2, \tag{C6} \]
\[ {\rm Var}[\delta F_t^{(R)}] \sim \frac{L}{R^2}, \qquad d=1. \tag{C7} \]
sonuçlarını verir.
Buna göre toplam score hatasını kontrol etmek için yaklaşık olarak:
- \(d=1\): \(R\sim\sqrt L\),
- \(d=2\): \(R\)'nin logaritmik olarak büyümesi,
- \(d\geq3\): sabit \(R\)
yeterli olabilir.
Fakat bu “kritik fizik doğru üretildi” anlamına gelmez. Ek C'nin power-spectrum testi, \(m_{\rm eff}\) küçüldükçe yerel/cropped score'un düşük-\(k\) spektrumunu yanlış yeniden ürettiğini gösterir. Kernel kesmesi fiziksel olarak sonlu korelasyon uzunluğu varmış gibi davranır. Kritik noktada gerçek korelasyon uzunluğu diverge ettiği için yerel kernel kritik davranışı kaybeder.
Bu sonuç neden önemli?
Bir makine öğrenmesi modelinin toplam ortalama hatasının küçük olması, fiziksel açıdan önemli bütün modların doğru olduğu anlamına gelmez. Kritik sistemlerde düşük-\(k\) modları toplam normda küçük ağırlığa sahip olsa bile uzun-menzilli korelasyonları belirler. Bu nedenle çalışma fiziksel gözlenebilirlerle doğrulamanın salt global score metriğine göre daha güvenli olduğunu göstermektedir.
Çalışmanın ana sonuçları
| Yöntem / mimari | Kritiklikte temel ölçeklenme | Kaynak yorumu |
|---|---|---|
| Yerel Langevin / basit MCMC gevşemesi | \(\tau\sim L^2\) | Fiziksel kritik yavaşlama |
| Tek lineer score katmanı + gradient descent | \(\tau_{\rm train}\sim L^2\) | Fiziksel darboğazı miras alır |
| Optimally tuned momentum | Yaklaşık \(L\) | Yavaşlamayı azaltır fakat kaldırmaz |
| İki lineer layer + uygun initialization | \(\tau_{\rm train}\sim\log L\) | Kritik training power-law yavaşlamasını ortadan kaldırır |
| \(N_\ell\geq3\) dengeli lineer layer | \(L^{2-4/N_\ell}\) | İki layer'dan daha kötü sistem-boyutu ölçeklenmesi |
| Naif gerçek-uzay tam konvolüsyon | \(O(N^2)\) | Hesaplama overhead'i avantajı yok edebilir |
| Fourier score uygulaması | \(O(N\log N)\) | FFT maliyeti baskındır |
Çalışmanın desteklediği sonuçlar
- Gaussian \(O(n\rightarrow\infty)\) modelinin exact diffusion score'u lineerdir ve tam-sistem lineer konvolüsyon kernel'iyle ifade edilebilir.
- Exact score'u temsil edebilen tek-katmanlı lineer ağın gradient-descent eğitimi kritik noktada \(L^2\) ölçekli kritik yavaşlama gösterir.
- Score eğitimindeki yavaşlama generation hatasına aktarılır ve doğru kovaryansın üretilmesini aynı sistem-boyutu ölçeklenmesiyle zorlaştırır.
- İkinci lineer layer'ın eklenmesi, uygun \(1/L\)-ölçekli initialization altında eğitim süresini \(L^2\)'den \(\log L\)'ye indirir.
- Daha fazla lineer layer bu sadeleştirilmiş modelde otomatik olarak daha iyi değildir; \(N_\ell>2\) için power-law sistem-boyutu bağımlılığı geri gelir.
- Fourier uygulaması tam-menzilli score hesabının ileri-geçiş maliyetini \(O(N^2)\)'den \(O(N\log N)\)'ye düşürür.
- Fourier tabanlı iki-layer ağın ürettiği kritik Gaussian alanlar; power spectrum, action, tek-alan dağılımı ve covariance ölçümlerinde teorik hedeflerle çok iyi uyum gösterir.
- Sonlu veri kümesi ve reverse-ODE ayrıklaştırma hataları incelenmiş ve tek-katman \(L^2\) training darboğazının baskın ölçeklenmesini değiştirmediği gösterilmiştir.
- Salt global score hatasının küçük olması kritik fiziksel korelasyonların doğru üretildiğini garanti etmez; düşük-\(k\) davranışının ayrıca kontrol edilmesi gerekir.
Çalışmanın desteklemediği sonuçlar
- \(L^2\rightarrow\log L\) iyileşmesi bütün modern görüntü/video difüzyon modelleri için evrensel bir yasa değildir.
- Çalışma Transformer, U-Net veya büyük nonlinear üretken modeller üzerinde aynı ölçeklenmeyi doğrudan göstermemektedir.
- Sonuçlar finite-\(n\) \(O(n)\) modellerinde analitik olarak doğrulanmış değildir.
- Gaussian modelde erişilemeyen \(m_{\rm eff}<0\) ferromanyetik faz doğrudan incelenmemektedir.
- İki layer'ın neden bu problemde özellikle optimum olduğu konusunda genel fiziksel sezginin tamamlandığı iddia edilmemektedir; yazarlar bunu gelecek araştırma konusu olarak bırakmaktadır.
- Yerel kernel'in toplam score hatasını kontrol etmesi kritik fiziksel gözlenebilirleri doğru üretme garantisi değildir.
- Fourier mimarisinin bütün çok-ölçekli gerçek veri setlerinde aynı performans avantajını göstereceği test edilmemiştir.
- Çalışma eğitim veri setinin nasıl elde edileceği sorununu çözmemektedir; yazarlar veri setini verilmiş kabul etmektedir.
Temel sınırlılıklar ve gelecek çalışma alanları
1. Gaussian büyük-\(n\) limiti: Analitik kontrolün ana nedeni aynı zamanda ana sınırlılıktır. \(n\rightarrow\infty\) limiti modelin Gaussian olmasını sağlar; finite-\(n\) etkileşimleri ve gerçek nonlinear score yapıları ana analizde bulunmaz.
2. Yüksek-sıcaklık/kritik taraf: Çalışma \(m_{\rm eff}\geq0\) bölgesine odaklanır. Gaussian limitte \(m_{\rm eff}<0\) model iyi tanımlı olmadığından ferromanyetik kırılmış-simetri fazı incelenemez.
3. Lineer mimariler: Tek ve iki layer ağlar aktivasyonsuz lineer konvolüsyonlardan oluşur. Bu, mimari parametrizasyon etkisini temiz biçimde izole eder fakat modern derin nonlinear diffusion mimarilerini temsil etmez.
4. Diffusion-time başına ayrı ağ: Son Fourier doğrulamasında tek bir time-embedded ağ yerine her sabit \(t\) için bağımsız bir ağ eğitilir. Bu tercih teoriyi doğrudan uygulamak içindir ve standart pratik diffusion mimarilerinden farklıdır.
5. Veri kümesi verilmiş kabul edilir: Fiziksel örnekleme problemlerinde çoğu zaman amaç zaten hedef dağılımdan eğitim verisi üretmektir. Makale, eğitim örneklerinin maliyetini temel problem dışında tutmaktadır.
6. Locality problemi: Kritik sistemde korelasyon uzunluğu diverge ettiği için tamamen yerel score modellemesi fiziksel düşük-\(k\) davranışını kaybedebilir.
7. Veri deposu DOI'si: Yüklenen v3 PDF veri erişilebilirliği beyanında Duke Digital Repository'ye atıf yapmaktadır ancak [96] referansında DOI hâlâ “10.7924/XXXXXXX” placeholder biçimindedir. Verianla bu eksikliği tamamlamamaktadır.
Kaynak ve Yöntem Notu
Özgün başlık: The critical slowing down in training diffusion models
Yazarlar: Luca Maria Del Bono, Giulio Biroli, Patrick Charbonneau, Marylou Gabrié.
Yazar sırası: Kaynak PDF'deki sıra aynen korunmuştur.
Sorumlu yazar: Luca Maria Del Bono. Kaynak PDF'de yıldız işaretiyle açıkça “Corresponding author” olarak belirtilmiştir.
Eş katkı: Yüklenen kaynakta eş katkı/eş birinci yazarlık beyanı tespit edilmemiştir.
Afiliyasyonlar: Dipartimento di Fisica, Sapienza Università di Roma; CNR-Nanotec Rome unit; Laboratoire de Physique Statistique, École normale supérieure / PSL Research University; Department of Physics, Duke University; Department of Chemistry, Duke University.
Yüklenen kaynak sürümü: arXiv:2605.12597v3 [cond-mat.dis-nn], 18 Eylül 2026.
arXiv DOI: 10.48550/arXiv.2605.12597. Bu DOI arXiv kaydının kalıcı kimliğidir ve dergi DOI'si değildir.
Güncel yayın durumu: Çalışma 28 Ekim 2026 tarihinde PRX Intelligence tarafından kabul edilmiştir. APS'nin “Accepted Paper” kaydındaki DOI 10.1103/yskc-plm7'dir. Bu Verianla metninin bilimsel içeriği yüklenen arXiv v3 PDF'ye dayanmaktadır; güncel kabul durumu yalnız bibliyografik doğrulama amacıyla eklenmiştir.
Dergi: PRX Intelligence — kabul edilmiş çalışma.
Yayınevi: American Physical Society (APS).
Kaynak türü: Teorik, analitik ve nümerik istatistiksel fizik / makine öğrenmesi araştırması.
Temel alanlar: Disordered Systems and Neural Networks, Statistical Mechanics, Artificial Intelligence, Machine Learning ve Computational Physics.
Ana fiziksel model: Gaussian \(O(n\rightarrow\infty)\) istatistiksel alan teorisi.
Ana makine öğrenmesi yöntemi: Score-based diffusion modeli; tek ve iki lineer konvolüsyon katmanının gradient-descent eğitim dinamiği.
Ana hesaplama yöntemi: Fourier-uzayı analizi, exact Gaussian score, gradient-flow çözümü, reverse diffusion ODE, FFT tabanlı score uygulaması ve nümerik konfigürasyon üretimi.
Nümerik yazılım: Kaynak, PyTorch konvolüsyonlarının kullanıldığını ve diffusion-model entegrasyon süper-yapısının bir bölümünün Referans [87]'den uyarlandığını belirtmektedir.
Nümerik donanım: Fourier ve gerçek-uzay ileri-geçiş süreleri karşılaştırmasında NVIDIA Tesla V100-SXM2-32GB GPU kullanılmıştır.
Veri erişilebilirliği: Yüklenen v3 PDF “The data that support the findings of this article are openly available [96]” ifadesini içerir; ancak aynı PDF'deki Referans [96] “Duke Digital Repository https://doi.org/10.7924/XXXXXXX” biçiminde tamamlanmamış DOI taşımaktadır. Bu nedenle kesin veri deposu DOI'si bu kaynak sürümünden doğrulanamamaktadır.
Finansman / hesaplama altyapısı: Çalışmada DARIAH HPC-AI cluster at CNR-NANOTEC, Lecce kullanılmıştır. Kaynak bu altyapının “MUR PON Ricerca e Innovazione 2014–2020” PIR01_00022 projesi ve European Union – NextGenerationEU – NRRP M4C2 kapsamındaki H2IOSC Project IR0000029 ile finanse edildiğini belirtmektedir.
Teşekkür: Yazarlar Davide Carbone, Sebastian Goldt, Misaki Ozawa ve Gilles Tarjus'a yararlı tartışmalar için teşekkür etmektedir. Luca Maria Del Bono ayrıca École normale supérieure'ün konukseverliğini belirtmektedir.
Çıkar çatışması: Yüklenen v3 PDF'de ayrı bir çıkar çatışması/competing interests beyanı tespit edilmemiştir; Verianla kaynakta bulunmayan bir beyan üretmemiştir.
Yazar katkıları / CRediT: Yüklenen v3 PDF'de ayrı bir CRediT katkı tablosu tespit edilmemiştir.
Lisans: arXiv kaydı non-exclusive distribution license göstermektedir. Bu, kaynak figürlerinin Creative Commons kapsamında serbestçe yeniden kullanılabileceği anlamına getirilmemiştir; Verianla kaynak figürlerini birebir kopyalamamış, bilimsel ilişkilerden bağımsız SVG ve HTML tablolar üretmiştir.
Temel yorum sınırı: Çalışma kontrollü Gaussian \(O(n\rightarrow\infty)\) modeli üzerinde lineer score mimarilerini incelemektedir. Sonuçların genel amaçlı büyük nonlinear diffusion modellerine nicel olarak doğrudan taşınması kaynak tarafından kanıtlanmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir