


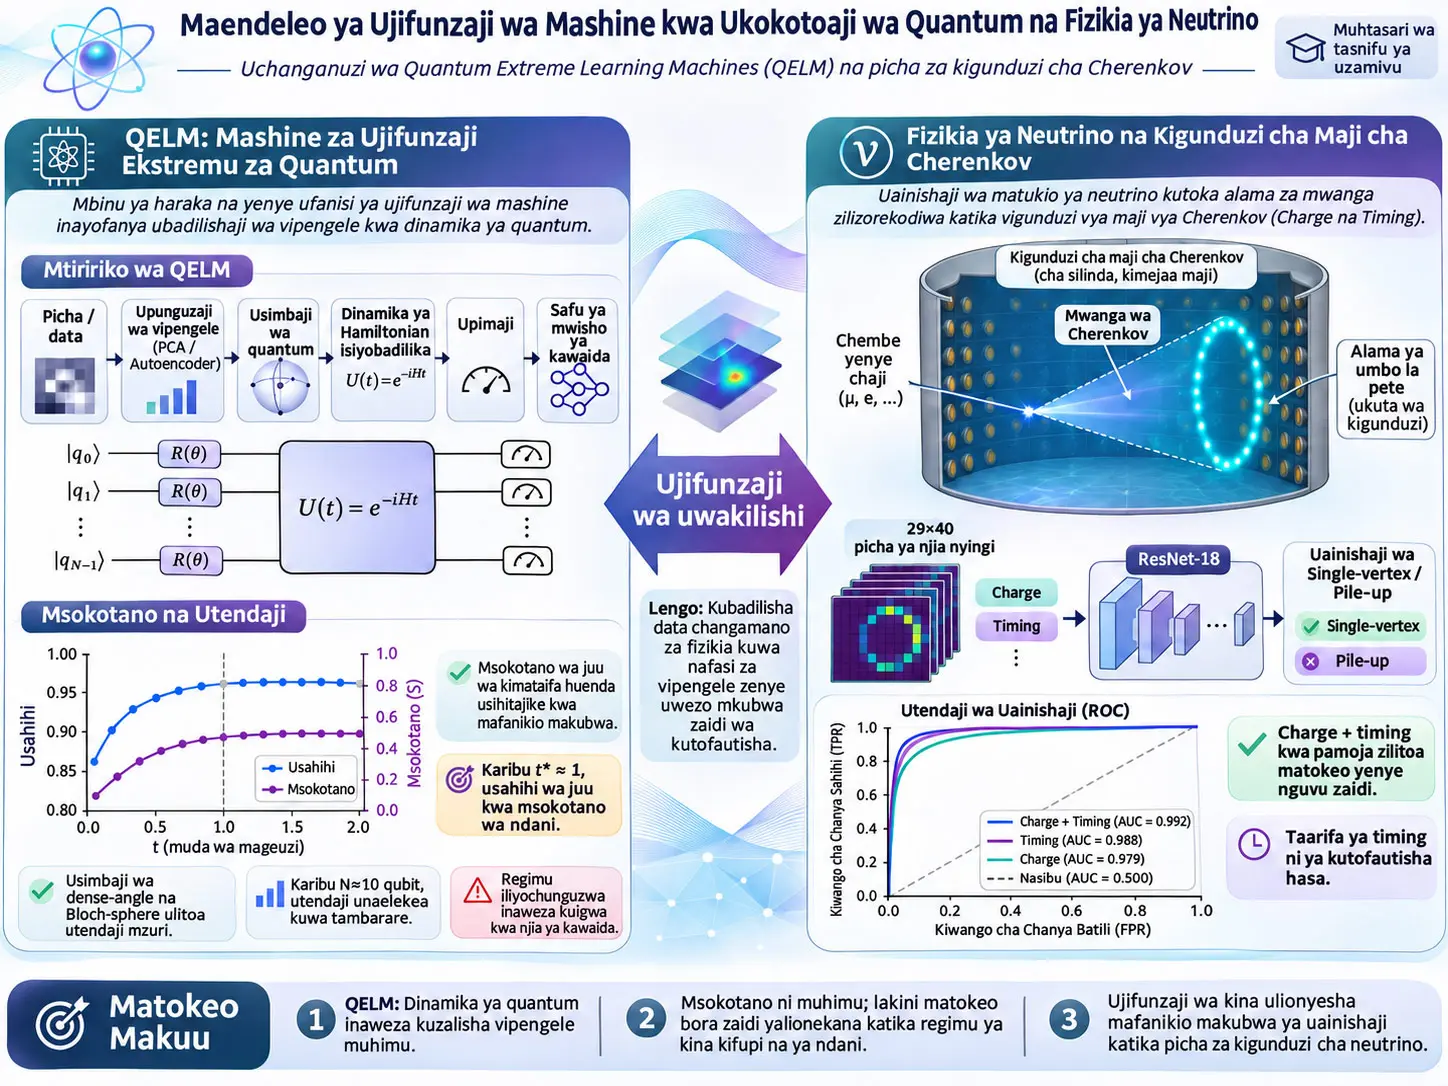
Quantum Extreme Learning Machine (QELM) ni usanifu mseto wa ujifunzaji wa mashine wa quantum–kawaida unaosimba data ya kawaida katika hali ya quantum, kubadilisha data kwa dinamika ya quantum isiyofunzwa na isiyobadilika, na kufunza tu safu ya mwisho ya kawaida ya usomaji. Tasnifu hii ya udaktari inachunguza tatizo la kutengeneza uwakilishi wenye ufanisi kutoka kwa data ya fizikia yenye vipimo vingi katika nyanja mbili tofauti. Mstari wa kwanza wa utafiti unachunguza jinsi QELM zinavyofanya kazi katika uainishaji wa picha, na jinsi mbinu ya ukandamizaji wa data, usimbaji wa quantum, dinamika ya Hamiltonian, kipimo, mfungamano na uwezekano wa kuigiza kwa njia ya kawaida vinavyoathiri utendaji. Mstari wa pili wa utafiti unachunguza kutenganisha matukio yenye sehemu moja ya mwingiliano na matukio ya pile-up ambako mwingiliano zaidi ya mmoja huingiliana ndani ya dirisha lilelile la usomaji, kwa kuchanganua picha za charge na timing zinazotokea katika vigunduzi vya neutrino vya maji vya Cherenkov kwa kutumia ResNet-18.
Utafiti wa kwanza upande wa QELM kwanza unakandamiza picha za MNIST na Fashion-MNIST kuwa vekta latent zenye vipimo vya chini kwa Principal Component Analysis (PCA) au convolutional autoencoder. Vipengele hivi hubadilishwa kuwa hali za qubit kwa kutumia angle, dense-angle, uniform Bloch-sphere, general au amplitude encoding. Kisha mageuko ya wakati ya kiunitari hutumika chini ya many-body Hamiltonian isiyobadilika. Vekta ya uwezekano inayotoka katika kipimo cha Computational-basis hufunzwa tu na shallow output neural network ya kawaida. Matokeo yanaonyesha kuwa chini ya ukandamizaji mkubwa, uwakilishi wa nonlinear autoencoder una ufanisi zaidi kuliko PCA, na kwamba usimbaji wa dense-angle na uniform Bloch-sphere unaotumia vipengele viwili/qubit hutoa uwiano mzuri hasa kati ya utendaji na utekelezekaji.
Katika utafiti wa kwanza wa QELM, kadiri idadi ya qubit inavyoongezeka, usahihi wa uainishaji huongezeka haraka na kuonyesha mwelekeo wa kufikia tambarare karibu na \(N\simeq10\). Mradi Hamiltonian zinazoingiliana zinazalisha uenezaji wa taarifa wa kutosha, utendaji wa modeli huwa na unyeti mdogo kwa kushangaza kwa maelezo ya kimaikroskopu ya Hamiltonian. Kinyume chake, katika hali za non-interacting ambako qubit hubaki huru, au katika regimen ambako taarifa haiwezi kuenea katika register kwa sababu ya localization kali, utendaji hupungua waziwazi. Matokeo haya yanaunga mkono kwamba kinachohitajika katika QELM si “Hamiltonian ya miujiza” maalum, bali dinamika ya quantum yenye mwingiliano wa kutosha ambayo inaweza kupanga upya taarifa iliyosimbwa katika nafasi ya kipimo.
Utafiti wa pili wa QELM katika tasnifu unaelekea kwenye swali la msingi zaidi: ni kiasi gani cha mfungamano wa quantum kinachohitajika kufikia mafanikio ya juu ya uainishaji, na je, regimen hii bado inaweza kuigwa kwa ufanisi kwenye kompyuta ya kawaida? Dense-angle encoding na nearest-neighbour XX Hamiltonian yenye masharti ya mpaka wa kipindi huwekwa bila kubadilika; ni wakati wa mageuko \(t\) pekee unaobadilishwa. Kwa MNIST, Fashion-MNIST na CIFAR-10, usahihi hubaki chini kwa nyakati fupi, huongezeka haraka karibu na \(t^\*\sim1\), kisha hufikia tambarare.
Matokeo muhimu zaidi ya quantum ni kwamba mpito huu hutokea kabla ya mfungamano wa volume-law kuundwa katika mfumo mzima. Wakati entropia za single-qubit hukua haraka katika kipimo cha \(t=O(1)\), half-chain entropy huhitaji muda wa \(t=O(N)\) kufikia global saturation. Kwa kuwa katika vitengo vilivyotumiwa kwa mnyororo wa XX kasi ya Lieb–Robinson ni \(v_{\mathrm{LR}}=1\), wakati wa \(t^\*\sim1\) taarifa imeenea kwenye site chache tu za jirani. Hata hivyo, usahihi wa uainishaji wa QELM tayari umefikia thamani ya tambarare.
Ugunduzi huu hauungi mkono wazo kwamba “mfungamano zaidi daima humaanisha ujifunzaji wa mashine bora zaidi”. Kulingana na hitimisho la tasnifu, kwa feature generation yenye manufaa katika majukumu yaliyochunguzwa, mfungamano mkubwa wa eneo la karibu unatosha; si lazima mnyororo mzima uwe globally scrambled. Zaidi ya hayo, dinamika hii ya muda mfupi inaweza kutekelezwa kwa makadirio kwa saketi za ndani zenye kina kisichobadilika na bado iko katika regimen inayoweza kufikiwa na mbinu za tensor-network kama Matrix Product State. Kwa hiyo, tasnifu haionyeshi ubora wa jumla au mkubwa wa ukokotoaji wa quantum.
Katika sehemu ya neutrino, tatizo la msingi la kifizikia ni tofauti. Neutrino haionekani moja kwa moja kwenye kigunduzi; chembe zenye chaji zinazozalishwa na mwingiliano wa neutrino zinaposonga kwa kasi ya kutosha ndani ya maji, huzalisha mwanga wa Cherenkov. Mahali, kiasi na muda ambao mwanga huu unafika kwenye mirija ya photomultiplier kwenye ukuta wa kigunduzi hubeba taarifa kuhusu topolojia ya kifizikia ya tukio. Uso wa silinda wa IWCD hufunguliwa katika viwianishi \((\phi,z)\) na kubadilishwa kuwa uwakilishi wa image-like wa pikseli 29×40.
Kwa kuwa kila moduli ya multi-PMT ina PMT 19 tofauti, uwakilishi wa picha wenye maelezo zaidi una chaneli 19 za charge na 19 za timing kwa kila pikseli, yaani jumla ya chaneli 38. Katika uchanganuzi kwa ResNet-18, charge na timing zinapotumiwa pamoja, AUC 0,987 hupatikana katika jaribio la No-Physics na AUC 0,990 katika jaribio la GENIE. Chaneli za timing pekee zina uwezo mkubwa wa kutofautisha kuliko chaneli za charge, na uwakilishi wa 2Q+2T ulio kompakt zaidi unaotumia wastani/mkengeuko wa kawaida pekee pia hubaki karibu sana na utendaji wa uwakilishi kamili wa 19Q+19T.
Tasnifu pia inatumia QELM kwa tatizo hilohilo la neutrino kama proof-of-concept. Hata hivyo, masharti ya ulinganisho si sawa: QELM hutumia tu subset iliyosawazishwa yenye matukio 60.000 ya NEUT; picha kamili za 29×40 kwanza hukandamizwa kwa PCA hadi vipengele 20 tu, kisha husimbwa katika qubit 10 kwa Bloch-sphere encoding. Katika usanidi bora wa time+charge, test AUC 0,6575, accuracy 0,6187 na F1 0,6286 hupatikana. Utendaji huu ni wa chini waziwazi kuliko ResNet-18. Tasnifu haitafsiri hili kama QELM kuishinda ResNet, bali kama onyesho la kwanza la uwezekano wa kuitumia kwa picha halisi-kikaribu za neutrino.
Quantum Extreme Learning Machine inatofautianaje na mtandao wa neva wa kawaida?
Katika QELM, badala ya hidden layer za kina zinazofunzwa katika mitandao ya neva ya kawaida, mfumo wa quantum usiobadilika hutumiwa kama feature generator; data husimbwa katika hali ya quantum, hubadilika chini ya Hamiltonian isiyobadilika, na uwezekano unaopatikana kutokana na kipimo hufunzwa tu katika safu ya mwisho ya kawaida ya readout.
Wazo la Extreme Learning Machine
Wazo kuu la mkabala wa kawaida wa Extreme Learning Machine ni kutenganisha feature generation na mchakato wa learning. Vigezo vya hidden layer vinaweza kuwekwa bila kubadilika; output layer pekee hufunzwa. QELM huhamisha wazo hili kwenda kwenye mfumo wa quantum.
Pipeline ya msingi ya QELM inayotumiwa katika tasnifu ina hatua nne:
- Data ya kawaida yenye vipimo vingi hukandamizwa kwa PCA au autoencoder.
- Vipengele latent husimbwa katika hali ya quantum yenye qubit \(N\).
- Hali ya quantum hubadilika kwa muda maalum chini ya many-body Hamiltonian isiyobadilika.
- Uwezekano wa kipimo cha Computational-basis hupewa shallow classifier ya kawaida.
Qubit ni nini?
Wakati bit ya kawaida inaweza kuwa na thamani 0 au 1 pekee, hali safi ya qubit huandikwa:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle, \qquad |\alpha|^2+|\beta|^2=1 \]
\(\alpha\) na \(\beta\) ni probability amplitude changamano. Kipimo kinapofanywa, matokeo ya \(|0\rangle\) hupatikana kwa uwezekano \(|\alpha|^2\), na matokeo ya \(|1\rangle\) kwa uwezekano \(|\beta|^2\).
Unapotumiwa tufe la Bloch, hali hiyo hiyo huonyeshwa:
\[ |\psi\rangle= \cos\left(\frac{\theta}{2}\right)|0\rangle + e^{i\phi} \sin\left(\frac{\theta}{2}\right)|1\rangle \tag{4.9} \]
kwa namna hiyo. \(\theta\) ni pembe ya polar na \(\phi\) ni pembe ya azimuth. Mbinu nyingi za encoding za QELM huweka vipengele vya kawaida moja kwa moja katika pembe hizi mbili.
Kwa nini nafasi ya Hilbert ni muhimu?
Nafasi ya hali ya mfumo wa qubit \(N\) ni:
\[ \mathcal{H}_N=(\mathbb{C}^2)^{\otimes N} \]
na ukubwa wake ni:
\[ \dim(\mathcal{H}_N)=2^N \]
.
Ukuaji huu wa kielelezo ndio msingi wa kihisabati unaowezesha kuunda state representation yenye vipimo vingi kwa idadi ndogo ya qubit. Hata hivyo, kuwepo kwa state space yenye vipimo \(2^N\) hakutengenezi moja kwa moja ubora wa quantum; state hiyo lazima iandaliwe, iendelezwe, ipimwe, na taarifa inayopatikana lazima iwe na manufaa halisi kwa uainishaji.
Vipengele vya kawaida husimbwaje katika qubit?
Tasnifu inalinganisha familia tano za encoding ambamo vipengele latent vya kawaida huwekwa katika amplitudes za qubit au pembe za tufe la Bloch; mbinu hizi huunda mabadilishano tofauti kati ya idadi ya vipengele vinavyobebwa kwa kila qubit na kina cha saketi ya state-preparation.
Dense-angle encoding
Dense-angle encoding huweka vipengele viwili katika kila qubit:
\[ |x\rangle = \bigotimes_{i=1}^{\lceil M/2\rceil} \left[ \cos\left(\frac{x_{2i-1}}{2}\right)|0\rangle + e^{ix_{2i}} \sin\left(\frac{x_{2i-1}}{2}\right)|1\rangle \right]. \tag{4.10} \]
Hapa \(x_{2i-1}\) hubadilishwa kuwa pembe ya polar, na \(x_{2i}\) kuwa pembe ya phase. Hivyo qubit moja hubeba vipengele viwili vya kawaida.
Angle encoding
Angle encoding hutumia pembe ya polar pekee:
\[ |x\rangle = \bigotimes_i \left[ \cos\left(\frac{x_i}{2}\right)|0\rangle+ \sin\left(\frac{x_i}{2}\right)|1\rangle \right]. \tag{4.11} \]
Kila qubit hubeba kipengele kimoja tu. Faida yake ni kwamba state preparation ni ya kina kidogo sana; hasara yake ni kwamba qubit zaidi zinaweza kuhitajika kuliko dense-angle ili kusimba idadi ileile ya vipengele.
Uniform Bloch-sphere encoding
Chanzo kinatoa usimbaji huu kama:
\[ |x\rangle = \bigotimes_i \left[ \sqrt{x_{2i-1}}|0\rangle+ e^{ix_{2i}} \sqrt{1-x_{2i-1}}|1\rangle \right] \tag{4.12} \]
Kipengele cha kwanza hudhibiti uzito wa population, na kipengele cha pili hudhibiti relative phase.
Amplitude encoding
Amplitude encoding:
\[ |x\rangle = \frac{1}{\|x\|_2} \sum_{i=0}^{2^N-1}x_i|i\rangle \tag{4.14} \]
kwa \(N\) qubit inaweza kinadharia kuweka hadi vipengele \(2^N\). Ingawa inaonekana kuwa kompakt sana kwa upande wa idadi ya qubit, generic amplitude state preparation inaweza kuhitaji saketi ya kina yenye many-qubit entangling circuit. Kwa sababu hii tasnifu inasisitiza kuwa utekelezekaji wa NISQ wa amplitude encoding ni mgumu zaidi kuliko usimbaji unaotegemea angle.
| Usimbaji | Vipengele kwa qubit | Kina cha kawaida cha saketi | Mabadilishano ya msingi |
|---|---|---|---|
| Angle | 1 | Chini | State preparation rahisi; qubit zaidi zinaweza kuhitajika |
| Dense-angle | 2 | Chini | Hutumia vigezo viwili vya Bloch; udhibiti wa phase unahitajika |
| Uniform Bloch-sphere | 2 | Chini | Husimba population na phase kwa pamoja |
| General | 2 | Chini | Uparametrishaji wa amplitudes uliorekebishwa moja kwa moja |
| Amplitude | Hadi jumla ya vipengele \(2^N\) | Juu | Inatumia qubit kwa ufanisi lakini generic state preparation ni ghali |
Katika utafiti wa kwanza wa uainishaji wa picha, usimbaji wa dense-angle na uniform Bloch-sphere kwa ujumla hutoa uwiano bora zaidi wa utendaji–utekelezekaji. General encoding hutoa matokeo mabaya zaidi hasa kwa idadi ndogo ya qubit. Amplitude encoding huboreka idadi ya latent feature inapokuwa kubwa vya kutosha; hata hivyo, katika hali ambapo pikseli zote 784 za MNIST zinatumiwa moja kwa moja kwa amplitude encoding kwa idadi ileile ya qubit, test accuracy hubaki karibu na 0,97 kwa \(N=10-12\), na hutoa matokeo ya chini kidogo kuliko mkabala wa dense-angle + compressed latent representation.
Kwa nini Hamiltonian haifunzwii katika QELM?
Lengo la QELM si kuboresha dinamika ya quantum kama trainable variational circuit, bali kuchunguza uwezo wa mfumo wa kifizikia usiobadilika kubadilisha data ya kawaida kuwa feature space yenye manufaa; kwa sababu hiyo vigezo vya Hamiltonian huwekwa bila kubadilika na mafunzo hufanywa tu katika output layer ya kawaida.
Mageuko ya wakati ya quantum state hufafanuliwa kwa:
\[ U(t)=e^{-iHt} \tag{4.15} \]
Hapa \(H\) ni Hamiltonian na \(t\) ni muda wa mageuko. Vitengo vya \(\hbar=1\) vinapotumiwa, umbo la kielelezo huandikwa hivi.
Hali ya mwanzo iliyosimbwa:
\[ |\psi(t)\rangle=U(t)|\psi_0(z)\rangle \]
ndiyo hiyo.
Kazi ya Hamiltonian si “kujifunza” lebo ya darasa. Kazi yake ni kusambaza upya taarifa ya feature ya awali ya eneo au yenye ugumu mdogo katika register, na kuzalisha probability representation inayofaa zaidi kutenganisha madarasa katika computational-basis measurement.
Kwa nini Hamiltonian sita tofauti hutumiwa katika utafiti wa kwanza?
Tasnifu hutumia familia za Hamiltonian zinazotofautiana kifisikia ili kujaribu ikiwa connectivity, integrability, chaos na localization kweli ndizo zinazoamua utendaji wa QELM.
| Modeli | Aina | Lengo kuu |
|---|---|---|
| \(H_1\) | Periodically driven long-range Ising | Reservoir yenye uchanganyaji mkubwa wa masafa marefu |
| \(H_2\) | Fully connected disordered transverse-field Ising | Kujaribu disorder na mwingiliano uliounganishwa kikamilifu |
| \(H_3\) | Chaotic nearest-neighbour Ising | Dinamika ya eneo lakini non-integrable/ergodic |
| \(H_4\) | Nearest-neighbour XXZ | Dinamika ya many-body ya eneo yenye anisotropic |
| \(H_5\) | Integrable XX chain | Reservoir rahisi, ya eneo na inayoweza kutatuliwa kikamilifu |
| \(H_6\) | Disordered long-range \(xx\) + random fields | Kulinganisha regimen za ergodic, non-ergodic na localized |
Long-range Ising \(H_1\)
Katika chanzo:
\[ H_1(t)= \begin{cases} B_1\displaystyle\sum_i\sigma_x^{(i)}, & 0\le t<T_1,\\ \displaystyle\sum_{i,j}J_{ij}^{(1)}\sigma_z^{(i)}\sigma_z^{(j)}, & T_1\le t<T, \end{cases} \tag{4.16} \]
na:
\[ J_{ij}^{(1)}= \frac{J_0}{|i-j|^\alpha} \tag{4.17} \]
hutumiwa.
Vigezo vinatolewa kama \(J_0=0.06\), \(\alpha=1.51\), \(B_1=3.05\) na \(T=2T_1=1\). Katika uigaji wa utafiti wa kwanza, dinamika hii hutumika kwa \(\Delta t=50T\).
Modeli ya Integrable XX \(H_5\)
Mnyororo wa XX:
\[ H_5= \frac12 \sum_{i=1}^{N} \left( \sigma_x^{(i)}\sigma_x^{(i+1)} + \sigma_y^{(i)}\sigma_y^{(i+1)} \right) \tag{4.24} \]
na sharti la mpaka wa kipindi:
\[ \sigma^{(N+1)}\equiv\sigma^{(1)} \]
hutumiwa.
Modeli ya XX ni modeli integrable inayoweza kulinganishwa na mfumo wa free fermion kupitia badiliko la Jordan–Wigner. Hata hivyo, inaweza kuzalisha local entanglement na ballistic information propagation zinazohitajika kwa uainishaji. Katika utafiti wa pili wa QELM wa tasnifu, modeli hii huchaguliwa hasa kwa sababu uhusiano kati ya dinamika ya kifizikia na classification transition unaweza kuchunguzwa kwa uwazi zaidi.
Kwa nini regimen ya localized hutoa utendaji mbaya?
Taarifa isipoenea katika register, vipengele vilivyosimbwa katika qubit tofauti havichanganyiki vya kutosha kabla ya measurement. Katika kikomo cha non-interacting \(H_2\), qubit husonga kwa kujitegemea. Katika regimen kali ya many-body localization, hata kama mwingiliano upo, spatial spreading ya taarifa ya mwanzo hukandamizwa kwa kiasi kikubwa.
Chanzo kinaonyesha kuwa katika hali zote mbili high-accuracy plateau huvunjika. Matokeo haya hayasemi kwamba “chaos ni lazima”; mnyororo wa integrable XX pia unaweza kufanya kazi vizuri. Kinachohitajika ni feature redistribution ya kutosha kwa jukumu la uainishaji linalochunguzwa.
Kwa nini kipimo ni sehemu muhimu ya quantum feature map?
Quantum state yenyewe haitolewi moja kwa moja kwa classifier ya kawaida; kwa kuwa classifier huona tu uwezekano wa vipimo, uhusiano kati ya eigenbasis ya Hamiltonian na measurement basis huamua ni taarifa gani ya mwingiliano wa quantum itabadilishwa kuwa feature ya kawaida.
Utengano wa spektramu wa Hamiltonian:
\[ H=\sum_n E_n|E_n\rangle\langle E_n| \tag{4.29} \]
uwe hivyo. Hali ya mwanzo:
\[ |\psi(0)\rangle=\sum_n c_n|E_n\rangle \tag{4.30} \]
na kwa muda:
\[ |\psi(t)\rangle= \sum_n c_ne^{-iE_nt}|E_n\rangle \tag{4.31} \]
hubadilika kwa namna hiyo.
Uwezekano wa matokeo katika measurement basis ya \(|s_k\rangle\) kwa kanuni ya Born ni:
\[ p_k(t)=|\langle s_k|\psi(t)\rangle|^2 \tag{4.32} \]
.
Chanzo kinaipanua na kupata:
\[ p_k(t)= \sum_{n,m} \langle s_k|E_n\rangle \langle E_m|s_k\rangle e^{-i(E_n-E_m)t} c_nc_m^\ast \tag{4.33} \]
usemi huo.
Mlinganyo huu ni muhimu sana. Ikiwa measurement basis ni sawa kabisa na eigenbasis ya Hamiltonian, off-diagonal interference contributions hupotea na:
\[ p_k(t)=|c_k|^2 \tag{4.34} \]
haibadiliki kwa muda. Kipimo kama hicho hakiwezi kutumia uwezo wa feature enrichment wa quantum dynamics.
Kinyume chake, ikiwa measurement basis na energy eigenbasis zinatofautiana vya kutosha, interference terms zinazotokana na tofauti za nishati \(E_n-E_m\) zinaweza kupanga upya probability vector kwa njia changamano kadiri muda unavyopita.
Safu ya kawaida ya matokeo ya QELM
Measurement probability vector:
\[ \mathbf{p}(t)= \left(p_s(t)\right)_{s\in\{0,1\}^N} \]
hutumiwa kama feature vector ya kawaida.
Safu ya matokeo:
\[ \mathbf{a}=W\mathbf{p}(t)+\mathbf{b} \tag{4.36} \]
huzalisha logit na softmax:
\[ y_c= \frac{e^{a_c}} {\sum_{c'=1}^{C}e^{a_{c'}}} \tag{4.37} \]
huzibadilisha kuwa class probability.
Categorical cross-entropy:
\[ \mathcal{L} = -\sum_{c=1}^{C}t_c\log y_c \tag{4.38} \]
hupunguzwa. Katika usanifu wa QELM, vigezo vya trainable ni \(W\) na \(b\); quantum reservoir yenyewe haifunzwii.
Je, QELM inahitaji mfungamano mwingi au kiasi sahihi cha mfungamano wa eneo?
Kwa QELM inayotegemea XX iliyochunguzwa katika tasnifu hii, usahihi wa juu wa uainishaji hauhitaji state yenye mfungamano wa kiwango cha juu kwa jumla au wa volume-law; tambarare ya usahihi hujitokeza katika regimen ya \(t^\*\approx1\), ambako mfungamano wa eneo umeundwa kati ya qubit jirani lakini mnyororo wote bado haujafungamana kwa nguvu.
Mpangilio unaodhibitiwa wa utafiti wa pili wa QELM
Utafiti huu huweka usanifu kwa kiasi kikubwa bila kubadilika ili kurahisisha tafsiri:
- feature reduction pipeline haibadiliki,
- encoding daima ni dense-angle,
- Hamiltonian ni mnyororo wa nearest-neighbour XX wenye masharti ya mpaka wa kipindi,
- measurement iko katika computational basis,
- continuous hyperparameter kuu inayobadilishwa ni evolution time \(t\) pekee.
XX Hamiltonian:
\[ H= \frac12 \sum_{i=1}^{N} \left( \sigma_x^{(i)}\sigma_x^{(i+1)} + \sigma_y^{(i)}\sigma_y^{(i+1)} \right) \tag{6.1} \]
na:
\[ |\psi_t(z)\rangle = e^{-iHt}|\psi_0(z)\rangle \tag{6.2} \]
hutumiwa.
Maeneo matatu ya utendaji
Katika MNIST, Fashion-MNIST na CIFAR-10, mikunjo ya accuracy–time kwa ujumla huonyesha maeneo matatu:
1. Muda mfupi: Dinamika bado haijabadilisha encoded state vya kutosha na accuracy ni ndogo.
2. Mpito: Karibu na \(t^\*\sim1\), training na test accuracy huongezeka haraka.
3. Tambarare: Baada ya \(t\gtrsim t^\*\), accuracy hufikia thamani ya tambarare inayotegemea dataset na \(N\).
Ni muhimu hasa kwamba muda wa mpito karibu hautegemei \(N\) katika ukubwa wa mifumo iliyochunguzwa. Ikiwa global scrambling ya mnyororo wote ingehitajika kwa classification, muda unaohitajika ungetarajiwa kuongezeka pamoja na ukubwa wa mfumo.
Vipimo vya muda vya entanglement ya eneo na ya jumla
Single-qubit entropy huongezeka haraka na:
\[ t=O(1) \]
hukaribia kushiba katika kipimo hicho. Hii inaonyesha kwamba kila qubit huunda mfungamano na mazingira yake ya karibu.
Half-chain entropy hupima global entanglement katika bipartition inayotenganisha nusu ya mnyororo na nusu nyingine, na kwa volume-law saturation huhitaji:
\[ t=O(N) \]
kipimo hicho.
Classification transition ya \(t^\*\approx1\) inaambatana na kipimo cha kwanza cha muda, si cha pili.
Kasi ya Lieb–Robinson ni nini?
Katika Hamiltonian za eneo, kuna kikomo madhubuti cha kasi kinachozuia taarifa na korrelasheni kuenea papo hapo kwa namna yoyote katika nafasi. Tabia hii huelezwa na Lieb–Robinson bound.
Kwa modeli ya XX ya tasnifu na vitengo vilivyotumiwa:
\[ v_{\mathrm{LR}}=1 \]
hupatikana.
Kwa hiyo, wakati \(t\lesssim1\), taarifa ya qubit moja inaweza kufikia kwa nguvu majirani walio takriban katika kiwango cha lattice spacing moja tu. QELM accuracy kufikia tambarare wakati huohuo kunaunga mkono kwamba site za mbali hazihitaji kufungamana kwa jumla kwa ajili ya classification.
Ulinganisho wa Haar-random unitary
Chanzo kinalinganisha plateau accuracy ya XX evolution na Haar-distributed random unitary zinazotumika kwa encoded state zilezile. Kwa kila \(N\) na dataset, sampuli 10 huru za Haar-random unitary hutumiwa.
Thamani ya tambarare ya \(t\gtrsim t^\*\) ya XX-QELM inalingana, ndani ya numerical uncertainties, na utendaji wa Haar-random unitary. Hata hivyo, modeli ya XX inaweza kufikia kiwango kilekile cha classification bila kuwa globally scrambled kama Haar-random state.
Shallow random circuits
Analog XX dynamics pia inalinganishwa na brickwork digital circuit inayotumia nearest-neighbour random two-qubit gates. Tasnifu inaripoti kwamba layer chache tu—kwa kawaida karibu layer nne hadi sita—zinaweza kutoa accuracy iliyo karibu sana na analog XX plateau.
Matokeo haya yanaimarisha tafsiri kwamba effective circuit depth haikui pamoja na \(N\) na relevant dynamics hubaki shallow.
Kwa nini matokeo haya si ubora mkubwa wa quantum?
Saketi za quantum za mwelekeo mmoja, zenye kina kifupi na mfungamano wa eneo uliobaki mdogo, mara nyingi zinaweza kuigwa kwa ufanisi kwa mbinu za tensor-network kama Matrix Product State. Regimen ya \(t^\*\) ambayo tasnifu imeona kuwa yenye manufaa kwa classification iko karibu kabisa na muundo huu.
Kwa hiyo, hitimisho la chanzo si kwamba “quantum feature map haina manufaa”. Hitimisho lina nuances zaidi: dinamika ya quantum inaweza kuhamisha madarasa kwenda kwenye feature geometry inayoweza kutenganishwa vizuri zaidi; lakini regimen ya dinamika ambako hili hutokea katika majukumu yaliyochunguzwa inaweza bado kufikiwa kwa njia za kawaida.
Probability polytope inamaanisha nini?
Kwa kila input sample, kipimo cha QELM hutoa uwezekano:
\[ p_t(s|z)=|\langle s|\psi_t(z)\rangle|^2 \tag{6.7} \]
.
Uwezekano wote wa bit-string \(2^N\):
\[ \mathbf{p}_t(z) = \left( p_t(s_1|z),\ldots,p_t(s_{2^N}|z) \right) \tag{6.6} \]
upo ndani ya probability simplex:
\[ \Delta_{2^N-1} = \left\{ \mathbf{p}\in\mathbb{R}^{2^N} \;\middle|\; p_i\ge0,\; \sum_i p_i=1 \right\}. \tag{6.8} \]
Tasnifu huita sample cloud hii “probability polytope”.
K-means inertia:
\[ I= \sum_{k=1}^{K} \sum_{x_j\in C_k} \|x_j-\mu_k\|_2^2 \tag{6.9} \]
hutumiwa kupima cluster compactness. Kadiri \(I\) inavyopungua, cluster hukusanyika kwa ukaribu zaidi kuzunguka centroid.
Utafiti unaonyesha kwamba wakati wa QELM accuracy transition, cluster za probability-space huwa zinaendana zaidi na class labels; kwa upande mwingine, single-site local observables zinaweza kupoteza taarifa ya darasa kadiri muda unavyopita. Hivyo, taarifa haipotei; huhamishwa kutoka local observables kwenda kwenye global correlation structure.
Kwa nini neutrino haionekani moja kwa moja na pete za Cherenkov huundwaje?
Katika kigunduzi cha maji cha Cherenkov, neutrino haitoi mwanga moja kwa moja; chembe zenye chaji za umeme zinazozalishwa na mwingiliano wa neutrino zinaposonga ndani ya maji kwa kasi kubwa kuliko kasi ya awamu ya mwanga, huzalisha mionzi ya Cherenkov yenye umbo la koni, na makutano ya koni hiyo na uso wa kigunduzi huunda picha zinazofanana na pete kwenye PMT.
Sharti la Cherenkov
Ili chembe izalishe mionzi ya Cherenkov ndani ya maji:
\[ v>\frac{c}{n} \]
lazima litimizwe.
Hapa \(v\) ni kasi ya chembe, \(c\) ni kasi ya mwanga katika ombwe, na \(n\) ni thamani ya refractive index ya kiowevu.
Pembe ya Cherenkov:
\[ \cos\theta_C= \frac{1}{\beta n}, \qquad \beta=\frac{v}{c} \]
hutolewa na uhusiano huu.
Kwa maji katika eneo la optiki, takriban \(n\approx1.33\), na kwa chembe za relativistic sana zenye \(\beta\rightarrow1\), pembe ya juu zaidi ni takriban \(42^\circ\).
Pete inayoonekana katika PMT haibebi tu taarifa ya kuwepo kwa chembe; pia hubeba taarifa kuhusu jiometri ya tukio kama direction, vertex position, propagation length na light timing.
Kwa nini single-vertex na pile-up zinaweza kuchanganywa?
Tukio la single-vertex lina neutrino interaction vertex moja, lakini interaction hiyo inaweza kuzalisha charged particle nyingi. Kwa hiyo, hata katika tukio la single-vertex, Cherenkov ring zaidi ya moja inaweza kuonekana.
Katika tukio la pile-up, interaction mbili au zaidi huru hutokea ndani ya detector readout window ileile. Pete za vertex kadhaa zinaweza kuingiliana.
Kwa hiyo, kanuni rahisi kama “ring moja = single vertex, ring nyingi = pile-up” si halali. Modeli lazima ijifunze spatial na temporal structure kwa pamoja.
Kwa nini charge na timing hukamilishana?
Charge inahusiana na kiasi cha mwanga kinachofika kwenye PMT na hubeba taarifa ya event morphology/brightness.
Timing huonyesha lini fotoni zinafika kwenye sensa na ni nyeti kwa vertex geometry, particle propagation na temporal separation ya interactions tofauti.
Katika matokeo ya tasnifu, timing-only representation kutoa classification bora kuliko charge-only representation kunathibitisha temporal component yenye nguvu ya tatizo la pile-up.
Picha ya IWCD hubadilishwaje kuwa mtandao wa neva bandia?
Uso wa silinda wa IWCD hufunguliwa katika viwianishi \((\phi,z)\), na kuunda picha ya 29×40 ambamo kila moduli ya multi-PMT hubadilishwa kuwa pikseli moja; thamani za charge na timing za PMT 19 katika kila pikseli hupewa mtandao wa neva kama chaneli tofauti au takwimu za muhtasari.
Mlolongo wa uigaji
Detector response huigwa kwa WCSim. Katika No-Physics dataset, final-state particle tracks huzalishwa moja kwa moja bila kutumia neutrino–nucleus interaction generator. Lengo ni kuhakikisha classifier inajifunza topolojia ya single-vertex/pile-up badala ya maelezo ya generator-specific.
Katika mkusanyiko wa data wa No-Physics:
- electron, muon, \(\pi^0\) na \(\pi^-\) hutumiwa,
- mielekeo ya track huchukuliwa sampuli kwa isotropic,
- jumla ya visible energy ni hadi 2000 MeV,
- uwiano wa single-vertex na pile-up ni sawa,
- matukio milioni 5 hutumiwa kwa training,
- matukio milioni 1 huru hutumiwa kwa test.
Mikusanyiko ya data ya GENIE na NEUT hutumia neutrino–nucleus interaction generator halisi-kikaribu. Kila mmoja una matukio milioni 1 na muundo wa takriban %32 single-vertex, %68 pile-up. Mikusanyiko hii hutumiwa kama majaribio ya realistic generalization.
Kwa nini pikseli 29×40 hufikia hadi chaneli 38?
Kila moduli ya multi-PMT ni image pixel moja. Kwa kuwa moduli moja ina PMT 19, kwa kila PMT:
19 charge channel + 19 timing channel = 38 channel
hupatikana.
Notation ya chanzo:
| Uwakilishi | Yaliyomo |
|---|---|
| 19Q | Chaneli 19 tofauti za charge |
| 19T | Chaneli 19 tofauti za timing |
| 19Q+19T | Chaneli 38 kamili |
| 2Q | Muhtasari wa mean + standard deviation wa thamani 19 za charge |
| 2T | Muhtasari wa mean + standard deviation wa thamani 19 za timing |
| 2Q+2T | Chaneli nne za muhtasari kwa Charge na timing |
Kwa nini Double-cover inahitajika?
Uso wa silinda unapofunguliwa kuwa mstatili tambarare, ingawa \(\phi=0\) na \(\phi=2\pi\) ni majirani kimwili, hutenganishwa kwenda kingo za kushoto na kulia za picha. Convolution ya kawaida inaweza kudhani kingo hizi mbili ni sehemu zilizo mbali.
Double-cover construction huiga na kupanga upya sehemu husika za picha ili kuwakilisha periodic cylindrical boundary kwa njia ya kifizikia zaidi kwa CNN.
Usanifu wa ResNet-18
Tasnifu huhifadhi muundo residual wa standard ResNet-18 lakini hurekebisha stem ya ingizo ili kuhifadhi taarifa nzuri za spatial ndani ya detector images.
Residual stage nne:
| Hatua | Chaneli ya matokeo | Residual block | Stride ya block ya kwanza |
|---|---|---|---|
| Layer 1 | 64 | 2 | 1 |
| Layer 2 | 128 | 2 | 2 |
| Layer 3 | 256 | 2 | 2 |
| Layer 4 | 512 | 2 | 2 |
Operesheni ya msingi ya residual block ni:
\[ y=F(x,W)+x \]
. Shortcut connection hurahisisha kujifunza mabadiliko residual badala ya kuunda mapping yote itakayojifunzwa kutoka sifuri na husaidia gradient flow katika mitandao ya kina.
Mwishoni mwa stage, adaptive average pooling hupunguza kila feature map hadi thamani 1×1. 512-dimensional vector hufanywa flatten na kupewa fully connected output layer.
Vigezo vya mafunzo ya ResNet
| Kigezo | Thamani |
|---|---|
| Optimizer | Adam |
| Learning rate | 0,01 |
| Epoch | 20 |
| Batch size | 512 |
| Jukumu | Classification ya madarasa mawili |
| Loss | Cross-entropy |
| Training augmentation | Hutumika |
| Validation / test augmentation | Haitumiki |
Mbinu na Matokeo ya Utafiti
Katika utafiti wa kwanza wa uainishaji wa picha kwa QELM, ni kipengele gani kilikuwa cha kuamua kweli?
Katika utafiti wa kwanza, athari kubwa zaidi zinatokana na uchaguzi wa feature reduction na encoding; nonlinear convolutional autoencoder huzalisha latent representation bora kuliko PCA, huku dense-angle na uniform Bloch-sphere encoding zikitoa uwiano mzuri kati ya utendaji wa juu na state preparation yenye kina kidogo kwa kutumia vipengele viwili kwa kila qubit.
Mikusanyiko ya data na uchakataji wa awali
Katika utafiti wa kwanza wa QELM, picha za grayscale za MNIST na Fashion-MNIST zenye ukubwa wa 28×28 hutumiwa. Thamani za pikseli hugawanywa kwa 255 na kurekebishwa kuwa katika masafa ya [0,1]. Denoising ya ziada au data augmentation haitumiki.
PCA inapotumiwa, picha ya 28×28 hufanywa flat kuwa vekta yenye vipimo 784 na huprojektiwa kwenye principal component za kwanza \(d\).
Autoencoder inapotumiwa, tensor asilia ya 28×28 huingia kwenye encoder na ni bottleneck vector yenye vipimo \(d\) pekee inayohifadhiwa.
Baseline configuration:
| Kipengele | Chaguo la rejea |
|---|---|
| Feature reduction | Autoencoder AE1 |
| Encoding | Dense-angle |
| Hamiltonian | Periodically driven long-range \(H_1\) |
| Classical readout | Feed-forward neural network |
| Idadi kubwa zaidi ya qubit | \(N=12\) |
\(N=12\) inaelezwa katika utafiti huu kuwa kikomo cha kivitendo cha full quantum dynamics kwa upande wa classical simulation. Kikomo hiki si idadi ya juu kabisa ya qubit ya quantum hardware halisi.
Matokeo ya PCA na autoencoder
Convolutional autoencoder za AE1 na AE2 hutoa classification accuracy bora kuliko PCA. AE1 kubwa zaidi huzalisha reconstruction error ndogo na latent representation bora zaidi; kwa upande mwingine, hubeba trainable parameter nyingi zaidi na training cost kubwa zaidi.
Chanzo kinafasiri matokeo haya hasa katika hali ya compression kali: wakati ni feature chache tu zinaweza kupelekwa kwenye quantum layer, ni taarifa ipi inayohifadhiwa huathiri kwa kiwango kikubwa mafanikio ya mwisho ya classification.
Matokeo ya encoding
Dense-angle na uniform Bloch-sphere ni miongoni mwa mbinu zenye nguvu zaidi za single-qubit encoding kwa upande wa training na test. Kwa kuwa simple angle hutumia kipengele kimoja kwa kila qubit, hubeba classical information kidogo katika \(N\) ileile.
Faida ya amplitude encoding ni uwezo wa kutoa compact state representation ya hadi vipengele \(2^N\); hasara yake ni kwamba generic state preparation inaweza kuwa ngumu sana kutekelezwa kwa majaribio.
Matokeo ya Hamiltonian
Interaction Hamiltonian nyingi zilizochunguzwa hutoa performance zinazokaribiana sana kadiri \(N\) inavyoongezeka na hufikia plateau karibu na \(N\simeq10\).
Matokeo haya hayathibitishi kwa ujumla kwamba integrability au chaos si muhimu. Hitimisho finyu zaidi la utafiti ni hili: katika matatizo ya image-classification na masafa ya system-size yaliyojaribiwa, maadamu taarifa inasambazwa vya kutosha, microscopic details za Hamiltonian huleta tofauti ndogo katika accuracy.
Non-interacting au strongly localized dynamics, kwa upande mwingine, hutoa matokeo mabaya zaidi kwa kiwango kinachoonekana.
Kikomo cha classical baseline
Utafiti wa kwanza unalinganisha QELM na baselines kama single-layer neural network inayopokea original 784 pixels na classical output network inayopokea AE1 latent features. Kwa thamani kubwa zaidi za \(N\), QELM inaweza kuonyesha performance iliyo juu ya baselines hizi.
Hata hivyo, haiwezi kuhitimishwa kutokana na hili kwamba “QELM inazidi modeli zote za kawaida za ujifunzaji wa mashine.” Ulinganisho umefanywa dhidi ya shallow baselines maalumu; si benchmark inayojumuisha modern classical models zote zenye nguvu zaidi.
Kwa nini utafiti wa pili wa QELM unapunguza dai la ubora wa quantum?
Kwa sababu classification performance ya juu zaidi hutokea kabla ya global volume-law entanglement kuundwa, katika hali ya kina kisichobadilika ambapo mfungamano wa muda mfupi na wa eneo la karibu hutawala; hali hii bado inaweza kufikiwa kwa njia za kawaida kwa kutumia tensor-network na shallow random-circuit.
Matokeo ya msingi:
| Kipengele cha matokeo | Matokeo ya chanzo | Tafsiri |
|---|---|---|
| Accuracy transition | \(t^\*\sim1\) | Kwa kiwango kikubwa huru na thamani za \(N\) zilizochunguzwa |
| Local entanglement | \(t=O(1)\) | Kiwango kilekile na classification transition |
| Half-chain volume-law saturation | \(t=O(N)\) | Si lazima kwa high accuracy |
| Lieb–Robinson velocity | \(v_{\mathrm{LR}}=1\) | Katika \(t\sim1\), taarifa imesambaa tu katika mazingira ya karibu |
| Haar-random comparison | Plateau accuracy inaendana ndani ya numerical uncertainties | XX dynamics inaweza kuzalisha random-like useful representation |
| Digital random circuits | Kwa kawaida layer 4–6 zinaweza kukaribia plateau | Dynamics yenye kina kidogo inaweza kutosha |
| Classical simulability | Hali inayolingana na tensor-network | Hakuna ushahidi wa generic strong quantum advantage |
Tafsiri inayoungwa mkono na sehemu hii ya tasnifu
Dinamika ya quantum inaweza kubadilisha representation geometry ya classical data kwa namna yenye manufaa. Entanglement ina jukumu katika mabadiliko haya. Lakini “entanglement yenye manufaa” na “entanglement ya juu kabisa/ya kimataifa” si kitu kilekile.
Tafsiri isiyoungwa mkono na sehemu hii ya tasnifu
Matokeo haya hayawezi kutumika kuhitimisha fault-tolerant quantum computer advantage, exponential speedup au intractability kwa classical algorithms. Kinyume chake, hali iliyochunguzwa inaendana na classical tractability.
ResNet-18 ilitenganisha matukio ya neutrino kwa kiwango gani?
Uwakilishi kamili wa 19Q+19T unaotumia pamoja taarifa za charge na timing hutoa AUC 0,987 katika No-Physics dataset na AUC 0,990 katika GENIE dataset; huku uwakilishi wa timing-only ukifanya vizuri kuliko charge-only, uwakilishi compact wa 2Q+2T hubaki karibu sana na input ya channel kamili.
| Usanidi | Loss | Accuracy | F1 | AUC |
|---|---|---|---|---|
| 19Q + 19T | 0,128 | 0,954 | 0,953 | 0,987 |
| 2Q + 2T | 0,136 | 0,951 | 0,950 | 0,986 |
| 19T | 0,142 | 0,949 | 0,948 | 0,985 |
| 19Q | 0,212 | 0,916 | 0,913 | 0,970 |
| Usanidi | Loss | Accuracy | F1 | AUC |
|---|---|---|---|---|
| 19Q + 19T | 0,114 | 0,954 | 0,966 | 0,990 |
| 2Q + 2T | 0,126 | 0,950 | 0,963 | 0,987 |
| 19T | 0,126 | 0,950 | 0,963 | 0,988 |
| 19Q | 0,180 | 0,924 | 0,943 | 0,976 |
Katika matokeo haya, nguvu ya timing information ina maana ya kifizikia. Sifa ya msingi ya matukio ya pile-up si spatial overlap pekee, bali pia independent interactions zinazoweza kutokea nyakati tofauti ndani ya readout window ileile.
Kadiri event vertices zinavyokaribiana katika nafasi na muda, ndivyo classification inavyokuwa ngumu zaidi. Events zilizo karibu na detector boundaries pia huainishwa kwa ugumu zaidi kwa sababu ya light patterns zinazokatika kwa sehemu.
Kwamba modeli iliyofunzwa kwenye No-Physics inaonyesha tabia ya ROC inayofanana kwenye interaction generators halisi-kikaribu zaidi kama GENIE na NEUT kunaunga mkono wazo kwamba classifier haijakariri tu sifa bandia za generator moja. Hata hivyo, haya yote ni simulated detector datasets; uthibitishaji wa mwisho wa uwanjani kwenye experimental IWCD data halisi haukufanywa katika tasnifu hii.
Je, QELM iliweza kuhamishiwa kwenye picha halisi-kikaribu za neutrino?
Ndiyo, lakini katika kiwango cha awali cha proof-of-concept pekee: matukio 60.000 ya NEUT yenye uwiano sawa yalibinywa hadi vipengele 20 vya PCA na kuhamishiwa kwenye QELM ya 10-qubit, na utenganishaji ulio juu ya random guessing ulipatikana; performance ilibaki chini kwa wazi kuliko ResNet-18 inayotumia picha kamili.
Mpangilio wa neutrino wa QELM
Input tatu zenye vipimo 20 zilitumiwa:
Charge only: feature 20 za charge.
Time only: feature 20 za timing.
Time + charge: feature 10 za timing + feature 10 za charge.
Dimensionality reduction hufanywa kwa PCA. Vector yenye vipimo 20 hubadilishwa kuwa 10-qubit Bloch-sphere encoding. Hubadilika chini ya XX-type Hamiltonian. Measurement probability vector hupelekwa kwenye sigmoid readout moja.
| Input | Train AUC | Train Accuracy | Train F1 | Test AUC | Test Accuracy | Test F1 |
|---|---|---|---|---|---|---|
| Charge only | 0,6600 | 0,6159 | 0,6058 | 0,6558 | 0,6110 | 0,6049 |
| Time only | 0,6560 | 0,6131 | 0,6215 | 0,6482 | 0,6112 | 0,6241 |
| Time + charge | 0,6659 | 0,6227 | 0,6288 | 0,6575 | 0,6187 | 0,6286 |
Class-wise recall:
| Input | Recall class 0 | Recall class 1 |
|---|---|---|
| Charge only | 0,629 | 0,593 |
| Time only | 0,580 | 0,642 |
| Time + charge | 0,595 | 0,642 |
Ukaribu wa thamani za train na test unapendekeza kwamba overfitting kali haikuonekana katika mpangilio huu. Hata hivyo, absolute classification performance ni yenye mipaka.
Kwa nini ResNet na QELM si ulinganisho wa moja kwa moja wenye haki?
ResNet inaweza kutumia 29×40 spatial structure kamili na channel kadhaa kwa convolution. Katika jaribio la QELM, picha imebinywa hadi feature 20 tu za PCA. Spatial topology, local pixel correlations na maelezo mengi hupotea kabla ya kufikia quantum encoding.
Zaidi ya hayo, QELM hutumia subset yenye uwiano sawa ya matukio 60.000, huku mnyororo wa tathmini wa ResNet ukifanya kazi na mikusanyiko mikubwa zaidi ya data yenye mamilioni ya matukio.
Kwa sababu hii, chanzo hakitoi dai la competitive benchmark kwa matokeo ya QELM.
Mielekeo ya kazi ya baadaye
Tasnifu inaeleza kwamba katika mkondo wa neutrino-QELM, convolutional autoencoder inapaswa kutumiwa badala ya PCA, idadi ya qubit iongezwe, na si classification accuracy pekee bali pia training/inference time na total computational cost zilinganishwe.
Kwa upande wa quantum, scalable architectures zaidi, mbinu mbadala za encoding na utekelezaji kwenye NISQ hardware halisi ni maeneo ya kazi ya baadaye.
Kwa upande wa neutrino deep-learning, tofauti za simulation–real-data, systematic uncertainties, detector effects, robustness na interpretability zinahitaji uthibitishaji wa juu zaidi.
Matokeo yanayoungwa mkono na utafiti
Tasnifu inaonyesha kwamba QELM zinazotumia pamoja classical image compression na fixed quantum feature generation zinafanya kazi kwa supervised image classification.
Katika hali ya strongly compressed input, nonlinear autoencoder representation inaweza kutoa classification feature bora kuliko PCA.
Dense-angle na uniform Bloch-sphere encoding hutoa uwiano mzuri kati ya performance na implementation complexity katika hali zilizochunguzwa.
Interacting Hamiltonian nyingi tofauti zinaweza kutoa accuracy zinazokaribiana zinapotoa information spreading ya kutosha kwa jukumu lilelile; non-interacting na localized dynamics hutoa performance ya chini zaidi.
Katika XX-QELM, classification transition hutokea kabla ya global scrambling na katika kiwango kilekile cha muda na uundaji wa local entanglement.
Hali hii ya high-performance inaendana na shallow local circuits na tensor-network simulability.
ResNet-18 inaonyesha performance ya juu kwa single-vertex/pile-up discrimination kwenye simulated Cherenkov images zinazofanana na IWCD.
Timing information hubeba discriminative content yenye nguvu zaidi kuliko charge information katika utenganishaji wa matukio uliochunguzwa.
QELM iliweza kuhamishiwa, kama proof-of-concept baada ya compression kali, kwenye NEUT event images halisi-kikaribu.
Matokeo ambayo utafiti hauungi mkono
Tasnifu haithibitishi computational quantum advantage ya jumla kwa QELM.
Tasnifu haionyeshi exponential speedup kwenye quantum hardware.
Tasnifu haiungi mkono hitimisho kwamba “entanglement zaidi daima huzalisha classification bora zaidi.”
Matokeo ya MNIST/Fashion-MNIST/CIFAR-10 hayawezi kujumlishwa kiotomatiki kwa kazi zote za machine-learning.
Matokeo ya ResNet si experimental performance ya mwisho kwenye IWCD detector data halisi; tathmini kuu zinategemea simulated datasets.
Matokeo ya QELM neutrino si matokeo yanayoizidi ResNet au kufikia performance sawa nayo.
Generalization nzuri kwenye GENIE na NEUT haionyeshi kwamba systematic uncertainties zote za detector halisi zimetatuliwa kikamilifu.
Matokeo ya QELM simulation katika tasnifu hayathibitishi kwa majaribio matatizo yote ya NISQ noise, gate error, readout error na calibration ya quantum-device halisi.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: MACHINE LEARNING DEVELOPMENT FOR QUANTUM COMPUTING AND NEUTRINO PHYSICS
Mwandishi: Annalisa De Lorenzis.
Aina ya utafiti: Doctoral thesis / tasnifu ya udaktari.
Nyanja: Quantum machine learning, quantum computing, machine learning, neutrino physics, water Cherenkov detector data analysis.
Shahada: Doctor of Physics.
Taasisi inayotoa shahada: Universitat Autònoma de Barcelona (UAB), Department of Physics. Taarifa hii imethibitishwa na rekodi rasmi ya taasisi ya UAB ya tasnifu.
Wasimamizi: M. Pilar Casado Lechuga; Thorsten Lux; Arnau Riera Graells.
Tutor: M. Pilar Casado Lechuga.
Tarehe ya jalada la PDF: 29 Mei 2026.
Tarehe rasmi ya shahada: Kulingana na rekodi ya taasisi ya UAB ya tasnifu, 10 Julai 2026.
Tarehe ya kuwasilishwa kwa ArXiv: 15 Julai 2026.
Rekodi ya ArXiv: arXiv:2607.13699v1 [quant-ph].
Repository DOI: 10.48550/arXiv.2607.13699.
Rekodi rasmi: arXiv:2607.13699 na rekodi ya taasisi ya UAB ya tasnifu, Handle 10803/698010.
Hali ya mapitio ya kitaalamu: Tasnifu yenyewe ni tasnifu ya udaktari na rekodi ya tasnifu/preprint ya arXiv; si makala ya jarida. Hata hivyo, sehemu muhimu ya matokeo makuu ya QELM katika tasnifu imechapishwa katika makala mbili tofauti zilizopitiwa na wataalamu katika Physical Review Applied.
Chapisho kuu 1 lililoorodheshwa katika tasnifu: Annalisa De Lorenzis, M. P. Casado, M. P. Estarellas, N. Lo Gullo, T. Lux, F. Plastina, A. Riera, J. Settino, “Harnessing Quantum Extreme Learning Machines for Image Classification,” Physical Review Applied 23, 044024, Aprili 2025.
Chapisho kuu 2 lililoorodheshwa katika tasnifu: Annalisa De Lorenzis, M. P. Casado, N. Lo Gullo, T. Lux, F. Plastina, A. Riera, “Entanglement and Classical Simulability in Quantum Extreme Learning Machines,” Physical Review Applied 25, 054052, Mei 2026.
Dokezo kuhusu hali ya uchapishaji ndani ya chanzo: Kurasa za mwanzo za tasnifu zinaonyesha makala ya pili kuwa imechapishwa kama Physical Review Applied 25, 054052, Mei 2026, huku katika maandishi ya mapema ya Sura 6 kukiwa bado na kauli ya zamani kama “currently under review”; mwishoni mwa Sura 6, utafiti unashughulikiwa kwa namna inayolingana na hali ya accepted/published. Tofauti hii ya muda wa uhariri haibadilishi matokeo ya kisayansi.
Leseni: Rekodi ya arXiv inaonekana chini ya non-exclusive distribution license. Leseni ya CC BY haijadhaniwa. Kwa kuwa chanzo kina vielelezo vyenye hakimiliki vya Physical Review Applied, vielelezo hivyo havikutumiwa moja kwa moja katika HTML ya Verianla; mahusiano ya kisayansi pekee yameundwa upya kwa inline SVG asilia.
Ufadhili / msaada: Ingawa tasnifu haina formal funding statement tofauti, katika sehemu ya acknowledgements inashukuru Qilimanjaro Quantum Tech na AGAUR kwa msaada wao wakati wa mchakato wa udaktari.
Programu na ukokotoaji: Tafiti za QELM hutumia simulated quantum dynamics kwa njia ya kawaida. Neutrino detector response iliundwa kwa WCSim; image-analysis pipeline imehusishwa na WatChMaL framework; mafunzo ya ResNet yalifanywa katika mpangilio wa PyTorch cross-entropy/Adam. Matumizi ya Keras/Adam yanaelezwa katika sehemu za classical readout za QELM.
Vyanzo vya data: MNIST, Fashion-MNIST, CIFAR-10; No-Physics, GENIE na NEUT-based IWCD simulations zilizozalishwa kwa WCSim.
Kikomo kikuu cha QELM: Full-state simulation huweka kikomo kwa idadi ya qubit; katika utafiti wa kwanza \(N=12\) ilitumiwa kama practical classical-simulation limit. Comprehensive hardware-error benchmark haikufanywa kwenye NISQ hardware halisi.
Kikomo kikuu cha quantum-advantage: Hali ya high-accuracy ya XX-QELM inahusishwa na local entanglement na shallow effective circuit depth na inaendana na efficient classical tensor-network simulation. Matokeo haya hayaungi mkono dai la generic strong quantum advantage.
Kikomo kikuu cha neutrino: Tathmini za ResNet zinategemea realistic lakini simulated detector datasets. Systematic detector uncertainties na simulation-to-real-data discrepancies lazima zishughulikiwe tofauti katika matumizi ya majaribio halisi.
Kikomo cha ulinganisho wa QELM–ResNet: Neutrino QELM hutumia 60.000 NEUT event na 20 PCA feature, huku ResNet ikitumia multi-channel images kamili na mikusanyiko mikubwa zaidi ya data. Performance zao hazipaswi kufasiriwa kama head-to-head benchmark chini ya hali sawa za input.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *