


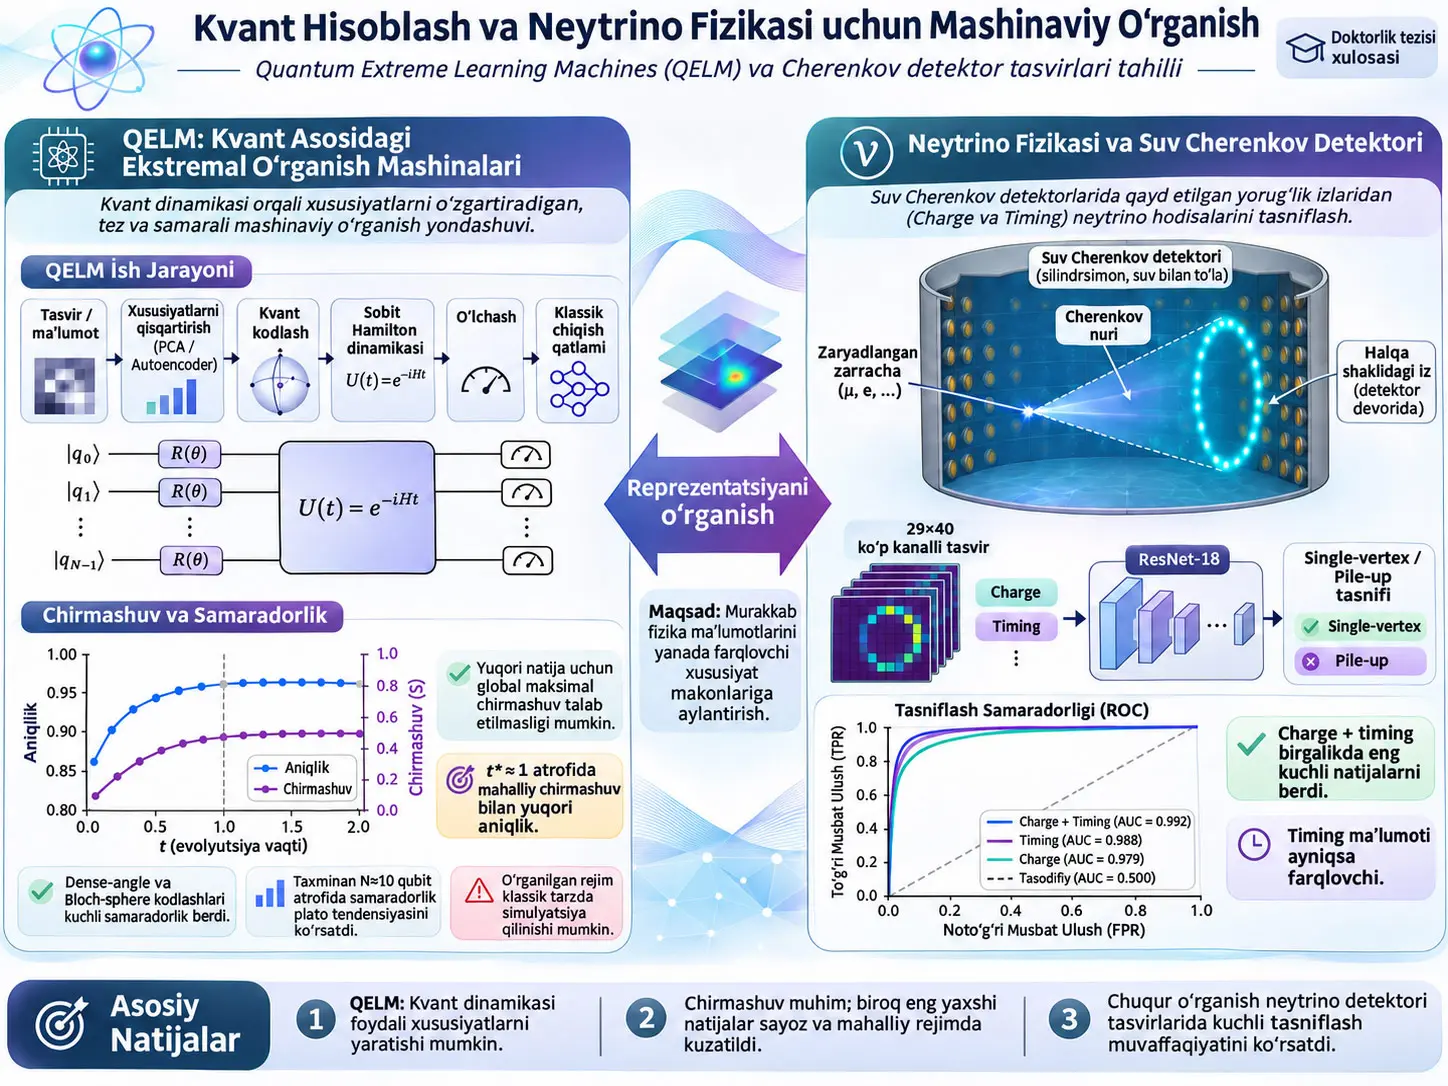
Quantum Extreme Learning Machine (QELM) — klassik maʼlumotlarni kvant holatiga kodlaydigan, maʼlumotlarni oʻqitilmaydigan sobit kvant dinamikasi orqali oʻzgartiradigan va faqat yakuniy klassik oʻqish qatlamini oʻqitadigan gibrid kvant–klassik mashinaviy oʻrganish arxitekturasidir. Ushbu doktorlik dissertatsiyasi yuqori oʻlchamli fizika maʼlumotlaridan samarali tasvir hosil qilish muammosini ikki xil sohada oʻrganadi. Birinchi tadqiqot yoʻnalishi QELM-larning tasvirlarni tasniflashda qanday ishlashini, maʼlumotlarni siqish usuli, kvant kodlash, Hamiltonian dinamikasi, oʻlchash, chigallashuv va klassik simulyatsiya qilish imkoniyati ishlash samaradorligiga qanday taʼsir qilishini tadqiq qiladi. Ikkinchi tadqiqot yoʻnalishi esa suv Cherenkov neytrino detektorlarida yuzaga keladigan charge va timing tasvirlarini ResNet-18 yordamida tahlil qilib, bitta oʻzaro taʼsir nuqtali hodisalarni bir xil oʻqish oynasida bir nechta oʻzaro taʼsir ustma-ust tushadigan pile-up hodisalaridan ajratishni oʻrganadi.
QELM yoʻnalishidagi birinchi ish MNIST va Fashion-MNIST tasvirlarini avval Principal Component Analysis (PCA) yoki convolutional autoencoder yordamida past oʻlchamli latent vektorlarga siqadi. Ushbu xususiyatlar angle, dense-angle, uniform Bloch-sphere, general yoki amplitude encoding yordamida qubit holatlariga aylantiriladi. Keyin sobit many-body Hamiltonian ostida unitar vaqt evolyutsiyasi qoʻllanadi. Computational-basis oʻlchovidan olingan ehtimollik vektori faqat klassik shallow output neural network tomonidan oʻrganiladi. Natijalar kuchli siqish sharoitida nonlinear autoencoder tasvirlari PCA-ga qaraganda samaraliroq ekanini hamda ikki xususiyat/qubit ishlatadigan dense-angle va uniform Bloch-sphere kodlashlari ishlash–amalga oshirish mumkinligi nuqtayi nazaridan ayniqsa yaxshi muvozanat berishini koʻrsatadi.
Birinchi QELM ishida qubit soni ortgani sari tasniflash aniqligi tez oshadi va taxminan \(N\simeq10\) atrofida plato tendensiyasini koʻrsatadi. Oʻzaro taʼsirlashuvchi Hamiltonianlar yetarli axborot tarqalishini hosil qilgan ekan, model ishlashi Hamiltonianning mikroskopik tafsilotlariga hayratlanarli darajada kam sezgir boʻladi. Aksincha, qubitlar mustaqil qoladigan non-interacting holatlarda yoki kuchli localization sabab axborot register boʻylab tarqala olmaydigan rejimlarda ishlash sezilarli darajada pasayadi. Bu natija QELM-da zarur boʻlgan omil maxsus “moʻjizaviy Hamiltonian” emas, balki kodlangan axborotni oʻlchov fazosida qayta tashkil qila oladigan yetarlicha oʻzaro taʼsirli kvant dinamikasi ekanini qoʻllab-quvvatlaydi.
Dissertatsiyaning ikkinchi QELM tadqiqoti yanada fundamental savolga yoʻnaladi: yuqori tasniflash muvaffaqiyatiga erishish uchun qancha kvant chigallashuvi kerak va bu rejim klassik kompyuterda hali ham samarali simulyatsiya qilinishi mumkinmi? Dense-angle encoding va davriy chegara shartli nearest-neighbour XX Hamiltoniani sobitlanadi; faqat evolyutsiya vaqti \(t\) oʻzgartiriladi. MNIST, Fashion-MNIST va CIFAR-10 uchun aniqlik qisqa vaqtlarda past boʻlib qoladi, taxminan \(t^\*\sim1\) atrofida tez koʻtariladi va keyin plato hosil qiladi.
Eng muhim kvant natijasi shundaki, bu oʻtish butun tizimda volume-law chigallashuvi yuzaga kelishidan oldin sodir boʻladi. Bir-qubit entropiyalari \(t=O(1)\) masshtabida tez oʻsarkan, half-chain entropy-ning global saturation-ga yetishi \(t=O(N)\) vaqt talab qiladi. XX zanjiri uchun ishlatilgan birliklarda Lieb–Robinson tezligi \(v_{\mathrm{LR}}=1\) boʻlgani sababli \(t^\*\sim1\) vaqtida axborot faqat bir nechta qoʻshni site-ga tarqalgan boʻladi. Shunga qaramay, QELM tasniflash aniqligi allaqachon plato qiymatiga yetadi.
Bu topilma “koʻproq chigallashuv har doim yaxshiroq mashinaviy oʻrganish deganidir” degan fikrni qoʻllab-quvvatlamaydi. Dissertatsiya xulosasiga koʻra, oʻrganilgan vazifalarda foydali feature generation uchun kuchli lokal chigallashuv yetarli; butun zanjirning global ravishda scramble boʻlishi shart emas. Bundan tashqari, bu qisqa-vaqt dinamikasi sobit chuqurlikdagi lokal sxemalar bilan taxminan amalga oshirilishi mumkin va Matrix Product State kabi tensor-network usullari uchun hamon erishish mumkin boʻlgan rejimdir. Shu sababli dissertatsiya umumiy yoki kuchli kvant hisoblash ustunligini koʻrsatmaydi.
Neytrino boʻlimida asosiy fizik muammo boshqacha. Neytrino detektorda bevosita koʻrinmaydi; neytrino oʻzaro taʼsiri hosil qilgan zaryadlangan zarrachalar suvda yetarlicha tez harakat qilganda Cherenkov nuri hosil qiladi. Bu nurning detektor devoridagi fotomultiplier naychalarga yetib borish joyi, miqdori va vaqti hodisaning fizik topologiyasi haqida axborot beradi. IWCD-ning silindrsimon yuzasi \((\phi,z)\) koordinatalarida yoyilib, image-like 29×40 pikselli tasvirga aylantiriladi.
Har bir multi-PMT modulida 19 ta alohida PMT boʻlgani sababli eng batafsil tasvir har bir piksel uchun 19 charge va 19 timing kanali, yaʼni jami 38 kanalni oʻz ichiga oladi. ResNet-18 bilan oʻtkazilgan tahlilda charge va timing birga ishlatilganda No-Physics testida AUC 0,987, GENIE testida AUC 0,990 olinadi. Timing kanallari yolgʻiz holda charge kanallaridan koʻra yaxshiroq farqlaydi va faqat oʻrtacha/standart ogʻishdan foydalanadigan ixchamroq 2Q+2T tasviri ham toʻliq 19Q+19T tasvirining ishlashiga juda yaqin qoladi.
Dissertatsiya xuddi shu neytrino muammosiga QELM-ni ham proof-of-concept sifatida qoʻllaydi. Biroq taqqoslash shartlari teng emas: QELM faqat 60.000 ta NEUT hodisasidan tashkil topgan muvozanatlangan subset-dan foydalanadi; toʻliq 29×40 tasvirlar avval PCA orqali atigi 20 xususiyatga siqiladi, soʻng 10 qubit-ga Bloch-sphere encoding bilan kodlanadi. Eng yaxshi time+charge konfiguratsiyasida test AUC 0,6575, accuracy 0,6187 va F1 0,6286 olinadi. Bu ishlash ResNet-18-dan sezilarli darajada past. Dissertatsiya buni QELM-ning ResNet-ni yengishi sifatida emas, balki realistik neytrino tasvirlariga qoʻllash mumkinligining dastlabki feasibility namoyishi sifatida talqin qiladi.
Quantum Extreme Learning Machine klassik neyron tarmogʻidan qanday farq qiladi?
QELM-da klassik neyron tarmoqlarining oʻqitiladigan chuqur hidden layer-lari oʻrniga sobit kvant tizimi feature generator sifatida ishlatiladi; maʼlumot kvant holatiga kodlanadi, sobit Hamiltonian ostida evolyutsiyalanadi va oʻlchovdan olingan ehtimollar faqat yakuniy klassik readout qatlamida oʻrganiladi.
Extreme Learning Machine gʻoyasi
Klassik Extreme Learning Machine yondashuvining asosiy gʻoyasi feature generation va learning jarayonlarini bir-biridan ajratishdir. Hidden layer parametrlari sobit saqlanishi mumkin; faqat output layer oʻqitiladi. QELM bu gʻoyani kvant tizimiga koʻchiradi.
Dissertatsiyada ishlatilgan asosiy QELM pipeline-i toʻrt bosqichdan iborat:
- Yuqori oʻlchamli klassik maʼlumotlar PCA yoki autoencoder bilan siqiladi.
- Latent xususiyatlar \(N\) qubit-li kvant holatiga kodlanadi.
- Kvant holati sobit many-body Hamiltonian ostida maʼlum vaqt evolyutsiyalanadi.
- Computational-basis oʻlchov ehtimollari klassik shallow classifier-ga beriladi.
Qubit nima?
Klassik bit faqat 0 yoki 1 qiymatini olsa, qubit-ning sof holati:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle, \qquad |\alpha|^2+|\beta|^2=1 \]
koʻrinishida yoziladi. \(\alpha\) va \(\beta\) kompleks probability amplitude-lardir. Oʻlchash amalga oshirilganda \(|0\rangle\) natijasi \(|\alpha|^2\), \(|1\rangle\) natijasi \(|\beta|^2\) ehtimol bilan olinadi.
Bloch sferasidan foydalanilganda ayni holat:
\[ |\psi\rangle= \cos\left(\frac{\theta}{2}\right)|0\rangle + e^{i\phi} \sin\left(\frac{\theta}{2}\right)|1\rangle \tag{4.9} \]
koʻrinishida ifodalanadi. \(\theta\) qutbiy, \(\phi\) azimut burchagidir. QELM-ning koʻplab encoding usullari klassik xususiyatlarni toʻgʻridan-toʻgʻri shu ikki burchakka joylashtiradi.
Hilbert fazosi nima uchun muhim?
\(N\) qubit-li tizimning holat fazosi:
\[ \mathcal{H}_N=(\mathbb{C}^2)^{\otimes N} \]
va oʻlchami:
\[ \dim(\mathcal{H}_N)=2^N \]
boʻladi.
Bu eksponensial oʻsish kam sonli qubit bilan yuqori oʻlchamli state representation hosil qilish mumkinligining matematik asosidir. Biroq \(2^N\) oʻlchamli state space mavjudligi avtomatik ravishda kvant ustunligini yaratmaydi; bu state-ni tayyorlash, evolyutsiyalantirish, oʻlchash va olingan axborotning tasniflash uchun haqiqatan foydali boʻlishi kerak.
Klassik xususiyatlar qubit-larga qanday kodlanadi?
Dissertatsiya klassik latent xususiyatlar qubit amplitudalariga yoki Bloch-sfera burchaklariga joylashtiriladigan beshta encoding oilasini taqqoslaydi; bu usullar qubit boshiga tashiladigan xususiyatlar soni bilan state-preparation sxema chuqurligi oʻrtasida turli murosalarni yuzaga keltiradi.
Dense-angle encoding
Dense-angle encoding har bir qubit-ga ikkita xususiyat joylashtiradi:
\[ |x\rangle = \bigotimes_{i=1}^{\lceil M/2\rceil} \left[ \cos\left(\frac{x_{2i-1}}{2}\right)|0\rangle + e^{ix_{2i}} \sin\left(\frac{x_{2i-1}}{2}\right)|1\rangle \right]. \tag{4.10} \]
Bu yerda \(x_{2i-1}\) qutbiy burchakka, \(x_{2i}\) faza burchagiga aylantiriladi. Shunday qilib bitta qubit ikkita klassik xususiyatni tashiydi.
Angle encoding
Angle encoding faqat qutbiy burchakdan foydalanadi:
\[ |x\rangle = \bigotimes_i \left[ \cos\left(\frac{x_i}{2}\right)|0\rangle+ \sin\left(\frac{x_i}{2}\right)|1\rangle \right]. \tag{4.11} \]
Har bir qubit faqat bitta xususiyatni tashiydi. Afzalligi state preparation ancha sayoz boʻlishidir; kamchiligi esa bir xil sonli xususiyatni kodlash uchun dense-angle-ga nisbatan koʻproq qubit talab qilinishi mumkinligidir.
Uniform Bloch-sphere encoding
Manba ushbu kodlashni:
\[ |x\rangle = \bigotimes_i \left[ \sqrt{x_{2i-1}}|0\rangle+ e^{ix_{2i}} \sqrt{1-x_{2i-1}}|1\rangle \right] \tag{4.12} \]
koʻrinishida beradi. Birinchi xususiyat population ogʻirligini, ikkinchi xususiyat relative phase-ni boshqaradi.
Amplitude encoding
Amplitude encoding:
\[ |x\rangle = \frac{1}{\|x\|_2} \sum_{i=0}^{2^N-1}x_i|i\rangle \tag{4.14} \]
orqali \(N\) qubit-ga nazariy jihatdan \(2^N\) ta xususiyatni joylashtira oladi. Qubit soni nuqtayi nazaridan juda ixcham koʻrinsa-da, generic amplitude state preparation chuqur va koʻp-qubitli entangling circuit-ni talab qilishi mumkin. Dissertatsiya shu sabab amplitude encoding-ning NISQ-da amalga oshirilishi angle-asosli kodlashlarga qaraganda murakkabroq ekanini taʼkidlaydi.
| Kodlash | Qubit boshiga xususiyat | Tipik sxema chuqurligi | Asosiy murosa |
|---|---|---|---|
| Angle | 1 | Past | Oddiy state preparation; koʻproq qubit talab qilinishi mumkin |
| Dense-angle | 2 | Past | Ikki Bloch parametridan foydalanadi; fazani nazorat qilish talab etiladi |
| Uniform Bloch-sphere | 2 | Past | Population va fazani birga kodlaydi |
| General | 2 | Past | Amplitudalarning bevosita normallashtirilgan parametrizatsiyasi |
| Amplitude | \(2^N\) ta jami xususiyatgacha | Yuqori | Qubit-samarali, biroq generic state preparation qimmat |
Birinchi tasvir tasniflash ishida dense-angle va uniform Bloch-sphere kodlashlari umuman olganda eng yaxshi ishlash–amalga oshirish mumkinligi muvozanatini beradi. General encoding ayniqsa qubit soni kichik boʻlganda yomonroq natija beradi. Amplitude encoding esa latent feature soni yetarlicha oshganda yaxshilanadi; biroq bir xil qubit sonida barcha 784 MNIST pikseli amplitude encoding bilan toʻgʻridan-toʻgʻri ishlatilgan holatda \(N=10-12\) uchun test accuracy taxminan 0,97 darajasida qoladi va dense-angle + compressed latent representation yondashuvidan biroz pastroq natija beradi.
QELM-da Hamiltonian nima uchun oʻqitilmaydi?
QELM-ning maqsadi kvant dinamikasini trainable variational circuit sifatida optimallashtirish emas, balki sobit fizik tizimning klassik maʼlumotlarni foydali feature space-ga aylantirish qobiliyatini oʻrganishdir; shu sabab Hamiltonian parametrlari sobit saqlanadi va oʻqitish faqat klassik output layer-da bajariladi.
Kvant state-ning vaqt evolyutsiyasi:
\[ U(t)=e^{-iHt} \tag{4.15} \]
bilan aniqlanadi. Bu yerda \(H\) Hamiltonian, \(t\) evolyutsiya vaqtidir. \(\hbar=1\) birliklaridan foydalanilganda eksponensial shakl shu tarzda yoziladi.
Kodlangan boshlangʻich holat:
\[ |\psi(t)\rangle=U(t)|\psi_0(z)\rangle \]
boʻladi.
Hamiltonianning vazifasi sinf yorligʻini “oʻrganish” emas. Uning vazifasi boshlangʻich lokal yoki past murakkablikdagi feature axborotini register boʻylab qayta taqsimlab, computational-basis measurement-da sinflarni ajratish uchun qulayroq probability representation hosil qilishdir.
Birinchi ishda nima uchun oltita turli Hamiltonian ishlatiladi?
Dissertatsiya connectivity, integrability, chaos va localization QELM ishlashida haqiqatan belgilovchi ekanini tekshirish uchun fizik jihatdan bir-biridan farq qiladigan Hamiltonian oilalaridan foydalanadi.
| Model | Tur | Asosiy maqsad |
|---|---|---|
| \(H_1\) | Periodically driven long-range Ising | Uzoq masofali kuchli aralashtiruvchi reservoir |
| \(H_2\) | Fully connected disordered transverse-field Ising | Disorder va toʻliq bogʻlangan oʻzaro taʼsirni sinash |
| \(H_3\) | Chaotic nearest-neighbour Ising | Lokal, biroq non-integrable/ergodic dinamika |
| \(H_4\) | Nearest-neighbour XXZ | Anizotrop lokal many-body dinamika |
| \(H_5\) | Integrable XX chain | Oddiy, lokal va toʻliq yechiladigan reservoir |
| \(H_6\) | Disordered long-range \(xx\) + random fields | Ergodic, non-ergodic va localized rejimlarini taqqoslash |
Long-range Ising \(H_1\)
Manbada:
\[ H_1(t)= \begin{cases} B_1\displaystyle\sum_i\sigma_x^{(i)}, & 0\le t<T_1,\\ \displaystyle\sum_{i,j}J_{ij}^{(1)}\sigma_z^{(i)}\sigma_z^{(j)}, & T_1\le t<T, \end{cases} \tag{4.16} \]
va:
\[ J_{ij}^{(1)}= \frac{J_0}{|i-j|^\alpha} \tag{4.17} \]
ishlatiladi.
Parametrlar \(J_0=0.06\), \(\alpha=1.51\), \(B_1=3.05\) va \(T=2T_1=1\) deb beriladi. Birinchi ish simulyatsiyasida bu dinamika \(\Delta t=50T\) davomida qoʻllanadi.
Integrable XX modeli \(H_5\)
XX zanjiri:
\[ H_5= \frac12 \sum_{i=1}^{N} \left( \sigma_x^{(i)}\sigma_x^{(i+1)} + \sigma_y^{(i)}\sigma_y^{(i+1)} \right) \tag{4.24} \]
va davriy chegara sharti:
\[ \sigma^{(N+1)}\equiv\sigma^{(1)} \]
bilan ishlatiladi.
XX modeli Jordan–Wigner oʻzgartirishi orqali free fermion tizimiga moslashtirilishi mumkin boʻlgan integrable modeldir. Shunga qaramay, u tasniflash uchun zarur lokal entanglement va ballistic information propagation-ni hosil qilishi mumkin. Dissertatsiyaning ikkinchi QELM ishida aynan shu model tanlanadi, chunki fizik dinamika bilan classification transition oʻrtasidagi munosabatni aniqroq oʻrganish mumkin.
Localized rejim nima uchun yomon ishlaydi?
Axborot register boʻylab tarqalmasa, turli qubit-larga kodlangan xususiyatlar measurement-dan oldin yetarlicha aralashmaydi. Non-interacting \(H_2\) limitida qubitlar mustaqil harakat qiladi. Kuchli many-body localization rejimida esa oʻzaro taʼsir mavjud boʻlsa ham boshlangʻich axborotning spatial spreading-i jiddiy ravishda bostiriladi.
Manba har ikki holatda ham high-accuracy plateau buzilishini koʻrsatadi. Bu natija “chaos majburiy” degani emas; integrable XX zanjiri ham yaxshi ishlashi mumkin. Zarur boʻlgan narsa — oʻrganilayotgan tasniflash vazifasi uchun yetarli feature redistribution.
Oʻlchash nima uchun kvant feature map-ning kritik qismidir?
Kvant state-ning oʻzi klassik classifier-ga bevosita berilmaydi; classifier faqat oʻlchash ehtimollarini koʻrgani uchun Hamiltonian eigenbasis-i va measurement basis oʻrtasidagi munosabat qaysi kvant interferensiya axboroti klassik feature-ga aylanishini belgilaydi.
Hamiltonianning spektral ajralishi:
\[ H=\sum_n E_n|E_n\rangle\langle E_n| \tag{4.29} \]
boʻlsin. Boshlangʻich holat:
\[ |\psi(0)\rangle=\sum_n c_n|E_n\rangle \tag{4.30} \]
va vaqt oʻtishi bilan:
\[ |\psi(t)\rangle= \sum_n c_ne^{-iE_nt}|E_n\rangle \tag{4.31} \]
koʻrinishida evolyutsiyalanadi.
\(|s_k\rangle\) measurement basis-dagi natija ehtimoli Born qoidasi bilan:
\[ p_k(t)=|\langle s_k|\psi(t)\rangle|^2 \tag{4.32} \]
boʻladi.
Manba buni yoyib:
\[ p_k(t)= \sum_{n,m} \langle s_k|E_n\rangle \langle E_m|s_k\rangle e^{-i(E_n-E_m)t} c_nc_m^\ast \tag{4.33} \]
ifodasini oladi.
Bu tenglama juda muhim. Measurement basis Hamiltonian eigenbasis-i bilan butunlay bir xil boʻlsa, off-diagonal interference contributions yoʻqoladi va:
\[ p_k(t)=|c_k|^2 \tag{4.34} \]
vaqt bilan oʻzgarmaydi. Bunday oʻlchash quantum dynamics-ning feature enrichment imkoniyatidan foydalana olmaydi.
Aksincha, measurement basis va energiya eigenbasis-i yetarlicha farq qilsa, \(E_n-E_m\) energiya farqlaridan keladigan interference terms probability vector-ni vaqt bilan murakkab tarzda qayta tashkil qilishi mumkin.
QELM-ning klassik chiqish qatlami
Oʻlchash probability vector-i:
\[ \mathbf{p}(t)= \left(p_s(t)\right)_{s\in\{0,1\}^N} \]
klassik feature vector sifatida ishlatiladi.
Chiqish qatlami:
\[ \mathbf{a}=W\mathbf{p}(t)+\mathbf{b} \tag{4.36} \]
logit-larni hosil qiladi va softmax:
\[ y_c= \frac{e^{a_c}} {\sum_{c'=1}^{C}e^{a_{c'}}} \tag{4.37} \]
orqali class probability-larga aylantiradi.
Categorical cross-entropy:
\[ \mathcal{L} = -\sum_{c=1}^{C}t_c\log y_c \tag{4.38} \]
minimallashtiriladi. QELM arxitekturasida trainable parametrlar \(W\) va \(b\)-dir; kvant reservoir-ning oʻzi oʻqitilmaydi.
QELM uchun koʻp chigallashuvmi yoki kerakli miqdordagi lokal chigallashuvmi zarur?
Ushbu dissertatsiyada oʻrganilgan XX-asosli QELM uchun yuqori tasniflash aniqligi global jihatdan maksimal yoki volume-law chigallashgan state-ni talab qilmaydi; aniqlik platosi qoʻshni qubit-lar orasida lokal chigallashuv paydo boʻlgan, ammo butun zanjir hali kuchli tarzda chigallashmagan \(t^\*\approx1\) rejimida yuzaga keladi.
Ikkinchi QELM ishining nazorat qilinadigan tuzilishi
Ushbu ish talqin qilishni osonlashtirish uchun arxitekturani katta darajada sobitlaydi:
- feature reduction pipeline sobit,
- encoding har doim dense-angle,
- Hamiltonian davriy chegara shartli nearest-neighbour XX zanjiri,
- measurement computational basis-da,
- oʻzgartiriladigan asosiy continuous hyperparameter faqat evolution time \(t\).
XX Hamiltoniani:
\[ H= \frac12 \sum_{i=1}^{N} \left( \sigma_x^{(i)}\sigma_x^{(i+1)} + \sigma_y^{(i)}\sigma_y^{(i+1)} \right) \tag{6.1} \]
va:
\[ |\psi_t(z)\rangle = e^{-iHt}|\psi_0(z)\rangle \tag{6.2} \]
ishlatiladi.
Uchta ishlash sohasi
MNIST, Fashion-MNIST va CIFAR-10-da accuracy–time egri chiziqlari odatda uchta sohani koʻrsatadi:
1. Qisqa vaqt: Dinamika encoded state-ni hali yetarlicha oʻzgartirmagan va accuracy past.
2. Oʻtish: \(t^\*\sim1\) atrofida training va test accuracy tez koʻtariladi.
3. Plato: \(t\gtrsim t^\*\) dan keyin accuracy dataset va \(N\)-ga bogʻliq plato qiymatiga yetadi.
Oʻtish vaqtining oʻrganilgan tizim oʻlchamlarida \(N\)-ga deyarli bogʻliq emasligi ayniqsa muhim. Agar classification uchun butun zanjirning global scrambling-i zarur boʻlganida, kerakli vaqt tizim oʻlchami bilan ortishi kutilardi.
Lokal va global entanglement vaqt masshtablari
Bir-qubit entropy tez koʻtariladi va:
\[ t=O(1) \]
masshtabida toʻyinishga yaqinlashadi. Bu har bir qubit yaqin atrofi bilan chigallashuv hosil qilishini koʻrsatadi.
Half-chain entropy esa zanjirning yarmini ikkinchi yarmidan ajratuvchi bipartition-dagi global entanglement-ni oʻlchaydi va volume-law saturation uchun:
\[ t=O(N) \]
masshtabi talab etiladi.
Classification transition \(t^\*\approx1\) birinchi vaqt masshtabiga mos keladi, ikkinchisiga emas.
Lieb–Robinson tezligi nima?
Lokal Hamiltonianlarda axborot va korrelyatsiyalarning fazoda ixtiyoriy ravishda bir zumda tarqalishiga toʻsqinlik qiluvchi samarali tezlik chegarasi mavjud. Bu xatti-harakat Lieb–Robinson bound bilan tavsiflanadi.
Dissertatsiyadagi XX modeli va ishlatilgan birliklar uchun:
\[ v_{\mathrm{LR}}=1 \]
olinadi.
Shu sabab \(t\lesssim1\) boʻlganda qubit axboroti faqat taxminan bir lattice spacing tartibidagi qoʻshnilarga kuchli yetib borishi mumkin. QELM accuracy ham shu vaqtda plato hosil qilishi classification uchun uzoq site-larning global tarzda chigallashishi shart emasligini qoʻllab-quvvatlaydi.
Haar-random unitary taqqoslanishi
Manba XX evolution-ning plateau accuracy-sini ayni encoded state-larga qoʻllanilgan Haar-distributed random unitary-lar bilan taqqoslaydi. Har bir \(N\) va dataset uchun 10 ta mustaqil Haar-random unitary namunasi ishlatiladi.
XX-QELM-ning \(t\gtrsim t^\*\) plato qiymati numerical uncertainties doirasida Haar-random unitary ishlashi bilan mos keladi. Biroq XX modeli Haar-random state darajasida global scramble boʻlmasdan ham ayni classification darajasiga yetishi mumkin.
Shallow random circuits
Analog XX dynamics shuningdek nearest-neighbour random two-qubit gates-dan foydalanadigan brickwork digital circuit bilan taqqoslanadi. Dissertatsiya atigi bir necha layer — odatda taxminan toʻrt-olti qatlam — analog XX plateau-siga juda yaqin accuracy bera olishini bildiradi.
Bu natija effective circuit depth \(N\) bilan ortmasligi va relevant dynamics shallow boʻlib qolishi haqidagi talqinni kuchaytiradi.
Nima uchun bu natija kuchli kvant ustunligi emas?
Bir oʻlchamli, qisqa chuqurlikdagi va lokal chigallashuv cheklangan kvant sxemalarini Matrix Product State kabi tensor-network usullari bilan koʻp hollarda samarali simulyatsiya qilish mumkin. Dissertatsiya classification uchun foydali deb topgan \(t^\*\) rejimi aynan shu tuzilishga yaqin.
Shu sabab manba natijasi “kvant feature map foydasiz” degani emas. Natija yanada nozik: kvant dinamikasi sinflarni yaxshiroq ajratiladigan feature geometry-ga koʻchirishi mumkin; biroq oʻrganilgan vazifalarda bu sodir boʻladigan dinamik rejim hali ham klassik usulda erishish mumkin boʻlishi mumkin.
Probability polytope nimani anglatadi?
Har bir input sample uchun QELM oʻlchovi:
\[ p_t(s|z)=|\langle s|\psi_t(z)\rangle|^2 \tag{6.7} \]
ehtimollarini beradi.
Barcha \(2^N\) bit-string ehtimoli:
\[ \mathbf{p}_t(z) = \left( p_t(s_1|z),\ldots,p_t(s_{2^N}|z) \right) \tag{6.6} \]
probability simplex ichida joylashadi:
\[ \Delta_{2^N-1} = \left\{ \mathbf{p}\in\mathbb{R}^{2^N} \;\middle|\; p_i\ge0,\; \sum_i p_i=1 \right\}. \tag{6.8} \]
Dissertatsiya ushbu sample cloud-ni “probability polytope” deb ataydi.
K-means inertia:
\[ I= \sum_{k=1}^{K} \sum_{x_j\in C_k} \|x_j-\mu_k\|_2^2 \tag{6.9} \]
bilan cluster compactness oʻlchanadi. \(I\) kamaygani sari cluster-lar centroid atrofida zichroq toʻplanadi.
Ish QELM accuracy transition vaqtida probability-space cluster-lar class labels bilan koʻproq moslashishini, aksincha bir-site local observables vaqt oʻtishi bilan sinf axborotini yoʻqotishi mumkinligini koʻrsatadi. Yaʼni axborot yoʻqolmaydi; local observables-dan global correlation structure-ga koʻchadi.
Neytrino nima uchun bevosita tasvirlanmaydi va Cherenkov halqalari qanday hosil boʻladi?
Suv Cherenkov detektorida neytrino bevosita yorugʻlik chiqarmaydi; neytrino oʻzaro taʼsiri hosil qilgan elektr zaryadli zarrachalar suvda yorugʻlikning faza tezligidan tezroq harakat qilganda konussimon Cherenkov nurlanishini chiqaradi va ushbu konusning detektor yuzasi bilan kesishishi PMT-larda halqasimon tasvirlarni hosil qiladi.
Cherenkov sharti
Zarracha suvda Cherenkov nurlanishini hosil qilishi uchun:
\[ v>\frac{c}{n} \]
boʻlishi kerak.
Bu yerda \(v\) zarracha tezligi, \(c\) vakuumdagi yorugʻlik tezligi, \(n\) muhitning refractive index qiymatidir.
Cherenkov burchagi:
\[ \cos\theta_C= \frac{1}{\beta n}, \qquad \beta=\frac{v}{c} \]
munosabati bilan beriladi.
Suv uchun optik sohada taxminan \(n\approx1.33\) va juda relativistik \(\beta\rightarrow1\) zarrachalar uchun maksimal burchak taxminan \(42^\circ\)-dir.
PMT-larda koʻrinadigan halqa nafaqat zarrachaning mavjudligini, balki direction, vertex position, propagation length va light timing kabi hodisa geometriyasiga oid axborotni ham tashiydi.
Single-vertex va pile-up nima uchun chalkashishi mumkin?
Single-vertex hodisa bitta neutrino interaction vertex-ni oʻz ichiga oladi, biroq ushbu interaction bir nechta charged particle hosil qilishi mumkin. Shuning uchun bitta-vertex hodisada ham bir nechta Cherenkov ring koʻrinishi mumkin.
Pile-up hodisasida esa ayni detector readout window ichida ikki yoki undan ortiq mustaqil interaction yuz beradi. Bir nechta vertex halqalari bir-birining ustiga tushishi mumkin.
Shu sabab “bir ring = single vertex, koʻp ring = pile-up” kabi oddiy qoida amal qilmaydi. Model spatial va temporal structure-ni birgalikda oʻrganishi kerak.
Charge va timing nima uchun bir-birini toʻldiradi?
Charge, PMT-ga yetib keladigan yorugʻlik miqdori bilan bogʻliq boʻlib, event morphology/brightness axborotini tashiydi.
Timing, fotonlarning sensorga qachon yetib kelishini koʻrsatadi va vertex geometry, particle propagation hamda turli interactions-ning temporal separation-iga sezgir.
Dissertatsiya natijalarida timing-only representation charge-only representation-dan yaxshiroq classification berishi pile-up muammosining kuchli temporal component-ga ega ekanini tasdiqlaydi.
IWCD tasviri sunʼiy neyron tarmogʻiga qanday aylantiriladi?
Silindrsimon IWCD yuzasi \((\phi,z)\) koordinatalarida yoyilib, har bir multi-PMT moduli bitta pikselga aylantiriladigan 29×40 tasvir hosil qilinadi; har bir pikseldagi 19 PMT-ning charge va timing qiymatlari alohida kanallar yoki umumlashtiruvchi statistikalar sifatida neyron tarmogʻiga beriladi.
Simulyatsiya zanjiri
Detector response WCSim yordamida simulyatsiya qilinadi. No-Physics dataset-da neutrino–nucleus interaction generator ishlatilmasdan final-state particle tracks bevosita yaratiladi. Maqsad classifier generator-specific tafsilotlarni emas, single-vertex/pile-up topologiyasini oʻrganishini taʼminlashdir.
No-Physics maʼlumotlar toʻplamida:
- electron, muon, \(\pi^0\) va \(\pi^-\) ishlatiladi,
- track yoʻnalishlari isotropic namuna olinadi,
- umumiy visible energy koʻpi bilan 2000 MeV,
- single-vertex va pile-up nisbati teng,
- 5 million hodisa training uchun,
- 1 million mustaqil hodisa test uchun ishlatiladi.
GENIE va NEUT maʼlumotlar toʻplamlari realistik neutrino–nucleus interaction generator-lardan foydalanadi. Har biri 1 million hodisani oʻz ichiga oladi va taxminan %32 single-vertex, %68 pile-up kompozitsiyasiga ega. Ushbu toʻplamlar realistic generalization testlari sifatida ishlatiladi.
29×40 piksel nima uchun 38 kanalgacha yetadi?
Har bir multi-PMT moduli bitta image pixel-dir. Bitta modulda 19 PMT boʻlgani uchun har bir PMT uchun:
19 charge channel + 19 timing channel = 38 channel
olinadi.
Manbaning notation-i:
| Belgilash | Mazmun |
|---|---|
| 19Q | 19 ta alohida charge kanali |
| 19T | 19 ta alohida timing kanali |
| 19Q+19T | 38 ta toʻliq kanal |
| 2Q | 19 charge qiymatining mean + standard deviation xulosasi |
| 2T | 19 timing qiymatining mean + standard deviation xulosasi |
| 2Q+2T | Charge va timing uchun toʻrtta umumlashtiruvchi kanal |
Double-cover nima uchun kerak?
Silindrsimon yuza tekis toʻrtburchakka yoyilganda \(\phi=0\) va \(\phi=2\pi\) fizik jihatdan qoʻshni boʻlsa ham, tasvirning chap va oʻng chetlariga ajraladi. Standart convolution bu ikki chetni uzoq nuqtalar deb qabul qilishi mumkin.
Double-cover construction tasvirning tegishli qismlarini koʻpaytirib va qayta tartiblab periodic cylindrical boundary-ni CNN uchun fizik jihatdan toʻgʻriroq ifodalaydi.
ResNet-18 arxitekturasi
Dissertatsiya standart ResNet-18-ning residual tuzilishini saqlaydi, biroq detector images ichidagi nozik spatial axborotni saqlash maqsadida kirish stem-ini moslashtiradi.
Toʻrtta residual stage:
| Bosqich | Chiqish kanali | Residual block | Birinchi block stride |
|---|---|---|---|
| Layer 1 | 64 | 2 | 1 |
| Layer 2 | 128 | 2 | 2 |
| Layer 3 | 256 | 2 | 2 |
| Layer 4 | 512 | 2 | 2 |
Residual block-ning asosiy amali:
\[ y=F(x,W)+x \]
koʻrinishidadir. Shortcut connection oʻrganiladigan mapping-ni toʻliq noldan hosil qilish oʻrniga residual oʻzgarishni oʻrganishni osonlashtiradi va chuqur tarmoqlarda gradient flow-ni qoʻllab-quvvatlaydi.
Stage oxirida adaptive average pooling har bir feature map-ni 1×1 qiymatgacha kamaytiradi. 512-dimensional vector flatten qilinadi va fully connected output layer-ga beriladi.
ResNet oʻqitish parametrlari
| Parametr | Qiymat |
|---|---|
| Optimizer | Adam |
| Learning rate | 0,01 |
| Epoch | 20 |
| Batch size | 512 |
| Vazifa | Ikki sinfli classification |
| Loss | Cross-entropy |
| Training augmentation | Qoʻllanadi |
| Validation / test augmentation | Qoʻllanmaydi |
Tadqiqot Usuli va Natijalari
Birinchi QELM tasvir tasniflash tadqiqotida qaysi komponent haqiqatan ham hal qiluvchi bo‘ldi?
Birinchi tadqiqotda eng kuchli ta’sirlar feature reduction va encoding tanlovidan kelib chiqadi; nonlinear convolutional autoencoder’lar PCA’ga qaraganda yaxshiroq latent representation hosil qilsa, dense-angle va uniform Bloch-sphere encoding ikki xususiyat/qubitdan foydalanib yuqori samaradorlik bilan nisbatan sayoz state preparation o‘rtasida yaxshi muvozanat ta’minlaydi.
Ma’lumotlar to‘plamlari va oldindan ishlov berish
Birinchi QELM tadqiqotida MNIST va Fashion-MNIST 28×28 grayscale tasvirlaridan foydalaniladi. Piksel qiymatlari 255 ga bo‘linib [0,1] oralig‘iga normallashtiriladi. Qo‘shimcha denoising yoki data augmentation qo‘llanmaydi.
PCA ishlatilganda 28×28 tasvir 784-dimensional vektorga flatten qilinadi va dastlabki \(d\) principal component’ga project qilinadi.
Autoencoder ishlatilganda tabiiy 28×28 tensor encoder’ga kiradi va faqat \(d\)-o‘lchamli bottleneck vector saqlanadi.
Baseline configuration:
| Komponent | Referens tanlov |
|---|---|
| Feature reduction | Autoencoder AE1 |
| Encoding | Dense-angle |
| Hamiltonian | Periodically driven long-range \(H_1\) |
| Classical readout | Feed-forward neural network |
| Eng katta qubit soni | \(N=12\) |
\(N=12\), ushbu tadqiqotda full quantum dynamics’ni classical simulation qilish nuqtai nazaridan amaliy chegara sifatida ko‘rsatiladi. Bu chegara haqiqiy quantum hardware’ning maksimal qubit soni emas.
PCA va autoencoder natijasi
AE1 va AE2 convolutional autoencoder’lari PCA’ga qaraganda yaxshiroq classification accuracy beradi. Kattaroq AE1 pastroq reconstruction error va yaxshiroq latent representation hosil qiladi; buning evaziga ko‘proq trainable parameter va training cost talab etadi.
Manba bu natijani ayniqsa kuchli siqish rejimida talqin qiladi: quantum layer’ga faqat oz sonli feature yuborish mumkin bo‘lganda, qaysi ma’lumotning saqlanishi yakuniy classification muvaffaqiyatiga jiddiy ta’sir qiladi.
Encoding natijasi
Dense-angle va uniform Bloch-sphere, training va test nuqtai nazaridan eng kuchli single-qubit encoding usullari qatoriga kiradi. Simple angle bir xususiyat/qubitdan foydalangani uchun ayni \(N\) da kamroq classical information tashiydi.
Amplitude encoding’ning afzalligi \(2^N\) tagacha xususiyatni compact state representation ko‘rinishida bera olishidir; kamchiligi esa generic state preparation’ning experimentally demanding bo‘lishidir.
Hamiltonian natijasi
Ko‘rib chiqilgan interaction Hamiltonian’larning aksariyati \(N\) ortgani sari bir-biriga juda yaqin performance beradi va taxminan \(N\simeq10\) atrofida platoga chiqadi.
Bu natija integrability yoki chaos ahamiyatsiz ekanini universal tarzda isbotlamaydi. Tadqiqotning torroq xulosasi shuki: sinovdan o‘tkazilgan image-classification muammolari va system-size oralig‘ida, ma’lumot sufficiently spread qilingan ekan, Hamiltonian’ning microscopic details’i accuracy’ga cheklangan darajada ta’sir qiladi.
Non-interacting yoki strongly localized dynamics esa sezilarli darajada yomonroq natija beradi.
Classical baseline chegarasi
Birinchi tadqiqot QELM’ni original 784 pixels bilan oziqlantiriladigan single-layer neural network va AE1 latent features bilan oziqlantiriladigan klassik output network kabi baselines bilan taqqoslaydi. Yuqoriroq \(N\) qiymatlarida QELM ushbu baselines’dan yuqoriroq natija ko‘rsatishi mumkin.
Biroq bundan “QELM barcha klassik mashinaviy o‘rganish modellaridan ustun” degan xulosa chiqarib bo‘lmaydi. Taqqoslash muayyan shallow baselines bilan bajarilgan; u kuchliroq zamonaviy classical models’larning barchasini qamrab oladigan benchmark emas.
Ikkinchi QELM tadqiqoti nega kvant ustunligi haqidagi da’voni cheklaydi?
Chunki eng yuqori classification performance global volume-law chigallashuv hosil bo‘lishidan oldin, qisqa vaqtli va mahalliy chigallashuv ustun bo‘lgan sobit chuqurlikdagi rejimda yuzaga keladi; bu rejim tensor-network va shallow random-circuit yondashuvlari bilan klassik tarzda hamon erishish mumkin bo‘lgan holatda qoladi.
Asosiy natijalar:
| Topilma elementi | Manba natijasi | Talqin |
|---|---|---|
| Accuracy transition | \(t^\*\sim1\) | Ko‘rib chiqilgan \(N\) qiymatlariga katta darajada bog‘liq emas |
| Local entanglement | \(t=O(1)\) | Classification transition bilan bir xil masshtab |
| Half-chain volume-law saturation | \(t=O(N)\) | High accuracy uchun zarur emas |
| Lieb–Robinson velocity | \(v_{\mathrm{LR}}=1\) | \(t\sim1\) da ma’lumot faqat yaqin atrofga tarqalgan |
| Haar-random comparison | Plateau accuracy numerical uncertainties doirasida mos keladi | XX dynamics random-like useful representation hosil qilishi mumkin |
| Digital random circuits | Odatda 4–6 layer platoga yaqinlasha oladi | Sayoz dinamika yetarli bo‘lishi mumkin |
| Classical simulability | Tensor-network bilan mos rejim | Generic strong quantum advantage isboti yo‘q |
Tezisning ushbu bo‘limi qo‘llab-quvvatlaydigan talqin
Kvant dinamikasi classical data’ning representation geometry’sini foydali tarzda o‘zgartirishi mumkin. Entanglement bu o‘zgarishda rol o‘ynaydi. Biroq “foydali entanglement” bilan “maksimal/global entanglement” bir xil narsa emas.
Tezisning ushbu bo‘limi qo‘llab-quvvatlamaydigan talqin
Bu natijalardan fault-tolerant quantum computer advantage, exponential speedup yoki classical algorithms uchun intractability xulosasi chiqarib bo‘lmaydi. Aksincha, ko‘rib chiqilgan rejim classical tractability bilan mos keladi.
ResNet-18 neytrino hodisalarini qanchalik yaxshi ajratdi?
Charge va timing ma’lumotlari birgalikda ishlatilgan to‘liq 19Q+19T representation No-Physics dataset’da AUC 0,987 va GENIE dataset’da AUC 0,990 beradi; timing-only representation charge-only’dan yaxshiroq natija ko‘rsatgan holda, 2Q+2T compact representation ham to‘liq kanal kiritishiga juda yaqin qoladi.
| Konfiguratsiya | Loss | Accuracy | F1 | AUC |
|---|---|---|---|---|
| 19Q + 19T | 0,128 | 0,954 | 0,953 | 0,987 |
| 2Q + 2T | 0,136 | 0,951 | 0,950 | 0,986 |
| 19T | 0,142 | 0,949 | 0,948 | 0,985 |
| 19Q | 0,212 | 0,916 | 0,913 | 0,970 |
| Konfiguratsiya | Loss | Accuracy | F1 | AUC |
|---|---|---|---|---|
| 19Q + 19T | 0,114 | 0,954 | 0,966 | 0,990 |
| 2Q + 2T | 0,126 | 0,950 | 0,963 | 0,987 |
| 19T | 0,126 | 0,950 | 0,963 | 0,988 |
| 19Q | 0,180 | 0,924 | 0,943 | 0,976 |
Bu natijalarda timing information’ning kuchli bo‘lishi fizik jihatdan mazmunlidir. Pile-up hodisalarining asosiy xususiyati faqat spatial overlap emas, balki ayni readout window’da turli vaqtlarda sodir bo‘lishi mumkin bo‘lgan mustaqil interactions’dir.
Event vertices fazoviy va vaqt jihatdan bir-biriga yaqinlashgani sari classification qiyinlashadi. Detector boundaries yaqinidagi events ham qisman kesilgan light patterns sababli qiyinroq tasniflanadi.
No-Physics’da o‘rgatilgan modelning GENIE va NEUT kabi realistikroq interaction generators’da o‘xshash ROC xatti-harakatini ko‘rsatishi classifier faqat bitta generator’ning sun’iy xususiyatlarini yodlab olmaganini qo‘llab-quvvatlaydi. Shunga qaramay, bularning barchasi simulated detector datasets’dir; haqiqiy experimental IWCD data’da yakuniy amaliy tasdiqlash bu tezisda bajarilmagan.
QELM realistik neytrino tasvirlariga ko‘chirilishi mumkin bo‘ldimi?
Ha, ammo faqat dastlabki proof-of-concept darajasida: 60.000 ta muvozanatlangan NEUT hodisasi 20 PCA xususiyatiga siqilib, 10-qubit QELM’ga uzatilgan va random guessing’dan yuqori ajratish natijasi olingan; natija to‘liq tasvirdan foydalanadigan ResNet-18’dan ancha past qolgan.
QELM neytrino qurilmasi
Uchta 20-dimensional input ishlatilgan:
Charge only: 20 charge feature.
Time only: 20 timing feature.
Time + charge: 10 timing + 10 charge feature.
Dimensionality reduction PCA bilan bajariladi. 20-dimensional vector 10-qubit Bloch-sphere encoding’ga aylantiriladi. XX-type Hamiltonian ostida evolyutsiya qiladi. Measurement probability vector bitta sigmoid readout’ga beriladi.
| Kirish | Train AUC | Train Accuracy | Train F1 | Test AUC | Test Accuracy | Test F1 |
|---|---|---|---|---|---|---|
| Charge only | 0,6600 | 0,6159 | 0,6058 | 0,6558 | 0,6110 | 0,6049 |
| Time only | 0,6560 | 0,6131 | 0,6215 | 0,6482 | 0,6112 | 0,6241 |
| Time + charge | 0,6659 | 0,6227 | 0,6288 | 0,6575 | 0,6187 | 0,6286 |
Class-wise recall:
| Kirish | Recall class 0 | Recall class 1 |
|---|---|---|
| Charge only | 0,629 | 0,593 |
| Time only | 0,580 | 0,642 |
| Time + charge | 0,595 | 0,642 |
Train va test qiymatlarining bir-biriga yaqin bo‘lishi ushbu qurilmada kuchli overfitting kuzatilmaganini anglatadi. Ammo absolute classification performance cheklangan.
Nega ResNet bilan QELM’ni to‘g‘ridan-to‘g‘ri adolatli taqqoslash emas?
ResNet to‘liq 29×40 spatial structure va o‘nlab channel’ni convolution orqali ishlata oladi. QELM sinovida tasvir faqat 20 PCA feature’ga siqilgan. Spatial topology, local pixel correlations va ko‘plab tafsilotlar quantum encoding’ga yetib bormasdan yo‘qoladi.
Bundan tashqari, QELM 60.000 hodisalik muvozanatlangan subset’dan foydalansa, ResNet baholash zanjiri millionlab hodisalarni o‘z ichiga olgan kattaroq ma’lumotlar to‘plamlari bilan ishlaydi.
Shu sababli manba QELM natijasi uchun raqobatbardosh benchmark da’vosini qilmaydi.
Kelgusi tadqiqot yo‘nalishlari
Tezis neytrino-QELM yo‘nalishida PCA o‘rniga convolutional autoencoder ishlatish, qubit sonini oshirish va faqat classification accuracy emas, training/inference time hamda total computational cost’ni ham taqqoslash kerakligini bildiradi.
Kvant tomonida more scalable architectures, muqobil encoding usullari va haqiqiy NISQ hardware qo‘llanmalari kelgusi tadqiqot sohalaridir.
Neytrino deep-learning tomonida simulation–real-data farqlari, systematic uncertainties, detector effects, robustness va interpretability yanada chuqurroq tasdiqlashni talab qiladi.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
Tezis klassik image compression bilan sobit kvant feature generation birgalikda qo‘llanadigan QELM’lar supervised image classification uchun funksional ekanini ko‘rsatadi.
Strongly compressed input rejimida nonlinear autoencoder representation, PCA’ga nisbatan yaxshiroq classification feature’larini ta’minlashi mumkin.
Dense-angle va uniform Bloch-sphere encoding, ko‘rib chiqilgan sharoitlarda performance bilan implementation complexity o‘rtasida kuchli muvozanatni ta’minlaydi.
Turli interacting Hamiltonian’larning ko‘pi ayni vazifa uchun yetarli information spreading ta’minlaganda bir-biriga yaqin accuracy hosil qilishi mumkin; non-interacting va localized dynamics pastroq natija beradi.
XX-QELM’da classification transition global scrambling’dan oldin, local entanglement hosil bo‘lishi bilan bir xil vaqt masshtabida sodir bo‘ladi.
Bu yuqori-performance rejim shallow local circuits va tensor-network simulability bilan mos keladi.
ResNet-18, IWCD’ga o‘xshash simulated Cherenkov images’da single-vertex/pile-up discrimination uchun yuqori samaradorlik ko‘rsatadi.
Timing information, ko‘rib chiqilgan hodisalarni ajratishda charge information’dan kuchliroq discriminative content tashiydi.
QELM realistik NEUT event images’ga kuchli compression’dan keyin proof-of-concept sifatida ko‘chirilgan.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
Tezis QELM uchun umumiy computational quantum advantage’ni isbotlamaydi.
Tezis quantum hardware’da exponential speedup ko‘rsatmaydi.
Tezis “ko‘proq entanglement har doim yaxshiroq classification beradi” degan xulosani qo‘llab-quvvatlamaydi.
MNIST/Fashion-MNIST/CIFAR-10 natijalarini barcha machine-learning vazifalariga avtomatik tarzda umumlashtirib bo‘lmaydi.
ResNet natijalari haqiqiy IWCD detector data’da yakuniy experimental performance emas; asosiy baholashlar simulated datasets’ga tayanadi.
QELM neutrino natijasi ResNet’dan ustun yoki unga teng performance beradigan natija emas.
GENIE va NEUT’da yaxshi generalization haqiqiy detector systematic uncertainties to‘liq hal qilinganini ko‘rsatmaydi.
Tezisdagi QELM simulation natijalari NISQ noise, gate error, readout error va haqiqiy quantum-device calibration muammolarining barchasini eksperimental tarzda tasdiqlamaydi.
Manba va Usul Haqida Izoh
Asl sarlavha: MACHINE LEARNING DEVELOPMENT FOR QUANTUM COMPUTING AND NEUTRINO PHYSICS
Muallif: Annalisa De Lorenzis.
Tadqiqot turi: Doctoral thesis / doktorlik dissertatsiyasi.
Sohalar: Quantum machine learning, quantum computing, machine learning, neutrino physics, water Cherenkov detector data analysis.
Daraja: Doctor of Physics.
Daraja bergan muassasa: Universitat Autònoma de Barcelona (UAB), Department of Physics. Bu ma’lumot UAB’ning rasmiy institutsional tezis qaydi bilan tasdiqlangan.
Ilmiy rahbarlar: M. Pilar Casado Lechuga; Thorsten Lux; Arnau Riera Graells.
Tutor: M. Pilar Casado Lechuga.
PDF muqova sanasi: 29 may 2026.
Rasmiy daraja sanasi: UAB institutsional tezis qaydiga ko‘ra 10 iyul 2026.
ArXiv yuborilgan sana: 15 iyul 2026.
ArXiv qaydi: arXiv:2607.13699v1 [quant-ph].
Repository DOI: 10.48550/arXiv.2607.13699.
Rasmiy qaydlar: arXiv:2607.13699 va UAB institutsional tezis qaydi, Handle 10803/698010.
Taqriz holati: Tezisning o‘zi doktorlik dissertatsiyasi va arXiv tezis/preprint qaydidir; jurnal maqolasi emas. Biroq tezisdagi asosiy QELM natijalarining muhim qismi ikki alohida taqrizdan o‘tgan Physical Review Applied maqolasida chop etilgan.
Tezisda keltirilgan asosiy nashr 1: Annalisa De Lorenzis, M. P. Casado, M. P. Estarellas, N. Lo Gullo, T. Lux, F. Plastina, A. Riera, J. Settino, “Harnessing Quantum Extreme Learning Machines for Image Classification,” Physical Review Applied 23, 044024, aprel 2025.
Tezisda keltirilgan asosiy nashr 2: Annalisa De Lorenzis, M. P. Casado, N. Lo Gullo, T. Lux, F. Plastina, A. Riera, “Entanglement and Classical Simulability in Quantum Extreme Learning Machines,” Physical Review Applied 25, 054052, may 2026.
Manba ichidagi nashr holati izohi: Tezisning dastlabki sahifalari ikkinchi maqolani Physical Review Applied 25, 054052, may 2026 da chop etilgan deb ko‘rsatgan bo‘lsa, 6-bobning dastlabki matnida “currently under review” kabi eskiroq ibora saqlanib qolgan; 6-bob oxirida esa ish accepted/published holatiga mos ravishda ko‘rib chiqiladi. Bu tahririy vaqt tafovuti ilmiy natijalarni o‘zgartirmaydi.
Litsenziya: arXiv qaydi non-exclusive distribution license ostida ko‘rinadi. CC BY litsenziyasi faraz qilinmagan. Manbada mualliflik huquqi bilan himoyalangan Physical Review Applied figuralari mavjud bo‘lgani sababli Verianla HTML’ida bu shakllar aynan ko‘chirilmagan, faqat ilmiy munosabatlar original inline SVG yordamida qayta qurilgan.
Moliyalashtirish / qo‘llab-quvvatlash: Tezisda alohida formal funding statement bo‘lmasa-da, acknowledgements bo‘limida Qilimanjaro Quantum Tech va AGAUR’ga doktorlik jarayonidagi qo‘llab-quvvatlashi uchun minnatdorlik bildiriladi.
Dasturiy ta’minot va hisoblash: QELM tadqiqotlari klassik tarzda simulated quantum dynamics’dan foydalanadi. Neutrino detector response WCSim bilan yaratilgan; image-analysis pipeline WatChMaL framework’i bilan bog‘langan; ResNet treningi PyTorch cross-entropy/Adam tartibida bajarilgan. QELM klassik readout bo‘limlarida Keras/Adam ishlatilishi ko‘rsatiladi.
Ma’lumot manbalari: MNIST, Fashion-MNIST, CIFAR-10; WCSim bilan yaratilgan No-Physics, GENIE va NEUT asosidagi IWCD simulations.
Asosiy QELM cheklovi: Full-state simulation qubit sonini cheklaydi; birinchi tadqiqotda \(N=12\) practical classical-simulation limit sifatida ishlatilgan. Haqiqiy NISQ hardware’da keng qamrovli hardware-error benchmark bajarilmagan.
Asosiy quantum-advantage chegarasi: XX-QELM’ning high-accuracy rejimi local entanglement va shallow effective circuit depth bilan bog‘liq hamda efficient classical tensor-network simulation bilan mos keladi. Bu natija kuchli generic quantum advantage da’vosini qo‘llab-quvvatlamaydi.
Asosiy neytrino cheklovi: ResNet baholashlari realistic, ammo simulated detector datasets’ga tayanadi. Systematic detector uncertainties va simulation-to-real-data discrepancies haqiqiy tajriba qo‘llanmasida alohida ko‘rib chiqilishi kerak.
QELM–ResNet taqqoslash chegarasi: Neutrino QELM 60.000 NEUT event va 20 PCA feature’dan foydalanganda, ResNet to‘liq multi-channel images va ancha katta ma’lumotlar to‘plamlaridan foydalanadi. Ularning samaradorligini teng input sharoitlaridagi head-to-head benchmark sifatida talqin qilmaslik kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan