


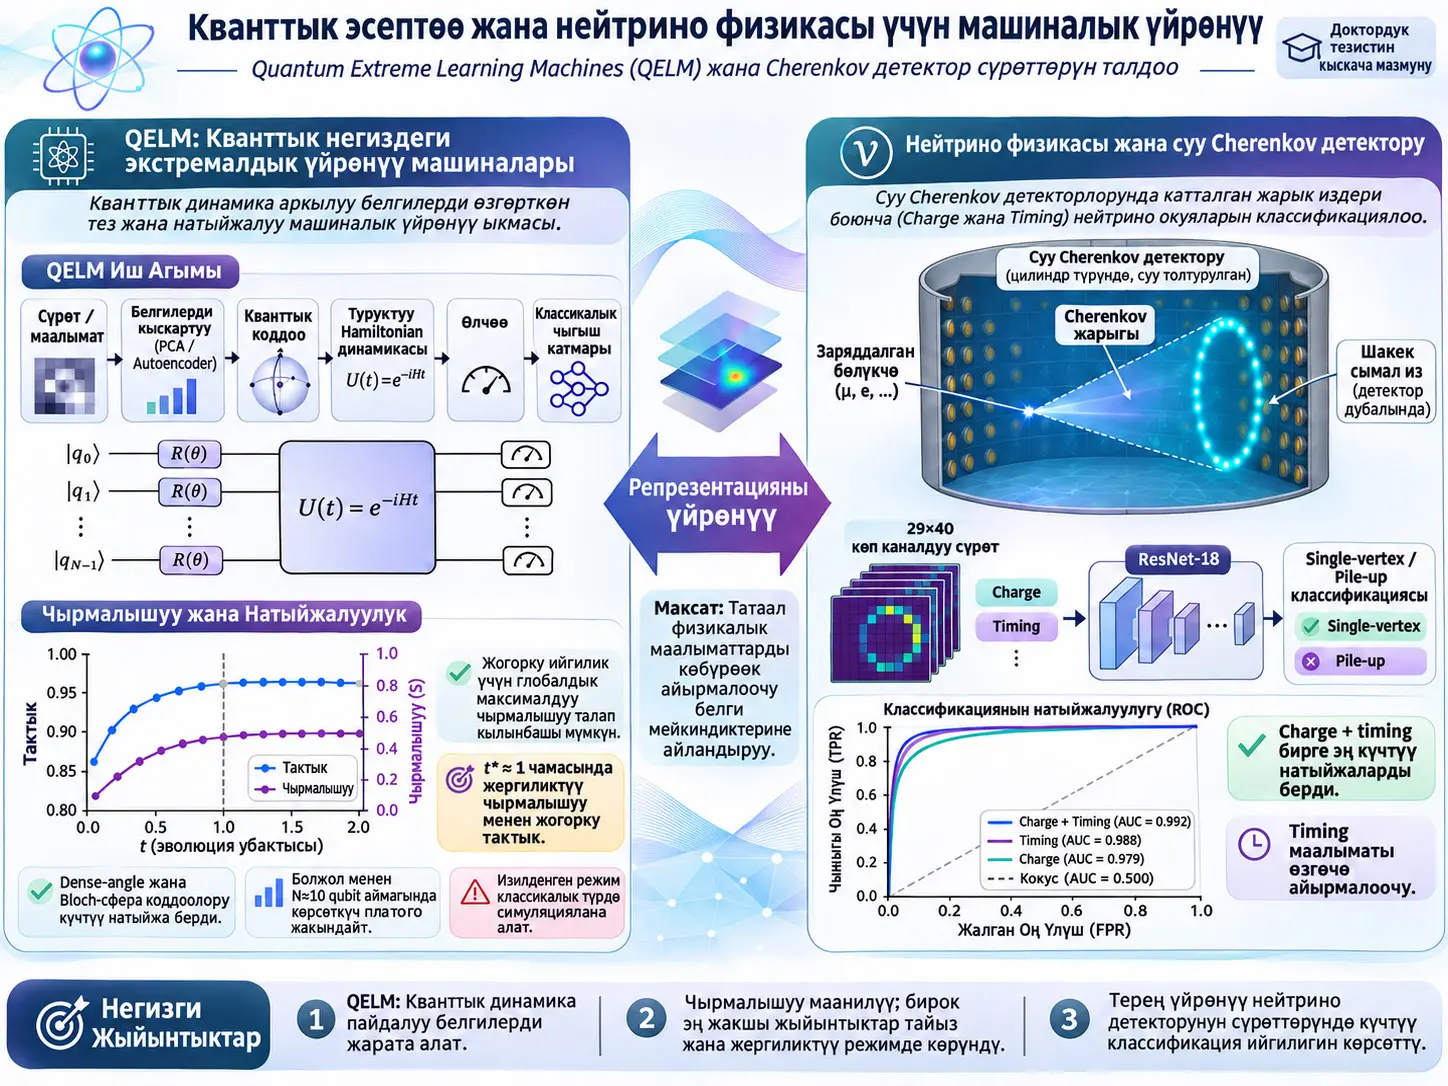
Quantum Extreme Learning Machine (QELM) — классикалык маалыматты кванттык абалга коддогон, маалыматты үйрөтүлбөгөн туруктуу кванттык динамика аркылуу өзгөрткөн жана акыркы классикалык окуу катмарын гана үйрөткөн гибриддик кванттык–классикалык машиналык үйрөнүү архитектурасы. Бул доктордук диссертация жогорку өлчөмдүү физикалык маалыматтардан натыйжалуу өкүлчүлүк түзүү маселесин эки башка багытта изилдейт. Биринчи изилдөө багыты QELMдер сүрөттөрдү классификациялоодо кандай иштей турганын, маалыматты кысуу ыкмасы, кванттык коддоо, Гамильтониан динамикасы, өлчөө, чырмалышуу жана классикалык симуляциялануучулук натыйжалуулукка кандай таасир этерин изилдейт. Экинчи изилдөө багыты болсо суу Черенков нейтрино детекторлорунда пайда болгон charge жана timing сүрөттөрүн ResNet-18 менен талдап, бир өз ара аракеттенүү чекити бар окуяларды ошол эле окуу терезесинде бир нече өз ара аракеттенүү үстү-үстүнө түшкөн pile-up окуяларынан айырмалоону изилдейт.
QELM боюнча биринчи изилдөө MNIST жана Fashion-MNIST сүрөттөрүн алгач Principal Component Analysis (PCA) же convolutional autoencoder аркылуу төмөн өлчөмдүү latent векторлорго кысат. Бул белгилер angle, dense-angle, uniform Bloch-sphere, general же amplitude encoding колдонуу менен qubit абалдарына айландырылат. Андан кийин туруктуу many-body Hamiltonian астында унитардык убакыт эволюциясы колдонулат. Computational-basis өлчөөсүнөн алынган ыктымалдык векторун классикалык shallow output neural network гана үйрөнөт. Натыйжалар күчтүү кысуу шартында nonlinear autoencoder өкүлчүлүктөрү PCAга караганда натыйжалуураак экенин жана эки белги/qubit колдонгон dense-angle менен uniform Bloch-sphere коддоолору натыйжалуулук–ишке ашыруу мүмкүнчүлүгү жагынан өзгөчө жакшы тең салмак камсыз кыларын көрсөтөт.
Биринчи QELM изилдөөсүндө qubit саны көбөйгөн сайын классификациянын тактыгы тездик менен жогорулап, болжол менен \(N\simeq10\) чамасында платого өтүү тенденциясын көрсөтөт. Өз ара аракеттенүүчү Гамильтониандар жетиштүү маалымат таралышын түзгөн шартта моделдин натыйжалуулугу Гамильтониандын микроскопиялык деталдарына таң каларлыктай аз сезгич болот. Тескерисинче, qubitтер өз алдынча калган non-interacting учурларда же күчтүү localization себептүү маалымат register боюнча тарай албаган режимдерде натыйжалуулук олуттуу төмөндөйт. Бул натыйжа QELM үчүн керектүү нерсе өзгөчө бир “керемет Гамильтониан” эмес, коддолгон маалыматты өлчөө мейкиндигинде кайра уюштура алган жетиштүү өз ара аракеттенүүчү кванттык динамика экенин колдойт.
Диссертациянын экинчи QELM изилдөөсү андан да фундаменталдуу суроого кайрылат: жогорку классификация ийгилигине жетүү үчүн канчалык кванттык чырмалышуу керек жана бул режимди классикалык компьютерде дагы эле натыйжалуу симуляциялоого болобу? Dense-angle encoding жана периоддук чек ара шарты бар nearest-neighbour XX Гамильтонианы туруктуу кармалат; эволюция убактысы \(t\) гана өзгөртүлөт. MNIST, Fashion-MNIST жана CIFAR-10 үчүн тактык кыска убакыттарда төмөн бойдон калат, болжол менен \(t^\*\sim1\) чамасында тез өсүп, андан соң платого чыгат.
Эң маанилүү кванттык натыйжа — бул өтүү бүтүндөй системада volume-law чырмалышуусу пайда болгонго чейин ишке ашат. Бир-qubit энтропиялары \(t=O(1)\) масштабында тез өссө, half-chain entropyнин global saturationга жетиши үчүн \(t=O(N)\) убакыт талап кылынат. XX чынжыры үчүн колдонулган бирдиктерде Lieb–Robinson ылдамдыгы \(v_{\mathrm{LR}}=1\) болгондуктан, \(t^\*\sim1\) маалында маалымат бир нече коңшу siteке гана тараган болот. Ошого карабастан QELM классификациясынын тактыгы буга чейин эле плато маанисине жетет.
Бул табылга “көбүрөөк чырмалышуу ар дайым жакшыраак машиналык үйрөнүүнү билдирет” деген пикирди колдобойт. Диссертациянын жыйынтыгына ылайык, каралган тапшырмаларда пайдалуу feature generation үчүн күчтүү жергиликтүү чырмалышуу жетиштүү; бүт чынжырдын глобалдык түрдө scramble болушу талап кылынбайт. Мындан тышкары, бул кыска-убакыттык динамиканы туруктуу тереңдиктеги жергиликтүү схемалар менен болжолдуу ишке ашырууга болот жана Matrix Product State сыяктуу tensor-network ыкмалары үчүн дагы эле жеткиликтүү режимде калат. Ошондуктан диссертация жалпы же күчтүү кванттык эсептөө артыкчылыгын көрсөтпөйт.
Нейтрино бөлүмүндөгү негизги физикалык маселе башкача. Нейтрино детектордо түздөн-түз көрүнбөйт; нейтрино өз ара аракеттенүүсү пайда кылган заряддуу бөлүкчөлөр сууда жетиштүү ылдам кыймылдаганда Черенков жарыгын чыгарат. Бул жарыктын детектор дубалындагы фотокөбөйткүч түтүктөргө жеткен орду, көлөмү жана убактысы окуянын физикалык топологиясы тууралуу маалымат берет. IWCDнин цилиндрдик бети \((\phi,z)\) координаттарында ачылып, image-like 29×40 пикселдик өкүлчүлүккө айландырылат.
Ар бир multi-PMT модулунда 19 өзүнчө PMT болгондуктан, эң деталдуу сүрөт өкүлчүлүгү ар бир пиксел үчүн 19 charge жана 19 timing каналын, башкача айтканда жалпы 38 каналды камтыйт. ResNet-18 менен жүргүзүлгөн талдоодо charge жана timing чогуу колдонулганда No-Physics тестинде AUC 0,987, GENIE тестинде AUC 0,990 алынат. Timing каналдары өзүнчө charge каналдарына караганда көбүрөөк айырмалоочу болуп чыгат, ал эми орточо маанини/стандарттык четтөөнү гана колдонгон кыйла компакттуу 2Q+2T өкүлчүлүгү да толук 19Q+19T өкүлчүлүгүнүн натыйжалуулугуна абдан жакын калат.
Диссертация ошол эле нейтрино маселесине QELMди proof-of-concept катары да колдонот. Бирок салыштыруу шарттары бирдей эмес: QELM 60.000 NEUT окуясынан турган тең салмакталган subsetти гана колдонот; толук 29×40 сүрөттөр алгач PCA аркылуу болгону 20 белгиге кысылып, андан кийин Bloch-sphere encoding менен 10 qubitке коддолот. Эң жакшы time+charge конфигурациясында test AUC 0,6575, accuracy 0,6187 жана F1 0,6286 алынат. Бул натыйжалуулук ResNet-18 моделине караганда кыйла төмөн. Диссертация муну QELMдин ResNetти жеңиши катары эмес, реалисттик нейтрино сүрөттөрүнө колдонууга болорун көрсөткөн алгачкы мүмкүнчүлүк демонстрациясы катары чечмелейт.
Quantum Extreme Learning Machine классикалык нейрондук тармактан эмнеси менен айырмаланат?
QELMде классикалык нейрондук тармактардагы үйрөтүлүүчү терең hidden layerлардын ордуна туруктуу кванттык система feature generator катары колдонулат; маалымат кванттык абалга коддолот, туруктуу Гамильтониан астында эволюцияланат жана өлчөөдөн алынган ыктымалдыктар акыркы классикалык readout катмарында гана үйрөнүлөт.
Extreme Learning Machine идеясы
Классикалык Extreme Learning Machine ыкмасынын негизги идеясы feature generation менен learning процессин бири-биринен ажыратуу болуп саналат. Hidden layer параметрлерин туруктуу кармоого болот; output layer гана үйрөтүлөт. QELM бул идеяны кванттык системага өткөрөт.
Диссертацияда колдонулган негизги QELM pipeline төрт кадамдан турат:
- Жогорку өлчөмдүү классикалык маалымат PCA же autoencoder менен кысылат.
- Latent белгилер \(N\) qubitтен турган кванттык абалга коддолот.
- Кванттык абал туруктуу many-body Hamiltonian астында белгилүү убакыт эволюцияланат.
- Computational-basis өлчөө ыктымалдыктары классикалык shallow classifierга берилет.
Qubit деген эмне?
Классикалык bit 0 же 1 маанисин гана алса, qubitтин таза абалы:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle, \qquad |\alpha|^2+|\beta|^2=1 \]
түрүндө жазылат. \(\alpha\) жана \(\beta\) комплекстүү probability amplitude болуп саналат. Өлчөө жүргүзүлгөндө \(|0\rangle\) натыйжасы \(|\alpha|^2\), \(|1\rangle\) натыйжасы \(|\beta|^2\) ыктымалдык менен алынат.
Bloch сферасы колдонулганда ошол эле абал:
\[ |\psi\rangle= \cos\left(\frac{\theta}{2}\right)|0\rangle + e^{i\phi} \sin\left(\frac{\theta}{2}\right)|1\rangle \tag{4.9} \]
түрүндө туюнтулат. \(\theta\) полярдык, \(\phi\) азимуттук бурч болуп саналат. QELMдин көптөгөн encoding ыкмалары классикалык белгилерди түздөн-түз ушул эки бурчка жайгаштырат.
Hilbert мейкиндиги эмне үчүн маанилүү?
\(N\) qubitтен турган системанын абал мейкиндиги:
\[ \mathcal{H}_N=(\mathbb{C}^2)^{\otimes N} \]
жана анын өлчөмү:
\[ \dim(\mathcal{H}_N)=2^N \]
болот.
Бул экспоненциалдык өсүү аз сандагы qubit менен жогорку өлчөмдүү state representation түзүүгө мүмкүн болушунун математикалык негизи. Бирок \(2^N\) өлчөмдүү state spaceтин болушу автоматтык түрдө кванттык артыкчылык жаратпайт; бул stateти даярдоо, эволюциялоо, өлчөө жана алынган маалыматтын классификация үчүн чындап пайдалуу болушу талап кылынат.
Классикалык белгилер qubitтерге кантип коддолот?
Диссертация классикалык latent белгилер qubit амплитудаларына же Bloch-сферасынын бурчтарына жайгаштырылган беш encoding үй-бүлөсүн салыштырат; бул ыкмалар qubitке туура келген белгилердин саны менен state-preparation схема тереңдигинин ортосунда ар түрдүү компромистерди түзөт.
Dense-angle encoding
Dense-angle encoding ар бир qubitке эки белги жайгаштырат:
\[ |x\rangle = \bigotimes_{i=1}^{\lceil M/2\rceil} \left[ \cos\left(\frac{x_{2i-1}}{2}\right)|0\rangle + e^{ix_{2i}} \sin\left(\frac{x_{2i-1}}{2}\right)|1\rangle \right]. \tag{4.10} \]
Бул жерде \(x_{2i-1}\) полярдык бурчка, \(x_{2i}\) фаза бурчуна айландырылат. Ошентип бир qubit эки классикалык белгини алып жүрөт.
Angle encoding
Angle encoding полярдык бурчту гана колдонот:
\[ |x\rangle = \bigotimes_i \left[ \cos\left(\frac{x_i}{2}\right)|0\rangle+ \sin\left(\frac{x_i}{2}\right)|1\rangle \right]. \tag{4.11} \]
Ар бир qubit бир гана белгини алып жүрөт. Артыкчылыгы — state preparation кыйла тайыз; кемчилиги — бирдей сандагы белгилерди коддоо үчүн dense-angleга караганда көбүрөөк qubit талап кылынышы мүмкүн.
Uniform Bloch-sphere encoding
Булак бул коддоону:
\[ |x\rangle = \bigotimes_i \left[ \sqrt{x_{2i-1}}|0\rangle+ e^{ix_{2i}} \sqrt{1-x_{2i-1}}|1\rangle \right] \tag{4.12} \]
түрүндө берет. Биринчи белги population салмагын, экинчи белги relative phaseти көзөмөлдөйт.
Amplitude encoding
Amplitude encoding:
\[ |x\rangle = \frac{1}{\|x\|_2} \sum_{i=0}^{2^N-1}x_i|i\rangle \tag{4.14} \]
аркылуу \(N\) qubitке теориялык жактан \(2^N\) белгиге чейин жайгаштыра алат. Qubit саны боюнча абдан компакттуу көрүнгөнү менен generic amplitude state preparation терең жана көп-qubit entangling circuit талап кылышы мүмкүн. Ошондуктан диссертация amplitude encodingдин NISQ шартында ишке ашырылышы angle-негизиндеги коддоолорго караганда татаалыраак экенин баса белгилейт.
| Коддоо | Qubitке туура келген белги | Типтүү схема тереңдиги | Негизги компромисс |
|---|---|---|---|
| Angle | 1 | Төмөн | Жөнөкөй state preparation; көбүрөөк qubit талап кылынышы мүмкүн |
| Dense-angle | 2 | Төмөн | Эки Bloch параметрин колдонот; фазаны көзөмөлдөө керек |
| Uniform Bloch-sphere | 2 | Төмөн | Population менен фазаны чогуу коддойт |
| General | 2 | Төмөн | Амплитудаларды түздөн-түз нормалдаштырылган параметрлештирүү |
| Amplitude | \(2^N\) жалпы белгиге чейин | Жогорку | Qubit-үнөмдүү, бирок generic state preparation кымбат |
Биринчи сүрөт классификациялоо изилдөөсүндө dense-angle жана uniform Bloch-sphere коддоолору жалпысынан натыйжалуулук–ишке ашыруу мүмкүнчүлүгүнүн эң жакшы тең салмагын берет. General encoding өзгөчө qubit саны аз болгондо начарыраак натыйжа берет. Amplitude encoding болсо latent feature саны жетиштүү көбөйгөндө жакшырат; бирок бирдей qubit санында бардык 784 MNIST пикселин amplitude encoding менен түздөн-түз колдонгон учурда \(N=10-12\) үчүн test accuracy болжол менен 0,97 деңгээлинде калып, dense-angle + compressed latent representation ыкмасынан бир аз төмөн натыйжа берет.
QELMде Гамильтониан эмне үчүн үйрөтүлбөйт?
QELMдин максаты кванттык динамиканы trainable variational circuit катары оптималдаштыруу эмес, туруктуу физикалык системанын классикалык маалыматты пайдалуу feature spaceке өзгөртүү мүмкүнчүлүгүн изилдөө; ошондуктан Гамильтониан параметрлери туруктуу кармалып, үйрөтүү классикалык output layerда гана жүргүзүлөт.
Кванттык stateтин убакыт эволюциясы:
\[ U(t)=e^{-iHt} \tag{4.15} \]
менен аныкталат. Бул жерде \(H\) — Гамильтониан, \(t\) — эволюция убактысы. \(\hbar=1\) бирдиктери колдонулганда экспоненциалдык форма ушундай жазылат.
Коддолгон баштапкы абал:
\[ |\psi(t)\rangle=U(t)|\psi_0(z)\rangle \]
болот.
Гамильтониандын милдети класстын белгисин “үйрөнүү” эмес. Анын милдети баштапкы жергиликтүү же төмөн татаалдыктагы feature маалыматын register боюнча кайра бөлүштүрүп, computational-basis measurement учурунда класстарды ажыратууга ыңгайлуураак probability representation түзүү.
Биринчи изилдөөдө эмне үчүн алты түрдүү Гамильтониан колдонулат?
Диссертация connectivity, integrability, chaos жана localization QELM натыйжалуулугунда чындап аныктоочу факторбу же жокпу текшерүү үчүн физикалык жактан бири-биринен айырмаланган Гамильтониан үй-бүлөлөрүн колдонот.
| Модель | Түрү | Негизги максат |
|---|---|---|
| \(H_1\) | Periodically driven long-range Ising | Узак аралыктагы күчтүү аралаштыруучу reservoir |
| \(H_2\) | Fully connected disordered transverse-field Ising | Disorder жана толук байланышкан өз ара аракеттенүүнү текшерүү |
| \(H_3\) | Chaotic nearest-neighbour Ising | Жергиликтүү, бирок non-integrable/ergodic динамика |
| \(H_4\) | Nearest-neighbour XXZ | Anisotropic жергиликтүү many-body динамика |
| \(H_5\) | Integrable XX chain | Жөнөкөй, жергиликтүү жана толук чечилүүчү reservoir |
| \(H_6\) | Disordered long-range \(xx\) + random fields | Ergodic, non-ergodic жана localized режимдерин салыштыруу |
Long-range Ising \(H_1\)
Булакта:
\[ H_1(t)= \begin{cases} B_1\displaystyle\sum_i\sigma_x^{(i)}, & 0\le t<T_1,\\ \displaystyle\sum_{i,j}J_{ij}^{(1)}\sigma_z^{(i)}\sigma_z^{(j)}, & T_1\le t<T, \end{cases} \tag{4.16} \]
жана:
\[ J_{ij}^{(1)}= \frac{J_0}{|i-j|^\alpha} \tag{4.17} \]
колдонулат.
Параметрлер \(J_0=0.06\), \(\alpha=1.51\), \(B_1=3.05\) жана \(T=2T_1=1\) деп берилет. Биринчи изилдөөнүн симуляциясында бул динамика \(\Delta t=50T\) өлчөмүндө колдонулат.
Integrable XX модели \(H_5\)
XX чынжыры:
\[ H_5= \frac12 \sum_{i=1}^{N} \left( \sigma_x^{(i)}\sigma_x^{(i+1)} + \sigma_y^{(i)}\sigma_y^{(i+1)} \right) \tag{4.24} \]
жана периоддук чек ара шарты:
\[ \sigma^{(N+1)}\equiv\sigma^{(1)} \]
менен колдонулат.
XX модели Jordan–Wigner өзгөртүүсү аркылуу free fermion системасына дал келтириле турган integrable модель. Ошого карабастан, ал классификация үчүн керектүү жергиликтүү entanglement жана ballistic information propagation түзө алат. Диссертациянын экинчи QELM изилдөөсүндө дал ушул модель тандалат, анткени физикалык динамика менен classification transition ортосундагы байланышты тазараак изилдөөгө болот.
Localized режим эмне үчүн начар натыйжа берет?
Маалымат register боюнча тарабаса, ар башка qubitтерге коддолгон белгилер measurement алдында жетиштүү аралашпайт. Non-interacting \(H_2\) чегинде qubitтер өз алдынча кыймылдайт. Күчтүү many-body localization режиминде болсо өз ара аракеттенүү бар болсо да, баштапкы маалыматтын spatial spreadingи олуттуу басаңдатылат.
Булак эки учурда тең high-accuracy plateau бузуларын көрсөтөт. Бул натыйжа “chaos сөзсүз керек” дегенди билдирбейт; integrable XX чынжыры да жакшы иштей алат. Керектүү нерсе — каралып жаткан классификация тапшырмасы үчүн жетиштүү feature redistribution.
Өлчөө эмне үчүн кванттык feature mapтин критикалык бөлүгү?
Кванттык state өзү классикалык classifierга түздөн-түз берилбейт; classifier өлчөө ыктымалдыктарын гана көргөндүктөн, Гамильтониандын eigenbasisи менен measurement basisтин ортосундагы байланыш кайсы кванттык интерференция маалыматы классикалык featureга айланарын аныктайт.
Гамильтониандын спектрдик ажыроосу:
\[ H=\sum_n E_n|E_n\rangle\langle E_n| \tag{4.29} \]
болсун. Баштапкы абал:
\[ |\psi(0)\rangle=\sum_n c_n|E_n\rangle \tag{4.30} \]
жана убакыт өткөн сайын:
\[ |\psi(t)\rangle= \sum_n c_ne^{-iE_nt}|E_n\rangle \tag{4.31} \]
түрүндө эволюцияланат.
\(|s_k\rangle\) measurement basisиндеги натыйжанын ыктымалдыгы Born эрежеси боюнча:
\[ p_k(t)=|\langle s_k|\psi(t)\rangle|^2 \tag{4.32} \]
болот.
Булак муну кеңейтип:
\[ p_k(t)= \sum_{n,m} \langle s_k|E_n\rangle \langle E_m|s_k\rangle e^{-i(E_n-E_m)t} c_nc_m^\ast \tag{4.33} \]
туюнтмасын алат.
Бул теңдеме өтө маанилүү. Measurement basis Гамильтониандын eigenbasisи менен толук бирдей болсо, off-diagonal interference contributions жоголот жана:
\[ p_k(t)=|c_k|^2 \tag{4.34} \]
убакыт менен өзгөрбөйт. Мындай өлчөө quantum dynamicsтин feature enrichment мүмкүнчүлүгүн колдоно албайт.
Тескерисинче, measurement basis менен энергия eigenbasisи жетиштүү айырмаланса, \(E_n-E_m\) энергия айырмаларынан чыккан interference terms probability vectorду убакыт өткөн сайын татаал түрдө кайра уюштура алат.
QELMдин классикалык чыгуу катмары
Өлчөө probability vectorу:
\[ \mathbf{p}(t)= \left(p_s(t)\right)_{s\in\{0,1\}^N} \]
классикалык feature vector катары колдонулат.
Чыгуу катмары:
\[ \mathbf{a}=W\mathbf{p}(t)+\mathbf{b} \tag{4.36} \]
logitтерди түзүп, softmax:
\[ y_c= \frac{e^{a_c}} {\sum_{c'=1}^{C}e^{a_{c'}}} \tag{4.37} \]
аркылуу class probabilityлерге айлантат.
Categorical cross-entropy:
\[ \mathcal{L} = -\sum_{c=1}^{C}t_c\log y_c \tag{4.38} \]
минималдаштырылат. QELM архитектурасында trainable параметрлер \(W\) жана \(b\); кванттык reservoir өзү үйрөтүлбөйт.
QELM үчүн көп чырмалышуу керекпи же жергиликтүү чырмалышуунун туура көлөмүбү?
Бул диссертацияда изилденген XX-негизиндеги QELM үчүн жогорку классификация тактыгы глобалдык максимумдагы же volume-law чырмалышкан stateти талап кылбайт; тактыктын платосу коңшу qubitтердин ортосунда жергиликтүү чырмалышуу пайда болгон, бирок бүт чынжыр али күчтүү чырмалыша элек \(t^\*\approx1\) режиминде пайда болот.
Экинчи QELM изилдөөсүнүн көзөмөлдөнгөн түзүлүшү
Бул изилдөө чечмелөөнү жеңилдетүү үчүн архитектураны негизинен туруктуу кармайт:
- feature reduction pipeline туруктуу,
- encoding ар дайым dense-angle,
- Гамильтониан периоддук чек ара шарты бар nearest-neighbour XX чынжыры,
- measurement computational basisте,
- өзгөртүлүүчү негизги continuous hyperparameter — evolution time \(t\) гана.
XX Гамильтонианы:
\[ H= \frac12 \sum_{i=1}^{N} \left( \sigma_x^{(i)}\sigma_x^{(i+1)} + \sigma_y^{(i)}\sigma_y^{(i+1)} \right) \tag{6.1} \]
жана:
\[ |\psi_t(z)\rangle = e^{-iHt}|\psi_0(z)\rangle \tag{6.2} \]
колдонулат.
Үч натыйжалуулук аймагы
MNIST, Fashion-MNIST жана CIFAR-10 топтомунда accuracy–time ийри сызыктары жалпысынан үч аймакты көрсөтөт:
1. Кыска убакыт: Динамика encoded stateти али жетиштүү өзгөртө элек жана accuracy төмөн.
2. Өтүү: \(t^\*\sim1\) чамасында training жана test accuracy тездик менен өсөт.
3. Плато: \(t\gtrsim t^\*\) болгондон кийин accuracy datasetке жана \(N\)ге көз каранды плато маанисине жетет.
Өтүү убактысынын каралган система өлчөмдөрүндө \(N\)ге дээрлик көз каранды эместиги өзгөчө маанилүү. Эгер classification үчүн бүт чынжырдын global scramblingи керек болгондо, талап кылынган убакыт система өлчөмү менен өсөт деп күтүлмөк.
Жергиликтүү жана глобалдык entanglement убакыт масштабдары
Бир-qubit entropy тез өсүп:
\[ t=O(1) \]
масштабында каныгууга жакындайт. Бул ар бир qubit өзүнүн жакын айланасы менен чырмалышуу түзөрүн көрсөтөт.
Half-chain entropy болсо чынжырдын жарымын экинчи жарымынан бөлгөн bipartitionдагы global entanglementти өлчөйт жана volume-law saturation үчүн:
\[ t=O(N) \]
масштабын талап кылат.
Classification transition \(t^\*\approx1\) биринчи убакыт масштабы менен дал келет, экинчиси менен эмес.
Lieb–Robinson ылдамдыгы деген эмне?
Жергиликтүү Гамильтониандарда маалымат менен корреляциялардын мейкиндикте каалагандай заматта таралышына жол бербеген эффективдүү ылдамдык чеги бар. Бул жүрүм-турум Lieb–Robinson bound менен сүрөттөлөт.
Диссертациядагы XX модели жана колдонулган бирдиктер үчүн:
\[ v_{\mathrm{LR}}=1 \]
алынат.
Ошондуктан \(t\lesssim1\) болгондо бир qubitтин маалыматы болжол менен бир lattice spacing тартибиндеги коңшуларга гана күчтүү жетет. QELM accuracyнин ошол эле убакта платого чыгышы classification үчүн алыстагы siteтердин глобалдык түрдө чырмалышуусу талап кылынбай турганын колдойт.
Haar-random unitary салыштыруусу
Булак XX evolutionдун plateau accuracyсин ошол эле encoded stateтерге колдонулган Haar-distributed random unitaryлер менен салыштырат. Ар бир \(N\) жана dataset үчүн 10 көз карандысыз Haar-random unitary үлгүсү колдонулат.
XX-QELMдин \(t\gtrsim t^\*\) плато мааниси numerical uncertainties чегинде Haar-random unitary натыйжалуулугу менен дал келет. Бирок XX модели Haar-random state сыяктуу глобалдык scramble болбостон эле ошол classification деңгээлине жете алат.
Shallow random circuits
Analog XX dynamics ошондой эле nearest-neighbour random two-qubit gates колдонгон brickwork digital circuit менен салыштырылат. Диссертация бир нече layer гана — адатта болжол менен төрттөн алты катмарга чейин — analog XX plateauсуна абдан жакын accuracy түзө аларын билдирет.
Бул натыйжа effective circuit depth \(N\) менен өспөй турганы жана relevant dynamics shallow бойдон калаары тууралуу чечмелөөнү күчөтөт.
Эмне үчүн бул натыйжа күчтүү кванттык артыкчылык эмес?
Бир өлчөмдүү, кыска тереңдиктеги, жергиликтүү чырмалышуу чектелүү калган кванттык схемаларды Matrix Product State сыяктуу tensor-network ыкмалары менен көп учурда натыйжалуу симуляциялоого болот. Диссертация classification үчүн пайдалуу деп тапкан \(t^\*\) режими так ушул түзүлүшкө жакын.
Ошондуктан булактын жыйынтыгы “кванттык feature map пайдасыз” дегенди билдирбейт. Жыйынтык кыйла нюанстуу: кванттык динамика класстарды жакшыраак ажыратылуучу feature geometryге өткөрө алат; бирок каралган тапшырмаларда бул ишке ашкан динамикалык режим классикалык ыкмалар үчүн дагы эле жеткиликтүү болушу мүмкүн.
Probability polytope деген эмне?
Ар бир input sample үчүн QELM өлчөөсү:
\[ p_t(s|z)=|\langle s|\psi_t(z)\rangle|^2 \tag{6.7} \]
ыктымалдыктарын берет.
Бардык \(2^N\) bit-string ыктымалдыгы:
\[ \mathbf{p}_t(z) = \left( p_t(s_1|z),\ldots,p_t(s_{2^N}|z) \right) \tag{6.6} \]
probability simplex ичинде жайгашат:
\[ \Delta_{2^N-1} = \left\{ \mathbf{p}\in\mathbb{R}^{2^N} \;\middle|\; p_i\ge0,\; \sum_i p_i=1 \right\}. \tag{6.8} \]
Диссертация бул sample cloudду “probability polytope” деп атайт.
K-means inertia:
\[ I= \sum_{k=1}^{K} \sum_{x_j\in C_k} \|x_j-\mu_k\|_2^2 \tag{6.9} \]
аркылуу cluster compactness өлчөнөт. \(I\) азайган сайын clusterлар centroid айланасына тыгызыраак топтолот.
Изилдөө QELM accuracy transition учурунда probability-space clusterлар class labels менен көбүрөөк шайкеш боло баштарын; ошол эле учурда single-site local observables убакыт өтүшү менен класс маалыматын жоготушу мүмкүн экенин көрсөтөт. Башкача айтканда, маалымат жоголбойт; local observablesтан global correlation structureга өтөт.
Нейтрино эмне үчүн түздөн-түз сүрөткө түшпөйт жана Черенков шакектери кантип пайда болот?
Суу Черенков детекторунда нейтрино түздөн-түз жарык чыгарбайт; нейтрино өз ара аракеттенүүсү пайда кылган электр заряддуу бөлүкчөлөр сууда жарыктын фазалык ылдамдыгынан тез кыймылдаганда конус түрүндөгү Черенков нурлануусун чыгарат, ал эми бул конустун детектор бетине кесилиши PMTлерде шакек сымал сүрөттөрдү түзөт.
Черенков шарты
Бөлүкчө сууда Черенков нурлануусун чыгарышы үчүн:
\[ v>\frac{c}{n} \]
болушу керек.
Бул жерде \(v\) — бөлүкчөнүн ылдамдыгы, \(c\) — вакуумдагы жарыктын ылдамдыгы, \(n\) — чөйрөнүн refractive index мааниси.
Черенков бурчу:
\[ \cos\theta_C= \frac{1}{\beta n}, \qquad \beta=\frac{v}{c} \]
байланышы менен берилет.
Суу үчүн оптикалык аймакта болжол менен \(n\approx1.33\), ал эми өтө relativistic \(\beta\rightarrow1\) бөлүкчөлөр үчүн максималдуу бурч болжол менен \(42^\circ\).
PMTлерде көрүнгөн шакек бөлүкчөнүн бар экенин гана эмес, direction, vertex position, propagation length жана light timing сыяктуу окуя геометриясына тиешелүү маалыматты да алып жүрөт.
Single-vertex менен pile-up эмне үчүн чаташтырылышы мүмкүн?
Single-vertex окуя бир neutrino interaction vertexти камтыйт, бирок бул interaction бир нече charged particle жаратышы мүмкүн. Ошондуктан бир-vertex окуяда да бир нече Cherenkov ring көрүнүшү мүмкүн.
Pile-up окуяда болсо ошол эле detector readout window ичинде эки же андан көп көз карандысыз interaction пайда болот. Бир нече vertexтин шакектери бири-бирине дал келип калышы мүмкүн.
Ошондуктан “бир ring = single vertex, көп ring = pile-up” сыяктуу жөнөкөй эреже жарактуу эмес. Модель spatial жана temporal structureду чогуу үйрөнүшү керек.
Charge менен timing эмне үчүн бири-бирин толуктайт?
Charge PMTге жеткен жарыктын көлөмү менен байланыштуу жана event morphology/brightness маалыматын алып жүрөт.
Timing фотондор сенсорго качан жеткенин көрсөтөт жана vertex geometry, particle propagation жана ар башка interactionsдын temporal separationына сезгич.
Диссертациянын натыйжаларында timing-only representation charge-only representationга караганда жакшыраак classification бериши pile-up маселесинин күчтүү temporal componentин ырастайт.
IWCD сүрөтү жасалма нейрондук тармакка кантип айландырылат?
Цилиндрдик IWCD бети \((\phi,z)\) координаттарында ачылып, ар бир multi-PMT модулу бир пикселге айландырылган 29×40 сүрөт түзүлөт; ар бир пикселдеги 19 PMTнин charge жана timing маанилери өзүнчө каналдар же жыйынтык статистикалар түрүндө нейрондук тармакка берилет.
Симуляция чынжыры
Detector response WCSim менен симуляцияланат. No-Physics datasetте neutrino–nucleus interaction generator колдонулбастан final-state particle tracks түздөн-түз түзүлөт. Максат classifier generator-specific деталдарды эмес, single-vertex/pile-up топологиясын үйрөнүшүн камсыз кылуу.
No-Physics маалымат топтомунда:
- electron, muon, \(\pi^0\) жана \(\pi^-\) колдонулат,
- track багыттары isotropic түрдө тандалат,
- жалпы visible energy эң көп 2000 MeV,
- single-vertex жана pile-up катышы бирдей,
- 5 миллион окуя training үчүн,
- 1 миллион көз карандысыз окуя test үчүн колдонулат.
GENIE жана NEUT маалымат топтомдору реалисттик neutrino–nucleus interaction generatorлорун колдонот. Ар бири 1 миллион окуяны камтыйт жана болжол менен %32 single-vertex, %68 pile-up курамына ээ. Бул топтомдор realistic generalization тесттери катары колдонулат.
29×40 пиксел эмне үчүн 38 каналга чейин жетет?
Ар бир multi-PMT модулу бир image pixel болуп саналат. Бир модулда 19 PMT болгондуктан, ар бир PMT үчүн:
19 charge channel + 19 timing channel = 38 channel
алынат.
Булактын notationы:
| Белгилөө | Мазмуну |
|---|---|
| 19Q | 19 өзүнчө charge каналы |
| 19T | 19 өзүнчө timing каналы |
| 19Q+19T | 38 толук канал |
| 2Q | 19 charge маанисинин mean + standard deviation жыйынтыгы |
| 2T | 19 timing маанисинин mean + standard deviation жыйынтыгы |
| 2Q+2T | Charge жана timing үчүн төрт жыйынтык канал |
Double-cover эмне үчүн керек?
Цилиндрдик бет түз тик бурчтукка ачылганда \(\phi=0\) жана \(\phi=2\pi\) физикалык жактан коңшу болгонуна карабастан сүрөттүн сол жана оң четтерине бөлүнүп калат. Стандарттык convolution бул эки четти алыс чекиттер деп кабыл алышы мүмкүн.
Double-cover construction сүрөттүн тиешелүү бөлүктөрүн көбөйтүп жана кайра уюштуруп, periodic cylindrical boundaryни CNN үчүн физикалык жактан ылайыктуураак чагылдырат.
ResNet-18 архитектурасы
Диссертация standard ResNet-18 моделинин residual түзүлүшүн сактайт, бирок detector images ичиндеги майда spatial маалыматты сактоо максатында кириш stemин ылайыкташтырат.
Төрт residual stage:
| Этап | Чыгуу каналы | Residual block | Биринчи block stride |
|---|---|---|---|
| Layer 1 | 64 | 2 | 1 |
| Layer 2 | 128 | 2 | 2 |
| Layer 3 | 256 | 2 | 2 |
| Layer 4 | 512 | 2 | 2 |
Residual blockтун негизги операциясы:
\[ y=F(x,W)+x \]
түрүндө. Shortcut connection үйрөнүлө турган mappingдин баарын нөлдөн түзүүнүн ордуна residual өзгөрүүнү үйрөнүүнү жеңилдетет жана терең тармактарда gradient flowду колдойт.
Stage аягында adaptive average pooling ар бир feature mapти 1×1 мааниге түшүрөт. 512-dimensional vector flatten кылынат жана fully connected output layerга берилет.
ResNet үйрөтүү параметрлери
| Параметр | Маани |
|---|---|
| Optimizer | Adam |
| Learning rate | 0,01 |
| Epoch | 20 |
| Batch size | 512 |
| Тапшырма | Эки класстуу classification |
| Loss | Cross-entropy |
| Training augmentation | Колдонулат |
| Validation / test augmentation | Колдонулбайт |
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Биринчи QELM сүрөт классификациялоо изилдөөсүндө кайсы компонент чындап аныктоочу болду?
Биринчи изилдөөдө эң күчтүү таасирлер feature reduction жана encoding тандоосунан келип чыгат; nonlinear convolutional autoencoderлер PCAга караганда жакшыраак latent representation түзсө, dense-angle жана uniform Bloch-sphere encoding эки белги/qubit колдонуп, жогорку натыйжалуулук менен салыштырмалуу тайыз state preparation ортосунда жакшы тең салмак камсыз кылат.
Маалымат топтомдору жана алдын ала иштетүү
Биринчи QELM изилдөөсүндө MNIST жана Fashion-MNIST 28×28 grayscale сүрөттөрү колдонулат. Пиксел маанилери 255 санына бөлүнүп [0,1] аралыгына нормалдаштырылат. Кошумча denoising же data augmentation колдонулбайт.
PCA колдонулганда 28×28 сүрөт 784-dimensional векторго flatten кылынат жана алгачкы \(d\) principal componentке project кылынат.
Autoencoder колдонулганда табигый 28×28 tensor encoderга кирет жана \(d\)-өлчөмдүү bottleneck vector гана сакталат.
Baseline configuration:
| Компонент | Референс тандоо |
|---|---|
| Feature reduction | Autoencoder AE1 |
| Encoding | Dense-angle |
| Гамильтониан | Periodically driven long-range \(H_1\) |
| Classical readout | Feed-forward neural network |
| Эң чоң qubit саны | \(N=12\) |
\(N=12\) бул изилдөөдө full quantum dynamicsти classical simulation кылуу жагынан практикалык чек катары көрсөтүлөт. Бул чек чыныгы quantum hardwareдын максималдуу qubit саны эмес.
PCA жана autoencoder жыйынтыгы
AE1 жана AE2 convolutional autoencoderлери PCAга караганда жогору classification accuracy берет. Чоңураак AE1 төмөн reconstruction error жана жакшыраак latent representation түзөт; бирок анын ордуна көбүрөөк trainable parameter жана training cost талап кылат.
Булак бул жыйынтыкты өзгөчө күчтүү кысуу режиминде чечмелейт: quantum layerга аз гана feature жөнөтүүгө мүмкүн болгондо, кайсы маалыматтын сакталышы акыркы classification ийгилигине олуттуу таасир этет.
Encoding жыйынтыгы
Dense-angle жана uniform Bloch-sphere training жана test жагынан эң күчтүү single-qubit encoding ыкмаларынын катарына кирет. Simple angle бир белги/qubit колдонгондуктан ошол эле \(N\)де азыраак classical information алып жүрөт.
Amplitude encodingдин артыкчылыгы \(2^N\) белгиге чейин compact state representation камсыз кыла алышы; кемчилиги generic state preparation experimentally demanding болушу.
Гамильтониан жыйынтыгы
Каралган interaction Hamiltonianдардын көбү \(N\) көбөйгөн сайын бири-бирине абдан жакын performance берип, болжол менен \(N\simeq10\) чамасында платого чыгат.
Бул жыйынтык integrability же chaos маанисиз экенин универсалдуу түрдө далилдебейт. Изилдөөнүн тар маанидеги жыйынтыгы мындай: сыналган image-classification маселелеринде жана system-size аралыгында, маалымат sufficiently spread болгон шартта Hamiltonianдын microscopic detailsи accuracyга чектелген гана айырма жаратат.
Non-interacting же strongly localized dynamics болсо кыйла начар натыйжа берет.
Classical baseline чеги
Биринчи изилдөө QELMди original 784 pixels менен азыктанган single-layer neural network жана AE1 latent features менен азыктанган классикалык output network сыяктуу baselines менен салыштырат. Жогоруураак \(N\) маанилеринде QELM бул baselinesдан жогору натыйжа көрсөтүшү мүмкүн.
Бирок мындан “QELM бардык классикалык машиналык үйрөнүү моделдеринен ашып түшөт” деген жыйынтык чыгарууга болбойт. Салыштыруу белгилүү shallow baselines менен жүргүзүлгөн; бул күчтүүрөөк заманбап classical modelsдин баарын камтыган benchmark эмес.
Экинчи QELM изилдөөсү эмне үчүн кванттык артыкчылык жөнүндөгү дооматты чектейт?
Анткени эң жогорку classification performance global volume-law чырмалышуусу пайда боло электе, кыска-убакыттык жана жергиликтүү чырмалышуу үстөм болгон туруктуу-тереңдик режиминде чыгат; бул режим tensor-network жана shallow random-circuit ыкмалары менен классикалык түрдө жеткиликтүү бойдон калат.
Негизги жыйынтыктар:
| Табылга элементи | Булак жыйынтыгы | Чечмелөө |
|---|---|---|
| Accuracy transition | \(t^\*\sim1\) | Каралган \(N\) маанилерине негизинен көз каранды эмес |
| Local entanglement | \(t=O(1)\) | Classification transition менен бир масштабда |
| Half-chain volume-law saturation | \(t=O(N)\) | High accuracy үчүн зарыл эмес |
| Lieb–Robinson velocity | \(v_{\mathrm{LR}}=1\) | \(t\sim1\) учурунда маалымат жакын чөйрөгө гана тараган |
| Haar-random comparison | Plateau accuracy numerical uncertainties чегинде шайкеш | XX dynamics random-like useful representation түзө алат |
| Digital random circuits | Адатта 4–6 layer платого жакындай алат | Тайыз динамика жетиштүү болушу мүмкүн |
| Classical simulability | Tensor-network менен шайкеш режим | Generic strong quantum advantage далили жок |
Диссертациянын бул бөлүгү колдогон чечмелөө
Кванттык динамика classical dataнын representation geometryсин пайдалуу түрдө өзгөртө алат. Entanglement бул өзгөрүүдө роль ойнойт. Бирок “пайдалуу entanglement” менен “максималдуу/global entanglement” бир эле нерсе эмес.
Диссертациянын бул бөлүгү колдобогон чечмелөө
Бул жыйынтыктардан fault-tolerant quantum computer advantage, exponential speedup же classical algorithms үчүн intractability жыйынтыгын чыгарууга болбойт. Тескерисинче, каралган режим classical tractability менен шайкеш.
ResNet-18 нейтрино окуяларын канчалык жакшы ажыратты?
Charge жана timing маалыматы бирге колдонулган толук 19Q+19T өкүлчүлүгү No-Physics datasetте AUC 0,987 жана GENIE datasetте AUC 0,990 берет; timing-only өкүлчүлүк charge-onlyдан жакшыраак натыйжа көрсөткөндө, 2Q+2T compact өкүлчүлүгү да толук канал киргизүүсүнүн натыйжалуулугуна абдан жакын калат.
| Конфигурация | Loss | Accuracy | F1 | AUC |
|---|---|---|---|---|
| 19Q + 19T | 0,128 | 0,954 | 0,953 | 0,987 |
| 2Q + 2T | 0,136 | 0,951 | 0,950 | 0,986 |
| 19T | 0,142 | 0,949 | 0,948 | 0,985 |
| 19Q | 0,212 | 0,916 | 0,913 | 0,970 |
| Конфигурация | Loss | Accuracy | F1 | AUC |
|---|---|---|---|---|
| 19Q + 19T | 0,114 | 0,954 | 0,966 | 0,990 |
| 2Q + 2T | 0,126 | 0,950 | 0,963 | 0,987 |
| 19T | 0,126 | 0,950 | 0,963 | 0,988 |
| 19Q | 0,180 | 0,924 | 0,943 | 0,976 |
Бул жыйынтыктарда timing informationдын күчтүү болушу физикалык жактан маанилүү. Pile-up окуяларынын негизги өзгөчөлүгү spatial overlap гана эмес, ошол эле readout window ичинде ар башка убакта пайда болушу мүмкүн болгон көз карандысыз interactions.
Event vertices мейкиндик жана убакыт боюнча бири-бирине жакындаган сайын classification татаалдашат. Detector boundaries жанындагы events да жарым-жартылай кесилген light patterns себептүү кыйыныраак классификацияланат.
No-Physicsте үйрөнгөн моделдин GENIE жана NEUT сыяктуу реалисттик interaction generatorsда окшош ROC жүрүм-турумун көрсөтүшү classifier бир generatorдун жасалма өзгөчөлүктөрүн гана жаттап албаганын колдойт. Ошентсе да, булардын баары simulated detector datasets; чыныгы experimental IWCD data боюнча акыркы талаалык текшерүү бул диссертацияда жүргүзүлгөн эмес.
QELM реалисттик нейтрино сүрөттөрүнө өткөрүлө алдыбы?
Ооба, бирок алдын ала proof-of-concept деңгээлинде гана: 60.000 тең салмакталган NEUT окуясы 20 PCA белгиге кысылып, 10-qubit QELMге өткөрүлүп, random guessingден жогору ажыратуу алынган; натыйжалуулук толук сүрөттү колдонгон ResNet-18 моделинен кыйла төмөн калган.
QELM нейтрино түзүлүшү
Үч 20-dimensional input колдонулган:
Charge only: 20 charge feature.
Time only: 20 timing feature.
Time + charge: 10 timing + 10 charge feature.
Dimensionality reduction PCA менен жүргүзүлөт. 20-dimensional vector 10-qubit Bloch-sphere encodingге айландырылат. XX-type Hamiltonian астында эволюцияланат. Measurement probability vector бир sigmoid readoutка берилет.
| Киргизүү | Train AUC | Train Accuracy | Train F1 | Test AUC | Test Accuracy | Test F1 |
|---|---|---|---|---|---|---|
| Charge only | 0,6600 | 0,6159 | 0,6058 | 0,6558 | 0,6110 | 0,6049 |
| Time only | 0,6560 | 0,6131 | 0,6215 | 0,6482 | 0,6112 | 0,6241 |
| Time + charge | 0,6659 | 0,6227 | 0,6288 | 0,6575 | 0,6187 | 0,6286 |
Class-wise recall:
| Киргизүү | Recall class 0 | Recall class 1 |
|---|---|---|
| Charge only | 0,629 | 0,593 |
| Time only | 0,580 | 0,642 |
| Time + charge | 0,595 | 0,642 |
Train жана test маанилеринин бири-бирине жакын болушу бул түзүлүштө күчтүү overfitting байкалбаганын көрсөтөт. Бирок absolute classification performance чектелүү.
Эмне үчүн ResNet менен QELMди түздөн-түз адилеттүү салыштыруу эмес?
ResNet толук 29×40 spatial structure жана ондогон channelды convolution аркылуу колдоно алат. QELM сынагында сүрөт 20 PCA featureга гана кысылган. Spatial topology, local pixel correlations жана көптөгөн деталдар quantum encodingге жетпей жоголот.
Мындан тышкары, QELM 60.000 окуялык тең салмакталган subset колдонсо, ResNet баалоо чынжыры миллиондогон окуяларды камтыган чоңураак маалымат топтомдору менен иштейт.
Ошондуктан булак QELM жыйынтыгы үчүн атаандаштык benchmark дооматын койбойт.
Келечектеги изилдөө багыттары
Диссертация нейтрино-QELM багытында PCAнын ордуна convolutional autoencoder колдонуу, qubit санын көбөйтүү жана classification accuracy гана эмес, training/inference time менен total computational costту да салыштыруу керектигин белгилейт.
Кванттык тарапта more scalable architectures, альтернативдүү encoding ыкмалары жана чыныгы NISQ hardware колдонмолору келечектеги изилдөө багыттары болуп саналат.
Нейтрино deep-learning тарабында simulation–real-data айырмачылыктары, systematic uncertainties, detector effects, robustness жана interpretability мындан аркы текшерүүнү талап кылат.
Изилдөө колдогон жыйынтыктар
Диссертация классикалык image compression менен туруктуу кванттык feature generation бирге колдонулган QELMдер supervised image classification үчүн иштей турганын көрсөтөт.
Strongly compressed input режиминде nonlinear autoencoder representation PCAга салыштырмалуу жакшыраак classification featureларын бере алат.
Dense-angle жана uniform Bloch-sphere encoding каралган шарттарда performance менен implementation complexity ортосунда күчтүү тең салмак берет.
Ар түрдүү interacting Hamiltonianдар ошол эле тапшырма үчүн жетиштүү information spreading камсыз кылганда бири-бирине жакын accuracy түзө алат; non-interacting жана localized dynamics төмөнүрөөк натыйжа берет.
XX-QELMде classification transition global scramblingден мурун, local entanglement пайда болушу менен бир убакыт масштабында ишке ашат.
Бул жогорку-performance режими shallow local circuits жана tensor-network simulability менен шайкеш.
ResNet-18 IWCDге окшош simulated Cherenkov images үстүндө single-vertex/pile-up discrimination үчүн жогорку натыйжалуулук көрсөтөт.
Timing information каралган окуяларды ажыратууда charge informationга караганда күчтүүрөөк discriminative content алып жүрөт.
QELM реалисттик NEUT event imagesке күчтүү compressionдан кийин proof-of-concept катары өткөрүлдү.
Изилдөө колдобогон жыйынтыктар
Диссертация QELM үчүн жалпы computational quantum advantage далилдебейт.
Диссертация quantum hardware үстүндө exponential speedup көрсөтпөйт.
Диссертация “көбүрөөк entanglement ар дайым жакшыраак classification берет” деген жыйынтыкты колдобойт.
MNIST/Fashion-MNIST/CIFAR-10 жыйынтыктарын бардык machine-learning тапшырмаларына автоматтык түрдө жалпылоого болбойт.
ResNet жыйынтыктары чыныгы IWCD detector data үстүндөгү акыркы experimental performance эмес; негизги баалоолор simulated datasetsке таянат.
QELM neutrino жыйынтыгы ResNetтен ашкан же ага тең performance берген жыйынтык эмес.
GENIE жана NEUT үстүндөгү жакшы generalization чыныгы detector systematic uncertainties толук чечилгенин көрсөтпөйт.
Диссертациядагы QELM simulation жыйынтыктары NISQ noise, gate error, readout error жана чыныгы quantum-device calibration көйгөйлөрүнүн баарын эксперименталдык түрдө ырастабайт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: MACHINE LEARNING DEVELOPMENT FOR QUANTUM COMPUTING AND NEUTRINO PHYSICS
Автор: Annalisa De Lorenzis.
Изилдөө түрү: Doctoral thesis / доктордук диссертация.
Тармактар: Quantum machine learning, quantum computing, machine learning, neutrino physics, water Cherenkov detector data analysis.
Даража: Doctor of Physics.
Даража берген мекеме: Universitat Autònoma de Barcelona (UAB), Department of Physics. Бул маалымат UABнин расмий институционалдык диссертация жазуусу менен ырасталган.
Илимий жетекчилер: M. Pilar Casado Lechuga; Thorsten Lux; Arnau Riera Graells.
Tutor: M. Pilar Casado Lechuga.
PDF мукабасынын датасы: 29 май 2026.
Расмий даража датасы: UAB институционалдык диссертация жазуусуна ылайык 10 июль 2026.
ArXiv жөнөтүлгөн дата: 15 июль 2026.
ArXiv жазуусу: arXiv:2607.13699v1 [quant-ph].
Repository DOI: 10.48550/arXiv.2607.13699.
Расмий жазуулар: arXiv:2607.13699 жана UAB институционалдык диссертация жазуусу, Handle 10803/698010.
Рецензия статусу: Диссертациянын өзү доктордук диссертация жана arXiv диссертация/preprint жазуусу болуп саналат; журнал макаласы эмес. Бирок диссертациядагы негизги QELM жыйынтыктарынын маанилүү бөлүгү эки өзүнчө рецензияланган Physical Review Applied макаласында жарыяланган.
Диссертацияда көрсөтүлгөн негизги жарыя 1: Annalisa De Lorenzis, M. P. Casado, M. P. Estarellas, N. Lo Gullo, T. Lux, F. Plastina, A. Riera, J. Settino, “Harnessing Quantum Extreme Learning Machines for Image Classification,” Physical Review Applied 23, 044024, апрель 2025.
Диссертацияда көрсөтүлгөн негизги жарыя 2: Annalisa De Lorenzis, M. P. Casado, N. Lo Gullo, T. Lux, F. Plastina, A. Riera, “Entanglement and Classical Simulability in Quantum Extreme Learning Machines,” Physical Review Applied 25, 054052, май 2026.
Булак ичиндеги жарыя статусу боюнча эскертүү: Диссертациянын алгачкы беттери экинчи макаланы Physical Review Applied 25, 054052, май 2026 болуп жарыяланган деп көрсөтсө, 6-бөлүмдүн эрте текстинде “currently under review” сыяктуу эскирээк сөз айкашы сакталып калган; ал эми 6-бөлүмдүн аягында иш accepted/published статусуна шайкеш каралат. Бул редакциялык убакыт айырмасы илимий жыйынтыктарды өзгөртпөйт.
Лицензия: arXiv жазуусу non-exclusive distribution license астында көрүнөт. CC BY лицензиясы болжолдонгон эмес. Булакта автордук укук менен корголгон Physical Review Applied фигуралары болгондуктан, Verianla HTMLинде бул фигуралар түзмө-түз колдонулган эмес, илимий байланыштар гана оригиналдуу inline SVG менен кайра түзүлгөн.
Каржылоо / колдоо: Диссертацияда өзүнчө formal funding statement жок болсо да, acknowledgements бөлүмүндө Qilimanjaro Quantum Tech жана AGAURга доктордук процесстеги колдоосу үчүн ыраазычылык билдирилет.
Программалык камсыздоо жана эсептөө: QELM изилдөөлөрү классикалык түрдө simulated quantum dynamics колдонот. Neutrino detector response WCSim менен түзүлгөн; image-analysis pipeline WatChMaL framework менен байланышкан; ResNet үйрөтүүсү PyTorch cross-entropy/Adam тартибинде жүргүзүлгөн. QELM классикалык readout бөлүмдөрүндө Keras/Adam колдонулганы көрсөтүлөт.
Маалымат булактары: MNIST, Fashion-MNIST, CIFAR-10; WCSim менен түзүлгөн No-Physics, GENIE жана NEUT негизиндеги IWCD simulations.
Негизги QELM чектөөсү: Full-state simulation qubit санын чектейт; биринчи изилдөөдө \(N=12\) practical classical-simulation limit катары колдонулган. Чыныгы NISQ hardware үстүндө кеңири hardware-error benchmark жүргүзүлгөн эмес.
Негизги quantum-advantage чеги: XX-QELMдин high-accuracy режими local entanglement жана shallow effective circuit depth менен байланыштуу жана efficient classical tensor-network simulation менен шайкеш. Бул жыйынтык күчтүү generic quantum advantage дооматын колдобойт.
Негизги нейтрино чектөөсү: ResNet баалоолору realistic, бирок simulated detector datasetsке таянат. Systematic detector uncertainties жана simulation-to-real-data discrepancies чыныгы эксперименттик колдонууда өзүнчө каралышы керек.
QELM–ResNet салыштыруу чеги: Neutrino QELM 60.000 NEUT event жана 20 PCA feature колдонсо, ResNet толук multi-channel images жана кыйла чоң маалымат топтомдорун колдонот. Алардын натыйжалуулугун бирдей input шарттарындагы head-to-head benchmark катары чечмелөөгө болбойт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген