

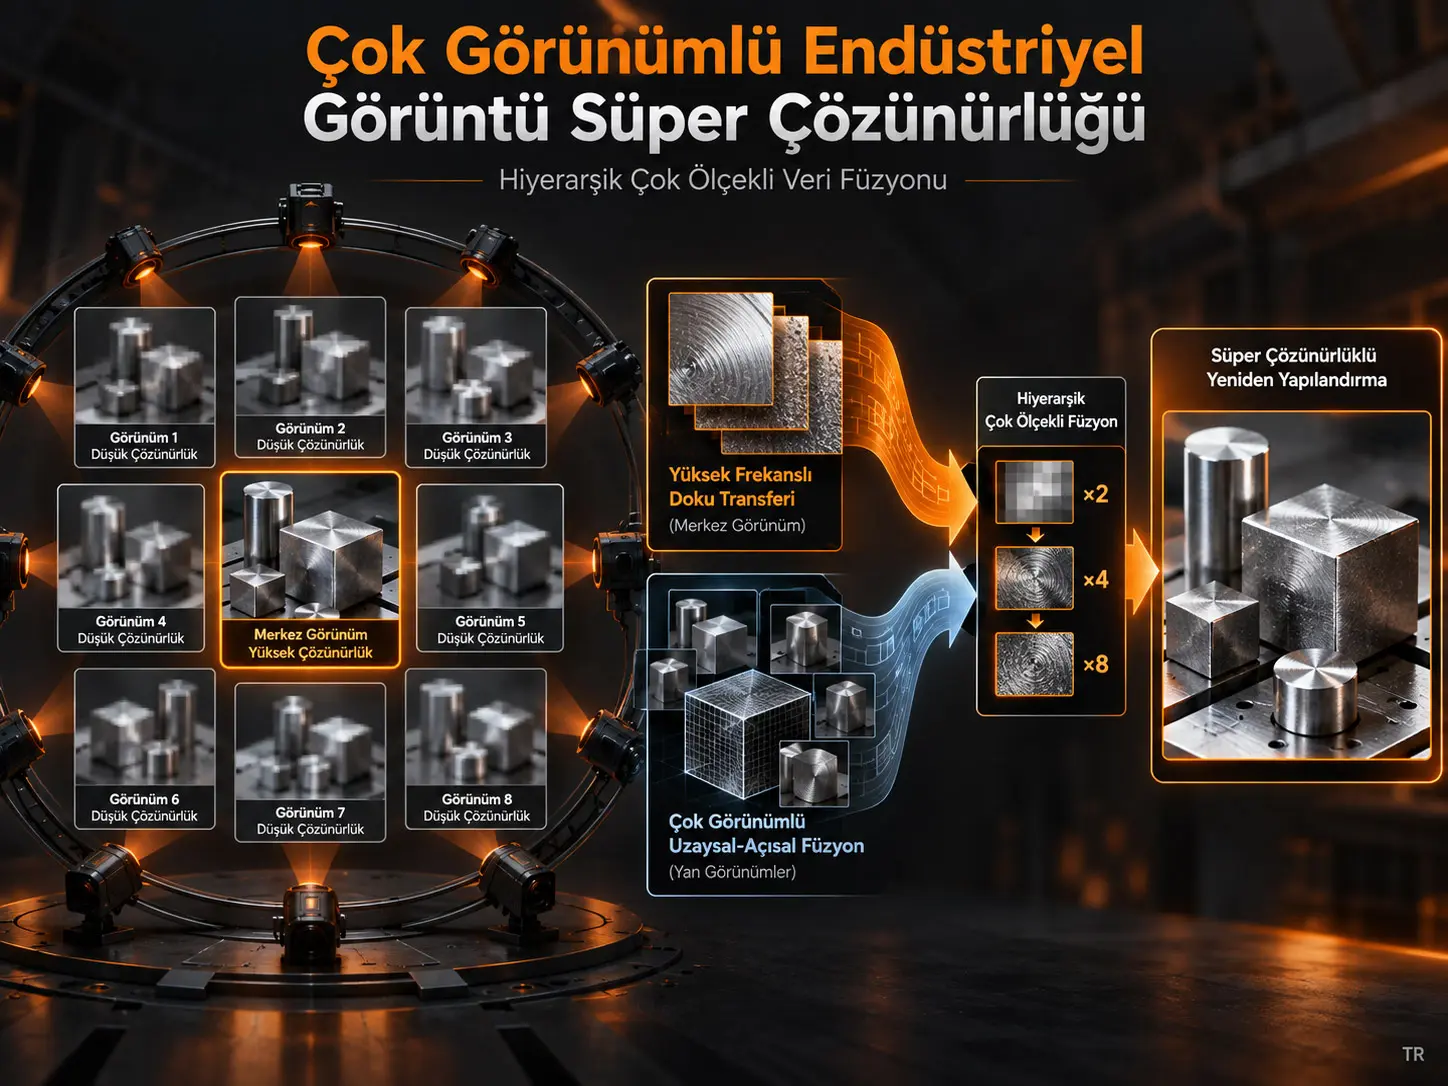
Önerilen hibrid çözünürlüklü çok görünümlü veri füzyon modeli, bir yüksek çözünürlüklü merkez görüntü ile sekiz düşük çözünürlüklü çevre görünümünden yararlanarak endüstriyel metal görüntülerini sekiz kat daha yüksek uzamsal çözünürlüğe taşımayı amaçlayan derin öğrenme tabanlı bir süper-çözünürlük mimarisidir. Sistem, yüksek çözünürlüklü merkez görünümden yüksek frekanslı dokuları aktaran STF (Search and Transfer at Feature Levels) kolunu, farklı düşük çözünürlüklü görünümler arasındaki uzamsal ve açısal tamamlayıcı bilgiyi işleyen SR2I koluyla ×2, ×4 ve ×8 ölçeklerinde aşamalı olarak birleştirir. Sentetik altı test sahnesinde önerilen yöntem ortalama 41,40 dB PSNR ve 0,930 SSIM; gerçek görüntülerde 35,37 dB PSNR ve 0,848 SSIM elde etmiştir. Buna karşın deneyler sabit 3 × 3 görünüm düzeni ve hibrid LR/HR edinim yapısına dayanmaktadır; dolayısıyla sonuçlar doğrudan bütün endüstriyel görüntüleme düzenlerine genellenemez.
Çalışmanın hedeflediği problem özellikle metal iş parçalarında zordur. Yüksek yansıtıcılık, zayıf veya tekrarlayan yüzey dokusu ve farklı kamera açıları arasındaki büyük parallax, hem geleneksel piksel hizalamayı hem de yüksek frekanslı ayrıntının doğru noktaya aktarılmasını güçleştirir. Buna karşılık yalnız tek görüntüden çalışan süper-çözünürlük yöntemleri farklı görüşlerde mevcut olan tamamlayıcı bilgiyi kullanamaz; yalnız düşük çözünürlüklü çoklu görünümleri kullanan yöntemler ise yüksek çözünürlüklü bir referansın sağladığı ince dokudan yararlanamaz.
Önerilen yaklaşım bu iki bilgi kaynağını ayırarak kullanır. STF kolu yüksek çözünürlüklü merkez görünümün ×1, ×2, ×4 ve ×8 ölçekteki özelliklerini çıkarır ve düşük çözünürlüklü yan görünüm bölgeleriyle dikkat tabanlı benzerlik eşleştirmesi yapar. SR2I kolu ise çok görünümlü LR görüntüleri dört boyutlu uzamsal-açısal bir yapı olarak işleyip Spatial–Angular Separable convolutions ile görünüm içi ve görünümler arası bilgiyi birleştirir. Her büyütme aşamasında iki kolun çıktısı kanal boyutunda birleştirilir ve artık blok aracılığıyla füzyon yapılır.
Sentetik veride ortalama PSNR 41,40 dB'ye ulaşmış; bu değer ERVSR'den 4,45 dB ve LFhybridSR'den 8,39 dB yüksektir. Gerçek veri setinde önerilen yöntem 35,37 dB ortalama PSNR ile en yüksek PSNR'lı karşılaştırma yöntemi LFhybridSR'nin 34,19 dB değerini 1,18 dB aşmıştır. Ayrıca gerçek görüntüler üzerinde MiDaS-small kullanılarak yapılan ön deneyde süper-çözünürlük ön işlemi Abs Rel derinlik hatasını 0,5349'dan 0,1024'e düşürmüştür. Bu downstream sonuç, görüntü ayrıntısının derinlik kestirimini destekleyebileceğini gösterir; ancak doğrudan hassas endüstriyel ölçüm doğruluğunun kanıtı değildir.
Çok Görünümlü Endüstriyel Görüntü Süper Çözünürlüğü Nedir?
Çok görünümlü endüstriyel görüntü süper çözünürlüğü, aynı iş parçasını farklı kamera açılarından gösteren görüntülerde bulunan tamamlayıcı uzamsal ve açısal bilgiyi birleştirerek düşük çözünürlüklü görünümlerden daha yüksek uzamsal ayrıntıya sahip görüntüler üretme problemidir.
Süper-çözünürlükte LR (Low Resolution) düşük çözünürlüklü, HR (High Resolution) yüksek çözünürlüklü, SR (Super-Resolved) ise model tarafından yeniden oluşturulan yüksek çözünürlüklü görüntüyü ifade eder.
Tek görüntülü süper-çözünürlükte, yani SISR'da model yalnız bir LR görüntüye dayanır. Bu yaklaşım başka kameralarda görünür halde bulunan ayrıntılardan yararlanamaz ve özellikle büyük büyütme oranlarında aşırı yumuşak sonuçlar üretebilir.
MVISR (Multi-View Image Super-Resolution) ise aynı sahnenin farklı açılardan alınmış görüntülerini birlikte kullanır. Bir ayrıntı belirli bir görünümde yansıma, açı veya düşük kontrast nedeniyle zayıfken başka bir görünümde daha belirgin olabilir.
Çalışma ayrıca bu çoklu LR görüntülerin merkezine tek bir HR referans görünüm yerleştirir. Böylece sistem yalnız çoklu görünüm geometrisini değil, gerçekten yüksek çözünürlüklü bir görüntüde mevcut olan yüksek frekanslı dokuyu da kullanabilir.
Uzamsal çözünürlük ile açısal çözünürlük arasındaki fark
Uzamsal çözünürlük, tek bir görüntüdeki piksel yoğunluğu ve ayrıntı seviyesidir. Açısal çözünürlük ise aynı sahnenin kaç farklı bakış açısından örneklendiğini ve bu görüşlerin nasıl dağıldığını ifade eder.
Bu çalışma açısal çözünürlüğü büyütmeye çalışmaz. Kullanılan görüş düzeni sabit 3 × 3'tür. Araştırmanın amacı bu dokuz görünümün uzamsal çözünürlüğünü yükseltmektir.
Metal yüzeyler neden daha zor?
Yüksek yansıtıcılığa sahip bir metal yüzeyde parlaklık doğrudan yüzey dokusuyla aynı şey değildir. Kamera açısı veya ışık değiştiğinde speküler yansıma da değişir; dolayısıyla aynı fiziksel yüzey parçası farklı görünümlerde büyük fotometrik farklılık gösterebilir.
İkinci sorun düşük dokudur. Düz ve parlak metal bölgelerde patch eşleştirmesinin kullanabileceği ayırt edici yerel desen az olabilir. Üçüncü sorun geniş açılı parallax'tır: yan kamera ile merkez kamera aynı yüzey ayrıntısını görüntünün farklı bölgelerinde ve farklı geometrik görünüşlerde yakalar.
Bu nedenle çalışma doğrudan ham piksel eşleştirmek yerine öğrenilmiş feature space içinde benzerlik aramayı ve güven düşük olduğunda aktarımı similarity score ile bastırmayı tercih etmektedir.
Hibrid Çözünürlüklü Girdi Neden Kullanılıyor?
Hibrid çözünürlüklü girdi, bütün kameraların pahalı HR görüntüler üretmesini gerektirmeden bir merkez HR görünümün yüksek frekanslı dokusunu sekiz çevre LR görünümün çok-açılı geometrik bilgisiyle birleştirmeyi amaçlar.
Gerçek sistemde dokuz deney görünümünün sekizi düşük çözünürlüklüdür; merkez görünüm yüksek çözünürlüklüdür. Bu tasarım, bütün görüşleri HR yakalamanın görüntüleme ve depolama maliyetini üstlenmeden yüksek çözünürlüklü referans bilgisinden yararlanma fikrine dayanır.
Model bu tek HR görünümü doğrudan bütün yan görüntülere yapıştırmaz. Bunun yerine HR ve LR görüntülerden öğrenilmiş özellikler çıkarılır; yan görünümdeki her bölge için merkez görünümdeki en benzer feature patch aranır ve yalnız benzerlik yeterli olduğunda yüksek frekanslı doku daha yüksek ağırlıkla aktarılır.
STF Modülü Yüksek Çözünürlüklü Dokuyu Nasıl Aktarıyor?
STF modülü, düşük çözünürlüklü yan görünüm feature patch'lerini sorgu, merkez görünüm feature patch'lerini anahtar olarak kullanır; normalize edilmiş patch benzerliğine göre en uygun merkez bölgesini seçer ve bu konumun yüksek çözünürlüklü çok-ölçekli özelliklerini yan görünüme aktarır.
İki ayrı encoder neden kullanılıyor?
STF kolunda LR ve HR görüntüler aynı encoder ağırlıklarını paylaşmaz. İki encoder birlikte eğitilir ancak parametreleri ayrıdır.
Merkez HR görüntü encoder'ı dört residual block içerir. Son üç block stride 2 kullanarak feature map boyutunu kademeli biçimde küçültür ve merkez görünümden:
\[ F_{hr_c}^{1},\; F_{hr_c}^{2},\; F_{hr_c}^{4},\; F_{hr_c}^{8} \]
olmak üzere dört ölçekte özellik çıkarır.
LR çoklu görünümler için yalnız ilk feature extraction block'u kullanılır ve:
\[ F_{lr}= \left\{ F_{lr}^{1}, F_{lr}^{2}, \dots, F_{lr}^{n} \right\} \]
biçiminde ×1 ölçekte görünüm özellikleri elde edilir.
Patch benzerliği nasıl hesaplanıyor?
\(i\). yan görünüm feature map'i ile merkez görünüm feature map'i patch'lere ayrılır. Yan görünümdeki \(k\). patch ile merkez görünümdeki \(j\). patch arasındaki benzerlik kaynak Denklem (1)'de normalize edilmiş iç çarpım biçimindedir:
\[ r_{k,j} = \left\langle \frac{P_{lr}^{k}}{\|P_{lr}^{k}\|}, \frac{P_{lr_c}^{j}}{\|P_{lr_c}^{j}\|} \right\rangle . \tag{1} \]
\(P_{lr}^{k}\), yan görünümün \(k\). patch'ini; \(P_{lr_c}^{j}\), merkez görünümün \(j\). patch'ini; \(r_{k,j}\) ise bu iki normalleştirilmiş feature patch arasındaki benzerlik skorunu temsil eder.
Matematiksel olarak bu yapı patch büyüklüğünden çok feature yönelimindeki benzerliği öne çıkarır. Yüksek \(r_{k,j}\), iki patch'in öğrenilmiş özellik uzayında birbirine daha çok benzediğini ifade eder.
En benzer bölge nasıl seçiliyor?
Her yan-görünüm patch'i için en yüksek benzerlik:
\[ S_{lr}^{k} = \max_{j} r_{k,j} \tag{2} \]
ve bu değeri üreten merkez-görünüm patch indeksinin konumu:
\[ N_{lr}^{k} = \arg\max_{j} r_{k,j} \tag{3} \]
ile elde edilir.
\(S_{lr}^{k}\) eşleşmenin güvenini; \(N_{lr}^{k}\) ise merkez HR görüntüde hangi konumdan ayrıntı taşınacağını belirler.
Similarity map neden bir “soft gate” gibi çalışıyor?
Merkez görünümdeki doğru patch bulunduğunda aynı indeks, ×1, ×2, ×4 ve ×8 yüksek çözünürlüklü feature map'lerden doku bilgisini çekmek için kullanılır.
Aktarılan doku feature'ları similarity map ile çarpılır. Güçlü eşleşmeler yüksek ağırlık alırken, speküler yansıma veya dokusuzluk nedeniyle güvenilir karşılığı bulunamayan bölgeler küçük ağırlıklarla bastırılır.
Bu mekanizma, yanlış merkez-görünüm dokusunun yan görünümde güçlü biçimde yerleştirilmesi riskini azaltmayı amaçlamaktadır.
Eşleştirme neden en kaba ölçekte yapılıyor?
Kaynak, feature matching işlemini kaba ölçekte gerçekleştirip bulunan indeksleri bütün transfer ölçeklerinde yeniden kullanmaktadır. Kaba feature map'in tek bir uzamsal noktası daha geniş bir görüntü bölgesinden bilgi topladığı için geniş açılı parallax'ın oluşturduğu küçük hizalama farklarına daha az duyarlı olabilir.
SR2I Kolu Çoklu Görünüm Geometrisini Nasıl Kullanıyor?
SR2I kolu, 3 × 3 LR görünüm grubunu uzamsal \((x,y)\) ve açısal \((u,v)\) boyutlarını birlikte taşıyan dört boyutlu bir tensör olarak işler ve Spatial–Angular Separable convolution bloklarıyla görünüm içi yapı ile görünümler arası ilişkiyi ayrı ayrı çıkarır.
Girdi:
\[ LR_{x,y,u,v} \]
biçiminde düşünülür. Burada \(x,y\) tek görüntü içindeki uzamsal koordinatları; \(u,v\) kamera görünümünün açısal konumunu temsil eder.
Önce spatial convolution her görünüm içinde yerel yapıyı çıkarır. Ardından angular convolution farklı görüşlerdeki feature'lar arasındaki ilişkiyi hesaplar. Sonraki fusion katmanı bu iki bilgi türünü birleştirir.
SR2I önce LR görüntüyü iki kat upsample eder. SAS bloklarının ürettiği feature'lardan, basit upsample edilmiş görüntü ile hedef HR görüntü arasındaki farkı temsil eden residual map tahmin edilir. Residual map upsample edilmiş görüntüye eklenerek çok görünümlü tamamlayıcı bilgi içeren SR sonucu oluşturulur.
STF ve SR2I neden ayrı tutuluyor?
İki kol farklı bilimsel görevler üstlenir. STF, merkez HR referanstan yüksek frekanslı doku transferine odaklanır. SR2I ise sekiz LR çevre görünüm ile merkez LR yapısı arasındaki uzamsal-açısal tutarlılığı kullanarak nesnenin geometrisini ve düşük frekanslı yapısını korumaya çalışır.
Aynı ölçekte üretilen STF ve SR2I tensorları kanal boyutunda birleştirilir ve convolutional residual block üzerinden adaptif füzyona girer. Bu işlem ×2, ×4 ve ×8 aşamalarında tekrarlanır.
×2, ×4 ve ×8 hiyerarşisi
Kaynağın ana mimarisinde doğrudan tek adımda ×8 büyütme yerine kademeli bir süreç kullanılır. İlk aşamada ×2 sonuç, ikinci aşamada ×4 ve son aşamada ×8 sonuç elde edilir.
Merkez HR görüntünün farklı ölçeklerdeki özellikleri STF tarafında her aşamaya uygun yüksek frekans bilgisini sağlarken, SR2I tarafı her aşamada çok görünümlü LR geometrisini işler.
Kaynak, önceki iç içe SR2I yapısının ×4'te kabul edilebilirken ×8 büyütmede belirgin performans kaybettiğini; STF'nin ayrılaştırılıp çok ölçekli feature aktarımı yapılmasının bu nedenle seçildiğini belirtmektedir.
Charbonnier Kayıp Fonksiyonu Neden Üç Ölçekte Hesaplanıyor?
Model ×2, ×4 ve ×8 ölçeklerinde ara SR görüntüler ürettiği için eğitim kaybı yalnız son ×8 çıktısında değil üç ölçeğin tamamında hesaplanan Charbonnier kayıplarının toplamı olarak tanımlanmıştır.
Kaynak Denklem (4):
\[ L = L_{c\times2} + L_{c\times4} + L_{c\times8} \tag{4} \]
ve her ölçek için:
\[ L_{c\times s} = \sqrt{ \left(I_{sr}-I_{hr}\right)^2+\epsilon^2 }. \]
\(I_{sr}\) modelin ürettiği SR görüntüyü, \(I_{hr}\) aynı ölçekteki hedef yüksek çözünürlüklü görüntüyü, \(\epsilon\) ise karekök hesabında sayısal kararsızlığı azaltmak için kullanılan küçük sabiti temsil eder.
Charbonnier kaybı mutlak hatanın düzgünleştirilmiş bir biçimidir. Kaynağın yorumuna göre küçük hata bölgelerinde daha pürüzsüz gradient davranışı sağlarken \(\epsilon\) terimi sayesinde aykırı değerlere L2 kaybına göre daha dayanıklıdır.
Kaynak \(\epsilon\)'in sayısal değerini raporlamamaktadır; bu değer Verianla tarafından varsayılmamıştır.
Çalışmanın Yöntemi ve Bulguları
Veri seti ve deneysel görüntü düzeni
Deneylerde daha önce 6D pose estimation amacıyla yayımlanmış olan Sim-to-Real Dataset of Industrial Metal Objects kullanılmıştır. Veri seti hem gerçek dünya görüntüleri hem de farklı aydınlatma koşullarında oluşturulmuş sentetik görüntüler içerir.
Kaynakta altı endüstriyel nesne türü bulunduğu ve bunların yüksek yansıtıcılığa sahip metal nesneler ile daha az yansıtıcı kırmızı nesneler olarak gruplandırıldığı belirtilmektedir. Nesneler palet, kutu ve karton gibi farklı taşıyıcılar üzerinde farklı istif düzenlerinde görüntülenmiştir.
Gerçek veri toplama sisteminde farklı kameralar endüstriyel robot çevresindeki dairesel yörüngelere yerleştirilmiştir. Toplam 13 görünüm bulunmasına rağmen merkez görüntü ile dış halkadaki sekiz görüntü deney için seçilmiş; iç halkadaki dört görünüm farklı merkez mesafeleri nedeniyle kullanılmamıştır.
Gerçek deney doğrulamasında Intel RealSense L515 RGB görüntüleri kullanılmıştır.
Sentetik veri Unity ortamında oluşturulmuştur. HDRI environment map'leri farklı aydınlatmaları, texture synthesis ise çizik gibi yüzey ayrıntılarını taklit etmektedir. Sentetik üretimin referans gerçek görüntüleri JAI GO-5000-PGE kamera ile elde edilmiştir.
Girdi ve hedef çözünürlükleri
| Veri türü | HR çözünürlük | LR çözünürlük | Açısal çözünürlük |
|---|---|---|---|
| Gerçek görüntü | 1920 × 1080 | 240 × 135 | 3 × 3 |
| Sentetik görüntü | 2560 × 2048 | 320 × 256 | 3 × 3 |
Her iki durumda da HR/LR kenar oranı ×8'dir. Eğitim sırasında cropping, rotation ve flipping veri artırma yöntemleri uygulanmıştır.
Kaynak toplam eğitim, doğrulama ve test örnek sayısını, optimizer'ı, learning rate'i, batch size'ı, epoch sayısını ve eğitim donanımını raporlamamaktadır. Bu nedenle modelin tam eğitim prosedürü yalnız yayımlanmış PDF'den birebir yeniden üretilemez.
Ablasyon çalışması
Kaynak, gerçek dünya verisinde dört mimari bileşeni ayrı ayrı değiştirerek tam modelle karşılaştırmaktadır.
| Varyant | Değişiklik | PSNR (dB) | SSIM | LPIPS |
|---|---|---|---|---|
| A | Ayrı encoderlar yerine weight-shared encoder | 35,30 | 0,847 | 0,226 |
| B | SAS block kaldırıldı | 35,16 | 0,842 | 0,241 |
| C | Fusion module kaldırıldı | 35,17 | 0,840 | 0,244 |
| D | Charbonnier yerine standart L1 loss | 35,33 | 0,847 | 0,227 |
| Tam model | Önerilen yapı | 35,37 | 0,848 | 0,221 |
En büyük bozulmalardan biri SAS block'un kaldırıldığı Variant B ile fusion module'ün kaldırıldığı Variant C'de görülmektedir. Variant A, bağımsız encoder tasarımının küçük fakat tutarlı yararını gösterir. Kaynak ayrıca bağımsız encoderların parametre sayısını artırdığını ve gerçek zamanlı sistemlerde daha hafif tasarımlara ihtiyaç olabileceğini belirtmektedir.
Variant D'nin tam modele yakın fakat biraz daha zayıf olması, Charbonnier kaybının görüntü yeniden yapılandırmasında standart L1'e göre küçük bir katkı sağladığını göstermektedir.
PSNR, SSIM ve LPIPS Sonuçları Birlikte Nasıl Okunmalı?
PSNR piksel düzeyindeki rekonstrüksiyon hatasına, SSIM yapı ve doku benzerliğine, LPIPS ise öğrenilmiş perceptual feature'lar üzerinden algısal benzerliğe odaklandığı için bu metrikler aynı görüntünün farklı kalite boyutlarını ölçer ve tek başına hiçbiri görsel kaliteyi eksiksiz temsil etmez.
Sentetik görüntüler
| Sahne | Bicubic | LFhybridSR | ERVSR | Önerilen yöntem |
|---|---|---|---|---|
| 1 | 33,06 / 0,904 | 33,56 / 0,882 | 37,71 / 0,935 | 42,25 / 0,937 |
| 2 | 32,52 / 0,894 | 33,05 / 0,874 | 36,96 / 0,926 | 41,32 / 0,930 |
| 3 | 31,29 / 0,875 | 31,81 / 0,862 | 35,36 / 0,910 | 39,68 / 0,924 |
| 4 | 32,93 / 0,896 | 33,45 / 0,874 | 37,39 / 0,927 | 41,84 / 0,930 |
| 5 | 33,06 / 0,899 | 33,53 / 0,878 | 37,56 / 0,930 | 42,06 / 0,933 |
| 6 | 32,33 / 0,885 | 32,66 / 0,871 | 36,71 / 0,918 | 41,27 / 0,929 |
| Ortalama | 32,53 / 0,892 | 33,01 / 0,874 | 36,95 / 0,924 | 41,40 / 0,930 |
Önerilen model bütün altı sentetik sahnede en yüksek PSNR'yi vermiştir. Ortalama PSNR, ERVSR'ye kıyasla 4,45 dB ve LFhybridSR'ye kıyasla 8,39 dB daha yüksektir.
Scene 3 bütün yöntemler için en zor sentetik örneklerden biridir. Bu sahnede birden fazla üzerinde yazı bulunan kırmızı blok vardır ve bütün yöntemlerin PSNR/SSIM değerleri diğer sahnelere göre düşer. Önerilen yöntemin PSNR'si burada 39,68 dB'dir.
Scene 3 görsel karşılaştırması
Kaynak Figure 6'daki yan görünüm için önerilen yöntemin RGB sonucu PSNR 35,59, SSIM 0,911 ve LPIPS 0,1502'dir. ERVSR 35,02 / 0,905 / 0,1652; LFhybridSR ise 30,50 / 0,858 / 0,2564 değerlerini vermektedir.
Büyük ve açık yazı alanlarında Bicubic dışındaki yöntemler okunabilir yapıyı daha iyi korurken, koyu bölgelerdeki küçük metin çoğu yöntemde tanınamaz hale gelmektedir. Kaynak, yalnız önerilen yöntemde küçük metnin bazı kenarlarının zayıf biçimde görünür kaldığını belirtmektedir.
Gerçek dünya görüntüleri
| Sahne | Bicubic | LFhybridSR | ERVSR | Önerilen yöntem |
|---|---|---|---|---|
| 1 | 33,39 / 0,755 | 33,60 / 0,747 | 28,56 / 0,785 | 34,73 / 0,814 |
| 2 | 34,36 / 0,823 | 34,50 / 0,808 | 30,67 / 0,855 | 35,88 / 0,878 |
| 3 | 34,19 / 0,816 | 34,21 / 0,797 | 30,05 / 0,847 | 35,53 / 0,869 |
| 4 | 35,86 / 0,841 | 35,73 / 0,837 | 34,59 / 0,856 | 36,61 / 0,870 |
| 5 | 33,86 / 0,796 | 33,98 / 0,781 | 29,22 / 0,830 | 35,24 / 0,855 |
| 6 | 32,94 / 0,734 | 33,14 / 0,724 | 27,97 / 0,769 | 34,23 / 0,799 |
| Ortalama | 34,10 / 0,794 | 34,19 / 0,782 | 30,18 / 0,823 | 35,37 / 0,848 |
Önerilen yöntem altı gerçek sahnenin tamamında en yüksek PSNR ve SSIM değerini üretmiştir. Ortalama PSNR farkı LFhybridSR'ye karşı 1,18 dB, Bicubic'e karşı 1,27 dB ve ERVSR'ye karşı 5,19 dB'dir.
Bununla birlikte metrik sıralaması ile görsel algı her zaman aynı değildir. Kaynak, ERVSR'nin bazı görüntülerde Bicubic'ten daha iyi ayrıntı vermesine rağmen PSNR tablosunda daha düşük değerlere sahip olduğunu açıkça tartışmaktadır.
Bu nedenle “PSNR daha yüksek → görüntünün bütün yönleri kesinlikle daha iyi” şeklindeki tek boyutlu yorum bu çalışmanın kendi görsel analizleriyle de desteklenmez.
Merkez görünüm ile yan görünüm arasındaki fark
Kaynak Figure 7'de merkez görünümlerde LFhybridSR ile önerilen yöntemin özellikle yazı ve metal yüzey dokularında en keskin sonuçları verdiğini belirtmektedir. Bu durum beklenebilir; çünkü merkez görünüm doğrudan HR referansla en güçlü ilişkiye sahiptir.
Figure 8'de yan görünümler daha zordur. Görüş açısı değiştikçe merkez referans ile yan görünüm arasındaki geometri farklılaşır ve speküler yansıma değişir.
Scene 5'in küçük metin alanında kaynak hiçbir yöntemin açık ve kolay tanınabilir metin üretmediğini belirtir. LFhybridSR bazı metal nesne kenarlarında jagged görünüm üretirken ERVSR yan görünümde Bicubic'e göre daha iyi görsel sonuç verebilmektedir. Önerilen yöntem ise merkez ve yan görünümler birlikte değerlendirildiğinde daha dengeli sonuç göstermektedir.
Süper-Çözünürlük Derinlik Kestirimini Ne Ölçüde İyileştirdi?
Gerçek görüntülerde MiDaS-small öncesinde SR ön işleme kullanılması, kaynak deneyinde Abs Rel değerini 0,5349'dan 0,1024'e düşürmüş ve üç \(\delta\) doğruluk ölçütünü belirgin biçimde yükseltmiştir; ancak bu sonuç yalnız kullanılan veri ve MiDaS düzeni için bir downstream görev göstergesidir.
| Girdi | Abs Rel | \(\delta_1\) | \(\delta_2\) | \(\delta_3\) |
|---|---|---|---|---|
| SR görüntü | 0,1024 | 0,8989 | 0,9383 | 0,9521 |
| LR görüntü | 0,5349 | 0,4007 | 0,5951 | 0,6569 |
Kaynağın açıklamasında SR görüntülerde tahmin edilen piksellerin yaklaşık %90'ı, %94'ü ve %95'i sırasıyla 1,25; 1,56 ve 1,95 göreli hata eşiklerinin içinde kalmaktadır.
Bu sonuç, SR ile geri kazanılan kenar ve doku bilgisinin monocular depth modeline daha elverişli giriş sağlayabileceğini desteklemektedir.
Bununla birlikte çalışma gerçek bir hassasiyet ölçüm cihazını, profilometreyi veya koordinat ölçüm sistemini SR öncesi/sonrası karşılaştırmamıştır. Bu nedenle sonuç “SR, endüstriyel ölçüm hatasını 0,5'ten 0,1'e düşürdü” şeklinde genellenmemelidir. Ölçülen değer MiDaS derinlik kestirimindeki Abs Rel hatasıdır.
Çalışmanın desteklediği sonuçlar
Kaynak deneyleri, hibrid HR/LR 3 × 3 çok-görünümlü giriş düzeninde STF tabanlı yüksek frekans texture transferi ile SR2I tabanlı spatial–angular feature fusion'ın birlikte kullanılmasının incelenen metal görüntü veri setinde Bicubic, LFhybridSR ve ERVSR'ye göre daha yüksek PSNR/SSIM sonuçları ürettiğini desteklemektedir.
Ablasyon çalışması ayrı encoderların, SAS block'un, iki kol arasındaki fusion yapısının ve Charbonnier kaybının tam modelin sonuçlarına katkı verdiğini göstermektedir.
Sentetik veride özellikle yüksek PSNR kazancı, modelin kontrollü olarak üretilmiş yüksek kaliteli referans dokuyu etkili biçimde kullanabildiğini göstermektedir.
Gerçek veride daha düşük fakat pozitif PSNR avantajı, yöntem performansının sentetik ortamla sınırlı olmadığını göstermektedir.
MiDaS deneyi, SR'nin belirli bir downstream monocular depth estimation görevinde giriş görüntüsü olarak yararlı olabileceğini göstermektedir.
Çalışmanın desteklemediği sonuçlar
Çalışma yöntemin bütün metal yüzeylerde, bütün kamera geometrilerinde veya bütün endüstriyel tesislerde aynı performansı vereceğini göstermemektedir. Deney düzeni sabit 3 × 3 görünüm yapısına dayanır.
Model yalnız LR görüntülerden çalışan genel bir MVISR sistemi olarak test edilmemiştir. Ana deneyde bir HR merkez referans vardır.
Çalışma gerçek zamanlı üretim hattında throughput, latency, GPU kullanımı veya maksimum işleme hızı benchmarkı sunmamaktadır.
Kaynak eğitimin optimizer, learning rate, batch size, epoch ve donanım ayrıntılarını bildirmediği için tam eğitim yeniden üretilebilirliği sınırlıdır.
PSNR/SSIM sonuçları için tekrarlar, hata çubukları, güven aralıkları veya istatistiksel anlamlılık testleri raporlanmamıştır. Bu nedenle tablo farkları gözlenen deney sonuçlarıdır; istatistiksel üstünlük testi olarak yorumlanmamalıdır.
MiDaS sonucu hassas endüstriyel metroloji doğrulaması değildir. Yalnız monocular depth estimation performansını ölçer.
Kaynak ayrıca yöntemini güncel state-of-the-art reference-based SR yöntemleriyle doğrudan kapsamlı deneysel benchmark içinde karşılaştırmadığını sınırlılık olarak belirtmektedir.
Gelecek çalışma yönleri
Yazarlar ilk olarak değişken angular resolution düzenlerini destekleyen bir mimariye geçilmesini önermektedir. Bu, daha seyrek veya daha yoğun kamera dizilerinde yöntemin ne ölçüde çalışacağını sınamayı mümkün kılabilir.
İkinci yön, yüksek yansıtıcılı metal bölgelerinde texture transferini fiziksel olarak daha iyi sınırlamak için differentiable rendering veya fizik-temelli kısıtlar eklemektir.
Üçüncü yön, daha çeşitli endüstriyel metal nesneleri ve görünüm düzenlerini içeren özel bir çok-görünümlü veri seti oluşturmaktır.
Son olarak yazarlar SR rekonstrüksiyonunu derinlik kestirimi veya precision measurement gibi sonraki görevlerle daha sıkı biçimde birleştirmeyi gelecek çalışma alanı olarak belirtmektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: Multi-View Industrial Image Super-Resolution via Hierarchical Multi-Scale Data Fusion
Yazarlar: Wenqin Zhao; Carman Ka Man Lee; Da Li; Benny Chi Fai Cheung.
Sorumlu yazar: Carman Ka Man Lee.
Kurum: State Key Laboratory of Ultra-Precision Machining Technology ve Department of Industrial and System Engineering, Hong Kong Polytechnic University, Hong Kong, Çin.
Dergi: AI.
Yayınevi: MDPI.
Kaynak türü: Hakemli özgün araştırma makalesi; derin öğrenme tabanlı endüstriyel görüntü süper-çözünürlük çalışması.
Yayın bilgisi: AI 2026, cilt 7, sayı 5, makale 172.
DOI: 10.3390/ai7050172
Gönderim: 13 Mart 2026.
Revizyon: 25 Nisan 2026.
Kabul: 14 Mayıs 2026.
Yayın: 16 Mayıs 2026.
Hakemlik / sürüm: Hakemli dergi makalesi; PolyU kurumsal arşivinde Version of Record olarak kayıtlıdır.
Lisans: Creative Commons Attribution (CC BY), açık erişim.
Veri seti: Sim-to-Real Dataset of Industrial Metal Objects. Kaynak, veri setinin açık erişilebilir olduğunu ve Machines 2024, 12, 99 çalışması üzerinden yayımlandığını belirtmektedir.
Gerçek görüntü kamerası: Intel RealSense L515 RGB.
Sentetik veri için temel gerçek görüntü kamerası: JAI GO-5000-PGE.
Sentetik üretim ortamı: Unity; HDRI environment map ve texture synthesis kullanımı kaynakta belirtilmiştir.
Downstream model: MiDaS-small monocular depth estimation modeli.
Karşılaştırma yöntemleri: Bicubic, LFhybridSR ve ERVSR.
Finansman: Research Impact Fund, Grant No. R5047–22.
Teşekkür: Research Grants Council of the Hong Kong Special Administrative Region, Department of Industrial and Systems Engineering ve State Key Laboratory of Ultra-Precision Machining Technology, The Hong Kong Polytechnic University.
Kurumsal etik kurul: Uygulanabilir değil.
Bilgilendirilmiş onam: Uygulanabilir değil.
Veri erişilebilirliği: Kaynak, verilerin açık erişilebilir olduğunu ve DOI 10.3390/machines12020099 adresindeki veri çalışmasını göstermektedir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmiştir.
Yazar katkıları: Kavramsallaştırma Wenqin Zhao, Da Li ve Carman Ka Man Lee; metodoloji ve yazılım Wenqin Zhao; doğrulama Wenqin Zhao; formal analiz ve araştırma Wenqin Zhao ile Da Li; kaynaklar Wenqin Zhao, Carman Ka Man Lee ve Benny Chi Fai Cheung; veri kürasyonu Wenqin Zhao; ilk taslak Wenqin Zhao; gözden geçirme ve düzenleme Carman Ka Man Lee; görselleştirme Wenqin Zhao; denetim Carman Ka Man Lee; proje yönetimi ve finansman edinimi Benny Chi Fai Cheung tarafından yürütülmüştür.
Yeniden üretilebilirlik notu: PDF optimizer, learning rate, batch size, training epoch sayısı, training hardware ve kesin eğitim/validasyon/test örnek sayılarını raporlamamaktadır. Kaynakta bulunmayan bu parametreler Verianla tarafından tamamlanmamıştır.
Temel yöntemsel sınırlılıklar: Hibrid HR/LR acquisition düzeni varsayımı; sabit 3 × 3 angular resolution; seyrek veya daha yoğun view array'lerin denenmemesi; açık reflectance veya fizik-temelli kısıtların bulunmaması; state-of-the-art reference-based SR yöntemleriyle doğrudan kapsamlı karşılaştırmanın yapılmaması; gerçek zamanlı deployment ölçümlerinin raporlanmaması.
Verianla yöntem notu: Bu içerik kaynak makalenin satır satır çevirisi değildir. Kaynaktaki araştırma problemi, çok-görünümlü hibrid görüntüleme düzeni, STF ve SR2I mimarisi, attention tabanlı patch eşleştirme, Denklem (1)–(4), veri seti ve kamera düzeni, ablasyonlar, PSNR/SSIM/LPIPS sonuçları, görsel değerlendirmeler, MiDaS derinlik kestirimi ve sınırlılıklar korunarak bağımsız bir Türkçe bilimsel öğrenme yapısı oluşturulmuştur. Kaynakta bulunmayan deney, performans, eğitim parametresi veya istatistik eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir