

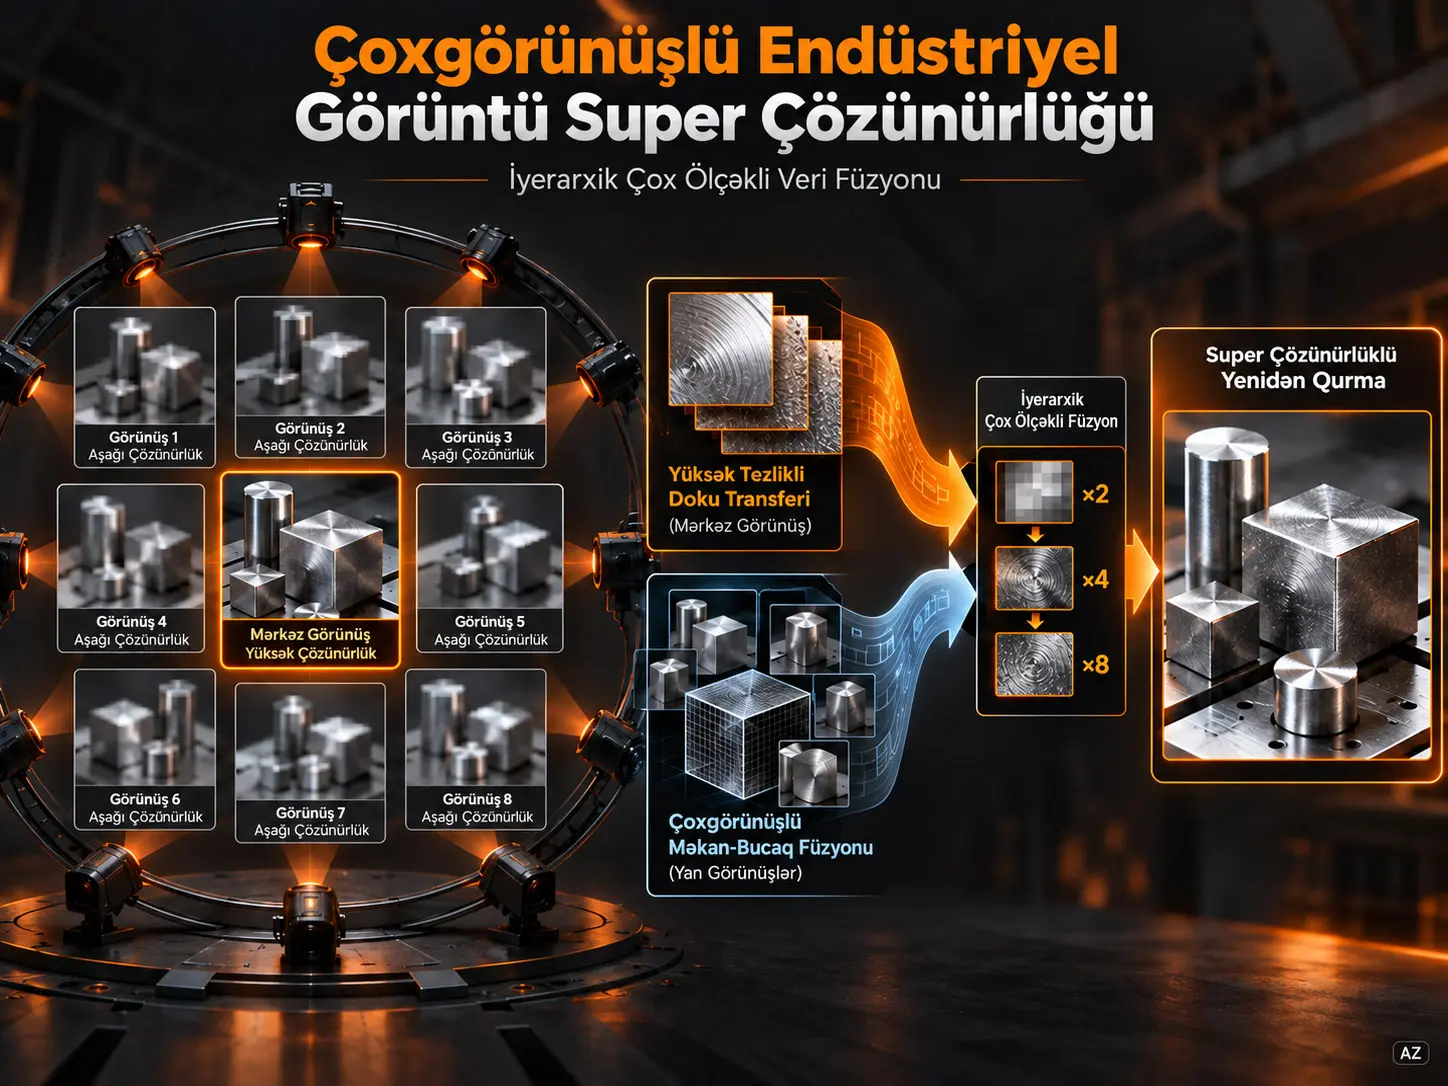
Təklif olunan hibrid ayırdetməli çoxgörünüşlü məlumat füzyonu modeli, bir yüksək ayırdetməli mərkəzi görüntü və səkkiz aşağı ayırdetməli ətraf görünüşdən istifadə etməklə sənaye metal görüntülərini səkkiz dəfə daha yüksək məkan ayırdetməsinə çatdırmağı hədəfləyən dərin öyrənməyə əsaslanan super-ayırdetmə arxitekturasıdır. Sistem, yüksək ayırdetməli mərkəzi görünüşdən yüksək tezlikli teksturaları ötürən STF (Search and Transfer at Feature Levels) qolunu, müxtəlif aşağı ayırdetməli görünüşlər arasındakı məkan və bucaq üzrə tamamlayıcı məlumatı emal edən SR2I qolu ilə ×2, ×4 və ×8 miqyaslarında mərhələli şəkildə birləşdirir. Altı sintetik test səhnəsində təklif olunan üsul orta hesabla 41,40 dB PSNR və 0,930 SSIM; real görüntülərdə isə 35,37 dB PSNR və 0,848 SSIM əldə etmişdir. Bununla belə, təcrübələr sabit 3 × 3 görünüş düzülüşünə və hibrid LR/HR əldəetmə quruluşuna əsaslanır; buna görə də nəticələr birbaşa bütün sənaye görüntüləmə düzənlərinə ümumiləşdirilə bilməz.
Tədqiqatın hədəflədiyi problem xüsusilə metal iş parçalarında çətindir. Yüksək əks etdirmə qabiliyyəti, zəif və ya təkrarlanan səth teksturası və müxtəlif kamera bucaqları arasındakı böyük parallaks həm ənənəvi piksel hizalamasını, həm də yüksək tezlikli detalın düzgün nöqtəyə ötürülməsini çətinləşdirir. Digər tərəfdən yalnız tək görüntü ilə işləyən super-ayırdetmə üsulları müxtəlif görünüşlərdə mövcud olan tamamlayıcı məlumatdan istifadə edə bilmir; yalnız aşağı ayırdetməli çoxsaylı görünüşlərdən istifadə edən üsullar isə yüksək ayırdetməli istinadın verdiyi incə teksturadan yararlana bilmir.
Təklif olunan yanaşma bu iki məlumat mənbəyindən ayrı-ayrılıqda istifadə edir. STF qolu yüksək ayırdetməli mərkəzi görünüşün ×1, ×2, ×4 və ×8 miqyaslarındakı xüsusiyyətlərini çıxarır və aşağı ayırdetməli yan görünüş sahələri ilə diqqət əsaslı oxşarlıq uyğunlaşdırması aparır. SR2I qolu isə çoxgörünüşlü LR görüntülərini dördölçülü məkan-bucaq quruluşu kimi emal edir və Spatial–Angular Separable convolutions vasitəsilə görünüşdaxili və görünüşlərarası məlumatı birləşdirir. Hər böyütmə mərhələsində iki qolun çıxışı kanal ölçüsü üzrə birləşdirilir və residual blok vasitəsilə füzyon edilir.
Sintetik verilərdə orta PSNR 41,40 dB-ə çatmışdır; bu göstərici ERVSR-dən 4,45 dB və LFhybridSR-dən 8,39 dB yüksəkdir. Real verilər dəstində təklif olunan üsul 35,37 dB orta PSNR ilə ən yüksək PSNR-li müqayisə üsulu LFhybridSR-nin 34,19 dB göstəricisini 1,18 dB üstələmişdir. Bundan əlavə, real görüntülərdə MiDaS-small istifadə edilən ilkin təcrübədə super-ayırdetmə ön emalı Abs Rel dərinlik xətasını 0,5349-dan 0,1024-ə endirmişdir. Bu downstream nəticə görüntü detalının dərinlik qiymətləndirilməsini dəstəkləyə biləcəyini göstərir; lakin birbaşa yüksək dəqiqlikli sənaye ölçməsinin doğruluğuna sübut deyil.
Çoxgörünüşlü Sənaye Görüntüsü Super-Ayırdetməsi Nədir?
Çoxgörünüşlü sənaye görüntüsü super-ayırdetməsi, eyni iş parçasını müxtəlif kamera bucaqlarından göstərən görüntülərdəki tamamlayıcı məkan və bucaq məlumatını birləşdirərək aşağı ayırdetməli görünüşlərdən daha yüksək məkan detalına malik görüntülər yaratmaq problemidir.
Super-ayırdetmədə LR (Low Resolution) aşağı ayırdetməni, HR (High Resolution) yüksək ayırdetməni, SR (Super-Resolved) isə model tərəfindən yenidən qurulan yüksək ayırdetməli görüntünü ifadə edir.
Tək görüntülü super-ayırdetmədə, yəni SISR-də model yalnız bir LR görüntüyə əsaslanır. Bu yanaşma başqa kameralarda görünən detallardan istifadə edə bilmir və xüsusilə böyük böyütmə əmsallarında həddən artıq yumşaq nəticələr yarada bilər.
MVISR (Multi-View Image Super-Resolution) isə eyni səhnənin müxtəlif bucaqlardan çəkilmiş görüntülərindən birlikdə istifadə edir. Bir detal müəyyən görünüşdə əks olunma, bucaq və ya aşağı kontrast səbəbindən zəif görünərkən başqa görünüşdə daha aydın ola bilər.
Tədqiqat həmçinin bu çoxsaylı LR görüntülərin mərkəzinə tək bir HR istinad görünüşü yerləşdirir. Beləliklə sistem yalnız çoxgörünüşlü həndəsədən deyil, həqiqətən yüksək ayırdetməli görüntüdə mövcud olan yüksək tezlikli teksturadan da istifadə edə bilir.
Məkan ayırdetməsi ilə bucaq ayırdetməsi arasındakı fərq
Məkan ayırdetməsi tək görüntüdəki piksel sıxlığı və detal səviyyəsidir. Bucaq ayırdetməsi isə eyni səhnənin neçə müxtəlif baxış bucağından nümunələndiyini və bu baxışların necə paylandığını ifadə edir.
Bu tədqiqat bucaq ayırdetməsini artırmağa çalışmır. İstifadə olunan görünüş düzülüşü sabit 3 × 3-dür. Tədqiqatın məqsədi bu doqquz görünüşün məkan ayırdetməsini yüksəltməkdir.
Metal səthlər niyə daha çətindir?
Yüksək əks etdirmə qabiliyyətinə malik metal səthdə parlaqlıq birbaşa səth teksturası ilə eyni şey deyil. Kamera bucağı və ya işıq dəyişdikdə spekulyar əks olunma da dəyişir; buna görə eyni fiziki səth hissəsi müxtəlif görünüşlərdə böyük fotometrik fərqlər göstərə bilər.
İkinci problem aşağı teksturadır. Hamar və parlaq metal sahələrdə patch uyğunlaşdırmasının istifadə edə biləcəyi fərqləndirici yerli naxış az ola bilər. Üçüncü problem geniş bucaqlı parallaksdır: yan kamera ilə mərkəzi kamera eyni səth detalını görüntünün müxtəlif sahələrində və fərqli həndəsi görünüşlərdə tutur.
Buna görə tədqiqat xam pikselləri birbaşa uyğunlaşdırmaq əvəzinə öyrənilmiş feature space daxilində oxşarlıq axtarmağa və etibar aşağı olduqda ötürməni similarity score ilə zəiflətməyə üstünlük verir.
Hibrid Ayırdetməli Giriş Niyə İstifadə Olunur?
Hibrid ayırdetməli giriş bütün kameraların bahalı HR görüntülər yaratmasını tələb etmədən bir mərkəzi HR görünüşün yüksək tezlikli teksturasını səkkiz ətraf LR görünüşün çoxbucaqlı həndəsi məlumatı ilə birləşdirməyi hədəfləyir.
Real sistemdə doqquz təcrübə görünüşündən səkkizi aşağı ayırdetməlidir; mərkəzi görünüş yüksək ayırdetməlidir. Bu dizayn bütün görünüşləri HR çəkməyin görüntüləmə və saxlama xərcini daşımadan yüksək ayırdetməli istinad məlumatından yararlanmaq ideyasına əsaslanır.
Model bu tək HR görünüşü birbaşa bütün yan görüntülərə yapışdırmır. Əvəzində HR və LR görüntülərdən öyrənilmiş xüsusiyyətlər çıxarılır; yan görünüşdəki hər sahə üçün mərkəzi görünüşdəki ən oxşar feature patch axtarılır və yalnız oxşarlıq kifayət qədər yüksək olduqda yüksək tezlikli tekstura daha böyük çəki ilə ötürülür.
STF Modulu Yüksək Ayırdetməli Teksturanı Necə Ötürür?
STF modulu aşağı ayırdetməli yan görünüş feature patch-lərini sorğu, mərkəzi görünüş feature patch-lərini açar kimi istifadə edir; normallaşdırılmış patch oxşarlığına əsasən ən uyğun mərkəzi sahəni seçir və həmin mövqenin yüksək ayırdetməli çoxmiqyaslı xüsusiyyətlərini yan görünüşə ötürür.
Niyə iki ayrı encoder istifadə olunur?
STF qolunda LR və HR görüntülər eyni encoder çəkilərini paylaşmır. İki encoder birlikdə öyrədilir, lakin parametrləri ayrıdır.
Mərkəzi HR görüntü encoder-i dörd residual block ehtiva edir. Son üç block stride 2 istifadə edərək feature map ölçüsünü mərhələli şəkildə kiçildir və mərkəzi görünüşdən:
\[ F_{hr_c}^{1},\; F_{hr_c}^{2},\; F_{hr_c}^{4},\; F_{hr_c}^{8} \]
olmaqla dörd miqyasda xüsusiyyət çıxarır.
LR çoxsaylı görünüşlər üçün yalnız ilk feature extraction block-u istifadə olunur və:
\[ F_{lr}= \left\{ F_{lr}^{1}, F_{lr}^{2}, \dots, F_{lr}^{n} \right\} \]
şəklində ×1 miqyasda görünüş xüsusiyyətləri əldə edilir.
Patch oxşarlığı necə hesablanır?
\(i\). yan görünüş feature map-i ilə mərkəzi görünüş feature map-i patch-lərə bölünür. Yan görünüşdəki \(k\). patch ilə mərkəzi görünüşdəki \(j\). patch arasındakı oxşarlıq mənbənin Tənlik (1)-ində normallaşdırılmış daxili hasil formasındadır:
\[ r_{k,j} = \left\langle \frac{P_{lr}^{k}}{\|P_{lr}^{k}\|}, \frac{P_{lr_c}^{j}}{\|P_{lr_c}^{j}\|} \right\rangle . \tag{1} \]
\(P_{lr}^{k}\) yan görünüşün \(k\). patch-ini; \(P_{lr_c}^{j}\) mərkəzi görünüşün \(j\). patch-ini; \(r_{k,j}\) isə bu iki normallaşdırılmış feature patch arasındakı oxşarlıq skorunu ifadə edir.
Riyazi olaraq bu quruluş patch böyüklüyündən çox feature istiqamətindəki oxşarlığı önə çıxarır. Yüksək \(r_{k,j}\), iki patch-in öyrənilmiş xüsusiyyət fəzasında bir-birinə daha çox bənzədiyini göstərir.
Ən oxşar sahə necə seçilir?
Hər yan-görünüş patch-i üçün ən yüksək oxşarlıq:
\[ S_{lr}^{k} = \max_{j} r_{k,j} \tag{2} \]
və bu dəyəri yaradan mərkəzi-görünüş patch indeksinin mövqeyi:
\[ N_{lr}^{k} = \arg\max_{j} r_{k,j} \tag{3} \]
ilə əldə edilir.
\(S_{lr}^{k}\) uyğunlaşdırmanın etibarını; \(N_{lr}^{k}\) isə mərkəzi HR görüntüdə hansı mövqedən detal daşınacağını müəyyən edir.
Similarity map niyə “soft gate” kimi işləyir?
Mərkəzi görünüşdə düzgün patch tapıldıqda eyni indeks ×1, ×2, ×4 və ×8 yüksək ayırdetməli feature map-lərdən tekstura məlumatını çəkmək üçün istifadə olunur.
Ötürülən tekstura feature-ları similarity map ilə vurulur. Güclü uyğunluqlar yüksək çəki alır, spekulyar əks olunma və ya teksturasızlıq səbəbindən etibarlı qarşılığı tapılmayan sahələr isə kiçik çəkilərlə zəiflədilir.
Bu mexanizm yanlış mərkəzi-görünüş teksturasının yan görünüşə güclü şəkildə yerləşdirilməsi riskini azaltmağı hədəfləyir.
Uyğunlaşdırma niyə ən kobud miqyasda aparılır?
Mənbə feature matching əməliyyatını kobud miqyasda aparır və tapılan indeksləri bütün transfer miqyaslarında yenidən istifadə edir. Kobud feature map-in tək bir məkan nöqtəsi daha geniş görüntü sahəsindən məlumat topladığı üçün geniş bucaqlı parallaksın yaratdığı kiçik hizalama fərqlərinə daha az həssas ola bilər.
SR2I Qolu Çoxgörünüşlü Həndəsədən Necə İstifadə Edir?
SR2I qolu 3 × 3 LR görünüş qrupunu məkan \((x,y)\) və bucaq \((u,v)\) ölçülərini birlikdə daşıyan dördölçülü tensor kimi emal edir və Spatial–Angular Separable convolution blokları ilə görünüşdaxili quruluşu və görünüşlərarası əlaqəni ayrı-ayrılıqda çıxarır.
Giriş:
\[ LR_{x,y,u,v} \]
şəklində nəzərdən keçirilir. Burada \(x,y\) tək görüntü daxilində məkan koordinatlarını; \(u,v\) isə kamera görünüşünün bucaq mövqeyini ifadə edir.
Əvvəlcə spatial convolution hər görünüş daxilində yerli quruluşu çıxarır. Ardınca angular convolution müxtəlif görünüşlərdəki feature-lar arasındakı əlaqəni hesablayır. Sonrakı fusion qatı bu iki məlumat növünü birləşdirir.
SR2I əvvəlcə LR görüntünü iki dəfə upsample edir. SAS bloklarının yaratdığı feature-lardan sadə upsample edilmiş görüntü ilə hədəf HR görüntü arasındakı fərqi ifadə edən residual map qiymətləndirilir. Residual map upsample edilmiş görüntüyə əlavə edilərək çoxgörünüşlü tamamlayıcı məlumat ehtiva edən SR nəticəsi yaradılır.
STF və SR2I niyə ayrı saxlanılır?
İki qol müxtəlif elmi vəzifələr yerinə yetirir. STF mərkəzi HR istinaddan yüksək tezlikli tekstura transferinə fokuslanır. SR2I isə səkkiz LR ətraf görünüşlə mərkəzi LR quruluşu arasındakı məkan-bucaq uyğunluğundan istifadə edərək obyektin həndəsəsini və aşağı tezlikli quruluşunu qorumağa çalışır.
Eyni miqyasda yaradılan STF və SR2I tensorları kanal ölçüsündə birləşdirilir və convolutional residual block vasitəsilə adaptiv füzyona daxil olur. Bu əməliyyat ×2, ×4 və ×8 mərhələlərində təkrarlanır.
×2, ×4 və ×8 iyerarxiyası
Mənbənin əsas arxitekturasında bir addımda birbaşa ×8 böyütmə əvəzinə mərhələli proses istifadə olunur. Birinci mərhələdə ×2 nəticə, ikinci mərhələdə ×4 və son mərhələdə ×8 nəticə əldə edilir.
Mərkəzi HR görüntünün müxtəlif miqyaslardakı xüsusiyyətləri STF tərəfində hər mərhələyə uyğun yüksək tezlikli məlumatı təmin edir, SR2I tərəfi isə hər mərhələdə çoxgörünüşlü LR həndəsəsini emal edir.
Mənbə əvvəlki iç-içə SR2I quruluşunun ×4-də qənaətbəxş olmasına baxmayaraq ×8 böyütmədə nəzərəçarpacaq dərəcədə performans itirdiyini; STF-nin ayrılmasının və çoxmiqyaslı feature transferinin bu səbəbdən seçildiyini bildirir.
Charbonnier İtki Funksiyası Niyə Üç Miqyasda Hesablanır?
Model ×2, ×4 və ×8 miqyaslarında aralıq SR görüntülər yaratdığı üçün təlim itkisi yalnız son ×8 çıxışında deyil, hər üç miqyasda hesablanan Charbonnier itkilərinin cəmi kimi müəyyən edilib.
Mənbə Tənlik (4):
\[ L = L_{c\times2} + L_{c\times4} + L_{c\times8} \tag{4} \]
və hər miqyas üçün:
\[ L_{c\times s} = \sqrt{ \left(I_{sr}-I_{hr}\right)^2+\epsilon^2 }. \]
\(I_{sr}\) modelin yaratdığı SR görüntünü, \(I_{hr}\) eyni miqyasdakı hədəf yüksək ayırdetməli görüntünü, \(\epsilon\) isə kvadrat kök hesablamasında ədədi qeyri-sabitliyi azaltmaq üçün istifadə olunan kiçik sabiti ifadə edir.
Charbonnier itkisi mütləq xətanın hamarlanmış formasıdır. Mənbənin şərhinə görə kiçik xəta sahələrində daha hamar gradient davranışı təmin edir, \(\epsilon\) termini sayəsində isə kənar dəyərlərə L2 itkisindən daha davamlıdır.
Mənbə \(\epsilon\)-in ədədi qiymətini bildirmir; bu dəyər Verianla tərəfindən fərz edilməyib.
Tədqiqatın Metodu və Nəticələri
Verilər dəsti və eksperimental görüntü düzülüşü
Təcrübələrdə əvvəllər 6D pose estimation məqsədi ilə yayımlanmış Sim-to-Real Dataset of Industrial Metal Objects istifadə olunub. Verilər dəsti həm real dünya görüntülərini, həm də müxtəlif işıqlandırma şəraitində yaradılmış sintetik görüntüləri ehtiva edir.
Mənbədə altı sənaye obyekti növünün olduğu və onların yüksək əks etdirmə qabiliyyətli metal obyektlər və daha az əks etdirən qırmızı obyektlər kimi qruplaşdırıldığı bildirilir. Obyektlər palet, qutu və karton kimi müxtəlif daşıyıcıların üzərində müxtəlif yığılma düzülüşlərində görüntülənib.
Real verilərin toplanması sistemində müxtəlif kameralar sənaye robotunun ətrafındakı dairəvi trayektoriyalara yerləşdirilib. Cəmi 13 görünüş olmasına baxmayaraq mərkəzi görüntü ilə xarici halqadakı səkkiz görüntü təcrübə üçün seçilib; daxili halqadakı dörd görünüş mərkəzdən fərqli məsafələrə görə istifadə olunmayıb.
Real təcrübə doğrulamasında Intel RealSense L515 RGB görüntüləri istifadə olunub.
Sintetik verilər Unity mühitində yaradılıb. HDRI environment map-lər müxtəlif işıqlandırmaları, texture synthesis isə cızıq kimi səth detallarını təqlid edir. Sintetik istehsalın istinad real görüntüləri JAI GO-5000-PGE kamera ilə əldə edilib.
Giriş və hədəf ayırdetmələri
| Veri növü | HR ayırdetmə | LR ayırdetmə | Bucaq ayırdetməsi |
|---|---|---|---|
| Real görüntü | 1920 × 1080 | 240 × 135 | 3 × 3 |
| Sintetik görüntü | 2560 × 2048 | 320 × 256 | 3 × 3 |
Hər iki halda HR/LR kənar nisbəti ×8-dir. Təlim zamanı cropping, rotation və flipping verilərin artırılması üsulları tətbiq olunub.
Mənbə ümumi təlim, doğrulama və test nümunələrinin sayını, optimizer-i, learning rate-i, batch size-ı, epoch sayını və təlim avadanlığını bildirmir. Buna görə modelin tam təlim proseduru yalnız yayımlanmış PDF-dən eynilə yenidən yaradıla bilməz.
Ablasiya tədqiqatı
Mənbə real dünya verilərində dörd arxitektura komponentini ayrı-ayrılıqda dəyişdirərək tam modellə müqayisə edir.
| Variant | Dəyişiklik | PSNR (dB) | SSIM | LPIPS |
|---|---|---|---|---|
| A | Ayrı encoder-lər əvəzinə weight-shared encoder | 35,30 | 0,847 | 0,226 |
| B | SAS block çıxarıldı | 35,16 | 0,842 | 0,241 |
| C | Fusion module çıxarıldı | 35,17 | 0,840 | 0,244 |
| D | Charbonnier əvəzinə standart L1 loss | 35,33 | 0,847 | 0,227 |
| Tam model | Təklif olunan quruluş | 35,37 | 0,848 | 0,221 |
Ən böyük pisləşmələrdən biri SAS block-un çıxarıldığı Variant B-də və fusion module-un çıxarıldığı Variant C-də müşahidə olunur. Variant A müstəqil encoder dizaynının kiçik, lakin ardıcıl faydasını göstərir. Mənbə həmçinin müstəqil encoder-lərin parametr sayını artırdığını və real vaxt sistemlərində daha yüngül dizaynlara ehtiyac ola biləcəyini bildirir.
Variant D-nin tam modelə yaxın, lakin bir qədər zəif olması Charbonnier itkisinin görüntü rekonstruksiyasında standart L1-lə müqayisədə kiçik töhfə verdiyini göstərir.
PSNR, SSIM və LPIPS Nəticələri Birlikdə Necə Oxunmalıdır?
PSNR piksel səviyyəsində rekonstruksiya xətasına, SSIM struktur və tekstura oxşarlığına, LPIPS isə öyrənilmiş perceptual feature-lar vasitəsilə qavrayış oxşarlığına fokuslandığı üçün bu metriklər eyni görüntünün müxtəlif keyfiyyət ölçülərini ölçür və heç biri təkbaşına vizual keyfiyyəti tam təmsil etmir.
Sintetik görüntülər
| Səhnə | Bicubic | LFhybridSR | ERVSR | Təklif olunan üsul |
|---|---|---|---|---|
| 1 | 33,06 / 0,904 | 33,56 / 0,882 | 37,71 / 0,935 | 42,25 / 0,937 |
| 2 | 32,52 / 0,894 | 33,05 / 0,874 | 36,96 / 0,926 | 41,32 / 0,930 |
| 3 | 31,29 / 0,875 | 31,81 / 0,862 | 35,36 / 0,910 | 39,68 / 0,924 |
| 4 | 32,93 / 0,896 | 33,45 / 0,874 | 37,39 / 0,927 | 41,84 / 0,930 |
| 5 | 33,06 / 0,899 | 33,53 / 0,878 | 37,56 / 0,930 | 42,06 / 0,933 |
| 6 | 32,33 / 0,885 | 32,66 / 0,871 | 36,71 / 0,918 | 41,27 / 0,929 |
| Orta | 32,53 / 0,892 | 33,01 / 0,874 | 36,95 / 0,924 | 41,40 / 0,930 |
Təklif olunan model bütün altı sintetik səhnədə ən yüksək PSNR-i verib. Orta PSNR ERVSR ilə müqayisədə 4,45 dB və LFhybridSR ilə müqayisədə 8,39 dB yüksəkdir.
Scene 3 bütün üsullar üçün ən çətin sintetik nümunələrdən biridir. Bu səhnədə üzərində yazı olan bir neçə qırmızı blok var və bütün üsulların PSNR/SSIM göstəriciləri digər səhnələrlə müqayisədə azalır. Təklif olunan üsulun PSNR-i burada 39,68 dB-dir.
Scene 3 vizual müqayisəsi
Mənbənin Figure 6-dakı yan görünüşü üçün təklif olunan üsulun RGB nəticəsi PSNR 35,59, SSIM 0,911 və LPIPS 0,1502-dir. ERVSR 35,02 / 0,905 / 0,1652; LFhybridSR isə 30,50 / 0,858 / 0,2564 nəticələrini verib.
Böyük və aydın yazı sahələrində Bicubic-dən başqa üsullar oxunaqlı quruluşu daha yaxşı qoruyur, lakin qaranlıq sahələrdəki kiçik mətn əksər üsullarda tanınmaz hala gəlir. Mənbə yalnız təklif olunan üsulda kiçik mətnin bəzi kənarlarının zəif şəkildə görünən qaldığını bildirir.
Real dünya görüntüləri
| Səhnə | Bicubic | LFhybridSR | ERVSR | Təklif olunan üsul |
|---|---|---|---|---|
| 1 | 33,39 / 0,755 | 33,60 / 0,747 | 28,56 / 0,785 | 34,73 / 0,814 |
| 2 | 34,36 / 0,823 | 34,50 / 0,808 | 30,67 / 0,855 | 35,88 / 0,878 |
| 3 | 34,19 / 0,816 | 34,21 / 0,797 | 30,05 / 0,847 | 35,53 / 0,869 |
| 4 | 35,86 / 0,841 | 35,73 / 0,837 | 34,59 / 0,856 | 36,61 / 0,870 |
| 5 | 33,86 / 0,796 | 33,98 / 0,781 | 29,22 / 0,830 | 35,24 / 0,855 |
| 6 | 32,94 / 0,734 | 33,14 / 0,724 | 27,97 / 0,769 | 34,23 / 0,799 |
| Orta | 34,10 / 0,794 | 34,19 / 0,782 | 30,18 / 0,823 | 35,37 / 0,848 |
Təklif olunan üsul altı real səhnənin hamısında ən yüksək PSNR və SSIM göstəricilərini yaradıb. Orta PSNR fərqi LFhybridSR ilə müqayisədə 1,18 dB, Bicubic ilə müqayisədə 1,27 dB və ERVSR ilə müqayisədə 5,19 dB-dir.
Bununla belə, metrik sıralaması ilə vizual qavrayış həmişə eyni deyil. Mənbə ERVSR-nin bəzi görüntülərdə Bicubic-dən daha yaxşı detal verməsinə baxmayaraq PSNR cədvəlində daha aşağı göstəricilərə malik olduğunu açıq şəkildə müzakirə edir.
Buna görə “PSNR daha yüksək → görüntünün bütün tərəfləri mütləq daha yaxşıdır” şəklində birölçülü şərh bu tədqiqatın öz vizual analizləri ilə də dəstəklənmir.
Mərkəzi görünüşlə yan görünüş arasındakı fərq
Mənbə Figure 7-də mərkəzi görünüşlərdə LFhybridSR ilə təklif olunan üsulun xüsusilə yazı və metal səth teksturalarında ən kəskin nəticələr verdiyini bildirir. Bu vəziyyət gözləniləndir; çünki mərkəzi görünüş birbaşa HR istinadla ən güclü əlaqəyə malikdir.
Figure 8-də yan görünüşlər daha çətindir. Baxış bucağı dəyişdikcə mərkəzi istinadla yan görünüş arasındakı həndəsə fərqlənir və spekulyar əks olunma dəyişir.
Scene 5-in kiçik mətn sahəsində mənbə heç bir üsulun aydın və asan tanınan mətn yaratmadığını bildirir. LFhybridSR bəzi metal obyekt kənarlarında jagged görünüş yaradır, ERVSR isə yan görünüşdə Bicubic ilə müqayisədə daha yaxşı vizual nəticə verə bilir. Təklif olunan üsul isə mərkəzi və yan görünüşlər birlikdə qiymətləndirildikdə daha balanslı nəticə göstərir.
Super-Ayırdetmə Dərinlik Qiymətləndirilməsini Nə Dərəcədə Yaxşılaşdırdı?
Real görüntülərdə MiDaS-small-dan əvvəl SR ön emalının istifadəsi mənbə təcrübəsində Abs Rel göstəricisini 0,5349-dan 0,1024-ə endirib və üç \(\delta\) dəqiqlik ölçüsünü nəzərəçarpacaq dərəcədə artırıb; lakin bu nəticə yalnız istifadə olunan verilər və MiDaS quruluşu üçün downstream tapşırıq göstəricisidir.
| Giriş | Abs Rel | \(\delta_1\) | \(\delta_2\) | \(\delta_3\) |
|---|---|---|---|---|
| SR görüntü | 0,1024 | 0,8989 | 0,9383 | 0,9521 |
| LR görüntü | 0,5349 | 0,4007 | 0,5951 | 0,6569 |
Mənbənin izahında SR görüntülərdə qiymətləndirilən piksellərin təxminən %90-ı, %94-ü və %95-i müvafiq olaraq 1,25; 1,56 və 1,95 nisbi xəta hədlərinin daxilində qalır.
Bu nəticə SR ilə bərpa olunan kənar və tekstura məlumatının monocular depth modelinə daha əlverişli giriş verə biləcəyini dəstəkləyir.
Bununla belə, tədqiqat real yüksək dəqiqlikli ölçmə cihazını, profilometri və ya koordinat ölçmə sistemini SR-dən əvvəl və sonra müqayisə etməyib. Buna görə nəticə “SR sənaye ölçmə xətasını 0,5-dən 0,1-ə endirdi” kimi ümumiləşdirilməməlidir. Ölçülən göstərici MiDaS dərinlik qiymətləndirilməsində Abs Rel xətasıdır.
Tədqiqatın dəstəklədiyi nəticələr
Mənbə təcrübələri hibrid HR/LR 3 × 3 çoxgörünüşlü giriş düzülüşündə STF əsaslı yüksək tezlikli texture transfer ilə SR2I əsaslı spatial–angular feature fusion-ın birlikdə istifadəsinin araşdırılan metal görüntü veriləri dəstində Bicubic, LFhybridSR və ERVSR ilə müqayisədə daha yüksək PSNR/SSIM nəticələri yaratdığını dəstəkləyir.
Ablasiya tədqiqatı ayrı encoder-lərin, SAS block-un, iki qol arasındakı fusion quruluşunun və Charbonnier itkisinin tam modelin nəticələrinə töhfə verdiyini göstərir.
Sintetik verilərdə xüsusilə yüksək PSNR qazancı modelin nəzarətli şəkildə yaradılmış yüksək keyfiyyətli istinad teksturasından səmərəli istifadə edə bildiyini göstərir.
Real verilərdə daha aşağı, lakin müsbət PSNR üstünlüyü üsulun performansının sintetik mühitlə məhdud olmadığını göstərir.
MiDaS təcrübəsi SR-nin müəyyən bir downstream monocular depth estimation tapşırığında giriş görüntüsü kimi faydalı ola biləcəyini göstərir.
Tədqiqatın dəstəkləmədiyi nəticələr
Tədqiqat üsulun bütün metal səthlərdə, bütün kamera həndəsələrində və ya bütün sənaye müəssisələrində eyni performans göstərəcəyini sübut etmir. Təcrübə düzülüşü sabit 3 × 3 görünüş quruluşuna əsaslanır.
Model yalnız LR görüntülərlə işləyən ümumi MVISR sistemi kimi sınaqdan keçirilməyib. Əsas təcrübədə bir HR mərkəzi istinad mövcuddur.
Tədqiqat real vaxt istehsal xəttində throughput, latency, GPU istifadəsi və ya maksimum emal sürəti benchmark-ı təqdim etmir.
Mənbə təlimin optimizer, learning rate, batch size, epoch və hardware detalları barədə məlumat vermədiyi üçün tam təlimin yenidən istehsal oluna bilməsi məhduddur.
PSNR/SSIM nəticələri üçün təkrarlar, xəta çubuqları, etibar intervalları və ya statistik əhəmiyyət testləri bildirilməyib. Buna görə cədvəl fərqləri müşahidə edilmiş eksperimental nəticələrdir; statistik üstünlük testi kimi şərh edilməməlidir.
MiDaS nəticəsi yüksək dəqiqlikli sənaye metrologiyasının doğrulaması deyil. Yalnız monocular depth estimation performansını ölçür.
Mənbə həmçinin üsulunu müasir state-of-the-art reference-based SR üsulları ilə birbaşa geniş eksperimental benchmark-da müqayisə etmədiyini məhdudiyyət kimi qeyd edir.
Gələcək tədqiqat istiqamətləri
Müəlliflər ilk növbədə dəyişən angular resolution düzənlərini dəstəkləyən arxitekturaya keçidi təklif edirlər. Bu, daha seyrək və ya daha sıx kamera massivlərində üsulun nə dərəcədə işlədiyini sınamağa imkan verə bilər.
İkinci istiqamət yüksək əks etdirən metal sahələrdə texture transfer-i fiziki baxımdan daha yaxşı məhdudlaşdırmaq üçün differentiable rendering və ya fizika əsaslı məhdudiyyətlər əlavə etməkdir.
Üçüncü istiqamət daha müxtəlif sənaye metal obyektlərini və görünüş düzənlərini ehtiva edən xüsusi çoxgörünüşlü verilər dəsti yaratmaqdır.
Sonda müəlliflər SR rekonstruksiyasını dərinlik qiymətləndirilməsi və ya precision measurement kimi sonrakı tapşırıqlarla daha sıx birləşdirməyi gələcək tədqiqat sahəsi kimi qeyd edirlər.
Mənbə və Metod Qeydi
Orijinal tədqiqat: Multi-View Industrial Image Super-Resolution via Hierarchical Multi-Scale Data Fusion
Müəlliflər: Wenqin Zhao; Carman Ka Man Lee; Da Li; Benny Chi Fai Cheung.
Məsul müəllif: Carman Ka Man Lee.
Qurum: State Key Laboratory of Ultra-Precision Machining Technology və Department of Industrial and System Engineering, Hong Kong Polytechnic University, Hong Kong, Çin.
Jurnal: AI.
Nəşriyyat: MDPI.
Mənbə növü: Resenziyalı orijinal tədqiqat məqaləsi; dərin öyrənməyə əsaslanan sənaye görüntüsü super-ayırdetmə tədqiqatı.
Nəşr məlumatı: AI 2026, cild 7, nömrə 5, məqalə 172.
DOI: 10.3390/ai7050172
Təqdim: 13 Mart 2026.
Reviziya: 25 Aprel 2026.
Qəbul: 14 May 2026.
Nəşr: 16 May 2026.
Resenziya / versiya: Resenziyalı jurnal məqaləsi; PolyU institusional arxivində Version of Record kimi qeydiyyatdadır.
Lisenziya: Creative Commons Attribution (CC BY), açıq giriş.
Verilər dəsti: Sim-to-Real Dataset of Industrial Metal Objects. Mənbə verilər dəstinin açıq girişli olduğunu və Machines 2024, 12, 99 tədqiqatı vasitəsilə yayımlandığını bildirir.
Real görüntü kamerası: Intel RealSense L515 RGB.
Sintetik verilər üçün əsas real görüntü kamerası: JAI GO-5000-PGE.
Sintetik istehsal mühiti: Unity; HDRI environment map və texture synthesis istifadəsi mənbədə göstərilib.
Downstream model: MiDaS-small monocular depth estimation modeli.
Müqayisə üsulları: Bicubic, LFhybridSR və ERVSR.
Maliyyələşdirmə: Research Impact Fund, Grant No. R5047–22.
Təşəkkür: Research Grants Council of the Hong Kong Special Administrative Region, Department of Industrial and Systems Engineering və State Key Laboratory of Ultra-Precision Machining Technology, The Hong Kong Polytechnic University.
İnstitusional etika şurası: Tətbiq edilmir.
Məlumatlandırılmış razılıq: Tətbiq edilmir.
Verilərin əlçatanlığı: Mənbə verilərin açıq girişli olduğunu və DOI 10.3390/machines12020099 ünvanındakı verilər tədqiqatına istinad edir.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşmasının olmadığını bəyan ediblər.
Müəllif töhfələri: Konseptuallaşdırma Wenqin Zhao, Da Li və Carman Ka Man Lee; metodologiya və proqram təminatı Wenqin Zhao; doğrulama Wenqin Zhao; formal analiz və tədqiqat Wenqin Zhao ilə Da Li; resurslar Wenqin Zhao, Carman Ka Man Lee və Benny Chi Fai Cheung; verilərin kurasiyası Wenqin Zhao; ilkin layihə Wenqin Zhao; nəzərdən keçirmə və redaktə Carman Ka Man Lee; vizuallaşdırma Wenqin Zhao; rəhbərlik Carman Ka Man Lee; layihə idarəçiliyi və maliyyə təminatı Benny Chi Fai Cheung tərəfindən həyata keçirilib.
Yenidən istehsal edilə bilmə qeydi: PDF optimizer, learning rate, batch size, training epoch sayı, training hardware və dəqiq təlim/doğrulama/test nümunə saylarını bildirmir. Mənbədə olmayan bu parametrlər Verianla tərəfindən tamamlanmayıb.
Əsas metodoloji məhdudiyyətlər: Hibrid HR/LR acquisition düzülüşü fərziyyəsi; sabit 3 × 3 angular resolution; seyrək və ya daha sıx view array-lərin sınaqdan keçirilməməsi; açıq reflectance və ya fizika əsaslı məhdudiyyətlərin olmaması; state-of-the-art reference-based SR üsulları ilə birbaşa geniş müqayisənin aparılmaması; real vaxt deployment ölçmələrinin bildirilməməsi.
Verianla metod qeydi: Bu məzmun mənbə məqalənin sətirbəsətir tərcüməsi deyil. Mənbədəki tədqiqat problemi, çoxgörünüşlü hibrid görüntüləmə düzülüşü, STF və SR2I arxitekturası, attention əsaslı patch uyğunlaşdırması, Tənlik (1)–(4), verilər dəsti və kamera düzülüşü, ablasiya təcrübələri, PSNR/SSIM/LPIPS nəticələri, vizual qiymətləndirmələr, MiDaS dərinlik qiymətləndirilməsi və məhdudiyyətlər qorunaraq müstəqil Azərbaycan dilində elmi öyrənmə quruluşu yaradılıb. Mənbədə olmayan təcrübə, performans, təlim parametri və ya statistika əlavə edilməyib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib