

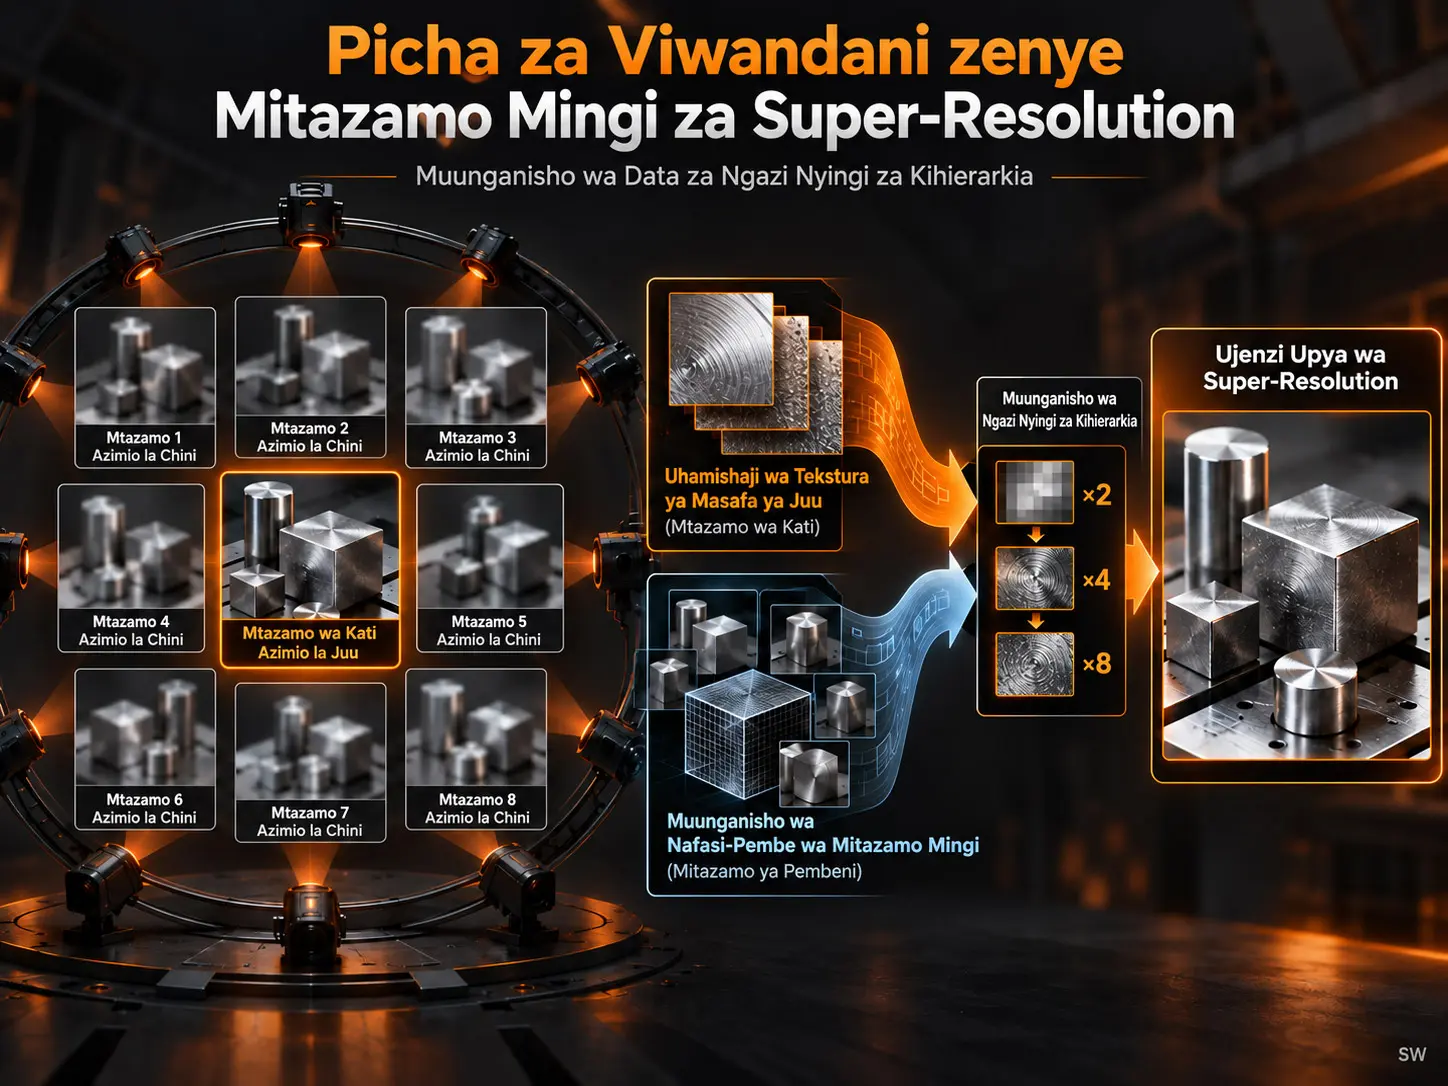
Modeli inayopendekezwa ya muunganisho wa data za mitazamo mingi yenye azimio mseto ni usanifu wa super-resolution unaotegemea deep learning unaolenga kuinua picha za metali za viwandani hadi azimio la anga lililo juu mara nane kwa kutumia picha moja ya katikati yenye azimio la juu na mitazamo minane ya pembeni yenye azimio la chini. Mfumo huunganisha kwa hatua tawi la STF (Search and Transfer at Feature Levels), linalohamisha tekstua za masafa ya juu kutoka mwonekano wa katikati wenye azimio la juu, na tawi la SR2I, linalochakata taarifa za nyongeza za anga na pembe kati ya mitazamo tofauti yenye azimio la chini, katika mizani ya ×2, ×4 na ×8. Katika mandhari sita za majaribio ya sintetiki, mbinu iliyopendekezwa ilipata wastani wa 41,40 dB PSNR na 0,930 SSIM; katika picha halisi ilipata 35,37 dB PSNR na 0,848 SSIM. Hata hivyo, majaribio yanategemea mpangilio thabiti wa mitazamo 3 × 3 na muundo mseto wa upataji LR/HR; kwa hiyo matokeo hayawezi kujumlishwa moja kwa moja kwa mipangilio yote ya upigaji picha viwandani.
Tatizo linalolengwa na utafiti ni gumu hasa kwa vipande vya kazi vya metali. Uakisi mkubwa, tekstua dhaifu au inayojirudia ya uso, na parallaksi kubwa kati ya pembe tofauti za kamera hufanya iwe vigumu kuoanisha pikseli kwa njia za kawaida na pia kuhamisha kwa usahihi undani wa masafa ya juu kwenda sehemu sahihi. Kwa upande mwingine, mbinu za super-resolution zinazotumia picha moja pekee haziwezi kutumia taarifa za nyongeza zilizopo katika mitazamo mingine; na mbinu zinazotumia mitazamo mingi yenye azimio la chini pekee haziwezi kunufaika na tekstua laini inayotolewa na rejeleo lenye azimio la juu.
Mbinu inayopendekezwa hutumia vyanzo hivi viwili vya taarifa kwa kutenganisha majukumu yake. Tawi la STF hutoa features za mwonekano wa katikati wenye azimio la juu katika mizani ya ×1, ×2, ×4 na ×8 na kufanya ulinganishaji wa kufanana unaotegemea attention na maeneo ya mitazamo ya pembeni yenye azimio la chini. Tawi la SR2I huchakata picha za LR za mitazamo mingi kama muundo wa vipimo vinne wa anga-na-pembe na kuunganisha taarifa za ndani ya mwonekano na kati ya mitazamo kupitia Spatial–Angular Separable convolutions. Katika kila hatua ya ukuzaji, matokeo ya matawi mawili huunganishwa katika kipimo cha channel na fusion hufanywa kupitia residual block.
Katika data sintetiki wastani wa PSNR ulifikia 41,40 dB; thamani hii ni 4,45 dB juu kuliko ERVSR na 8,39 dB juu kuliko LFhybridSR. Katika seti ya data halisi, mbinu iliyopendekezwa ilipata wastani wa PSNR wa 35,37 dB na kuzidi kwa 1,18 dB thamani ya 34,19 dB ya LFhybridSR, ambayo ilikuwa mbinu ya kulinganisha yenye PSNR ya juu zaidi. Zaidi ya hayo, katika jaribio la awali kwenye picha halisi kwa kutumia MiDaS-small, uchakataji wa awali wa super-resolution ulipunguza kosa la kina la Abs Rel kutoka 0,5349 hadi 0,1024. Matokeo haya ya downstream yanaonyesha kwamba undani wa picha unaweza kusaidia ukadiriaji wa kina; lakini si ushahidi wa moja kwa moja wa usahihi wa vipimo vya viwandani vya hali ya juu.
Super-Resolution ya Picha za Viwandani zenye Mitazamo Mingi ni Nini?
Super-resolution ya picha za viwandani zenye mitazamo mingi ni tatizo la kutengeneza picha zenye undani mkubwa zaidi wa anga kutoka kwenye mitazamo yenye azimio la chini kwa kuunganisha taarifa za nyongeza za anga na pembe zilizopo katika picha zinazoonyesha kifaa au kipande kilekile cha kazi kutoka pembe tofauti za kamera.
Katika super-resolution, LR (Low Resolution) humaanisha azimio la chini, HR (High Resolution) azimio la juu, na SR (Super-Resolved) picha yenye azimio la juu iliyojengwa upya na modeli.
Katika super-resolution ya picha moja, yaani SISR, modeli hutegemea picha moja tu ya LR. Mbinu hii haiwezi kutumia undani unaoonekana katika kamera nyingine na hasa katika viwango vikubwa vya ukuzaji inaweza kutoa matokeo laini kupita kiasi.
MVISR (Multi-View Image Super-Resolution) hutumia kwa pamoja picha za tukio lilelile zilizopigwa kutoka pembe tofauti. Undani ambao katika mwonekano mmoja ni dhaifu kwa sababu ya uakisi, pembe au contrast ndogo unaweza kuwa wazi zaidi katika mwonekano mwingine.
Utafiti pia huweka mwonekano mmoja wa rejeleo wa HR katikati ya picha hizi nyingi za LR. Hivyo mfumo unaweza kutumia si tu jiometria ya mitazamo mingi bali pia tekstua ya masafa ya juu iliyopo kweli katika picha yenye azimio la juu.
Tofauti kati ya azimio la anga na azimio la pembe
Azimio la anga ni msongamano wa pikseli na kiwango cha undani ndani ya picha moja. Azimio la pembe linaeleza tukio lilelile limechukuliwa sampuli kutoka mitazamo mingapi tofauti na jinsi mitazamo hiyo ilivyosambazwa.
Utafiti huu haujaribu kuongeza azimio la pembe. Mpangilio wa mitazamo unaotumiwa ni thabiti wa 3 × 3. Lengo la utafiti ni kuongeza azimio la anga la mitazamo hiyo tisa.
Kwa nini nyuso za metali ni ngumu zaidi?
Katika uso wa metali wenye uakisi mkubwa, mwangaza si sawa moja kwa moja na tekstua ya uso. Pembe ya kamera au mwanga unapobadilika, uakisi wa specular pia hubadilika; kwa hiyo sehemu ileile ya uso wa kimwili inaweza kuonyesha tofauti kubwa za photometric katika mitazamo tofauti.
Tatizo la pili ni tekstua ndogo. Katika maeneo laini na yanayong’aa ya metali, kunaweza kuwa na mifumo michache ya ndani yenye kutofautisha ambayo patch matching inaweza kutumia. Tatizo la tatu ni parallaksi ya pembe pana: kamera ya pembeni na kamera ya katikati hunasa undani uleule wa uso katika maeneo tofauti ya picha na katika mwonekano tofauti wa kijiometri.
Kwa hiyo utafiti unapendelea kutafuta kufanana ndani ya feature space iliyojifunzwa badala ya kulinganisha moja kwa moja pikseli ghafi, na kupunguza uhamishaji kwa similarity score pale uaminifu unapokuwa mdogo.
Kwa Nini Inatumika Input yenye Azimio Mseto?
Input yenye azimio mseto inalenga kuunganisha tekstua ya masafa ya juu kutoka mwonekano mmoja wa katikati wa HR na taarifa ya kijiometri ya pembe nyingi kutoka mitazamo minane ya pembeni ya LR bila kuhitaji kamera zote kuzalisha picha za HR zenye gharama kubwa.
Katika mfumo halisi, mitazamo minane kati ya tisa ya majaribio ina azimio la chini; mwonekano wa katikati una azimio la juu. Muundo huu unatokana na wazo la kutumia taarifa ya rejeleo yenye azimio la juu bila kubeba gharama ya kupiga na kuhifadhi mitazamo yote katika HR.
Modeli haibandiki moja kwa moja mwonekano huu mmoja wa HR kwenye picha zote za pembeni. Badala yake features zilizojifunzwa hutolewa kutoka picha za HR na LR; kwa kila eneo la mwonekano wa pembeni hutafutwa feature patch inayofanana zaidi katika mwonekano wa katikati, na tekstua ya masafa ya juu huhamishwa kwa uzito mkubwa tu pale kiwango cha kufanana kinapokuwa cha kutosha.
Moduli ya STF Inahamishaje Tekstua yenye Azimio la Juu?
Moduli ya STF hutumia feature patch za mwonekano wa pembeni wenye azimio la chini kama query na feature patch za mwonekano wa katikati kama key; huchagua eneo la katikati linalofaa zaidi kulingana na ufanano wa patch uliorekebishwa na kuhamisha features za azimio la juu za mizani mingi kutoka eneo hilo kwenda mwonekano wa pembeni.
Kwa nini encoder mbili tofauti hutumiwa?
Katika tawi la STF, picha za LR na HR hazishiriki uzito wa encoder moja. Encoder mbili hufundishwa pamoja lakini parameters zake ni tofauti.
Encoder ya picha ya katikati ya HR ina residual block nne. Block tatu za mwisho hutumia stride 2 kupunguza hatua kwa hatua ukubwa wa feature map na kutoa kutoka mwonekano wa katikati:
\[ F_{hr_c}^{1},\; F_{hr_c}^{2},\; F_{hr_c}^{4},\; F_{hr_c}^{8} \]
features katika mizani minne.
Kwa mitazamo mingi ya LR, feature extraction block ya kwanza pekee hutumiwa na:
\[ F_{lr}= \left\{ F_{lr}^{1}, F_{lr}^{2}, \dots, F_{lr}^{n} \right\} \]
features za mwonekano katika mizani ya ×1 hupatikana.
Ufanano wa patch huhesabiwaje?
Feature map ya mwonekano wa pembeni wa \(i\) na feature map ya mwonekano wa katikati hugawanywa kuwa patch. Ufanano kati ya patch ya \(k\) ya mwonekano wa pembeni na patch ya \(j\) ya mwonekano wa katikati umefafanuliwa katika Equation (1) ya chanzo kama inner product iliyorekebishwa:
\[ r_{k,j} = \left\langle \frac{P_{lr}^{k}}{\|P_{lr}^{k}\|}, \frac{P_{lr_c}^{j}}{\|P_{lr_c}^{j}\|} \right\rangle . \tag{1} \]
\(P_{lr}^{k}\) inawakilisha patch ya \(k\) ya mwonekano wa pembeni; \(P_{lr_c}^{j}\) patch ya \(j\) ya mwonekano wa katikati; na \(r_{k,j}\) alama ya kufanana kati ya feature patch hizi mbili zilizorekebishwa.
Kihisabati, muundo huu huweka mbele zaidi ufanano katika mwelekeo wa feature kuliko ukubwa wa patch. \(r_{k,j}\) ya juu humaanisha kwamba patch hizo mbili zinafanana zaidi katika nafasi ya features iliyojifunzwa.
Eneo linalofanana zaidi huchaguliwaje?
Kwa kila patch ya mwonekano wa pembeni, ufanano wa juu zaidi:
\[ S_{lr}^{k} = \max_{j} r_{k,j} \tag{2} \]
na mahali pa index ya patch ya mwonekano wa katikati inayotoa thamani hiyo:
\[ N_{lr}^{k} = \arg\max_{j} r_{k,j} \tag{3} \]
hupatikana.
\(S_{lr}^{k}\) huonyesha uaminifu wa ulinganishaji; \(N_{lr}^{k}\) huamua undani uhamishwe kutoka mahali gani katika picha ya katikati ya HR.
Kwa nini similarity map hufanya kazi kama “soft gate”?
Patch sahihi inapopatikana katika mwonekano wa katikati, index ileile hutumiwa kuvuta taarifa ya tekstua kutoka feature map za azimio la juu za ×1, ×2, ×4 na ×8.
Feature za tekstua zilizohamishwa huzidishwa na similarity map. Ulinganifu wenye nguvu hupata uzito mkubwa, huku maeneo ambayo hayana ulinganifu wa kuaminika kwa sababu ya uakisi wa specular au ukosefu wa tekstua yakipunguzwa kwa uzito mdogo.
Utaratibu huu unalenga kupunguza hatari ya kuweka kwa nguvu tekstua isiyo sahihi kutoka mwonekano wa katikati kwenye mwonekano wa pembeni.
Kwa nini ulinganishaji hufanywa katika kiwango cha jumla zaidi?
Chanzo hufanya feature matching katika kiwango cha coarse na kutumia tena index zilizopatikana katika mizani yote ya transfer. Kwa sababu sehemu moja ya anga katika coarse feature map hukusanya taarifa kutoka eneo pana zaidi la picha, inaweza kuwa na unyeti mdogo kwa tofauti ndogo za alignment zinazotokana na parallaksi ya pembe pana.
Tawi la SR2I Linatumiaje Jiometria ya Mitazamo Mingi?
Tawi la SR2I huchakata kundi la mitazamo 3 × 3 ya LR kama tensor ya vipimo vinne inayobeba pamoja vipimo vya anga \((x,y)\) na vya pembe \((u,v)\), na kutumia Spatial–Angular Separable convolution blocks kutoa kando muundo wa ndani ya mwonekano na uhusiano kati ya mitazamo.
Input:
\[ LR_{x,y,u,v} \]
huchukuliwa katika namna hii. Hapa \(x,y\) huwakilisha coordinates za anga ndani ya picha moja; \(u,v\) huwakilisha nafasi ya pembe ya mwonekano wa kamera.
Kwanza spatial convolution hutoa muundo wa ndani katika kila mwonekano. Kisha angular convolution huhesabu uhusiano kati ya feature za mitazamo tofauti. Fusion layer inayofuata huunganisha aina hizi mbili za taarifa.
SR2I kwanza hu-upsample picha ya LR mara mbili. Kutokana na feature zinazotolewa na SAS blocks, hukadiriwa residual map inayowakilisha tofauti kati ya picha iliyofanyiwa upsample rahisi na picha lengwa ya HR. Residual map huongezwa kwenye picha iliyofanyiwa upsample ili kuunda matokeo ya SR yenye taarifa za nyongeza za mitazamo mingi.
Kwa nini STF na SR2I hutenganishwa?
Matawi haya mawili yana majukumu tofauti ya kisayansi. STF inalenga uhamishaji wa tekstua za masafa ya juu kutoka rejeleo la katikati la HR. SR2I hutumia uwiano wa anga-na-pembe kati ya mitazamo minane ya pembeni ya LR na muundo wa katikati wa LR ili kujaribu kuhifadhi jiometria ya kitu na muundo wa masafa ya chini.
Tensor za STF na SR2I zinazozalishwa katika kiwango kilekile huunganishwa katika kipimo cha channel na kuingia kwenye fusion inayobadilika kupitia convolutional residual block. Mchakato huu hurudiwa katika hatua za ×2, ×4 na ×8.
Hierarkia ya ×2, ×4 na ×8
Katika usanifu mkuu wa chanzo, badala ya kuongeza moja kwa moja ×8 kwa hatua moja, hutumiwa mchakato wa hatua kwa hatua. Hatua ya kwanza hutoa matokeo ya ×2, ya pili ×4 na hatua ya mwisho ×8.
Features za picha ya katikati ya HR katika mizani tofauti hutoa taarifa inayofaa ya masafa ya juu kwa kila hatua upande wa STF, huku upande wa SR2I ukichakata jiometria ya LR ya mitazamo mingi katika kila hatua.
Chanzo kinaeleza kuwa muundo wa awali wa SR2I uliokuwa nested ulikuwa wa kukubalika katika ×4 lakini ulipoteza utendaji kwa kiasi kikubwa katika ukuzaji wa ×8; kwa sababu hiyo STF ilitenganishwa na uhamishaji wa feature za mizani mingi ukachaguliwa.
Kwa Nini Loss Function ya Charbonnier Huhesabiwa Katika Mizani Mitatu?
Kwa sababu modeli huzalisha picha za kati za SR katika mizani ya ×2, ×4 na ×8, loss ya mafunzo imefafanuliwa si katika output ya mwisho ya ×8 pekee bali kama jumla ya loss za Charbonnier zinazohesabiwa katika mizani yote mitatu.
Equation (4) ya chanzo:
\[ L = L_{c\times2} + L_{c\times4} + L_{c\times8} \tag{4} \]
na kwa kila scale:
\[ L_{c\times s} = \sqrt{ \left(I_{sr}-I_{hr}\right)^2+\epsilon^2 }. \]
\(I_{sr}\) huwakilisha picha ya SR iliyotengenezwa na modeli, \(I_{hr}\) picha lengwa yenye azimio la juu katika scale ileile, na \(\epsilon\) ni constant ndogo inayotumiwa kupunguza numerical instability katika hesabu ya square root.
Charbonnier loss ni toleo lililosawazishwa la absolute error. Kulingana na tafsiri ya chanzo, hutoa gradient behavior laini zaidi katika maeneo yenye kosa dogo na, kwa sababu ya term ya \(\epsilon\), huwa na ustahimilivu mkubwa kwa outlier values kuliko L2 loss.
Chanzo hakiripoti thamani ya namba ya \(\epsilon\); thamani hii haijakisiwa na Verianla.
Mbinu na Matokeo ya Utafiti
Seti ya data na mpangilio wa majaribio wa upigaji picha
Katika majaribio ilitumika Sim-to-Real Dataset of Industrial Metal Objects, ambayo hapo awali ilichapishwa kwa madhumuni ya 6D pose estimation. Seti ya data ina picha za ulimwengu halisi pamoja na picha sintetiki zilizoundwa katika hali tofauti za mwanga.
Chanzo kinaeleza kuwa kuna aina sita za vitu vya viwandani na kwamba zimegawanywa katika vitu vya metali vyenye uakisi mkubwa na vitu vyekundu vyenye uakisi mdogo. Vitu vilipigwa picha kwenye vibebea mbalimbali kama pallet, box na carton katika mipangilio tofauti ya kupanga.
Katika mfumo wa kukusanya data halisi, kamera tofauti ziliwekwa katika trajectories za mviringo kuzunguka roboti ya viwandani. Ingawa kulikuwa na mitazamo 13 kwa jumla, picha ya katikati na picha nane za duara la nje zilichaguliwa kwa majaribio; mitazamo minne ya duara la ndani haikutumiwa kwa sababu ya tofauti za umbali kutoka katikati.
Katika uthibitishaji wa majaribio ya kweli zilitumika picha za Intel RealSense L515 RGB.
Data sintetiki iliundwa katika mazingira ya Unity. HDRI environment maps huiga hali tofauti za mwanga, na texture synthesis huiga undani wa uso kama mikwaruzo. Picha halisi za rejeleo kwa ajili ya uzalishaji sintetiki zilipatikana kwa kamera ya JAI GO-5000-PGE.
Azimio la input na target
| Aina ya data | Azimio la HR | Azimio la LR | Azimio la pembe |
|---|---|---|---|
| Picha halisi | 1920 × 1080 | 240 × 135 | 3 × 3 |
| Picha sintetiki | 2560 × 2048 | 320 × 256 | 3 × 3 |
Katika hali zote mbili uwiano wa ukingo wa HR/LR ni ×8. Wakati wa mafunzo zilitumika mbinu za data augmentation cropping, rotation na flipping.
Chanzo hakiripoti jumla ya idadi ya samples za training, validation na test, optimizer, learning rate, batch size, idadi ya epoch au training hardware. Kwa hiyo taratibu kamili za mafunzo ya modeli haziwezi kutengenezwa upya sawasawa kutoka PDF iliyochapishwa pekee.
Utafiti wa ablation
Chanzo hubadilisha kando vipengele vinne vya usanifu kwenye data za ulimwengu halisi na kulinganisha kila kimoja na modeli kamili.
| Variant | Mabadiliko | PSNR (dB) | SSIM | LPIPS |
|---|---|---|---|---|
| A | Weight-shared encoder badala ya encoder tofauti | 35,30 | 0,847 | 0,226 |
| B | SAS block imeondolewa | 35,16 | 0,842 | 0,241 |
| C | Fusion module imeondolewa | 35,17 | 0,840 | 0,244 |
| D | Standard L1 loss badala ya Charbonnier | 35,33 | 0,847 | 0,227 |
| Modeli kamili | Muundo uliopendekezwa | 35,37 | 0,848 | 0,221 |
Mojawapo ya kuzorota kubwa huonekana katika Variant B ambako SAS block imeondolewa na Variant C ambako fusion module imeondolewa. Variant A inaonyesha faida ndogo lakini thabiti ya kutumia encoder huru. Chanzo pia kinaeleza kuwa encoder huru huongeza idadi ya parameters na kwamba mifumo ya muda halisi inaweza kuhitaji miundo myepesi zaidi.
Ukweli kwamba Variant D iko karibu na modeli kamili lakini ni dhaifu kidogo unaonyesha kuwa Charbonnier loss hutoa mchango mdogo katika image reconstruction ikilinganishwa na standard L1.
Matokeo ya PSNR, SSIM na LPIPS Yasomweje Pamoja?
Kwa kuwa PSNR hulenga kosa la reconstruction katika kiwango cha pixel, SSIM hulenga kufanana kwa structure na texture, na LPIPS hulenga perceptual similarity kupitia learned perceptual features, metrics hizi hupima vipengele tofauti vya ubora wa picha ileile na hakuna hata moja inayowakilisha kikamilifu ubora wa kuona peke yake.
Picha sintetiki
| Mandhari | Bicubic | LFhybridSR | ERVSR | Mbinu iliyopendekezwa |
|---|---|---|---|---|
| 1 | 33,06 / 0,904 | 33,56 / 0,882 | 37,71 / 0,935 | 42,25 / 0,937 |
| 2 | 32,52 / 0,894 | 33,05 / 0,874 | 36,96 / 0,926 | 41,32 / 0,930 |
| 3 | 31,29 / 0,875 | 31,81 / 0,862 | 35,36 / 0,910 | 39,68 / 0,924 |
| 4 | 32,93 / 0,896 | 33,45 / 0,874 | 37,39 / 0,927 | 41,84 / 0,930 |
| 5 | 33,06 / 0,899 | 33,53 / 0,878 | 37,56 / 0,930 | 42,06 / 0,933 |
| 6 | 32,33 / 0,885 | 32,66 / 0,871 | 36,71 / 0,918 | 41,27 / 0,929 |
| Wastani | 32,53 / 0,892 | 33,01 / 0,874 | 36,95 / 0,924 | 41,40 / 0,930 |
Modeli iliyopendekezwa ilitoa PSNR ya juu zaidi katika mandhari zote sita za sintetiki. Wastani wa PSNR ni 4,45 dB juu kuliko ERVSR na 8,39 dB juu kuliko LFhybridSR.
Scene 3 ni moja ya mifano migumu zaidi ya sintetiki kwa mbinu zote. Mandhari hii ina blocks kadhaa nyekundu zenye maandishi na viwango vya PSNR/SSIM vya mbinu zote hushuka ukilinganisha na mandhari nyingine. PSNR ya mbinu iliyopendekezwa hapa ni 39,68 dB.
Ulinganisho wa kuona wa Scene 3
Kwa mwonekano wa pembeni katika Figure 6 ya chanzo, matokeo ya RGB ya mbinu iliyopendekezwa ni PSNR 35,59, SSIM 0,911 na LPIPS 0,1502. ERVSR ilitoa 35,02 / 0,905 / 0,1652; LFhybridSR ilitoa 30,50 / 0,858 / 0,2564.
Katika maeneo yenye maandishi makubwa na wazi, mbinu nyingine isipokuwa Bicubic huhifadhi vizuri zaidi muundo unaoweza kusomeka, lakini maandishi madogo katika maeneo meusi huwa hayatambuliki katika mbinu nyingi. Chanzo kinaeleza kuwa katika mbinu iliyopendekezwa pekee baadhi ya kingo za maandishi madogo hubaki kuonekana kwa udhaifu.
Picha za ulimwengu halisi
| Mandhari | Bicubic | LFhybridSR | ERVSR | Mbinu iliyopendekezwa |
|---|---|---|---|---|
| 1 | 33,39 / 0,755 | 33,60 / 0,747 | 28,56 / 0,785 | 34,73 / 0,814 |
| 2 | 34,36 / 0,823 | 34,50 / 0,808 | 30,67 / 0,855 | 35,88 / 0,878 |
| 3 | 34,19 / 0,816 | 34,21 / 0,797 | 30,05 / 0,847 | 35,53 / 0,869 |
| 4 | 35,86 / 0,841 | 35,73 / 0,837 | 34,59 / 0,856 | 36,61 / 0,870 |
| 5 | 33,86 / 0,796 | 33,98 / 0,781 | 29,22 / 0,830 | 35,24 / 0,855 |
| 6 | 32,94 / 0,734 | 33,14 / 0,724 | 27,97 / 0,769 | 34,23 / 0,799 |
| Wastani | 34,10 / 0,794 | 34,19 / 0,782 | 30,18 / 0,823 | 35,37 / 0,848 |
Mbinu iliyopendekezwa ilitoa viwango vya juu zaidi vya PSNR na SSIM katika mandhari zote sita halisi. Tofauti ya wastani wa PSNR ni 1,18 dB dhidi ya LFhybridSR, 1,27 dB dhidi ya Bicubic na 5,19 dB dhidi ya ERVSR.
Hata hivyo, mpangilio wa metrics na perception ya kuona si kila mara sawa. Chanzo kinajadili wazi kwamba ERVSR katika baadhi ya picha hutoa undani bora kuliko Bicubic lakini ina viwango vya chini zaidi kwenye jedwali la PSNR.
Kwa hiyo tafsiri ya upande mmoja kama “PSNR ikiwa juu zaidi → vipengele vyote vya picha lazima viwe bora zaidi” haiungwi mkono hata na uchambuzi wa kuona wa utafiti wenyewe.
Tofauti kati ya mwonekano wa katikati na mwonekano wa pembeni
Katika Figure 7 chanzo kinaeleza kwamba katika mitazamo ya katikati, LFhybridSR na mbinu iliyopendekezwa zilitoa matokeo makali zaidi hasa kwenye maandishi na tekstua za nyuso za metali. Hili linaweza kutarajiwa kwa sababu mwonekano wa katikati una uhusiano wa moja kwa moja na wenye nguvu zaidi na rejeleo la HR.
Katika Figure 8 mitazamo ya pembeni ni migumu zaidi. Pembe ya kutazama inapobadilika, jiometria kati ya rejeleo la katikati na mwonekano wa pembeni hubadilika, na uakisi wa specular pia hubadilika.
Katika eneo la maandishi madogo la Scene 5, chanzo kinaeleza kuwa hakuna mbinu iliyotoa maandishi wazi na rahisi kutambulika. LFhybridSR huweza kutoa muonekano jagged katika baadhi ya kingo za vitu vya metali, huku ERVSR ikiweza kutoa matokeo bora ya kuona kuliko Bicubic kwenye mwonekano wa pembeni. Mbinu iliyopendekezwa inaonyesha matokeo yenye usawaziko zaidi wakati mitazamo ya katikati na ya pembeni inatathminiwa pamoja.
Super-Resolution Iliboresha Kwa Kiasi Gani Ukadiriaji wa Kina?
Katika picha halisi, kutumia uchakataji wa awali wa SR kabla ya MiDaS-small kulipunguza thamani ya Abs Rel kutoka 0,5349 hadi 0,1024 katika jaribio la chanzo na kuongeza kwa kiasi kikubwa vipimo vitatu vya usahihi vya \(\delta\); lakini matokeo haya ni kiashirio cha kazi ya downstream kwa data na mpangilio wa MiDaS uliotumika pekee.
| Input | Abs Rel | \(\delta_1\) | \(\delta_2\) | \(\delta_3\) |
|---|---|---|---|---|
| Picha ya SR | 0,1024 | 0,8989 | 0,9383 | 0,9521 |
| Picha ya LR | 0,5349 | 0,4007 | 0,5951 | 0,6569 |
Kulingana na maelezo ya chanzo, takribani %90, %94 na %95 ya pikseli zilizokadiriwa katika picha za SR hubaki ndani ya viwango vya kosa jamaa vya 1,25; 1,56 na 1,95 mtawalia.
Matokeo haya yanaunga mkono kwamba taarifa za kingo na tekstua zilizorejeshwa kwa SR zinaweza kutoa input inayofaa zaidi kwa monocular depth model.
Hata hivyo, utafiti haukulinganisha kifaa halisi cha kipimo cha usahihi wa juu, profilometer au coordinate measurement system kabla na baada ya SR. Kwa hiyo matokeo hayapaswi kujumlishwa kama “SR ilipunguza kosa la vipimo vya viwandani kutoka 0,5 hadi 0,1”. Thamani iliyopimwa ni kosa la Abs Rel katika ukadiriaji wa kina wa MiDaS.
Hitimisho linaloungwa mkono na utafiti
Majaribio ya chanzo yanaunga mkono kwamba matumizi ya pamoja ya STF-based high-frequency texture transfer na SR2I-based spatial–angular feature fusion katika mpangilio mseto wa HR/LR 3 × 3 wa mitazamo mingi yalitoa matokeo ya juu zaidi ya PSNR/SSIM kuliko Bicubic, LFhybridSR na ERVSR katika seti ya data za picha za metali iliyochunguzwa.
Utafiti wa ablation unaonyesha kwamba encoder tofauti, SAS block, muundo wa fusion kati ya matawi mawili na Charbonnier loss zote zinachangia matokeo ya modeli kamili.
Katika data sintetiki, ongezeko kubwa hasa la PSNR linaonyesha kwamba modeli inaweza kutumia kwa ufanisi tekstua ya rejeleo ya ubora wa juu iliyotengenezwa kwa hali iliyodhibitiwa.
Katika data halisi, faida ndogo lakini chanya ya PSNR inaonyesha kwamba utendaji wa mbinu hauishii kwenye mazingira ya sintetiki pekee.
Jaribio la MiDaS linaonyesha kwamba SR inaweza kuwa muhimu kama picha ya input katika kazi maalum ya downstream monocular depth estimation.
Hitimisho lisiloungwa mkono na utafiti
Utafiti hauonyeshi kwamba mbinu itatoa utendaji uleule kwa nyuso zote za metali, jiometria zote za kamera au viwanda vyote. Mpangilio wa majaribio unategemea muundo thabiti wa mitazamo 3 × 3.
Modeli haijajaribiwa kama mfumo wa jumla wa MVISR unaofanya kazi kwa picha za LR pekee. Katika jaribio kuu kuna rejeleo moja la katikati la HR.
Utafiti hautoi benchmark ya throughput, latency, matumizi ya GPU au kasi ya juu ya processing katika line ya uzalishaji ya muda halisi.
Kwa sababu chanzo hakiripoti optimizer, learning rate, batch size, epoch na maelezo ya hardware ya mafunzo, uwezo wa kurudia mafunzo kikamilifu ni mdogo.
Kwa matokeo ya PSNR/SSIM, hakujaripotiwa marudio, error bars, confidence intervals au statistical significance tests. Kwa hiyo tofauti za jedwali ni matokeo ya majaribio yaliyoonekana; hazipaswi kutafsiriwa kama mtihani wa ubora wa takwimu.
Matokeo ya MiDaS si uthibitisho wa precision industrial metrology. Yanapima tu utendaji wa monocular depth estimation.
Chanzo pia kinataja kama limitation kwamba hakikulinganisha mbinu yake moja kwa moja katika benchmark pana ya majaribio dhidi ya mbinu za sasa za state-of-the-art reference-based SR.
Mwelekeo wa utafiti wa baadaye
Waandishi kwanza wanapendekeza kuhamia kwenye usanifu unaounga mkono mipangilio inayobadilika ya angular resolution. Hili linaweza kufanya iwezekane kupima mbinu inafanya kazi kwa kiwango gani katika arrays za kamera zilizo sparse zaidi au dense zaidi.
Mwelekeo wa pili ni kuongeza differentiable rendering au vizuizi vinavyotegemea fizikia ili kuweka mipaka bora ya kimwili kwenye texture transfer katika maeneo ya metali yenye uakisi mkubwa.
Mwelekeo wa tatu ni kuunda seti maalum ya data ya mitazamo mingi yenye aina mbalimbali za vitu vya metali vya viwandani na mipangilio ya mitazamo.
Mwishowe, waandishi wanataja kuunganisha reconstruction ya SR kwa ukaribu zaidi na kazi za baadaye kama ukadiriaji wa kina au precision measurement kama eneo la utafiti wa siku zijazo.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Multi-View Industrial Image Super-Resolution via Hierarchical Multi-Scale Data Fusion
Waandishi: Wenqin Zhao; Carman Ka Man Lee; Da Li; Benny Chi Fai Cheung.
Mwandishi wa mawasiliano: Carman Ka Man Lee.
Taasisi: State Key Laboratory of Ultra-Precision Machining Technology na Department of Industrial and System Engineering, Hong Kong Polytechnic University, Hong Kong, China.
Jarida: AI.
Mchapishaji: MDPI.
Aina ya chanzo: Makala asilia ya utafiti iliyopitiwa na wenzao; utafiti wa super-resolution ya picha za viwandani unaotegemea deep learning.
Taarifa ya uchapishaji: AI 2026, juzuu 7, toleo 5, makala 172.
DOI: 10.3390/ai7050172
Uwasilishaji: 13 Machi 2026.
Marekebisho: 25 Aprili 2026.
Kukubaliwa: 14 Mei 2026.
Kuchapishwa: 16 Mei 2026.
Peer review / toleo: Makala ya jarida iliyopitiwa na wenzao; imesajiliwa kama Version of Record katika hifadhi ya kitaasisi ya PolyU.
Leseni: Creative Commons Attribution (CC BY), ufikiaji wazi.
Seti ya data: Sim-to-Real Dataset of Industrial Metal Objects. Chanzo kinaeleza kuwa seti ya data inapatikana wazi na ilichapishwa kupitia utafiti wa Machines 2024, 12, 99.
Kamera ya picha halisi: Intel RealSense L515 RGB.
Kamera kuu ya picha halisi kwa data sintetiki: JAI GO-5000-PGE.
Mazingira ya uzalishaji sintetiki: Unity; chanzo kinataja matumizi ya HDRI environment map na texture synthesis.
Downstream model: MiDaS-small monocular depth estimation model.
Mbinu za kulinganisha: Bicubic, LFhybridSR na ERVSR.
Ufadhili: Research Impact Fund, Grant No. R5047–22.
Shukrani: Research Grants Council of the Hong Kong Special Administrative Region, Department of Industrial and Systems Engineering na State Key Laboratory of Ultra-Precision Machining Technology, The Hong Kong Polytechnic University.
Kamati ya maadili ya taasisi: Haitumiki.
Idhini yenye taarifa: Haitumiki.
Upatikanaji wa data: Chanzo kinaeleza kuwa data zinapatikana kwa ufikiaji wazi na kinaelekeza kwenye utafiti wa data katika DOI 10.3390/machines12020099.
Mgongano wa maslahi: Waandishi wametangaza kuwa hakuna mgongano wa maslahi.
Michango ya waandishi: Uundaji wa dhana Wenqin Zhao, Da Li na Carman Ka Man Lee; methodology na software Wenqin Zhao; validation Wenqin Zhao; formal analysis na investigation Wenqin Zhao na Da Li; resources Wenqin Zhao, Carman Ka Man Lee na Benny Chi Fai Cheung; data curation Wenqin Zhao; first draft Wenqin Zhao; review and editing Carman Ka Man Lee; visualization Wenqin Zhao; supervision Carman Ka Man Lee; project administration na funding acquisition vilifanywa na Benny Chi Fai Cheung.
Maelezo ya reproducibility: PDF hairipoti optimizer, learning rate, batch size, idadi ya training epoch, training hardware na idadi kamili ya samples za training/validation/test. Parameters hizi ambazo hazipo kwenye chanzo hazijajazwa na Verianla.
Vikwazo vikuu vya kimethodolojia: Dhana ya mpangilio mseto wa HR/LR acquisition; angular resolution thabiti ya 3 × 3; kutopimwa kwa view array zilizo sparse au dense zaidi; kutokuwepo kwa reflectance ya wazi au vizuizi vinavyotegemea fizikia; kutofanywa kwa ulinganisho mpana wa moja kwa moja dhidi ya mbinu za state-of-the-art reference-based SR; kutoripotiwa kwa vipimo vya real-time deployment.
Maelezo ya mbinu ya Verianla: Maudhui haya si tafsiri ya mstari kwa mstari ya makala chanzo. Tatizo la utafiti, mpangilio mseto wa upigaji picha wa mitazamo mingi, usanifu wa STF na SR2I, attention-based patch matching, Equation (1)–(4), seti ya data na mpangilio wa kamera, ablations, matokeo ya PSNR/SSIM/LPIPS, tathmini za kuona, ukadiriaji wa kina wa MiDaS na vikwazo vimehifadhiwa ili kuunda muundo huru wa kujifunza kisayansi kwa Kiswahili. Hakuna jaribio, thamani ya utendaji, parameter ya mafunzo au takwimu isiyokuwepo kwenye chanzo iliyoongezwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *