


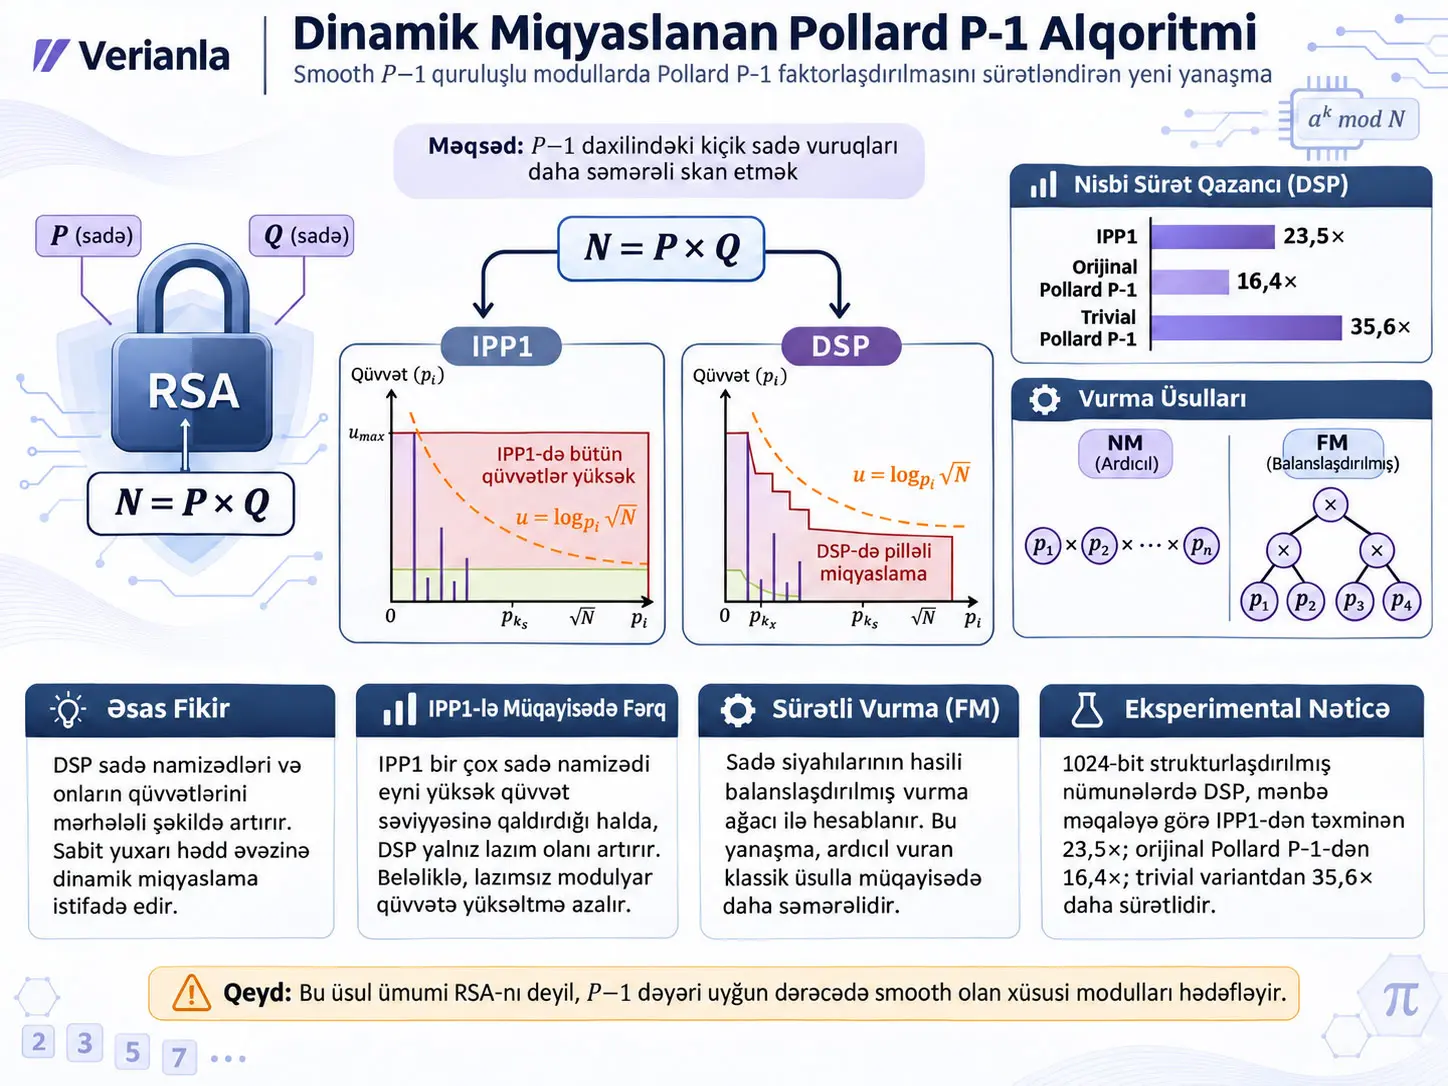
Dynamic Scaling Pollard’s P-1 Algorithm (DSP), Pollard P-1 xüsusi təyinatlı tam ədədlərin faktorlaşdırılması üsulunu, sadə ədəd namizədlərini və onların zəruri üstlərini mərhələli şəkildə böyüdəcək formada yenidən təşkil edən alqoritm variantıdır. Tədqiqat xüsusilə RSA modulu \(N=PQ\) daxilindəki sadə vuruq \(P\) üçün \(P-1\)-in kiçik sadə vuruqlardan ibarət olduğu halları hədəfləyir. DSP-nin əsas məqsədi ənənəvi Pollard P-1 və IPP1 üsullarında ortaya çıxan sabit smoothness-bound seçimini və lazımsız yüksək üst hesablamalarını azaltmaqdır. Tədqiqat həmçinin böyük sadə ədəd siyahılarının hasilini daha aşağı xərclə hesablamaq üçün Fast Multiplication (FM) üsulunu inkişaf etdirir.
DSP-nin fərqləndirici xüsusiyyəti sadə ədəd namizədlərini bir sabit aralıqda toplamaq əvəzinə böyüklüklərinə görə mərhələli alt çoxluqlara bölməsi və kiçik sadə ədədlərin hasillərindən daha əvvəl əldə edilmiş aralıq nəticələri sonrakı üstlərdə yenidən istifadə etməsidir. Beləliklə, IPP1-də olduğu kimi bütün sadə ədəd namizədlərini eyni \(u_{\max}\) səviyyəsinə qədər yüksəltmək əvəzinə, kiçik sadə ədədlər daha yüksək üstlərə, böyük sadə ədədlər isə riyazi baxımdan tələb olunan daha aşağı üstlərə qədər qaldırılır. Bu yanaşma xüsusilə \(P-1\)-in sadə vuruqlarından birinin yüksək üstə malik olduğu, lakin digərlərinin eyni yüksək üstə ehtiyac duymadığı halda lazımsız modul üzrə üst alma xərcini azaltmağı hədəfləyir.
Müəlliflərin nəzəri müqayisəsində müəyyən şərtlər altında ən böyük əlaqəli sadə ədəd \(p_{\sigma_s}\ge64\) olduqda DSP-nin IPP1-dən daha aşağı xərcli olmasını dəstəkləyən ehtimal ən azı 0,95 kimi çıxarılmışdır. Bu dəyər ümumi RSA açarlarının %95-nin DSP ilə sındırıla biləcəyi demək deyil; məqalədəki müəyyən ədəd-nəzəri xərclər bərabərsizliyinin ehtimalıdır.
Eksperimental bölmədə \(P-1\)-in Pollard P-1 ilə həll edilə bilməsini təmin etmək üçün bir neçə təsadüfi 30-bit ədədin hasilindən istifadə etməklə 512-bit \(P\) sadə ədədləri yaradılmış, eyni bit uzunluğunda təsadüfi \(Q\) seçilərək 1024-bit \(N=PQ\) modulları hazırlanmışdır. Tək axınlı Intel Core i5-9500 sistemindəki müqayisədə mənbə DSP-nin təxminən IPP1-dən 23,5 dəfə, orijinal Pollard P-1-dən 16,4 dəfə və trivial variantdan 35,6 dəfə daha sürətli işlədiyini bildirir.
Ən mühüm şərh sərhədi: DSP ümumi təyinatlı RSA sındırma alqoritmi deyil. Pollard P-1 ailəsi yalnız sadə vuruqlardan birinin \(P-1\) və ya \(Q-1\) qiymətində uyğun smoothness zəifliyi olan xüsusi hallarda səmərəlidir. Tədqiqatın 1024-bit təcrübələri də məhz bu zəifliyi daşıyacaq şəkildə qurulmuş test modullarıdır.
Tam ədədlərin faktorlaşdırılması problemi nədir?
RSA tipli modul:
şəklində iki böyük və fərqli sadə ədədin hasilidir. \(N\) məlum olduqda \(P\) və \(Q\)-nu geri əldə etmək problemi Integer Factorization Problem (IFP), yəni tam ədədlərin faktorlaşdırılması problemi adlandırılır.
Modulun bit uzunluğu:
ilə göstərilir. \(n_N\), \(N\)-ni ikilik təsvirlə yazmaq üçün tələb olunan bit sayıdır. Mənbə analizində \(P\) və \(Q\)-nun təxminən eyni bit uzunluğuna malik olduğu fərz edilir; buna görə onların hər biri təxminən \(n_N/2\) bit uzunluğundadır.
Eylerin totient funksiyası:
şəklindədir.
B-smooth ədəd nə deməkdir?
Mənbə tədqiqatın tərifinə görə B-smooth ədəd, bütün sadə vuruqları \(B\)-dən kiçik və ya \(B\)-yə bərabər olan müsbət tam ədəddir.
Məsələn:
yalnız 2 və 3 sadə vuruqlarını ehtiva etdiyinə görə 3-smooth ədəddir. Buradakı nümunə yalnız tərifi öyrətmək üçündür; tədqiqatın eksperimental nəticəsi deyil.
Pollard P-1 alqoritminin hədəflədiyi zəiflik \(P-1\)-in bu cür kiçik sadə vuruqlardan ibarət olmasıdır.
Pollard P-1 niyə işləyə bilər?
Fermanın Kiçik Teoremi bildirir ki, \(P\) sadə ədəd və \(a\) ədədi \(P\) ilə qarşılıqlı sadədirsə:
bərabərliyi doğrudur.
Əgər seçilmiş üst \(z\), \(P-1\)-in qatıdırsa:
və buna görə:
olar.
Bu halda:
hesabı uyğun şərtlərdə:
\[ 1
olan sadə vuruq \(P\)-ni verə bilər.
Buna görə Pollard P-1-in əsas problemi \(P-1\)-in sadə vuruqlarını daxil edəcək qədər zəngin, lakin lazımsız dərəcədə böyük olmayan \(z\) üstü yaratmaqdır.
Mənbənin əsas notasiyası
\(P-1\) həmişə cüt olduğuna görə mənbə əvvəlcə tək hissəni:
kimi ayırır.
\(\gamma\), sadə ədəd namizədləri siyahısının qlobal yuxarı sərhədidir. Namizəd çoxluğu:
şəklində müəyyən edilir.
\(P_{\mathrm{div}}\) daxilindəki həqiqi sadə vuruqlar:
şəklində yazılır.
- \(p_{\sigma_i}\): həqiqətən \(P_{\mathrm{div}}\)-i bölən sadə ədəd.
- \(u_{\sigma_i}\): həmin sadə ədədin həqiqi üstü.
- \(\sigma_1<\sigma_2<\cdots<\sigma_s\): bu sadə ədədlərin qlobal sadə ədədlər siyahısındakı sıraları.
- \(u_{\max}\): həqiqi sadə ədəd üstləri arasındakı maksimum dəyər.
Mənbə həmçinin ən böyük sadə-üst komponentini:
kimi müəyyən edir.
Bir \(p_i\) sadə ədədinin mümkün maksimum üstü üçün mənbə:
yuxarı sərhədindən istifadə edir. Bunun səbəbi:
olduğuna görə istənilən sadə ədəd qüvvəsinin də bu böyüklüyü aşmamasıdır.
DSP sadə ədəd namizədlərini necə bölür?
Mənbə sadə ədəd namizədləri çoxluğunu böyüklüklərinə görə \(k_0\) alt çoxluğa bölür:
və:
şəklində aralıqlardan istifadə edir.
Bu double-exponential sərhədlər ilk baxışda qeyri-adi görünə bilər. Məqsəd sadə ədədin böyüklüyü artdıqca həmin sadə ədədin \(P-1\) daxilində daşıya biləcəyi maksimum üst sayının sürətlə azalması faktını alqoritmik quruluşa əks etdirməkdir.
DSP doğrudanmı heç bir Smoothness Bound istifadə etmir?
Xeyr; Algorithm 4-ün girişlərindən biri \(\gamma\) adlı qlobal sadə-ədəd-siyahısı yuxarı sərhədidir. DSP-nin üstünlüyü klassik Pollard P-1 və ya IPP1-də olduğu kimi işin uğuru üçün dar \(B\) sərhədini əvvəlcədən düzgün təxmin etməyə bağlı olmamasıdır: \(\gamma\) nəzəri maksimuma təyin edilə bilər və alqoritm sadə ədəd/üst sahəsini dinamik olaraq skan edir; əvvəlcədən məlumat varsa, daha kiçik \(\gamma\) yalnız sürətləndirmə məqsədilə istifadə edilə bilər.
Sadə-ədəd hasilinin bit uzunluğunun gözlənilən dəyəri
Mənbə FM və NM xərcini təhlil etmək üçün \(L(p,n_1,n_2)\) adlı siyahı modeli qurur. Siyahıdakı hər bir:
element müstəqil olaraq \(p\) ehtimalı ilə seçilir.
Siyahıdakı bütün ədədlərin hasilinin gözlənilən struktur bit uzunluğu:
kimi verilir.
Bu düstur vaxt ölçmür. Sonrakı böyük-tam-ədəd vurma və modul üzrə üst alma xərclərinin operand böyüklüyünü təxmin etmək üçün istifadə edilən riyazi aralıq nəticədir.
Əsas əməliyyat xərc modelləri
Mənbə bütün DSP/IPP1 xərc təhlilini dörd əsas əməliyyat növünə ayırır.
1. Böyük tam ədədlərin vurulması:
Burada \(n\) operandın bit uzunluğu; \(C_1\) implementation-dependent sabitdir. Mənbə asimptotik təhlil üçün böyük tam ədədlərin vurulmasını \(O(n\log n)\) kimi modelləşdirir.
2. Modul üzrə üst alma:
\(l\) exponent bit uzunluğu; \(n\) base/modulus bit böyüklüyü; \(w\) isə sliding-window eni olmaqla:
şəklində modelləşdirilir.
Mənbə optimal pəncərə seçimini Lambert W funksiyasının asimptotik yaxınlaşdırması ilə həll edib:
yaxınlaşdırmasını əldə edir.
Araşdırılan exponent-böyüklük aralığında bu xərc exponent bit uzunluğu \(l\) ilə təxminən xətti davranır. DSP-nin aralıq sadə ədəd hasillərini yenidən istifadə etməsi ideyasının mühüm riyazi əsaslarından biri budur.
3. Normal üst alma:
mənbədə sadə binary exponentiation üçün istifadə edilən yuxarı xərc modelidir.
4. Ən böyük ortaq bölən:
şəklində modelləşdirilir. \(C_2\), GCD implementation-na bağlı sabitdir.
Orijinal Pollard P-1 alqoritmi
Mənbə Pollardın orijinal yanaşmasını iki mərhələli quruluş kimi izah edir. \(1<B_1<B_2\) olmaqla alqoritmin uğurlu ola biləcəyi iki əsas hal:
- \(P-1\), \(B_1\)-smooth-dur.
- \(P-1=Ap\), burada \(A\) \(B_1\)-smooth və \(B_1<p<B_2\) sadə ədəddir.
Birinci mərhələdə hər sadə ədəd üçün:
kimi kifayət qədər üst seçilərək:
yaradılır.
Bishopun trivial variantı
Bishopun mənbənin müqayisə etdiyi sadə variantında əvvəlcə təsadüfi:
seçilir və:
əməliyyatları ardıcıl tətbiq edilir. Hər addımda:
hesablanır. Bu yanaşma əvvəlcədən smoothness bound seçməyi tələb etməsə də, exponent-i bir-bir artırdığı üçün mənbədə praktik olmayan dərəcədə bahalı hesab edilir.
IPP1 necə işləyir?
IPP1 əvvəlcə müəyyən sadə ədədlər siyahısının bütün elementlərini bir hasilə birləşdirir:
və sonra:
əməliyyatını təkrarlayaraq bütün sadə ədədləri eyni iteration sayı boyunca birlikdə yüksəldir.
Bu üsul sadə ədədlərin üstləri bir-birinə yaxın olduqda üstün ola bilər. Lakin tək bir sadə ədədin həqiqi üstü yüksək olduqda bütün digər sadə ədəd namizədləri də eyni təkrar sayına məruz qalır. DSP-nin hədəflədiyi əsas lazımsız xərc budur.
IPP1 nəzəri xərc modeli
Mənbə Theorem 1-də \(p_t\ge p_{\sigma_s}\) şərti altında:
yuxarı xərcini verir.
\(p_t=p_{\sigma_s}\) seçilərsə:
alınır.
Birinci termin sadə-ədəd-siyahısı hasilinin xərcini; ikinci termin təkrarlanan GCD xərcini; üçüncü termin isə təkrarlanan modular exponentiation-ın dominant xərcini təmsil edir.
DSP-nin əsas alqoritmi
DSP-nin girişləri:
- \(N\): vuruqlara ayrılacaq iki-sadə-ədədli modul.
- \(\gamma\): sadə ədəd namizədləri siyahısının qlobal yuxarı sərhədi.
çıxış isə tapılmış sadə vuruq və ya uğursuzluğu göstərən \(\perp\)-dir.
Başlanğıcda:
və:
hesablanır.
İlk GCD non-trivial vuruq vermirsə:
ilə dynamic scaling başladılır.
\(j<k_0\) üçün müvafiq sadə ədəd alt çoxluğu:
yaradılır.
Bu aralıqdakı sadə ədədlərin hasili:
kimi hesablanır.
Dinamik exponent:
və növbəti mərhələnin accumulator-u:
olur.
Hər dövrdə:
və ardınca:
hesablanır.
Non-trivial \(d\) tapılarsa alqoritm vuruğu qaytarır. Tapılmazsa növbəti sadə ədəd/üst miqyasına keçir.
DSP-nin ikinci mərhələsi niyə fərqlidir?
Mənbədə son sadə ədəd alt çoxluğu \(\mathcal{P}_{k_0}\) üçün xüsusi müşahidə aparılır. Bu aralıqdakı sadə ədədlər o qədər böyükdür ki, \(P_{\mathrm{div}}\) daxilində onlardan eyni anda ikisinin olması böyüklük sərhədi ilə ziddiyyət təşkil edər. Buna görə son alt çoxluqda bütün sadə ədədləri yüksək üstlərə qaldıran bahalı əməliyyat əvəzinə Pollardın shift modular exponentiation yanaşmasından istifadə edilir.
Ardıcıl sadə ədəd namizədləri arasındakı yarım fərq üçün:
hesablanır və:
əvvəlcədən hesablanır. Beləliklə, ardıcıl sadə ədəd namizədlərinə keçiddə exponentiation sıfırdan aparılmaq əvəzinə sadə ədədlər arasındakı fərqlərdən istifadə olunur.
DSP-də aralıq nəticələrin yenidən istifadəsi niyə işləyir?
Mənbənin Example 1-i iki sadə ədəd \(p_1,p_2\) üçün:
ifadəsinin iki fərqli üsulla hesablanmasını müqayisə edir.
Birinci üsulda:
bir dəfə hesablanır və:
sonra:
hesablanır.
İkinci üsulda exponent əvvəlcə birbaşa:
kimi qurulur və tək modul üzrə üst alma aparılır.
Modular exponentiation xərci exponent bit uzunluğu ilə təxminən xətti olduğuna görə iki üsulun modular exponentiation xərcləri bir-birinə yaxın ola bilər; lakin ikinci üsul əlavə olaraq böyük exponent-in kvadratını yaratmalıdır. Mənbənin nəticəsi aralıq hasilin yenidən istifadəsinin exponent-yaratma xərcini azalda bilməsidir.
DSP nəzəri xərc modeli
Mənbə Theorem 2-də uyğun halda DSP xərcini:
şəklində verir.
Burada:
- \(p_{\sigma_s}\): \(P_{\mathrm{div}}\)-dəki ən böyük həqiqi sadə vuruq.
- \(p_{\sigma_x}^{u_{\sigma_x}}\): ən böyük sadə-üst komponenti.
- \(n_N\): modulun bit uzunluğu.
- \(C_1\): böyük tam ədədlərin vurulması xərc sabiti.
- \(C_2\): GCD xərc sabiti.
- \(o(\cdot)\): dominant terminlərdən daha yavaş böyüyən aşağı dərəcəli terminləri göstərir.
Bu teorem mənbədə uğurla faktorlaşdırıla bilən hal üçün qurulmuşdur. Uğursuzluq ssenarisinin bütün xərci bu ifadəyə daxil deyil.
DSP niyə IPP1-dən daha az lazımsız üst hesablaya bilər?
IPP1 seçilmiş sadə ədədlər siyahısındakı bütün sadə ədəd namizədlərini eyni \(u_{\max}\) təkrar sayına qədər birlikdə yüksəltdiyi halda, DSP sadə ədədin böyüklüyü artdıqca mümkün üst sərhədinin azalması faktından istifadə edərək müxtəlif sadə ədəd aralıqlarını müxtəlif sürətlə miqyaslandırır; buna görə tək bir kiçik sadə ədədin yüksək üstə malik olması bütün digər namizədlərin eyni yüksək üstü lazımsız yerə almasına səbəb olmur.
%95 nəticəsi necə əldə edilir?
Mənbə Theorem 1 və Theorem 2 xərclərini müqayisə edərkən DSP-nin daha aşağı xərcli ola biləcəyi bərabərsizlik əldə edir. Sonra \(P-1\)-in largest-prime-factor paylanması üçün Riesel-də müəyyən edilmiş \(\rho_1\) funksiyasına müraciət edir.
\(p_{\sigma_s}\ge64\) olduqda:
və mənbə istifadə etdiyi nəticədən:
olduğunu bildirir. \(\rho_1\) monoton azalan olduğuna görə müvafiq hadisə üçün:
nəticəsinə çatılır.
Buna görə məqalədəki “%95-dən çox” ifadəsi nəzəri xərc-müqayisə ehtimalıdır. Bu, RSA açar sındırma uğur faizi, təhlükəsizlik səviyyəsi və ya eksperimental 100 nümunədən 95-nin sındırıldığı mənasına gəlmir.
DSP ümumiyyətlə RSA-nı sındıran alqoritmdirmi?
Xeyr; DSP Pollard P-1 ailəsinin xüsusi təyinatlı faktorlaşdırma üsuludur və səmərəli olması üçün \(P-1\) və ya \(Q-1\)-in kiçik sadə vuruqlardan ibarət uyğun smooth quruluşa malik olması lazımdır; tədqiqatın 1024-bit test modulları da bu quruluşun mövcudluğunu təmin etmək məqsədilə xüsusi hazırlanmışdır.
Fast Multiplication problemi nədir?
DSP və IPP1 çox sayda sadə ədəd namizədinin hasilini hesablamaq məcburiyyətindədir. Sadə Normal Multiplication (NM) üsulunda:
siyahısı üçün ilk element daim böyüyən akkumulyator kimi istifadə edilir:
Bu halda hər yeni vurma əvvəlkindən çox daha böyük tam ədədlə aparılır.
FM necə işləyir?
Fast Multiplication siyahıda ən kiçik ilə ən böyük, ikinci kiçik ilə ikinci böyük elementi cütləşdirir:
və:
edərək siyahını hər dövrdə təxminən yarıya endirir.
Siyahıdakı elementlərin sayı təkdirsə, başlanğıca vurma təsiri olmayan 1 əlavə olunur. Əməliyyat tək bir hasil qalana qədər təkrarlanır.
Fast Multiplication niyə Normal Multiplication-dan daha ucuz ola bilər?
Normal Multiplication daim böyüyən tək akkumulyatoru yeni elementlərlə vurduğu üçün çox balanssız operand ölçüləri yaradır; FM isə böyük və kiçik elementləri simmetrik şəkildə cütləşdirərək balanslı vurma ağacı qurur. Mənbənin böyük-tam-ədəd xərc modelində bu quruluş sadə-ədəd-siyahısı hasilində təxminən \(4^n\) miqyaslı NM xərcini təxminən \(2^n n^2\) miqyaslı FM xərcinə endirir.
Normal Multiplication mürəkkəbliyi
Theorem 3-də:
ifadəsi verilir.
\(p=1\) olduqda:
olar.
Sadə ədədlərin təxmini sıxlığı Prime Number Theorem ilə nəzərə alındıqda, bütün \(n\)-bit sərhədindən aşağı sadə ədədlərin NM ilə hasilinin xərci mənbədə:
şəklində verilir.
Fast Multiplication mürəkkəbliyi
Theorem 4:
nəticəsini verir.
\(p=1\) üçün:
olar.
Sadə ədədlər siyahısı üçün Corollary 2-də:
alınır.
\(n_1=0,n_2=n\) götürüldükdə əsas miqyas:
olarkən NM tərəfi \(4^n\) ilə böyüyür. Mənbə Şəkil 4-də 21-26 bitlik maksimum sadə vuruq ölçüləri üçün nəzəri əyrilərin real ölçmələrlə yaxşı uyğunlaşdığını göstərir. Xam ölçmə cədvəli verilmədiyinə görə Verianla qrafikdən dəqiq vaxt çıxarmır.
Tədqiqatın Metodu və Nəticələri
Təcrübə 1: Pollard P-1-in dörd variantının müqayisəsi
Mənbə dörd implementation-ı müqayisə edir:
- DSP + Fast Multiplication.
- IPP1 + Fast Multiplication.
- Orijinal Pollard P-1.
- Bishopun trivial Pollard P-1 variantı.
Təcrübə kod deposu mənbədə belə göstərilir:
https://github.com/Summwer/expemeriment_of_pollardpm1
Mənbə bağlantı üçün 1 avqust 2026 giriş tarixini göstərir.
1024-bit test modulları necə yaradıldı?
Müəlliflər əvvəlcə \(P\)-ni elə yaradıblar ki, \(P-1\) dəyəri bir neçə təsadüfi yaradılmış 30-bit ədədin hasili olsun. Beləliklə, \(P-1\)-in ən böyük sadə vuruğu:
olur və test nümunələrinin Pollard P-1 ailəsi tərəfindən həll edilə bilməsi hədəflənir.
Sonra \(P\) ilə eyni bit uzunluğunda təsadüfi sadə ədəd \(Q\) yaradılır və:
hesablanır.
Mənbə mətni bu üsulla **10 ədəd 1024-bit \(N\)** yaradıldığını deyir. Buna qarşılıq mənbə Şəkil 7-nin görünən x oxunda yalnız instance 1-8 yer alır. Mənbə bu fərqi izah etmir.
Təcrübə avadanlığı
| Element | Mənbədə bildirilən dəyər |
|---|---|
| Əməliyyat sistemi | Ubuntu 20.04.1 |
| Arxitektura | x86-64 |
| CPU | Intel Core i5-9500 @ 3.00 GHz |
| Mənbədə yazılan CPU məlumatı | 6 × Intel Core i5-9500 |
| RAM | 16 GB |
| İcra | Single thread |
| Modul | 1024-bit \(N=PQ\) |
| \(P,Q\) bit uzunluğu | Təxminən 512 bit |
Təcrübə 1-in əsas sürət nəticəsi
| Müqayisə edilən üsul | DSP-nin mənbədə bildirilən təxmini sürət üstünlüyü | Kontekst |
|---|---|---|
| IPP1 + FM | 23,5× | Xüsusi hazırlanmış 1024-bit test modulları |
| Orijinal Pollard P-1 | 16,4× | Eyni test quruluşu |
| Trivial Pollard P-1 | 35,6× | Eyni test quruluşu |
Mənbə yüksək sadə-üstlərin olduğu instance 2, 3, 4, 5 və 8-in bu davranışı görünən etdiyini bildirir. Instance 2, 3, 4 və 8-də IPP1-in hətta orijinal Pollard P-1-dən daha yavaş olduğu, buna baxmayaraq DSP-nin orijinal alqoritmdən daha sürətli qaldığı bildirilib.
Müəlliflərin şərhinə görə DSP-nin xərci sadə vuruqların sayından və ya sadə ədədin sıra indeksindən daha çox ən böyük sadə vuruğun böyüklüyünə həssasdır. Bu, mənbənin öz eksperimental və nəzəri şərhidir; digər paylanmalardakı bütün \(P-1\) quruluşları üçün yeni universal nəticə kimi genişləndirilməməlidir.
Təcrübə 2: Bir yüksək üst nəzarətli şəkildə böyüdülür
İkinci təcrübədə 512-bit \(P\) aşağıdakı quruluşda yaradılır:
və:
istifadə edilir.
Bu dizaynın məqsədi digər şərtləri nəzarətdə saxlayarkən 3 sadə ədədinin üstünü böyütmək və IPP1 ilə DSP arasındakı fərqi sistemli şəkildə müşahidə etməkdir.
Hər \(P\) üçün təsadüfi 512-bit \(Q\) seçilir və:
yaradılır.
DSP üçün:
- Algorithm 4 real implementation,
- Algorithm 6 DSPEst estimator,
- Theorem 2 nəzəri xərc
müqayisə edilir.
IPP1 üçün isə:
- Algorithm 3 real implementation,
- Algorithm 5 IPP1Est estimator,
- Theorem 1 nəzəri xərc
müqayisə edilir.
Şəkil 8-də nəzəri xərc xətləri, estimator nöqtələri və real təcrübə nöqtələri eyni artım meylini yaxından izləyir. Bu nəticə tədqiqatın xərc modellərinin test edilmiş bu konfiqurasiyalarda implementation davranışını yaxşı təmsil etdiyini dəstəkləyir. Mənbə xam nöqtə dəyərlərini cədvəl şəklində vermədiyinə görə yeni aralıq dəyər yaradılmır.
Nəzəri %95 müqayisəsinin düzgün şərhi
Mənbənin nəzəri nəticəsi:
- \(p_{\sigma_s}\ge64\) şərtini,
- Rieselin \(\rho_1\) funksiyasını,
- Theorem 1 və Theorem 2 xərc modellərini
birlikdə istifadə edir.
Buna görə “DSP %95 uğur faizinə malikdir” demək yanlışdır. Mənbənin dediyi, müəyyən şərtlər altında DSP-nin IPP1-dən aşağı nəzəri hesablama xərcinə malik olmasını dəstəkləyən hadisənin ehtimalının ən azı 0,95 olmasıdır.
Tədqiqatın dəstəklədiyi nəticələr
- DSP, Pollard P-1-in sadə ədəd namizədlərini və zəruri üstləri eyni dinamik skan qaydasında işləyən yeni variantıdır.
- Əvvəl hesablanmış sadə ədəd hasillərinin yenidən istifadəsi yüksək exponent yaratma xərcini azalda bilər.
- DSP sadə ədədin böyüklüyünə görə exponent təyinatını dəyişdirərək IPP1-in bütün namizədləri \(u_{\max}\)-a qədər aparmasından yaranan lazımsız hesablamaları azaldır.
- Fast Multiplication balanslı vurma ağacından istifadə etməklə mənbənin xərc modelində Normal Multiplication-dan daha yaxşı asimptotik davranış göstərir.
- Mənbə Şəkil 4-də NM/FM nəzəri xərc modelləri ilə eksperimental xərclərin yaxşı uyğunlaşdığını göstərir.
- Mənbənin nəzəri şərtlərində \(p_{\sigma_s}\ge64\) olduqda DSP-nin IPP1 xərcindən aşağı olması üçün istifadə edilən ehtimal ən azı 0,95-dir.
- Mənbənin qurulmuş 1024-bit təcrübələrində DSP müqayisə edilən üç köhnə variantdan daha sürətlidir.
- Mənbə yüksək sadə-üstlər olduqda DSP üstünlüyünün daha görünən hala gəldiyini bildirir.
- Nəzarətli \(u_x\) təcrübəsində Theorem 1/2, estimator-lar və implementation xərclərinin meylləri bir-birinə yaxındır.
Tədqiqatın dəstəkləmədiyi nəticələr
- DSP-nin ümumi 1024-bit RSA modullarını səmərəli şəkildə faktorlaşdırdığı nəticəsinə gəlmək olmaz.
- 23,5×, 16,4× və 35,6× sürət nisbətləri bütün RSA açarlarına ümumiləşdirilə bilməz.
- %95 dəyəri ümumi RSA faktorlaşdırma uğur faizi deyil.
- DSP-nin Number Field Sieve kimi ümumi təyinatlı faktorlaşdırma üsullarından ümumiyyətlə daha sürətli olduğu test edilməyib.
- Tədqiqatın təcrübələri quantum factoring müqayisəsi deyil.
- Mürəkkəblik teoremləri uğursuz faktorlaşdırma ssenarisinin tam xərc analizini ehtiva etmir.
- Çoxnüvəli və ya GPU sürətləndirməli performans test edilməyib.
- Başqa CPU, arbitrary-precision library və ya implementation mühitində eyni sürət nisbətlərinin qorunacağı sübut edilməyib.
- Şəkil 7-də görünməyən instance 9 və 10 üçün zaman dəyərləri mənbədən çıxarıla bilməz.
Əsas metodoloji və təkrar istehsal edilə bilmə məhdudiyyətləri
- Təcrübə nümunələri Pollard P-1 ilə həll edilə biləcək smooth quruluş xüsusi olaraq təmin edilərək yaradılmışdır.
- Müqayisə tək bir fərdi kompüterdə və single-thread icra olunmuşdur.
- Mənbə mətni ilk təcrübə üçün 10 ədəd 1024-bit modul desə də, Şəkil 7 yalnız səkkiz instance göstərir.
- Şəkil 7-nin bütün bar hündürlükləri cədvəl şəklində verilməyib.
- Şəkil 8-in xam təcrübə, estimator və nəzəri dəyərləri cədvəl kimi dərc edilməyib.
- DSP/IPP1 nəzəri mürəkkəblik bölməsi açıq şəkildə solvable situation ilə məhdudlaşdırılıb və failure scenario xaric edilib.
- Mənbədə təcrübələrdə istifadə edilən arbitrary-precision arithmetic library-nin versiyası ətraflı bildirilməyib.
- Məqalə klassik ədəd nəzəriyyəsi və klassik hesablama kontekstindədir; quantum factoring nəticəsi təqdim etmir.
Tədqiqatın kriptoqrafik mənası
Pollard P-1 alqoritmləri RSA-nın əsas integer-factorization problemindəki ümumi çətinliyi aradan qaldırmır. Bunun əvəzinə prime generation zamanı ortaya çıxa bilən müəyyən algebraic weakness-ları hədəfləyir. Məqalənin töhfəsi də bu xüsusi zəiflik mövcud olduqda faktorlaşdırma prosesini daha az lazımsız hesablamayla aparmağa yönəlib.
Buna görə tədqiqatın düzgün xülasəsi “RSA artıq sındırılıb” deyil. Daha düzgün ifadə, smooth \(P-1\) və ya \(Q-1\) quruluşuna malik xüsusi kompozitlərdə Pollard P-1 faktorlaşdırmasını sürətləndirməyi hədəfləyən yeni traversal/exponent-scaling strategiyasının nəzəri və eksperimental olaraq araşdırılmış olmasıdır.
Mənbə və Metod Qeydi
Orijinal başlıq: Dynamic Scaling Pollard’s P-1 Algorithm
Müəlliflər: Wenwen Xia; Geng Wang; Dawu Gu.
Müəllif sırası: Wenwen Xia birinci; Geng Wang ikinci; Dawu Gu üçüncü müəllifdir.
Məsul müəlliflər: Geng Wang və Dawu Gu.
Qurum: School of Cyber Science and Engineering, Shanghai Jiao Tong University, Shanghai 200240, China.
Bərabər töhfə: Mənbədə bərabər birinci müəlliflik və ya bərabər töhfə bəyanatı yoxdur.
Jurnal: Cryptography.
Nəşriyyat: MDPI.
Cild / nömrə / məqalə: 10(4), Article 57.
Səhifə sayı: 26.
DOI: 10.3390/cryptography10040057.
Academic Editor: Josef Pieprzyk.
Göndərilmə: 14 iyun 2026.
Reviziya: 23 iyul 2026.
Qəbul: 29 iyul 2026.
Nəşr: 13 avqust 2026.
Version of Record qeydi: Rəsmi MDPI Version Notes qeydində ilk Version of Record PDF-i 13 avqust 2026-da, yenilənmiş PDF/HTML versiyası isə 17 avqust 2026-da dərc edilib.
Mənbə növü: Rəyli tədqiqat məqaləsi; ədəd nəzəriyyəsi, klassik kriptoanaliz, alqoritm dizaynı, asimptotik mürəkkəblik analizi və nəzarətli kompüter təcrübəsini birləşdirir.
Rəy prosesi: Cryptography rəyli MDPI jurnalidir. Jurnalın submission materialları single-anonymized peer review prosesini bildirir.
Preprint statusu: İşlənən mənbə dərc edilmiş Version of Record-dur; bu məqalədə ayrıca preprint əsas götürülməyib.
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Rəsmi bağlantı: https://doi.org/10.3390/cryptography10040057
Açar sözlər: cryptanalysis; RSA; integer factorization; Pollard’s P-1.
Əsas elmi töhfə: Dynamic Scaling Pollard’s P-1 (DSP) və Fast Multiplication (FM).
Müqayisə edilən alqoritmlər: DSP; IPP1; orijinal Pollard P-1; Bishopun trivial Pollard P-1 variantı.
Nəzəri modellər: Böyük tam ədəd multiplication, sliding-window modular powering, binary normal powering və GCD xərclərinin birləşməsindən DSP/IPP1 cost estimator-ları yaradılmışdır.
Əsas DSP xüsusiyyəti: Sadə ədəd namizədlərini double-exponential böyüklük aralıqlarına bölmək, daha kiçik sadə ədədləri daha yüksək üst səviyyələrinə mərhələli qaldırmaq və daha əvvəl hesablanmış sadə ədəd hasillərini yenidən istifadə etmək.
FM xüsusiyyəti: Artan siyahıda simmetrik son elementləri pairwise vuraraq hər dövrdə siyahını təxminən yarıya endirən balanslı multiplication tree.
Birinci təcrübə: \(P-1\)-in bir neçə təsadüfi 30-bit ədədin hasili olacaq şəkildə yaradıldığı, 512-bit \(P\) və təxminən eyni ölçülü təsadüfi \(Q\)-dan 1024-bit \(N=PQ\) test modulları.
İlk təcrübə mühiti: Ubuntu 20.04.1; x86-64; Intel Core i5-9500 @ 3.00 GHz; 16 GB RAM; single thread.
İlk təcrübənin əsas nəticəsi: Mənbə DSP-nin təxminən IPP1-dən 23,5×, orijinal Pollard P-1-dən 16,4× və trivial variantdan 35,6× sürətli olduğunu bildirir.
İlk təcrübədə mənbədaxili uyğunsuzluq: Mətn 10 ədəd 1024-bit test instance-ı bildirdiyi halda mənbə Şəkil 7-nin görünən x oxunda yalnız 1-8 instance-ları var. Mənbə bu fərqi izah etmir.
İkinci təcrübə: \(P=2\times3^{u_x}\times1073741789\times z+1\), \(u_x\in\{0,20,40,60,80,100\}\); təsadüfi 512-bit \(Q\); DSP və IPP1 üçün nəzəriyyə-estimator-təcrübə müqayisəsi.
Nəzəri %95 nəticəsi: \(p_{\sigma_s}\ge64\) şərtində Rieselin \(\rho_1\) funksiyasına əsaslanan çıxarışda DSP lehinə istifadə edilən xərc şərti üçün ən azı 0,95 ehtimal əldə edilir. Bu, RSA sındırma uğur faizi deyil.
Kod deposu: https://github.com/Summwer/expemeriment_of_pollardpm1 — mənbədə giriş tarixi 1 avqust 2026 kimi göstərilib.
Maliyyələşdirmə: National Cryptologic Science Fund of China, No. 2025NCSF02017.
Məlumatların əlçatanlığı: Müəlliflər nəticələri dəstəkləyən xam məlumatların tələb əsasında təqdim ediləcəyini bildirirlər.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşmasının olmadığını bəyan edirlər.
Müəllif töhfələri: Conceptualization, methodology, software, validation, formal analysis, investigation, data curation və original draft: Wenwen Xia; resources: Dawu Gu; visualization: Wenwen Xia və Geng Wang; supervision və project administration: Geng Wang və Dawu Gu; funding acquisition: Geng Wang və Dawu Gu.
Etik komitə / məlumatlandırılmış razılıq: Mənbədə ayrıca etik komitə və ya informed-consent bəyanatı yoxdur; tədqiqat riyazi alqoritm və sintetik/hesablama əsaslı faktorlaşdırma təcrübəsidir.
Əsas metodoloji məhdudiyyətlər: Nəzəri cost analysis uğursuzluq ssenarisini istisna edir; təcrübə modulları Pollard P-1-ə uyğun smooth quruluş təmin edilərək yaradılıb; müqayisə tək maşın və single-thread-dir; ilk təcrübədə mətn-qrafik instance sayı uyğunsuzluğu var; Şəkil 7-8-in xam rəqəmsal məlumatları cədvəl kimi verilməyib.
Ümumi şərh sərhədi: Tədqiqat uyğun smooth \(P-1\) və ya \(Q-1\) quruluşuna malik modullarda Pollard P-1 faktorlaşdırmasının DSP və FM ilə sürətləndirilə biləcəyini dəstəkləyir; arbitrary RSA modulus, ümumi NFS müqayisəsi və ya müasir bütün RSA açarlarının praktik olaraq sındırıla bildiyi nəticəsini dəstəkləmir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib