

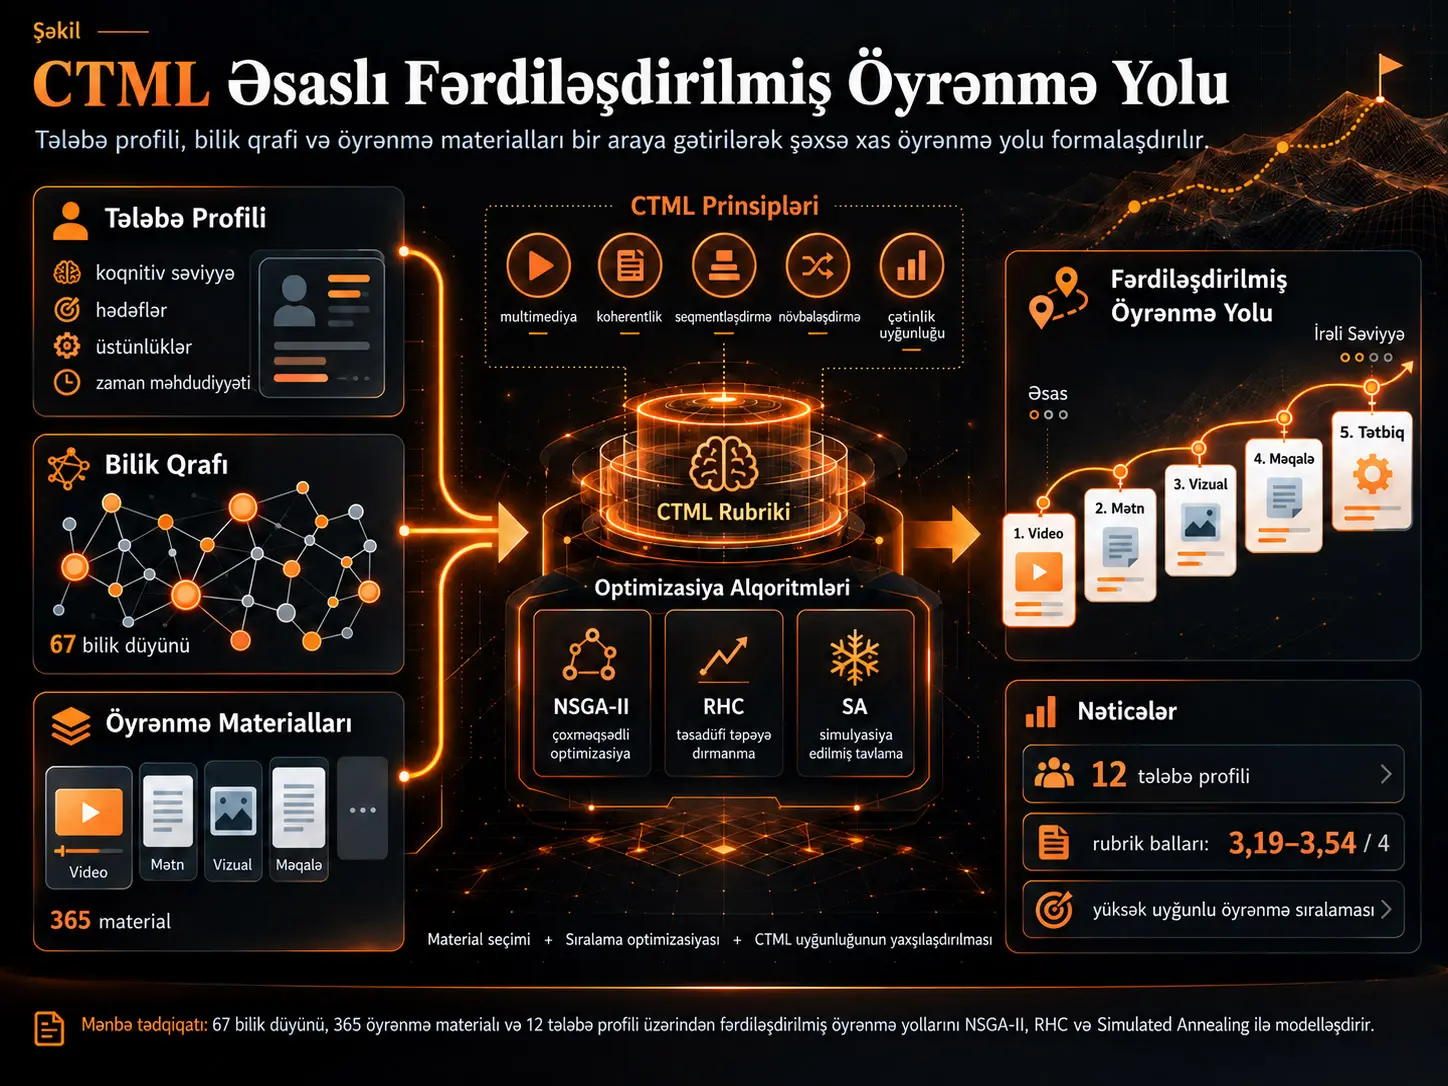
Fərdiləşdirilmiş öyrənmə yolu (Personalized Learning Path, PLP), müəyyən bir öyrənənin məqsədləri, koqnitiv səviyyəsi, məzmun və media üstünlükləri ilə zaman məhdudiyyətləri nəzərə alınaraq öyrənmə materiallarının seçildiyi və pedaqoji əlaqələrinə görə sıralandığı şəxsəxas öyrənmə materialları ardıcıllığıdır. Bu tədqiqat PLP dizaynını eksperimental dəstəyi zəif olan “öyrənmə üslubları” yanaşmasına deyil, Multimediya Öyrənmənin Koqnitiv Nəzəriyyəsinə (Cognitive Theory of Multimedia Learning, CTML) əsaslandırır; CTML prinsiplərini kəmiyyət öyrənmə materialı və PLP rubriklərinə çevirərək material seçimini və material sıralamasını iki çoxməqsədli optimallaşdırma problemi kimi formullaşdırır.
Tədqiqatda kompüter elmləri sahəsindən götürülmüş 67 bilik düyünlü bilik qrafı, 365 real öyrənmə materialı və 12 magistratura səviyyəli tələbədən əldə olunmuş öyrənən profilləri istifadə edilir. Öyrənmə materiallarının seçimi Non-Dominated Sorting Genetic Algorithm II (NSGA-II) ilə, seçilmiş materialların sıralanması isə Random Hill Climber (RHC) və Simulated Annealing (SA) alqoritmləri ilə həyata keçirilmişdir. Ümumi seçim probleminin Subset Sum-dan reduksiya yolu ilə NP-tam olduğu; ümumi çoxdan-çoxa sıralama probleminin interleaving və prerequisite komponentlərinin də ayrı-ayrılıqda NP-tam olduğu göstərilmişdir.
Mənbənin Cədvəl 8-inə görə, 12 tələbə profilinin yekun inteqrasiya olunmuş PLP rubrik ortalamaları 4 bal üzərindən 3,19 ilə 3,54 arasında dəyişir. Ən aşağı dəyər Student 11 üçün 3,19, ən yüksək dəyər isə Student 9 üçün 3,54-dür. RHC və SA sıralama alqoritmləri ümumilikdə yüksək rubrik balları yaratmış; xüsusilə RHC bir çox tələbə profilində üç sıralama meyarının hamısında 4,00 bala çatmışdır.
Bu nəticələr CTML əsaslı optimallaşdırma prosesinin müəyyən edilmiş rubrik baxımından yüksək ballı PLP-lər yarada bildiyini göstərir; tələbələrin bu yollarla həqiqətən daha yaxşı öyrəndiyini göstərmir. Tədqiqatda tələbələrin öyrənmə nailiyyətlərini müqayisə edən insan eksperimenti aparılmamış, PLP rubrikinin real öyrənmə nəticələri ilə təsdiqlənməsi gələcək tədqiqata saxlanmışdır.
Tədqiqatın əsas problemi
Onlayn təhsil sistemi yüzlərlə və ya minlərlə öyrənmə materialına malik ola bilər. Bütün tələbələrin eyni materialları eyni ardıcıllıqla izləməsi onların fərqli bilik səviyyələrini, məqsədlərini, vaxtını və üstünlüklərini nəzərə almır. PLP yanaşması bu problemi hər bir tələbə üçün ayrıca material altçoxluğu və ayrıca öyrənmə ardıcıllığı yaratmaqla həll etməyə çalışır.
Lakin fərdiləşdirmənin hansı pedaqoji qaydaya əsasən aparılacağı kritik sualdır. Mənbə əvvəlki PLP tədqiqatlarında öyrənmə üslublarının geniş istifadə olunduğunu, buna baxmayaraq bu yanaşmanın təhsil və psixologiya ədəbiyyatında güclü empirik əsasa malik olmadığını vurğulayır.
Bu tədqiqatın təklifi PLP dizaynını elmi baxımdan daha güclü öyrənmə nəzəriyyəsinə bağlamaqdır. CTML insanın informasiyanı vizual və eşitmə kanalları ilə emal etdiyini, işçi yaddaşın məhdud olduğunu və davamlı öyrənmə üçün fəal koqnitiv emalın tələb edildiyini qəbul edir. Buna görə materialın yalnız tələbənin “üstünlük verdiyi formada” olması deyil, koqnitiv yükü, strukturlaşdırmanı və mənalı öyrənməni dəstəkləyəcək şəkildə hazırlanması əhəmiyyət qazanır.
CTML Prinsipləri Öyrənmə Alqoritminə Necə Çevrilir?
Tədqiqat CTML-ni birbaşa alqoritmə kodlaşdırmaq əvəzinə, əvvəlcə öyrənmə materiallarını və bütöv PLP-ni qiymətləndirən rubriklərə çevirir. Materiallar multimedia, coherence, worked example, segmenting, signaling, spatial contiguity, temporal contiguity, modality, redundancy, personalization, voice və sourcing prinsipləri baxımından qiymətləndirilir; bu ballar daha sonra çoxməqsədli seçim probleminin dizayn dəyişənlərinə çevrilir.
CTML-nin üç koqnitiv məqsədi
Mənbə CTML-nin tədris dizaynında üç geniş koqnitiv məqsədini əsas götürür:
- Lazımsız koqnitiv emalı azaltmaq: Tələbənin məhdud işçi yaddaşını öyrənmə məqsədi ilə əlaqəsi olmayan informasiyaya sərf etməsinin qarşısını almaq.
- Əsas emalı idarə etmək: Mürəkkəb məzmunun tələbənin işçi yaddaş məhdudiyyətlərinə uyğun şəkildə strukturlaşdırılmasını dəstəkləmək.
- Generativ koqnitiv emalı dəstəkləmək: Tələbənin yeni informasiyanı əvvəlki biliklə fəal şəkildə əlaqələndirib zehni sxem yaratmasını asanlaşdırmaq.
Öyrənmə materialı rubriki
Tədqiqatda istifadə olunan 365 öyrənmə materialı insan tədqiqatçılar tərəfindən CTML uyğunluğu baxımından dörd səviyyəli şkala ilə qiymətləndirilmişdir. 4 ən yüksək uyğunluğu, 1 ən aşağı uyğunluğu; 2 və 3 isə aralıq uyğunluq səviyyələrini təmsil edir.
Dörd ballı quruluş şüurlu seçimdir: neytral orta nöqtədən istifadə edilmir və daha geniş şkalaların yarada biləcəyi süni dəqiqlikdən qaçılır.
PLP rubrikinin seçim meyarları
| Meyar | Simvol | Elmi / alqoritmik məna |
|---|---|---|
| CTML uyğunluğu | Vp | Seçilmiş materialların koqnitiv multimediya prinsiplərinə nə dərəcədə uyğun olduğunu ümumiləşdirir. |
| Çətinlik uyğunluğu | Dp | Materialın çətinliyinin tələbənin müvafiq bilik düyünündəki koqnitiv səviyyəsi ilə nə qədər uyğun gəldiyini ölçür. |
| Öyrənən üstünlüyü | Op | Media və məzmun növünün tələbənin bildirdiyi üstünlüklərlə uyğunluğunu ölçür. |
| Müddət | Tp | Seçilmiş materialların ümumi müddətinin tələbənin müəyyən etdiyi minimum və maksimum müddət intervalına uyğunluğunu təmsil edir. |
| Material bütövlüyü / cohesiveness | Ep | Materialların semantik baxımdan bir-biri ilə nə qədər uyğun olduğunu ölçür. |
| Coherence | Cp | Tələbənin məqsədlərindən kənarda qalan bilik düyünlərinin lazımsız şəkildə əhatə olunmasını cəzalandırır. |
| Segmenting | Sp | Bir materialın orta hesabla neçə bilik düyününü əhatə etdiyini istifadə edərək daha hədəfli hissələri təşviq edir. |
| Multiple-document integration | Mp | Hədəf bilik düyünlərinin birdən çox materialla dəstəklənməsini mükafatlandırır. |
| Topic balance | Bp | Öyrənmə materiallarının hədəf mövzular arasında nə qədər balanslı paylandığını ölçür. |
Əsas seçim tənlikləri
Namizəd PLP daxilindəki materiallar \(\chi_j \in \{0,1\}\) qərar dəyişənləri ilə seçilir. \(\chi_j=1\), \(j\)-ci öyrənmə materialının PLP-yə daxil edildiyini göstərir.
Orta CTML dəyəri:
\[ V_p = \frac{\sum_{j=1}^{n}\chi_j v_j} {|p|} \]
Orta çətinlik uyğunluğu:
\[ D_p = \frac{\sum_{j=1}^{n}\chi_j d_j} {|p|} \]
Orta üstünlük dəyəri:
\[ O_p = \frac{\sum_{j=1}^{n}\chi_j o_j} {|p|} \]
Ümumi PLP müddəti:
\[ T_p=\sum_{j=1}^{n}\chi_j t_j \]
Burada \(v_j\) materialın CTML dəyəri; \(d_j\) çətinlik uyğunluğu; \(o_j\) öyrənən üstünlüyünün dəyəri və \(t_j\) materialın müddətidir.
Materiallararası semantik uyğunluq necə hesablanır?
Hər materialın mətn təsviri Sentence-BERT all-mpnet-base-v2 modeli ilə 768 ölçülü vektora çevrilir. Material cütlərinin cosine similarity dəyərləri hesablanıb [0,1] intervalına normallaşdırılaraq materiallararası cohesiveness dəyəri yaradılır.
Bu istifadə öyrənmə materialının pedaqoji düzgünlüyünü avtomatik ölçmür. Model yalnız material təsvirlərinin semantik oxşarlığının PLP daxilində birlikdə istifadə edilə bilmə meyarlarından biri kimi işlədilməsinə xidmət edir.
Üç məlumat strukturu birlikdə fərdiləşdirməni necə yaradır?
| Məlumat strukturu | Mənbədə istifadə olunan məzmun | PLP-də funksiyası |
|---|---|---|
| Bilik qrafı | 67 bilik düyünü və prerequisite əlaqələri | Hansı mövzuların öyrəniləcəyini və hansı mövzunun hansından əvvəl gəlməli olduğunu müəyyən edir. |
| Öyrənən profili | Koqnitiv səviyyə, hədəf KN-lər, media və məzmun üstünlükləri, müddət məhdudiyyətləri | Eyni material hovuzundan tələbəyə xas problem nümunəsi yaradır. |
| Öyrənmə materialları | 365 materialın çətinlik, media, məzmun, müddət, CTML uyğunluğu və əhatə etdiyi KN-lər kimi metadata-sı | Alqoritmin seçib sıralayacağı namizəd resurs hovuzunu yaradır. |
12 tələbə profilinin əsas fərqləri
| Tələbə | Hədəf KN | Ort. koqnitiv səviyyə | Üstünlük verilən media | Min. müddət (dəq.) | Maks. müddət (dəq.) |
|---|---|---|---|---|---|
| 0 | 4 | 1,88 | Mətn | 360 | 1200 |
| 1 | 5 | 1,45 | Üstünlük yoxdur | 2400 | 4800 |
| 2 | 5 | 2,13 | Video | 30 | 90 |
| 3 | 18 | 1,42 | Mətn | 15 | 60 |
| 4 | 5 | 1,76 | Video | 20 | 90 |
| 5 | 5 | 1,72 | Video | 5 | 60 |
| 6 | 5 | 2,57 | Video | 10 | 30 |
| 7 | 15 | 2,22 | Video | 30 | 90 |
| 8 | 5 | 1,28 | Video | 30 | 90 |
| 9 | 5 | 1,64 | Video | 30 | 120 |
| 10 | 5 | 2,27 | Video | 30 | 120 |
| 11 | 5 | 2,93 | Video | 10 | 60 |
Mənbə uyğunluğu qeydi: Sorğu metodunda tələbələrdən ən çox 5 hədəf KN seçmələrinin istəndiyi bildirilsə də, Student 3 və Student 7 üçün müvafiq olaraq 18 və 15 hədəf KN hesabat verilmişdir. Mənbə bu fərqin necə yarandığını ayrıca izah etmir.
PLP Seçim və Sıralama Problemləri Niyə NP-Tamdır?
Tədqiqatın ümumi çoxməqsədli material seçimi problemi NP-tamdır; çünki yalnız ümumi müddət məhdudiyyəti saxlanıldıqda belə NP-tam Subset Sum problemi polinom zamanda bu problemə reduksiya edilə bilir. Çoxdan-çoxa material–bilik düyünü münasibətində sıralama problemi də interleaving və ya prerequisite məqsədlərindən yalnız biri aktiv olduqda belə NP-tam ola bilər. Bunun əksinə, yalnız çətinliyə görə sıralama adi sıralama alqoritmi ilə polinom zamanda həll edilə bilər.
Material seçimi: Subset Sum reduksiyası
Mənbə əvvəlcə namizəd həllin bütün məhdudiyyətlərinin polinom zamanda yoxlanıla bildiyini göstərərək seçim probleminin NP daxilində olduğunu əsaslandırır. Daha sonra Subset Sum problemindəki hər ədədi bir öyrənmə materialının müddətinə çevirir və minimum ilə maksimum PLP müddətini eyni hədəf dəyərinə bərabərləşdirir.
Bu halda keçərli PLP tapmaq, müddətləri tam olaraq hədəf cəmini verən material altçoxluğunu tapmağa ekvivalent olur. Subset Sum NP-tam olduğuna və reduksiya polinom zamanda aparıla bildiyinə görə seçim problemi NP-çətindir; eyni zamanda NP daxilində olduğu üçün NP-tamdır.
Sıralamada üç məqsəd
Materiallar seçildikdən sonra ikinci problem seçilmiş materialları pedaqoji cəhətdən uyğun ardıcıllığa gətirməkdir. Mənbə üç pozuntu meyarını minimuma endirir:
| Meyar | Simvol | Nə sayılır? |
|---|---|---|
| Çətinlik sıralaması | Hp | Daha çətin materialın daha asan materialdan əvvəl gəlməsi səbəbindən yaranan pozuntular. |
| Prerequisite / elaboration sıralaması | Rp | Ön şərt mövzunu əhatə edən materialdan əvvəl hədəf mövzunun materialının təqdim edildiyi hallar. |
| Interleaving | Ip | Eyni bilik düyününü əhatə edən materialların ard-arda gəlməsi səbəbindən yaranan pozuntular. |
Sıralama alqoritmlərinin istifadə etdiyi normallaşdırılmış birləşik fitness:
\[ fitness = \frac{ H_p/H_M + R_p/R_M + I_p/I_M }{3} \]
Burada \(H_M\), \(R_M\) və \(I_M\) müvafiq meyarların mümkün olan maksimum pozuntu dəyərləridir. Hər komponent [0,1] intervalına gətirilir və daha aşağı fitness daha yaxşı sıralama deməkdir.
Çoxdan-çoxa və çoxdan-birə niyə vacibdir?
| Material–KN münasibəti | Məqsəd | Mürəkkəblik | Əsas metod / sübut |
|---|---|---|---|
| Çoxdan-çoxa | Interleaving + prerequisite + difficulty | NP-tam | Birləşik problem |
| Çoxdan-çoxa | Yalnız interleaving | NP-tam | Hamiltonian Path reduksiyası |
| Çoxdan-çoxa | Yalnız prerequisite | NP-tam | Minimum Feedback Arc reduksiyası |
| Çoxdan-çoxa | Yalnız difficulty | PTIME | Artan çətinliyə görə sıralama |
| Çoxdan-birə | Yalnız interleaving | PTIME | Mənbədə verilən greedy alqoritm |
| Çoxdan-birə | Yalnız prerequisite, DAG | PTIME | Topological sort |
| Çoxdan-birə | Yalnız difficulty | PTIME | Adi sıralama |
| Çoxdan-birə | Üç məqsəd birlikdə | Mənbədə açıq saxlanmışdır | Gələcək tədqiqat |
Bu nəticə “fərdiləşdirilmiş öyrənmə yolu hər halda hesablanması çox çətin problemdir” demək deyil. Ümumi problem sinfi NP-tam ola bilər, lakin müəyyən məlumat strukturları, tək məqsədlər və ya çoxdan-birə material dizaynları polinom zamanda həll edilə bilər.
Tədqiqatın Metodu və Nəticələri
Design Science Research quruluşu
Tədqiqat ümumilikdə Design Science Research Process for Information Systems yanaşmasına uyğun qurulmuşdur. Tədqiqat ardıcıllığı bu məntiqi izləyir: elmi cəhətdən təsdiqlənmiş öyrənmə nəzəriyyəsini seçmək; nəzəriyyəni kəmiyyət rubriklərinə çevirmək; seçim və sıralama problemlərini riyazi şəkildə müəyyənləşdirmək; onların mürəkkəbliyini sübut etmək; real məlumatlarla problem nümunələri yaratmaq; alqoritmləri işlətmək; nəticələri rubrik və statistik testlərlə qiymətləndirmək.
Mənbənin öz metod cədvəlində insan eksperimentlərinin cari qiymətləndirmə mərhələsində yer almadığı xüsusi olaraq qeyd edilir. Bu çatışmazlıq yalnız texniki detal deyil, tədqiqatın pedaqoji şərh sərhədidir.
NSGA-II ilə öyrənmə materialının seçimi
Material seçimi 365 ikili qərar dəyişənindən ibarət xromosomdan istifadə edən PyGAD NSGA-II tətbiqi ilə aparılmışdır. Doqquz xam məqsəd alqoritmin daha həssas axtarış edə bilməsi üçün üç birləşik məqsədə çevrilmişdir.
Normallaşdırılmış dəyərlərdən hesablanan iki davamlı uyğunluq göstəricisi bunlardır:
\[ LM\_Compliance = 3\left( \frac{V_N+D_N+O_N+T_N+E_N}{5} \right)+1 \]
\[ KN\_Compliance = 3\left( \frac{B_N+M_N+C_N+S_N}{4} \right)+1 \]
LM_Compliance, seçilmiş materialların tələbəyə uyğunluğunu; KN_Compliance, bu materialların tələbənin öyrənmə məqsədlərini nə qədər yaxşı qarşıladığını ölçür. Üçüncü məqsəd olan Rubric_Average, doqquz PLP rubrik kateqoriyasının ortalamasıdır.
NSGA-II parametrləri
| Parametr | Mənbə dəyəri |
|---|---|
| Qərar dəyişənlərinin sayı | 365 |
| Population size | 100 |
| Generation sayı | 500 |
| Crossover tipi | Single-point |
| Mutation tipi | Swap |
| Mutation probability | 1/365 |
| Müstəqil işə salınma | Hər tələbə üçün 30 |
| Crossover probability | Konfiqurasiya siyahısında 0,84 |
Mənbədaxili fərq: Parametr axtarışının təsvirində 0,90 crossover ehtimalının tələbə populyasiyasında ən yüksək orta rubrik balını verdiyi bildirildiyi halda, istifadə olunan konfiqurasiya siyahısında 0,84 yazılmışdır. Mənbə yekun konfiqurasiyada niyə fərqli dəyərin istifadə edildiyini izah etmir.
Başlanğıc populyasiya
NSGA-II başlanğıc populyasiyası tamamilə təsadüfi 365 bit yaratmaq əvəzinə problem strukturundan istifadə edən prosedurla qurulmuşdur. Alqoritm əvvəlcə hədəf bilik düyünlərini əhatə edən materialları təsadüfi seçir. Bütün hədəflər əhatə olunub, lakin ümumi müddət minimum müddətdən aşağıdırsa, qalan materiallardan əlavə seçim edir.
10.000 ardıcıl cəhddə zaman məhdudiyyətini ödəyən xromosom yaradıla bilməzsə, qalan populyasiya üçün zaman həddi yumşaldılır və hədəf KN-ləri əhatə etmə prioriteti qorunur. Bu dizayn genetik alqoritmin başlanğıcdan tamamilə mənasız material kombinasiyalarına vaxt sərf etməsini azaltmağı hədəfləyir.
RHC və Simulated Annealing ilə sıralama
Hər iki sıralama alqoritmi təsadüfi material ardıcıllığı ilə başlayır. RHC iki təsadüfi indeksdəki materialların yerini dəyişir və yeni həll daha yaxşı fitness verirsə, dəyişikliyi saxlayır. SA eyni qonşuluq hərəkətindən istifadə edir, lakin xüsusilə erkən iterasiyalarda daha pis həlli müəyyən ehtimalla qəbul etməklə lokal optimumdan çıxa bilməyi hədəfləyir.
| Parametr | Dəyər |
|---|---|
| RHC iterasiya sayı | 10.000 |
| SA iterasiya sayı | 10.000 |
| SA başlanğıc temperaturu | 0,95 |
| SA son temperaturu | 0,01 |
| Soyuma əmsalı α | 0,9995467 |
| Başlanğıcda 0,1 daha pis addımın qəbul ehtimalı | Təxminən 0,90 |
| Hər NSGA-II material dəsti üçün RHC təkrarları | 30 |
| Hər NSGA-II material dəsti üçün SA təkrarları | 30 |
| Hər tələbə üçün hər sıralama alqoritminin ümumi işə salınma sayı | 900 |
SA-nın soyuma əmsalı mənbədə:
\[ \alpha = \left( \frac{T_m}{T_1} \right)^{1/(m-1)} \]
şəklində hesablanmışdır. \(T_1=0,95\), \(T_m=0,01\) və \(m=10.000\) üçün \(\alpha=0,9995467\) alınmışdır.
Dispersiya üçün χ² testi
Alqoritmlər stoxastik olduğuna görə, 30 təkrardakı nəticələrin tələbəyə xas struktur daşımayan təsadüfi nəticələrdən ibarət olub-olmadığını araşdırmaq üçün birtərəfli tək-dispersiya χ² testi istifadə edilmişdir. Əhəmiyyətlilik səviyyəsi \(p=0,05\)-dir.
Dörd ballı diskret bərabər paylanma üçün bir rubrik kateqoriyasının gözlənilən dispersiyası 1,25 qəbul edilmişdir. Doqquz seçim kateqoriyasının ortalaması üçün gözlənilən dəyər:
\[ \sigma^2_{selection} = \frac{1,25}{9} \approx 0,139 \]
Üç sıralama kateqoriyası üçün:
\[ \sigma^2_{sequencing} = \frac{1,25}{3} \approx 0,417 \]
Mənbə kritik dispersiyanı:
\[ \chi^2 = \frac{(n-1)s^2}{\sigma^2} \]
əlaqəsi ilə hesablayır. 30 nümunə üçün 29 sərbəstlik dərəcəsində \(\chi^2=17,708\) istifadə edilmişdir. Buna görə mətndəki hesab:
\[ s^2_{selection} = \frac{17,708 \times 0,139}{29} = 0,0849 \]
\[ s^2_{sequencing} = \frac{17,708 \times 0,417}{29} = 0,254 \]
Mənbədaxili ədədi uyğunsuzluq: Eyni paraqrafın dərhal davamında seçim problemi üçün qəbul həddi 0,8049 kimi yazılmışdır. Bu dəyər yuxarıdakı 0,0849 hesabı ilə uyğun gəlmir. Verianla bu iki dəyəri vahid “düzəldilmiş” dəyər kimi birləşdirmir.
Alqoritmlər 12 Tələbə Profili Üçün Necə Nəticə Verdi?
Mənbənin Cədvəl 8-də NSGA-II ilə seçilmiş və RHC ilə sıralanmış PLP-lərin inteqrasiya olunmuş rubrik ortalamaları 3,19–3,54 / 4 intervalındadır. Student 9 ən yüksək 3,54, Student 11 isə ən aşağı 3,19 dəyərini almışdır. Bununla belə, bütün tələbələr eyni alt meyarlarda güclü deyil; bəzi profillərdə müddət, mövzu balansı və ya segmenting arasında aydın Pareto güzəştləri mövcuddur.
| Tələbə | İnteqrasiya olunmuş orta / 4 |
|---|---|
| 0 | 3,41 |
| 1 | 3,35 |
| 2 | 3,30 |
| 3 | 3,24 |
| 4 | 3,52 |
| 5 | 3,30 |
| 6 | 3,24 |
| 7 | 3,21 |
| 8 | 3,32 |
| 9 | 3,54 |
| 10 | 3,52 |
| 11 | 3,19 |
Student 7 və Student 11: müddət–mövzu balansı gərginliyi
Student 7 və Student 11-in seçim nəticələrində xüsusilə time interval və topic balance meyarları arasında mənfi əlaqə görülmüşdür. Student 7-nin 15 hədəf KN-i və 30–90 dəqiqəlik müddət həddi vardır; Student 11-in isə beş hədəfi və 10–60 dəqiqəlik müddət həddi mövcuddur.
Alqoritm bütün hədəf mövzulara materialı daha balanslı payladıqda müddət həddini aşma riski artır; müddəti daha sərt saxladıqda isə mövzu paylanması pozula bilər. Mənbə bunu çoxməqsədli optimallaşdırmanın real Pareto güzəştinə nümunə kimi şərh edir.
Student 5: uyğunluq ilə topic balance arasında güzəşt
Student 5-də mövzu balansı balı CTML uyğunluğu, çətinlik uyğunluğu və öyrənən üstünlüyü uyğunluğu ilə əks istiqamətdə hərəkət etmişdir. Başqa sözlə, alqoritm bəzi işə salınmalarda materialların tələbə ilə güclü uyğunluğunu, bəzilərində isə hədəf mövzular arasında daha balanslı paylanmanı önə çıxarmışdır.
Student 1: uzun müddət həddinin təsiri
Student 1 üçün minimum müddət 2400 dəqiqə, maksimum müddət 4800 dəqiqədir. Mənbə bu profil üçün həllərin təxminən 80 material ehtiva etdiyini bildirir. Belə böyük dəst tələbənin hədəflərini əhatə edən kifayət qədər material olmadıqda coherence və topic balance kimi meyarlar arasında yeni gərginliklər yaratmışdır.
SA və RHC sıralama nəticələri
| Tələbə | SA ortalaması | RHC ortalaması |
|---|---|---|
| 0 | 4,00 | 4,00 |
| 1 | 3,48 | 4,00 |
| 2 | 4,00 | 4,00 |
| 3 | 4,00 | 4,00 |
| 4 | 4,00 | 4,00 |
| 5 | 4,00 | 4,00 |
| 6 | 4,00 | 4,00 |
| 7 | 3,99 | 4,00 |
| 8 | 3,97 | 3,93 |
| 9 | 3,84 | 3,81 |
| 10 | 3,94 | 3,94 |
| 11 | 4,00 | 4,00 |
Student 1 SA ilə RHC arasındakı ən aydın fərqi göstərir. Təxminən 80 materiallıq böyük həll dəstində SA-nın zaman-zaman daha pis qonşu həlləri qəbul etməsi mənfi üstünlüyə çevrilmiş; SA-nın difficulty və prerequisite ortalamaları müvafiq olaraq təxminən 3,01 və 3,42, inteqrasiya olunmuş sıralama balı isə 3,48 olmuşdur. RHC isə eyni profil üçün 4,00 ortalamaya çatmışdır.
Daha kiçik material dəstlərində SA bəzi hallarda RHC-dən bir qədər yaxşı nəticə verə bilmişdir. Mənbə bunu SA-nın lokal optimumlardan çıxa bilmə xüsusiyyətinin kiçik problem nümunələrində faydalı ola biləcəyinə işarə kimi şərh edir.
Ümumilikdə NP-tam sıralama problemi eksperimentlərdə niyə asan göründü?
Mənbə seçim mərhələsindəki segmenting və topic balance məqsədlərinin sonrakı sıralama problemini təbii olaraq asanlaşdırmış ola biləcəyini müdafiə edir. Segmenting məqsədi az sayda KN-ni əhatə edən daha kiçik və hədəflənmiş materiallara üstünlük verir; bunun nəticəsində bəzi çoxdan-çoxa strukturlar faktiki olaraq çoxdan-birə struktura yaxınlaşa bilər.
Topic balance məqsədi isə öyrənmə materiallarını hədəf KN-lər arasında daha balanslı paylayır. Bu struktur xüsusilə interleaving pozuntularını azaltmağı asanlaşdıra bilər. Nəticədə ümumi riyazi problem NP-tam olsa da, bu 12 real tələbə profili üçün NSGA-II tərəfindən yaradılmış material dəstləri sıralama baxımından nisbətən asan problem nümunələrinə çevrilmişdir.
Bu Tədqiqat CTML Əsaslı PLP-lərin Tələbələrin Daha Yaxşı Öyrənməsini Sübut Edirmi?
Xeyr. Tədqiqat CTML prinsiplərinin riyazi məqsədlərə çevrilə bildiyini və alqoritmlərin bu məqsədlər baxımından yüksək ballı fərdiləşdirilmiş öyrənmə yolları yarada bildiyini göstərir; lakin tələbələrin CTML əsaslı PLP-lərlə daha yüksək öyrənmə, yadda saxlama və ya transfer nailiyyəti əldə etdiyini birbaşa sınaqdan keçirməmişdir. Mənbə bu insan doğrulamasını tədqiqatın növbəti mərhələsinə saxlayır.
Rubrikin keçərliliyi hələ insan öyrənməsi ilə təsdiqlənməyib
365 materialın CTML balları tədqiqatçılar tərəfindən verilmişdir. Həm rubrik dizaynında, həm də materialların insan tərəfindən qiymətləndirilməsində səhv ola bilər. Mənbə buna görə CTML rubrikinin daha çox sınaq və təkmilləşdirmə tələb etdiyini açıq şəkildə bildirir.
Elaboration + difficulty + interleaving fərziyyəsi
Sıralama problemi elaboration/prerequisite, asandan çətinə irəliləmə və interleaving məqsədlərinin birlikdə yaxşılaşdırılmasının daha güclü tələbə nəticələri verəcəyi fərziyyəsinə əsaslanır.
Bu fərziyyə öyrənmə ədəbiyyatı ilə əsaslandırılsa da, bu məqalədə tələbələr iki fərqli sıralama şərtinə təyin edilərək müqayisə edilməmişdir. Buna görə üç meyarın birlikdə optimallaşdırılmasının real öyrənmə üzərində üstünlüyü hələ eksperimental nəticə deyil.
365 material miqyası məhdudiyyəti
Mənbə 365 materiallıq hovuzun nisbətən kiçik olduğunu və daha böyük axtarış məkanlarında alqoritm davranışının yenidən araşdırılmalı olduğunu bildirir. Daha böyük və metadata baxımından daha müxtəlif material hovuzları tələbəyə daha yaxşı uyğun PLP-lər yarada bilər; lakin eyni zamanda seçim probleminin hesablama yükünü də artıra bilər.
NSGA-II-dən başqa alqoritmlər
Tədqiqat doqquz seçim meyarını üç birləşik məqsəddə topladıqdan sonra NSGA-II-dən istifadə etmişdir. Gələcək tədqiqatlarda məqsədlər birləşdirilmədən çoxsaylı məqsədlər üçün hazırlanmış NSGA-III kimi metodlarla nəticələrin müqayisə edilməsi təklif olunur.
Nümunə məhdudiyyəti
Öyrənən profilləri yalnız 12 magistratura səviyyəli tələbədən əldə edilmişdir. Bu say alqoritmik problem nümunələri yaratmaq üçün istifadə olunmuşdur; tələbələrin demoqrafik və ya pedaqoji populyasiyasını təmsil edən geniş təhsil nümunəsi deyil.
Tədqiqatın dəstəklədiyi və dəstəkləmədiyi nəticələr
| Tədqiqatın dəstəklədiyi | Tədqiqatın təkbaşına dəstəkləmədiyi |
|---|---|
| CTML prinsiplərinin PLP seçim və sıralama məqsədlərinə kəmiyyət olaraq çevrilə bilməsi. | CTML əsaslı PLP-nin real tələbələrdə öyrənmə nailiyyətini artırması. |
| Ümumi çoxməqsədli LM seçim probleminin NP-tam olması. | Hər real PLP nümunəsinin praktikada hesablanması mümkün olmayacaq qədər çətin olması. |
| Çoxdan-çoxa sıralamada interleaving və prerequisite məqsədlərinin ayrı-ayrılıqda NP-tamlıq yarada bilməsi. | Çoxdan-birə bütün sıralama problemlərinin NP-tam olması. |
| NSGA-II + RHC/SA araşdırılan məlumat və rubrik altında 3,19–3,54 / 4 inteqrasiya olunmuş PLP balları yaratmışdır. | Bu balların imtahan balı, öyrənmə nailiyyəti və ya tələbə məmnuniyyəti olması. |
| Mənbə öz χ² prosedurunda alqoritm təkrarlarının uniform təsadüfi rubrik qiymətləndirmədən fərqli olduğunu hesabat vermişdir. | Alqoritmin pedaqoji cəhətdən optimal olması və ya başqa metodlardan üstün olması. |
| Mövcud real məlumat nümunələrində RHC və SA sıralama problemləri əksər tələbələr üçün yüksək rubrik balları yaratmışdır. | RHC və ya SA-nın bütün PLP məlumat dəstlərində ən yaxşı alqoritm olması. |
Mənbə və Metod Qeydi
| Orijinal başlıq | A Personalized Learning Path Problem Based on the Cognitive Theory of Multimedia Learning |
|---|---|
| Müəlliflər | Sean Mochocki; Mark Reith; Laurence D. Merkle; Paolo J. Singh; Jonathan Zemmer; Ralucca Gera; Gilbert Peterson; John Jasper; Brett Borghetti |
| Məsul müəllif | Ralucca Gera |
| Qurum 1 | Department of Electrical and Computer Engineering, Air Force Institute of Technology, Wright-Patterson AFB, Ohio, USA |
| Qurum 2 | Department of Applied Mathematics, Naval Postgraduate School, Monterey, California, USA |
| Qurum 3 | The Center for Innovation and Excellence, Air Force Institute of Technology, Wright-Patterson AFB, Ohio, USA |
| Qurum 4 | Department of Mathematics and Statistics, Air Force Institute of Technology, Wright-Patterson AFB, Ohio, USA |
| DOI | 10.3390/aieduc2030025 |
| Jurnal | AI in Education |
| Nəşriyyat | MDPI, Basel, Switzerland |
| Cild / nömrə / məqalə | 2 / 3 / 25 |
| Mənbə növü | Article; Design Science Research əsaslı riyazi və alqoritmik PLP tədqiqatı |
| Qəbul tarixi | 9 Aprel 2026 |
| Reviziya | 12 İyun 2026 |
| Qəbul | 3 İyul 2026 |
| Nəşr | 20 İyul 2026 |
| Resenziya | Resenziyalı jurnal məqaləsi |
| Lisenziya | Creative Commons Attribution 4.0 International (CC BY 4.0) |
| Maliyyələşdirmə | U.S. Department of Veteran Affairs, grant 2022-133; Department of Defense tərəfindən qismən maliyyələşdirmə |
| IRB | 16 Yanvar 2024 tarixində 32 CFR 219.104(d)(2) kateqoriyası çərçivəsində azadolma təsdiqi |
| Məlumatlandırılmış razılıq | Tədqiqatda iştirak edən bütün şəxslərdən alınmışdır. |
| Məlumat və kod | Mənbə tədqiqat orijinal məlumat və kodun AFIT Scholar üzərində açıq şəkildə əlçatan olduğunu bildirir. |
| Maraqların toqquşması | Müəlliflər maraqların toqquşması olmadığını bildirmişdir; maliyyələşdirənlərin tədqiqat dizaynı, məlumat təhlili, şərh, yazı və ya nəşr qərarında rolunun olmadığı qeyd edilmişdir. |
Müəllif töhfələri: Konseptuallaşdırma Sean Mochocki və Mark Reith; metodologiya Sean Mochocki, Mark Reith və Jonathan Zemmer; tədqiqat Sean Mochocki; formal təhlil Sean Mochocki, John Jasper və Laurence D. Merkle; resurslar Mark Reith; proqram təminatı Sean Mochocki; nəzarət Mark Reith; ilkin layihə Sean Mochocki; nəzərdən keçirmə və redaktə Mark Reith, Paolo J. Singh, Ralucca Gera, Gilbert Peterson, Brett Borghetti, John Jasper və Laurence D. Merkle tərəfindən həyata keçirilmişdir.
Məlumat və təkrar istehsal oluna bilmə: Mənbə rubriklərin, məlumat paketinin və alqoritm kodlarının açıq olduğunu bildirir. Bu, riyazi və alqoritmik nəticələrin müstəqil şəkildə yenidən araşdırılmasını asanlaşdırır.
İnstitusional mövqe sərhədi: Məqalədə ifadə olunan fikirlərin müəlliflərə aid olduğu və United States Air Force, Department of Defense və ya United States Government-ın rəsmi siyasətini və ya mövqeyini təmsil etmədiyi bildirilir.
Əsas metodoloji məhdudiyyət: Tədqiqatın son pedaqoji doğrulama mərhələsi olan insan öyrənməsi eksperimenti aparılmamışdır. PLP rubrikinin yüksək bal verməsi tələbənin daha yaxşı öyrəndiyi demək deyil.
Mənbədaxili ədədi qeydlər: NSGA-II crossover axtarışında 0,90 ən yaxşı kimi göstərildiyi halda yekun parametr siyahısı 0,84 verir; seçim dispersiyası hesabında 0,0849 alındığı halda növbəti qəbul cümləsində 0,8049 yazılır; tədqiqat boyunca 12 tələbə profili istifadə edildiyi halda conclusion bir yerdə 11 tələbə deyir. Bu fərqlər Verianla tərəfindən səssizcə düzəldilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib