

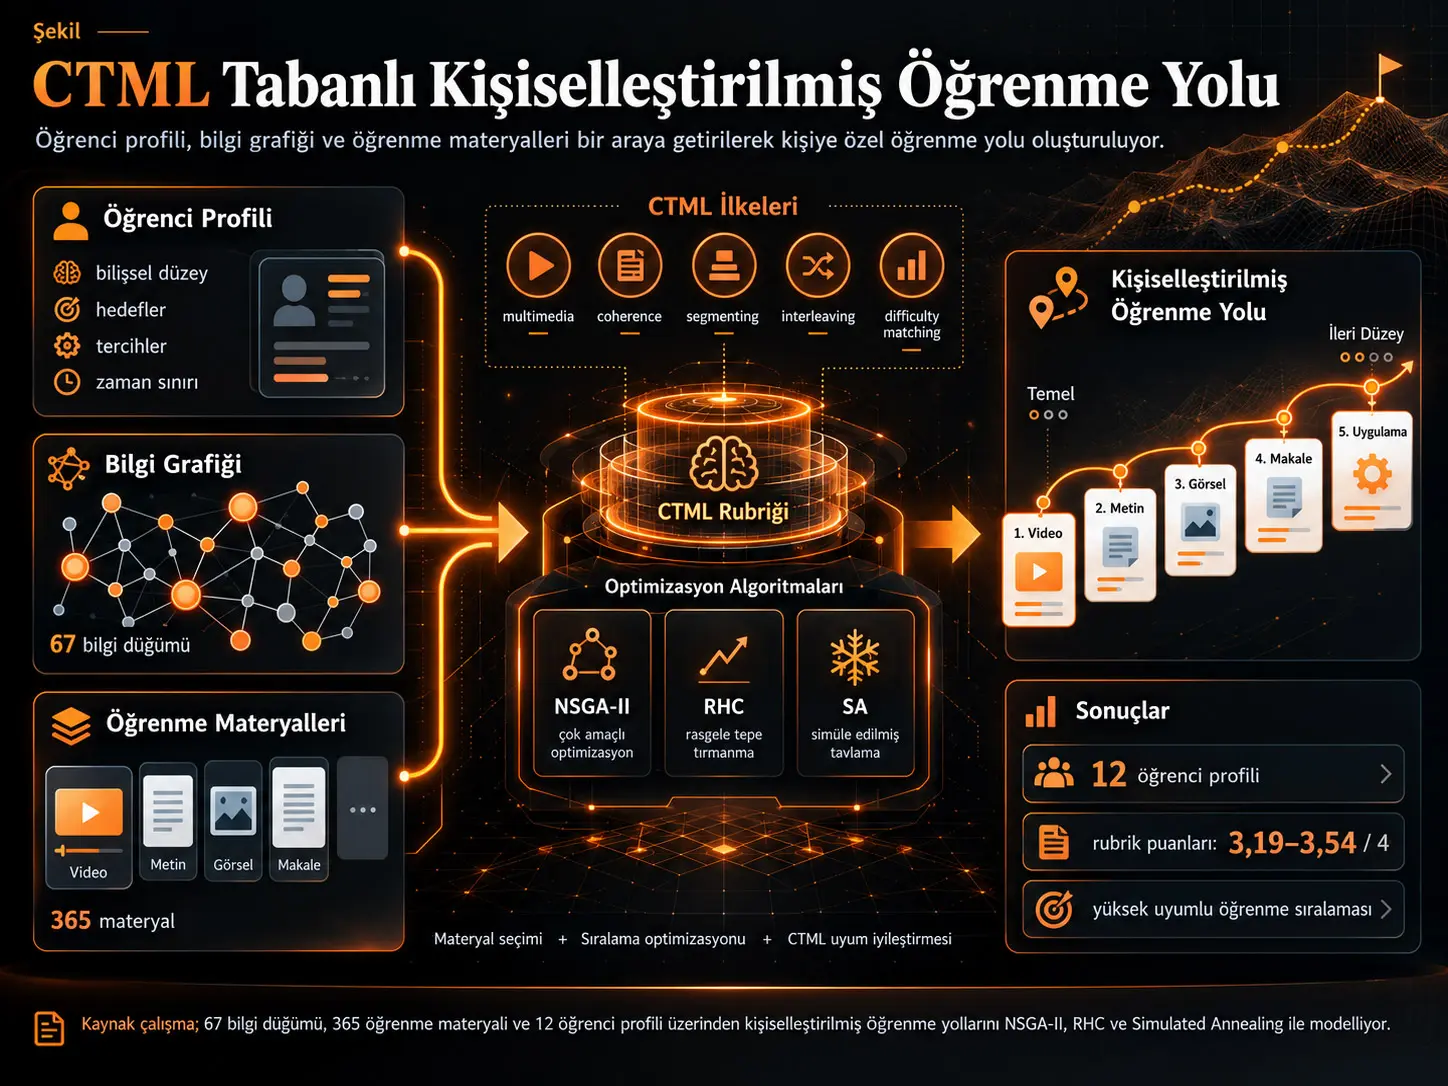
Kişiselleştirilmiş öğrenme yolu (Personalized Learning Path, PLP), belirli bir öğrenenin hedefleri, bilişsel düzeyi, içerik ve medya tercihleri ile zaman kısıtları dikkate alınarak öğrenme materyallerinin seçildiği ve pedagojik ilişkilerine göre sıralandığı kişiye özgü bir öğrenme materyali dizisidir. Bu çalışma PLP tasarımını deneysel desteği zayıf “öğrenme stilleri” yaklaşımına değil, Çoklu Ortam Öğrenmenin Bilişsel Kuramı'na (Cognitive Theory of Multimedia Learning, CTML) dayandırmakta; CTML ilkelerini nicel öğrenme materyali ve PLP rubriklerine dönüştürerek materyal seçimi ile materyal sıralamasını iki çok amaçlı optimizasyon problemi olarak formüle etmektedir.
Çalışmada bilgisayar bilimi alanından türetilmiş 67 bilgi düğümlü bir bilgi grafiği, 365 gerçek öğrenme materyali ve 12 lisansüstü öğrenciden elde edilmiş öğrenen profilleri kullanılmaktadır. Öğrenme materyali seçimi Non-Dominated Sorting Genetic Algorithm II (NSGA-II) ile, seçilen materyallerin sıralanması ise Random Hill Climber (RHC) ve Simulated Annealing (SA) algoritmalarıyla gerçekleştirilmiştir. Genel seçim problemi Subset Sum'dan indirgeme yoluyla NP-tam; genel çoktan-çoğa sıralama probleminin interleaving ve prerequisite bileşenleri de ayrı ayrı NP-tam olarak gösterilmiştir.
Kaynak Tablo 8'e göre 12 öğrenci profilinin nihai bütünleşik PLP rubrik ortalamaları 4 puan üzerinden 3,19 ile 3,54 arasında değişmektedir. En düşük değer Student 11 için 3,19, en yüksek değer Student 9 için 3,54'tür. RHC ve SA sıralama algoritmaları genel olarak yüksek rubrik puanları üretmiş; özellikle RHC birçok öğrenci profilinde üç sıralama ölçütünün tamamında 4,00 puana ulaşmıştır.
Bu sonuçlar CTML tabanlı optimizasyon sürecinin tanımlanan rubrik açısından yüksek puanlı PLP'ler üretebildiğini göstermektedir; öğrencilerin bu yollarla gerçekten daha iyi öğrendiğini göstermemektedir. Çalışmada öğrencilerin öğrenme kazanımlarını karşılaştıran bir insan deneyi yapılmamış, PLP rubriğinin gerçek öğrenme sonuçlarıyla doğrulanması gelecek çalışmaya bırakılmıştır.
Araştırmanın temel problemi
Bir çevrim içi eğitim sistemi yüzlerce veya binlerce öğrenme materyaline sahip olabilir. Bütün öğrencilerin aynı materyalleri aynı sırada izlemesi, öğrencilerin farklı bilgi düzeylerini, hedeflerini, zamanlarını ve tercihlerini dikkate almaz. PLP yaklaşımı bu sorunu, her öğrenci için ayrı materyal alt kümesi ve ayrı öğrenme sırası oluşturarak çözmeye çalışır.
Ancak kişiselleştirmenin hangi pedagojik kurala göre yapılacağı kritik bir sorundur. Kaynak, önceki PLP çalışmalarında öğrenme stillerinin yaygın biçimde kullanıldığını, buna karşın bu yaklaşımın eğitim ve psikoloji literatüründe güçlü ampirik temele sahip olmadığını vurgulamaktadır.
Bu çalışmanın önerisi, PLP tasarımının bilimsel olarak daha güçlü bir öğrenme kuramına bağlanmasıdır. CTML, insanın görsel ve işitsel kanallarla bilgi işlediğini, çalışma belleğinin sınırlı olduğunu ve kalıcı öğrenme için aktif bilişsel işleme gerektiğini kabul eder. Bu nedenle materyalin yalnız öğrencinin “tercih ettiği biçimde” olması değil; bilişsel yükü, yapılandırmayı ve anlamlı öğrenmeyi destekleyecek biçimde tasarlanmış olması önem kazanır.
CTML İlkeleri Bir Öğrenme Algoritmasına Nasıl Dönüştürülüyor?
Çalışma CTML'yi doğrudan algoritmaya kodlamak yerine önce öğrenme materyallerini ve bütün PLP'yi puanlayan rubriklere dönüştürmektedir. Materyaller multimedia, coherence, worked example, segmenting, signaling, spatial contiguity, temporal contiguity, modality, redundancy, personalization, voice ve sourcing ilkeleri açısından değerlendirilmekte; bu puanlar daha sonra çok amaçlı seçim probleminin tasarım değişkenlerine çevrilmektedir.
CTML'nin üç bilişsel hedefi
Kaynak CTML'nin öğretim tasarımında üç geniş bilişsel hedefini esas almaktadır:
- Gereksiz bilişsel işlemeyi azaltmak: Öğrencinin sınırlı çalışma belleğini öğrenme hedefiyle ilgisiz bilgiye harcamasını önlemek.
- Temel işlemeyi yönetmek: Karmaşık içeriğin öğrencinin çalışma belleği sınırlarına uygun biçimde yapılandırılmasını desteklemek.
- Üretici bilişsel işlemeyi desteklemek: Öğrencinin yeni bilgi ile önceki bilgiyi aktif olarak ilişkilendirip zihinsel şema oluşturmasını kolaylaştırmak.
Öğrenme materyali rubriği
Çalışmada kullanılan 365 öğrenme materyali insan araştırmacılar tarafından CTML uyumu açısından dört düzeyli bir ölçekle derecelendirilmiştir. 4 en yüksek uyumu, 1 en düşük uyumu; 2 ve 3 ara uyum düzeylerini temsil eder.
Dört puanlı yapı bilinçli bir tercihtir: nötr orta nokta kullanılmamakta ve daha geniş ölçeklerin oluşturabileceği yapay hassasiyetten kaçınılmaktadır.
PLP rubriğinin seçim ölçütleri
| Ölçüt | Sembol | Bilimsel / algoritmik anlam |
|---|---|---|
| CTML uyumu | Vp | Seçilen materyallerin bilişsel çoklu ortam ilkelerine ne ölçüde uyduğunu özetler. |
| Zorluk eşleşmesi | Dp | Materyal zorluğunun öğrencinin ilgili bilgi düğümündeki bilişsel düzeyiyle ne kadar eşleştiğini ölçer. |
| Öğrenen tercihi | Op | Medya ve içerik türünün öğrencinin bildirdiği tercihleriyle uyumunu ölçer. |
| Süre | Tp | Seçilen materyallerin toplam süresinin öğrencinin belirlediği minimum ve maksimum süre aralığına uygunluğunu temsil eder. |
| Materyal bütünlüğü / cohesiveness | Ep | Materyallerin anlamsal olarak birbirleriyle ne kadar uyumlu olduğunu ölçer. |
| Coherence | Cp | Öğrencinin hedefleri dışında kalan bilgi düğümlerinin gereksiz biçimde kapsanmasını cezalandırır. |
| Segmenting | Sp | Bir materyalin ortalama olarak kaç bilgi düğümünü kapsadığını kullanarak daha hedefli parçaları teşvik eder. |
| Multiple-document integration | Mp | Hedef bilgi düğümlerinin birden fazla materyalle desteklenmesini ödüllendirir. |
| Topic balance | Bp | Öğrenme materyallerinin hedef konular arasında ne kadar dengeli dağıtıldığını ölçer. |
Temel seçim denklemleri
Bir aday PLP içindeki materyaller \(\chi_j \in \{0,1\}\) karar değişkenleriyle seçilir. \(\chi_j=1\), \(j\). öğrenme materyalinin PLP'ye dâhil edildiğini gösterir.
Ortalama CTML değeri:
\[ V_p = \frac{\sum_{j=1}^{n}\chi_j v_j} {|p|} \]
Ortalama zorluk eşleşmesi:
\[ D_p = \frac{\sum_{j=1}^{n}\chi_j d_j} {|p|} \]
Ortalama tercih değeri:
\[ O_p = \frac{\sum_{j=1}^{n}\chi_j o_j} {|p|} \]
Toplam PLP süresi:
\[ T_p=\sum_{j=1}^{n}\chi_j t_j \]
Burada \(v_j\), materyalin CTML değeri; \(d_j\), zorluk eşleşmesi; \(o_j\), öğrenen tercih değeri ve \(t_j\), materyalin süresidir.
Materyaller arası anlamsal uyum nasıl hesaplanıyor?
Her materyalin metinsel açıklaması Sentence-BERT all-mpnet-base-v2 modeliyle 768 boyutlu bir vektöre dönüştürülmektedir. Materyal çiftlerinin cosine similarity değerleri hesaplanıp [0,1] aralığına normalize edilerek materyaller arası cohesiveness değeri oluşturulmaktadır.
Bu kullanım, öğrenme materyalinin pedagojik doğruluğunu otomatik olarak ölçmez. Model yalnız materyal açıklamalarının anlamsal benzerliğinin, PLP içinde birlikte kullanılabilirlik ölçütlerinden biri olarak kullanılmasına hizmet etmektedir.
Üç veri yapısı birlikte nasıl kişiselleştirme oluşturuyor?
| Veri yapısı | Kaynakta kullanılan içerik | PLP'deki işlev |
|---|---|---|
| Bilgi grafiği | 67 bilgi düğümü ve prerequisite ilişkileri | Hangi konuların öğrenileceğini ve hangi konunun hangisinden önce gelmesi gerektiğini belirler. |
| Öğrenen profili | Bilişsel düzey, hedef KN'ler, medya ve içerik tercihleri, süre sınırları | Aynı materyal havuzundan öğrenciye özgü problem örneği oluşturur. |
| Öğrenme materyalleri | 365 materyalin zorluk, medya, içerik, süre, CTML uyumu ve kapsadığı KN'ler gibi metadata'sı | Algoritmanın seçip sıralayacağı aday kaynak havuzunu oluşturur. |
12 öğrenci profilinin temel farklılıkları
| Öğrenci | Hedef KN | Ort. bilişsel düzey | Tercih edilen medya | Min. süre (dk.) | Maks. süre (dk.) |
|---|---|---|---|---|---|
| 0 | 4 | 1,88 | Metin | 360 | 1200 |
| 1 | 5 | 1,45 | Tercih yok | 2400 | 4800 |
| 2 | 5 | 2,13 | Video | 30 | 90 |
| 3 | 18 | 1,42 | Metin | 15 | 60 |
| 4 | 5 | 1,76 | Video | 20 | 90 |
| 5 | 5 | 1,72 | Video | 5 | 60 |
| 6 | 5 | 2,57 | Video | 10 | 30 |
| 7 | 15 | 2,22 | Video | 30 | 90 |
| 8 | 5 | 1,28 | Video | 30 | 90 |
| 9 | 5 | 1,64 | Video | 30 | 120 |
| 10 | 5 | 2,27 | Video | 30 | 120 |
| 11 | 5 | 2,93 | Video | 10 | 60 |
Kaynak tutarlılık notu: Anket yönteminde öğrencilerin en fazla 5 hedef KN seçmesi istendiği belirtilmesine rağmen Student 3 ve Student 7 için sırasıyla 18 ve 15 hedef KN raporlanmıştır. Kaynak bu farkın nasıl oluştuğunu ayrıca açıklamamaktadır.
PLP Seçim ve Sıralama Problemleri Neden NP-Tamdır?
Çalışmanın genel çok amaçlı materyal seçimi problemi NP-tamdır; çünkü yalnız toplam süre kısıtı bırakıldığında bile NP-tam Subset Sum problemi polinom zamanda bu probleme indirgenebilmektedir. Çoktan-çoğa materyal–bilgi düğümü ilişkisinde sıralama problemi de interleaving veya prerequisite hedeflerinden yalnız biri aktif olduğunda dahi NP-tam olabilir. Buna karşılık yalnız zorluğa göre sıralama, normal sıralama algoritmasıyla polinom zamanda çözülebilir.
Materyal seçimi: Subset Sum indirgemesi
Kaynak, seçim probleminin NP içinde olduğunu önce aday çözümün bütün kısıtlarının polinom zamanda denetlenebildiğini göstererek kurar. Daha sonra Subset Sum problemindeki her sayıyı bir öğrenme materyali süresine dönüştürür ve minimum ile maksimum PLP süresini aynı hedef değere eşitler.
Bu durumda geçerli PLP bulmak, süreleri tam olarak hedef toplamı veren bir materyal alt kümesi bulmakla eşdeğer hâle gelir. Subset Sum NP-tam olduğundan ve indirgeme polinom zamanda yapılabildiğinden seçim problemi NP-zordur; aynı zamanda NP içinde olduğu için NP-tamdır.
Sıralamada üç hedef
Materyaller seçildikten sonra ikinci problem, seçili materyalleri pedagojik olarak uygun bir sıra hâline getirmektir. Kaynak üç ihlal ölçütünü minimize etmektedir:
| Ölçüt | Sembol | Ne sayılıyor? |
|---|---|---|
| Zorluk sıralaması | Hp | Daha zor bir materyalin daha kolay materyalden önce gelmesi nedeniyle oluşan ihlaller. |
| Prerequisite / elaboration sıralaması | Rp | Önkoşul konuyu kapsayan materyalden önce hedef konunun materyalinin sunulduğu durumlar. |
| Interleaving | Ip | Aynı bilgi düğümünü kapsayan materyallerin art arda gelmesi nedeniyle oluşan ihlaller. |
Sıralama algoritmalarının kullandığı normalize edilmiş birleşik fitness:
\[ fitness = \frac{ H_p/H_M + R_p/R_M + I_p/I_M }{3} \]
Burada \(H_M\), \(R_M\) ve \(I_M\) ilgili ölçütlerin mümkün olan maksimum ihlal değerleridir. Her bileşen [0,1] aralığına getirilir ve daha düşük fitness daha iyi sıralama anlamına gelir.
Çoktan-çoğa ve çoktan-bire neden önemli?
| Materyal–KN ilişkisi | Hedef | Karmaşıklık | Temel yöntem / kanıt |
|---|---|---|---|
| Çoktan-çoğa | Interleaving + prerequisite + difficulty | NP-tam | Birleşik problem |
| Çoktan-çoğa | Yalnız interleaving | NP-tam | Hamiltonian Path indirgemesi |
| Çoktan-çoğa | Yalnız prerequisite | NP-tam | Minimum Feedback Arc indirgemesi |
| Çoktan-çoğa | Yalnız difficulty | PTIME | Artan zorlukta sıralama |
| Çoktan-bire | Yalnız interleaving | PTIME | Kaynakta verilen greedy algoritma |
| Çoktan-bire | Yalnız prerequisite, DAG | PTIME | Topological sort |
| Çoktan-bire | Yalnız difficulty | PTIME | Normal sıralama |
| Çoktan-bire | Üç hedef birlikte | Kaynakta açık bırakılmıştır | Gelecek çalışma |
Bu sonuç, “kişiselleştirilmiş öğrenme yolu her durumda hesaplanması çok zor bir problemdir” anlamına gelmez. Genel problem sınıfı NP-tam olabilirken belirli veri yapıları, tek hedefler veya çoktan-bire materyal tasarımları polinom zamanda çözülebilir.
Çalışmanın Yöntemi ve Bulguları
Design Science Research yapısı
Çalışma genel olarak Design Science Research Process for Information Systems yaklaşımına göre yapılandırılmıştır. Araştırma sırası şu mantığı izlemektedir: bilimsel olarak doğrulanmış öğrenme kuramını seçmek; kuramı nicel rubriklere dönüştürmek; seçim ve sıralama problemlerini matematiksel olarak tanımlamak; karmaşıklıklarını kanıtlamak; gerçek verilerle problem örnekleri üretmek; algoritmaları çalıştırmak; sonuçları rubrik ve istatistiksel testlerle değerlendirmek.
Kaynağın kendi yöntem tablosunda insan deneylerinin mevcut değerlendirme aşamasında bulunmadığı özellikle belirtilmektedir. Bu eksiklik yalnız teknik ayrıntı değil, çalışmanın pedagojik yorum sınırıdır.
NSGA-II ile öğrenme materyali seçimi
Materyal seçimi, 365 ikili karar değişkeninden oluşan kromozom kullanan PyGAD NSGA-II uygulamasıyla yapılmıştır. Dokuz ham hedef, algoritmanın daha duyarlı arama yapabilmesi amacıyla üç birleşik hedefe dönüştürülmüştür.
Normalize edilmiş değerlerden hesaplanan iki sürekli uyum ölçütü şunlardır:
\[ LM\_Compliance = 3\left( \frac{V_N+D_N+O_N+T_N+E_N}{5} \right)+1 \]
\[ KN\_Compliance = 3\left( \frac{B_N+M_N+C_N+S_N}{4} \right)+1 \]
LM_Compliance, seçilen materyallerin öğrenciye uygunluğunu; KN_Compliance, bu materyallerin öğrencinin öğrenme hedeflerini ne kadar iyi karşıladığını ölçer. Üçüncü amaç olan Rubric_Average, dokuz PLP rubrik kategorisinin ortalamasıdır.
NSGA-II parametreleri
| Parametre | Kaynak değeri |
|---|---|
| Karar değişkeni sayısı | 365 |
| Population size | 100 |
| Generation sayısı | 500 |
| Crossover tipi | Single-point |
| Mutation tipi | Swap |
| Mutation probability | 1/365 |
| Bağımsız çalıştırma | Her öğrenci için 30 |
| Crossover probability | Konfigürasyon listesinde 0,84 |
Kaynak-içi farklılık: Parametre taraması açıklamasında 0,90 crossover olasılığının öğrenci popülasyonunda en yüksek ortalama rubrik puanını verdiği belirtilirken, kullanılan konfigürasyon listesi 0,84 yazmaktadır. Kaynak neden farklı bir değerin nihai konfigürasyonda kullanıldığını açıklamamaktadır.
Başlangıç popülasyonu
NSGA-II başlangıç popülasyonu tamamen rastgele 365 bit üretmek yerine problem yapısını kullanan bir prosedürle oluşturulmuştur. Algoritma önce hedef bilgi düğümlerini kapsayan materyalleri rastgele seçer. Hedeflerin tamamı kapsanmış ancak toplam süre minimum sürenin altındaysa kalan materyaller arasından ek seçim yapar.
10.000 ardışık girişimde zaman kısıtını karşılayan kromozom üretilemezse kalan popülasyon için zaman sınırı gevşetilip hedef KN'leri kapsama önceliği korunur. Bu tasarım, genetik algoritmanın başlangıçtan itibaren tamamen anlamsız materyal kombinasyonlarında zaman kaybetmesini azaltmayı amaçlar.
RHC ve Simulated Annealing ile sıralama
Her iki sıralama algoritması rastgele bir materyal dizisiyle başlar. RHC iki rastgele indeksteki materyali değiştirir ve yeni çözüm daha iyi fitness sağlıyorsa değişikliği korur. SA aynı komşuluk hareketini kullanır ancak özellikle erken iterasyonlarda daha kötü bir çözümü belirli bir olasılıkla kabul ederek yerel optimumdan kaçabilmeyi amaçlar.
| Parametre | Değer |
|---|---|
| RHC iterasyon sayısı | 10.000 |
| SA iterasyon sayısı | 10.000 |
| SA başlangıç sıcaklığı | 0,95 |
| SA son sıcaklığı | 0,01 |
| Soğuma katsayısı α | 0,9995467 |
| Başlangıçta 0,1 daha kötü adıma kabul olasılığı | Yaklaşık 0,90 |
| Her NSGA-II materyal kümesi için RHC tekrarları | 30 |
| Her NSGA-II materyal kümesi için SA tekrarları | 30 |
| Öğrenci başına her sıralama algoritmasının toplam çalıştırılması | 900 |
SA'nın soğuma katsayısı kaynakta:
\[ \alpha = \left( \frac{T_m}{T_1} \right)^{1/(m-1)} \]
biçiminde hesaplanmıştır. \(T_1=0,95\), \(T_m=0,01\) ve \(m=10.000\) için \(\alpha=0,9995467\) elde edilmiştir.
Varyans için χ² testi
Algoritmalar stokastik olduğundan, 30 tekrardaki sonuçların öğrenciye özgü yapı taşımayan rastgele sonuçlardan oluşup oluşmadığını incelemek için tek taraflı tek-varyans χ² testi kullanılmıştır. Anlamlılık düzeyi \(p=0,05\)'tir.
Dört puanlı ayrık uniform dağılım için tek rubrik kategorisinin beklenen varyansı 1,25 alınmıştır. Dokuz seçim kategorisinin ortalaması için beklenen değer:
\[ \sigma^2_{selection} = \frac{1,25}{9} \approx 0,139 \]
Üç sıralama kategorisi için:
\[ \sigma^2_{sequencing} = \frac{1,25}{3} \approx 0,417 \]
Kaynak kritik varyansı:
\[ \chi^2 = \frac{(n-1)s^2}{\sigma^2} \]
bağıntısıyla hesaplamaktadır. 30 örnek için 29 serbestlik derecesinde \(\chi^2=17,708\) kullanılmıştır. Buna göre metindeki hesap:
\[ s^2_{selection} = \frac{17,708 \times 0,139}{29} = 0,0849 \]
\[ s^2_{sequencing} = \frac{17,708 \times 0,417}{29} = 0,254 \]
Kaynak-içi sayısal tutarsızlık: Aynı paragrafın hemen devamında seçim problemi için kabul eşiği 0,8049 olarak yazılmıştır. Bu değer yukarıdaki 0,0849 hesabıyla uyuşmamaktadır. Verianla bu iki değeri tek bir “düzeltilmiş” değer gibi birleştirmemektedir.
Algoritmalar 12 Öğrenci Profili İçin Nasıl Sonuç Verdi?
Kaynak Tablo 8'de, NSGA-II ile seçilen ve RHC ile sıralanan PLP'lerin bütünleşik rubrik ortalamaları 3,19–3,54 / 4 aralığındadır. Student 9 en yüksek 3,54, Student 11 en düşük 3,19 değeri almıştır. Bununla birlikte bütün öğrenciler aynı alt ölçütlerde güçlü değildir; bazı profillerde süre, konu dengesi veya segmenting arasında belirgin Pareto ödünleşimleri bulunmaktadır.
| Öğrenci | Bütünleşik ortalama / 4 |
|---|---|
| 0 | 3,41 |
| 1 | 3,35 |
| 2 | 3,30 |
| 3 | 3,24 |
| 4 | 3,52 |
| 5 | 3,30 |
| 6 | 3,24 |
| 7 | 3,21 |
| 8 | 3,32 |
| 9 | 3,54 |
| 10 | 3,52 |
| 11 | 3,19 |
Student 7 ve Student 11: süre–konu dengesi gerilimi
Student 7 ve Student 11'in seçim sonuçlarında özellikle time interval ve topic balance ölçütleri arasında negatif ilişki görülmüştür. Student 7'nin 15 hedef KN'si ve 30–90 dakikalık süre sınırı vardır; Student 11'in ise beş hedefi ve 10–60 dakika sınırı bulunmaktadır.
Algoritma bütün hedef konulara daha dengeli materyal dağıttığında süre sınırını aşma riski artmakta; süreyi daha sıkı tuttuğunda ise konu dağılımı bozulabilmektedir. Kaynak bunu çok amaçlı optimizasyonun gerçek Pareto ödünleşmesine örnek olarak yorumlamaktadır.
Student 5: eşleşme ile topic balance arasında ödünleşim
Student 5'te konu dengesi puanı CTML eşleşmesi, zorluk eşleşmesi ve öğrenen tercih eşleşmesiyle ters yönlü hareket etmiştir. Bir başka ifadeyle algoritma bazı çalıştırmalarda materyallerin öğrenciyle güçlü eşleşmesini, bazı çalıştırmalarda hedef konular arasında daha dengeli dağılımı öne çıkarmıştır.
Student 1: uzun süre sınırının etkisi
Student 1 için minimum süre 2400 dakika, maksimum süre 4800 dakikadır. Kaynak bu profil için çözümlerin yaklaşık 80 materyal içerdiğini belirtmektedir. Böylesine büyük bir set, öğrencinin hedeflerini kapsayan yeterli materyal bulunmadığında coherence ve topic balance gibi kriterler arasında yeni gerilimler oluşturmuştur.
SA ve RHC sıralama sonuçları
| Öğrenci | SA ortalaması | RHC ortalaması |
|---|---|---|
| 0 | 4,00 | 4,00 |
| 1 | 3,48 | 4,00 |
| 2 | 4,00 | 4,00 |
| 3 | 4,00 | 4,00 |
| 4 | 4,00 | 4,00 |
| 5 | 4,00 | 4,00 |
| 6 | 4,00 | 4,00 |
| 7 | 3,99 | 4,00 |
| 8 | 3,97 | 3,93 |
| 9 | 3,84 | 3,81 |
| 10 | 3,94 | 3,94 |
| 11 | 4,00 | 4,00 |
Student 1, SA ile RHC arasındaki en belirgin ayrımı göstermektedir. Yaklaşık 80 materyalli büyük çözüm setinde SA'nın zaman zaman daha kötü komşu çözümleri kabul etmesi dezavantaja dönüşmüş; SA'nın difficulty ve prerequisite ortalamaları sırasıyla yaklaşık 3,01 ve 3,42, bütünleşik sıralama puanı 3,48 olmuştur. RHC ise aynı profil için 4,00 ortalamaya ulaşmıştır.
Daha küçük materyal setlerinde SA bazı durumlarda RHC'den biraz daha iyi sonuç verebilmiştir. Kaynak bunu SA'nın yerel optimumlardan kaçabilme özelliğinin küçük problem örneklerinde yararlı olabileceğine ilişkin bir işaret olarak yorumlamaktadır.
Neden genel olarak NP-tam bir sıralama problemi deneylerde kolay göründü?
Kaynak, seçim aşamasındaki segmenting ve topic balance hedeflerinin daha sonraki sıralama problemini doğal olarak kolaylaştırmış olabileceğini savunmaktadır. Segmenting hedefi az sayıda KN kapsayan daha küçük ve hedefli materyalleri tercih eder; bunun sonucunda bazı çoktan-çoğa yapıların fiilen çoktan-bire yapıya yaklaşması mümkündür.
Topic balance hedefi ise öğrenme materyallerini hedef KN'ler arasında daha dengeli dağıtır. Bu yapı özellikle interleaving ihlallerini azaltmayı kolaylaştırabilir. Sonuç olarak genel matematiksel problem NP-tam olsa da bu 12 gerçek öğrenci profili için NSGA-II tarafından üretilen materyal kümeleri sıralama açısından görece kolay problem örneklerine dönüşmüştür.
Bu Çalışma CTML Tabanlı PLP'lerin Öğrencilerin Daha İyi Öğrenmesini Kanıtlıyor mu?
Hayır. Çalışma CTML ilkelerinin matematiksel hedeflere dönüştürülebileceğini ve algoritmaların bu hedefler açısından yüksek puanlı kişiselleştirilmiş öğrenme yolları üretebildiğini göstermektedir; ancak öğrencilerin CTML tabanlı PLP'lerle daha yüksek öğrenme, hatırlama veya transfer başarısı elde ettiğini doğrudan test etmemiştir. Kaynak bu insan doğrulamasını araştırmanın bir sonraki aşaması olarak bırakmaktadır.
Rubrik geçerliği henüz insan öğrenmesiyle doğrulanmadı
365 materyalin CTML puanları araştırmacılar tarafından verilmiştir. Hem rubrik tasarımında hem de materyallerin insan tarafından derecelendirilmesinde hata bulunması mümkündür. Kaynak bu nedenle CTML rubriğinin daha fazla test ve iyileştirme gerektirdiğini açıkça belirtmektedir.
Elaboration + difficulty + interleaving varsayımı
Sıralama problemi, elaboration/prerequisite, kolaydan zora ilerleme ve interleaving hedeflerinin birlikte iyileştirilmesinin daha güçlü öğrenci sonuçları sağlayacağı varsayımına dayanmaktadır.
Bu varsayım öğrenme literatürüyle gerekçelendirilmiş olsa da bu makalede öğrenciler iki farklı sıralama koşuluna atanıp karşılaştırılmamıştır. Dolayısıyla üç ölçütün birlikte optimizasyonunun gerçek öğrenme üzerindeki üstünlüğü henüz deneysel sonuç değildir.
365 materyal ölçek sınırı
Kaynak, 365 materyallik havuzun görece küçük olduğunu ve daha büyük arama uzaylarında algoritma davranışının yeniden incelenmesi gerektiğini belirtmektedir. Daha büyük ve metadata bakımından daha çeşitli materyal havuzları, öğrenciye daha iyi uyan PLP'ler yaratabilir; ancak aynı zamanda seçim probleminin hesaplama yükünü de artırabilir.
NSGA-II dışındaki algoritmalar
Çalışma dokuz seçim ölçütünü üç birleşik amaçta topladıktan sonra NSGA-II kullanmıştır. Gelecek çalışmaların amaçları birleştirmeden, çok sayıda hedef için tasarlanmış NSGA-III gibi yöntemlerle sonuçları karşılaştırması önerilmektedir.
Örneklem sınırı
Öğrenen profilleri yalnız 12 lisansüstü öğrenciden elde edilmiştir. Bu sayı algoritmik problem örnekleri oluşturmak için kullanılmıştır; öğrencilerin demografik veya pedagojik popülasyonunu temsil eden geniş eğitim örneklemi değildir.
Çalışmanın desteklediği ve desteklemediği sonuçlar
| Çalışmanın desteklediği | Çalışmanın tek başına desteklemediği |
|---|---|
| CTML ilkelerinin PLP seçim ve sıralama hedeflerine nicel olarak dönüştürülebileceği. | CTML tabanlı PLP'nin gerçek öğrencilerde öğrenme kazanımını artırdığı. |
| Genel çok amaçlı LM seçim probleminin NP-tam olduğu. | Her gerçek PLP örneğinin pratikte hesaplanamayacak kadar zor olduğu. |
| Çoktan-çoğa sıralamada interleaving ve prerequisite hedeflerinin ayrı ayrı NP-tamlık oluşturabildiği. | Çoktan-bire bütün sıralama problemlerinin NP-tam olduğu. |
| NSGA-II + RHC/SA, incelenen veri ve rubrik altında 3,19–3,54 / 4 bütünleşik PLP puanları üretmiştir. | Bu puanların sınav puanı, öğrenme başarısı veya öğrenci memnuniyeti olduğu. |
| Kaynak kendi χ² prosedüründe algoritma tekrarlarının uniform rastgele rubrik puanlamadan farklı olduğunu raporlamıştır. | Algoritmanın pedagojik olarak optimal olduğu veya başka yöntemlerden üstün olduğu. |
| Mevcut gerçek veri örneklerinde RHC ve SA sıralama problemleri çoğu öğrenci için yüksek rubrik puanları üretmiştir. | RHC veya SA'nın bütün PLP veri kümelerinde en iyi algoritma olduğu. |
Kaynak ve Yöntem Notu
| Özgün başlık | A Personalized Learning Path Problem Based on the Cognitive Theory of Multimedia Learning |
|---|---|
| Yazarlar | Sean Mochocki; Mark Reith; Laurence D. Merkle; Paolo J. Singh; Jonathan Zemmer; Ralucca Gera; Gilbert Peterson; John Jasper; Brett Borghetti |
| Sorumlu yazar | Ralucca Gera |
| Kurum 1 | Department of Electrical and Computer Engineering, Air Force Institute of Technology, Wright-Patterson AFB, Ohio, USA |
| Kurum 2 | Department of Applied Mathematics, Naval Postgraduate School, Monterey, California, USA |
| Kurum 3 | The Center for Innovation and Excellence, Air Force Institute of Technology, Wright-Patterson AFB, Ohio, USA |
| Kurum 4 | Department of Mathematics and Statistics, Air Force Institute of Technology, Wright-Patterson AFB, Ohio, USA |
| DOI | 10.3390/aieduc2030025 |
| Dergi | AI in Education |
| Yayınevi | MDPI, Basel, Switzerland |
| Cilt / sayı / makale | 2 / 3 / 25 |
| Kaynak türü | Article; Design Science Research temelli matematiksel ve algoritmik PLP çalışması |
| Alınma tarihi | 9 Nisan 2026 |
| Revizyon | 12 Haziran 2026 |
| Kabul | 3 Temmuz 2026 |
| Yayın | 20 Temmuz 2026 |
| Hakemlik | Hakemli dergi makalesi |
| Lisans | Creative Commons Attribution 4.0 International (CC BY 4.0) |
| Finansman | U.S. Department of Veteran Affairs, grant 2022-133; Department of Defense tarafından kısmi finansman |
| IRB | 16 Ocak 2024 tarihinde 32 CFR 219.104(d)(2) kategorisi kapsamında muafiyet onayı |
| Bilgilendirilmiş onam | Araştırmaya katılan bütün kişilerden alınmıştır. |
| Veri ve kod | Kaynak çalışma, özgün veri ve kodun AFIT Scholar üzerinde açık biçimde erişilebilir olduğunu bildirmektedir. |
| Çıkar çatışması | Yazarlar çıkar çatışması bildirmemiştir; finansörlerin çalışma tasarımı, veri analizi, yorumlama, yazım veya yayın kararında rolü olmadığı belirtilmiştir. |
Yazar katkıları: Kavramsallaştırma Sean Mochocki ve Mark Reith; metodoloji Sean Mochocki, Mark Reith ve Jonathan Zemmer; araştırma Sean Mochocki; biçimsel analiz Sean Mochocki, John Jasper ve Laurence D. Merkle; kaynaklar Mark Reith; yazılım Sean Mochocki; denetim Mark Reith; ilk taslak Sean Mochocki; gözden geçirme ve düzenleme Mark Reith, Paolo J. Singh, Ralucca Gera, Gilbert Peterson, Brett Borghetti, John Jasper ve Laurence D. Merkle tarafından yürütülmüştür.
Veri ve yeniden üretilebilirlik: Kaynak, rubriklerin, veri paketinin ve algoritma kodlarının açık olduğunu bildirmektedir. Bu durum matematiksel ve algoritmik sonuçların bağımsız olarak yeniden incelenmesini kolaylaştırmaktadır.
Kurumsal görüş sınırı: Makalede ifade edilen görüşlerin yazarların görüşleri olduğu ve United States Air Force, Department of Defense veya United States Government'ın resmî politika ya da görüşünü temsil etmediği belirtilmektedir.
Temel yöntemsel sınırlılık: Çalışmanın son pedagojik doğrulama aşaması olan insan öğrenme deneyi yapılmamıştır. PLP rubriğinin yüksek puan vermesi, öğrencinin daha iyi öğrendiği anlamına gelmemektedir.
Kaynak-içi sayısal notlar: NSGA-II crossover taramasında 0,90 en iyi olarak yazılırken nihai parametre listesi 0,84 vermektedir; seçim varyansı hesabında 0,0849 elde edilirken sonraki kabul cümlesinde 0,8049 yazmaktadır; çalışma boyunca 12 öğrenci profili kullanılırken conclusion bir yerde 11 öğrenci demektedir. Bu farklılıklar Verianla tarafından sessizce düzeltilmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir