

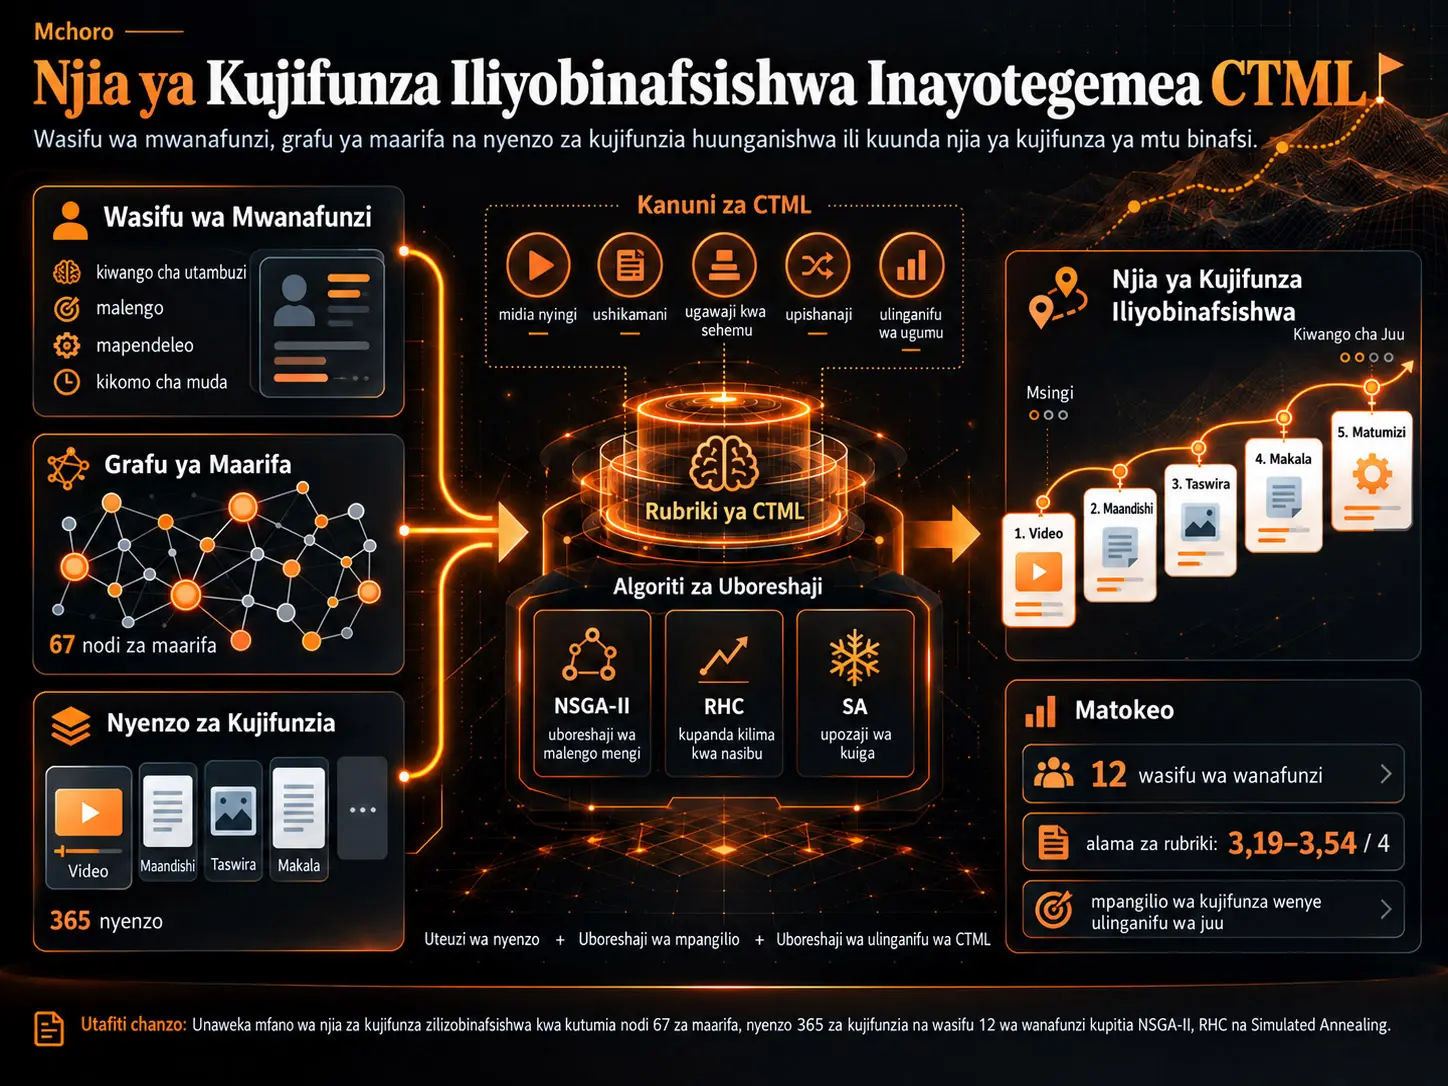
Njia ya Kujifunza Iliyobinafsishwa (Personalized Learning Path, PLP), ni mfuatano wa nyenzo za kujifunzia ulioundwa kwa mtu mahususi ambapo nyenzo huchaguliwa kwa kuzingatia malengo ya mwanafunzi fulani, kiwango chake cha kiutambuzi, mapendeleo ya maudhui na midia, pamoja na vikwazo vya muda, kisha hupangwa kulingana na mahusiano yake ya kielimu. Utafiti huu haujengi muundo wa PLP juu ya mkabala wa “mitindo ya kujifunza” wenye ushahidi dhaifu wa majaribio, bali juu ya Nadharia ya Kiutambuzi ya Ujifunzaji wa Midia Nyingi (Cognitive Theory of Multimedia Learning, CTML); unabadilisha kanuni za CTML kuwa rubriki za kiasi za nyenzo za kujifunzia na PLP, na kuunda uteuzi wa nyenzo na upangaji wa nyenzo kama matatizo mawili ya uboreshaji wenye malengo mengi.
Utafiti unatumia grafu ya maarifa yenye nodi 67 za maarifa iliyotokana na sayansi ya kompyuta, nyenzo halisi 365 za kujifunzia, na profaili za wanafunzi zilizopatikana kutoka kwa wanafunzi 12 wa shahada za uzamili. Uteuzi wa nyenzo za kujifunzia ulifanywa kwa Non-Dominated Sorting Genetic Algorithm II (NSGA-II), huku upangaji wa nyenzo zilizochaguliwa ukifanywa kwa algoriti za Random Hill Climber (RHC) na Simulated Annealing (SA). Tatizo la jumla la uteuzi limeonyeshwa kuwa NP-kamili kupitia upunguzaji kutoka Subset Sum; vipengele vya interleaving na prerequisite vya tatizo la jumla la upangaji wa nyingi-kwa-nyingi pia vimeonyeshwa kila kimoja kuwa NP-kamili.
Kwa mujibu wa Jedwali la 8 la chanzo, wastani wa mwisho uliounganishwa wa rubriki za PLP kwa profaili 12 za wanafunzi unatofautiana kutoka 3,19 hadi 3,54 kati ya alama 4. Thamani ya chini zaidi ni 3,19 kwa Student 11, na ya juu zaidi ni 3,54 kwa Student 9. Algoriti za upangaji RHC na SA kwa ujumla zilitoa alama za juu za rubriki; hasa RHC ilifikia alama 4,00 katika vigezo vyote vitatu vya upangaji kwa profaili nyingi za wanafunzi.
Matokeo haya yanaonyesha kuwa mchakato wa uboreshaji unaotegemea CTML unaweza kuzalisha PLP zenye alama za juu kwa mujibu wa rubriki iliyofafanuliwa; hayaonyeshi kwamba wanafunzi kweli hujifunza vizuri zaidi kupitia njia hizo. Utafiti haukufanya jaribio la kibinadamu linalolinganishwa matokeo ya kujifunza kwa wanafunzi, na uthibitishaji wa rubriki ya PLP dhidi ya matokeo halisi ya kujifunza umeachwa kwa utafiti wa baadaye.
Tatizo kuu la utafiti
Mfumo wa elimu mtandaoni unaweza kuwa na mamia au maelfu ya nyenzo za kujifunzia. Kuwafanya wanafunzi wote wapitie nyenzo zilezile kwa mpangilio uleule hakuzingatii viwango tofauti vya maarifa, malengo, muda na mapendeleo yao. Mkabala wa PLP hujaribu kutatua tatizo hili kwa kuunda seti ndogo tofauti ya nyenzo na mpangilio tofauti wa kujifunza kwa kila mwanafunzi.
Hata hivyo, ni muhimu kuamua ubinafsishaji ufanywe kwa kanuni ipi ya kielimu. Chanzo kinasisitiza kuwa mitindo ya kujifunza imetumika sana katika tafiti za awali za PLP, ingawa mkabala huu hauna msingi thabiti wa kiempiria katika fasihi ya elimu na saikolojia.
Pendekezo la utafiti huu ni kuunganisha muundo wa PLP na nadharia ya kujifunza yenye msingi imara zaidi wa kisayansi. CTML hukubali kwamba binadamu huchakata taarifa kupitia njia za kuona na kusikia, kwamba kumbukumbu tendaji ina uwezo mdogo, na kwamba ujifunzaji wa kudumu unahitaji uchakataji hai wa kiutambuzi. Kwa hiyo, muhimu si nyenzo kuwa tu katika “muundo anaoupenda” mwanafunzi, bali pia kutengenezwa kwa namna inayosaidia mzigo wa kiutambuzi, uundaji wa miundo, na ujifunzaji wenye maana.
Kanuni za CTML Hubadilishwaje Kuwa Algoriti ya Kujifunza?
Badala ya kuweka CTML moja kwa moja kwenye algoriti, utafiti kwanza huibadilisha kuwa rubriki zinazopima nyenzo za kujifunzia na PLP nzima. Nyenzo hutathminiwa kwa kanuni za multimedia, coherence, worked example, segmenting, signaling, spatial contiguity, temporal contiguity, modality, redundancy, personalization, voice na sourcing; kisha alama hizi hubadilishwa kuwa vigezo vya muundo wa tatizo la uteuzi lenye malengo mengi.
Malengo matatu ya kiutambuzi ya CTML
Chanzo kinachukua malengo matatu mapana ya kiutambuzi ya CTML katika muundo wa ufundishaji:
- Kupunguza uchakataji wa kiutambuzi usio wa lazima: Kuzuia mwanafunzi kutumia kumbukumbu yake tendaji yenye uwezo mdogo kwa taarifa zisizohusiana na lengo la kujifunza.
- Kusimamia uchakataji wa msingi: Kusaidia kupanga maudhui changamano kwa namna inayolingana na mipaka ya kumbukumbu tendaji ya mwanafunzi.
- Kusaidia uchakataji wa kiutambuzi zalishi: Kurahisisha mwanafunzi kuunganisha kwa vitendo taarifa mpya na maarifa ya awali na kuunda skimu ya kiakili.
Rubriki ya nyenzo za kujifunzia
Nyenzo 365 za kujifunzia zilizotumika katika utafiti zilipewa viwango vinne na watafiti binadamu kwa mujibu wa ulinganifu wake na CTML. 4 inawakilisha ulinganifu wa juu zaidi, 1 ulinganifu wa chini zaidi, huku 2 na 3 zikiwakilisha viwango vya kati vya ulinganifu.
Muundo wa alama nne ni chaguo la makusudi: hakuna sehemu ya kati isiyoegemea upande wowote, na huepuka usahihi bandia ambao mizani mipana zaidi inaweza kuunda.
Vigezo vya uteuzi vya rubriki ya PLP
| Kigezo | Alama | Maana ya kisayansi / kialgoriti |
|---|---|---|
| Ulinganifu wa CTML | Vp | Hufupisha kiwango ambacho nyenzo zilizochaguliwa zinatii kanuni za kiutambuzi za midia nyingi. |
| Ulinganifu wa ugumu | Dp | Hupima jinsi ugumu wa nyenzo unavyolingana na kiwango cha kiutambuzi cha mwanafunzi katika nodi husika ya maarifa. |
| Upendeleo wa mwanafunzi | Op | Hupima ulinganifu wa aina ya midia na maudhui na mapendeleo yaliyoripotiwa na mwanafunzi. |
| Muda | Tp | Huwakilisha ulinganifu wa jumla ya muda wa nyenzo zilizochaguliwa na kipindi cha chini na cha juu cha muda kilichowekwa na mwanafunzi. |
| Ushikamanifu wa nyenzo / cohesiveness | Ep | Hupima kiwango ambacho nyenzo zinaendana kisemantiki. |
| Coherence | Cp | Huadhibu kufunikwa kusiko lazima kwa nodi za maarifa zilizo nje ya malengo ya mwanafunzi. |
| Segmenting | Sp | Kwa kutumia wastani wa idadi ya nodi za maarifa ambazo nyenzo moja hufunika, huhimiza vipande vinavyolengwa zaidi. |
| Multiple-document integration | Mp | Hutoa zawadi kwa nodi za maarifa lengwa zinazoungwa mkono na zaidi ya nyenzo moja. |
| Topic balance | Bp | Hupima jinsi nyenzo za kujifunzia zinavyosambazwa kwa uwiano kati ya mada lengwa. |
Milinganyo ya msingi ya uteuzi
Nyenzo ndani ya PLP kandidati huchaguliwa kwa vigezo vya uamuzi \(\chi_j \in \{0,1\}\). \(\chi_j=1\) huonyesha kuwa nyenzo ya kujifunzia ya \(j\) imejumuishwa katika PLP.
Thamani ya wastani ya CTML:
\[ V_p = \frac{\sum_{j=1}^{n}\chi_j v_j} {|p|} \]
Wastani wa ulinganifu wa ugumu:
\[ D_p = \frac{\sum_{j=1}^{n}\chi_j d_j} {|p|} \]
Thamani ya wastani ya upendeleo:
\[ O_p = \frac{\sum_{j=1}^{n}\chi_j o_j} {|p|} \]
Jumla ya muda wa PLP:
\[ T_p=\sum_{j=1}^{n}\chi_j t_j \]
Hapa \(v_j\) ni thamani ya CTML ya nyenzo; \(d_j\) ni ulinganifu wa ugumu; \(o_j\) ni thamani ya upendeleo wa mwanafunzi; na \(t_j\) ni muda wa nyenzo.
Ulinganifu wa kisemantiki kati ya nyenzo huhesabiwaje?
Maelezo ya maandishi ya kila nyenzo Sentence-BERT all-mpnet-base-v2 hubadilishwa kuwa vekta yenye vipimo 768 kwa kutumia modeli hiyo. Thamani za cosine similarity za jozi za nyenzo huhesabiwa na kurekebishwa hadi kipindi cha [0,1], na hivyo kuunda thamani ya cohesiveness kati ya nyenzo.
Matumizi haya hayapimi moja kwa moja usahihi wa kielimu wa nyenzo ya kujifunzia. Modeli hutumika tu kufanya ufanano wa kisemantiki wa maelezo ya nyenzo kuwa mojawapo ya vigezo vya uwezekano wa kutumia nyenzo pamoja ndani ya PLP.
Miundo mitatu ya data huundaje ubinafsishaji kwa pamoja?
| Muundo wa data | Maudhui yanayotumiwa katika chanzo | Jukumu katika PLP |
|---|---|---|
| Grafu ya maarifa | Nodi 67 za maarifa na mahusiano ya prerequisite | Huamua mada zipi zitajifunzwa na ni mada ipi inapaswa kuja kabla ya nyingine. |
| Profaili ya mwanafunzi | Kiwango cha kiutambuzi, KN lengwa, mapendeleo ya midia na maudhui, vikwazo vya muda | Huunda mfano wa tatizo unaomlenga mwanafunzi kutoka kwenye hifadhi ileile ya nyenzo. |
| Nyenzo za kujifunzia | Metadata ya nyenzo 365, kama ugumu, midia, maudhui, muda, ulinganifu wa CTML na KN zinazofunikwa | Huunda hifadhi ya rasilimali kandidati ambazo algoriti itachagua na kupanga. |
Tofauti kuu za profaili 12 za wanafunzi
| Mwanafunzi | KN lengwa | Wast. kiwango cha kiutambuzi | Midia inayopendelewa | Muda wa chini (dak.) | Muda wa juu (dak.) |
|---|---|---|---|---|---|
| 0 | 4 | 1,88 | Maandishi | 360 | 1200 |
| 1 | 5 | 1,45 | Hakuna upendeleo | 2400 | 4800 |
| 2 | 5 | 2,13 | Video | 30 | 90 |
| 3 | 18 | 1,42 | Maandishi | 15 | 60 |
| 4 | 5 | 1,76 | Video | 20 | 90 |
| 5 | 5 | 1,72 | Video | 5 | 60 |
| 6 | 5 | 2,57 | Video | 10 | 30 |
| 7 | 15 | 2,22 | Video | 30 | 90 |
| 8 | 5 | 1,28 | Video | 30 | 90 |
| 9 | 5 | 1,64 | Video | 30 | 120 |
| 10 | 5 | 2,27 | Video | 30 | 120 |
| 11 | 5 | 2,93 | Video | 10 | 60 |
Dokezo la uthabiti wa chanzo: Ingawa mbinu ya dodoso inaeleza kuwa wanafunzi waliombwa kuchagua KN lengwa zisizozidi 5, Student 3 na Student 7 waliripotiwa kuwa na KN lengwa 18 na 15 mtawalia. Chanzo hakielezi kando jinsi tofauti hii ilivyotokea.
Kwa Nini Matatizo ya Uteuzi na Upangaji wa PLP ni NP-Kamili?
Tatizo la jumla la uteuzi wa nyenzo lenye malengo mengi katika utafiti ni NP-kamili, kwa sababu hata kikibaki kizuizi cha jumla ya muda pekee, tatizo la NP-kamili la Subset Sum linaweza kupunguzwa hadi tatizo hili kwa muda wa kipolinomia. Tatizo la upangaji katika uhusiano wa nyingi-kwa-nyingi kati ya nyenzo na nodi za maarifa pia linaweza kuwa NP-kamili hata pale ambapo ni lengo moja tu kati ya interleaving au prerequisite linalotumika. Kinyume chake, upangaji kwa ugumu pekee unaweza kutatuliwa kwa muda wa kipolinomia kwa algoriti ya kawaida ya kupanga.
Uteuzi wa nyenzo: upunguzaji wa Subset Sum
Chanzo kwanza huonyesha kuwa tatizo la uteuzi liko ndani ya NP kwa kuonyesha kuwa vikwazo vyote vya suluhisho kandidati vinaweza kukaguliwa kwa muda wa kipolinomia. Kisha hubadilisha kila nambari katika tatizo la Subset Sum kuwa muda wa nyenzo ya kujifunzia na kuweka muda wa chini na wa juu wa PLP kuwa sawa na thamani ileile lengwa.
Katika hali hii, kupata PLP halali kunakuwa sawa na kupata seti ndogo ya nyenzo ambazo muda wake unatoa jumla lengwa kwa usahihi. Kwa kuwa Subset Sum ni NP-kamili na upunguzaji unaweza kufanywa kwa muda wa kipolinomia, tatizo la uteuzi ni NP-gumu; na kwa kuwa pia liko ndani ya NP, ni NP-kamili.
Malengo matatu katika upangaji
Baada ya nyenzo kuchaguliwa, tatizo la pili ni kupanga nyenzo zilizochaguliwa katika mfuatano unaofaa kielimu. Chanzo hupunguza vigezo vitatu vya ukiukaji:
| Kigezo | Alama | Ni nini kinachohesabiwa? |
|---|---|---|
| Upangaji kwa ugumu | Hp | Ukiukaji unaotokea kwa sababu nyenzo ngumu zaidi inakuja kabla ya nyenzo rahisi zaidi. |
| Upangaji wa prerequisite / elaboration | Rp | Hali ambapo nyenzo ya mada lengwa huwasilishwa kabla ya nyenzo inayofunika mada ya sharti. |
| Interleaving | Ip | Ukiukaji unaotokea kwa sababu nyenzo zinazofunika nodi ileile ya maarifa zinafuatana moja kwa moja. |
Fitness iliyounganishwa na iliyorekebishwa inayotumiwa na algoriti za upangaji:
\[ fitness = \frac{ H_p/H_M + R_p/R_M + I_p/I_M }{3} \]
Hapa \(H_M\), \(R_M\) na \(I_M\) ni thamani za juu kabisa zinazowezekana za ukiukaji kwa vigezo husika. Kila kipengele huletwa katika kipindi cha [0,1], na fitness ya chini humaanisha upangaji bora.
Kwa nini nyingi-kwa-nyingi na nyingi-kwa-moja ni muhimu?
| Uhusiano wa nyenzo–KN | Lengo | Uchangamano | Mbinu kuu / ushahidi |
|---|---|---|---|
| Nyingi-kwa-nyingi | Interleaving + prerequisite + difficulty | NP-kamili | Tatizo lililounganishwa |
| Nyingi-kwa-nyingi | Interleaving pekee | NP-kamili | Upunguzaji wa Hamiltonian Path |
| Nyingi-kwa-nyingi | Prerequisite pekee | NP-kamili | Upunguzaji wa Minimum Feedback Arc |
| Nyingi-kwa-nyingi | Difficulty pekee | PTIME | Kupanga kwa ugumu unaoongezeka |
| Nyingi-kwa-moja | Interleaving pekee | PTIME | Algoriti ya greedy iliyotolewa katika chanzo |
| Nyingi-kwa-moja | Prerequisite pekee, DAG | PTIME | Topological sort |
| Nyingi-kwa-moja | Difficulty pekee | PTIME | Upangaji wa kawaida |
| Nyingi-kwa-moja | Malengo matatu kwa pamoja | Limeachwa wazi katika chanzo | Utafiti wa baadaye |
Matokeo haya hayamaanishi kwamba “njia ya kujifunza iliyobinafsishwa ni tatizo gumu sana kuhesabu katika kila hali”. Daraja la jumla la tatizo linaweza kuwa NP-kamili, lakini miundo fulani ya data, malengo moja moja au miundo ya nyenzo ya nyingi-kwa-moja inaweza kutatuliwa kwa muda wa kipolinomia.
Mbinu na Matokeo ya Utafiti
Muundo wa Design Science Research
Utafiti kwa ujumla umeundwa kwa mujibu wa mkabala wa Design Science Research Process for Information Systems. Mfuatano wa utafiti unafuata mantiki hii: kuchagua nadharia ya kujifunza iliyothibitishwa kisayansi; kuibadilisha kuwa rubriki za kiasi; kufafanua matatizo ya uteuzi na upangaji kwa namna ya kihisabati; kuthibitisha uchangamano wake; kuunda mifano ya tatizo kwa data halisi; kuendesha algoriti; na kutathmini matokeo kwa rubriki na vipimo vya kitakwimu.
Katika jedwali la mbinu la chanzo chenyewe, imeelezwa wazi kwamba majaribio ya binadamu hayapo katika hatua ya sasa ya tathmini. Upungufu huu si maelezo ya kiufundi tu, bali ni mpaka wa tafsiri ya kielimu ya utafiti.
Uteuzi wa nyenzo za kujifunzia kwa NSGA-II
Uteuzi wa nyenzo ulifanywa kwa utekelezaji wa PyGAD NSGA-II unaotumia kromosomu yenye vigezo 365 vya uamuzi wa binary. Malengo tisa ghafi yalibadilishwa kuwa malengo matatu yaliyounganishwa ili algoriti iweze kufanya utafutaji nyeti zaidi.
Vipimo viwili endelevu vya ulinganifu vinavyohesabiwa kutoka kwa thamani zilizorekebishwa ni:
\[ LM\_Compliance = 3\left( \frac{V_N+D_N+O_N+T_N+E_N}{5} \right)+1 \]
\[ KN\_Compliance = 3\left( \frac{B_N+M_N+C_N+S_N}{4} \right)+1 \]
LM_Compliance, hupima ulinganifu wa nyenzo zilizochaguliwa na mwanafunzi; KN_Compliance, hupima jinsi nyenzo hizi zinavyokidhi malengo ya kujifunza ya mwanafunzi. Lengo la tatu, Rubric_Average, ni wastani wa kategoria tisa za rubriki ya PLP.
Vigezo vya NSGA-II
| Kigezo | Thamani ya chanzo |
|---|---|
| Idadi ya vigezo vya uamuzi | 365 |
| Population size | 100 |
| Idadi ya Generation | 500 |
| Aina ya Crossover | Single-point |
| Aina ya Mutation | Swap |
| Mutation probability | 1/365 |
| Uendeshaji huru | 30 kwa kila mwanafunzi |
| Crossover probability | 0,84 katika orodha ya usanidi |
Tofauti ya ndani ya chanzo: Katika maelezo ya utafutaji wa vigezo, uwezekano wa crossover wa 0,90 unasemekana kutoa wastani wa juu zaidi wa alama ya rubriki katika kundi la wanafunzi, ilhali orodha ya usanidi uliotumika inaandika 0,84. Chanzo hakielezi kwa nini thamani tofauti ilitumiwa katika usanidi wa mwisho.
Kundi la mwanzo
Kundi la mwanzo la NSGA-II liliundwa kwa utaratibu unaotumia muundo wa tatizo badala ya kuzalisha biti 365 kwa nasibu kabisa. Algoriti kwanza huchagua kwa nasibu nyenzo zinazofunika nodi lengwa za maarifa. Ikiwa malengo yote yamefunikwa lakini jumla ya muda iko chini ya muda wa chini, hufanya uteuzi wa ziada kutoka kwenye nyenzo zilizobaki.
Ikiwa katika majaribio 10.000 mfululizo hakuna kromosomu inayokidhi kizuizi cha muda inayoweza kutengenezwa, kikomo cha muda hulegezwa kwa kundi lililobaki huku kipaumbele cha kufunika KN lengwa kikihifadhiwa. Muundo huu unalenga kupunguza muda ambao algoriti ya kijeni ingeupoteza tangu mwanzo kwenye michanganyiko ya nyenzo isiyo na maana kabisa.
Upangaji kwa RHC na Simulated Annealing
Algoriti zote mbili za upangaji huanza na mfuatano wa nyenzo wa nasibu. RHC hubadilisha nafasi za nyenzo katika fahirisi mbili za nasibu na huhifadhi mabadiliko ikiwa suluhisho jipya linatoa fitness bora. SA hutumia mwendo huo huo wa ujirani, lakini hasa katika iteresheni za mwanzo hukubali suluhisho baya zaidi kwa uwezekano fulani ili kuweza kutoroka optimum ya eneo.
| Kigezo | Thamani |
|---|---|
| Idadi ya iteresheni za RHC | 10.000 |
| Idadi ya iteresheni za SA | 10.000 |
| Joto la mwanzo la SA | 0,95 |
| Joto la mwisho la SA | 0,01 |
| Kigezo cha kupoa α | 0,9995467 |
| Uwezekano wa kukubali hatua iliyo mbaya kwa 0,1 mwanzoni | Takriban 0,90 |
| Marudio ya RHC kwa kila seti ya nyenzo ya NSGA-II | 30 |
| Marudio ya SA kwa kila seti ya nyenzo ya NSGA-II | 30 |
| Jumla ya uendeshaji wa kila algoriti ya upangaji kwa kila mwanafunzi | 900 |
Kigezo cha kupoa cha SA katika chanzo:
\[ \alpha = \left( \frac{T_m}{T_1} \right)^{1/(m-1)} \]
kilihesabiwa kwa namna hii. Kwa \(T_1=0,95\), \(T_m=0,01\) na \(m=10.000\), \(\alpha=0,9995467\) ilipatikana.
Jaribio la χ² kwa variansi
Kwa kuwa algoriti ni za kistokastiki, jaribio la upande mmoja la variansi moja la χ² lilitumiwa kuchunguza ikiwa matokeo ya marudio 30 yalitokana na matokeo ya nasibu yasiyo na muundo mahususi wa mwanafunzi. Kiwango cha umuhimu ni \(p=0,05\).
Kwa usambazaji sare wa diskriti wa alama nne, variansi inayotarajiwa ya kategoria moja ya rubriki ilichukuliwa kuwa 1,25. Kwa wastani wa kategoria tisa za uteuzi, thamani inayotarajiwa ni:
\[ \sigma^2_{selection} = \frac{1,25}{9} \approx 0,139 \]
Kwa kategoria tatu za upangaji:
\[ \sigma^2_{sequencing} = \frac{1,25}{3} \approx 0,417 \]
Chanzo huhesabu variansi muhimu:
\[ \chi^2 = \frac{(n-1)s^2}{\sigma^2} \]
kwa uhusiano huu. Kwa sampuli 30 na nyuzi 29 za uhuru, \(\chi^2=17,708\) ilitumiwa. Kwa hiyo hesabu katika maandishi ni:
\[ s^2_{selection} = \frac{17,708 \times 0,139}{29} = 0,0849 \]
\[ s^2_{sequencing} = \frac{17,708 \times 0,417}{29} = 0,254 \]
Kutolingana kwa nambari ndani ya chanzo: Mara tu baada ya aya hiyo, kizingiti cha kukubalika kwa tatizo la uteuzi kimeandikwa kuwa 0,8049. Thamani hii haiendani na hesabu ya 0,0849 hapo juu. Verianla haiunganishi thamani hizi mbili kuwa thamani moja “iliyorekebishwa”.
Algoriti Zilitoa Matokeo Gani kwa Profaili 12 za Wanafunzi?
Katika Jedwali la 8 la chanzo, wastani uliounganishwa wa rubriki za PLP zilizochaguliwa kwa NSGA-II na kupangwa kwa RHC uko katika kipindi cha 3,19–3,54 / 4. Student 9 ana thamani ya juu zaidi 3,54 na Student 11 ya chini zaidi 3,19. Hata hivyo, wanafunzi wote hawana nguvu sawa katika vigezo vidogo; katika baadhi ya profaili kuna maafikiano ya wazi ya Pareto kati ya muda, uwiano wa mada au segmenting.
| Mwanafunzi | Wastani uliounganishwa / 4 |
|---|---|
| 0 | 3,41 |
| 1 | 3,35 |
| 2 | 3,30 |
| 3 | 3,24 |
| 4 | 3,52 |
| 5 | 3,30 |
| 6 | 3,24 |
| 7 | 3,21 |
| 8 | 3,32 |
| 9 | 3,54 |
| 10 | 3,52 |
| 11 | 3,19 |
Student 7 na Student 11: mvutano wa muda–uwiano wa mada
Katika matokeo ya uteuzi ya Student 7 na Student 11, hasa kuna uhusiano hasi kati ya vigezo vya time interval na topic balance. Student 7 ana KN lengwa 15 na kikomo cha muda cha dakika 30–90; Student 11 ana malengo matano na kikomo cha dakika 10–60.
Algoriti inapogawa nyenzo kwa uwiano zaidi kati ya mada zote lengwa, hatari ya kuvuka kikomo cha muda huongezeka; inaposhikilia muda kwa ukali zaidi, usambazaji wa mada unaweza kuvurugika. Chanzo hutafsiri hili kama mfano wa afikiano halisi wa Pareto katika uboreshaji wenye malengo mengi.
Student 5: afikiano kati ya ulinganifu na topic balance
Kwa Student 5, alama ya uwiano wa mada ilisogea kinyume na ulinganifu wa CTML, ulinganifu wa ugumu na ulinganifu wa mapendeleo ya mwanafunzi. Kwa maneno mengine, katika baadhi ya uendeshaji algoriti ilipa kipaumbele ulinganifu mkubwa wa nyenzo na mwanafunzi, na katika nyingine usambazaji wenye uwiano zaidi kati ya mada lengwa.
Student 1: athari ya kikomo kirefu cha muda
Kwa Student 1, muda wa chini ni dakika 2400 na muda wa juu ni dakika 4800. Chanzo kinaeleza kuwa suluhisho za profaili hii zina takriban nyenzo 80. Seti kubwa namna hii, wakati hakuna nyenzo za kutosha zinazofunika malengo ya mwanafunzi, ilitengeneza mivutano mipya kati ya vigezo kama coherence na topic balance.
Matokeo ya upangaji ya SA na RHC
| Mwanafunzi | Wastani wa SA | Wastani wa RHC |
|---|---|---|
| 0 | 4,00 | 4,00 |
| 1 | 3,48 | 4,00 |
| 2 | 4,00 | 4,00 |
| 3 | 4,00 | 4,00 |
| 4 | 4,00 | 4,00 |
| 5 | 4,00 | 4,00 |
| 6 | 4,00 | 4,00 |
| 7 | 3,99 | 4,00 |
| 8 | 3,97 | 3,93 |
| 9 | 3,84 | 3,81 |
| 10 | 3,94 | 3,94 |
| 11 | 4,00 | 4,00 |
Student 1 anaonyesha tofauti iliyo wazi zaidi kati ya SA na RHC. Katika seti kubwa ya suluhisho yenye takriban nyenzo 80, tabia ya SA ya kukubali mara kwa mara suluhisho jirani zilizo mbaya zaidi iligeuka kuwa hasara; wastani wa difficulty na prerequisite wa SA ulikuwa takriban 3,01 na 3,42 mtawalia, na alama iliyounganishwa ya upangaji ilikuwa 3,48. RHC ilifikia wastani wa 4,00 kwa profaili hiyo hiyo.
Katika seti ndogo za nyenzo, SA katika baadhi ya hali iliweza kutoa matokeo bora kidogo kuliko RHC. Chanzo hutafsiri hili kama ishara kwamba uwezo wa SA wa kutoroka optimum za eneo unaweza kuwa na manufaa katika mifano midogo ya tatizo.
Kwa nini tatizo la upangaji ambalo kwa ujumla ni NP-kamili lilionekana rahisi katika majaribio?
Chanzo kinapendekeza kuwa malengo ya segmenting na topic balance katika hatua ya uteuzi huenda yalirahisisha kwa kawaida tatizo la upangaji lililofuata. Lengo la Segmenting hupendelea nyenzo ndogo na zinazolengwa zinazofunika KN chache; kwa hiyo baadhi ya miundo ya nyingi-kwa-nyingi inaweza kwa vitendo kukaribia miundo ya nyingi-kwa-moja.
Lengo la Topic balance husambaza nyenzo za kujifunzia kwa uwiano zaidi kati ya KN lengwa. Muundo huu unaweza hasa kurahisisha kupunguza ukiukaji wa interleaving. Kwa hiyo, ingawa tatizo la jumla la kihisabati ni NP-kamili, seti za nyenzo zilizotengenezwa na NSGA-II kwa profaili hizi 12 halisi za wanafunzi ziligeuka kuwa mifano rahisi kwa kiasi katika suala la upangaji.
Je, Utafiti Huu Unathibitisha Kwamba PLP Zinazotegemea CTML Huwafanya Wanafunzi Kujifunza Vizuri Zaidi?
Hapana. Utafiti unaonyesha kwamba kanuni za CTML zinaweza kubadilishwa kuwa malengo ya kihisabati na kwamba algoriti zinaweza kuzalisha njia za kujifunza zilizobinafsishwa zenye alama za juu kwa mujibu wa malengo hayo; lakini haujajaribu moja kwa moja ikiwa wanafunzi wanapata mafanikio ya juu zaidi ya kujifunza, kukumbuka au transfer kwa kutumia PLP zinazotegemea CTML. Chanzo kinaacha uthibitishaji huu wa kibinadamu kwa hatua inayofuata ya utafiti.
Uhalali wa rubriki bado haujathibitishwa kwa ujifunzaji wa binadamu
Alama za CTML za nyenzo 365 zilitolewa na watafiti. Kuna uwezekano wa makosa katika muundo wa rubriki na pia katika ukadiriaji wa nyenzo unaofanywa na binadamu. Kwa hiyo chanzo kinasema wazi kuwa rubriki ya CTML inahitaji majaribio na uboreshaji zaidi.
Dhana ya elaboration + difficulty + interleaving
Tatizo la upangaji linategemea dhana kwamba kuboresha kwa pamoja malengo ya elaboration/prerequisite, kusonga kutoka rahisi kwenda ngumu, na interleaving kutaleta matokeo bora zaidi kwa wanafunzi.
Ingawa dhana hii inaungwa mkono na fasihi ya kujifunza, katika makala hii wanafunzi hawakugawiwa hali mbili tofauti za upangaji na kulinganishwa. Kwa hiyo ubora wa kuunganisha uboreshaji wa vigezo vitatu kwa ujifunzaji halisi bado si matokeo ya majaribio.
Kikomo cha kipimo cha nyenzo 365
Chanzo kinaeleza kuwa hifadhi ya nyenzo 365 ni ndogo kwa kiasi na kwamba tabia ya algoriti inapaswa kuchunguzwa tena katika nafasi kubwa zaidi za utafutaji. Hifadhi kubwa na zenye utofauti zaidi wa metadata zinaweza kuunda PLP zinazolingana vizuri zaidi na mwanafunzi; lakini pia zinaweza kuongeza mzigo wa kihesabu wa tatizo la uteuzi.
Algoriti nyingine mbali na NSGA-II
Utafiti ulitumia NSGA-II baada ya kuunganisha vigezo tisa vya uteuzi kuwa malengo matatu yaliyounganishwa. Tafiti zijazo zinapendekezwa kulinganisha matokeo na mbinu kama NSGA-III, zilizoundwa kwa malengo mengi, bila kuunganisha malengo.
Kikomo cha sampuli
Profaili za wanafunzi zilipatikana kutoka kwa wanafunzi 12 tu wa shahada za uzamili. Idadi hii ilitumika kuunda mifano ya matatizo ya kialgoriti; si sampuli kubwa ya kielimu inayowakilisha idadi ya wanafunzi kwa upande wa demografia au pedagogia.
Hitimisho ambazo utafiti unaunga mkono na hauungi mkono
| Utafiti unaunga mkono | Utafiti peke yake hauungi mkono |
|---|---|
| Kanuni za CTML zinaweza kubadilishwa kwa kiasi kuwa malengo ya uteuzi na upangaji wa PLP. | PLP inayotegemea CTML imeongeza mafanikio ya kujifunza kwa wanafunzi halisi. |
| Tatizo la jumla la uteuzi wa LM lenye malengo mengi ni NP-kamili. | Kila mfano halisi wa PLP ni mgumu kiasi cha kutoweza kuhesabiwa kwa vitendo. |
| Katika upangaji wa nyingi-kwa-nyingi, malengo ya interleaving na prerequisite yanaweza kila moja kuunda NP-kamilifu. | Matatizo yote ya upangaji wa nyingi-kwa-moja ni NP-kamili. |
| NSGA-II + RHC/SA zilizalisha alama zilizounganishwa za PLP za 3,19–3,54 / 4 chini ya data na rubriki zilizochunguzwa. | Alama hizi ni alama za mtihani, mafanikio ya kujifunza au kuridhika kwa mwanafunzi. |
| Chanzo kimeripoti katika utaratibu wake wa χ² kwamba marudio ya algoriti yalitofautiana na upangaji alama wa rubriki wa nasibu wa uniform. | Algoriti ni bora zaidi kielimu au ni bora kuliko mbinu nyingine. |
| Katika mifano ya sasa ya data halisi, RHC na SA zilizalisha alama za juu za rubriki ya upangaji kwa wanafunzi wengi. | RHC au SA ndiyo algoriti bora katika seti zote za data za PLP. |
Maelezo ya Chanzo na Mbinu
| Kichwa asili | A Personalized Learning Path Problem Based on the Cognitive Theory of Multimedia Learning |
|---|---|
| Waandishi | Sean Mochocki; Mark Reith; Laurence D. Merkle; Paolo J. Singh; Jonathan Zemmer; Ralucca Gera; Gilbert Peterson; John Jasper; Brett Borghetti |
| Mwandishi wa mawasiliano | Ralucca Gera |
| Taasisi 1 | Department of Electrical and Computer Engineering, Air Force Institute of Technology, Wright-Patterson AFB, Ohio, USA |
| Taasisi 2 | Department of Applied Mathematics, Naval Postgraduate School, Monterey, California, USA |
| Taasisi 3 | The Center for Innovation and Excellence, Air Force Institute of Technology, Wright-Patterson AFB, Ohio, USA |
| Taasisi 4 | Department of Mathematics and Statistics, Air Force Institute of Technology, Wright-Patterson AFB, Ohio, USA |
| DOI | 10.3390/aieduc2030025 |
| Jarida | AI in Education |
| Mchapishaji | MDPI, Basel, Switzerland |
| Juzuu / toleo / makala | 2 / 3 / 25 |
| Aina ya chanzo | Article; utafiti wa kihisabati na kialgoriti wa PLP unaotegemea Design Science Research |
| Tarehe ya kupokelewa | 9 Aprili 2026 |
| Marekebisho | 12 Juni 2026 |
| Kukubaliwa | 3 Julai 2026 |
| Kuchapishwa | 20 Julai 2026 |
| Mapitio ya rika | Makala ya jarida iliyopitiwa na rika |
| Leseni | Creative Commons Attribution 4.0 International (CC BY 4.0) |
| Ufadhili | U.S. Department of Veteran Affairs, grant 2022-133; ufadhili wa sehemu kutoka Department of Defense |
| IRB | Idhini ya msamaha chini ya kategoria ya 32 CFR 219.104(d)(2) tarehe 16 Januari 2024 |
| Ridhaa yenye taarifa | Ilipatikana kutoka kwa watu wote walioshiriki katika utafiti. |
| Data na msimbo | Utafiti chanzo unaripoti kuwa data asili na msimbo zinapatikana wazi kwenye AFIT Scholar. |
| Mgongano wa maslahi | Waandishi hawakuripoti mgongano wa maslahi; imeelezwa kuwa wafadhili hawakuwa na nafasi katika muundo wa utafiti, uchanganuzi wa data, tafsiri, uandishi au uamuzi wa kuchapisha. |
Michango ya waandishi: Uundaji wa dhana Sean Mochocki na Mark Reith; metodolojia Sean Mochocki, Mark Reith na Jonathan Zemmer; uchunguzi Sean Mochocki; uchanganuzi rasmi Sean Mochocki, John Jasper na Laurence D. Merkle; rasilimali Mark Reith; programu Sean Mochocki; usimamizi Mark Reith; rasimu ya kwanza Sean Mochocki; mapitio na uhariri ulifanywa na Mark Reith, Paolo J. Singh, Ralucca Gera, Gilbert Peterson, Brett Borghetti, John Jasper na Laurence D. Merkle.
Data na uzalishikaji upya: Chanzo kinaripoti kuwa rubriki, kifurushi cha data na misimbo ya algoriti viko wazi. Hali hii hurahisisha ukaguzi huru wa matokeo ya kihisabati na kialgoriti.
Mpaka wa msimamo wa taasisi: Makala inaeleza kuwa maoni yaliyotolewa ni ya waandishi na hayawakilishi sera au msimamo rasmi wa United States Air Force, Department of Defense au United States Government.
Kikomo kikuu cha kimetodolojia: Jaribio la kujifunza kwa binadamu, ambalo ni hatua ya mwisho ya uthibitishaji wa kielimu wa utafiti, halikufanywa. PLP kupata alama ya juu kwenye rubriki hakumaanishi kuwa mwanafunzi alijifunza vizuri zaidi.
Madokezo ya nambari ndani ya chanzo: Katika utafutaji wa crossover wa NSGA-II, 0,90 imeandikwa kuwa bora zaidi lakini orodha ya mwisho ya vigezo inatoa 0,84; katika hesabu ya variansi ya uteuzi 0,0849 hupatikana lakini katika sentensi inayofuata ya kukubalika imeandikwa 0,8049; na ingawa profaili 12 za wanafunzi zilitumika katika utafiti mzima, conclusion mahali pamoja inasema wanafunzi 11. Verianla haijasahihisha tofauti hizi kimya kimya.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *