


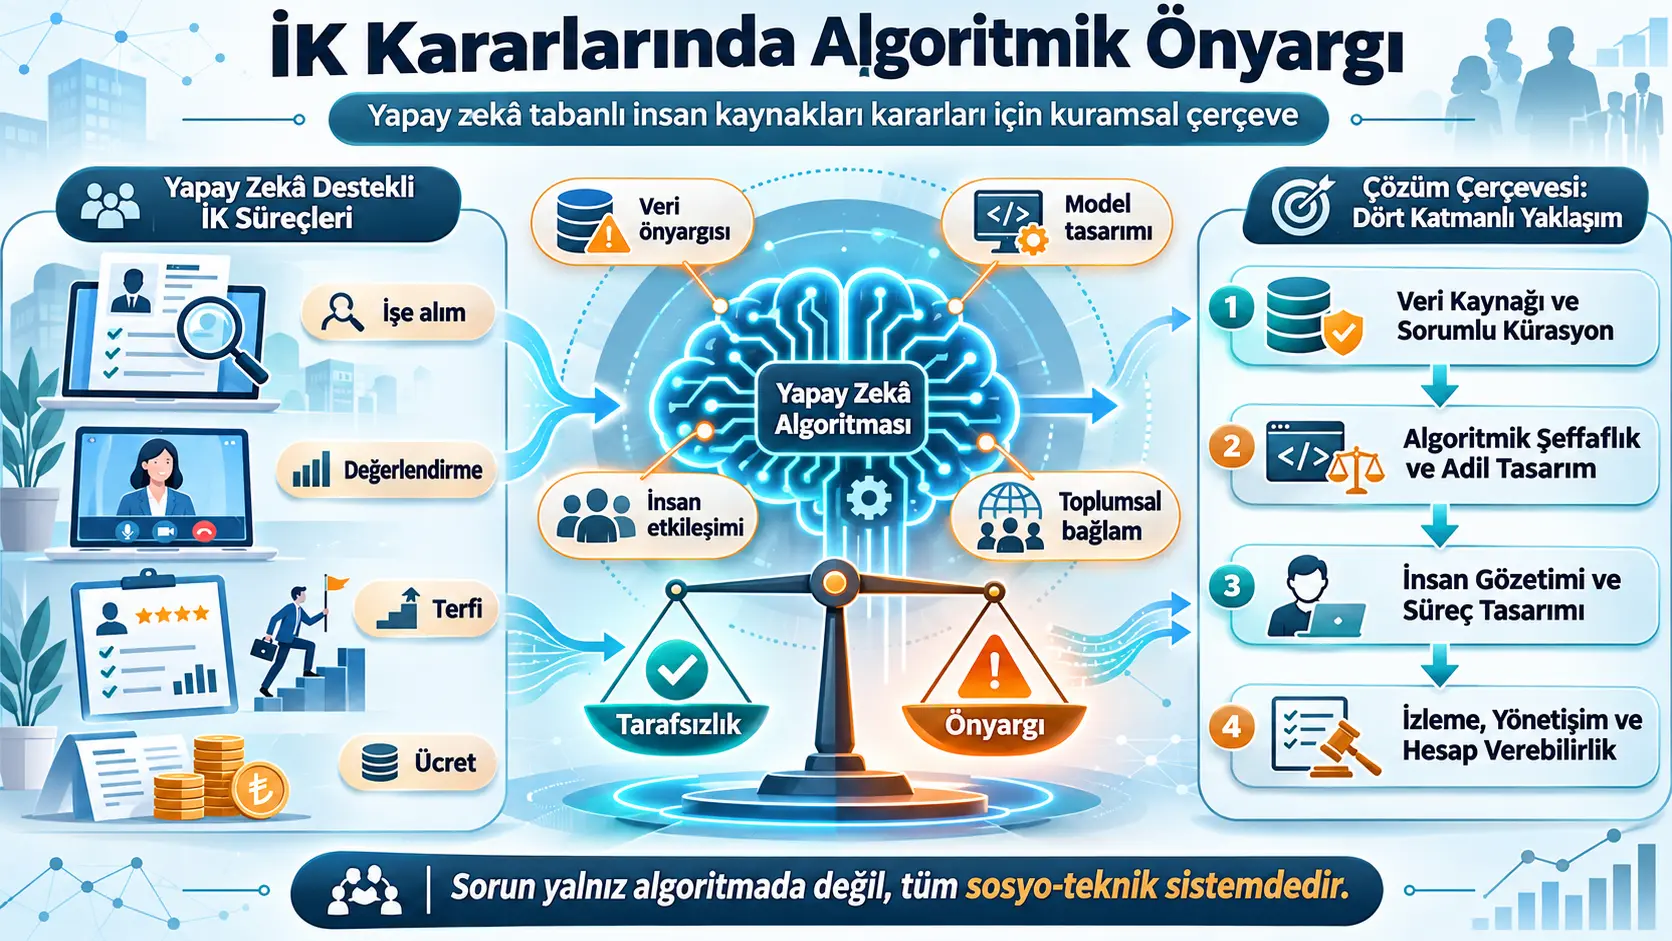
İnsan kaynaklarında algoritmik önyargı, yapay zekâ veya algoritmik karar sistemlerinin belirli birey veya gruplar için sistematik biçimde adaletsiz sonuçlar üretmesi ya da mevcut toplumsal eşitsizlikleri yeniden üretmesi veya büyütmesi durumudur. Bu teorik çalışma; işe alım, aday tarama, görüşme, değerlendirme, performans yönetimi, terfi, çalışanı elde tutma ve işten ayrılma/çıkarma gibi insan kaynakları süreçlerindeki yapay zekâ kullanımını veri, algoritma tasarımı, insan–sistem etkileşimi ve örgütsel/toplumsal bağlam açısından incelemektedir. Çalışma yeni bir veri seti veya deney kullanmamakta; bilgisayar bilimi, sosyoloji, eleştirel İnsan Kaynakları Yönetimi — Human Resource Management (HRM) ve etik literatüründeki görüşleri bir araya getirerek çok katmanlı bir önyargı azaltma çerçevesi önermektedir.
Kaynağın temel savı, algoritmik önyargının yalnız “hatalı algoritma” problemi olmadığıdır. Geçmiş işe alım ve terfi verilerindeki eşitsizlikler, korunan özelliklerle ilişkili vekil değişkenler, eksik veri örüntüleri, model ve özellik seçimi, optimizasyon hedefleri, insan kullanıcıların algoritmik sonuçlara aşırı güvenmesi, adayların teknolojiyle farklı biçimlerde etkileşmesi ve kurumun kendi kültürel/örgütsel öncelikleri aynı sistem içinde önyargı oluşturabilir veya güçlendirebilir.
Çalışmanın önerdiği çözüm dört bağlantılı katmandan oluşmaktadır: veri kaynağı ve sorumlu veri kürasyonu, algoritmik şeffaflık ve tasarımdan itibaren adalet, örgütsel süreç tasarımı ve insan gözetimi, hesap verebilirlik, sürekli izleme ve etik yönetişim. Yazarların yaklaşımına göre yalnız veri temizlemek, tek bir fairness metriğini optimize etmek veya sisteme bir insan denetçi eklemek yeterli değildir; teknik ve sosyal sistemlerin birlikte ele alınması gerekir.
Bu sonuç bir algoritmanın deneysel olarak diğer algoritmadan daha adil olduğunun kanıtı değildir. Kaynak herhangi bir model eğitmemekte, aday verisi analiz etmemekte, demographic parity, equal opportunity veya başka bir fairness metriğini hesaplamamakta ve önerdiği dört katmanlı çerçeveyi gerçek bir kurumda kontrollü deneyle doğrulamamaktadır. Çalışmanın katkısı kavramsal ve teoriktir.
Yapay zekâ insan kaynaklarında nerelerde kullanılabilir?
Kaynak, yapay zekâ kullanımını insan kaynakları yaşam döngüsünün çok sayıda aşamasına yayılmış biçimde ele almaktadır. Bunlar arasında aday kaynağı bulma, özgeçmiş tarama, görüşme, yetkinlik veya aday değerlendirmesi, performans yönetimi, terfi, çalışanı elde tutma ve işten ayrılma/çıkarma süreçleri bulunmaktadır.
Bu sistemlerin kullanılmasının temel gerekçeleri; büyük aday hacimlerinin işlenebilmesi, insan emeğinin azaltılması, tahmine dayalı analiz yapılabilmesi, karar sürecinin ölçeklenebilmesi ve kararların daha nesnel olduğu yönündeki beklentidir.
Kaynak aynı zamanda önemli bir karşıt noktaya dikkat çekmektedir: Yapay zekâ sistemi yalnızca bilgisayar tarafından çalıştırıldığı için kendiliğinden tarafsız hâle gelmez. Sistem, beslendiği verinin tarihini, geliştiricilerin seçimlerini ve kullanıldığı kurumun karar mantığını taşıyabilir.
İnsan Kaynaklarında Algoritmik Önyargı Nedir?
Kaynak bağlamında algoritmik önyargı, yapay zekâ destekli insan kaynakları kararlarının ırk, cinsiyet, yaş, engellilik durumu, sosyoekonomik geçmiş veya benzeri grup özellikleriyle bağlantılı biçimde sistematik ve adaletsiz farklılıklar üretmesi veya mevcut eşitsizlikleri büyütmesidir; bu nedenle sorun yalnız model çıktısında değil, veriden örgütsel uygulamaya uzanan bütün sosyo-teknik sistemde aranmalıdır.
“Korunan özellik” ne demektir?
Protected characteristic — korunan özellik, ayrımcılık hukukunda veya kurumsal eşitlik politikalarında karar verilmesinde haksız ayrımcılığa temel oluşturmaması gereken kişisel özellikleri ifade eder. Kaynak örnekler arasında race, gender, age, disability ve socioeconomic background ifadelerini kullanmaktadır.
Ancak hangi özelliğin hukuken “korunan özellik” sayıldığı ülkeye ve düzenleyici sisteme göre değişebilir. Kaynağın kendisi de küresel bağlamda farklı kültürel normlar ve hukuki çerçevelerin fairness uygulamalarını zorlaştırdığını vurgulamaktadır. Bu nedenle verilen liste bütün ülkeler için tek ve evrensel hukuk listesi olarak okunmamalıdır.
DEI nedir?
Diversity, Equity and Inclusion — Çeşitlilik, Hakkaniyet ve Kapsayıcılık (DEI), çalışanların farklı özellik ve geçmişlerinin temsil edilmesini, fırsat ve süreçlerin hakkaniyetli olmasını ve bireylerin örgüte katılımının desteklenmesini hedefleyen kurumsal yaklaşımların genel adıdır.
Kaynak, önyargılı yapay zekâ sistemlerinin iş gücündeki eşitsizlikleri sürdürerek DEI girişimlerini zayıflatabileceğini, çalışan güvenini aşındırabileceğini ve hatalı yetenek kararlarına neden olabileceğini savunmaktadır.
Algoritmik önyargının dört ana kaynağı
| Önyargı kaynağı | Nasıl ortaya çıkabilir? | Kaynakta verilen örnekler |
|---|---|---|
| Veri önyargısı | Eğitim verisinin geçmişteki adaletsiz kararları veya eksik temsili taşıması. | Geçmiş işe alım/terfi ayrımcılığı, düşük grup temsili, eksik veri, vekil değişkenler, geri besleme döngüleri. |
| Algoritmik tasarım önyargısı | Model, özellikler veya optimizasyon hedefinin bazı grupları sistematik olarak dezavantajlı hâle getirmesi. | Model seçimi, feature engineering, “cultural fit” optimizasyonu, fairness kısıtlarının bulunmaması, black-box modeller. |
| Etkileşim önyargısı | İnsan kullanıcıların model çıktısını yorumlama biçimi veya adayların AI sistemiyle farklı koşullarda etkileşmesi. | Aşırı güven, doğrulama önyargısı, puanların yanlış anlaşılması, görüntü/aksan/kültürel sunum farklılıkları. |
| Bağlamsal / toplumsal önyargı | Daha geniş toplumsal eşitsizliklerin ve örgütsel önceliklerin veri ile sistem tasarımına taşınması. | Toplumsal eşitsizliklerin veri ve karar kriterlerinde yeniden üretilmesi. |
Veri önyargısı neden bu kadar önemlidir?
Bir makine öğrenmesi sistemi geçmiş karar verilerini kullanıyorsa, geçmiş kararların adil olduğu varsayımı kritik hâle gelir. Örneğin geçmişte belirli bir grubun sistematik olarak daha az işe alınmış olması, model açısından yalnız “geçmişte gözlenmiş bir örüntü” olarak görünebilir. Model bu örüntüyü başarı kriteriyle karıştırırsa geçmiş eşitsizliği gelecekte yeniden üretebilir.
Kaynak bu durumu veri önyargısını önyargının “core fuel — temel yakıtı” olarak nitelendirerek açıklamaktadır.
Proxy veya vekil değişken nedir?
Proxy variable — vekil değişken, modelde doğrudan kullanılmayan hassas bir özelliğe güçlü biçimde bağlı başka bir değişkendir. Kaynak posta kodu, üniversite adı veya özgeçmişteki bazı anahtar kelimeleri örnek vermektedir.
Örneğin bir sistem cinsiyet bilgisini doğrudan kullanmasa bile başka özellikler cinsiyetle güçlü biçimde ilişkiliyse model dolaylı biçimde benzer ayrımlar oluşturabilir. Bu nedenle yalnız hassas sütunu veri setinden silmek, fairness problemini otomatik olarak çözmez.
Feedback loop — geri besleme döngüsü nedir?
Geri besleme döngüsü, algoritmanın verdiği kararların daha sonra yeni eğitim verisinin parçası hâline gelerek önceki eğilimi güçlendirmesidir.
Kaynağın işaret ettiği mantık öğretici olarak şöyle düşünülebilir:
Geçmiş önyargılı veri → model tahmini → önyargılı karar → yeni kurumsal kayıt → sonraki model eğitimi.
Bu döngü kırılmazsa sistem başlangıçtaki dengesizliği yalnız tekrar etmekle kalmayabilir; sonraki veri nesillerinde daha belirgin hâle getirebilir.
Algoritmik tasarım önyargısı nasıl oluşabilir?
Kaynak dört önemli tasarım noktasına dikkat çekmektedir: model seçimi, özellik seçimi ve feature engineering, optimizasyon metriği ve fairness kısıtları.
Bir modelin optimizasyon hedefi, geliştiricinin “başarı” olarak tanımladığı matematiksel kriteri güçlendirmeye çalışır. Örneğin kaynak “cultural fit — kültürel uyum” için optimizasyon yapılmasının geçmiş örgütsel normları veya tercihleri modele kodlayabileceğini belirtmektedir.
Buradaki problem bilgisayarın kötü niyetli olması değildir. Problem, ölçülmeye çalışılan hedefin kendisinin yanlış, eksik veya sosyal olarak problemli biçimde tanımlanabilmesidir.
Black-box model ne demektir?
Black-box — kara kutu, modelin girdiden çıktıya nasıl ulaştığının kullanıcı tarafından kolayca anlaşılmadığı sistemleri tanımlamak için kullanılan genel ifadedir. Kaynak, karmaşık modellerin bu özelliğinin önyargının fark edilmesini zorlaştırabileceğini belirtmektedir.
Kara kutu olması bir modelin otomatik olarak önyargılı olduğu anlamına gelmez. Kaynağın vurgusu, karmaşıklığın kararın neden verildiğini incelemeyi ve hatalı örüntüleri teşhis etmeyi zorlaştırabilmesidir.
İnsan etkileşimi neden ayrıca bir önyargı kaynağıdır?
Bir algoritma teknik olarak aynı puanı üretse bile bu puanın insan yöneticiler tarafından nasıl yorumlandığı nihai sonucu değiştirebilir. Kaynak özellikle üç soruna dikkat çekmektedir:
- Algoritmik çıktıya aşırı güvenmek,
- çıktıyı kendi ön yargısını doğrulamak için kullanmak,
- AI puanının ne anlama geldiğini yanlış yorumlamak.
Kaynak ayrıca video görüşme gibi sistemlerde adayın ışık koşulları, aksanı veya kültürel sunum biçiminin teknolojiyle etkileşimi etkileyebileceğini örneklemektedir. Çalışma bu örnekler için yeni deney gerçekleştirmemiştir; bunları literatürdeki risk alanlarının kuramsal sentezi olarak sunmaktadır.
Önyargı insan kaynaklarının hangi aşamalarında görünür olabilir?
| HR alanı | Kaynakta belirtilen olası sorun |
|---|---|
| Recruitment & Screening — İşe alım ve aday tarama | Önyargılı özgeçmiş ayrıştırma, ayrımcı reklam hedefleme, video görüşme analizinde adaletsizlik ve geleneksel olmayan kariyer geçmişlerinin dezavantajlı sıralanması. |
| Performance Evaluation — Performans değerlendirmesi | Çarpık geçmiş verilere veya ilgisiz özelliklere dayalı gelecekteki performans tahmini ve adaletsiz karşılaştırma metrikleri. |
| Promotion & Succession Planning — Terfi ve halefiyet planlama | Geçmiş başarı kalıplarını yeniden kullanarak mevcut hiyerarşileri güçlendirme ve yeterince temsil edilmeyen gruplardaki yetenekleri gözden kaçırma. |
| Compensation — Ücretlendirme | Önyargılı veri veya vekil değişkenlerden hareketle daha düşük ücret bantlarının önerilmesi. |
Teknik debiasing nedir?
Debiasing, modelde veya veri işleme sürecinde gözlenen sistematik adaletsizliği azaltmayı amaçlayan tekniklerin genel adıdır. Kaynak bu teknikleri üç aşamada sınıflandırmaktadır.
Pre-processing — ön işleme: Model eğitilmeden önce verinin temizlenmesi veya yeniden ağırlıklandırılması.
In-processing — eğitim/modelleme sırasında müdahale: Fairness-aware algoritmalar veya adversarial debiasing gibi yöntemlerin doğrudan modelin öğrenme sürecine yerleştirilmesi.
Post-processing — sonradan işleme: Model tahminleri üretildikten sonra çıktıların veya karar eşiklerinin kalibre edilmesi.
Kaynak bu tekniklerin yararlı olabileceğini fakat çoğu zaman belirtileri hedeflediğini, fairness metrikleri arasında çatışmalar bulunabileceğini, korunan grupları tanımlamanın zor olabileceğini, bazı durumlarda model doğruluğuyla ödünleşim ortaya çıkabileceğini ve teknik yaklaşımın örgütsel bağlamı gözden kaçırabileceğini belirtmektedir.
Teknik Önyargı Giderme Yöntemleri Neden Tek Başına Yeterli Değildir?
Çalışmaya göre algoritmik önyargı yalnız veride veya model kodunda oluşmadığı için yalnız teknik debiasing uygulamak sistemik problemi çözmez; veri geçmişi, insan kullanıcıların davranışı, HR sürecinin tasarımı, kurumsal güç ilişkileri, hesap verebilirlik ve sürekli yönetişim aynı anda ele alınmalıdır.
Explainable AI — XAI nedir?
Explainable Artificial Intelligence — Açıklanabilir Yapay Zekâ (XAI), modelin tahmin veya önerisinin hangi girdilerle ve hangi mantıksal/istatistiksel ilişkilerle oluştuğunu kullanıcıya daha anlaşılır biçimde açıklamaya çalışan yöntemler bütünüdür.
Kaynak XAI bağlamında LIME ve SHAP tekniklerini örnek olarak vermektedir.
LIME — Local Interpretable Model-agnostic Explanations, karmaşık bir modelin belirli tek bir tahmininin çevresindeki davranışı daha basit ve yorumlanabilir bir yaklaşık modelle açıklamaya çalışan yerel açıklama yaklaşımıdır.
SHAP — SHapley Additive exPlanations, bir tahminde farklı özelliklerin katkısını işbirlikçi oyun teorisindeki Shapley değeri mantığıyla dağıtmaya dayanan açıklama ailesidir.
Kaynak bu yöntemlerin varlığını önyargının ortadan kalktığının kanıtı olarak görmemektedir. Açıklamalar karmaşık, eksik veya yanıltıcı olabilir; bağımsız denetim zaman ve uzmanlık gerektirebilir. XAI esas olarak problemi görünür kılmaya yardımcı olur; tek başına önyargıyı önleyen mekanizma değildir.
Human-in-the-Loop — HITL nedir?
Human-in-the-Loop — HITL, yapay zekâ sisteminin verdiği çıktıların belirli karar noktalarında insan tarafından incelenmesini veya insan karar sürecine dâhil edilmesini ifade eder.
Kaynak HITL'nin de otomatik çözüm olmadığını belirtmektedir. İnsan denetçi kendi bilişsel önyargılarını taşıyabilir, algoritmik puanı “objektif gerçek” gibi görerek sisteme aşırı güvenebilir veya çok büyük aday hacimlerinde insan incelemesi ölçeklenemeyebilir.
Bu nedenle önerilen çerçeve basit HITL yerine HITL+ yaklaşımını vurgulamaktadır: HR profesyonelleri ve yöneticiler yapay zekâ sınırları, önyargı tanıma, çıktı yorumlama ve gerektiğinde hatalı öneriyi geçersiz kılma konusunda eğitilmelidir.
Fairness metriği neyi ölçer?
Kaynak, algoritmik fairness için tek bir evrensel metrik vermemekte; bağlama uygun açık fairness hedeflerinin tanımlanması gerektiğini belirtmekte ve demographic parity ile equal opportunity kavramlarını örnek vermektedir.
Aşağıdaki denklemler kaynak makalenin hesapladığı bulgular değildir. Makalede adı geçen iki fairness kavramının ne anlama geldiğini öğretmek için standart matematiksel gösterimlerdir.
Demographic parity — demografik eşitlik
Basitleştirilmiş standart gösterim:
\[ P(\hat{Y}=1\mid A=a) = P(\hat{Y}=1\mid A=b) \]
Burada:
- \(\hat{Y}=1\): modelin olumlu karar vermesini, örneğin adayın sonraki aşamaya geçirilmesini,
- \(A\): incelenen grup özelliğini,
- \(a\) ve \(b\): karşılaştırılan iki grubu
temsil eder.
Bu fairness tanımı, olumlu karar oranlarının gruplar arasında eşit olmasını hedefler. Ancak tek başına adayların temel yeterlilik veya gerçek sonuç dağılımlarını dikkate almadığı için her HR bağlamında otomatik olarak doğru fairness standardı sayılamaz. Kaynağın “context-specific fairness” vurgusu tam olarak bu noktada önemlidir.
Equal opportunity — fırsat eşitliği
Basitleştirilmiş standart gösterim:
\[ P(\hat{Y}=1\mid Y=1,A=a) = P(\hat{Y}=1\mid Y=1,A=b) \]
Burada \(Y=1\), ilgili referans ölçütüne göre olumlu gerçek durumu; örneğin değerlendirme tasarımının tanımladığı “uygun/yeterli” durumu temsil eder.
Bu yaklaşım, gerçekten olumlu sınıfta bulunan kişilerin olumlu tahmin alma oranının gruplar arasında eşitlenmesine odaklanır. Makale bu metriği hesaplamamakta; yalnız fairness hedeflerinin bağlama göre seçilmesi gerektiğini belirtmektedir.
Kaynak ayrıca farklı fairness metriklerinin birbirleriyle veya accuracy, privacy ve iş gereksinimleriyle ödünleşim oluşturabileceğini vurgulamaktadır. Bu nedenle “tek bir fairness sayısını yükseltmek = bütün sistem adil oldu” sonucu çıkarılamaz.
Kuramsal temel 1: Critical HRM
Critical Human Resource Management — Eleştirel İnsan Kaynakları Yönetimi yaklaşımı, insan kaynakları süreçlerinin tamamen tarafsız teknik işlemler olmadığını; örgütsel güç yapıları, normlar ve eşitsizliklerle bağlantılı olabileceğini savunur.
Kaynak yapay zekâ araçlarını bu çerçevede yalnız pasif yazılım olarak değil, mevcut kurumsal dinamikleri yeniden üretebilen örgütsel aktörler olarak düşünmektedir.
Kuramsal temel 2: Sosyo-Teknik Sistemler Teorisi
Socio-Technical Systems Theory — Sosyo-Teknik Sistemler Teorisi, teknik sistem ile sosyal sistemi birbirinden bağımsız görmez. Algoritma, veri tabanı ve model teknik sistemin; çalışanlar, yöneticiler, örgütsel süreçler ve kültür sosyal sistemin parçalarıdır.
Kaynağın ana argümanı büyük ölçüde bu yaklaşım üzerine oturmaktadır: algoritmik önyargı azaltımı yalnız teknik katmanda yapılırsa sosyal katmandaki nedenler veya sonuçlar devam edebilir.
Kuramsal temel 3: Örgütsel Adalet Teorisi
Organizational Justice Theory — Örgütsel Adalet Teorisi, çalışanların kurum içindeki sonuçları ve karar süreçlerini ne kadar adil algıladığıyla ilgilenir.
Kaynak üç adalet biçimine atıf yapmaktadır:
- Distributive justice: sonuçların dağılımındaki adalet,
- procedural justice: karar sürecinin adaleti,
- interactional justice: karar sürecinde kişilere nasıl davranıldığıyla ilgili adalet.
Önyargılı AI özellikle prosedürel adaleti doğrudan tehdit edebilir; çünkü aday veya çalışan “karar hangi kuralla ve neden verildi?” sorusuna güvenilir cevap alamayabilir.
Kuramsal temel 4: Ethics of Care ve Human-Centered AI
Ethics of Care — Bakım Etiği ve Human-Centered AI — İnsan Merkezli Yapay Zekâ yaklaşımları, insan refahını, insan onurunu ve kararın içinde bulunduğu bağlamı merkeze alır.
Kaynağın bu perspektifteki açık yaklaşımı, insan kaynakları gibi değer yüklü karar alanlarında yapay zekânın insan yargısını tamamen ortadan kaldırmak yerine onu desteklemesi gerektiğidir.
Çalışmanın Yöntemi ve Bulguları
Çalışmanın bilimsel yöntemi
Bu çalışma yeni bir ampirik veri seti üretmemektedir. Kaynak kendisini teorik çalışma olarak tanımlamakta ve bilgisayar bilimi, sosyoloji, eleştirel HRM ve etik alanlarından görüşleri sentezleyerek kavramsal bir çerçeve oluşturmaktadır.
Kaynakta:
- literatür veri tabanı arama sorgusu,
- arama tarih aralığı,
- dahil etme/dışlama kriterleri,
- PRISMA veya benzeri çalışma seçim akışı,
- kalite değerlendirme protokolü,
- örneklem,
- kontrol grubu,
- model eğitimi,
- istatistiksel hipotez testi,
- fairness metriği hesabı
raporlanmamaktadır. Bu nedenle çalışma sistematik literatür derlemesi veya deneysel fairness benchmark'ı olarak sınıflandırılmamalıdır.
Dört Katmanlı Önyargı Azaltma Çerçevesi Nasıl Çalışır?
Kaynağın önerdiği çerçeve, önyargı azaltmayı tek bir model düzeltmesi yerine birbirine bağlı dört müdahale seviyesi olarak kurar: güvenilir ve izlenebilir veri temeli oluşturulur; algoritmada şeffaflık ve fairness hedefleri tasarlanır; HR süreçleri insan gözetimi ve itiraz mekanizmalarıyla yeniden düzenlenir; son olarak sorumluluk, sürekli denetim, iletişim ve etik kültür bütün sistemin yaşam döngüsü boyunca sürdürülür.
Katman 1 — Data Provenance & Responsible Curation
Data provenance — veri kökeni/provenansı, bir veri kümesinin nereden geldiğini, nasıl toplandığını, nasıl dönüştürüldüğünü ve hangi sınırlılıkları taşıdığını izleyebilme bilgisidir.
Kaynak bu katmanda üç müdahale önerir:
- Rigorous Data Auditing: Temsil dengesizlikleri, tarihsel önyargı, vekil değişkenler ve eksik veri örüntülerinin sistematik denetimi.
- Bias-Aware Data Collection & Annotation: Veri toplama ve etiketleme için fairness odaklı kurallar, çeşitli annotator havuzu, annotator önyargısı eğitimi ve veri lineage belgelemesi.
- Synthetic Data & Augmentation: Gerçek veri yetersiz olduğunda sentetik veri veya artırma tekniklerinin dikkatli biçimde değerlendirilmesi.
Kaynağın “cautiously — dikkatle” ifadesi önemlidir. Sentetik veri kendiliğinden adil veri anlamına gelmez; üretim yöntemi mevcut önyargıyı yeniden üretebilir. Çalışma sentetik veriyle yapılmış bir deney sunmamaktadır.
Katman 2 — Algorithmic Transparency & Fairness by Design
Fairness by Design, fairness kontrolünün sistem tamamlandıktan sonra eklenen bir düzeltme değil, model seçimi ve sistem tasarımından itibaren dikkate alınması yaklaşımıdır.
Kaynağın bu katmandaki bileşenleri:
- Gereksiz karmaşıklıktan kaçınıp bağlama uygun model seçmek,
- fairness hedef ve metriklerini açıkça tanımlamak,
- pre-processing, in-processing veya post-processing tekniklerini şeffaf biçimde uygulamak,
- HR profesyonelleri, yöneticiler ve adaylar için anlaşılabilir açıklamalar geliştirmek.
Kaynak özellikle “daha karmaşık model = daha iyi HR modeli” varsayımını kabul etmemektedir. Karmaşıklığın gereksiz olduğu durumlarda daha yorumlanabilir bir model tercih edilmesi önerilmektedir.
Katman 3 — Context, Process Design & Human Oversight
Bu katman modelden insan kaynakları sürecinin tamamına geçer.
Bias Impact Assessment — BIA, sistem kullanılmadan önce ve kullanım sırasında belirli gruplar üzerinde farklı/advers etkilerin oluşup oluşmadığını değerlendirmeye yönelik yapılandırılmış etki incelemesidir.
Kaynak BIA'nın deployment öncesinde ve periyodik olarak yapılmasını önerir.
İkinci temel ilke, yapay zekânın tek karar verici olmamasıdır. Özellikle aday veya çalışan açısından olumsuz sonuç doğuran kararlarda insan inceleme noktalarının ve itiraz/geri bildirim kanallarının bulunması önerilmektedir.
Üçüncü unsur HITL+'dır. İnsan gözetmen modelin sınırlılıklarını bilmeli, algoritmik çıktıyı sorgulayabilmeli ve hatalı bir öneriyi gerektiğinde geçersiz kılabilmelidir.
Dördüncü unsur ise geliştirme ve gözetim ekiplerinin yalnız teknik uzmanlardan oluşmamasıdır. Kaynak ekip çeşitliliğini cinsiyet, ırk, geçmiş ve uzmanlık alanları açısından ele almakta; HR, teknoloji ve etik bilgisinin birlikte bulunmasını önermektedir.
Katman 4 — Accountability, Monitoring & Culture
Kaynak son katmanda sistemin “kuruldu ve bitti” yaklaşımıyla yönetilemeyeceğini savunur.
Açık sorumluluk yapısı: AI sisteminin performansı, fairness sonuçları ve olumsuz etkileri için HR, IT, hukuk veya etik kurul gibi birimler arasında kimin hangi sorumluluğu taşıdığı tanımlanmalıdır.
Sürekli izleme ve audit: Fairness metrikleri, farklı gruplardaki doğruluk ve kullanıcı geri bildirimi zaman içinde izlenmeli; düzenli bağımsız denetimler planlanmalıdır.
Şeffaflık ve iletişim: Aday ve çalışanlara AI kullanıldığı, sistemin genel rolü ve itiraz mekanizmaları hakkında bilgi verilmesi önerilir.
Etik AI kültürü: Bias, etik ve responsible AI konusunda sürekli eğitim ve kurumsal kültür geliştirme önerilmektedir.
Düzenleyici uyum ve ötesi: Kaynak GDPR, önerilen AI düzenlemeleri ve EEOC rehberliği gibi örnekleri anmakta; yalnız minimum hukuki uyumla yetinmek yerine etik iyi uygulamaların hedeflenmesini savunmaktadır. Çalışma ayrıntılı hukuk analizi yapmamaktadır.
Önerilen çerçevenin ampirik durumu
Dört katmanlı model kaynakta teorik olarak önerilmektedir. Çalışmada bu çerçevenin uygulanmasından önce ve sonra:
- disparate impact değişimi,
- demographic parity değişimi,
- true-positive-rate farkı,
- model doğruluğu,
- işe alım çeşitliliği,
- aday memnuniyeti,
- hukuki vaka sayısı
gibi ölçümler yapılmamıştır. Bu nedenle çerçeve “etkisi deneysel olarak kanıtlanmış müdahale paketi” olarak değil, mevcut literatürü bütünleştiren sosyo-teknik bir öneri olarak okunmalıdır.
Kaynağın mevcut yöntemler için verdiği sınırlılıklar
| Yaklaşım | Amaç | Kaynakta belirtilen sınırlılık |
|---|---|---|
| Pre-processing debiasing | Eğitim verisini model öncesinde düzeltmek. | Bağlamsal veya örgütsel nedenleri tek başına çözmeyebilir. |
| In-processing / fairness-aware learning | Fairness hedefini öğrenme sürecine dahil etmek. | Fairness metrikleri arasında ödünleşimler ve accuracy etkileri ortaya çıkabilir. |
| Post-processing | Model çıktılarının/eşiklerinin sonradan kalibre edilmesi. | Temel veri veya süreç problemini ortadan kaldırmayabilir. |
| XAI / Audit | Model kararının nedenlerini incelemek ve önyargıyı tespit etmek. | Açıklamalar karmaşık, eksik veya yanıltıcı olabilir; audit uzmanlık ve kaynak gerektirir; tespit önleme değildir. |
| Human-in-the-Loop | Karara insan gözetimi eklemek. | İnsan önyargısı, automation bias/aşırı güven ve ölçeklenebilirlik sorunları devam edebilir. |
Fairness neden tek bir tanıma indirgenemiyor?
Kaynak fairness'ın bağlama özgü olarak operasyonelleştirilmesini en önemli güçlüklerden biri olarak göstermektedir. Bir HR sürecinde “adil sonuç” denildiğinde farklı hedefler ortaya çıkabilir: grupların olumlu karar oranlarının eşitliği, gerçekten uygun adayların yakalanma oranlarının eşitliği, benzer adayların benzer biçimde değerlendirilmesi veya karar sürecinin açıklanabilir ve itiraz edilebilir olması gibi.
Kaynak bu nedenle fairness hedefinin teknik ekip tarafından tek başına seçilmesine karşı daha geniş sosyo-teknik değerlendirme önermektedir.
Fairness, doğruluk, gizlilik ve işletme ihtiyacı arasındaki ödünleşim
Çalışmanın tartışmasında fairness'ın tek hedef olmadığı belirtilir. Kurum aynı zamanda model doğruluğunu, aday gizliliğini, süreç maliyetini ve operasyonel gereksinimleri yönetmek zorundadır.
Kaynağın söylediği, fairness için mutlaka doğruluk kaybedileceği değildir. Söylediği, bu amaçların bazı tasarımlarda çatışabileceği ve trade-off'ların açık biçimde yönetilmesi gerektiğidir.
Mükemmel tarafsızlık mümkün mü?
Kaynak “illusion of neutrality — tarafsızlık yanılsaması” kavramıyla tam ve kusursuz tarafsızlığın muhtemelen erişilebilir bir hedef olmadığını vurgulamaktadır. Bunun yerine hedef:
- önyargının farkında olmak,
- ölçmek ve denetlemek,
- mümkün olan yerde azaltmak,
- etkileri sürekli izlemek,
- değişen koşullara göre sistemi yeniden değerlendirmek
olmalıdır.
İnsan kaynakları uygulamaları açısından anlamı
Kaynağa göre sorumlu AI kullanımı önemli kurumsal yatırım gerektirir. Bu yalnız yazılım satın alma maliyeti değildir; veri bilimi ve etik uzmanlığı, süreç yeniden tasarımı, yönetici/HR eğitimi, denetim, hukuki inceleme ve kültürel değişim gerektirebilir.
Bu yaklaşım HR fonksiyonuna yeni bir sorumluluk da yükler: İnsan kaynakları birimi yalnız AI çıktısını kullanan son kullanıcı değil, teknolojinin etik kullanımının gözeticilerinden biri hâline gelir.
Çalışmanın desteklediği sonuçlar
- İnsan kaynaklarında algoritmik önyargı yalnız teknik algoritma seviyesinde ortaya çıkabilecek bir problem olarak ele alınmamalıdır.
- Geçmiş veri, model tasarımı, optimizasyon hedefleri, insan–AI etkileşimi ve örgütsel/toplumsal bağlam birlikte önyargı üretebilir veya güçlendirebilir.
- İşe alım, performans değerlendirme, terfi ve ücretlendirme süreçleri algoritmik önyargının görünür olabileceği HR alanlarıdır.
- Teknik debiasing teknikleri yararlı olabilir ancak tek başına bütün sosyo-teknik problemi çözmez.
- XAI ve audit önyargıyı tespit etmeye yardımcı olabilir; varlıkları sistemin otomatik olarak adil olduğu anlamına gelmez.
- Human-in-the-Loop yaklaşımının insan önyargısı ve automation bias gibi kendi sınırlılıkları vardır.
- Kaynak veri, algoritma, örgütsel süreç ve yönetişimi kapsayan dört katmanlı bütüncül müdahale çerçevesi önermektedir.
- Algoritmik fairness tek seferlik düzeltme değil, sürekli izleme ve yönetişim süreci olarak ele alınmaktadır.
Çalışmanın desteklemediği sonuçlar
- Belirli bir AI işe alım sisteminin ayrımcı olduğu bu çalışma tarafından deneysel olarak gösterilmemiştir.
- Önerilen dört katmanlı çerçevenin fairness değerini belirli bir yüzde artırdığı ölçülmemiştir.
- LIME veya SHAP kullanımının tek başına önyargıyı ortadan kaldırdığı gösterilmemiştir.
- Human-in-the-Loop kullanılan bütün HR sistemlerinin adil olacağı kanıtlanmamıştır.
- Belirli bir fairness metriğinin bütün işe alım veya terfi süreçleri için en doğru metrik olduğu ileri sürülmemektedir.
- Kaynak yeni makine öğrenmesi algoritması, veri seti veya fairness benchmark'ı geliştirmemektedir.
- Çalışma bir hukuk incelemesi olmadığı için belirli bir sistemin GDPR, Title VII, EEOC rehberliği veya başka bir düzenlemeyle uyumlu olup olmadığını belirlememektedir.
- Kaynak farklı ülkelerdeki gerçek HR süreçlerinde çerçevenin uzun dönemli etkisini ölçmemektedir.
Temel bilimsel ve yöntemsel sınırlılıklar
Teorik tasarım: Çalışma kavramsal sentezdir; önerilen çerçevenin ampirik performansı test edilmemiştir.
Literatür seçim protokolü yoktur: Çalışma çeşitli disiplinlerden kaynakları bir araya getirmektedir ancak sistematik veri tabanı araması, dahil etme/dışlama ölçütü veya çalışma kalite değerlendirme protokolü vermemektedir.
Fairness metriği hesaplanmamıştır: Demographic parity ve equal opportunity örnek olarak anılmakta fakat herhangi bir gerçek HR veri seti üzerinde hesaplanmamaktadır.
Bağlam bağımlılığı: Fairness tanımı ve korunan özellikler kültür, sektör ve hukuk düzenine göre değişebilir.
İnsan faktörü devam eder: İnsan gözetiminin sisteme eklenmesi insan önyargısını otomatik olarak kaldırmaz.
Kaynak ve ölçek maliyeti: Çok katmanlı denetim uzmanlık, süreç yeniden tasarımı ve sürekli izleme gerektirdiği için kaynak yoğun olabilir.
Teknolojik değişim: AI ve bias tespit/azaltma tekniklerinin hızla gelişmesi, yönetişim mekanizmalarının sürekli güncellenmesini gerektirir.
Kaynağın gelecek araştırma önerileri
Çalışma gelecekte:
- HR bağlamına özel fairness metrikleri ve denetim araçlarının geliştirilmesini,
- önyargı azaltma stratejilerinin gerçek dünyadaki uzun dönemli etkisini inceleyen longitudinal araştırmaları,
- çalışan ve adayların tasarım sürecine katıldığı participatory design yaklaşımlarını,
- farklı yönetişim modellerinin etkinliğinin karşılaştırılmasını,
- emotion recognition ve diğer ileri analitik yöntemlerin etik sonuçlarının incelenmesini
önermektedir.
Bunlar mevcut bildirinin doğruladığı bulgular değil, araştırılması gereken gelecek çalışma alanlarıdır.
Kaynak ve Yöntem Notu
Özgün başlık: ALGORITHMIC BIAS IN ARTIFICIAL INTELLIGENCE - BASED HUMAN RESOURCE DECISIONS: A THEORETICAL PERSPECTIVE
Yazarlar: Dr.T.Naresh Babu; Dr.N.Suhasini.
Yazar sırası: Dr.T.Naresh Babu birinci, Dr.N.Suhasini ikinci yazardır.
Dr.T.Naresh Babu: Associate Professor, Department of Management Studies, KSRM College of Engineering (A), Kadapa, Andhra Pradesh.
Dr.N.Suhasini: HoD & Professor, Department of Management Studies, KSRM College of Engineering (A), Kadapa, Andhra Pradesh.
Corresponding author: Kaynakta açıkça belirtilmemiştir.
Eş katkı / eş birinci yazarlık: Kaynakta bildirilmemiştir.
Kaynak türü: Teorik/kavramsal konferans bildirisi; anlatısal ve disiplinler arası literatür sentezi.
Bilimsel alan: Yapay zekâ etiği, insan kaynakları yönetimi, algoritmik fairness, sosyo-teknik sistemler ve örgütsel adalet.
Platform: International Conference Proceedings on Advanced Multidisciplinary Research and Innovation (ICAMRI – 2026).
Makale sayfaları: Bildiriler kitabında 1–6; yüklenen PDF'de 11–16. sayfalar.
Baskı: First Edition.
Baskı tarihi: August 2026.
ISBN: 978-81-688512-3-8.
Kaynakta verilen DOI: 10.65647/msp/128/2026.
DOI sınırı: Aynı DOI bildiriler kitabındaki diğer makale sayfalarının altında da kullanılmaktadır. Kaynak bunun bu bildiriye özgü bağımsız DOI olduğunu açık biçimde göstermediği için Verianla bunu makale DOI'si olarak kesinleştirmemektedir.
Konferans tarihiyle ilgili kaynak-içi fark: Bildiriler kitabı ICAMRI – 2026 ve August 2026 baskısı olarak sunulurken organizasyon sayfasında konferans tarihi 15th August 2025 olarak yazılmıştır.
Organizasyon: University of Edenberg, Lusaka, Zambia, Africa.
Akademik işbirliği: S.T.Hindu College; Sree Ayyappa College for Women; Don Bosco College; Women's Christian College.
Hakemlik: Bildiriler kitabının önsözü bütün manuskriptlerin deneyimli hakemler ve alan uzmanlarından oluşan panel tarafından rigorous peer-review process kapsamında değerlendirildiğini beyan etmektedir. Bu konferans kitabının kendi beyanıdır; çalışma hakemli dergi makalesi olarak sınıflandırılmamıştır.
Lisans / telif: Kaynak “All Rights Reserved” ve © Publisher ibarelerini taşımaktadır. Açık Creative Commons lisansı belirtilmemiştir.
Yayıncı bilgisi: PDF'de “Publisher” başlığı altında Australia, Chennai & Kanyakumari; +91 6384730258; editor@multispectrum.org ve www.multispectrum.org bilgileri bulunmaktadır. Kurumsal yayınevi adı PDF'nin bibliyografik sayfasında ayrıca açık biçimde yazılmamıştır.
Resmî bağlantı: Kaynak bildiriler kitabında www.multispectrum.org adresini vermektedir. Bu makaleye özel ayrı resmî yayın URL'si PDF içinde belirtilmemiştir.
Anahtar kelimeler: Artificial Intelligence; AI Bias; Algorithmic Bias; Human Resources; HR Decision-Making; Fairness; Ethics; Responsible AI; Socio-Technical Systems; Diversity; Equity; Inclusion.
Temel araştırma amacı: İnsan kaynakları kararlarında yapay zekâ önyargısının veri, algoritma, insan etkileşimi ve örgütsel/toplumsal bağlamdan doğan çok katmanlı yapısını kavramsal olarak incelemek ve yalnız teknik düzeltmeye dayanmayan bütüncül bir azaltma çerçevesi önermek.
Yöntem: Kaynak kendi çalışmasını theoretical paper olarak tanımlamaktadır. Bilgisayar bilimi, sosyoloji, Critical HRM ve etik literatüründen kavramlar sentezlenmiştir. Ayrı bir sistematik arama veya çalışma seçim yöntemi raporlanmamaktadır.
Örneklem: Bulunmamaktadır.
Veri seti: Bulunmamaktadır.
Deney / kontrol grubu: Bulunmamaktadır.
Model eğitimi: Bulunmamaktadır.
İstatistiksel analiz: Bulunmamaktadır.
p değeri / güven aralığı / etki büyüklüğü: Raporlanmamıştır.
Kaynakta hesaplanmış fairness metriği: Bulunmamaktadır.
Kaynakta bilimsel denklem: Bulunmamaktadır. HTML içindeki demographic parity ve equal opportunity gösterimleri, kaynağın adıyla andığı fairness kavramlarını öğretmek için verilen standart kavramsal denklemlerdir ve çalışma sonucu değildir.
Teorik temeller: Critical HRM Perspective; Socio-Technical Systems Theory; Organizational Justice Theory; Ethics of Care; Human-Centered AI.
Önyargı kaynakları: Data Bias; Algorithmic Design Bias; Interaction Bias; Contextual/Societal Bias.
Başlıca uygulama alanları: Recruitment & Screening; Performance Evaluation; Promotion & Succession Planning; Compensation.
Mevcut azaltma yaklaşımları: Pre-processing, in-processing ve post-processing debiasing; auditing; XAI; LIME; SHAP; Human-in-the-Loop.
Önerilen çerçeve — Katman 1: Data Provenance & Responsible Curation.
Önerilen çerçeve — Katman 2: Algorithmic Transparency & Fairness by Design.
Önerilen çerçeve — Katman 3: Organizational Context, Process Design & Human Oversight.
Önerilen çerçeve — Katman 4: Governance — Accountability, Monitoring & Culture.
Kaynakça: Bildiri sonunda 10 bibliyografik girdi bulunmaktadır; Barocas & Selbst, Bogen & Rieke, Dastin, Friedman & Nissenbaum, Green & Chen, Holm & Staunæs, Kamishima ve arkadaşları, Mehrabi ve arkadaşları, Raghavan ve arkadaşları, Selbst ve arkadaşları kaynakçada yer almaktadır.
Finansman: Ayrı finansman bildirimi bulunmamaktadır.
Çıkar çatışması: Ayrı çıkar çatışması bildirimi bulunmamaktadır.
Veri erişilebilirliği: Ayrı data availability statement bulunmamaktadır; çalışma yeni veri üretmeyen teorik bir bildiridir.
CRediT / yazar katkıları: Ayrı yazar katkı bildirimi bulunmamaktadır.
Etik kurul: Kaynakta ayrı etik kurul beyanı bulunmamaktadır; çalışma insan katılımcı üzerinde yeni deney veya veri toplama raporlamayan teorik araştırmadır.
Kaynak şekilleri: Kaynakta özgün bilimsel şekil veya veri grafiği bulunmamaktadır. Verianla HTML'sindeki iki SVG, kaynak metinde açıkça tanımlanan önyargı zinciri ve dört katmanlı çerçevenin bağımsız, ölçeksiz ve kaynak-türetilmiş görsel karşılıklarıdır.
Temel yorum sınırı: Çalışma algoritmik HR önyargısının sistemik niteliğini ve çok katmanlı azaltma yaklaşımını kuramsal olarak savunmaktadır. Çerçeve herhangi bir gerçek HR veri setinde deneysel olarak test edilmediği için belirli bir algoritmanın, şirketin veya müdahalenin fairness performansı hakkında nicel sonuç çıkarılamaz.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir