

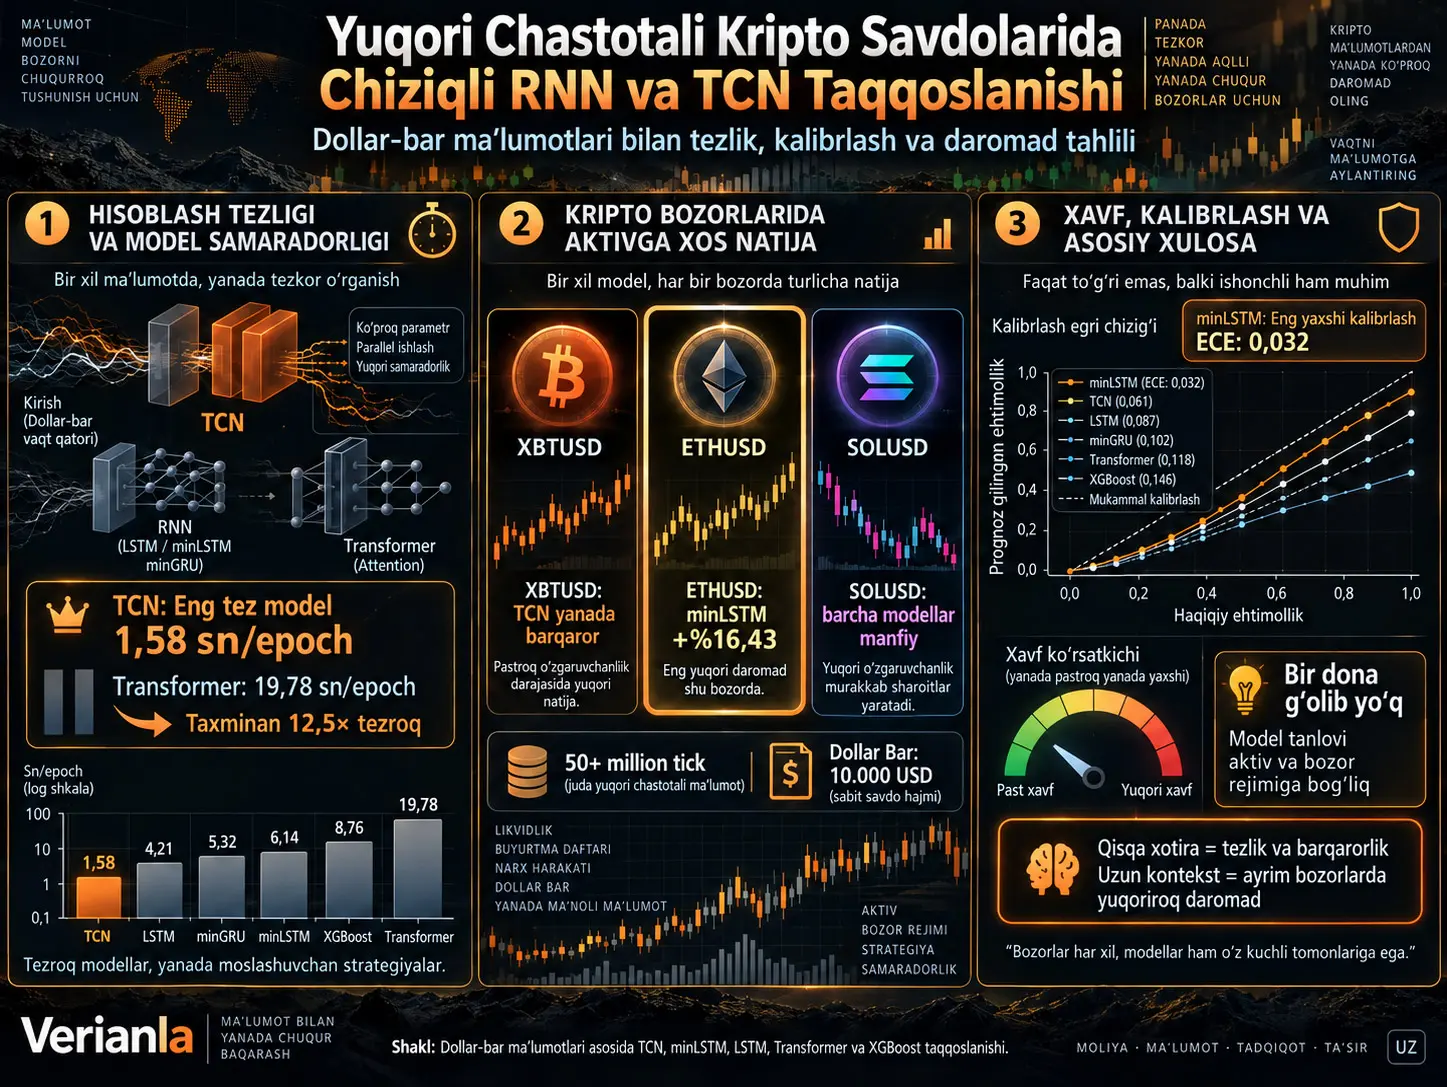
Yuqori chastotali moliyaviy ma’lumotlarda kuchli model faqat to‘g‘ri prognoz qilishi shart emas; u, shuningdek, millionlab bitimlardan iborat oqimni yetarlicha tez qayta ishlashi, bozor rejimi o‘zgarganda eski ma’lumotni unutishi, ishlab chiqargan ehtimollari yaxshi kalibrlangan bo‘lishi va tranzaksiya xarajatlari sharoitida iqtisodiy qiymat yaratishi kerak. Ushbu tadqiqot muammoning turli jihatlarini bir xil tajriba tuzilmasida sinab, minGRU, minLSTM, klassik LSTM, Temporal Convolutional Network (TCN), Transformer va XGBoost modellarini taqqoslaydi.
Tajribalar Kraken kriptovalyuta birjasidan olingan 50 milliondan ortiq tickni qamrab oluvchi XBTUSD, ETHUSD va SOLUSD ma’lumotlarida o‘tkazilgan. Qat’iy vaqt oralig‘i o‘rniga taxminan 10.000 USD tranzaksiya qiymatiga yetilganda yangi kuzatuv yaratadigan dollar-bar namunalash qo‘llanadi. Shu yo‘l bilan juda faol va juda sokin bozor davrlarining bir xil vaqt barida haddan tashqari turlicha miqdordagi bitimlarni o‘z ichiga olishi kamaytiriladi.
Tadqiqotning asosiy xulosasi shuki, bitta model arxitekturasi barcha bozorlarda ustun emas. TCN hisoblash jihatidan aniq eng tez modeldir. \(L=1024\) ketma-ketlik uzunligida bir epoch TCN uchun 1,58 soniya, minLSTM uchun 4,90 soniya, minGRU uchun 4,00 soniya, klassik LSTM uchun 4,16 soniya va Transformer uchun 19,78 soniyani tashkil qiladi.
Iqtisodiy natijalar esa aktivga qarab teskari tus oladi. XBTUSD’da \(L=1024\) uchun minLSTM +%9,52 bilan eng yuqori mutlaq daromadni yaratadi, TCN esa 0,174 Sortino nisbati va −%0,86 maksimal drawdown bilan barqarorroq risk profilini ko‘rsatadi. ETHUSD’da minLSTM +%16,43 daromad va 0,276 Sortino bilan yaqqol ajralib turadi. SOLUSD’da esa hech bir model umumiy namunada ijobiy daromad yaratmaydi.
Tadqiqotning umumiyroq xabari shundan iboratki, moliyaviy vaqt qatorlarida “kattaroq model”, “uzunroq xotira” yoki “zamonaviyroq arxitektura” iboralari o‘z-o‘zidan samaradorlik kafolatini bermaydi. Modelning induktiv moyilligi, bozorning yetukligi, volatillik rejimi, talab qilinadigan xotira uzunligi va prognoz ehtimollarining kalibrlanishi birgalikda baholanishi kerak.
Yuqori chastotali moliyaviy ma’lumotlar nega boshqacha?
Tabiiy til kabi ko‘plab sequence-learning muammolarida uzoq o‘tmish konteksti muhim axborot tashishi mumkin. Moliyaviy mikrostrukturada esa eski ma’lumotning qiymati ancha tez yo‘qolishi mumkin. Buyurtma oqimi, qisqa muddatli sotib olish-sotish bosimi, likvidlikdagi o‘zgarishlar va narx qaytishlari bir necha bitim ichida ta’sirini yo‘qotishi mumkin.
Shuning uchun asosiy muammo faqat “uzoq o‘tmishni eslab qolish” emas. Model qaysi ma’lumot endi shovqin ekanini ajrata olishi va yangi bozor rejimiga tez moslashishi kerak.
Klassik LSTM buning uchun forget, input va output gate tuzilmalaridan foydalanadi; biroq vaqt qadamlari ketma-ket qayta ishlangani sababli GPU parallellashtirish cheklanadi. Transformer butun ketma-ketlikni parallel qayta ishlay oladi, ammo standart self-attention hisoblash xarajati ketma-ketlik uzunligiga nisbatan taxminan \(O(L^2)\) o‘sadi.
minGRU va minLSTM kabi chiziqli rekurrent arxitekturalar ushbu ikki yondashuv orasida yechim taklif qiladi: recurrent state saqlanadi, hidden-state bog‘liqligi gate hisobidan chiqariladi va hisoblash parallel associative scan ko‘rinishiga aylantirilishi mumkin.
minGRU va minLSTM Nega Osonroq Parallellashtiriladi?
Standart GRU’dagi update gate taxminan:
\[ z_t=\sigma(W_zx_t+U_zh_{t-1}) \]
ko‘rinishidadir. Bu yerdagi \(h_{t-1}\), oldingi hidden state hisoblanmasdan joriy gate qiymatini yakunlab bo‘lmasligini anglatadi.
minGRU yondashuvida recurrent hidden-state hadi gate hisobidan chiqariladi:
\[ z_t=\sigma(W_zx_t) \]
va nomzod holat:
\[ \tilde{h}_t=g(W_hx_t) \]
ko‘rinishida hisoblanadi.
Yangilanish:
\[ h_t=(1-z_t)\odot h_{t-1}+z_t\odot\tilde{h}_t \]
bo‘ladi.
Ushbu tuzilma:
\[ h_t=a_th_{t-1}+b_t \]
ko‘rinishidagi chiziqli recurrence shakliga aylangani sababli associative scan bilan parallel hisoblanishi mumkin. Manbaning nazariy doirasida bu tuzilma umumiy hisoblash ishi bo‘yicha \(O(L)\), parallel reduction chuqurligi bo‘yicha esa taxminan \(O(\log L)\) xususiyatiga ega va inference paytida keladigan yangi kuzatuv uchun faqat joriy state’ni yangilash kifoya.
TCN boshqa yondashuvdan foydalanadi
Temporal Convolutional Network recurrent state ishlatish o‘rniga causal va dilated convolution qo‘llaydi. Asosiy tajribada kernel o‘lchami \(k=3\) va dilation qiymatlari \(\{1,2\}\).
Effective receptive field:
\[ RF=1+\sum_i(k-1)d_i \]
bo‘lgani uchun asosiy TCN taxminan 7 dollar-bar o‘tmishni ko‘ra oladi.
Uch qatlamli \(\{1,2,4\}\) dilation variantida receptive field taxminan 15 bar bo‘ladi.
Bu nuqta muhim: tajribada TCN uchun kirish ketma-ketligi \(L=1024\) bo‘lsa ham, modelning yakuniy prognozi uchun samarali o‘tmish barcha 1024 bar emas. Asosiy TCNning inductive bias’i ayniqsa juda qisqa lokal mikrostruktura naqshlarini o‘rganishga majbur qilingan.
Dollar-Bar Namunalash Nima va Nega Qo‘llanadi?
Standart 1 daqiqalik barlar har bir vaqt bo‘lagida bir xil davomiylikni qamrab oladi, ammo bir xil miqdordagi iqtisodiy faollikni qamrab olmaydi. Bir daqiqada bozor juda faol bo‘lsa, minglab bitimlar yuz berishi mumkin; sokin bir daqiqada esa juda oz bitim bo‘lishi mumkin.
Tadqiqotda buning o‘rniga har bir yangi bar umumiy tranzaksiya qiymati belgilangan chegaraga yetganda yaratiladi:
\[ \sum_{i=k_{last}+1}^{k}p_iv_i\geq\theta \]
va
\[ \theta=10.000\ \text{USD}. \]
Shunday qilib, har bir dollar-bar taxminan bir xil dollar ko‘rinishidagi iqtisodiy tranzaksiya faolligini ifodalashga intiladi.
| Aktiv | Dollar-Bar Soni | O‘rtacha Kunlik Volatillik | Daromad Kurtosisi |
|---|---|---|---|
| XBTUSD | ≈699.299 | %2,1 | 4,2 |
| ETHUSD | ≈450.100 | %3,4 | 5,8 |
| SOLUSD | ≈320.500 | %5,8 | 12,1 |
SOLUSD’ning 12,1 kurtosis qiymati uch aktiv orasida eng qalin dumli narx xatti-harakati shu bozorda ekanini ko‘rsatadi. XBTUSD esa 4,2 bilan pastroq kurtosis qiymatiga ega.
Manbaning nazariy lemmasi dollar barlar dispersiyani barqarorlashtirishini ta’kidlaydi. Biroq tenglama barqarorlashtiriladigan miqdor fizik coin hajmi emas, balki narx × hajm bilan o‘lchanadigan taxminiy dollar tranzaksiya qiymati ekanini ko‘rsatadi. Shu sababli “har bir barda hajm doimiy” degan ibora texnik jihatdan dollar-notional doimiyligiga yaqinroq talqin qilinishi kerak.
Modellar Qaysi Kirishlardan Foydalanadi?
Manba mikrostruktura xususiyatlari sifatida aniq uchta kirishni belgilaydi.
Log daromad:
\[ r_t=\ln\left(\frac{p_t}{p_{t-1}}\right) \]
Order Flow Imbalance:
\[ OFI_t= \frac{ V_t^{buy}-V_t^{sell} }{ V_t^{buy}+V_t^{sell}+\epsilon } \]
Tick intensity:
\[ \tau_t=\ln(1+\text{count}_t). \]
Barcha xususiyatlar heavy-tail ta’sirini kamaytirish uchun median atrofida markazlashtirilgan va interquartile range yordamida RobustScaler bilan masshtablangan.
Shunga qaramay, manba kirish vektorini \(x_t\in\mathbb{R}^{4}\) deb belgilaydi va Universal Model kirish qatlami ham 4 o‘lchovli kirishni 256 o‘lchovga proyeksiya qiladi. Xususiyatlar ro‘yxatida esa faqat uchta o‘zgaruvchi aniq berilgan. To‘rtinchi xususiyat nima ekani PDF’da ko‘rsatilmagan. Bu tadqiqotni to‘liq qayta ishlab chiqish nuqtai nazaridan muhim kamchilikdir.
Model Taqqoslash Qanday Adolatli Qilinadi?
Chuqur modellar umumiy Universal Model doirasiga joylashtirilgan:
Kirish → 256 o‘lchovli projection → sequence encoder → layer normalization → Bear / Neutral / Bull tasniflash boshi
Model parametrlarining aksariyati taxminan 200.000–500.000 oralig‘ida saqlangan. Ketma-ketlik uzunligi:
\[ L\in\{256,512,1024\} \]
ko‘rinishida o‘zgartirilgan.
Taqqoslangan modellar:
- ikki qatlamli klassik LSTM,
- minGRU,
- minLSTM,
- ikki qatlamli qisqa-xotirali TCN,
- ikki qatlamli va to‘rtta attention head’li Transformer,
- 100 estimator va maksimal chuqurlik 6 ishlatadigan XGBoost.
XGBoost sequence modeli emas va \(L\) o‘zgarishidan bevosita ta’sirlanmaydigan tabular baseline sifatida ishlatilgan.
Transformer esa causal mask ishlatadi, ammo explicit positional encoding ishlatmaydi. Ushbu tajriba dizayni Transformer natijalarini talqin qilishda ayniqsa muhim.
Walk-Forward Validatsiya Nega Muhim?
Moliyaviy vaqt qatorlarida tasodifiy train-test ajratish kelajak kuzatuvlarining o‘tmishga sizib kirishiga olib kelishi mumkin. Tadqiqotda besh fold expanding-window walk-forward validation qo‘llanadi.
Birinchi o‘qitish qismi ma’lumotning %50’idir. Keyin o‘qitish oynasi kengaytiriladi va faqat keyingi davr sinovdan o‘tkaziladi.
Ushbu tuzilma:
O‘tmishda o‘qit → kelajakda test qil → o‘qitish oynasini kengaytir → yana test qil
mantiqi bilan real vaqtdagi modelni qayta o‘qitishning vaqt ketma-ketligini yaqinlashtiradi.
Backtest qanday ishlaydi?
Boshlang‘ich kapital:
\[ 100.000\ \text{USD} \]
deb belgilangan.
Modelning eng yuqori sinf ehtimoli:
\[ \tau=0,40 \]
chegarasidan oshsa Bear yoki Bull sinfiga ko‘ra short yoki long pozitsiya ochiladi. Signal teskariga o‘girilganda pozitsiya yopiladi.
Algoritm fee va slippage terminlarini ham o‘z ichiga oladi. Biroq PDF bu ikki parametr uchun ishlatilgan sonli qiymatlarni ko‘rsatmaydi. Modellar ishlab chiqargan bitimlar soni sezilarli farq qilgani sababli bu kamchilik sof PnL’ni qayta ishlab chiqish imkoniyatiga bevosita ta’sir qilishi mumkin.
Tadqiqot Usuli va Natijalari
Hisoblash vaqti: TCN nega ajralib turadi?
| Model | L=256 | L=512 | L=1024 |
|---|---|---|---|
| Transformer | 4,02 son | 8,70 son | 19,78 son |
| minLSTM | 1,46 son | 2,63 son | 4,90 son |
| minGRU | 1,29 son | 2,21 son | 4,00 son |
| LSTM | 1,39 son | 2,26 son | 4,16 son |
| TCN | 0,62 son | 0,98 son | 1,58 son |
TCN barcha ketma-ketlik uzunliklarida eng past epoch vaqtiga ega.
\(L=1024\) uchun TCN minLSTM’ga nisbatan taxminan:
\[ \frac{4,90}{1,58}\approx3,1 \]
marta tez ekani ko‘rinadi.
Transformer bilan taqqoslash esa:
\[ \frac{19,78}{1,58}\approx12,5 \]
martadir.
Shu sababli manbaning abstract va xulosa qismidagi “15× faster than Transformers” iborasi 2-jadvaldagi bevosita qiymatlardan olinadigan taxminan 12,5× nisbat bilan to‘liq mos kelmaydi.
Prognoz Aniqligi bilan Moliyaviy Daromad Bir Xil Narsami?
Yo‘q. Tadqiqotning muhim natijalaridan biri macro F1 balli iqtisodiy daromad bilan chiziqli bog‘lanish ko‘rsatmasligidir.
| Model | XBTUSD F1 | ETHUSD F1 | SOLUSD F1 |
|---|---|---|---|
| LSTM | 0,372 | 0,392 | 0,350 |
| minGRU | 0,391 | 0,430 | 0,354 |
| minLSTM | 0,377 | 0,434 | 0,364 |
| TCN | 0,377 | 0,414 | 0,350 |
| Transformer | 0,357 | 0,403 | 0,319 |
| XGBoost | 0,363 | 0,380 | 0,360 |
Barcha F1 qiymatlarining taxminan 0,30–0,43 diapazonda bo‘lishi yuqori chastotali kripto ma’lumotlaridagi past signal-to-noise nisbatini ko‘rsatadi.
Shunga qaramay, tasniflashdagi bir necha ball farq moliyaviy natijaga birma-bir o‘girilmaydi. Strategiyaning iqtisodiy natijasi signal qaysi bozor davrlarida to‘g‘ri bo‘lgani, noto‘g‘ri prognoz kattaligi, pozitsiya davomiyligi, ehtimol kalibrlanishi va savdo chastotasi kabi omillarga ham bog‘liq.
Bitcoin’da Qanday Model Xatti-harakati Ko‘rinadi?
\(L=1024\) uchun XBTUSD natijalari:
| Model | Umumiy Daromad | Max Drawdown | Sortino | Bitim |
|---|---|---|---|---|
| LSTM | +%9,09 | −%1,08 | 0,135 | 642 |
| minGRU | +%4,11 | −%1,39 | 0,097 | 414 |
| minLSTM | +%9,52 | −%1,72 | 0,152 | 481 |
| TCN | +%4,29 | −%0,86 | 0,174 | 594 |
| Transformer | +%4,99 | −%1,42 | 0,144 | 830 |
| XGBoost | +%8,71 | −%1,29 | 0,125 | 2012 |
Mutlaq daromadda minLSTM va LSTM ajralib tursa, TCN pastroq daromad, ammo yuqoriroq Sortino va pastroq maksimal drawdown ko‘rsatadi.
\(L=512\) kontekstida klassik LSTM daromadi +%12,58, Sortino’si 0,159; TCN daromadi +%7,20, biroq Sortino’si 0,209 deb hisobot qilingan.
Bu natija Bitcoin’da uzunroq kontekst avtomatik ravishda yaxshiroq emasligini ko‘rsatadi. Manbaga ko‘ra, o‘rta darajadagi xotira mutlaq daromad jihatidan, qisqa lokal xotira esa riskka moslashtirilgan barqarorlik jihatidan afzallik berishi mumkin.
Ethereum’da minLSTM Nega Ajralib Turadi?
ETHUSD \(L=1024\) natijalarida minLSTM yaqqol ajralib turadi:
| Model | Daromad | Max Drawdown | Sortino |
|---|---|---|---|
| LSTM | +%9,84 | −%4,72 | 0,109 |
| minGRU | −%5,11 | −%6,80 | −0,041 |
| minLSTM | +%16,43 | −%1,28 | 0,276 |
| TCN | −%15,67 | −%17,06 | −0,144 |
| Transformer | −%10,45 | −%10,50 | −0,146 |
| XGBoost | −%52,37 | −%52,40 | −0,288 |
Manba buni Ethereum’dagi uzoqroq muddatli momentum axborotini recurrent xotira ushlay olishi bilan bog‘laydi.
Biroq ketma-ketlik uzunligi natijasi monoton emas:
\[ L=256:\ +14,75\% \]
\[ L=512:\ +1,45\% \]
\[ L=1024:\ +16,43\%. \]
Shu sababli natijani “uzunroq ketma-ketlik har doim yaxshiroq” deb talqin qilib bo‘lmaydi. Muayyan kontekst uzunliklarining bozor rejimi bilan o‘zaro ta’siri muhim.
Solana Natijalari Model Chegaralari Haqida Nima Ko‘rsatadi?
SOLUSD’da \(L=1024\) uchun barcha modellar umumiy namunada zarar ko‘radi:
| Model | Daromad | Max Drawdown |
|---|---|---|
| LSTM | −%17,63 | −%17,75 |
| minGRU | −%13,05 | −%13,12 |
| minLSTM | −%8,83 | −%8,84 |
| TCN | −%8,59 | −%8,60 |
| Transformer | −%15,33 | −%15,34 |
| XGBoost | −%35,77 | −%35,77 |
Bu model taqqoslashining ehtimol eng muhim salbiy natijasidir. Yaxshi arxitektura tanlashning o‘zi kuchli alpha manbasini yaratmaydi. Juda yuqori volatillik va qalin dumlar sharoitida faqat mikrostruktura xususiyatlaridan iborat signal to‘plami yetarli bo‘lmasligi mumkin.
Manba kelajakda Level-2 order book, cross-exchange liquidity va qo‘shimcha risk-management qatlamlarini o‘rganishni shu sababli taklif qiladi.
Kalibrlash Nega Tasniflash Aniqligi Kabi Muhim?
Model “Bull ehtimoli %80” desa, bu prognozlarning taxminan %80’i haqiqatan ham Bull bo‘lishi kutiladi. Ushbu moslik probability calibration bilan o‘lchanadi.
| Model | ECE |
|---|---|
| minLSTM | 0,032 |
| minGRU | 0,041 |
| LSTM | 0,048 |
| TCN | 0,055 |
| Transformer | 0,067 |
| XGBoost | 0,089 |
Past ECE yaxshiroq kalibrlashni anglatadi. minLSTM ushbu o‘lchovda eng yaxshi natijani beradi.
8-sahifadagi threshold sezgirligi grafigi ETHUSD’da confidence threshold 0,30’dan 0,60’ga o‘zgartirilganda XGBoost daromadi taxminan −%80 bilan +%20 orasida juda keskin harakat qilishini ko‘rsatadi. minLSTM va LSTM esa silliqroq egri chiziqlar hosil qiladi.
Bu natija nafaqat prognoz sinfi, balki prognozga biriktirilgan ishonch qiymati ham iqtisodiy strategiya barqarorligini o‘zgartirishini ko‘rsatadi.
Eng Yomon Bitimlar Modellarning Xotira Xatti-harakatini Ko‘rsatadimi?
ETHUSD uchinchi walk-forward fold’da berilgan worst-trade natijalari:
| Model | Eng Katta Zarar | Davomiylik | Yo‘nalish |
|---|---|---|---|
| LSTM | −%14,57 | 99 bar | Short |
| minGRU | −%16,09 | 4 bar | Short |
| minLSTM | −%13,39 | 9 bar | Short |
| TCN | −%14,32 | 6 bar | Long |
| Transformer | −%12,82 | 10 bar | Short |
Manba LSTM’ning 99 bar davom etgan zararini “state persistence” muammosi sifatida talqin qiladi: model eski bozor holatini kerak bo‘lganidan uzoqroq saqlab turgan bo‘lishi mumkin.
Biroq jadvaldagi “Max Loss %” bilan umumiy strategiya jadvalidagi “Max Drawdown %” bir xil kattalik emas. Masalan, minLSTM uchun worst trade −%13,39 bo‘lsa, umumiy equity maximum drawdown −%1,28. Manba bu ikki foiz qaysi turli bazaga ko‘ra normallashtirilganini batafsil tushuntirmaydi; shu sababli ularni to‘g‘ridan-to‘g‘ri taqqoslamaslik kerak.
Bootstrap Natijalari Qanchalik Ishonchli?
Manba 1.000 bootstrap namunalashdan foydalanadi. XBTUSD’da LSTM, minLSTM, TCN va XGBoost Sharpe intervallari sezilarli darajada ustma-ust tushishi, shuning uchun riskka moslashtirilgan samaradorlik farqlari statistik jihatdan aniq ajralmasligi aytiladi.
ETHUSD \(L=1024\) uchun minLSTM Sharpe oralig‘i:
\[ [0,11,\ 0,28] \]
TCN oralig‘i:
\[ [-0,16,\ -0,04] \]
deb berilgan va intervallar ustma-ust tushmaydi.
Shunga qaramay, metod bo‘limida “%95 bootstrap ishonch oralig‘i” deyilishiga qaramay, quyi va yuqori chegaralar 5- va 95-persentillar ekani tushuntirilgan. Standart percentile-bootstrap terminologiyasida 5.–95. persentil markaziy %90 interval hosil qiladi; markaziy %95 interval uchun odatda 2,5.–97,5. persentillar ishlatiladi. Bu manbaning statistik hisobotidagi tuzatilishi kerak bo‘lgan nomuvofiqlikdir.
TCN Xotirasi 7 Bar Bo‘lsa, Nega U Shunchalik Yaxshi Ishlaydi?
Manba buni moliyaviy mikrostrukturaning kuchli locality xususiyati bilan izohlaydi. Juda qisqa muddatli order-flow imbalance va tick intensity o‘zgarishlari, ayniqsa yetuk va likvid bozorlarda, uzoq o‘tmishdan muhimroq bo‘lishi mumkin.
TCN receptive field taxminan 7 bardan 15 barga kengaytirilganda XBTUSD daromadi:
\[ +4,29\%\rightarrow+5,12\% \]
va ETHUSD:
\[ -15,67\%\rightarrow-12,01\% \]
ko‘rinishida o‘zgaradi.
Bu kengaytirish ma’lum darajada yaxshilanish bersa ham ETHUSD’ni ijobiy daromadga olib chiqmaydi. Manba TCN uzoq o‘tmishni adaptiv ravishda vaznlantira olmasligi momentum ustun bo‘lgan bozorlarda cheklovchi bo‘lishi mumkinligini ta’kidlaydi.
Tadqiqot Qo‘llab-quvvatlaydigan Asosiy Natijalar
- TCN ishlatilgan A100/PyTorch tajriba muhitida taqqoslangan neural sequence modellaridan tezroq o‘qitiladi.
- Transformer o‘qitish vaqti ketma-ketlik uzunligi oshgani sari boshqa modellardan ancha tez o‘sadi.
- minGRU va minLSTM hisoblash vaqti ketma-ketlik uzunligiga taxminan chiziqli miqyoslanadi.
- F1 balli bilan backtest daromadi o‘rtasida birma-bir bog‘lanish yo‘q.
- XBTUSD’da qisqa-lokal TCN yuqoriroq riskka moslashtirilgan barqarorlik ko‘rsatishi mumkin, LSTM/minLSTM esa yuqoriroq mutlaq daromad yaratishi mumkin.
- ETHUSD \(L=1024\) tajribasida minLSTM +%16,43 daromad va 0,276 Sortino bilan kuchli natija beradi.
- minLSTM 0,032 ECE bilan eng yaxshi ehtimol kalibrlanishini ta’minlaydi.
- SOLUSD’da \(L=1024\) sharoitida barcha modellar umumiy hisobda manfiy.
- Model samaradorligi aktiv, ketma-ketlik uzunligi va volatillik rejimiga bog‘liq.
- TCN receptive field’ini kengaytirish natijalarni biroz yaxshilasa ham model tartibini butunlay o‘zgartirmaydi.
Tadqiqot Qo‘llab-quvvatlamaydigan Natijalar
Tadqiqot minLSTM barcha kriptovalyuta bozorlarida eng yaxshi model ekanini ko‘rsatmaydi.
TCNning eng tez bo‘lishi eng foydali model ekanini anglatmaydi.
Transformerning ushbu tajribadagi sust natijasi barcha Transformer yoki attention asosidagi vaqt qatori modellari HFT uchun foydasiz ekanini isbotlamaydi; sinovdan o‘tkazilgan Transformer explicit positional encoding ishlatmaydi.
Backtest daromadlari real jonli savdo daromadlari emas. Exchange latency, order-book queue position, market impact va ishlatilgan haqiqiy fee/slippage parametrlari natijalarni o‘zgartirishi mumkin.
50 milliondan ortiq tick ishlatilgani model kelajakda ham foydali bo‘lishini kafolatlamaydi.
Dollar-bar namunalash moliyaviy ma’lumotlarni butunlay stationary yoki IID holatiga keltirishini isbotlamaydi; u faqat faoliyat intensivligidagi geterogenlikni kamaytirishni maqsad qiladi.
SOLUSD natijasi barcha altcoin bozorlarida chuqur o‘rganish ishlamasligini anglatmaydi.
Tadqiqot jonli birja infratuzilmasidagi nanosekund/mikrosekund order-routing samaradorligini o‘lchamaydi; u o‘qitish va backtest kontekstidagi yuqori chastotali ma’lumotlarni modellashtirishni o‘rganadi.
Manba va Usul Haqida Izoh
Asl sarlavha: Linear Recurrent versus Convolutional Neural Networks for High-Frequency Cryptocurrency Trading: Evidence from Dollar-Bar Data
Muallif: Ahoora Rostamian.
Muassasa: University of Essex.
Nashr turi: SSRN preprint; Elsevier’ga yuborilgan preprint shakli.
SSRN yuborilgan sana: 27 May 2026.
SSRN Abstract ID: 6839368.
DOI: 10.2139/ssrn.6839368.
Peer review: Manba aniq ravishda ekspert baholashidan o‘tmaganini bildiradi.
Mualliflik huquqi / litsenziya: SSRN qaydi “All rights reserved; no reuse allowed without permission” holatini ko‘rsatadi. Shu sababli manba shakl va jadvallari Verianla ichida qayta nashr qilinmagan.
Ma’lumot manbai: Kraken kriptovalyuta birjasi tick ma’lumotlari.
Aktivlar: XBTUSD, ETHUSD va SOLUSD.
Jami xom ma’lumot: Manba 50 milliondan ortiq tick bildiradi.
Dollar-bar chegarasi: 10.000 USD.
Taxminiy bar sonlari: XBTUSD 699.299; ETHUSD 450.100; SOLUSD 320.500.
Taqvim davri: PDF ma’lumot namunasining aniq boshlanish va tugash sanalarini ochiq bildirmaydi.
Modellar: LSTM, minGRU, minLSTM, TCN, Transformer va XGBoost.
Ketma-ketlik uzunliklari: 256, 512 va 1024.
Uskuna: Bitta NVIDIA A100-SXM4 GPU, 40 GB HBM2e.
Dasturiy ta’minot: PyTorch 2.1 va CUDA 12.1; minRNNlarda torch.compile reduce-overhead rejimi.
Validatsiya: Besh fold expanding-window walk-forward validation.
Backtest: 100.000 USD boshlang‘ich equity, 0,40 confidence threshold; long/short signallari.
Asosiy qayta ishlab chiqish cheklovlari: To‘rtinchi input feature aniqlanmagan; fee va slippage qiymatlari berilmagan; exact dataset sana oralig‘i ko‘rsatilmagan.
Statistik hisobot izohi: Manba %95 bootstrap CI iborasidan foydalansa-da 5.–95. persentillarni bildirganini aytadi; standart percentile talqinida bu markaziy %90 intervaldir.
Hisoblash izohi: Manba TCN Transformer’dan 15× tez ekanini aytadi; 2-jadvaldagi \(L=1024\) qiymatlari 19,78 son va 1,58 son bo‘lgani uchun bevosita nisbat taxminan 12,5×.
Transformer talqini: Sinovdan o‘tkazilgan baseline explicit positional encoding ishlatmagani sababli natijalar Transformer oilasining barcha variantlariga umumlashtirilmasligi kerak.
Moliyaviy talqin chegarasi: Hisobotdagi foizlar tadqiqotning walk-forward backtest natijalaridir; haqiqiy investitsiya daromadi, jonli HFT samaradorligi yoki kelajakdagi samaradorlik kafolati emas.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan