

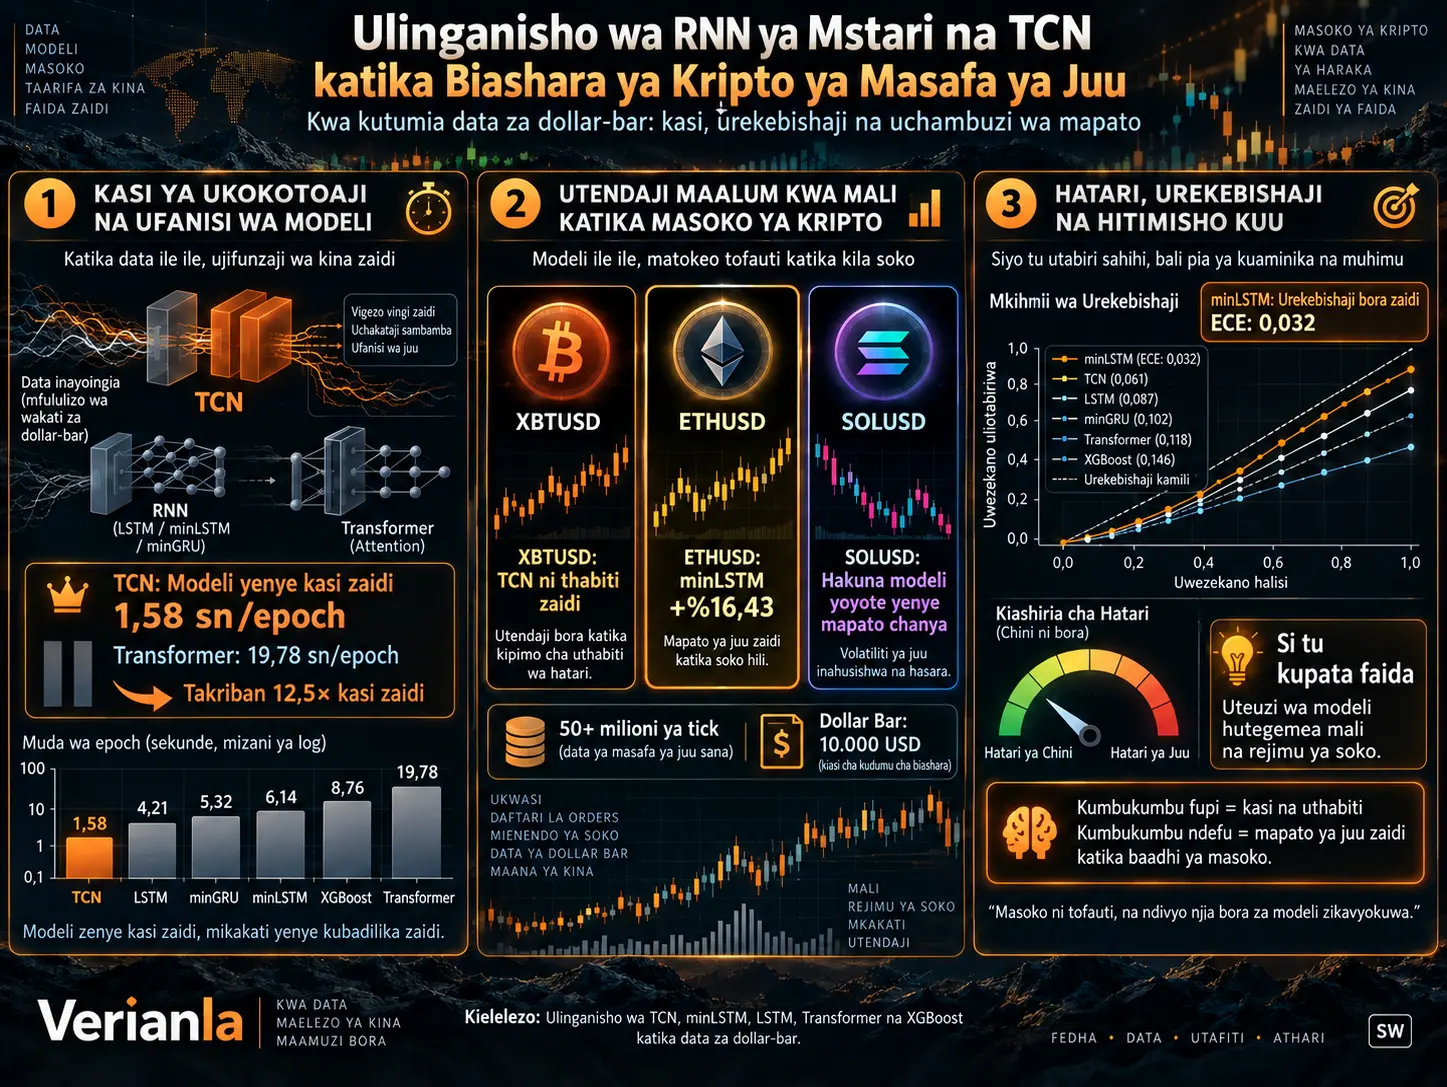
Katika data ya kifedha ya masafa ya juu, modeli imara haitakiwi tu kutoa utabiri sahihi; pia inapaswa kuwa na uwezo wa kuchakata kwa kasi ya kutosha mtiririko wenye mamilioni ya miamala, kusahau taarifa za zamani wakati hali ya soko inapobadilika, kutoa uwezekano uliokalibishwa vizuri na kuunda thamani ya kiuchumi baada ya kuzingatia gharama za miamala. Utafiti huu unajaribu vipengele tofauti vya tatizo hili ndani ya mpangilio mmoja wa majaribio kwa kulinganisha modeli za minGRU, minLSTM, LSTM ya kawaida, Temporal Convolutional Network (TCN), Transformer na XGBoost.
Majaribio yalifanywa kwa data za XBTUSD, ETHUSD na SOLUSD kutoka soko la kubadilishana sarafu za kidijitali la Kraken, zikijumuisha zaidi ya tick milioni 50. Badala ya vipindi vya muda vilivyowekwa, utafiti unatumia sampuli ya dollar-bar ambayo huunda uchunguzi mpya takribani kila thamani ya biashara inapofikia 10.000 USD. Lengo ni kupunguza hali ambapo vipindi vya soko vyenye shughuli nyingi sana na vile tulivu sana hubeba idadi tofauti kupita kiasi ya miamala ndani ya time bar moja.
Hitimisho kuu la utafiti ni kwamba hakuna usanifu mmoja wa modeli unaotawala katika masoko yote. TCN ndiyo modeli yenye kasi kubwa zaidi ya kukokotoa kwa tofauti iliyo wazi. Kwa urefu wa mfuatano wa \(L=1024\), epoch moja huchukua sekunde 1,58 kwa TCN, sekunde 4,90 kwa minLSTM, sekunde 4,00 kwa minGRU, sekunde 4,16 kwa LSTM ya kawaida na sekunde 19,78 kwa Transformer.
Matokeo ya kiuchumi, hata hivyo, hubadilika kulingana na mali. Kwa XBTUSD katika \(L=1024\), minLSTM hutoa mapato ya juu zaidi ya jumla kwa +%9,52, huku TCN ikionyesha wasifu thabiti zaidi wa hatari kwa uwiano wa Sortino wa 0,174 na maximum drawdown ya −%0,86. Kwa ETHUSD, minLSTM inaongoza wazi kwa mapato ya +%16,43 na Sortino ya 0,276. Kwa SOLUSD, hakuna modeli inayozalisha mapato chanya katika sampuli nzima.
Ujumbe mpana zaidi wa utafiti ni kwamba katika mfululizo wa muda wa kifedha, kauli kama “modeli kubwa zaidi”, “kumbukumbu ndefu zaidi” au “usanifu wa kisasa zaidi” hazitoi dhamana ya utendaji zenyewe. Upendeleo wa kiinduktivu wa modeli, ukomavu wa soko, hali ya volatility, urefu wa kumbukumbu unaohitajika na kalibresheni ya uwezekano wa utabiri vinapaswa kutathminiwa kwa pamoja.
Kwa nini data ya kifedha ya masafa ya juu ni tofauti?
Katika matatizo mengi ya sequence-learning, kama lugha ya asili, muktadha mrefu wa historia unaweza kubeba taarifa muhimu. Katika microstructure ya kifedha, hata hivyo, thamani ya taarifa ya zamani inaweza kupotea kwa kasi zaidi. Mtiririko wa maagizo, shinikizo la muda mfupi la kununua na kuuza, mabadiliko ya ukwasi na marejeo ya bei yanaweza kupoteza athari ndani ya miamala michache.
Kwa hiyo, tatizo kuu si tu “kukumbuka historia ndefu”. Modeli inapaswa kuchuja taarifa ambayo tayari imekuwa kelele na kuzoea haraka hali mpya ya soko.
LSTM ya kawaida hutumia miundo ya forget, input na output gate kwa madhumuni haya; lakini kwa sababu hatua za muda huchakatwa kwa mfululizo, uparaleli wa GPU huwa na kikomo. Transformer inaweza kuchakata mfuatano mzima kwa sambamba, lakini gharama ya kawaida ya self-attention hukua takribani kwa \(O(L^2)\) kulingana na urefu wa mfuatano.
Miundo ya linear recurrent kama minGRU na minLSTM inapendekeza suluhisho kati ya njia hizi mbili: recurrent state huhifadhiwa, utegemezi wa hidden-state huondolewa katika hesabu ya gate, na hesabu inaweza kubadilishwa kuwa parallel associative scan.
Kwa Nini minGRU na minLSTM Zinaweza Kuparalelishwa kwa Urahisi Zaidi?
Update gate katika GRU ya kawaida inaweza kuandikwa takribani kama:
\[ z_t=\sigma(W_zx_t+U_zh_{t-1}) \]
Hapa \(h_{t-1}\) inamaanisha kwamba thamani ya gate ya sasa haiwezi kukamilishwa kabla hidden state ya awali haijahesabiwa.
Katika mbinu ya minGRU, kipengele cha recurrent hidden-state huondolewa katika hesabu ya gate:
\[ z_t=\sigma(W_zx_t) \]
na hali mgombea huhesabiwa kama:
\[ \tilde{h}_t=g(W_hx_t) \]
Hali hii huhesabiwa kwa namna hiyo.
Sasisho huwa:
\[ h_t=(1-z_t)\odot h_{t-1}+z_t\odot\tilde{h}_t \]
Hivyo ndivyo sasisho linavyopatikana.
Muundo huu:
\[ h_t=a_th_{t-1}+b_t \]
hubadilika kuwa linear recurrence na kwa hiyo unaweza kuhesabiwa kwa sambamba kwa associative scan. Katika mfumo wa kinadharia wa chanzo, muundo huu una \(O(L)\) kwa jumla ya kazi ya hesabu na takribani \(O(\log L)\) kwa kina cha parallel reduction; wakati wa inference, inatosha kusasisha state ya sasa kwa uchunguzi mpya unaoingia.
TCN hutumia mbinu tofauti
Temporal Convolutional Network haitumii recurrent state; badala yake hutumia causal na dilated convolution. Katika jaribio kuu, ukubwa wa kernel ni \(k=3\) na thamani za dilation ni \(\{1,2\}\).
Effective receptive field:
\[ RF=1+\sum_i(k-1)d_i \]
hivyo TCN kuu inaweza kuona takribani historia ya 7 dollar-bar.
Katika toleo la tabaka tatu lenye dilation \(\{1,2,4\}\), receptive field ni takribani 15 bar.
Jambo hili ni muhimu: hata kama mfuatano wa kuingiza kwa TCN katika jaribio ni \(L=1024\), historia yenye athari kwa utabiri wa mwisho wa modeli si bar zote 1024. Inductive bias ya TCN kuu imelazimishwa hasa kujifunza mifumo ya ndani ya microstructure ya muda mfupi sana.
Sampuli ya Dollar-Bar ni Nini na Kwa Nini Inatumika?
Bar za kawaida za dakika 1 hufunika muda sawa katika kila kipande cha wakati, lakini hazifunikii kiwango sawa cha shughuli za kiuchumi. Ikiwa soko lina shughuli nyingi sana ndani ya dakika moja, maelfu ya miamala yanaweza kutokea; katika dakika tulivu, miamala inaweza kuwa michache sana.
Katika utafiti huu, badala yake kila bar mpya huundwa wakati thamani ya jumla ya miamala inapofikia kizingiti kilichowekwa:
\[ \sum_{i=k_{last}+1}^{k}p_iv_i\geq\theta \]
na
\[ \theta=10.000\ \text{USD}. \]
Kwa hiyo, kila dollar-bar hujaribu kuwakilisha takribani kiwango sawa cha shughuli za biashara kwa thamani ya dola.
| Mali | Idadi ya Dollar-Bar | Volatility ya Wastani kwa Siku | Kurtosis ya Mapato |
|---|---|---|---|
| XBTUSD | ≈699.299 | %2,1 | 4,2 |
| ETHUSD | ≈450.100 | %3,4 | 5,8 |
| SOLUSD | ≈320.500 | %5,8 | 12,1 |
Thamani ya kurtosis ya 12,1 kwa SOLUSD inaonyesha kwamba kati ya mali hizi tatu, tabia ya bei yenye mikia minene zaidi iko katika soko hili. XBTUSD ina kurtosis ya chini zaidi ya 4,2.
Lemma ya kinadharia ya chanzo inadai kwamba dollar bar hutuliza variance. Hata hivyo, mlinganyo unaonyesha kwamba kiasi kinachowekwa karibu sawa si ujazo wa kimwili wa coin, bali ni takribani thamani ya biashara kwa dola inayopimwa kama bei × ujazo. Kwa hiyo, kauli “ujazo ni uleule katika kila bar” inapaswa kutafsiriwa kitaalamu zaidi kama uthabiti wa dollar-notional.
Modeli Zinatumia Ingizo Gani?
Chanzo kinafafanua wazi ingizo tatu kama vipengele vya microstructure.
Log return:
\[ r_t=\ln\left(\frac{p_t}{p_{t-1}}\right) \]
Order Flow Imbalance:
\[ OFI_t= \frac{ V_t^{buy}-V_t^{sell} }{ V_t^{buy}+V_t^{sell}+\epsilon } \]
Tick intensity:
\[ \tau_t=\ln(1+\text{count}_t). \]
Vipengele vyote vimewekwa katikati kuzunguka median na kupimwa kwa RobustScaler kwa kutumia interquartile range ili kupunguza athari ya heavy-tail.
Hata hivyo, chanzo kinafafanua vekta ya ingizo kama \(x_t\in\mathbb{R}^{4}\), na tabaka la ingizo la Universal Model pia huprojekta ingizo lenye vipimo 4 hadi vipimo 256. Orodha ya vipengele, hata hivyo, inataja wazi vigezo vitatu tu. Kipengele cha nne hakijaelezwa katika PDF. Hili ni pengo muhimu kwa uwezo wa kurudia utafiti kikamilifu.
Ulinganisho wa Modeli Unafanywaje kwa Haki?
Modeli za deep learning zimewekwa katika mfumo wa pamoja wa Universal Model:
Ingizo → projection ya vipimo 256 → sequence encoder → layer normalization → kichwa cha uainishaji Bear / Neutral / Bull
Vigezo vingi vya modeli vimehifadhiwa takribani katika kiwango cha 200.000–500.000. Urefu wa mfuatano umebadilishwa kama:
\[ L\in\{256,512,1024\} \]
Urefu huo umebadilishwa kwa namna hii.
Modeli zinazolinganishwa ni:
- LSTM ya kawaida yenye tabaka mbili,
- minGRU,
- minLSTM,
- TCN yenye tabaka mbili na kumbukumbu fupi,
- Transformer yenye tabaka mbili na attention head nne,
- XGBoost yenye 100 estimator na kina cha juu 6.
XGBoost si sequence model na hutumiwa kama tabular baseline ambayo haiathiriwi moja kwa moja na mabadiliko ya \(L\).
Transformer hutumia causal mask lakini haitumii explicit positional encoding. Muundo huu wa majaribio ni muhimu hasa katika kutafsiri matokeo ya Transformer.
Kwa Nini Walk-Forward Validation ni Muhimu?
Katika mfululizo wa muda wa kifedha, mgawanyo wa train-test wa nasibu unaweza kusababisha uchunguzi wa siku za baadaye kuvuja kwenda katika kipindi cha nyuma. Utafiti unatumia expanding-window walk-forward validation ya fold tano.
Sehemu ya kwanza ya mafunzo ni %50 ya data. Baadaye, dirisha la mafunzo hupanuliwa na kipindi cha baadaye pekee ndicho kinachopimwa.
Muundo huu:
Fundisha kwa kipindi cha nyuma → pima kwa kipindi cha baadaye → panua dirisha la mafunzo → pima tena
hukadiria mpangilio wa muda wa kufundisha upya modeli katika matumizi ya wakati halisi.
Backtest inafanyaje kazi?
Mtaji wa mwanzo:
\[ 100.000\ \text{USD} \]
umefafanuliwa.
Uwezekano wa juu zaidi wa darasa la modeli:
\[ \tau=0,40 \]
ukizidi kizingiti hiki, nafasi ya short au long hufunguliwa kulingana na darasa la Bear au Bull. Nafasi hufungwa ishara inapogeuka.
Algoriti pia inajumuisha fee na slippage. Hata hivyo, PDF haitaji thamani za nambari zilizotumiwa kwa vigezo hivi viwili. Kwa kuwa idadi ya miamala inayozalishwa na modeli hutofautiana sana, pengo hili linaweza kuathiri moja kwa moja uwezo wa kurudia net PnL.
Mbinu na Matokeo ya Utafiti
Muda wa kukokotoa: kwa nini TCN inaongoza?
| Modeli | L=256 | L=512 | L=1024 |
|---|---|---|---|
| Transformer | 4,02 sek | 8,70 sek | 19,78 sek |
| minLSTM | 1,46 sek | 2,63 sek | 4,90 sek |
| minGRU | 1,29 sek | 2,21 sek | 4,00 sek |
| LSTM | 1,39 sek | 2,26 sek | 4,16 sek |
| TCN | 0,62 sek | 0,98 sek | 1,58 sek |
TCN ina muda wa chini zaidi wa epoch katika urefu wote wa mfuatano.
Kwa \(L=1024\), TCN ni takribani:
\[ \frac{4,90}{1,58}\approx3,1 \]
mara haraka kuliko minLSTM.
Kwa kulinganisha na Transformer:
\[ \frac{19,78}{1,58}\approx12,5 \]
mara.
Kwa hiyo, kauli “15× faster than Transformers” katika abstract na sehemu ya hitimisho ya chanzo haipatani kikamilifu na uwiano wa takribani 12,5× unaopatikana moja kwa moja kutoka thamani za Jedwali 2.
Je, Usahihi wa Utabiri na Mapato ya Kifedha ni Kitu Kimoja?
Hapana. Mojawapo ya matokeo muhimu ya utafiti ni kwamba alama ya macro F1 haina uhusiano wa mstari wa moja kwa moja na mapato ya kiuchumi.
| Modeli | XBTUSD F1 | ETHUSD F1 | SOLUSD F1 |
|---|---|---|---|
| LSTM | 0,372 | 0,392 | 0,350 |
| minGRU | 0,391 | 0,430 | 0,354 |
| minLSTM | 0,377 | 0,434 | 0,364 |
| TCN | 0,377 | 0,414 | 0,350 |
| Transformer | 0,357 | 0,403 | 0,319 |
| XGBoost | 0,363 | 0,380 | 0,360 |
Ukweli kwamba thamani zote za F1 ziko takribani katika kiwango cha 0,30–0,43 unaonyesha uwiano mdogo wa signal-to-noise katika data ya kripto ya masafa ya juu.
Hata hivyo, tofauti ya pointi chache katika uainishaji haitafsiriki moja kwa moja kuwa tofauti sawa ya utendaji wa kifedha. Matokeo ya kiuchumi ya mkakati pia hutegemea kipindi gani cha soko ishara ilikuwa sahihi, ukubwa wa utabiri usio sahihi, muda wa kushikilia nafasi, kalibresheni ya uwezekano na mara ngapi miamala hufanyika.
Ni Tabia Gani ya Modeli Inayoonekana Katika Bitcoin?
Matokeo ya XBTUSD kwa \(L=1024\):
| Modeli | Mapato ya Jumla | Max Drawdown | Sortino | Idadi ya Miamala |
|---|---|---|---|---|
| LSTM | +%9,09 | −%1,08 | 0,135 | 642 |
| minGRU | +%4,11 | −%1,39 | 0,097 | 414 |
| minLSTM | +%9,52 | −%1,72 | 0,152 | 481 |
| TCN | +%4,29 | −%0,86 | 0,174 | 594 |
| Transformer | +%4,99 | −%1,42 | 0,144 | 830 |
| XGBoost | +%8,71 | −%1,29 | 0,125 | 2012 |
Kwa mapato ya jumla, minLSTM na LSTM zinaongoza, huku TCN ikiwa na mapato ya chini zaidi lakini Sortino ya juu zaidi na maximum drawdown ya chini zaidi.
Katika muktadha wa \(L=512\), mapato ya LSTM ya kawaida yameripotiwa kuwa +%12,58 na Sortino 0,159; TCN ina mapato +%7,20 lakini Sortino yake ni 0,209.
Matokeo haya yanaonyesha kwamba katika Bitcoin, muktadha mrefu zaidi si bora moja kwa moja. Kwa mujibu wa chanzo, kumbukumbu ya kati inaweza kuwa na faida kwa mapato ya jumla, huku kumbukumbu fupi ya ndani ikitoa faida kwa uthabiti uliorekebishwa kwa hatari.
Kwa Nini minLSTM Inaongoza Katika Ethereum?
Katika matokeo ya ETHUSD kwa \(L=1024\), minLSTM inajitenga wazi:
| Modeli | Mapato | Max Drawdown | Sortino |
|---|---|---|---|
| LSTM | +%9,84 | −%4,72 | 0,109 |
| minGRU | −%5,11 | −%6,80 | −0,041 |
| minLSTM | +%16,43 | −%1,28 | 0,276 |
| TCN | −%15,67 | −%17,06 | −0,144 |
| Transformer | −%10,45 | −%10,50 | −0,146 |
| XGBoost | −%52,37 | −%52,40 | −0,288 |
Chanzo kinahusisha hili na uwezo wa recurrent memory kunasa taarifa ya momentum ya muda mrefu zaidi katika Ethereum.
Hata hivyo, matokeo ya urefu wa mfuatano si ya kuongezeka kwa mpangilio mmoja:
\[ L=256:\ +14,75\% \]
\[ L=512:\ +1,45\% \]
\[ L=1024:\ +16,43\%. \]
Kwa hiyo, matokeo hayawezi kutafsiriwa kama “mfuatano mrefu zaidi ni bora kila wakati”. Mwingiliano wa urefu maalum wa muktadha na hali ya soko ni muhimu.
Matokeo ya Solana Yanaonyesha Nini Kuhusu Mipaka ya Modeli?
Katika SOLUSD kwa \(L=1024\), modeli zote zina hasara katika sampuli nzima:
| Modeli | Mapato | Max Drawdown |
|---|---|---|
| LSTM | −%17,63 | −%17,75 |
| minGRU | −%13,05 | −%13,12 |
| minLSTM | −%8,83 | −%8,84 |
| TCN | −%8,59 | −%8,60 |
| Transformer | −%15,33 | −%15,34 |
| XGBoost | −%35,77 | −%35,77 |
Hili huenda ndilo hitimisho hasi muhimu zaidi katika ulinganisho wa modeli. Kuchagua usanifu mzuri peke yake hakutengenezi chanzo chenye nguvu cha alpha. Chini ya volatility ya juu sana na mikia minene, seti ya ishara inayotumia vipengele vya microstructure pekee inaweza kutotosha.
Kwa sababu hii, chanzo kinapendekeza tafiti za baadaye kuhusu Level-2 order book, cross-exchange liquidity na tabaka za ziada za risk-management.
Kwa Nini Kalibresheni ni Muhimu Kama Usahihi wa Uainishaji?
Ikiwa modeli inasema “uwezekano wa Bull ni %80”, inatarajiwa kwamba takribani %80 ya utabiri huo kweli uwe Bull. Ulinganifu huu hupimwa kwa probability calibration.
| Modeli | ECE |
|---|---|
| minLSTM | 0,032 |
| minGRU | 0,041 |
| LSTM | 0,048 |
| TCN | 0,055 |
| Transformer | 0,067 |
| XGBoost | 0,089 |
ECE ya chini inawakilisha kalibresheni bora. minLSTM inatoa matokeo bora zaidi kwa kipimo hiki.
Grafu ya unyeti wa threshold katika ukurasa wa 8 inaonyesha kuwa wakati confidence threshold inabadilishwa kutoka 0,30 hadi 0,60 katika ETHUSD, mapato ya XGBoost hubadilika kwa nguvu sana kutoka takribani −%80 hadi +%20. minLSTM na LSTM hutengeneza mikunjo iliyo laini zaidi.
Matokeo haya yanaonyesha kwamba si darasa la utabiri pekee bali pia kiwango cha kujiamini kinachopewa utabiri kinaweza kubadilisha uthabiti wa mkakati wa kiuchumi.
Je, Miamala Mbaya Zaidi Inaonyesha Tabia ya Kumbukumbu ya Modeli?
Matokeo ya worst-trade yaliyoripotiwa katika fold ya tatu ya walk-forward ya ETHUSD:
| Modeli | Hasara Kubwa Zaidi | Muda | Mwelekeo |
|---|---|---|---|
| LSTM | −%14,57 | 99 bar | Short |
| minGRU | −%16,09 | 4 bar | Short |
| minLSTM | −%13,39 | 9 bar | Short |
| TCN | −%14,32 | 6 bar | Long |
| Transformer | −%12,82 | 10 bar | Short |
Chanzo kinatafsiri hasara ya LSTM iliyodumu 99 bar kama tatizo la “state persistence”: huenda modeli ilibeba hali ya zamani ya soko kwa muda mrefu kuliko ilivyohitajika.
Hata hivyo, “Max Loss %” katika jedwali hili si kipimo sawa na “Max Drawdown %” katika jedwali la mkakati mzima. Kwa mfano, worst trade ya minLSTM ni −%13,39, wakati maximum drawdown ya equity nzima ni −%1,28. Chanzo hakielezi kwa kina misingi tofauti inayotumiwa kusawazisha asilimia hizi mbili; kwa hiyo hazipaswi kulinganishwa moja kwa moja.
Matokeo ya Bootstrap Yanaaminika kwa Kiasi Gani?
Chanzo kinatumia sampuli 1.000 za bootstrap. Kwa XBTUSD, inaelezwa kuwa vipindi vya Sharpe vya LSTM, minLSTM, TCN na XGBoost vinaingiliana kwa kiasi kikubwa, hivyo tofauti za utendaji uliorekebishwa kwa hatari hazitengani wazi kwa msingi wa takwimu.
Kwa ETHUSD \(L=1024\), kipindi cha Sharpe cha minLSTM:
\[ [0,11,\ 0,28] \]
na kipindi cha TCN:
\[ [-0,16,\ -0,04] \]
vimeripotiwa, na vipindi hivi haviingiliani.
Hata hivyo, ingawa sehemu ya mbinu inatumia kauli “%95 bootstrap confidence interval”, inaeleza kwamba mipaka ya chini na juu ni percentile ya 5 na 95. Katika istilahi ya kawaida ya percentile-bootstrap, percentile ya 5.–95. huunda kipindi cha kati cha %90; kwa kipindi cha kati cha %95, kawaida percentile ya 2,5.–97,5. hutumika. Huu ni ukinzani katika taarifa ya takwimu ya chanzo unaohitaji kurekebishwa.
Ikiwa Kumbukumbu ya TCN ni Bar 7, Kwa Nini Inaweza Kufanya Vizuri Sana?
Chanzo kinaeleza hili kwa locality yenye nguvu katika microstructure ya kifedha. Mabadiliko ya muda mfupi sana ya order-flow imbalance na tick intensity, hasa katika masoko yaliyopevuka na yenye ukwasi, yanaweza kuwa muhimu zaidi kuliko historia ya mbali.
Receptive field ya TCN inapopanuliwa kutoka takribani bar 7 hadi bar 15, mapato ya XBTUSD hubadilika kutoka:
\[ +4,29\%\rightarrow+5,12\% \]
na ETHUSD:
\[ -15,67\%\rightarrow-12,01\% \]
Hivyo ndivyo matokeo yanavyobadilika.
Hata ingawa upanuzi huu hutoa uboreshaji fulani, hauleti ETHUSD kwenye mapato chanya. Chanzo kinahoji kwamba kutoweza kwa TCN kuweka uzito kwa historia ya mbali kwa njia ya kubadilika kunaweza kuwa kikwazo katika masoko yanayotawaliwa na momentum.
Matokeo Makuu Yanayoungwa Mkono na Utafiti
- TCN hufundishwa kwa kasi zaidi kuliko neural sequence model zinazolinganishwa katika mazingira ya majaribio ya A100/PyTorch yaliyotumiwa.
- Muda wa mafunzo wa Transformer hukua kwa kasi zaidi kuliko wa modeli nyingine kadiri urefu wa mfuatano unavyoongezeka.
- Muda wa kukokotoa wa minGRU na minLSTM huongezeka takribani kwa mstari kulingana na urefu wa mfuatano.
- Hakuna uhusiano wa moja kwa moja wa moja kwa moja kati ya alama ya F1 na mapato ya backtest.
- Kwa XBTUSD, TCN yenye muktadha mfupi wa ndani inaweza kuonyesha uthabiti bora uliorekebishwa kwa hatari, huku LSTM/minLSTM zikiweza kutoa mapato ya juu zaidi ya jumla.
- Katika jaribio la ETHUSD \(L=1024\), minLSTM hutoa matokeo yenye nguvu kwa mapato ya +%16,43 na Sortino ya 0,276.
- minLSTM inatoa kalibresheni bora zaidi ya uwezekano kwa ECE ya 0,032.
- Kwa SOLUSD katika \(L=1024\), modeli zote zina matokeo hasi kwa jumla.
- Utendaji wa modeli hutegemea mali, urefu wa mfuatano na hali ya volatility.
- Kupanua receptive field ya TCN huboresha matokeo kwa kiasi fulani lakini hakubadilishi kabisa mpangilio wa modeli.
Matokeo Ambayo Utafiti Hauungi Mkono
Utafiti hauonyeshi kwamba minLSTM ndiyo modeli bora zaidi katika masoko yote ya sarafu za kidijitali.
Kuwa kwa TCN ndiyo ya haraka zaidi hakumaanishi ndiyo modeli yenye faida kubwa zaidi.
Utendaji dhaifu wa Transformer katika jaribio hili hauonyeshi kwamba modeli zote za Transformer au attention-based time series hazifai kwa HFT; Transformer iliyojaribiwa haitumii explicit positional encoding.
Mapato ya backtest si mapato halisi ya biashara ya moja kwa moja. Exchange latency, order-book queue position, market impact na vigezo halisi vya fee/slippage vinaweza kubadilisha matokeo.
Matumizi ya zaidi ya tick milioni 50 hayatoi dhamana kwamba modeli itakuwa yenye faida pia katika siku zijazo.
Sampuli ya dollar-bar haithibitishi kuwa data ya kifedha inakuwa stationary au IID kikamilifu; inalenga tu kupunguza heterogeneity katika kiwango cha shughuli.
Matokeo ya SOLUSD hayamaanishi kwamba deep learning haitafanya kazi katika masoko yote ya altcoin.
Utafiti haupimi utendaji wa order-routing wa nanosecond/microsecond katika miundombinu halisi ya soko la kubadilishana; unachunguza uundaji wa modeli za data ya masafa ya juu katika muktadha wa mafunzo na backtest.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Linear Recurrent versus Convolutional Neural Networks for High-Frequency Cryptocurrency Trading: Evidence from Dollar-Bar Data
Mwandishi: Ahoora Rostamian.
Taasisi: University of Essex.
Aina ya uchapishaji: SSRN preprint; preprint iliyowasilishwa kwa Elsevier.
Tarehe ya kuwasilishwa SSRN: 27 May 2026.
SSRN Abstract ID: 6839368.
DOI: 10.2139/ssrn.6839368.
Hali ya peer review: Chanzo kinaeleza wazi kwamba hakijapitia mapitio ya wenzao.
Hakimiliki / leseni: Rekodi ya SSRN inaonyesha hali “All rights reserved; no reuse allowed without permission”. Kwa hiyo, michoro na majedwali ya chanzo hayajachapishwa tena ndani ya Verianla.
Chanzo cha data: Data ya tick kutoka soko la kubadilishana sarafu za kidijitali la Kraken.
Mali: XBTUSD, ETHUSD na SOLUSD.
Jumla ya data ghafi: Chanzo kinaripoti zaidi ya tick milioni 50.
Kizingiti cha dollar-bar: 10.000 USD.
Takribani idadi ya bar: XBTUSD 699.299; ETHUSD 450.100; SOLUSD 320.500.
Kipindi cha kalenda: PDF haitaji kwa uwazi tarehe kamili ya kuanza na kumalizika kwa sampuli ya data.
Modeli: LSTM, minGRU, minLSTM, TCN, Transformer na XGBoost.
Urefu wa mfuatano: 256, 512 na 1024.
Vifaa: NVIDIA A100-SXM4 GPU moja, 40 GB HBM2e.
Programu: PyTorch 2.1 na CUDA 12.1; modi ya torch.compile reduce-overhead katika minRNN.
Uthibitishaji: Five-fold expanding-window walk-forward validation.
Backtest: 100.000 USD ya equity ya mwanzo, confidence threshold ya 0,40; ishara za long/short.
Vikwazo vikuu vya kurudia matokeo: Kipengele cha nne cha input hakijafafanuliwa; thamani za fee na slippage hazijatolewa; exact dataset date range haijatajwa.
Dokezo la taarifa ya takwimu: Chanzo kinatumia kauli %95 bootstrap CI lakini kinasema kwamba kinaripoti percentile ya 5.–95.; chini ya tafsiri ya kawaida ya percentile, hii ni interval ya kati ya %90.
Dokezo la hesabu: Chanzo kinasema TCN ni 15× haraka kuliko Transformer; kwa kuwa thamani za \(L=1024\) katika Jedwali 2 ni sekunde 19,78 na sekunde 1,58, uwiano wa moja kwa moja ni takribani 12,5×.
Tafsiri ya Transformer: Kwa kuwa baseline iliyojaribiwa haitumii explicit positional encoding, matokeo hayapaswi kujumlishwa kwa aina zote za familia ya Transformer.
Kikomo cha tafsiri ya kifedha: Asilimia zilizoripotiwa ni matokeo ya walk-forward backtest ya utafiti; si mapato halisi ya uwekezaji, utendaji halisi wa HFT au dhamana ya utendaji wa siku zijazo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *