

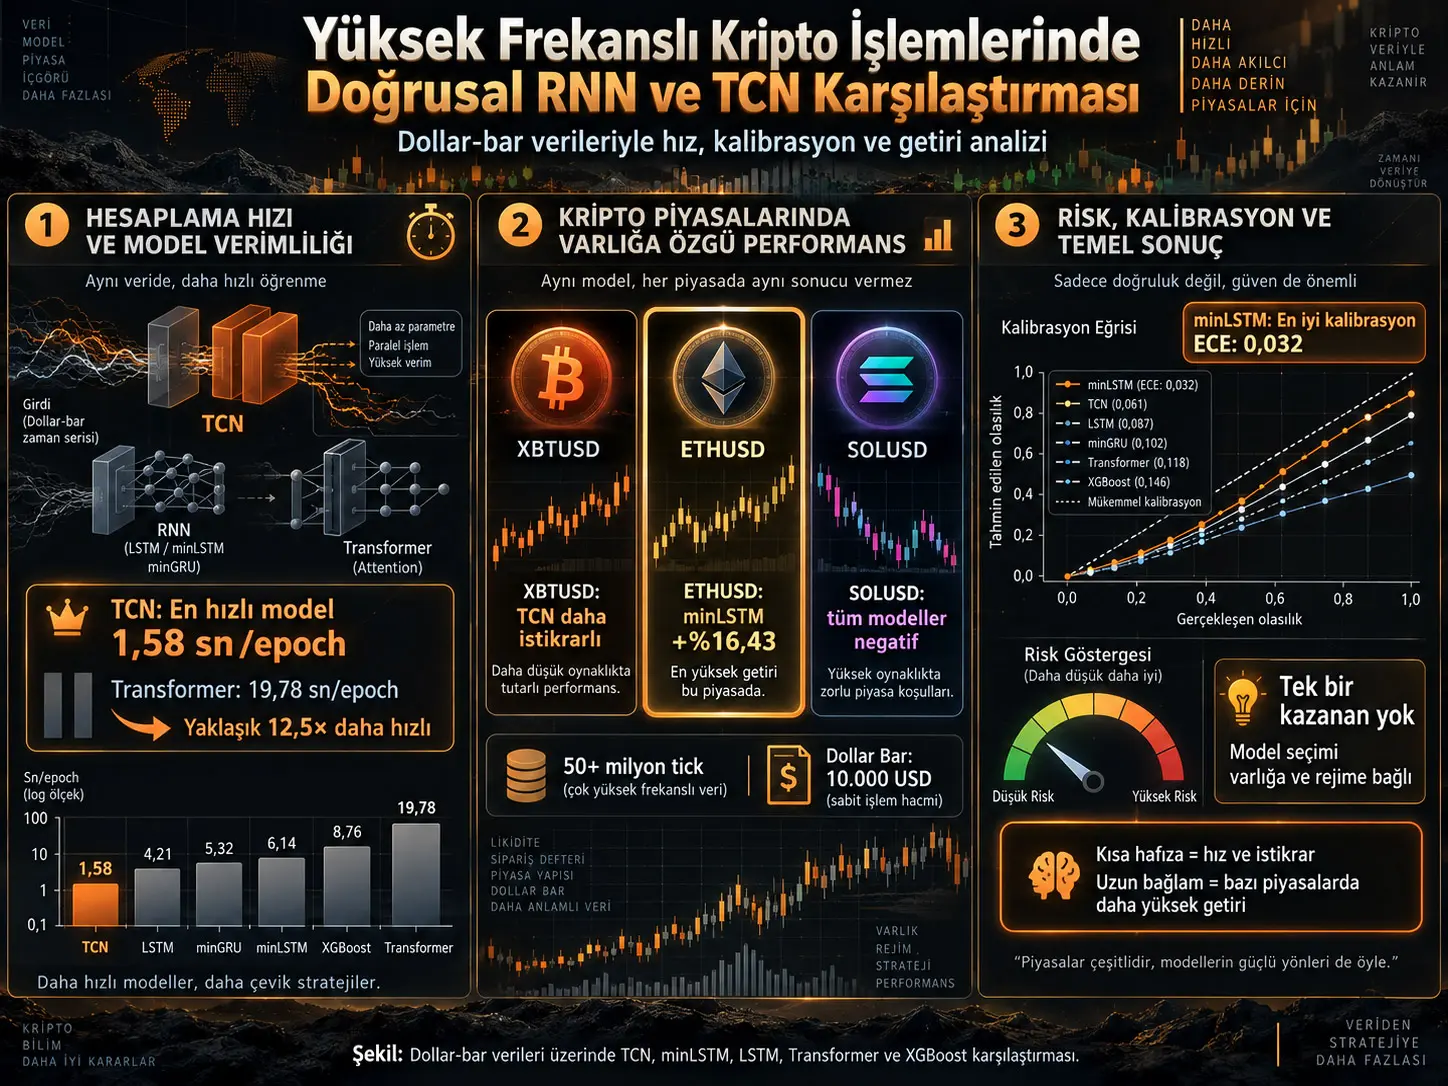
Yüksek frekanslı finansal veride güçlü bir model yalnız doğru tahmin yapmak zorunda değildir; aynı zamanda milyonlarca işlemden oluşan akışı yeterince hızlı işleyebilmeli, piyasa rejimi değiştiğinde eski bilgiyi unutabilmeli, ürettiği olasılıklar iyi kalibre edilmiş olmalı ve işlem maliyetleri altında ekonomik değer yaratabilmelidir. Bu çalışma, bu problemin farklı yönlerini aynı deney düzeninde test ederek minGRU, minLSTM, klasik LSTM, Temporal Convolutional Network (TCN), Transformer ve XGBoost modellerini karşılaştırmaktadır.
Deneyler Kraken kripto para borsasından elde edilen 50 milyondan fazla tick'i kapsayan XBTUSD, ETHUSD ve SOLUSD verileri üzerinde gerçekleştirilmiştir. Sabit zaman aralıkları yerine yaklaşık 10.000 USD işlem değerine ulaşıldığında yeni gözlem oluşturan dollar-bar örneklemesi kullanılmaktadır. Böylece çok yoğun ve çok sakin piyasa dönemlerinin aynı zaman barında aşırı farklı miktarda işlem taşıması azaltılmaya çalışılmaktadır.
Çalışmanın temel sonucu tek bir model mimarisinin bütün piyasalarda üstün olmamasıdır. TCN hesaplama açısından açık ara en hızlı modeldir. \(L=1024\) sekans uzunluğunda bir epoch TCN için 1,58 saniye, minLSTM için 4,90 saniye, minGRU için 4,00 saniye, klasik LSTM için 4,16 saniye ve Transformer için 19,78 saniyedir.
Ekonomik sonuçlar ise varlığa göre tersine dönmektedir. XBTUSD'de \(L=1024\) için minLSTM +%9,52 ile en yüksek mutlak getiriyi üretirken TCN 0,174 Sortino oranı ve −%0,86 maksimum drawdown ile daha istikrarlı risk profili göstermektedir. ETHUSD'de minLSTM +%16,43 getiri ve 0,276 Sortino ile açık biçimde öne çıkmaktadır. SOLUSD'de ise hiçbir model toplam örneklemde pozitif getiri üretememektedir.
Çalışmanın daha genel mesajı, finansal zaman serilerinde “daha büyük model”, “daha uzun hafıza” veya “daha modern mimari” ifadelerinin tek başına performans garantisi oluşturmadığıdır. Modelin endüktif önyargısı, piyasanın olgunluğu, volatilite rejimi, gerekli hafıza uzunluğu ve tahmin olasılıklarının kalibrasyonu birlikte değerlendirilmelidir.
Yüksek frekanslı finansal veri neden farklıdır?
Doğal dil gibi birçok sequence-learning probleminde uzun geçmiş bağlamı önemli bilgi taşıyabilir. Finansal mikro-yapıda ise eski bilginin değeri çok daha hızlı kaybolabilir. Emir akışı, kısa vadeli alım-satım baskısı, likidite değişimleri ve fiyat tersine dönüşleri birkaç işlem içinde etkisini yitirebilir.
Bu nedenle temel problem yalnız “uzun geçmişi hatırlamak” değildir. Modelin hangi bilginin artık gürültü olduğunu ayıklaması ve yeni piyasa rejimine hızlı uyum sağlaması gerekir.
Klasik LSTM bu amaçla forget, input ve output gate yapıları kullanır; ancak zaman adımları ardışık işlendiği için GPU paralelleştirmesi sınırlanır. Transformer bütün sekansı paralel işleyebilir ancak standart self-attention hesaplama maliyeti sekans uzunluğuna göre yaklaşık \(O(L^2)\) büyür.
minGRU ve minLSTM gibi doğrusal yinelemeli mimariler bu ikisinin arasında bir çözüm önermektedir: recurrent state korunurken hidden-state bağımlılığı gate hesabından çıkarılır ve hesap parallel associative scan biçimine dönüştürülebilir.
minGRU ve minLSTM Neden Daha Kolay Paralelleştirilebiliyor?
Standart GRU'daki update gate yaklaşık olarak:
\[ z_t=\sigma(W_zx_t+U_zh_{t-1}) \]
şeklindedir. Buradaki \(h_{t-1}\), önceki hidden state hesaplanmadan mevcut gate değerinin tamamlanamaması anlamına gelir.
minGRU yaklaşımında recurrent hidden-state terimi gate hesabından çıkarılır:
\[ z_t=\sigma(W_zx_t) \]
ve aday durum:
\[ \tilde{h}_t=g(W_hx_t) \]
biçiminde hesaplanır.
Güncelleme:
\[ h_t=(1-z_t)\odot h_{t-1}+z_t\odot\tilde{h}_t \]
olur.
Bu yapı:
\[ h_t=a_th_{t-1}+b_t \]
şeklindeki doğrusal recurrence biçimine dönüştüğü için associative scan ile paralel hesaplanabilir. Kaynağın teorik çerçevesinde bu yapı toplam hesaplama işi açısından \(O(L)\), paralel reduction derinliği açısından ise yaklaşık \(O(\log L)\) özelliğine sahiptir ve inference sırasında gelen yeni gözlem için yalnız mevcut state'in güncellenmesi yeterlidir.
TCN farklı bir yaklaşım kullanıyor
Temporal Convolutional Network ise recurrent state kullanmak yerine causal ve dilated convolution uygular. Ana deneyde kernel büyüklüğü \(k=3\) ve dilation değerleri \(\{1,2\}\)'dir.
Effective receptive field:
\[ RF=1+\sum_i(k-1)d_i \]
olduğundan ana TCN yaklaşık 7 dollar-bar geçmişi görebilmektedir.
Üç katmanlı \(\{1,2,4\}\) dilation varyantında receptive field yaklaşık 15 bar olmaktadır.
Bu nokta önemlidir: deneyde TCN için giriş sekansı \(L=1024\) olsa bile modelin son tahmininin etkin geçmişi bütün 1024 bar değildir. Ana TCN'nin inductive bias'ı özellikle çok kısa yerel mikro-yapı örüntülerini öğrenmeye zorlanmıştır.
Dollar-Bar Örnekleme Nedir ve Neden Kullanılıyor?
Standart 1 dakikalık barlar her zaman diliminde aynı süreyi kapsar fakat aynı miktarda ekonomik aktiviteyi kapsamaz. Bir dakika içinde piyasa son derece hareketliyse binlerce işlem gerçekleşebilir; sakin bir dakikada ise çok az işlem olabilir.
Çalışmada bunun yerine her yeni bar, toplam işlem değeri belirlenen eşiğe ulaştığında oluşturulmaktadır:
\[ \sum_{i=k_{last}+1}^{k}p_iv_i\geq\theta \]
ve
\[ \theta=10.000\ \text{USD}. \]
Dolayısıyla her dollar-bar yaklaşık aynı dolar cinsinden ekonomik işlem aktivitesini temsil etmeye çalışır.
| Varlık | Dollar-Bar Sayısı | Ortalama Günlük Volatilite | Getiri Kurtosis |
|---|---|---|---|
| XBTUSD | ≈699.299 | %2,1 | 4,2 |
| ETHUSD | ≈450.100 | %3,4 | 5,8 |
| SOLUSD | ≈320.500 | %5,8 | 12,1 |
SOLUSD'nin 12,1 kurtosis değeri, üç varlık arasında en kalın kuyruklu fiyat davranışının bu piyasada bulunduğunu göstermektedir. XBTUSD ise 4,2 ile daha düşük bir kurtosis değerine sahiptir.
Kaynağın teorik lemma'sı dollar barların varyansı stabilize ettiğini savunmaktadır. Bununla birlikte denklem sabitlenen büyüklüğün fiziksel coin hacmi değil, fiyat × hacim ile ölçülen yaklaşık dolar işlem değeri olduğunu göstermektedir. Dolayısıyla “her barda hacim sabittir” ifadesi teknik olarak dollar-notional sabitliğine daha yakın okunmalıdır.
Modeller Hangi Girdileri Kullanıyor?
Kaynak mikro-yapı özellikleri olarak açıkça üç girdiyi tanımlamaktadır.
Log getiri:
\[ r_t=\ln\left(\frac{p_t}{p_{t-1}}\right) \]
Order Flow Imbalance:
\[ OFI_t= \frac{ V_t^{buy}-V_t^{sell} }{ V_t^{buy}+V_t^{sell}+\epsilon } \]
Tick intensity:
\[ \tau_t=\ln(1+\text{count}_t). \]
Bütün özellikler heavy-tail etkisini azaltmak için medyan etrafında merkezlenmiş ve interquartile range kullanılarak RobustScaler ile ölçeklendirilmiştir.
Bununla birlikte kaynak giriş vektörünü \(x_t\in\mathbb{R}^{4}\) olarak tanımlamaktadır ve Universal Model giriş katmanı da 4 boyutlu girdiyi 256 boyuta projekte etmektedir. Özellik listesinde ise yalnız üç değişken açık biçimde verilmiştir. Dördüncü özelliğin ne olduğu PDF'de belirtilmemektedir. Bu, çalışmanın tam olarak yeniden üretilmesi açısından önemli bir eksikliktir.
Model Karşılaştırması Nasıl Adil Hale Getiriliyor?
Derin modeller ortak bir Universal Model çerçevesine yerleştirilmiştir:
Girdi → 256 boyutlu projection → sequence encoder → layer normalization → Bear / Neutral / Bull sınıflandırma başlığı
Model parametrelerinin çoğu yaklaşık 200.000–500.000 aralığında tutulmuştur. Sekans uzunluğu:
\[ L\in\{256,512,1024\} \]
olarak değiştirilmiştir.
Karşılaştırılan modeller:
- iki katmanlı klasik LSTM,
- minGRU,
- minLSTM,
- iki katmanlı kısa-hafızalı TCN,
- iki katmanlı ve dört attention head'li Transformer,
- 100 estimator ve maksimum derinlik 6 kullanan XGBoost'tur.
XGBoost sequence modeli değildir ve \(L\) değişiminden doğrudan etkilenmeyen tabular baseline olarak kullanılmıştır.
Transformer ise causal mask kullanmakta fakat explicit positional encoding kullanmamaktadır. Bu deney tasarımı Transformer sonuçlarının yorumunda özellikle önemlidir.
Walk-Forward Doğrulama Neden Önemli?
Finansal zaman serilerinde rastgele train-test bölme gelecekteki gözlemlerin geçmişe sızmasına yol açabilir. Çalışmada beş katlı expanding-window walk-forward validation kullanılmaktadır.
İlk eğitim bölümü verinin %50'sidir. Daha sonra eğitim penceresi genişletilir ve yalnız daha sonraki dönem test edilir.
Bu yapı:
Geçmişte eğit → gelecekte test et → eğitim penceresini genişlet → tekrar test et
mantığıyla gerçek zamanlı model yeniden eğitiminin zaman sırasını yaklaşıklar.
Backtest nasıl çalışıyor?
Başlangıç sermayesi:
\[ 100.000\ \text{USD} \]
olarak tanımlanmıştır.
Modelin en yüksek sınıf olasılığı:
\[ \tau=0,40 \]
eşiğini aşarsa Bear veya Bull sınıfına göre short ya da long pozisyon açılmaktadır. Sinyal tersine döndüğünde pozisyon kapatılır.
Algoritma fee ve slippage terimlerini de içerir. Ancak PDF, bu iki parametrenin kullanılan sayısal değerlerini belirtmemektedir. Modellerin ürettiği işlem sayıları önemli ölçüde farklı olduğundan bu eksiklik net PnL'nin yeniden üretilebilirliğini doğrudan etkileyebilir.
Çalışmanın Yöntemi ve Bulguları
Hesaplama süresi: TCN neden öne çıkıyor?
| Model | L=256 | L=512 | L=1024 |
|---|---|---|---|
| Transformer | 4,02 sn | 8,70 sn | 19,78 sn |
| minLSTM | 1,46 sn | 2,63 sn | 4,90 sn |
| minGRU | 1,29 sn | 2,21 sn | 4,00 sn |
| LSTM | 1,39 sn | 2,26 sn | 4,16 sn |
| TCN | 0,62 sn | 0,98 sn | 1,58 sn |
TCN bütün sekans uzunluklarında en düşük epoch süresine sahiptir.
\(L=1024\) için TCN'nin minLSTM'ye göre yaklaşık:
\[ \frac{4,90}{1,58}\approx3,1 \]
kat hızlı olduğu görülmektedir.
Transformer karşılaştırması ise:
\[ \frac{19,78}{1,58}\approx12,5 \]
kattır.
Kaynağın abstract ve sonuç bölümündeki “15× faster than Transformers” ifadesi bu nedenle Tablo 2'deki doğrudan değerlerden elde edilen yaklaşık 12,5× oranıyla tam örtüşmemektedir.
Tahmin Doğruluğu ile Finansal Getiri Aynı Şey mi?
Hayır. Çalışmanın önemli sonuçlarından biri macro F1 puanının ekonomik getiriyle doğrusal ilişki göstermemesidir.
| Model | XBTUSD F1 | ETHUSD F1 | SOLUSD F1 |
|---|---|---|---|
| LSTM | 0,372 | 0,392 | 0,350 |
| minGRU | 0,391 | 0,430 | 0,354 |
| minLSTM | 0,377 | 0,434 | 0,364 |
| TCN | 0,377 | 0,414 | 0,350 |
| Transformer | 0,357 | 0,403 | 0,319 |
| XGBoost | 0,363 | 0,380 | 0,360 |
Bütün F1 değerlerinin yaklaşık 0,30–0,43 bandında olması yüksek frekanslı kripto verisindeki düşük signal-to-noise oranını göstermektedir.
Bununla birlikte birkaç puanlık sınıflandırma farkı finansal performansa bire bir çevrilmemektedir. Bir stratejinin ekonomik sonucu sinyalin hangi piyasa dönemlerinde doğru olduğu, yanlış tahminin büyüklüğü, pozisyon süresi, olasılık kalibrasyonu ve işlem sıklığı gibi faktörlere de bağlıdır.
Bitcoin'de Hangi Model Davranışı Görülüyor?
\(L=1024\) için XBTUSD sonuçları:
| Model | Toplam Getiri | Max Drawdown | Sortino | İşlem |
|---|---|---|---|---|
| LSTM | +%9,09 | −%1,08 | 0,135 | 642 |
| minGRU | +%4,11 | −%1,39 | 0,097 | 414 |
| minLSTM | +%9,52 | −%1,72 | 0,152 | 481 |
| TCN | +%4,29 | −%0,86 | 0,174 | 594 |
| Transformer | +%4,99 | −%1,42 | 0,144 | 830 |
| XGBoost | +%8,71 | −%1,29 | 0,125 | 2012 |
Mutlak getiride minLSTM ve LSTM öne çıkarken TCN daha düşük getiri fakat daha yüksek Sortino ve daha düşük maksimum drawdown göstermektedir.
\(L=512\) bağlamında klasik LSTM'nin getirisi +%12,58, Sortino'su 0,159; TCN'nin getirisi +%7,20 fakat Sortino'su 0,209 olarak raporlanmıştır.
Bu sonuç Bitcoin'de daha uzun bağlamın otomatik olarak daha iyi olmadığına işaret etmektedir. Kaynağa göre orta düzey hafıza mutlak getiri açısından, kısa yerel hafıza ise risk-düzeltilmiş istikrar açısından avantaj sağlayabilmektedir.
Ethereum'da minLSTM Neden Öne Çıkıyor?
ETHUSD \(L=1024\) sonuçlarında minLSTM belirgin biçimde ayrışmaktadır:
| Model | Getiri | Max Drawdown | Sortino |
|---|---|---|---|
| LSTM | +%9,84 | −%4,72 | 0,109 |
| minGRU | −%5,11 | −%6,80 | −0,041 |
| minLSTM | +%16,43 | −%1,28 | 0,276 |
| TCN | −%15,67 | −%17,06 | −0,144 |
| Transformer | −%10,45 | −%10,50 | −0,146 |
| XGBoost | −%52,37 | −%52,40 | −0,288 |
Kaynak bunu Ethereum'daki daha uzun süreli momentum bilgisinin recurrent hafıza tarafından yakalanabilmesiyle ilişkilendirmektedir.
Ancak sekans uzunluğu sonucu monoton değildir:
\[ L=256:\ +14,75\% \]
\[ L=512:\ +1,45\% \]
\[ L=1024:\ +16,43\%. \]
Bu nedenle sonuç “daha uzun sekans her zaman daha iyidir” şeklinde yorumlanamaz. Belirli bağlam uzunluklarının piyasa rejimiyle etkileşimi önemlidir.
Solana Sonuçları Model Sınırları Hakkında Ne Gösteriyor?
SOLUSD'de \(L=1024\) için bütün modeller toplam örneklemde zarardadır:
| Model | Getiri | Max Drawdown |
|---|---|---|
| LSTM | −%17,63 | −%17,75 |
| minGRU | −%13,05 | −%13,12 |
| minLSTM | −%8,83 | −%8,84 |
| TCN | −%8,59 | −%8,60 |
| Transformer | −%15,33 | −%15,34 |
| XGBoost | −%35,77 | −%35,77 |
Bu, model karşılaştırmasının belki de en önemli negatif sonucudur. İyi bir mimari seçmek tek başına güçlü bir alpha kaynağı yaratmamaktadır. Çok yüksek volatilite ve kalın kuyruk altında yalnız mikro-yapı özelliklerinden oluşan sinyal seti yetersiz kalabilir.
Kaynak gelecekte Level-2 order book, cross-exchange liquidity ve ek risk-management katmanlarının araştırılmasını bu nedenle önermektedir.
Kalibrasyon Neden Sınıflandırma Doğruluğu Kadar Önemli?
Bir model “Bull olasılığı %80” diyorsa bu tahminlerin yaklaşık %80'inin gerçekten Bull olması beklenir. Bu uyum probability calibration ile ölçülür.
| Model | ECE |
|---|---|
| minLSTM | 0,032 |
| minGRU | 0,041 |
| LSTM | 0,048 |
| TCN | 0,055 |
| Transformer | 0,067 |
| XGBoost | 0,089 |
Düşük ECE daha iyi kalibrasyonu temsil eder. minLSTM bu ölçütte en iyi sonucu vermektedir.
Sayfa 8'deki eşik duyarlılığı grafiği ETHUSD'de confidence threshold 0,30'dan 0,60'a değiştirilirken XGBoost getirisinin yaklaşık −%80 ile +%20 arasında çok sert hareket ettiğini göstermektedir. minLSTM ve LSTM ise daha düzgün eğriler üretmektedir.
Bu sonuç, yalnız tahmin sınıfının değil tahmine atanan güven değerinin de ekonomik stratejinin istikrarını değiştirdiğini göstermektedir.
En Kötü İşlemler Modellerin Hafıza Davranışını Gösteriyor mu?
ETHUSD üçüncü walk-forward fold'da raporlanan worst-trade sonuçları:
| Model | En Büyük Kayıp | Süre | Yön |
|---|---|---|---|
| LSTM | −%14,57 | 99 bar | Short |
| minGRU | −%16,09 | 4 bar | Short |
| minLSTM | −%13,39 | 9 bar | Short |
| TCN | −%14,32 | 6 bar | Long |
| Transformer | −%12,82 | 10 bar | Short |
Kaynak, LSTM'nin 99 bar süren kaybını “state persistence” problemi olarak yorumlamaktadır: model eski piyasa durumunu gereğinden uzun süre taşımış olabilir.
Ancak tabloda “Max Loss %” ile genel strateji tablosundaki “Max Drawdown %” aynı büyüklükte değildir. Örneğin minLSTM için worst trade −%13,39 iken toplam equity maximum drawdown −%1,28'dir. Kaynak bu iki yüzdenin hangi farklı baza göre normalize edildiğini ayrıntılı açıklamamaktadır; bu nedenle doğrudan birbirleriyle karşılaştırılmamalıdır.
Bootstrap Sonuçları Ne Kadar Güvenilir?
Kaynak 1.000 bootstrap örneklemesi kullanmaktadır. XBTUSD'de LSTM, minLSTM, TCN ve XGBoost Sharpe aralıklarının ciddi ölçüde çakıştığı, dolayısıyla risk-düzeltilmiş performans farklarının açık biçimde istatistiksel olarak ayrışmadığı belirtilmektedir.
ETHUSD \(L=1024\) için minLSTM Sharpe aralığı:
\[ [0,11,\ 0,28] \]
TCN aralığı:
\[ [-0,16,\ -0,04] \]
olarak raporlanmaktadır ve aralıklar örtüşmemektedir.
Bununla birlikte yöntem bölümünde “%95 bootstrap güven aralığı” denmesine rağmen alt ve üst sınırların 5. ve 95. persentiller olduğu açıklanmıştır. Standart percentile-bootstrap terminolojisinde 5.–95. persentil merkezi %90 aralık oluşturur; %95 merkezi aralık için normal olarak 2,5.–97,5. persentiller kullanılır. Bu, kaynağın istatistiksel raporlamasında düzeltilmesi gereken bir tutarsızlıktır.
TCN'nin Hafızası 7 Bardansa Neden Bu Kadar İyi Çalışabiliyor?
Kaynak bunu finansal mikro-yapının güçlü locality özelliğiyle açıklamaktadır. Çok kısa süreli order-flow imbalance ve tick intensity değişimleri, özellikle olgun ve likit piyasalarda uzak geçmişten daha önemli olabilir.
TCN receptive field'i yaklaşık 7 bardan 15 bara çıkarıldığında XBTUSD getirisi:
\[ +4,29\%\rightarrow+5,12\% \]
ve ETHUSD:
\[ -15,67\%\rightarrow-12,01\% \]
olarak değişmektedir.
Bu genişletme bir miktar iyileşme sağlasa da ETHUSD'yi pozitif getiriye taşımamaktadır. Kaynak, TCN'nin uzak geçmişi adaptif olarak ağırlayamamasının momentum ağırlıklı piyasalarda sınırlayıcı olabileceğini savunmaktadır.
Çalışmanın Desteklediği Temel Sonuçlar
- TCN, kullanılan A100/PyTorch deney ortamında karşılaştırılan neural sequence modellerinden daha hızlı eğitilmektedir.
- Transformer eğitim süresi sekans uzunluğu arttıkça diğer modellerden çok daha hızlı büyümektedir.
- minGRU ve minLSTM'nin hesaplama süresi sekans uzunluğuna yaklaşık doğrusal biçimde ölçeklenmektedir.
- F1 puanı ile backtest getirisi arasında bire bir ilişki bulunmamaktadır.
- XBTUSD'de kısa-yerel TCN daha yüksek risk-düzeltilmiş istikrar gösterebilirken LSTM/minLSTM daha yüksek mutlak getiri üretebilmektedir.
- ETHUSD \(L=1024\) deneyinde minLSTM +%16,43 getiri ve 0,276 Sortino ile güçlü sonuç vermektedir.
- minLSTM 0,032 ECE ile en iyi olasılık kalibrasyonunu sağlamaktadır.
- SOLUSD'de \(L=1024\) koşulunda bütün modeller toplamda negatiftir.
- Model performansı varlığa, sekans uzunluğuna ve volatilite rejimine bağlıdır.
- TCN receptive field'ini genişletmek sonuçları bir miktar iyileştirse de model sıralamasını tamamen değiştirmemektedir.
Çalışmanın Desteklemediği Sonuçlar
Çalışma minLSTM'nin bütün kripto para piyasalarında en iyi model olduğunu göstermez.
TCN'nin en hızlı olması en kârlı model olduğu anlamına gelmez.
Transformer'ın bu deneyde zayıf performansı bütün Transformer veya attention tabanlı zaman serisi modellerinin HFT için kullanışsız olduğunu kanıtlamaz; test edilen Transformer explicit positional encoding kullanmamaktadır.
Backtest getirileri gerçek canlı işlem getirisi değildir. Exchange latency, order-book queue position, market impact ve kullanılan gerçek fee/slippage parametreleri sonuçları değiştirebilir.
50 milyondan fazla tick kullanılması modelin gelecekte de kârlı olacağını garanti etmez.
Dollar-bar örneklemesi finansal veriyi tamamen stationary veya IID hale getirdiğini kanıtlamaz; yalnız aktivite yoğunluğundaki heterojenliği azaltmayı amaçlar.
SOLUSD sonucu bütün altcoin piyasalarında derin öğrenmenin çalışmayacağı anlamına gelmez.
Çalışma canlı borsa altyapısındaki nanosaniye/mikrosaniye order-routing performansını ölçmemektedir; eğitim ve backtest bağlamındaki yüksek frekanslı veri modellemesini incelemektedir.
Kaynak ve Yöntem Notu
Özgün başlık: Linear Recurrent versus Convolutional Neural Networks for High-Frequency Cryptocurrency Trading: Evidence from Dollar-Bar Data
Yazar: Ahoora Rostamian.
Kurum: University of Essex.
Yayın türü: SSRN preprint; Elsevier'a gönderilmiş preprint biçimi.
SSRN gönderim tarihi: 27 Mayıs 2026.
SSRN Abstract ID: 6839368.
DOI: 10.2139/ssrn.6839368.
Hakemlik: Kaynak açık biçimde hakem değerlendirmesinden geçmediğini belirtmektedir.
Telif / lisans: SSRN kaydı “All rights reserved; no reuse allowed without permission” durumunu göstermektedir. Kaynak şekil ve tabloları bu nedenle Verianla içinde yeniden yayımlanmamıştır.
Veri kaynağı: Kraken kripto para borsası tick verileri.
Varlıklar: XBTUSD, ETHUSD ve SOLUSD.
Toplam ham veri: Kaynak 50 milyondan fazla tick bildirmektedir.
Dollar-bar eşiği: 10.000 USD.
Yaklaşık bar sayıları: XBTUSD 699.299; ETHUSD 450.100; SOLUSD 320.500.
Takvim dönemi: PDF veri örnekleminin kesin başlangıç ve bitiş tarihlerini açıkça raporlamamaktadır.
Modeller: LSTM, minGRU, minLSTM, TCN, Transformer ve XGBoost.
Sekans uzunlukları: 256, 512 ve 1024.
Donanım: Tek NVIDIA A100-SXM4 GPU, 40 GB HBM2e.
Yazılım: PyTorch 2.1 ve CUDA 12.1; minRNN'lerde torch.compile reduce-overhead modu.
Doğrulama: Beş fold expanding-window walk-forward validation.
Backtest: 100.000 USD başlangıç equity, 0,40 confidence threshold; long/short sinyalleri.
Temel yeniden üretilebilirlik sınırları: Dördüncü input feature tanımlanmamıştır; fee ve slippage değerleri verilmemiştir; exact dataset tarih aralığı belirtilmemiştir.
İstatistiksel raporlama notu: Kaynak %95 bootstrap CI ifadesini kullanmasına rağmen 5.–95. persentilleri bildirdiğini söylemektedir; bu standart percentile yorumu altında merkezi %90 aralıktır.
Hesaplama notu: Kaynak TCN'nin Transformer'dan 15× hızlı olduğunu belirtmektedir; Tablo 2'nin \(L=1024\) değerleri 19,78 sn ve 1,58 sn olduğundan doğrudan oran yaklaşık 12,5×'tir.
Transformer yorumu: Test edilen baseline explicit positional encoding kullanmadığından bulgular Transformer ailesinin bütün varyantlarına genellenmemelidir.
Finansal yorum sınırı: Raporlanan yüzdeler araştırmanın walk-forward backtest sonuçlarıdır; gerçek yatırım getirisi, canlı HFT performansı veya gelecekteki performans garantisi değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir