

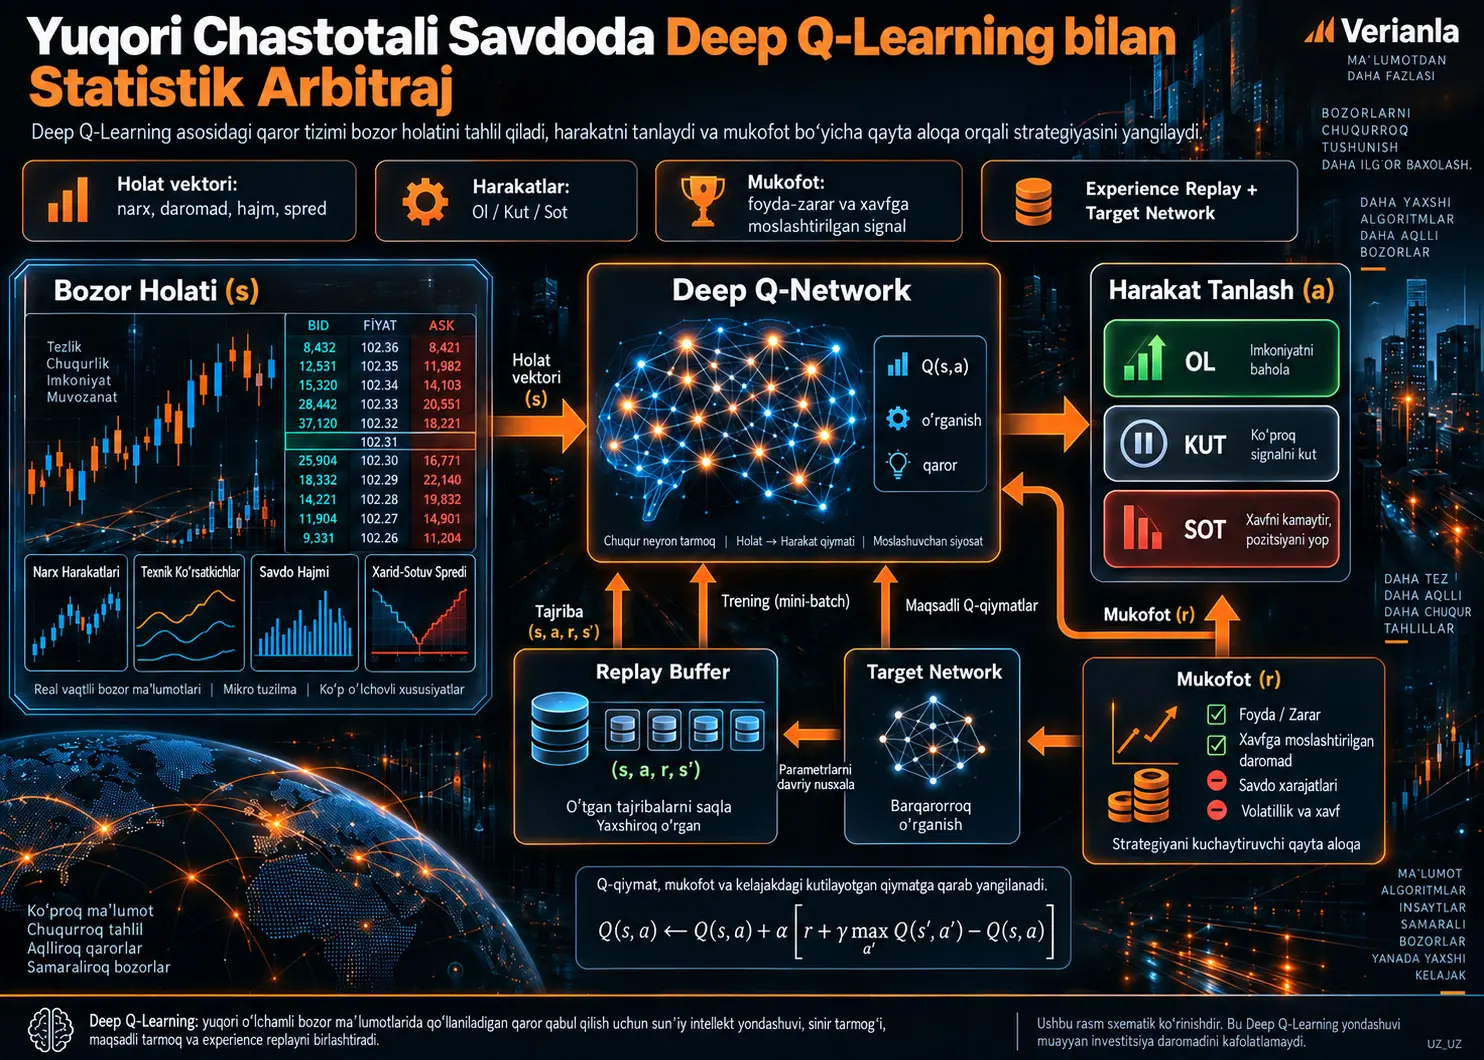
Deep Q-Learning — mustahkamlovchi oʻrganish agenti muayyan bozor holatida turli harakatlarning kutilayotgan uzoq muddatli qiymatlarini chuqur neyron tarmoq yordamida taxminiy hisoblaydigan model-free qaror oʻrganish yondashuvidir. Koʻrib chiqilayotgan tadqiqot ushbu yondashuvdan yuqori chastotali savdoda (High-Frequency Trading, HFT) statistik arbitraj uchun qanday foydalanish mumkinligini Q-Learning yangilanishi, neyron tarmoqqa asoslangan Q-funksiya, maqsadli tarmoq, experience replay hamda holat-harakat-mukofot dizayni orqali tushuntiradi. Manba Deep Q-Learning oʻzgaruvchan bozor sharoitlariga moslasha olishini ilgari suradi; biroq PDF asosiy matnida bu daʼvoni tasdiqlaydigan batafsil backtest maʼlumotlari yoki miqdoriy samaradorlik natijalari keltirilmagan.
Taklif etilgan HFT doirasida bozor holati soʻnggi narx harakatlari, daromadlar, texnik koʻrsatkichlar, savdo hajmi va bid-ask spread kabi oʻzgaruvchilardan iborat boʻlishi mumkin. Agent ushbu holatga qarab sotib olish, pozitsiyani saqlash yoki sotish kabi harakatlar orasidan tanlaydi. Amalga oshgan foyda/zarar yoki riskka moslashtirilgan samaradorlik mukofot signaliga aylantiriladi; Q-tarmoq keyin yuz bergan tajribalardan oʻrganib, kelajakdagi qarorlarini yangilaydi.
Tadqiqotning eng oʻrgatuvchi jihati HFT muammosini bir martalik narx prognozi sifatida emas, balki ketma-ket qaror qabul qilish muammosi sifatida koʻrib chiqishidir. Biroq usulning konseptual jihatdan mos boʻlishi uning real bozorda iqtisodiy ustunlik berishini oʻz-oʻzidan koʻrsatmaydi. Kechikish, buyurtmalar kitobi dinamikasi, tranzaksiya toʻlovlari, slippage, bozor taʼsiri, real vaqt hisoblash xarajati va rejim oʻzgarishlari kabi HFT uchun muhim omillarning manbada empirik ravishda miqdorlashtirilmaganligi muhim cheklovdir.
Nega yuqori chastotali savdo ketma-ket qaror qabul qilish muammosidir?
Yuqori chastotali savdo tizimlari faqat “keyingi narx yuqoriga chiqadimi yoki pastga tushadimi?” degan savolga javob bermaydi. Savdo agenti joriy bozor holatini kuzatadi, harakat tanlaydi, bozorning keyingi holatga oʻtishini va savdoning moliyaviy natijasini koʻradi, soʻng yangi qaror qabul qiladi. Shuning uchun savdo jarayoni vaqt davomida oʻzaro bogʻlangan qarorlar ketma-ketligidan iborat.
Bu tuzilma mustahkamlovchi oʻrganishning asosiy muammo taʼrifiga mos keladi. Agent muhitdan \(s\) holatni kuzatadi, \(a\) harakatni bajaradi, \(r\) mukofotni oladi va yangi \(s'\) holatga oʻtadi. Oʻrganishning maqsadi faqat joriy savdodan olinadigan daromadni emas, kelajakda yuzaga kelishi mumkin boʻlgan mukofotlarni ham hisobga oladigan siyosat ishlab chiqishdir.
Deep Q-Learning nima?
Deep Q-Learning klassik Q-Learningdagi holat-harakat qiymat funksiyasini katta jadvalda saqlash oʻrniga chuqur neyron tarmoq yordamida taxminan hisoblaydigan mustahkamlovchi oʻrganish usulidir; shu tariqa narx, daromad, hajm va bozor mikrostrukturasi kabi koʻp oʻlchovli kirishlar hosil qilgan katta holat fazolarida turli harakatlarning kutilayotgan qiymatlarini baholash mumkin.
Klassik tabular Q-Learningda har bir holat-harakat juftligi uchun alohida qiymat saqlanishi mumkin. Biroq moliyaviy bozordagi holat koʻplab narx kuzatuvlari, daromadlar, harakatlanuvchi oʻrtachalar, volatillik koʻrsatkichlari, hajm va bid-ask spread kabi oʻzgaruvchilardan iborat boʻlsa, mumkin boʻlgan holatlar soni nihoyatda kattalashadi. Deep Q-Learning bu masshtab muammosini neyron tarmoqqa asoslangan funksiya approksimatsiyasi bilan hal qiladi.
Q-Learning yangilanishi
Manbada asosiy Q-Learning yangilanishi quyidagicha berilgan:
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+\gamma\max_{a'}Q(s',a')-Q(s,a) \right] \]
Bu tenglamada \(Q(s,a)\) \(s\) holatdagi \(a\) harakatning kutilayotgan umumiy qiymatini ifodalaydi. \(r\) — harakatdan keyin kuzatilgan darhol olinadigan mukofot. \(s'\) — savdodan keyin yuzaga kelgan yangi holat. \(\max_{a'}Q(s',a')\) yangi holatda mavjud harakatlar orasidagi eng yuqori taxminiy kelajak qiymatini koʻrsatadi.
\(\alpha\) oʻrganish tezligi boʻlib, yangi kuzatuv joriy Q-qiymatni qanchalik oʻzgartirishini belgilaydi. \(\gamma\) diskont koeffitsiyentidir; qiymat 1 ga yaqinlashgan sari kelajakdagi mukofotlarga beriladigan vazn ortadi, 0 ga yaqinlashgan sari yaqin muddatdagi mukofot ustunroq boʻladi.
Tenglamadagi kvadrat qavs ichidagi farq joriy Q bahosi bilan kuzatilgan mukofot va kelajak haqidagi bahodan tuzilgan maqsad oʻrtasidagi xatodir. Oʻrganish jarayoni shu xatodan foydalanib qiymat baholarini qayta-qayta tuzatadi.
Neyron tarmoq Q-qiymatni qanday approksimatsiya qiladi?
Deep Q-Learningda Q-qiymatlar alohida kataklardan iborat jadvalda saqlanmaydi. Manba quyidagi umumiy yondashuvni beradi:
\[ Q(s,a;\theta)=f(s;\theta) \]
\(\theta\) neyron tarmoqning oʻrganiladigan parametrlarini; \(s\) bozorni ifodalovchi kirish holatini; \(f\) esa neyron tarmoq amalga oshiradigan funksional oʻzgartirishni bildiradi. Tarmoq chiqishi mavjud harakatlar uchun taxminiy Q-qiymatlaridan iborat vektordir.
Masalan, harakatlar fazosi sotib olish, kutish va sotish deb belgilangan boʻlsa, tarmoq ayni bozor holatida ushbu uch harakat uchun uch xil qiymat bahosini ishlab chiqishi mumkin. Qaror siyosati shu baholardan foydalanib harakatni tanlaydi.
Nega maqsadli tarmoq ishlatiladi?
Deep Q-Learningda oʻrganilayotgan tarmoq ham joriy bahoni, ham oʻzining oʻrganish maqsadini doim bir vaqtda oʻzgartirsa, taʼlim beqaror boʻlishi mumkin. Manba bu muammoni kamaytirish uchun davriy ravishda yangilanadigan alohida target network dan foydalanish yondashuvini tushuntiradi.
Yoʻqotish funksiyasi manbada quyidagicha berilgan:
\[ L(\theta)= E\left[ \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
Bu yerda \(\theta\) joriy Q-tarmoqning, \(\theta^-\) esa maqsadli tarmoqning parametrlaridir. \(Q(s,a;\theta)\) joriy tarmoq bahosidir; \(r+\gamma\max Q(s',a';\theta^-)\) esa taʼlim maqsadini hosil qiladi. Kvadrat farqning kutilayotgan qiymatini kamaytirish orqali joriy tarmoqni maqsadli Q-qiymatlarga yaqinlashtirish koʻzlanadi.
Maqsadli tarmoqning har qadamda asosiy tarmoq bilan bir vaqtda oʻzgartirilmasligi oʻrganish maqsadining qisqa davrlar davomida barqarorroq qolishini taʼminlaydi. Manba buni Q-Learning taʼlimidagi tebranish va ogʻish xavfini kamaytiruvchi mexanizmlardan biri sifatida taqdim etadi.
Experience Replay nega ishlatiladi?
Experience replay agentning ketma-ket bozor kuzatuvlarini bevosita bir xil tartibda oʻrganishi oʻrniga \((s,a,r,s')\) tajribalarni replay buffer ichida saqlashi va taʼlim vaqtida ushbu xotiradan tasodifiy mini-batchlar tanlashini taʼminlab, ketma-ket namunalar orasidagi kuchli korrelyatsiyani kamaytirish hamda avvalgi tajribalardan qayta foydalanishni maqsad qiladi.
Moliyaviy vaqt qatorlarida ketma-ket kuzatuvlar koʻpincha yuqori darajada bogʻlangan boʻladi. Neyron tarmoqni faqat soʻnggi bir necha ketma-ket kuzatuv bilan oʻqitish oʻrganishning tor bozor rejimiga haddan tashqari bogʻlanib qolishiga olib kelishi mumkin. Replay buffer turli davrlardan namunalarni bir xil taʼlim guruhida birlashtirib, namunalar xilma-xilligini oshiradi.
Manba mini-batch yangilanishini konseptual jihatdan quyidagicha ifodalaydi:
\[ \Delta\theta = E_{(s,a,r,s')\sim U(D)} \left[ \nabla_\theta \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
\(D\) replay buffer-ni, \(U(D)\) ushbu xotiradan uniform namuna olishni, \(\Delta\theta\) esa tarmoq parametrlarining taʼlim davomida oʻzgarishini ifodalaydi.
HFT uchun holat vektori
Manba taklif qilgan HFT holati taʼrifi uch asosiy axborot guruhiga tayanadi: soʻnggi narx harakatlari va daromadlar, texnik koʻrsatkichlar hamda bozor mikrostrukturasi oʻzgaruvchilari. Umumiy holat vektori quyidagicha koʻrsatiladi:
\[ s=[p_1,p_2,\ldots,p_n,i_1,i_2,\ldots,i_m,v,b] \]
Bu yerda \(p\) narx harakatlarini, \(i\) texnik koʻrsatkichlarni, \(v\) savdo hajmini va \(b\) bid-ask spread-ni ifodalaydi. Manba texnik koʻrsatkichlarga misol sifatida harakatlanuvchi oʻrtachalar, Bollinger Bands va Relative Strength Index-ni (RSI) tilga oladi.
Bu ifoda aniq maʼlumotlar sxemasi emas. Maqolada nechta narx kechikishidan foydalanilishi, qaysi koʻrsatkichlar tanlanishi, maʼlumotlar qaysi vaqt rezolyutsiyasida namuna olinishi yoki kirishlar qanday normallashtirilishi koʻrsatilmagan.
Harakatlar fazosi
Manba uchta asosiy harakatni belgilaydi:
- Buy: narx oshishi kutilganda aktivni sotib olish.
- Hold: yangi savdo ochmasdan mavjud pozitsiyani saqlash.
- Sell: pozitsiyani kamaytirish yoki yopish.
Haqiqiy HFT tizimida buyurtma turi, narx darajasi, miqdor, bekor qilish qarori va navbatdagi oʻrin kabi batafsilroq harakatlar talab etilishi mumkin. Ammo manba bu kengroq execution darajasini modellashtirmaydi.
Mukofot funksiyasi
Maqola savdo foydasi yoki zararini asosiy mukofot komponenti sifatida koʻrib chiqadi va faqat yalpi foydaga asoslanish yuqori risk oluvchi siyosatlarni ragʻbatlantirishi mumkinligiga eʼtibor qaratadi. Riskka moslashtirilgan mukofot konseptual ravishda:
\[ r = \frac{\text{Beklenen Getiri}} {\text{Getirilerin Standart Sapması}} \]
koʻrinishida taqdim etilgan. Bu nisbat Sharpe turidagi riskka moslashtirilgan samaradorlik gʻoyasiga yaqin. Biroq manbada haqiqiy taʼlim tajribasida bu mukofot qaysi vaqt oynasida, qanday risksiz daromad farazi bilan yoki qaysi masshtablash usuli yordamida hisoblanganligi koʻrsatilmagan.
Statistik arbitraj bilan bogʻliqlik
Statistik arbitraj oʻzaro bogʻliq moliyaviy vositalar yoki narx jarayonlari orasidagi vaqtinchalik nisbiy ogʻishlarni statistik usullar bilan aniqlash va ular meʼyoriy holatga qaytadi degan kutish asosida savdo qilishga tayanadi. Deep Q-Learning nuqtayi nazarida agent faqat qatʼiy kirish-chiqish chegarasidan foydalanish oʻrniga bozor holati va oldingi mukofotlardan oʻrganib, harakat siyosatini moslashtirishga intiladi.
Bu moslashuvchanlik nazariy jihatdan rejim oʻzgarishlariga javob berish afzalligini berishi mumkin. Biroq moliyaviy bozorlarning non-stationary boʻlishi avval oʻrganilgan Q-qiymatlar kelajakda ham amal qilishini kafolatlamaydi. Yangi bozor rejimlari replay buffer ichidagi eski tajribalar bilan zid kelishi va mukofot taqsimoti vaqt oʻtishi bilan oʻzgarishi mumkin.
Tadqiqot Usuli va Natijalari
Manbada belgilangan uslubiy komponentlar
| Komponent | Manbada belgilangan rol | Manbada yetishmaydigan amaliyot tafsiloti |
|---|---|---|
| Holat \(s\) | Narx, daromad, texnik koʻrsatkich, hajm va bid-ask spread kabi bozor maʼlumotlarini ifodalaydi. | Vaqt rezolyutsiyasi, oyna hajmi, normallashtirish va aniq xususiyatlar toʻplami berilmagan. |
| Harakat \(a\) | Buy, Hold va Sell qarorlari. | Buyurtma miqdori, limit/market buyurtma farqi va execution tafsilotlari berilmagan. |
| Mukofot \(r\) | Foyda/zarar yoki riskka moslashtirilgan daromad. | Haqiqiy amaliyotda ishlatilgan aniq mukofot funksiyasi va parametrlari berilmagan. |
| Q-Learning | Bellman asosidagi qiymat yangilanishi orqali uzoq muddatli mukofotni oʻrganadi. | \(\alpha\) va \(\gamma\) uchun haqiqiy tajriba qiymatlari hisobot qilinmagan. |
| Q-network | Yuqori oʻlchamli holatdan harakat Q-qiymatlarini baholaydi. | Qatlamlar soni, neyronlar soni, aktivatsiya funksiyalari va optimizer berilmagan. |
| Target network | Oʻrganish maqsadini barqarorroq saqlash uchun alohida Q-bahoni taʼminlaydi. | Yangilash chastotasi tushuntirilmagan. |
| Replay buffer | Oldingi tajribalarni saqlaydi va tasodifiy mini-batch taʼlimiga imkon beradi. | Buffer sigʻimi, batch size va sampling tafsilotlari hisobot qilinmagan. |
| Yoʻqotish funksiyasi | Joriy Q bahosi bilan maqsadli Q orasidagi kvadrat farqni kamaytiradi. | Taʼlim davomiyligi, convergence mezoni va oʻrganish egri chiziqlari berilmagan. |
Maqola Deep Q-Learning HFTda koʻproq daromadli ekanini isbotlaydimi?
Yoʻq; manba xulosasida simulyatsiyalar va backtestlar moslashuv, daromadlilik va riskka moslashtirilgan daromadlar nuqtayi nazaridan ijobiy natija bergani ilgari surilgan boʻlsa-da, maqolaning asosiy matnida bu daʼvoni mustaqil baholash imkonini beradigan maʼlumotlar toʻplami, backtest davri, benchmark, PnL, Sharpe nisbati, drawdown, tranzaksiya xarajati yoki statistik ahamiyat natijalari hisobot qilinmagan.
Bu farq tadqiqotni talqin qilishda markaziy ahamiyatga ega. Manba Deep Q-Learning HFT statistik arbitrajiga qanday moslashtirilishi mumkinligini tushuntiradi va usulning potensial afzalliklarini muhokama qiladi. Biroq mavjud PDF usulning muayyan bozor maʼlumotlarida muayyan benchmarkdan miqdoriy jihatdan ustunligini koʻrsatadigan takror ishlab chiqariladigan empirik dalil taqdim etmaydi.
Xulosa bilan asosiy matn orasidagi dalil farqi
Xulosada “extensive simulations and backtests” iborasi ishlatiladi va daromadlilik metrikalari hamda riskka moslashtirilgan daromadlarda yaxshilanish borligi aytiladi. Bunga qarshi, manba asosiy matnida alohida maʼlumot, tajriba, natija yoki backtest boʻlimi mavjud emas. Raqamli daromad qatori, samaradorlik jadvali yoki model taqqoslash berilmagan.
Shu sababli Verianla nuqtayi nazaridan xavfsiz ilmiy ifoda quyidagicha: tadqiqot Deep Q-Learningni HFT statistik arbitraji uchun konseptual jihatdan asoslaydi va qoʻllash mumkin boʻlgan arxitekturani taklif qiladi; biroq ushbu PDF taqdim etgan dalil darajasi usulning real iqtisodiy ustunligini miqdoriy jihatdan tasdiqlash uchun yetarli emas.
Takror ishlab chiqarish nuqtayi nazaridan kamchiliklar
- Foydalanilgan moliyaviy bozor yoki aktivlar olami koʻrsatilmagan.
- Tick, trade yoki limit-order-book maʼlumot manbai berilmagan.
- Train, validation va test davrlari hisobot qilinmagan.
- Out-of-sample baholash protokoli berilmagan.
- Q-network arxitekturasi koʻrsatilmagan.
- Learning rate, discount factor, batch size va replay-buffer sigʻimi berilmagan.
- Epsilon-greedy yoki boshqa exploration siyosati parametrlari koʻrsatilmagan.
- Target network yangilanish chastotasi berilmagan.
- Savdo komissiyalari, bid-ask xarajati, slippage va market impact modellashtirilmagan.
- Latency yoki savdo infratuzilmasi xarajati hisobot qilinmagan.
- Taqqoslash benchmarklari berilmagan.
- Sharpe ratio, maximum drawdown, turnover yoki PnL qatori hisobot qilinmagan.
Tadqiqot qoʻllab-quvvatlaydigan xulosa
Manba Deep Q-Learning yuqori oʻlchamli bozor holatlarini neyron tarmoq orqali ifodalash, harakat qiymatlarini Q-Learning tamoyili bilan yangilash, replay buffer orqali oldingi tajribalardan qayta oʻrganish va target network yordamida taʼlim maqsadini barqarorlashtirish uchun mantiqiy HFT doirasini taqdim etishini qoʻllab-quvvatlaydi.
Tadqiqot qoʻllab-quvvatlamaydigan xulosa
Manba bu arxitektura muayyan birja, aktiv, savdo davri yoki real vaqt HFT infratuzilmasida statistik jihatdan ustun daromad berganini, tranzaksiya xarajatlaridan keyin ham daromadli qolganini yoki klassik statistik arbitraj usullaridan yaxshiroq ekanini miqdoriy tarzda koʻrsatmaydi.
Manba va Usul Haqida Izoh
Asl tadqiqot: Harnessing Deep Q-Learning for Enhanced Statistical Arbitrage in High-Frequency Trading: A Comprehensive Exploration.
Muallif: Soumyadip Sarkar.
Manba: arXiv:2311.10718v1, q-fin.TR.
Sana: 13 sentabr 2023.
Doimiy identifikator: 10.48550/ARXIV.2311.10718.
Manba turi: arXiv preprint; manbada taqrizdan oʻtgan jurnal/konferensiya nashri haqida maʼlumot berilmagan.
Institutsional affiliatsiya: Manba PDFda muallif uchun institutsional affiliatsiya koʻrsatilmagan, faqat aloqa e-pochta manzili berilgan.
Litsenziya: Koʻrib chiqilgan PDF va bibliografik yozuvlarda muayyan ochiq litsenziya tasdiqlanmagani sababli Verianla matni manba ifodasini qayta nashr etish oʻrniga ilmiy tushunchalarni mustaqil oʻrgatuvchi tuzilishda tushuntiradi.
Maʼlumotlar mavjudligi: Manba muayyan maʼlumotlar toʻplami yoki maʼlumotlar omborini belgilamaydi.
Moliyalashtirish va manfaatlar toʻqnashuvi: PDFda ochiq moliyalashtirish yoki manfaatlar toʻqnashuvi bayonoti mavjud emas.
Asosiy uslubiy cheklov: Manbada Deep Q-Learningning matematik va konseptual komponentlari tushuntirilgan boʻlsa-da, empirik qoʻllanmani qayta yaratish uchun zarur maʼlumotlar, giperparametrlar, taʼlim tartibi va samaradorlik natijalari taqdim etilmagan.
Moliyaviy talqin chegarasi: Ushbu Verianla mazmuni savdo strategiyasi taklifi yoki investitsiya tavsiyasi emas; u manba tadqiqotning uslubiy tuzilishi va dalil chegaralarini tushuntiradigan ilmiy taʼlim matnidir.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan