


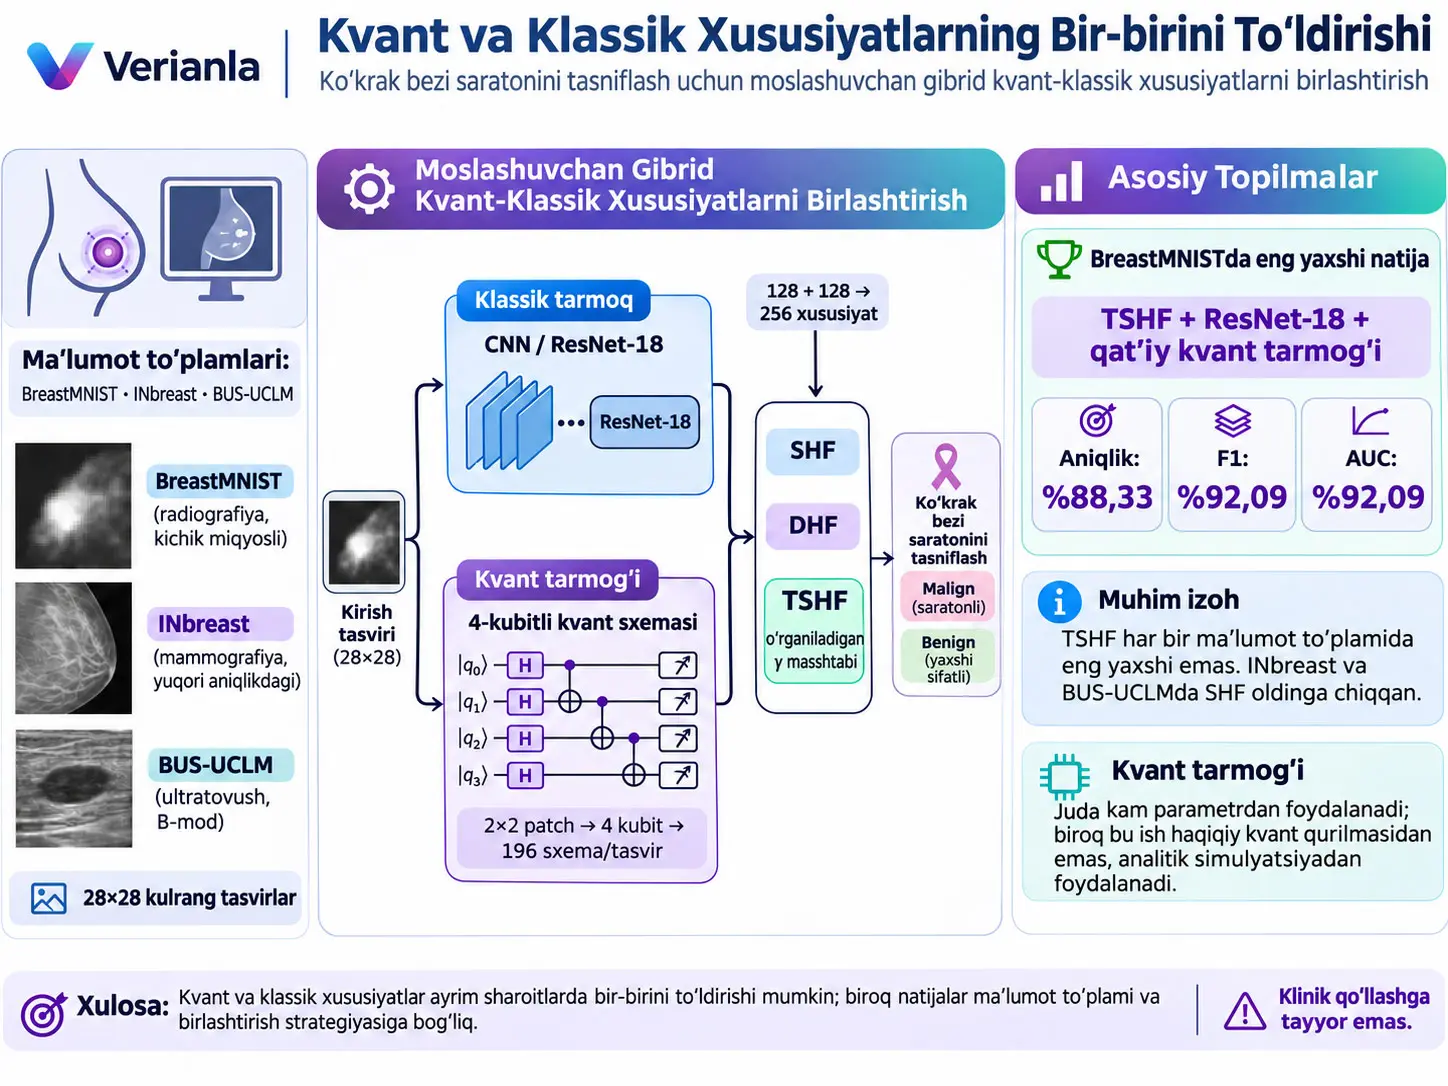
Moslashuvchan Gibrid Kvant-Klassik Xususiyatlarni Birlashtirish, ayni ko‘krak tasvirini parallel klassik neyron tarmog‘i va to‘rt kubitli quanvolutional kvant tarmog‘i orqali qayta ishlaydigan, ikki tarmoq hosil qilgan turli xususiyat tasvirlarini umumiy tasniflash fazosida birlashtiradigan gibrid mashina o‘rganishi doirasidir. Tadqiqot uchta birlashtirish strategiyasini taqqoslaydi: xususiyatlar oldindan ajratilib, faqat tasniflagich o‘qitiladigan Static Hybrid Fusion (SHF), ikki tarmoq boshdan-oxir birgalikda o‘qitiladigan Dynamic Hybrid Fusion (DHF) va kvant xususiyatlarining hissasini yagona o‘qitiladigan \(\gamma\) koeffitsiyenti bilan masshtablaydigan Temperature-Scaled Hybrid Fusion (TSHF). Uchala strategiya ResNet-18 va shallow CNN bo‘lgan ikkita klassik backbone, trainable va deterministic/non-trainable bo‘lgan ikkita kvant tarmog‘i hamda BreastMNIST, INbreast va BUS-UCLM ma’lumotlar to‘plamlarida beshta mustaqil ishga tushirish bilan sinovdan o‘tkazilgan.
BreastMNIST’da eng yuqori aniqlik ResNet-18 bilan non-trainable kvant sxemasini TSHF ostida birlashtirgan modelda olingan: aniqlik \(88.33\%\pm2.00\), F1-score \(92.09\%\pm1.25\) va AUC-ROC \(92.09\%\pm0.44\). Ayni ma’lumotlar to‘plamida faqat ResNet-18 aniqligi \(84.74\%\pm2.99\), AUC qiymati esa \(87.08\%\pm3.07\). Biroq TSHF har bir sharoitda eng yaxshi emas: INbreast’da eng yaxshi natija SHF + ResNet-18 + non-trainable kvant sxemasi bilan \(70.42\%\pm3.73\) aniqlik, BUS-UCLM’da esa SHF + ResNet-18 + trainable sxema bilan \(78.46\%\pm8.85\) aniqlik sifatida topilgan. Shuning uchun tadqiqot “yanada moslashuvchan birlashtirish har doim yaxshiroq” degan xulosani qo‘llab-quvvatlamaydi.
Kvant tarmog‘i tasvirni to‘g‘ridan-to‘g‘ri katta kvant register’iga yuklamaydi. 28×28 kulrang darajali tasvir non-overlapping 2×2 patch’larga bo‘linadi; natijada har bir tasvir uchun 196 patch hosil bo‘ladi. To‘rt pikselli har bir patch to‘rt kubitga burchak kodlash orqali joylashtiriladi, sayoz kvant sxemasi bilan qayta ishlanadi va har bir kubitda Pauli-\(Z\) kutilma qiymati o‘lchanadi. To‘rtta o‘lchov patch-grid ustida to‘rtta xususiyat kanalini hosil qiladi. Bu tuzilma manbada quanvolutional layer deb ataladi.
Tadqiqotning diqqatga sazovor natijalaridan biri trainable kvant sxemasi atigi to‘rtta o‘qitiladigan kvant parametridan foydalanishi, deterministic sxemada esa umuman o‘qitiladigan kvant parametri yo‘qligidir. Bunga qarshi, ishlatilgan ResNet-18 backbone taxminan 11,17 million parametrga ega. Ammo bu parametr samaradorligi hisoblash tezlashuvi degani emas: kvant sxemalari PennyLane lightning.qubit state-vector simulator’da CPU’da bajarilgani uchun gibrid o‘qitish klassik SCNN baseline’ga nisbatan yuzlabdan minglab martagacha sekinroq.
Kvant natijalari haqiqiy fizik kvant apparatida olinmagan. Simulyatsiya analytic mode’da va shot ishlatilmasdan bajarilgan; shot noise, decoherence va gate error modellashtirilmagan. Tadqiqot shuningdek 28×28 aniqlikdagi kichik ochiq ma’lumotlar to‘plamlaridan foydalanadi hamda mustaqil klinik kohortda external validation, calibration analysis yoki reader study’ni o‘z ichiga olmaydi. Shu sabab natijalar klinik diagnostika qurilmasining samaradorligi yoki quantum computational advantage dalili emas, balki gibrid xususiyatlarni birlashtirishning metodologik va izlanish xarakteridagi bahosidir.
Tadqiqotning asosiy savoli
Klassik convolutional neural network’lar tasvirlardan iyerarxik va fazoviy jihatdan barqaror xususiyatlarni o‘rganishda kuchli. Kvant sxemalari esa ayni kirishda boshqa matematik feature map hosil qilishi mumkin. Ushbu tadqiqot ikki tasvir turi bir-birining nusxasi bo‘lish o‘rniga bir-birini to‘ldiradimi va bu to‘ldiruvchanlik ko‘krak tasvirlarini tasniflashda amaliy samaradorlik oshishini ta’minlay oladimi, degan savolni o‘rganadi.
Mualliflarning gipotezasi shuki, klassik va kvant tarmoqlari ayni tasvirlarni turli tarzda tashkil qiladi va ikki tasvirni bir xil feature space ichida birlashtirish bitta tarmoq ta’minlay oladiganidan boyroq kontekst hosil qilishi mumkin. Biroq faqat ikkita feature vector’ni concatenate qilish yetarli bo‘lmasligi mumkin; klassik va kvant tarmoqlarining kattaliklari, dispersiyalari va gradient dinamikalari farq qilganda o‘qitish jarayonida klassik tarmoq kvant tarmog‘ining hissasini bosib ketishi mumkin.
Quanvolutional Qatlam Nima?
Quanvolutional qatlam klassik convolution amalidagi lokal tasvir oynalarini kichik kvant sxemalarida qayta ishlab, har bir patch uchun kvant kutilma qiymatlaridan yangi xususiyat kanallarini hosil qiluvchi gibrid feature-extraction qatlamidir; ushbu tadqiqotda har bir 2×2 tasvir patch’i to‘rt kubitga burchak kodlash orqali yuklanadi, to‘rt kubitli sayoz sxemada qayta ishlanadi va to‘rtta Pauli-\(Z\) kutilma qiymati chiqish xususiyatiga aylantiriladi.
Kirish patch’ini kvant register’iga aylantirish
Bir kanalli tasvir uchun patch o‘lchami \(k\times k\) va kanal soni \(c=1\) bo‘lganda zarur kubitlar soni:
Tadqiqotning barcha tajribalarida:
Ya’ni har bir 2×2 patch ichidagi to‘rtta piksel to‘rtta alohida kubitning rotation angle’ini belgilaydi.
28×28 tasvir patch size 2 va stride 2 bilan qayta ishlanganda har bir o‘qda 14 patch hosil bo‘ladi:
patch/tasvir olinadi. Shu sabab har bir tasvirni kvant tarmog‘i bilan qayta ishlash 196 ta alohida kichik quantum-circuit evaluation talab qiladi.
Trainable quanvolution uchun burchak kodlash
Manbaning Tenglama (3)i:
Formula nimani hisoblaydi? Patch ichidagi har bir normallashtirilgan piksel qiymatini alohida kubitning \(Y\)-o‘qi atrofidagi aylanish burchagiga joylashtiruvchi kirish unitary’sini belgilaydi.
\(x_i\): Patch ichidagi \(i\)-chi piksel qiymati.
\(R_Y(x_i)\): \(i\)-chi kubitda \(Y\)-o‘qi atrofidagi aylanish gate’i.
\(\bigotimes\): To‘rtta bir-kubit amalining birgalikda to‘rt-kubitli register’da qo‘llanishini ko‘rsatuvchi tensor/Kronecker product belgisi.
Boshlang‘ich holat:
bo‘lgani uchun kodlangan holat:
ko‘rinishida hosil bo‘ladi.
Variational ansatz nima qiladi?
Burchak kodlashdan keyin manbada \(R_X\), \(R_Y\), \(R_Z\) parametrik aylanishlari va CNOT chirmashtiruvchi gate’ini o‘z ichiga olgan sayoz variational ansatz \(U(\theta_Q)\) qo‘llanadi:
\(\theta_Q\) kvant sxemasining o‘qitiladigan parametr vektoridir. Ushbu tadqiqotdagi trainable sxema faqat bitta circuit layer va to‘rtta trainable quantum parameter’dan foydalanadi.
Pauli-Z kutilma qiymati qanday qilib xususiyatga aylanadi?
Trainable sxemaning \(i\)-chi chiqish xususiyati:
Formula nimani hisoblaydi? Kvant sxemasi ishga tushirilgandan keyin \(i\)-chi kubitdagi Pauli-\(Z\) observablining kutilma qiymatini hisoblaydi.
\(\sigma_z^{(i)}\) faqat \(i\)-chi kubitga Pauli-\(Z\) qo‘llaydigan, boshqa kubitlarda identity bo‘lgan operatordir.
Kutilma qiymat
oralig‘idadir. Tadqiqot bu qiymatni ReLU amalidan o‘tkazadi va har bir kubit chiqishini alohida feature channel sifatida ishlatadi.
Deterministic/non-trainable kvant sxemasi nimani anglatadi?
Non-trainable variantda quantum rotation parameter’lar dastlab
taqsimotidan bir marta namuna olinadi va o‘qitish vaqtida o‘zgartirilmaydi. Kirish yana angle encoding orqali sxemaga uzatiladi, ammo kvant sxemasining o‘z parametrlari o‘zgarmas qoladi.
Chiqish:
ko‘rinishida hisoblanadi.
Sxema parametrlari optimallashtirilmagani uchun:
Bu nol gradient “model hech narsani o‘rganmaydi” degani emas. Quantum feature map o‘zgarmas; biroq bu feature’lardan foydalanadigan projection head, fusion layer va classifier’ning klassik parametrlari o‘qitilishi mumkin. Afzalligi quantum parameter optimization va barren-plateau xavfining butunlay yo‘qolishidir.
Quantum feature map o‘lchami
Har bir patch to‘rtta chiqish hosil qilgani va patch grid 14×14 bo‘lgani sabab quantum feature map:
o‘lchamga ega. Table IV’ga ko‘ra, bu tuzilma keyin bilinear resize, ReLU va flatten amallari orqali 784 o‘lchamli feature vector’ga aylantiriladi. Quantum projection head:
chiziqli o‘zgartirishni qo‘llaydi.
Klassik tarmoq ham backbone turiga qarab 128 yoki 512 o‘lchamli penultimate feature vector hosil qiladi va alohida projection head orqali 128 o‘lchamga moslashtiriladi. Shunday qilib, ikki tarmoq birlashtirishdan oldin ayni feature dimension’ga keltiriladi.
SHF, DHF va TSHF O‘rtasidagi Farq Nima?
SHF kvant va klassik xususiyatlarni oldindan ajratib, ularni muzlatadi va faqat fusion/classification head’ni o‘qitadi; DHF ikki tarmoq parametrlarini tasniflash xatosi bilan birga boshdan-oxir optimallashtiradi; TSHF esa DHF’ning birgalikdagi o‘qitishiga qo‘shimcha ravishda normallashtirilgan kvant feature vector’ini yagona o‘qitiladigan \(\gamma\) koeffitsiyenti bilan masshtablab, ikki tarmoq orasidagi feature-magnitude va gradient nomutanosibligini sozlashga urinadi.
Static Hybrid Fusion — SHF
Kvant feature extractor:
va klassik feature extractor:
tasvirlarini hosil qiladi. Har ikki branch alohida projection head orqali ayni \(d=128\) o‘lchamga keltiriladi va \(\ell_2\)-normallashtiriladi.
Birlashtirilgan tasvir:
\(\oplus\): concatenation operatoridir.
Ikkita 128-o‘lchamli vector birlashtirilgani uchun:
SHF’da feature extractors fusion bosqichida frozen holatda qoladi. Gradient quantum yoki classical backbone’ga qaytmaydi; faqat classifier/fusion head o‘qitiladi.
Dynamic Hybrid Fusion — DHF
DHF ayni concatenation tuzilmasidan foydalanadi, biroq frozen feature extraction o‘rniga yagona forward/backward pipeline hosil qiladi. Cross-entropy loss’dan keladigan gradient classifier’dan ikki tarmoqqa ajraladi:
- klassik branch’ning \(\phi\) parametrlariga,
- agar trainable quantum branch ishlatilsa, \(\theta_Q\) parametrlariga.
Bu co-adaptation ko‘proq moslashuvchanlik beradi; biroq manbada asosiy muammo sifatida ta’riflangan optimization asymmetry aynan shu yerda yuzaga chiqadi. Ancha katta va yaxshiroq condition qilingan klassik tarmoqning gradient tuzilmasi kvant tarmog‘ining hissasini bosib ketishi mumkin.
Temperature-Scaled Hybrid Fusion — TSHF
TSHF DHF’ga yagona o‘qitiladigan scalar qo‘shadi:
\(\gamma\) o‘lchamsiz yagona trainable parametr bo‘lib, dastlab:
qilib o‘rnatiladi. Bu boshlang‘ich holatda standart concatenation bilan bir xil ma’noga ega.
Gradient ta’siri manbaning Tenglama (7)ida:
ko‘rinishida beriladi.
Formula nimani hisoblaydi? Quantum embedding’ga qaytadigan loss gradient’i \(\gamma\) bilan masshtablanishini ko‘rsatadi.
\(\mathcal L\): tasniflash yo‘qotishi.
\(h_Q\): quantum feature vector.
\(\gamma>1\): boshqa hamma narsa teng bo‘lganda quantum embedding’ning forward o‘tishdagi va backward gradient’dagi nisbiy masshtabini oshiradi.
\(0<\gamma<1\): nisbiy masshtabni kamaytiradi.
Manba qo‘llanmasida \(\gamma\) musbatlikni saqlash uchun dasturiy qatlamda \(\exp(\log\gamma)\) orqali ifodalanadi.
\(\ell_2\) normallashtirish nega markaziy ahamiyatga ega?
TSHF mexanizmini faqat \(\gamma\) orqali talqin qilish to‘liq bo‘lmaydi. Manbaning eng yaxshi BreastMNIST konfiguratsiyasidagi batafsil branch-norm tahlili projection output bosqichida quantum branch normasi klassik branch’nikidan tizimli ravishda kichik ekanini ko‘rsatadi:
Klassik norma test namunalari orasida taxminan 52 baravar o‘zgarsa, quantum norma taxminan 8,6 baravar o‘zgaradi. Normallashtirishdan oldingi branch nisbati taxminan 0,01–1,4 oralig‘ida o‘zgaradi.
Bu sharoitda kvant tarmog‘ining fused-vector energiyasidagi median ulushi atigi:
deb qayd etiladi.
Branch-wise \(\ell_2\) normalization ikki feature vector normasini birlik qiymatga tenglashtiradi. Shundan keyin \(\gamma\) qolgan yagona nisbiy scale parameter’ga aylanadi.
Ikki normallashtirilgan branch uchun manbaning 12-shakl izohidagi quantum-energy ulushi:
Masalan, vakillik qiluvchi ishga tushirishda:
uchun quantum ulushi taxminan:
deb beriladi. Besh ishga tushirish o‘rtachasidagi
esa taxminan %51,2 quantum ulushiga mos keladi.
Bu tahlil tuzatishning katta qismini \(\ell_2\) normalization amalga oshirishini; \(\gamma\) esa normallashtirishdan keyin qolgan branch balance’ni yagona degree of freedom orqali sozlashini ko‘rsatadi.
Barren plateau nima va bu yerda nega muhim?
Tadqiqotning trainable quantum branch dizaynida tilga olingan “barren plateau” kvant sxemasi kengaygani yoki chuqurlashgani sari loss gradient’lari juda kichrayib, optimallashtirishni qiyinlashtirishi mumkin bo‘lgan training-landscape muammosidir. Mualliflar shu sabab sxemani ataylab to‘rt kubit, bitta variational layer va faqat to‘rtta quantum parameter bilan kichik saqlaydilar. Bu dizayn optimization xavfini kamaytiradi, biroq ayni paytda trainable sxemaning representational capacity’sini cheklaydi.
Deterministic quantum feature map nega kutilmagan darajada raqobatbardosh?
Deterministic sxema training vaqtida quantum gradient talab qilmaydi, barren plateau’ga duch kelmaydi va quantum features ma’lumotlar to‘plami uchun bir marta oldindan hisoblanib cache qilinishi mumkin. Tadqiqotda eng yaxshi BreastMNIST va INbreast konfiguratsiyalarining non-trainable quantum branch’dan foydalanishi “o‘qitiladigan kvant sxemasi har doim kuchliroq” degan taxminni qo‘llab-quvvatlamaydi.
Biroq manba bu natijani variational quantum circuit’lar haqida umumiy hukmga aylantirmaydi. Ishlatilgan trainable ansatz atigi to‘rt parametrli va bir qatlamli. Kengroq yoki chuqurroq trainable quantum circuits boshqacha natija berishi mumkin; bu masala kelgusi tadqiqotga qoldirilgan.
Tadqiqot Usuli va Natijalari
Ishlatilgan uchta ma’lumotlar to‘plami
| Ma’lumotlar to‘plami | Bo‘lim | Benign | Malignant | Jami | Malignant ulushi |
|---|---|---|---|---|---|
| BreastMNIST | O‘qitish | 399 | 147 | 546 | %26,9 |
| BreastMNIST | Tasdiqlash | 57 | 21 | 78 | %26,9 |
| BreastMNIST | Test | 114 | 42 | 156 | %26,9 |
| BreastMNIST | Jami | 570 | 210 | 780 | %26,9 |
| INbreast | O‘qitish | 160 | 150 | 310 | %48,4 |
| INbreast | Tasdiqlash | 38 | 37 | 75 | %49,3 |
| INbreast | Test | 50 | 46 | 96 | %47,9 |
| INbreast | Jami | 248 | 233 | 481 | %48,4 |
| BUS-UCLM | O‘qitish | 135 | 64 | 199 | %32,2 |
| BUS-UCLM | Tasdiqlash | 32 | 7 | 39 | %17,9 |
| BUS-UCLM | Test | 7 | 19 | 26 | %73,1 |
| BUS-UCLM | Jami | 174 | 90 | 264 | %34,1 |
BreastMNIST
BreastMNIST MedMNIST taqdim etgan native 28×28 kulrang darajali ultratovush tasvirlaridir. Manba rasmiy train/validation/test split’ni o‘zgartirmasdan ishlatadi.
Bu ma’lumotlar to‘plamida metrikalarni talqin qilishda alohida e’tibor talab qiladigan yorliq konvensiyasi mavjud: musbat sinf benign/normal kategoriyadir. Demak BreastMNIST precision, recall va F1 qiymatlari benign sinf bo‘yicha hisoblangan.
INbreast
INbreast raqamli mammogram ma’lumotlar to‘plamidir. Manba expert annotation’lardan foydalanib suspicious tumor region’larni crop qiladi. Bir tasvirda bir nechta region of interest mavjud bo‘lsa, har bir hudud alohida sample sifatida ko‘rib chiqilishi mumkin.
Crop qilingan hududlar:
- Contrast Limited Adaptive Histogram Equalization (CLAHE) bilan yaxshilanadi,
- har bir tasvir bo‘yicha min–max normalization bilan \([0,1]\) oralig‘iga keltiriladi,
- 28×28 o‘lchamga qayta masshtablanadi.
INbreast’da musbat sinf malignant kategoriyadir.
BUS-UCLM
BUS-UCLM annotated breast-ultrasound tasvirlaridir. Manba tasvirlarga crop yoki CLAHE qo‘llamaydi; faqat normalization va 28×28 resize qo‘llaydi.
BUS-UCLM’da ham musbat sinf malignant kategoriyadir.
INbreast va BUS-UCLM split’lari patient level’da yaratiladi: ayni bemordan kelgan namunalar bir nechta split’ga taqsimlanmaydi. Shu tariqa patient leakage oldi olinadi.
BUS-UCLM’dagi sinf taqsimoti nega ayniqsa muammoli?
O‘qitish to‘plamida malignant ulushi %32,2 bo‘lsa, validation’da %17,9 va testda %73,1. Manba kam sonli bemorlarda patient-level partition qo‘llanishi bu katta prevalence shift’ni yuzaga keltirganini va shu sabab BUS-UCLM natijalari faqat indicative sifatida baholanishi kerakligini ochiq aytadi.
Test to‘plamida atigi 26 tasvir bo‘lgani sabab bitta noto‘g‘ri tasniflash:
accuracy point o‘zgarishini keltirib chiqaradi.
Kirish normalization
Table IV barcha modellar uchun kirishni:
grayscale tensor deb belgilaydi va preprocessing’da:
normalization parametrlarini beradi.
Klassik backbone’lar
| Model | Xususiyat | Feature o‘lchami | Jami parametr |
|---|---|---|---|
| Shallow CNN (SCNN) | Uch convolution block, BatchNorm, ReLU, pooling/GAP | 128 | 93.378 |
| ResNet-18 | ImageNet initialization, birinchi convolution bir kanalga moslashtirilgan | 512 | 11.171.266 |
Kvant branch’ning to‘liq tuzilma xulosasi
| Element | Manba sozlamasi |
|---|---|
| Patch | 2×2, non-overlapping |
| Stride | 2 |
| Patch soni | 196 |
| Kubit | 4 |
| O‘lchov | \(\langle Z_j\rangle,\;j=1,\ldots,4\) |
| Xom feature map | 4×14×14 |
| Post-processing | Bilinear resize + ReLU + flatten |
| Flatten o‘lchami | 784 |
| Quantum projection | 784→128 |
| Fixed circuit trainable quantum parameter | 0 |
| Trainable circuit trainable quantum parameter | 4 |
| Variational layer | 1 |
Fusion qatlamining o‘lchamlari
Klassik va kvant projection output’lari:
sifatida normallashtiriladi. Concatenation’dan keyin:
Bu vector ReLU va 256→2 classifier orqali ikki sinfning score/probability chiqishiga aylantiriladi.
O‘qitish giperparametrlari
| Giperparametr | SCNN | ResNet-18 | Quantum fixed | Quantum trainable | SHF | DHF | TSHF |
|---|---|---|---|---|---|---|---|
| Epoch | 20 | 20 | 10 | 10 | 10 | 10 | 10 |
| Batch size | 16 | 16 | 16 | 16 | 16 | 16 | 16 |
| Asosiy learning rate | \(10^{-3}\) | \(10^{-3}\) | \(3\times10^{-3}\) | \(10^{-2}\) | — | — | — |
| Classical branch LR | — | — | — | — | \(10^{-4}\) | \(10^{-4}\) | \(10^{-4}\) |
| Quantum branch LR | — | — | — | — | \(10^{-2}\) | \(10^{-2}\) | \(10^{-2}\) |
| Fusion head LR | — | — | — | — | \(10^{-3}\) | \(10^{-3}\) | \(10^{-1}\) |
| \(\gamma\) LR | — | — | — | — | Yo‘q | Yo‘q | \(10^{-2}\) |
| Fused feature dim. | — | — | — | — | 128/branch | 128/branch | 128/branch |
Barcha modellar Adam optimizer va cross-entropy loss’dan foydalanadi.
Simulyatsiya va apparat muhiti
| Element | Manbada berilgan ma’lumot |
|---|---|
| Classical framework | PyTorch |
| Quantum framework | PennyLane |
| Trainable integration | TorchLayer |
| Quantum backend | lightning.qubit state-vector |
| Quantum mode | Analytic mode, no shots |
| Quantum execution | CPU |
| Classical execution | CUDA-enabled NVIDIA L40S GPU |
| Mustaqil takrorlash | 5 seed / configuration |
| Optimizer | Adam |
| Loss | Cross-entropy |
Standalone baseline natijalari
| Ma’lumotlar to‘plami | Paradigma | Model | Accuracy | Precision | Recall | F1 | AUC |
|---|---|---|---|---|---|---|---|
| BreastMNIST | Klassik | SCNN | 82.82 ± 2.70 | 86.27 ± 2.26 | 91.05 ± 3.79 | 88.55 ± 1.93 | 84.49 ± 2.23 |
| BreastMNIST | Klassik | ResNet-18 | 84.74 ± 2.99 | 88.67 ± 1.69 | 90.70 ± 2.82 | 89.67 ± 2.10 | 87.08 ± 3.07 |
| BreastMNIST | Kvant | Non-trainable | 78.21 ± 1.98 | 82.69 ± 4.80 | 89.47 ± 4.92 | 85.73 ± 0.54 | 79.42 ± 3.13 |
| BreastMNIST | Kvant | Trainable | 77.82 ± 2.06 | 81.18 ± 3.33 | 91.05 ± 4.45 | 85.71 ± 1.26 | 78.32 ± 1.67 |
| INbreast | Klassik | SCNN | 67.92 ± 2.38 | 65.05 ± 4.16 | 73.04 ± 5.87 | 68.56 ± 1.13 | 78.78 ± 1.61 |
| INbreast | Klassik | ResNet-18 | 68.33 ± 2.72 | 72.91 ± 13.87 | 66.09 ± 24.04 | 65.15 ± 7.93 | 77.30 ± 4.54 |
| INbreast | Kvant | Non-trainable | 69.58 ± 2.49 | 65.78 ± 2.71 | 76.52 ± 5.83 | 70.63 ± 2.85 | 78.63 ± 1.32 |
| INbreast | Kvant | Trainable | 70.00 ± 2.49 | 70.00 ± 6.74 | 68.26 ± 9.55 | 68.44 ± 1.97 | 77.15 ± 2.86 |
| BUS-UCLM | Klassik | SCNN | 66.92 ± 9.26 | 93.20 ± 4.19 | 58.95 ± 12.57 | 71.66 ± 10.05 | 91.88 ± 3.58 |
| BUS-UCLM | Klassik | ResNet-18 | 65.38 ± 9.02 | 95.14 ± 4.58 | 55.79 ± 13.72 | 69.36 ± 11.04 | 86.62 ± 5.27 |
| BUS-UCLM | Kvant | Non-trainable | 69.23 ± 9.02 | 97.24 ± 3.79 | 60.00 ± 14.22 | 73.15 ± 11.26 | 86.47 ± 3.94 |
| BUS-UCLM | Kvant | Trainable | 70.77 ± 15.53 | 86.67 ± 8.81 | 72.63 ± 25.35 | 76.64 ± 15.40 | 81.80 ± 12.01 |
Standalone natijalarning ma’nosi
BreastMNIST’da klassik ResNet-18 quantum-only modellardan sezilarli darajada yuqori aniqlikka ega. INbreast va BUS-UCLM’da esa standalone quantum modellar klassik modellar bilan bir xil darajada yoki accuracy bo‘yicha biroz yuqoriroq natijalar ko‘rsatishi mumkin. Biroq, ayniqsa BUS-UCLM’da standart og‘ishlar juda katta va kichik test to‘plami sabab natijalar beqaror.
BreastMNIST — barcha birlashtirish natijalari xulosasi
| Strategiya | Klassik | Kvant | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 84.74 ± 2.10 | 88.88 ± 1.73 | 92.12 ± 0.18 | — |
| SHF | ResNet-18 | Non-trainable | 78.46 ± 2.89 | 85.61 ± 2.70 | 81.14 ± 1.24 | — |
| SHF | SCNN | Trainable | 80.77 ± 1.28 | 87.08 ± 1.01 | 83.56 ± 1.19 | — |
| SHF | SCNN | Non-trainable | 80.77 ± 1.50 | 86.92 ± 1.14 | 83.07 ± 0.66 | — |
| DHF | ResNet-18 | Trainable | 84.87 ± 1.79 | 89.21 ± 1.73 | 92.48 ± 0.52 | — |
| DHF | ResNet-18 | Non-trainable | 86.28 ± 2.20 | 90.22 ± 1.84 | 92.39 ± 0.24 | — |
| DHF | SCNN | Trainable | 80.00 ± 3.52 | 86.52 ± 3.54 | 82.45 ± 0.55 | — |
| DHF | SCNN | Non-trainable | 81.54 ± 1.39 | 87.62 ± 1.03 | 83.46 ± 0.86 | — |
| TSHF | ResNet-18 | Trainable | 86.15 ± 1.48 | 90.11 ± 1.26 | 92.18 ± 0.22 | 1.280 ± 0.331 |
| TSHF | ResNet-18 | Non-trainable | 88.33 ± 2.00 | 92.09 ± 1.25 | 92.09 ± 0.44 | 1.025 ± 0.039 |
| TSHF | SCNN | Trainable | 81.54 ± 0.84 | 88.10 ± 0.80 | 83.71 ± 0.64 | 0.930 ± 0.053 |
| TSHF | SCNN | Non-trainable | 81.92 ± 0.95 | 88.23 ± 0.81 | 83.29 ± 0.84 | 1.019 ± 0.057 |
BreastMNIST’da eng yuqori accuracy va F1 TSHF + ResNet-18 + non-trainable sxemada olinadi. Biroq eng yuqori AUC:
bilan DHF + ResNet-18 + trainable konfiguratsiyasidadir. Shuning uchun “TSHF barcha metrikalarda eng yaxshi” degan xulosa to‘g‘ri emas.
BreastMNIST confusion-matrix xabari
Manba besh ishga tushirishning jami confusion matrix’larida eng yaxshi TSHF modeli malignant namunalarni benign deb tasniflashni standalone ResNet-18 va deterministic quantum baseline’ga nisbatan kamaytirganini; benign namunalarni malignant sinfga o‘tkazishni ham kamaytirganini bildiradi. Ya’ni bu ma’lumotlar to‘plamida improvement faqat operating threshold’ni bitta sinf foydasiga siljitishdan emas, balki ikki turdagi xatoning birgalikda kamayishidan kelib chiqadi.
INbreast — barcha birlashtirish natijalari xulosasi
| Strategiya | Klassik | Kvant | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 66.87 ± 4.32 | 68.73 ± 3.57 | 79.62 ± 0.09 | — |
| SHF | ResNet-18 | Non-trainable | 70.42 ± 3.73 | 72.96 ± 1.29 | 80.28 ± 0.46 | — |
| SHF | SCNN | Trainable | 68.33 ± 0.93 | 66.55 ± 3.76 | 76.83 ± 2.20 | — |
| SHF | SCNN | Non-trainable | 68.75 ± 1.47 | 65.81 ± 3.63 | 77.70 ± 0.98 | — |
| DHF | ResNet-18 | Trainable | 67.08 ± 2.16 | 69.91 ± 2.56 | 74.67 ± 1.26 | — |
| DHF | ResNet-18 | Non-trainable | 69.79 ± 1.95 | 70.30 ± 4.09 | 76.25 ± 2.04 | — |
| DHF | SCNN | Trainable | 68.33 ± 2.51 | 65.76 ± 5.99 | 76.55 ± 2.48 | — |
| DHF | SCNN | Non-trainable | 68.54 ± 2.80 | 64.99 ± 4.79 | 77.12 ± 1.50 | — |
| TSHF | ResNet-18 | Trainable | 67.92 ± 1.55 | 69.32 ± 3.12 | 76.53 ± 1.25 | 1.080 ± 0.169 |
| TSHF | ResNet-18 | Non-trainable | 65.42 ± 3.71 | 70.72 ± 1.71 | 78.12 ± 1.22 | 1.095 ± 0.150 |
| TSHF | SCNN | Trainable | 67.71 ± 6.46 | 67.80 ± 3.07 | 75.26 ± 2.54 | 0.977 ± 0.053 |
| TSHF | SCNN | Non-trainable | 68.13 ± 3.50 | 69.36 ± 2.46 | 75.70 ± 2.76 | 1.045 ± 0.084 |
INbreast’da adaptive strategiyalar static fusion’dan o‘tmaydi. Eng yaxshi natija frozen feature extractors’dan foydalanadigan SHF’dan keladi.
Confusion matrix tahlili bu ma’lumotlar to‘plamidagi yutuq BreastMNIST’dagi mexanizmdan farq qilishini ko‘rsatadi: missed malignant holatlar kamayganda benign namunalardagi false-positive soni ortadi. Demak fusion bu yerda sensitivity–specificity trade-off’ni o‘zgartiradi.
BUS-UCLM — barcha birlashtirish natijalari xulosasi
| Strategiya | Klassik | Kvant | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 78.46 ± 8.85 | 84.66 ± 6.57 | 89.47 ± 3.28 | — |
| SHF | ResNet-18 | Non-trainable | 73.08 ± 7.69 | 78.16 ± 7.38 | 90.38 ± 2.09 | — |
| SHF | SCNN | Trainable | 62.31 ± 6.88 | 65.39 ± 7.81 | 87.52 ± 2.64 | — |
| SHF | SCNN | Non-trainable | 56.15 ± 9.65 | 56.46 ± 14.79 | 90.23 ± 4.15 | — |
| DHF | ResNet-18 | Trainable | 58.46 ± 7.40 | 61.98 ± 9.01 | 82.56 ± 6.43 | — |
| DHF | ResNet-18 | Non-trainable | 69.23 ± 9.02 | 74.41 ± 10.00 | 89.17 ± 3.39 | — |
| DHF | SCNN | Trainable | 59.23 ± 4.39 | 61.69 ± 5.64 | 89.77 ± 2.41 | — |
| DHF | SCNN | Non-trainable | 55.38 ± 5.83 | 56.10 ± 8.69 | 88.57 ± 3.66 | — |
| TSHF | ResNet-18 | Trainable | 65.38 ± 13.60 | 68.98 ± 16.03 | 83.16 ± 13.44 | 0.989 ± 0.045 |
| TSHF | ResNet-18 | Non-trainable | 53.08 ± 14.24 | 51.13 ± 24.55 | 81.95 ± 11.09 | 1.005 ± 0.024 |
| TSHF | SCNN | Trainable | 62.31 ± 15.24 | 64.45 ± 19.75 | 88.57 ± 4.13 | 0.959 ± 0.062 |
| TSHF | SCNN | Non-trainable | 54.62 ± 20.24 | 50.51 ± 33.42 | 87.67 ± 4.68 | 1.025 ± 0.045 |
BUS-UCLM’da eng yaxshi accuracy va F1 static fusion’dadir. Aksincha, ma’lumotlar to‘plamidagi eng yuqori AUC:
bilan standalone SCNN’ga tegishli. Bu ham fusion “har bir metrikani oshiradi” degan talqinni to‘sadi.
TSHF Nega Har Bir Ma’lumotlar To‘plamida Eng Yaxshi Emas?
TSHF’ning qo‘shimcha \(\gamma\) kalibrlashi va end-to-end co-adaptation’i o‘zlari ham o‘rganilishi kerak bo‘lgan qo‘shimcha erkinliklardir; BreastMNIST’ning 546 ta o‘qitish namunasida bu moslashuvchanlik foyda bergan bo‘lsa, INbreast’ning 310 va BUS-UCLM’ning 199 ta o‘qitish namunasida manba soddaroq SHF yaxshiroq generalization ko‘rsatganini va kichik ma’lumotlar to‘plamlari branch-weight calibration bilan birgalikdagi optimallashtirishni ishonchli o‘rganish uchun yetarli signal bermagan bo‘lishi mumkinligini bildiradi.
Temperature scalar ablyatsiyasi
Manba BreastMNIST + ResNet-18 ustida:
- scaling yo‘q,
- \(\gamma=0.001\),
- \(\gamma=0.01\),
- \(\gamma=0.1\),
- \(\gamma=0.5\),
- \(\gamma=2\),
- branch-wise \(\ell_1\) normalization,
- o‘qitiladigan \(\gamma\)
variantlarini taqqoslaydi.
Non-trainable quantum branch’da learned TSHF:
accuracy bilan ushbu blokdagi eng yaxshi natijani beradi.
Trainable quantum branch’da esa \(\ell_1\) normalization:
accuracy bilan learned TSHF’ning:
qiymatidan yuqoriroqdir.
Demak learned scalar amaliy avtomatik calibration mechanism taqdim etadi, biroq barcha quantum branch turlarida eng yuqori accuracy’ni kafolatlamaydi.
O‘rganilgan \(\gamma\) qanchalik o‘zgaradi?
O‘n ikkita TSHF konfiguratsiyasining barchasida manba:
oralig‘ini bildiradi. O‘n bitta konfiguratsiyada qiymat boshlang‘ich nuqta \(1.0\) ning taxminan %10 i ichida qoladi.
Shu sabab \(\gamma\) qiymatini ma’lumotlar to‘plamining “qiyinlik darajasi” sifatida talqin qilish to‘g‘ri emas. Mualliflar buni alohida rad etadilar.
UMAP tahlili nimani ko‘rsatadi?
Manba BreastMNIST, INbreast va BUS-UCLM embeddings’larini Uniform Manifold Approximation and Projection (UMAP) yordamida ikki o‘lchamga kamaytiradi. Standalone classical va quantum branches ayni namunalarni turli latent geometriyalarda tashkil qiladi; fusion’dan keyin ayrim muvaffaqiyatli konfiguratsiyalarda benign va malignant namunalar vizual ravishda yanada tuzilgan hududlarda to‘planadi.
Biroq mualliflar UMAP:
- non-linear,
- stochastic,
- hyperparameter-sensitive
vizualizatsiya ekanini va o‘z-o‘zicha sinf separability metrikasi deb hisoblab bo‘lmasligini ochiq aytadilar. Tasvirlar faqat bitta run’ga tegishli. Miqdoriy separability da’vosining asosi UMAP tasviri emas, AUC qiymatlaridir.
%95 ishonch oraliqlari
Appendix E beshta mustaqil run o‘rtachasi uchun %95 confidence interval beradi. Bular beshta seed o‘rtachasiga oid ishonch oraliqlaridir; minglab mustaqil klinik bemorlar ustidagi population confidence interval kabi talqin qilinmasligi kerak.
| Ma’lumotlar to‘plami | Konfiguratsiya | Accuracy | F1 | AUC |
|---|---|---|---|---|
| BreastMNIST | TSHF + ResNet-18 + non-trainable | 88.33 [85.85, 90.81] | 92.09 [90.54, 93.64] | 92.09 [91.54, 92.64] |
| INbreast | SHF + ResNet-18 + non-trainable | 70.42 [65.79, 75.05] | 72.96 [71.36, 74.56] | 80.28 [79.71, 80.85] |
| BUS-UCLM | SHF + ResNet-18 + trainable | 78.46 [67.47, 89.45] | 84.66 [76.50, 92.82] | 89.47 [85.40, 93.54] |
BUS-UCLM confidence interval’larining kengligi kichik test namunasi va seed-to-seed o‘zgaruvchanlik bilan mos keladi.
Formal significance testi o‘tkazildimi?
Yo‘q. Manba competing methods o‘rtasida formal statistical significance testing o‘tkazilmaganini ochiq aytadi. Shu sabab o‘rtacha accuracy yoki AUC farqlari “statistik jihatdan isbotlangan ustunlik” sifatida ifodalanmasligi kerak. Mualliflar farqlarni descriptive trend sifatida baholaydilar va sample-level paired analysis’ni kelgusi ishga qoldiradilar.
Oldingi gibrid modellar bilan BreastMNIST taqqoslash
| Model / tadqiqot | Accuracy | F1 | AUC |
|---|---|---|---|
| Matondo et al. | 76.66 | 68.00 | Berilmagan |
| Yurtseven et al. | 86.54 | 91.31 | Berilmagan |
| Sobrinho et al. | 82.10 | 80.30 | 82.60 |
| Ushbu tadqiqot — SHF, ResNet-18 + trainable | 84.74 ± 2.10 | 88.88 ± 1.73 | 92.12 ± 0.18 |
| Ushbu tadqiqot — DHF, ResNet-18 + non-trainable | 86.28 ± 2.20 | 90.22 ± 1.84 | 92.39 ± 0.24 |
| Ushbu tadqiqot — TSHF, ResNet-18 + non-trainable | 88.33 ± 2.00 | 92.09 ± 1.25 | 92.09 ± 0.44 |
Taqqoslashning muhim cheklovi shuki: ushbu tadqiqot qiymatlari beshta seed o‘rtachasidir; manbada taqqoslangan oldingi tadqiqotlar qiymatlari single-run hisobotlaridir. Shu sabab jadvalda ayni test split ishlatilishi foydali bo‘lsa-da, tajriba protokollari to‘liq teng emas.
Computational cost
| Model | Jami parametr | Circuit / tasvir | Inference (ms/tasvir) | Training (ms/qadam) | SCNN’ga nisbatan training slowdown |
|---|---|---|---|---|---|
| SCNN | 93.378 | 0 | 0.03 | 2.4 | 1× |
| ResNet-18 | 11.171.266 | 0 | 0.22 | 55 | 23× |
| QC-fixed | 1.570 | 196 | 118 | 2.357 | ≈\(9.6\times10^2\) |
| QC-trainable | 1.574 | 196 | 143 | 8.304 | ≈\(3.4\times10^3\) |
| SHF + SCNN | 210.888 | 196 | 176 | 2.864 | ≈\(1.2\times10^3\) |
| SHF + ResNet-18 | 11.337.928 | 196 | 134 | 2.140 | ≈\(8.7\times10^2\) |
| DHF + SCNN | 210.888 | 196 | 149 | 8.839 | ≈\(3.6\times10^3\) |
| DHF + ResNet-18 | 11.337.928 | 196 | 169 | 12.785 | ≈\(5.2\times10^3\) |
| TSHF + SCNN | 210.889 | 196 | 190 | 12.283 | ≈\(5.0\times10^3\) |
| TSHF + ResNet-18 | 11.337.929 | 196 | 180 | 9.442 | ≈\(3.9\times10^3\) |
TSHF faqat bitta qo‘shimcha learnable scalar qo‘shgani uchun DHF’ga nisbatan analitik model murakkabligini sezilarli oshirmaydi. Table XI’da DHF va TSHF o‘rtasidagi measured runtime farqlari run-to-run dispersion doirasida baholanadi; manba bu vaqt farqlarini \(\gamma\) mexanizmining bevosita xarajati sifatida talqin qilmaydi.
Ushbu Tadqiqot Kvant Ustunligini yoki Kvant Tezlashuvini Isbotlaydimi?
Yo‘q; tadqiqot simulated to‘rt-kubitli quanvolutional feature maps klassik CNN xususiyatlari bilan to‘ldiruvchi tasvir hosil qila olishiga metodologik dalil beradi, ammo fizik kvant apparatida klassik usullardan tezroq, arzonroq yoki aniqroq end-to-end hisoblashni ko‘rsatmagani sabab quantum computational advantage yoki quantum speedup’ni isbotlamaydi.
Nega parametr samaradorligi tezlashuv emas?
Trainable quantum circuit atigi to‘rtta trainable quantum parameter ishlatsa, ResNet-18 taxminan 11,17 million parametrni o‘z ichiga oladi. Bu muhim parameter-efficiency farqidir.
Biroq har bir tasvir 196 ta alohida quantum-circuit evaluation talab qilishi va bu sxemalar state-vector simulator’da CPU’da bajarilishi sabab wall-clock runtime juda yuqori. Manbaning o‘z xulosasiga ko‘ra, simulated hybrid pipeline klassik SCNN’dan taxminan uch tartibgacha sekinroq bo‘lishi mumkin.
Mualliflar real quantum hardware’da cost profile boshqacha bo‘lishini aytadilar, lekin qanchalik boshqacha bo‘lishini o‘lchamaydilar. Shu sabab Verianla kelajakdagi apparat tezligini sonli tarzda taxmin qilmaydi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- Klassik va kvant feature representations ayni tasvirlarni turli latent tuzilmalarda tashkil qilishi mumkin va bu farq ayrim ma’lumotlar to‘plamlarida foydali fusion signalini berishi mumkin.
- BreastMNIST’da TSHF + ResNet-18 + non-trainable kvant branch standalone ResNet-18’dan yuqoriroq accuracy, F1 va AUC olgan.
- INbreast va BUS-UCLM’da eng yaxshi accuracy adaptive TSHF’dan emas, SHF’dan kelgan.
- Adaptive fusion foydasi ma’lumot miqdori va branch/model tanloviga bog‘liq; universal emas.
- Deterministic quantum feature map ikkita ma’lumotlar to‘plamidagi eng yaxshi konfiguratsiyaning bir qismi bo‘lib, trainable quantum parameter talab qilmaydi.
- Trainable quantum branch’ning to‘rt parametrli bir qatlamli ansatz’i deterministic sxemani izchil ravishda ortda qoldirmaydi.
- Branch-wise normalization quantum/classical magnitude asimmetriyasining katta qismini tuzatadi.
- Learnable \(\gamma\) normalization’dan keyin qolgan relative branch scale’ni bitta parametr bilan sozlaydi.
- UMAP tasvirlari classical va quantum latent representations turlicha tashkil bo‘lishi mumkinligini sifat jihatdan ko‘rsatadi.
- Quantitative class separability baholash UMAP o‘rniga AUC orqali amalga oshirilishi kerak.
Tadqiqot qo‘llab-quvvatlamaydigan natijalar
- Haqiqiy kvant kompyuteri ko‘krak bezi saratonini klassik kompyuterdan yaxshiroq tasniflashi ko‘rsatilmagan.
- Quantum speedup yoki quantum computational advantage ko‘rsatilmagan.
- Shot noise, decoherence va gate error’ni o‘z ichiga olgan fizik quantum hardware xatti-harakati sinovdan o‘tkazilmagan.
- TSHF barcha ma’lumotlar to‘plamlarida va barcha metrikalarda eng yaxshi ekani ko‘rsatilmagan.
- Trainable quantum circuit umuman deterministic circuit’dan ustun ekani ko‘rsatilmagan.
- Formal statistical significance testi o‘tkazilmagani sabab o‘rtacha farqlar p-qiymati bilan tasdiqlangan ustunliklar emas.
- UMAP cluster ajralishi mustaqil miqdoriy separability dalili emas.
- Ishlatilgan kichik ma’lumotlar to‘plamlari screening population’ni ifodalamaydi.
- External clinical validation, calibration analysis yoki reader study o‘tkazilmagan.
- Model klinik foydalanishga tayyor ekani ko‘rsatilmagan.
- 28×28 past aniqlikdagi muvaffaqiyat yuqori aniqlikdagi haqiqiy klinik workflow’ga avtomatik umumlashtirilmaydi.
Tadqiqotning asosiy cheklovlari
- Barcha tasvirlar 28×28 grayscale aniqlikda.
- Test to‘plamlari faqat 156, 96 va 26 tasvirni o‘z ichiga oladi.
- Har bir model faqat beshta mustaqil seed bilan baholangan.
- Competing methods o‘rtasida formal significance testing yo‘q.
- BUS-UCLM train/validation/test prevalence taqsimotlari sezilarli darajada farq qiladi.
- Quantum circuit analytic simulation; haqiqiy hardware noise yo‘q.
- Kvant sxemasi faqat to‘rt kubit va bitta variational layer’ni o‘z ichiga oladi.
- External validation cohort yo‘q.
- Clinical calibration tahlili yo‘q.
- Radiologist/reader study yo‘q.
- Dataset’lar population-level screening cohort emas.
Kelgusi tadqiqot
Manba kengroq qubit register’lar, chuqurroq variational circuits, fizik quantum hardware’da execution, kattaroq va yuqori aniqlikdagi ma’lumotlar to‘plamlari, multimodal tasvirlash, calibration analysis va external validation’ni taklif qiladi. Ayniqsa trainable quantum branch’ning ushbu tadqiqotda faqat to‘rtta parametr bilan cheklangani, kattaroq ansatz’lar haqiqatdan qo‘shimcha foyda beradimi degan savolni ochiq qoldiradi.
Manba va Usul Haqida Izoh
Asl sarlavha: On the Complementarity of Quantum and Classical Features: Adaptive Hybrid Quantum-Classical Feature Fusion for Breast Cancer Classification.
Mualliflar: Yasmin Rodrigues Sobrinho; João Renato Ribeiro Manesco; João Paulo Papa.
PDF’da ishlatilgan qisqartirilgan muallif ismlari: Yasmin R. Sobrinho; João R. R. Manesco; João P. Papa.
Muassasa: Department of Computing, São Paulo State University (UNESP), Bauru, SP, Brazil.
E-pochta: PDF uch muallifga tegishli yasmin.sobrinho, joao.r.manesco va joao.papa @unesp.br manzillarini birgalikda beradi.
Corresponding author: Yuklangan PDF’da alohida corresponding-author belgisi aniq ko‘rsatilmagan.
Teng hissa: Yuklangan PDF’da teng hissa/teng birinchi muallif bayonoti ko‘rinmaydi.
Platforma: arXiv.
arXiv: arXiv:2604.22903v2 [cs.CV].
Ilk yuborish: 24 Aprel 2026.
v2 tahriri: 20 Oktabr 2026.
DOI: 10.48550/arXiv.2604.22903. Bu arXiv/DataCite DOI’sidir; retsenziyalangan jurnal DOI’si emas.
Retsenziya holati: 15 Noyabr 2026 holatiga tasdiqlangan joriy bibliografik yozuv tadqiqotni preprint sifatida ko‘rsatadi. ArXiv comments maydoni maqola Artificial Intelligence in Medicine jurnalida ko‘rib chiqilayotganini bildiradi; alohida nashr etilgan retsenziyalangan versiya tasdiqlanmagan.
Litsenziya: Yuklangan PDF’da muayyan litsenziya bayonoti ko‘rinmaydi va ushbu sessiyada rasmiy arXiv metadata’sidagi litsenziya maydoni ishonchli tarzda tasdiqlanmagani sabab Verianla muayyan ochiq litsenziyani taxmin qilmaydi.
Tadqiqot turi: Methodological/exploratory hybrid quantum-classical machine-learning simulation tadqiqoti.
Qo‘llanish sohasi: Ko‘krak tasvirlarida benign–malignant tasniflash.
Klassik modellar: ResNet-18 va Shallow CNN.
Kvant modellar: To‘rt-kubitli deterministic/non-trainable quanvolutional feature map va to‘rtta trainable quantum parameter’ni o‘z ichiga olgan bir qatlamli variational quanvolutional circuit.
Fusion strategiyalari: Static Hybrid Fusion (SHF), Dynamic Hybrid Fusion (DHF), Temperature-Scaled Hybrid Fusion (TSHF).
Ma’lumotlar to‘plamlari: BreastMNIST, INbreast va BUS-UCLM.
Jami noyob tasvir/ROI namunalarining bevosita yig‘indisi: Ma’lumotlar to‘plamlari turli tuzilishga ega bo‘lgani sabab tadqiqot yagona birlashtirilgan klinik cohort sifatida baholanmasligi kerak; BreastMNIST 780 namuna, INbreast qayta ishlangan 481 ROI/sample va BUS-UCLM 264 namunani o‘z ichiga oladi.
Tasvir aniqligi: 28×28, bir kanalli grayscale.
Quantum patch: 2×2, stride 2, to‘rt kubit, har bir tasvir uchun 196 quantum circuit evaluation.
Quantum o‘lchov: Har bir kubitda Pauli-\(Z\) expectation value.
Quantum simulation: PennyLane lightning.qubit, state-vector, analytic mode, no shots, CPU.
Klassik apparat: CUDA-enabled NVIDIA L40S GPU.
Framework: PyTorch + PennyLane TorchLayer.
Optimizer: Adam.
Loss: Cross-entropy.
Takrorlash: Har bir konfiguratsiya beshta independent seed.
Fusion konfiguratsiyalari: Manba 36 ta fusion konfiguratsiyasi va 12 ta standalone baseline baholashini hisobot qiladi.
Asosiy baholash metrikalari: Accuracy, precision, recall, F1-score va AUC-ROC.
Musbat sinf ogohlantirishi: BreastMNIST’da positive class benign; INbreast va BUS-UCLM’da malignant. Shu sabab precision, recall va F1 qiymatlari ma’lumotlar to‘plamlari orasida sinf ma’nosi nuqtai nazaridan to‘g‘ridan-to‘g‘ri ayni musbat sinfni ifodalamaydi.
Formal statistik test: Competing methods o‘rtasida formal significance testing o‘tkazilmagan. Appendix E’da beshta run o‘rtachasi uchun %95 confidence intervals berilgan.
UMAP: Latent-space visualization uchun ishlatilgan; manba UMAP’ni miqdoriy separability dalili deb qabul qilmaydi.
Computational cost cheklovi: Qayd etilgan katta runtime overhead CPU’dagi classical quantum simulation’ga tegishli va fizik quantum hardware runtime o‘lchovi emas.
Clinical cheklov: Calibration analysis, independent external cohort validation va reader study yo‘q; manba clinical readiness da’vosini qilmaydi.
Kod mavjudligi: Manba implementation, configuration files, experiment scripts va INbreast/BUS-UCLM patient-level split fayllari ochiq GitHub repository’da mavjudligini bildiradi.
Ma’lumot mavjudligi: BreastMNIST MedMNIST benchmark orqali; INbreast va BUS-UCLM esa o‘z ta’minotchilarining kirish shartlari asosida olinishi mumkin.
Moliyalashtirish / minnatdorchilik: Manba São Paulo Research Foundation (FAPESP) grant 2013/07375-0, 2023/14427-0, 2024/00117-0, 2024/22853-0, 2026/11390-4 va 2025/07171-2 hamda Brazilian National Council for Scientific and Technological Development (CNPq) process 308529/2021-9 yordamini bildiradi.
Muallif hissalari: Yuklangan v2 PDF’da alohida CRediT/Author Contributions bo‘limi ko‘rinmaydi.
Manfaatlar to‘qnashuvi: Yuklangan v2 PDF’da alohida competing-interests/conflict-of-interest bayonoti mavjud emas.
Etik bayonot: Yuklangan v2 PDF’da alohida ethics statement ko‘rinmaydi. Tadqiqot yangi bemor ma’lumotini yig‘magan, ochiq tadqiqot ma’lumotlar to‘plamlaridan foydalangan; biroq Verianla manba ochiq aytmagan etik qo‘mita xulosasini o‘zidan yaratmaydi.
Manba ichidagi vizual qayd: Appendix A’dagi precision–recall sahifalaridan birida panel sarlavhalari bilan parsed caption o‘rtasida ma’lumotlar to‘plami nomi bo‘yicha nomuvofiq ko‘rinish mavjud.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan