


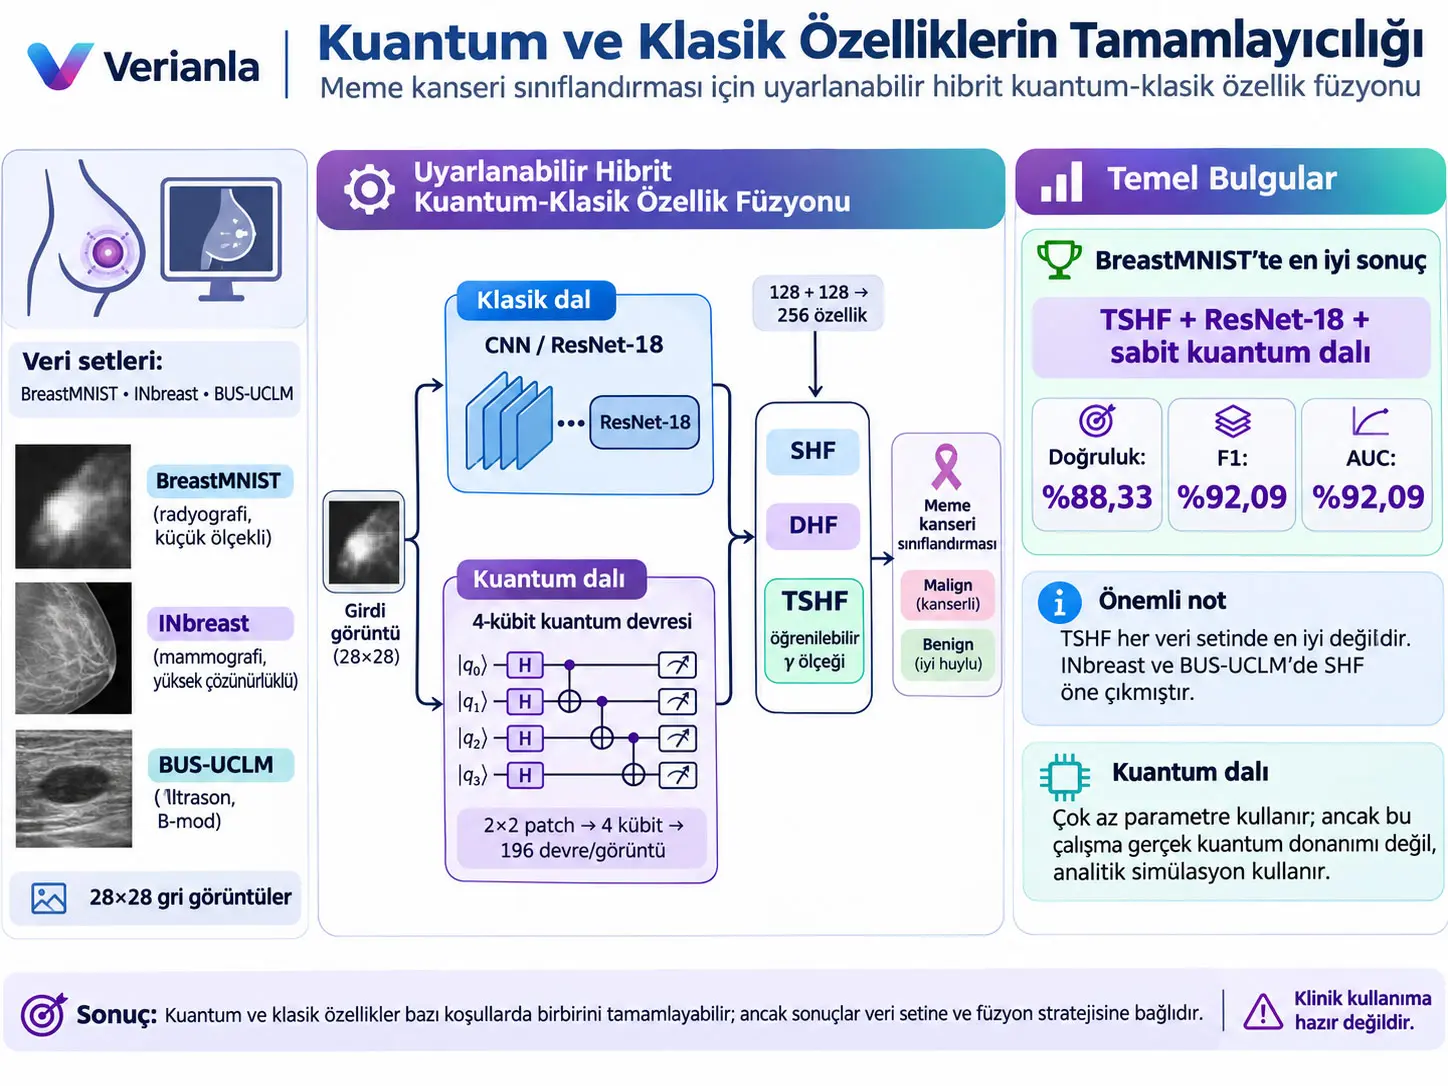
Uyarlanabilir Hibrit Kuantum-Klasik Özellik Füzyonu, aynı meme görüntüsünü paralel bir klasik sinir ağı ve dört kübitli bir quanvolutional kuantum dalıyla işleyen, iki dalın ürettiği farklı özellik temsillerini ortak bir sınıflandırma uzayında birleştiren hibrit bir makine öğrenmesi çerçevesidir. Çalışma üç füzyon stratejisini karşılaştırır: özelliklerin önceden çıkarılıp yalnız sınıflandırıcının eğitildiği Static Hybrid Fusion (SHF), iki dalın uçtan uca birlikte eğitildiği Dynamic Hybrid Fusion (DHF) ve kuantum özelliklerinin katkısını tek bir öğrenilebilir \(\gamma\) katsayısıyla ölçekleyen Temperature-Scaled Hybrid Fusion (TSHF). Üç strateji; ResNet-18 ve shallow CNN olmak üzere iki klasik backbone, trainable ve deterministic/non-trainable olmak üzere iki kuantum dalı ve BreastMNIST, INbreast ve BUS-UCLM veri setleri üzerinde beş bağımsız koşuyla test edilmiştir.
BreastMNIST’te en yüksek doğruluk, ResNet-18 ile non-trainable kuantum devresini TSHF altında birleştiren modelde elde edilmiştir: doğruluk \(88.33\%\pm2.00\), F1-score \(92.09\%\pm1.25\) ve AUC-ROC \(92.09\%\pm0.44\)’tür. Aynı veri setinde yalnız ResNet-18 doğruluğu \(84.74\%\pm2.99\), AUC değeri \(87.08\%\pm3.07\)’dir. Ancak TSHF her koşulda en iyi değildir: INbreast’te en iyi sonuç SHF + ResNet-18 + non-trainable kuantum devresiyle \(70.42\%\pm3.73\) doğruluk, BUS-UCLM’de ise SHF + ResNet-18 + trainable devreyle \(78.46\%\pm8.85\) doğruluk olarak bulunmuştur. Dolayısıyla çalışma “daha adaptif füzyon her zaman daha iyidir” sonucunu desteklemez.
Kuantum dalı, görüntüyü doğrudan büyük bir kuantum register’a yüklemez. 28×28 gri-seviye görüntü non-overlapping 2×2 patch’lere bölünür; böylece görüntü başına 196 patch oluşur. Her dört piksellik patch dört kübite açı kodlamasıyla yerleştirilir, sığ bir kuantum devresiyle işlenir ve her kübitte Pauli-\(Z\) beklenti değeri ölçülür. Dört ölçüm, patch-grid üzerinde dört özellik kanalı oluşturur. Bu yapı kaynakta quanvolutional layer olarak adlandırılır.
Çalışmanın dikkat çekici sonuçlarından biri trainable kuantum devresinin yalnız dört öğrenilebilir kuantum parametresi kullanması, deterministic devrenin ise hiç öğrenilebilir kuantum parametresi içermemesidir. Buna karşılık kullanılan ResNet-18 backbone yaklaşık 11,17 milyon parametreye sahiptir. Fakat bu parametre verimliliği hesaplama hızlanması anlamına gelmez: kuantum devreleri PennyLane lightning.qubit state-vector simulator üzerinde CPU’da çalıştırıldığından hybrid eğitim, klasik SCNN baseline’a göre yüzlerce ile binlerce kat daha yavaştır.
Kuantum sonuçları gerçek fiziksel kuantum donanımında elde edilmemiştir. Simülasyon analytic mode’da ve shot kullanılmadan gerçekleştirilmiştir; shot noise, decoherence ve gate error modellenmemiştir. Çalışma ayrıca 28×28 çözünürlüklü küçük açık veri setlerini kullanmakta, bağımsız klinik kohortta external validation, calibration analysis veya reader study içermemektedir. Dolayısıyla bulgular bir klinik tanı cihazının etkinliği veya quantum computational advantage kanıtı değil, hibrit özellik füzyonunun metodolojik ve keşifsel bir değerlendirmesidir.
Çalışmanın temel araştırma sorusu
Klasik convolutional neural network’ler görüntülerden hiyerarşik ve uzamsal olarak kararlı özellikler öğrenmede güçlüdür. Kuantum devreleri ise aynı girdi üzerinde farklı bir matematiksel feature map üretebilir. Bu çalışma, iki temsil türünün birbirinin kopyası olmak yerine birbirini tamamlayıp tamamlamadığını ve bu tamamlayıcılığın meme görüntüsü sınıflandırmasında kullanılabilir bir performans artışı sağlayıp sağlamadığını araştırır.
Yazarların hipotezi, klasik ve kuantum dalların aynı görüntüleri farklı biçimde organize ettiği ve iki temsili aynı feature space içinde birleştirmenin tek bir dalın sağlayabildiğinden daha zengin bir bağlam oluşturabileceğidir. Bununla birlikte yalnız iki feature vector’ı concatenate etmek yeterli olmayabilir; klasik ve kuantum dalların büyüklükleri, varyansları ve gradient dinamikleri farklı olduğunda eğitim sırasında klasik dal kuantum dalının katkısını baskılayabilir.
Quanvolutional Katman Nedir?
Quanvolutional katman, klasik convolution işlemindeki yerel görüntü pencerelerini küçük kuantum devrelerinde işleyerek her patch için kuantum beklenti değerlerinden yeni özellik kanalları üreten hibrit bir feature-extraction katmanıdır; bu çalışmada her 2×2 görüntü patch’i dört kübite açı kodlamasıyla yüklenir, dört kübitli sığ devrede işlenir ve dört Pauli-\(Z\) beklenti değeri çıkış özelliğine dönüştürülür.
Girdi patch’inin kuantum register’a dönüştürülmesi
Tek-kanallı görüntü için patch boyutu \(k\times k\) ve kanal sayısı \(c=1\) olduğunda gereken kübit sayısı:
Çalışmanın bütün deneylerinde:
Yani her 2×2 patch içindeki dört piksel, dört ayrı kübitin rotation angle’ını belirler.
28×28 görüntü, patch size 2 ve stride 2 ile işlendiğinde her eksende 14 patch oluşur:
patch/görüntü elde edilir. Bu nedenle her görüntünün kuantum dalı tarafından işlenmesi 196 ayrı küçük quantum-circuit evaluation gerektirir.
Trainable quanvolution için açı kodlama
Kaynağın Denklem (3)’ü:
Formül neyi hesaplar? Patch içindeki her normalize edilmiş piksel değerini ayrı bir kübitin \(Y\)-ekseni dönüş açısına yerleştiren giriş unitary’sini tanımlar.
\(x_i\): Patch içindeki \(i\). piksel değeridir.
\(R_Y(x_i)\): \(i\). kübit üzerinde \(Y\)-ekseni etrafındaki dönüş kapısıdır.
\(\bigotimes\): Dört tek-kübit işlemin birlikte dört-kübit register üzerinde uygulanmasını gösteren tensor/Kronecker product işaretidir.
Başlangıç durumu:
olduğundan kodlanmış durum:
şeklinde oluşur.
Variational ansatz ne yapıyor?
Açı kodlamasından sonra kaynakta \(R_X\), \(R_Y\), \(R_Z\) parametrik dönüşleri ve CNOT dolaştırıcı kapısını içeren sığ bir variational ansatz \(U(\theta_Q)\) uygulanır:
\(\theta_Q\), kuantum devresinin öğrenilebilir parametre vektörüdür. Bu çalışmadaki trainable devre yalnız bir circuit layer ve dört trainable quantum parameter kullanır.
Pauli-Z beklenti değeri nasıl özellik oluyor?
Trainable devrenin \(i\). çıkış özelliği:
Formül neyi hesaplar? Kuantum devresi çalıştırıldıktan sonra \(i\). kübit üzerindeki Pauli-\(Z\) observablının beklenti değerini hesaplar.
\(\sigma_z^{(i)}\), yalnız \(i\). kübite Pauli-\(Z\) uygulayan, diğer kübitlerde identity olan operatördür.
Beklenti değeri
aralığındadır. Çalışma bu değeri ReLU işleminden geçirir ve her kübitin çıktısını ayrı feature channel olarak kullanır.
Deterministic/non-trainable kuantum devresi ne anlama geliyor?
Non-trainable varyantta quantum rotation parameter’ları başlangıçta
dağılımından bir kez örneklenir ve eğitim sırasında değiştirilmez. Girdi yine angle encoding ile devreye aktarılır, ancak kuantum devresinin kendi parametreleri sabit kalır.
Çıkış:
olarak hesaplanır.
Devrenin parametreleri optimize edilmediği için:
Bu sıfır gradient “model hiçbir şey öğrenmiyor” anlamına gelmez. Quantum feature map sabittir; ancak bu feature’ları kullanan projection head, fusion layer ve classifier’ın klasik parametreleri eğitilebilir. Avantajı, quantum parameter optimization’ın ve barren-plateau riskinin tamamen ortadan kalkmasıdır.
Quantum feature map’in boyutu
Her patch dört çıkış ürettiğinden ve patch grid 14×14 olduğundan quantum feature map:
boyutundadır. Table IV’e göre bu yapı daha sonra bilinear resize, ReLU ve flatten işlemleriyle 784 boyutlu feature vector’a dönüştürülür. Quantum projection head:
lineer dönüşümü uygular.
Klasik dal da backbone tipine göre 128 veya 512 boyutlu penultimate feature vector üretir ve ayrı projection head ile 128 boyuta eşlenir. Böylece iki dal füzyon öncesinde aynı feature dimension’a getirilir.
SHF, DHF ve TSHF Arasındaki Fark Nedir?
SHF kuantum ve klasik özellikleri önceden çıkarıp dondurur ve yalnız fusion/classification head’i eğitir; DHF iki dalın parametrelerini sınıflandırma hatasıyla birlikte uçtan uca optimize eder; TSHF ise DHF’nin ortak eğitimine ek olarak normalize edilmiş kuantum feature vector’ını tek bir öğrenilebilir \(\gamma\) katsayısıyla ölçekleyerek iki dal arasındaki feature-magnitude ve gradient dengesizliğini ayarlamaya çalışır.
Static Hybrid Fusion — SHF
Kuantum feature extractor:
ve klasik feature extractor:
temsillerini üretir. Her iki branch ayrı projection head ile aynı \(d=128\) boyutuna getirilir ve \(\ell_2\)-normalize edilir.
Birleşik temsil:
\(\oplus\): concatenation operatörüdür.
İki 128-boyutlu vector birleştirildiği için:
SHF’de feature extractors fusion aşamasında frozen’dır. Gradient quantum veya classical backbone’a geri gitmez; yalnız classifier/fusion head eğitilir.
Dynamic Hybrid Fusion — DHF
DHF aynı concatenation yapısını kullanır ancak frozen feature extraction yerine tek bir forward/backward pipeline oluşturur. Cross-entropy loss’tan gelen gradient classifier’dan iki kola ayrılır:
- klasik branch’in \(\phi\) parametrelerine,
- trainable quantum branch kullanılıyorsa \(\theta_Q\) parametrelerine.
Bu co-adaptation daha fazla esneklik sağlar; fakat kaynakta asıl sorun olarak tanımlanan optimization asymmetry burada ortaya çıkar. Çok daha büyük ve daha iyi condition edilmiş klasik ağın gradient yapısı kuantum dalını baskılayabilir.
Temperature-Scaled Hybrid Fusion — TSHF
TSHF, DHF’ye tek öğrenilebilir scalar ekler:
\(\gamma\) boyutsuz tek bir trainable parametredir ve başlangıçta:
olarak ayarlanır. Bu başlangıçta standart concatenation ile aynı anlama gelir.
Gradient etkisi kaynak Denklem (7)’de:
şeklinde gösterilir.
Formül neyi hesaplar? Quantum embedding’e geri giden loss gradient’inin \(\gamma\) ile ölçeklendiğini gösterir.
\(\mathcal L\): sınıflandırma kaybıdır.
\(h_Q\): quantum feature vector’dır.
\(\gamma>1\): diğer her şey eşitken quantum embedding’in ileri geçişteki ve backward gradient’teki göreli ölçeğini artırır.
\(0<\gamma<1\): göreli ölçeği azaltır.
Kaynağın uygulamasında \(\gamma\), pozitifliği korumak üzere uygulama katmanında \(\exp(\log\gamma)\) üzerinden temsil edilir.
\(\ell_2\) normalization neden merkezi?
TSHF’nin mekanizmasını yalnız \(\gamma\) üzerinden okumak eksik olur. Kaynağın en iyi BreastMNIST konfigürasyonundaki ayrıntılı branch-norm analizi, projection output aşamasında quantum branch normunun klasik branch’ten sistematik olarak küçük olduğunu gösterir:
Klasik norm test örnekleri arasında yaklaşık 52 kat değişirken quantum norm yaklaşık 8,6 kat değişmektedir. Normalization öncesi branch oranı yaklaşık 0,01–1,4 aralığında değişmektedir.
Bu koşulda kuantum dalının fused-vector enerjisindeki medyan payı yalnız:
olarak raporlanır.
Branch-wise \(\ell_2\) normalization iki feature vector’ın normunu birim değere eşitler. Ardından \(\gamma\) kalan tek göreli scale parameter haline gelir.
İki normalize branch için kaynağın Şekil 12 açıklamasındaki quantum-energy payı:
Örneğin temsilî koşuda:
için quantum payı yaklaşık:
olarak verilir. Beş koşu ortalamasındaki
ise yaklaşık %51,2 quantum payına karşılık gelir.
Bu analiz, düzeltmenin büyük kısmını \(\ell_2\) normalization’ın yaptığını; \(\gamma\)’nın ise normalization sonrası kalan branch balance’ı tek bir degree of freedom ile ayarladığını gösterir.
Barren plateau nedir ve burada neden önemli?
Çalışmanın trainable quantum branch tasarımında kullanılan “barren plateau”, kuantum devresi genişledikçe veya derinleştikçe loss gradient’lerinin çok küçülerek optimizasyonu zorlaştırabildiği training-landscape problemidir. Yazarlar bu nedenle devreyi dört kübit, tek variational layer ve yalnız dört quantum parameter ile kasıtlı olarak küçük tutar. Bu tasarım optimization riskini azaltır fakat aynı zamanda trainable devrenin representational capacity’sini sınırlar.
Deterministic quantum feature map neden şaşırtıcı biçimde rekabetçi?
Deterministic devre training sırasında quantum gradient gerektirmez, barren plateau ile karşılaşmaz ve quantum features veri seti için bir kez önceden hesaplanıp cache edilebilir. Çalışmada en iyi BreastMNIST ve INbreast konfigürasyonlarının non-trainable quantum branch kullanması, “öğrenilebilir kuantum devresi her zaman daha güçlüdür” varsayımını desteklemez.
Ancak kaynak bu sonucu variational quantum circuit’ler hakkında genel hükme dönüştürmez. Kullanılan trainable ansatz yalnız dört parametreli ve tek katmanlıdır. Daha geniş veya daha derin trainable quantum circuits farklı sonuç verebilir; bu konu gelecek çalışma olarak bırakılmıştır.
Çalışmanın Yöntemi ve Bulguları
Kullanılan üç veri seti
| Veri seti | Bölüm | Benign | Malignant | Toplam | Malignant oranı |
|---|---|---|---|---|---|
| BreastMNIST | Eğitim | 399 | 147 | 546 | %26,9 |
| BreastMNIST | Doğrulama | 57 | 21 | 78 | %26,9 |
| BreastMNIST | Test | 114 | 42 | 156 | %26,9 |
| BreastMNIST | Toplam | 570 | 210 | 780 | %26,9 |
| INbreast | Eğitim | 160 | 150 | 310 | %48,4 |
| INbreast | Doğrulama | 38 | 37 | 75 | %49,3 |
| INbreast | Test | 50 | 46 | 96 | %47,9 |
| INbreast | Toplam | 248 | 233 | 481 | %48,4 |
| BUS-UCLM | Eğitim | 135 | 64 | 199 | %32,2 |
| BUS-UCLM | Doğrulama | 32 | 7 | 39 | %17,9 |
| BUS-UCLM | Test | 7 | 19 | 26 | %73,1 |
| BUS-UCLM | Toplam | 174 | 90 | 264 | %34,1 |
BreastMNIST
BreastMNIST, MedMNIST tarafından sağlanan native 28×28 gri-seviye ultrason görüntüleridir. Kaynak resmi train/validation/test split’ini değiştirmeden kullanır.
Bu veri setinde metrik yorumunda özellikle dikkat edilmesi gereken bir etiket konvansiyonu vardır: pozitif sınıf benign/normal kategoridir. Dolayısıyla BreastMNIST precision, recall ve F1 değerleri benign sınıfa göre hesaplanmıştır.
INbreast
INbreast dijital mammogram veri setidir. Kaynak expert annotation’ları kullanarak suspicious tumor region’ları crop eder. Bir görüntüde birden fazla region of interest bulunuyorsa her bölge ayrı sample olarak ele alınabilir.
Cropped bölgeler:
- Contrast Limited Adaptive Histogram Equalization (CLAHE) ile iyileştirilir,
- görüntü başına min–max normalization ile \([0,1]\) aralığına alınır,
- 28×28 boyutuna yeniden ölçeklenir.
INbreast’te pozitif sınıf malignant kategoridir.
BUS-UCLM
BUS-UCLM annotated breast-ultrasound görüntüleridir. Kaynak görüntülere crop veya CLAHE uygulamaz; yalnız normalization ve 28×28 resize uygular.
BUS-UCLM’de de pozitif sınıf malignant kategoridir.
INbreast ve BUS-UCLM split’leri patient level’da oluşturulur: aynı hastadan gelen örnekler birden fazla split’e dağıtılmaz. Böylece patient leakage önlenir.
BUS-UCLM’deki sınıf dağılımı neden özellikle problemli?
Eğitim setindeki malignant oranı %32,2 iken validation’da %17,9 ve testte %73,1’dir. Kaynak, az sayıdaki hasta üzerinde patient-level partition uygulamasının bu büyük prevalence shift’i ürettiğini ve BUS-UCLM sonuçlarının bu nedenle yalnız indicative olarak değerlendirilmesi gerektiğini açıkça belirtir.
Test setinde yalnız 26 görüntü bulunduğu için tek bir yanlış sınıflandırma:
accuracy point değişimi yaratır.
Girdi normalization
Table IV bütün modeller için girdiyi:
grayscale tensor olarak tanımlar ve preprocessing’de:
normalization parametrelerini verir.
Klasik backbone’lar
| Model | Özellik | Feature boyutu | Toplam parametre |
|---|---|---|---|
| Shallow CNN (SCNN) | Üç convolution block, BatchNorm, ReLU, pooling/GAP | 128 | 93.378 |
| ResNet-18 | ImageNet initialization, ilk convolution tek kanala uyarlanmış | 512 | 11.171.266 |
Kuantum branch’in tam yapı özeti
| Öğe | Kaynak ayarı |
|---|---|
| Patch | 2×2, non-overlapping |
| Stride | 2 |
| Patch sayısı | 196 |
| Kübit | 4 |
| Ölçüm | \(\langle Z_j\rangle,\;j=1,\ldots,4\) |
| Ham feature map | 4×14×14 |
| Post-processing | Bilinear resize + ReLU + flatten |
| Flatten boyutu | 784 |
| Quantum projection | 784→128 |
| Fixed circuit trainable quantum parameter | 0 |
| Trainable circuit trainable quantum parameter | 4 |
| Variational layer | 1 |
Fusion katmanının boyutları
Klasik ve kuantum projection output’ları:
olarak normalize edilir. Concatenation sonrası:
Bu vector ReLU ve 256→2 classifier üzerinden iki sınıfın score/probability çıktısına dönüştürülür.
Eğitim hiperparametreleri
| Hiperparametre | SCNN | ResNet-18 | Quantum fixed | Quantum trainable | SHF | DHF | TSHF |
|---|---|---|---|---|---|---|---|
| Epoch | 20 | 20 | 10 | 10 | 10 | 10 | 10 |
| Batch size | 16 | 16 | 16 | 16 | 16 | 16 | 16 |
| Ana learning rate | \(10^{-3}\) | \(10^{-3}\) | \(3\times10^{-3}\) | \(10^{-2}\) | — | — | — |
| Classical branch LR | — | — | — | — | \(10^{-4}\) | \(10^{-4}\) | \(10^{-4}\) |
| Quantum branch LR | — | — | — | — | \(10^{-2}\) | \(10^{-2}\) | \(10^{-2}\) |
| Fusion head LR | — | — | — | — | \(10^{-3}\) | \(10^{-3}\) | \(10^{-1}\) |
| \(\gamma\) LR | — | — | — | — | Yok | Yok | \(10^{-2}\) |
| Fused feature dim. | — | — | — | — | 128/branch | 128/branch | 128/branch |
Bütün modeller Adam optimizer ve cross-entropy loss kullanır.
Simülasyon ve donanım ortamı
| Öğe | Kaynakta verilen bilgi |
|---|---|
| Classical framework | PyTorch |
| Quantum framework | PennyLane |
| Trainable integration | TorchLayer |
| Quantum backend | lightning.qubit state-vector |
| Quantum mode | Analytic mode, no shots |
| Quantum execution | CPU |
| Classical execution | CUDA-enabled NVIDIA L40S GPU |
| Bağımsız tekrar | 5 seed / configuration |
| Optimizer | Adam |
| Loss | Cross-entropy |
Standalone baseline sonuçları
| Veri seti | Paradigma | Model | Accuracy | Precision | Recall | F1 | AUC |
|---|---|---|---|---|---|---|---|
| BreastMNIST | Klasik | SCNN | 82.82 ± 2.70 | 86.27 ± 2.26 | 91.05 ± 3.79 | 88.55 ± 1.93 | 84.49 ± 2.23 |
| BreastMNIST | Klasik | ResNet-18 | 84.74 ± 2.99 | 88.67 ± 1.69 | 90.70 ± 2.82 | 89.67 ± 2.10 | 87.08 ± 3.07 |
| BreastMNIST | Kuantum | Non-trainable | 78.21 ± 1.98 | 82.69 ± 4.80 | 89.47 ± 4.92 | 85.73 ± 0.54 | 79.42 ± 3.13 |
| BreastMNIST | Kuantum | Trainable | 77.82 ± 2.06 | 81.18 ± 3.33 | 91.05 ± 4.45 | 85.71 ± 1.26 | 78.32 ± 1.67 |
| INbreast | Klasik | SCNN | 67.92 ± 2.38 | 65.05 ± 4.16 | 73.04 ± 5.87 | 68.56 ± 1.13 | 78.78 ± 1.61 |
| INbreast | Klasik | ResNet-18 | 68.33 ± 2.72 | 72.91 ± 13.87 | 66.09 ± 24.04 | 65.15 ± 7.93 | 77.30 ± 4.54 |
| INbreast | Kuantum | Non-trainable | 69.58 ± 2.49 | 65.78 ± 2.71 | 76.52 ± 5.83 | 70.63 ± 2.85 | 78.63 ± 1.32 |
| INbreast | Kuantum | Trainable | 70.00 ± 2.49 | 70.00 ± 6.74 | 68.26 ± 9.55 | 68.44 ± 1.97 | 77.15 ± 2.86 |
| BUS-UCLM | Klasik | SCNN | 66.92 ± 9.26 | 93.20 ± 4.19 | 58.95 ± 12.57 | 71.66 ± 10.05 | 91.88 ± 3.58 |
| BUS-UCLM | Klasik | ResNet-18 | 65.38 ± 9.02 | 95.14 ± 4.58 | 55.79 ± 13.72 | 69.36 ± 11.04 | 86.62 ± 5.27 |
| BUS-UCLM | Kuantum | Non-trainable | 69.23 ± 9.02 | 97.24 ± 3.79 | 60.00 ± 14.22 | 73.15 ± 11.26 | 86.47 ± 3.94 |
| BUS-UCLM | Kuantum | Trainable | 70.77 ± 15.53 | 86.67 ± 8.81 | 72.63 ± 25.35 | 76.64 ± 15.40 | 81.80 ± 12.01 |
Standalone sonuçların anlamı
BreastMNIST’te klasik ResNet-18 kuantum-only modellerden belirgin biçimde daha yüksek doğruluğa sahiptir. INbreast ve BUS-UCLM’de ise standalone quantum modeller klasik modellerle aynı mertebede veya accuracy bakımından biraz daha yüksek sonuçlar gösterebilir. Fakat özellikle BUS-UCLM’de standart sapmalar çok büyüktür ve sonuçlar küçük test seti nedeniyle kararsızdır.
BreastMNIST — bütün füzyon sonuçlarının özeti
| Strateji | Klasik | Kuantum | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 84.74 ± 2.10 | 88.88 ± 1.73 | 92.12 ± 0.18 | — |
| SHF | ResNet-18 | Non-trainable | 78.46 ± 2.89 | 85.61 ± 2.70 | 81.14 ± 1.24 | — |
| SHF | SCNN | Trainable | 80.77 ± 1.28 | 87.08 ± 1.01 | 83.56 ± 1.19 | — |
| SHF | SCNN | Non-trainable | 80.77 ± 1.50 | 86.92 ± 1.14 | 83.07 ± 0.66 | — |
| DHF | ResNet-18 | Trainable | 84.87 ± 1.79 | 89.21 ± 1.73 | 92.48 ± 0.52 | — |
| DHF | ResNet-18 | Non-trainable | 86.28 ± 2.20 | 90.22 ± 1.84 | 92.39 ± 0.24 | — |
| DHF | SCNN | Trainable | 80.00 ± 3.52 | 86.52 ± 3.54 | 82.45 ± 0.55 | — |
| DHF | SCNN | Non-trainable | 81.54 ± 1.39 | 87.62 ± 1.03 | 83.46 ± 0.86 | — |
| TSHF | ResNet-18 | Trainable | 86.15 ± 1.48 | 90.11 ± 1.26 | 92.18 ± 0.22 | 1.280 ± 0.331 |
| TSHF | ResNet-18 | Non-trainable | 88.33 ± 2.00 | 92.09 ± 1.25 | 92.09 ± 0.44 | 1.025 ± 0.039 |
| TSHF | SCNN | Trainable | 81.54 ± 0.84 | 88.10 ± 0.80 | 83.71 ± 0.64 | 0.930 ± 0.053 |
| TSHF | SCNN | Non-trainable | 81.92 ± 0.95 | 88.23 ± 0.81 | 83.29 ± 0.84 | 1.019 ± 0.057 |
BreastMNIST’te en yüksek accuracy ve F1 TSHF + ResNet-18 + non-trainable devrede elde edilir. Ancak en yüksek AUC:
ile DHF + ResNet-18 + trainable konfigürasyonundadır. Dolayısıyla “TSHF bütün metriklerde en iyidir” sonucu doğru değildir.
BreastMNIST confusion-matrix mesajı
Kaynak beş koşunun toplam confusion matrix’lerinde en iyi TSHF modelinin, malignant örneklerin benign olarak sınıflandırılmasını standalone ResNet-18 ve deterministic quantum baseline’a göre azalttığını; benign örneklerin malignant sınıfa kaymasını da azalttığını bildirir. Yani bu veri setinde improvement yalnız operating threshold’u bir sınıf lehine kaydırmaktan değil, iki hata türünün birlikte azalmasından gelir.
INbreast — bütün füzyon sonuçlarının özeti
| Strateji | Klasik | Kuantum | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 66.87 ± 4.32 | 68.73 ± 3.57 | 79.62 ± 0.09 | — |
| SHF | ResNet-18 | Non-trainable | 70.42 ± 3.73 | 72.96 ± 1.29 | 80.28 ± 0.46 | — |
| SHF | SCNN | Trainable | 68.33 ± 0.93 | 66.55 ± 3.76 | 76.83 ± 2.20 | — |
| SHF | SCNN | Non-trainable | 68.75 ± 1.47 | 65.81 ± 3.63 | 77.70 ± 0.98 | — |
| DHF | ResNet-18 | Trainable | 67.08 ± 2.16 | 69.91 ± 2.56 | 74.67 ± 1.26 | — |
| DHF | ResNet-18 | Non-trainable | 69.79 ± 1.95 | 70.30 ± 4.09 | 76.25 ± 2.04 | — |
| DHF | SCNN | Trainable | 68.33 ± 2.51 | 65.76 ± 5.99 | 76.55 ± 2.48 | — |
| DHF | SCNN | Non-trainable | 68.54 ± 2.80 | 64.99 ± 4.79 | 77.12 ± 1.50 | — |
| TSHF | ResNet-18 | Trainable | 67.92 ± 1.55 | 69.32 ± 3.12 | 76.53 ± 1.25 | 1.080 ± 0.169 |
| TSHF | ResNet-18 | Non-trainable | 65.42 ± 3.71 | 70.72 ± 1.71 | 78.12 ± 1.22 | 1.095 ± 0.150 |
| TSHF | SCNN | Trainable | 67.71 ± 6.46 | 67.80 ± 3.07 | 75.26 ± 2.54 | 0.977 ± 0.053 |
| TSHF | SCNN | Non-trainable | 68.13 ± 3.50 | 69.36 ± 2.46 | 75.70 ± 2.76 | 1.045 ± 0.084 |
INbreast’te adaptive stratejiler static fusion’ı geçmez. En iyi sonuç frozen feature extractors kullanan SHF’den gelir.
Confusion matrix analizi, bu veri setindeki kazancın BreastMNIST’teki mekanizmadan farklı olduğunu gösterir: missed malignant vakalar azalırken benign örneklerde false-positive sayısı yükselir. Dolayısıyla fusion burada sensitivity–specificity trade-off’unu değiştirir.
BUS-UCLM — bütün füzyon sonuçlarının özeti
| Strateji | Klasik | Kuantum | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 78.46 ± 8.85 | 84.66 ± 6.57 | 89.47 ± 3.28 | — |
| SHF | ResNet-18 | Non-trainable | 73.08 ± 7.69 | 78.16 ± 7.38 | 90.38 ± 2.09 | — |
| SHF | SCNN | Trainable | 62.31 ± 6.88 | 65.39 ± 7.81 | 87.52 ± 2.64 | — |
| SHF | SCNN | Non-trainable | 56.15 ± 9.65 | 56.46 ± 14.79 | 90.23 ± 4.15 | — |
| DHF | ResNet-18 | Trainable | 58.46 ± 7.40 | 61.98 ± 9.01 | 82.56 ± 6.43 | — |
| DHF | ResNet-18 | Non-trainable | 69.23 ± 9.02 | 74.41 ± 10.00 | 89.17 ± 3.39 | — |
| DHF | SCNN | Trainable | 59.23 ± 4.39 | 61.69 ± 5.64 | 89.77 ± 2.41 | — |
| DHF | SCNN | Non-trainable | 55.38 ± 5.83 | 56.10 ± 8.69 | 88.57 ± 3.66 | — |
| TSHF | ResNet-18 | Trainable | 65.38 ± 13.60 | 68.98 ± 16.03 | 83.16 ± 13.44 | 0.989 ± 0.045 |
| TSHF | ResNet-18 | Non-trainable | 53.08 ± 14.24 | 51.13 ± 24.55 | 81.95 ± 11.09 | 1.005 ± 0.024 |
| TSHF | SCNN | Trainable | 62.31 ± 15.24 | 64.45 ± 19.75 | 88.57 ± 4.13 | 0.959 ± 0.062 |
| TSHF | SCNN | Non-trainable | 54.62 ± 20.24 | 50.51 ± 33.42 | 87.67 ± 4.68 | 1.025 ± 0.045 |
BUS-UCLM’de en iyi accuracy ve F1 static fusion’dadır. Buna karşılık veri setindeki en yüksek AUC:
ile standalone SCNN’ye aittir. Bu da fusion’ın “her metriği artırdığı” yorumunu engeller.
TSHF Neden Her Veri Setinde En İyi Değil?
TSHF’nin ek \(\gamma\) kalibrasyonu ve end-to-end co-adaptation’ı kendileri de öğrenilmesi gereken ek serbestliklerdir; BreastMNIST’in 546 eğitim örneğinde bu esneklik yarar sağlarken INbreast’in 310 ve BUS-UCLM’nin 199 eğitim örneğinde kaynak, daha basit SHF’nin daha iyi generalization gösterdiğini ve küçük veri setlerinin branch-weight calibration ile ortak optimizasyonu güvenilir biçimde öğrenmek için yeterli sinyal sağlamamış olabileceğini belirtir.
Temperature scalar ablasyonu
Kaynak BreastMNIST + ResNet-18 üzerinde:
- scaling yok,
- \(\gamma=0.001\),
- \(\gamma=0.01\),
- \(\gamma=0.1\),
- \(\gamma=0.5\),
- \(\gamma=2\),
- branch-wise \(\ell_1\) normalization,
- öğrenilebilir \(\gamma\)
seçeneklerini karşılaştırır.
Non-trainable quantum branch’te learned TSHF:
accuracy ile bu bloktaki en iyi sonucu verir.
Trainable quantum branch’te ise \(\ell_1\) normalization:
accuracy ile learned TSHF’nin:
değerinden daha yüksektir.
Dolayısıyla learned scalar pratik bir otomatik calibration mechanism sunar fakat bütün quantum branch türlerinde en yüksek accuracy’yi garanti etmez.
Öğrenilen \(\gamma\) ne kadar değişiyor?
On iki TSHF konfigürasyonunun tamamında kaynak:
aralığını bildirir. On bir konfigürasyonda değer başlangıç noktası \(1.0\)’ın yaklaşık %10’u içinde kalır.
Bu nedenle \(\gamma\) değerini veri setinin “zorluk derecesi” gibi okumak doğru değildir. Yazarlar bunu özellikle reddeder.
UMAP analizi ne gösteriyor?
Kaynak BreastMNIST, INbreast ve BUS-UCLM embeddings’lerini Uniform Manifold Approximation and Projection (UMAP) ile iki boyuta indirger. Standalone classical ve quantum branches aynı örnekleri farklı latent geometrilerde düzenler; fusion sonrası bazı başarılı konfigürasyonlarda benign ve malignant örnekler görsel olarak daha yapılandırılmış bölgelerde toplanır.
Fakat yazarlar UMAP’in:
- non-linear,
- stochastic,
- hyperparameter-sensitive
bir görselleştirme olduğunu ve tek başına sınıf separability metriği sayılamayacağını açıkça belirtir. Gösterimler yalnız bir run’a aittir. Nicel separability iddiasının dayanağı UMAP görüntüsü değil AUC değerleridir.
%95 güven aralıkları
Appendix E, beş bağımsız run ortalaması için %95 confidence interval verir. Bunlar beş seed’in ortalamasına ilişkin güven aralıklarıdır; binlerce bağımsız klinik hasta üzerindeki population confidence interval gibi yorumlanmamalıdır.
| Veri seti | Konfigürasyon | Accuracy | F1 | AUC |
|---|---|---|---|---|
| BreastMNIST | TSHF + ResNet-18 + non-trainable | 88.33 [85.85, 90.81] | 92.09 [90.54, 93.64] | 92.09 [91.54, 92.64] |
| INbreast | SHF + ResNet-18 + non-trainable | 70.42 [65.79, 75.05] | 72.96 [71.36, 74.56] | 80.28 [79.71, 80.85] |
| BUS-UCLM | SHF + ResNet-18 + trainable | 78.46 [67.47, 89.45] | 84.66 [76.50, 92.82] | 89.47 [85.40, 93.54] |
BUS-UCLM confidence interval’larının genişliği küçük test örneklemi ve seed-to-seed değişkenlikle uyumludur.
Formal significance testi yapıldı mı?
Hayır. Kaynak competing methods arasında formal statistical significance testing yapılmadığını açıkça belirtir. Bu nedenle ortalama accuracy veya AUC farkları “istatistiksel olarak kanıtlanmış üstünlük” şeklinde ifade edilmemelidir. Yazarlar farkları descriptive trend olarak değerlendirir ve sample-level paired analysis’i gelecek çalışmaya bırakır.
Önceki hibrit modellerle BreastMNIST karşılaştırması
| Model / çalışma | Accuracy | F1 | AUC |
|---|---|---|---|
| Matondo et al. | 76.66 | 68.00 | Raporlanmamış |
| Yurtseven et al. | 86.54 | 91.31 | Raporlanmamış |
| Sobrinho et al. | 82.10 | 80.30 | 82.60 |
| Bu çalışma — SHF, ResNet-18 + trainable | 84.74 ± 2.10 | 88.88 ± 1.73 | 92.12 ± 0.18 |
| Bu çalışma — DHF, ResNet-18 + non-trainable | 86.28 ± 2.20 | 90.22 ± 1.84 | 92.39 ± 0.24 |
| Bu çalışma — TSHF, ResNet-18 + non-trainable | 88.33 ± 2.00 | 92.09 ± 1.25 | 92.09 ± 0.44 |
Karşılaştırmanın önemli sınırı şudur: bu çalışmanın değerleri beş seed ortalamasıdır; kaynakta karşılaştırılan önceki çalışmaların değerleri single-run raporlarıdır. Bu nedenle tabloda aynı test split kullanılması yararlı olsa da deney protokolleri tamamen eşdeğer değildir.
Computational cost
| Model | Toplam parametre | Circuit / görüntü | Inference (ms/görüntü) | Training (ms/adım) | SCNN’ye göre training slowdown |
|---|---|---|---|---|---|
| SCNN | 93.378 | 0 | 0.03 | 2.4 | 1× |
| ResNet-18 | 11.171.266 | 0 | 0.22 | 55 | 23× |
| QC-fixed | 1.570 | 196 | 118 | 2.357 | ≈\(9.6\times10^2\) |
| QC-trainable | 1.574 | 196 | 143 | 8.304 | ≈\(3.4\times10^3\) |
| SHF + SCNN | 210.888 | 196 | 176 | 2.864 | ≈\(1.2\times10^3\) |
| SHF + ResNet-18 | 11.337.928 | 196 | 134 | 2.140 | ≈\(8.7\times10^2\) |
| DHF + SCNN | 210.888 | 196 | 149 | 8.839 | ≈\(3.6\times10^3\) |
| DHF + ResNet-18 | 11.337.928 | 196 | 169 | 12.785 | ≈\(5.2\times10^3\) |
| TSHF + SCNN | 210.889 | 196 | 190 | 12.283 | ≈\(5.0\times10^3\) |
| TSHF + ResNet-18 | 11.337.929 | 196 | 180 | 9.442 | ≈\(3.9\times10^3\) |
TSHF yalnız bir ekstra learnable scalar eklediği için DHF’ye göre analitik model karmaşıklığını anlamlı biçimde artırmaz. Table XI’de DHF ve TSHF arasındaki measured runtime farkları run-to-run dispersion içinde değerlendirilir; kaynak bu zaman farklarını \(\gamma\) mekanizmasının doğrudan maliyeti olarak yorumlamaz.
Bu Çalışma Kuantum Üstünlüğünü veya Kuantum Hızlanmasını Kanıtlıyor mu?
Hayır; çalışma simulated dört-kübit quanvolutional feature maps’in klasik CNN özellikleriyle tamamlayıcı temsil oluşturabildiğine dair metodolojik kanıt sunar, ancak fiziksel kuantum donanımı üzerinde klasik yöntemlerden daha hızlı, daha ucuz veya daha doğru end-to-end hesaplama göstermediği için quantum computational advantage veya quantum speedup kanıtlamaz.
Neden parametre verimliliği hızlanma değildir?
Trainable quantum circuit yalnız dört trainable quantum parameter kullanırken ResNet-18 yaklaşık 11,17 milyon parametre içerir. Bu önemli bir parameter-efficiency farkıdır.
Ancak her görüntünün 196 ayrı quantum-circuit evaluation gerektirmesi ve bu devrelerin state-vector simulator üzerinde CPU’da çalıştırılması nedeniyle wall-clock runtime çok yüksektir. Kaynağın kendi sonucu, simulated hybrid pipeline’ın klasik SCNN’den yaklaşık üç büyüklük mertebesine kadar daha yavaş olabileceğidir.
Yazarlar gerçek quantum hardware üzerinde cost profile’ın farklı olacağını belirtir; fakat bunun ne kadar farklı olacağını ölçmez. Bu nedenle gelecekteki donanım hızını Verianla sayısal olarak tahmin etmemektedir.
Çalışmanın desteklediği sonuçlar
- Klasik ve kuantum feature representations aynı görüntüleri farklı latent yapılarda düzenleyebilir ve bu farklılık bazı veri setlerinde yararlı fusion sinyali sağlayabilir.
- BreastMNIST’te TSHF + ResNet-18 + non-trainable kuantum branch, standalone ResNet-18’den daha yüksek accuracy, F1 ve AUC elde etmiştir.
- INbreast ve BUS-UCLM’de en iyi accuracy adaptive TSHF’den değil SHF’den gelmiştir.
- Adaptive fusion’ın yararı veri miktarına ve branch/model seçimine bağlıdır; evrensel değildir.
- Deterministic quantum feature map iki veri setindeki en iyi konfigürasyonun parçasıdır ve trainable quantum parameter gerektirmez.
- Trainable quantum branch’in dört parametreli tek katmanlı ansatz’ı deterministic devreyi tutarlı biçimde geçmemektedir.
- Branch-wise normalization, quantum/classical magnitude asimetrisinin büyük bölümünü düzeltmektedir.
- Learnable \(\gamma\), normalization sonrasında kalan relative branch scale’ı tek bir parametreyle ayarlar.
- UMAP görselleri classical ve quantum latent representations’ın farklı organize olabildiğini nitel olarak göstermektedir.
- Quantitative class separability değerlendirmesi UMAP yerine AUC üzerinden yapılmalıdır.
Çalışmanın desteklemediği sonuçlar
- Gerçek kuantum bilgisayarın meme kanserini klasik bilgisayardan daha iyi sınıflandırdığı gösterilmemiştir.
- Quantum speedup veya quantum computational advantage gösterilmemiştir.
- Shot noise, decoherence ve gate error içeren fiziksel quantum hardware davranışı test edilmemiştir.
- TSHF’nin bütün veri setlerinde ve bütün metriklerde en iyi olduğu gösterilmemiştir.
- Trainable quantum circuit’in deterministic circuit’ten genel olarak üstün olduğu gösterilmemiştir.
- Formal statistical significance testi yapılmadığı için ortalama farklar p-değeriyle doğrulanmış üstünlükler değildir.
- UMAP cluster ayrışması bağımsız nicel separability kanıtı değildir.
- Kullanılan küçük veri setleri screening population’ı temsil etmez.
- External clinical validation, calibration analysis veya reader study yapılmamıştır.
- Modelin klinik kullanım için hazır olduğu gösterilmemiştir.
- 28×28 düşük çözünürlükteki başarı yüksek çözünürlüklü gerçek klinik workflow’a otomatik genellenemez.
Çalışmanın ana sınırlılıkları
- Bütün görüntüler 28×28 grayscale çözünürlüktedir.
- Test setleri yalnız 156, 96 ve 26 görüntü içerir.
- Her model yalnız beş bağımsız seed ile değerlendirilmiştir.
- Competing methods arasında formal significance testing yoktur.
- BUS-UCLM train/validation/test prevalence dağılımları belirgin biçimde farklıdır.
- Quantum circuit analytic simulation’dır; gerçek hardware noise yoktur.
- Kuantum devresi yalnız dört kübit ve tek variational layer içerir.
- External validation cohort yoktur.
- Clinical calibration analizi yoktur.
- Radiologist/reader study yoktur.
- Dataset’ler population-level screening cohort değildir.
Gelecek çalışma
Kaynak daha geniş qubit register’lar, daha derin variational circuits, fiziksel quantum hardware üzerinde execution, daha büyük ve daha yüksek çözünürlüklü veri setleri, multimodal görüntüleme, calibration analysis ve external validation önerir. Özellikle trainable quantum branch’in bu çalışmada yalnız dört parametreyle sınırlı tutulmuş olması, daha büyük ansatz’ların gerçekten ek yarar sağlayıp sağlamayacağı sorusunu açık bırakır.
Kaynak ve Yöntem Notu
Özgün başlık: On the Complementarity of Quantum and Classical Features: Adaptive Hybrid Quantum-Classical Feature Fusion for Breast Cancer Classification.
Yazarlar: Yasmin Rodrigues Sobrinho; João Renato Ribeiro Manesco; João Paulo Papa.
PDF’de kullanılan kısaltılmış yazar adları: Yasmin R. Sobrinho; João R. R. Manesco; João P. Papa.
Kurum: Department of Computing, São Paulo State University (UNESP), Bauru, SP, Brazil.
E-posta: PDF üç yazara ait yasmin.sobrinho, joao.r.manesco ve joao.papa @unesp.br adreslerini birlikte verir.
Corresponding author: Yüklenen PDF’de ayrı bir corresponding-author işareti açık biçimde belirtilmemektedir.
Eş katkı: Yüklenen PDF’de eş katkı/eş birinci yazar beyanı görünmemektedir.
Platform: arXiv.
arXiv: arXiv:2604.22903v2 [cs.CV].
İlk gönderim: 24 Nisan 2026.
v2 revizyonu: 20 Ekim 2026.
DOI: 10.48550/arXiv.2604.22903. Bu arXiv/DataCite DOI’sidir; hakemli dergi DOI’si değildir.
Hakemlik durumu: 15 Kasım 2026 itibarıyla doğrulanan güncel bibliyografik kayıt çalışmayı preprint olarak göstermektedir. ArXiv comments alanı makalenin Artificial Intelligence in Medicine dergisinde inceleme altında olduğunu belirtmektedir; ayrı bir yayımlanmış hakemli sürüm doğrulanmamıştır.
Lisans: Yüklenen PDF’de belirli lisans bildirimi görünmemektedir ve bu oturumda resmî arXiv metadata’sındaki lisans alanı güvenilir biçimde doğrulanamadığından Verianla belirli bir açık lisans varsaymamaktadır.
Çalışma türü: Methodological/exploratory hybrid quantum-classical machine-learning simulation çalışması.
Uygulama alanı: Meme görüntülerinde benign–malignant sınıflandırması.
Klasik modeller: ResNet-18 ve Shallow CNN.
Kuantum modeller: Dört-kübit deterministic/non-trainable quanvolutional feature map ve dört trainable quantum parameter içeren tek-katmanlı variational quanvolutional circuit.
Fusion stratejileri: Static Hybrid Fusion (SHF), Dynamic Hybrid Fusion (DHF), Temperature-Scaled Hybrid Fusion (TSHF).
Veri setleri: BreastMNIST, INbreast ve BUS-UCLM.
Toplam benzersiz görüntü/ROI örneklerinin doğrudan toplanması: Veri setleri farklı yapıda olduğundan çalışma tek bir birleşik klinik cohort olarak değerlendirilmemelidir; BreastMNIST 780 örnek, INbreast işlenmiş 481 ROI/sample ve BUS-UCLM 264 örnek içermektedir.
Görüntü çözünürlüğü: 28×28, tek kanal grayscale.
Quantum patch: 2×2, stride 2, dört kübit, görüntü başına 196 quantum circuit evaluation.
Quantum ölçüm: Her kübitte Pauli-\(Z\) expectation value.
Quantum simulation: PennyLane lightning.qubit, state-vector, analytic mode, no shots, CPU.
Klasik donanım: CUDA-enabled NVIDIA L40S GPU.
Framework: PyTorch + PennyLane TorchLayer.
Optimizer: Adam.
Loss: Cross-entropy.
Tekrar: Her konfigürasyon beş independent seed.
Fusion konfigürasyonları: Kaynak 36 fusion konfigürasyonu ve 12 standalone baseline değerlendirmesi raporlar.
Ana değerlendirme metrikleri: Accuracy, precision, recall, F1-score ve AUC-ROC.
Pozitif sınıf uyarısı: BreastMNIST’te positive class benign; INbreast ve BUS-UCLM’de malignant’tır. Bu nedenle precision, recall ve F1 değerleri veri setleri arasında sınıf anlamı bakımından doğrudan aynı pozitif sınıfı temsil etmez.
Formal istatistik testi: Competing methods arasında formal significance testing yapılmamıştır. Appendix E’de beş run ortalaması için %95 confidence intervals verilmiştir.
UMAP: Latent-space visualization için kullanılmıştır; kaynak UMAP’i nicel separability kanıtı olarak kabul etmez.
Computational cost sınırı: Raporlanan büyük runtime overhead CPU’daki classical quantum simulation’a aittir ve fiziksel quantum hardware runtime ölçümü değildir.
Clinical sınır: Calibration analysis, independent external cohort validation ve reader study yoktur; kaynak clinical readiness iddiasında bulunmaz.
Kod erişilebilirliği: Kaynak implementation, configuration files, experiment scripts ve INbreast/BUS-UCLM patient-level split dosyalarının kamuya açık GitHub deposunda bulunduğunu belirtmektedir.
Veri erişilebilirliği: BreastMNIST MedMNIST benchmark üzerinden; INbreast ve BUS-UCLM kendi sağlayıcılarının erişim koşulları altında alınabilir.
Finansman / teşekkür: Kaynak São Paulo Research Foundation (FAPESP) grant 2013/07375-0, 2023/14427-0, 2024/00117-0, 2024/22853-0, 2026/11390-4 ve 2025/07171-2 ile Brazilian National Council for Scientific and Technological Development (CNPq) process 308529/2021-9 desteğini belirtir.
Yazar katkıları: Yüklenen v2 PDF’de ayrı CRediT/Author Contributions bölümü görünmemektedir.
Çıkar çatışması: Yüklenen v2 PDF’de ayrı competing-interests/conflict-of-interest bildirimi bulunmamaktadır.
Etik beyan: Yüklenen v2 PDF’de ayrı ethics statement görünmemektedir. Çalışma yeni hasta verisi toplamamış, kamuya açık araştırma veri setlerini kullanmıştır; ancak Verianla kaynağın açıkça vermediği etik kurul sonucunu kendiliğinden üretmemektedir.
Kaynak-içi görsel not: Appendix A’daki precision–recall sayfalarından birinde panel başlıkları ile parsed caption arasında veri seti adı açısından tutarsız görünüm bulunmaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir