


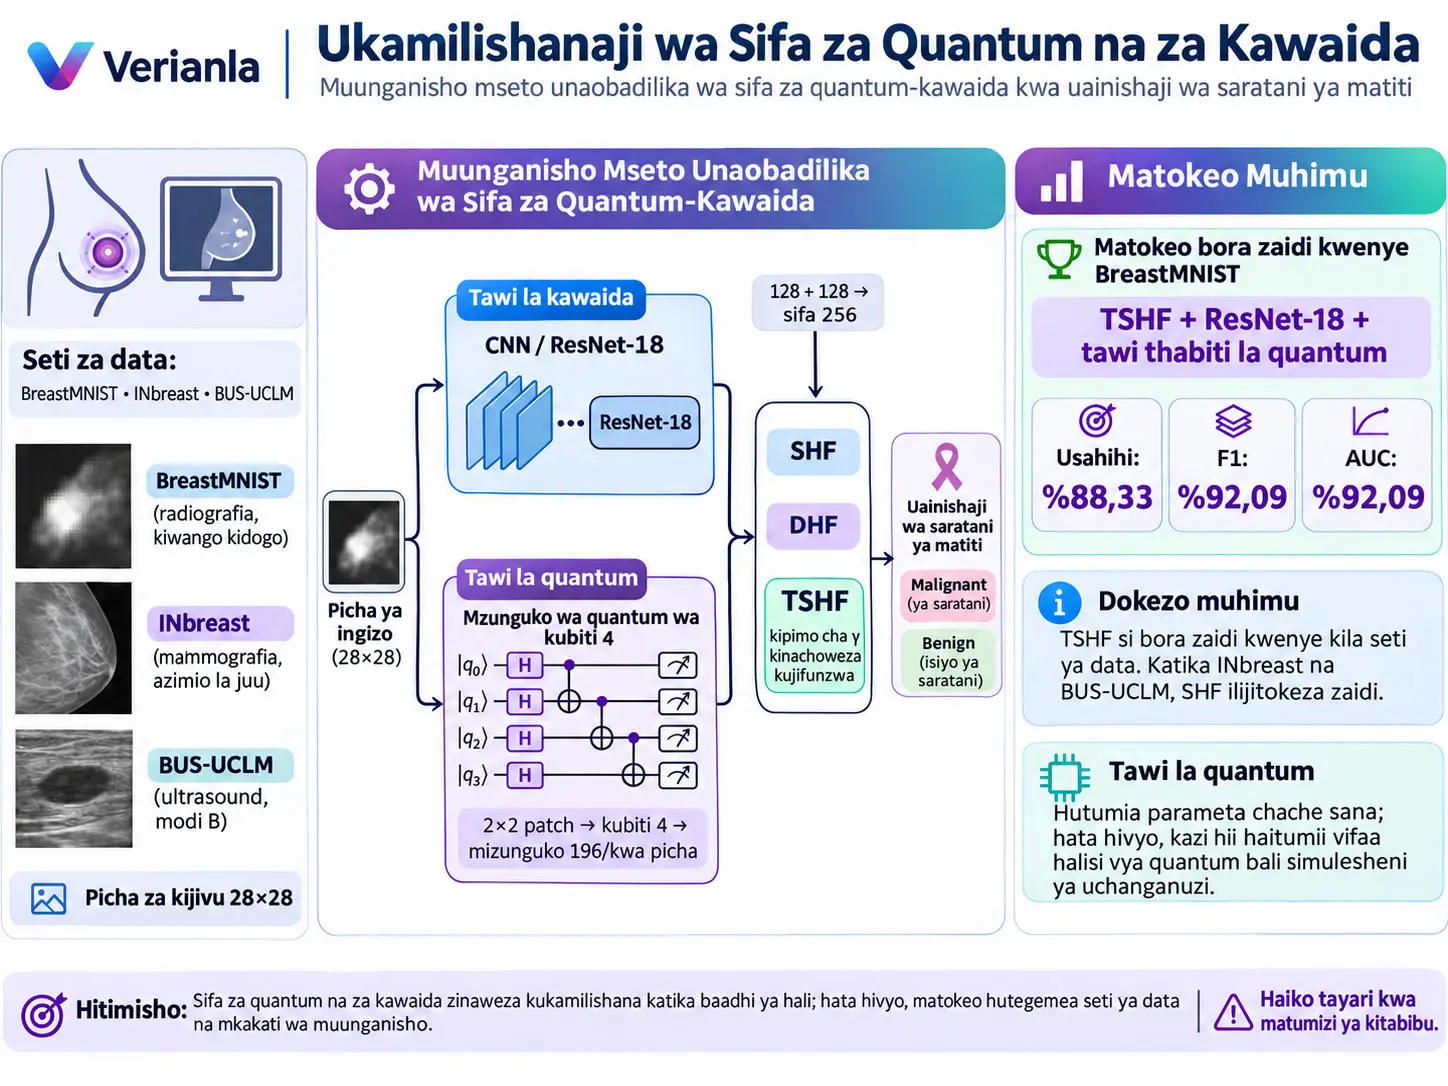
Muunganisho Mseto Unaobadilika wa Sifa za Quantum-Kawaida ni mfumo mseto wa ujifunzaji wa mashine unaochakata picha ileile ya matiti kwa sambamba kupitia mtandao wa neva wa kawaida na tawi la quantum la quanvolution lenye kubiti nne, kisha unaunganisha uwakilishi tofauti wa sifa unaozalishwa na matawi hayo mawili katika nafasi ya pamoja ya uainishaji. Utafiti unalinganisha mikakati mitatu ya fusion: Static Hybrid Fusion (SHF), ambapo sifa hutolewa mapema na classifier pekee ndiyo hufunzwa; Dynamic Hybrid Fusion (DHF), ambapo matawi mawili hufunzwa kwa pamoja end-to-end; na Temperature-Scaled Hybrid Fusion (TSHF), ambayo hupima mchango wa sifa za quantum kwa mgawo mmoja unaoweza kufunzwa \(\gamma\). Mikakati hii mitatu ilijaribiwa katika run tano huru kwa kutumia backbone mbili za kawaida, ResNet-18 na shallow CNN, matawi mawili ya quantum, trainable na deterministic/non-trainable, na seti za data za BreastMNIST, INbreast na BUS-UCLM.
Katika BreastMNIST, accuracy ya juu zaidi ilipatikana kwa modeli iliyounganisha ResNet-18 na saketi ya quantum non-trainable chini ya TSHF: accuracy ilikuwa \(88.33\%\pm2.00\), F1-score \(92.09\%\pm1.25\), na AUC-ROC \(92.09\%\pm0.44\). Katika seti hiyohiyo ya data, accuracy ya ResNet-18 pekee ilikuwa \(84.74\%\pm2.99\), na thamani ya AUC ilikuwa \(87.08\%\pm3.07\). Hata hivyo, TSHF si bora katika kila hali: katika INbreast matokeo bora yalikuwa accuracy ya \(70.42\%\pm3.73\) kwa SHF + ResNet-18 + saketi ya quantum non-trainable, na katika BUS-UCLM yalikuwa accuracy ya \(78.46\%\pm8.85\) kwa SHF + ResNet-18 + saketi trainable. Kwa hiyo utafiti hauungi mkono hitimisho kwamba “fusion inayobadilika zaidi huwa bora kila wakati”.
Tawi la quantum halipakii picha moja kwa moja kwenye quantum register kubwa. Picha ya grayscale ya 28×28 hugawanywa katika patch zisizopishana za 2×2; hivyo hutokea patch 196 kwa kila picha. Kila patch yenye pikseli nne hupakiwa kwenye kubiti nne kwa angle encoding, huchakatwa na saketi ya quantum yenye kina kifupi, na expectation value ya Pauli-\(Z\) hupimwa katika kila kubiti. Vipimo vinne huunda channel nne za sifa kwenye patch-grid. Muundo huu huitwa quanvolutional layer katika chanzo.
Moja ya matokeo yanayovutia ya utafiti ni kwamba saketi ya quantum trainable hutumia parameter nne tu za quantum zinazoweza kufunzwa, huku saketi deterministic ikiwa haina parameter yoyote ya quantum inayoweza kufunzwa. Kwa kulinganisha, backbone ya ResNet-18 inayotumiwa ina takribani parameter milioni 11,17. Lakini ufanisi huu wa parameter haumaanishi kuharakisha hesabu: kwa sababu saketi za quantum zinaendeshwa kwenye CPU kwa PennyLane lightning.qubit state-vector simulator, mafunzo ya hybrid ni polepole kwa mamia hadi maelfu ya mara kuliko classical SCNN baseline.
Matokeo ya quantum hayakupatikana kwenye physical quantum hardware halisi. Simuleringi ilifanywa katika analytic mode bila kutumia shot; shot noise, decoherence na gate error hazikuigwa. Utafiti pia unatumia seti ndogo za data za wazi zenye resolution ya 28×28 na hauna external validation katika cohort huru ya kliniki, calibration analysis wala reader study. Kwa hiyo matokeo haya si ushahidi wa ufanisi wa kifaa cha utambuzi wa kliniki au quantum computational advantage, bali ni tathmini ya kimetodolojia na ya uchunguzi ya hybrid feature fusion.
Swali kuu la utafiti
Classical convolutional neural network zina nguvu katika kujifunza sifa za kihierarkia na thabiti kijiometri kutoka kwenye picha. Saketi za quantum, kwa upande mwingine, zinaweza kuzalisha mathematical feature map tofauti kwenye ingizo lilelile. Utafiti huu unachunguza kama aina hizi mbili za uwakilishi, badala ya kuwa nakala za kila mmoja, zinaweza kukamilishana na kama ukamilishanaji huo unaweza kutoa ongezeko la utendaji linaloweza kutumika katika uainishaji wa picha za matiti.
Hipothesisi ya waandishi ni kwamba matawi ya kawaida na ya quantum hupanga picha zilezile kwa namna tofauti na kwamba kuunganisha uwakilishi huo miwili ndani ya feature space moja kunaweza kuunda muktadha tajiri zaidi kuliko tawi moja pekee. Hata hivyo, ku-concatenate feature vector mbili pekee huenda isiwe ya kutosha; ukubwa, variance na gradient dynamics za matawi ya kawaida na quantum zinapotofautiana, tawi la kawaida linaweza kufunika mchango wa tawi la quantum wakati wa mafunzo.
Quanvolutional Layer ni Nini?
Quanvolutional layer ni tabaka mseto la feature extraction linalochakata madirisha ya picha ya ndani ya classical convolution katika saketi ndogo za quantum na kuzalisha channel mpya za sifa kutoka expectation values za quantum kwa kila patch; katika utafiti huu kila patch ya picha ya 2×2 hupakiwa kwenye kubiti nne kwa angle encoding, huchakatwa katika saketi ya kubiti nne yenye kina kifupi na expectation values nne za Pauli-\(Z\) hubadilishwa kuwa sifa za kutoka.
Kubadilisha patch ya ingizo kuwa quantum register
Kwa picha ya channel moja, ikiwa ukubwa wa patch ni \(k\times k\) na idadi ya channel ni \(c=1\), idadi ya kubiti inayohitajika ni:
Katika majaribio yote ya utafiti:
Kwa hiyo pikseli nne katika kila patch ya 2×2 huamua rotation angle ya kubiti nne tofauti.
Picha ya 28×28 inapochakatwa kwa patch size 2 na stride 2, patch 14 huundwa katika kila mhimili:
patch/picha hupatikana. Kwa hiyo kuchakata kila picha kwa tawi la quantum kunahitaji quantum-circuit evaluation ndogo 196 tofauti.
Angle encoding kwa quanvolution trainable
Tengano (3) la chanzo ni:
Fomula huhesabu nini? Hufafanua input unitary inayoweka kila thamani ya pikseli iliyofanyiwa normalization ndani ya patch kwenye pembe ya mzunguko wa mhimili-\(Y\) wa kubiti tofauti.
\(x_i\): ni thamani ya pikseli ya \(i\) ndani ya patch.
\(R_Y(x_i)\): ni gate ya mzunguko kwenye kubiti ya \(i\) kuzunguka mhimili-\(Y\).
\(\bigotimes\): ni ishara ya tensor/Kronecker product inayoonyesha kwamba operesheni nne za kubiti moja hutekelezwa kwa pamoja kwenye register ya kubiti nne.
Kwa kuwa hali ya awali ni:
hali iliyokodishwa huundwa kama:
.
Variational ansatz hufanya nini?
Baada ya angle encoding, chanzo hutumia mizunguko ya parametriki \(R_X\), \(R_Y\), \(R_Z\) na variational ansatz \(U(\theta_Q)\) yenye kina kifupi inayojumuisha CNOT entangling gate:
\(\theta_Q\) ni vector ya parameter zinazoweza kufunzwa za saketi ya quantum. Saketi trainable katika utafiti huu hutumia circuit layer moja tu na trainable quantum parameter nne.
Expectation value ya Pauli-Z inakuwaje sifa?
Sifa ya kutoka ya \(i\) ya saketi trainable ni:
Fomula huhesabu nini? Baada ya saketi ya quantum kuendeshwa, kwenye kubiti ya \(i\) huhesabu expectation value ya observabla ya Pauli-\(Z\).
\(\sigma_z^{(i)}\) ni opereta ambayo kwenye kubiti ya \(i\) pekee hutumia Pauli-\(Z\), na identity kwenye kubiti nyingine.
Expectation value iko katika muda wa
. Utafiti hupitisha thamani hii kwenye ReLU na hutumia matokeo ya kila kubiti kama feature channel tofauti.
Saketi ya quantum deterministic/non-trainable inamaanisha nini?
Katika variant non-trainable, quantum rotation parameter hutolewa mara moja mwanzoni kutoka usambazaji
na hazibadilishwi wakati wa mafunzo. Ingizo bado hupelekwa kwenye saketi kwa angle encoding, lakini parameter za saketi yenyewe ya quantum hubaki fixed.
Matokeo huhesabiwa kama:
.
Kwa sababu parameter za saketi hazifanyiwi optimization:
Gradient hii ya sifuri haimaanishi kwamba “modeli haijifunzi chochote”. Quantum feature map ni fixed; lakini parameter za kawaida za projection head, fusion layer na classifier zinazotumia feature hizi zinaweza kufunzwa. Faida yake ni kuondoa kabisa quantum parameter optimization na hatari ya barren plateau.
Ukubwa wa quantum feature map
Kwa kuwa kila patch huzalisha matokeo manne na patch grid ni 14×14, quantum feature map ina:
vipimo. Kulingana na Table IV, muundo huu kisha hubadilishwa kuwa feature vector ya vipimo 784 kupitia bilinear resize, ReLU na flatten. Quantum projection head:
hutumia ubadilishaji wa mstari.
Tawi la kawaida pia huzalisha penultimate feature vector ya vipimo 128 au 512 kulingana na aina ya backbone na huichora hadi vipimo 128 kwa projection head tofauti. Hivyo matawi yote mawili huletwa kwenye feature dimension ileile kabla ya fusion.
Tofauti Kati ya SHF, DHF na TSHF ni Nini?
SHF hutoa mapema sifa za quantum na za kawaida, huzifanya frozen na hufunza fusion/classification head pekee; DHF huoptimize parameter za matawi mawili kwa pamoja end-to-end kwa kutumia kosa la uainishaji; TSHF, pamoja na mafunzo ya pamoja ya DHF, hujaribu kurekebisha kutokuwiana kwa feature-magnitude na gradient kati ya matawi mawili kwa kupima quantum feature vector iliyofanyiwa normalization kwa mgawo mmoja unaoweza kufunzwa \(\gamma\).
Static Hybrid Fusion — SHF
Quantum feature extractor:
na classical feature extractor:
huzalisha uwakilishi. Branch zote mbili huletwa kwenye ukubwa uleule wa \(d=128\) kupitia projection head tofauti na kufanyiwa \(\ell_2\)-normalization.
Uwakilishi uliounganishwa:
\(\oplus\): ni opereta ya concatenation.
Kwa kuwa vector mbili za vipimo 128 zinaunganishwa:
Katika SHF, feature extractors ni frozen katika hatua ya fusion. Gradient hairudi kwenye quantum au classical backbone; classifier/fusion head pekee ndiyo hufunzwa.
Dynamic Hybrid Fusion — DHF
DHF hutumia muundo uleule wa concatenation lakini badala ya frozen feature extraction huunda forward/backward pipeline moja. Gradient inayotoka kwenye cross-entropy loss hugawanyika kutoka classifier kwenda matawi mawili:
- kwenda kwenye parameter za \(\phi\) za branch ya kawaida,
- na, ikiwa trainable quantum branch inatumiwa, kwenda kwenye parameter za \(\theta_Q\).
Co-adaptation hii hutoa unyumbufu zaidi; lakini optimization asymmetry, ambayo chanzo kinaieleza kama tatizo kuu, hujitokeza hapa. Muundo wa gradient wa mtandao wa kawaida ulio mkubwa zaidi na wenye conditioning bora unaweza kufunika mchango wa tawi la quantum.
Temperature-Scaled Hybrid Fusion — TSHF
TSHF huongeza scalar moja inayoweza kufunzwa kwenye DHF:
\(\gamma\) ni trainable parameter moja isiyo na dimension na mwanzoni huwekwa kuwa:
. Mwanzoni hii ina maana sawa na concatenation ya kawaida.
Athari ya gradient inaonyeshwa katika Tengano (7) la chanzo kama:
.
Fomula huhesabu nini? Inaonyesha kuwa loss gradient inayorudi kwenye quantum embedding hupimwa kwa \(\gamma\).
\(\mathcal L\): ni hasara ya uainishaji.
\(h_Q\): ni quantum feature vector.
\(\gamma>1\): mambo mengine yote yakiwa sawa, huongeza kipimo cha jamaa cha quantum embedding katika forward pass na backward gradient.
\(0<\gamma<1\): hupunguza kipimo cha jamaa.
Katika utekelezaji wa chanzo, \(\gamma\) huwakilishwa katika safu ya utekelezaji kupitia \(\exp(\log\gamma)\) ili kudumisha kuwa chanya.
Kwa nini \(\ell_2\) normalization ni ya msingi?
Kusoma utaratibu wa TSHF kupitia \(\gamma\) pekee kungekuwa pungufu. Uchambuzi wa kina wa branch-norm katika usanidi bora zaidi wa BreastMNIST wa chanzo unaonyesha kwamba katika hatua ya projection output, norm ya quantum branch ni ndogo kwa utaratibu kuliko ya classical branch:
Norm ya kawaida hubadilika kwa takribani mara 52 kati ya sampuli za test, huku norm ya quantum ikibadilika takribani mara 8,6. Kabla ya normalization, uwiano wa branch hubadilika takribani katika muda wa 0,01–1,4.
Katika hali hii, sehemu ya median ya tawi la quantum katika nishati ya fused-vector ni:
pekee.
Branch-wise \(\ell_2\) normalization husawazisha norm ya feature vector zote mbili hadi thamani ya kitengo. Kisha \(\gamma\) hubaki kuwa relative scale parameter pekee.
Kwa branch mbili zilizofanyiwa normalization, sehemu ya quantum-energy katika maelezo ya Kielelezo 12 cha chanzo ni:
Kwa mfano, katika run ya uwakilishi:
sehemu ya quantum hutolewa kama takribani:
. Wastani wa run tano wa
unalingana na takribani %51,2 ya sehemu ya quantum.
Uchambuzi huu unaonyesha kwamba sehemu kubwa ya marekebisho hufanywa na \(\ell_2\) normalization, huku \(\gamma\) ikirekebisha branch balance iliyobaki baada ya normalization kwa degree of freedom moja.
Barren plateau ni nini na kwa nini ni muhimu hapa?
“Barren plateau” inayohusika katika muundo wa trainable quantum branch wa utafiti ni tatizo la training-landscape ambapo loss gradient zinaweza kuwa ndogo sana kadiri saketi ya quantum inavyopanuka au kuwa na kina zaidi, hivyo kufanya optimization kuwa ngumu. Kwa sababu hiyo waandishi huweka saketi ndogo kwa makusudi: kubiti nne, variational layer moja na quantum parameter nne pekee. Muundo huu hupunguza optimization risk, lakini pia huweka kikomo kwa representational capacity ya saketi trainable.
Kwa nini deterministic quantum feature map ina ushindani wa kushangaza?
Saketi deterministic haihitaji quantum gradient wakati wa training, haikabili barren plateau, na quantum features zinaweza kuhesabiwa mapema mara moja kwa seti ya data na kuwekwa cache. Ukweli kwamba usanidi bora zaidi wa BreastMNIST na INbreast katika utafiti unatumia non-trainable quantum branch hauungi mkono dhana kwamba “saketi ya quantum inayoweza kufunzwa huwa na nguvu zaidi kila wakati”.
Hata hivyo, chanzo hakibadilishi matokeo haya kuwa hukumu ya jumla kuhusu variational quantum circuit. Ansatz trainable iliyotumiwa ina parameter nne tu na layer moja. Trainable quantum circuits pana au zenye kina zaidi zinaweza kutoa matokeo tofauti; suala hili limeachwa kwa kazi ya baadaye.
Mbinu na Matokeo ya Utafiti
Seti tatu za data zilizotumiwa
| Seti ya data | Sehemu | Benign | Malignant | Jumla | Uwiano wa malignant |
|---|---|---|---|---|---|
| BreastMNIST | Mafunzo | 399 | 147 | 546 | %26,9 |
| BreastMNIST | Uthibitishaji | 57 | 21 | 78 | %26,9 |
| BreastMNIST | Test | 114 | 42 | 156 | %26,9 |
| BreastMNIST | Jumla | 570 | 210 | 780 | %26,9 |
| INbreast | Mafunzo | 160 | 150 | 310 | %48,4 |
| INbreast | Uthibitishaji | 38 | 37 | 75 | %49,3 |
| INbreast | Test | 50 | 46 | 96 | %47,9 |
| INbreast | Jumla | 248 | 233 | 481 | %48,4 |
| BUS-UCLM | Mafunzo | 135 | 64 | 199 | %32,2 |
| BUS-UCLM | Uthibitishaji | 32 | 7 | 39 | %17,9 |
| BUS-UCLM | Test | 7 | 19 | 26 | %73,1 |
| BUS-UCLM | Jumla | 174 | 90 | 264 | %34,1 |
BreastMNIST
BreastMNIST ni picha za native ultrasound za grayscale za 28×28 zinazotolewa na MedMNIST. Chanzo hutumia train/validation/test split rasmi bila kuibadilisha.
Katika tafsiri ya metrika za seti hii ya data kuna kanuni ya label inayohitaji uangalifu maalum: positive class ni kategoria ya benign/normal. Kwa hiyo precision, recall na F1 za BreastMNIST zimehesabiwa kwa kuzingatia sinfi ya benign.
INbreast
INbreast ni seti ya data ya mammogram za kidijitali. Chanzo hutumia expert annotation kukata suspicious tumor region. Ikiwa picha moja ina zaidi ya region of interest moja, kila eneo linaweza kuchukuliwa kama sample tofauti.
Maeneo yaliyofanyiwa crop:
- huboreshwa kwa Contrast Limited Adaptive Histogram Equalization (CLAHE),
- huwekwa katika muda wa \([0,1]\) kwa min–max normalization kwa kila picha,
- na hupimwa upya hadi ukubwa wa 28×28.
Katika INbreast, positive class ni kategoria ya malignant.
BUS-UCLM
BUS-UCLM ni picha za annotated breast-ultrasound. Chanzo hakitumii crop au CLAHE kwenye picha; kinatumia normalization na 28×28 resize pekee.
Katika BUS-UCLM pia positive class ni kategoria ya malignant.
Split za INbreast na BUS-UCLM huundwa katika patient level: sampuli kutoka kwa mgonjwa yuleyule hazigawanywi katika split zaidi ya moja. Hivyo patient leakage huzuiwa.
Kwa nini mgawanyo wa madarasa katika BUS-UCLM ni tatizo hasa?
Wakati uwiano wa malignant katika seti ya mafunzo ni %32,2, katika validation ni %17,9 na katika test ni %73,1. Chanzo kinaeleza wazi kwamba kutumia patient-level partition kwa idadi ndogo ya wagonjwa kulizalisha prevalence shift hii kubwa na kwa sababu hiyo matokeo ya BUS-UCLM yanapaswa kutathminiwa kama indicative pekee.
Kwa kuwa seti ya test ina picha 26 pekee, uainishaji mmoja usio sahihi:
husababisha mabadiliko ya accuracy point.
Normalization ya ingizo
Table IV hufafanua ingizo kwa modeli zote kama:
grayscale tensor na katika preprocessing hutoa parameter za normalization:
.
Backbone za kawaida
| Modeli | Sifa | Ukubwa wa feature | Jumla ya parameter |
|---|---|---|---|
| Shallow CNN (SCNN) | Convolution block tatu, BatchNorm, ReLU, pooling/GAP | 128 | 93.378 |
| ResNet-18 | ImageNet initialization, convolution ya kwanza imebadilishwa kwa channel moja | 512 | 11.171.266 |
Muhtasari kamili wa muundo wa quantum branch
| Kipengele | Mpangilio wa chanzo |
|---|---|
| Patch | 2×2, non-overlapping |
| Stride | 2 |
| Idadi ya patch | 196 |
| Kubiti | 4 |
| Kipimo | \(\langle Z_j\rangle,\;j=1,\ldots,4\) |
| Raw feature map | 4×14×14 |
| Post-processing | Bilinear resize + ReLU + flatten |
| Ukubwa wa flatten | 784 |
| Quantum projection | 784→128 |
| Fixed circuit trainable quantum parameter | 0 |
| Trainable circuit trainable quantum parameter | 4 |
| Variational layer | 1 |
Vipimo vya tabaka la fusion
Projection output za kawaida na quantum:
hufanyiwa normalization. Baada ya Concatenation:
Vector hii hubadilishwa kuwa score/probability output ya madarasa mawili kupitia ReLU na classifier ya 256→2.
Hyperparameter za mafunzo
| Hyperparameter | SCNN | ResNet-18 | Quantum fixed | Quantum trainable | SHF | DHF | TSHF |
|---|---|---|---|---|---|---|---|
| Epoch | 20 | 20 | 10 | 10 | 10 | 10 | 10 |
| Batch size | 16 | 16 | 16 | 16 | 16 | 16 | 16 |
| Learning rate kuu | \(10^{-3}\) | \(10^{-3}\) | \(3\times10^{-3}\) | \(10^{-2}\) | — | — | — |
| Classical branch LR | — | — | — | — | \(10^{-4}\) | \(10^{-4}\) | \(10^{-4}\) |
| Quantum branch LR | — | — | — | — | \(10^{-2}\) | \(10^{-2}\) | \(10^{-2}\) |
| Fusion head LR | — | — | — | — | \(10^{-3}\) | \(10^{-3}\) | \(10^{-1}\) |
| \(\gamma\) LR | — | — | — | — | Hakuna | Hakuna | \(10^{-2}\) |
| Fused feature dim. | — | — | — | — | 128/branch | 128/branch | 128/branch |
Modeli zote hutumia Adam optimizer na cross-entropy loss.
Mazingira ya simuleringi na maunzi
| Kipengele | Taarifa iliyotolewa katika chanzo |
|---|---|
| Classical framework | PyTorch |
| Quantum framework | PennyLane |
| Trainable integration | TorchLayer |
| Quantum backend | lightning.qubit state-vector |
| Quantum mode | Analytic mode, no shots |
| Quantum execution | CPU |
| Classical execution | CUDA-enabled NVIDIA L40S GPU |
| Marudio huru | 5 seed / configuration |
| Optimizer | Adam |
| Loss | Cross-entropy |
Matokeo ya standalone baseline
| Seti ya data | Paradigma | Modeli | Accuracy | Precision | Recall | F1 | AUC |
|---|---|---|---|---|---|---|---|
| BreastMNIST | Kawaida | SCNN | 82.82 ± 2.70 | 86.27 ± 2.26 | 91.05 ± 3.79 | 88.55 ± 1.93 | 84.49 ± 2.23 |
| BreastMNIST | Kawaida | ResNet-18 | 84.74 ± 2.99 | 88.67 ± 1.69 | 90.70 ± 2.82 | 89.67 ± 2.10 | 87.08 ± 3.07 |
| BreastMNIST | Quantum | Non-trainable | 78.21 ± 1.98 | 82.69 ± 4.80 | 89.47 ± 4.92 | 85.73 ± 0.54 | 79.42 ± 3.13 |
| BreastMNIST | Quantum | Trainable | 77.82 ± 2.06 | 81.18 ± 3.33 | 91.05 ± 4.45 | 85.71 ± 1.26 | 78.32 ± 1.67 |
| INbreast | Kawaida | SCNN | 67.92 ± 2.38 | 65.05 ± 4.16 | 73.04 ± 5.87 | 68.56 ± 1.13 | 78.78 ± 1.61 |
| INbreast | Kawaida | ResNet-18 | 68.33 ± 2.72 | 72.91 ± 13.87 | 66.09 ± 24.04 | 65.15 ± 7.93 | 77.30 ± 4.54 |
| INbreast | Quantum | Non-trainable | 69.58 ± 2.49 | 65.78 ± 2.71 | 76.52 ± 5.83 | 70.63 ± 2.85 | 78.63 ± 1.32 |
| INbreast | Quantum | Trainable | 70.00 ± 2.49 | 70.00 ± 6.74 | 68.26 ± 9.55 | 68.44 ± 1.97 | 77.15 ± 2.86 |
| BUS-UCLM | Kawaida | SCNN | 66.92 ± 9.26 | 93.20 ± 4.19 | 58.95 ± 12.57 | 71.66 ± 10.05 | 91.88 ± 3.58 |
| BUS-UCLM | Kawaida | ResNet-18 | 65.38 ± 9.02 | 95.14 ± 4.58 | 55.79 ± 13.72 | 69.36 ± 11.04 | 86.62 ± 5.27 |
| BUS-UCLM | Quantum | Non-trainable | 69.23 ± 9.02 | 97.24 ± 3.79 | 60.00 ± 14.22 | 73.15 ± 11.26 | 86.47 ± 3.94 |
| BUS-UCLM | Quantum | Trainable | 70.77 ± 15.53 | 86.67 ± 8.81 | 72.63 ± 25.35 | 76.64 ± 15.40 | 81.80 ± 12.01 |
Maana ya matokeo ya standalone
Katika BreastMNIST, ResNet-18 ya kawaida ina accuracy ya juu kwa wazi kuliko modeli za quantum-only. Katika INbreast na BUS-UCLM, standalone quantum models zinaweza kutoa matokeo ya kiwango sawa na modeli za kawaida au yaliyo juu kidogo kwa accuracy. Hata hivyo, hasa katika BUS-UCLM, standard deviation ni kubwa sana na matokeo si thabiti kwa sababu ya seti ndogo ya test.
BreastMNIST — muhtasari wa matokeo yote ya fusion
| Mkakati | Kawaida | Quantum | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 84.74 ± 2.10 | 88.88 ± 1.73 | 92.12 ± 0.18 | — |
| SHF | ResNet-18 | Non-trainable | 78.46 ± 2.89 | 85.61 ± 2.70 | 81.14 ± 1.24 | — |
| SHF | SCNN | Trainable | 80.77 ± 1.28 | 87.08 ± 1.01 | 83.56 ± 1.19 | — |
| SHF | SCNN | Non-trainable | 80.77 ± 1.50 | 86.92 ± 1.14 | 83.07 ± 0.66 | — |
| DHF | ResNet-18 | Trainable | 84.87 ± 1.79 | 89.21 ± 1.73 | 92.48 ± 0.52 | — |
| DHF | ResNet-18 | Non-trainable | 86.28 ± 2.20 | 90.22 ± 1.84 | 92.39 ± 0.24 | — |
| DHF | SCNN | Trainable | 80.00 ± 3.52 | 86.52 ± 3.54 | 82.45 ± 0.55 | — |
| DHF | SCNN | Non-trainable | 81.54 ± 1.39 | 87.62 ± 1.03 | 83.46 ± 0.86 | — |
| TSHF | ResNet-18 | Trainable | 86.15 ± 1.48 | 90.11 ± 1.26 | 92.18 ± 0.22 | 1.280 ± 0.331 |
| TSHF | ResNet-18 | Non-trainable | 88.33 ± 2.00 | 92.09 ± 1.25 | 92.09 ± 0.44 | 1.025 ± 0.039 |
| TSHF | SCNN | Trainable | 81.54 ± 0.84 | 88.10 ± 0.80 | 83.71 ± 0.64 | 0.930 ± 0.053 |
| TSHF | SCNN | Non-trainable | 81.92 ± 0.95 | 88.23 ± 0.81 | 83.29 ± 0.84 | 1.019 ± 0.057 |
Katika BreastMNIST, accuracy na F1 za juu zaidi hupatikana kwa TSHF + ResNet-18 + non-trainable. Hata hivyo, AUC ya juu zaidi ni:
katika usanidi wa DHF + ResNet-18 + trainable. Kwa hiyo hitimisho kwamba “TSHF ni bora katika metrika zote” si sahihi.
Ujumbe wa confusion matrix wa BreastMNIST
Chanzo kinaripoti katika confusion matrix zilizojumlishwa za run tano kwamba modeli bora ya TSHF inapunguza uainishaji wa sampuli malignant kama benign ikilinganishwa na standalone ResNet-18 na deterministic quantum baseline, na pia inapunguza kusogea kwa sampuli benign kwenda kwenye sinfi malignant. Kwa hiyo katika seti hii ya data, improvement haitokani tu na kusogeza operating threshold kwa manufaa ya sinfi moja, bali kutoka kupungua kwa aina zote mbili za makosa kwa pamoja.
INbreast — muhtasari wa matokeo yote ya fusion
| Mkakati | Kawaida | Quantum | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 66.87 ± 4.32 | 68.73 ± 3.57 | 79.62 ± 0.09 | — |
| SHF | ResNet-18 | Non-trainable | 70.42 ± 3.73 | 72.96 ± 1.29 | 80.28 ± 0.46 | — |
| SHF | SCNN | Trainable | 68.33 ± 0.93 | 66.55 ± 3.76 | 76.83 ± 2.20 | — |
| SHF | SCNN | Non-trainable | 68.75 ± 1.47 | 65.81 ± 3.63 | 77.70 ± 0.98 | — |
| DHF | ResNet-18 | Trainable | 67.08 ± 2.16 | 69.91 ± 2.56 | 74.67 ± 1.26 | — |
| DHF | ResNet-18 | Non-trainable | 69.79 ± 1.95 | 70.30 ± 4.09 | 76.25 ± 2.04 | — |
| DHF | SCNN | Trainable | 68.33 ± 2.51 | 65.76 ± 5.99 | 76.55 ± 2.48 | — |
| DHF | SCNN | Non-trainable | 68.54 ± 2.80 | 64.99 ± 4.79 | 77.12 ± 1.50 | — |
| TSHF | ResNet-18 | Trainable | 67.92 ± 1.55 | 69.32 ± 3.12 | 76.53 ± 1.25 | 1.080 ± 0.169 |
| TSHF | ResNet-18 | Non-trainable | 65.42 ± 3.71 | 70.72 ± 1.71 | 78.12 ± 1.22 | 1.095 ± 0.150 |
| TSHF | SCNN | Trainable | 67.71 ± 6.46 | 67.80 ± 3.07 | 75.26 ± 2.54 | 0.977 ± 0.053 |
| TSHF | SCNN | Non-trainable | 68.13 ± 3.50 | 69.36 ± 2.46 | 75.70 ± 2.76 | 1.045 ± 0.084 |
Katika INbreast, mikakati adaptive haizidi static fusion. Matokeo bora hutoka SHF inayotumia frozen feature extractors.
Uchambuzi wa confusion matrix unaonyesha kwamba faida katika seti hii ya data ina utaratibu tofauti na ule wa BreastMNIST: wakati missed malignant cases zinapungua, idadi ya false-positive katika sampuli benign huongezeka. Kwa hiyo fusion hapa hubadilisha sensitivity–specificity trade-off.
BUS-UCLM — muhtasari wa matokeo yote ya fusion
| Mkakati | Kawaida | Quantum | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 78.46 ± 8.85 | 84.66 ± 6.57 | 89.47 ± 3.28 | — |
| SHF | ResNet-18 | Non-trainable | 73.08 ± 7.69 | 78.16 ± 7.38 | 90.38 ± 2.09 | — |
| SHF | SCNN | Trainable | 62.31 ± 6.88 | 65.39 ± 7.81 | 87.52 ± 2.64 | — |
| SHF | SCNN | Non-trainable | 56.15 ± 9.65 | 56.46 ± 14.79 | 90.23 ± 4.15 | — |
| DHF | ResNet-18 | Trainable | 58.46 ± 7.40 | 61.98 ± 9.01 | 82.56 ± 6.43 | — |
| DHF | ResNet-18 | Non-trainable | 69.23 ± 9.02 | 74.41 ± 10.00 | 89.17 ± 3.39 | — |
| DHF | SCNN | Trainable | 59.23 ± 4.39 | 61.69 ± 5.64 | 89.77 ± 2.41 | — |
| DHF | SCNN | Non-trainable | 55.38 ± 5.83 | 56.10 ± 8.69 | 88.57 ± 3.66 | — |
| TSHF | ResNet-18 | Trainable | 65.38 ± 13.60 | 68.98 ± 16.03 | 83.16 ± 13.44 | 0.989 ± 0.045 |
| TSHF | ResNet-18 | Non-trainable | 53.08 ± 14.24 | 51.13 ± 24.55 | 81.95 ± 11.09 | 1.005 ± 0.024 |
| TSHF | SCNN | Trainable | 62.31 ± 15.24 | 64.45 ± 19.75 | 88.57 ± 4.13 | 0.959 ± 0.062 |
| TSHF | SCNN | Non-trainable | 54.62 ± 20.24 | 50.51 ± 33.42 | 87.67 ± 4.68 | 1.025 ± 0.045 |
Katika BUS-UCLM, accuracy na F1 bora zaidi ziko katika static fusion. Kwa upande mwingine, AUC ya juu zaidi katika seti hii ya data ni:
ya standalone SCNN. Hili pia linazuia tafsiri kwamba fusion “huongeza kila metrika”.
Kwa Nini TSHF Si Bora Katika Kila Seti ya Data?
Kalibrering ya ziada ya \(\gamma\) na end-to-end co-adaptation ya TSHF zenyewe ni degrees of freedom za ziada zinazopaswa kujifunzwa; wakati unyumbufu huu unasaidia katika sampuli 546 za mafunzo za BreastMNIST, chanzo kinaeleza kwamba katika sampuli 310 za mafunzo za INbreast na 199 za BUS-UCLM, SHF iliyo rahisi zaidi ilionyesha generalization bora na huenda seti ndogo za data hazikutoa signal ya kutosha kujifunza branch-weight calibration na optimization ya pamoja kwa kutegemewa.
Temperature scalar ablation
Chanzo kinalinganisha chaguo zifuatazo kwenye BreastMNIST + ResNet-18:
- bila scaling,
- \(\gamma=0.001\),
- \(\gamma=0.01\),
- \(\gamma=0.1\),
- \(\gamma=0.5\),
- \(\gamma=2\),
- branch-wise \(\ell_1\) normalization,
- \(\gamma\) inayoweza kufunzwa
.
Katika non-trainable quantum branch, learned TSHF hutoa:
accuracy, matokeo bora zaidi katika block hii.
Katika trainable quantum branch, \(\ell_1\) normalization hutoa:
accuracy, ambayo ni ya juu kuliko thamani ya learned TSHF:
.
Kwa hiyo learned scalar hutoa calibration mechanism ya kiotomatiki na ya vitendo, lakini haihakikishi accuracy ya juu zaidi kwa aina zote za quantum branch.
\(\gamma\) iliyojifunzwa hubadilika kwa kiasi gani?
Katika usanidi wote kumi na miwili wa TSHF, chanzo kinaripoti muda:
. Katika usanidi kumi na mmoja, thamani hubaki ndani ya takribani %10 ya hatua ya kuanzia \(1.0\).
Kwa hiyo si sahihi kutafsiri thamani ya \(\gamma\) kama “kiwango cha ugumu” cha seti ya data. Waandishi wanakataa tafsiri hii waziwazi.
Uchambuzi wa UMAP unaonyesha nini?
Chanzo hupunguza embedding za BreastMNIST, INbreast na BUS-UCLM hadi vipimo viwili kwa Uniform Manifold Approximation and Projection (UMAP). Standalone classical na quantum branches hupanga sampuli zilezile katika latent geometries tofauti; baada ya fusion, katika baadhi ya usanidi uliofanikiwa, sampuli benign na malignant hukusanyika kwa mwonekano katika maeneo yenye muundo zaidi.
Hata hivyo, waandishi wanaeleza wazi kwamba UMAP ni:
- non-linear,
- stochastic,
- hyperparameter-sensitive
visualization na haiwezi kuchukuliwa yenyewe kama metrika ya class separability. Maonyesho yanahusu run moja tu. Msingi wa madai ya quantitative separability si picha ya UMAP bali thamani za AUC.
%95 confidence intervals
Appendix E hutoa %95 confidence interval kwa wastani wa run tano huru. Hizi ni confidence interval zinazohusu wastani wa seed tano; hazipaswi kutafsiriwa kama population confidence interval juu ya maelfu ya wagonjwa huru wa kliniki.
| Seti ya data | Usanidi | Accuracy | F1 | AUC |
|---|---|---|---|---|
| BreastMNIST | TSHF + ResNet-18 + non-trainable | 88.33 [85.85, 90.81] | 92.09 [90.54, 93.64] | 92.09 [91.54, 92.64] |
| INbreast | SHF + ResNet-18 + non-trainable | 70.42 [65.79, 75.05] | 72.96 [71.36, 74.56] | 80.28 [79.71, 80.85] |
| BUS-UCLM | SHF + ResNet-18 + trainable | 78.46 [67.47, 89.45] | 84.66 [76.50, 92.82] | 89.47 [85.40, 93.54] |
Upana wa confidence interval za BUS-UCLM unalingana na sampuli ndogo ya test na mabadiliko ya seed-to-seed.
Je, formal significance test ilifanywa?
Hapana. Chanzo kinaeleza wazi kwamba formal statistical significance testing haikufanywa kati ya competing methods. Kwa hiyo tofauti za wastani wa accuracy au AUC hazipaswi kuwasilishwa kama “ubora uliothibitishwa kitakwimu”. Waandishi hutathmini tofauti kama descriptive trend na kuacha sample-level paired analysis kwa kazi ya baadaye.
Ulinganisho wa BreastMNIST na modeli mseto za awali
| Modeli / utafiti | Accuracy | F1 | AUC |
|---|---|---|---|
| Matondo et al. | 76.66 | 68.00 | Haijaripotiwa |
| Yurtseven et al. | 86.54 | 91.31 | Haijaripotiwa |
| Sobrinho et al. | 82.10 | 80.30 | 82.60 |
| Utafiti huu — SHF, ResNet-18 + trainable | 84.74 ± 2.10 | 88.88 ± 1.73 | 92.12 ± 0.18 |
| Utafiti huu — DHF, ResNet-18 + non-trainable | 86.28 ± 2.20 | 90.22 ± 1.84 | 92.39 ± 0.24 |
| Utafiti huu — TSHF, ResNet-18 + non-trainable | 88.33 ± 2.00 | 92.09 ± 1.25 | 92.09 ± 0.44 |
Kikomo muhimu cha ulinganisho ni hiki: thamani za utafiti huu ni wastani wa seed tano; thamani za tafiti za awali zinazolinganishwa katika chanzo ni ripoti za single-run. Kwa hiyo, ingawa kutumia test split ileile katika jedwali ni muhimu, protokali za majaribio si sawa kabisa.
Computational cost
| Modeli | Jumla ya parameter | Circuit / picha | Inference (ms/picha) | Training (ms/hatua) | Training slowdown dhidi ya SCNN |
|---|---|---|---|---|---|
| SCNN | 93.378 | 0 | 0.03 | 2.4 | 1× |
| ResNet-18 | 11.171.266 | 0 | 0.22 | 55 | 23× |
| QC-fixed | 1.570 | 196 | 118 | 2.357 | ≈\(9.6\times10^2\) |
| QC-trainable | 1.574 | 196 | 143 | 8.304 | ≈\(3.4\times10^3\) |
| SHF + SCNN | 210.888 | 196 | 176 | 2.864 | ≈\(1.2\times10^3\) |
| SHF + ResNet-18 | 11.337.928 | 196 | 134 | 2.140 | ≈\(8.7\times10^2\) |
| DHF + SCNN | 210.888 | 196 | 149 | 8.839 | ≈\(3.6\times10^3\) |
| DHF + ResNet-18 | 11.337.928 | 196 | 169 | 12.785 | ≈\(5.2\times10^3\) |
| TSHF + SCNN | 210.889 | 196 | 190 | 12.283 | ≈\(5.0\times10^3\) |
| TSHF + ResNet-18 | 11.337.929 | 196 | 180 | 9.442 | ≈\(3.9\times10^3\) |
Kwa kuwa TSHF huongeza learnable scalar moja tu ya ziada, haiwezi kuongeza kwa kiasi kikubwa analytical model complexity ikilinganishwa na DHF. Katika Table XI, tofauti za measured runtime kati ya DHF na TSHF hutathminiwa ndani ya run-to-run dispersion; chanzo hakitafsiri tofauti hizi za muda kama gharama ya moja kwa moja ya utaratibu wa \(\gamma\).
Je, Utafiti Huu Unathibitisha Quantum Advantage au Quantum Speedup?
Hapana; utafiti unatoa ushahidi wa kimetodolojia kwamba simulated quanvolutional feature maps za kubiti nne zinaweza kuunda uwakilishi unaokamilishana na sifa za CNN za kawaida, lakini kwa sababu hauonyeshi hesabu ya end-to-end iliyo ya haraka zaidi, nafuu zaidi au sahihi zaidi kuliko mbinu za kawaida kwenye physical quantum hardware, hauthibitishi quantum computational advantage wala quantum speedup.
Kwa nini ufanisi wa parameter si kuharakisha?
Wakati trainable quantum circuit hutumia trainable quantum parameter nne pekee, ResNet-18 ina takribani parameter milioni 11,17. Hii ni tofauti muhimu ya parameter-efficiency.
Hata hivyo, kwa sababu kila picha inahitaji quantum-circuit evaluation 196 tofauti na saketi hizi zinaendeshwa kwenye CPU kwa state-vector simulator, wall-clock runtime ni kubwa sana. Hitimisho la chanzo chenyewe ni kwamba simulated hybrid pipeline inaweza kuwa polepole hadi takribani orders of magnitude tatu kuliko SCNN ya kawaida.
Waandishi wanaeleza kwamba cost profile itakuwa tofauti kwenye quantum hardware halisi, lakini hawapimi tofauti hiyo itakuwa kubwa kiasi gani. Kwa hiyo Verianla haikadirii kwa namba kasi ya maunzi ya baadaye.
Matokeo yanayoungwa mkono na utafiti
- Classical na quantum feature representations zinaweza kupanga picha zilezile katika latent structures tofauti na tofauti hiyo inaweza kutoa signal muhimu ya fusion katika baadhi ya seti za data.
- Katika BreastMNIST, TSHF + ResNet-18 + non-trainable quantum branch ilipata accuracy, F1 na AUC za juu kuliko standalone ResNet-18.
- Katika INbreast na BUS-UCLM, accuracy bora zaidi ilitoka SHF, si adaptive TSHF.
- Faida ya adaptive fusion inategemea kiasi cha data na uchaguzi wa branch/model; si ya ulimwengu wote.
- Deterministic quantum feature map ni sehemu ya usanidi bora katika seti mbili za data na haihitaji trainable quantum parameter.
- Ansatz ya layer moja yenye parameter nne ya trainable quantum branch haizidi kwa uthabiti saketi deterministic.
- Branch-wise normalization hurekebisha sehemu kubwa ya quantum/classical magnitude asymmetry.
- Learnable \(\gamma\) hurekebisha relative branch scale iliyobaki baada ya normalization kwa parameter moja.
- Picha za UMAP zinaonyesha kwa ubora kwamba classical na quantum latent representations zinaweza kupangwa kwa namna tofauti.
- Tathmini ya quantitative class separability inapaswa kufanywa kwa AUC badala ya UMAP.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa kwamba kompyuta halisi ya quantum huainisha saratani ya matiti vizuri zaidi kuliko kompyuta ya kawaida.
- Quantum speedup au quantum computational advantage haijaonyeshwa.
- Tabia ya physical quantum hardware yenye shot noise, decoherence na gate error haijajaribiwa.
- Haijaonyeshwa kwamba TSHF ni bora katika seti zote za data na metrika zote.
- Haijaonyeshwa kwamba trainable quantum circuit kwa ujumla ni bora kuliko deterministic circuit.
- Kwa kuwa formal statistical significance testing haikufanywa, tofauti za wastani si ubora uliothibitishwa kwa p-value.
- Mgawanyiko wa cluster wa UMAP si ushahidi huru wa quantitative separability.
- Seti ndogo za data zilizotumiwa haziwakilishi screening population.
- External clinical validation, calibration analysis au reader study haikufanywa.
- Haijaonyeshwa kwamba modeli iko tayari kwa matumizi ya kliniki.
- Mafanikio katika resolution ya chini ya 28×28 hayawezi kuenezwa moja kwa moja kwa workflow halisi ya kliniki yenye resolution ya juu.
Vikwazo vikuu vya utafiti
- Picha zote zina resolution ya 28×28 grayscale.
- Seti za test zina picha 156, 96 na 26 pekee.
- Kila modeli imetathminiwa kwa seed tano huru pekee.
- Hakuna formal significance testing kati ya competing methods.
- Mgawanyo wa prevalence wa train/validation/test katika BUS-UCLM unatofautiana kwa wazi.
- Quantum circuit ni analytic simulation; hakuna real hardware noise.
- Saketi ya quantum ina kubiti nne pekee na variational layer moja.
- Hakuna external validation cohort.
- Hakuna clinical calibration analysis.
- Hakuna radiologist/reader study.
- Dataset hizi si population-level screening cohort.
Kazi ya baadaye
Chanzo kinapendekeza qubit register pana zaidi, variational circuits zenye kina zaidi, execution kwenye physical quantum hardware, seti za data kubwa zaidi na zenye resolution ya juu zaidi, multimodal imaging, calibration analysis na external validation. Hasa kwa kuwa trainable quantum branch katika utafiti huu iliwekewa kikomo cha parameter nne pekee, swali la kama ansatz kubwa zaidi zinaweza kutoa faida ya ziada kweli hubaki wazi.
Maelezo ya Chanzo na Mbinu
Kichwa asili: On the Complementarity of Quantum and Classical Features: Adaptive Hybrid Quantum-Classical Feature Fusion for Breast Cancer Classification.
Waandishi: Yasmin Rodrigues Sobrinho; João Renato Ribeiro Manesco; João Paulo Papa.
Majina yaliyofupishwa ya waandishi yaliyotumiwa katika PDF: Yasmin R. Sobrinho; João R. R. Manesco; João P. Papa.
Taasisi: Department of Computing, São Paulo State University (UNESP), Bauru, SP, Brazil.
Barua pepe: PDF hutoa kwa pamoja anwani za yasmin.sobrinho, joao.r.manesco na joao.papa @unesp.br za waandishi watatu.
Corresponding author: Katika PDF iliyopakiwa, alama tofauti ya corresponding-author haijaonyeshwa wazi.
Mchango sawa: Katika PDF iliyopakiwa, tamko la mchango sawa/uandishi wa kwanza sawa halionekani.
Jukwaa: arXiv.
arXiv: arXiv:2604.22903v2 [cs.CV].
Uwasilishaji wa kwanza: 24 Aprili 2026.
Marekebisho ya v2: 20 Oktoba 2026.
DOI: 10.48550/arXiv.2604.22903. Hii ni DOI ya arXiv/DataCite; si DOI ya jarida lililopitiwa na wenzao.
Hali ya mapitio: Rekodi ya sasa ya bibliografia iliyothibitishwa kufikia 15 Novemba 2026 inaonyesha utafiti kama preprint. Sehemu ya comments ya arXiv inaeleza kwamba makala iko chini ya ukaguzi katika jarida la Artificial Intelligence in Medicine; toleo tofauti lililochapishwa na kupitiwa na wenzao halijathibitishwa.
Leseni: Hakuna tamko maalum la leseni linaloonekana katika PDF iliyopakiwa, na kwa kuwa sehemu ya leseni katika metadata rasmi ya arXiv haikuweza kuthibitishwa kwa kutegemewa katika kipindi hiki, Verianla haidhanii leseni maalum ya wazi.
Aina ya utafiti: Methodological/exploratory hybrid quantum-classical machine-learning simulation study.
Eneo la matumizi: Uainishaji wa benign–malignant katika picha za matiti.
Modeli za kawaida: ResNet-18 na Shallow CNN.
Modeli za quantum: Quanvolutional feature map ya kubiti nne deterministic/non-trainable na variational quanvolutional circuit ya layer moja yenye trainable quantum parameter nne.
Mikakati ya fusion: Static Hybrid Fusion (SHF), Dynamic Hybrid Fusion (DHF), Temperature-Scaled Hybrid Fusion (TSHF).
Seti za data: BreastMNIST, INbreast na BUS-UCLM.
Jumla ya moja kwa moja ya picha za kipekee/sampuli za ROI: Kwa kuwa seti za data zina miundo tofauti, utafiti haupaswi kutathminiwa kama clinical cohort moja iliyounganishwa; BreastMNIST ina sampuli 780, INbreast ina ROI/sample 481 zilizochakatwa na BUS-UCLM ina sampuli 264.
Resolution ya picha: 28×28, channel moja ya grayscale.
Quantum patch: 2×2, stride 2, kubiti nne, quantum circuit evaluation 196 kwa kila picha.
Quantum measurement: Pauli-\(Z\) expectation value katika kila kubiti.
Quantum simulation: PennyLane lightning.qubit, state-vector, analytic mode, no shots, CPU.
Maunzi ya kawaida: CUDA-enabled NVIDIA L40S GPU.
Framework: PyTorch + PennyLane TorchLayer.
Optimizer: Adam.
Loss: Cross-entropy.
Marudio: independent seed tano kwa kila usanidi.
Usanidi wa fusion: Chanzo kinaripoti usanidi 36 wa fusion na tathmini 12 za standalone baseline.
Metrika kuu za tathmini: Accuracy, precision, recall, F1-score na AUC-ROC.
Onyo kuhusu positive class: Katika BreastMNIST positive class ni benign; katika INbreast na BUS-UCLM ni malignant. Kwa hiyo thamani za precision, recall na F1 katika seti hizi za data haziwakilishi moja kwa moja positive class ileile kwa maana ya darasa.
Formal statistical test: Formal significance testing haikufanywa kati ya competing methods. Appendix E hutoa %95 confidence intervals kwa wastani wa run tano.
UMAP: Ilitumika kwa latent-space visualization; chanzo hakikubali UMAP kama ushahidi wa quantitative separability.
Kikomo cha computational cost: Runtime overhead kubwa iliyoripotiwa inahusu classical quantum simulation kwenye CPU na si kipimo cha runtime cha physical quantum hardware.
Kikomo cha clinical: Hakuna calibration analysis, independent external cohort validation wala reader study; chanzo hakidai clinical readiness.
Upatikanaji wa code: Chanzo kinaeleza kwamba implementation, configuration files, experiment scripts na faili za patient-level split za INbreast/BUS-UCLM ziko katika GitHub repository ya umma.
Upatikanaji wa data: BreastMNIST inapatikana kupitia MedMNIST benchmark; INbreast na BUS-UCLM zinapatikana chini ya masharti ya ufikiaji ya watoa huduma wao.
Ufadhili / shukrani: Chanzo kinataja msaada wa São Paulo Research Foundation (FAPESP) grant 2013/07375-0, 2023/14427-0, 2024/00117-0, 2024/22853-0, 2026/11390-4 na 2025/07171-2 pamoja na Brazilian National Council for Scientific and Technological Development (CNPq) process 308529/2021-9.
Michango ya waandishi: Katika PDF ya v2 iliyopakiwa hakuna sehemu tofauti ya CRediT/Author Contributions inayoonekana.
Mgongano wa maslahi: Katika PDF ya v2 iliyopakiwa hakuna tamko tofauti la competing-interests/conflict-of-interest.
Tamko la maadili: Katika PDF ya v2 iliyopakiwa hakuna ethics statement tofauti inayoonekana. Utafiti haukukusanya data mpya za wagonjwa na ulitumia seti za data za utafiti zilizo wazi kwa umma; hata hivyo Verianla haitungi yenyewe hitimisho la kamati ya maadili ambalo chanzo hakijatoa wazi.
Dokezo la picha ndani ya chanzo: Katika mojawapo ya kurasa za precision–recall za Appendix A, kuna mwonekano wa kutolingana kwa jina la seti ya data kati ya vichwa vya panel na parsed caption.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *