


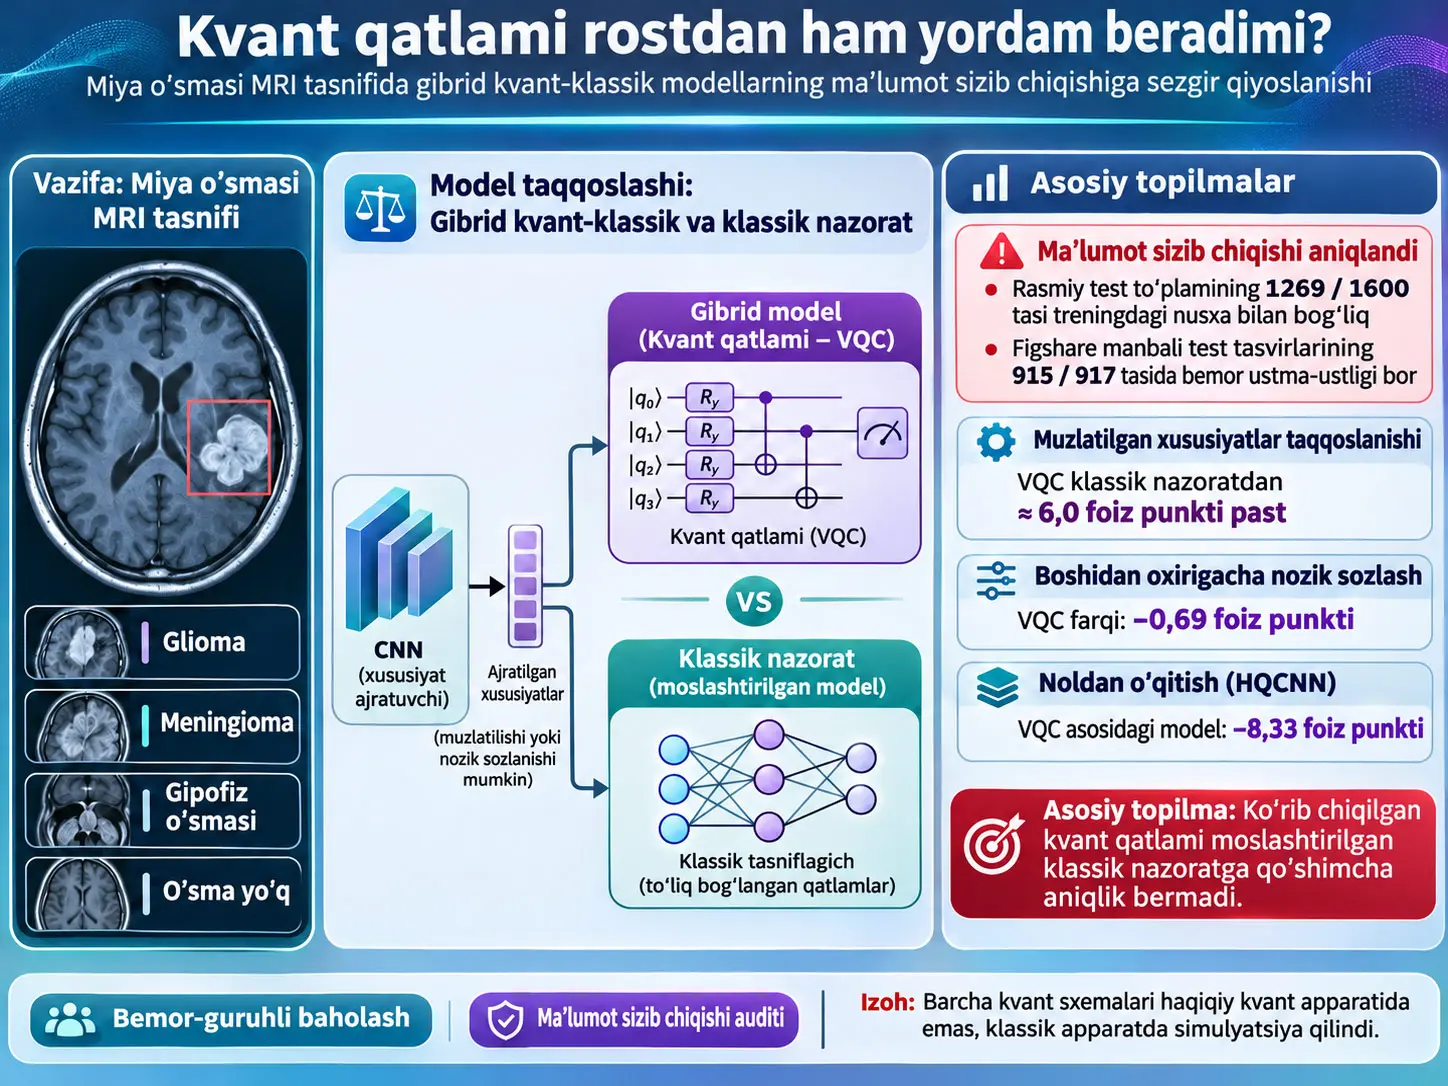
Variatsion kvant zanjiri (variational quantum circuit, VQC), klassik tasvir xususiyatlarini kvant aylanish burchaklariga kodlaydigan, oʻrganiladigan kvant darvozalari bilan shu kodlangan holatni qayta ishlaydigan va oʻlchangan Pauli-Z kutilma qiymatlarini yana klassik tasniflash qatlamiga uzatadigan parametrlangan kvant zanjiridir. Ushbu tadqiqot miya oʻsmasi magnit-rezonans tasvirlarini (magnetic resonance imaging, MRI) tasniflashda ishlatiladigan bunday VQC qatlami haqiqatan tasniflash aniqligiga hissa qoʻshadimi-yoʻqmi, uni ayni kenglik va ayni oʻqitish sharoitidagi klassik nazorat qatlamlari bilan taqqoslab sinagan. Shu bilan birga, ishlatilgan ochiq MRI maʼlumotlar toʻplamida train–test maʼlumot sizib chiqishi, bemorlar qoplanishi va tasvir manbasiga bogʻliq shortcut ishoralari batafsil tekshirilgan.
Tadqiqotda Kaggle Brain Tumor MRI Datasetning 13-fevral 2026 da eʼlon qilingan 2-versiyasi ishlatilgan. Maʼlumotlar toʻplami jami 7200 ikki oʻlchamli JPEG MRI kesimini oʻz ichiga oladi: glioma, meningioma, gipofiz oʻsmasi va oʻsmasiz boʻlgan toʻrt sinfning har birida 1800 ta tasvir bor. Rasmiy boʻlinma 5600 ta train va 1600 ta test tasviridan iborat. Manba kolleksiyalari bilan moslashtirish natijasida 4846 ta oʻsma tasviri uchun bemor identifikatori qayta tiklangan.
Maʼlumot auditi, maʼlumotlar toʻplamining rasmiy tavsifidagi “train–test qoplanishi bartaraf etilgan” degan kutilmaga qaramay, jiddiy sizib chiqish mavjudligini koʻrsatgan. Akslantirish va aylantirishga chidamli auditda 1600 rasmiy test tasvirining 1269 tasi, yaʼni taxminan %79 tasi train boʻlimidagi bir tasvir bilan bir xil duplicate guruhiga bogʻlanganligi aniqlangan. Figshare manbali 917 test tasvirining 915 tasi train boʻlimida ayni bemordan kamida bitta boshqa tasvir bilan qoplashgan. Faqat 87 ta rasmiy test tasviri aniqlangan nusxalardan ham, maʼlum bemor qoplanishidan ham mustaqil boʻlgan “strict-clean” quyi toʻplamni tashkil etgan.
Tadqiqotchilarning asosiy taqqoslashi olti qubitli, ikki variatsion qatlamli VQC head bilan ayni kirish/chiqish kengligiga ega Linear(6,6) + tanh klassik nazorat oʻrtasidadir. Muzlatilgan ImageNet xususiyatlari ustida bemor-guruhlangan besh foldli cross-validationda VQC moslashtirilgan klassik nazoratdan oʻrtacha 6,03 foiz punkti pastroq aniqlik koʻrsatgan; %95 ishonch oraligʻi −6,78 dan −5,20 foiz punktigacha. VQC, shuningdek, chuqurroq klassik nazoratdan va kvant zanjiri hisoblay oladigan funksiyalar sinfini qamrab oluvchi klassik Fourier surrogate modelidan ham pastroq aniqlik bergan.
End-to-end fine-tuningda farq kamaygan. Birinchi oʻqitish retsepti ishlatilganda EfficientNet-B0 + VQC %94,1, klassik nazorat %94,2 aniqlik bergan va ular orasidagi −0,07 foiz punkt farq ±1 foiz punktlik ekvivalentlik chegarasida qolgan. Biroq yaqinlashishga asoslangan uzoqroq oʻqitishda VQC %93,8, klassik nazorat %94,5 aniqlik bergan; VQC farqi −0,69 foiz punkti (%95 GA −1,25 dan −0,13 gacha) boʻlgan va ±1 foiz punkt chegarasida ekvivalentlik eʼlon qilinmagan. Noldan oʻqitilgan gibrid kvant–klassik CNN esa %67,9 aniqlik bilan %76,2 lik klassik nazoratdan 8,33 foiz punkt ortda qolgan.
Tadqiqot bu natijalarni “kvant mashinaviy oʻrganish hech qachon ishlamaydi” tarzida umumlashtirmaydi. Natija faqat tekshirilgan dressed VQC arxitekturasi, ishlatilgan klassik MRI maʼlumotlari, 2–10 qubit oraligʻi, tekshirilgan encoding va nazorat modellari uchun amal qiladi. Bundan tashqari, barcha kvant zanjirlari klassik kompyuterda simulyatsiya qilingan; haqiqiy kvant protsessorida oʻqitish yoki inference bajarilmagan. Hisobot qilingan aniqliklarni klinik diagnostik aniqlik deb talqin qilib boʻlmaydi.
Tadqiqotning asl savoli nima?
Gibrid kvant–klassik tasvir tasniflash tadqiqotlarida yuqori umumiy aniqlikni koʻrish kvant qatlamining haqiqatan foydali ekanini oʻz-oʻzidan koʻrsatmaydi. Chunki gibrid tarmoqning katta qismi hanuz klassik boʻlishi mumkin: tasvir xususiyatlarini chiqaradigan CNN, kvant zanjiriga kirish hosil qiladigan chiziqli proyeksiya va kvant oʻlchovlarini sinflarga aylantiradigan chiqish qatlami klassik komponentlardir.
Shuning uchun tadqiqotning markaziy savoli faqat “gibrid model necha foiz aniqlik berdi?” emas. Kuchliroq savol quyidagicha: Ayni klassik backbone, ayni maʼlumot, ayni oʻqitish protokoli va ayni bottleneck kengligi saqlanib, faqat kvant zanjiri ayni kenglikdagi klassik qatlam bilan almashtirilganda samaradorlik haqiqatan pasayadimi?
Agar javob yoʻq boʻlsa, yuqori umumiy samaradorlikni kvant qatlamiga bogʻlash mumkin emas.
Maʼlumot Sizib Chiqishi Nima va Bu Tadqiqotda Nega Kritik Muammo?
Maʼlumot sizib chiqishi — test bosqichida haqiqatan koʻrilmagan maʼlumotlarni baholash oʻrniga, oʻqitish paytida ayni tasvir, uning qayta ishlangan nusxasi yoki ayni bemordan juda oʻxshash tasvirlar modelga bilvosita koʻrsatilgan holatdir; ushbu tadqiqotda rasmiy test toʻplamining %79 tasi traindagi nusxaga bogʻlanganligi va figshare manbali 917 test tasvirining 915 tasi trainda ayni bemor bilan qoplashgani sababli yuqori test aniqliklarining muhim qismi haqiqiy umumlashtirish samaradorligini aslidan yuqori koʻrsatishi mumkinligi aniqlangan.
Aniq nusxa bilan yaqin nusxa bir xil narsa emas
Tadqiqotchilar bir nechta sizib chiqish turini alohida qidirgan.
- Exact duplicate: Piksel massivlari mutlaqo bir xil tasvirlardir. Ular dekodlangan piksel massivining MD5 checksum'i bilan aniqlangan.
- Near-duplicate: Qayta JPEG kodlangan, qayta oʻlchamlangan yoki kichik qayta ishlash farqlariga ega, ammo mohiyatan ayni tasvirni tashuvchi namunalar.
- Mirrored copy: Tasvirga gorizontal/vertikal yoki boshqa akslantirish oʻzgartirishlari qoʻllangan nusxalar.
- Rotated/flipped copy: Kvadrat tasvirning sakkiz aylantirish va akslantirish oʻzgartirishidan biri bilan olingan mos nusxalar.
- Patient overlap: Tasvirlar aynan bir xil boʻlmasa ham, train va test toʻplamlarida ayni bemorga tegishli turli MRI kesimlarining mavjudligi.
Yaqin nusxa nomzodlari 64-bit perceptual hash (pHash) bilan skaner qilingan va Hamming masofasi koʻpi bilan 8 bit boʻlishi sharti ishlatilgan. Keyin nomzod juftlarning 64 × 64 pikselli thumbnail-lari orasidagi normallashtirilgan oʻzaro korrelyatsiya (normalized cross-correlation, NCC) kamida 0,95 boʻlishi talab qilingan.
Hamming masofasi, ikki bit ketma-ketligida farq qiladigan bitlar sonidir. Masalan, ikki 64-bit pHash orasida Hamming masofasi 8 boʻlsa, 64 pozitsiyaning sakkiztasida bit qiymatlari farq qiladi. Kichik Hamming masofasi vizual tuzilmalarning oʻxshashligiga ishora qiladi; ammo u yolgʻiz yetarli deb olinmagan va NCC tasdigʻi ham qoʻllangan.
NCC, ikki tasvir naqshining chiziqli oʻxshashligini oʻlchaydigan normallashtirilgan korrelyatsiya oʻlchovidir. Tadqiqotdagi 0,95 chegarasi pHash hosil qilgan nomzodlarning haqiqatan juda oʻxshash tasvir ekanini ikkinchi marta tekshirish uchun ishlatilgan.
Akslantirish va aylantirish nega ayniqsa muhim edi?
Standart pHash akslantirish va aylantirishga invariant emas. Yaʼni MRI kesimining oyna tasviri inson koʻziga aniq ayni tasvir boʻlib koʻrinsa ham, bevosita pHash taqqoslashida yetarlicha yaqin chiqmasligi mumkin. Shu sababli tadqiqotchilar har bir tasvirning kvadrat ustidagi sakkiz aylantirish/akslantirish oʻzgartirishini baholab, eng kichik Hamming masofasi va unga mos NCC qiymatini ishlatgan.
Dastlabki audit 385 exact va 6162 near-duplicate juftini topgan boʻlsa, transformatsiyalarga chidamli qayta audit qoʻshimcha 7915 akslantirilgan va 10.161 aylantirilgan/flipped juftni aniqlagan. Jami duplicate-pair soni 24.623 ga yetgan va ularning 9699 tasi train–test chegarasini kesib oʻtgan.
| Koʻrsatkich | Manba natijasi | Izoh |
|---|---|---|
| Jami tasvir | 7200 | Toʻrt sinfning har birida 1800 ta tasvir |
| Rasmiy train / test | 5600 / 1600 | Har sinfda 1400 train + 400 test |
| Jami aniqlangan duplicate juft | 24.623 | Exact, near, mirrored va rotated/flipped juftlar yigʻindisi |
| Train–test chegarasini kesib oʻtgan duplicate juft | 9699 | Rasmiy boʻlinmaga bevosita taʼsir qiluvchi bogʻlanishlar |
| Trainda nusxasi mavjud test tasviri | 1269 / 1600 (%79) | Augmented namunalarni ham oʻz ichiga olgan qayta audit |
| Figshare manbali test tasvirlarida bemor qoplanishi | 915 / 917 | Ayni bemor train boʻlimida ham bor |
| Hech qanday nusxa yoki maʼlum bemor bogʻlanishi boʻlmagan strict-clean test | 87 | 74 glioma, 11 meningioma, 2 gipofiz oʻsmasi; oʻsmasiz namuna yoʻq |
Maʼlumot manbasi nega alohida tekshirildi?
Ayni oʻsma sinfining turli qurilmalar, turli MRI sekvensiyalari, turli tasvir matritsalari yoki turli JPEG qayta ishlash zanjirlaridan kelishi model uchun istalmagan shortcut yaratishi mumkin. Model oʻsma morfologiyasini oʻrganish oʻrniga tasvir qaysi maʼlumot manbasidan kelganini oʻrganishi mumkin.
Shu sababli tadqiqotchilar tasvir eni, balandligi, aspect ratio, 512 × 512 boʻlishi, rang rejimi, JPEG fayl hajmi, global intensivlik statistikasi va hatto oʻsmaning batafsil koʻrinishini oʻz ichiga olmaydigan atigi 8 × 8 pikselli thumbnail kabi xususiyatlar bilan gradient-boosting tasniflagichlarini oʻqitgan.
Faqat tasvir oʻlchami, aspect ratio va rang rejimidan foydalanilganda oʻsma–oʻsmasiz ajratish %91,8 aniqlik bilan bajarilgan. Faqat 8 × 8 thumbnail ishlatilganda toʻrt sinfli aniqlik %78,9 boʻlgan; tasodifiy imkon darajasi %25. Bemor-guruhlangan Protocol 3 ostida ham bu qoʻpol thumbnail %78,1 aniqlik bergan.
Tasvirlar standartlashtirilib fon, chegaralar, matritsa oʻlchami va intensivlik shkalasi kabi koʻplab ishoralar olib tashlanganidan keyin ham 8 × 8 thumbnail toʻrt sinfda %69,7 aniqlik bergan. Bu natijalar maʼlumotlar toʻplamidagi sinf yorliqlarini faqat oʻsma toʻqimasining koʻrinishidan emas, balki tasvirlash manbasi va qoʻpol anatomiya kabi boshqa signallardan ham bashorat qilish mumkinligini koʻrsatadi.
76 ta “out-of-source” glioma tasviri nega muhim?
Rasmiy test boʻlimidagi 400 glioma tasviridan 76 tasi train glioma tasvirlaridan farqli manba va tasvirlash taqsimotiga tegishli. Traindagi barcha 1400 glioma tasviri 512 × 512 figshare formatida boʻlgan, bu 76 tasvir esa 61 xil matritsa oʻlchamida boʻlgan.
Manba moslashtirish bu 76 tasvir SARTAJ kolleksiyasidagi test glioma tasvirlarining piksel nusxalari ekanini koʻrsatgan. Demak, ular nafaqat “yangi bemor”, balki model glioma sinfi uchun oʻqitish vaqtida koʻrmagan maʼlumot manbasidir.
Fine-tuned modellar umumiy bemor-guruhlangan aniqlikda taxminan %94 ga yetganiga qaramay, ushbu 76 tasvirda atigi %46,1–61,8 aniqlik koʻrsatgan. Bu farq umumiy aniqlikni maʼlumot manbasi boʻyicha ajratish nega zarurligini aniq koʻrsatadi.
Nomzod yorliq xatolari
Confident-learning skani 6997 augmented boʻlmagan tasvirning 28 tasini ehtimoliy yorliq xatosi sifatida belgilagan. Ularning 19 tasi figshare manbali. Figshare original annotatsiyasi 15 tasida mavjud yorliqni qoʻllab-quvvatlagan, toʻrt tasvirda esa model taklif qilgan muqobil sinfni qoʻllab-quvvatlagan.
Manba bu 28 tasvirni “aniq notoʻgʻri yorliq” deb atamaydi. Radiologning mustaqil koʻrigi boʻlmagani sababli ular faqat candidate label errors, yaʼni ekspert koʻrigini talab qiluvchi nomzodlar va asosiy tahlillarning hech birida maʼlumotlar toʻplamidan chiqarilmagan.
Variatsion Kvant Zanjiri Bu Modelda Aniq Nima Qiladi?
Tadqiqotdagi dressed VQC klassik CNN backbone-dan kelgan yuqori oʻlchamli xususiyatlarni avval n ta burchakka siqadi, bu burchaklarni n qubitning RY aylanishlariga kodlaydi, oʻrganiladigan bir-qubit aylanishlari va CNOT halqalari bilan qayta ishlaydi, har bir qubitda Pauli-Z kutilma qiymatini oʻlchaydi va hosil boʻlgan n ta haqiqiy sonni toʻrt MRI sinfiga tegishli klassik logitlarga aylantiradi; demak kvant zanjiri butun model emas, klassik xususiyat chiqaruvchi bilan klassik chiqish qatlami orasidagi kichik oraliq qatlamdir.
Qubit nima?
Klassik bit faqat 0 yoki 1 holatida taʼriflansa, bir qubit, oʻlchashdan oldin ikki asosiy holatning kompleks amplitudalar bilan taʼriflanadigan kvant superpozitsiyasida boʻlishi mumkin. Umumiy bir-qubit holati konseptual ravishda:
\[ |\psi\rangle=\alpha|0\rangle+\beta|1\rangle, \qquad |\alpha|^2+|\beta|^2=1 \]
koʻrinishida yozilishi mumkin. Bu ifoda tadqiqotning yangi natijasi emas; VQCdagi qubit tushunchasini tushuntiruvchi asosiy kvant mexanikasi ifodasidir.
Tenglama (1): Klassik xususiyatlar kvant burchaklariga qanday aylantiriladi?
Manbada klassik xususiyat vektoridan kvant zanjiriga kiradigan burchaklarning hosil qilinishi:
\[ \mathbf{x} = \frac{\pi}{2} \tanh(W\mathbf{f}+\mathbf{b}) \in \left(-\frac{\pi}{2},\frac{\pi}{2}\right)^n \tag{1} \]
koʻrinishidadir.
Bu yerda:
- \(\mathbf{f}\), klassik backbone-dan keluvchi \(d\)-oʻlchamli xususiyat vektoridir.
- \(W\), oʻrganiladigan chiziqli transformatsiya matritsasidir.
- \(\mathbf{b}\), oʻrganiladigan bias vektoridir.
- \(\tanh\), elementlar boʻyicha giperbolik tangens funksiyasidir.
- \(\mathbf{x}=(x_1,\ldots,x_n)\), kvant zanjiriga kodlanadigan \(n\) ta aylanish burchagini oʻz ichiga oladi.
- \(n\), ayni paytda VQCdagi qubitlar sonidir.
\(\tanh\) chiqishi −1 bilan +1 orasida boʻlgani uchun \(\pi/2\) ga koʻpaytirilganda har bir burchak \(-\pi/2\) bilan \(+\pi/2\) orasida chegaralanadi. Shunday qilib minglab klassik CNN xususiyatlari bevosita minglab qubitga yuklanmaydi; avval kichik \(n\)-oʻlchamli bottleneckka siqiladi.
Asosiy olti qubitli modelda, masalan, EfficientNet-B0 ning 1280 oʻlchamli pooled xususiyat vektori avval atigi olti burchakka qisqartiriladi. Bu oʻlchamni kamaytirishning oʻzi muhim axborot bottleneckidir va kvant zanjirining keyingi hisobini talqin qilishda hisobga olinishi kerak.
Hadamard va RY darvozalari nima qiladi?
Har bir qubit boshlangʻichda \(|0\rangle\) holatida boʻladi. Manba zanjirida avval Hadamard (\(H\)) darvozasi, keyin \(R_Y(x_i)\) aylanishi qoʻllanadi.
Hadamard darvozasi asosiy holatdagi qubitni ikki asosiy holat superpozitsiyasiga oʻtkazadi. \(R_Y(x_i)\) esa Bloch sferasida Y oʻqi atrofida \(x_i\) burchakka aylantiradi. Shu tariqa klassik xususiyatlardan olingan sonli burchak kvant holatining amplitudalariga kodlanadi.
Oʻrganiladigan Rot darvozasi
Har bir variatsion qatlamda har bir qubitga:
\[ \operatorname{Rot}(\alpha,\beta,\gamma) = R_Z(\gamma)R_Y(\beta)R_Z(\alpha) \]
koʻrinishida uchta oʻrganiladigan burchakka ega umumiy bir-qubit aylanishi qoʻllangan.
Olti qubit va ikki variatsion qatlamda har bir qubit uchun qatlam boshiga uch parametr boʻlgani sababli kvant zanjirining oʻrganiladigan parametrlar soni:
\[ 6\times2\times3=36 \]
boʻladi.
CNOT halqasi va kvant chirmashuvi
Bir-qubit aylanishlaridan soʻng qubitlar controlled-NOT (CNOT) halqasi bilan oʻzaro bogʻlangan. Halqada qubit \(i\), qubit \(i+1\) ni boshqaradi va indeks oxirgi qubitdan keyin yana birinchi qubitga qaytadi.
CNOT kabi ikki-qubit darvozalari mos kirish holatlarida qubitlar orasida kvant chirmashuvini hosil qilishi mumkin. Biroq ushbu tadqiqotning muhim ablatsiya natijalaridan biri CNOT halqasini olib tashlash aniqlikni kamaytirmagani, aksincha asosiy olti-qubit tajribasida oshirganidir. Shu sababli “chirmashuv ishlatildi, demak afzallik kvant chirmashuvidan kelgan” degan talqinni manba qoʻllab-quvvatlamaydi.
Tenglama (2): VQCning kvant holati
Manbadagi zanjir tenglamasi burchak kodlash va \(L\) variatsion qatlamni quyidagi umumiy tuzilmada ifodalaydi:
\[ |\psi(\mathbf{x};\boldsymbol{\theta})\rangle = U_{\mathrm{ent}}R(\boldsymbol{\theta}^{(L)}) \cdots U_{\mathrm{ent}}R(\boldsymbol{\theta}^{(1)}) \left[ \bigotimes_{i=1}^{n} R_Y(x_i)H \right] |0\rangle^{\otimes n} \tag{2} \]
Bu yerda:
- \(|0\rangle^{\otimes n}\), barcha \(n\) qubitning boshlangʻich holatidir.
- \(\bigotimes\), amallar turli qubitlarga tensor koʻpaytma orqali qoʻllanishini koʻrsatadi.
- \(R_Y(x_i)\), \(i\)-klassik burchakning tegishli qubitga kodlanishidir.
- \(R(\boldsymbol{\theta}^{(\ell)})\), \(\ell\)-qatlamdagi oʻrganiladigan bir-qubit aylanishlarining umumiy tuzilishini ifodalaydi.
- \(U_{\mathrm{ent}}\), CNOT halqasidan tashkil topgan chirmashuv qatlamidir.
- \(L\), variatsion qatlamlar sonidir.
- \(\boldsymbol{\theta}\), oʻrganiladigan kvant zanjiri parametrlarining barchasidir.
Asosiy modelda \(n=6\) va \(L=2\).
Zanjirdan klassik son qanday chiqadi?
Har bir qubit uchun Pauli-Z operatorining kutilma qiymati oʻlchanadi:
\[ z_i = \langle\psi(\mathbf{x};\boldsymbol{\theta})| Z_i |\psi(\mathbf{x};\boldsymbol{\theta})\rangle, \qquad z_i\in[-1,1]. \]
\(Z_i\) faqat \(i\)-qubitdagi Pauli-Z oʻlchovini ifodalaydi. Kutilma qiymat bitta oʻlchovda faqat 0 yoki 1 emas; koʻplab oʻlchovlar yoki toʻliq holat simulyatsiyasi hosil qilgan ehtimollik taqsimotidan hisoblanadigan −1 dan +1 gacha haqiqiy qiymatdir.
Olti qubitli zanjir shu tariqa oltita haqiqiy son hosil qiladi. Yakuniy klassik chiziqli qatlam bu olti qiymatni toʻrt sinfga tegishli toʻrtta logitga aylantiradi va tasniflash qarori shu klassik chiqish orqali beriladi.
Klassik nazorat nega “ayni kenglikda” boʻlishi kerak?
Olti-qubitli VQC oʻrniga juda katta yoki juda kichik klassik tarmoq qoʻyish samaradorlik farqi kvant hisoblashdanmi yoki model sigʻimidanmi kelayotganini ajratishni qiyinlashtiradi.
Asosiy klassik nazorat shu sababli VQCning olti kirish va olti chiqishiga mos Linear(6,6) + tanh ishlatgan. Olti-qubitli VQCning 36 ta oʻrganiladigan kvant parametriga nisbatan klassik oraliq qatlamda 42 parametr bor.
Tadqiqot buning ham toʻliq “ifodalash quvvati tengligi”ni taʼminlamasligini tan olgan va ikkita qoʻshimcha klassik nazoratni ishlatgan:
- Deeper control: ikkita
Linear(6,6) + tanhqatlami; 84 ta oraliq-qatlam parametri. - Fourier surrogate: VQCning bir martalik burchak kodlashida hisoblay oladigan trigonometrik funksiyalar sinfini qamrab olish uchun \(3^6=729\) ta klassik trigonometrik xususiyat.
Fourier surrogate katta ahamiyatga ega. Manbada VQCning har bir chiqishi har bir kirish burchagida chastotalari \(\{-1,0,1\}\) boʻlgan trigonometrik polinom ekani tushuntiriladi. Oltita kirish uchun mumkin boʻlgan koʻpaytma bazisining hajmi:
\[ 3^6=729 \]
boʻladi. Ushbu bazisdagi har bir xususiyat:
\[ \prod_i g_i(x_i), \qquad g_i\in\{1,\cos x_i,\sin x_i\} \]
koʻrinishida. Demak chiziqli klassik model ushbu zanjir dizayni hosil qila oladigan funksiyalar sinfini ifodalay oladi. Tadqiqotda bu surrogate VQCdan aniqroq chiqqan.
“Barren plateau” natijasi isbotlandimi?
Yoʻq. Sakkiz va oʻn qubitli zanjirlarda aniqlikning pasayishi hamda kvant modelining uzoqroq oʻqitishni talab qilishi mualliflar tomonidan kvant zanjirlarida maʼlum boʻlgan yassilashgan optimallashtirish landshaftlari bilan mos deb baholanadi; biroq tadqiqot gradient variansini toʻgʻridan-toʻgʻri oʻlchab barren plateau mavjudligini isbotlamagan.
Kvant zanjiri haqiqiy kvant qurilmada ishlatildimi?
Yoʻq. Shovqinsiz zanjirlar PyTorchda yozilgan batched state-vector simulyatori bilan klassik CPU/GPUda toʻliq simulyatsiya qilingan. Shovqinli zanjirlar density-matrix simulyatsiyasi bilan hisoblangan. PennyLane faqat ishlab chiqilgan simulyator chiqishini tekshirish uchun ishlatilgan.
Shuning uchun tadqiqotdagi 18,8 ms kabi latency qiymatlari kvant protsessorining ishlash vaqti emas. Ular RTX 3090 da kvant zanjiri simulyatsiyasini ham oʻz ichiga olgan klassik GPU forward-pass vaqtlaridir.
Depolarizing noise modeli
Shovqin tajribasida har bir qubitga har gate layerdan keyin bir-qubit depolarizatsiya kanali qoʻllangan:
\[ \rho \rightarrow (1-p)\rho + \frac{p}{3} \left( X\rho X+Y\rho Y+Z\rho Z \right). \]
Bu yerda:
- \(\rho\), qubitning density matrix holatidir.
- \(p\), ushbu qatlamda Pauli xatosi qoʻllanish ehtimolidir.
- \(X,Y,Z\), Pauli operatorlaridir.
\(p=0\) ideal shovqinsiz simulyatsiyani, kattaroq \(p\) esa kuchliroq depolarizatsiyani ifodalaydi. Manbada \(p=\{0{,}001,0{,}003,0{,}01,0{,}03,0{,}1\}\) qiymatlari sinovdan oʻtkazilgan.
Bu model haqiqiy qurilmaning barcha xato manbalarini qamrab olmaydi. Crosstalk, readout error, cheklangan ulanish topologiyasi va haqiqiy gate decomposition xarajati modelga kiritilmagan.
“Shot” nimani anglatadi?
Haqiqiy kvant kompyuterida kutilma qiymat bitta oʻlchovdan aniq olinmaydi. Ayni zanjir koʻp marta ishlatiladi va oʻlchov natijalari statistikasi qoʻllanadi. Zanjirni bir marta tayyorlab oʻlchash odatda shot deb ataladi.
Tadqiqotda finite-shot taʼsirini taqlid qilish uchun exact outcome probability taqsimotidan \(S\) ta natija namunalangan. Sinovdan oʻtkazilgan shot sonlari:
\[ S\in\{16,64,256,1024,4096\} \]
boʻlgan.
Quantum kernel nima?
Model-head tajribalaridan alohida ravishda tadqiqotchilar quantum-kernel support vector machine (SVM) bilan klassik radial basis function (RBF) kernel SVMni ham taqqoslagan.
EfficientNet-B0 xususiyatlari avval principal component analysis (PCA) bilan 4, 6, 8 yoki 10 komponentga qisqartirilgan va [0,1] oraligʻiga masshtablangan. Quantum kernel uchun ZZ feature map ishlatilgan.
Ikki kirishning kernel oʻxshashligi kvant holatlarining fidelitysi bilan aniqlangan:
\[ k(\mathbf{x},\mathbf{x}') = \left| \langle\psi(\mathbf{x})|\psi(\mathbf{x}')\rangle \right|^2. \]
Ichki koʻpaytmaning mutlaq kvadrati 0 bilan 1 orasidagi oʻxshashlik qiymatidir. Ayni kvant holatida 1 ga yetadi; holatlar farqlashgan sari kichrayishi mumkin.
Klassik taqqoslagich ayni PCA kirishlarida RBF kernel ishlatgan. Shu tariqa ikki kernel ayni past-oʻlchamli kirish axboroti ustida taqqoslangan.
Tadqiqot Usuli va Natijalari
Brain Tumor MRI Dataset 2-versiyasi
| Sinf | Train | Test | Jami |
|---|---|---|---|
| Glioma | 1400 | 400 | 1800 |
| Meningioma | 1400 | 400 | 1800 |
| Gipofiz oʻsmasi | 1400 | 400 | 1800 |
| Oʻsma yoʻq | 1400 | 400 | 1800 |
| Jami | 5600 | 1600 | 7200 |
Figshare kolleksiyasi 233 bemordan 3064 ta kontrastli T1-weighted MRI kesimini oʻz ichiga oladi va original bemor identifikatorlari bilan birga oʻsma turi hamda qoʻlda chizilgan oʻsma maskasini beradi. Tadqiqotning provenance moslashtirishi Kaggle maʼlumotlar toʻplamidagi 5400 oʻsma tasvirining 4846 tasini figshare manbali sifatida moslashtira olgan.
Qolgan oʻsma tasvirlarining manbalari SARTAJ kolleksiyasi moslashtirishlari bilan tekshirilgan. JPEG quantization table, chroma subsampling va color mode maʼlumotlari ham ishlab chiqarish/qayta ishlash zanjirining fingerprinti sifatida qayd etilgan.
Uchta baholash protokoli
| Protokol | Tuzilma | Maqsad / talqin chegarasi |
|---|---|---|
| Protocol 1 | Rasmiy 5600/1600 boʻlinishi; traindan 800 tasvir validation uchun ajratiladi | Sizib chiqish va source-shift taʼsirini oʻlchash uchun saqlangan; asosiy model taqqoslashi emas |
| Protocol 2 | Besh foldli grouped CV; dastlabki duplicate audit guruhlari foldlar orasida boʻlinmaydi | Dastlabki topshirishda ishlatilgan yondashuv; qayta auditdan keyin yetarli emasligi aniqlangan |
| Protocol 3 | Revised duplicate guruhlari + ayni figshare bemorining barcha tasvirlari birlashtirilib besh fold hosil qilinadi | Asosiy baholash protokoli; maʼlum ayni bemor yoki aniqlangan nusxa foldlar orasida oʻta olmaydi |
Protocol 3 da 6997 augmented boʻlmagan tasvirning har biri aynan bir marta out-of-fold test bashoratini oladi. Figshare manbali test tasviri uchun modelni oʻqitgan fold na bu tasvirni, na aniqlangan nusxasini, na ayni bemorning boshqa figshare tasvirini koʻrgan boʻladi.
Biroq manba muhim qoldiq cheklovni qayd etadi: figsharedan tashqari oʻsma tasvirlari va oʻsmasiz tasvirlarda bemor identifikatori yoʻq. Shu sababli duplicate detector tutmagan ayni tekshiruvga tegishli boshqa kesimlarning turli foldlarga tushish ehtimoli butunlay yoʻqotilmagan.
Frozen-feature tajribalari
Toʻrtta ImageNet-pretrained backbone faqat sobit xususiyat chiqaruvchi sifatida ishlatilgan:
| Backbone | Xususiyat oʻlchami d |
|---|---|
| EfficientNet-B0 | 1280 |
| DenseNet-121 | 1024 |
| ResNet-50 | 2048 |
| MobileNetV2 | 1280 |
Tasvirlar grayscalega aylantirilib uch kanalga nusxalangan, 256 × 256 pikselga qayta oʻlchamlangan, markazdan 224 × 224 qilib kesilgan va ImageNet statistikasi bilan normallashtirilgan. Pooled xususiyatlar har bir train foldning oʻrtacha qiymati va standart ogʻishi bilan standartlashtirilgan.
Sakkiz xil head taqqoslangan:
- 6-qubit, 2-qatlam VQC;
- moslashtirilgan klassik nazorat;
- chuqurroq klassik nazorat;
- Fourier surrogate;
- bottleneck-only;
- linear probe;
- 256 yashirin birlikli MLP;
- kvant parametrlari random boshlangʻich holatda muzlatilgan untrained VQC.
Headlar Adam optimizer bilan oʻqitilgan; weight decay \(10^{-4}\), batch size 128 va koʻpi bilan 80 epoch ishlatilgan. Validation loss besh epoch yaxshilanmasa learning rate yarmiga tushirilgan, oʻn epoch yaxshilanmasa oʻqitish toʻxtatilgan. Boshlangʻich learning rate har bir sharoitda:
\[ \{10^{-3},3\times10^{-3},10^{-2}\} \]
orasidan validation loss boʻyicha tanlangan.
Kvant Qatlami Bu Benchmarkda Haqiqatan Foyda Berdimi?
Yoʻq; tadqiqot sinagan uch asosiy oʻqitish rejimida olti-qubitli VQC ayni kenglikdagi klassik qatlam aniqligini oshirmagan: frozen-feature tajribalarida aniq ortda qolgan, end-to-end fine-tuningda taxminan ayni darajaga yaqinlashgan, biroq convergence-based oʻqitishda yana 0,69 foiz punkt past qolgan va noldan oʻqitilgan HQCNNda klassik nazoratdan 8,33 foiz punkt past aniqlik bergan; bu natija faqat tekshirilgan zanjir, maʼlumotlar toʻplami va oʻqitish protokollari uchun amal qiladi.
| Rejim | Taqqoslash | Aniqlik farqi | %95 GA | Manba talqini |
|---|---|---|---|---|
| Frozen features | VQC − moslashtirilgan klassik nazorat | −6,03 foiz punkti | −6,78 dan −5,20 gacha | Klassik nazorat 20/20 backbone–fold blokda yaxshiroq |
| Frozen features | VQC − deeper control | −4,71 foiz punkti | −5,63 dan −3,73 gacha | Klassik model 20/20 blokda yaxshiroq |
| Frozen features | VQC − Fourier surrogate | −5,27 foiz punkti | −6,20 dan −4,39 gacha | Zanjir funksiyalar sinfini qamrab oluvchi klassik surrogate yaxshiroq |
| End-to-end, Block A | VQC − klassik nazorat | −0,07 foiz punkti | −1,08 dan +1,00 gacha | ±1 pp ichida ekvivalent |
| End-to-end, Block B | VQC − klassik nazorat | −0,69 foiz punkti | −1,25 dan −0,13 gacha | ±1 pp ekvivalentligi eʼlon qilinmadi |
| Standardized images, Block C | VQC − klassik nazorat | −1,11 foiz punkti | −2,07 dan −0,20 gacha | VQC pastroq |
| From scratch | HQCNN − klassik nazorat | −8,33 foiz punkti | −12,72 dan −4,06 gacha | Klassik nazorat yaxshiroq |
Frozen-feature natijalarining tafsiloti
| Head | EfficientNet-B0 | DenseNet-121 | ResNet-50 | MobileNetV2 |
|---|---|---|---|---|
| VQC | 82,0 ± 3,4 | 79,5 ± 3,5 | 76,0 ± 4,0 | 78,5 ± 2,1 |
| Klassik nazorat | 86,4 ± 2,9 | 86,4 ± 3,1 | 83,1 ± 3,1 | 84,3 ± 3,9 |
| Deeper control | 84,4 ± 2,6 | 85,5 ± 2,8 | 81,3 ± 2,9 | 83,7 ± 3,7 |
| Fourier surrogate | 85,5 ± 3,3 | 85,4 ± 3,6 | 82,1 ± 2,6 | 84,2 ± 2,9 |
| Bottleneck only | 87,6 ± 3,2 | 87,9 ± 3,6 | 85,5 ± 2,5 | 86,4 ± 3,6 |
| Linear probe | 88,1 ± 3,0 | 88,1 ± 3,1 | 86,0 ± 2,3 | 87,1 ± 3,6 |
| MLP | 87,9 ± 2,8 | 88,8 ± 3,2 | 86,3 ± 2,1 | 87,5 ± 3,7 |
| Untrained VQC | 80,6 ± 4,5 | 78,1 ± 4,8 | 69,7 ± 3,0 | 77,0 ± 5,8 |
Bu yerdagi ± qiymatlar har bir backbone uchun besh fold boʻyicha seed-averaged aniqlikning standart ogʻishidir.
VQCning oʻqitilgani butunlay foydasiz emas: oʻqitilgan VQC random parametrlarda muzlatilgan VQCdan oʻrtacha 2,67 foiz punkt aniqroq chiqqan (%95 GA 1,11–4,24). Demak zanjir parametrlarini oʻrganish maʼlum hissa bergan; biroq bu hissa kvant qatlamini klassik nazoratlardan yuqoriga olib chiqishga yetmagan.
Qubitlar soni oshganda nima boʻldi?
EfficientNet-B0 frozen xususiyatlarida bottleneck kengligi va VQC qubit soni 2, 4, 6, 8 va 10 qilib oʻzgartirilgan.
VQC ikki va olti qubit oraligʻida taxminan %83,3–83,6 darajada qolgan, sakkiz qubitda %80,8 ga va oʻn qubitda %81,4 ga tushgan. Klassik nazorat esa kenglik ortgani sari ikki birlikda %82,0 dan sakkiz birlikda %86,6 gacha koʻtarilgan.
VQC faqat ikki qubitda klassik nazoratdan +1,3 foiz punkt yaxshiroq boʻlgan; biroq bu farq besh foldning faqat uchtasida ayni yoʻnalishda va ikkala model ham bottleneck-only headning %84,2 aniqligidan past qolgan. Manba bu natijani barqaror kvant afzalligi deb talqin qilmaydi.
Zanjir chuqurligi
Olti qubitda variatsion qatlamlar soni 1, 2, 4 va 6 qilib oʻzgartirilgan. Aniqlik bir qatlamda %83,0 dan toʻrt qatlamda %85,0 ga koʻtarilgan va olti qatlamda %84,8 boʻlgan. Bu yaxshilanishga qaramay klassik nazorat %86,7 bilan yuqoriroq qolgan.
Chirmashuv olib tashlanganda nima boʻldi?
Asosiy olti-qubit, ikki-qatlamli zanjirda CNOT halqasini butunlay olib tashlash aniqlikni %83,5 dan %86,4 ga oshirgan; standart VQCga nisbatan +2,9 foiz punkt farq bor. Chirmashuvsiz versiya klassik nazoratdan atigi −0,3 foiz punkt farq qiladi.
Bu natija “kvant chirmashuvi zararli” degan umumiy fizik xulosa emas. U faqat ushbu zanjir tuzilishi, ushbu maʼlumot ifodasi va ushbu tasniflash vazifasida CNOT halqasi oʻlchangan aniqlikka foyda bermaganini koʻrsatadi.
Data re-uploading
Har variatsion qatlamdan oldin \(R_Y(x_i)\) encodingni qayta qoʻllash, yaʼni data re-uploading, asosiy VQCning %83,5 aniqligini %78,2 ga tushirgan. Farq −5,3 foiz punkt boʻlgan va barcha besh foldda natija yomonroq chiqqan.
Maʼlumot kam boʻlganda kvant model afzallik berdimi?
Yoʻq. Aksincha, VQCning eng zaif nisbiy samaradorligi oʻqitish maʼlumotlari eng kam boʻlgan sharoitlarda kuzatilgan.
Train foldning nominal %1 qismi ishlatilganda guruh asosidagi namunalash tufayli oʻrtacha taxminan 115 ta train tasviri qolgan. Bu sharoitda:
| Model | Aniqlik |
|---|---|
| VQC | %38,6 |
| Klassik nazorat | %62,3 |
| Linear probe | %65,5 |
| MLP | %62,3 |
Shuning uchun “maʼlumot kam boʻlsa kichik kvant zanjirlari avtomatik afzallik beradi” degan faraz ushbu benchmark tomonidan qoʻllab-quvvatlanmagan.
Shovqin VQCning klassik modeldan ortda qolishini tushuntiradimi?
Yoʻq. Asosiy aniqlik farqi shovqinsiz simulyatsiyada allaqachon mavjud.
Olti-qubit, ikki-qatlamli VQC shovqinsiz holatda %83,5 aniqlik bergan, qubit va qatlam boshiga \(p=0,03\) depolarizatsiya ehtimolida esa %83,3 ga tushgan. \(p=0,1\) da aniqlik %70,2 ga tushgan.
Chuqurroq zanjirlar yuqori shovqinga sezgirroq: \(p=0,1\) da toʻrt qatlamli zanjir %31,3, olti qatlamli zanjir %24,0 aniqlikkacha tushgan; toʻrt sinfli tasodif darajasi %25.
Finite-shot simulyatsiyasida faqat 16 shot ishlatilganda asosiy olti-qubit model 1,5 foiz punkt yoʻqotgan. 1024 shot bilan, yolgʻiz yoki \(p=0,01\) depolarizatsiya bilan birga, natija shovqinsiz zanjirning 0,1 foiz punkti ichida qolgan.
Quantum kernel va RBF kernel taqqoslashi
| PCA komponenti / qubit | Quantum kernel | RBF kernel | Quantum − klassik |
|---|---|---|---|
| 4 | %72,8 | %73,3 | −0,5 pp |
| 6 | %77,7 | %78,1 | −0,4 pp |
| 8 | %79,7 | %80,8 | −1,1 pp |
| 10 | %80,9 | %81,5 | −0,6 pp |
Har ikkala kernel modeli ham toʻliq 1280-oʻlchamli EfficientNet-B0 xususiyatlarida ishlaydigan %88,0 aniqlikli linear probedan past qolgan. Mualliflar bu natijani kichik kvant zanjiriga maʼlumot yuklash uchun kerak boʻlgan oʻlchamni qisqartirish muhim samaradorlik bottleneckiga ishora qiladi deb talqin qilgan.
Kernel concentration nima edi?
Quantum fidelity kernelda sobit bandwidth 0,1 yoki undan yuqori boʻlganda qubit soni oshgan sari off-diagonal kernel entry variansi keskin kamaygan. Masalan, bandwidth 0,1 da varians toʻrt qubitda \(5.6\times10^{-2}\) boʻlsa, oʻn qubitda \(2.6\times10^{-3}\) ga tushgan.
Bandwidth 1 da ayni kattalik \(7.4\times10^{-3}\) dan \(4.5\times10^{-5}\) ga tushgan. Bu xatti-harakat fidelity kernellarda maʼlum kernel concentration bilan mos keladi.
Validation 20 fold–width kombinatsiyasining 15 tasida eng kichik bandwidth 0,03 ni tanlagan. Biroq toʻrt qubitda shu bandwidth bilan off-diagonal kernel oʻrtachasi 0,92 boʻlgani uchun kernel boshqa chekka muammoga, yaʼni koʻplab namuna juftlarining bir-biriga juda oʻxshash koʻrinishiga yaqinlashgan.
End-to-end fine-tuning
Fine-tuning tajribalarida ImageNet-pretrained EfficientNet-B0, ResNet-50, DenseNet-121, MobileNetV2, ConvNeXt-Tiny va ViT-Small/16 backbone-lari baholangan. VQC va moslashtirilgan klassik nazoratning bevosita taqqoslashi EfficientNet-B0 ustida bajarilgan.
Block A: birinchi oʻqitish retsepti
AdamW optimizer, weight decay 0,05, %10 warm-up bilan one-cycle learning-rate schedule, head uchun \(10^{-3}\), backbone uchun \(3\times10^{-4}\) peak learning rate, batch size 32 va label smoothing 0,05 ishlatilgan. Oʻqitish koʻpi bilan 30 epoch davom etgan va validation loss olti epoch yaxshilanmasa toʻxtatilgan.
Augmentation random resized crop (scale 0,8–1,0; aspect ratio 0,9–1,1), horizontal flip, ±10° rotatsiya va 0,15 brightness/contrast jitterni oʻz ichiga olgan.
Block B: yaqinlashishga asoslangan oʻqitish
Ikki epoch chiziqli warm-up ishlatilgan, validation loss uch epoch yaxshilanmasa learning rate yarmiga tushirilgan, oʻn epoch yaxshilanish boʻlmasa early stopping qoʻllangan va maksimum 80 epoch belgilangan.
Head learning rate:
\[ \{3\times10^{-4},10^{-3},3\times10^{-3}\} \]
orasidan birinchi foldning validation setida tanlangan; backbone learning rate head tezligining 0,3 baravariga sozlangan. Tanlangan learning rate besh fold va ikki seed davomida ishlatilgan.
Block C: standartlashtirilgan tasvirlar
Fon, chegaralar, overlaylar, matritsa oʻlchami va global intensivlik shkalasi kabi manba shortcutlarini kamaytirish uchun head mask yaratilgan, tasvir maska hududiga kesilgan, kvadratga pad qilingan, maska ichidagi 1.–99. percentil oraligʻiga koʻra intensity rescale qilingan va 256 × 256 pikselga qayta oʻlchamlangan.
Manba ishonchli 2B skull stripping boʻlmagani uchun kalla tasvirda qolganini ochiq qayd etadi. Demak standartlashtirish barcha manba/shortcut axborotini olib tashlamagan.
End-to-end asosiy samaradorlik natijalari
| Rejim | VQC | Klassik nazorat | Linear head |
|---|---|---|---|
| Block A | %94,1 | %94,2 | %94,5 |
| Block B | %93,8 | %94,5 | %94,5 |
| Block C, standardized | %93,6 | %94,7 | %94,3 |
Block A da VQC bilan klassik nazorat orasidagi %95 ishonch oraligʻi −1,08 dan +1,00 pp gacha. %90 ishonch oraligʻi −0,93 dan +0,82 pp gacha toʻliq ±1 pp ekvivalentlik hududida qolganligi uchun manba bu ikki modelni ±1 foiz punkt darajasida ekvivalent deb qabul qilgan.
Block B da VQC − klassik nazorat farqi −0,69 pp. %90 ishonch oraligʻi −1,16 dan −0,22 gacha boʻlib −1 pp chegarasidan oʻtgani sababli ±1 pp ekvivalentligi eʼlon qilinmagan. Ekvivalentlik eʼlon qilinishi mumkin boʻlgan eng kichik margin 1,16 pp.
Bu farq muhim: statistik jihatdan ahamiyatli farq topilmagani bilan modellar ekvivalent ekanini koʻrsatish bir xil narsa emas. Shu sababli tadqiqot faqat p qiymatiga emas, oldindan belgilangan ±1 pp equivalence margin va %90 ishonch oraligʻiga qaragan.
Fine-tuning xarajati
| Model | Oʻrtacha toʻxtash epochi | Training vaqti / run | Bitta tasvir latency | Peak GPU memory |
|---|---|---|---|---|
| VQC | 38,8 | 12,8 daq | 18,8 ms | 1461 MB |
| Klassik nazorat | 26,0 | 6,8 daq | 11,3 ms | 1461 MB |
| Deeper control | 29,1 | 7,7 daq | 11,2 ms | 1461 MB |
| Fourier surrogate | 22,3 | 6,0 daq | 11,7 ms | 1461 MB |
| Linear head | 23,2 | 6,0 daq | 10,7 ms | 1461 MB |
Bu vaqtlar haqiqiy kvant qurilmasi xarajatlari emas. Kvant zanjiri klassik GPUda simulyatsiya qilingani sababli faqat tadqiqot implementation xarajatini koʻrsatadi.
Noldan oʻqitilgan HQCNN
Manba avvalgi gibrid tadqiqotlarning koʻpiga yaqinroq ssenariyni sinash uchun pretrained backbone ishlatmasdan noldan gibrid kvant–klassik CNNni ham oʻqitgan.
Encoder uch blokdan iborat:
- 3 × 3 convolution, 64 kanal + batch normalization + ReLU + 2 × 2 max pooling;
- 3 × 3 convolution, 128 kanal + batch normalization + ReLU + 2 × 2 max pooling;
- 3 × 3 convolution, 256 kanal + batch normalization + ReLU + 2 × 2 max pooling.
Shundan soʻng global average pooling, 256 → 6 chiziqli burchak proyeksiyasi, olti-qubitli ikki-qatlamli VQC, 64 va 32 birlikli klassik dense qatlamlar hamda toʻrt sinfli chiqish keladi.
HQCNNning jami 375.950 ta oʻrganiladigan parametridan faqat 36 tasi kvant zanjirida. Moslashtirilgan klassik nazorat VQC oʻrniga Linear(6,6)+tanh ishlatadi va jami 375.956 parametrga ega.
Natija:
HQCNN: %67,9 aniqlik (%95 GA 63,5–72,1).
Klassik nazorat: %76,2 aniqlik (%95 GA 72,7–79,6).
Farq −8,33 foiz punkt (%95 GA −12,72 dan −4,06 gacha; McNemar \(p=1.6\times10^{-41}\)).
Maʼlumot sizib chiqishi aniqlikni qancha oshirdi?
Tadqiqotchilar ayni modellar va ayni tasvirlarni faqat fold guruhlash qoidalarini oʻzgartirib Protocol 2 va Protocol 3 ostida oʻqitgan. Bu yondashuv sizib chiqish taʼsirini yanada bevosita ajratishni maqsad qilgan.
| Model guruhi / tasvir bogʻlanishi | Protocol 2 → Protocol 3 aniqlik oʻzgarishi |
|---|---|
| Frozen-feature headlar, umumiy | −3,3 dan −7,8 pp gacha |
| Frozen, Protocol 2 training foldida nusxasi mavjud tasvirlar | −3,9 dan −9,6 pp gacha |
| Frozen, faqat ayni bemor bogʻlanishi boʻlgan tasvirlar | −2,3 dan −6,9 pp gacha |
| Frozen, bogʻlanmagan 750 tasvir | −5,5 dan +3,5 pp gacha; oʻrtacha −0,4 pp |
| Fine-tuned modellar, umumiy | −3,3 dan −3,6 pp gacha |
| Fine-tuned, nusxasi mavjud tasvirlar | −3,7 dan −4,0 pp gacha |
| Fine-tuned, faqat ayni bemor bogʻlanishi | −3,5 dan −4,6 pp gacha |
Sizib chiqish taʼsirining asosan training fold bilan nusxa yoki bemor bogʻlanishi mavjud tasvirlarda toʻplanishi kuzatilgan aniqlik pasayishi faqat tasodifiy fold oʻzgarishidan kelmaganini qoʻllab-quvvatlaydi.
Lesion occlusion tajribasi
Figshare manbali test oʻsmalarida qoʻlda chizilgan oʻsma maskasi 8 piksel kengaytirilgan va bu hudud kallaning qolgan qismidagi median intensity bilan toʻldirilgan. Model avval normal, occlusion qilinmagan tasvirlarda oʻqitilgan.
Oʻsma hududining koʻrinishi olib tashlanganda:
- klassik nazorat %85,6 dan %83,0 ga,
- linear probe %87,3 dan %84,7 ga,
- VQC %80,6 dan %78,9 ga
tushgan.
Boshqacha aytganda, oʻsmaning tasvir intensivligi olib tashlanganiga qaramay aniqlik atigi bir necha foiz punkt pasaygan. Bu modellar oʻsma toʻqimasining vizual koʻrinishidan tashqarida qoladigan anatomiya, manba va lezyon geometriyasi kabi maʼlumotlardan sezilarli foydalanayotganiga ishora qiladi.
Biroq occluded hudud butunlay axborotsiz emas: oʻsma maskasining joylashuvi, oʻlchami va shakli saqlanadi. Darhaqiqat, faqat 16 × 16 oʻlchamga kichraytirilgan oʻsma maskasi bilan oʻqitilgan logistic regression ham oʻsma sinfini %61,4 aniqlik bilan bashorat qilgan. Shu sababli occlusion natijasi “model oʻsmadan umuman foydalanmaydi” degani emas.
Manbalararo umumlashtirish
Faqat figshare manbali uch oʻsma sinfida bemor-guruhlangan oʻqitish bajarilganda VQC %80,8, klassik nazorat %86,4 va linear probe %87,5 aniqlik bergan.
Figshare oʻsmalarida oʻqitilib, bogʻlanmagan SARTAJ oʻsmalarida test qilinganda barcha headlar taxminan tasodif darajasiga yaqinlashgan:
\[ 36.1\%-38.8\% \]
toʻrt backbone oʻrtachasi oraligʻidadir; uch sinfli tasodif darajasi %33,3.
Shu sababli manba kvant va klassik headlarning ikkalasi ham acquisition-source oʻzgarishiga qarshi zaif transfer koʻrsatishini qayd etadi.
Grad-CAM nimani koʻrsatdi?
Gradient-weighted Class Activation Mapping (Grad-CAM) CNN bashoratini qoʻllab-quvvatlaydigan fazoviy hududlarning gradientga asoslangan ahamiyat xaritasini hosil qiladi. Manba buni “model nega qaror qildi?” savolining aniq javobi sifatida emas, modelning bashorat bilan bogʻliq faollashuvi qayerda jamlanganini koʻrsatuvchi izohlash vositasi sifatida ishlatgan.
Birinchi folddagi 1400 test tasvirida Grad-CAM energiyasining median tarzda kalla maskasi ichida qolgan ulushi:
| Model | Median ulush |
|---|---|
| ResNet-50 linear | %95 |
| EfficientNet-B0 linear | %80 |
| EfficientNet-B0 klassik nazorat | %89 |
| EfficientNet-B0 VQC | %85 |
| HQCNN | %52 |
VQCda non-zero Grad-CAM xaritasi boʻlgan tasvirlarning %28 tasida energiyaning yarmidan kami kalla maskasi ichida qolgan; klassik nazoratda bu ulush %10, linear headda %0,2. Biroq Grad-CAM sababiy izoh bermagani uchun bu farq oʻz-oʻzidan model “nimani oʻrganganini” aniq belgilamaydi.
Statistik tahlil qanday bajarildi?
Tadqiqot faqat bitta aniqlik foizini hisobot qilish oʻrniga koʻp qatlamli statistikani ishlatgan.
Frozen-feature taqqoslashlarda toʻrt backbone × besh fold = 20 backbone–fold bloki bor. Seedlar blok ichida oʻrtachalashtirilgan. Headlar orasidagi juftlangan farqlar Wilcoxon signed-rank testi bilan baholangan, oʻrtacha farqlar uchun bootstrap %95 ishonch intervallari hisoblangan va barcha headlar Friedman testi bilan taqqoslangan.
Fold va backbonelar butunlay mustaqil boʻlmagani uchun qoʻshimcha:
- backbone va backbone ichidagi fold uchun random interceptli linear mixed model,
- repeated cross-validation uchun variance-corrected resampled t-test,
- bemor va duplicate guruhlarini qayta namunalaydigan image-level cluster bootstrap
qoʻllangan.
End-to-end modellarda atigi besh fold boʻlgani uchun fold-level Wilcoxon testi juda past rezolyutsiyaga ega; besh juftda erishiladigan eng kichik ikki tomonlama p qiymati 0,0625. Shu sababli modellarning out-of-fold bashoratlari tasvir darajasida birlashtirilib exact McNemar testi ishlatilgan.
Bemor va duplicate tasvirlarni mustaqil deb boʻlmagani sababli aniqlik va paired-difference %95 ishonch intervallari bemor/duplicate guruhlarini qayta namunalaydigan cluster bootstrap bilan hisoblangan. Asosiy baholashlarda 5000 bootstrap namunasi, ayrim sinf-spetsifik va sizib chiqish quyi toʻplamlarida 2000 namuna ishlatilgan.
±1 foiz punkt ekvivalentlik testi nimani anglatadi?
Ikki model orasida “ahamiyatli farq topmadik” deyish ularning amalda ekvivalent ekanini isbotlamaydi. Manba shuning uchun ikki model farqining %90 ishonch oraligʻi toʻliq:
\[ [-1,+1]\ \text{yüzde puanı} \]
oraligʻida qolishini ekvivalentlik mezoni sifatida ishlatgan. Bu \(\alpha=0,05\) darajasidagi ikki bir tomonlama ekvivalentlik testiga mos keladi.
±1 pp chegarasi fizik tabiat doimiysi emas; tadqiqotchilar oldindan tanlagan amaliy margindir. Manba margin tanlovi konvensiya ekanini ochiq tan olgan va har bir taqqoslash uchun ekvivalentlik eʼlon qilinishi mumkin boʻlgan eng kichik marginni ham alohida hisobot qilgan.
Tadqiqot qoʻllab-quvvatlaydigan natijalar
- Kaggle Brain Tumor MRI Dataset 2-versiyasining rasmiy train/test boʻlimlari jiddiy tasvir va bemor qoplanishini oʻz ichiga oladi.
- Rasmiy test tasvirlarining %79 tasi train boʻlimidagi tasvir bilan duplicate guruhini baham koʻradi.
- Figshare manbali test tasvirlarining 915/917 tasi trainda ayni bemor bilan qoplanadi.
- Bemor-guruhlangan baholash frozen-feature aniqligini taxminan 3,3–7,8 pp va fine-tuned aniqligini taxminan 3,3–3,6 pp kamaytirgan.
- Olti-qubit VQC frozen xususiyatlarda ayni kenglikdagi klassik nazoratdan taxminan 6,0 pp past aniqlik bergan.
- Fine-tuning VQCning klassik nazorat bilan farqini taxminan 1 pp yoki undan pastga tushirgan, biroq yaqinlashishga asoslangan oʻqitishda VQC ustunlik koʻrsatmagan.
- Noldan oʻqitilgan HQCNN klassik nazoratdan 8,33 pp past aniqlik bergan.
- Tekshirilgan ablatsiyada chirmashuv darvozalarini olib tashlash aniqlikni kamaytirmagan, oshirgan.
- Tekshirilgan quantum kernel barcha PCA oʻlchamlarida RBF kerneldan biroz past aniqlik bergan.
- Kam oʻqitish maʼlumoti sharoitida VQC klassik nazoratlardan yomonroq ishlagan.
- Moderate depolarizing noise asosiy kvant–klassik farqni tushuntirmaydi; farq shovqinsiz simulyatsiyada ham bor.
- Tasvir manbasiga bogʻliq shortcutlar kuchli va boshqa manbaga umumlashtirish barcha modellar uchun zaif.
Tadqiqot qoʻllab-quvvatlamaydigan natijalar
- “Kvant mashinaviy oʻrganish hech bir tibbiy tasvirlash vazifasida ishlamaydi” degan xulosa chiqarib boʻlmaydi.
- Haqiqiy kvant qurilmasi bu vazifada sekinroq yoki tezroq ekanini ushbu simulyatsiya vaqtlaridan chiqarib boʻlmaydi.
- 10 qubitdan katta zanjirlar yoki boshqa encoding/ansatz arxitekturalarining samaradorligi ushbu tadqiqotda sinovdan oʻtkazilmagan.
- Quantum convolutional networks haqida umumiy muvaffaqiyatsizlik xulosasi chiqarib boʻlmaydi.
- Bu tadqiqot klinik miya oʻsmasi tashxis qurilmasini tasdiqlash emas.
- %94 atrofidagi fine-tuned aniqliklar real kasalxona diagnostik aniqligi bahosi emas.
- Slice-level tasniflash examination-level yoki patient-level klinik tashxis bilan bir xil emas.
- Out-of-source glioma xatolarining barchasi model xatosi deb boʻlmaydi; ayrim yorliqlar ham muammoli boʻlishi mumkin va radiolog koʻrigi qilinmagan.
- Grad-CAM xaritalari model qarorining sababiy izohi emas.
- Lesion occlusion tajribasi model oʻsma axborotidan umuman foydalanmasligini koʻrsatmaydi; lezyon joylashuvi, oʻlchami va shakli saqlangan.
- Barren plateau toʻgʻridan-toʻgʻri oʻlchanib isbotlanmagan.
Tadqiqotning kuchli tomonlari
Birinchi kuchli tomon kvant modelini aloqasiz CNN bilan emas, ayni kenglik va ayni protokoldagi klassik nazorat bilan taqqoslashidir. Shu tariqa umumiy tarmoq samaradorligi oʻrniga kvant oraliq qatlamining marginal hissasi tekshirilgan.
Ikkinchi kuchli tomon faqat parametrlar sonini moslashtirish bilan cheklanmay, chuqurroq klassik nazorat va zanjir funksiyalar sinfini qamrab oluvchi Fourier surrogateni ishlatganidir.
Uchinchi kuchli tomon maʼlumotlar toʻplamidagi nusxalarni faqat exact checksum bilan qidirmay, akslantirish va aylantirishga chidamli pHash + NCC usuli bilan skaner qilgani va mumkin tasvirlar uchun original figshare bemor identifikatorlarini qayta tiklaganidir.
Toʻrtinchi kuchli tomon kvant zanjirini frozen features, end-to-end fine-tuning va training from scratch kabi uch xil rejimda sinaganidir.
Beshinchi kuchli tomon qubit soni, circuit depth, entanglement, data re-uploading, training-data fraction, depolarizing noise va shot count ablatsiyalarini birgalikda tekshirganidir.
Oltinchi kuchli tomon faqat umumiy aniqlik oʻrniga acquisition source, shortcut, lesion occlusion, cross-source transfer va Grad-CAM tahlillari orqali model aslida nimadan foydalanayotgan boʻlishi mumkinligini tekshirganidir.
Cheklovlar
Bitta maʼlumotlar toʻplami: Tadqiqot bitta ochiq, ikki oʻlchamli MRI benchmarkiga asoslangan. Natijalarni boshqa kasalliklar, boshqa tasvirlash vazifalari yoki 3B MRI hajmlariga avtomatik koʻchirish mumkin emas.
Yetishmaydigan bemor identifikatorlari: Bemor identifikatori faqat 4846 figshare manbali oʻsma tasviri uchun qayta tiklangan. Boshqa oʻsma va oʻsmasiz tasvirlarda guruhlash duplicate detectionga bogʻliq; aniqlanmagan ayni-tekshiruv kesimlarining turli foldlarda boʻlishi butunlay inkor etilmaydi.
Haqiqiy kvant qurilmasi yoʻq: Barcha zanjirlar simulyatsiya qilingan. Ishlatilgan noise model crosstalk, readout error, limited connectivity va haqiqiy gate decomposition xarajatlarini oʻz ichiga olmaydi.
Cheklangan zanjir oilasi: Dressed VQClar koʻpi bilan oʻn qubit va bitta asosiy encoding yondashuvi bilan tekshirilgan. Boshqa encodinglar, kattaroq zanjirlar va kvant maʼlumotida ishlaydigan boshqa arxitekturalar boshqacha xatti-harakat qilishi mumkin.
Hyperparameter qidiruvi cheklangan: End-to-end asosiy taqqoslashda ikki seed/fold va birinchi foldda uch learning-rate nomzodidan tanlash ishlatilgan. Kengroq qidiruv kichik farqlarni oʻzgartirishi mumkin.
Standartlashtirish barcha shortcutlarni olib tashlamaydi: Head masking kallani olib tashlamagan. Coarse anatomy va imaging plane axboroti qolgan.
Grad-CAM cheklovi: Grad-CAM model qayerga qarayotganiga oid taxminiy fazoviy ishora beradi; qaror mexanizmini tushuntirmaydi.
Yorliqni tekshirish: Candidate label errors va 76 out-of-source glioma tasviri mustaqil radiolog tomonidan qayta yorliqlanmagan.
Klinik doira
Manba hisobot qilingan aniqliklar klinik diagnostik aniqlik emasligini ochiq taʼkidlaydi. Klinik daʼvo uchun kamida slice-level oʻrniga examination-level kirishlar, barcha sinflar uchun bemor ajratilishi, gistopatologiya yoki ekspert konsensusi kabi referens standart, oʻsmasiz guruhning oʻsma guruhi bilan ayni klinik populyatsiyadan kelishi va mustaqil koʻp-markazli tekshiruv kerak.
Shuning uchun ushbu tadqiqot mavzusi “MRI da miya oʻsmasini %94 aniqlik bilan tashxislaydigan kvant tizimi” emas. Tadqiqotning asl mavzusi, kvant oraliq qatlami moslashtirilgan klassik nazoratga nisbatan qoʻshimcha tasniflash qiymati beradimi va maʼlumot sizib chiqishi bunday benchmarklarni qanday chalgʻitishi mumkinligidir.
Manba va Usul Haqida Izoh
Asl sarlavha: Does the Quantum Layer Help? A Leakage-Aware Benchmark of Hybrid Quantum–Classical Models for Brain Tumor MRI Classification
Mualliflar: Tuan-Linh Duong; Pande Wikantyasa Maswita; Tony Sumaryada; Sitti Yani; Thanh-Tai Duong; Hiba Omer; Nissren Tamam; Abdelmoneim Sulieman.
Mualliflar tartibi: Manba PDF va rasmiy nashr qaydi bilan mos.
Teng hissa: Manbada teng birinchi mualliflik/teng hissa belgisi bildirilmagan.
Masʼul muallif: Thanh-Tai Duong.
Muassasa 1: The Laboratory Center, Hanoi University of Public Health, Hanoi 100000, Vietnam.
Muassasa 2: Department of Physics, Faculty of Mathematics and Natural Sciences, IPB University, Bogor 16680, Indonesia.
Muassasa 3: Department of Medical Physics, Faculty of Medicine, Nguyen Tat Thanh University, Ho Chi Minh City 700000, Vietnam.
Muassasa 4: Department of Radiological Sciences, College of Applied Medical Sciences, Imam Abdulrahman Bin Faisal University, Dammam 34212, Saudi Arabia.
Muassasa 5: Department of Physics, College of Sciences, Princess Nourah bint Abdulrahman University, Riyadh 11671, Saudi Arabia.
Muassasa 6: Department of Radiological Sciences, College of Applied Medical Sciences, King Saud bin Abdulaziz University for Health Sciences, Al Ahsa 31982, Saudi Arabia.
Muassasa 7: Imaging Physics Section, Research and Innovation Department, King Faisal Specialist Hospital & Research Center, Riyadh 11211, Saudi Arabia.
Manba turi: Taqrizli original tadqiqot maqolasi.
Jurnal: Diagnostics.
Nashriyot: MDPI.
Jild / son / maqola raqami: 16 / 21 / 3485.
DOI: 10.3390/diagnostics16213485.
Qabul qilingan sana: 7-oktabr 2026.
Reviziya: 17-oktabr 2026.
Qabul: 21-oktabr 2026.
Nashr: 24-oktabr 2026.
Taqriz holati: Taqrizli jurnal maqolasi.
Litsenziya: Creative Commons Attribution (CC BY).
Rasmiy nashr: Diagnostics 2026, 16, 3485; DOI 10.3390/diagnostics16213485.
Asosiy ilmiy soha: Quantum machine learning, medical image classification, deep learning benchmarking va data-leakage auditing.
Asosiy vazifa: Glioma, meningioma, gipofiz oʻsmasi va oʻsmasiz MRI kesimlarini toʻrt sinfli tasniflash.
Asosiy kvant modeli: Angle encoding ishlatadigan, olti-qubit va ikki variatsion qatlamli hardware-efficient dressed VQC; ablatsiyalarda 2–10 qubit va 1–6 qatlam baholangan.
Haqiqiy kvant qurilmasi: Ishlatilmagan. Barcha kvant zanjirlari klassik qurilmada simulyatsiya qilingan.
Asosiy baholash protokoli: Patient-grouped five-fold cross-validation (Protocol 3).
Asosiy natija: Tekshirilgan VQC qatlami sinovdan oʻtkazilgan uch asosiy oʻqitish rejimida moslashtirilgan klassik qatlam aniqligini oshirmagan.
Maʼlumotlar toʻplamining asosiy muammosi: Rasmiy test tasvirlarining %79 tasi train boʻlimidagi nusxa bilan bogʻlangan va figshare manbali test tasvirlarining 915/917 tasi trainda ayni bemor bilan qoplanadi.
Statistika: Frozen-feature taqqoslashlarda Wilcoxon signed-rank, Friedman testi, bootstrap %95 GA, linear mixed model va variance-corrected resampled t-test; end-to-end taqqoslashlarda exact McNemar, patient/duplicate-group cluster bootstrap va ±1 pp equivalence margin ishlatilgan.
Implementation: Python, PyTorch 2.14.0, timm 1.0.30, scikit-learn 1.8.0; PennyLane 0.45.1 faqat simulyatorni tekshirish uchun ishlatilgan. End-to-end oʻqitish NVIDIA GeForce RTX 3090 24 GB GPUda bajarilgan.
Generative AI ishlatish bayonoti: Manba Claude Opus model oilasi tahlil kodini yozish va debug qilish hamda statistik tahlillarni bajarishda mualliflar yoʻnaltirishi ostida ishlatilganini; tahlillar mualliflar tomonidan belgilanganini, kod va natijalar tekshirilganini va kod eʼlon qilinganini bildiradi.
Maʼlumotlarning mavjudligi: Brain Tumor MRI Dataset 2-versiyasi Kaggle da ochiq; maʼlumotlar toʻplami DOI si 10.34740/KAGGLE/DSV/2645886. Maqola maʼlumotlar toʻplami 28-sentabr 2026 da yuklab olinganini bildiradi. Dataset audit kodi, quantum circuit simulator, self-testlar, tajribalar, statistik tahlillar, leakage-aware splitlar, duplicate/patient annotations, checksum manifest, model bashoratlari va natija jadvallari mualliflar koʻrsatgan GitHub repositoriyida eʼlon qilingan. Maʼlumotlar toʻplami tasvirlarining oʻzi qayta tarqatilmaydi.
Etika kengashi: Faqat ochiq va toʻliq anonimlashtirilgan maʼlumotlar ishlatilgani uchun etik koʻrib chiqish va tasdiqdan voz kechilgan.
Bemor roziligi: Faqat ochiq, anonimlashtirilgan tasvirlar ishlatilgani uchun rozilikdan voz kechilgan.
Moliyalashtirish: Princess Nourah bint Abdulrahman University Researchers Supporting Project, PNURSP2026R12. Maqola processing fee si ham Princess Nourah bint Abdulrahman University tomonidan moliyalashtirilgan.
Manfaatlar toʻqnashuvi: Mualliflar manfaatlar toʻqnashuvini bildirmagan. Moliyalashtiruvchilarning tadqiqot dizayni, maʼlumot yigʻish/tahlil/talqin, yozish yoki nashr qarorida roli boʻlmagani qayd etilgan.
Muallif hissalari: Conceptualization: P.W.M., T.-L.D., S.Y., T.-T.D.; methodology: P.W.M., T.-L.D.; software: P.W.M., T.-L.D.; formal analysis: T.-L.D.; investigation: P.W.M., T.-L.D., T.S.; data curation: T.-L.D.; visualization: T.-L.D.; original draft: P.W.M., T.-L.D.; review and editing: barcha mualliflar; supervision: S.Y., T.S., T.-T.D.; project administration: S.Y.; funding acquisition: S.Y., N.T.
Asosiy talqin chegarasi: Natijalar ushbu maʼlumotlar toʻplami va sinovdan oʻtkazilgan kichik simulyatsiya qilingan VQC oilasida kvant qatlami qoʻshimcha aniqlik bermaganini koʻrsatadi. Tadqiqot barcha quantum machine learning modellarini, haqiqiy kvant qurilmasini yoki klinik MRI tashxisini umuman inkor etmaydi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan