


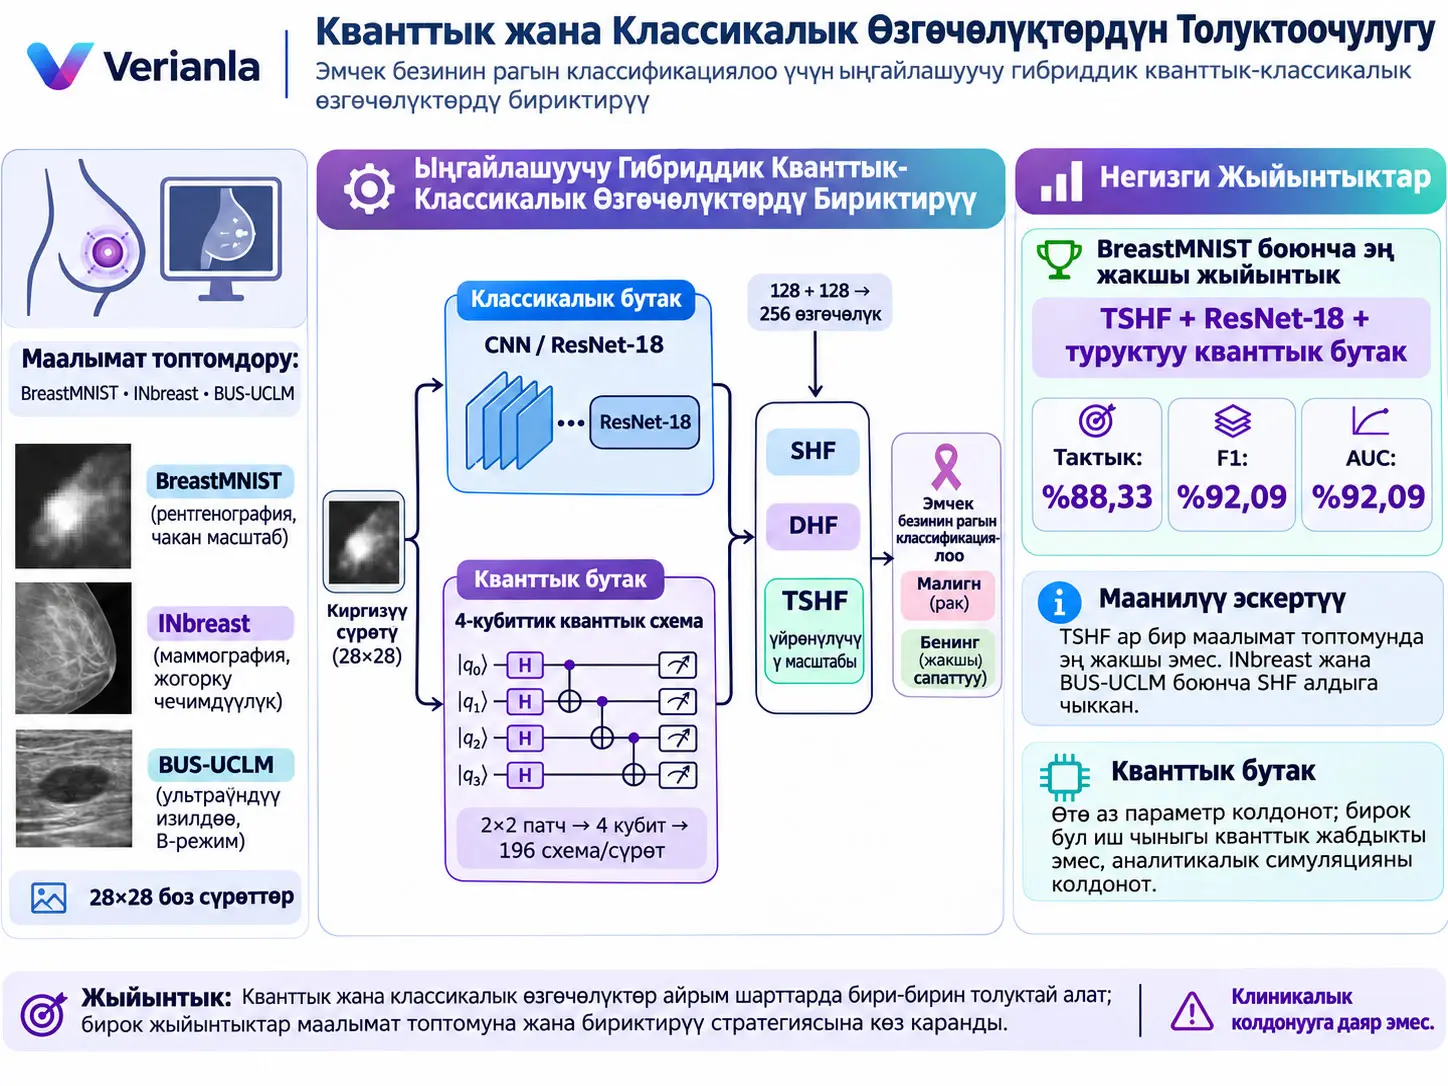
Ыңгайлашуучу Гибриддик Кванттык-Классикалык Өзгөчөлүктөрдү Бириктирүү — бир эле эмчек сүрөтүн параллелдүү классикалык нейрон тармагы жана төрт кубиттик quanvolutional кванттык бутак менен иштетип, эки бутак түзгөн ар башка өзгөчөлүк өкүлчүлүктөрүн жалпы классификация мейкиндигинде бириктирген гибриддик машиналык үйрөнүү алкагы. Изилдөө үч бириктирүү стратегиясын салыштырат: өзгөчөлүктөр алдын ала чыгарылып, классификатор гана окутулган Static Hybrid Fusion (SHF), эки бутак башынан аягына чейин чогуу окутулган Dynamic Hybrid Fusion (DHF) жана кванттык өзгөчөлүктөрдүн салымын бир үйрөтүлүүчү \(\gamma\) коэффициенти менен масштабдаган Temperature-Scaled Hybrid Fusion (TSHF). Үч стратегия ResNet-18 жана shallow CNN болгон эки классикалык backbone, trainable жана deterministic/non-trainable болгон эки кванттык бутак, ошондой эле BreastMNIST, INbreast жана BUS-UCLM маалымат топтомдорунда беш көз карандысыз иштетүү менен сыналган.
BreastMNISTте эң жогорку тактык ResNet-18ди non-trainable кванттык схема менен TSHF ичинде бириктирген моделде алынган: тактык \(88.33\%\pm2.00\), F1-score \(92.09\%\pm1.25\) жана AUC-ROC \(92.09\%\pm0.44\). Ошол эле маалымат топтомунда бир гана ResNet-18дин тактыгы \(84.74\%\pm2.99\), AUC мааниси \(87.08\%\pm3.07\). Бирок TSHF бардык шартта эң жакшы эмес: INbreastте эң жакшы жыйынтык SHF + ResNet-18 + non-trainable кванттык схема менен \(70.42\%\pm3.73\) тактык, BUS-UCLMде болсо SHF + ResNet-18 + trainable схема менен \(78.46\%\pm8.85\) тактык болуп табылган. Демек, изилдөө “көбүрөөк ыңгайлашуучу бириктирүү дайыма жакшы” деген жыйынтыкты колдобойт.
Кванттык бутак сүрөттү түздөн-түз чоң кванттык registerге жүктөбөйт. 28×28 боз-деңгээлдүү сүрөт non-overlapping 2×2 patchтерге бөлүнөт; ошентип ар бир сүрөт үчүн 196 patch пайда болот. Ар бир төрт пикселдүү patch төрт кубитке бурчтук коддоо аркылуу жайгаштырылат, тайыз кванттык схема менен иштетилет жана ар бир кубитте Pauli-\(Z\) күтүү мааниси өлчөнөт. Төрт өлчөө patch-grid үстүндө төрт өзгөчөлүк каналын түзөт. Бул түзүлүш булакта quanvolutional layer деп аталат.
Изилдөөнүн көңүл бурарлык жыйынтыктарынын бири trainable кванттык схема болгону төрт үйрөтүлүүчү кванттык параметрди колдонгону, ал эми deterministic схемада эч кандай үйрөтүлүүчү кванттык параметр жок экени. Мунун ордуна колдонулган ResNet-18 backbone болжол менен 11,17 миллион параметрге ээ. Бирок мындай параметр натыйжалуулугу эсептөөнүн ылдамдашы дегенди билдирбейт: кванттык схемалар PennyLane lightning.qubit state-vector simulator үстүндө CPUда иштетилгендиктен, гибриддик окутуу классикалык SCNN baselineга караганда жүздөгөндөн миңдеген эсеге чейин жайыраак.
Кванттык жыйынтыктар реалдуу физикалык кванттык жабдыкта алынган эмес. Симуляция analytic mode режиминде жана shot колдонулбастан жүргүзүлгөн; shot noise, decoherence жана gate error моделденген эмес. Изилдөө ошондой эле 28×28 чечилишиндеги кичине ачык маалымат топтомдорун колдонот жана көз карандысыз клиникалык когортто external validation, calibration analysis же reader study камтыбайт. Ошондуктан жыйынтыктар клиникалык диагностикалык түзмөктүн натыйжалуулугунун же quantum computational advantageдын далили эмес, гибриддик өзгөчөлүктөрдү бириктирүүнүн методологиялык жана изилдөөчү мүнөздөгү баалоосу.
Изилдөөнүн негизги суроосу
Классикалык convolutional neural networkтер сүрөттөрдөн иерархиялык жана мейкиндик жагынан туруктуу өзгөчөлүктөрдү үйрөнүүдө күчтүү. Кванттык схемалар болсо ошол эле киргизүүдө башка математикалык feature map түзө алат. Бул изилдөө эки өкүлчүлүк түрү бири-биринин көчүрмөсү болбостон бири-бирин толуктайбы жана бул толуктоочулук эмчек сүрөттөрүн классификациялоодо колдонууга жарактуу натыйжалуулук өсүшүн бере алабы деген суроону изилдейт.
Авторлордун гипотезасы — классикалык жана кванттык бутактар ошол эле сүрөттөрдү ар башкача уюштурат жана эки өкүлчүлүктү бир feature space ичинде бириктирүү бир гана бутак бере алгандан байыраак контекст түзүшү мүмкүн. Бирок эки feature vectorду жөн гана concatenate кылуу жетишсиз болушу мүмкүн; классикалык жана кванттык бутактардын чоңдуктары, дисперсиялары жана gradient динамикалары айырмаланганда окутуу маалында классикалык бутак кванттык бутактын салымын басып калышы мүмкүн.
Quanvolutional Катмар Деген Эмне?
Quanvolutional катмар — классикалык convolution операциясындагы жергиликтүү сүрөт терезелерин кичине кванттык схемаларда иштетип, ар бир patch үчүн кванттык күтүү маанилеринен жаңы өзгөчөлүк каналдарын түзгөн гибриддик feature-extraction катмар; бул изилдөөдө ар бир 2×2 сүрөт patchи төрт кубитке бурчтук коддоо менен жүктөлүп, төрт кубиттик тайыз схемада иштетилет жана төрт Pauli-\(Z\) күтүү мааниси чыгыш өзгөчөлүгүнө айландырылат.
Киргизүү patchин кванттык registerге айландыруу
Бир каналдуу сүрөт үчүн patch өлчөмү \(k\times k\) жана канал саны \(c=1\) болгондо керектүү кубит саны:
Изилдөөнүн бардык эксперименттеринде:
Башкача айтканда, ар бир 2×2 patch ичиндеги төрт пиксел төрт өзүнчө кубиттин rotation angleын аныктайт.
28×28 сүрөт patch size 2 жана stride 2 менен иштетилгенде ар бир огу боюнча 14 patch пайда болот:
patch/сүрөт алынат. Ошондуктан ар бир сүрөттү кванттык бутак менен иштетүү 196 өзүнчө кичине quantum-circuit evaluation талап кылат.
Trainable quanvolution үчүн бурчтук коддоо
Булактын Теңдеме (3)ү:
Формула эмнени эсептейт? Patch ичиндеги ар бир нормалдаштырылган пиксел маанисин өзүнчө кубиттин \(Y\)-огу боюнча айлануу бурчуна жайгаштырган киргизүү unitaryсин аныктайт.
\(x_i\): Patch ичиндеги \(i\)-чи пикселдин мааниси.
\(R_Y(x_i)\): \(i\)-чи кубитте \(Y\)-огунун айланасындагы айлануу gateи.
\(\bigotimes\): Төрт бир-кубиттик операциянын чогуу төрт-кубиттик register үстүндө колдонулушун көрсөткөн tensor/Kronecker product белгиси.
Баштапкы абал:
болгондуктан коддолгон абал:
түрүндө пайда болот.
Variational ansatz эмне кылат?
Бурчтук коддоодон кийин булакта \(R_X\), \(R_Y\), \(R_Z\) параметрдик айлануулары жана CNOT чырмалыштыруучу gateи камтылган тайыз variational ansatz \(U(\theta_Q)\) колдонулат:
\(\theta_Q\) — кванттык схеманын үйрөтүлүүчү параметр вектору. Бул изилдөөдөгү trainable схема бир гана circuit layer жана төрт trainable quantum parameter колдонот.
Pauli-Z күтүү мааниси кантип өзгөчөлүккө айланат?
Trainable схеманын \(i\)-чи чыгыш өзгөчөлүгү:
Формула эмнени эсептейт? Кванттык схема иштетилгенден кийин \(i\)-чи кубиттеги Pauli-\(Z\) observableдын күтүү маанисин эсептейт.
\(\sigma_z^{(i)}\) — \(i\)-чи кубитке гана Pauli-\(Z\) колдонгон, башка кубиттерде identity болгон оператор.
Күтүү мааниси
аралыгында болот. Изилдөө бул маанини ReLU операциясынан өткөрүп, ар бир кубиттин чыгышын өзүнчө feature channel катары колдонот.
Deterministic/non-trainable кванттык схема эмнени билдирет?
Non-trainable вариантта quantum rotation parameterлар башында
бөлүштүрүүдөн бир жолу тандалып, окутуу маалында өзгөртүлбөйт. Киргизүү дагы angle encoding аркылуу схемага берилет, бирок кванттык схеманын өз параметрлери туруктуу калат.
Чыгыш:
түрүндө эсептелет.
Схеманын параметрлери оптималдаштырылбагандыктан:
Бул нөл gradient “модель эч нерсе үйрөнбөйт” дегенди билдирбейт. Quantum feature map туруктуу; бирок бул featureларды колдонгон projection head, fusion layer жана classifierдын классикалык параметрлери үйрөтүлө алат. Артыкчылыгы — quantum parameter optimization жана barren-plateau коркунучу толугу менен жоюлат.
Quantum feature mapтын өлчөмү
Ар бир patch төрт чыгыш чыгаргандыктан жана patch grid 14×14 болгондуктан quantum feature map:
өлчөмүндө болот. Table IV боюнча бул түзүлүш андан кийин bilinear resize, ReLU жана flatten операциялары менен 784 өлчөмдүү feature vectorго айландырылат. Quantum projection head:
сызыктуу өзгөртүүнү колдонот.
Классикалык бутак да backbone түрүнө жараша 128 же 512 өлчөмдүү penultimate feature vector түзүп, өзүнчө projection head менен 128 өлчөмгө дал келтирилет. Ошентип эки бутак бириктирүүдөн мурда бирдей feature dimensionга келтирилет.
SHF, DHF жана TSHF Ортосундагы Айырма Эмне?
SHF кванттык жана классикалык өзгөчөлүктөрдү алдын ала чыгарып, тоңдуруп коёт жана fusion/classification headти гана окутат; DHF эки бутактын параметрлерин классификация катасы менен чогуу башынан аягына чейин оптималдаштырат; TSHF болсо DHFнин биргелешкен окутуусуна кошумча нормалдаштырылган кванттык feature vectorду бир үйрөтүлүүчү \(\gamma\) коэффициенти менен масштабдап, эки бутактын ортосундагы feature-magnitude жана gradient теңсиздигин жөнгө салууга аракет кылат.
Static Hybrid Fusion — SHF
Кванттык feature extractor:
жана классикалык feature extractor:
өкүлчүлүктөрдү түзөт. Эки branch тең өзүнчө projection head аркылуу бирдей \(d=128\) өлчөмгө келтирилип, \(\ell_2\)-нормалдаштырылат.
Бириккен өкүлчүлүк:
\(\oplus\): concatenation оператору.
Эки 128-өлчөмдүү vector бириктирилгендиктен:
SHFде feature extractors fusion баскычында frozen абалда калат. Gradient quantum же classical backboneго кайтып барбайт; classifier/fusion head гана окутулат.
Dynamic Hybrid Fusion — DHF
DHF ошол эле concatenation түзүлүшүн колдонот, бирок frozen feature extraction ордуна бирдиктүү forward/backward pipeline түзөт. Cross-entropy lossтан келген gradient classifierдан эки бутакка бөлүнөт:
- классикалык branchтин \(\phi\) параметрлерине,
- эгер trainable quantum branch колдонулса, \(\theta_Q\) параметрлерине.
Бул co-adaptation көбүрөөк ийкемдүүлүк берет; бирок булакта негизги көйгөй катары аныкталган optimization asymmetry дал ушул жерде пайда болот. Кыйла чоң жана жакшыраак condition кылынган классикалык тармактын gradient түзүлүшү кванттык бутакты басып калышы мүмкүн.
Temperature-Scaled Hybrid Fusion — TSHF
TSHF DHFге бир үйрөтүлүүчү scalar кошот:
\(\gamma\) — өлчөмсүз жалгыз trainable параметр жана башында:
деп коюлат. Бул баштапкы учурда стандарттуу concatenation менен бирдей мааниге ээ.
Gradient таасири булактын Теңдеме (7)синде:
түрүндө көрсөтүлөт.
Формула эмнени эсептейт? Quantum embeddingге кайтып барган loss gradient \(\gamma\) менен масштабдаларын көрсөтөт.
\(\mathcal L\): классификация жоготуусу.
\(h_Q\): quantum feature vector.
\(\gamma>1\): башка шарттар тең болгондо quantum embeddingдин forward өтүштөгү жана backward gradientтеги салыштырмалуу масштабын көбөйтөт.
\(0<\gamma<1\): салыштырмалуу масштабды азайтат.
Булактын колдонмосунда \(\gamma\) оң маанини сактоо үчүн колдонмо катмарында \(\exp(\log\gamma)\) аркылуу берилет.
\(\ell_2\) нормалдаштыруу эмне үчүн борбордук мааниге ээ?
TSHF механизминин маанисин \(\gamma\) аркылуу гана түшүндүрүү толук эмес. Булактын эң жакшы BreastMNIST конфигурациясындагы кеңири branch-norm анализи projection output баскычында quantum branch нормасы классикалык branchке караганда системалуу түрдө кичине экенин көрсөтөт:
Классикалык норма тест үлгүлөрүнүн арасында болжол менен 52 эсе өзгөрсө, quantum норма болжол менен 8,6 эсе өзгөрөт. Нормалдаштыруудан мурдагы branch катышы болжол менен 0,01–1,4 аралыгында өзгөрөт.
Бул шартта кванттык бутактын fused-vector энергиясындагы медианалык үлүшү болгону:
деп билдирилет.
Branch-wise \(\ell_2\) normalization эки feature vectorдун нормасын бирдик мааниге теңейт. Андан кийин \(\gamma\) калган жалгыз салыштырмалуу scale parameter болуп калат.
Эки нормалдаштырылган branch үчүн булактын 12-сүрөт түшүндүрмөсүндөгү quantum-energy үлүшү:
Мисалы, өкүлчүлүктүү иштетүүдө:
үчүн quantum үлүшү болжол менен:
деп берилет. Беш иштетүүнүн орточосундагы
болсо болжол менен %51,2 quantum үлүшүнө туура келет.
Бул анализ оңдоонун чоң бөлүгүн \(\ell_2\) normalization аткарарын; \(\gamma\) болсо нормалдаштыруудан кийин калган branch balanceты бир гана degree of freedom аркылуу жөнгө саларын көрсөтөт.
Barren plateau деген эмне жана бул жерде эмне үчүн маанилүү?
Изилдөөнүн trainable quantum branch дизайнында айтылган “barren plateau” — кванттык схема кеңейген же тереңдеген сайын loss gradientтери өтө кичирейип, оптималдаштырууну кыйындатышы мүмкүн болгон training-landscape көйгөйү. Авторлор ошондуктан схеманы атайылап төрт кубит, бир variational layer жана болгону төрт quantum parameter менен кичине кармашат. Бул дизайн optimization коркунучун азайтат, бирок ошол эле учурда trainable схеманын representational capacityсин чектейт.
Deterministic quantum feature map эмне үчүн күтүлбөгөндөй атаандаштыкка жөндөмдүү?
Deterministic схема training маалында quantum gradient талап кылбайт, barren plateau менен туш болбойт жана quantum features маалымат топтому үчүн бир жолу алдын ала эсептелип cache кылына алат. Изилдөөдө эң жакшы BreastMNIST жана INbreast конфигурациялары non-trainable quantum branch колдонгону “үйрөтүлүүчү кванттык схема дайыма күчтүүрөөк” деген божомолду колдобойт.
Бирок булак бул жыйынтыкты variational quantum circuitтер жөнүндө жалпы өкүмгө айландырбайт. Колдонулган trainable ansatz болгону төрт параметрлүү жана бир катмарлуу. Кеңирээк же тереңирээк trainable quantum circuits башка жыйынтык бере алат; бул маселе келечектеги изилдөөгө калтырылган.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Колдонулган үч маалымат топтому
| Маалымат топтому | Бөлүк | Benign | Malignant | Жалпы | Malignant үлүшү |
|---|---|---|---|---|---|
| BreastMNIST | Окутуу | 399 | 147 | 546 | %26,9 |
| BreastMNIST | Валидация | 57 | 21 | 78 | %26,9 |
| BreastMNIST | Тест | 114 | 42 | 156 | %26,9 |
| BreastMNIST | Жалпы | 570 | 210 | 780 | %26,9 |
| INbreast | Окутуу | 160 | 150 | 310 | %48,4 |
| INbreast | Валидация | 38 | 37 | 75 | %49,3 |
| INbreast | Тест | 50 | 46 | 96 | %47,9 |
| INbreast | Жалпы | 248 | 233 | 481 | %48,4 |
| BUS-UCLM | Окутуу | 135 | 64 | 199 | %32,2 |
| BUS-UCLM | Валидация | 32 | 7 | 39 | %17,9 |
| BUS-UCLM | Тест | 7 | 19 | 26 | %73,1 |
| BUS-UCLM | Жалпы | 174 | 90 | 264 | %34,1 |
BreastMNIST
BreastMNIST — MedMNIST берген native 28×28 боз-деңгээлдүү ультраүндүк сүрөттөр. Булак расмий train/validation/test splitти өзгөртпөстөн колдонот.
Бул маалымат топтомунда метрикаларды чечмелөөдө өзгөчө көңүл бурууну талап кылган белгилөө конвенциясы бар: оң класс benign/normal категориясы. Ошондуктан BreastMNIST precision, recall жана F1 маанилери benign класс боюнча эсептелген.
INbreast
INbreast — санарип mammogram маалымат топтому. Булак expert annotationдарды колдонуп suspicious tumor regionдарды crop кылат. Бир сүрөттө бир нече region of interest болсо, ар бир аймак өзүнчө sample катары каралышы мүмкүн.
Crop кылынган аймактар:
- Contrast Limited Adaptive Histogram Equalization (CLAHE) менен жакшыртылат,
- ар бир сүрөт боюнча min–max normalization менен \([0,1]\) аралыгына келтирилет,
- 28×28 өлчөмүнө кайра масштабдалат.
INbreastте оң класс malignant категориясы.
BUS-UCLM
BUS-UCLM — annotated breast-ultrasound сүрөттөрү. Булак сүрөттөргө crop же CLAHE колдонбойт; normalization жана 28×28 resize гана колдонот.
BUS-UCLMде да оң класс malignant категориясы.
INbreast жана BUS-UCLM splitтери patient levelде түзүлөт: бир эле бейтаптан келген үлгүлөр бир нече splitке бөлүштүрүлбөйт. Ошентип patient leakage алдын алынат.
BUS-UCLMдеги класс бөлүштүрүлүшү эмне үчүн өзгөчө көйгөйлүү?
Окутуу топтомунда malignant үлүшү %32,2 болсо, validationда %17,9 жана тестте %73,1. Булак аз сандагы бейтаптарда patient-level partition колдонуу бул чоң prevalence shiftти пайда кылганын жана BUS-UCLM жыйынтыктары ошондуктан indicative катары гана бааланышы керек экенин ачык белгилейт.
Тест топтомунда болгону 26 сүрөт бар болгондуктан, бир эле туура эмес классификация:
accuracy point өзгөрүүсүн жаратат.
Киргизүү normalization
Table IV бардык моделдер үчүн киргизүүнү:
grayscale tensor катары аныктап, preprocessingде:
normalization параметрлерин берет.
Классикалык backboneдор
| Модель | Өзгөчөлүк | Feature өлчөмү | Жалпы параметр |
|---|---|---|---|
| Shallow CNN (SCNN) | Үч convolution block, BatchNorm, ReLU, pooling/GAP | 128 | 93.378 |
| ResNet-18 | ImageNet initialization, биринчи convolution бир каналга ылайыкташтырылган | 512 | 11.171.266 |
Кванттык branchтин толук түзүлүшүнүн жыйынтыгы
| Элемент | Булактагы жөндөө |
|---|---|
| Patch | 2×2, non-overlapping |
| Stride | 2 |
| Patch саны | 196 |
| Кубит | 4 |
| Өлчөө | \(\langle Z_j\rangle,\;j=1,\ldots,4\) |
| Чийки feature map | 4×14×14 |
| Post-processing | Bilinear resize + ReLU + flatten |
| Flatten өлчөмү | 784 |
| Quantum projection | 784→128 |
| Fixed circuit trainable quantum parameter | 0 |
| Trainable circuit trainable quantum parameter | 4 |
| Variational layer | 1 |
Fusion катмарынын өлчөмдөрү
Классикалык жана кванттык projection outputтар:
түрүндө нормалдаштырылат. Concatenationдан кийин:
Бул vector ReLU жана 256→2 classifier аркылуу эки класстын score/probability чыгышына айландырылат.
Окутуу гиперпараметрлери
| Гиперпараметр | SCNN | ResNet-18 | Quantum fixed | Quantum trainable | SHF | DHF | TSHF |
|---|---|---|---|---|---|---|---|
| Epoch | 20 | 20 | 10 | 10 | 10 | 10 | 10 |
| Batch size | 16 | 16 | 16 | 16 | 16 | 16 | 16 |
| Негизги learning rate | \(10^{-3}\) | \(10^{-3}\) | \(3\times10^{-3}\) | \(10^{-2}\) | — | — | — |
| Classical branch LR | — | — | — | — | \(10^{-4}\) | \(10^{-4}\) | \(10^{-4}\) |
| Quantum branch LR | — | — | — | — | \(10^{-2}\) | \(10^{-2}\) | \(10^{-2}\) |
| Fusion head LR | — | — | — | — | \(10^{-3}\) | \(10^{-3}\) | \(10^{-1}\) |
| \(\gamma\) LR | — | — | — | — | Жок | Жок | \(10^{-2}\) |
| Fused feature dim. | — | — | — | — | 128/branch | 128/branch | 128/branch |
Бардык моделдер Adam optimizer жана cross-entropy loss колдонушат.
Симуляция жана жабдык чөйрөсү
| Элемент | Булакта берилген маалымат |
|---|---|
| Classical framework | PyTorch |
| Quantum framework | PennyLane |
| Trainable integration | TorchLayer |
| Quantum backend | lightning.qubit state-vector |
| Quantum mode | Analytic mode, no shots |
| Quantum execution | CPU |
| Classical execution | CUDA-enabled NVIDIA L40S GPU |
| Көз карандысыз кайталоо | 5 seed / configuration |
| Optimizer | Adam |
| Loss | Cross-entropy |
Standalone baseline жыйынтыктары
| Маалымат топтому | Парадигма | Модель | Accuracy | Precision | Recall | F1 | AUC |
|---|---|---|---|---|---|---|---|
| BreastMNIST | Классикалык | SCNN | 82.82 ± 2.70 | 86.27 ± 2.26 | 91.05 ± 3.79 | 88.55 ± 1.93 | 84.49 ± 2.23 |
| BreastMNIST | Классикалык | ResNet-18 | 84.74 ± 2.99 | 88.67 ± 1.69 | 90.70 ± 2.82 | 89.67 ± 2.10 | 87.08 ± 3.07 |
| BreastMNIST | Кванттык | Non-trainable | 78.21 ± 1.98 | 82.69 ± 4.80 | 89.47 ± 4.92 | 85.73 ± 0.54 | 79.42 ± 3.13 |
| BreastMNIST | Кванттык | Trainable | 77.82 ± 2.06 | 81.18 ± 3.33 | 91.05 ± 4.45 | 85.71 ± 1.26 | 78.32 ± 1.67 |
| INbreast | Классикалык | SCNN | 67.92 ± 2.38 | 65.05 ± 4.16 | 73.04 ± 5.87 | 68.56 ± 1.13 | 78.78 ± 1.61 |
| INbreast | Классикалык | ResNet-18 | 68.33 ± 2.72 | 72.91 ± 13.87 | 66.09 ± 24.04 | 65.15 ± 7.93 | 77.30 ± 4.54 |
| INbreast | Кванттык | Non-trainable | 69.58 ± 2.49 | 65.78 ± 2.71 | 76.52 ± 5.83 | 70.63 ± 2.85 | 78.63 ± 1.32 |
| INbreast | Кванттык | Trainable | 70.00 ± 2.49 | 70.00 ± 6.74 | 68.26 ± 9.55 | 68.44 ± 1.97 | 77.15 ± 2.86 |
| BUS-UCLM | Классикалык | SCNN | 66.92 ± 9.26 | 93.20 ± 4.19 | 58.95 ± 12.57 | 71.66 ± 10.05 | 91.88 ± 3.58 |
| BUS-UCLM | Классикалык | ResNet-18 | 65.38 ± 9.02 | 95.14 ± 4.58 | 55.79 ± 13.72 | 69.36 ± 11.04 | 86.62 ± 5.27 |
| BUS-UCLM | Кванттык | Non-trainable | 69.23 ± 9.02 | 97.24 ± 3.79 | 60.00 ± 14.22 | 73.15 ± 11.26 | 86.47 ± 3.94 |
| BUS-UCLM | Кванттык | Trainable | 70.77 ± 15.53 | 86.67 ± 8.81 | 72.63 ± 25.35 | 76.64 ± 15.40 | 81.80 ± 12.01 |
Standalone жыйынтыктардын мааниси
BreastMNISTте классикалык ResNet-18 quantum-only моделдерден ачык түрдө жогорку тактыкка ээ. INbreast жана BUS-UCLMде болсо standalone quantum моделдер классикалык моделдер менен бир деңгээлде же accuracy боюнча бир аз жогору жыйынтык көрсөтүшү мүмкүн. Бирок өзгөчө BUS-UCLMде стандарттык четтөөлөр абдан чоң жана кичине тест топтомунан улам жыйынтыктар туруксуз.
BreastMNIST — бардык бириктирүү жыйынтыктарынын кыскача мазмуну
| Стратегия | Классикалык | Кванттык | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 84.74 ± 2.10 | 88.88 ± 1.73 | 92.12 ± 0.18 | — |
| SHF | ResNet-18 | Non-trainable | 78.46 ± 2.89 | 85.61 ± 2.70 | 81.14 ± 1.24 | — |
| SHF | SCNN | Trainable | 80.77 ± 1.28 | 87.08 ± 1.01 | 83.56 ± 1.19 | — |
| SHF | SCNN | Non-trainable | 80.77 ± 1.50 | 86.92 ± 1.14 | 83.07 ± 0.66 | — |
| DHF | ResNet-18 | Trainable | 84.87 ± 1.79 | 89.21 ± 1.73 | 92.48 ± 0.52 | — |
| DHF | ResNet-18 | Non-trainable | 86.28 ± 2.20 | 90.22 ± 1.84 | 92.39 ± 0.24 | — |
| DHF | SCNN | Trainable | 80.00 ± 3.52 | 86.52 ± 3.54 | 82.45 ± 0.55 | — |
| DHF | SCNN | Non-trainable | 81.54 ± 1.39 | 87.62 ± 1.03 | 83.46 ± 0.86 | — |
| TSHF | ResNet-18 | Trainable | 86.15 ± 1.48 | 90.11 ± 1.26 | 92.18 ± 0.22 | 1.280 ± 0.331 |
| TSHF | ResNet-18 | Non-trainable | 88.33 ± 2.00 | 92.09 ± 1.25 | 92.09 ± 0.44 | 1.025 ± 0.039 |
| TSHF | SCNN | Trainable | 81.54 ± 0.84 | 88.10 ± 0.80 | 83.71 ± 0.64 | 0.930 ± 0.053 |
| TSHF | SCNN | Non-trainable | 81.92 ± 0.95 | 88.23 ± 0.81 | 83.29 ± 0.84 | 1.019 ± 0.057 |
BreastMNISTте эң жогорку accuracy жана F1 TSHF + ResNet-18 + non-trainable схемада алынат. Бирок эң жогорку AUC:
DHF + ResNet-18 + trainable конфигурациясында. Ошондуктан “TSHF бардык метрикаларда эң жакшы” деген жыйынтык туура эмес.
BreastMNIST confusion-matrix билдирүүсү
Булак беш иштетүүнүн жалпы confusion matrixтеринде эң жакшы TSHF модели malignant үлгүлөрдүн benign деп классификацияланышын standalone ResNet-18 жана deterministic quantum baselineга салыштырмалуу азайтканын; benign үлгүлөрдүн malignant класска өтүшүн да азайтканын билдирет. Башкача айтканда, бул маалымат топтомунда improvement operating thresholdду бир класстын пайдасына жылдыруудан гана эмес, эки ката түрүнүн чогуу азайышынан келип чыгат.
INbreast — бардык бириктирүү жыйынтыктарынын кыскача мазмуну
| Стратегия | Классикалык | Кванттык | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 66.87 ± 4.32 | 68.73 ± 3.57 | 79.62 ± 0.09 | — |
| SHF | ResNet-18 | Non-trainable | 70.42 ± 3.73 | 72.96 ± 1.29 | 80.28 ± 0.46 | — |
| SHF | SCNN | Trainable | 68.33 ± 0.93 | 66.55 ± 3.76 | 76.83 ± 2.20 | — |
| SHF | SCNN | Non-trainable | 68.75 ± 1.47 | 65.81 ± 3.63 | 77.70 ± 0.98 | — |
| DHF | ResNet-18 | Trainable | 67.08 ± 2.16 | 69.91 ± 2.56 | 74.67 ± 1.26 | — |
| DHF | ResNet-18 | Non-trainable | 69.79 ± 1.95 | 70.30 ± 4.09 | 76.25 ± 2.04 | — |
| DHF | SCNN | Trainable | 68.33 ± 2.51 | 65.76 ± 5.99 | 76.55 ± 2.48 | — |
| DHF | SCNN | Non-trainable | 68.54 ± 2.80 | 64.99 ± 4.79 | 77.12 ± 1.50 | — |
| TSHF | ResNet-18 | Trainable | 67.92 ± 1.55 | 69.32 ± 3.12 | 76.53 ± 1.25 | 1.080 ± 0.169 |
| TSHF | ResNet-18 | Non-trainable | 65.42 ± 3.71 | 70.72 ± 1.71 | 78.12 ± 1.22 | 1.095 ± 0.150 |
| TSHF | SCNN | Trainable | 67.71 ± 6.46 | 67.80 ± 3.07 | 75.26 ± 2.54 | 0.977 ± 0.053 |
| TSHF | SCNN | Non-trainable | 68.13 ± 3.50 | 69.36 ± 2.46 | 75.70 ± 2.76 | 1.045 ± 0.084 |
INbreastте adaptive стратегиялар static fusionдан ашпайт. Эң жакшы жыйынтык frozen feature extractors колдонгон SHFден келет.
Confusion matrix анализи бул маалымат топтомундагы пайда BreastMNISTтеги механизмден башка экенин көрсөтөт: missed malignant учурлар азайганда benign үлгүлөрдөгү false-positive саны өсөт. Демек fusion бул жерде sensitivity–specificity trade-offту өзгөртөт.
BUS-UCLM — бардык бириктирүү жыйынтыктарынын кыскача мазмуну
| Стратегия | Классикалык | Кванттык | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 78.46 ± 8.85 | 84.66 ± 6.57 | 89.47 ± 3.28 | — |
| SHF | ResNet-18 | Non-trainable | 73.08 ± 7.69 | 78.16 ± 7.38 | 90.38 ± 2.09 | — |
| SHF | SCNN | Trainable | 62.31 ± 6.88 | 65.39 ± 7.81 | 87.52 ± 2.64 | — |
| SHF | SCNN | Non-trainable | 56.15 ± 9.65 | 56.46 ± 14.79 | 90.23 ± 4.15 | — |
| DHF | ResNet-18 | Trainable | 58.46 ± 7.40 | 61.98 ± 9.01 | 82.56 ± 6.43 | — |
| DHF | ResNet-18 | Non-trainable | 69.23 ± 9.02 | 74.41 ± 10.00 | 89.17 ± 3.39 | — |
| DHF | SCNN | Trainable | 59.23 ± 4.39 | 61.69 ± 5.64 | 89.77 ± 2.41 | — |
| DHF | SCNN | Non-trainable | 55.38 ± 5.83 | 56.10 ± 8.69 | 88.57 ± 3.66 | — |
| TSHF | ResNet-18 | Trainable | 65.38 ± 13.60 | 68.98 ± 16.03 | 83.16 ± 13.44 | 0.989 ± 0.045 |
| TSHF | ResNet-18 | Non-trainable | 53.08 ± 14.24 | 51.13 ± 24.55 | 81.95 ± 11.09 | 1.005 ± 0.024 |
| TSHF | SCNN | Trainable | 62.31 ± 15.24 | 64.45 ± 19.75 | 88.57 ± 4.13 | 0.959 ± 0.062 |
| TSHF | SCNN | Non-trainable | 54.62 ± 20.24 | 50.51 ± 33.42 | 87.67 ± 4.68 | 1.025 ± 0.045 |
BUS-UCLMде эң жакшы accuracy жана F1 static fusionда. Ал эми маалымат топтомундагы эң жогорку AUC:
standalone SCNNге тиешелүү. Бул fusion “ар бир метриканы жогорулатат” деген чечмелөөгө жол бербейт.
TSHF Эмне Үчүн Ар Бир Маалымат Топтомунда Эң Жакшы Эмес?
TSHFнин кошумча \(\gamma\) калибрлөөсү жана end-to-end co-adaptationы өздөрү да үйрөнүлүшү керек болгон кошумча эркиндиктер; BreastMNISTтин 546 окутуу үлгүсүндө бул ийкемдүүлүк пайда берген болсо, INbreastтин 310 жана BUS-UCLMнин 199 окутуу үлгүсүндө булак жөнөкөй SHF жакшыраак generalization көрсөткөнүн жана кичине маалымат топтомдору branch-weight calibration менен биргелешкен оптималдаштырууну ишенимдүү үйрөнүү үчүн жетиштүү сигнал бербеген болушу мүмкүн экенин белгилейт.
Temperature scalar абляциясы
Булак BreastMNIST + ResNet-18 үстүндө:
- scaling жок,
- \(\gamma=0.001\),
- \(\gamma=0.01\),
- \(\gamma=0.1\),
- \(\gamma=0.5\),
- \(\gamma=2\),
- branch-wise \(\ell_1\) normalization,
- үйрөтүлүүчү \(\gamma\)
варианттарын салыштырат.
Non-trainable quantum branchте learned TSHF:
accuracy менен бул блоктогу эң жакшы жыйынтыкты берет.
Trainable quantum branchте болсо \(\ell_1\) normalization:
accuracy менен learned TSHFнин:
маанисинен жогору.
Демек learned scalar практикалык автоматтык calibration mechanism берет, бирок бардык quantum branch түрүндө эң жогорку accuracyга кепилдик бербейт.
Үйрөнүлгөн \(\gamma\) канчалык өзгөрөт?
Он эки TSHF конфигурациясынын баарында булак:
аралыгын билдирет. Он бир конфигурацияда маани баштапкы \(1.0\) чекитинин болжол менен %10унун ичинде калат.
Ошондуктан \(\gamma\) маанисин маалымат топтомунун “татаалдык деңгээли” катары окуу туура эмес. Авторлор муну өзгөчө четке кагат.
UMAP анализи эмнени көрсөтөт?
Булак BreastMNIST, INbreast жана BUS-UCLM embeddingsтерин Uniform Manifold Approximation and Projection (UMAP) менен эки өлчөмгө түшүрөт. Standalone classical жана quantum branches ошол эле үлгүлөрдү ар башка latent геометрияларда уюштурат; fusionдан кийин айрым ийгиликтүү конфигурацияларда benign жана malignant үлгүлөр визуалдык жактан көбүрөөк түзүмдөлгөн аймактарга топтолот.
Бирок авторлор UMAP:
- non-linear,
- stochastic,
- hyperparameter-sensitive
визуалдаштыруу экенин жана өзүнчө класс separability метрикасы болуп эсептелбеши керектигин ачык белгилешет. Көрсөтүүлөр бир гана runга тиешелүү. Сандык separability ырастоосунун негизи UMAP сүрөтү эмес, AUC маанилери.
%95 ишеним аралыктары
Appendix E беш көз карандысыз run орточосу үчүн %95 confidence interval берет. Булар беш seedдин орточосуна тиешелүү ишеним аралыктары; миңдеген көз карандысыз клиникалык бейтаптардагы population confidence interval катары чечмеленбеши керек.
| Маалымат топтому | Конфигурация | Accuracy | F1 | AUC |
|---|---|---|---|---|
| BreastMNIST | TSHF + ResNet-18 + non-trainable | 88.33 [85.85, 90.81] | 92.09 [90.54, 93.64] | 92.09 [91.54, 92.64] |
| INbreast | SHF + ResNet-18 + non-trainable | 70.42 [65.79, 75.05] | 72.96 [71.36, 74.56] | 80.28 [79.71, 80.85] |
| BUS-UCLM | SHF + ResNet-18 + trainable | 78.46 [67.47, 89.45] | 84.66 [76.50, 92.82] | 89.47 [85.40, 93.54] |
BUS-UCLM confidence intervalдарынын кеңдиги кичине тест үлгүсү жана seed-to-seed өзгөрмөлүүлүк менен шайкеш келет.
Formal significance тести жүргүзүлдүбү?
Жок. Булак competing methods ортосунда formal statistical significance testing жүргүзүлбөгөнүн ачык белгилейт. Ошондуктан орточо accuracy же AUC айырмалары “статистикалык жактан далилденген артыкчылык” деп айтылбашы керек. Авторлор айырмаларды descriptive trend катары баалап, sample-level paired analysisти келечектеги ишке калтырат.
Мурунку гибриддик моделдер менен BreastMNIST салыштыруусу
| Модель / изилдөө | Accuracy | F1 | AUC |
|---|---|---|---|
| Matondo et al. | 76.66 | 68.00 | Билдирилген эмес |
| Yurtseven et al. | 86.54 | 91.31 | Билдирилген эмес |
| Sobrinho et al. | 82.10 | 80.30 | 82.60 |
| Бул изилдөө — SHF, ResNet-18 + trainable | 84.74 ± 2.10 | 88.88 ± 1.73 | 92.12 ± 0.18 |
| Бул изилдөө — DHF, ResNet-18 + non-trainable | 86.28 ± 2.20 | 90.22 ± 1.84 | 92.39 ± 0.24 |
| Бул изилдөө — TSHF, ResNet-18 + non-trainable | 88.33 ± 2.00 | 92.09 ± 1.25 | 92.09 ± 0.44 |
Салыштыруунун маанилүү чеги: бул изилдөөнүн маанилери беш seedдин орточосу; булакта салыштырылган мурунку изилдөөлөрдүн маанилери single-run отчеттору. Ошондуктан таблицада ошол эле test split колдонулганы пайдалуу болгону менен эксперимент протоколдору толук эквиваленттүү эмес.
Computational cost
| Модель | Жалпы параметр | Circuit / сүрөт | Inference (ms/сүрөт) | Training (ms/кадам) | SCNNге карата training slowdown |
|---|---|---|---|---|---|
| SCNN | 93.378 | 0 | 0.03 | 2.4 | 1× |
| ResNet-18 | 11.171.266 | 0 | 0.22 | 55 | 23× |
| QC-fixed | 1.570 | 196 | 118 | 2.357 | ≈\(9.6\times10^2\) |
| QC-trainable | 1.574 | 196 | 143 | 8.304 | ≈\(3.4\times10^3\) |
| SHF + SCNN | 210.888 | 196 | 176 | 2.864 | ≈\(1.2\times10^3\) |
| SHF + ResNet-18 | 11.337.928 | 196 | 134 | 2.140 | ≈\(8.7\times10^2\) |
| DHF + SCNN | 210.888 | 196 | 149 | 8.839 | ≈\(3.6\times10^3\) |
| DHF + ResNet-18 | 11.337.928 | 196 | 169 | 12.785 | ≈\(5.2\times10^3\) |
| TSHF + SCNN | 210.889 | 196 | 190 | 12.283 | ≈\(5.0\times10^3\) |
| TSHF + ResNet-18 | 11.337.929 | 196 | 180 | 9.442 | ≈\(3.9\times10^3\) |
TSHF бир гана кошумча learnable scalar кошкондуктан, DHFге салыштырмалуу аналитикалык моделдин татаалдыгын олуттуу көбөйтпөйт. Table XIде DHF жана TSHF ортосундагы measured runtime айырмалары run-to-run dispersion ичинде бааланат; булак бул убакыт айырмаларын \(\gamma\) механизминин түз чыгымы катары чечмелебейт.
Бул Изилдөө Кванттык Артыкчылыкты же Кванттык Ылдамданууну Далилдейби?
Жок; изилдөө simulated төрт-кубиттик quanvolutional feature maps классикалык CNN өзгөчөлүктөрү менен толуктоочу өкүлчүлүк түзө аларына методологиялык далил берет, бирок физикалык кванттык жабдыкта классикалык ыкмалардан тезирээк, арзаныраак же такыраак end-to-end эсептөөнү көрсөтпөгөндүктөн quantum computational advantage же quantum speedup далилдебейт.
Эмне үчүн параметр натыйжалуулугу ылдамдануу эмес?
Trainable quantum circuit болгону төрт trainable quantum parameter колдонсо, ResNet-18 болжол менен 11,17 миллион параметр камтыйт. Бул маанилүү parameter-efficiency айырмасы.
Бирок ар бир сүрөт 196 өзүнчө quantum-circuit evaluation талап кылгандыктан жана бул схемалар state-vector simulator үстүндө CPUда иштетилгендиктен, wall-clock runtime абдан жогору. Булактын өз жыйынтыгы боюнча simulated hybrid pipeline классикалык SCNNден болжол менен үч чоңдук тартибине чейин жайыраак болушу мүмкүн.
Авторлор реалдуу quantum hardwareда cost profile башкача болорун айтышат, бирок канчалык башкача экенин өлчөбөйт. Ошондуктан Verianla келечектеги жабдык ылдамдыгын сандык түрдө божомолдобойт.
Изилдөө колдогон жыйынтыктар
- Классикалык жана кванттык feature representations бир эле сүрөттөрдү ар башка latent түзүлүштөрдө уюштура алат жана бул айырма айрым маалымат топтомдорунда пайдалуу fusion сигналын бере алат.
- BreastMNISTте TSHF + ResNet-18 + non-trainable кванттык branch standalone ResNet-18ге караганда жогорку accuracy, F1 жана AUC алган.
- INbreast жана BUS-UCLMде эң жакшы accuracy adaptive TSHFден эмес, SHFден келген.
- Adaptive fusionдун пайдасы маалымат көлөмүнө жана branch/model тандоосуна көз каранды; универсалдуу эмес.
- Deterministic quantum feature map эки маалымат топтомундагы эң жакшы конфигурациянын бөлүгү болуп, trainable quantum parameter талап кылбайт.
- Trainable quantum branchтин төрт параметрлүү бир катмарлуу ansatzы deterministic схемадан туруктуу түрдө ашпайт.
- Branch-wise normalization quantum/classical magnitude асимметриясынын чоң бөлүгүн оңдойт.
- Learnable \(\gamma\) normalizationдан кийин калган relative branch scaleды бир параметр менен жөнгө салат.
- UMAP сүрөттөрү classical жана quantum latent representations ар башка уюшулушу мүмкүн экенин сапаттык түрдө көрсөтөт.
- Quantitative class separability баалоосу UMAPтын ордуна AUC аркылуу жасалышы керек.
Изилдөө колдобогон жыйынтыктар
- Реалдуу кванттык компьютер эмчек безинин рагын классикалык компьютерден жакшыраак классификациялаганы көрсөтүлгөн эмес.
- Quantum speedup же quantum computational advantage көрсөтүлгөн эмес.
- Shot noise, decoherence жана gate error камтыган физикалык quantum hardware жүрүм-туруму сыналган эмес.
- TSHF бардык маалымат топтомдорунда жана бардык метрикаларда эң жакшы экени көрсөтүлгөн эмес.
- Trainable quantum circuit жалпы түрдө deterministic circuitтен артык экени көрсөтүлгөн эмес.
- Formal statistical significance тести жүргүзүлбөгөндүктөн орточо айырмалар p-маани менен ырасталган артыкчылыктар эмес.
- UMAP cluster бөлүнүшү көз карандысыз сандык separability далили эмес.
- Колдонулган кичине маалымат топтомдору screening populationду өкүлчүлүк кылбайт.
- External clinical validation, calibration analysis же reader study жүргүзүлгөн эмес.
- Модель клиникалык колдонууга даяр экени көрсөтүлгөн эмес.
- 28×28 төмөн чечилишиндеги ийгилик жогорку чечилишиндеги реалдуу клиникалык workflowго автоматтык жалпыланбайт.
Изилдөөнүн негизги чектөөлөрү
- Бардык сүрөттөр 28×28 grayscale чечилишинде.
- Тест топтомдору болгону 156, 96 жана 26 сүрөттү камтыйт.
- Ар бир модель болгону беш көз карандысыз seed менен бааланган.
- Competing methods ортосунда formal significance testing жок.
- BUS-UCLM train/validation/test prevalence бөлүштүрүлүштөрү олуттуу айырмаланат.
- Quantum circuit analytic simulation болуп саналат; реалдуу hardware noise жок.
- Кванттык схема болгону төрт кубит жана бир variational layer камтыйт.
- External validation cohort жок.
- Clinical calibration анализи жок.
- Radiologist/reader study жок.
- Datasetтер population-level screening cohort эмес.
Келечектеги изилдөө
Булак кеңирээк qubit registerлерди, тереңирээк variational circuitsти, физикалык quantum hardwareда executionду, чоңураак жана жогорку чечилишиндеги маалымат топтомдорун, multimodal сүрөттөөнү, calibration analysisти жана external validationду сунуштайт. Өзгөчө trainable quantum branch бул изилдөөдө болгону төрт параметр менен чектелип турганы чоңураак ansatzтар чындап кошумча пайда береби деген суроону ачык калтырат.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: On the Complementarity of Quantum and Classical Features: Adaptive Hybrid Quantum-Classical Feature Fusion for Breast Cancer Classification.
Авторлор: Yasmin Rodrigues Sobrinho; João Renato Ribeiro Manesco; João Paulo Papa.
PDFте колдонулган кыскартылган автор аттары: Yasmin R. Sobrinho; João R. R. Manesco; João P. Papa.
Мекеме: Department of Computing, São Paulo State University (UNESP), Bauru, SP, Brazil.
Электрондук почта: PDF үч авторго тиешелүү yasmin.sobrinho, joao.r.manesco жана joao.papa @unesp.br даректерин бирге берет.
Corresponding author: Жүктөлгөн PDFте өзүнчө corresponding-author белгиси ачык көрсөтүлгөн эмес.
Тең салым: Жүктөлгөн PDFте тең салым/тең биринчи автор тууралуу билдирүү көрүнбөйт.
Платформа: arXiv.
arXiv: arXiv:2604.22903v2 [cs.CV].
Биринчи жөнөтүү: 24 Апрель 2026.
v2 ревизиясы: 20 Октябрь 2026.
DOI: 10.48550/arXiv.2604.22903. Бул arXiv/DataCite DOI; рецензияланган журнал DOI эмес.
Рецензия статусу: 15 Ноябрь 2026га карата текшерилген учурдагы библиографиялык жазуу изилдөөнү preprint катары көрсөтөт. ArXiv comments талаасы макала Artificial Intelligence in Medicine журналында кароодо экенин билдирет; өзүнчө жарыяланган рецензияланган версия тастыкталган эмес.
Лицензия: Жүктөлгөн PDFте белгилүү лицензия билдирүүсү көрүнбөйт жана бул сессияда расмий arXiv metadataдагы лицензия талаасы ишенимдүү текшерилбегендиктен Verianla белгилүү ачык лицензияны божомолдобойт.
Изилдөө түрү: Methodological/exploratory hybrid quantum-classical machine-learning simulation изилдөөсү.
Колдонуу тармагы: Эмчек сүрөттөрүндө benign–malignant классификациясы.
Классикалык моделдер: ResNet-18 жана Shallow CNN.
Кванттык моделдер: Төрт-кубиттик deterministic/non-trainable quanvolutional feature map жана төрт trainable quantum parameter камтыган бир катмарлуу variational quanvolutional circuit.
Fusion стратегиялары: Static Hybrid Fusion (SHF), Dynamic Hybrid Fusion (DHF), Temperature-Scaled Hybrid Fusion (TSHF).
Маалымат топтомдору: BreastMNIST, INbreast жана BUS-UCLM.
Жалпы уникалдуу сүрөт/ROI үлгүлөрүнүн түз суммасы: Маалымат топтомдору ар башка түзүлүштө болгондуктан изилдөө бирдиктүү бириктирилген клиникалык cohort катары бааланбашы керек; BreastMNIST 780 үлгү, INbreast иштетилген 481 ROI/sample жана BUS-UCLM 264 үлгү камтыйт.
Сүрөт чечилиши: 28×28, бир каналдуу grayscale.
Quantum patch: 2×2, stride 2, төрт кубит, ар бир сүрөт үчүн 196 quantum circuit evaluation.
Quantum өлчөө: Ар бир кубитте Pauli-\(Z\) expectation value.
Quantum simulation: PennyLane lightning.qubit, state-vector, analytic mode, no shots, CPU.
Классикалык жабдык: CUDA-enabled NVIDIA L40S GPU.
Framework: PyTorch + PennyLane TorchLayer.
Optimizer: Adam.
Loss: Cross-entropy.
Кайталоо: Ар бир конфигурация беш independent seed.
Fusion конфигурациялары: Булак 36 fusion конфигурациясын жана 12 standalone baseline баалоосун билдирет.
Негизги баалоо метрикалары: Accuracy, precision, recall, F1-score жана AUC-ROC.
Оң класс боюнча эскертүү: BreastMNISTте positive class benign; INbreast жана BUS-UCLMде malignant. Ошондуктан precision, recall жана F1 маанилери маалымат топтомдорунун арасында класс мааниси боюнча түздөн-түз бир эле оң классты билдирбейт.
Formal статистикалык тест: Competing methods ортосунда formal significance testing жүргүзүлгөн эмес. Appendix Eде беш run орточосу үчүн %95 confidence intervals берилген.
UMAP: Latent-space visualization үчүн колдонулган; булак UMAPты сандык separability далили катары кабыл албайт.
Computational cost чеги: Билдирилген чоң runtime overhead CPUдагы classical quantum simulationга тиешелүү жана физикалык quantum hardware runtime өлчөөсү эмес.
Clinical чеги: Calibration analysis, independent external cohort validation жана reader study жок; булак clinical readiness ырастоосун бербейт.
Код жеткиликтүүлүгү: Булак implementation, configuration files, experiment scripts жана INbreast/BUS-UCLM patient-level split файлдары коомдук GitHub репозиторийинде бар экенин билдирет.
Маалымат жеткиликтүүлүгү: BreastMNIST MedMNIST benchmark аркылуу; INbreast жана BUS-UCLM өз камсыздоочуларынын жетүү шарттары менен алынышы мүмкүн.
Каржылоо / ыраазычылык: Булак São Paulo Research Foundation (FAPESP) grant 2013/07375-0, 2023/14427-0, 2024/00117-0, 2024/22853-0, 2026/11390-4 жана 2025/07171-2, ошондой эле Brazilian National Council for Scientific and Technological Development (CNPq) process 308529/2021-9 колдоосун билдирет.
Автор салымдары: Жүктөлгөн v2 PDFте өзүнчө CRediT/Author Contributions бөлүмү көрүнбөйт.
Кызыкчылыктардын кагылышы: Жүктөлгөн v2 PDFте өзүнчө competing-interests/conflict-of-interest билдирүүсү жок.
Этикалык билдирүү: Жүктөлгөн v2 PDFте өзүнчө ethics statement көрүнбөйт. Изилдөө жаңы бейтап маалыматтарын чогулткан эмес, коомчулукка ачык изилдөө маалымат топтомдорун колдонгон; бирок Verianla булак ачык бербеген этикалык комитет жыйынтыгын өзүнөн чыгарбайт.
Булак ичиндеги визуалдык эскертүү: Appendix Aдагы precision–recall барактарынын биринде панел аталыштары менен parsed caption ортосунда маалымат топтомунун аталышы жагынан шайкешсиз көрүнүш бар.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген