


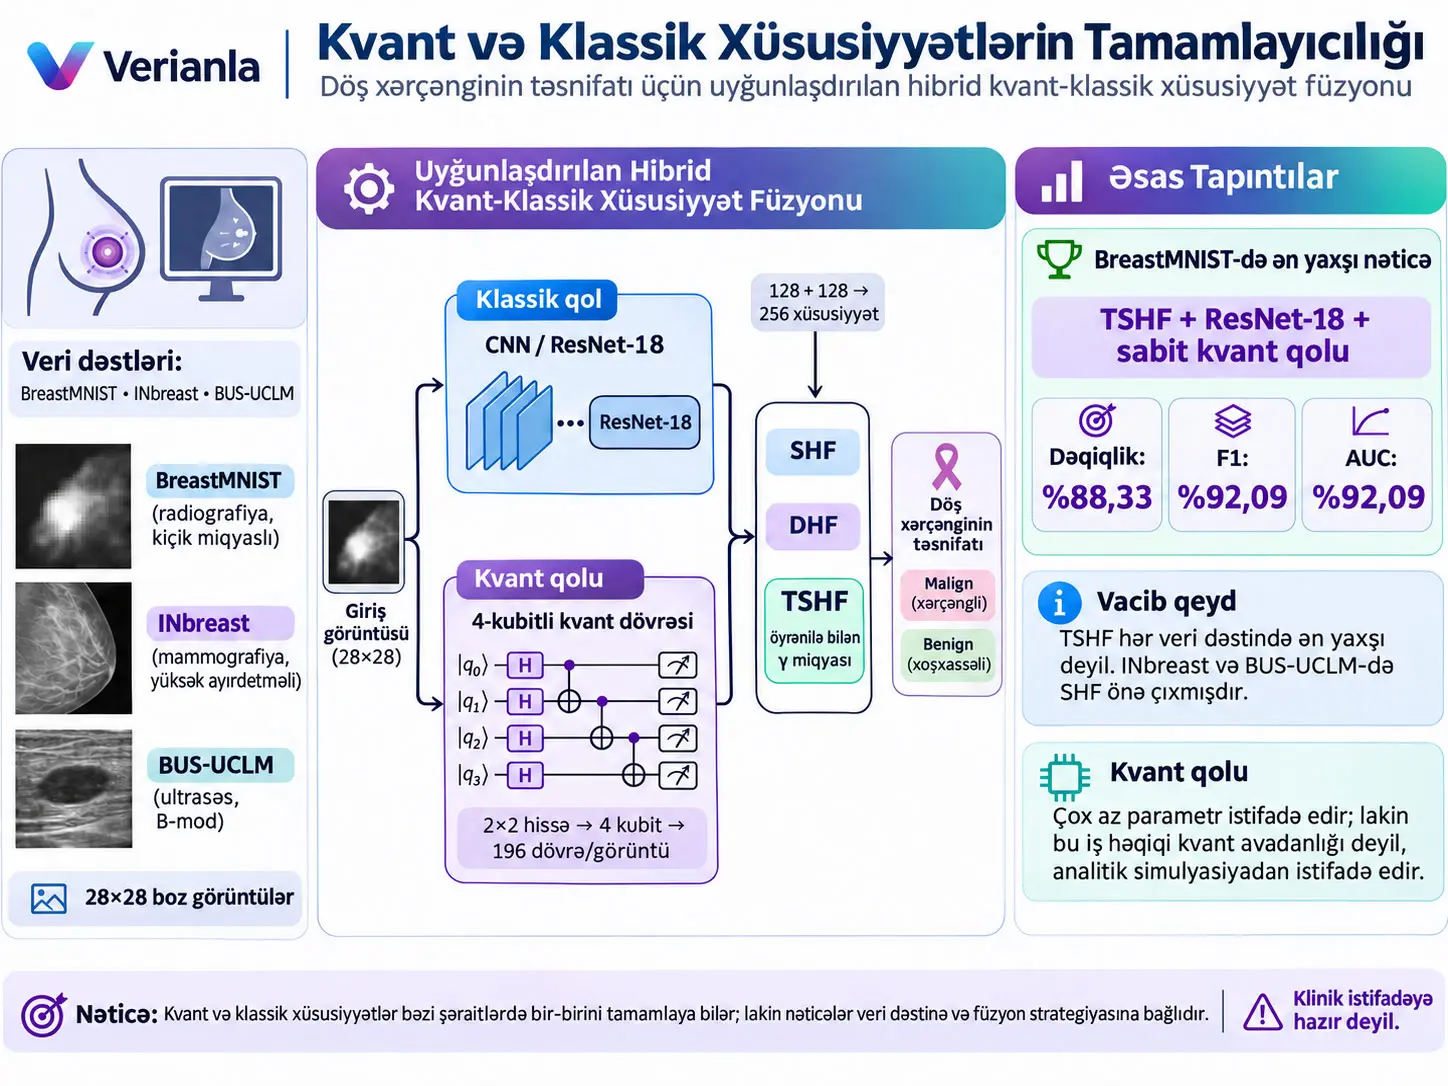
Uyğunlaşdırılan Hibrid Kvant-Klassik Xüsusiyyət Füzyonu, eyni döş görüntüsünü paralel klassik sinir şəbəkəsi və dörd kubitlik quanvolutional kvant qolu ilə emal edən, iki qolun yaratdığı fərqli xüsusiyyət təsvirlərini ortaq təsnifat fəzasında birləşdirən hibrid maşın öyrənməsi çərçivəsidir. Tədqiqat üç füzyon strategiyasını müqayisə edir: xüsusiyyətlərin əvvəlcədən çıxarıldığı və yalnız təsnifatçının öyrədildiyi Static Hybrid Fusion (SHF), iki qolun başdan-başa birlikdə öyrədildiyi Dynamic Hybrid Fusion (DHF) və kvant xüsusiyyətlərinin töhfəsini tək öyrədilə bilən \(\gamma\) əmsalı ilə miqyaslandıran Temperature-Scaled Hybrid Fusion (TSHF). Üç strategiya; ResNet-18 və shallow CNN olmaqla iki klassik backbone, trainable və deterministic/non-trainable olmaqla iki kvant qolu və BreastMNIST, INbreast və BUS-UCLM məlumat dəstləri üzərində beş müstəqil işə salınma ilə sınaqdan keçirilmişdir.
BreastMNIST-də ən yüksək dəqiqlik ResNet-18-i non-trainable kvant dövrəsi ilə TSHF altında birləşdirən modeldə əldə edilmişdir: dəqiqlik \(88.33\%\pm2.00\), F1-score \(92.09\%\pm1.25\) və AUC-ROC \(92.09\%\pm0.44\)-dür. Eyni məlumat dəstində yalnız ResNet-18 dəqiqliyi \(84.74\%\pm2.99\), AUC qiyməti isə \(87.08\%\pm3.07\)-dir. Lakin TSHF hər şəraitdə ən yaxşı deyil: INbreast-də ən yaxşı nəticə SHF + ResNet-18 + non-trainable kvant dövrəsi ilə \(70.42\%\pm3.73\) dəqiqlik, BUS-UCLM-də isə SHF + ResNet-18 + trainable dövrə ilə \(78.46\%\pm8.85\) dəqiqlik kimi tapılmışdır. Buna görə tədqiqat “daha adaptiv füzyon həmişə daha yaxşıdır” nəticəsini dəstəkləmir.
Kvant qolu görüntünü birbaşa böyük kvant register-ına yükləmir. 28×28 boz-səviyyəli görüntü non-overlapping 2×2 patch-lərə bölünür; beləliklə hər görüntü üçün 196 patch yaranır. Dörd pikselli hər patch dörd kubitə bucaq kodlaması ilə yerləşdirilir, dayaz kvant dövrəsi ilə emal olunur və hər kubitdə Pauli-\(Z\) gözlənilən qiyməti ölçülür. Dörd ölçmə patch-grid üzərində dörd xüsusiyyət kanalı yaradır. Bu struktur mənbədə quanvolutional layer adlandırılır.
Tədqiqatın diqqətçəkən nəticələrindən biri trainable kvant dövrəsinin yalnız dörd öyrədilə bilən kvant parametrindən istifadə etməsi, deterministic dövrənin isə heç bir öyrədilə bilən kvant parametri ehtiva etməməsidir. Bunun müqabilində istifadə olunan ResNet-18 backbone təxminən 11,17 milyon parametrə malikdir. Lakin bu parametr səmərəliliyi hesablama sürətlənməsi demək deyil: kvant dövrələri PennyLane lightning.qubit state-vector simulator üzərində CPU-da işlədildiyinə görə hibrid təlim klassik SCNN baseline ilə müqayisədə yüzlərlə və minlərlə dəfə daha yavaşdır.
Kvant nəticələri real fiziki kvant avadanlığında əldə edilməmişdir. Simulyasiya analytic mode-da və shot istifadə edilmədən aparılmışdır; shot noise, decoherence və gate error modelləşdirilməmişdir. Tədqiqat həmçinin 28×28 həllolma ölçülü kiçik açıq məlumat dəstlərindən istifadə edir və müstəqil klinik kohortda external validation, calibration analysis və ya reader study ehtiva etmir. Buna görə nəticələr klinik diaqnostika cihazının effektivliyinə və ya quantum computational advantage-a sübut deyil, hibrid xüsusiyyət füzyonunun metodoloji və kəşfiyyat xarakterli qiymətləndirilməsidir.
Tədqiqatın əsas tədqiqat sualı
Klassik convolutional neural network-lər görüntülərdən iyerarxik və məkan baxımından sabit xüsusiyyətləri öyrənməkdə güclüdür. Kvant dövrələri isə eyni giriş üzərində fərqli riyazi feature map yarada bilər. Bu tədqiqat iki təsvir növünün bir-birinin surəti olmaq əvəzinə bir-birini tamamlayıb-tamamlamadığını və bu tamamlayıcılığın döş görüntülərinin təsnifatında istifadə oluna bilən performans artımı verib-vermədiyini araşdırır.
Müəlliflərin hipotezi ondan ibarətdir ki, klassik və kvant qolları eyni görüntüləri fərqli şəkildə təşkil edir və iki təsviri eyni feature space daxilində birləşdirmək tək bir qolun verə bildiyindən daha zəngin kontekst yarada bilər. Bununla belə yalnız iki feature vector-u concatenate etmək kifayət etməyə bilər; klassik və kvant qollarının ölçüləri, dispersiyaları və gradient dinamikaları fərqli olduqda təlim zamanı klassik qol kvant qolunun töhfəsini sıxışdıra bilər.
Quanvolutional Qat Nədir?
Quanvolutional qat klassik convolution əməliyyatındakı lokal görüntü pəncərələrini kiçik kvant dövrələrində emal edərək hər patch üçün kvant gözlənilən qiymətlərindən yeni xüsusiyyət kanalları yaradan hibrid feature-extraction qatıdır; bu tədqiqatda hər 2×2 görüntü patch-i dörd kubitə bucaq kodlaması ilə yüklənir, dörd kubitlik dayaz dövrədə emal olunur və dörd Pauli-\(Z\) gözlənilən qiyməti çıxış xüsusiyyətinə çevrilir.
Giriş patch-inin kvant register-ına çevrilməsi
Təkkanallı görüntü üçün patch ölçüsü \(k\times k\) və kanal sayı \(c=1\) olduqda tələb olunan kubit sayı:
Tədqiqatın bütün təcrübələrində:
Yəni hər 2×2 patch daxilindəki dörd piksel dörd ayrı kubitin rotation angle-ını müəyyən edir.
28×28 görüntü patch size 2 və stride 2 ilə emal edildikdə hər ox üzrə 14 patch yaranır:
patch/görüntü əldə edilir. Buna görə hər görüntünün kvant qolu tərəfindən emalı 196 ayrıca kiçik quantum-circuit evaluation tələb edir.
Trainable quanvolution üçün bucaq kodlaması
Mənbənin Tənlik (3)-ü:
Formula nəyi hesablayır? Patch daxilindəki hər normallaşdırılmış piksel qiymətini ayrıca kubitin \(Y\)-oxu ətrafında fırlanma bucağına yerləşdirən giriş unitary-sini müəyyən edir.
\(x_i\): Patch daxilindəki \(i\)-ci piksel qiymətidir.
\(R_Y(x_i)\): \(i\)-ci kubit üzərində \(Y\)-oxu ətrafındakı fırlanma qapısıdır.
\(\bigotimes\): Dörd tək-kubit əməliyyatının birlikdə dörd-kubit register üzərində tətbiq olunduğunu göstərən tensor/Kronecker product işarəsidir.
Başlanğıc vəziyyəti:
olduğuna görə kodlanmış vəziyyət:
şəklində yaranır.
Variational ansatz nə edir?
Bucaq kodlamasından sonra mənbədə \(R_X\), \(R_Y\), \(R_Z\) parametrik fırlanmaları və CNOT dolaşdırıcı qapısını ehtiva edən dayaz variational ansatz \(U(\theta_Q)\) tətbiq edilir:
\(\theta_Q\) kvant dövrəsinin öyrədilə bilən parametr vektorudur. Bu tədqiqatdakı trainable dövrə yalnız bir circuit layer və dörd trainable quantum parameter istifadə edir.
Pauli-Z gözlənilən qiyməti necə xüsusiyyətə çevrilir?
Trainable dövrənin \(i\)-ci çıxış xüsusiyyəti:
Formula nəyi hesablayır? Kvant dövrəsi işə salındıqdan sonra \(i\)-ci kubit üzərində Pauli-\(Z\) observablının gözlənilən qiymətini hesablayır.
\(\sigma_z^{(i)}\) yalnız \(i\)-ci kubitə Pauli-\(Z\) tətbiq edən, digər kubitlərdə identity olan operatordur.
Gözlənilən qiymət
intervalındadır. Tədqiqat bu qiyməti ReLU əməliyyatından keçirir və hər kubitin çıxışını ayrıca feature channel kimi istifadə edir.
Deterministic/non-trainable kvant dövrəsi nə deməkdir?
Non-trainable variantda quantum rotation parameter-ları başlanğıcda
paylanmasından bir dəfə seçilir və təlim zamanı dəyişdirilmir. Giriş yenə angle encoding ilə dövrəyə ötürülür, lakin kvant dövrəsinin öz parametrləri sabit qalır.
Çıxış:
kimi hesablanır.
Dövrənin parametrləri optimallaşdırılmadığı üçün:
Bu sıfır gradient “model heç nə öyrənmir” demək deyil. Quantum feature map sabitdir; lakin bu feature-lardan istifadə edən projection head, fusion layer və classifier-ın klassik parametrləri öyrədilə bilər. Üstünlüyü quantum parameter optimization-ın və barren-plateau riskinin tamamilə aradan qalxmasıdır.
Quantum feature map-in ölçüsü
Hər patch dörd çıxış yaratdığına və patch grid 14×14 olduğuna görə quantum feature map:
ölçüsündədir. Table IV-ə görə bu struktur daha sonra bilinear resize, ReLU və flatten əməliyyatları ilə 784 ölçülü feature vector-a çevrilir. Quantum projection head:
xətti çevrilməni tətbiq edir.
Klassik qol da backbone növünə görə 128 və ya 512 ölçülü penultimate feature vector yaradır və ayrıca projection head ilə 128 ölçüyə uyğunlaşdırılır. Beləliklə iki qol füzyondan əvvəl eyni feature dimension-a gətirilir.
SHF, DHF və TSHF Arasındakı Fərq Nədir?
SHF kvant və klassik xüsusiyyətləri əvvəlcədən çıxarıb dondurur və yalnız fusion/classification head-i öyrədir; DHF iki qolun parametrlərini təsnifat xətası ilə birlikdə başdan-başa optimallaşdırır; TSHF isə DHF-nin birgə təliminə əlavə olaraq normallaşdırılmış kvant feature vector-unu tək öyrədilə bilən \(\gamma\) əmsalı ilə miqyaslandıraraq iki qol arasındakı feature-magnitude və gradient balanssızlığını tənzimləməyə çalışır.
Static Hybrid Fusion — SHF
Kvant feature extractor:
və klassik feature extractor:
təsvirlərini yaradır. Hər iki branch ayrıca projection head ilə eyni \(d=128\) ölçüyə gətirilir və \(\ell_2\)-normallaşdırılır.
Birləşdirilmiş təsvir:
\(\oplus\): concatenation operatorudur.
İki 128-ölçülü vector birləşdirildiyinə görə:
SHF-də feature extractors füzyon mərhələsində frozen vəziyyətdədir. Gradient quantum və ya classical backbone-a geri getmir; yalnız classifier/fusion head öyrədilir.
Dynamic Hybrid Fusion — DHF
DHF eyni concatenation strukturundan istifadə edir, lakin frozen feature extraction əvəzinə vahid forward/backward pipeline yaradır. Cross-entropy loss-dan gələn gradient classifier-dan iki qola ayrılır:
- klassik branch-in \(\phi\) parametrlərinə,
- trainable quantum branch istifadə olunursa \(\theta_Q\) parametrlərinə.
Bu co-adaptation daha çox çeviklik verir; lakin mənbədə əsas problem kimi müəyyən edilən optimization asymmetry burada meydana çıxır. Xeyli daha böyük və daha yaxşı condition edilmiş klassik şəbəkənin gradient strukturu kvant qolunu sıxışdıra bilər.
Temperature-Scaled Hybrid Fusion — TSHF
TSHF DHF-yə tək öyrədilə bilən scalar əlavə edir:
\(\gamma\) ölçüsüz tək trainable parametrdir və başlanğıcda:
kimi təyin edilir. Bu, başlanğıcda standart concatenation ilə eyni məna daşıyır.
Gradient təsiri mənbənin Tənlik (7)-sində:
şəklində göstərilir.
Formula nəyi hesablayır? Quantum embedding-ə geri gedən loss gradient-inin \(\gamma\) ilə miqyaslandığını göstərir.
\(\mathcal L\): təsnifat itkisidir.
\(h_Q\): quantum feature vector-dur.
\(\gamma>1\): digər bütün amillər eyni olduqda quantum embedding-in forward keçiddə və backward gradient-də nisbi miqyasını artırır.
\(0<\gamma<1\): nisbi miqyası azaldır.
Mənbənin tətbiqində \(\gamma\), müsbətliyi qorumaq üçün tətbiq qatında \(\exp(\log\gamma)\) vasitəsilə təmsil olunur.
\(\ell_2\) normallaşdırma niyə mərkəzi əhəmiyyət daşıyır?
TSHF mexanizmini yalnız \(\gamma\) üzərindən oxumaq natamam olar. Mənbənin ən yaxşı BreastMNIST konfiqurasiyasındakı ətraflı branch-norm analizi projection output mərhələsində quantum branch normasının klassik branch-dən sistematik olaraq kiçik olduğunu göstərir:
Klassik norma test nümunələri arasında təxminən 52 dəfə dəyişdiyi halda quantum norma təxminən 8,6 dəfə dəyişir. Normallaşdırmadan əvvəl branch nisbəti təxminən 0,01–1,4 intervalında dəyişir.
Bu şəraitdə kvant qolunun fused-vector enerjisindəki median payı yalnız:
kimi bildirilir.
Branch-wise \(\ell_2\) normalization iki feature vector-un normasını vahid qiymətə bərabərləşdirir. Bundan sonra \(\gamma\) qalan yeganə nisbi scale parameter olur.
İki normallaşdırılmış branch üçün mənbənin Şəkil 12 açıqlamasındakı quantum-energy payı:
Məsələn, təmsilçi işə salınmada:
üçün quantum payı təxminən:
kimi verilir. Beş işə salınmanın ortalamasındakı
isə təxminən %51,2 quantum payına uyğun gəlir.
Bu analiz düzəlişin böyük hissəsini \(\ell_2\) normalization-ın etdiyini; \(\gamma\)-nın isə normallaşdırmadan sonra qalan branch balance-ı tək degree of freedom ilə tənzimlədiyini göstərir.
Barren plateau nədir və burada niyə vacibdir?
Tədqiqatın trainable quantum branch dizaynında istifadə olunan “barren plateau”, kvant dövrəsi genişləndikcə və ya dərinləşdikcə loss gradient-lərinin çox kiçilərək optimallaşdırmanı çətinləşdirə bildiyi training-landscape problemidir. Müəlliflər buna görə dövrəni qəsdən dörd kubit, bir variational layer və yalnız dörd quantum parameter ilə kiçik saxlayırlar. Bu dizayn optimization riskini azaldır, lakin eyni zamanda trainable dövrənin representational capacity-sini məhdudlaşdırır.
Deterministic quantum feature map niyə təəccüblü dərəcədə rəqabətqabiliyyətlidir?
Deterministic dövrə training zamanı quantum gradient tələb etmir, barren plateau ilə qarşılaşmır və quantum features məlumat dəsti üçün bir dəfə əvvəlcədən hesablanıb cache edilə bilər. Tədqiqatda ən yaxşı BreastMNIST və INbreast konfiqurasiyalarının non-trainable quantum branch istifadə etməsi “öyrədilə bilən kvant dövrəsi həmişə daha güclüdür” fərziyyəsini dəstəkləmir.
Lakin mənbə bu nəticəni variational quantum circuit-lər haqqında ümumi hökmə çevirmir. İstifadə olunan trainable ansatz yalnız dörd parametrli və birqatlıdır. Daha geniş və ya daha dərin trainable quantum circuits fərqli nəticə verə bilər; bu məsələ gələcək tədqiqat mövzusu kimi saxlanılır.
Tədqiqatın Metodu və Nəticələri
İstifadə olunan üç məlumat dəsti
| Məlumat dəsti | Bölmə | Xoşxassəli | Bədxassəli | Cəmi | Bədxassəli nisbəti |
|---|---|---|---|---|---|
| BreastMNIST | Təlim | 399 | 147 | 546 | %26,9 |
| BreastMNIST | Doğrulama | 57 | 21 | 78 | %26,9 |
| BreastMNIST | Test | 114 | 42 | 156 | %26,9 |
| BreastMNIST | Cəmi | 570 | 210 | 780 | %26,9 |
| INbreast | Təlim | 160 | 150 | 310 | %48,4 |
| INbreast | Doğrulama | 38 | 37 | 75 | %49,3 |
| INbreast | Test | 50 | 46 | 96 | %47,9 |
| INbreast | Cəmi | 248 | 233 | 481 | %48,4 |
| BUS-UCLM | Təlim | 135 | 64 | 199 | %32,2 |
| BUS-UCLM | Doğrulama | 32 | 7 | 39 | %17,9 |
| BUS-UCLM | Test | 7 | 19 | 26 | %73,1 |
| BUS-UCLM | Cəmi | 174 | 90 | 264 | %34,1 |
BreastMNIST
BreastMNIST MedMNIST tərəfindən təqdim olunan native 28×28 boz-səviyyəli ultrasəs görüntüləridir. Mənbə rəsmi train/validation/test split-i dəyişdirmədən istifadə edir.
Bu məlumat dəstində metriklərin şərhində xüsusilə diqqət edilməli etiket konvensiyası var: müsbət sinif benign/normal kateqoriyadır. Buna görə BreastMNIST precision, recall və F1 qiymətləri benign sinfə görə hesablanmışdır.
INbreast
INbreast rəqəmsal mammogram məlumat dəstidir. Mənbə expert annotation-lardan istifadə edərək suspicious tumor region-ları crop edir. Bir görüntüdə birdən çox region of interest varsa, hər bölgə ayrıca sample kimi götürülə bilər.
Crop edilmiş bölgələr:
- Contrast Limited Adaptive Histogram Equalization (CLAHE) ilə yaxşılaşdırılır,
- hər görüntü üzrə min–max normalization ilə \([0,1]\) intervalına gətirilir,
- 28×28 ölçüsünə yenidən miqyaslandırılır.
INbreast-də müsbət sinif malignant kateqoriyadır.
BUS-UCLM
BUS-UCLM annotated breast-ultrasound görüntüləridir. Mənbə görüntülərə crop və ya CLAHE tətbiq etmir; yalnız normalization və 28×28 resize tətbiq edir.
BUS-UCLM-də də müsbət sinif malignant kateqoriyadır.
INbreast və BUS-UCLM split-ləri patient level-da yaradılır: eyni xəstədən gələn nümunələr birdən çox split-ə paylanmır. Beləliklə patient leakage-in qarşısı alınır.
BUS-UCLM-də sinif paylanması niyə xüsusilə problemlidir?
Təlim dəstində malignant nisbəti %32,2 olduğu halda validation-da %17,9, testdə isə %73,1-dir. Mənbə az sayda xəstə üzərində patient-level partition tətbiqinin bu böyük prevalence shift-i yaratdığını və BUS-UCLM nəticələrinin buna görə yalnız indicative kimi qiymətləndirilməli olduğunu açıq şəkildə bildirir.
Test dəstində yalnız 26 görüntü olduğu üçün tək bir yanlış təsnifat:
accuracy point dəyişməsi yaradır.
Giriş normalization
Table IV bütün modellər üçün girişi:
grayscale tensor kimi müəyyən edir və preprocessing-də:
normalization parametrlərini verir.
Klassik backbone-lar
| Model | Xüsusiyyət | Feature ölçüsü | Ümumi parametr |
|---|---|---|---|
| Shallow CNN (SCNN) | Üç convolution block, BatchNorm, ReLU, pooling/GAP | 128 | 93.378 |
| ResNet-18 | ImageNet initialization, ilk convolution tək kanala uyğunlaşdırılıb | 512 | 11.171.266 |
Kvant branch-in tam struktur xülasəsi
| Element | Mənbə ayarı |
|---|---|
| Patch | 2×2, non-overlapping |
| Stride | 2 |
| Patch sayı | 196 |
| Kubit | 4 |
| Ölçmə | \(\langle Z_j\rangle,\;j=1,\ldots,4\) |
| Xam feature map | 4×14×14 |
| Post-processing | Bilinear resize + ReLU + flatten |
| Flatten ölçüsü | 784 |
| Quantum projection | 784→128 |
| Fixed circuit trainable quantum parameter | 0 |
| Trainable circuit trainable quantum parameter | 4 |
| Variational layer | 1 |
Fusion qatının ölçüləri
Klassik və kvant projection output-ları:
kimi normallaşdırılır. Concatenation-dan sonra:
Bu vector ReLU və 256→2 classifier vasitəsilə iki sinfin score/probability çıxışına çevrilir.
Təlim hiperparametrləri
| Hiperparametr | SCNN | ResNet-18 | Quantum fixed | Quantum trainable | SHF | DHF | TSHF |
|---|---|---|---|---|---|---|---|
| Epoch | 20 | 20 | 10 | 10 | 10 | 10 | 10 |
| Batch size | 16 | 16 | 16 | 16 | 16 | 16 | 16 |
| Əsas learning rate | \(10^{-3}\) | \(10^{-3}\) | \(3\times10^{-3}\) | \(10^{-2}\) | — | — | — |
| Classical branch LR | — | — | — | — | \(10^{-4}\) | \(10^{-4}\) | \(10^{-4}\) |
| Quantum branch LR | — | — | — | — | \(10^{-2}\) | \(10^{-2}\) | \(10^{-2}\) |
| Fusion head LR | — | — | — | — | \(10^{-3}\) | \(10^{-3}\) | \(10^{-1}\) |
| \(\gamma\) LR | — | — | — | — | Yoxdur | Yoxdur | \(10^{-2}\) |
| Fused feature dim. | — | — | — | — | 128/branch | 128/branch | 128/branch |
Bütün modellər Adam optimizer və cross-entropy loss istifadə edir.
Simulyasiya və avadanlıq mühiti
| Element | Mənbədə verilən məlumat |
|---|---|
| Classical framework | PyTorch |
| Quantum framework | PennyLane |
| Trainable integration | TorchLayer |
| Quantum backend | lightning.qubit state-vector |
| Quantum mode | Analytic mode, no shots |
| Quantum execution | CPU |
| Classical execution | CUDA-enabled NVIDIA L40S GPU |
| Müstəqil təkrar | 5 seed / configuration |
| Optimizer | Adam |
| Loss | Cross-entropy |
Standalone baseline nəticələri
| Məlumat dəsti | Paradiqma | Model | Accuracy | Precision | Recall | F1 | AUC |
|---|---|---|---|---|---|---|---|
| BreastMNIST | Klassik | SCNN | 82.82 ± 2.70 | 86.27 ± 2.26 | 91.05 ± 3.79 | 88.55 ± 1.93 | 84.49 ± 2.23 |
| BreastMNIST | Klassik | ResNet-18 | 84.74 ± 2.99 | 88.67 ± 1.69 | 90.70 ± 2.82 | 89.67 ± 2.10 | 87.08 ± 3.07 |
| BreastMNIST | Kvant | Non-trainable | 78.21 ± 1.98 | 82.69 ± 4.80 | 89.47 ± 4.92 | 85.73 ± 0.54 | 79.42 ± 3.13 |
| BreastMNIST | Kvant | Trainable | 77.82 ± 2.06 | 81.18 ± 3.33 | 91.05 ± 4.45 | 85.71 ± 1.26 | 78.32 ± 1.67 |
| INbreast | Klassik | SCNN | 67.92 ± 2.38 | 65.05 ± 4.16 | 73.04 ± 5.87 | 68.56 ± 1.13 | 78.78 ± 1.61 |
| INbreast | Klassik | ResNet-18 | 68.33 ± 2.72 | 72.91 ± 13.87 | 66.09 ± 24.04 | 65.15 ± 7.93 | 77.30 ± 4.54 |
| INbreast | Kvant | Non-trainable | 69.58 ± 2.49 | 65.78 ± 2.71 | 76.52 ± 5.83 | 70.63 ± 2.85 | 78.63 ± 1.32 |
| INbreast | Kvant | Trainable | 70.00 ± 2.49 | 70.00 ± 6.74 | 68.26 ± 9.55 | 68.44 ± 1.97 | 77.15 ± 2.86 |
| BUS-UCLM | Klassik | SCNN | 66.92 ± 9.26 | 93.20 ± 4.19 | 58.95 ± 12.57 | 71.66 ± 10.05 | 91.88 ± 3.58 |
| BUS-UCLM | Klassik | ResNet-18 | 65.38 ± 9.02 | 95.14 ± 4.58 | 55.79 ± 13.72 | 69.36 ± 11.04 | 86.62 ± 5.27 |
| BUS-UCLM | Kvant | Non-trainable | 69.23 ± 9.02 | 97.24 ± 3.79 | 60.00 ± 14.22 | 73.15 ± 11.26 | 86.47 ± 3.94 |
| BUS-UCLM | Kvant | Trainable | 70.77 ± 15.53 | 86.67 ± 8.81 | 72.63 ± 25.35 | 76.64 ± 15.40 | 81.80 ± 12.01 |
Standalone nəticələrin mənası
BreastMNIST-də klassik ResNet-18 quantum-only modellərdən nəzərəçarpacaq dərəcədə daha yüksək dəqiqliyə malikdir. INbreast və BUS-UCLM-də isə standalone quantum modellər klassik modellərlə eyni səviyyədə və ya accuracy baxımından bir qədər yüksək nəticələr göstərə bilər. Lakin xüsusilə BUS-UCLM-də standart sapmalar çox böyükdür və kiçik test dəsti səbəbindən nəticələr qeyri-sabitdir.
BreastMNIST — bütün füzyon nəticələrinin xülasəsi
| Strategiya | Klassik | Kvant | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 84.74 ± 2.10 | 88.88 ± 1.73 | 92.12 ± 0.18 | — |
| SHF | ResNet-18 | Non-trainable | 78.46 ± 2.89 | 85.61 ± 2.70 | 81.14 ± 1.24 | — |
| SHF | SCNN | Trainable | 80.77 ± 1.28 | 87.08 ± 1.01 | 83.56 ± 1.19 | — |
| SHF | SCNN | Non-trainable | 80.77 ± 1.50 | 86.92 ± 1.14 | 83.07 ± 0.66 | — |
| DHF | ResNet-18 | Trainable | 84.87 ± 1.79 | 89.21 ± 1.73 | 92.48 ± 0.52 | — |
| DHF | ResNet-18 | Non-trainable | 86.28 ± 2.20 | 90.22 ± 1.84 | 92.39 ± 0.24 | — |
| DHF | SCNN | Trainable | 80.00 ± 3.52 | 86.52 ± 3.54 | 82.45 ± 0.55 | — |
| DHF | SCNN | Non-trainable | 81.54 ± 1.39 | 87.62 ± 1.03 | 83.46 ± 0.86 | — |
| TSHF | ResNet-18 | Trainable | 86.15 ± 1.48 | 90.11 ± 1.26 | 92.18 ± 0.22 | 1.280 ± 0.331 |
| TSHF | ResNet-18 | Non-trainable | 88.33 ± 2.00 | 92.09 ± 1.25 | 92.09 ± 0.44 | 1.025 ± 0.039 |
| TSHF | SCNN | Trainable | 81.54 ± 0.84 | 88.10 ± 0.80 | 83.71 ± 0.64 | 0.930 ± 0.053 |
| TSHF | SCNN | Non-trainable | 81.92 ± 0.95 | 88.23 ± 0.81 | 83.29 ± 0.84 | 1.019 ± 0.057 |
BreastMNIST-də ən yüksək accuracy və F1 TSHF + ResNet-18 + non-trainable dövrədə əldə edilir. Lakin ən yüksək AUC:
ilə DHF + ResNet-18 + trainable konfiqurasiyasındadır. Buna görə “TSHF bütün metriklərdə ən yaxşıdır” nəticəsi düzgün deyil.
BreastMNIST confusion-matrix mesajı
Mənbə beş işə salınmanın ümumi confusion matrix-lərində ən yaxşı TSHF modelinin malignant nümunələrin benign kimi təsnif edilməsini standalone ResNet-18 və deterministic quantum baseline ilə müqayisədə azaltdığını; benign nümunələrin malignant sinfə keçməsini də azaltdığını bildirir. Yəni bu məlumat dəstində improvement yalnız operating threshold-u bir sinfin xeyrinə dəyişdirməkdən deyil, hər iki xəta növünün birlikdə azalmasından yaranır.
INbreast — bütün füzyon nəticələrinin xülasəsi
| Strategiya | Klassik | Kvant | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 66.87 ± 4.32 | 68.73 ± 3.57 | 79.62 ± 0.09 | — |
| SHF | ResNet-18 | Non-trainable | 70.42 ± 3.73 | 72.96 ± 1.29 | 80.28 ± 0.46 | — |
| SHF | SCNN | Trainable | 68.33 ± 0.93 | 66.55 ± 3.76 | 76.83 ± 2.20 | — |
| SHF | SCNN | Non-trainable | 68.75 ± 1.47 | 65.81 ± 3.63 | 77.70 ± 0.98 | — |
| DHF | ResNet-18 | Trainable | 67.08 ± 2.16 | 69.91 ± 2.56 | 74.67 ± 1.26 | — |
| DHF | ResNet-18 | Non-trainable | 69.79 ± 1.95 | 70.30 ± 4.09 | 76.25 ± 2.04 | — |
| DHF | SCNN | Trainable | 68.33 ± 2.51 | 65.76 ± 5.99 | 76.55 ± 2.48 | — |
| DHF | SCNN | Non-trainable | 68.54 ± 2.80 | 64.99 ± 4.79 | 77.12 ± 1.50 | — |
| TSHF | ResNet-18 | Trainable | 67.92 ± 1.55 | 69.32 ± 3.12 | 76.53 ± 1.25 | 1.080 ± 0.169 |
| TSHF | ResNet-18 | Non-trainable | 65.42 ± 3.71 | 70.72 ± 1.71 | 78.12 ± 1.22 | 1.095 ± 0.150 |
| TSHF | SCNN | Trainable | 67.71 ± 6.46 | 67.80 ± 3.07 | 75.26 ± 2.54 | 0.977 ± 0.053 |
| TSHF | SCNN | Non-trainable | 68.13 ± 3.50 | 69.36 ± 2.46 | 75.70 ± 2.76 | 1.045 ± 0.084 |
INbreast-də adaptiv strategiyalar static fusion-u üstələmir. Ən yaxşı nəticə frozen feature extractors istifadə edən SHF-dən gəlir.
Confusion matrix analizi bu məlumat dəstindəki qazancın BreastMNIST-dəki mexanizmdən fərqli olduğunu göstərir: missed malignant hallar azalarkən benign nümunələrdə false-positive sayı artır. Buna görə fusion burada sensitivity–specificity trade-off-u dəyişir.
BUS-UCLM — bütün füzyon nəticələrinin xülasəsi
| Strategiya | Klassik | Kvant | Accuracy | F1 | AUC | \(\gamma\) |
|---|---|---|---|---|---|---|
| SHF | ResNet-18 | Trainable | 78.46 ± 8.85 | 84.66 ± 6.57 | 89.47 ± 3.28 | — |
| SHF | ResNet-18 | Non-trainable | 73.08 ± 7.69 | 78.16 ± 7.38 | 90.38 ± 2.09 | — |
| SHF | SCNN | Trainable | 62.31 ± 6.88 | 65.39 ± 7.81 | 87.52 ± 2.64 | — |
| SHF | SCNN | Non-trainable | 56.15 ± 9.65 | 56.46 ± 14.79 | 90.23 ± 4.15 | — |
| DHF | ResNet-18 | Trainable | 58.46 ± 7.40 | 61.98 ± 9.01 | 82.56 ± 6.43 | — |
| DHF | ResNet-18 | Non-trainable | 69.23 ± 9.02 | 74.41 ± 10.00 | 89.17 ± 3.39 | — |
| DHF | SCNN | Trainable | 59.23 ± 4.39 | 61.69 ± 5.64 | 89.77 ± 2.41 | — |
| DHF | SCNN | Non-trainable | 55.38 ± 5.83 | 56.10 ± 8.69 | 88.57 ± 3.66 | — |
| TSHF | ResNet-18 | Trainable | 65.38 ± 13.60 | 68.98 ± 16.03 | 83.16 ± 13.44 | 0.989 ± 0.045 |
| TSHF | ResNet-18 | Non-trainable | 53.08 ± 14.24 | 51.13 ± 24.55 | 81.95 ± 11.09 | 1.005 ± 0.024 |
| TSHF | SCNN | Trainable | 62.31 ± 15.24 | 64.45 ± 19.75 | 88.57 ± 4.13 | 0.959 ± 0.062 |
| TSHF | SCNN | Non-trainable | 54.62 ± 20.24 | 50.51 ± 33.42 | 87.67 ± 4.68 | 1.025 ± 0.045 |
BUS-UCLM-də ən yaxşı accuracy və F1 static fusion-dadır. Buna qarşılıq məlumat dəstindəki ən yüksək AUC:
ilə standalone SCNN-yə məxsusdur. Bu da fusion-un “hər metriki artırdığı” şərhini mümkünsüz edir.
TSHF Niyə Hər Məlumat Dəstində Ən Yaxşı Deyil?
TSHF-nin əlavə \(\gamma\) kalibrasiyası və end-to-end co-adaptation-ı özləri də öyrənilməli olan əlavə sərbəstliklərdir; BreastMNIST-in 546 təlim nümunəsində bu çeviklik fayda verdiyi halda, INbreast-in 310 və BUS-UCLM-nin 199 təlim nümunəsində mənbə daha sadə SHF-nin daha yaxşı generalization göstərdiyini və kiçik məlumat dəstlərinin branch-weight calibration ilə birgə optimallaşdırmanı etibarlı şəkildə öyrənmək üçün kifayət qədər siqnal verməmiş ola biləcəyini bildirir.
Temperature scalar ablasiyası
Mənbə BreastMNIST + ResNet-18 üzərində:
- scaling yoxdur,
- \(\gamma=0.001\),
- \(\gamma=0.01\),
- \(\gamma=0.1\),
- \(\gamma=0.5\),
- \(\gamma=2\),
- branch-wise \(\ell_1\) normalization,
- öyrədilə bilən \(\gamma\)
seçimlərini müqayisə edir.
Non-trainable quantum branch-də learned TSHF:
accuracy ilə bu blokda ən yaxşı nəticəni verir.
Trainable quantum branch-də isə \(\ell_1\) normalization:
accuracy ilə learned TSHF-nin:
qiymətindən daha yüksəkdir.
Beləliklə learned scalar praktik avtomatik calibration mechanism təqdim edir, lakin bütün quantum branch növlərində ən yüksək accuracy-ni təmin etmir.
Öyrənilən \(\gamma\) nə qədər dəyişir?
On iki TSHF konfiqurasiyasının hamısında mənbə:
intervalını bildirir. On bir konfiqurasiyada qiymət başlanğıc nöqtəsi \(1.0\)-ın təxminən %10-u daxilində qalır.
Buna görə \(\gamma\) qiymətini məlumat dəstinin “çətinlik dərəcəsi” kimi oxumaq düzgün deyil. Müəlliflər bunu xüsusi olaraq rədd edirlər.
UMAP analizi nə göstərir?
Mənbə BreastMNIST, INbreast və BUS-UCLM embeddings-lərini Uniform Manifold Approximation and Projection (UMAP) ilə iki ölçüyə endirir. Standalone classical və quantum branches eyni nümunələri fərqli latent həndəsələrdə təşkil edir; fusion-dan sonra bəzi uğurlu konfiqurasiyalarda benign və malignant nümunələr vizual olaraq daha strukturlaşmış bölgələrdə toplanır.
Lakin müəlliflər UMAP-in:
- non-linear,
- stochastic,
- hyperparameter-sensitive
vizuallaşdırma olduğunu və təkbaşına sinif separability metriyi hesab edilə bilməyəcəyini açıq şəkildə bildirirlər. Göstərimlər yalnız bir run-a aiddir. Kəmiyyət separability iddiasının əsası UMAP görüntüsü deyil, AUC qiymətləridir.
%95 etibar intervalları
Appendix E beş müstəqil run ortalaması üçün %95 confidence interval verir. Bunlar beş seed-in ortalamasına dair etibar intervallarıdır; minlərlə müstəqil klinik xəstə üzrə population confidence interval kimi şərh edilməməlidir.
| Məlumat dəsti | Konfiqurasiya | Accuracy | F1 | AUC |
|---|---|---|---|---|
| BreastMNIST | TSHF + ResNet-18 + non-trainable | 88.33 [85.85, 90.81] | 92.09 [90.54, 93.64] | 92.09 [91.54, 92.64] |
| INbreast | SHF + ResNet-18 + non-trainable | 70.42 [65.79, 75.05] | 72.96 [71.36, 74.56] | 80.28 [79.71, 80.85] |
| BUS-UCLM | SHF + ResNet-18 + trainable | 78.46 [67.47, 89.45] | 84.66 [76.50, 92.82] | 89.47 [85.40, 93.54] |
BUS-UCLM confidence interval-larının genişliyi kiçik test nümunəsi və seed-to-seed dəyişkənliklə uyğundur.
Formal significance testi aparılıbmı?
Xeyr. Mənbə competing methods arasında formal statistical significance testing aparılmadığını açıq şəkildə bildirir. Buna görə orta accuracy və ya AUC fərqləri “statistik olaraq sübut edilmiş üstünlük” şəklində ifadə edilməməlidir. Müəlliflər fərqləri descriptive trend kimi qiymətləndirir və sample-level paired analysis-i gələcək tədqiqata saxlayırlar.
Əvvəlki hibrid modellərlə BreastMNIST müqayisəsi
| Model / tədqiqat | Accuracy | F1 | AUC |
|---|---|---|---|
| Matondo et al. | 76.66 | 68.00 | Bildirilməyib |
| Yurtseven et al. | 86.54 | 91.31 | Bildirilməyib |
| Sobrinho et al. | 82.10 | 80.30 | 82.60 |
| Bu tədqiqat — SHF, ResNet-18 + trainable | 84.74 ± 2.10 | 88.88 ± 1.73 | 92.12 ± 0.18 |
| Bu tədqiqat — DHF, ResNet-18 + non-trainable | 86.28 ± 2.20 | 90.22 ± 1.84 | 92.39 ± 0.24 |
| Bu tədqiqat — TSHF, ResNet-18 + non-trainable | 88.33 ± 2.00 | 92.09 ± 1.25 | 92.09 ± 0.44 |
Müqayisənin mühüm məhdudiyyəti budur: bu tədqiqatın qiymətləri beş seed ortalamasıdır; mənbədə müqayisə edilən əvvəlki tədqiqatların qiymətləri single-run hesabatlarıdır. Buna görə cədvəldə eyni test split-in istifadə olunması faydalı olsa da, eksperiment protokolları tam ekvivalent deyil.
Computational cost
| Model | Ümumi parametr | Circuit / görüntü | Inference (ms/görüntü) | Training (ms/addım) | SCNN-yə görə training slowdown |
|---|---|---|---|---|---|
| SCNN | 93.378 | 0 | 0.03 | 2.4 | 1× |
| ResNet-18 | 11.171.266 | 0 | 0.22 | 55 | 23× |
| QC-fixed | 1.570 | 196 | 118 | 2.357 | ≈\(9.6\times10^2\) |
| QC-trainable | 1.574 | 196 | 143 | 8.304 | ≈\(3.4\times10^3\) |
| SHF + SCNN | 210.888 | 196 | 176 | 2.864 | ≈\(1.2\times10^3\) |
| SHF + ResNet-18 | 11.337.928 | 196 | 134 | 2.140 | ≈\(8.7\times10^2\) |
| DHF + SCNN | 210.888 | 196 | 149 | 8.839 | ≈\(3.6\times10^3\) |
| DHF + ResNet-18 | 11.337.928 | 196 | 169 | 12.785 | ≈\(5.2\times10^3\) |
| TSHF + SCNN | 210.889 | 196 | 190 | 12.283 | ≈\(5.0\times10^3\) |
| TSHF + ResNet-18 | 11.337.929 | 196 | 180 | 9.442 | ≈\(3.9\times10^3\) |
TSHF yalnız bir əlavə learnable scalar əlavə etdiyi üçün DHF ilə müqayisədə analitik model mürəkkəbliyini nəzərəçarpacaq dərəcədə artırmır. Table XI-də DHF və TSHF arasındakı measured runtime fərqləri run-to-run dispersion daxilində qiymətləndirilir; mənbə bu zaman fərqlərini \(\gamma\) mexanizminin birbaşa xərci kimi şərh etmir.
Bu Tədqiqat Kvant Üstünlüyünü və ya Kvant Sürətlənməsini Sübut Edirmi?
Xeyr; tədqiqat simulated dörd-kubit quanvolutional feature maps-in klassik CNN xüsusiyyətləri ilə tamamlayıcı təsvir yarada bildiyinə dair metodoloji sübut təqdim edir, lakin fiziki kvant avadanlığında klassik metodlardan daha sürətli, daha ucuz və ya daha dəqiq end-to-end hesablama göstərmədiyi üçün quantum computational advantage və ya quantum speedup sübut etmir.
Niyə parametr səmərəliliyi sürətlənmə deyil?
Trainable quantum circuit yalnız dörd trainable quantum parameter istifadə etdiyi halda ResNet-18 təxminən 11,17 milyon parametr ehtiva edir. Bu, mühüm parameter-efficiency fərqidir.
Lakin hər görüntü 196 ayrıca quantum-circuit evaluation tələb etdiyinə və bu dövrələr state-vector simulator üzərində CPU-da işlədildiyinə görə wall-clock runtime çox yüksəkdir. Mənbənin öz nəticəsinə görə simulated hybrid pipeline klassik SCNN-dən təxminən üç böyüklük mərtəbəsinə qədər daha yavaş ola bilər.
Müəlliflər real quantum hardware üzərində cost profile-ın fərqli olacağını bildirirlər; lakin bunun nə qədər fərqli olacağını ölçmürlər. Buna görə Verianla gələcək avadanlıq sürətini ədədi olaraq təxmin etmir.
Tədqiqatın dəstəklədiyi nəticələr
- Klassik və kvant feature representations eyni görüntüləri fərqli latent strukturlarda təşkil edə bilər və bu fərq bəzi məlumat dəstlərində faydalı fusion siqnalı verə bilər.
- BreastMNIST-də TSHF + ResNet-18 + non-trainable kvant branch standalone ResNet-18-dən daha yüksək accuracy, F1 və AUC əldə etmişdir.
- INbreast və BUS-UCLM-də ən yaxşı accuracy adaptive TSHF-dən deyil, SHF-dən gəlmişdir.
- Adaptive fusion-un faydası məlumat miqdarından və branch/model seçimindən asılıdır; universal deyil.
- Deterministic quantum feature map iki məlumat dəstində ən yaxşı konfiqurasiyanın bir hissəsidir və trainable quantum parameter tələb etmir.
- Trainable quantum branch-in dörd parametrli birqatlı ansatz-ı deterministic dövrəni ardıcıl şəkildə üstələmir.
- Branch-wise normalization quantum/classical magnitude asimmetriyasının böyük hissəsini düzəldir.
- Learnable \(\gamma\) normalization-dan sonra qalan relative branch scale-ı tək parametrlə tənzimləyir.
- UMAP görüntüləri classical və quantum latent representations-ın fərqli şəkildə təşkil oluna bildiyini keyfiyyətcə göstərir.
- Quantitative class separability qiymətləndirilməsi UMAP əvəzinə AUC üzərindən aparılmalıdır.
Tədqiqatın dəstəkləmədiyi nəticələr
- Real kvant kompüterinin döş xərçəngini klassik kompüterdən daha yaxşı təsnif etdiyi göstərilməmişdir.
- Quantum speedup və ya quantum computational advantage göstərilməmişdir.
- Shot noise, decoherence və gate error ehtiva edən fiziki quantum hardware davranışı sınaqdan keçirilməmişdir.
- TSHF-nin bütün məlumat dəstlərində və bütün metriklərdə ən yaxşı olduğu göstərilməmişdir.
- Trainable quantum circuit-in deterministic circuit-dən ümumən üstün olduğu göstərilməmişdir.
- Formal statistical significance testi aparılmadığı üçün orta fərqlər p-qiyməti ilə təsdiqlənmiş üstünlüklər deyil.
- UMAP cluster ayrılması müstəqil kəmiyyət separability sübutu deyil.
- İstifadə olunan kiçik məlumat dəstləri screening population-u təmsil etmir.
- External clinical validation, calibration analysis və ya reader study aparılmamışdır.
- Modelin klinik istifadə üçün hazır olduğu göstərilməmişdir.
- 28×28 aşağı həllolma ölçüsündəki uğur yüksək həllolmalı real klinik workflow-a avtomatik ümumiləşdirilə bilməz.
Tədqiqatın əsas məhdudiyyətləri
- Bütün görüntülər 28×28 grayscale həllolma ölçüsündədir.
- Test dəstləri yalnız 156, 96 və 26 görüntü ehtiva edir.
- Hər model yalnız beş müstəqil seed ilə qiymətləndirilmişdir.
- Competing methods arasında formal significance testing yoxdur.
- BUS-UCLM train/validation/test prevalence paylanmaları nəzərəçarpacaq dərəcədə fərqlidir.
- Quantum circuit analytic simulation-dır; real hardware noise yoxdur.
- Kvant dövrəsi yalnız dörd kubit və bir variational layer ehtiva edir.
- External validation cohort yoxdur.
- Clinical calibration analizi yoxdur.
- Radiologist/reader study yoxdur.
- Dataset-lər population-level screening cohort deyil.
Gələcək tədqiqat
Mənbə daha geniş qubit register-lar, daha dərin variational circuits, fiziki quantum hardware üzərində execution, daha böyük və daha yüksək həllolmalı məlumat dəstləri, multimodal görüntüləmə, calibration analysis və external validation təklif edir. Xüsusilə trainable quantum branch-in bu tədqiqatda yalnız dörd parametrlə məhdud saxlanması, daha böyük ansatz-ların həqiqətən əlavə fayda verib-verməyəcəyi sualını açıq saxlayır.
Mənbə və Metod Qeydi
Orijinal başlıq: On the Complementarity of Quantum and Classical Features: Adaptive Hybrid Quantum-Classical Feature Fusion for Breast Cancer Classification.
Müəlliflər: Yasmin Rodrigues Sobrinho; João Renato Ribeiro Manesco; João Paulo Papa.
PDF-də istifadə olunan qısaldılmış müəllif adları: Yasmin R. Sobrinho; João R. R. Manesco; João P. Papa.
Qurum: Department of Computing, São Paulo State University (UNESP), Bauru, SP, Brazil.
E-poçt: PDF üç müəllifə aid yasmin.sobrinho, joao.r.manesco və joao.papa @unesp.br ünvanlarını birlikdə verir.
Corresponding author: Yüklənmiş PDF-də ayrıca corresponding-author işarəsi açıq şəkildə göstərilmir.
Bərabər töhfə: Yüklənmiş PDF-də bərabər töhfə/bərabər birinci müəllif bəyanatı görünmür.
Platforma: arXiv.
arXiv: arXiv:2604.22903v2 [cs.CV].
İlk göndəriş: 24 aprel 2026.
v2 reviziyası: 20 oktyabr 2026.
DOI: 10.48550/arXiv.2604.22903. Bu arXiv/DataCite DOI-sidir; rəyli jurnal DOI-si deyil.
Rəy statusu: 15 noyabr 2026 tarixinə doğrulanan cari biblioqrafik qeyd tədqiqatı preprint kimi göstərir. ArXiv comments sahəsi məqalənin Artificial Intelligence in Medicine jurnalında nəzərdən keçirildiyini bildirir; ayrıca yayımlanmış rəyli versiya təsdiqlənməmişdir.
Lisenziya: Yüklənmiş PDF-də müəyyən lisenziya bəyanatı görünmür və bu sessiyada rəsmi arXiv metadata-sındakı lisenziya sahəsi etibarlı şəkildə doğrulanmadığı üçün Verianla müəyyən açıq lisenziya fərz etmir.
Tədqiqat növü: Methodological/exploratory hybrid quantum-classical machine-learning simulation tədqiqatı.
Tətbiq sahəsi: Döş görüntülərində benign–malignant təsnifatı.
Klassik modellər: ResNet-18 və Shallow CNN.
Kvant modelləri: Dörd-kubit deterministic/non-trainable quanvolutional feature map və dörd trainable quantum parameter ehtiva edən birqatlı variational quanvolutional circuit.
Fusion strategiyaları: Static Hybrid Fusion (SHF), Dynamic Hybrid Fusion (DHF), Temperature-Scaled Hybrid Fusion (TSHF).
Məlumat dəstləri: BreastMNIST, INbreast və BUS-UCLM.
Ümumi unikal görüntü/ROI nümunələrinin birbaşa cəmi: Məlumat dəstləri fərqli struktura malik olduğuna görə tədqiqat vahid birləşdirilmiş klinik cohort kimi qiymətləndirilməməlidir; BreastMNIST 780 nümunə, INbreast emal edilmiş 481 ROI/sample və BUS-UCLM 264 nümunə ehtiva edir.
Görüntü həllolma ölçüsü: 28×28, təkkanallı grayscale.
Quantum patch: 2×2, stride 2, dörd kubit, hər görüntü üçün 196 quantum circuit evaluation.
Quantum ölçmə: Hər kubitdə Pauli-\(Z\) expectation value.
Quantum simulation: PennyLane lightning.qubit, state-vector, analytic mode, no shots, CPU.
Klassik avadanlıq: CUDA-enabled NVIDIA L40S GPU.
Framework: PyTorch + PennyLane TorchLayer.
Optimizer: Adam.
Loss: Cross-entropy.
Təkrar: Hər konfiqurasiya beş independent seed.
Fusion konfiqurasiyaları: Mənbə 36 fusion konfiqurasiyası və 12 standalone baseline qiymətləndirməsi bildirir.
Əsas qiymətləndirmə metrikləri: Accuracy, precision, recall, F1-score və AUC-ROC.
Müsbət sinif xəbərdarlığı: BreastMNIST-də positive class benign; INbreast və BUS-UCLM-də malignant-dır. Buna görə precision, recall və F1 qiymətləri məlumat dəstləri arasında sinif mənası baxımından birbaşa eyni müsbət sinfi təmsil etmir.
Formal statistika testi: Competing methods arasında formal significance testing aparılmamışdır. Appendix E-də beş run ortalaması üçün %95 confidence intervals verilmişdir.
UMAP: Latent-space visualization üçün istifadə edilmişdir; mənbə UMAP-i kəmiyyət separability sübutu kimi qəbul etmir.
Computational cost məhdudiyyəti: Bildirilən böyük runtime overhead CPU-dakı classical quantum simulation-a aiddir və fiziki quantum hardware runtime ölçümü deyil.
Clinical məhdudiyyət: Calibration analysis, independent external cohort validation və reader study yoxdur; mənbə clinical readiness iddiası irəli sürmür.
Kod əlçatanlığı: Mənbə implementation, configuration files, experiment scripts və INbreast/BUS-UCLM patient-level split fayllarının ictimai GitHub deposunda olduğunu bildirir.
Məlumat əlçatanlığı: BreastMNIST MedMNIST benchmark vasitəsilə; INbreast və BUS-UCLM isə öz təminatçılarının giriş şərtləri altında əldə edilə bilər.
Maliyyələşdirmə / təşəkkür: Mənbə São Paulo Research Foundation (FAPESP) grant 2013/07375-0, 2023/14427-0, 2024/00117-0, 2024/22853-0, 2026/11390-4 və 2025/07171-2 ilə Brazilian National Council for Scientific and Technological Development (CNPq) process 308529/2021-9 dəstəyini bildirir.
Müəllif töhfələri: Yüklənmiş v2 PDF-də ayrıca CRediT/Author Contributions bölməsi görünmür.
Maraqların toqquşması: Yüklənmiş v2 PDF-də ayrıca competing-interests/conflict-of-interest bəyanatı yoxdur.
Etik bəyan: Yüklənmiş v2 PDF-də ayrıca ethics statement görünmür. Tədqiqat yeni xəstə məlumatı toplamamış, ictimai açıq tədqiqat məlumat dəstlərindən istifadə etmişdir; lakin Verianla mənbənin açıq şəkildə vermədiyi etik komitə nəticəsini özündən yaratmır.
Mənbədaxili vizual qeyd: Appendix A-dakı precision–recall səhifələrindən birində panel başlıqları ilə parsed caption arasında məlumat dəstinin adı baxımından uyğunsuz görünüş mövcuddur.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib