


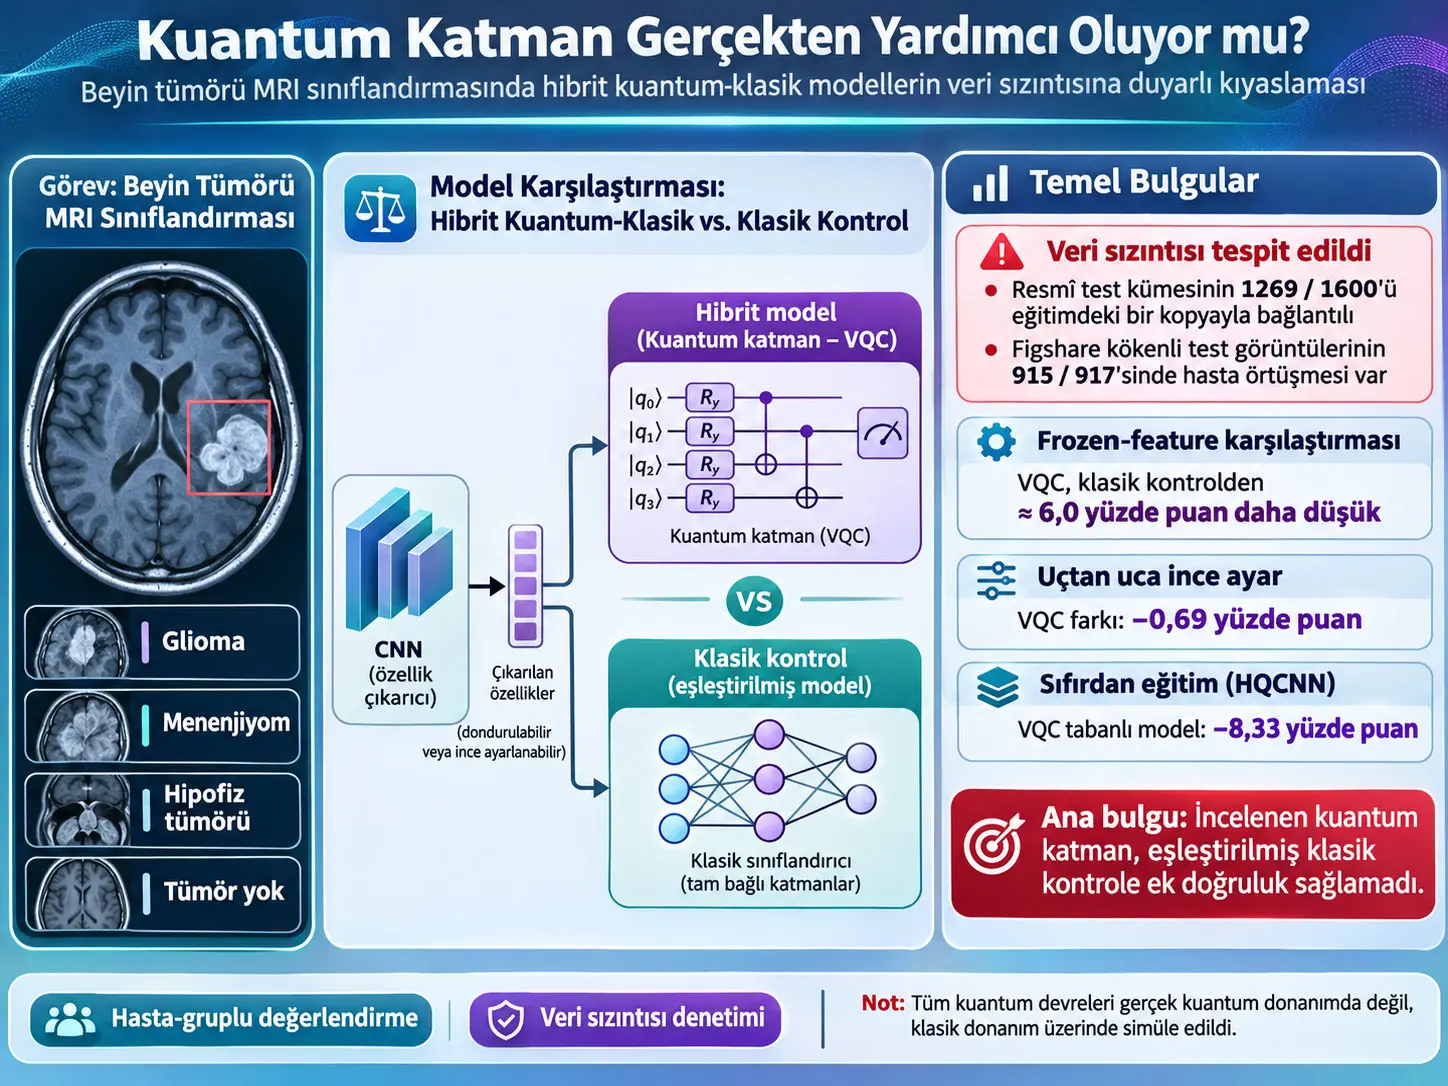
Varyasyonel kuantum devresi (variational quantum circuit, VQC), klasik görüntü özelliklerini kuantum dönüş açılarına kodlayan, öğrenilebilir kuantum kapılarıyla bu kodlanmış durumu işleyen ve ölçülen Pauli-Z beklenti değerlerini yeniden klasik sınıflandırma katmanına aktaran parametreli bir kuantum devresidir. Bu çalışma, beyin tümörü manyetik rezonans görüntülerinin (magnetic resonance imaging, MRI) sınıflandırılmasında kullanılan böyle bir VQC katmanının gerçekten sınıflandırma doğruluğuna katkı sağlayıp sağlamadığını, aynı genişlikte ve aynı eğitim koşullarındaki klasik kontrol katmanlarıyla karşılaştırarak test etmiştir. Aynı zamanda kullanılan kamuya açık MRI veri setinde eğitim–test veri sızıntısı, hasta örtüşmesi ve görüntü kaynağına bağlı kestirme ipuçları ayrıntılı biçimde denetlenmiştir.
Çalışmada Kaggle Brain Tumor MRI Dataset'in 13 Şubat 2026'da yayımlanan sürüm 2'si kullanılmıştır. Veri seti toplam 7200 iki boyutlu JPEG MRI kesiti içerir: glioma, meningioma, hipofiz tümörü ve tümörsüz olmak üzere dört sınıfın her birinde 1800 görüntü vardır. Resmî bölümleme 5600 eğitim ve 1600 test görüntüsünden oluşur. Kaynak koleksiyonlarla yapılan eşleştirme sonucunda 4846 tümör görüntüsü için hasta kimliği geri kazanılabilmiştir.
Veri denetimi, veri setinin resmî açıklamasındaki “eğitim–test örtüşmesi giderildi” beklentisine rağmen ciddi bir sızıntı bulunduğunu göstermiştir. Aynalama ve döndürmeye dayanıklı denetimle 1600 resmî test görüntüsünün 1269'unun, yani yaklaşık %79'unun eğitim bölümündeki bir görüntüyle aynı duplicate grubuna bağlı olduğu belirlenmiştir. Figshare kökenli 917 test görüntüsünün 915'i eğitim bölümünde aynı hastadan en az bir başka görüntüyle paylaşılmıştır. Yalnız 87 resmî test görüntüsü hem tespit edilen kopyalardan hem de bilinen hasta örtüşmesinden bağımsız olan “strict-clean” alt kümeyi oluşturmuştur.
Araştırmacıların temel karşılaştırması altı kübitli, iki varyasyonel katmanlı VQC başlığı ile aynı giriş/çıkış genişliğine sahip Linear(6,6) + tanh klasik kontrol arasındadır. Dondurulmuş ImageNet özellikleri üzerinde hasta-gruplu beş katlı çapraz doğrulamada VQC, eşleştirilmiş klasik kontrolden ortalama 6,03 yüzde puanı daha düşük doğruluk göstermiştir; %95 güven aralığı −6,78 ile −5,20 yüzde puanı arasındadır. VQC ayrıca daha derin klasik kontrolden ve kuantum devresinin hesaplayabildiği fonksiyon sınıfını kapsayan klasik Fourier surrogate modelinden de daha düşük doğruluk vermiştir.
Uçtan uca ince ayarda fark küçülmüştür. İlk eğitim reçetesi kullanıldığında EfficientNet-B0 + VQC %94,1, klasik kontrol %94,2 doğruluk sağlamış ve aralarındaki −0,07 yüzde puanlık fark ±1 yüzde puanlık eşdeğerlik sınırı içinde kalmıştır. Ancak yakınsamaya dayalı daha uzun eğitimde VQC %93,8, klasik kontrol %94,5 doğruluk vermiş; VQC'nin farkı −0,69 yüzde puanı (%95 GA −1,25 ile −0,13) olmuştur ve ±1 yüzde puan sınırı içinde eşdeğerlik ilan edilememiştir. Sıfırdan eğitilen hibrit kuantum–klasik CNN ise %67,9 doğrulukla %76,2'lik klasik kontrolünün 8,33 yüzde puan gerisinde kalmıştır.
Çalışma bu sonuçları “kuantum makine öğrenmesi hiçbir zaman işe yaramaz” şeklinde genellememektedir. Sonuç yalnız incelenen dressed VQC mimarisi, kullanılan klasik MRI verisi, 2–10 kübit aralığı, incelenen encoding ve kontrol modelleri için geçerlidir. Ayrıca bütün kuantum devreleri klasik bilgisayarda simüle edilmiştir; gerçek kuantum işlemcide eğitim veya çıkarım yapılmamıştır. Raporlanan doğruluklar klinik tanısal doğruluk olarak yorumlanamaz.
Araştırmanın asıl sorusu nedir?
Hibrit kuantum–klasik görüntü sınıflandırma çalışmalarında yüksek bir toplam doğruluk görmek, kuantum katmanın gerçekten yararlı olduğunu tek başına göstermez. Çünkü bir hibrit ağın büyük bölümü hâlâ klasik olabilir: görüntü özelliklerini çıkaran CNN, kuantum devresine giriş üreten lineer projeksiyon ve kuantum ölçümlerini sınıflara dönüştüren çıktı katmanı klasik bileşenlerdir.
Bu nedenle çalışmanın merkezî araştırma sorusu yalnız “hibrit model kaç yüzde doğruluk verdi?” değildir. Daha güçlü soru şudur: Aynı klasik omurga, aynı veri, aynı eğitim protokolü ve aynı dar boğaz genişliği korunup yalnız kuantum devresi aynı genişlikte klasik bir katmanla değiştirildiğinde performans gerçekten düşüyor mu?
Eğer cevap hayırsa, yüksek toplam performansı kuantum katmana atfetmek mümkün değildir.
Veri Sızıntısı Nedir ve Bu Çalışmada Neden Kritik Bir Sorundur?
Veri sızıntısı, test aşamasında gerçekten görülmemiş verileri değerlendirmek yerine eğitim sırasında aynı görüntünün, işlenmiş bir kopyasının veya aynı hastadan çok benzer görüntülerin modele dolaylı biçimde gösterilmiş olmasıdır; bu çalışmada resmî test kümesinin %79'unun eğitimde bir kopyaya bağlı bulunması ve figshare kökenli 917 test görüntüsünün 915'inin eğitimde aynı hastayla örtüşmesi nedeniyle yüksek test doğruluklarının önemli bir bölümünün gerçek genelleme performansını olduğundan yüksek gösterebileceği belirlenmiştir.
Kesin kopya ile yakın kopya aynı şey değildir
Araştırmacılar birden fazla sızıntı türünü ayrı ayrı aramıştır.
- Exact duplicate: Piksel dizileri tamamen aynı görüntülerdir. Bunlar decode edilmiş piksel dizisinin MD5 checksum'u ile saptanmıştır.
- Near-duplicate: Yeniden JPEG kodlanmış, yeniden ölçeklenmiş veya küçük işleme farkları bulunan fakat esasen aynı görüntüyü taşıyan örneklerdir.
- Mirrored copy: Görüntünün yatay/dikey veya başka yansıma dönüşümleri uygulanmış kopyalarıdır.
- Rotated/flipped copy: Kare görüntünün sekiz döndürme ve yansıma dönüşümünden biriyle elde edilen karşılıklarıdır.
- Patient overlap: Görüntüler birebir aynı olmasa bile eğitim ve test kümelerinde aynı hastaya ait farklı MRI kesitlerinin bulunmasıdır.
Yakın kopya adayları 64-bit perceptual hash (pHash) ile taranmış ve Hamming uzaklığının en fazla 8 bit olması koşulu kullanılmıştır. Daha sonra aday çiftlerin 64 × 64 piksel thumbnail'ları arasındaki normalize çapraz korelasyonun (normalized cross-correlation, NCC) en az 0,95 olması istenmiştir.
Hamming uzaklığı, iki bit dizisinde birbirinden farklı olan bitlerin sayısıdır. Örneğin iki 64-bit pHash arasında Hamming uzaklığı 8 ise 64 konumun sekizinde bit değerleri farklıdır. Küçük Hamming uzaklığı görsel yapıların benzer olduğuna işaret eder; ancak tek başına yeterli kabul edilmemiş ve NCC doğrulaması da kullanılmıştır.
NCC, iki görüntü deseninin doğrusal benzerliğini ölçen normalize bir korelasyon ölçüsüdür. Çalışmadaki 0,95 eşiği, pHash'in ürettiği adayların gerçekten çok benzer görüntüler olduğunun ikinci bir kontrolü olarak kullanılmıştır.
Neden aynalama ve döndürme özellikle önemliydi?
Standart pHash aynalama ve döndürmeye değişmez değildir. Yani bir MRI kesitinin ayna görüntüsü insan gözüne açıkça aynı görüntü gibi görünse bile doğrudan pHash karşılaştırmasında yeterince yakın çıkmayabilir. Araştırmacılar bu nedenle her görüntünün kare üzerindeki sekiz döndürme/yansıma dönüşümünü değerlendirip en küçük Hamming uzaklığını ve karşılık gelen NCC değerini kullanmıştır.
İlk denetim 385 exact ve 6162 near-duplicate çift bulurken, dönüşümlere dayanıklı revize denetim buna ek olarak 7915 aynalanmış ve 10.161 döndürülmüş/çevrilmiş çift belirlemiştir. Toplam duplicate-pair sayısı 24.623'e ulaşmış ve bunların 9699'u eğitim–test sınırını geçmiştir.
| Ölçüt | Kaynak sonucu | Yorum |
|---|---|---|
| Toplam görüntü | 7200 | Dört sınıfta 1800'er görüntü |
| Resmî eğitim / test | 5600 / 1600 | Her sınıfta 1400 eğitim + 400 test |
| Toplam tespit edilen duplicate çift | 24.623 | Exact, near, mirrored ve rotated/flipped çiftlerin toplamı |
| Eğitim–test sınırını geçen duplicate çift | 9699 | Resmî bölümlemeyi doğrudan etkileyen bağlantılar |
| Eğitimde kopyası bulunan test görüntüsü | 1269 / 1600 (%79) | Augmented örnekler dahil revize denetim |
| Figshare kökenli test görüntülerinde hasta örtüşmesi | 915 / 917 | Aynı hasta eğitim bölümünde de bulunuyor |
| Herhangi bir kopya veya bilinen hasta bağlantısı olmayan strict-clean test | 87 | 74 glioma, 11 meningioma, 2 hipofiz tümörü; tümörsüz örnek yok |
Veri kaynağı neden ayrıca incelendi?
Aynı tümör sınıfının farklı cihazlar, farklı MRI sekansları, farklı görüntü matrisleri veya farklı JPEG işleme zincirlerinden gelmesi model için istenmeyen bir kestirme yol oluşturabilir. Model tümör morfolojisini öğrenmek yerine görüntünün hangi veri kaynağından geldiğini öğrenebilir.
Bu nedenle araştırmacılar görüntü genişliği, yüksekliği, en-boy oranı, 512 × 512 olma durumu, renk modu, JPEG dosya boyutu, global yoğunluk istatistikleri ve hatta yalnız 8 × 8 piksellik thumbnail gibi tümörün ayrıntılı görünümünü içermeyen özelliklerle gradient-boosting sınıflandırıcıları eğitmiştir.
Yalnız görüntü boyutu, en-boy oranı ve renk modu kullanıldığında tümör–tümörsüz ayrımı %91,8 doğrulukla yapılabilmiştir. Yalnız 8 × 8 thumbnail kullanıldığında dört sınıflı doğruluk %78,9 olmuştur; rastgele şans seviyesi %25'tir. Hasta-gruplu Protocol 3 altında bile bu kaba thumbnail %78,1 doğruluk vermiştir.
Görüntüler standardize edilip arka plan, sınırlar, matris boyutu ve yoğunluk ölçeği gibi birçok ipucu kaldırıldığında bile 8 × 8 thumbnail dört sınıfta %69,7 doğruluk vermiştir. Bu sonuçlar veri setindeki sınıf etiketlerinin yalnız tümör dokusunun görünümünden değil, görüntüleme kaynağı ve kaba anatomi gibi başka sinyallerden de tahmin edilebilir olduğunu göstermektedir.
76 “out-of-source” glioma görüntüsü neden önemli?
Resmî test bölümündeki 400 glioma görüntüsünden 76'sı eğitim glioma görüntülerinden farklı bir kaynak ve görüntüleme dağılımına aittir. Eğitimdeki bütün 1400 glioma görüntüsü 512 × 512 figshare biçimindeyken bu 76 görüntü 61 farklı matris boyutunda bulunmuştur.
Kaynak eşleştirmesi bu 76 görüntünün SARTAJ koleksiyonundaki test glioma görüntülerinin piksel kopyaları olduğunu göstermiştir. Böylece bunlar yalnız “yeni hasta” değil, aynı zamanda modelin glioma sınıfı için eğitim sırasında görmediği bir veri kaynağıdır.
Fine-tuned modeller genel hasta-gruplu doğrulukta yaklaşık %94 seviyesine ulaşmasına rağmen bu 76 görüntüde yalnız %46,1–61,8 doğruluk göstermiştir. Bu fark, toplam doğruluğun veri kaynağına göre ayrıştırılmasının neden gerekli olduğunu açıkça ortaya koymaktadır.
Aday etiket hataları
Confident-learning taraması 6997 augmented olmayan görüntüden 28'ini olası etiket hatası için işaretlemiştir. Bunların 19'u figshare kökenlidir. Figshare'ın özgün anotasyonu 15'inde mevcut etiketi desteklerken dört görüntüde modelin önerdiği alternatif sınıfı desteklemiştir.
Kaynak bu 28 görüntüyü “kesin yanlış etiket” olarak adlandırmamaktadır. Radyolog bağımsız incelemesi yapılmadığı için bunlar yalnız candidate label errors, yani uzman incelemesi gerektiren adaylardır ve bütün ana analizlerde veri setinden çıkarılmamışlardır.
Varyasyonel Kuantum Devresi Bu Modelde Tam Olarak Ne Yapıyor?
Çalışmadaki dressed VQC, klasik CNN omurgasından gelen yüksek boyutlu özellikleri önce n adet açıya sıkıştırır, bu açıları n kübitin RY dönüşlerine kodlar, öğrenilebilir tek-kübit dönüşleri ve CNOT halkalarıyla işler, her kübitte Pauli-Z beklenti değerini ölçer ve ortaya çıkan n gerçek sayıyı dört MRI sınıfına ait klasik logitlere dönüştürür; dolayısıyla kuantum devresi bütün modeli değil, klasik özellik çıkarıcı ile klasik çıktı katmanı arasındaki küçük bir ara katmanı oluşturur.
Kübit nedir?
Klasik bit yalnız 0 veya 1 durumunda tanımlanırken bir kübit, ölçümden önce iki temel durumun karmaşık genliklerle tanımlanan kuantum süperpozisyonunda bulunabilir. Genel tek-kübit durumu kavramsal olarak:
\[ |\psi\rangle=\alpha|0\rangle+\beta|1\rangle, \qquad |\alpha|^2+|\beta|^2=1 \]
şeklinde yazılabilir. Bu ifade çalışmanın yeni sonucu değildir; VQC'deki kübit kavramını açıklayan temel kuantum mekaniği gösterimidir.
Denklem (1): Klasik özellikler kuantum açılarına nasıl dönüştürülüyor?
Kaynakta klasik özellik vektöründen kuantum devresine girecek açıların üretimi:
\[ \mathbf{x} = \frac{\pi}{2} \tanh(W\mathbf{f}+\mathbf{b}) \in \left(-\frac{\pi}{2},\frac{\pi}{2}\right)^n \tag{1} \]
şeklindedir.
Burada:
- \(\mathbf{f}\), klasik omurgadan gelen \(d\)-boyutlu özellik vektörüdür.
- \(W\), öğrenilebilir lineer dönüşüm matrisidir.
- \(\mathbf{b}\), öğrenilebilir bias vektörüdür.
- \(\tanh\), eleman bazında hiperbolik tanjant fonksiyonudur.
- \(\mathbf{x}=(x_1,\ldots,x_n)\), kuantum devresine kodlanacak \(n\) adet dönüş açısını içerir.
- \(n\), aynı zamanda VQC'deki kübit sayısıdır.
\(\tanh\) çıktısı −1 ile +1 arasında olduğu için \(\pi/2\) ile çarpıldığında her açı \(-\pi/2\) ile \(+\pi/2\) arasına sınırlandırılır. Böylece binlerce klasik CNN özelliği doğrudan binlerce kübite yüklenmez; önce küçük bir \(n\)-boyutlu dar boğaza sıkıştırılır.
Altı kübitli ana modelde, örneğin EfficientNet-B0'nun 1280 boyutlu pooled özellik vektörü önce yalnız altı açıya indirgenmektedir. Bu boyut daraltmanın kendisi önemli bir bilgi darboğazıdır ve kuantum devresinin sonraki hesaplamasını yorumlarken göz önünde bulundurulmalıdır.
Hadamard ve RY kapıları ne yapıyor?
Her kübit başlangıçta \(|0\rangle\) durumundadır. Kaynak devrede önce Hadamard (\(H\)) kapısı, ardından \(R_Y(x_i)\) dönüşü uygulanır.
Hadamard kapısı temel durumda bulunan bir kübiti iki temel durumun süperpozisyonuna taşır. \(R_Y(x_i)\) ise Bloch küresi üzerinde Y ekseni etrafında \(x_i\) açısı kadar dönüş uygular. Böylece klasik özelliklerden elde edilen sayısal açı kuantum durumunun genliklerine kodlanmış olur.
Öğrenilebilir Rot kapısı
Her varyasyonel katmanda her kübite:
\[ \operatorname{Rot}(\alpha,\beta,\gamma) = R_Z(\gamma)R_Y(\beta)R_Z(\alpha) \]
biçiminde üç öğrenilebilir açı içeren genel tek-kübit dönüşü uygulanmıştır.
Altı kübit ve iki varyasyonel katmanda her kübit için katman başına üç parametre bulunduğundan kuantum devresinin öğrenilebilir parametre sayısı:
\[ 6\times2\times3=36 \]
olur.
CNOT halkası ve kuantum dolaşıklığı
Tek-kübit dönüşlerinden sonra kübitler bir controlled-NOT (CNOT) halkasıyla birbirine bağlanmıştır. Halkada kübit \(i\), kübit \(i+1\)'i kontrol eder ve indeks son kübitten sonra yeniden ilk kübite döner.
CNOT gibi iki-kübit kapıları uygun giriş durumlarında kübitler arasında kuantum dolaşıklığı oluşturabilir. Ancak bu çalışmanın önemli ablasyon sonuçlarından biri, CNOT halkasının kaldırılmasının doğruluğu düşürmemesi, tersine ana altı-kübit deneyinde artırmasıdır. Bu nedenle “dolaşıklık kullanıldı, dolayısıyla avantaj kuantum dolaşıklığından geldi” şeklinde bir yorum kaynak tarafından desteklenmemektedir.
Denklem (2): VQC'nin kuantum durumu
Kaynağın devre denklemi, açı kodlamasını ve \(L\) varyasyonel katmanı şu genel yapı içinde ifade eder:
\[ |\psi(\mathbf{x};\boldsymbol{\theta})\rangle = U_{\mathrm{ent}}R(\boldsymbol{\theta}^{(L)}) \cdots U_{\mathrm{ent}}R(\boldsymbol{\theta}^{(1)}) \left[ \bigotimes_{i=1}^{n} R_Y(x_i)H \right] |0\rangle^{\otimes n} \tag{2} \]
Burada:
- \(|0\rangle^{\otimes n}\), bütün \(n\) kübitin başlangıç durumudur.
- \(\bigotimes\), işlemlerin farklı kübitlere tensör çarpımıyla uygulandığını gösterir.
- \(R_Y(x_i)\), \(i\). klasik açının ilgili kübite kodlanmasıdır.
- \(R(\boldsymbol{\theta}^{(\ell)})\), \(\ell\). katmandaki öğrenilebilir tek-kübit dönüşlerinin toplam yapısını temsil eder.
- \(U_{\mathrm{ent}}\), CNOT halkasından oluşan dolaşıklık katmanıdır.
- \(L\), varyasyonel katman sayısıdır.
- \(\boldsymbol{\theta}\), öğrenilebilir kuantum devresi parametrelerinin tamamıdır.
Ana modelde \(n=6\) ve \(L=2\)'dir.
Devreden nasıl klasik sayı çıkıyor?
Her kübit için Pauli-Z operatörünün beklenti değeri ölçülmektedir:
\[ z_i = \langle\psi(\mathbf{x};\boldsymbol{\theta})| Z_i |\psi(\mathbf{x};\boldsymbol{\theta})\rangle, \qquad z_i\in[-1,1]. \]
\(Z_i\), yalnız \(i\). kübit üzerinde Pauli-Z ölçümünü temsil eder. Beklenti değeri tek ölçümde yalnız 0 veya 1 değildir; çok sayıda ölçümün veya tam durum simülasyonunun ürettiği olasılık dağılımından hesaplanan −1 ile +1 arasında gerçek bir değerdir.
Altı kübitli devre böylece altı gerçek sayı üretir. Son klasik lineer katman bu altı değeri dört sınıfa ait dört logite dönüştürür ve sınıflandırma kararı bu klasik çıktı üzerinden verilir.
Neden klasik kontrolün “aynı genişlikte” olması gerekiyor?
Altı-kübit VQC'nin yerine çok büyük veya çok küçük bir klasik ağ koymak, performans farkının kuantum hesaplamadan mı yoksa model kapasitesinden mi kaynaklandığını ayırmayı zorlaştırır.
Ana klasik kontrol bu nedenle VQC'nin altı giriş ve altı çıkışına karşılık Linear(6,6) + tanh kullanmıştır. Altı-kübit VQC'nin 36 öğrenilebilir kuantum parametresine karşı klasik orta katmanın 42 parametresi vardır.
Çalışma bunun da tam anlamıyla “ifade gücü eşitliği” sağlamadığını kabul etmiş ve iki ek klasik kontrol kullanmıştır:
- Deeper control: iki adet
Linear(6,6) + tanhkatmanı; 84 orta-katman parametresi. - Fourier surrogate: VQC'nin tek seferlik açı kodlaması altında hesaplayabildiği trigonometrik fonksiyon sınıfını kapsayacak şekilde \(3^6=729\) klasik trigonometrik özellik.
Fourier surrogate'ün önemi büyüktür. Kaynakta VQC'nin her çıktısının, her giriş açısında frekansları \(\{-1,0,1\}\) olan trigonometrik bir polinom olduğu açıklanmaktadır. Altı giriş için olası çarpım tabanının büyüklüğü:
\[ 3^6=729 \]
olur. Bu tabandaki her özellik:
\[ \prod_i g_i(x_i), \qquad g_i\in\{1,\cos x_i,\sin x_i\} \]
biçimindedir. Dolayısıyla lineer bir klasik model bu devre tasarımının üretebildiği fonksiyon sınıfını temsil edebilir. Çalışmada bu surrogate VQC'den daha doğru çıkmıştır.
“Barren plateau” sonucu kanıtlandı mı?
Hayır. Sekiz ve on kübitli devrelerin doğruluğunun düşmesi ve kuantum modelinin daha uzun eğitim gerektirmesi, yazarlar tarafından kuantum devrelerinde bilinen düzleşmiş optimizasyon manzaralarıyla uyumlu görülmektedir; fakat çalışma doğrudan gradient varyansı ölçerek barren plateau bulunduğunu kanıtlamamıştır.
Kuantum devresi gerçek kuantum donanımda mı çalıştırıldı?
Hayır. Gürültüsüz devreler PyTorch ile yazılmış batched state-vector simülatörüyle klasik CPU/GPU üzerinde tam olarak simüle edilmiştir. Gürültülü devreler density-matrix simülasyonuyla hesaplanmıştır. PennyLane yalnız geliştirilen simülatörün çıktısını doğrulamak için kullanılmıştır.
Bu nedenle çalışmadaki 18,8 ms gibi latency değerleri bir kuantum işlemcinin çalışma süresi değildir. Bunlar RTX 3090 üzerinde kuantum devresi simülasyonunu da içeren klasik GPU ileri-geçiş süreleridir.
Depolarizing noise modeli
Gürültü deneyinde her kübite her gate layer sonrasında tek-kübit depolarizasyon kanalı uygulanmıştır:
\[ \rho \rightarrow (1-p)\rho + \frac{p}{3} \left( X\rho X+Y\rho Y+Z\rho Z \right). \]
Burada:
- \(\rho\), kübitin density matrix durumudur.
- \(p\), bu katmanda Pauli hatası uygulanma olasılığıdır.
- \(X,Y,Z\), Pauli operatörleridir.
\(p=0\) ideal gürültüsüz simülasyonu, daha büyük \(p\) daha güçlü depolarizasyonu temsil eder. Kaynakta \(p=\{0{,}001,0{,}003,0{,}01,0{,}03,0{,}1\}\) değerleri test edilmiştir.
Bu model gerçek donanımın bütün hata kaynaklarını kapsamaz. Crosstalk, readout error, sınırlı bağlantı topolojisi ve gerçek kapı decomposition maliyeti modele dahil edilmemiştir.
“Shot” ne anlama geliyor?
Gerçek bir kuantum bilgisayarda bir beklenti değeri tek ölçümden kesin olarak elde edilmez. Aynı devre birçok kez çalıştırılır ve ölçüm sonuçlarının istatistiği kullanılır. Devrenin bir kez hazırlanıp ölçülmesine genel olarak bir shot denir.
Çalışmada finite-shot etkisini taklit etmek için exact outcome probability dağılımından \(S\) adet sonuç örneklenmiştir. Test edilen shot sayıları:
\[ S\in\{16,64,256,1024,4096\} \]
olmuştur.
Quantum kernel nedir?
Model-head deneylerinden ayrı olarak araştırmacılar quantum-kernel support vector machine (SVM) ile klasik radial basis function (RBF) kernel SVM'yi de karşılaştırmıştır.
EfficientNet-B0 özellikleri önce principal component analysis (PCA) ile 4, 6, 8 veya 10 bileşene düşürülmüş ve [0,1] aralığına ölçeklenmiştir. Quantum kernel için ZZ feature map kullanılmıştır.
İki girdinin kernel benzerliği kuantum durumlarının fidelity'siyle tanımlanmıştır:
\[ k(\mathbf{x},\mathbf{x}') = \left| \langle\psi(\mathbf{x})|\psi(\mathbf{x}')\rangle \right|^2. \]
İç çarpımın mutlak karesi 0 ile 1 arasında bir benzerlik değeridir. Aynı kuantum durumunda 1'e ulaşır; durumlar daha farklı hale geldikçe küçülebilir.
Klasik karşılaştırıcı aynı PCA girdilerinde RBF kernel kullanmıştır. Böylece iki kernel aynı düşük-boyutlu girdi bilgisi üzerinden kıyaslanmıştır.
Çalışmanın Yöntemi ve Bulguları
Brain Tumor MRI Dataset sürüm 2
| Sınıf | Eğitim | Test | Toplam |
|---|---|---|---|
| Glioma | 1400 | 400 | 1800 |
| Meningioma | 1400 | 400 | 1800 |
| Hipofiz tümörü | 1400 | 400 | 1800 |
| Tümör yok | 1400 | 400 | 1800 |
| Toplam | 5600 | 1600 | 7200 |
Figshare koleksiyonu 233 hastadan 3064 kontrastlı T1-ağırlıklı MRI kesiti içerir ve özgün hasta kimlikleriyle birlikte tümör tipini ve manuel tümör maskesini sağlar. Çalışmanın provenance eşleştirmesi, Kaggle veri setindeki 5400 tümör görüntüsünün 4846'sını figshare kökenli olarak eşleştirebilmiştir.
Geriye kalan tümör görüntülerinin kaynakları SARTAJ koleksiyonu eşleştirmeleriyle araştırılmıştır. JPEG quantization table, chroma subsampling ve color mode bilgileri de üretim/işleme zincirinin fingerprint'i olarak kaydedilmiştir.
Üç değerlendirme protokolü
| Protokol | Yapı | Amaç / yorum sınırı |
|---|---|---|
| Protocol 1 | Resmî 5600/1600 bölümlemesi; eğitimden 800 görüntü validation için ayrılır | Sızıntı ve source-shift etkisini ölçmek için korunmuştur; ana model kıyaslaması değildir |
| Protocol 2 | Beş katlı grouped CV; ilk duplicate audit grupları fold'lar arasında bölünmez | İlk gönderimde kullanılan yaklaşım; revize audit sonrası yetersiz olduğu anlaşılmıştır |
| Protocol 3 | Revised duplicate grupları + aynı figshare hastasının tüm görüntüleri birleştirilerek beş fold oluşturulur | Ana değerlendirme protokolü; bilinen aynı hasta veya tespit edilen kopya fold'lar arasında geçemez |
Protocol 3'te 6997 augmented olmayan görüntünün her biri tam bir kez out-of-fold test tahmini alır. Figshare kökenli bir test görüntüsü için modeli eğiten fold, ne bu görüntüyü ne tespit edilen bir kopyasını ne de aynı hastanın başka bir figshare görüntüsünü görmüş olur.
Ancak kaynak önemli bir kalıntı sınırlılığı belirtmektedir: figshare dışındaki tümör görüntüleri ve tümörsüz görüntülerde hasta kimliği bulunmamaktadır. Bu nedenle duplicate detector tarafından yakalanmayan aynı muayeneye ait başka kesitlerin farklı fold'lara düşme ihtimali tamamen ortadan kaldırılamamıştır.
Frozen-feature deneyleri
Dört ImageNet-pretrained omurga yalnız sabit özellik çıkarıcı olarak kullanılmıştır:
| Omurga | Özellik boyutu d |
|---|---|
| EfficientNet-B0 | 1280 |
| DenseNet-121 | 1024 |
| ResNet-50 | 2048 |
| MobileNetV2 | 1280 |
Görüntüler grayscale'e dönüştürülüp üç kanala kopyalanmış, 256 × 256 piksele yeniden boyutlandırılmış, merkezden 224 × 224 kırpılmış ve ImageNet istatistikleriyle normalize edilmiştir. Pooled özellikler her eğitim fold'unun ortalama ve standart sapmasıyla standardize edilmiştir.
Sekiz farklı head karşılaştırılmıştır:
- 6-kübit, 2-katman VQC;
- eşleştirilmiş klasik kontrol;
- daha derin klasik kontrol;
- Fourier surrogate;
- bottleneck-only;
- linear probe;
- 256 gizli birimli MLP;
- kuantum parametreleri random başlangıçta dondurulmuş untrained VQC.
Head'ler Adam optimizer ile eğitilmiş; weight decay \(10^{-4}\), batch size 128 ve en fazla 80 epoch kullanılmıştır. Validation loss beş epoch iyileşmezse learning rate yarıya indirilmiş, on epoch iyileşmezse eğitim durdurulmuştur. Başlangıç learning rate'i her koşuda:
\[ \{10^{-3},3\times10^{-3},10^{-2}\} \]
arasından validation loss'a göre seçilmiştir.
Kuantum Katman Bu Benchmark'ta Gerçekten Fayda Sağladı mı?
Hayır; çalışmanın test ettiği üç ana eğitim rejiminde altı-kübitli VQC, aynı genişlikteki klasik katmanın doğruluğunu artırmamıştır: frozen-feature deneylerinde belirgin biçimde geride kalmış, uçtan uca fine-tuning sırasında yaklaşık aynı düzeye yaklaşmış fakat convergence-based eğitimde yine 0,69 yüzde puanı düşük kalmış ve sıfırdan eğitilen HQCNN'de klasik kontrolünden 8,33 yüzde puan düşük doğruluk vermiştir; bu sonuç yalnız incelenen devre, veri seti ve eğitim protokolleri için geçerlidir.
| Rejim | Karşılaştırma | Doğruluk farkı | %95 GA | Kaynak yorumu |
|---|---|---|---|---|
| Frozen features | VQC − eşleştirilmiş klasik kontrol | −6,03 yüzde puanı | −6,78 ile −5,20 | Klasik kontrol 20/20 backbone–fold blokta daha iyi |
| Frozen features | VQC − deeper control | −4,71 yüzde puanı | −5,63 ile −3,73 | Klasik model 20/20 blokta daha iyi |
| Frozen features | VQC − Fourier surrogate | −5,27 yüzde puanı | −6,20 ile −4,39 | Devrenin fonksiyon sınıfını kapsayan klasik surrogate daha iyi |
| End-to-end, Block A | VQC − klasik kontrol | −0,07 yüzde puanı | −1,08 ile +1,00 | ±1 pp içinde eşdeğer |
| End-to-end, Block B | VQC − klasik kontrol | −0,69 yüzde puanı | −1,25 ile −0,13 | ±1 pp eşdeğerliği ilan edilemedi |
| Standardized images, Block C | VQC − klasik kontrol | −1,11 yüzde puanı | −2,07 ile −0,20 | VQC daha düşük |
| From scratch | HQCNN − klasik kontrol | −8,33 yüzde puanı | −12,72 ile −4,06 | Klasik kontrol daha iyi |
Frozen-feature sonuçlarının ayrıntısı
| Head | EfficientNet-B0 | DenseNet-121 | ResNet-50 | MobileNetV2 |
|---|---|---|---|---|
| VQC | 82,0 ± 3,4 | 79,5 ± 3,5 | 76,0 ± 4,0 | 78,5 ± 2,1 |
| Klasik kontrol | 86,4 ± 2,9 | 86,4 ± 3,1 | 83,1 ± 3,1 | 84,3 ± 3,9 |
| Deeper control | 84,4 ± 2,6 | 85,5 ± 2,8 | 81,3 ± 2,9 | 83,7 ± 3,7 |
| Fourier surrogate | 85,5 ± 3,3 | 85,4 ± 3,6 | 82,1 ± 2,6 | 84,2 ± 2,9 |
| Bottleneck only | 87,6 ± 3,2 | 87,9 ± 3,6 | 85,5 ± 2,5 | 86,4 ± 3,6 |
| Linear probe | 88,1 ± 3,0 | 88,1 ± 3,1 | 86,0 ± 2,3 | 87,1 ± 3,6 |
| MLP | 87,9 ± 2,8 | 88,8 ± 3,2 | 86,3 ± 2,1 | 87,5 ± 3,7 |
| Untrained VQC | 80,6 ± 4,5 | 78,1 ± 4,8 | 69,7 ± 3,0 | 77,0 ± 5,8 |
Buradaki ± değerler, her backbone için beş fold üzerindeki seed-averaged doğruluğun standart sapmasıdır.
VQC'nin eğitimli olması tamamen yararsız değildir: eğitimli VQC, random parametrelerde dondurulan VQC'den ortalama 2,67 yüzde puanı daha doğru çıkmıştır (%95 GA 1,11–4,24). Dolayısıyla devre parametrelerinin öğrenilmesi bir miktar katkı sağlamıştır; fakat bu katkı kuantum katmanı klasik kontrollerin üzerine çıkarmaya yetmemiştir.
Kübit sayısı arttıkça ne oldu?
EfficientNet-B0 frozen özelliklerinde bottleneck genişliği ve VQC kübit sayısı 2, 4, 6, 8 ve 10 olarak değiştirilmiştir.
VQC iki ile altı kübit arasında yaklaşık %83,3–83,6 seviyesinde kalmış, sekiz kübitte %80,8'e ve on kübitte %81,4'e düşmüştür. Klasik kontrol ise genişlik arttıkça iki birimde %82,0'dan sekiz birimde %86,6'ya kadar yükselmiştir.
VQC yalnız iki kübitte klasik kontrolünden +1,3 yüzde puanı daha iyi olmuştur; ancak bu fark beş fold'un yalnız üçünde aynı yöndedir ve her iki model de bottleneck-only başlığın %84,2 doğruluğunun altında kalmıştır. Kaynak bu sonucu istikrarlı kuantum avantajı olarak yorumlamamaktadır.
Devre derinliği
Altı kübitte varyasyonel katman sayısı 1, 2, 4 ve 6 olarak değiştirilmiştir. Doğruluk bir katmanda %83,0'dan dört katmanda %85,0'a çıkmış ve altı katmanda %84,8 olmuştur. Bu iyileşmeye rağmen klasik kontrol %86,7 ile daha yüksek kalmıştır.
Dolaşıklık kaldırıldığında ne oldu?
Ana altı-kübit, iki-katman devrede CNOT halkasının tamamen çıkarılması doğruluğu %83,5'ten %86,4'e yükseltmiştir; standart VQC'ye göre +2,9 yüzde puanlık fark vardır. Dolaşıklıksız sürüm klasik kontrolden yalnız −0,3 yüzde puanı farklıdır.
Bu sonuç “kuantum dolaşıklığı zararlıdır” şeklinde genel bir fiziksel sonuç değildir. Yalnız bu devre yapısı, bu veri temsili ve bu sınıflandırma görevi için CNOT halkasının ölçülen doğruluğa yarar sağlamadığını gösterir.
Data re-uploading
Her varyasyonel katmandan önce \(R_Y(x_i)\) encoding'in yeniden uygulanması, yani data re-uploading, ana VQC'nin %83,5 doğruluğunu %78,2'ye düşürmüştür. Fark −5,3 yüzde puanı olmuş ve beş fold'un tamamında daha kötü sonuç alınmıştır.
Az veri olduğunda kuantum model avantaj sağladı mı?
Hayır. Tam tersine VQC'nin en zayıf göreli performansı eğitim verisinin en az olduğu koşullarda görülmüştür.
Eğitim fold'unun nominal %1'i kullanıldığında grup bazlı örnekleme nedeniyle ortalama yaklaşık 115 eğitim görüntüsü kalmıştır. Bu koşulda:
| Model | Doğruluk |
|---|---|
| VQC | %38,6 |
| Klasik kontrol | %62,3 |
| Linear probe | %65,5 |
| MLP | %62,3 |
Bu nedenle “az veri olduğunda küçük kuantum devreleri otomatik olarak avantaj sağlar” varsayımı bu benchmark tarafından desteklenmemiştir.
Gürültü VQC'nin klasik modelin gerisinde kalmasını açıklıyor mu?
Hayır. Ana doğruluk açığı gürültüsüz simülasyonda zaten vardır.
Altı-kübit, iki-katman VQC gürültüsüz durumda %83,5 doğruluk verirken kübit ve katman başına \(p=0,03\) depolarizasyon olasılığında %83,3'e düşmüştür. \(p=0,1\)'de doğruluk %70,2'ye düşmüştür.
Daha derin devreler yüksek gürültüye daha hassastır: \(p=0,1\)'de dört katmanlı devre %31,3, altı katmanlı devre %24,0 doğruluğa düşmüş; dört sınıflı şans seviyesi %25'tir.
Finite-shot simülasyonunda yalnız 16 shot kullanıldığında ana altı-kübit model 1,5 yüzde puanı kaybetmiştir. 1024 shot ile, tek başına veya \(p=0,01\) depolarizasyonla birlikte, sonuç gürültüsüz devrenin 0,1 yüzde puanı içinde kalmıştır.
Quantum kernel ile RBF kernel karşılaştırması
| PCA bileşeni / kübit | Quantum kernel | RBF kernel | Quantum − klasik |
|---|---|---|---|
| 4 | %72,8 | %73,3 | −0,5 pp |
| 6 | %77,7 | %78,1 | −0,4 pp |
| 8 | %79,7 | %80,8 | −1,1 pp |
| 10 | %80,9 | %81,5 | −0,6 pp |
Her iki kernel modeli de tam 1280-boyutlu EfficientNet-B0 özelliklerinde çalışan %88,0 doğruluklu linear probe'un altında kalmıştır. Yazarlar bu sonucu, küçük kuantum devresine veri yüklemek için gereken boyut indirgeme işleminin önemli bir performans darboğazı olduğuna işaret eden bulgu olarak yorumlamaktadır.
Kernel concentration neydi?
Quantum fidelity kernel'de sabit bandwidth 0,1 veya daha yüksek olduğunda qubit sayısı arttıkça off-diagonal kernel entry varyansı güçlü biçimde küçülmüştür. Örneğin bandwidth 0,1'de varyans dört kübitte \(5.6\times10^{-2}\) iken on kübitte \(2.6\times10^{-3}\)'e düşmüştür.
Bandwidth 1'de aynı büyüklük \(7.4\times10^{-3}\)'ten \(4.5\times10^{-5}\)'e düşmüştür. Bu davranış fidelity kernel'larda bilinen kernel concentration ile uyumludur.
Validation, 20 fold–width kombinasyonunun 15'inde en küçük bandwidth olan 0,03'ü seçmiştir. Ancak dört kübitte bu bandwidth ile off-diagonal kernel ortalaması 0,92 olduğu için kernel başka bir uç probleme, yani birçok örnek çiftinin birbirine çok benzer görünmesine yaklaşmıştır.
Uçtan uca ince ayar
Fine-tuning deneylerinde ImageNet-pretrained EfficientNet-B0, ResNet-50, DenseNet-121, MobileNetV2, ConvNeXt-Tiny ve ViT-Small/16 omurgaları değerlendirilmiştir. VQC ve eşleştirilmiş klasik kontrolün doğrudan karşılaştırması EfficientNet-B0 üzerinde yapılmıştır.
Block A: ilk eğitim reçetesi
AdamW optimizer, weight decay 0,05, %10 warm-up'lı one-cycle learning-rate schedule, head için \(10^{-3}\), backbone için \(3\times10^{-4}\) peak learning rate, batch size 32 ve label smoothing 0,05 kullanılmıştır. Eğitim en fazla 30 epoch sürmüş ve validation loss altı epoch iyileşmezse durdurulmuştur.
Augmentation; random resized crop (scale 0,8–1,0; aspect ratio 0,9–1,1), horizontal flip, ±10° rotasyon ve 0,15 brightness/contrast jitter içermiştir.
Block B: yakınsamaya dayalı eğitim
İki epoch lineer warm-up kullanılmış, validation loss üç epoch iyileşmezse learning rate yarıya indirilmiş, on epoch iyileşme olmazsa erken durdurma uygulanmış ve maksimum 80 epoch tanımlanmıştır.
Head learning rate:
\[ \{3\times10^{-4},10^{-3},3\times10^{-3}\} \]
arasından ilk fold'un validation setinde seçilmiş; backbone learning rate head hızının 0,3 katı olarak ayarlanmıştır. Seçilen learning rate beş fold ve iki seed boyunca kullanılmıştır.
Block C: standardize görüntüler
Arka plan, sınırlar, overlay'ler, matris boyutu ve global yoğunluk ölçeği gibi kaynak kestirmelerini azaltmak için head mask oluşturulmuş, görüntü maske alanına kırpılmış, kareye pad edilmiş, maske içindeki 1.–99. yüzdelik aralığına göre intensity rescale edilmiş ve 256 × 256 piksele yeniden boyutlandırılmıştır.
Kaynak, güvenilir 2B skull stripping bulunmadığı için kafatasının görüntüde kaldığını açıkça belirtmektedir. Dolayısıyla standardizasyon bütün kaynak/shortcut bilgisini ortadan kaldırmış değildir.
Uçtan uca ana performans sonuçları
| Rejim | VQC | Klasik kontrol | Linear head |
|---|---|---|---|
| Block A | %94,1 | %94,2 | %94,5 |
| Block B | %93,8 | %94,5 | %94,5 |
| Block C, standardized | %93,6 | %94,7 | %94,3 |
Block A'da VQC ile klasik kontrol arasındaki %95 güven aralığı −1,08 ile +1,00 pp'dir. %90 güven aralığı −0,93 ile +0,82 pp arasında tamamen ±1 pp eşdeğerlik bölgesinde kaldığı için kaynak bu iki modeli ±1 yüzde puanı düzeyinde eşdeğer kabul etmiştir.
Block B'de VQC − klasik kontrol farkı −0,69 pp'dir. %90 güven aralığı −1,16 ile −0,22 olduğundan −1 pp sınırını geçtiği için ±1 pp eşdeğerliği ilan edilememiştir. Eşdeğerlik ilan edilebilecek en küçük margin 1,16 pp'dir.
Bu ayrım önemlidir: istatistiksel olarak anlamlı fark bulunmaması ile modellerin eşdeğer olduğunun gösterilmesi aynı şey değildir. Çalışma bu nedenle yalnız p değerine değil önceden tanımlanmış ±1 pp equivalence margin ve %90 güven aralığına bakmıştır.
Fine-tuning maliyeti
| Model | Ortalama durma epoch'u | Training süresi / run | Tek görüntü latency | Peak GPU memory |
|---|---|---|---|---|
| VQC | 38,8 | 12,8 dk | 18,8 ms | 1461 MB |
| Klasik kontrol | 26,0 | 6,8 dk | 11,3 ms | 1461 MB |
| Deeper control | 29,1 | 7,7 dk | 11,2 ms | 1461 MB |
| Fourier surrogate | 22,3 | 6,0 dk | 11,7 ms | 1461 MB |
| Linear head | 23,2 | 6,0 dk | 10,7 ms | 1461 MB |
Bu süreler gerçek kuantum donanım maliyetleri değildir. Kuantum devresi klasik GPU üzerinde simüle edildiği için yalnız çalışmanın implementation maliyetini gösterir.
Sıfırdan eğitilen HQCNN
Kaynak, önceki hibrit çalışmaların çoğuna daha yakın bir senaryoyu test etmek için pretrained backbone kullanmadan sıfırdan hibrit bir kuantum–klasik CNN de eğitmiştir.
Encoder üç bloktan oluşur:
- 3 × 3 convolution, 64 kanal + batch normalization + ReLU + 2 × 2 max pooling;
- 3 × 3 convolution, 128 kanal + batch normalization + ReLU + 2 × 2 max pooling;
- 3 × 3 convolution, 256 kanal + batch normalization + ReLU + 2 × 2 max pooling.
Bunun ardından global average pooling, 256 → 6 lineer açı projeksiyonu, altı-kübit iki-katman VQC, 64 ve 32 birimli klasik dense katmanlar ve dört sınıflı çıktı bulunur.
HQCNN'nin toplam 375.950 öğrenilebilir parametresinin yalnız 36'sı kuantum devresindedir. Eşleştirilmiş klasik kontrol VQC yerine Linear(6,6)+tanh kullanır ve toplam 375.956 parametre içerir.
Sonuç:
HQCNN: %67,9 doğruluk (%95 GA 63,5–72,1).
Klasik kontrol: %76,2 doğruluk (%95 GA 72,7–79,6).
Fark −8,33 yüzde puanıdır (%95 GA −12,72 ile −4,06; McNemar \(p=1.6\times10^{-41}\)).
Veri sızıntısı doğruluğu ne kadar yükseltti?
Araştırmacılar aynı modelleri ve aynı görüntüleri yalnız fold gruplama kurallarını değiştirerek Protocol 2 ve Protocol 3 altında eğitmiştir. Bu yaklaşım sızıntının etkisini daha doğrudan izole etmeyi amaçlamıştır.
| Model grubu / görüntü bağlantısı | Protocol 2 → Protocol 3 doğruluk değişimi |
|---|---|
| Frozen-feature head'ler, genel | −3,3 ile −7,8 pp |
| Frozen, Protocol 2 training fold'unda kopyası olan görüntüler | −3,9 ile −9,6 pp |
| Frozen, yalnız aynı hasta bağlantısı olan görüntüler | −2,3 ile −6,9 pp |
| Frozen, bağlantısız 750 görüntü | −5,5 ile +3,5 pp; ortalama −0,4 pp |
| Fine-tuned modeller, genel | −3,3 ile −3,6 pp |
| Fine-tuned, kopyası olan görüntüler | −3,7 ile −4,0 pp |
| Fine-tuned, yalnız aynı hasta bağlantısı | −3,5 ile −4,6 pp |
Sızıntının etkisinin esas olarak training fold'uyla kopya veya hasta bağlantısı bulunan görüntülerde toplanması, gözlenen doğruluk düşüşünün yalnız rastgele fold değişiminden kaynaklanmadığını desteklemektedir.
Lesion occlusion deneyi
Figshare kökenli test tümörlerinde manuel tümör maskesi 8 piksel genişletilmiş ve bu bölge kafanın kalan kısmındaki median intensity ile doldurulmuştur. Model daha önce normal, occlusion yapılmamış görüntüler üzerinde eğitilmiştir.
Tümör bölgesinin görünümü kaldırıldığında:
- klasik kontrol %85,6'dan %83,0'a,
- linear probe %87,3'ten %84,7'ye,
- VQC %80,6'dan %78,9'a
düşmüştür.
Başka bir deyişle tümörün görüntü yoğunluğu ortadan kaldırılmasına rağmen doğruluk yalnız birkaç yüzde puanı düşmüştür. Bu durum modellerin tümör dokusunun görsel görünümünün dışında kalan anatomi, kaynak ve lezyon geometrisi gibi bilgilerden önemli ölçüde yararlandığına işaret etmektedir.
Ancak occluded alan tamamen bilgi içermeyen bir alan değildir: tümör maskesinin konumu, boyutu ve şekli korunmaktadır. Nitekim yalnız 16 × 16 boyutuna küçültülmüş tümör maskesiyle eğitilen logistic regression bile tümör sınıfını %61,4 doğrulukla tahmin etmiştir. Bu nedenle occlusion sonucu “model tümörü hiç kullanmıyor” anlamına gelmez.
Kaynaklar arası genelleme
Yalnız figshare kökenli üç tümör sınıfında hasta-gruplu eğitim yapıldığında VQC %80,8, klasik kontrol %86,4 ve linear probe %87,5 doğruluk sağlamıştır.
Figshare tümörlerinde eğitilip bağlantısız SARTAJ tümörlerinde test edildiğinde bütün head'ler yaklaşık şans düzeyine yaklaşmıştır:
\[ 36.1\%-38.8\% \]
dört backbone ortalaması aralığındadır; üç sınıflı şans seviyesi %33,3'tür.
Bu nedenle kaynak, kuantum ve klasik head'lerin ikisinin de acquisition-source değişimine karşı zayıf transfer gösterdiğini belirtmektedir.
Grad-CAM ne gösterdi?
Gradient-weighted Class Activation Mapping (Grad-CAM), CNN'in tahminini destekleyen uzamsal bölgelerin gradient-temelli önem haritasını üretir. Kaynak bunu “model neden karar verdi?” sorusunun kesin cevabı olarak değil, modelin tahminle ilişkili aktivasyonunun nerede yoğunlaştığını gösteren bir açıklama aracı olarak kullanmıştır.
İlk fold'daki 1400 test görüntüsünde Grad-CAM enerjisinin median olarak kafa maskesi içinde kalan oranı:
| Model | Median oran |
|---|---|
| ResNet-50 linear | %95 |
| EfficientNet-B0 linear | %80 |
| EfficientNet-B0 klasik kontrol | %89 |
| EfficientNet-B0 VQC | %85 |
| HQCNN | %52 |
VQC'de non-zero Grad-CAM haritasına sahip görüntülerin %28'inde enerjinin yarısından azı kafa maskesi içinde kalmıştır; klasik kontrolde bu oran %10, linear head'de %0,2'dir. Ancak Grad-CAM nedensel açıklama sağlamadığından bu farklılık tek başına modelin “neyi öğrendiğini” kesinleştirmez.
İstatistiksel analiz nasıl yapıldı?
Çalışma yalnız tek doğruluk yüzdesi raporlamak yerine çok katmanlı istatistik kullanmıştır.
Frozen-feature karşılaştırmalarında dört backbone × beş fold = 20 backbone–fold bloğu vardır. Seed'ler blok içinde ortalanmıştır. Head'ler arasındaki eşleştirilmiş farklar Wilcoxon signed-rank testiyle değerlendirilmiş, ortalama farklar için bootstrap %95 güven aralıkları hesaplanmış ve bütün head'ler Friedman testiyle karşılaştırılmıştır.
Fold ve backbone'lar tamamen bağımsız olmadığı için ayrıca:
- backbone ve backbone içindeki fold için random intercept içeren linear mixed model,
- repeated cross-validation için variance-corrected resampled t-test,
- hasta ve duplicate gruplarını yeniden örnekleyen image-level cluster bootstrap
uygulanmıştır.
End-to-end modellerde yalnız beş fold bulunduğundan fold-level Wilcoxon testi çok düşük çözünürlüğe sahiptir; beş çiftte ulaşılabilen en küçük iki taraflı p değeri 0,0625'tir. Bu nedenle modellerin out-of-fold tahminleri görüntü düzeyinde birleştirilmiş ve exact McNemar testi kullanılmıştır.
Hasta ve duplicate görüntüler bağımsız kabul edilemeyeceğinden doğruluk ve paired-difference %95 güven aralıkları hasta/duplicate gruplarını yeniden örnekleyen cluster bootstrap ile hesaplanmıştır. Ana değerlendirmelerde 5000 bootstrap örneklemesi, bazı sınıf-spesifik ve sızıntı alt kümelerinde 2000 örnekleme kullanılmıştır.
±1 yüzde puan eşdeğerlik testi ne demektir?
İki model arasında “anlamlı fark bulamadık” demek onların pratik olarak eşdeğer olduğunu kanıtlamaz. Kaynak bu nedenle iki model arasındaki farkın %90 güven aralığının tamamen:
\[ [-1,+1]\ \text{yüzde puanı} \]
aralığında kalmasını eşdeğerlik kriteri olarak kullanmıştır. Bu, \(\alpha=0,05\) düzeyindeki iki tek-yönlü eşdeğerlik testine karşılık gelir.
±1 pp sınırı fiziksel bir doğa sabiti değildir; araştırmacılar tarafından önceden seçilmiş pratik bir margin'dir. Kaynak da margin seçiminin konvansiyon olduğunu açıkça kabul etmiş ve her karşılaştırma için eşdeğerlik ilan edilebilecek en küçük margin'i ayrıca raporlamıştır.
Çalışmanın desteklediği sonuçlar
- Kaggle Brain Tumor MRI Dataset sürüm 2'nin resmî eğitim/test bölümleri ciddi görüntü ve hasta örtüşmesi içermektedir.
- Resmî test görüntülerinin %79'u eğitim bölümündeki bir görüntüyle duplicate grubunu paylaşmaktadır.
- Figshare kökenli test görüntülerinin 915/917'si eğitimde aynı hastayla örtüşmektedir.
- Hasta-gruplu değerlendirme frozen-feature doğruluğunu yaklaşık 3,3–7,8 pp ve fine-tuned doğruluğu yaklaşık 3,3–3,6 pp azaltmıştır.
- Altı-kübit VQC frozen özelliklerde aynı genişlikte klasik kontrolden yaklaşık 6,0 pp düşük doğruluk vermiştir.
- Fine-tuning VQC'nin klasik kontrole olan açığını yaklaşık 1 pp veya altına indirmiştir fakat yakınsamaya dayalı eğitimde VQC üstünlük göstermemiştir.
- Sıfırdan eğitilen HQCNN klasik kontrolünden 8,33 pp daha düşük doğruluk vermiştir.
- İncelenen ablasyonda dolaşıklık kapılarını kaldırmak doğruluğu düşürmemiş, artırmıştır.
- İncelenen quantum kernel, bütün PCA boyutlarında RBF kernel'den biraz daha düşük doğruluk vermiştir.
- Az eğitim verisi koşulunda VQC klasik kontrollerden daha kötü performans göstermiştir.
- Moderate depolarizing noise ana kuantum–klasik farkı açıklamamaktadır; fark gürültüsüz simülasyonda da vardır.
- Görüntü kaynağına bağlı shortcut'lar güçlüdür ve farklı kaynağa genelleme bütün modeller için zayıftır.
Çalışmanın desteklemediği sonuçlar
- “Kuantum makine öğrenmesi hiçbir tıbbi görüntüleme görevinde işe yaramaz” sonucu çıkarılamaz.
- Gerçek kuantum donanımın bu görevde daha yavaş veya daha hızlı olduğu bu simülasyon sürelerinden çıkarılamaz.
- 10 kübitten büyük devreler veya başka encoding/ansatz mimarilerinin performansı bu çalışmada test edilmemiştir.
- Quantum convolutional networks üzerinde genel bir başarısızlık sonucu çıkarılamaz.
- Bu çalışma klinik beyin tümörü teşhis cihazı doğrulaması değildir.
- %94 civarındaki fine-tuned doğruluklar gerçek hastane tanısal doğruluk tahmini değildir.
- Slice-level sınıflandırma examination-level veya patient-level klinik tanıyla aynı şey değildir.
- Out-of-source glioma hatalarının tamamının model hatası olduğu söylenemez; bazı etiketler de sorunlu olabilir ve radyolog incelemesi yapılmamıştır.
- Grad-CAM haritaları modelin kararının nedensel açıklaması değildir.
- Lesion occlusion deneyi modelin tümör bilgisini hiç kullanmadığını göstermez; lezyonun konum, boyut ve şekli korunmuştur.
- Barren plateau doğrudan ölçülüp kanıtlanmamıştır.
Çalışmanın güçlü yönleri
Birinci güçlü yön, kuantum modeli ilgisiz bir CNN ile değil aynı genişlikte ve aynı protokolde klasik kontrolle karşılaştırmasıdır. Böylece toplam ağ performansı yerine kuantum ara katmanın marjinal katkısı sorgulanabilmiştir.
İkinci güçlü yön, yalnız parametre sayısını eşleştirmekle yetinmeyip daha derin klasik kontrol ve devrenin fonksiyon sınıfını kapsayan Fourier surrogate kullanmasıdır.
Üçüncü güçlü yön, veri setindeki kopyaları yalnız exact checksum ile aramak yerine aynalama ve döndürmeye dayanıklı pHash + NCC yöntemiyle taraması ve mümkün olan görüntüler için özgün figshare hasta kimliklerini geri kazanmasıdır.
Dördüncü güçlü yön, kuantum devresini frozen features, end-to-end fine-tuning ve training from scratch olmak üzere üç farklı rejimde test etmesidir.
Beşinci güçlü yön, qubit sayısı, circuit depth, entanglement, data re-uploading, training-data fraction, depolarizing noise ve shot count ablasyonlarının birlikte incelenmesidir.
Altıncı güçlü yön, yalnız genel doğruluk yerine acquisition source, shortcut, lesion occlusion, cross-source transfer ve Grad-CAM analizleriyle modelin gerçekten neyi kullanıyor olabileceğini sorgulamasıdır.
Sınırlılıklar
Tek veri seti: Çalışma tek bir kamuya açık, iki boyutlu MRI benchmark'ına dayanmaktadır. Sonuçların başka hastalıklar, başka görüntüleme görevleri veya 3B MRI hacimlerine otomatik aktarılması mümkün değildir.
Eksik hasta kimlikleri: Hasta kimliği yalnız 4846 figshare kökenli tümör görüntüsü için geri kazanılmıştır. Diğer tümör ve tümörsüz görüntülerde gruplama duplicate detection'a bağlıdır; tespit edilmemiş aynı-muayene kesitlerinin farklı fold'larda bulunması tamamen dışlanamamaktadır.
Gerçek kuantum donanımı yok: Bütün devreler simüle edilmiştir. Kullanılan noise model crosstalk, readout error, limited connectivity ve gerçek gate decomposition maliyetlerini içermez.
Sınırlı devre ailesi: Dressed VQC'ler en fazla on kübit ve tek temel encoding yaklaşımıyla incelenmiştir. Başka encoding'ler, daha büyük devreler ve kuantum verisi üzerinde çalışan başka mimariler farklı davranabilir.
Hyperparameter araması sınırlı: End-to-end ana kıyaslamada iki seed/fold ve ilk fold üzerinde üç learning-rate adayından seçim kullanılmıştır. Daha geniş arama küçük farkları değiştirebilir.
Standardizasyon bütün shortcut'ları kaldırmıyor: Head masking kafatasını kaldırmamıştır. Coarse anatomy ve imaging plane bilgileri kalmıştır.
Grad-CAM sınırlılığı: Grad-CAM modelin nereye baktığına dair yaklaşık uzamsal ipucu verir; karar mekanizmasını açıklamaz.
Etiket doğrulaması: Candidate label errors ve 76 out-of-source glioma görüntüsü bağımsız radyolog tarafından yeniden etiketlenmemiştir.
Klinik kapsam
Kaynak, raporlanan doğrulukların klinik tanısal doğruluk olmadığını açıkça vurgulamaktadır. Klinik bir iddia için en azından slice-level yerine examination-level girdiler, bütün sınıflar için hasta ayrımı, histopatoloji veya uzman konsensüsü gibi referans standart, tümörsüz grubun tümör grubuyla aynı klinik popülasyondan gelmesi ve bağımsız çok-merkezli doğrulama gerekir.
Dolayısıyla bu çalışmanın konusu “MRI'da beyin tümörünü %94 doğrulukla teşhis eden kuantum sistem” değildir. Çalışmanın asıl konusu, bir kuantum ara katmanın eşleştirilmiş klasik kontrol karşısında ek sınıflandırma değeri sağlayıp sağlamadığı ve veri sızıntısının bu tür benchmark'ları nasıl yanıltabildiğidir.
Kaynak ve Yöntem Notu
Özgün başlık: Does the Quantum Layer Help? A Leakage-Aware Benchmark of Hybrid Quantum–Classical Models for Brain Tumor MRI Classification
Yazarlar: Tuan-Linh Duong; Pande Wikantyasa Maswita; Tony Sumaryada; Sitti Yani; Thanh-Tai Duong; Hiba Omer; Nissren Tamam; Abdelmoneim Sulieman.
Yazar sırası: Kaynak PDF ve resmî yayın kaydıyla uyumludur.
Eş katkı: Kaynakta eş birinci yazarlık/eş katkı işareti bildirilmemektedir.
Sorumlu yazar: Thanh-Tai Duong.
Kurum 1: The Laboratory Center, Hanoi University of Public Health, Hanoi 100000, Vietnam.
Kurum 2: Department of Physics, Faculty of Mathematics and Natural Sciences, IPB University, Bogor 16680, Indonesia.
Kurum 3: Department of Medical Physics, Faculty of Medicine, Nguyen Tat Thanh University, Ho Chi Minh City 700000, Vietnam.
Kurum 4: Department of Radiological Sciences, College of Applied Medical Sciences, Imam Abdulrahman Bin Faisal University, Dammam 34212, Saudi Arabia.
Kurum 5: Department of Physics, College of Sciences, Princess Nourah bint Abdulrahman University, Riyadh 11671, Saudi Arabia.
Kurum 6: Department of Radiological Sciences, College of Applied Medical Sciences, King Saud bin Abdulaziz University for Health Sciences, Al Ahsa 31982, Saudi Arabia.
Kurum 7: Imaging Physics Section, Research and Innovation Department, King Faisal Specialist Hospital & Research Center, Riyadh 11211, Saudi Arabia.
Kaynak türü: Hakemli özgün araştırma makalesi.
Dergi: Diagnostics.
Yayınevi: MDPI.
Cilt / sayı / makale numarası: 16 / 21 / 3485.
DOI: 10.3390/diagnostics16213485.
Alınma tarihi: 7 Ekim 2026.
Revizyon: 17 Ekim 2026.
Kabul: 21 Ekim 2026.
Yayın: 24 Ekim 2026.
Hakemlik durumu: Hakemli dergi makalesidir.
Lisans: Creative Commons Attribution (CC BY).
Resmî yayın: Diagnostics 2026, 16, 3485; DOI 10.3390/diagnostics16213485.
Ana bilimsel alan: Quantum machine learning, medical image classification, deep learning benchmarking ve data-leakage auditing.
Ana görev: Glioma, meningioma, hipofiz tümörü ve tümörsüz MRI kesitlerinin dört sınıflı sınıflandırılması.
Ana kuantum model: Angle encoding kullanan, altı-kübit ve iki varyasyonel katmanlı hardware-efficient dressed VQC; ablasyonlarda 2–10 kübit ve 1–6 katman değerlendirilmiştir.
Gerçek kuantum donanım: Kullanılmamıştır. Bütün kuantum devreleri klasik donanım üzerinde simüle edilmiştir.
Ana değerlendirme protokolü: Patient-grouped five-fold cross-validation (Protocol 3).
Ana sonuç: İncelenen VQC katmanı test edilen üç ana eğitim rejiminde eşleştirilmiş klasik katmanın doğruluğunu artırmamıştır.
Veri seti ana sorunu: Resmî test görüntülerinin %79'u eğitim bölümündeki bir kopyayla bağlantılıdır ve figshare kökenli test görüntülerinin 915/917'si eğitimde aynı hastayla örtüşmektedir.
İstatistik: Frozen-feature kıyaslarında Wilcoxon signed-rank, Friedman testi, bootstrap %95 GA, linear mixed model ve variance-corrected resampled t-test; end-to-end kıyaslarda exact McNemar, patient/duplicate-group cluster bootstrap ve ±1 pp equivalence margin kullanılmıştır.
Implementation: Python, PyTorch 2.14.0, timm 1.0.30, scikit-learn 1.8.0; PennyLane 0.45.1 yalnız simülatör doğrulaması için kullanılmıştır. End-to-end eğitim NVIDIA GeForce RTX 3090 24 GB GPU'da yürütülmüştür.
Generative AI kullanım beyanı: Kaynak, Claude'un Opus model ailesinin analiz kodunun yazılması ve debug edilmesi ile istatistiksel analizlerin yürütülmesinde yazarların yönlendirmesi altında kullanıldığını; analizlerin yazarlar tarafından tanımlandığını, kod ve sonuçların kontrol edildiğini ve kodun yayımlandığını bildirmektedir.
Veri erişilebilirliği: Brain Tumor MRI Dataset sürüm 2 Kaggle'da kamuya açıktır; veri seti DOI'si 10.34740/KAGGLE/DSV/2645886'dır. Makale veri setini 28 Eylül 2026'da indirdiğini bildirmektedir. Dataset audit kodu, quantum circuit simulator, self-test'ler, deneyler, istatistiksel analizler, leakage-aware split'ler, duplicate/patient annotations, checksum manifest, model tahminleri ve sonuç tabloları yazarların bildirdiği GitHub deposunda yayımlanmıştır. Veri seti görüntülerinin kendisi yeniden dağıtılmamaktadır.
Etik kurul: Yalnız kamuya açık ve tamamen kimliksizleştirilmiş veri kullanıldığı için etik inceleme ve onaydan feragat edilmiştir.
Hasta onamı: Yalnız kamuya açık, kimliksizleştirilmiş görüntüler kullanıldığı için onamdan feragat edilmiştir.
Finansman: Princess Nourah bint Abdulrahman University Researchers Supporting Project, PNURSP2026R12. Makale işlem ücreti de Princess Nourah bint Abdulrahman University tarafından finanse edilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir. Fon sağlayıcıların çalışma tasarımı, veri toplama/analiz/yorum, yazım veya yayımlama kararında rolü olmadığı belirtilmiştir.
Yazar katkıları: Conceptualization: P.W.M., T.-L.D., S.Y., T.-T.D.; methodology: P.W.M., T.-L.D.; software: P.W.M., T.-L.D.; formal analysis: T.-L.D.; investigation: P.W.M., T.-L.D., T.S.; data curation: T.-L.D.; visualization: T.-L.D.; original draft: P.W.M., T.-L.D.; review and editing: bütün yazarlar; supervision: S.Y., T.S., T.-T.D.; project administration: S.Y.; funding acquisition: S.Y., N.T.
Temel yorum sınırı: Sonuçlar, bu veri setinde ve test edilen küçük simüle VQC ailesinde kuantum katmanın ek doğruluk sağlamadığını göstermektedir. Çalışma bütün quantum machine learning modellerini, gerçek kuantum donanımı veya klinik MRI tanısını genel olarak geçersiz kılmaz.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir