


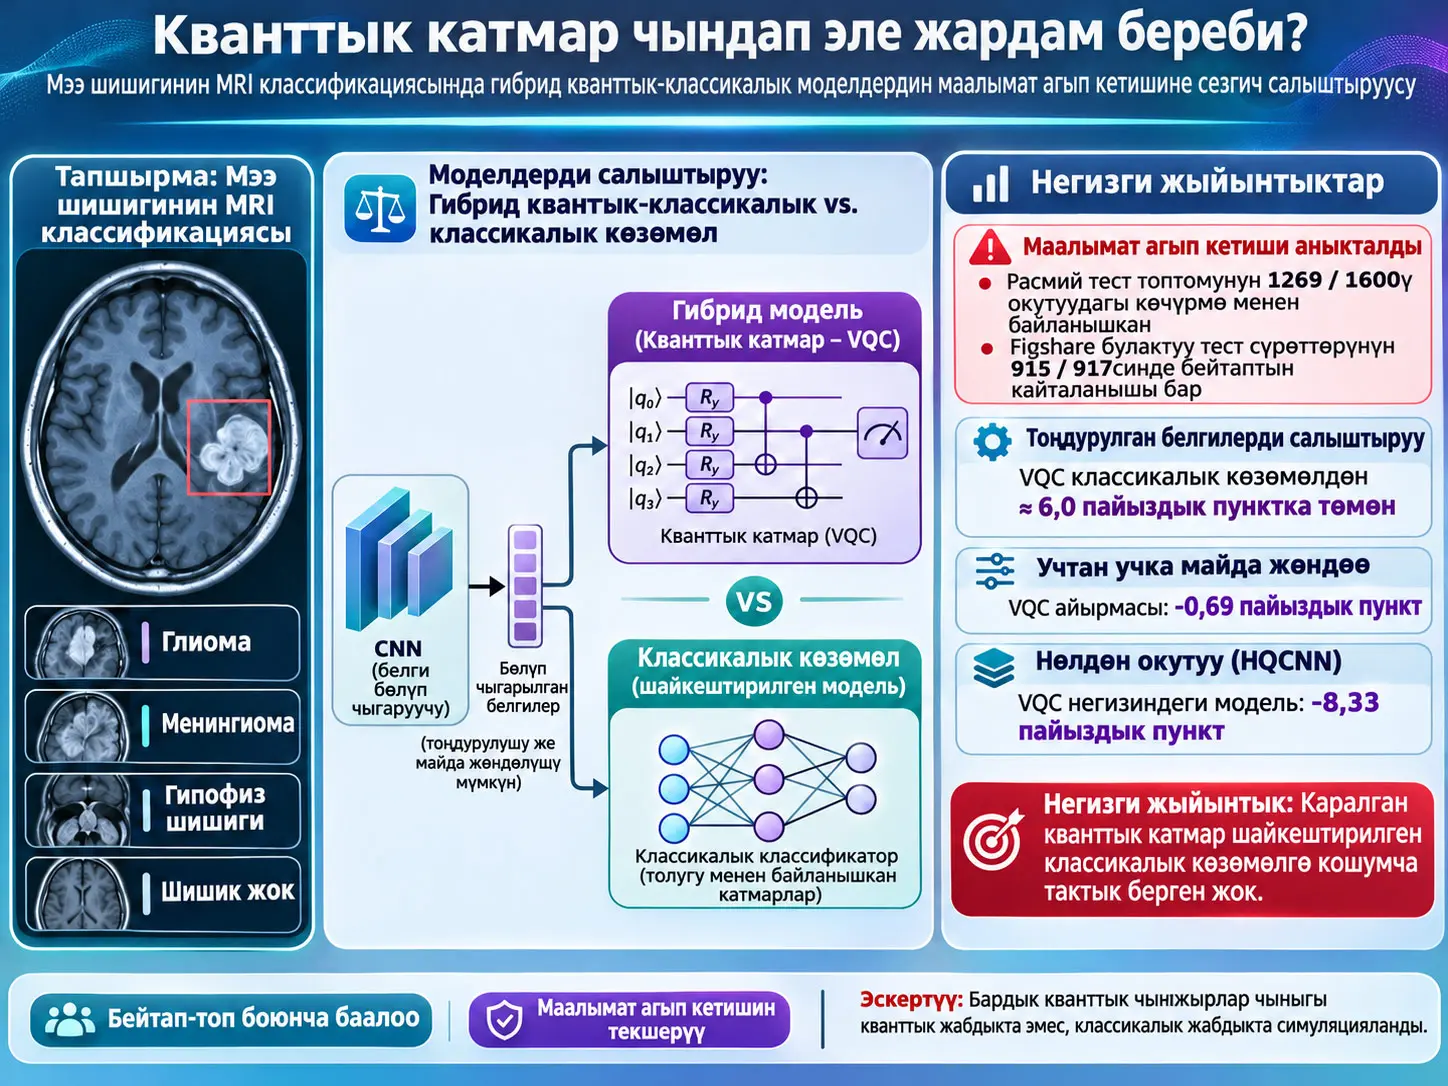
Вариациялык кванттык схема (variational quantum circuit, VQC), классикалык сүрөт белгилерин кванттык айлануу бурчтарына коддогон, үйрөнүлүүчү кванттык дарбазалар менен бул коддолгон абалды иштеткен жана өлчөнгөн Pauli-Z күтүлүүчү маанилерин кайра классикалык классификация катмарына өткөргөн параметрлештирилген кванттык схема. Бул изилдөө мээ шишигинин магниттик-резонанстык сүрөттөрүн (magnetic resonance imaging, MRI) классификациялоодо колдонулган мындай VQC катмары чындап эле классификация тактыгына салым кошобу же жокпу, аны ошол эле кеңдиктеги жана ошол эле окутуу шарттарындагы классикалык көзөмөл катмарлары менен салыштырып текшерген. Ошол эле учурда колдонулган ачык MRI маалымат топтомунда окутуу–тест маалымат агып кетиши, бейтаптардын кайталанышы жана сүрөт булагына байланышкан shortcut белгилери кеңири текшерилген.
Изилдөөдө Kaggle Brain Tumor MRI Datasetтин 13-февраль 2026-жылы жарыяланган 2-версиясы колдонулган. Маалымат топтому жалпысынан 7200 эки өлчөмдүү JPEG MRI кесиндисин камтыйт: glioma, meningioma, гипофиз шишиги жана шишиксиз болуп төрт класстын ар биринде 1800 сүрөт бар. Расмий бөлүнүү 5600 окутуу жана 1600 тест сүрөтүнөн турат. Булак коллекциялар менен дал келтирүүнүн натыйжасында 4846 шишик сүрөтү үчүн бейтаптын идентификатору калыбына келтирилген.
Маалымат аудити маалымат топтомунун расмий сүрөттөмөсүндөгү “окутуу–тест кайталанышы жоюлган” деген күтүүгө карабастан олуттуу агып кетүү бар экенин көрсөткөн. Күзгүлөө жана айлантууга туруктуу аудит менен 1600 расмий тест сүрөтүнүн 1269у, башкача айтканда болжол менен %79у, окутуу бөлүмүндөгү сүрөт менен бир duplicate тобуна байланышканы аныкталган. Figshare булагындагы 917 тест сүрөтүнүн 915и окутуу бөлүмүндө ошол эле бейтаптан жок дегенде дагы бир сүрөт менен кайталанган. Болгону 87 расмий тест сүрөтү аныкталган көчүрмөлөрдөн да, белгилүү бейтап кайталанышынан да көз каранды эмес “strict-clean” ички топтомду түзгөн.
Изилдөөчүлөрдүн негизги салыштыруусу алты кубиттүү, эки вариациялык катмарлуу VQC head менен ошол эле кириш/чыгыш кеңдигине ээ Linear(6,6) + tanh классикалык көзөмөлдүн ортосунда. Тоңдурулган ImageNet белгилеринде бейтап-топтолгон беш foldдук cross-validationда VQC дал келтирилген классикалык көзөмөлдөн орточо 6,03 пайыздык пункт төмөн тактык көрсөткөн; %95 ишеним аралыгы −6,78ден −5,20 пайыздык пунктка чейин. VQC ошондой эле тереңирээк классикалык көзөмөлдөн жана кванттык схема эсептей алган функциялар классын камтыган классикалык Fourier surrogate моделинен да төмөн тактык берген.
End-to-end fine-tuningде айырма азайган. Биринчи окутуу рецепти колдонулганда EfficientNet-B0 + VQC %94,1, классикалык көзөмөл %94,2 тактык берип, алардын ортосундагы −0,07 пайыздык пункт айырмасы ±1 пайыздык пункттук эквиваленттүүлүк чегинде калган. Бирок жакындашууга негизделген узагыраак окутууда VQC %93,8, классикалык көзөмөл %94,5 тактык берген; VQC айырмасы −0,69 пайыздык пункт (%95 GA −1,25тен −0,13кө чейин) болуп, ±1 пайыздык пункт чегинде эквиваленттүүлүк жарыяланган эмес. Нөлдөн окутулган гибрид кванттык–классикалык CNN болсо %67,9 тактык менен %76,2 болгон классикалык көзөмөлдөн 8,33 пайыздык пункт артта калган.
Изилдөө бул натыйжаларды “кванттык машиналык үйрөнүү эч качан иштебейт” деп жалпылабайт. Натыйжа текшерилген dressed VQC архитектурасы, колдонулган классикалык MRI маалыматы, 2–10 кубит аралыгы, текшерилген encoding жана көзөмөл моделдери үчүн гана жарактуу. Мындан тышкары бардык кванттык схемалар классикалык компьютерде симуляцияланган; чыныгы кванттык процессордо окутуу же inference жүргүзүлгөн эмес. Баяндалган тактыктарды клиникалык диагностикалык тактык деп чечмелөөгө болбойт.
Изилдөөнүн негизги суроосу кайсы?
Гибрид кванттык–классикалык сүрөт классификациялоо иштеринде жогорку жалпы тактыкты көрүү кванттык катмар чындап пайдалуу экенин өзүнөн-өзү далилдебейт. Анткени гибрид тармактын чоң бөлүгү дагы эле классикалык болушу мүмкүн: сүрөт белгилерин чыгарган CNN, кванттык схемага кириш түзгөн сызыктуу проекция жана кванттык өлчөөлөрдү класстарга айланткан чыгыш катмары классикалык компоненттер.
Ошондуктан изилдөөнүн борбордук суроосу болгону “гибрид модель канча пайыз тактык берди?” эмес. Күчтүүрөөк суроо мындай: Ошол эле классикалык backbone, ошол эле маалымат, ошол эле окутуу протоколу жана ошол эле bottleneck кеңдиги сакталып, кванттык схема гана ошол эле кеңдиктеги классикалык катмар менен алмаштырылганда натыйжалуулук чындап төмөндөйбү?
Эгер жооп жок болсо, жогорку жалпы натыйжалуулукту кванттык катмарга таандык кылууга болбойт.
Маалымат Агып Кетиши Деген Эмне жана Бул Изилдөөдө Эмне Үчүн Критикалык Маселе?
Маалымат агып кетиши — тест этабында чындап көрүлбөгөн маалыматты баалоонун ордуна, окутуу учурунда ошол эле сүрөттүн, иштетилген көчүрмөсүнүн же ошол эле бейтаптан абдан окшош сүрөттөрдүн моделге кыйыр түрдө көрсөтүлүшү; бул изилдөөдө расмий тест топтомунун %79у окутуудагы көчүрмө менен байланышканы жана figshare булагындагы 917 тест сүрөтүнүн 915и окутууда ошол эле бейтап менен кайталанганы үчүн жогорку тест тактыктарынын маанилүү бөлүгү чыныгы жалпылоо натыйжалуулугун ашыкча көрсөтүшү мүмкүн экени аныкталган.
Так көчүрмө менен жакын көчүрмө бирдей эмес
Изилдөөчүлөр агып кетүүнүн бир нече түрүн өз-өзүнчө издешкен.
- Exact duplicate: Пиксел массивдери толугу менен бирдей сүрөттөр. Алар декоддолгон пиксел массивинин MD5 checksum'у менен аныкталган.
- Near-duplicate: Кайра JPEG коддолгон, кайра өлчөмдөлгөн же майда иштетүү айырмалары бар, бирок маңызы боюнча ошол эле сүрөттү алып жүргөн үлгүлөр.
- Mirrored copy: Сүрөткө горизонталдык/вертикалдык же башка чагылдыруу өзгөртүүлөрү колдонулган көчүрмөлөр.
- Rotated/flipped copy: Квадрат сүрөттүн сегиз айлантуу жана чагылдыруу өзгөртүүлөрүнүн бири менен алынган дал келүүлөр.
- Patient overlap: Сүрөттөр толук бирдей болбосо да, окутуу жана тест топтомдорунда ошол эле бейтапка тиешелүү ар башка MRI кесиндилеринин болушу.
Жакын көчүрмө талапкерлери 64-bit perceptual hash (pHash) менен сканерленип, Hamming аралыгы эң көп 8 bit болушу шарт кылынган. Андан кийин талапкер жуптардын 64 × 64 пиксел thumbnail-дарынын ортосундагы нормалдаштырылган кайчылаш корреляция (normalized cross-correlation, NCC) кеминде 0,95 болушу талап кылынган.
Hamming аралыгы, эки бит тизмегинде айырмаланган биттердин саны. Мисалы, эки 64-bit pHash ортосунда Hamming аралыгы 8 болсо, 64 позициянын сегизинде бит маанилери башкача. Кичине Hamming аралыгы визуалдык түзүлүштөрдүн окшоштугун көрсөтөт; бирок жалгыз өзү жетиштүү деп саналган эмес жана NCC текшерүүсү да колдонулган.
NCC, эки сүрөт үлгүсүнүн сызыктуу окшоштугун өлчөгөн нормалдаштырылган корреляция өлчөмү. Изилдөөдөгү 0,95 чеги pHash чыгарган талапкерлер чындап өтө окшош сүрөт экенин экинчи текшерүү катары колдонулган.
Күзгүлөө жана айлантуу эмнеге өзгөчө маанилүү болгон?
Стандарттуу pHash күзгүлөө жана айлантууга инварианттуу эмес. Башкача айтканда, MRI кесиндисинин күзгү сүрөтү адамдын көзүнө ачык эле ошол сүрөт болуп көрүнсө да, түз pHash салыштыруусунда жетиштүү жакын чыкпашы мүмкүн. Ошондуктан изилдөөчүлөр ар бир сүрөттүн квадраттагы сегиз айлантуу/чагылдыруу өзгөртүүсүн баалап, эң кичине Hamming аралыгын жана тиешелүү NCC маанисин колдонушкан.
Алгачкы аудит 385 exact жана 6162 near-duplicate жупту тапса, өзгөртүүлөргө туруктуу жаңыланган аудит кошумча 7915 күзгүлөнгөн жана 10.161 айлантылган/flipped жупту аныктаган. Жалпы duplicate-pair саны 24.623кө жетип, алардын 9699у окутуу–тест чек арасынан өткөн.
| Өлчөм | Булак натыйжасы | Түшүндүрмө |
|---|---|---|
| Жалпы сүрөт | 7200 | Төрт класстын ар биринде 1800 сүрөт |
| Расмий окутуу / тест | 5600 / 1600 | Ар класста 1400 окутуу + 400 тест |
| Жалпы аныкталган duplicate жуп | 24.623 | Exact, near, mirrored жана rotated/flipped жуптардын суммасы |
| Окутуу–тест чек арасынан өткөн duplicate жуп | 9699 | Расмий бөлүнүүгө түз таасир эткен байланыштар |
| Окутууда көчүрмөсү бар тест сүрөтү | 1269 / 1600 (%79) | Augmented үлгүлөрдү камтыган жаңыланган аудит |
| Figshare булагындагы тест сүрөттөрүндө бейтап кайталанышы | 915 / 917 | Ошол эле бейтап окутуу бөлүмүндө да бар |
| Эч кандай көчүрмө же белгилүү бейтап байланышы жок strict-clean тест | 87 | 74 glioma, 11 meningioma, 2 гипофиз шишиги; шишиксиз үлгү жок |
Маалымат булагы эмнеге өзүнчө изилденген?
Ошол эле шишик классынын ар башка аппараттардан, ар башка MRI секвенцияларынан, ар башка сүрөт матрицаларынан же ар башка JPEG иштетүү чынжырларынан келиши модель үчүн керексиз shortcut түзүшү мүмкүн. Модель шишик морфологиясын үйрөнүүнүн ордуна сүрөт кайсы маалымат булагынан келгенин үйрөнүшү мүмкүн.
Ошондуктан изилдөөчүлөр сүрөттүн туурасы, бийиктиги, aspect ratio, 512 × 512 болушу, түс режими, JPEG файл өлчөмү, глобалдык интенсивдүүлүк статистикасы жана ал тургай шишиктин деталдуу көрүнүшүн камтыбаган болгону 8 × 8 пиксел thumbnail сыяктуу белгилер менен gradient-boosting классификаторлорун окутушкан.
Сүрөт өлчөмү, aspect ratio жана түс режими гана колдонулганда шишик–шишиксиз ажыратуу %91,8 тактык менен аткарылган. 8 × 8 thumbnail гана колдонулганда төрт класстуу тактык %78,9 болгон; кокустук мүмкүнчүлүк деңгээли %25. Бейтап-топтолгон Protocol 3 шартында да бул одоно thumbnail %78,1 тактык берген.
Сүрөттөр стандартташтырылып, фон, чек аралар, матрица өлчөмү жана интенсивдүүлүк масштабы сыяктуу көптөгөн белгилер алынып салынгандан кийин да 8 × 8 thumbnail төрт класста %69,7 тактык берген. Бул натыйжалар маалымат топтомундагы класс белгилерин шишик тканынын көрүнүшүнөн гана эмес, сүрөттөө булагы жана одоно анатомия сыяктуу башка сигналдардан да болжолдоого болорун көрсөтөт.
76 “out-of-source” glioma сүрөтү эмнеге маанилүү?
Расмий тест бөлүмүндөгү 400 glioma сүрөтүнүн 76сы окутуудагы glioma сүрөттөрүнөн башка булакка жана сүрөттөө бөлүштүрүүсүнө таандык. Окутуудагы бардык 1400 glioma сүрөтү 512 × 512 figshare форматында болсо, бул 76 сүрөт 61 ар башка матрица өлчөмүндө болгон.
Булак дал келтирүүсү бул 76 сүрөт SARTAJ коллекциясындагы тест glioma сүрөттөрүнүн пикселдик көчүрмөлөрү экенин көрсөткөн. Демек, алар “жаңы бейтап” гана эмес, ошол эле учурда модель glioma классы үчүн окутуу учурунда көрбөгөн маалымат булагы.
Fine-tuned моделдер жалпы бейтап-топтолгон тактыкта болжол менен %94 деңгээлге жеткени менен, бул 76 сүрөттө болгону %46,1–61,8 тактык көрсөткөн. Бул айырма жалпы тактыкты маалымат булагы боюнча бөлүү эмне үчүн керек экенин ачык көрсөтөт.
Талапкер энбелги каталары
Confident-learning сканы 6997 augmented эмес сүрөттүн 28ин мүмкүн болгон энбелги катасы катары белгилеген. Алардын 19у figshare булагынан. Figshare түпнуска аннотациясы 15инде учурдагы энбелгини колдогон, төрт сүрөттө болсо модель сунуштаган альтернативдүү классты колдогон.
Булак бул 28 сүрөттү “так туура эмес энбелги” деп атабайт. Радиологдун көз карандысыз кароосу жүргүзүлбөгөндүктөн, алар болгону candidate label errors, башкача айтканда эксперттик кароону талап кылган талапкерлер жана бардык негизги анализдерде маалымат топтомунан чыгарылган эмес.
Вариациялык Кванттык Схема Бул Моделде Так Эмне Кылат?
Изилдөөдөгү dressed VQC классикалык CNN backbone-дан келген жогорку өлчөмдүү белгилерди адегенде n бурчка кысат, бул бурчтарды n кубиттин RY айланууларына коддойт, үйрөнүлүүчү бир-кубит айлануулары жана CNOT шакектери менен иштетет, ар кубитте Pauli-Z күтүлүүчү маанисин өлчөйт жана чыккан n чыныгы санды төрт MRI классына тиешелүү классикалык logitтерге айлантат; демек кванттык схема бүтүндөй модель эмес, классикалык белги чыгаргыч менен классикалык чыгыш катмарынын ортосундагы кичине аралык катмар.
Кубит деген эмне?
Классикалык бит 0 же 1 абалында гана аныкталса, бир кубит, өлчөөгө чейин эки негизги абалдын комплекстүү амплитудалар менен сүрөттөлгөн кванттык суперпозициясында боло алат. Жалпы бир-кубит абалы концептуалдык түрдө:
\[ |\psi\rangle=\alpha|0\rangle+\beta|1\rangle, \qquad |\alpha|^2+|\beta|^2=1 \]
түрүндө жазылат. Бул туюнтма изилдөөнүн жаңы жыйынтыгы эмес; VQCдеги кубит түшүнүгүн түшүндүргөн негизги кванттык механика көрсөтмөсү.
Теңдеме (1): Классикалык белгилер кванттык бурчтарга кантип айландырылат?
Булакта классикалык белги векторунан кванттык схемага кире турган бурчтарды түзүү:
\[ \mathbf{x} = \frac{\pi}{2} \tanh(W\mathbf{f}+\mathbf{b}) \in \left(-\frac{\pi}{2},\frac{\pi}{2}\right)^n \tag{1} \]
түрүндө.
Бул жерде:
- \(\mathbf{f}\), классикалык backbone-дан келген \(d\)-өлчөмдүү белги вектору.
- \(W\), үйрөнүлүүчү сызыктуу өзгөртүү матрицасы.
- \(\mathbf{b}\), үйрөнүлүүчү bias вектору.
- \(\tanh\), элементтик гиперболалык тангенс функциясы.
- \(\mathbf{x}=(x_1,\ldots,x_n)\), кванттык схемага коддоло турган \(n\) айлануу бурчун камтыйт.
- \(n\), ошол эле учурда VQCдеги кубиттердин саны.
\(\tanh\) чыгышы −1 менен +1 ортосунда болгондуктан \(\pi/2\) ге көбөйтүлгөндө ар бир бурч \(-\pi/2\) менен \(+\pi/2\) арасында чектелет. Ошентип миңдеген классикалык CNN белгилери түздөн-түз миңдеген кубитке жүктөлбөйт; адегенде кичине \(n\)-өлчөмдүү bottleneckке кысылат.
Негизги алты кубиттүү моделде, мисалы, EfficientNet-B0нун 1280 өлчөмдүү pooled белги вектору адегенде болгону алты бурчка кыскарат. Бул өлчөмдү азайтуу өзү маанилүү маалымат bottleneckи болуп саналат жана кванттык схеманын кийинки эсептөөсүн чечмелөөдө эске алынышы керек.
Hadamard жана RY дарбазалары эмне кылат?
Ар бир кубит башында \(|0\rangle\) абалында болот. Булак схемасында адегенде Hadamard (\(H\)) дарбазасы, андан кийин \(R_Y(x_i)\) айлануусу колдонулат.
Hadamard дарбазасы негизги абалдагы кубитти эки негизги абалдын суперпозициясына өткөрөт. \(R_Y(x_i)\) болсо Bloch сферасында Y огунун айланасында \(x_i\) бурчуна айлантат. Ошентип классикалык белгилерден алынган сандык бурч кванттык абалдын амплитудаларына коддолот.
Үйрөнүлүүчү Rot дарбазасы
Ар бир вариациялык катмарда ар бир кубитке:
\[ \operatorname{Rot}(\alpha,\beta,\gamma) = R_Z(\gamma)R_Y(\beta)R_Z(\alpha) \]
түрүндө үч үйрөнүлүүчү бурчу бар жалпы бир-кубит айлануусу колдонулган.
Алты кубит жана эки вариациялык катмарда ар кубит үчүн катмар башына үч параметр болгондуктан кванттык схеманын үйрөнүлүүчү параметрлеринин саны:
\[ 6\times2\times3=36 \]
болот.
CNOT шакеги жана кванттык чырмалышуу
Бир-кубит айланууларынан кийин кубиттер controlled-NOT (CNOT) шакеги менен байланыштырылган. Шакекте кубит \(i\), кубит \(i+1\)ди башкарат жана индекс акыркы кубиттен кийин кайра биринчи кубитке кайтып келет.
CNOT сыяктуу эки-кубит дарбазалары ылайыктуу кириш абалдарында кубиттердин ортосунда кванттык чырмалышууну түзө алат. Бирок бул изилдөөнүн маанилүү абляция жыйынтыктарынын бири CNOT шакегин алып салуу тактыкты төмөндөтпөстөн, тескерисинче негизги алты-кубит тажрыйбасында жогорулатканы. Ошондуктан “чырмалышуу колдонулду, демек артыкчылык кванттык чырмалышуудан келди” деген чечмелөөнү булак колдобойт.
Теңдеме (2): VQCнин кванттык абалы
Булактын схема теңдемеси бурч коддоону жана \(L\) вариациялык катмарды төмөнкү жалпы түзүлүштө берет:
\[ |\psi(\mathbf{x};\boldsymbol{\theta})\rangle = U_{\mathrm{ent}}R(\boldsymbol{\theta}^{(L)}) \cdots U_{\mathrm{ent}}R(\boldsymbol{\theta}^{(1)}) \left[ \bigotimes_{i=1}^{n} R_Y(x_i)H \right] |0\rangle^{\otimes n} \tag{2} \]
Бул жерде:
- \(|0\rangle^{\otimes n}\), бардык \(n\) кубиттин баштапкы абалы.
- \(\bigotimes\), амалдар ар башка кубиттерге тензордук көбөйтүү аркылуу колдонуларын көрсөтөт.
- \(R_Y(x_i)\), \(i\)-классикалык бурчтун тиешелүү кубитке коддолушу.
- \(R(\boldsymbol{\theta}^{(\ell)})\), \(\ell\)-катмардагы үйрөнүлүүчү бир-кубит айланууларынын жалпы түзүлүшүн билдирет.
- \(U_{\mathrm{ent}}\), CNOT шакегинен турган чырмалышуу катмары.
- \(L\), вариациялык катмарлардын саны.
- \(\boldsymbol{\theta}\), үйрөнүлүүчү кванттык схема параметрлеринин баары.
Негизги моделде \(n=6\) жана \(L=2\).
Схемадан классикалык сан кантип чыгат?
Ар бир кубит үчүн Pauli-Z операторунун күтүлүүчү мааниси өлчөнөт:
\[ z_i = \langle\psi(\mathbf{x};\boldsymbol{\theta})| Z_i |\psi(\mathbf{x};\boldsymbol{\theta})\rangle, \qquad z_i\in[-1,1]. \]
\(Z_i\) болгону \(i\)-кубиттеги Pauli-Z өлчөөсүн билдирет. Күтүлүүчү маани бир өлчөөнүн ичинде 0 же 1 гана эмес; көп өлчөөлөр же толук абал симуляциясы түзгөн ыктымалдык бөлүштүрүүдөн эсептелген −1 менен +1 арасындагы чыныгы маани.
Алты кубиттүү схема ушундайча алты чыныгы сан чыгарат. Акыркы классикалык сызыктуу катмар бул алты маанини төрт класска тиешелүү төрт logitке айландырат жана классификация чечими ушул классикалык чыгыш аркылуу берилет.
Классикалык көзөмөл эмнеге “ошол эле кеңдикте” болушу керек?
Алты-кубит VQCнин ордуна өтө чоң же өтө кичине классикалык тармак коюу натыйжалуулук айырмасы кванттык эсептөөдөнбү же модель сыйымдуулугунанбы келип жатканын ажыратууну кыйындатат.
Негизги классикалык көзөмөл ошондуктан VQCнин алты кириш жана алты чыгышына туура келген Linear(6,6) + tanh колдонгон. Алты-кубит VQCнин 36 үйрөнүлүүчү кванттык параметрине каршы классикалык аралык катмарда 42 параметр бар.
Изилдөө бул да толук “туюнтуу күчүнүн теңдигин” камсыз кылбай турганын кабыл алып, дагы эки классикалык көзөмөл колдонгон:
- Deeper control: эки
Linear(6,6) + tanhкатмары; 84 аралык-катмар параметри. - Fourier surrogate: VQC бир жолку бурч коддоодо эсептей алган тригонометриялык функциялар классын камтуу үчүн \(3^6=729\) классикалык тригонометриялык белги.
Fourier surrogate маанилүү. Булак VQCнин ар бир чыгышы ар бир кириш бурчунда жыштыктары \(\{-1,0,1\}\) болгон тригонометриялык полином экенин түшүндүрөт. Алты кириш үчүн мүмкүн болгон көбөйтүндү базисинин өлчөмү:
\[ 3^6=729 \]
болот. Бул базистеги ар бир белги:
\[ \prod_i g_i(x_i), \qquad g_i\in\{1,\cos x_i,\sin x_i\} \]
түрүндө. Демек сызыктуу классикалык модель бул схема дизайны чыгара алган функциялар классын көрсөтө алат. Изилдөөдө бул surrogate VQCден такыраак чыккан.
“Barren plateau” жыйынтыгы далилдендиби?
Жок. Сегиз жана он кубиттүү схемалардын тактыгынын төмөндөшү жана кванттык моделдин узагыраак окутууну талап кылышы авторлор тарабынан кванттык схемаларда белгилүү жалпак оптималдаштыруу ландшафттары менен шайкеш деп бааланат; бирок изилдөө gradient вариациясын түз өлчөп barren plateau бар экенин далилдеген эмес.
Кванттык схема чыныгы кванттык жабдыкта иштетилдиби?
Жок. Ызы-чуусуз схемалар PyTorch менен жазылган batched state-vector симулятору аркылуу классикалык CPU/GPUда толук симуляцияланган. Ызы-чуулуу схемалар density-matrix симуляциясы менен эсептелген. PennyLane иштелип чыккан симулятордун чыгышын текшерүү үчүн гана колдонулган.
Ошондуктан изилдөөдөгү 18,8 ms сыяктуу latency маанилери кванттык процессордун иштөө убактысы эмес. Алар RTX 3090до кванттык схема симуляциясын да камтыган классикалык GPU forward-pass убакыттары.
Depolarizing noise модели
Ызы-чуу тажрыйбасында ар бир кубитке ар gate layerден кийин бир-кубит деполяризация каналы колдонулган:
\[ \rho \rightarrow (1-p)\rho + \frac{p}{3} \left( X\rho X+Y\rho Y+Z\rho Z \right). \]
Бул жерде:
- \(\rho\), кубиттин density matrix абалы.
- \(p\), ушул катмарда Pauli катасы колдонулуу ыктымалдыгы.
- \(X,Y,Z\), Pauli операторлору.
\(p=0\) идеалдуу ызы-чуусуз симуляцияны, чоңураак \(p\) күчтүүрөөк деполяризацияны билдирет. Булакта \(p=\{0{,}001,0{,}003,0{,}01,0{,}03,0{,}1\}\) маанилери текшерилген.
Бул модель чыныгы жабдыктын бардык ката булактарын камтыбайт. Crosstalk, readout error, чектелген байланыш топологиясы жана чыныгы gate decomposition чыгымы моделге киргизилген эмес.
“Shot” деген эмне?
Чыныгы кванттык компьютерде күтүлүүчү маани бир өлчөөнүн өзүнөн так алынбайт. Ошол эле схема көп жолу иштетилип, өлчөө жыйынтыктарынын статистикасы колдонулат. Схеманы бир жолу даярдап өлчөөгө жалпысынан shot деп айтылат.
Изилдөөдө finite-shot таасирин окшоштуруу үчүн exact outcome probability бөлүштүрүүдөн \(S\) натыйжа үлгүлөнгөн. Текшерилген shot сандары:
\[ S\in\{16,64,256,1024,4096\} \]
болгон.
Quantum kernel деген эмне?
Model-head тажрыйбаларынан өзүнчө изилдөөчүлөр quantum-kernel support vector machine (SVM) менен классикалык radial basis function (RBF) kernel SVMди да салыштырышкан.
EfficientNet-B0 белгилери адегенде principal component analysis (PCA) менен 4, 6, 8 же 10 компонентке кыскартылып, [0,1] аралыгына масштабдалган. Quantum kernel үчүн ZZ feature map колдонулган.
Эки кириштин kernel окшоштугу кванттык абалдардын fidelityси менен аныкталган:
\[ k(\mathbf{x},\mathbf{x}') = \left| \langle\psi(\mathbf{x})|\psi(\mathbf{x}')\rangle \right|^2. \]
Ички көбөйтүндүнүн абсолюттук квадраты 0 менен 1 арасындагы окшоштук мааниси. Ошол эле кванттык абалда 1ге жетет; абалдар айырмаланган сайын кичирейиши мүмкүн.
Классикалык салыштыргыч ошол эле PCA кириштеринде RBF kernel колдонгон. Ошентип эки kernel ошол эле төмөн өлчөмдүү кириш маалыматы боюнча салыштырылган.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Brain Tumor MRI Dataset 2-версиясы
| Класс | Окутуу | Тест | Жалпы |
|---|---|---|---|
| Glioma | 1400 | 400 | 1800 |
| Meningioma | 1400 | 400 | 1800 |
| Гипофиз шишиги | 1400 | 400 | 1800 |
| Шишик жок | 1400 | 400 | 1800 |
| Жалпы | 5600 | 1600 | 7200 |
Figshare коллекциясы 233 бейтаптан 3064 контрасттуу T1-weighted MRI кесиндисин камтып, түпнуска бейтап идентификаторлору менен бирге шишик түрүн жана кол менен түзүлгөн шишик маскасын берет. Изилдөөнүн provenance дал келтирүүсү Kaggle маалымат топтомундагы 5400 шишик сүрөтүнүн 4846сын figshare булагы катары дал келтирген.
Калган шишик сүрөттөрүнүн булактары SARTAJ коллекциясы менен дал келтирүү аркылуу изилденген. JPEG quantization table, chroma subsampling жана color mode маалыматтары да өндүрүү/иштетүү чынжырынын fingerprintи катары катталган.
Үч баалоо протоколу
| Протокол | Түзүлүш | Максат / чечмелөө чеги |
|---|---|---|
| Protocol 1 | Расмий 5600/1600 бөлүнүшү; окутуудан 800 сүрөт validation үчүн бөлүнөт | Агып кетүү жана source-shift таасирин өлчөө үчүн сакталган; негизги модель салыштыруусу эмес |
| Protocol 2 | Беш foldдук grouped CV; алгачкы duplicate audit топтору foldдордун арасында бөлүнбөйт | Алгачкы тапшырууда колдонулган ыкма; жаңыланган auditтен кийин жетишсиз экени аныкталган |
| Protocol 3 | Revised duplicate топтору + ошол эле figshare бейтаптын бардык сүрөттөрү бириктирилип беш fold түзүлөт | Негизги баалоо протоколу; белгилүү ошол эле бейтап же табылган көчүрмө foldдордун арасында өтө албайт |
Protocol 3тө 6997 augmented эмес сүрөттүн ар бири так бир жолу out-of-fold тест божомолун алат. Figshare булагындагы тест сүрөтү үчүн моделди окуткан fold бул сүрөттү да, табылган көчүрмөсүн да, ошол эле бейтаптын башка figshare сүрөтүн да көрбөйт.
Бирок булак маанилүү калган чектөөнү белгилейт: figshareдан тышкаркы шишик сүрөттөрүндө жана шишиксиз сүрөттөрдө бейтап идентификатору жок. Ошондуктан duplicate detector кармабаган ошол эле текшерүүгө тиешелүү башка кесиндилердин ар башка foldдорго түшүү мүмкүнчүлүгү толук жок кылынган эмес.
Frozen-feature тажрыйбалары
Төрт ImageNet-pretrained backbone туруктуу белги чыгаргыч катары гана колдонулган:
| Backbone | Белги өлчөмү d |
|---|---|
| EfficientNet-B0 | 1280 |
| DenseNet-121 | 1024 |
| ResNet-50 | 2048 |
| MobileNetV2 | 1280 |
Сүрөттөр grayscaleге айландырылып үч каналга көчүрүлгөн, 256 × 256 пикселге кайра өлчөмдөлгөн, борбордон 224 × 224 кесилген жана ImageNet статистикасы менен нормалдаштырылган. Pooled белгилер ар бир окутуу foldунун орточо мааниси жана стандарттык четтөөсү менен стандартташтырылган.
Сегиз башка head салыштырылган:
- 6-кубит, 2-катмар VQC;
- дал келтирилген классикалык көзөмөл;
- тереңирээк классикалык көзөмөл;
- Fourier surrogate;
- bottleneck-only;
- linear probe;
- 256 жашыруун бирдиктүү MLP;
- кванттык параметрлери random баштапкы абалда тоңдурулган untrained VQC.
Headдер Adam optimizer менен окутулган; weight decay \(10^{-4}\), batch size 128 жана эң көп 80 epoch колдонулган. Validation loss беш epoch жакшырбаса learning rate эки эсе азайтылган, он epoch жакшырбаса окутуу токтотулган. Баштапкы learning rate ар шартта:
\[ \{10^{-3},3\times10^{-3},10^{-2}\} \]
арасынан validation loss боюнча тандалган.
Кванттык Катмар Бул Benchmarkта Чындап Пайда Бердиби?
Жок; изилдөө текшерген үч негизги окутуу режиминде алты-кубит VQC ошол эле кеңдиктеги классикалык катмардын тактыгын жогорулаткан эмес: frozen-feature тажрыйбаларында ачык артта калган, end-to-end fine-tuning учурунда болжол менен ошол эле деңгээлге жакындаган, бирок convergence-based окутууда кайра 0,69 пайыздык пункт төмөн болуп, нөлдөн окутулган HQCNNде классикалык көзөмөлдөн 8,33 пайыздык пункт төмөн тактык берген; бул натыйжа текшерилген схема, маалымат топтому жана окутуу протоколдору үчүн гана жарактуу.
| Режим | Салыштыруу | Тактык айырмасы | %95 GA | Булак чечмелөөсү |
|---|---|---|---|---|
| Frozen features | VQC − дал келтирилген классикалык көзөмөл | −6,03 пайыздык пункт | −6,78ден −5,20га чейин | Классикалык көзөмөл 20/20 backbone–fold блокто жакшыраак |
| Frozen features | VQC − deeper control | −4,71 пайыздык пункт | −5,63төн −3,73кө чейин | Классикалык модель 20/20 блокто жакшыраак |
| Frozen features | VQC − Fourier surrogate | −5,27 пайыздык пункт | −6,20дан −4,39га чейин | Схеманын функциялар классын камтыган классикалык surrogate жакшыраак |
| End-to-end, Block A | VQC − классикалык көзөмөл | −0,07 пайыздык пункт | −1,08ден +1,00га чейин | ±1 pp ичинде эквивалент |
| End-to-end, Block B | VQC − классикалык көзөмөл | −0,69 пайыздык пункт | −1,25тен −0,13кө чейин | ±1 pp эквиваленттүүлүгү жарыяланган жок |
| Standardized images, Block C | VQC − классикалык көзөмөл | −1,11 пайыздык пункт | −2,07ден −0,20га чейин | VQC төмөн |
| From scratch | HQCNN − классикалык көзөмөл | −8,33 пайыздык пункт | −12,72ден −4,06га чейин | Классикалык көзөмөл жакшыраак |
Frozen-feature жыйынтыктарынын деталдары
| Head | EfficientNet-B0 | DenseNet-121 | ResNet-50 | MobileNetV2 |
|---|---|---|---|---|
| VQC | 82,0 ± 3,4 | 79,5 ± 3,5 | 76,0 ± 4,0 | 78,5 ± 2,1 |
| Классикалык көзөмөл | 86,4 ± 2,9 | 86,4 ± 3,1 | 83,1 ± 3,1 | 84,3 ± 3,9 |
| Deeper control | 84,4 ± 2,6 | 85,5 ± 2,8 | 81,3 ± 2,9 | 83,7 ± 3,7 |
| Fourier surrogate | 85,5 ± 3,3 | 85,4 ± 3,6 | 82,1 ± 2,6 | 84,2 ± 2,9 |
| Bottleneck only | 87,6 ± 3,2 | 87,9 ± 3,6 | 85,5 ± 2,5 | 86,4 ± 3,6 |
| Linear probe | 88,1 ± 3,0 | 88,1 ± 3,1 | 86,0 ± 2,3 | 87,1 ± 3,6 |
| MLP | 87,9 ± 2,8 | 88,8 ± 3,2 | 86,3 ± 2,1 | 87,5 ± 3,7 |
| Untrained VQC | 80,6 ± 4,5 | 78,1 ± 4,8 | 69,7 ± 3,0 | 77,0 ± 5,8 |
Бул жердеги ± маанилер ар backbone үчүн беш fold боюнча seed-averaged тактыктын стандарттык четтөөсү.
VQCнин окутулганы толугу менен пайдасыз эмес: окутулган VQC random параметрлерде тоңдурулган VQCден орточо 2,67 пайыздык пункт такыраак чыккан (%95 GA 1,11–4,24). Демек схема параметрлерин үйрөнүү белгилүү салым берген; бирок бул салым кванттык катмарды классикалык көзөмөлдөрдөн жогору чыгарууга жеткен эмес.
Кубиттердин саны көбөйгөндө эмне болду?
EfficientNet-B0 frozen белгилеринде bottleneck кеңдиги жана VQC кубит саны 2, 4, 6, 8 жана 10 болуп өзгөртүлгөн.
VQC экиден алты кубитке чейин болжол менен %83,3–83,6 деңгээлде калып, сегиз кубитте %80,8ге жана он кубитте %81,4кө түшкөн. Классикалык көзөмөл болсо кеңдик өскөн сайын эки бирдикте %82,0дан сегиз бирдикте %86,6га чейин жогорулаган.
VQC эки кубитте гана классикалык көзөмөлдөн +1,3 пайыздык пункт жакшы болгон; бирок бул айырма беш foldдун үчөөндө гана ошол эле багытта болуп, эки модель тең bottleneck-only headдин %84,2 тактыгынан төмөн калган. Булак муну туруктуу кванттык артыкчылык деп чечмелебейт.
Схема тереңдиги
Алты кубитте вариациялык катмарлардын саны 1, 2, 4 жана 6 болуп өзгөртүлгөн. Тактык бир катмарда %83,0дан төрт катмарда %85,0га көтөрүлүп, алты катмарда %84,8 болгон. Бул жакшырууга карабай классикалык көзөмөл %86,7 менен жогору бойдон калган.
Чырмалышуу алынып салынганда эмне болду?
Негизги алты-кубит, эки-катмар схемада CNOT шакегин толук алып салуу тактыкты %83,5тен %86,4кө жогорулаткан; стандарттуу VQCге салыштырмалуу +2,9 пайыздык пункт айырма бар. Чырмалышуусуз версия классикалык көзөмөлдөн болгону −0,3 пайыздык пункт айырмаланат.
Бул натыйжа “кванттык чырмалышуу зыяндуу” деген жалпы физикалык жыйынтык эмес. Ал болгону ушул схема түзүлүшү, ушул маалымат көрсөтүлүшү жана ушул классификация тапшырмасы үчүн CNOT шакеги өлчөнгөн тактыкка пайда бербегенин көрсөтөт.
Data re-uploading
Ар вариациялык катмардан мурда \(R_Y(x_i)\) encodingди кайра колдонуу, башкача айтканда data re-uploading, негизги VQCнин %83,5 тактыгын %78,2ге түшүргөн. Айырма −5,3 пайыздык пункт болуп, беш foldдун баарында жыйынтык начарыраак болгон.
Маалымат аз болгондо кванттык модель артыкчылык бердиби?
Жок. Тескерисинче VQCнин эң начар салыштырмалуу натыйжалуулугу окутуу маалыматы эң аз шарттарда байкалган.
Окутуу foldунун номиналдык %1и колдонулганда топтук үлгүлөө себептүү орточо болжол менен 115 окутуу сүрөтү калган. Бул шартта:
| Модель | Тактык |
|---|---|
| VQC | %38,6 |
| Классикалык көзөмөл | %62,3 |
| Linear probe | %65,5 |
| MLP | %62,3 |
Ошондуктан “маалымат аз болгондо кичине кванттык схемалар автоматтык артыкчылык берет” деген божомол бул benchmark тарабынан колдоого алынган эмес.
Ызы-чуу VQCнин классикалык моделден артта калышын түшүндүрөбү?
Жок. Негизги тактык ажырымы ызы-чуусуз симуляцияда эле бар.
Алты-кубит, эки-катмар VQC ызы-чуусуз абалда %83,5 тактык берсе, кубит жана катмар башына \(p=0,03\) деполяризация ыктымалдыгында %83,3кө түшкөн. \(p=0,1\)де тактык %70,2ге түшкөн.
Тереңирээк схемалар жогорку ызы-чууга сезгич: \(p=0,1\)де төрт катмарлуу схема %31,3, алты катмарлуу схема %24,0 тактыкка түшкөн; төрт класстуу кокустук деңгээл %25.
Finite-shot симуляциясында 16 shot гана колдонулганда негизги алты-кубит модель 1,5 пайыздык пункт жоготкон. 1024 shot менен, өзүнчө же \(p=0,01\) деполяризация менен бирге, натыйжа ызы-чуусуз схеманын 0,1 пайыздык пунктунун ичинде калган.
Quantum kernel жана RBF kernel салыштыруусу
| PCA компоненти / кубит | Quantum kernel | RBF kernel | Quantum − классикалык |
|---|---|---|---|
| 4 | %72,8 | %73,3 | −0,5 pp |
| 6 | %77,7 | %78,1 | −0,4 pp |
| 8 | %79,7 | %80,8 | −1,1 pp |
| 10 | %80,9 | %81,5 | −0,6 pp |
Эки kernel модели тең толук 1280-өлчөмдүү EfficientNet-B0 белгилеринде иштеген %88,0 тактыктагы linear probeдон төмөн калган. Авторлор бул натыйжаны кичине кванттык схемага маалымат жүктөө үчүн талап кылынган өлчөмдү азайтуу маанилүү натыйжалуулук bottleneckи экенине ишара кылган табылга катары чечмелешет.
Kernel concentration деген эмне эле?
Quantum fidelity kernelде туруктуу bandwidth 0,1 же андан жогору болгондо qubit саны өскөн сайын off-diagonal kernel entry вариациясы кескин азайган. Мисалы, bandwidth 0,1де вариация төрт кубитте \(5.6\times10^{-2}\) болсо, он кубитте \(2.6\times10^{-3}\)кө түшкөн.
Bandwidth 1де ошол эле чоңдук \(7.4\times10^{-3}\)төн \(4.5\times10^{-5}\)ке түшкөн. Бул жүрүм-турум fidelity kernelдерде белгилүү kernel concentration менен шайкеш.
Validation 20 fold–width комбинациясынын 15инде эң кичине bandwidth 0,03тү тандаган. Бирок төрт кубитте ушул bandwidth менен off-diagonal kernel орточосу 0,92 болгондуктан kernel башка чектеги көйгөйгө, башкача айтканда көп үлгү жуптары бири-бирине өтө окшош көрүнүүгө жакындаган.
End-to-end fine-tuning
Fine-tuning тажрыйбаларында ImageNet-pretrained EfficientNet-B0, ResNet-50, DenseNet-121, MobileNetV2, ConvNeXt-Tiny жана ViT-Small/16 backboneдор бааланган. VQC менен дал келтирилген классикалык көзөмөлдүн түз салыштыруусу EfficientNet-B0 үстүндө жүргүзүлгөн.
Block A: биринчи окутуу рецепти
AdamW optimizer, weight decay 0,05, %10 warm-up кошулган one-cycle learning-rate schedule, head үчүн \(10^{-3}\), backbone үчүн \(3\times10^{-4}\) peak learning rate, batch size 32 жана label smoothing 0,05 колдонулган. Окутуу эң көп 30 epoch созулуп, validation loss алты epoch жакшырбаса токтотулган.
Augmentation random resized crop (scale 0,8–1,0; aspect ratio 0,9–1,1), horizontal flip, ±10° айлантуу жана 0,15 brightness/contrast jitter камтыган.
Block B: жакындашууга негизделген окутуу
Эки epoch сызыктуу warm-up колдонулуп, validation loss үч epoch жакшырбаса learning rate эки эсе азайтылган, он epoch жакшыруу болбосо early stopping колдонулуп, максимум 80 epoch белгиленген.
Head learning rate:
\[ \{3\times10^{-4},10^{-3},3\times10^{-3}\} \]
арасынан биринчи foldдун validation топтомунда тандалган; backbone learning rate head ылдамдыгынын 0,3 эсеси болуп коюлган. Тандалган learning rate беш fold жана эки seed бою колдонулган.
Block C: стандартташтырылган сүрөттөр
Фон, чек аралар, overlayлер, матрица өлчөмү жана глобалдык интенсивдүүлүк масштабы сыяктуу булак shortcutтарын азайтуу үчүн head mask түзүлүп, сүрөт маска аймагына кесилип, квадратка pad кылынып, маска ичиндеги 1.–99. процентиль аралыгына жараша intensity rescale жасалып, 256 × 256 пикселге кайра өлчөмдөлгөн.
Булак ишенимдүү 2B skull stripping жок болгондуктан баш сөөгү сүрөттө калганын ачык белгилейт. Демек стандартташтыруу бардык булак/shortcut маалыматын жок кылган эмес.
End-to-end негизги натыйжалуулук жыйынтыктары
| Режим | VQC | Классикалык көзөмөл | Linear head |
|---|---|---|---|
| Block A | %94,1 | %94,2 | %94,5 |
| Block B | %93,8 | %94,5 | %94,5 |
| Block C, standardized | %93,6 | %94,7 | %94,3 |
Block Aда VQC менен классикалык көзөмөлдүн ортосундагы %95 ишеним аралыгы −1,08ден +1,00 ppге чейин. %90 ишеним аралыгы −0,93төн +0,82 ppге чейин толугу менен ±1 pp эквиваленттүүлүк аймагында калгандыктан булак бул эки моделди ±1 пайыздык пункт деңгээлинде эквиваленттүү деп эсептеген.
Block Bде VQC − классикалык көзөмөл айырмасы −0,69 pp. %90 ишеним аралыгы −1,16дан −0,22ге чейин болуп, −1 pp чегинен өткөндүктөн ±1 pp эквиваленттүүлүгү жарыяланган эмес. Эквиваленттүүлүк жарыялоого боло турган эң кичине margin 1,16 pp.
Бул айырма маанилүү: статистикалык маанилүү айырма табылбаганы менен моделдердин эквиваленттүү экени көрсөтүлүшү бир эле нерсе эмес. Ошондуктан изилдөө p маанисине гана эмес, алдын ала белгиленген ±1 pp equivalence margin жана %90 ишеним аралыгына да караган.
Fine-tuning чыгымы
| Модель | Орточо токтоо epochу | Training убактысы / run | Бир сүрөт latency | Peak GPU memory |
|---|---|---|---|---|
| VQC | 38,8 | 12,8 мүн | 18,8 ms | 1461 MB |
| Классикалык көзөмөл | 26,0 | 6,8 мүн | 11,3 ms | 1461 MB |
| Deeper control | 29,1 | 7,7 мүн | 11,2 ms | 1461 MB |
| Fourier surrogate | 22,3 | 6,0 мүн | 11,7 ms | 1461 MB |
| Linear head | 23,2 | 6,0 мүн | 10,7 ms | 1461 MB |
Бул убакыттар чыныгы кванттык жабдык чыгымдары эмес. Кванттык схема классикалык GPUда симуляциялангандыктан, алар изилдөөнүн implementation чыгымын гана көрсөтөт.
Нөлдөн окутулган HQCNN
Булак мурдагы гибрид изилдөөлөрдүн көбүнө жакыныраак сценарийди текшерүү үчүн pretrained backbone колдонбостон, нөлдөн гибрид кванттык–классикалык CNN да окуткан.
Encoder үч блоктон турат:
- 3 × 3 convolution, 64 канал + batch normalization + ReLU + 2 × 2 max pooling;
- 3 × 3 convolution, 128 канал + batch normalization + ReLU + 2 × 2 max pooling;
- 3 × 3 convolution, 256 канал + batch normalization + ReLU + 2 × 2 max pooling.
Андан кийин global average pooling, 256 → 6 сызыктуу бурч проекциясы, алты-кубит эки-катмар VQC, 64 жана 32 бирдиктүү классикалык dense катмарлар жана төрт класстуу чыгыш бар.
HQCNNдин жалпы 375.950 үйрөнүлүүчү параметринин болгону 36сы кванттык схемада. Дал келтирилген классикалык көзөмөл VQC ордуна Linear(6,6)+tanh колдонот жана жалпы 375.956 параметр камтыйт.
Натыйжа:
HQCNN: %67,9 тактык (%95 GA 63,5–72,1).
Классикалык көзөмөл: %76,2 тактык (%95 GA 72,7–79,6).
Айырма −8,33 пайыздык пункт (%95 GA −12,72ден −4,06га чейин; McNemar \(p=1.6\times10^{-41}\)).
Маалымат агып кетиши тактыкты канча көтөрдү?
Изилдөөчүлөр ошол эле моделдерди жана сүрөттөрдү fold топтоо эрежелерин гана өзгөртүп Protocol 2 жана Protocol 3 шартында окутушкан. Бул ыкма агып кетүүнүн таасирин түзүрөөк бөлүп көрсөтүүнү максат кылган.
| Модель тобу / сүрөт байланышы | Protocol 2 → Protocol 3 тактык өзгөрүшү |
|---|---|
| Frozen-feature headдер, жалпы | −3,3төн −7,8 ppге чейин |
| Frozen, Protocol 2 training foldунда көчүрмөсү бар сүрөттөр | −3,9дан −9,6 ppге чейин |
| Frozen, ошол эле бейтап байланышы гана бар сүрөттөр | −2,3төн −6,9 ppге чейин |
| Frozen, байланышсыз 750 сүрөт | −5,5тен +3,5 ppге чейин; орточо −0,4 pp |
| Fine-tuned моделдер, жалпы | −3,3төн −3,6 ppге чейин |
| Fine-tuned, көчүрмөсү бар сүрөттөр | −3,7ден −4,0 ppге чейин |
| Fine-tuned, ошол эле бейтап байланышы гана | −3,5тен −4,6 ppге чейин |
Агып кетүүнүн таасири негизинен training fold менен көчүрмө же бейтап байланышы бар сүрөттөрдө топтолгону байкалган тактык төмөндөшү жөн гана кокустук fold өзгөрүшүнөн келип чыкпаганын колдойт.
Lesion occlusion тажрыйбасы
Figshare булагындагы тест шишиктеринде кол менен түзүлгөн шишик маскасы 8 пиксел кеңейтилген жана бул аймак баштын калган бөлүгүндөгү median intensity менен толтурулган. Модель мурда кадимки, occlusion жасалбаган сүрөттөрдө окутулган.
Шишик аймагынын көрүнүшү алынып салынганда:
- классикалык көзөмөл %85,6дан %83,0га,
- linear probe %87,3төн %84,7ге,
- VQC %80,6дан %78,9га
түшкөн.
Башкача айтканда, шишиктин сүрөт интенсивдүүлүгү алынып салынса да тактык болгону бир нече пайыздык пункт төмөндөгөн. Бул моделдер шишик тканынын визуалдык көрүнүшүнөн тышкары анатомия, булак жана лезия геометриясы сыяктуу маалыматтарды олуттуу колдонуп жатканын көрсөтөт.
Бирок occluded аймак толугу менен маалыматсыз эмес: шишик маскасынын орду, өлчөмү жана формасы сакталат. Чынында 16 × 16 өлчөмгө гана кичирейтилген шишик маскасы менен окутулган logistic regression да шишик классын %61,4 тактык менен божомолдогон. Ошондуктан occlusion натыйжасы “модель шишикти такыр колдонбойт” дегенди билдирбейт.
Булактар аралык жалпылоо
Figshare булагындагы үч шишик классы менен гана бейтап-топтолгон окутуу жүргүзүлгөндө VQC %80,8, классикалык көзөмөл %86,4 жана linear probe %87,5 тактык берген.
Figshare шишиктеринде окутулуп, байланышсыз SARTAJ шишиктеринде тесттелгенде бардык headдер болжол менен кокустук деңгээлге жакындаган:
\[ 36.1\%-38.8\% \]
төрт backbone орточосунун аралыгында; үч класстуу кокустук деңгээл %33,3.
Ошондуктан булак кванттык жана классикалык headдердин экөө тең acquisition-source өзгөрүшүнө каршы начар transfer көрсөткөнүн белгилейт.
Grad-CAM эмнени көрсөттү?
Gradient-weighted Class Activation Mapping (Grad-CAM) CNN божомолун колдогон мейкиндик аймактарынын gradient-негизиндеги маанилүүлүк картасын чыгарат. Булак муну “модель эмне үчүн чечим чыгарды?” деген суроонун так жообу катары эмес, божомолго байланышкан активдешүү кайда топтолгонун көрсөткөн түшүндүрмө куралы катары колдонгон.
Биринчи folddогу 1400 тест сүрөтүндө Grad-CAM энергиясынын median түрдө баш маскасынын ичинде калган үлүшү:
| Модель | Median үлүш |
|---|---|
| ResNet-50 linear | %95 |
| EfficientNet-B0 linear | %80 |
| EfficientNet-B0 классикалык көзөмөл | %89 |
| EfficientNet-B0 VQC | %85 |
| HQCNN | %52 |
VQCде non-zero Grad-CAM картасы бар сүрөттөрдүн %28инде энергиянын жарымынан азы баш маскасынын ичинде калган; классикалык көзөмөлдө бул көрсөткүч %10, linear headде %0,2. Бирок Grad-CAM себептик түшүндүрмө бербегендиктен, бул айырма өзү эле модель “эмнени үйрөнгөнүн” так аныктабайт.
Статистикалык анализ кантип жүргүзүлдү?
Изилдөө бир гана тактык пайызын баяндоонун ордуна көп катмарлуу статистиканы колдонгон.
Frozen-feature салыштырууларында төрт backbone × беш fold = 20 backbone–fold блогу бар. Seedдер блок ичинде орточолонгон. Headдердин ортосундагы жупталган айырмалар Wilcoxon signed-rank тести менен бааланып, орточо айырмалар үчүн bootstrap %95 ишеним аралыктары эсептелип, бардык headдер Friedman тести менен салыштырылган.
Fold жана backboneдор толугу менен көз карандысыз болбогондуктан кошумча:
- backbone жана backbone ичиндеги fold үчүн random intercept камтыган linear mixed model,
- repeated cross-validation үчүн variance-corrected resampled t-test,
- бейтап жана duplicate топторун кайра үлгүлөгөн image-level cluster bootstrap
колдонулган.
End-to-end моделдерде болгону беш fold болгондуктан fold-level Wilcoxon тестинин чечилиш жөндөмү өтө төмөн; беш жупта жетүүгө боло турган эң кичине эки тараптуу p мааниси 0,0625. Ошондуктан моделдердин out-of-fold божомолдору сүрөт деңгээлинде бириктирилип, exact McNemar тести колдонулган.
Бейтап жана duplicate сүрөттөрдү көз карандысыз деп эсептөөгө болбогондуктан тактык жана paired-difference %95 ишеним аралыктары бейтап/duplicate топторун кайра үлгүлөгөн cluster bootstrap менен эсептелген. Негизги баалоолордо 5000 bootstrap үлгүсү, айрым класс-спецификалык жана агып кетүү ички топтомдорунда 2000 үлгү колдонулган.
±1 пайыздык пункт эквиваленттүүлүк тести эмнени билдирет?
Эки моделдин ортосунда “маанилүү айырма тапкан жокпуз” деп айтуу алардын практикалык жактан эквиваленттүү экенин далилдебейт. Булак ошондуктан эки моделдин айырмасынын %90 ишеним аралыгы толугу менен:
\[ [-1,+1]\ \text{yüzde puanı} \]
аралыгында калышын эквиваленттүүлүк критерийи катары колдонгон. Бул \(\alpha=0,05\) деңгээлиндеги эки бир тараптуу эквиваленттүүлүк тестине туура келет.
±1 pp чеги физикалык табияттын туруктуусу эмес; изилдөөчүлөр алдын ала тандаган практикалык margin. Булак margin тандоо конвенция экенин ачык кабыл алып, ар салыштыруу үчүн эквиваленттүүлүк жарыялоого боло турган эң кичине marginди да өзүнчө баяндаган.
Изилдөө колдогон жыйынтыктар
- Kaggle Brain Tumor MRI Dataset 2-версиясынын расмий окутуу/тест бөлүмдөрү олуттуу сүрөт жана бейтап кайталанышын камтыйт.
- Расмий тест сүрөттөрүнүн %79у окутуу бөлүмүндөгү сүрөт менен duplicate тобун бөлүшөт.
- Figshare булагындагы тест сүрөттөрүнүн 915/917си окутууда ошол эле бейтап менен кайталанат.
- Бейтап-топтолгон баалоо frozen-feature тактыгын болжол менен 3,3–7,8 pp жана fine-tuned тактыгын болжол менен 3,3–3,6 pp азайткан.
- Алты-кубит VQC frozen белгилеринде ошол эле кеңдиктеги классикалык көзөмөлдөн болжол менен 6,0 pp төмөн тактык берген.
- Fine-tuning VQCнин классикалык көзөмөл менен айырмасын болжол менен 1 pp же андан төмөн кылган, бирок жакындашууга негизделген окутууда VQC артыкчылык көрсөткөн эмес.
- Нөлдөн окутулган HQCNN классикалык көзөмөлдөн 8,33 pp төмөн тактык берген.
- Текшерилген абляцияда чырмалышуу дарбазаларын алып салуу тактыкты төмөндөтпөстөн, жогорулаткан.
- Текшерилген quantum kernel бардык PCA өлчөмдөрүндө RBF kernelден бир аз төмөн тактык берген.
- Аз окутуу маалыматы шартында VQC классикалык көзөмөлдөрдөн начарыраак иштеген.
- Moderate depolarizing noise негизги кванттык–классикалык айырманы түшүндүрбөйт; айырма ызы-чуусуз симуляцияда да бар.
- Сүрөт булагына байланышкан shortcutтар күчтүү жана башка булакка жалпылоо бардык моделдер үчүн начар.
Изилдөө колдобогон жыйынтыктар
- “Кванттык машиналык үйрөнүү эч бир медициналык сүрөттөө тапшырмасында иштебейт” деген жыйынтык чыгарууга болбойт.
- Чыныгы кванттык жабдык бул тапшырмада жайыраак же тезирээк экенин бул симуляция убакыттарынан чыгарууга болбойт.
- 10 кубиттен чоң схемалар же башка encoding/ansatz архитектураларынын натыйжалуулугу бул изилдөөдө текшерилген эмес.
- Quantum convolutional networks боюнча жалпы ийгиликсиздик жыйынтыгын чыгарууга болбойт.
- Бул изилдөө клиникалык мээ шишиги диагноз аппаратынын валидациясы эмес.
- %94 тегерегиндеги fine-tuned тактыктар чыныгы оорукана диагностикалык тактыгынын баасы эмес.
- Slice-level классификация examination-level же patient-level клиникалык диагноз менен бирдей эмес.
- Out-of-source glioma каталарынын баары модель катасы деп айтууга болбойт; айрым энбелгилер да көйгөйлүү болушу мүмкүн жана радиолог кароосу жүргүзүлгөн эмес.
- Grad-CAM карталары модель чечиминин себептик түшүндүрмөсү эмес.
- Lesion occlusion тажрыйбасы модель шишик маалыматын такыр колдонбой турганын көрсөтпөйт; лезиянын орду, өлчөмү жана формасы сакталган.
- Barren plateau түз өлчөнүп далилденген эмес.
Изилдөөнүн күчтүү жактары
Биринчи күчтүү жагы — кванттык моделди байланышы жок CNN менен эмес, ошол эле кеңдиктеги жана ошол эле протоколдогу классикалык көзөмөл менен салыштырганы. Ошентип жалпы тармак натыйжалуулугунун ордуна кванттык аралык катмардын маргиналдык салымын текшерүүгө мүмкүн болгон.
Экинчи күчтүү жагы — параметрлердин санын дал келтирүү менен чектелбей, тереңирээк классикалык көзөмөл жана схеманын функциялар классын камтыган Fourier surrogate колдонгону.
Үчүнчү күчтүү жагы — маалымат топтомундагы көчүрмөлөрдү exact checksum менен гана издебестен, күзгүлөө жана айлантууга туруктуу pHash + NCC ыкмасы менен сканерлеп, мүмкүн болгон сүрөттөр үчүн түпнуска figshare бейтап идентификаторлорун калыбына келтиргени.
Төртүнчү күчтүү жагы — кванттык схеманы frozen features, end-to-end fine-tuning жана training from scratch болуп үч башка режимде текшергени.
Бешинчи күчтүү жагы — qubit саны, circuit depth, entanglement, data re-uploading, training-data fraction, depolarizing noise жана shot count абляцияларын бирге караганы.
Алтынчы күчтүү жагы — жалпы тактыкка гана эмес, acquisition source, shortcut, lesion occlusion, cross-source transfer жана Grad-CAM анализдери аркылуу модель чындап эмнени колдонуп жатышы мүмкүн экенин текшергени.
Чектөөлөр
Бир маалымат топтому: Изилдөө бир гана ачык, эки өлчөмдүү MRI benchmarkына негизделет. Натыйжаларды башка ооруларга, башка сүрөттөө тапшырмаларына же 3B MRI көлөмдөрүнө автоматтык өткөрүүгө болбойт.
Толук эмес бейтап идентификаторлору: Бейтап идентификатору болгону 4846 figshare булагындагы шишик сүрөтү үчүн калыбына келтирилген. Башка шишик жана шишиксиз сүрөттөрдө топтоо duplicate detectionга көз каранды; аныкталбаган ошол эле-текшерүү кесиндилеринин ар башка foldдордо болушун толук четке кагууга болбойт.
Чыныгы кванттык жабдык жок: Бардык схемалар симуляцияланган. Колдонулган noise model crosstalk, readout error, limited connectivity жана чыныгы gate decomposition чыгымдарын камтыбайт.
Чектелген схема үй-бүлөсү: Dressed VQCлер эң көп он кубит жана бир негизги encoding ыкмасы менен каралган. Башка encodingдер, чоңураак схемалар жана кванттык маалыматта иштеген башка архитектуралар башкача жүрүшү мүмкүн.
Hyperparameter издөө чектелген: End-to-end негизги салыштырууда эки seed/fold жана биринчи foldдо үч learning-rate талапкеринин арасынан тандоо колдонулган. Кеңири издөө кичине айырмаларды өзгөртүшү мүмкүн.
Стандартташтыруу бардык shortcutтарды алып салбайт: Head masking баш сөөгүн алып салган эмес. Coarse anatomy жана imaging plane маалыматы калган.
Grad-CAM чектөөсү: Grad-CAM модель кайда карап жатканы тууралуу болжолдуу мейкиндик белги берет; чечим механизмин түшүндүрбөйт.
Энбелгини текшерүү: Candidate label errors жана 76 out-of-source glioma сүрөтү көз карандысыз радиолог тарабынан кайра энбелгиленген эмес.
Клиникалык алкак
Булак баяндалган тактыктар клиникалык диагностикалык тактык эмес экенин ачык баса белгилейт. Клиникалык доомат үчүн жок дегенде slice-level ордуна examination-level кириштер, бардык класстар үчүн бейтапты ажыратуу, гистопатология же эксперттик консенсус сыяктуу референс стандарт, шишиксиз топтун шишик тобу менен ошол эле клиникалык популяциядан келиши жана көз карандысыз көп-борборлуу текшерүү керек.
Ошондуктан бул изилдөөнүн темасы “MRIда мээ шишигин %94 тактык менен диагноздогон кванттык система” эмес. Изилдөөнүн чыныгы темасы, кванттык аралык катмар дал келтирилген классикалык көзөмөлгө салыштырмалуу кошумча классификациялык баа береби жана маалымат агып кетиши мындай benchmarkтарды кантип жаңылдыра алат деген суроо.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: Does the Quantum Layer Help? A Leakage-Aware Benchmark of Hybrid Quantum–Classical Models for Brain Tumor MRI Classification
Авторлор: Tuan-Linh Duong; Pande Wikantyasa Maswita; Tony Sumaryada; Sitti Yani; Thanh-Tai Duong; Hiba Omer; Nissren Tamam; Abdelmoneim Sulieman.
Авторлордун тартиби: Булак PDF жана расмий жарыя жазуусу менен шайкеш.
Тең салым: Булакта тең биринчи авторлук/тең салым белгиси билдирилген эмес.
Жооптуу автор: Thanh-Tai Duong.
Мекеме 1: The Laboratory Center, Hanoi University of Public Health, Hanoi 100000, Vietnam.
Мекеме 2: Department of Physics, Faculty of Mathematics and Natural Sciences, IPB University, Bogor 16680, Indonesia.
Мекеме 3: Department of Medical Physics, Faculty of Medicine, Nguyen Tat Thanh University, Ho Chi Minh City 700000, Vietnam.
Мекеме 4: Department of Radiological Sciences, College of Applied Medical Sciences, Imam Abdulrahman Bin Faisal University, Dammam 34212, Saudi Arabia.
Мекеме 5: Department of Physics, College of Sciences, Princess Nourah bint Abdulrahman University, Riyadh 11671, Saudi Arabia.
Мекеме 6: Department of Radiological Sciences, College of Applied Medical Sciences, King Saud bin Abdulaziz University for Health Sciences, Al Ahsa 31982, Saudi Arabia.
Мекеме 7: Imaging Physics Section, Research and Innovation Department, King Faisal Specialist Hospital & Research Center, Riyadh 11211, Saudi Arabia.
Булак түрү: Рецензияланган түпнуска изилдөө макаласы.
Журнал: Diagnostics.
Басмакана: MDPI.
Том / сан / макала номери: 16 / 21 / 3485.
DOI: 10.3390/diagnostics16213485.
Алынган күнү: 7 октябрь 2026.
Ревизия: 17 октябрь 2026.
Кабыл алуу: 21 октябрь 2026.
Жарыялоо: 24 октябрь 2026.
Рецензиялоо абалы: Рецензияланган журнал макаласы.
Лицензия: Creative Commons Attribution (CC BY).
Расмий жарыя: Diagnostics 2026, 16, 3485; DOI 10.3390/diagnostics16213485.
Негизги илимий тармак: Quantum machine learning, medical image classification, deep learning benchmarking жана data-leakage auditing.
Негизги тапшырма: Glioma, meningioma, гипофиз шишиги жана шишиксиз MRI кесиндилерин төрт класска классификациялоо.
Негизги кванттык модель: Angle encoding колдонгон, алты-кубит жана эки вариациялык катмарлуу hardware-efficient dressed VQC; абляцияларда 2–10 кубит жана 1–6 катмар бааланган.
Чыныгы кванттык жабдык: Колдонулган эмес. Бардык кванттык схемалар классикалык жабдыкта симуляцияланган.
Негизги баалоо протоколу: Patient-grouped five-fold cross-validation (Protocol 3).
Негизги жыйынтык: Текшерилген VQC катмары сыналган үч негизги окутуу режиминде дал келтирилген классикалык катмардын тактыгын жогорулаткан эмес.
Маалымат топтомунун негизги көйгөйү: Расмий тест сүрөттөрүнүн %79у окутуу бөлүмүндөгү көчүрмө менен байланышкан жана figshare булагындагы тест сүрөттөрүнүн 915/917си окутууда ошол эле бейтап менен кайталанат.
Статистика: Frozen-feature салыштырууларында Wilcoxon signed-rank, Friedman тести, bootstrap %95 GA, linear mixed model жана variance-corrected resampled t-test; end-to-end салыштырууларында exact McNemar, patient/duplicate-group cluster bootstrap жана ±1 pp equivalence margin колдонулган.
Implementation: Python, PyTorch 2.14.0, timm 1.0.30, scikit-learn 1.8.0; PennyLane 0.45.1 симуляторду текшерүү үчүн гана колдонулган. End-to-end окутуу NVIDIA GeForce RTX 3090 24 GB GPUда жүргүзүлгөн.
Generative AI колдонуу билдирүүсү: Булак Claudeдун Opus модель үй-бүлөсү анализ кодун жазуу жана debug кылуу, ошондой эле статистикалык анализдерди жүргүзүүдө авторлордун жетекчилиги астында колдонулганын; анализдер авторлор тарабынан аныкталып, код жана жыйынтыктар текшерилип, код жарыяланганын билдирет.
Маалыматтардын жеткиликтүүлүгү: Brain Tumor MRI Dataset 2-версиясы Kaggleда ачык; маалымат топтомунун DOIси 10.34740/KAGGLE/DSV/2645886. Макала маалымат топтому 28 сентябрь 2026да жүктөлгөнүн билдирет. Dataset audit коду, quantum circuit simulator, self-testтер, тажрыйбалар, статистикалык анализдер, leakage-aware splitтер, duplicate/patient annotations, checksum manifest, модель божомолдору жана жыйынтык таблицалары авторлор көрсөткөн GitHub репозиторийинде жарыяланган. Маалымат топтомунун сүрөттөрү өздөрү кайра таратылбайт.
Этика кеңеши: Ачык жана толук де-идентификацияланган маалымат гана колдонулгандыктан этикалык кароо жана бекитүүдөн баш тартылган.
Бейтап макулдугу: Ачык, де-идентификацияланган сүрөттөр гана колдонулгандыктан макулдуктан баш тартылган.
Каржылоо: Princess Nourah bint Abdulrahman University Researchers Supporting Project, PNURSP2026R12. Макала иштетүү акысы да Princess Nourah bint Abdulrahman University тарабынан каржыланган.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышын билдирген эмес. Каржылоочулардын изилдөө дизайны, маалымат чогултуу/анализ/чечмелөө, жазуу же жарыялоо чечиминде ролу болбогону айтылган.
Авторлордун салымдары: Conceptualization: P.W.M., T.-L.D., S.Y., T.-T.D.; methodology: P.W.M., T.-L.D.; software: P.W.M., T.-L.D.; formal analysis: T.-L.D.; investigation: P.W.M., T.-L.D., T.S.; data curation: T.-L.D.; visualization: T.-L.D.; original draft: P.W.M., T.-L.D.; review and editing: бардык авторлор; supervision: S.Y., T.S., T.-T.D.; project administration: S.Y.; funding acquisition: S.Y., N.T.
Негизги чечмелөө чеги: Жыйынтыктар бул маалымат топтомунда жана текшерилген кичине симуляцияланган VQC үй-бүлөсүндө кванттык катмар кошумча тактык бербегенин көрсөтөт. Изилдөө бардык quantum machine learning моделдерин, чыныгы кванттык жабдыкты же клиникалык MRI диагнозун жалпы түрдө жараксыз деп чыгарбайт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген