


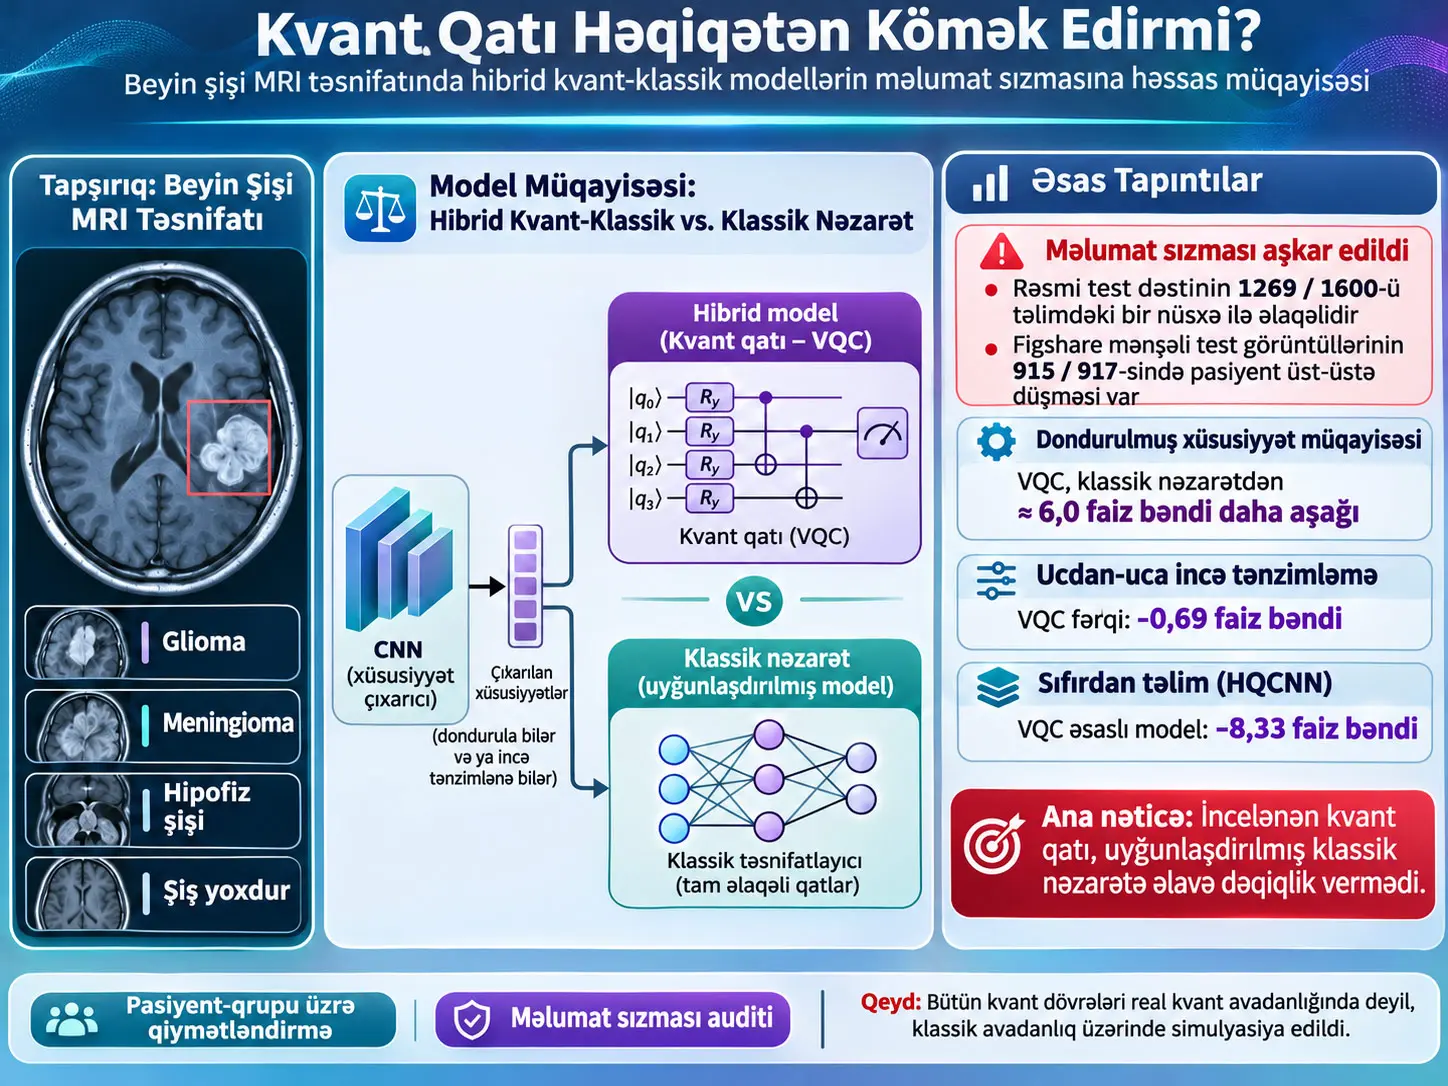
Variasiyalı kvant dövrəsi (variational quantum circuit, VQC), klassik görüntü xüsusiyyətlərini kvant fırlanma bucaqlarına kodlayan, öyrənilə bilən kvant qapıları ilə bu kodlanmış vəziyyəti emal edən və ölçülmüş Pauli-Z gözlənilən qiymətlərini yenidən klassik təsnifat qatına ötürən parametrli kvant dövrəsidir. Bu tədqiqat beyin şişinin maqnit-rezonans görüntülərinin (magnetic resonance imaging, MRI) təsnifatında istifadə olunan belə bir VQC qatının həqiqətən təsnifat dəqiqliyinə töhfə verib-vermədiyini eyni enə və eyni təlim şərtlərinə malik klassik nəzarət qatları ilə müqayisə edərək sınaqdan keçirmişdir. Eyni zamanda istifadə olunan açıq MRI məlumat dəstində təlim–test məlumat sızması, xəstə üst-üstə düşməsi və görüntü mənbəyindən asılı qısa yol ipucları ətraflı şəkildə yoxlanılmışdır.
Tədqiqatda Kaggle Brain Tumor MRI Dataset-in 13 fevral 2026-cı ildə yayımlanmış 2-ci versiyasından istifadə edilmişdir. Məlumat dəsti ümumilikdə 7200 ikiölçülü JPEG MRI kəsiyi ehtiva edir: glioma, meningioma, hipofiz şişi və şişsiz olmaqla dörd sinfin hər birində 1800 görüntü vardır. Rəsmi bölünmə 5600 təlim və 1600 test görüntüsündən ibarətdir. Mənbə kolleksiyaları ilə uyğunlaşdırma nəticəsində 4846 şiş görüntüsü üçün xəstə identifikatoru bərpa edilə bilmişdir.
Məlumat auditi, məlumat dəstinin rəsmi təsvirindəki “təlim–test üst-üstə düşməsi aradan qaldırılıb” gözləntisinə baxmayaraq ciddi sızma olduğunu göstərmişdir. Güzgüləmə və fırlatmaya davamlı auditlə 1600 rəsmi test görüntüsünün 1269-unun, yəni təxminən %79-unun təlim bölməsindəki bir görüntü ilə eyni duplicate qrupuna bağlı olduğu müəyyən edilmişdir. Figshare mənşəli 917 test görüntüsünün 915-i təlim bölməsində eyni xəstədən ən azı bir başqa görüntü ilə ortaq olmuşdur. Yalnız 87 rəsmi test görüntüsü həm aşkar edilmiş surətlərdən, həm də məlum xəstə üst-üstə düşməsindən müstəqil olan “strict-clean” alt dəstini yaratmışdır.
Tədqiqatçıların əsas müqayisəsi altı kubitli, iki variasiyalı qatlı VQC başlığı ilə eyni giriş/çıxış eninə malik Linear(6,6) + tanh klassik nəzarət arasındadır. Dondurulmuş ImageNet xüsusiyyətləri üzərində xəstə-qruplu beşqat çarpaz doğrulamada VQC uyğunlaşdırılmış klassik nəzarətdən orta hesabla 6,03 faiz bəndi daha aşağı dəqiqlik göstərmişdir; %95 etibar intervalı −6,78 ilə −5,20 faiz bəndi arasındadır. VQC həmçinin daha dərin klassik nəzarətdən və kvant dövrəsinin hesablaya bildiyi funksiya sinfini əhatə edən klassik Fourier surrogate modelindən də daha aşağı dəqiqlik vermişdir.
Ucdan-uca incə tənzimləmədə fərq azalmışdır. İlk təlim resepti istifadə edildikdə EfficientNet-B0 + VQC %94,1, klassik nəzarət %94,2 dəqiqlik təmin etmiş və aralarındakı −0,07 faiz bəndi fərqi ±1 faiz bəndlik ekvivalentlik sərhədi daxilində qalmışdır. Lakin yaxınlaşmaya əsaslanan daha uzun təlimdə VQC %93,8, klassik nəzarət %94,5 dəqiqlik vermiş; VQC fərqi −0,69 faiz bəndi (%95 GA −1,25 ilə −0,13) olmuş və ±1 faiz bəndi sərhədi daxilində ekvivalentlik elan edilə bilməmişdir. Sıfırdan öyrədilən hibrid kvant–klassik CNN isə %67,9 dəqiqliklə %76,2-lik klassik nəzarətdən 8,33 faiz bəndi geri qalmışdır.
Tədqiqat bu nəticələri “kvant maşın öyrənməsi heç vaxt işləmir” şəklində ümumiləşdirmir. Nəticə yalnız araşdırılan dressed VQC arxitekturası, istifadə olunan klassik MRI məlumatı, 2–10 kubit aralığı, araşdırılan encoding və nəzarət modelləri üçün keçərlidir. Bundan əlavə, bütün kvant dövrələri klassik kompüterdə simulyasiya edilmişdir; real kvant prosessorunda təlim və ya çıxarım aparılmamışdır. Hesabat verilən dəqiqliklər klinik diaqnostik dəqiqlik kimi şərh edilə bilməz.
Tədqiqatın əsas sualı nədir?
Hibrid kvant–klassik görüntü təsnifatı tədqiqatlarında yüksək ümumi dəqiqlik görmək kvant qatının həqiqətən faydalı olduğunu təkbaşına göstərmir. Çünki hibrid şəbəkənin böyük hissəsi hələ də klassik ola bilər: görüntü xüsusiyyətlərini çıxaran CNN, kvant dövrəsinə giriş yaradan xətti proyeksiya və kvant ölçmələrini siniflərə çevirən çıxış qatı klassik komponentlərdir.
Bu səbəbdən tədqiqatın mərkəzi sualı yalnız “hibrid model neçə faiz dəqiqlik verdi?” deyil. Daha güclü sual budur: Eyni klassik backbone, eyni məlumat, eyni təlim protokolu və eyni darboğaz eni saxlanılıb yalnız kvant dövrəsi eyni enli klassik qatla əvəz edildikdə performans həqiqətən azalırmı?
Əgər cavab xeyrdirsə, yüksək ümumi performansı kvant qatına aid etmək mümkün deyil.
Məlumat Sızması Nədir və Bu Tədqiqatda Niyə Kritik Problemdir?
Məlumat sızması, test mərhələsində həqiqətən görülməmiş məlumatları qiymətləndirmək əvəzinə, təlim zamanı eyni görüntünün, işlənmiş surətinin və ya eyni xəstədən çox oxşar görüntülərin modelə dolayı şəkildə göstərilməsidir; bu tədqiqatda rəsmi test dəstinin %79-unun təlimdə bir surətlə bağlı olması və figshare mənşəli 917 test görüntüsünün 915-inin təlimdə eyni xəstə ilə üst-üstə düşməsi səbəbindən yüksək test dəqiqliklərinin mühüm hissəsinin real ümumiləşdirmə performansını olduğundan yüksək göstərə biləcəyi müəyyən edilmişdir.
Dəqiq surət ilə yaxın surət eyni şey deyil
Tədqiqatçılar bir neçə sızma növünü ayrıca axtarmışlar.
- Exact duplicate: Piksel massivləri tam eyni olan görüntülərdir. Bunlar dekodlaşdırılmış piksel massivinin MD5 checksum-u ilə müəyyən edilmişdir.
- Near-duplicate: Yenidən JPEG kodlanmış, yenidən ölçüləndirilmiş və ya kiçik emal fərqləri olan, lakin mahiyyətcə eyni görüntünü daşıyan nümunələrdir.
- Mirrored copy: Görüntüyə üfüqi/şaquli və ya başqa əks etdirmə çevrilmələri tətbiq edilmiş surətlərdir.
- Rotated/flipped copy: Kvadrat görüntünün səkkiz fırlatma və əks etdirmə çevrilməsindən biri ilə əldə edilmiş qarşılıqlarıdır.
- Patient overlap: Görüntülər tam eyni olmasa belə, təlim və test dəstlərində eyni xəstəyə aid fərqli MRI kəsiklərinin olmasıdır.
Yaxın surət namizədləri 64-bit perceptual hash (pHash) ilə skan edilmiş və Hamming məsafəsinin ən çox 8 bit olması şərti tətbiq edilmişdir. Daha sonra namizəd cütlərin 64 × 64 piksel thumbnail-ları arasındakı normallaşdırılmış çarpaz korrelyasiyanın (normalized cross-correlation, NCC) ən azı 0,95 olması tələb edilmişdir.
Hamming məsafəsi, iki bit ardıcıllığında fərqli olan bitlərin sayıdır. Məsələn, iki 64-bit pHash arasında Hamming məsafəsi 8-dirsə, 64 mövqenin səkkizində bit qiymətləri fərqlidir. Kiçik Hamming məsafəsi vizual strukturların oxşarlığına işarə edir; lakin təkbaşına kifayət sayılmamış və NCC təsdiqi də istifadə edilmişdir.
NCC, iki görüntü nümunəsinin xətti oxşarlığını ölçən normallaşdırılmış korrelyasiya ölçüsüdür. Tədqiqatdakı 0,95 həddi pHash-in yaratdığı namizədlərin həqiqətən çox oxşar görüntülər olduğunun ikinci yoxlaması kimi istifadə edilmişdir.
Güzgüləmə və fırlatma niyə xüsusilə vacib idi?
Standart pHash güzgüləmə və fırlatmaya invariant deyil. Yəni MRI kəsiyinin güzgü görüntüsü insan gözünə açıq şəkildə eyni görünsə belə, birbaşa pHash müqayisəsində kifayət qədər yaxın çıxmaya bilər. Buna görə tədqiqatçılar hər görüntünün kvadrat üzərində səkkiz fırlatma/əks etdirmə çevrilməsini qiymətləndirib ən kiçik Hamming məsafəsindən və ona uyğun NCC qiymətindən istifadə etmişlər.
İlk audit 385 exact və 6162 near-duplicate cüt aşkar etdiyi halda, çevrilmələrə davamlı yenilənmiş audit əlavə olaraq 7915 güzgülənmiş və 10.161 fırladılmış/çevrilmiş cüt müəyyən etmişdir. Ümumi duplicate-pair sayı 24.623-ə çatmış və bunların 9699-u təlim–test sərhədini keçmişdir.
| Ölçü | Mənbə nəticəsi | Şərh |
|---|---|---|
| Ümumi görüntü | 7200 | Dörd sinifdə hərəsində 1800 görüntü |
| Rəsmi təlim / test | 5600 / 1600 | Hər sinifdə 1400 təlim + 400 test |
| Ümumi aşkar edilmiş duplicate cüt | 24.623 | Exact, near, mirrored və rotated/flipped cütlərin cəmi |
| Təlim–test sərhədini keçən duplicate cüt | 9699 | Rəsmi bölünməyə birbaşa təsir edən əlaqələr |
| Təlimdə surəti olan test görüntüsü | 1269 / 1600 (%79) | Augmented nümunələr daxil yenilənmiş audit |
| Figshare mənşəli test görüntülərində xəstə üst-üstə düşməsi | 915 / 917 | Eyni xəstə təlim bölməsində də mövcuddur |
| Heç bir surət və ya məlum xəstə əlaqəsi olmayan strict-clean test | 87 | 74 glioma, 11 meningioma, 2 hipofiz şişi; şişsiz nümunə yoxdur |
Məlumat mənbəyi niyə ayrıca araşdırıldı?
Eyni şiş sinfinin fərqli cihazlardan, fərqli MRI ardıcıllıqlarından, fərqli görüntü matrislərindən və ya fərqli JPEG emal zəncirlərindən gəlməsi model üçün arzuolunmaz qısa yol yarada bilər. Model şiş morfologiyasını öyrənmək əvəzinə görüntünün hansı məlumat mənbəyindən gəldiyini öyrənə bilər.
Buna görə tədqiqatçılar görüntü eni, hündürlüyü, en-hündürlük nisbəti, 512 × 512 olub-olmaması, rəng rejimi, JPEG fayl ölçüsü, qlobal intensivlik statistikaları və hətta şişin ətraflı görünüşünü ehtiva etməyən yalnız 8 × 8 piksellik thumbnail kimi xüsusiyyətlərlə gradient-boosting təsnifatçıları öyrətmişlər.
Yalnız görüntü ölçüsü, en-hündürlük nisbəti və rəng rejimindən istifadə edildikdə şiş–şişsiz ayrımı %91,8 dəqiqliklə aparıla bilmişdir. Yalnız 8 × 8 thumbnail istifadə edildikdə dörd sinifli dəqiqlik %78,9 olmuşdur; təsadüfi şans səviyyəsi %25-dir. Xəstə-qruplu Protocol 3 altında belə bu kobud thumbnail %78,1 dəqiqlik vermişdir.
Görüntülər standartlaşdırılıb fon, sərhədlər, matris ölçüsü və intensivlik şkalası kimi bir çox ipucu aradan qaldırıldıqdan sonra belə 8 × 8 thumbnail dörd sinifdə %69,7 dəqiqlik vermişdir. Bu nəticələr məlumat dəstindəki sinif etiketlərinin yalnız şiş toxumasının görünüşündən deyil, görüntüləmə mənbəyi və kobud anatomiya kimi başqa siqnallardan da proqnozlaşdırıla bildiyini göstərir.
76 “out-of-source” glioma görüntüsü niyə vacibdir?
Rəsmi test bölməsindəki 400 glioma görüntüsündən 76-sı təlim glioma görüntülərindən fərqli mənbə və görüntüləmə paylanmasına aiddir. Təlimdəki bütün 1400 glioma görüntüsü 512 × 512 figshare formatında olduğu halda bu 76 görüntü 61 fərqli matris ölçüsündə olmuşdur.
Mənbə uyğunlaşdırması bu 76 görüntünün SARTAJ kolleksiyasındakı test glioma görüntülərinin piksel surətləri olduğunu göstərmişdir. Beləliklə, bunlar yalnız “yeni xəstə” deyil, eyni zamanda modelin glioma sinfi üçün təlim zamanı görmədiyi məlumat mənbəyidir.
Fine-tuned modellər ümumi xəstə-qruplu dəqiqlikdə təxminən %94 səviyyəsinə çatsa da, bu 76 görüntüdə yalnız %46,1–61,8 dəqiqlik göstərmişdir. Bu fərq ümumi dəqiqliyin məlumat mənbəyinə görə ayrılmasının niyə zəruri olduğunu açıq şəkildə göstərir.
Namizəd etiket xətaları
Confident-learning skanı 6997 augmented olmayan görüntüdən 28-ni mümkün etiket xətası üçün işarələmişdir. Bunların 19-u figshare mənşəlidir. Figshare-ın orijinal annotasiyası 15-də mövcud etiketi dəstəklədiyi halda dörd görüntüdə modelin təklif etdiyi alternativ sinfi dəstəkləmişdir.
Mənbə bu 28 görüntünü “qəti yanlış etiket” adlandırmır. Radioloqun müstəqil baxışı aparılmadığı üçün bunlar yalnız candidate label errors, yəni ekspert baxışı tələb edən namizədlərdir və bütün əsas analizlərdə məlumat dəstindən çıxarılmamışdır.
Variasiyalı Kvant Dövrəsi Bu Modeldə Dəqiq Nə Edir?
Tədqiqatdakı dressed VQC klassik CNN backbone-dan gələn yüksəkölçülü xüsusiyyətləri əvvəlcə n ədəd bucağa sıxır, bu bucaqları n kubitin RY fırlanmalarına kodlayır, öyrənilə bilən tək-kubit fırlanmaları və CNOT halqaları ilə emal edir, hər kubitdə Pauli-Z gözlənilən qiymətini ölçür və yaranan n real ədədi dörd MRI sinfinə aid klassik logitlərə çevirir; beləliklə kvant dövrəsi bütün modeli deyil, klassik xüsusiyyət çıxarıcı ilə klassik çıxış qatı arasında kiçik ara qat təşkil edir.
Kubit nədir?
Klassik bit yalnız 0 və ya 1 vəziyyətində müəyyən olunduğu halda, bir kubit, ölçmədən əvvəl iki əsas vəziyyətin kompleks amplitudlarla təyin olunan kvant superpozisiyasında ola bilər. Ümumi tək-kubit vəziyyəti konseptual olaraq:
\[ |\psi\rangle=\alpha|0\rangle+\beta|1\rangle, \qquad |\alpha|^2+|\beta|^2=1 \]
şəklində yazıla bilər. Bu ifadə tədqiqatın yeni nəticəsi deyil; VQC-də kubit anlayışını izah edən əsas kvant mexanikası göstərimidir.
Tənlik (1): Klassik xüsusiyyətlər kvant bucaqlarına necə çevrilir?
Mənbədə klassik xüsusiyyət vektorundan kvant dövrəsinə daxil olacaq bucaqların yaradılması:
\[ \mathbf{x} = \frac{\pi}{2} \tanh(W\mathbf{f}+\mathbf{b}) \in \left(-\frac{\pi}{2},\frac{\pi}{2}\right)^n \tag{1} \]
şəklindədir.
Burada:
- \(\mathbf{f}\), klassik backbone-dan gələn \(d\)-ölçülü xüsusiyyət vektorudur.
- \(W\), öyrənilə bilən xətti çevrilmə matrisidir.
- \(\mathbf{b}\), öyrənilə bilən bias vektorudur.
- \(\tanh\), element üzrə hiperbolik tangens funksiyasıdır.
- \(\mathbf{x}=(x_1,\ldots,x_n)\), kvant dövrəsinə kodlanacaq \(n\) ədəd fırlanma bucağını ehtiva edir.
- \(n\), eyni zamanda VQC-dəki kubit sayıdır.
\(\tanh\) çıxışı −1 ilə +1 arasında olduğuna görə \(\pi/2\) ilə vurulduqda hər bucaq \(-\pi/2\) ilə \(+\pi/2\) arasında məhdudlaşdırılır. Beləliklə minlərlə klassik CNN xüsusiyyəti birbaşa minlərlə kubitə yüklənmir; əvvəlcə kiçik \(n\)-ölçülü darboğaza sıxılır.
Altı kubitli əsas modeldə, məsələn, EfficientNet-B0-nun 1280 ölçülü pooled xüsusiyyət vektoru əvvəlcə yalnız altı bucağa endirilir. Bu ölçü azaldılması özlüyündə mühüm məlumat darboğazıdır və kvant dövrəsinin sonrakı hesablamasını şərh edərkən nəzərə alınmalıdır.
Hadamard və RY qapıları nə edir?
Hər kubit başlanğıcda \(|0\rangle\) vəziyyətindədir. Mənbə dövrəsində əvvəlcə Hadamard (\(H\)) qapısı, ardından \(R_Y(x_i)\) fırlanması tətbiq edilir.
Hadamard qapısı əsas vəziyyətdə olan kubiti iki əsas vəziyyətin superpozisiyasına keçirir. \(R_Y(x_i)\) isə Bloch kürəsi üzərində Y oxu ətrafında \(x_i\) bucağı qədər fırlanma tətbiq edir. Beləliklə klassik xüsusiyyətlərdən alınan ədədi bucaq kvant vəziyyətinin amplitudlarına kodlanmış olur.
Öyrənilə bilən Rot qapısı
Hər variasiyalı qatda hər kubitə:
\[ \operatorname{Rot}(\alpha,\beta,\gamma) = R_Z(\gamma)R_Y(\beta)R_Z(\alpha) \]
şəklində üç öyrənilə bilən bucaq ehtiva edən ümumi tək-kubit fırlanması tətbiq edilmişdir.
Altı kubit və iki variasiyalı qatda hər kubit üçün qat başına üç parametr olduğuna görə kvant dövrəsinin öyrənilə bilən parametr sayı:
\[ 6\times2\times3=36 \]
olur.
CNOT halqası və kvant dolaşıqlığı
Tək-kubit fırlanmalarından sonra kubitlər controlled-NOT (CNOT) halqası ilə bir-birinə bağlanmışdır. Halqada kubit \(i\), kubit \(i+1\)-i idarə edir və indeks son kubitdən sonra yenidən ilk kubitə qayıdır.
CNOT kimi iki-kubit qapıları uyğun giriş vəziyyətlərində kubitlər arasında kvant dolaşıqlığı yarada bilər. Lakin bu tədqiqatın mühüm ablasiya nəticələrindən biri CNOT halqasının çıxarılmasının dəqiqliyi azaltmaması, əksinə əsas altı-kubit təcrübəsində artırmasıdır. Buna görə “dolaşıqlıq istifadə edildi, deməli üstünlük kvant dolaşıqlığından gəldi” kimi şərh mənbə tərəfindən dəstəklənmir.
Tənlik (2): VQC-nin kvant vəziyyəti
Mənbənin dövrə tənliyi bucaq kodlamasını və \(L\) variasiyalı qatı aşağıdakı ümumi quruluşda ifadə edir:
\[ |\psi(\mathbf{x};\boldsymbol{\theta})\rangle = U_{\mathrm{ent}}R(\boldsymbol{\theta}^{(L)}) \cdots U_{\mathrm{ent}}R(\boldsymbol{\theta}^{(1)}) \left[ \bigotimes_{i=1}^{n} R_Y(x_i)H \right] |0\rangle^{\otimes n} \tag{2} \]
Burada:
- \(|0\rangle^{\otimes n}\), bütün \(n\) kubitin başlanğıc vəziyyətidir.
- \(\bigotimes\), əməliyyatların fərqli kubitlərə tensor hasili ilə tətbiq edildiyini göstərir.
- \(R_Y(x_i)\), \(i\)-ci klassik bucağın uyğun kubitə kodlanmasıdır.
- \(R(\boldsymbol{\theta}^{(\ell)})\), \(\ell\)-ci qatda öyrənilə bilən tək-kubit fırlanmalarının ümumi quruluşunu təmsil edir.
- \(U_{\mathrm{ent}}\), CNOT halqasından ibarət dolaşıqlıq qatıdır.
- \(L\), variasiyalı qatların sayıdır.
- \(\boldsymbol{\theta}\), öyrənilə bilən kvant dövrəsi parametrlərinin hamısıdır.
Əsas modeldə \(n=6\) və \(L=2\)-dir.
Dövrədən klassik ədəd necə çıxır?
Hər kubit üçün Pauli-Z operatorunun gözlənilən qiyməti ölçülür:
\[ z_i = \langle\psi(\mathbf{x};\boldsymbol{\theta})| Z_i |\psi(\mathbf{x};\boldsymbol{\theta})\rangle, \qquad z_i\in[-1,1]. \]
\(Z_i\), yalnız \(i\)-ci kubit üzərində Pauli-Z ölçməsini təmsil edir. Gözlənilən qiymət tək ölçmədə yalnız 0 və ya 1 deyil; çoxsaylı ölçmələrin və ya tam vəziyyət simulyasiyasının yaratdığı ehtimal paylanmasından hesablanan −1 ilə +1 arasında real qiymətdir.
Altı kubitli dövrə beləliklə altı real ədəd yaradır. Son klassik xətti qat bu altı qiyməti dörd sinfə aid dörd logitə çevirir və təsnifat qərarı bu klassik çıxış üzərindən verilir.
Klassik nəzarətin niyə “eyni enli” olması lazımdır?
Altı-kubit VQC-nin yerinə çox böyük və ya çox kiçik klassik şəbəkə qoymaq performans fərqinin kvant hesablamasından, yoxsa model tutumundan qaynaqlandığını ayırmağı çətinləşdirir.
Əsas klassik nəzarət buna görə VQC-nin altı giriş və altı çıxışına uyğun Linear(6,6) + tanh istifadə etmişdir. Altı-kubit VQC-nin 36 öyrənilə bilən kvant parametrinə qarşı klassik orta qatın 42 parametri vardır.
Tədqiqat bunun da tam mənada “ifadə gücü bərabərliyi” təmin etmədiyini qəbul etmiş və iki əlavə klassik nəzarətdən istifadə etmişdir:
- Deeper control: iki ədəd
Linear(6,6) + tanhqatı; 84 orta-qat parametri. - Fourier surrogate: VQC-nin bir dəfəlik bucaq kodlaması altında hesablaya bildiyi triqonometrik funksiya sinfini əhatə edəcək şəkildə \(3^6=729\) klassik triqonometrik xüsusiyyət.
Fourier surrogate-in əhəmiyyəti böyükdür. Mənbədə VQC-nin hər çıxışının hər giriş bucağında tezlikləri \(\{-1,0,1\}\) olan triqonometrik polinom olduğu izah edilir. Altı giriş üçün mümkün hasil bazasının ölçüsü:
\[ 3^6=729 \]
olur. Bu bazadakı hər xüsusiyyət:
\[ \prod_i g_i(x_i), \qquad g_i\in\{1,\cos x_i,\sin x_i\} \]
şəklindədir. Buna görə xətti klassik model bu dövrə dizaynının yarada bildiyi funksiya sinfini təmsil edə bilər. Tədqiqatda bu surrogate VQC-dən daha dəqiq çıxmışdır.
“Barren plateau” nəticəsi sübut edilibmi?
Xeyr. Səkkiz və on kubitli dövrələrin dəqiqliyinin azalması və kvant modelinin daha uzun təlim tələb etməsi müəlliflər tərəfindən kvant dövrələrində məlum olan yastılaşmış optimallaşdırma landşaftları ilə uyğun hesab olunur; lakin tədqiqat gradient variasiyasını birbaşa ölçərək barren plateau olduğunu sübut etməmişdir.
Kvant dövrəsi real kvant avadanlığında işlədilibmi?
Xeyr. Səs-küysüz dövrələr PyTorch ilə yazılmış batched state-vector simulyatoru vasitəsilə klassik CPU/GPU üzərində tam simulyasiya edilmişdir. Səs-küylü dövrələr density-matrix simulyasiyası ilə hesablanmışdır. PennyLane yalnız hazırlanmış simulyatorun çıxışını doğrulamaq üçün istifadə edilmişdir.
Buna görə tədqiqatdakı 18,8 ms kimi latency qiymətləri kvant prosessorunun işləmə müddəti deyil. Bunlar RTX 3090 üzərində kvant dövrəsi simulyasiyasını da ehtiva edən klassik GPU forward-pass müddətləridir.
Depolarizing noise modeli
Səs-küy təcrübəsində hər kubitə hər gate layer-dən sonra tək-kubit depolarizasiya kanalı tətbiq edilmişdir:
\[ \rho \rightarrow (1-p)\rho + \frac{p}{3} \left( X\rho X+Y\rho Y+Z\rho Z \right). \]
Burada:
- \(\rho\), kubitin density matrix vəziyyətidir.
- \(p\), bu qatda Pauli xətasının tətbiq olunma ehtimalıdır.
- \(X,Y,Z\), Pauli operatorlarıdır.
\(p=0\) ideal səs-küysüz simulyasiyanı, daha böyük \(p\) isə daha güclü depolarizasiyanı təmsil edir. Mənbədə \(p=\{0{,}001,0{,}003,0{,}01,0{,}03,0{,}1\}\) qiymətləri sınaqdan keçirilmişdir.
Bu model real avadanlığın bütün xəta mənbələrini əhatə etmir. Crosstalk, readout error, məhdud əlaqə topologiyası və real gate decomposition xərci modelə daxil edilməmişdir.
“Shot” nə deməkdir?
Real kvant kompüterində gözlənilən qiymət bir ölçmədən dəqiq əldə edilmir. Eyni dövrə dəfələrlə işlədilir və ölçmə nəticələrinin statistikası istifadə olunur. Dövrənin bir dəfə hazırlanıb ölçülməsinə ümumiyyətlə shot deyilir.
Tədqiqatda finite-shot təsirini təqlid etmək üçün exact outcome probability paylanmasından \(S\) ədəd nəticə nümunələnmişdir. Sınaqdan keçirilən shot sayları:
\[ S\in\{16,64,256,1024,4096\} \]
olmuşdur.
Quantum kernel nədir?
Model-head təcrübələrindən ayrıca olaraq tədqiqatçılar quantum-kernel support vector machine (SVM) ilə klassik radial basis function (RBF) kernel SVM-ni də müqayisə etmişlər.
EfficientNet-B0 xüsusiyyətləri əvvəlcə principal component analysis (PCA) ilə 4, 6, 8 və ya 10 komponentə endirilmiş və [0,1] intervalına miqyaslanmışdır. Quantum kernel üçün ZZ feature map istifadə edilmişdir.
İki girişin kernel oxşarlığı kvant vəziyyətlərinin fidelity-si ilə müəyyən edilmişdir:
\[ k(\mathbf{x},\mathbf{x}') = \left| \langle\psi(\mathbf{x})|\psi(\mathbf{x}')\rangle \right|^2. \]
Daxili hasilin mütləq kvadratı 0 ilə 1 arasında oxşarlıq qiymətidir. Eyni kvant vəziyyətində 1-ə çatır; vəziyyətlər daha fərqli olduqca kiçilə bilər.
Klassik müqayisəçi eyni PCA girişlərində RBF kernel istifadə etmişdir. Beləliklə iki kernel eyni aşağıölçülü giriş məlumatı üzərindən müqayisə edilmişdir.
Tədqiqatın Metodu və Nəticələri
Brain Tumor MRI Dataset 2-ci versiya
| Sinif | Təlim | Test | Cəmi |
|---|---|---|---|
| Glioma | 1400 | 400 | 1800 |
| Meningioma | 1400 | 400 | 1800 |
| Hipofiz şişi | 1400 | 400 | 1800 |
| Şiş yoxdur | 1400 | 400 | 1800 |
| Cəmi | 5600 | 1600 | 7200 |
Figshare kolleksiyası 233 xəstədən 3064 kontrastlı T1-çəkiyə malik MRI kəsiyi ehtiva edir və orijinal xəstə identifikatorları ilə birlikdə şiş tipini və əl ilə hazırlanmış şiş maskasını təqdim edir. Tədqiqatın provenance uyğunlaşdırması Kaggle məlumat dəstindəki 5400 şiş görüntüsünün 4846-sını figshare mənşəli kimi uyğunlaşdıra bilmişdir.
Qalan şiş görüntülərinin mənbələri SARTAJ kolleksiyası uyğunlaşdırmaları ilə araşdırılmışdır. JPEG quantization table, chroma subsampling və color mode məlumatları da istehsal/emal zəncirinin fingerprint-i kimi qeydə alınmışdır.
Üç qiymətləndirmə protokolu
| Protokol | Quruluş | Məqsəd / şərh sərhədi |
|---|---|---|
| Protocol 1 | Rəsmi 5600/1600 bölünməsi; təlimdən 800 görüntü validation üçün ayrılır | Sızma və source-shift təsirini ölçmək üçün saxlanılmışdır; əsas model müqayisəsi deyil |
| Protocol 2 | Beşqat grouped CV; ilk duplicate audit qrupları fold-lar arasında bölünmür | İlk təqdimatda istifadə edilən yanaşma; yenilənmiş auditdən sonra yetərsiz olduğu müəyyən edilmişdir |
| Protocol 3 | Revised duplicate qrupları + eyni figshare xəstəsinin bütün görüntüləri birləşdirilərək beş fold yaradılır | Əsas qiymətləndirmə protokolu; məlum eyni xəstə və ya aşkar edilmiş surət fold-lar arasında keçə bilməz |
Protocol 3-də 6997 augmented olmayan görüntünün hər biri tam bir dəfə out-of-fold test proqnozu alır. Figshare mənşəli test görüntüsü üçün modeli öyrədən fold nə bu görüntünü, nə aşkar edilmiş surətini, nə də eyni xəstənin başqa figshare görüntüsünü görmüş olur.
Lakin mənbə mühüm qalıq məhdudiyyətini qeyd edir: figshare xaricindəki şiş görüntülərində və şişsiz görüntülərdə xəstə identifikatoru yoxdur. Buna görə duplicate detector tərəfindən tutulmayan eyni müayinəyə aid başqa kəsiklərin fərqli fold-lara düşməsi ehtimalı tam aradan qaldırılmamışdır.
Frozen-feature təcrübələri
Dörd ImageNet-pretrained backbone yalnız sabit xüsusiyyət çıxarıcı kimi istifadə edilmişdir:
| Backbone | Xüsusiyyət ölçüsü d |
|---|---|
| EfficientNet-B0 | 1280 |
| DenseNet-121 | 1024 |
| ResNet-50 | 2048 |
| MobileNetV2 | 1280 |
Görüntülər grayscale-ə çevrilib üç kanala kopyalanmış, 256 × 256 pikselə yenidən ölçüləndirilmiş, mərkəzdən 224 × 224 kəsilmiş və ImageNet statistikaları ilə normallaşdırılmışdır. Pooled xüsusiyyətlər hər təlim fold-unun orta və standart sapması ilə standartlaşdırılmışdır.
Səkkiz fərqli head müqayisə edilmişdir:
- 6-kubit, 2-qat VQC;
- uyğunlaşdırılmış klassik nəzarət;
- daha dərin klassik nəzarət;
- Fourier surrogate;
- bottleneck-only;
- linear probe;
- 256 gizli vahidli MLP;
- kvant parametrləri random başlanğıcda dondurulmuş untrained VQC.
Head-lər Adam optimizer ilə öyrədilmiş; weight decay \(10^{-4}\), batch size 128 və ən çox 80 epoch istifadə edilmişdir. Validation loss beş epoch yaxşılaşmasa learning rate yarıya endirilmiş, on epoch yaxşılaşmasa təlim dayandırılmışdır. Başlanğıc learning rate hər şəraitdə:
\[ \{10^{-3},3\times10^{-3},10^{-2}\} \]
arasından validation loss-a görə seçilmişdir.
Kvant Qatı Bu Benchmark-da Həqiqətən Fayda Verdi?
Xeyr; tədqiqatın sınaqdan keçirdiyi üç əsas təlim rejimində altı-kubitli VQC eyni enli klassik qatın dəqiqliyini artırmamışdır: frozen-feature təcrübələrində aydın şəkildə geri qalmış, ucdan-uca fine-tuning zamanı təxminən eyni səviyyəyə yaxınlaşmış, lakin convergence-based təlimdə yenə 0,69 faiz bəndi aşağı qalmış və sıfırdan öyrədilən HQCNN-də klassik nəzarətdən 8,33 faiz bəndi daha aşağı dəqiqlik vermişdir; bu nəticə yalnız araşdırılan dövrə, məlumat dəsti və təlim protokolları üçün keçərlidir.
| Rejim | Müqayisə | Dəqiqlik fərqi | %95 GA | Mənbə şərhi |
|---|---|---|---|---|
| Frozen features | VQC − uyğunlaşdırılmış klassik nəzarət | −6,03 faiz bəndi | −6,78 ilə −5,20 | Klassik nəzarət 20/20 backbone–fold blokunda daha yaxşı |
| Frozen features | VQC − deeper control | −4,71 faiz bəndi | −5,63 ilə −3,73 | Klassik model 20/20 blokda daha yaxşı |
| Frozen features | VQC − Fourier surrogate | −5,27 faiz bəndi | −6,20 ilə −4,39 | Dövrənin funksiya sinfini əhatə edən klassik surrogate daha yaxşı |
| End-to-end, Block A | VQC − klassik nəzarət | −0,07 faiz bəndi | −1,08 ilə +1,00 | ±1 pp daxilində ekvivalent |
| End-to-end, Block B | VQC − klassik nəzarət | −0,69 faiz bəndi | −1,25 ilə −0,13 | ±1 pp ekvivalentliyi elan edilə bilmədi |
| Standardized images, Block C | VQC − klassik nəzarət | −1,11 faiz bəndi | −2,07 ilə −0,20 | VQC daha aşağı |
| From scratch | HQCNN − klassik nəzarət | −8,33 faiz bəndi | −12,72 ilə −4,06 | Klassik nəzarət daha yaxşı |
Frozen-feature nəticələrinin təfərrüatı
| Head | EfficientNet-B0 | DenseNet-121 | ResNet-50 | MobileNetV2 |
|---|---|---|---|---|
| VQC | 82,0 ± 3,4 | 79,5 ± 3,5 | 76,0 ± 4,0 | 78,5 ± 2,1 |
| Klassik nəzarət | 86,4 ± 2,9 | 86,4 ± 3,1 | 83,1 ± 3,1 | 84,3 ± 3,9 |
| Deeper control | 84,4 ± 2,6 | 85,5 ± 2,8 | 81,3 ± 2,9 | 83,7 ± 3,7 |
| Fourier surrogate | 85,5 ± 3,3 | 85,4 ± 3,6 | 82,1 ± 2,6 | 84,2 ± 2,9 |
| Bottleneck only | 87,6 ± 3,2 | 87,9 ± 3,6 | 85,5 ± 2,5 | 86,4 ± 3,6 |
| Linear probe | 88,1 ± 3,0 | 88,1 ± 3,1 | 86,0 ± 2,3 | 87,1 ± 3,6 |
| MLP | 87,9 ± 2,8 | 88,8 ± 3,2 | 86,3 ± 2,1 | 87,5 ± 3,7 |
| Untrained VQC | 80,6 ± 4,5 | 78,1 ± 4,8 | 69,7 ± 3,0 | 77,0 ± 5,8 |
Buradakı ± qiymətlər hər backbone üçün beş fold üzərində seed-averaged dəqiqliyin standart sapmasıdır.
VQC-nin öyrədilmiş olması tamamilə faydasız deyil: öyrədilmiş VQC random parametrlərdə dondurulmuş VQC-dən orta hesabla 2,67 faiz bəndi daha dəqiq çıxmışdır (%95 GA 1,11–4,24). Deməli, dövrə parametrlərinin öyrənilməsi müəyyən töhfə vermişdir; lakin bu töhfə kvant qatını klassik nəzarətlərin üzərinə çıxarmağa kifayət etməmişdir.
Kubit sayı artdıqca nə baş verdi?
EfficientNet-B0 frozen xüsusiyyətlərində bottleneck eni və VQC kubit sayı 2, 4, 6, 8 və 10 olaraq dəyişdirilmişdir.
VQC iki ilə altı kubit arasında təxminən %83,3–83,6 səviyyəsində qalmış, səkkiz kubitdə %80,8-ə və on kubitdə %81,4-ə düşmüşdür. Klassik nəzarət isə en artdıqca iki vahiddə %82,0-dan səkkiz vahiddə %86,6-ya qədər yüksəlmişdir.
VQC yalnız iki kubitdə klassik nəzarətdən +1,3 faiz bəndi daha yaxşı olmuşdur; lakin bu fərq beş fold-un yalnız üçündə eyni istiqamətdədir və hər iki model bottleneck-only başlığının %84,2 dəqiqliyindən aşağı qalmışdır. Mənbə bu nəticəni sabit kvant üstünlüyü kimi şərh etmir.
Dövrə dərinliyi
Altı kubitdə variasiyalı qat sayı 1, 2, 4 və 6 olaraq dəyişdirilmişdir. Dəqiqlik bir qatda %83,0-dan dörd qatda %85,0-a yüksəlmiş və altı qatda %84,8 olmuşdur. Bu yaxşılaşmaya baxmayaraq klassik nəzarət %86,7 ilə daha yüksək qalmışdır.
Dolaşıqlıq çıxarıldıqda nə baş verdi?
Əsas altı-kubit, ikiqat dövrədə CNOT halqasının tam çıxarılması dəqiqliyi %83,5-dən %86,4-ə yüksəltmişdir; standart VQC ilə müqayisədə +2,9 faiz bəndi fərq vardır. Dolaşıqlığı olmayan versiya klassik nəzarətdən yalnız −0,3 faiz bəndi fərqlənir.
Bu nəticə “kvant dolaşıqlığı zərərlidir” şəklində ümumi fiziki nəticə deyil. Yalnız bu dövrə quruluşu, bu məlumat təmsili və bu təsnifat tapşırığı üçün CNOT halqasının ölçülən dəqiqliyə fayda vermədiyini göstərir.
Data re-uploading
Hər variasiyalı qatdan əvvəl \(R_Y(x_i)\) encoding-in yenidən tətbiqi, yəni data re-uploading, əsas VQC-nin %83,5 dəqiqliyini %78,2-yə endirmişdir. Fərq −5,3 faiz bəndi olmuş və beş fold-un hamısında daha pis nəticə alınmışdır.
Az məlumat olduqda kvant model üstünlük verdi?
Xeyr. Əksinə, VQC-nin ən zəif nisbi performansı təlim məlumatının ən az olduğu şəraitdə görülmüşdür.
Təlim fold-unun nominal %1-i istifadə edildikdə qrup əsaslı nümunələmə səbəbindən orta hesabla təxminən 115 təlim görüntüsü qalmışdır. Bu şəraitdə:
| Model | Dəqiqlik |
|---|---|
| VQC | %38,6 |
| Klassik nəzarət | %62,3 |
| Linear probe | %65,5 |
| MLP | %62,3 |
Buna görə “az məlumat olduqda kiçik kvant dövrələri avtomatik üstünlük verir” fərziyyəsi bu benchmark tərəfindən dəstəklənməmişdir.
Səs-küy VQC-nin klassik modeldən geri qalmasını izah edirmi?
Xeyr. Əsas dəqiqlik boşluğu səs-küysüz simulyasiyada artıq mövcuddur.
Altı-kubit, ikiqat VQC səs-küysüz halda %83,5 dəqiqlik verdiyi halda kubit və qat başına \(p=0,03\) depolarizasiya ehtimalında %83,3-ə düşmüşdür. \(p=0,1\)-də dəqiqlik %70,2-yə düşmüşdür.
Daha dərin dövrələr yüksək səs-küyə daha həssasdır: \(p=0,1\)-də dördqat dövrə %31,3, altıqat dövrə %24,0 dəqiqliyə düşmüş; dörd sinifli şans səviyyəsi %25-dir.
Finite-shot simulyasiyasında yalnız 16 shot istifadə edildikdə əsas altı-kubit model 1,5 faiz bəndi itirmişdir. 1024 shot ilə, təkbaşına və ya \(p=0,01\) depolarizasiya ilə birlikdə, nəticə səs-küysüz dövrənin 0,1 faiz bəndi daxilində qalmışdır.
Quantum kernel ilə RBF kernel müqayisəsi
| PCA komponenti / kubit | Quantum kernel | RBF kernel | Quantum − klassik |
|---|---|---|---|
| 4 | %72,8 | %73,3 | −0,5 pp |
| 6 | %77,7 | %78,1 | −0,4 pp |
| 8 | %79,7 | %80,8 | −1,1 pp |
| 10 | %80,9 | %81,5 | −0,6 pp |
Hər iki kernel modeli də tam 1280-ölçülü EfficientNet-B0 xüsusiyyətlərində işləyən %88,0 dəqiqlikli linear probe-dan aşağı qalmışdır. Müəlliflər bu nəticəni kiçik kvant dövrəsinə məlumat yükləmək üçün tələb olunan ölçü azaldılmasının mühüm performans darboğazı olduğuna işarə edən tapıntı kimi şərh edirlər.
Kernel concentration nə idi?
Quantum fidelity kernel-də sabit bandwidth 0,1 və ya daha yüksək olduqda qubit sayı artdıqca off-diagonal kernel entry variasiyası güclü şəkildə azalmışdır. Məsələn, bandwidth 0,1-də variasiya dörd kubitdə \(5.6\times10^{-2}\) olduğu halda on kubitdə \(2.6\times10^{-3}\)-ə düşmüşdür.
Bandwidth 1-də eyni kəmiyyət \(7.4\times10^{-3}\)-dən \(4.5\times10^{-5}\)-ə düşmüşdür. Bu davranış fidelity kernel-lərdə məlum olan kernel concentration ilə uyğundur.
Validation 20 fold–width kombinasiyasının 15-də ən kiçik bandwidth olan 0,03-ü seçmişdir. Lakin dörd kubitdə bu bandwidth ilə off-diagonal kernel ortalaması 0,92 olduğuna görə kernel başqa bir sərhəd problemə, yəni çoxsaylı nümunə cütlərinin bir-birinə çox oxşar görünməsinə yaxınlaşmışdır.
Ucdan-uca incə tənzimləmə
Fine-tuning təcrübələrində ImageNet-pretrained EfficientNet-B0, ResNet-50, DenseNet-121, MobileNetV2, ConvNeXt-Tiny və ViT-Small/16 backbone-ları qiymətləndirilmişdir. VQC ilə uyğunlaşdırılmış klassik nəzarətin birbaşa müqayisəsi EfficientNet-B0 üzərində aparılmışdır.
Block A: ilk təlim resepti
AdamW optimizer, weight decay 0,05, %10 warm-up-lı one-cycle learning-rate schedule, head üçün \(10^{-3}\), backbone üçün \(3\times10^{-4}\) peak learning rate, batch size 32 və label smoothing 0,05 istifadə edilmişdir. Təlim ən çox 30 epoch davam etmiş və validation loss altı epoch yaxşılaşmasa dayandırılmışdır.
Augmentation; random resized crop (scale 0,8–1,0; aspect ratio 0,9–1,1), horizontal flip, ±10° fırlanma və 0,15 brightness/contrast jitter ehtiva etmişdir.
Block B: yaxınlaşmaya əsaslanan təlim
İki epoch xətti warm-up istifadə edilmiş, validation loss üç epoch yaxşılaşmasa learning rate yarıya endirilmiş, on epoch yaxşılaşma olmasa erkən dayandırma tətbiq edilmiş və maksimum 80 epoch müəyyən edilmişdir.
Head learning rate:
\[ \{3\times10^{-4},10^{-3},3\times10^{-3}\} \]
arasından ilk fold-un validation setində seçilmiş; backbone learning rate head sürətinin 0,3 qatı kimi tənzimlənmişdir. Seçilmiş learning rate beş fold və iki seed boyunca istifadə edilmişdir.
Block C: standartlaşdırılmış görüntülər
Fon, sərhədlər, overlay-lər, matris ölçüsü və qlobal intensivlik şkalası kimi mənbə qısa yollarını azaltmaq üçün head mask yaradılmış, görüntü maska sahəsinə kəsilmiş, kvadrata pad edilmiş, maska daxilindəki 1.–99. persentil intervalına görə intensity rescale edilmiş və 256 × 256 pikselə yenidən ölçüləndirilmişdir.
Mənbə etibarlı 2B skull stripping olmadığına görə kəllənin görüntüdə qaldığını açıq şəkildə bildirir. Buna görə standartlaşdırma bütün mənbə/shortcut məlumatını aradan qaldırmış deyil.
Ucdan-uca əsas performans nəticələri
| Rejim | VQC | Klassik nəzarət | Linear head |
|---|---|---|---|
| Block A | %94,1 | %94,2 | %94,5 |
| Block B | %93,8 | %94,5 | %94,5 |
| Block C, standardized | %93,6 | %94,7 | %94,3 |
Block A-da VQC ilə klassik nəzarət arasındakı %95 etibar intervalı −1,08 ilə +1,00 pp-dir. %90 etibar intervalı −0,93 ilə +0,82 pp arasında tamamilə ±1 pp ekvivalentlik bölgəsində qaldığına görə mənbə bu iki modeli ±1 faiz bəndi səviyyəsində ekvivalent qəbul etmişdir.
Block B-də VQC − klassik nəzarət fərqi −0,69 pp-dir. %90 etibar intervalı −1,16 ilə −0,22 olduğuna və −1 pp sərhədini keçdiyinə görə ±1 pp ekvivalentliyi elan edilə bilməmişdir. Ekvivalentliyin elan edilə biləcəyi ən kiçik margin 1,16 pp-dir.
Bu fərq vacibdir: statistik olaraq əhəmiyyətli fərq tapılmaması ilə modellərin ekvivalent olduğunun göstərilməsi eyni şey deyil. Buna görə tədqiqat yalnız p qiymətinə deyil, əvvəlcədən müəyyən edilmiş ±1 pp equivalence margin və %90 etibar intervalına baxmışdır.
Fine-tuning xərci
| Model | Orta dayanma epoch-u | Training müddəti / run | Tək görüntü latency | Peak GPU memory |
|---|---|---|---|---|
| VQC | 38,8 | 12,8 dəq | 18,8 ms | 1461 MB |
| Klassik nəzarət | 26,0 | 6,8 dəq | 11,3 ms | 1461 MB |
| Deeper control | 29,1 | 7,7 dəq | 11,2 ms | 1461 MB |
| Fourier surrogate | 22,3 | 6,0 dəq | 11,7 ms | 1461 MB |
| Linear head | 23,2 | 6,0 dəq | 10,7 ms | 1461 MB |
Bu müddətlər real kvant avadanlığı xərcləri deyil. Kvant dövrəsi klassik GPU üzərində simulyasiya edildiyi üçün yalnız tədqiqatın implementation xərcini göstərir.
Sıfırdan öyrədilən HQCNN
Mənbə əvvəlki hibrid tədqiqatların çoxuna daha yaxın ssenarini sınaqdan keçirmək üçün pretrained backbone istifadə etmədən sıfırdan hibrid kvant–klassik CNN də öyrətmişdir.
Encoder üç blokdan ibarətdir:
- 3 × 3 convolution, 64 kanal + batch normalization + ReLU + 2 × 2 max pooling;
- 3 × 3 convolution, 128 kanal + batch normalization + ReLU + 2 × 2 max pooling;
- 3 × 3 convolution, 256 kanal + batch normalization + ReLU + 2 × 2 max pooling.
Bundan sonra global average pooling, 256 → 6 xətti bucaq proyeksiyası, altı-kubit ikiqat VQC, 64 və 32 vahidli klassik dense qatlar və dörd sinifli çıxış yerləşir.
HQCNN-nin ümumi 375.950 öyrənilə bilən parametrinin yalnız 36-sı kvant dövrəsindədir. Uyğunlaşdırılmış klassik nəzarət VQC əvəzinə Linear(6,6)+tanh istifadə edir və ümumilikdə 375.956 parametr ehtiva edir.
Nəticə:
HQCNN: %67,9 dəqiqlik (%95 GA 63,5–72,1).
Klassik nəzarət: %76,2 dəqiqlik (%95 GA 72,7–79,6).
Fərq −8,33 faiz bəndidir (%95 GA −12,72 ilə −4,06; McNemar \(p=1.6\times10^{-41}\)).
Məlumat sızması dəqiqliyi nə qədər yüksəltdi?
Tədqiqatçılar eyni modelləri və eyni görüntüləri yalnız fold qruplaşdırma qaydalarını dəyişdirərək Protocol 2 və Protocol 3 altında öyrətmişlər. Bu yanaşma sızmanın təsirini daha birbaşa təcrid etməyi hədəfləmişdir.
| Model qrupu / görüntü əlaqəsi | Protocol 2 → Protocol 3 dəqiqlik dəyişikliyi |
|---|---|
| Frozen-feature head-lər, ümumi | −3,3 ilə −7,8 pp |
| Frozen, Protocol 2 training fold-unda surəti olan görüntülər | −3,9 ilə −9,6 pp |
| Frozen, yalnız eyni xəstə əlaqəsi olan görüntülər | −2,3 ilə −6,9 pp |
| Frozen, əlaqəsiz 750 görüntü | −5,5 ilə +3,5 pp; orta −0,4 pp |
| Fine-tuned modellər, ümumi | −3,3 ilə −3,6 pp |
| Fine-tuned, surəti olan görüntülər | −3,7 ilə −4,0 pp |
| Fine-tuned, yalnız eyni xəstə əlaqəsi | −3,5 ilə −4,6 pp |
Sızmanın təsirinin əsasən training fold-u ilə surət və ya xəstə əlaqəsi olan görüntülərdə cəmlənməsi müşahidə edilən dəqiqlik azalmasının yalnız təsadüfi fold dəyişməsindən qaynaqlanmadığını dəstəkləyir.
Lesion occlusion təcrübəsi
Figshare mənşəli test şişlərində əl ilə hazırlanmış şiş maskası 8 piksel genişləndirilmiş və bu sahə başın qalan hissəsindəki median intensity ilə doldurulmuşdur. Model daha əvvəl normal, occlusion edilməmiş görüntülər üzərində öyrədilmişdir.
Şiş sahəsinin görünüşü aradan qaldırıldıqda:
- klassik nəzarət %85,6-dan %83,0-a,
- linear probe %87,3-dən %84,7-yə,
- VQC %80,6-dan %78,9-a
düşmüşdür.
Başqa sözlə, şişin görüntü intensivliyi aradan qaldırılsa da dəqiqlik yalnız bir neçə faiz bəndi azalmışdır. Bu hal modellərin şiş toxumasının vizual görünüşündən kənarda qalan anatomiya, mənbə və lezyon həndəsəsi kimi məlumatlardan əhəmiyyətli dərəcədə faydalandığına işarə edir.
Lakin occluded sahə tamamilə məlumatsız sahə deyil: şiş maskasının mövqeyi, ölçüsü və forması saxlanılır. Hətta yalnız 16 × 16 ölçüyə endirilmiş şiş maskası ilə öyrədilən logistic regression belə şiş sinfini %61,4 dəqiqliklə proqnozlaşdırmışdır. Buna görə occlusion nəticəsi “model şişdən heç istifadə etmir” demək deyil.
Mənbələrarası ümumiləşdirmə
Yalnız figshare mənşəli üç şiş sinfində xəstə-qruplu təlim aparıldıqda VQC %80,8, klassik nəzarət %86,4 və linear probe %87,5 dəqiqlik təmin etmişdir.
Figshare şişlərində öyrədilib əlaqəsiz SARTAJ şişlərində test edildikdə bütün head-lər təxminən şans səviyyəsinə yaxınlaşmışdır:
\[ 36.1\%-38.8\% \]
dörd backbone ortalamasının intervalındadır; üç sinifli şans səviyyəsi %33,3-dür.
Buna görə mənbə həm kvant, həm də klassik head-lərin acquisition-source dəyişikliyinə qarşı zəif transfer göstərdiyini bildirir.
Grad-CAM nə göstərdi?
Gradient-weighted Class Activation Mapping (Grad-CAM), CNN-in proqnozunu dəstəkləyən fəza sahələrinin gradient-əsaslı əhəmiyyət xəritəsini yaradır. Mənbə bunu “model niyə qərar verdi?” sualının qəti cavabı kimi deyil, modelin proqnozla əlaqəli aktivləşməsinin harada cəmləndiyini göstərən izah vasitəsi kimi istifadə etmişdir.
İlk fold-dakı 1400 test görüntüsündə Grad-CAM enerjisinin median olaraq baş maskası daxilində qalan nisbəti:
| Model | Median nisbət |
|---|---|
| ResNet-50 linear | %95 |
| EfficientNet-B0 linear | %80 |
| EfficientNet-B0 klassik nəzarət | %89 |
| EfficientNet-B0 VQC | %85 |
| HQCNN | %52 |
VQC-də non-zero Grad-CAM xəritəsi olan görüntülərin %28-də enerjinin yarısından azı baş maskası daxilində qalmışdır; klassik nəzarətdə bu nisbət %10, linear head-də %0,2-dir. Lakin Grad-CAM səbəbli izah vermədiyinə görə bu fərq təkbaşına modelin “nə öyrəndiyini” qəti müəyyən etmir.
Statistik analiz necə aparıldı?
Tədqiqat yalnız tək dəqiqlik faizi hesabat vermək əvəzinə çoxqatlı statistika istifadə etmişdir.
Frozen-feature müqayisələrində dörd backbone × beş fold = 20 backbone–fold bloku vardır. Seed-lər blok daxilində ortalanmışdır. Head-lər arasındakı cütləşdirilmiş fərqlər Wilcoxon signed-rank testi ilə qiymətləndirilmiş, orta fərqlər üçün bootstrap %95 etibar intervalları hesablanmış və bütün head-lər Friedman testi ilə müqayisə edilmişdir.
Fold və backbone-lar tam müstəqil olmadığından əlavə olaraq:
- backbone və backbone daxilində fold üçün random intercept ehtiva edən linear mixed model,
- repeated cross-validation üçün variance-corrected resampled t-test,
- xəstə və duplicate qruplarını yenidən nümunələyən image-level cluster bootstrap
tətbiq edilmişdir.
End-to-end modellərdə yalnız beş fold olduğuna görə fold-level Wilcoxon testi çox aşağı ayırdetməyə malikdir; beş cütdə əldə edilə bilən ən kiçik ikitərəfli p qiyməti 0,0625-dir. Buna görə modellərin out-of-fold proqnozları görüntü səviyyəsində birləşdirilmiş və exact McNemar testi istifadə edilmişdir.
Xəstə və duplicate görüntülər müstəqil qəbul edilə bilmədiyinə görə dəqiqlik və paired-difference %95 etibar intervalları xəstə/duplicate qruplarını yenidən nümunələyən cluster bootstrap ilə hesablanmışdır. Əsas qiymətləndirmələrdə 5000 bootstrap nümunəsi, bəzi sinif-spesifik və sızma alt dəstlərində 2000 nümunə istifadə edilmişdir.
±1 faiz bəndi ekvivalentlik testi nə deməkdir?
İki model arasında “əhəmiyyətli fərq tapmadıq” demək onların praktik olaraq ekvivalent olduğunu sübut etmir. Mənbə buna görə iki model arasındakı fərqin %90 etibar intervalının tamamilə:
\[ [-1,+1]\ \text{yüzde puanı} \]
intervalında qalmasını ekvivalentlik meyarı kimi istifadə etmişdir. Bu, \(\alpha=0,05\) səviyyəsində iki birtərəfli ekvivalentlik testinə uyğun gəlir.
±1 pp sərhədi fiziki təbiət sabiti deyil; tədqiqatçılar tərəfindən əvvəlcədən seçilmiş praktik margin-dir. Mənbə də margin seçiminin konvensiya olduğunu açıq qəbul etmiş və hər müqayisə üçün ekvivalentliyin elan oluna biləcəyi ən kiçik margin-i ayrıca hesabat vermişdir.
Tədqiqatın dəstəklədiyi nəticələr
- Kaggle Brain Tumor MRI Dataset 2-ci versiyanın rəsmi təlim/test bölmələri ciddi görüntü və xəstə üst-üstə düşməsi ehtiva edir.
- Rəsmi test görüntülərinin %79-u təlim bölməsindəki bir görüntü ilə duplicate qrupunu paylaşır.
- Figshare mənşəli test görüntülərinin 915/917-si təlimdə eyni xəstə ilə üst-üstə düşür.
- Xəstə-qruplu qiymətləndirmə frozen-feature dəqiqliyini təxminən 3,3–7,8 pp, fine-tuned dəqiqliyini isə təxminən 3,3–3,6 pp azaltmışdır.
- Altı-kubit VQC frozen xüsusiyyətlərdə eyni enli klassik nəzarətdən təxminən 6,0 pp aşağı dəqiqlik vermişdir.
- Fine-tuning VQC-nin klassik nəzarətlə fərqini təxminən 1 pp və ya daha aşağı səviyyəyə endirmişdir, lakin yaxınlaşmaya əsaslanan təlimdə VQC üstünlük göstərməmişdir.
- Sıfırdan öyrədilən HQCNN klassik nəzarətdən 8,33 pp daha aşağı dəqiqlik vermişdir.
- Araşdırılan ablasiyada dolaşıqlıq qapılarının çıxarılması dəqiqliyi azaltmamış, artırmışdır.
- Araşdırılan quantum kernel bütün PCA ölçülərində RBF kernel-dən bir qədər aşağı dəqiqlik vermişdir.
- Az təlim məlumatı şəraitində VQC klassik nəzarətlərdən daha pis performans göstərmişdir.
- Moderate depolarizing noise əsas kvant–klassik fərqi izah etmir; fərq səs-küysüz simulyasiyada da mövcuddur.
- Görüntü mənbəyindən asılı shortcut-lar güclüdür və fərqli mənbəyə ümumiləşdirmə bütün modellər üçün zəifdir.
Tədqiqatın dəstəkləmədiyi nəticələr
- “Kvant maşın öyrənməsi heç bir tibbi görüntüləmə tapşırığında işləmir” nəticəsi çıxarıla bilməz.
- Real kvant avadanlığının bu tapşırıqda daha yavaş və ya daha sürətli olduğu bu simulyasiya müddətlərindən çıxarıla bilməz.
- 10 kubitdən böyük dövrələrin və ya başqa encoding/ansatz arxitekturalarının performansı bu tədqiqatda sınaqdan keçirilməmişdir.
- Quantum convolutional networks üçün ümumi uğursuzluq nəticəsi çıxarıla bilməz.
- Bu tədqiqat klinik beyin şişi diaqnostika cihazının doğrulanması deyil.
- %94 ətrafındakı fine-tuned dəqiqliklər real xəstəxana diaqnostik dəqiqlik qiymətləndirilməsi deyil.
- Slice-level təsnifat examination-level və ya patient-level klinik diaqnozla eyni şey deyil.
- Out-of-source glioma xətalarının hamısının model xətası olduğu deyilə bilməz; bəzi etiketlər də problemli ola bilər və radioloq baxışı aparılmamışdır.
- Grad-CAM xəritələri model qərarının səbəbli izahı deyil.
- Lesion occlusion təcrübəsi modelin şiş məlumatından ümumiyyətlə istifadə etmədiyini göstərmir; lezyonun mövqeyi, ölçüsü və forması saxlanmışdır.
- Barren plateau birbaşa ölçülüb sübut edilməmişdir.
Tədqiqatın güclü tərəfləri
Birinci güclü tərəf kvant modelini əlaqəsiz CNN ilə deyil, eyni enli və eyni protokollu klassik nəzarətlə müqayisə etməsidir. Beləliklə ümumi şəbəkə performansı əvəzinə kvant ara qatının marjinal töhfəsi sorğulana bilmişdir.
İkinci güclü tərəf yalnız parametr sayını uyğunlaşdırmaqla kifayətlənməyib daha dərin klassik nəzarət və dövrənin funksiya sinfini əhatə edən Fourier surrogate istifadə etməsidir.
Üçüncü güclü tərəf məlumat dəstindəki surətləri yalnız exact checksum ilə axtarmaq əvəzinə güzgüləmə və fırlatmaya davamlı pHash + NCC üsulu ilə skan etməsi və mümkün görüntülər üçün orijinal figshare xəstə identifikatorlarını bərpa etməsidir.
Dördüncü güclü tərəf kvant dövrəsini frozen features, end-to-end fine-tuning və training from scratch olmaqla üç fərqli rejimdə sınaqdan keçirməsidir.
Beşinci güclü tərəf qubit sayı, circuit depth, entanglement, data re-uploading, training-data fraction, depolarizing noise və shot count ablasiyalarının birlikdə araşdırılmasıdır.
Altıncı güclü tərəf yalnız ümumi dəqiqliyə deyil, acquisition source, shortcut, lesion occlusion, cross-source transfer və Grad-CAM analizləri ilə modelin həqiqətən nədən istifadə edə biləcəyini sorğulamasıdır.
Məhdudiyyətlər
Tək məlumat dəsti: Tədqiqat bir açıq, ikiölçülü MRI benchmark-ına əsaslanır. Nəticələrin başqa xəstəliklərə, başqa görüntüləmə tapşırıqlarına və ya 3B MRI həcmlərinə avtomatik köçürülməsi mümkün deyil.
Natamam xəstə identifikatorları: Xəstə identifikatoru yalnız 4846 figshare mənşəli şiş görüntüsü üçün bərpa edilmişdir. Digər şiş və şişsiz görüntülərdə qruplaşdırma duplicate detection-dan asılıdır; aşkar edilməmiş eyni-müayinə kəsiklərinin fərqli fold-larda olması tam istisna edilə bilmir.
Real kvant avadanlığı yoxdur: Bütün dövrələr simulyasiya edilmişdir. İstifadə olunan noise model crosstalk, readout error, limited connectivity və real gate decomposition xərclərini ehtiva etmir.
Məhdud dövrə ailəsi: Dressed VQC-lər ən çox on kubit və bir əsas encoding yanaşması ilə araşdırılmışdır. Başqa encoding-lər, daha böyük dövrələr və kvant məlumatı üzərində işləyən başqa arxitekturalar fərqli davrana bilər.
Hyperparameter axtarışı məhduddur: End-to-end əsas müqayisədə iki seed/fold və ilk fold üzərində üç learning-rate namizədindən seçim istifadə edilmişdir. Daha geniş axtarış kiçik fərqləri dəyişə bilər.
Standartlaşdırma bütün shortcut-ları aradan qaldırmır: Head masking kəlləni aradan qaldırmamışdır. Coarse anatomy və imaging plane məlumatları qalmışdır.
Grad-CAM məhdudiyyəti: Grad-CAM modelin hara baxdığı barədə təxmini fəza ipucu verir; qərar mexanizmini izah etmir.
Etiket doğrulaması: Candidate label errors və 76 out-of-source glioma görüntüsü müstəqil radioloq tərəfindən yenidən etiketlənməmişdir.
Klinik əhatə
Mənbə hesabat verilən dəqiqliklərin klinik diaqnostik dəqiqlik olmadığını açıq vurğulayır. Klinik iddia üçün ən azı slice-level əvəzinə examination-level girişlər, bütün siniflər üçün xəstə ayrımı, histopatologiya və ya ekspert konsensusu kimi istinad standartı, şişsiz qrupun şiş qrupu ilə eyni klinik populyasiyadan gəlməsi və müstəqil çoxmərkəzli doğrulama lazımdır.
Buna görə bu tədqiqatın mövzusu “MRI-da beyin şişini %94 dəqiqliklə diaqnoz edən kvant sistemi” deyil. Tədqiqatın əsas mövzusu, kvant ara qatının uyğunlaşdırılmış klassik nəzarətlə müqayisədə əlavə təsnifat dəyəri verib-vermədiyi və məlumat sızmasının bu cür benchmark-ları necə yanıltmasıdır.
Mənbə və Metod Qeydi
Orijinal başlıq: Does the Quantum Layer Help? A Leakage-Aware Benchmark of Hybrid Quantum–Classical Models for Brain Tumor MRI Classification
Müəlliflər: Tuan-Linh Duong; Pande Wikantyasa Maswita; Tony Sumaryada; Sitti Yani; Thanh-Tai Duong; Hiba Omer; Nissren Tamam; Abdelmoneim Sulieman.
Müəllif sırası: Mənbə PDF və rəsmi nəşr qeydi ilə uyğundur.
Bərabər töhfə: Mənbədə bərabər birinci müəlliflik/bərabər töhfə işarəsi bildirilməmişdir.
Məsul müəllif: Thanh-Tai Duong.
Qurum 1: The Laboratory Center, Hanoi University of Public Health, Hanoi 100000, Vietnam.
Qurum 2: Department of Physics, Faculty of Mathematics and Natural Sciences, IPB University, Bogor 16680, Indonesia.
Qurum 3: Department of Medical Physics, Faculty of Medicine, Nguyen Tat Thanh University, Ho Chi Minh City 700000, Vietnam.
Qurum 4: Department of Radiological Sciences, College of Applied Medical Sciences, Imam Abdulrahman Bin Faisal University, Dammam 34212, Saudi Arabia.
Qurum 5: Department of Physics, College of Sciences, Princess Nourah bint Abdulrahman University, Riyadh 11671, Saudi Arabia.
Qurum 6: Department of Radiological Sciences, College of Applied Medical Sciences, King Saud bin Abdulaziz University for Health Sciences, Al Ahsa 31982, Saudi Arabia.
Qurum 7: Imaging Physics Section, Research and Innovation Department, King Faisal Specialist Hospital & Research Center, Riyadh 11211, Saudi Arabia.
Mənbə növü: Rəyli orijinal tədqiqat məqaləsi.
Jurnal: Diagnostics.
Nəşriyyat: MDPI.
Cild / say / məqalə nömrəsi: 16 / 21 / 3485.
DOI: 10.3390/diagnostics16213485.
Qəbul edilmə tarixi: 7 oktyabr 2026.
Reviziya: 17 oktyabr 2026.
Qəbul: 21 oktyabr 2026.
Nəşr: 24 oktyabr 2026.
Rəyçilik statusu: Rəyli jurnal məqaləsidir.
Lisenziya: Creative Commons Attribution (CC BY).
Rəsmi nəşr: Diagnostics 2026, 16, 3485; DOI 10.3390/diagnostics16213485.
Əsas elmi sahə: Quantum machine learning, medical image classification, deep learning benchmarking və data-leakage auditing.
Əsas tapşırıq: Glioma, meningioma, hipofiz şişi və şişsiz MRI kəsiklərinin dörd sinifli təsnifatı.
Əsas kvant modeli: Angle encoding istifadə edən, altı-kubit və iki variasiyalı qatlı hardware-efficient dressed VQC; ablasiyalarda 2–10 kubit və 1–6 qat qiymətləndirilmişdir.
Real kvant avadanlığı: İstifadə edilməmişdir. Bütün kvant dövrələri klassik avadanlıq üzərində simulyasiya edilmişdir.
Əsas qiymətləndirmə protokolu: Patient-grouped five-fold cross-validation (Protocol 3).
Əsas nəticə: Araşdırılan VQC qatı sınaqdan keçirilən üç əsas təlim rejimində uyğunlaşdırılmış klassik qatın dəqiqliyini artırmamışdır.
Məlumat dəstinin əsas problemi: Rəsmi test görüntülərinin %79-u təlim bölməsindəki bir surətlə əlaqəlidir və figshare mənşəli test görüntülərinin 915/917-si təlimdə eyni xəstə ilə üst-üstə düşür.
Statistika: Frozen-feature müqayisələrində Wilcoxon signed-rank, Friedman testi, bootstrap %95 GA, linear mixed model və variance-corrected resampled t-test; end-to-end müqayisələrində exact McNemar, patient/duplicate-group cluster bootstrap və ±1 pp equivalence margin istifadə edilmişdir.
Implementation: Python, PyTorch 2.14.0, timm 1.0.30, scikit-learn 1.8.0; PennyLane 0.45.1 yalnız simulyatorun doğrulanması üçün istifadə edilmişdir. End-to-end təlim NVIDIA GeForce RTX 3090 24 GB GPU-da aparılmışdır.
Generative AI istifadə bəyanatı: Mənbə Claude-un Opus model ailəsinin analiz kodunun yazılması və debug edilməsi, həmçinin statistik analizlərin aparılmasında müəlliflərin istiqamətləndirməsi altında istifadə edildiyini; analizlərin müəlliflər tərəfindən müəyyən edildiyini, kod və nəticələrin yoxlanıldığını və kodun yayımlandığını bildirir.
Məlumatların əlçatanlığı: Brain Tumor MRI Dataset 2-ci versiya Kaggle-da açıqdır; məlumat dəstinin DOI-si 10.34740/KAGGLE/DSV/2645886-dır. Məqalə məlumat dəstinin 28 sentyabr 2026-cı ildə endirildiyini bildirir. Dataset audit kodu, quantum circuit simulator, self-test-lər, təcrübələr, statistik analizlər, leakage-aware split-lər, duplicate/patient annotations, checksum manifest, model proqnozları və nəticə cədvəlləri müəlliflərin bildirdiyi GitHub deposunda yayımlanmışdır. Məlumat dəsti görüntülərinin özü yenidən paylanmır.
Etik komitə: Yalnız açıq və tam anonimləşdirilmiş məlumat istifadə edildiyinə görə etik baxış və təsdiqdən imtina edilmişdir.
Xəstə razılığı: Yalnız açıq, anonimləşdirilmiş görüntülər istifadə edildiyinə görə razılıqdan imtina edilmişdir.
Maliyyələşdirmə: Princess Nourah bint Abdulrahman University Researchers Supporting Project, PNURSP2026R12. Məqalə emal haqqı da Princess Nourah bint Abdulrahman University tərəfindən maliyyələşdirilmişdir.
Maraqların toqquşması: Müəlliflər maraqların toqquşması bildirməmişdir. Maliyyələşdirən qurumların tədqiqat dizaynı, məlumat toplama/analiz/şərh, yazı və ya nəşr qərarında rolu olmadığı bildirilmişdir.
Müəllif töhfələri: Conceptualization: P.W.M., T.-L.D., S.Y., T.-T.D.; methodology: P.W.M., T.-L.D.; software: P.W.M., T.-L.D.; formal analysis: T.-L.D.; investigation: P.W.M., T.-L.D., T.S.; data curation: T.-L.D.; visualization: T.-L.D.; original draft: P.W.M., T.-L.D.; review and editing: bütün müəlliflər; supervision: S.Y., T.S., T.-T.D.; project administration: S.Y.; funding acquisition: S.Y., N.T.
Əsas şərh sərhədi: Nəticələr bu məlumat dəstində və sınaqdan keçirilən kiçik simulyasiya olunmuş VQC ailəsində kvant qatının əlavə dəqiqlik vermədiyini göstərir. Tədqiqat bütün quantum machine learning modellərini, real kvant avadanlığını və ya klinik MRI diaqnozunu ümumilikdə etibarsız etmir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib