


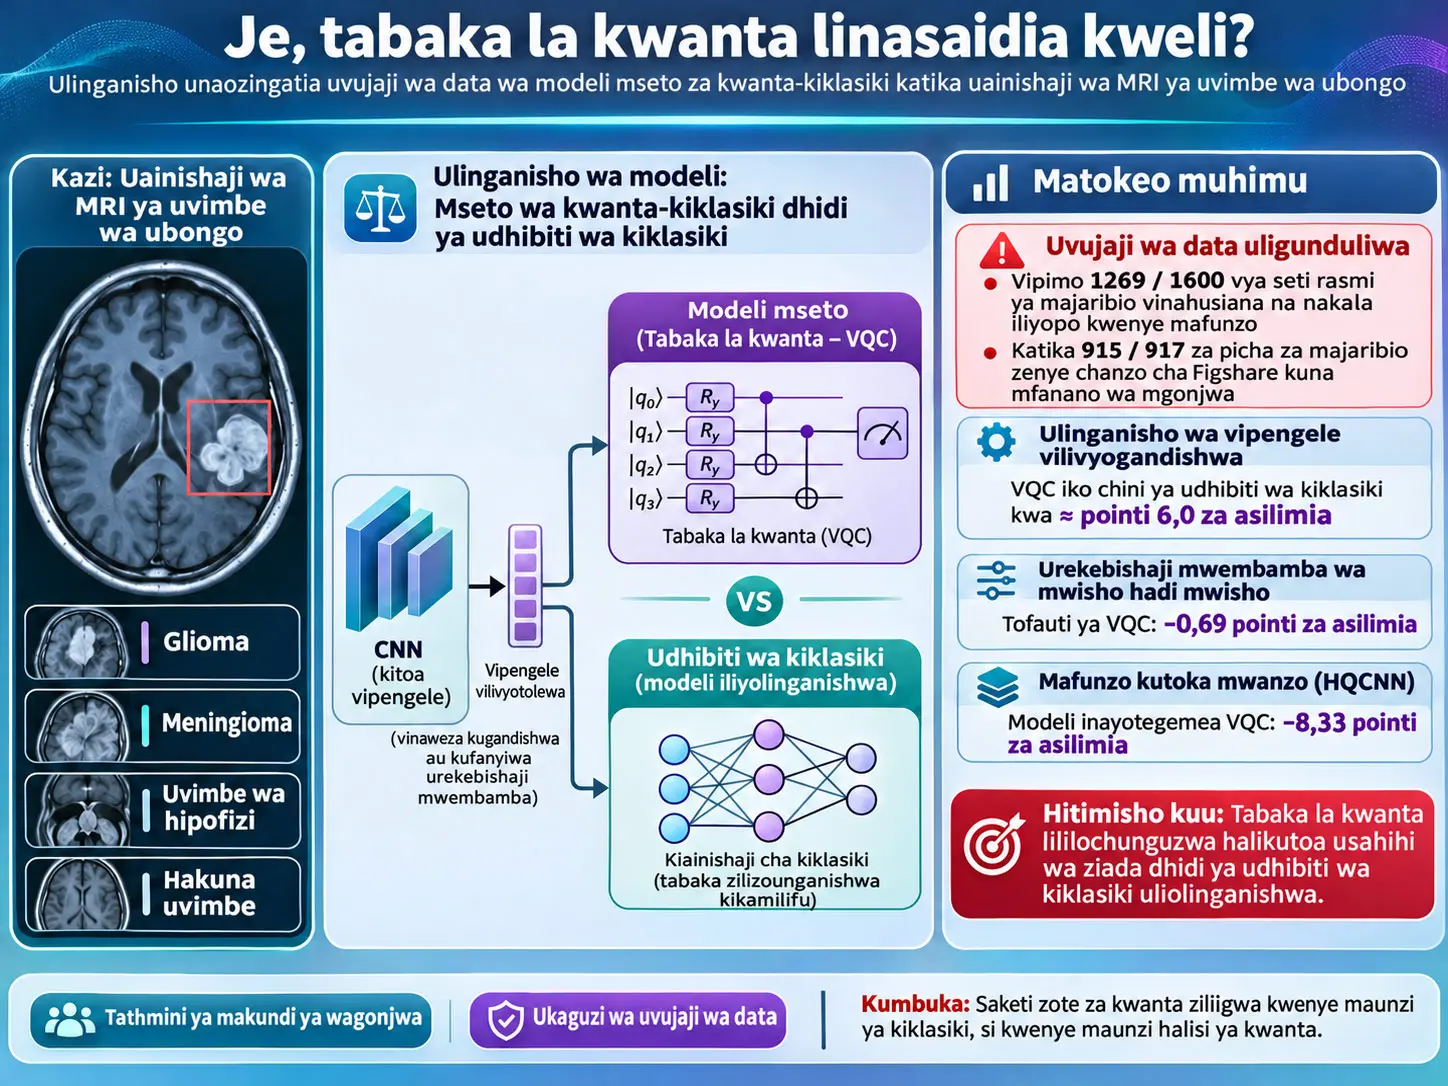
Saketi ya kwanta ya vigezo (variational quantum circuit, VQC), ni saketi ya kwanta yenye vigezo inayosimba vipengele vya picha za kiklasiki katika pembe za mizunguko ya kwanta, kuchakata hali hiyo iliyosimbwa kwa milango ya kwanta inayoweza kujifunza, na kurudisha thamani za matarajio za Pauli-Z zilizopimwa kwenye tabaka la uainishaji wa kiklasiki. Utafiti huu ulijaribu kama tabaka kama hilo la VQC linalotumiwa katika uainishaji wa picha za resonance ya sumaku za uvimbe wa ubongo (magnetic resonance imaging, MRI) kweli linachangia usahihi wa uainishaji, kwa kulilinganisha na tabaka za udhibiti wa kiklasiki zenye upana uleule na chini ya masharti yale yale ya mafunzo. Wakati huohuo, uvujaji wa data kati ya mafunzo–testi, mwingiliano wa wagonjwa na vidokezo vya njia za mkato vinavyotegemea chanzo cha picha katika seti ya data ya MRI ya umma iliyotumiwa vilikaguliwa kwa kina.
Katika utafiti, toleo la 2 la Kaggle Brain Tumor MRI Dataset lililotolewa tarehe 13 Februari 2026 lilitumika. Seti ya data ina jumla ya vipande 7200 vya JPEG MRI vya pande mbili: kuna picha 1800 katika kila mojawapo ya madarasa manne, yaani glioma, meningioma, uvimbe wa pituitari na bila uvimbe. Mgawanyo rasmi una picha 5600 za mafunzo na picha 1600 za testi. Kutokana na ulinganishaji na makusanyo ya chanzo, utambulisho wa mgonjwa uliweza kurejeshwa kwa picha 4846 za uvimbe.
Ukaguzi wa data ulionyesha kuwa kulikuwa na uvujaji mkubwa licha ya matarajio ya “mwingiliano wa mafunzo–testi umeondolewa” katika maelezo rasmi ya seti ya data. Kwa ukaguzi unaostahimili uakisi na mzunguko, ilibainika kuwa picha 1269 kati ya picha 1600 za testi rasmi, yaani takriban %79, zilihusishwa na kundi lilelile la duplicate kama picha fulani katika sehemu ya mafunzo. Kati ya picha 917 za testi zenye asili ya Figshare, 915 zilishiriki mgonjwa yuleyule na angalau picha nyingine moja katika sehemu ya mafunzo. Picha 87 tu za testi rasmi ziliunda seti ndogo ya “strict-clean” iliyokuwa huru na nakala zilizogunduliwa pamoja na mwingiliano wa wagonjwa unaojulikana.
Ulinganisho mkuu wa watafiti ni kati ya head ya VQC yenye kubiti sita na tabaka mbili za variational na udhibiti wa kiklasiki wenye upana uleule wa ingizo/tokeo wa Linear(6,6) + tanh. Katika uthibitishaji mtambuka wa fold tano uliopangwa kwa wagonjwa juu ya frozen ImageNet features, VQC ilionyesha usahihi wa wastani ulio chini kwa asilimia-pointi 6,03 kuliko udhibiti wa kiklasiki uliolinganishwa; kipindi cha kujiamini cha %95 kilikuwa kati ya asilimia-pointi −6,78 na −5,20. VQC pia ilitoa usahihi wa chini kuliko udhibiti wa kiklasiki wa kina zaidi na kuliko modeli ya kiklasiki ya Fourier surrogate inayofunika darasa la funksi ambalo saketi ya kwanta inaweza kukokotoa.
Katika fine-tuning ya end-to-end, tofauti ilipungua. Wakati recipe ya kwanza ya mafunzo ilipotumiwa, EfficientNet-B0 + VQC ilitoa usahihi wa %94,1 na udhibiti wa kiklasiki %94,2, na tofauti yao ya asilimia-pointi −0,07 ilibaki ndani ya mpaka wa ulinganifu wa ±1 asilimia-pointi. Hata hivyo, katika mafunzo marefu zaidi yanayotegemea convergence, VQC ilitoa usahihi wa %93,8 na udhibiti wa kiklasiki %94,5; tofauti ya VQC ilikuwa asilimia-pointi −0,69 (%95 GA −1,25 hadi −0,13) na ulinganifu ndani ya mpaka wa ±1 asilimia-pointi haukuweza kutangazwa. HQCNN mseto wa kwanta–kiklasiki uliofunzwa kutoka mwanzo ulitoa usahihi wa %67,9, ukiwa nyuma kwa asilimia-pointi 8,33 ya udhibiti wake wa kiklasiki wenye %76,2.
Utafiti haujumlishi matokeo haya kuwa “machine learning ya kwanta haifanyi kazi kamwe”. Hitimisho linatumika tu kwa usanifu wa dressed VQC uliochunguzwa, data ya MRI ya kiklasiki iliyotumiwa, masafa ya kubiti 2–10, na encoding pamoja na modeli za udhibiti zilizochunguzwa. Aidha, saketi zote za kwanta ziliigwa kwenye kompyuta ya kiklasiki; hakuna mafunzo au inference iliyofanywa kwenye processor halisi ya kwanta. Usahihi ulioripotiwa haupaswi kufasiriwa kuwa usahihi wa uchunguzi wa kliniki.
Swali kuu la utafiti ni lipi?
Kuona usahihi wa jumla ulio juu katika tafiti za uainishaji wa picha kwa mifumo mseto ya kwanta–kiklasiki hakuthibitishi peke yake kwamba tabaka la kwanta lina manufaa halisi. Sababu ni kwamba sehemu kubwa ya mtandao mseto bado inaweza kuwa ya kiklasiki: CNN inayotoa vipengele vya picha, projection ya mstari inayozalisha ingizo la saketi ya kwanta na tabaka la kutoka linalobadilisha vipimo vya kwanta kuwa madarasa ni vipengele vya kiklasiki.
Kwa hiyo, swali kuu la utafiti si tu “modeli mseto ilitoa usahihi wa asilimia ngapi?”. Swali lenye nguvu zaidi ni hili: Je, utendaji kweli hushuka wakati backbone ileile ya kiklasiki, data ileile, itifaki ileile ya mafunzo na upana uleule wa bottleneck vinahifadhiwa, na saketi ya kwanta pekee inabadilishwa na tabaka la kiklasiki lenye upana uleule?
Ikiwa jibu ni hapana, haiwezekani kuhusisha utendaji wa juu wa jumla na tabaka la kwanta.
Uvujaji wa Data ni Nini na Kwa Nini ni Tatizo Muhimu katika Utafiti Huu?
Uvujaji wa data ni hali ambapo, badala ya kutathmini data ambayo kwa kweli haijaonekana katika hatua ya testi, picha ileile, nakala iliyochakatwa yake au picha zinazofanana sana kutoka kwa mgonjwa yuleyule zimeonyeshwa kwa modeli kwa njia isiyo ya moja kwa moja wakati wa mafunzo; katika utafiti huu, kwa kuwa %79 ya seti rasmi ya testi ilihusishwa na nakala katika mafunzo na picha 915 kati ya 917 za testi zenye asili ya figshare ziliingiliana na mgonjwa yuleyule katika mafunzo, ilibainika kuwa sehemu muhimu ya usahihi wa juu wa testi inaweza kuonyesha utendaji halisi wa generalization kuwa juu kuliko ulivyo.
Exact duplicate na near-duplicate si kitu kilekile
Watafiti walitafuta aina kadhaa za uvujaji kila moja kando.
- Exact duplicate: Picha ambazo safu zao za pikseli ni sawa kabisa. Hizi ziligunduliwa kwa MD5 checksum ya safu ya pikseli iliyodecode.
- Near-duplicate: Mifano iliyosimbwa upya kwa JPEG, iliyobadilishwa ukubwa au yenye tofauti ndogo za uchakataji lakini kimsingi ikibeba picha ileile.
- Mirrored copy: Nakala za picha zilizopitia mabadiliko ya uakisi wa mlalo/wima au uakisi mwingine.
- Rotated/flipped copy: Nakala zinazopatikana kwa mojawapo ya mabadiliko nane ya mzunguko na uakisi wa picha ya mraba.
- Patient overlap: Kuwepo kwa vipande tofauti vya MRI vya mgonjwa yuleyule katika seti za mafunzo na testi hata kama picha si sawa kabisa.
Wagombea wa near-duplicate walichunguzwa kwa 64-bit perceptual hash (pHash), kwa sharti kwamba umbali wa Hamming uwe si zaidi ya 8 bit. Kisha normalized cross-correlation (normalized cross-correlation, NCC) kati ya thumbnail za pikseli 64 × 64 za jozi wagombea ilitakiwa kuwa angalau 0,95.
Umbali wa Hamming ni idadi ya biti zinazotofautiana kati ya mifuatano miwili ya biti. Kwa mfano, ikiwa umbali wa Hamming kati ya pHash mbili za 64-bit ni 8, thamani za biti hutofautiana katika nafasi nane kati ya 64. Umbali mdogo wa Hamming unaashiria kwamba miundo ya kuona inafanana; hata hivyo, haukuchukuliwa kuwa wa kutosha peke yake na uthibitishaji wa NCC pia ulitumika.
NCC ni kipimo cha correlation kilichonormalishwa kinachopima ufanano wa mstari wa mifumo miwili ya picha. Kizingiti cha 0,95 katika utafiti kilitumika kama ukaguzi wa pili kwamba wagombea waliotolewa na pHash kweli walikuwa picha zinazofanana sana.
Kwa nini uakisi na mzunguko vilikuwa muhimu hasa?
pHash ya kawaida si invariant kwa uakisi na mzunguko. Hivyo, hata kama picha ya kioo ya kipande cha MRI inaonekana wazi kwa jicho la binadamu kuwa picha ileile, huenda isionekane karibu vya kutosha katika ulinganisho wa moja kwa moja wa pHash. Kwa hiyo watafiti walitathmini mabadiliko nane ya mzunguko/uakisi ya kila picha kwenye mraba na kutumia umbali mdogo zaidi wa Hamming pamoja na thamani ya NCC inayolingana.
Wakati ukaguzi wa kwanza ulipata jozi 385 za exact na 6162 za near-duplicate, ukaguzi uliorekebishwa unaostahimili mabadiliko ulitambua kwa nyongeza jozi 7915 zilizoakisiwa na 10.161 zilizozungushwa/kugeuzwa. Jumla ya duplicate-pair ilifikia 24.623 na 9699 kati ya hizo zilivuka mpaka wa mafunzo–testi.
| Kipimo | Matokeo ya chanzo | Tafsiri |
|---|---|---|
| Jumla ya picha | 7200 | Picha 1800 katika kila moja ya madarasa manne |
| Mafunzo / testi rasmi | 5600 / 1600 | 1400 mafunzo + 400 testi katika kila darasa |
| Jumla ya jozi duplicate zilizogunduliwa | 24.623 | Jumla ya jozi exact, near, mirrored na rotated/flipped |
| Jozi duplicate zinazovuka mpaka wa mafunzo–testi | 9699 | Mahusiano yanayoathiri moja kwa moja mgawanyo rasmi |
| Picha za testi zenye nakala katika mafunzo | 1269 / 1600 (%79) | Ukaguzi uliorekebishwa ukijumuisha mifano augmented |
| Mwingiliano wa wagonjwa katika picha za testi zenye asili ya Figshare | 915 / 917 | Mgonjwa yuleyule pia yupo katika sehemu ya mafunzo |
| Testi strict-clean isiyo na nakala yoyote au uhusiano wa mgonjwa unaojulikana | 87 | 74 glioma, 11 meningioma, 2 uvimbe wa pituitari; hakuna mfano usio na uvimbe |
Kwa nini chanzo cha data kilichunguzwa pia?
Kutoka kwa darasa lilelile la uvimbe kwenye vifaa tofauti, sequence tofauti za MRI, matrix tofauti za picha au minyororo tofauti ya uchakataji wa JPEG kunaweza kuunda njia ya mkato isiyotakiwa kwa modeli. Badala ya kujifunza morphology ya uvimbe, modeli inaweza kujifunza picha ilitoka katika chanzo gani cha data.
Kwa hiyo watafiti walifundisha gradient-boosting classifiers kwa vipengele visivyobeba mwonekano wa kina wa uvimbe, kama upana wa picha, urefu, aspect ratio, hali ya kuwa 512 × 512, color mode, ukubwa wa faili ya JPEG, takwimu za global intensity na hata thumbnail ya pikseli 8 × 8 tu.
Kwa kutumia tu ukubwa wa picha, aspect ratio na color mode, utenganishaji wa uvimbe–bila uvimbe uliwezekana kwa usahihi wa %91,8. Kwa kutumia thumbnail ya 8 × 8 pekee, usahihi wa madarasa manne ulikuwa %78,9; kiwango cha bahati nasibu kilikuwa %25. Hata chini ya Protocol 3 iliyopangwa kwa wagonjwa, thumbnail hii ghafi ilitoa usahihi wa %78,1.
Hata baada ya picha kustandardishwa na vidokezo vingi kama background, mipaka, ukubwa wa matrix na intensity scale kuondolewa, thumbnail ya 8 × 8 ilitoa usahihi wa %69,7 katika madarasa manne. Matokeo haya yanaonyesha kwamba lebo za madarasa katika seti ya data zinaweza kutabiriwa si kutokana na mwonekano wa tishu za uvimbe pekee, bali pia kutokana na ishara nyingine kama chanzo cha imaging na anatomy ya jumla.
Kwa nini picha 76 za glioma za “out-of-source” ni muhimu?
Kati ya picha 400 za glioma katika sehemu rasmi ya testi, 76 zinatoka kwenye chanzo na distribution ya imaging tofauti na picha za glioma za mafunzo. Wakati picha zote 1400 za glioma za mafunzo ziko katika muundo wa figshare wa 512 × 512, picha hizi 76 zilikuwa katika ukubwa 61 tofauti wa matrix.
Ulinganishaji wa chanzo ulionyesha kuwa picha hizi 76 ni nakala za pikseli za picha za glioma za testi katika mkusanyo wa SARTAJ. Hivyo, si “wagonjwa wapya” tu bali pia ni chanzo cha data ambacho modeli haikuwahi kuona wakati wa mafunzo kwa darasa la glioma.
Ingawa modeli fine-tuned zilifikia karibu %94 katika usahihi wa jumla uliopangwa kwa wagonjwa, zilionyesha usahihi wa %46,1–61,8 tu kwenye picha hizi 76. Tofauti hii inaonyesha wazi kwa nini ni muhimu kutenganisha usahihi wa jumla kulingana na chanzo cha data.
Makosa ya lebo yanayoweza kuwepo
Uchunguzi wa confident-learning uliashiria picha 28 kati ya picha 6997 zisizo augmented kuwa zinaweza kuwa na kosa la lebo. Kati ya hizo, 19 zilikuwa na asili ya figshare. Annotation asilia ya Figshare iliunga mkono lebo iliyopo katika 15, huku katika picha nne iliunga mkono darasa mbadala lililopendekezwa na modeli.
Chanzo hakiziiti picha hizi 28 “lebo zilizokosewa kwa uhakika”. Kwa kuwa hakuna ukaguzi huru wa radiologist uliofanywa, hizi ni candidate label errors, yaani wagombea wanaohitaji ukaguzi wa mtaalamu, na hazikuondolewa kwenye seti ya data katika uchanganuzi wowote mkuu.
Saketi ya Kwanta ya Vigezo Inafanya Nini Hasa katika Modeli Hii?
Dressed VQC katika utafiti kwanza hubana vipengele vya dimensionality ya juu kutoka kwenye backbone ya CNN ya kiklasiki kuwa pembe n, husimba pembe hizo katika mizunguko ya RY ya kubiti n, huzichakata kwa mizunguko ya kubiti moja inayoweza kujifunza na pete za CNOT, hupima thamani ya matarajio ya Pauli-Z kwenye kila kubiti, na hubadilisha namba halisi n zinazopatikana kuwa logit za kiklasiki za madarasa manne ya MRI; kwa hiyo saketi ya kwanta si modeli yote, bali ni tabaka dogo la kati kati ya feature extractor ya kiklasiki na tabaka la kutoka la kiklasiki.
Kubiti ni nini?
Wakati biti ya kiklasiki hufafanuliwa tu katika hali 0 au 1, kubiti inaweza kuwa, kabla ya kipimo, katika superposition ya kwanta ya hali mbili za msingi inayofafanuliwa kwa amplitude changamani. Hali ya jumla ya kubiti moja inaweza kuandikwa kimawazo kama:
\[ |\psi\rangle=\alpha|0\rangle+\beta|1\rangle, \qquad |\alpha|^2+|\beta|^2=1 \]
Hii inaweza kuandikwa kwa namna hiyo. Usemi huu si matokeo mapya ya utafiti; ni uwakilishi wa msingi wa mechanics ya kwanta unaoeleza dhana ya kubiti katika VQC.
Mlinganyo (1): Vipengele vya kiklasiki hubadilishwaje kuwa pembe za kwanta?
Katika chanzo, uzalishaji wa pembe zitakazoingia kwenye saketi ya kwanta kutoka kwa vector ya vipengele vya kiklasiki ni:
\[ \mathbf{x} = \frac{\pi}{2} \tanh(W\mathbf{f}+\mathbf{b}) \in \left(-\frac{\pi}{2},\frac{\pi}{2}\right)^n \tag{1} \]
kwa namna hiyo.
Hapa:
- \(\mathbf{f}\), ni vector ya vipengele yenye dimension \(d\) kutoka kwenye backbone ya kiklasiki.
- \(W\), ni matrix ya transformation ya mstari inayoweza kujifunza.
- \(\mathbf{b}\), ni vector ya bias inayoweza kujifunza.
- \(\tanh\), ni funksi ya hyperbolic tangent inayotumika kwa kila elementi.
- \(\mathbf{x}=(x_1,\ldots,x_n)\), ina pembe \(n\) za mzunguko zitakazosimbwa kwenye saketi ya kwanta.
- \(n\), pia ni idadi ya kubiti katika VQC.
Kwa kuwa tokeo la \(\tanh\) liko kati ya −1 na +1, linapozidishwa kwa \(\pi/2\) kila pembe hufungwa kati ya \(-\pi/2\) na \(+\pi/2\). Hivyo maelfu ya vipengele vya CNN ya kiklasiki hayapakiiwi moja kwa moja kwenye maelfu ya kubiti; kwanza hubanwa katika bottleneck ndogo yenye dimension \(n\).
Katika modeli kuu ya kubiti sita, kwa mfano, vector ya pooled features yenye dimension 1280 ya EfficientNet-B0 kwanza hupunguzwa hadi pembe sita tu. Upunguzaji huu wa dimensionality wenyewe ni bottleneck muhimu ya taarifa na unapaswa kuzingatiwa wakati wa kufasiri hesabu inayofuata ya saketi ya kwanta.
Milango ya Hadamard na RY hufanya nini?
Kila kubiti huanza katika hali \(|0\rangle\). Katika saketi ya chanzo, kwanza lango la Hadamard (\(H\)) linatumika, likifuatiwa na mzunguko \(R_Y(x_i)\).
Lango la Hadamard huhamisha kubiti kutoka hali ya msingi kwenda kwenye superposition ya hali mbili za msingi. \(R_Y(x_i)\), kwa upande mwingine, hufanya mzunguko wa pembe \(x_i\) kuzunguka mhimili Y kwenye Bloch sphere. Hivyo pembe ya namba inayotokana na vipengele vya kiklasiki husimbwa katika amplitude za hali ya kwanta.
Lango la Rot linaloweza kujifunza
Katika kila tabaka la variational, kwa kila kubiti hutumika:
\[ \operatorname{Rot}(\alpha,\beta,\gamma) = R_Z(\gamma)R_Y(\beta)R_Z(\alpha) \]
mzunguko wa jumla wa kubiti moja wenye pembe tatu zinazoweza kujifunza.
Kwa kuwa katika kubiti sita na tabaka mbili za variational kuna vigezo vitatu kwa kila kubiti kwa kila tabaka, idadi ya vigezo vinavyoweza kujifunza vya saketi ya kwanta ni:
\[ 6\times2\times3=36 \]
.
Pete ya CNOT na quantum entanglement
Baada ya mizunguko ya kubiti moja, kubiti ziliunganishwa kwa pete ya controlled-NOT (CNOT). Katika pete hiyo, kubiti \(i\) hudhibiti kubiti \(i+1\), na baada ya kubiti ya mwisho index hurudi kwenye kubiti ya kwanza.
Milango ya kubiti mbili kama CNOT inaweza kuunda quantum entanglement kati ya kubiti katika hali zinazofaa za ingizo. Hata hivyo, mojawapo ya matokeo muhimu ya ablation katika utafiti huu ni kwamba kuondoa pete ya CNOT hakukupunguza usahihi; kinyume chake, kuliuongeza katika jaribio kuu la kubiti sita. Kwa hiyo, tafsiri ya kwamba “entanglement ilitumika, kwa hiyo faida ilitokana na quantum entanglement” haiungwi mkono na chanzo.
Mlinganyo (2): Hali ya kwanta ya VQC
Mlinganyo wa saketi katika chanzo unaonyesha usimbaji wa pembe na tabaka \(L\) za variational katika muundo huu wa jumla:
\[ |\psi(\mathbf{x};\boldsymbol{\theta})\rangle = U_{\mathrm{ent}}R(\boldsymbol{\theta}^{(L)}) \cdots U_{\mathrm{ent}}R(\boldsymbol{\theta}^{(1)}) \left[ \bigotimes_{i=1}^{n} R_Y(x_i)H \right] |0\rangle^{\otimes n} \tag{2} \]
Hapa:
- \(|0\rangle^{\otimes n}\), ni hali ya mwanzo ya kubiti zote \(n\).
- \(\bigotimes\), inaonyesha kuwa operesheni zinatumika kwa kubiti tofauti kwa tensor product.
- \(R_Y(x_i)\), ni usimbaji wa pembe ya kiklasiki ya \(i\) kwenye kubiti husika.
- \(R(\boldsymbol{\theta}^{(\ell)})\), inawakilisha muundo wa jumla wa mizunguko ya kubiti moja inayoweza kujifunza katika tabaka la \(\ell\).
- \(U_{\mathrm{ent}}\), ni tabaka la entanglement linaloundwa na pete ya CNOT.
- \(L\), ni idadi ya tabaka za variational.
- \(\boldsymbol{\theta}\), ni vigezo vyote vya saketi ya kwanta vinavyoweza kujifunza.
Katika modeli kuu, \(n=6\) na \(L=2\).
Namba ya kiklasiki hutokaje kwenye saketi?
Kwa kila kubiti, thamani ya matarajio ya operator ya Pauli-Z hupimwa:
\[ z_i = \langle\psi(\mathbf{x};\boldsymbol{\theta})| Z_i |\psi(\mathbf{x};\boldsymbol{\theta})\rangle, \qquad z_i\in[-1,1]. \]
\(Z_i\), inawakilisha kipimo cha Pauli-Z kwenye kubiti ya \(i\) pekee. Thamani ya matarajio si 0 au 1 tu katika kipimo kimoja; ni thamani halisi kati ya −1 na +1 inayokokotolewa kutoka kwenye distribution ya probability inayotolewa na vipimo vingi au simulation ya hali kamili.
Kwa njia hii saketi ya kubiti sita huzalisha namba halisi sita. Tabaka la mwisho la mstari la kiklasiki hubadilisha thamani hizi sita kuwa logit nne za madarasa manne, na uamuzi wa uainishaji hutolewa kupitia tokeo hili la kiklasiki.
Kwa nini udhibiti wa kiklasiki unapaswa kuwa na “upana uleule”?
Kuweka mtandao wa kiklasiki mkubwa sana au mdogo sana badala ya VQC ya kubiti sita kunafanya iwe vigumu kutenganisha kama tofauti ya utendaji inatokana na hesabu ya kwanta au uwezo wa modeli.
Kwa hiyo udhibiti mkuu wa kiklasiki ulitumia Linear(6,6) + tanh sambamba na ingizo sita na matokeo sita ya VQC. Dhidi ya vigezo 36 vya kwanta vinavyoweza kujifunza vya VQC ya kubiti sita, tabaka la kati la kiklasiki lina vigezo 42.
Utafiti ulikubali kwamba hata hili halitoi “usawa wa nguvu ya uwakilishi” kikamilifu, na ukatumia vidhibiti viwili vya ziada vya kiklasiki:
- Deeper control: tabaka mbili za
Linear(6,6) + tanh; vigezo 84 vya tabaka la kati. - Fourier surrogate: vipengele vya trigonometria vya kiklasiki vinavyofunika darasa la funksi ambalo VQC inaweza kukokotoa chini ya usimbaji wa pembe wa mara moja, \(3^6=729\).
Umuhimu wa Fourier surrogate ni mkubwa. Chanzo kinaeleza kwamba kila tokeo la VQC ni polynomial ya trigonometria yenye frequencies \(\{-1,0,1\}\) katika kila pembe ya ingizo. Kwa ingizo sita, ukubwa wa basis ya bidhaa inayowezekana ni:
\[ 3^6=729 \]
Kila kipengele katika basis hii ni:
\[ \prod_i g_i(x_i), \qquad g_i\in\{1,\cos x_i,\sin x_i\} \]
Kwa hiyo, modeli ya kiklasiki ya mstari inaweza kuwakilisha darasa la funksi ambalo muundo huu wa saketi unaweza kuzalisha. Katika utafiti, surrogate hii ilikuwa sahihi zaidi kuliko VQC.
Je, matokeo ya “barren plateau” yalithibitishwa?
Hapana. Kushuka kwa usahihi wa saketi za kubiti nane na kumi na hitaji la modeli ya kwanta la mafunzo marefu zaidi kulionekana na waandishi kuwa kunaoana na mandhari bapa za optimization zinazojulikana katika saketi za kwanta; hata hivyo, utafiti haukupima moja kwa moja variance ya gradient na kuthibitisha kuwepo kwa barren plateau.
Je, saketi ya kwanta iliendeshwa kwenye hardware halisi ya kwanta?
Hapana. Saketi zisizo na noise ziliigwa kikamilifu kwenye CPU/GPU za kiklasiki kwa batched state-vector simulator iliyoandikwa kwa PyTorch. Saketi zenye noise zilikokotolewa kwa density-matrix simulation. PennyLane ilitumika tu kuthibitisha tokeo la simulator iliyotengenezwa.
Kwa hiyo, thamani za latency kama 18,8 ms katika utafiti si muda wa uendeshaji wa processor ya kwanta. Hizi ni nyakati za forward-pass za GPU ya kiklasiki kwenye RTX 3090, zikijumuisha simulation ya saketi ya kwanta.
Modeli ya depolarizing noise
Katika jaribio la noise, channel ya depolarization ya kubiti moja ilitumika kwa kila kubiti baada ya kila gate layer:
\[ \rho \rightarrow (1-p)\rho + \frac{p}{3} \left( X\rho X+Y\rho Y+Z\rho Z \right). \]
Hapa:
- \(\rho\), ni hali ya density matrix ya kubiti.
- \(p\), ni uwezekano wa kutumia kosa la Pauli katika tabaka hili.
- \(X,Y,Z\), ni operator za Pauli.
\(p=0\) inawakilisha simulation bora isiyo na noise, na \(p\) kubwa inawakilisha depolarization yenye nguvu zaidi. Katika chanzo, thamani \(p=\{0{,}001,0{,}003,0{,}01,0{,}03,0{,}1\}\) zilijaribiwa.
Modeli hii haijumuishi vyanzo vyote vya makosa ya hardware halisi. Crosstalk, readout error, topolojia yenye connectivity yenye mipaka na gharama halisi ya gate decomposition hazikujumuishwa katika modeli.
“Shot” inamaanisha nini?
Katika kompyuta halisi ya kwanta, thamani ya matarajio haipatikani kwa uhakika kutokana na kipimo kimoja. Saketi ileile huendeshwa mara nyingi na takwimu za matokeo ya vipimo hutumiwa. Maandalizi na kipimo cha saketi mara moja kwa kawaida huitwa shot.
Katika utafiti, matokeo \(S\) yalichukuliwa sampuli kutoka exact outcome probability distribution ili kuiga athari ya finite-shot. Idadi za shot zilizojaribiwa ni:
\[ S\in\{16,64,256,1024,4096\} \]
.
Quantum kernel ni nini?
Kando na majaribio ya model-head, watafiti pia walilinganisha quantum-kernel support vector machine (SVM) na radial basis function (RBF) kernel SVM ya kiklasiki.
Vipengele vya EfficientNet-B0 kwanza vilipunguzwa kwa principal component analysis (PCA) kuwa components 4, 6, 8 au 10 na kuscale kwenye masafa [0,1]. ZZ feature map ilitumika kwa quantum kernel.
Ufanano wa kernel kati ya ingizo mbili ulifafanuliwa kwa fidelity ya hali za kwanta:
\[ k(\mathbf{x},\mathbf{x}') = \left| \langle\psi(\mathbf{x})|\psi(\mathbf{x}')\rangle \right|^2. \]
Mraba wa absolute value ya inner product ni thamani ya ufanano kati ya 0 na 1. Hufikia 1 kwa hali ileile ya kwanta; inaweza kupungua kadiri hali zinavyotofautiana zaidi.
Kilinganishi cha kiklasiki kilitumia RBF kernel kwenye ingizo zilezile za PCA. Hivyo kernel mbili zililinganishwa juu ya taarifa ileile ya ingizo ya dimensionality ya chini.
Mbinu na Matokeo ya Utafiti
Brain Tumor MRI Dataset toleo la 2
| Darasa | Mafunzo | Testi | Jumla |
|---|---|---|---|
| Glioma | 1400 | 400 | 1800 |
| Meningioma | 1400 | 400 | 1800 |
| Uvimbe wa pituitari | 1400 | 400 | 1800 |
| Hakuna uvimbe | 1400 | 400 | 1800 |
| Jumla | 5600 | 1600 | 7200 |
Mkusanyo wa Figshare una vipande 3064 vya MRI vyenye contrast na T1-weighted kutoka kwa wagonjwa 233, na hutoa aina ya uvimbe pamoja na mask ya uvimbe iliyochorwa kwa mkono na utambulisho asilia wa wagonjwa. Ulinganishaji wa provenance wa utafiti uliweza kulinganisha picha 4846 kati ya picha 5400 za uvimbe katika seti ya Kaggle kuwa zenye asili ya figshare.
Vyanzo vya picha za uvimbe zilizobaki vilichunguzwa kwa ulinganishaji na mkusanyo wa SARTAJ. Taarifa za JPEG quantization table, chroma subsampling na color mode pia zilirekodiwa kama fingerprint ya mnyororo wa uzalishaji/uchakataji.
Itifaki tatu za tathmini
| Itifaki | Muundo | Lengo / mpaka wa tafsiri |
|---|---|---|
| Protocol 1 | Mgawanyo rasmi 5600/1600; picha 800 kutoka mafunzo zinatengwa kwa validation | Imehifadhiwa kupima athari ya leakage na source-shift; si ulinganisho mkuu wa modeli |
| Protocol 2 | Grouped CV ya fold tano; vikundi vya duplicate audit ya kwanza havivunjwi kati ya fold | Njia iliyotumiwa katika uwasilishaji wa kwanza; iligundulika haitoshi baada ya audit iliyorekebishwa |
| Protocol 3 | Vikundi vya duplicate vilivyorekebishwa + picha zote za mgonjwa yuleyule wa figshare zinaunganishwa ili kuunda fold tano | Itifaki kuu ya tathmini; mgonjwa yuleyule anayejulikana au nakala iliyogunduliwa haiwezi kuvuka kati ya fold |
Katika Protocol 3, kila moja ya picha 6997 zisizo augmented hupata utabiri wa testi wa out-of-fold mara moja kamili. Kwa picha ya testi yenye asili ya Figshare, fold iliyofundisha modeli huwa haijaona picha hiyo, nakala yake iliyogunduliwa, wala picha nyingine ya figshare ya mgonjwa yuleyule.
Hata hivyo, chanzo kinataja kizuizi muhimu kilichobaki: picha za uvimbe zisizo za figshare na picha zisizo na uvimbe hazina utambulisho wa mgonjwa. Kwa hiyo uwezekano wa vipande vingine vya uchunguzi uleule ambavyo havijakamatwa na duplicate detector kuangukia fold tofauti haujaondolewa kabisa.
Majaribio ya frozen-feature
Backbone nne za ImageNet-pretrained zilitumiwa tu kama feature extractor zisizobadilika:
| Backbone | Dimension ya feature d |
|---|---|
| EfficientNet-B0 | 1280 |
| DenseNet-121 | 1024 |
| ResNet-50 | 2048 |
| MobileNetV2 | 1280 |
Picha zilibadilishwa kuwa grayscale na kunakiliwa kwenye channels tatu, zikabadilishwa ukubwa kuwa pikseli 256 × 256, zikakatwa katikati kuwa 224 × 224 na kunormalishwa kwa takwimu za ImageNet. Pooled features zilistandardishwa kwa wastani na standard deviation ya kila fold ya mafunzo.
Head nane tofauti zililinganishwa:
- VQC ya kubiti 6, tabaka 2;
- udhibiti wa kiklasiki uliolinganishwa;
- udhibiti wa kiklasiki wa kina zaidi;
- Fourier surrogate;
- bottleneck-only;
- linear probe;
- MLP yenye hidden units 256;
- untrained VQC yenye vigezo vya kwanta vilivyofungiwa kwenye random initialization.
Head zilifundishwa kwa Adam optimizer; weight decay \(10^{-4}\), batch size 128 na kiwango cha juu cha epoch 80 vilitumika. Ikiwa validation loss haikuboreka kwa epoch tano, learning rate ilipunguzwa nusu; ikiwa haikuboreka kwa epoch kumi, mafunzo yalisimamishwa. Learning rate ya mwanzo katika kila hali ilichaguliwa kutoka:
\[ \{10^{-3},3\times10^{-3},10^{-2}\} \]
kulingana na validation loss.
Je, Tabaka la Kwanta Lilitoa Manufaa Halisi katika Benchmark Hii?
Hapana; katika regime tatu kuu za mafunzo zilizojaribiwa na utafiti, VQC ya kubiti sita haikuongeza usahihi wa tabaka la kiklasiki lenye upana uleule: ilibaki nyuma wazi katika majaribio ya frozen-feature, ilikaribia kiwango kilekile wakati wa end-to-end fine-tuning lakini katika mafunzo yanayotegemea convergence bado ilikuwa chini kwa asilimia-pointi 0,69, na katika HQCNN iliyofundishwa kutoka mwanzo ilitoa usahihi ulio chini kwa asilimia-pointi 8,33 kuliko udhibiti wake wa kiklasiki; hitimisho hili linatumika tu kwa saketi, seti ya data na itifaki za mafunzo zilizochunguzwa.
| Regime | Ulinganisho | Tofauti ya usahihi | %95 GA | Tafsiri ya chanzo |
|---|---|---|---|---|
| Frozen features | VQC − udhibiti wa kiklasiki uliolinganishwa | −6,03 asilimia-pointi | −6,78 hadi −5,20 | Udhibiti wa kiklasiki bora katika block 20/20 za backbone–fold |
| Frozen features | VQC − deeper control | −4,71 asilimia-pointi | −5,63 hadi −3,73 | Modeli ya kiklasiki bora katika block 20/20 |
| Frozen features | VQC − Fourier surrogate | −5,27 asilimia-pointi | −6,20 hadi −4,39 | Surrogate ya kiklasiki inayofunika darasa la funksi la saketi ni bora |
| End-to-end, Block A | VQC − udhibiti wa kiklasiki | −0,07 asilimia-pointi | −1,08 hadi +1,00 | Sawa ndani ya ±1 pp |
| End-to-end, Block B | VQC − udhibiti wa kiklasiki | −0,69 asilimia-pointi | −1,25 hadi −0,13 | Ulinganifu wa ±1 pp haukuweza kutangazwa |
| Standardized images, Block C | VQC − udhibiti wa kiklasiki | −1,11 asilimia-pointi | −2,07 hadi −0,20 | VQC ni ya chini |
| From scratch | HQCNN − udhibiti wa kiklasiki | −8,33 asilimia-pointi | −12,72 hadi −4,06 | Udhibiti wa kiklasiki ni bora |
Maelezo ya matokeo ya frozen-feature
| Head | EfficientNet-B0 | DenseNet-121 | ResNet-50 | MobileNetV2 |
|---|---|---|---|---|
| VQC | 82,0 ± 3,4 | 79,5 ± 3,5 | 76,0 ± 4,0 | 78,5 ± 2,1 |
| Udhibiti wa kiklasiki | 86,4 ± 2,9 | 86,4 ± 3,1 | 83,1 ± 3,1 | 84,3 ± 3,9 |
| Deeper control | 84,4 ± 2,6 | 85,5 ± 2,8 | 81,3 ± 2,9 | 83,7 ± 3,7 |
| Fourier surrogate | 85,5 ± 3,3 | 85,4 ± 3,6 | 82,1 ± 2,6 | 84,2 ± 2,9 |
| Bottleneck only | 87,6 ± 3,2 | 87,9 ± 3,6 | 85,5 ± 2,5 | 86,4 ± 3,6 |
| Linear probe | 88,1 ± 3,0 | 88,1 ± 3,1 | 86,0 ± 2,3 | 87,1 ± 3,6 |
| MLP | 87,9 ± 2,8 | 88,8 ± 3,2 | 86,3 ± 2,1 | 87,5 ± 3,7 |
| Untrained VQC | 80,6 ± 4,5 | 78,1 ± 4,8 | 69,7 ± 3,0 | 77,0 ± 5,8 |
Thamani za ± hapa ni standard deviation ya usahihi uliowastaniwa juu ya seed katika fold tano kwa kila backbone.
Kufundishwa kwa VQC si bure kabisa: VQC iliyofundishwa ilikuwa sahihi zaidi kwa wastani wa asilimia-pointi 2,67 kuliko VQC iliyofungiwa kwenye random parameters (%95 GA 1,11–4,24). Kwa hiyo kujifunza vigezo vya saketi kulitoa mchango fulani; lakini mchango huu haukutosha kuinua tabaka la kwanta juu ya vidhibiti vya kiklasiki.
Nini kilitokea kadiri idadi ya kubiti ilivyoongezeka?
Katika frozen features za EfficientNet-B0, upana wa bottleneck na idadi ya kubiti za VQC zilibadilishwa kuwa 2, 4, 6, 8 na 10.
VQC ilibaki karibu na kiwango cha %83,3–83,6 kati ya kubiti mbili na sita, ikashuka hadi %80,8 kwa kubiti nane na %81,4 kwa kubiti kumi. Udhibiti wa kiklasiki, kwa upande mwingine, ulipanda kadiri upana ulivyoongezeka, kutoka %82,0 kwa units mbili hadi %86,6 kwa units nane.
VQC ilikuwa bora kuliko udhibiti wa kiklasiki kwa +1,3 asilimia-pointi katika kubiti mbili pekee; hata hivyo, tofauti hii ilikuwa katika mwelekeo huo katika fold tatu tu kati ya tano, na modeli zote mbili zilibaki chini ya usahihi wa %84,2 wa head ya bottleneck-only. Chanzo hakitafsiri matokeo haya kama quantum advantage thabiti.
Kina cha saketi
Kwa kubiti sita, idadi ya tabaka za variational ilibadilishwa kuwa 1, 2, 4 na 6. Usahihi ulipanda kutoka %83,0 kwa tabaka moja hadi %85,0 kwa tabaka nne na ulikuwa %84,8 kwa tabaka sita. Licha ya uboreshaji huu, udhibiti wa kiklasiki ulibaki juu kwa %86,7.
Nini kilitokea entanglement ilipoondolewa?
Kuondoa kabisa pete ya CNOT katika saketi kuu ya kubiti sita, tabaka mbili kuliongeza usahihi kutoka %83,5 hadi %86,4; tofauti dhidi ya VQC ya kawaida ilikuwa +2,9 asilimia-pointi. Toleo lisilo na entanglement lilitofautiana na udhibiti wa kiklasiki kwa −0,3 asilimia-pointi tu.
Matokeo haya si hitimisho la jumla la kifizikia kwamba “quantum entanglement ni hatari”. Yanaonyesha tu kwamba kwa muundo huu wa saketi, uwakilishi huu wa data na jukumu hili la uainishaji, pete ya CNOT haikutoa manufaa kwa usahihi uliopimwa.
Data re-uploading
Kutumia tena encoding ya \(R_Y(x_i)\) kabla ya kila tabaka la variational, yaani data re-uploading, kulipunguza usahihi wa VQC kuu kutoka %83,5 hadi %78,2. Tofauti ilikuwa −5,3 asilimia-pointi na matokeo yalikuwa mabaya zaidi katika fold zote tano.
Je, modeli ya kwanta ilitoa faida wakati data ilikuwa chache?
Hapana. Kinyume chake, utendaji dhaifu zaidi wa jamaa wa VQC ulionekana katika hali zenye data ndogo zaidi ya mafunzo.
Wakati nominal %1 ya fold ya mafunzo ilipotumiwa, wastani wa takriban picha 115 za mafunzo ulisalia kwa sababu ya sampling inayotegemea vikundi. Katika hali hii:
| Modeli | Usahihi |
|---|---|
| VQC | %38,6 |
| Udhibiti wa kiklasiki | %62,3 |
| Linear probe | %65,5 |
| MLP | %62,3 |
Kwa hiyo dhana kwamba “saketi ndogo za kwanta hutoa faida kiotomatiki wakati data ni chache” haikuungwa mkono na benchmark hii.
Je, noise inaeleza kwa nini VQC ilibaki nyuma ya modeli ya kiklasiki?
Hapana. Pengo kuu la usahihi tayari lipo katika simulation isiyo na noise.
Wakati VQC ya kubiti sita, tabaka mbili ilitoa usahihi wa %83,5 katika hali isiyo na noise, ilishuka hadi %83,3 kwa uwezekano wa depolarization \(p=0,03\) kwa kila kubiti na tabaka. Kwa \(p=0,1\), usahihi ulishuka hadi %70,2.
Saketi za kina zaidi ni nyeti zaidi kwa noise kubwa: kwa \(p=0,1\), saketi ya tabaka nne ilishuka hadi usahihi wa %31,3 na saketi ya tabaka sita hadi %24,0; kiwango cha bahati nasibu kwa madarasa manne ni %25.
Katika finite-shot simulation, modeli kuu ya kubiti sita ilipoteza asilimia-pointi 1,5 wakati shot 16 tu zilitumika. Kwa shot 1024, zikiwa peke yake au pamoja na depolarization \(p=0,01\), matokeo yalibaki ndani ya asilimia-pointi 0,1 ya saketi isiyo na noise.
Ulinganisho wa quantum kernel na RBF kernel
| Component ya PCA / kubiti | Quantum kernel | RBF kernel | Quantum − kiklasiki |
|---|---|---|---|
| 4 | %72,8 | %73,3 | −0,5 pp |
| 6 | %77,7 | %78,1 | −0,4 pp |
| 8 | %79,7 | %80,8 | −1,1 pp |
| 10 | %80,9 | %81,5 | −0,6 pp |
Modeli zote mbili za kernel zilibaki chini ya linear probe yenye usahihi wa %88,0 inayofanya kazi kwenye vipengele kamili vya EfficientNet-B0 vya dimension 1280. Waandishi wanatafsiri matokeo haya kama dalili kwamba upunguzaji wa dimensionality unaohitajika kupakia data kwenye saketi ndogo ya kwanta ni bottleneck muhimu ya utendaji.
Kernel concentration ilikuwa nini?
Katika quantum fidelity kernel, wakati bandwidth ya kudumu ilikuwa 0,1 au zaidi, variance ya off-diagonal kernel entry ilipungua sana kadiri idadi ya kubiti ilivyoongezeka. Kwa mfano, kwa bandwidth 0,1, variance ilikuwa \(5.6\times10^{-2}\) kwa kubiti nne na ilishuka hadi \(2.6\times10^{-3}\) kwa kubiti kumi.
Kwa bandwidth 1, ukubwa huohuo ulishuka kutoka \(7.4\times10^{-3}\) hadi \(4.5\times10^{-5}\). Tabia hii inalingana na kernel concentration inayojulikana katika fidelity kernels.
Validation ilichagua bandwidth ndogo zaidi, 0,03, katika 15 kati ya mchanganyiko 20 wa fold–width. Hata hivyo, kwa kubiti nne, kwa kuwa wastani wa off-diagonal kernel ulikuwa 0,92 kwa bandwidth hii, kernel ilikaribia tatizo jingine la mwisho, yaani jozi nyingi za mifano kuonekana kufanana sana.
Fine-tuning ya end-to-end
Katika majaribio ya fine-tuning, backbone za ImageNet-pretrained EfficientNet-B0, ResNet-50, DenseNet-121, MobileNetV2, ConvNeXt-Tiny na ViT-Small/16 zilitathminiwa. Ulinganisho wa moja kwa moja wa VQC na udhibiti wa kiklasiki uliolinganishwa ulifanywa kwenye EfficientNet-B0.
Block A: recipe ya kwanza ya mafunzo
AdamW optimizer, weight decay 0,05, one-cycle learning-rate schedule yenye warm-up ya %10, peak learning rate \(10^{-3}\) kwa head, \(3\times10^{-4}\) kwa backbone, batch size 32 na label smoothing 0,05 vilitumika. Mafunzo yaliendelea kwa kiwango cha juu cha epoch 30 na yalisimamishwa ikiwa validation loss haikuboreka kwa epoch sita.
Augmentation ilijumuisha random resized crop (scale 0,8–1,0; aspect ratio 0,9–1,1), horizontal flip, rotation ±10° na brightness/contrast jitter 0,15.
Block B: mafunzo yanayotegemea convergence
Linear warm-up ya epoch mbili ilitumika; ikiwa validation loss haikuboreka kwa epoch tatu learning rate ilipunguzwa nusu, ikiwa haikuboreka kwa epoch kumi early stopping ilitumika, na kiwango cha juu cha epoch 80 kiliwekwa.
Head learning rate:
\[ \{3\times10^{-4},10^{-3},3\times10^{-3}\} \]
ilichaguliwa kutoka hizo kwenye validation set ya fold ya kwanza; backbone learning rate iliwekwa kuwa mara 0,3 ya head rate. Learning rate iliyochaguliwa ilitumika katika fold tano na seed mbili.
Block C: picha standardized
Ili kupunguza shortcuts za chanzo kama background, mipaka, overlays, ukubwa wa matrix na global intensity scale, head mask iliundwa, picha ikakatwa kwenye eneo la mask, ikapad kuwa mraba, intensity ikarescale kulingana na percentile 1.–99. ndani ya mask na picha ikabadilishwa ukubwa kuwa pikseli 256 × 256.
Chanzo kinasema wazi kwamba kwa kuwa skull stripping ya 2B yenye kuaminika haikupatikana, fuvu lilibaki kwenye picha. Kwa hiyo standardization haikuondoa taarifa zote za chanzo/shortcut.
Matokeo makuu ya utendaji wa end-to-end
| Regime | VQC | Udhibiti wa kiklasiki | Linear head |
|---|---|---|---|
| Block A | %94,1 | %94,2 | %94,5 |
| Block B | %93,8 | %94,5 | %94,5 |
| Block C, standardized | %93,6 | %94,7 | %94,3 |
Katika Block A, kipindi cha kujiamini cha %95 cha tofauti kati ya VQC na udhibiti wa kiklasiki ni −1,08 hadi +1,00 pp. Kwa kuwa kipindi cha kujiamini cha %90 cha −0,93 hadi +0,82 pp kilibaki kabisa ndani ya eneo la ulinganifu la ±1 pp, chanzo kilikubali modeli hizi mbili kuwa sawa katika kiwango cha ±1 asilimia-pointi.
Katika Block B, tofauti ya VQC − udhibiti wa kiklasiki ni −0,69 pp. Kwa kuwa kipindi cha kujiamini cha %90 ni −1,16 hadi −0,22 na kilivuka mpaka wa −1 pp, ulinganifu wa ±1 pp haukuweza kutangazwa. Margin ndogo zaidi ambayo ingewezesha kutangaza ulinganifu ni 1,16 pp.
Tofauti hii ni muhimu: kutopata tofauti yenye significance ya kitakwimu si sawa na kuonyesha kwamba modeli ni sawa. Kwa hiyo utafiti haukutazama p-value pekee, bali pia equivalence margin ya ±1 pp iliyofafanuliwa mapema na kipindi cha kujiamini cha %90.
Gharama ya fine-tuning
| Modeli | Wastani wa epoch ya kusimama | Muda wa training / run | Latency ya picha moja | Peak GPU memory |
|---|---|---|---|---|
| VQC | 38,8 | 12,8 dk | 18,8 ms | 1461 MB |
| Udhibiti wa kiklasiki | 26,0 | 6,8 dk | 11,3 ms | 1461 MB |
| Deeper control | 29,1 | 7,7 dk | 11,2 ms | 1461 MB |
| Fourier surrogate | 22,3 | 6,0 dk | 11,7 ms | 1461 MB |
| Linear head | 23,2 | 6,0 dk | 10,7 ms | 1461 MB |
Nyakati hizi si gharama za hardware halisi ya kwanta. Kwa kuwa saketi ya kwanta iliigwa kwenye GPU ya kiklasiki, zinaonyesha tu gharama ya implementation ya utafiti.
HQCNN iliyofundishwa kutoka mwanzo
Ili kujaribu scenario iliyo karibu zaidi na tafiti nyingi za awali za hybrid, chanzo pia kilifundisha CNN mseto ya kwanta–kiklasiki kutoka mwanzo bila kutumia pretrained backbone.
Encoder ina block tatu:
- 3 × 3 convolution, channels 64 + batch normalization + ReLU + 2 × 2 max pooling;
- 3 × 3 convolution, channels 128 + batch normalization + ReLU + 2 × 2 max pooling;
- 3 × 3 convolution, channels 256 + batch normalization + ReLU + 2 × 2 max pooling.
Baada ya hapo kuna global average pooling, projection ya pembe ya mstari 256 → 6, VQC ya kubiti sita yenye tabaka mbili, dense layers za kiklasiki zenye units 64 na 32, na tokeo la madarasa manne.
Kati ya jumla ya vigezo 375.950 vinavyoweza kujifunza vya HQCNN, 36 tu viko kwenye saketi ya kwanta. Udhibiti wa kiklasiki uliolinganishwa hutumia Linear(6,6)+tanh badala ya VQC na una jumla ya vigezo 375.956.
Matokeo:
HQCNN: usahihi %67,9 (%95 GA 63,5–72,1).
Udhibiti wa kiklasiki: usahihi %76,2 (%95 GA 72,7–79,6).
Tofauti ni asilimia-pointi −8,33 (%95 GA −12,72 hadi −4,06; McNemar \(p=1.6\times10^{-41}\)).
Uvujaji wa data uliinua usahihi kwa kiasi gani?
Watafiti walifundisha modeli zilezile na picha zilezile chini ya Protocol 2 na Protocol 3 kwa kubadilisha tu sheria za grouping za fold. Njia hii ililenga kutenga kwa moja kwa moja zaidi athari ya leakage.
| Kundi la modeli / uhusiano wa picha | Mabadiliko ya usahihi Protocol 2 → Protocol 3 |
|---|---|
| Frozen-feature heads, kwa jumla | −3,3 hadi −7,8 pp |
| Frozen, picha zenye nakala katika training fold ya Protocol 2 | −3,9 hadi −9,6 pp |
| Frozen, picha zenye uhusiano wa mgonjwa yuleyule pekee | −2,3 hadi −6,9 pp |
| Frozen, picha 750 zisizo na uhusiano | −5,5 hadi +3,5 pp; wastani −0,4 pp |
| Modeli fine-tuned, kwa jumla | −3,3 hadi −3,6 pp |
| Fine-tuned, picha zenye nakala | −3,7 hadi −4,0 pp |
| Fine-tuned, uhusiano wa mgonjwa yuleyule pekee | −3,5 hadi −4,6 pp |
Kujikusanya kwa athari ya leakage hasa katika picha zenye uhusiano wa nakala au mgonjwa na training fold kunaunga mkono kwamba kushuka kwa usahihi kulikobainika hakukutokana tu na mabadiliko ya fold ya nasibu.
Jaribio la lesion occlusion
Katika uvimbe wa testi wenye asili ya Figshare, mask ya uvimbe iliyochorwa kwa mkono ilipanuliwa kwa pikseli 8 na eneo hilo likajazwa na median intensity ya sehemu iliyobaki ya kichwa. Modeli ilikuwa imefundishwa awali kwenye picha za kawaida zisizo na occlusion.
Mwonekano wa eneo la uvimbe ulipoondolewa:
- udhibiti wa kiklasiki ulitoka %85,6 hadi %83,0,
- linear probe ilitoka %87,3 hadi %84,7,
- VQC ilitoka %80,6 hadi %78,9
.
Kwa maneno mengine, ingawa intensity ya picha ya uvimbe iliondolewa, usahihi ulipungua kwa asilimia-pointi chache tu. Hii inaashiria kwamba modeli zilitumia kwa kiasi kikubwa taarifa nje ya mwonekano wa tishu ya uvimbe, kama anatomy, chanzo na geometri ya lesion.
Hata hivyo, eneo lililo occluded si eneo lisilo na taarifa kabisa: nafasi, ukubwa na umbo la mask ya uvimbe zimehifadhiwa. Kwa kweli, hata logistic regression iliyofundishwa kwa mask ya uvimbe pekee iliyopunguzwa hadi 16 × 16 ilitabiri darasa la uvimbe kwa usahihi wa %61,4. Kwa hiyo matokeo ya occlusion hayamaanishi kwamba “modeli haitumii uvimbe kabisa”.
Generalization kati ya vyanzo
Wakati mafunzo yaliyopangwa kwa wagonjwa yalifanywa katika madarasa matatu ya uvimbe yenye asili ya figshare pekee, VQC ilitoa usahihi wa %80,8, udhibiti wa kiklasiki %86,4 na linear probe %87,5.
Modeli zilipofundishwa kwenye uvimbe wa Figshare na kujaribiwa kwenye uvimbe wa SARTAJ usio na uhusiano, head zote zilikaribia kiwango cha bahati nasibu:
\[ 36.1\%-38.8\% \]
katika masafa ya wastani wa backbone nne; kiwango cha bahati nasibu kwa madarasa matatu ni %33,3.
Kwa hiyo chanzo kinaeleza kwamba head za kwanta na za kiklasiki zote zilionyesha transfer dhaifu dhidi ya mabadiliko ya acquisition-source.
Grad-CAM ilionyesha nini?
Gradient-weighted Class Activation Mapping (Grad-CAM) huzalisha ramani ya umuhimu inayotegemea gradient ya maeneo ya anga yanayounga mkono utabiri wa CNN. Chanzo kiliitumia si kama jibu la uhakika kwa swali “kwa nini modeli iliamua hivi?”, bali kama zana ya maelezo inayoonyesha mahali activation inayohusiana na utabiri wa modeli ilipojikita.
Katika picha 1400 za testi za fold ya kwanza, uwiano wa median wa nishati ya Grad-CAM uliobaki ndani ya mask ya kichwa ulikuwa:
| Modeli | Uwiano wa median |
|---|---|
| ResNet-50 linear | %95 |
| EfficientNet-B0 linear | %80 |
| EfficientNet-B0 udhibiti wa kiklasiki | %89 |
| EfficientNet-B0 VQC | %85 |
| HQCNN | %52 |
Katika VQC, kwenye %28 ya picha zenye non-zero Grad-CAM map, chini ya nusu ya nishati ilibaki ndani ya mask ya kichwa; katika udhibiti wa kiklasiki uwiano huu ulikuwa %10, na katika linear head %0,2. Hata hivyo, kwa kuwa Grad-CAM haitoi maelezo ya causality, tofauti hii peke yake haiwezi kubainisha kwa uhakika “modeli ilijifunza nini”.
Uchambuzi wa kitakwimu ulifanywaje?
Badala ya kuripoti asilimia moja tu ya usahihi, utafiti ulitumia takwimu za tabaka nyingi.
Katika ulinganisho wa frozen-feature, kuna block 20 za backbone–fold kutokana na backbone nne × fold tano. Seed ziliwastaniwa ndani ya block. Tofauti zilizolinganishwa kati ya head zilitathminiwa kwa Wilcoxon signed-rank test, bootstrap %95 confidence intervals zilikokotolewa kwa tofauti za wastani, na head zote zililinganishwa kwa Friedman test.
Kwa kuwa fold na backbone si huru kabisa, pia zilitumika:
- linear mixed model yenye random intercept kwa backbone na fold ndani ya backbone,
- variance-corrected resampled t-test kwa repeated cross-validation,
- image-level cluster bootstrap inayosample upya vikundi vya mgonjwa na duplicate
.
Kwa kuwa kuna fold tano tu katika modeli za end-to-end, fold-level Wilcoxon test ina resolution ndogo sana; kwa jozi tano, p-value ndogo zaidi ya pande mbili inayoweza kufikiwa ni 0,0625. Kwa hiyo utabiri wa out-of-fold wa modeli uliunganishwa katika kiwango cha picha na exact McNemar test ilitumika.
Kwa kuwa picha za mgonjwa na duplicate haziwezi kuchukuliwa kuwa huru, confidence intervals za %95 za usahihi na paired-difference zilikokotolewa kwa cluster bootstrap inayosample upya vikundi vya mgonjwa/duplicate. Katika tathmini kuu zilitumika bootstrap samples 5000, na katika baadhi ya subsets za darasa maalum na leakage zilitumika samples 2000.
Jaribio la ulinganifu la ±1 asilimia-pointi linamaanisha nini?
Kusema “hatukupata tofauti yenye significance” kati ya modeli mbili hakuthibitishi kwamba zinafanana kwa vitendo. Kwa hiyo chanzo kilitumia kigezo cha ulinganifu kwamba confidence interval ya %90 ya tofauti kati ya modeli mbili ibaki kabisa ndani ya:
\[ [-1,+1]\ \text{yüzde puanı} \]
masafa hayo. Hii inalingana na majaribio mawili ya ulinganifu ya upande mmoja katika kiwango \(\alpha=0,05\).
Mpaka wa ±1 pp si constant ya kifizikia ya asili; ni margin ya vitendo iliyochaguliwa mapema na watafiti. Chanzo pia kinakubali wazi kwamba uchaguzi wa margin ni convention na kimeripoti tofauti margin ndogo zaidi ambayo ingewezesha kutangaza ulinganifu kwa kila ulinganisho.
Matokeo yanayoungwa mkono na utafiti
- Sehemu rasmi za mafunzo/testi za Kaggle Brain Tumor MRI Dataset toleo la 2 zina mwingiliano mkubwa wa picha na wagonjwa.
- %79 ya picha rasmi za testi hushiriki kundi la duplicate na picha katika sehemu ya mafunzo.
- Picha 915/917 za testi zenye asili ya Figshare zina mwingiliano na mgonjwa yuleyule katika mafunzo.
- Tathmini iliyopangwa kwa wagonjwa ilipunguza usahihi wa frozen-feature kwa takriban 3,3–7,8 pp na usahihi fine-tuned kwa takriban 3,3–3,6 pp.
- VQC ya kubiti sita ilitoa usahihi wa takriban 6,0 pp chini ya udhibiti wa kiklasiki wenye upana uleule kwenye frozen features.
- Fine-tuning ilipunguza pengo la VQC dhidi ya udhibiti wa kiklasiki hadi takriban 1 pp au chini, lakini VQC haikuonyesha ubora katika mafunzo yanayotegemea convergence.
- HQCNN iliyofundishwa kutoka mwanzo ilitoa usahihi wa 8,33 pp chini ya udhibiti wake wa kiklasiki.
- Katika ablation iliyochunguzwa, kuondoa milango ya entanglement hakukupunguza usahihi; kuliuongeza.
- Quantum kernel iliyochunguzwa ilitoa usahihi kidogo chini ya RBF kernel katika dimensionality zote za PCA.
- Katika hali ya data chache za mafunzo, VQC ilifanya vibaya zaidi kuliko vidhibiti vya kiklasiki.
- Moderate depolarizing noise haielezi tofauti kuu ya kwanta–kiklasiki; tofauti ipo pia katika simulation isiyo na noise.
- Shortcuts zinazohusiana na chanzo cha picha ni zenye nguvu na generalization kwenda chanzo tofauti ni dhaifu kwa modeli zote.
Matokeo ambayo utafiti hauungi mkono
- Haiwezi kuhitimishwa kwamba “quantum machine learning haifanyi kazi katika jukumu lolote la medical imaging”.
- Haiwezi kuhitimishwa kutokana na nyakati hizi za simulation kwamba hardware halisi ya kwanta ni polepole au haraka zaidi katika jukumu hili.
- Utendaji wa saketi kubwa kuliko kubiti 10 au encoding/ansatz architectures nyingine haukujaribiwa katika utafiti huu.
- Haiwezi kutolewa hitimisho la kushindwa kwa ujumla kwa quantum convolutional networks.
- Utafiti huu si uthibitishaji wa kifaa cha kliniki cha utambuzi wa uvimbe wa ubongo.
- Usahihi fine-tuned wa karibu %94 si makadirio ya usahihi halisi wa uchunguzi hospitalini.
- Uainishaji wa slice-level si sawa na diagnosis ya kliniki ya examination-level au patient-level.
- Haiwezi kusemwa kwamba makosa yote ya out-of-source glioma ni makosa ya modeli; baadhi ya lebo pia zinaweza kuwa na tatizo na hakuna ukaguzi wa radiologist uliofanywa.
- Ramani za Grad-CAM si maelezo ya causality ya uamuzi wa modeli.
- Jaribio la lesion occlusion halionyeshi kwamba modeli haitumii kabisa taarifa ya uvimbe; nafasi, ukubwa na umbo la lesion limehifadhiwa.
- Barren plateau haikupimwa moja kwa moja wala kuthibitishwa.
Nguvu za utafiti
Nguvu ya kwanza ni kulinganisha modeli ya kwanta si na CNN isiyohusiana, bali na udhibiti wa kiklasiki wenye upana uleule na itifaki ileile. Hivyo mchango wa marginal wa tabaka la kati la kwanta uliweza kuulizwa badala ya utendaji wa mtandao mzima.
Nguvu ya pili ni kutotosheka na kulinganisha idadi ya vigezo pekee, bali pia kutumia udhibiti wa kiklasiki wa kina zaidi na Fourier surrogate inayofunika darasa la funksi la saketi.
Nguvu ya tatu ni kuchunguza nakala katika seti ya data si kwa exact checksum pekee, bali kwa njia ya pHash + NCC inayostahimili uakisi na mzunguko, na kurejesha utambulisho asilia wa wagonjwa wa figshare kwa picha ambako iliwezekana.
Nguvu ya nne ni kujaribu saketi ya kwanta katika regime tatu tofauti: frozen features, end-to-end fine-tuning na training from scratch.
Nguvu ya tano ni kuchunguza pamoja ablation za idadi ya qubit, circuit depth, entanglement, data re-uploading, training-data fraction, depolarizing noise na shot count.
Nguvu ya sita ni kuuliza modeli inaweza kuwa inatumia nini kwa kweli kupitia uchanganuzi wa acquisition source, shortcut, lesion occlusion, cross-source transfer na Grad-CAM badala ya kutazama usahihi wa jumla pekee.
Mapungufu
Seti moja ya data: Utafiti unategemea benchmark moja ya MRI ya pande mbili, ya umma. Matokeo hayawezi kuhamishwa kiotomatiki kwa magonjwa mengine, kazi nyingine za imaging au volume za MRI za 3B.
Utambulisho wa wagonjwa haujakamilika: Utambulisho wa mgonjwa ulirejeshwa kwa picha 4846 tu za uvimbe zenye asili ya figshare. Katika picha nyingine za uvimbe na zisizo na uvimbe, grouping inategemea duplicate detection; haiwezekani kuondoa kabisa uwezekano kwamba vipande vya uchunguzi uleule ambavyo havikugunduliwa viko katika fold tofauti.
Hakuna hardware halisi ya kwanta: Saketi zote ziliigwa. Noise model iliyotumiwa haijumuishi crosstalk, readout error, limited connectivity wala gharama halisi za gate decomposition.
Familia ya saketi ni yenye mipaka: Dressed VQC zilichunguzwa hadi kubiti kumi pekee na kwa njia moja kuu ya encoding. Encoding nyingine, saketi kubwa zaidi na architectures nyingine zinazofanya kazi kwenye data ya kwanta zinaweza kuonyesha tabia tofauti.
Utafutaji wa hyperparameter ni wenye mipaka: Katika ulinganisho mkuu wa end-to-end, seed mbili kwa fold na uchaguzi kati ya wagombea watatu wa learning-rate kwenye fold ya kwanza ulitumika. Utafutaji mpana zaidi unaweza kubadilisha tofauti ndogo.
Standardization haiondoi shortcut zote: Head masking haikuondoa fuvu. Taarifa za coarse anatomy na imaging plane zilibaki.
Kizuizi cha Grad-CAM: Grad-CAM hutoa kidokezo cha anga cha takriban kuhusu mahali modeli inapotazama; haielezi mekanism ya uamuzi.
Uthibitishaji wa lebo: Candidate label errors na picha 76 za out-of-source glioma hazikuwekewa lebo upya na radiologist huru.
Upeo wa kliniki
Chanzo kinasisitiza wazi kwamba usahihi ulioripotiwa si usahihi wa uchunguzi wa kliniki. Kwa dai la kliniki, angalau ingizo za examination-level badala ya slice-level, utenganishaji wa wagonjwa kwa madarasa yote, reference standard kama histopathology au consensus ya wataalamu, kundi lisilo na uvimbe kutoka population ileile ya kliniki kama kundi la uvimbe, na uthibitishaji huru wa vituo vingi vingehitajika.
Kwa hiyo, mada ya utafiti huu si “mfumo wa kwanta unaotambua uvimbe wa ubongo kwenye MRI kwa usahihi wa %94”. Mada halisi ya utafiti ni kama tabaka la kati la kwanta linatoa thamani ya ziada ya uainishaji dhidi ya udhibiti wa kiklasiki uliolinganishwa, na jinsi uvujaji wa data unavyoweza kupotosha benchmark za aina hii.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Does the Quantum Layer Help? A Leakage-Aware Benchmark of Hybrid Quantum–Classical Models for Brain Tumor MRI Classification
Waandishi: Tuan-Linh Duong; Pande Wikantyasa Maswita; Tony Sumaryada; Sitti Yani; Thanh-Tai Duong; Hiba Omer; Nissren Tamam; Abdelmoneim Sulieman.
Mpangilio wa waandishi: Unaendana na PDF ya chanzo na rekodi rasmi ya uchapishaji.
Mchango sawa: Chanzo hakiripoti alama ya uandishi mwenza wa kwanza/mchango sawa.
Mwandishi wa mawasiliano: Thanh-Tai Duong.
Taasisi 1: The Laboratory Center, Hanoi University of Public Health, Hanoi 100000, Vietnam.
Taasisi 2: Department of Physics, Faculty of Mathematics and Natural Sciences, IPB University, Bogor 16680, Indonesia.
Taasisi 3: Department of Medical Physics, Faculty of Medicine, Nguyen Tat Thanh University, Ho Chi Minh City 700000, Vietnam.
Taasisi 4: Department of Radiological Sciences, College of Applied Medical Sciences, Imam Abdulrahman Bin Faisal University, Dammam 34212, Saudi Arabia.
Taasisi 5: Department of Physics, College of Sciences, Princess Nourah bint Abdulrahman University, Riyadh 11671, Saudi Arabia.
Taasisi 6: Department of Radiological Sciences, College of Applied Medical Sciences, King Saud bin Abdulaziz University for Health Sciences, Al Ahsa 31982, Saudi Arabia.
Taasisi 7: Imaging Physics Section, Research and Innovation Department, King Faisal Specialist Hospital & Research Center, Riyadh 11211, Saudi Arabia.
Aina ya chanzo: Makala asilia ya utafiti iliyopitiwa na wenzao.
Jarida: Diagnostics.
Mchapishaji: MDPI.
Juzuu / toleo / namba ya makala: 16 / 21 / 3485.
DOI: 10.3390/diagnostics16213485.
Tarehe ya kupokelewa: 7 Oktoba 2026.
Marekebisho: 17 Oktoba 2026.
Kukubaliwa: 21 Oktoba 2026.
Kuchapishwa: 24 Oktoba 2026.
Hali ya peer review: Ni makala ya jarida iliyopitiwa na wenzao.
Leseni: Creative Commons Attribution (CC BY).
Uchapishaji rasmi: Diagnostics 2026, 16, 3485; DOI 10.3390/diagnostics16213485.
Eneo kuu la kisayansi: Quantum machine learning, medical image classification, deep learning benchmarking na data-leakage auditing.
Jukumu kuu: Uainishaji wa madarasa manne wa vipande vya MRI vya glioma, meningioma, uvimbe wa pituitari na bila uvimbe.
Modeli kuu ya kwanta: Hardware-efficient dressed VQC yenye angle encoding, kubiti sita na tabaka mbili za variational; katika ablation, kubiti 2–10 na tabaka 1–6 zilitathminiwa.
Hardware halisi ya kwanta: Haikutumika. Saketi zote za kwanta ziliigwa kwenye hardware ya kiklasiki.
Itifaki kuu ya tathmini: Patient-grouped five-fold cross-validation (Protocol 3).
Matokeo kuu: Tabaka la VQC lililochunguzwa halikuongeza usahihi wa tabaka la kiklasiki lililolinganishwa katika regime tatu kuu za mafunzo zilizojaribiwa.
Tatizo kuu la seti ya data: %79 ya picha rasmi za testi zimeunganishwa na nakala katika sehemu ya mafunzo na picha 915/917 za testi zenye asili ya figshare zina mwingiliano na mgonjwa yuleyule katika mafunzo.
Takwimu: Katika ulinganisho wa frozen-feature zilitumika Wilcoxon signed-rank, Friedman test, bootstrap %95 GA, linear mixed model na variance-corrected resampled t-test; katika ulinganisho wa end-to-end zilitumika exact McNemar, patient/duplicate-group cluster bootstrap na equivalence margin ya ±1 pp.
Implementation: Python, PyTorch 2.14.0, timm 1.0.30, scikit-learn 1.8.0; PennyLane 0.45.1 ilitumika tu kwa uthibitishaji wa simulator. Mafunzo ya end-to-end yalifanywa kwenye NVIDIA GeForce RTX 3090 24 GB GPU.
Tamko la matumizi ya Generative AI: Chanzo kinaripoti kwamba familia ya modeli ya Claude Opus ilitumika chini ya uongozi wa waandishi katika kuandika na kudebug code ya uchanganuzi pamoja na kufanya uchanganuzi wa kitakwimu; uchanganuzi ulifafanuliwa na waandishi, code na matokeo vilikaguliwa, na code ilichapishwa.
Upatikanaji wa data: Brain Tumor MRI Dataset toleo la 2 linapatikana kwa umma kwenye Kaggle; DOI ya seti ya data ni 10.34740/KAGGLE/DSV/2645886. Makala inaripoti kwamba seti ya data ilipakuliwa tarehe 28 Septemba 2026. Dataset audit code, quantum circuit simulator, self-tests, majaribio, uchanganuzi wa kitakwimu, leakage-aware splits, duplicate/patient annotations, checksum manifest, utabiri wa modeli na majedwali ya matokeo yamechapishwa katika GitHub repository iliyoripotiwa na waandishi. Picha zenyewe za seti ya data hazijasambazwa upya.
Kamati ya maadili: Kwa kuwa data ya umma na iliyofutwa utambulisho kabisa pekee ilitumika, mapitio na idhini ya maadili viliondolewa.
Ridhaa ya mgonjwa: Kwa kuwa picha za umma na zilizofutwa utambulisho pekee zilitumika, ridhaa iliondolewa.
Ufadhili: Princess Nourah bint Abdulrahman University Researchers Supporting Project, PNURSP2026R12. Ada ya uchakataji wa makala pia ilifadhiliwa na Princess Nourah bint Abdulrahman University.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi. Ilielezwa kwamba wafadhili hawakuwa na jukumu katika muundo wa utafiti, ukusanyaji/uchanganuzi/tafsiri ya data, uandishi au uamuzi wa kuchapisha.
Michango ya waandishi: Conceptualization: P.W.M., T.-L.D., S.Y., T.-T.D.; methodology: P.W.M., T.-L.D.; software: P.W.M., T.-L.D.; formal analysis: T.-L.D.; investigation: P.W.M., T.-L.D., T.S.; data curation: T.-L.D.; visualization: T.-L.D.; original draft: P.W.M., T.-L.D.; review and editing: waandishi wote; supervision: S.Y., T.S., T.-T.D.; project administration: S.Y.; funding acquisition: S.Y., N.T.
Mpaka mkuu wa tafsiri: Matokeo yanaonyesha kwamba katika seti hii ya data na familia ndogo ya VQC zilizoigwa zilizojaribiwa, tabaka la kwanta halikuongeza usahihi wa ziada. Utafiti hauondoi kwa ujumla uhalali wa modeli zote za quantum machine learning, hardware halisi ya kwanta au utambuzi wa kliniki kwa MRI.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *