

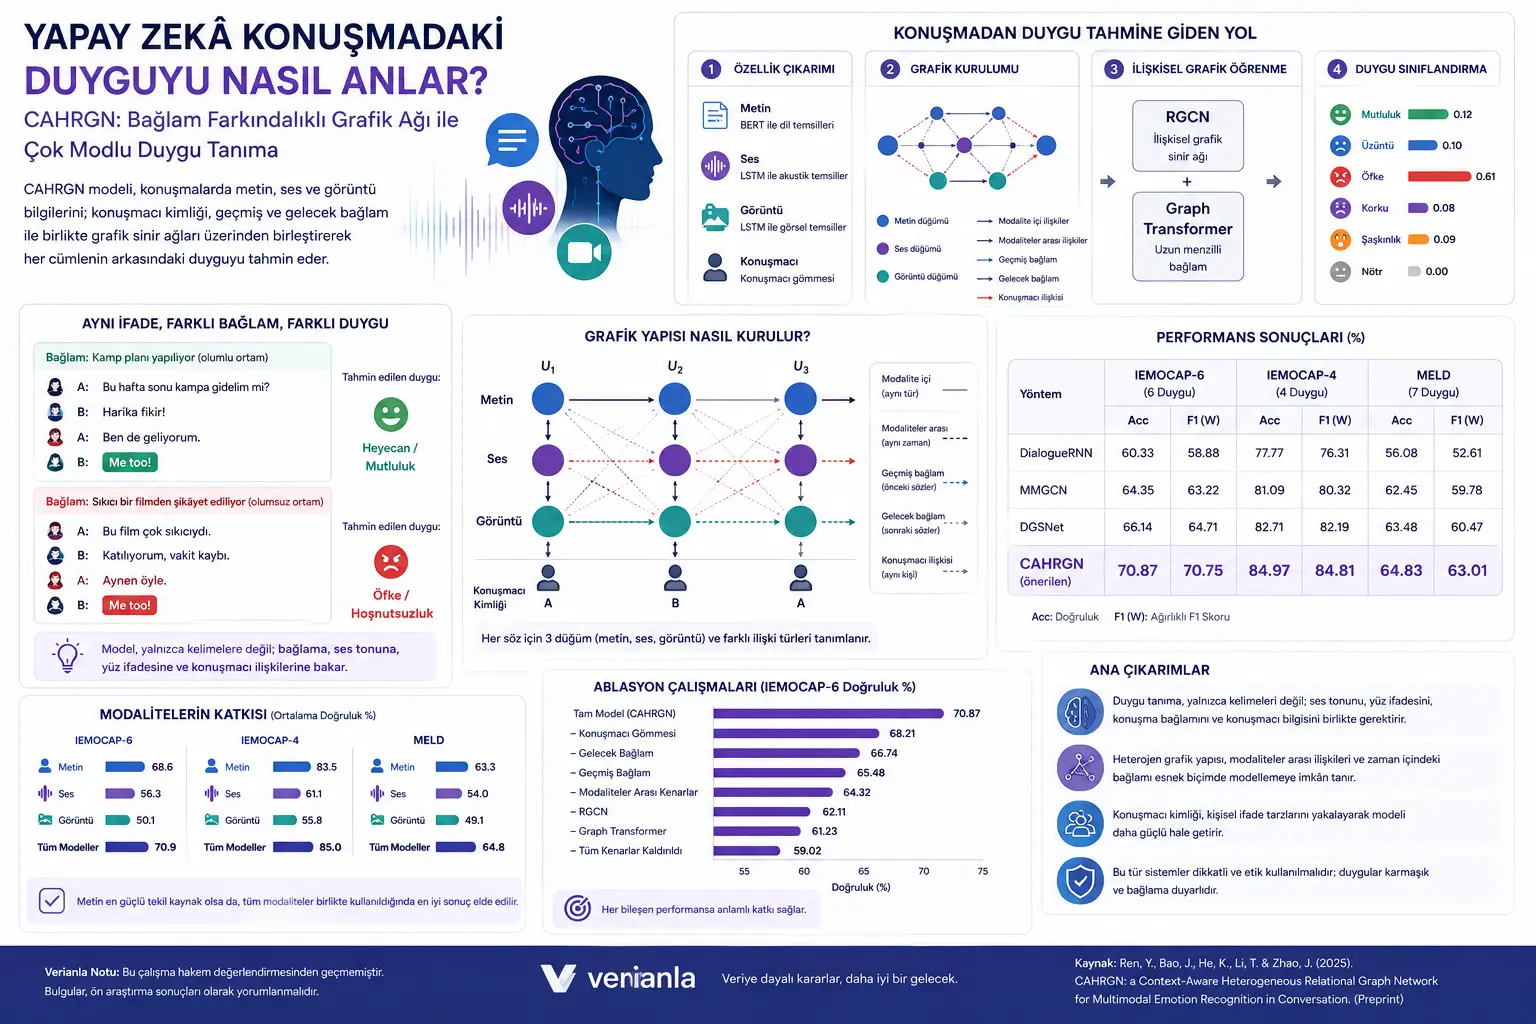
Kuelewa hisia katika mazungumzo mara nyingi si kusoma sentensi moja tu. Sentensi ileile inaweza kubeba hisia tofauti kabisa katika miktadha tofauti. Kwa mfano, usemi “Ben de” unaweza kuonyesha msisimko katika mazungumzo moja, na katika mazungumzo mengine ukaonyesha hasira au kuvunjika moyo. Kwa hiyo, ili akili bandia ielewe hisia katika mazungumzo, inapaswa kuangalia si maneno pekee, bali pia mtiririko wa mazungumzo, wazungumzaji ni akina nani, toni ya sauti na vidokezo vya kuona.
Utafiti huu unapendekeza modeli mpya iitwayo CAHRGN kwa utambuzi wa hisia wa njia nyingi katika mazungumzo. CAHRGN ni kifupi cha “Context-Aware Heterogeneous Relational Graph Network”. Kwa Kiswahili inaweza kutafsiriwa kama “Mtandao wa Grafu ya Mahusiano Tofautitofauti Unaotambua Muktadha”. Modeli huwakilisha kila kipande cha mazungumzo kwa njia tatu tofauti za taarifa: maandishi, sauti na picha; kisha huchakata mahusiano kati ya njia hizi na muktadha wa nyuma-na-mbele katika mpangilio wa mazungumzo ndani ya muundo wa grafu.
Ujumbe mkuu wa utafiti ni huu: kuchambua maandishi pekee hakutoshi kwa utambuzi wa hisia. Wakati mtiririko wa mazungumzo, mtindo wa kujieleza wa wazungumzaji na mahusiano kati ya maandishi-sauti-picha vinazingatiwa pamoja, modeli inaweza kutoa matokeo yenye nguvu zaidi.
Tatizo Ni Nini?
Mifumo ya utambuzi wa hisia mara nyingi hujaribu kukisia hisia kutoka kwenye maandishi mafupi, rekodi za sauti au mionekano ya uso. Lakini mazungumzo halisi ni changamano zaidi kuliko sentensi iliyotengwa. Watu hujibu sentensi zilizotangulia, wazungumzaji huathiriana, na wakati mwingine maneno huonekana ya kawaida lakini toni ya sauti au uso hubeba hisia tofauti.
Kwa sababu hii, utambuzi wa hisia ndani ya mazungumzo ni tatizo gumu zaidi kuliko uainishaji wa hisia wa kawaida. Modeli hailazimiki kujibu tu swali la “ni maneno gani yaliyomo katika sentensi hii?”; pia inalazimika kujibu maswali kama “sentensi hii ilisemwa na nani, kabla yake kilisemwa nini, baada yake kilifuata nini, je sauti na picha zinaunga mkono maandishi haya au zinapingana nayo?”
Baadhi ya mbinu zilizotangulia hufuatilia mpangilio wa mazungumzo kwa mitandao inayojirudia kama LSTM. Mbinu hizi zinaweza kukamata muktadha wa karibu; lakini katika mazungumzo marefu zinaweza kushindwa kuhifadhi utegemezi wa mbali. Mbinu za grafu zinaweza kumodeli mahusiano katika mazungumzo kwa unyumbufu zaidi; lakini baadhi yake huchukulia maandishi, sauti na picha kama nodi moja iliyounganishwa, na hivyo kushindwa kutumia kikamilifu mchango wa kipekee wa kila modaliti.
Tatizo ambalo utafiti unajaribu kutatua ni hili hasa: akili bandia inaweza kumodelije vizuri zaidi mahusiano kati ya modaliti na athari tofauti za muktadha wa nyuma na wa mbele katika mazungumzo ya njia nyingi?
Mbinu Inapendekeza Nini?
Modeli ya CAHRGN hufikiria mazungumzo kama grafu. Grafu ni muundo unaoundwa na nodi na kingo. Katika utafiti huu, kila kitengo cha mazungumzo, yaani kila utterance, huwakilishwa kwa modaliti tatu tofauti: maandishi, sauti na picha. Kwa hiyo, badala ya kuunda nodi moja tu kwa sentensi moja, huundwa nodi ya maandishi, nodi ya sauti na nodi ya picha.
Mtazamo huu ni muhimu; kwa sababu ishara ya hisia haiwi kila wakati imara katika njia ileile. Katika baadhi ya hali, maneno huonyesha hisia waziwazi. Katika nyingine, toni ya sauti huwa yenye kuamua zaidi. Katika hali nyingine, uso au tabia ya kuona hubeba taarifa zaidi kuliko maandishi. CAHRGN hujaribu kujifunza mahusiano kati ya njia hizi bila kuzitupa zote katika mfuko mmoja.
Wazo la pili muhimu la modeli ni kutenganisha mwelekeo wa wakati katika mazungumzo. Sentensi zilizopita na sentensi zijazo hazichukuliwi kama aina moja ya muktadha. Kwa sababu katika kuelewa hisia ya sentensi moja, yaliyosemwa kabla yanaweza kutoa vidokezo tofauti na majibu yanayokuja baadaye. Ndiyo maana modeli huunda aina tofauti za uhusiano kwa muktadha wa zamani na muktadha wa baadaye.
Wazo la tatu ni taarifa ya mzungumzaji. Hisia ileile inaweza kuonyeshwa kwa njia tofauti na watu tofauti. Baadhi ya watu huonyesha hasira waziwazi, wengine huzungumza kwa namna ya upande wowote zaidi; baadhi ya wazungumzaji hutumia kauli fupi na kali, wengine hutumia maelezo ya mzunguko. Modeli hujaribu kukamata mitindo hii ya kujieleza ya mtu binafsi kwa kuongeza utambulisho wa mzungumzaji kama uwakilishi uliopachikwa.
Mwishowe CAHRGN hutumia pamoja usanifu wa RGCN na Graph Transformer. RGCN hujifunza uhamishaji wa taarifa kati ya nodi katika grafu zenye aina tofauti za mahusiano. Graph Transformer husaidia kukamata muktadha mpana na mahusiano ya mbali. Hivyo modeli huchakata pamoja mahusiano ya ndani ya mazungumzo na muundo mpana zaidi wa mazungumzo.
Formuli Zinasema Nini?
Utafiti una vielelezo vingi vya kihisabati vinavyoeleza vipengele vya msingi vya modeli. Formuli zilizo hapa chini zimehamishwa kwa uaminifu kadiri iwezekanavyo kwa muundo wa alama uliomo kwenye utafiti, na zimefafanuliwa kwa lugha rahisi.
BERT hutumiwa kwa modaliti ya maandishi. Hapa \(U_i^l\) huonyesha umbo la maandishi la usemi wa \(i\). katika mazungumzo; \(u_i^l\) huonyesha uwakilishi wa maandishi unaotolewa na BERT.
Kwa njia za sauti na picha hutumiwa visimbaji vya msingi wa Bi-LSTM. Visimbaji hivi hubadilisha sifa za sauti na picha za kila kitengo cha mazungumzo kuwa uwakilishi wenye urefu thabiti.
Taarifa ya mzungumzaji huwakilishwa kwa tabaka tofauti la upachikaji. \(S\) huonyesha vitambulisho vya wazungumzaji katika mazungumzo; \(S_{emb}\) huonyesha uwakilishi uliopachikwa unaotolewa kutoka kwenye vitambulisho hivi.
Upachikaji wa mzungumzaji hutumiwa kuimarisha uwakilishi wa kila modaliti. \(\eta\) ni parameta inayojifunzwa inayowakilisha uzito wa mchango wa taarifa ya mzungumzaji.
Katika grafu ya njia nyingi inayojengwa na modeli, kila kitengo cha mazungumzo hugawanywa katika nodi tatu za modaliti. \(N\) ni idadi ya semi katika mazungumzo. Katika hali hii, jumla ya nodi huongezeka mara tatu.
Katika grafu, mahusiano ya njia nyingi huundwa kati ya nodi za maandishi, sauti na picha za usemi uleule. Mahusiano haya hutumiwa kujifunza jinsi modaliti zinavyokamilishana.
Muktadha wa zamani na wa baadaye hufafanuliwa kama aina tofauti za uhusiano. \(P\) huwakilisha dirisha la zamani; \(F\) huwakilisha dirisha la baadaye. Muundo huu huruhusu modeli kushughulikia kwa umakini zaidi mwelekeo wa mtiririko wa mazungumzo.
Katika tabaka la RGCN, kila nodi hukusanya taarifa za majirani kutoka aina tofauti za mahusiano. \(W_r^{(k)}\) ni matriki ya uzito maalumu kwa aina ya uhusiano; \(W_0^{(k)}\) ni uzito unaohifadhi taarifa ya nodi yenyewe; na \(\sigma\) huonyesha uamsho wa ReLU.
Katika tabaka la Graph Transformer huhesabiwa alama ya attention kati ya nodi. Muundo huu husaidia kujifunza jirani yupi ni muhimu zaidi kwa nodi husika.
Katika hatua ya mwisho, uwakilishi wa maandishi, sauti na picha huunganishwa, na lebo ya hisia hutabiriwa kwa kila usemi.
Funguo kuu ya hasara inayotumiwa katika mafunzo ni cross-entropy. Hasara hii hupungua kadiri utabiri wa modeli unavyokaribia lebo halisi ya hisia.
Ujumbe Mkuu wa Grafu, Jedwali na Skimu
Skimu ya mfano wa mazungumzo katika utafiti inaonyesha kwamba usemi uleule unaweza kubeba hisia tofauti katika miktadha tofauti. Usemi mfupi na unaoonekana wa upande wowote kama “Me too” unaweza kuhusishwa na msisimko au furaha katika mazungumzo chanya kuhusu maandalizi ya kambi, lakini unaweza kubeba hasira au kutoridhika katika mazungumzo mengine yanayolalamikia filamu iliyochosha. Mfano huu unaonyesha kwa urahisi kwa nini muktadha ni lazima katika utambuzi wa hisia.
Usanifu wa modeli una sehemu nne kuu: uchimbaji wa sifa, uundaji wa grafu, kujifunza kwa grafu ya mahusiano na uainishaji wa hisia. Katika sehemu ya uchimbaji wa sifa, BERT hutumiwa kwa maandishi, na visimbaji vya msingi wa LSTM hutumiwa kwa sauti na picha. Katika sehemu ya uundaji wa grafu, mahusiano ya maandishi-sauti-picha ya usemi uleule na muktadha wa zamani/baadaye wa mazungumzo humodeliwa kama aina tofauti za kingo. Mtandao wa grafu ya mahusiano na Graph Transformer huchakata muundo huu changamano na kuzalisha uwakilishi tajiri zaidi kwa kila usemi.
Ujumbe mkuu wa majedwali ya matokeo ni kwamba modeli ya CAHRGN inaonyesha utendaji wenye nguvu katika seti tatu tofauti za data. Kwenye IEMOCAP-6, modeli hufikia usahihi wa asilimia 70,87 na weighted F1 ya asilimia 70,75. Kwenye IEMOCAP-4 hupata usahihi wa asilimia 84,97 na weighted F1 ya asilimia 84,81. Kwenye MELD, huripotiwa usahihi wa asilimia 64,83 na weighted F1 ya asilimia 63,01. Thamani hizi zinaonekana kuwa juu ya mbinu za msingi zilizolinganishwa.
Uchambuzi wa modaliti unaonyesha kwamba maandishi pekee ndiyo modaliti yenye nguvu zaidi. Sauti pekee hutoa mchango wa kiwango cha kati, ilhali picha pekee hubaki dhaifu zaidi. Hata hivyo, matokeo bora zaidi hupatikana wakati modaliti zote tatu zinatumiwa pamoja. Ugunduzi huu unaunga mkono kwamba utambuzi wa hisia si kazi ya kusoma maandishi tu; sauti na picha pia, hasa pamoja na muktadha, zinaweza kutoa taarifa ya ziada.
Matokeo ya ablation yanaonyesha kwamba vipengele vya msingi vya modeli vinafanya kazi kweli. RGCN au Graph Transformer zikiondolewa, utendaji hushuka. Kingo za mahusiano ya njia nyingi au kingo za muktadha zikiondolewa, matokeo pia hudhoofika. Hii inaonyesha kwamba mafanikio ya modeli hayategemei kipengele kimoja tu; yanatokana na kazi ya pamoja ya mahusiano ya modaliti, muktadha wa wakati, taarifa ya mzungumzaji na kujifunza kwa msingi wa grafu.
Uchambuzi wa taarifa ya mzungumzaji pia hutoa ujumbe muhimu. Wakati upachikaji wa mzungumzaji unatumiwa, modeli hutoa matokeo bora katika seti zote tatu za data. Hili linaunga mkono kwamba mitindo ya kujieleza na mielekeo ya hisia ya watu tofauti hubeba taarifa muhimu katika utambuzi wa hisia.
Majaribio Yalifanywaje?
Utafiti hutumia seti tatu maarufu za data za utambuzi wa hisia wa njia nyingi: IEMOCAP-4, IEMOCAP-6 na MELD. IEMOCAP-4 ina lebo nne za hisia: hasira, huzuni, furaha na upande wowote. IEMOCAP-6 hutumia lebo sita za hisia: furaha, huzuni, upande wowote, hofu, mshangao na hasira. Seti ya data ya MELD pia ni seti maarufu ya ulinganisho inayotumiwa kwa utambuzi wa hisia katika mazungumzo yenye wazungumzaji wengi.
Sifa za maandishi hutolewa kwa BERT. Sifa za sauti hutolewa kupitia OpenSmile kwa IEMOCAP, na kupitia librosa kwa MELD. Sifa za kuona hutolewa kwa kutumia OpenFace kwa IEMOCAP. Sifa hizi kisha huhamishwa kwenye muundo wa grafu wa modeli ya CAHRGN.
Utendaji wa modeli hupimwa kwa Accuracy na weighted F1-score. Accuracy ni uwiano wa mifano iliyotabiriwa kwa usahihi. Weighted F1-score ni kipimo kinachozingatia vizuri zaidi ukosefu wa usawa kati ya madarasa. Kwa kuwa katika seti za data za utambuzi wa hisia baadhi ya madarasa ya hisia yanaweza kuonekana kwa uchache kuliko mengine, weighted F1 ni muhimu hasa.
Katika majaribio, CAHRGN hulinganishwa na mbinu zilizotangulia kama bc-LSTM, DialogueRNN, DialogueGCN, MMGCN, COGMEN, DGSNet, FrameERC na nyingine zinazofanana. Pia, ili kuelewa ni kiasi gani modeli inanufaika na vipengele gani, hufanywa tafiti za ablation. Katika muktadha huu, modaliti hujaribiwa moja moja au pamoja; RGCN, Graph Transformer, kingo za njia nyingi, kingo za muktadha na upachikaji wa mzungumzaji huondolewa na mabadiliko ya utendaji huzingatiwa.
Matokeo Yanaonyesha Nini?
Matokeo ya kwanza ni kwamba CAHRGN inaonyesha utendaji wenye nguvu katika seti zote tatu za data. Modeli inapita mbinu nyingi zilizotangulia katika kazi ya utambuzi wa hisia ndani ya mazungumzo. Matokeo haya yanaonyesha kwamba muundo wa grafu tofautitofauti na utambuzi wa muktadha vinaweza kuwa na manufaa katika utambuzi wa hisia.
Matokeo ya pili ni kwamba taarifa ya maandishi bado ndiyo chanzo chenye nguvu zaidi cha pekee. Modaliti ya maandishi pekee hutoa utendaji wa juu kuliko modaliti za sauti na picha. Hata hivyo, matokeo bora zaidi hayapatikani kwa maandishi pekee, bali kwa matumizi ya pamoja ya maandishi, sauti na picha. Hii inaunga mkono thamani ya vitendo ya mtazamo wa njia nyingi.
Matokeo ya tatu ni kwamba mwelekeo wa muktadha ni muhimu. Semi zilizopita na zijazo hazipaswi kushughulikiwa kwa namna ileile. Modeli inapowakilisha muktadha wa zamani na wa baadaye kwa aina tofauti za mahusiano, inaweza kukamata vizuri zaidi mtiririko wa kihisia wa mazungumzo.
Matokeo ya nne ni kwamba taarifa ya mzungumzaji huchangia utambuzi wa hisia. Upachikaji wa mzungumzaji ukiondolewa, usahihi hushuka. Hili linaonyesha kwamba njia za watu kueleza hisia hutofautiana mtu kwa mtu, na ni muhimu kwa modeli kujifunza tofauti hii.
Matokeo ya tano ni kwamba vipengele vya RGCN na Graph Transformer hufanya kazi kwa kukamilishana. Wakati RGCN inachakata aina za mahusiano na ujirani wa grafu wa ndani, Graph Transformer husaidia kukamata muktadha mpana na utegemezi wa masafa marefu. Muunganiko wa usanifu hizi mbili huzalisha uwakilishi wenye nguvu zaidi kuliko miundo inayotumiwa peke yake.
Kwa Nini Hili Ni Muhimu?
Utambuzi wa hisia katika mazungumzo unaweza kutumiwa katika maeneo mengi kama huduma kwa wateja, teknolojia za elimu, roboti za kijamii, uchambuzi wa mikutano ya mtandaoni, tathmini ya ubora wa vituo vya simu na mwingiliano wa binadamu na kompyuta. Lakini katika maeneo haya, uaminifu na unyeti wa kimaadili ni muhimu sana. Hisia ya binadamu haiwezi kupunguzwa kuwa neno moja, uso mmoja au toni moja ya sauti.
Utafiti huu unaonyesha mwelekeo muhimu kwa mifumo ya utambuzi wa hisia iliyo na muktadha zaidi na njia nyingi zaidi. Ili kuelewa mtu anahisi nini, si lazima kuangalia tu neno alilosema, bali pia alilisema katika hatua gani ya mazungumzo, sentensi za kabla na baada yake, mtindo wa mzungumzaji na jinsi modaliti tofauti zinavyounga mkono kila nyingine.
Muundo wa modeli wa msingi wa grafu pia ni muhimu. Mazungumzo hayachukuliwi kama mlolongo tambarare wa maandishi, bali kama mtandao unaoundwa na watu, wakati, modaliti na mahusiano. Mtazamo huu unaweza kuchangia jinsi akili bandia inavyomodeli mawasiliano ya binadamu kwa njia ya kimahusiano na ya kimuktadha zaidi.
Hata hivyo, matumizi halisi ya mifumo ya aina hii yanahitaji tahadhari. Modeli za utambuzi wa hisia zinaweza kukisia vibaya, kukosa tofauti za kitamaduni, kutafsiri vibaya mitindo ya mtu binafsi ya kujieleza au kusababisha matatizo ya faragha ya data binafsi. Kwa hiyo modeli kama hizi zinapaswa kufikiriwa kama zana za kusaidia uamuzi, si mifumo ya uhakika inayoweka lebo moja kwa moja kwa binadamu.
Mambo ya Kuzingatia
Jambo la kwanza la kuzingatia ni kwamba utafiti ni preprint. Kwa kuwa haujapitia tathmini ya rika, utendaji wa modeli, maelezo ya mbinu na madai yanaweza kubadilika baadaye. Matokeo yanapaswa kusomwa kwa uangalifu na kwa kulinganishwa.
Jambo la pili la kuzingatia ni mipaka ya seti za data. Seti kama IEMOCAP na MELD zina thamani kwa utafiti; lakini mazungumzo halisi duniani ni changamano zaidi, yenye kelele zaidi, yenye utofauti mkubwa wa kitamaduni na yanayotegemea muktadha zaidi. Mafanikio katika seti ya data ya maabara au iliyokusanywa hayamaanishi moja kwa moja mafanikio ya dunia halisi.
Jambo la tatu la kuzingatia ni asili ya lebo za hisia. Hisia mara nyingi hazigawanyiki katika madarasa makali. Mtu anaweza kuwa na huzuni na hasira kwa wakati mmoja; anaweza kuzungumza kwa kejeli; anaweza kuficha hisia zake; anaweza kujieleza kwa namna tofauti kitamaduni. Kwa hiyo mifumo ya uainishaji wa hisia inapaswa kutathminiwa kila mara ikiwa na nafasi ya kutokuwa na uhakika.
Jambo la nne la kuzingatia ni taarifa ya mzungumzaji na faragha. Modeli kunufaika na utambulisho wa mzungumzaji kunaweza kuongeza utendaji; lakini kunahitaji umakini wa data binafsi na matumizi ya kimaadili. Taarifa kama wasifu wa mzungumzaji, mwelekeo wa hisia au mtindo wa kujieleza zinaweza kupata tabia ya data nyeti.
Mwishowe, maudhui haya si ushauri wa tathmini ya kisaikolojia au kitabibu. Matokeo ya utambuzi wa hisia wa msingi wa akili bandia hayapaswi kutumiwa peke yake kutafsiri tabia ya binadamu kwa uhakika.
Hitimisho
Utafiti huu unaonyesha kwamba utambuzi wa hisia katika mazungumzo si tatizo la kuainisha maneno pekee. Hisia ni ishara changamano ya mawasiliano inayoundwa pamoja na maandishi, sauti, picha, utambulisho wa mzungumzaji na muktadha unaoendelea kwa muda.
Modeli ya CAHRGN inatoa njia muhimu kwa kuwakilisha uchangamano huu ndani ya muundo wa grafu. Hushughulikia kila kitengo cha mazungumzo kwa nodi za maandishi, sauti na picha; huchakata pamoja mahusiano ya modaliti ndani ya usemi uleule, muktadha wa zamani na wa baadaye, taarifa ya mzungumzaji na utegemezi wa masafa marefu. Matokeo ya majaribio yanaonyesha kwamba usanifu huu unaweza kutoa utendaji wenye nguvu zaidi kuliko mbinu zilizopo.
Kwa Verianla, ujumbe mkuu wa utafiti huu ni huu: ili akili bandia ielewe vizuri zaidi hisia ya binadamu, haitoshi kuwa na modeli kubwa zaidi pekee; inahitaji usanifu sahihi zaidi wa muktadha. Hisia hazionekani katika sentensi moja tu; huibuka katika mtiririko wa mazungumzo, mtindo wa mzungumzaji na uhusiano kati ya maandishi-sauti-picha.
Noti ya Chanzo na Mbinu
Maudhui haya yametayarishwa kwa msingi wa utafiti wa preprint “CAHRGN: a Context-Aware Heterogeneous Relational Graph Network for Multimodal Emotion Recognition in Conversation” ulioandaliwa na Yuling Ren, Junpeng Bao, Kaiyu He, Tingyu Li na Jiangjiang Zhao. Utafiti unapendekeza modeli ya CAHRGN inayounganisha utambuzi wa hisia wa mazungumzo ya njia nyingi, mitandao ya grafu ya mahusiano tofautitofauti, upachikaji wa mzungumzaji, RGCN na usanifu wa Graph Transformer.
Maudhui haya si tafsiri ya neno kwa neno; wazo kuu la utafiti limebadilishwa kuwa makala asilia ya Kituruki ya kiuhariri, iliyorahisishwa kwa mujibu wa mstari wa uchapishaji wa Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *