

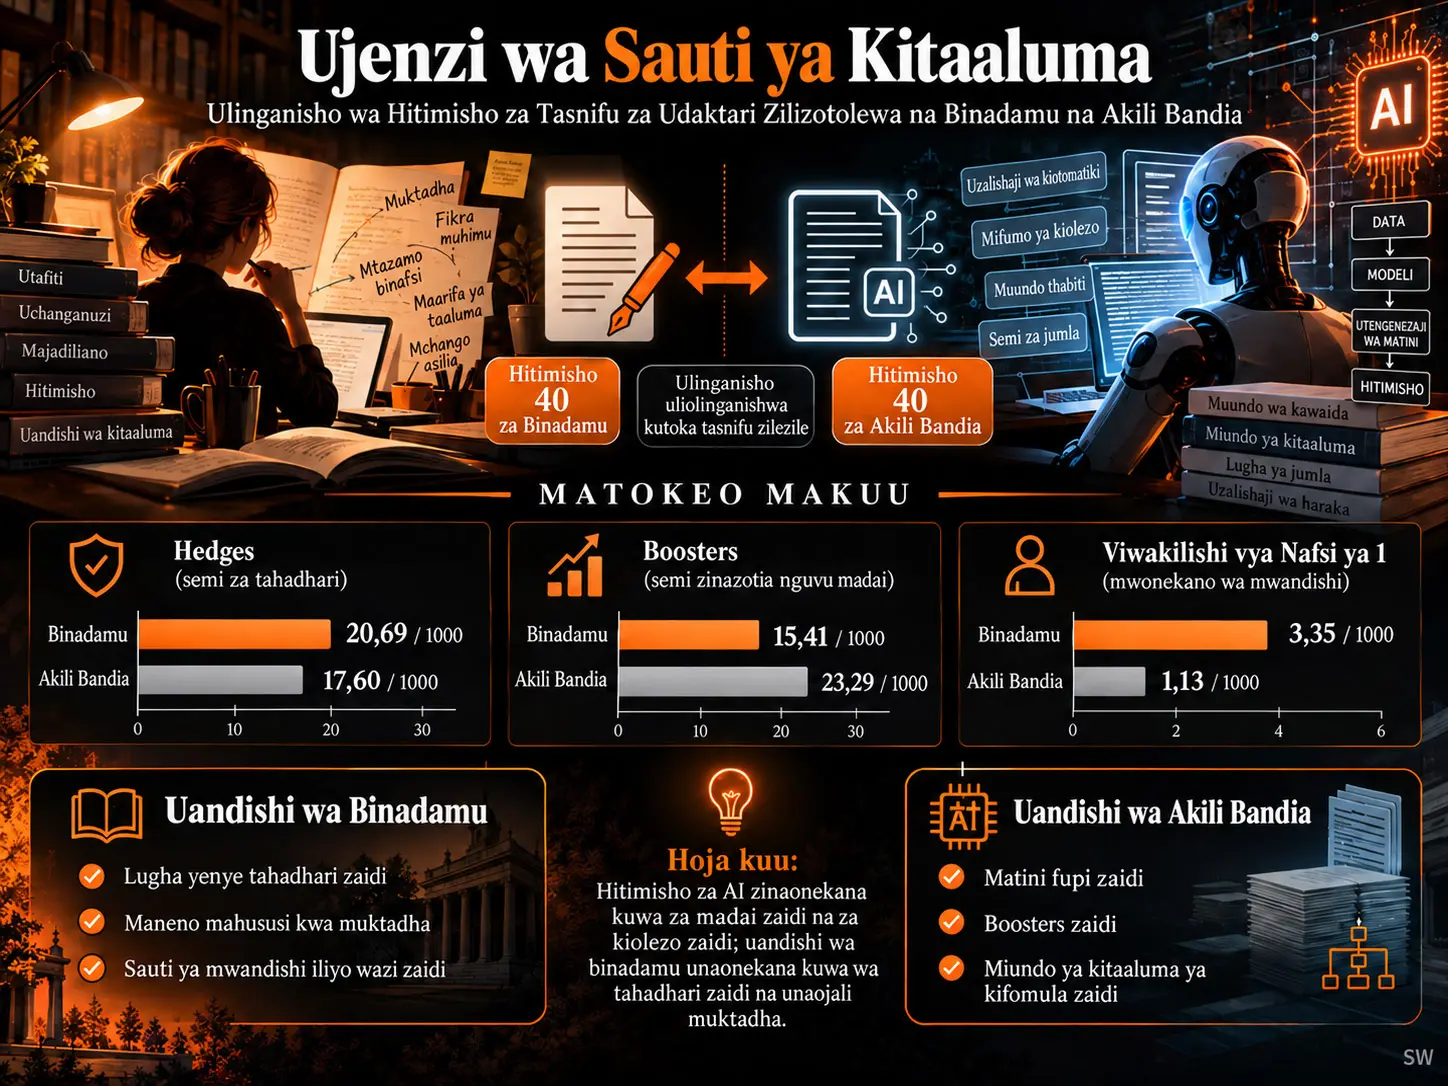
Mifumo ya akili bandia zalishi inaweza kuandika matini fasaha zinazofanana na mtindo wa kitaaluma; hata hivyo, ni muhimu kutosahau kwamba uandishi wa kitaaluma hauishii kwenye usahihi wa kisarufi pekee. Waandishi wa kisayansi hutumia nyenzo mbalimbali za lugha kudhibiti kiwango cha uhakika wa madai yao, sehemu ambazo wanakuwa waangalifu, namna wanavyoeleza tathmini zao, na kiwango ambacho wanafanya utambulisho wao wa kiuandishi uonekane katika matini. Vipengele hivi kwa pamoja vinaunda sehemu muhimu ya sauti ya kitaaluma.
Utafiti huu unalinganisha sehemu asilia za General Conclusion za tasnifu 40 za uzamivu katika Applied Linguistics na matini 40 mpya za General Conclusion zilizotolewa na Google Gemini 3 Flash Preview baada ya sehemu za hitimisho kuondolewa kutoka tasnifu hizo hizo. Hivyo, jumla ya jozi 40 za matini za human–AI zilizolinganishwa ziliundwa.
Uchanganuzi unalenga kategoria za hedges, boosters, attitude markers na self-mentions katika modeli ya stance ya Hyland. Katika korpasi ya binadamu, hedges zilipatikana kwa kiwango cha 20,69 kwa kila maneno 1.000, na katika korpasi ya AI kwa kiwango cha 17,60. Kwa upande mwingine, boosters zinaonekana kwa kiwango cha juu zaidi katika matini za AI: 15,41 katika korpasi ya binadamu na 23,29/1.000 maneno katika korpasi ya AI.
Kwa attitude markers, korpasi hizo mbili ziko karibu sana: 10,77 dhidi ya 11,10/1.000 maneno. Viwakilishi vya nafsi ya kwanza vilionekana kwa kiwango cha 3,35/1.000 katika hitimisho za binadamu na 1,13/1.000 pekee katika hitimisho za AI. Imeripotiwa kwamba waandishi wa binadamu hutumia zaidi uwepo wa moja kwa moja wa mwandishi kupitia “I” na “we”, ilhali matini za AI huelekea zaidi kwenye miundo kama “this study” na “the present thesis” inayofanya utafiti wenyewe kuwa kiima.
Hitimisho za AI zina wastani wa takribani maneno 730, ilhali hitimisho za binadamu zina takribani maneno 1.351. AI pia ilitumia mara nyingi zaidi miundo sanifu ya kufunga maandishi ya kitaaluma kama “in conclusion”, “this study set out to...” na “future research”. Muundo huu unaunga mkono mwelekeo kwamba, chini ya modeli na prompt zilizotumika, matini za AI huzalisha sauti ya kitaaluma iliyo fupi zaidi, yenye madai ya uhakika zaidi na iliyo ya kifomula zaidi.
Hata hivyo, chanzo kina matatizo muhimu ya uripoti na mbinu. Thamani za juu isivyo kawaida za kategoria ya self-mention, kama 500–600/1.000 maneno, haziwezi kupatanishwa kwa urahisi na majedwali mengine. Katika safu ya direction ya Table 2, ishara ya kategoria tatu imeandikwa kinyume. Ingawa Abstract inadai kwamba binadamu wana lexical diversity kubwa zaidi, majedwali ya TTR katika makala yanaonyesha thamani kubwa zaidi kwa AI. Aidha, ingawa data imeoanishwa, Mann–Whitney U na Welch t-test zilizotumika ni vipimo vya sampuli huru. Kwa hiyo, uchanganuzi upya wa baadhi ya matokeo unaweza kuwa na manufaa.
Sauti ya kitaaluma ni nini?
Sauti ya kitaaluma haijumuishi tu kile ambacho matini ya kisayansi inasema, bali pia namna mwandishi anavyojiweka kuhusiana na maarifa anayoyatoa. Mtafiti anaweza kuwasilisha ugunduzi kama ukweli wa uhakika, kuuweka kama uwezekano, kuongeza tathmini binafsi, au kufanya wajibu wake mwenyewe wa kisayansi uonekane moja kwa moja.
Mkabala wa stance wa Hyland huchunguza kazi hizi katika makundi manne ya msingi: hedges, boosters, attitude markers na self-mentions.
Hedge hufanya kazi gani?
Hedge hupunguza kiwango cha uhakika wa dai la kisayansi. Miundo kama “May”, “might”, “suggest” na inayofanana nayo huonyesha kwamba mwandishi anatoa hitimisho si kama ukweli kamili, bali kwa kiwango kinachoruhusiwa na ushahidi.
Katika utafiti, kwa korpasi ya binadamu 20,69 na kwa korpasi ya AI 17,60 hedge/1.000 maneno ziliripotiwa.
Hata hivyo, matokeo ya kitakwimu hutofautiana kulingana na mbinu. Katika Mann–Whitney U na Welch t-test, tofauti si p<0,05; lakini jaribio la aggregate log-likelihood linatoa matokeo yenye umuhimu. Kwa hiyo, kuna tofauti ya marudio inayoonyesha waandishi wa binadamu kuwa na epistemic caution zaidi, lakini ushahidi wa kitakwimu si sawa katika vipimo vyote.
Booster ni nini?
Booster ni alama ya lugha inayoongeza uhakika au nguvu ya dai. Misemo kama “Clearly demonstrates”, “reveals” na “establishes” huonyesha kwamba mwandishi amejifunga kwa nguvu zaidi kwenye kauli fulani.
Korpasi ya AI:
23,29 booster / 1.000 maneno
wakati korpasi ya binadamu:
15,41 / 1.000 maneno
imezalisha.
Tofauti hii ni mojawapo ya matokeo thabiti zaidi ya kitakwimu katika utafiti. Vipimo vyote vitatu vya chanzo vinaripoti tofauti yenye umuhimu kati ya korpasi katika matumizi ya booster.
Kwa hiyo, utafiti unapendekeza kwamba chini ya modeli ya Gemini na prompt iliyotumika, hitimisho za AI huunda toni ya assertive zaidi kuliko hitimisho za binadamu.
Je, attitude markers ni tofauti?
Hakuna tofauti kubwa kati ya korpasi hizo mbili.
Binadamu:
10,77 / 1.000
AI:
11,10 / 1.000
na Welch test ni p=0,8352.
Kwa hiyo, utafiti haukupata tofauti dhahiri ya human–AI katika matumizi ya evaluative attitude.
Hitimisho za Binadamu na AI Zinatofautiana kwa Kiasi Gani kwa Urefu?
| Kipengele | Korpasi ya Binadamu | Korpasi ya AI |
|---|---|---|
| Idadi ya matini | 40 | 40 |
| Jumla ya maneno | 54.046 | 29.197 |
| Jumla ya sentensi | 2.051 | 1.257 |
| Wastani wa maneno | 1.351,2 | 729,9 |
| Wastani wa sentensi | 51,3 | 31,4 |
Sehemu za hitimisho za binadamu ni ndefu kwa wastani takribani mara 1,85 kuliko hitimisho za AI.
Tofauti hii peke yake haithibitishi kwamba AI kwa asili huwa fupi zaidi. Chanzo kinaeleza wazi kwamba muundo wa prompt na mipaka ya input/output ya modeli huenda iliathiri urefu wa conclusion.
Binadamu au AI Hutumia Utofauti Mkubwa Zaidi wa Msamiati?
Kuna mkanganyiko muhimu ndani ya chanzo kuhusu suala hili.
Abstract inasema waandishi wa binadamu wana lexical diversity kubwa zaidi. Kinyume chake, katika Table 1 Type-Token Ratio imetolewa kama:
Human = 0,0854
AI = 0,1262
.
Katika jedwali la baadaye la standardize TTR, AI pia imeripotiwa kuwa 138,11 na korpasi ya binadamu 91,06. Aidha, katika hitimisho zote 40 zilizoanishwa, thamani ya TTR ya AI imeonyeshwa kuwa kubwa kuliko ya jozi ya binadamu.
Kwa hiyo, data za nambari za utafiti wenyewe haziungi mkono hitimisho kwamba “binadamu walionyesha lexical diversity kubwa zaidi”.
Tofauti ambayo chanzo kinaunga mkono vizuri zaidi ni hii:
AI huonyesha vipimo vya juu zaidi vya lexical-variety, ilhali waandishi wa binadamu hutumia context-specific vocabulary zaidi.
Katika korpasi ya binadamu, maneno yanayohusiana na muktadha halisi wa utafiti kama “teachers”, “teaching”, “writing” hujitokeza zaidi, ilhali katika korpasi ya AI maneno ya jumla ya kitaaluma kama “doctoral”, “transition”, “landscape” na “underscores” yanaonekana kuwa bainifu zaidi.
Kwa Nini AI Inaonekana ya Kifomula Zaidi?
Phraseological analysis inaonyesha kwamba baadhi ya miundo ya academic-summary hurudiwa katika hitimisho za AI.
Kwa mfano, “in conclusion” ilionekana mara mbili katika korpasi ya binadamu na mara 31 katika korpasi ya AI.
Muundo wa maneno matano wa “This study set out to investigate...” ulionekana mara 10 katika korpasi ya AI; na muundo unaofanana na “The present doctoral thesis set out to...” ulionekana mara nane.
Muundo huu unapendekeza kwamba AI hutumia mara nyingi zaidi violezo vya kitaaluma vyenye uwezekano mkubwa ili kupanga hitimisho.
Uwepo huu wa kifomula si kosa la kisarufi. Matini inaweza kuwa sahihi sana lakini ikatumia rhetorical packaging inayofanana katika tafiti tofauti.
Kwa Nini Matumizi ya “Future Research” Yanavutia?
Kauli “Future research” ilipatikana mara tisa katika korpasi ya binadamu na mara 43 katika korpasi ya AI.
Kwa kuzingatia kwamba korpasi ya AI ni fupi zaidi kuliko korpasi ya binadamu, tofauti iliyorekebishwa kwa urefu huwa kubwa zaidi.
Matokeo haya yanaendana na mwelekeo wa AI kutumia wito wa utafiti wa baadaye kama genre marker ya kawaida wakati wa kufunga aina ya conclusion ya tasnifu ya uzamivu.
Hata hivyo, si matokeo yote ya recommendation yana kiwango sawa cha kuaminika. Chanzo kinalinganisha baadhi ya miundo ya recommendation kwa kutumia marudio ghafi pekee na hakizingatii tofauti ya ukubwa wa korpasi. Kwa hiyo, ni lazima kuwa waangalifu zaidi kuhusu ni korpasi ipi kwa ujumla “hutoa mapendekezo ya moja kwa moja zaidi”.
Namna Mwandishi Anavyojionyesha Katika Matini Inatofautianaje?
Tofauti katika viwakilishi vya nafsi ya kwanza ni wazi kabisa:
| Kiashiria | Binadamu | AI |
|---|---|---|
| Viwakilishi vya nafsi ya 1 / 1.000 | 3,35 | 1,13 |
| Passive constructions / 1.000 | 12,84 | 6,23 |
| Wastani wa urefu wa sentensi | 26,4 | 23,2 |
Waandishi wa binadamu wana mwelekeo mkubwa zaidi wa kufanya wajibu wao wa kitaaluma uonekane moja kwa moja kwa kutumia miundo kama “I” na “we”.
AI, kwa upande mwingine, huelekea zaidi kwenye miundo ya authorial proxy kama “this study” na “the present thesis” ambayo hufanya utafiti kuwa kiima.
Kwa hiyo, kuchunguza si tu jumla ya “self-mention” bali pia namna authorial presence inavyoundwa ni jambo lenye taarifa zaidi.
Kwa Nini Kuna Tatizo Katika Matokeo ya Self-Mention?
Katika Table 2 ya chanzo, self-mention 27.171 zimehesabiwa kwa korpasi ya binadamu na 17.611 kwa korpasi ya AI. Viwango vilivyonormishwa ni 502,74 na 603,18/1.000 maneno mtawalia.
Huu ni ukubwa wa matokeo unaomaanisha kwamba takribani moja kati ya kila maneno mawili limeainishwa kama self-mention.
Chanzo hicho hicho kinaripoti viwakilishi vya nafsi ya kwanza katika viwango vya 3,35 na 1,13/1.000 pekee, huku muundo wa kawaida wa “this study/research/thesis/paper” ukiwa umehesabiwa mara 128 na 200 pekee.
Kwa hiyo, haiwezekani kuelewa kutoka katika uripoti uliopo wa makala jinsi jumla ya self-mention ilivyofikia kiwango hiki cha juu.
Bila kuchapishwa kwa kamusi ya kuhesabu na msimbo wa Python, kategoria hii haiwezi kuthibitishwa kwa kujitegemea. Kwa hiyo, matokeo ya self-mention hayapaswi kuwekwa miongoni mwa matokeo ya kiasi yaliyo imara zaidi ya utafiti.
Je, Kuna Hitilafu ya Kuripoti Katika Table 2?
Ndiyo. Safu ya “Direction” inaandika HC > AIC kwa kategoria zote.
Hata hivyo, nambari zilizonormishwa zinaonyesha kwamba AIC ni kubwa zaidi katika kategoria za boosters, attitude markers na source-defined self-mentions.
Kwa kuwa maandishi ya maelezo yanayofuata yanatumia mwelekeo sahihi, huenda hili ni kosa la upangaji wa jedwali au la uripoti.
Je, Muundo Ulioanishwa Umehamishwa Kikamilifu Katika Uchanganuzi wa Kitakwimu?
Hapana. Nguvu muhimu ya utafiti ni kwamba jozi 40 za matini za human–AI zinatoka kwenye tasnifu zilezile za chanzo. Kila AI conclusion ina human conclusion inayolingana nayo moja kwa moja.
Hata hivyo, Mann–Whitney U na Welch t-test zilitumika katika ulinganisho wa kitakwimu. Hivi ni vipimo vya sampuli huru na havitumii moja kwa moja taarifa ya thesis-level pairing.
Kwa hiyo, uchanganuzi upya kwa kutumia vipimo vilivyoanishwa kama paired t-test au Wilcoxon signed-rank unaweza kutathmini vizuri zaidi uimara wa kitakwimu wa matokeo.
Hasa kwa hedges, ukweli kwamba vipimo tofauti vinatoa matokeo tofauti ya umuhimu hufanya uchanganuzi huu upya kuwa muhimu.
Mbinu na Matokeo ya Utafiti
Muundo wa korpasi
Utafiti ulitumia jozi 40 za matini zilizoanishwa zinazojumuisha 40 human-written na 40 AI-generated General Conclusion.
Chanzo cha korpasi ya binadamu
Tasnifu za uzamivu zilizoandikwa kwa Kiingereza, katika Applied Linguistics au nyanja iliyo karibu, na zinazopatikana kwa ufikiaji wazi kutoka vyuo vikuu vya Algeria zilichaguliwa.
Uzalishaji wa AI
Sehemu asilia ya General Conclusion ya kila tasnifu iliondolewa; sehemu nyingine kama utangulizi, fasihi, mbinu, matokeo na discussion zilitolewa kwa modeli ya Gemini 3 Flash Preview.
Udhibiti wa prompt
Prompt ileile, iliyokusudiwa kuwa rahisi, ilitumika katika tasnifu zote 40. Prompt haikuomba modeli kutumia stance au mtindo fulani wa kitaaluma kwa namna maalum.
Mfumo wa uchanganuzi
Kwa mujibu wa modeli ya stance ya Hyland, hedges, boosters, attitude markers na self-mentions zilichanganuliwa.
Unormishaji
Marudio ya stance-marker yalirekebishwa kwa kila maneno 1.000 ili kupunguza tofauti ya urefu wa korpasi.
Takwimu
Mann–Whitney U, Welch t-test na log-likelihood zilitumika. Ingawa muundo ulikuwa umeoanishwa, vipimo viwili vya kwanza havitathmini pairing moja kwa moja.
Matokeo makuu ya stance
| Kategoria | Binadamu / 1.000 | AI / 1.000 | Tafsiri salama zaidi |
|---|---|---|---|
| Hedges | 20,69 | 17,60 | Binadamu ni ya juu zaidi; vipimo havikubaliani kuhusu umuhimu |
| Boosters | 15,41 | 23,29 | AI ni ya juu zaidi kwa uwazi |
| Attitude markers | 10,77 | 11,10 | Hakuna tofauti dhahiri |
| Self-mentions | 502,74 | 603,18 | Haipaswi kutumika bila kuthibitisha hesabu ya chanzo |
Uwepo wa mwandishi katika nafsi ya kwanza
Matini za binadamu zinaonyesha 3,35 first-person pronoun/1.000, na matini za AI 1,13/1.000.
Miundo ya balagha
AI ilitumia zaidi standardized academic expressions kama “in conclusion”, “this study...” na “future research”.
Matokeo ya leksia
Majedwali ya TTR ya chanzo yanaonyesha thamani za juu zaidi za lexical-variety kwa AI, ilhali uchanganuzi wa keyword na bundle unaonyesha uandishi wa binadamu kuwa context-specific zaidi. Vipengele hivi viwili vinapaswa kutenganishwa.
Sentence complexity
Hitimisho za binadamu zilitumia sentensi za wastani wa maneno 26,4, na hitimisho za AI sentensi za wastani wa maneno 23,2.
Passive voice
Katika korpasi ya binadamu, passive constructions ziliripotiwa kuwa 12,84/1.000, na katika korpasi ya AI 6,23/1.000.
Matokeo yanayoungwa mkono na utafiti
Katika seti hii ya data, AI conclusion ni fupi kuliko human conclusion. AI hutumia boosters kwa msongamano mkubwa zaidi. Hakuna tofauti dhahiri katika matumizi ya attitude-marker. Waandishi wa binadamu hutumia zaidi authorial presence ya nafsi ya kwanza. AI huonyesha zaidi standardized conclusion formula na generic academic phrasing. Matini za binadamu, kwa upande mwingine, hutumia mara nyingi zaidi maneno yanayohusiana na muktadha halisi wa utafiti.
Matokeo yasiyoungwa mkono na utafiti
Haiwezi kusemwa kwamba modeli zote za akili bandia huandika kwa msisitizo mkubwa zaidi kuliko binadamu. Haiwezi kuhitimishwa kutokana na utafiti huu kwamba AI kwa ujumla ina lexical diversity ya chini zaidi. Kiwango cha self-mention cha 603/1.000 hakijathibitishwa kwa kujitegemea. Hakuna upangaji wa jumla wa ubora wa uwezo wa binadamu na AI katika uandishi wa kitaaluma uliotolewa. Utafiti umewekewa mipaka kwa modeli moja, prompt moja sanifu, taaluma mahususi na tasnifu 40 kutoka vyuo vikuu vya Algeria.
Maelezo ya Chanzo na Mbinu
Utafiti asilia:Constructing Academic Voice: A Corpus-Based Comparison of Human- and AI-Generated Doctoral Thesis Conclusions
Mwandishi: Dhaya Eddine Ayachi.
Taasisi katika PDF: Mohammed Seddik Ben Yahia University, Faculty of Letters and Languages, Department of English.
Jukwaa: SSRN.
Tarehe ya uchapishaji wa SSRN: 10 Juni 2026.
SSRN DOI: 10.2139/ssrn.6911006.
Aina ya chanzo: preprint research paper ya kurasa 36.
Hali ya uhakiki: Preprint not peer reviewed.
Leseni: All rights reserved; no reuse allowed without permission.
Modeli kuu ya AI: Google Gemini 3 Flash Preview.
Korpasi: jozi 40 zilizoanishwa za human–AI General Conclusion.
Mfumo wa kinadharia: Modeli ya stance ya Hyland.
Zana za uchanganuzi: Python; NLTK; SciPy; uchanganuzi wa marker unaotegemea regex; Mann–Whitney U, Welch t-test na log-likelihood.
Vikwazo vikuu: Kutumia LLM moja na prompt moja; korpasi ya human kuwekwa ndani ya taaluma moja na muktadha wa nchi moja; tofauti kubwa katika urefu wa matini za binadamu na AI; kutumia vipimo vya sampuli huru licha ya muundo ulioanishwa; marudio ya juu yasiyoelezeka katika kategoria ya self-mention; baadhi ya uchanganuzi wa rhetorical-move kutegemea idadi ghafi zisizonormishwa; makosa katika lebo za direction za Table 2; mgongano kati ya tafsiri ya lexical-diversity katika abstract na matokeo ya TTR.
Kanuni ya uwasilishaji ya Verianla: Maudhui haya si tafsiri kamili ya matini ya preprint ya chanzo. Muundo wa korpasi, matokeo ya stance-marker, matokeo ya phraseological na matatizo ya kimetodolojia ndani ya chanzo yamehifadhiwa huku muundo huru, wa kufundisha na wa kukosoa ukiundwa. Matini za conclusion na majedwali ya chanzo hayajatumiwa tena kwa njia ya kimitambo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *