

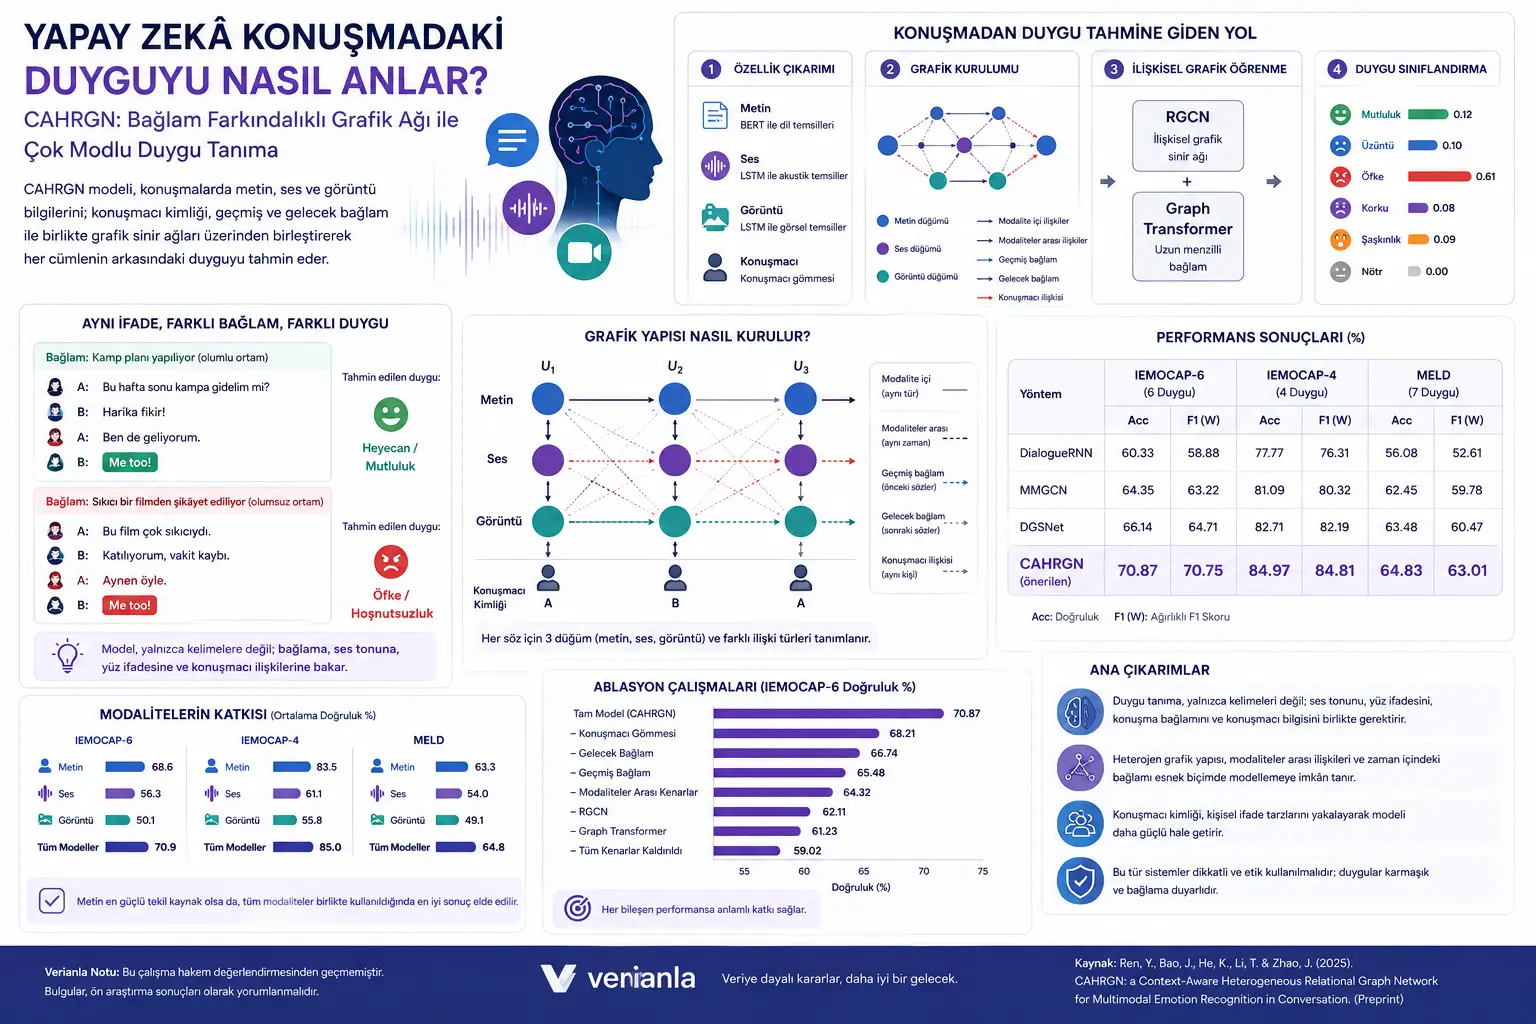
Bir söhbətdə emosiyanı anlamaq çox vaxt yalnız bir cümləni oxumaqdan ibarət deyil. Eyni cümlə fərqli kontekstlərdə tamamilə fərqli emosiyalar daşıya bilər. Məsələn, “Mən də” ifadəsi bir söhbətdə həyəcanı, başqa bir söhbətdə qəzəbi və ya məyusluğu əks etdirə bilər. Buna görə süni intellektin söhbətdəki emosiyanı anlaması üçün yalnız sözlərə deyil, söhbətin axınına, danışanların kim olduğuna, səs tonuna və vizual ipuclarına da baxması lazımdır.
Bu tədqiqat söhbətlərdə multimodal emosiya tanınması üçün CAHRGN adlı yeni model təklif edir. CAHRGN, “Context-Aware Heterogeneous Relational Graph Network” ifadəsinin qısaltmasıdır. Azərbaycan dilinə “Kontekstdən Xəbərdar Heterogen Əlaqəli Qraf Şəbəkəsi” kimi çevrilə bilər. Model hər danışıq vahidini mətn, səs və görüntü olmaqla üç ayrı informasiya kanalı ilə təmsil edir; sonra bu kanallar arasındakı əlaqələri və söhbətin gedişindəki keçmiş-gələcək kontekstini qraf strukturu daxilində emal edir.
Tədqiqatın əsas mesajı budur: Emosiya tanınması üçün yalnız mətni təhlil etmək kifayət deyil. Söhbətin zaman axını, danışanların ifadə tərzi və mətn-səs-görüntü arasındakı əlaqələr birlikdə nəzərə alındıqda model daha güclü nəticələr verə bilər.
Problem Nədir?
Emosiya tanıma sistemləri çox vaxt qısa mətnlərdən, səs yazılarından və ya üz ifadələrindən emosiya proqnozu verməyə çalışır. Lakin real söhbətlər təkbaşına nəzərdən keçirilən bir cümlədən xeyli mürəkkəbdir. İnsanlar əvvəlki cümlələrə cavab verir, danışanlar bir-birinə təsir edir, bəzən sözlər neytral görünür, amma səs tonu və ya üz ifadəsi fərqli emosiya daşıyır.
Buna görə söhbət daxilində emosiya tanınması klassik emosiya təsnifatından daha çətin problemdir. Model yalnız “bu cümlədə hansı sözlər var?” sualını deyil; “bu cümləni kim deyib, əvvəl nə deyilib, sonra nə gəlib, səs və görüntü bu mətni dəstəkləyir, yoxsa onunla ziddiyyət təşkil edir?” suallarını da cavablandırmalıdır.
Əvvəlki üsulların bir qismi söhbət ardıcıllığını LSTM kimi təkrarlanan şəbəkələrlə izləyir. Bu üsullar yaxın konteksti tuta bilər; lakin uzun söhbətlərdə uzaq asılılıqları qorumaqda çətinlik çəkə bilər. Qraf əsaslı üsullar isə söhbətdəki əlaqələri daha çevik modelləşdirə bilər; lakin bəziləri mətn, səs və görüntünü tək bir birləşmiş düyün kimi nəzərdən keçirdiyinə görə hər modalın özünəməxsus töhfəsindən kifayət qədər istifadə edə bilmir.
Tədqiqatın həll etməyə çalışdığı problem məhz budur: Süni intellekt multimodal söhbətlərdə həm modallar arasındakı əlaqələri, həm də keçmiş və gələcək kontekstin fərqli təsirlərini necə daha yaxşı modelləşdirə bilər?
Metod Nə Təklif Edir?
CAHRGN modeli söhbəti qraf kimi nəzərdən keçirir. Qraf düyünlərdən və kənarlardan ibarət strukturdur. Bu tədqiqatda hər danışıq vahidi, yəni hər utterance, üç ayrı modalla təmsil edilir: mətn, səs və görüntü. Beləliklə, tək bir cümlə üçün yalnız bir düyün yaratmaq əvəzinə mətn düyünü, səs düyünü və görüntü düyünü yaradılır.
Bu yanaşma vacibdir; çünki emosiyanın əlaməti həmişə eyni kanalda güclü olmaya bilər. Bəzi hallarda sözlər emosiyaya açıq şəkildə işarə edir. Bəzi hallarda səs tonu daha müəyyənedici olur. Bəzi hallarda üz ifadəsi və ya vizual davranış mətndən daha çox informasiya daşıyır. CAHRGN bu kanalları bir yerə qarışdırmadan, aralarındakı əlaqələri ayrıca öyrənməyə çalışır.
Modelin ikinci mühüm ideyası söhbətdə zaman istiqamətini ayırmasıdır. Keçmiş cümlələr və gələcək cümlələr eyni növ kontekst kimi nəzərdən keçirilmir. Çünki bir cümlənin emosiyasını anlamaqda əvvəlki sözlər başqa, sonrakı reaksiyalar isə başqa ipucları verə bilər. Buna görə model keçmiş kontekst və gələcək kontekst üçün ayrı əlaqə növləri qurur.
Üçüncü ideya danışan məlumatıdır. Eyni emosiya müxtəlif insanlarda fərqli ifadə oluna bilər. Bəzi insanlar qəzəbini açıq göstərir, bəziləri daha neytral danışır; bəzi danışanlar qısa və sərt ifadələrdən istifadə edir, bəziləri dolayı danışır. Model danışan kimliyini embedding təmsil kimi əlavə edərək şəxsə xas ifadə tərzlərini tutmağa çalışır.
Nəhayət CAHRGN, RGCN və Graph Transformer arxitekturalarından birlikdə istifadə edir. RGCN müxtəlif əlaqə növlərinə malik qraflarda düyünlərarası informasiya ötürülməsini öyrənir. Graph Transformer isə daha geniş konteksti və uzaq əlaqələri tutmağa kömək edir. Beləliklə, model həm lokal söhbət əlaqələrini, həm də daha geniş dialoq strukturunu birlikdə emal edir.
Formullar Nəyi İzah Edir?
Tədqiqatda modelin əsas komponentlərini izah edən çoxsaylı riyazi ifadələr yer alır. Aşağıdakı formullar tədqiqatdakı simvol strukturuna mümkün qədər sadiq şəkildə verilib və Azərbaycan dilində izahlarla sadələşdirilib.
Mətn modalı üçün BERT istifadə olunur. Burada \(U_i^l\), söhbətdəki \(i\). ifadənin mətn formasını; \(u_i^l\) isə BERT tərəfindən çıxarılan mətn təmsilini göstərir.
Səs və görüntü kanalları üçün Bi-LSTM əsaslı enkoderlərdən istifadə olunur. Bu enkoderlər hər danışıq vahidinin səs və vizual xüsusiyyətlərini sabit uzunluqlu təmsillərə çevirir.
Danışan məlumatı ayrıca embedding qatı ilə təmsil olunur. \(S\), söhbətdəki danışan kimliklərini; \(S_{emb}\) isə bu kimliklərdən yaradılan embedding təmsili ifadə edir.
Danışan embedding-i hər modal təmsili gücləndirmək üçün istifadə olunur. \(\eta\), danışan məlumatının töhfə çəkisini təmsil edən öyrənilə bilən parametrdir.
Modelin qurduğu multimodal qrafda hər danışıq vahidi üç modal düyünə ayrılır. \(N\), söhbətdəki ifadə sayıdır. Bu halda ümumi düyün sayı üç dəfə artır.
Qrafda eyni ifadənin mətn, səs və görüntü düyünləri arasında multimodal əlaqələr qurulur. Bu əlaqələr modalların bir-birini necə tamamladığını öyrənmək üçün istifadə olunur.
Keçmiş və gələcək kontekst ayrıca əlaqə növləri kimi müəyyənləşdirilir. \(P\), keçmiş pəncərəni; \(F\), gələcək pəncərəni təmsil edir. Bu struktur modelin söhbət axınının istiqamətini daha həssas nəzərə almasına imkan verir.
RGCN qatında hər düyün müxtəlif əlaqə növlərindən gələn qonşu məlumatlarını toplayır. \(W_r^{(k)}\), əlaqə növünə xas çəki matrisini; \(W_0^{(k)}\), düyünün öz məlumatını qoruyan çəkini; \(\sigma\) isə ReLU aktivləşdirməsini göstərir.
Graph Transformer qatında düyünlərarası attention balı hesablanır. Bu struktur hansı qonşunun müvafiq düyün üçün daha vacib olduğunu öyrənməyə xidmət edir.
Son mərhələdə mətn, səs və görüntü təmsilləri birləşdirilir və hər ifadə üçün emosiya etiketi proqnozlaşdırılır.
Təlimdə istifadə olunan əsas itki funksiyası cross entropy-dir. Modelin proqnozu həqiqi emosiya etiketinə yaxınlaşdıqca bu itki azalır.
Qrafik, Cədvəl və Sxemin Əsas Mesajı
Tədqiqatdakı nümunə söhbət sxemi eyni ifadənin fərqli kontekstlərdə fərqli emosiya daşıya biləcəyini göstərir. “Me too” kimi qısa və səthdə neytral görünən ifadə düşərgəyə hazırlıq görülən müsbət söhbətdə həyəcan və ya xoşbəxtliklə əlaqələnə bildiyi halda, darıxdırıcı filmdən şikayət edilən başqa söhbətdə qəzəb və ya narazılıq daşıya bilər. Bu nümunə emosiya tanınmasında kontekstin niyə əvəzolunmaz olduğunu sadə şəkildə göstərir.
Model arxitekturası dörd əsas hissədən ibarətdir: xüsusiyyət çıxarılması, qrafın qurulması, əlaqəli qraf öyrənməsi və emosiya təsnifatı. Xüsusiyyət çıxarılması bölməsində mətn üçün BERT, səs və görüntü üçün LSTM əsaslı enkoderlərdən istifadə olunur. Qrafın qurulması bölməsində eyni ifadənin mətn-səs-görüntü əlaqələri və söhbətin keçmiş/gələcək konteksti ayrıca kənar növləri kimi modelləşdirilir. Əlaqəli qraf şəbəkəsi və Graph Transformer isə bu mürəkkəb strukturu emal edərək hər ifadə üçün daha zəngin təmsil yaradır.
Nəticə cədvəllərinin əsas mesajı CAHRGN modelinin üç fərqli verilənlər dəstində də güclü performans göstərməsidir. IEMOCAP-6 üzərində model yüzdə 70,87 dəqiqlik və yüzdə 70,75 weighted F1 dəyərinə çatır. IEMOCAP-4 üzərində yüzdə 84,97 dəqiqlik və yüzdə 84,81 weighted F1 əldə edilir. MELD üzərində isə yüzdə 64,83 dəqiqlik və yüzdə 63,01 weighted F1 dəyəri bildirilir. Bu dəyərlər müqayisə edilən əsas üsullardan daha yüksək görünür.
Modal analizlər təkbaşına mətnin ən güclü modal olduğunu göstərir. Səs təkbaşına orta səviyyədə töhfə verdiyi halda, görüntü təkbaşına daha zəif qalır. Lakin üç modal birlikdə istifadə edildikdə ən yaxşı nəticələr əldə olunur. Bu tapıntı emosiya tanınmasının yalnız mətn oxuma işi olmadığını; səs və görüntünün də xüsusilə kontekstlə birlikdə əlavə informasiya verə bildiyini göstərir.
Ablation nəticələri modelin əsas komponentlərinin həqiqətən işlədiyini göstərir. RGCN və ya Graph Transformer çıxarıldıqda performans azalır. Multimodal əlaqə kənarları və ya kontekst kənarları çıxarıldıqda da nəticələr zəifləyir. Bu, modelin uğurunun tək bir komponentə deyil; modal əlaqələri, zaman konteksti, danışan məlumatı və qraf əsaslı öyrənmənin birlikdə işləməsinə əsaslandığını göstərir.
Danışan məlumatı analizi də mühüm mesaj verir. Danışan embedding-i istifadə edildikdə model üç verilənlər dəstində də daha yaxşı nəticə verir. Bu, fərqli insanların ifadə tərzi və emosiya meyllərinin emosiya tanınmasında mənalı informasiya daşıdığını dəstəkləyir.
Təcrübələr Necə Aparılıb?
Tədqiqatda üç geniş istifadə olunan multimodal emosiya tanıma verilənlər dəsti istifadə olunur: IEMOCAP-4, IEMOCAP-6 və MELD. IEMOCAP-4 dörd emosiya etiketini əhatə edir: qəzəb, kədər, xoşbəxtlik və neytral. IEMOCAP-6 isə xoşbəxtlik, kədər, neytral, qorxu, təəccüb və qəzəb olmaqla altı emosiya etiketindən istifadə edir. MELD verilənlər dəsti də çoxdanışanlı dialoqlarda emosiya tanınması üçün istifadə olunan geniş yayılmış müqayisə verilənlər dəstidir.
Mətn xüsusiyyətləri BERT ilə çıxarılır. Səs xüsusiyyətləri IEMOCAP üçün OpenSmile, MELD üçün librosa vasitəsilə əldə edilir. Vizual xüsusiyyətlər IEMOCAP üçün OpenFace istifadə edilərək çıxarılır. Bu xüsusiyyətlər daha sonra CAHRGN modelinin qraf strukturuna ötürülür.
Modelin performansı Accuracy və weighted F1-score ilə ölçülür. Accuracy düzgün proqnozlaşdırılan nümunələrin nisbətidir. Weighted F1-score isə sinif balanssızlıqlarını daha yaxşı nəzərə alan ölçüdür. Emosiya tanıma verilənlər dəstlərində bəzi emosiya sinifləri digərlərindən daha az görünə bildiyi üçün weighted F1 xüsusilə vacibdir.
Təcrübələrdə CAHRGN, bc-LSTM, DialogueRNN, DialogueGCN, MMGCN, COGMEN, DGSNet, FrameERC və oxşar əvvəlki üsullarla müqayisə edilir. Bundan əlavə, modelin hansı komponentlərdən nə qədər faydalandığını anlamaq üçün ablation tədqiqatları aparılır. Bu çərçivədə modallar ayrı-ayrılıqda və ya birlikdə sınaqdan keçirilir; RGCN, Graph Transformer, multimodal kənarlar, kontekst kənarları və danışan embedding-i çıxarılaraq performans dəyişməsi müşahidə edilir.
Nəticələr Nəyi Göstərir?
İlk nəticə CAHRGN-nin üç verilənlər dəstində də güclü performans göstərməsidir. Model söhbət daxilində emosiya tanıma tapşırığında əvvəlki bir çox üsulu geridə qoyur. Bu nəticə heterogen qraf strukturunun və kontekstdən xəbərdarlığın emosiya tanınmasında faydalı ola biləcəyini göstərir.
İkinci nəticə mətn məlumatının hələ də ən güclü tək mənbə olmasıdır. Təkcə mətn modalı səs və görüntü modallarından daha yüksək performans verir. Lakin ən yaxşı nəticə yalnız mətnlə deyil, mətn, səs və görüntünün birlikdə istifadəsi ilə əldə olunur. Bu, multimodal yanaşmanın praktik dəyərini dəstəkləyir.
Üçüncü nəticə kontekstin istiqamətinin vacib olmasıdır. Keçmiş və gələcək ifadələr eyni şəkildə nəzərdən keçirilməməlidir. Model keçmiş və gələcək konteksti ayrı əlaqə növləri ilə təmsil etdikdə söhbətdəki emosional axını daha yaxşı tuta bilər.
Dördüncü nəticə danışan məlumatının emosiya tanınmasına töhfə verməsidir. Danışan embedding-i çıxarıldıqda dəqiqlik azalır. Bu da insanların emosiya ifadə tərzlərinin insandan insana dəyişdiyini və modelin bu fərqi öyrənməsinin faydalı olduğunu göstərir.
Beşinci nəticə RGCN və Graph Transformer komponentlərinin bir-birini tamamlayaraq işləməsidir. RGCN əlaqə növlərini və lokal qraf qonşuluqlarını emal etdiyi halda, Graph Transformer daha geniş konteksti və uzaq məsafəli asılılıqları tutmağa kömək edir. İki arxitekturanın birləşməsi təkbaşına istifadə olunan strukturlara nisbətən daha güclü təmsil yaradır.
Bu Niyə Vacibdir?
Söhbətlərdə emosiya tanınması müştəri xidmətləri, təhsil texnologiyaları, sosial robotlar, onlayn toplantı təhlilləri, çağrı mərkəzi keyfiyyət qiymətləndirilməsi və insan-kompüter qarşılıqlı əlaqəsi kimi bir çox sahədə istifadə oluna bilər. Lakin bu sahələrdə etibarlılıq və etik həssaslıq kritik əhəmiyyət daşıyır. İnsan emosiyasını tək bir sözə, üz ifadəsinə və ya səs tonuna endirmək olmaz.
Bu tədqiqat daha kontekstli və çoxkanallı emosiya tanıma sistemləri üçün mühüm istiqamət göstərir. Bir insanın nə hiss etdiyini anlamaq üçün yalnız dediyi sözə deyil, söhbətin hansı nöqtəsində dediyinə, əvvəlki və sonrakı cümlələrə, danışan tərzinə və fərqli modalların bir-birini necə dəstəklədiyinə baxmaq lazımdır.
Modelin qraf əsaslı quruluşu da vacibdir. Söhbət düz mətn ardıcıllığı kimi deyil; insanlar, zaman, modallar və əlaqələrdən ibarət şəbəkə kimi nəzərdən keçirilir. Bu yanaşma süni intellektin insan ünsiyyətini daha əlaqəli və kontekstual şəkildə modelləşdirməsinə töhfə verə bilər.
Lakin belə sistemlərin real dünyada istifadəsi diqqət tələb edir. Emosiya tanıma modelləri səhv proqnoz verə, mədəni fərqləri qaçıra, fərdi ifadə tərzlərini yanlış şərh edə və ya şəxsi məlumatların məxfiliyi problemləri yarada bilər. Buna görə belə modellər qərar dəstək aləti kimi düşünülməli; insanları avtomatik etiketləyən qəti sistemlər kimi istifadə edilməməlidir.
Diqqət Edilməli Məqamlar
İlk diqqət nöqtəsi tədqiqatın preprint olmasıdır. Rəyçi qiymətləndirməsindən keçmədiyi üçün model performansı, metod izahları və iddialar gələcəkdə dəyişə bilər. Nəticələr diqqətli və müqayisəli oxunmalıdır.
İkinci diqqət nöqtəsi verilənlər dəsti məhdudiyyətidir. IEMOCAP və MELD kimi verilənlər dəstləri tədqiqat üçün dəyərlidir; lakin real dünyadakı söhbətlər daha mürəkkəb, səs-küylü, mədəni baxımdan müxtəlif və kontekstdən asılıdır. Laboratoriya və ya tərtib edilmiş verilənlər dəstindəki uğur birbaşa real dünya uğuru demək deyil.
Üçüncü diqqət nöqtəsi emosiya etiketlərinin təbiətidir. Emosiyalar çox vaxt kəskin siniflərə ayrılmır. İnsan eyni anda həm kədərli, həm qəzəbli ola bilər; ironik danışa bilər; emosiyasını gizlədə bilər; mədəni baxımdan fərqli ifadə edə bilər. Buna görə emosiya təsnifat sistemləri həmişə qeyri-müəyyənlik payı ilə qiymətləndirilməlidir.
Dördüncü diqqət nöqtəsi danışan məlumatı və məxfilikdir. Modelin danışan kimliyindən faydalanması performansı artıra bilər; lakin şəxsi məlumat və etik istifadə baxımından diqqət tələb edir. Danışan profili, emosiya meyli və ya ifadə tərzi kimi məlumatlar həssas məlumat xarakteri daşıya bilər.
Nəhayət, bu məzmun psixoloji və ya klinik qiymətləndirmə tövsiyəsi deyil. Süni intellekt əsaslı emosiya tanıma nəticələri insan davranışını qəti şəkildə şərh etmək üçün təkbaşına istifadə edilməməlidir.
Nəticə
Bu tədqiqat söhbətlərdə emosiya tanınmasının yalnız söz təsnifatı problemi olmadığını göstərir. Emosiya mətn, səs, görüntü, danışan kimliyi və zaman daxilində kontekstin birlikdə formalaşdırdığı mürəkkəb ünsiyyət siqnalıdır.
CAHRGN modeli bu mürəkkəbliyi qraf strukturu daxilində təmsil edərək mühüm yanaşma təqdim edir. Hər danışıq vahidini mətn, səs və görüntü düyünləri ilə nəzərdən keçirir; eyni ifadə daxilində modal əlaqələrini, keçmiş və gələcək konteksti, danışan məlumatını və uzaq məsafəli asılılıqları birlikdə emal edir. Eksperimental nəticələr bu dizaynın mövcud üsullara nisbətən daha güclü performans təmin edə biləcəyini göstərir.
Verianla baxımından tədqiqatın əsas mesajı budur: Süni intellektin insan emosiyasını daha yaxşı anlaması üçün yalnız daha böyük model deyil, daha düzgün kontekst arxitekturası lazımdır. Emosiya tək bir cümlədə deyil; söhbətin axınında, danışanın tərzində və mətn-səs-görüntü arasındakı əlaqədə ortaya çıxır.
Mənbə və Metod Qeydi
Bu məzmun Yuling Ren, Junpeng Bao, Kaiyu He, Tingyu Li və Jiangjiang Zhao tərəfindən hazırlanmış “CAHRGN: a Context-Aware Heterogeneous Relational Graph Network for Multimodal Emotion Recognition in Conversation” başlıqlı preprint tədqiqat işinə əsasən hazırlanıb. Tədqiqat multimodal söhbət emosiyasının tanınması, heterogen əlaqəli qraf şəbəkələri, danışan embedding-i, RGCN və Graph Transformer arxitekturalarını birləşdirən CAHRGN modelini təklif edir.
Bu məzmun sözbəsöz tərcümə deyil; tədqiqatın əsas ideyası Verianla nəşr xəttinə uyğun şəkildə sadələşdirilib və orijinal Azərbaycan dilli redaksiya məqaləsinə çevrilib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib