

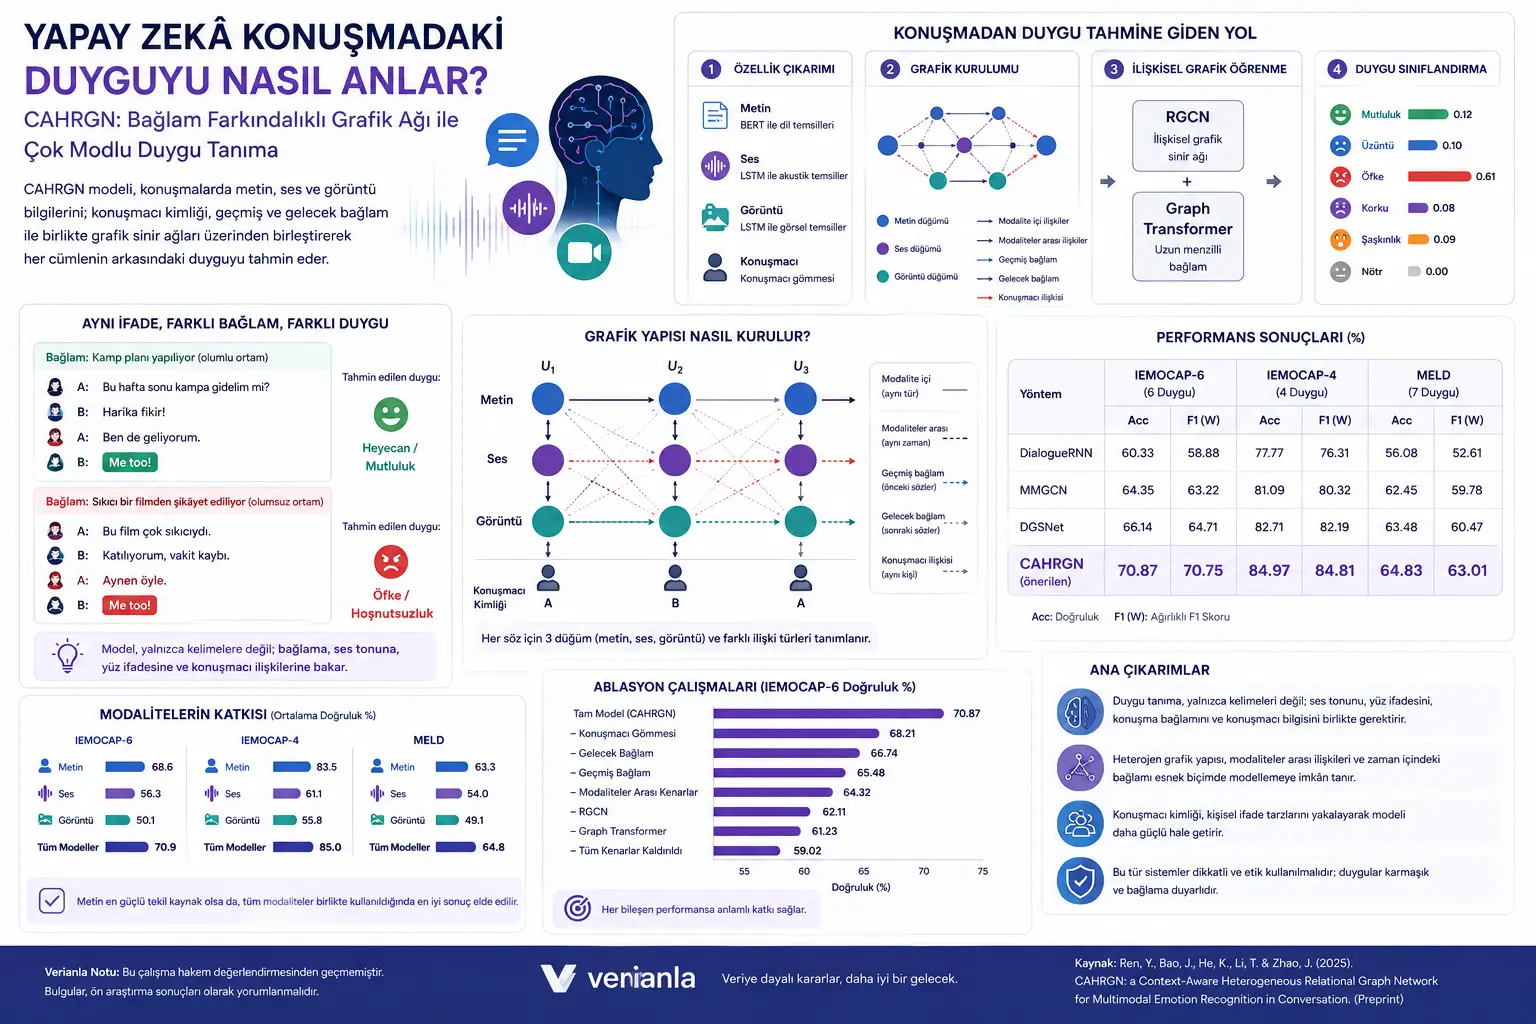
Сүйлөшүүдөгү эмоцияны түшүнүү көбүнчө бир эле сүйлөмдү окуу менен чектелбейт. Ошол эле сүйлөм ар кандай контексттерде таптакыр башка эмоцияларды алып жүрүшү мүмкүн. Мисалы, "Мен дагы" деген сөз айкашы (ifadesi) бир маекте (сүйлөшүүдө) толкунданууну, ал эми башка маекте ачууланууну же көңүл калууну (hayal kırıklığı) чагылдырышы мүмкүн. Ошондуктан жасалма интеллект сүйлөшүүдөгү эмоцияны түшүнүүсү үчүн бир гана сөздөргө (келимелерге) эмес, сүйлөшүүнүн агымына, сүйлөп жаткан адамдарга (сөзгө), үн тонуна жана визуалдык сигналдарга да көңүл бурушу керек.
Бул изилдөө сүйлөшүүлөрдөгү мультимодалдык (көп модалдык) эмоцияны таануу үчүн CAHRGN аттуу жаңы моделди сунуштайт. CAHRGN - бул “Context-Aware Heterogeneous Relational Graph Network” сөз айкашынын кыскартылышы. Кыргызчага “Контекстти Баамдаган (Түшүнгөн) Гетерогендүү Реляциялык График Тармагы” деп которууга болот. Модель ар бир сүйлөшүү бирдигин (utterance) текст, үн жана сүрөт (görüntü) сыяктуу үч башка маалымат каналы менен билдирет (temsil eder); андан кийин бул каналдардын ортосундагы байланыштарды жана сүйлөшүү учурундагы өткөн-келечек контекстин (geçmiş-gelecek bağlamı) график (graph) структурасынын ичинде иштетет.
Изилдөөнүн негизги билдирүүсү төмөнкүдөй: Эмоцияны таануу үчүн текстти гана талдоо (анализдөө) жетишсиз. Сүйлөшүүнүн убактылуу (замандык) агымы, сүйлөөчүлөрдүн (сөз сүйлөгөндөрдүн) оюн билдирүү стили (ifade tarzı) жана текст-үн-сүрөт ортосундагы мамилелер (байланыштар) чогуу каралганда модель күчтүүрөөк жыйынтыктарды бере алат.
Көйгөй эмнеде?
Эмоцияны таануу системалары көбүнчө кыска тексттерден, үн жазууларынан же жүзү (мимикасы) аркылуу эмоцияны болжолдоого аракет кылышат. Бирок чыныгы сүйлөшүүлөр (маектешүүлөр) жалгыз (tek başına) алынган бир сүйлөмгө караганда алда канча татаал. Адамдар мурунку сүйлөмдөргө жооп беришет, сүйлөөчүлөр (сөз сүйлөгөндөр) бири-бирине таасир этет, кээде сөздөр нейтралдуу көрүнөт, бирок үн тону же мимикасы башка эмоцияны билдирет.
Ошондуктан сүйлөшүүнүн ичиндеги эмоцияны таануу (emotion recognition in conversation) классикалык эмоция классификациясына караганда кыйыныраак маселе (problem) болуп саналат. Модель бир гана "бул сүйлөмдө кандай сөздөр бар?" деген суроого эмес; "бул сүйлөмдү ким айтты, мурун эмне деп айтылган, андан кийин эмне болду, үн жана сүрөт бул текстти колдойбу же ага каршыбы (çelişiyor mu)?" деген суроолорго да жооп бериши керек.
Мурдагы (Өткөн) ыкмалардын (методдордун) айрымдары LSTM сыяктуу кайталанма (tekrarlayan) тармактар менен сүйлөшүүнүн тартибин (sırasını) көзөмөлдөйт. Бул ыкмалар жакын контекстти кармай алат; бирок узак сүйлөшүүлөрдө алыскы көз карандылыкты (uzak bağımlılıkları) сактоодо кыйналышы мүмкүн. Графикке (Graph) негизделген ыкмалар болсо сүйлөшүүдөгү мамилелерди (байланыштарды) ийкемдүүрөөк моделдей алат; бирок айрымдары текстти, үндү жана сүрөттү (görüntüyü) бирдиктүү түйүн (düğüm) катары карагандыктан, ар бир модальдүүлүктүн өзгөчө (özgü) салымын жетиштүү колдоно албайт.
Изилдөө чечүүгө аракет кылган көйгөй дал ушул: Жасалма интеллект (AI) мультимодалдык (көп модалдык) сүйлөшүүлөрдө модальдүүлүктөр ортосундагы мамилелерди да, өткөн жана келечектеги контексттин ар кандай таасирлерин да кантип жакшыраак моделдей алат?
Метод эмнени сунуштайт?
CAHRGN модели сүйлөшүүнү (маектешүүнү) график (graph) катары карайт. График - бул түйүндөр (düğümler / nodes) жана четтерден (kenarlar / edges) турган түзүлүш. Бул изилдөөдө ар бир сүйлөшүү бирдиги, б.а. ар бир utterance (сүйлөм/сөз), үч башка модальдүүлүк менен билдирилет (temsil edilir): текст, үн жана сүрөт. Ошентип, бир сүйлөм үчүн бир гана түйүн түзүүнүн ордуна, текст түйүнү, үн түйүнү жана сүрөт түйүнү түзүлөт.
Бул ыкма (мамиле) маанилүү; анткени эмоциянын белгиси ар дайым эле бир каналда күчтүү боло бербейт. Кээ бир учурларда сөздөр эмоцияны ачык көрсөтүп турат. Кээ бир учурларда үн тону чечүүчү (belirleyici) болот. Кээ бир учурларда беттин мимикасы (yüz ifadesi) же визуалдык жүрүм-туруму (görsel davranış) текстке караганда көбүрөөк маалымат алып жүрөт. CAHRGN бул каналдарды (модальдүүлүктөрдү) бир баштыкка (torbaya) салбастан, алардын ортосундагы мамилелерди өз-өзүнчө үйрөнүүгө аракет кылат.
Моделдин экинчи маанилүү идеясы сүйлөшүүдөгү убакыттын багытын бөлөт. Өткөн сүйлөмдөр (geçmiş cümleler) жана келечектеги сүйлөмдөр (gelecek cümleler) контексттин бир түрү катары каралбайт. Анткени сүйлөмдүн эмоциясын түшүнүүдө мурунку сөздөр башкача, кийинки реакциялар (tepkiler) башкача белгилерди бериши мүмкүн. Ошондуктан модель өткөн контекст жана келечектеги контекст үчүн өзүнчө мамилелердин түрлөрүн (ilişki tipleri) түзөт.
Үчүнчү идея - сүйлөөчүнүн маалыматы (konuşmacı bilgisi). Бир эле эмоция ар кайсы адамдарда ар кандай түрдө көрсөтүлүшү (ifade edilebilir) мүмкүн. Кээ бир адамдар ачуусун ачык көрсөтөт, кээ бирлери нейтралдуураак (nötr) сүйлөйт; кээ бир сүйлөөчүлөр кыска жана кескин (keskin) сөздөрдү колдонушат, кээ бирлери кыйыр (dolaylı) сүйлөшөт. Модель сүйлөөчүнүн кимдигин кыстарылган (embedded) өкүлчүлүк (temsil) катары кошуу менен бул адамга мүнөздүү сүйлөө стилдерин (ifade tarzlarını) кармап калууга аракет кылат.
Акырында CAHRGN RGCN жана Graph Transformer архитектураларын чогуу колдонот. RGCN ар кандай мамиле (ilişki) түрлөрүнө ээ графиктердеги түйүндөр ортосундагы маалымат алмашууну (bilgi aktarımını) үйрөнөт. Graph Transformer болсо кеңири контекстти (bağlamı) жана алыскы мамилелерди (uzak ilişkileri) кармоого жардам берет. Ошентип, модель жергиликтүү (yerel) сүйлөшүү мамилелерин да, кеңири диалог түзүмүн да (diyalog yapısını) чогуу иштетет.
Формулалар эмнени түшүндүрөт?
Изилдөөдө моделдин негизги компоненттерин (бөлүктөрүн) түшүндүргөн көптөгөн математикалык туюнтмалар бар. Төмөнкү формулалар изилдөөдөгү символдордун түзүлүшүнө мүмкүн болушунча ишенимдүү болуу менен которулган жана кыргызча түшүндүрмөлөр менен жөнөкөйлөтүлгөн.
Текст модальдүүлүгү (modalitesi) үчүн BERT колдонулат. Бул жерде \(U_i^l\), сүйлөшүүдөгү \(i\)-чи сөздүн текст формасын (metin biçimini); \(u_i^l\) болсо BERT тарабынан чыгарылган текст өкүлчүлүгүн (temsilini) көрсөтөт.
Үн жана сүрөт (görüntü) каналдары үчүн Bi-LSTM негизиндеги коддогучтар (kodlayıcılar) колдонулат. Бул коддогучтар ар бир сүйлөшүү бирдигинин үн жана визуалдык өзгөчөлүктөрүн белгиленген (sabit) узундуктагы өкүлчүлүктөргө (temsillere) айлантат.
Сүйлөөчүнүн маалыматы өзүнчө бир кыстаруу катмары (gömme katmanı / embedding layer) менен көрсөтүлөт. \(S\), сүйлөшүүдөгү сүйлөөчүнүн кимдиктерин (kimliklerini); \(S_{emb}\) болсо бул кимдиктерден (идентификациялардан) өндүрүлгөн кыстарылган өкүлчүлүктү (gömülü temsili) билдирет.
Сүйлөөчүнүн кыстаруусу (Embedding) ар бир модальдүүлүк өкүлчүлүгүн бекемдөө (güçlendirmek) үчүн колдонулат. \(\eta\), сүйлөөчүнүн маалыматынын салым салмагын (katkı ağırlığını) билдирген үйрөнүүгө боло турган (öğrenilebilir) параметр болуп саналат.
Модель түзгөн мультимодалдык (многомодалдык) графикте ар бир сүйлөшүү бирдиги үч модальдүүлүк түйүнүнө (düğümüne) бөлүнөт. \(N\), сүйлөшүүдөгү сөздөрдүн саны. Бул учурда түйүндөрдүн жалпы саны үч эсеге көбөйөт.
Графикте (Гранфте) бир эле сөздүн текст, үн жана сүрөт түйүндөрүнүн ортосунда мультимодалдык мамилелер түзүлөт. Бул мамилелер модальдүүлүктөрдүн бири-бирин кантип толуктай турганын (tamamladığını) үйрөнүү үчүн колдонулат.
Өткөн жана келечектеги контекст өзүнчө мамилелердин түрлөрү (ilişki türleri) катары аныкталат. \(P\), өткөн терезени (geçmiş pencereyi); \(F\), келечектеги терезени билдирет. Бул түзүм моделге сүйлөшүү агымынын (konuşma akışının) багытын такыраак кароого (ele almasını) мүмкүндүк берет.
RGCN катмарында ар бир түйүн (düğüm) ар кандай мамиле (ilişki) түрлөрүнөн келген кошуналардын маалыматын чогултат. \(W_r^{(k)}\), мамиленин түрүнө (ilişki türüne) тиешелүү салмак матрицасын (ağırlık matrisini); \(W_0^{(k)}\), түйүндүн өз маалыматын сактаган салмакты; \(\sigma\) болсо ReLU активдештирүүсүн (aktivasyonunu) көрсөтөт.
Graph Transformer катмарында түйүндөр арасындагы көңүл буруу баллы (dikkat puanı / attention score) эсептелет. Бул түзүм (yapı) кайсы кошуна (komşunun) тиешелүү түйүн үчүн маанилүүрөөк экенин үйрөнүүгө жардам берет.
Акыркы баскычта (Aşamada) текст, үн жана сүрөт өкүлчүлүктөрү бириктирилип, ар бир сөз үчүн эмоция этикеткасы (duygu etiketi) болжолдонот.
Окутууда (Eğitimde) колдонулган негизги жоготуу функциясы (kayıp fonksiyonu) кросс-энтропия (çapraz entropi) болуп саналат. Моделдин божомолу реалдуу эмоция этикеткасына жакындаган сайын бул жоготуу (kayıp) азаят.
График, Таблица жана Схеманын Негизги Билдирүүсү
Изилдөөнүн үлгүлүү сүйлөшүү схемасы, ошол эле сөздүн ар кандай контексттерде ар кандай эмоцияны алып жүрө аларын көрсөтөт. "Мен дагы" ("Me too") сыяктуу кыска жана сыртынан нейтралдуу көрүнгөн сөз айкашы, лагерге (кампка) даярдануу учурундагы позитивдүү (olumlu) сүйлөшүүдө толкундануу (heyecan) же бакыт менен байланышса; кызыксыз (sıkıcı) фильмге арызданып (şikâyet edilen) жаткан башка бир сүйлөшүүдө ачууланууну же нааразычылыкты алып жүрүшү мүмкүн. Бул мисал эмоцияны таанууда контексттин эмне үчүн алмаштыргыс (vazgeçilmez) экенин жөнөкөй (sade) көрсөтүп турат.
Моделдин архитектурасы төрт негизги бөлүктөн турат: өзгөчөлүктөрдү чыгаруу (özellik çıkarımı), графикти орнотуу (grafik kurulumu), реляциялык графикти үйрөнүү (ilişkisel grafik öğrenme) жана эмоцияны классификациялоо. Өзгөчөлүктөрдү чыгаруу бөлүмүндө текст үчүн BERT, үн жана сүрөт үчүн LSTM негизиндеги коддогучтар колдонулат. Графикти орнотуу бөлүмүндө ошол эле сөздүн текст-үн-сүрөт мамилелери жана сүйлөшүүнүн өткөн/келечектеги контексти өзүнчө четин (kenar) түрлөрү катары моделделет. Реляциялык график тармагы (RGCN) жана Graph Transformer бул татаал түзүмдү иштетүү менен ар бир сөз үчүн байыраак (zengin) өкүлчүлүк (temsil) өндүрөт.
Натыйжа таблицаларынын негизги билдирүүсү - CAHRGN моделинин үч башка маалымат топтомунда да күчтүү өндүрүмдүүлүктү (performans) көрсөтүшү. IEMOCAP-6 маалымат топтомунда модель 70,87 пайыз тактыкка (accuracy) жана 70,75 пайыз салмакталган F1 (weighted F1) маанисине жетет. IEMOCAP-4тө 84,97 пайыз тактык жана 84,81 пайыз салмакталган F1 алынган. MELD маалымат топтомунда болсо 64,83 пайыз тактык жана 63,01 пайыз салмакталган F1 мааниси билдирилет. Бул маанилер салыштырылган негизги методдордун (yöntemlerin) үстүндө көрүнөт.
Модальдүүлүк (Modalite) анализдери жалгыз өзү тексттин эң күчтүү модальдүүлүк экенин көрсөтөт. Үн (ses) жалгыз орточо деңгээлде салым кошсо, сүрөт (görüntü) жалгыз алсызыраак калат. Бирок үч модальдүүлүк чогуу колдонулганда эң жакшы (en iyi) жыйынтыктар алынат. Бул табылга (bulgu), эмоцияны таануу бир гана текст окуу иши эмес экенин; үн жана сүрөттүн да өзгөчө контекст менен бирге кошумча (ek) маалымат бере аларын көрсөтөт.
Абляция (Ablasyon) жыйынтыктары моделдин негизги компоненттеринин (bileşenlerinin) чындап эле ишке жараганын көрсөтөт. RGCN же Graph Transformer чыгарылганда (çıkarıldığında) өндүрүмдүүлүк (performans) төмөндөйт. Мультимодалдык мамилелердин четтери же контекст четтери алынып салынганда да натыйжалар (sonuçlar) алсырайт. Бул моделдин ийгилиги бир гана компонентке эмес; модальдүүлүк мамилелеринин, убактылуу (zamansal) контексттин, сүйлөөчүнүн маалыматынын жана графикке негизделген үйрөнүүнүн биргелешип иштөөсүнө таянарын көрсөтөт.
Сүйлөөчүнүн маалыматы (konuşmacı bilgisi) анализи да маанилүү билдирүү (mesaj) берет. Сүйлөөчүнүн кыстаруусу (konuşmacı gömmesi) колдонулганда модель үч маалымат топтомунда тең жакшыраак жыйынтыктарды берет. Бул ар кайсы адамдардын оюн билдирүү стили (ifade tarzı) жана эмоция тенденциялары эмоцияны таанууда маанилүү маалымат алып жүрөрүн тастыктайт.
Эксперименттер кандайча жасалган?
Изилдөөдө үч кеңири таралган (yaygın) мультимодалдык (көп модалдык) эмоцияны таануу маалымат топтому (veri seti) колдонулган: IEMOCAP-4, IEMOCAP-6 жана MELD. IEMOCAP-4 төрт эмоция этикеткасын камтыйт: ачуулануу, кайгы (üzüntü), бакыт жана нейтралдуу (nötr). IEMOCAP-6 болсо алты эмоция этикеткасын колдонот: бакыт, кайгы, нейтралдуу, коркуу (korku), таң калуу (şaşkınlık) жана ачуулануу. MELD маалымат топтому да көп сүйлөөчүсү бар диалогдордо эмоцияны таануу үчүн колдонулган жалпы салыштыруу (karşılaştırma) маалымат топтому болуп саналат.
Тексттин өзгөчөлүктөрү BERT менен чыгарылат (çıkarılır). Үндүн (ses) өзгөчөлүктөрү IEMOCAP үчүн OpenSmile, MELD үчүн librosa аркылуу алынат. Визуалдык (Görsel) өзгөчөлүктөр IEMOCAP үчүн OpenFace колдонуу менен чыгарылат. Андан кийин бул өзгөчөлүктөр CAHRGN моделинин график түзүмүнө (grafik yapısına) өткөрүлүп берилет.
Моделдин өндүрүмдүүлүгү Accuracy (Тактык) жана weighted F1-score (салмакталган F1-баллы) менен өлчөнөт. Accuracy - бул туура болжолдонгон мисалдардын үлүшү (oranı). Weighted F1-score болсо класстардын (sınıf) тең салмаксыздыгын (dengesizliklerini) жакшыраак эске алган өлчөө (ölçü). Эмоцияны таануу маалымат топтомдорунда кээ бир эмоция класстары (sınıfları) башкаларга караганда азыраак кездешкендиктен, weighted F1 өзгөчө маанилүү.
Эксперименттерде CAHRGN; bc-LSTM, DialogueRNN, DialogueGCN, MMGCN, COGMEN, DGSNet, FrameERC жана башка ушул сыяктуу мурунку ыкмалар менен салыштырылат. Андан тышкары моделдин кайсы компоненттерден канчалык пайда көрөрүн (faydalandığını) түшүнүү үчүн ablation (абляция) изилдөөлөрү жүргүзүлөт. Бул алкакта модальдүүлүктөр (modaliteler) өзүнчө же чогуу сыналат (denenir); RGCN, Graph Transformer, мультимодалдык (көп модалдык) четтер (kenarlar), контекст четтери жана сүйлөөчүнүн кыстаруусу (konuşmacı gömmesi) алынып салынып, өндүрүмдүүлүктүн өзгөрүшү байкалат.
Натыйжалар эмнени көрсөтүп турат?
Биринчи натыйжа, CAHRGNдин үч маалымат топтомунда тең күчтүү өндүрүмдүүлүктү (performans) көрсөтүшү. Модель сүйлөшүүнүн ичиндеги (konuşma içindeki) эмоцияны таануу тапшырмасында мурунку көптөгөн методдорду (ыкмаларды) артта калтырат (geride bırakır). Бул натыйжа, гетерогендүү график түзүмү (heterojen grafik yapısı) жана контекстти баалоо (bağlam farkındalığı) эмоцияны таанууда пайдалуу болоорун көрсөтүп турат.
Экинчи натыйжа, тексттик маалымат дагы эле эң күчтүү бирдиктүү (tekil) булак экендиги. Бир гана текст модальдүүлүгү (modalitesi), үн жана сүрөт (görüntü) модальдүүлүктөрүнө караганда жогорку өндүрүмдүүлүктү (performans) берет. Бирок эң мыкты (en iyi) натыйжа бир гана текст менен эмес; текст, үн жана сүрөттү чогуу колдонуу менен алынат. Бул мультимодалдык ыкманын (yaklaşımın) практикалык баалуулугун колдойт.
Үчүнчү натыйжа, контексттин багытынын (yönünün) маанилүү экендиги. Өткөн жана келечектеги сөздөр бирдей (aynı şekilde) каралбашы (ele alınmamalıdır) керек. Модель өткөн жана келечектеги контекстти өзүнчө мамиле (ilişki) түрлөрү менен көрсөткөндө, сүйлөшүүдөгү эмоционалдык агымды (duygusal akışı) жакшыраак кармай алат (yakalayabilir).
Төртүнчү натыйжа, сүйлөөчүнүн маалыматынын эмоцияны таанууда салым кошкондугу (katkı sağladığı). Сүйлөөчүнүн кыстаруусу (konuşmacı gömmesi) алынып салынганда (çıkarıldığında), тактык (doğruluk) төмөндөйт. Бул адамдардын эмоцияны билдирүү стилдеринин кишиден кишиге өзгөрөрүн жана моделдин бул айырмачылыкты үйрөнүүсү пайдалуу экенин көрсөтөт.
Бешинчи натыйжа, RGCN жана Graph Transformer компоненттеринин бири-бирин толуктап (tamamlayıcı) иштегени. RGCN мамилелердин түрлөрүн жана жергиликтүү (yerel) графиктин кошуналыктарын иштетсе; Graph Transformer кеңири контекстти (bağlamı) жана узак аралыктагы (uzun menzilli) көз карандылыктарды кармоого жардам берет. Эки архитектуранын биригиши, өзүнчө колдонулган структураларга караганда күчтүүрөөк өкүлчүлүк (temsil) өндүрөт.
Бул эмне үчүн маанилүү?
Сүйлөшүүлөрдөгү (Маектешүүлөрдөгү) эмоцияны таануу; кардарларды тейлөө (müşteri hizmetleri), билим берүү технологиялары, социалдык роботтор, онлайн жолугушууларды (топтомдорду) талдоо, call-борбордун (çağrı merkezi) сапатын баалоо жана адам-компьютер өз ара аракеттенүүсү сыяктуу көптөгөн тармактарда колдонулушу мүмкүн. Бирок бул тармактарда ишенимдүүлүк (güvenilirlik) жана этикалык сезимталдык (etik hassasiyet) критикалык мааниге ээ. Адамдын эмоциясы бир эле сөзгө, мимикага же үн тонуна кыскартылышы (indirgenemez) мүмкүн эмес.
Бул изилдөө көбүрөөк контексттүү (bağlamlı) жана көп каналдуу эмоцияны таануу системалары үчүн маанилүү багытты (yön) көрсөтөт. Адамдын эмне сезип жатканын түшүнүү үчүн анын айткан сөзүнө гана эмес, аны сүйлөшүүнүн кайсы чекитинде (noktasında) айтканына, мурунку жана кийинки сүйлөмдөргө, сүйлөөчүнүн стилине жана ар кандай модальдүүлүктөрдүн (modalitelerin) бири-бирин кантип колдой турганына кароо (bakmak) керек.
Моделдин графикке негизделген (grafik tabanlı) түзүмү да маанилүү. Сүйлөшүү (Маектешүү) түз (düz) тексттик тизмек (metin dizisi) сыяктуу эмес; адамдардан, убакыттан, модальдүүлүктөрдөн жана мамилелерден (ilişkilerden) турган тармак (ağ) катары каралат. Бул мамиле (yaklaşım), жасалма интеллекттин адамдын коммуникациясын (iletişimini) реляциялык (ilişkisel) жана контексттик (bağlamsal) түрдө моделдештирүүсүнө салым кошо алат.
Бирок мындай системалардын реалдуу дүйнөдө (gerçek dünyada) колдонулушу этияттыкты (dikkat) талап кылат. Эмоцияны таануу моделдери ката (hatalı) божомол жасашы мүмкүн, маданий айырмачылыктарды (kültürel farkları) өткөрүп жибериши (kaçırabilir) мүмкүн, жекече (bireysel) билдирүү стилдерин туура эмес чечмелеши мүмкүн же жеке маалыматтардын купуялуулугуна (veri gizliliği) байланыштуу көйгөйлөрдү жаратышы мүмкүн. Ушул себептен улам мындай моделдер чечим кабыл алууну колдоо куралы (karar destek aracı) катары каралышы керек; адамды автоматтык түрдө белгилөөчү (etiketleyen) так системалар (kesin sistemler) катары колдонулбашы керек.
Көңүл буруу пункттары
Биринчи көңүл бура турган жагдай, изилдөөнүн preprint (алдын ала басып чыгаруу) экендигинде. Ал рецензиядан (hakem değerlendirmesi) өтпөгөндүктөн, моделдин өндүрүмдүүлүгү (performansı), методдун түшүндүрмөлөрү жана дооматтары (iddiaları) келечекте өзгөрүшү мүмкүн. Натыйжалар (Sonuçlar) кылдаттык жана салыштыруу менен окулушу керек.
Экинчи көңүл бура турган жагдай - маалымат топтомунун чектелгендиги (veri seti sınırlılığı). IEMOCAP жана MELD сыяктуу маалымат топтомдору изилдөө үчүн баалуу; бирок реалдуу дүйнөдөгү (gerçek dünyadaki) сүйлөшүүлөр алда канча татаал (karmaşık), ызы-чуулуу (gürültülü), маданий жактан ар түрдүү жана контекстке көз каранды (bağlama bağımlı). Лабораториядагы же түзүлгөн (derlenmiş) маалымат топтомундагы ийгилик түздөн-түз (doğrudan) реалдуу дүйнөдөгү ийгиликти билдирбейт.
Үчүнчү көңүл бура турган жагдай - эмоция этикеткаларынын (duygu etiketlerinin) табияты. Эмоциялар көбүнчө кескин класстарга (keskin sınıflara) бөлүнбөйт. Адам бир эле учурда кайгырып да, ачууланып да болушу мүмкүн; ирониялык (ironik) сүйлөшү мүмкүн; эмоциясын жашырышы мүмкүн; маданий жактан ар түрдүү көрсөтүшү (ifade etmesi) мүмкүн. Ошондуктан эмоцияларды классификациялоо системалары ар дайым белгисиздик маржасы (belirsizlik payı) менен бааланышы керек.
Төртүнчү көңүл бура турган жагдай - сүйлөөчүнүн маалыматы (konuşmacı bilgisi) жана купуялык (gizlilik). Моделдин сүйлөөчүнүн кимдигинен (kimliğinden) пайдалануусу өндүрүмдүүлүктү (performansı) жогорулатышы мүмкүн; бирок жеке маалыматтар (kişisel veri) жана этикалык колдонуу жагынан этияттыкты талап кылат. Сүйлөөчүнүн профили, эмоция тенденциясы (eğilimi) же билдирүү стили (ifade tarzı) сыяктуу маалыматтар сезгич (hassas) маалымат статусуна ээ болушу мүмкүн.
Акырында, бул мазмун психологиялык же клиникалык баалоо боюнча кеңеш (tavsiye) эмес. Жасалма интеллектке негизделген эмоцияны таануунун натыйжалары (sonuçları) адамдын жүрүм-турумун (davranışını) так (kesin olarak) чечмелөө үчүн өз алдынча (tek başına) колдонулбашы керек.
Жыйынтык
Бул изилдөө сүйлөшүүлөрдөгү (маектешүүлөрдөгү) эмоцияны таануу жөн гана сөздү (kelime) классификациялоо көйгөйү эмес экенин көрсөтөт. Эмоция (Duygu) - бул текст, үн, сүрөт (görüntü), сүйлөөчүнүн кимдиги (kimliği) жана убакыттын ичиндеги контекст чогуу калыптандырган татаал коммуникация сигналы (iletişim sinyalidir).
CAHRGN модели бул татаалдыкты график түзүмүнүн (grafik yapısı) ичинде көрсөтүү (temsil ederek) менен маанилүү ыкманы (yaklaşım) сунуштайт. Ар бир сүйлөшүү бирдигин (utterance) текст, үн жана сүрөт түйүндөрү (düğümleri) менен карайт; бир эле сөздүн ичиндеги модальдүүлүк (modalite) мамилелерин, өткөн жана келечектеги контекстти, сүйлөөчүнүн маалыматын жана узак аралыктагы (uzun menzilli) көз карандылыктарды (bağımlılıkları) бирге иштетет. Эксперименталдык натыйжалар (Deneysel sonuçlar) бул дизайн (tasarım) учурдагы методдорго караганда күчтүүрөөк өндүрүмдүүлүктү (performans) камсыздай аларын көрсөтүп турат.
Verianla жагынан алганда изилдөөнүн негизги билдирүүсү төмөнкүдөй: Жасалма интеллекттин адамдын эмоциясын (duygusunu) жакшыраак түшүнүүсү үчүн чоңураак модель гана эмес, туурараак контекст архитектурасы (bağlam mimarisi) керек. Эмоция бир эле сүйлөмдө эмес; сүйлөшүүнүн агымында, сүйлөөчүнүн стилинде жана текст-үн-сүрөт (metin-ses-görüntü) ортосундагы мамиледе (байланышта) пайда болот.
Булак жана Метод Эскертүүсү
Бул мазмун Юлинг Рен (Yuling Ren), Жунпенг Бао (Junpeng Bao), Кайю Хэ (Kaiyu He), Тиню Ли (Tingyu Li) жана Цзянцзян Чжао (Jiangjiang Zhao) тарабынан даярдалган "CAHRGN: a Context-Aware Heterogeneous Relational Graph Network for Multimodal Emotion Recognition in Conversation" аттуу preprint (алдын ала басып чыгаруу) изилдөөсүнө негизделип даярдалган. Изилдөө; мультимодалдык (көп модалдык) сүйлөшүүлөрдөгү эмоцияны таанууну, гетерогендүү реляциялык график тармактарын, сүйлөөчүнү кыстарууну (konuşmacı gömmesi), RGCN жана Graph Transformer архитектураларын бириктирген CAHRGN моделин сунуштайт.
Бул мазмун сөзмө-сөз котормо эмес; изилдөөнүн негизги идеясы Verianla басып чыгаруу багытына ылайык жөнөкөйлөштүрүлүп, оригиналдуу кыргызча редактордук макалага айландырылган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген