

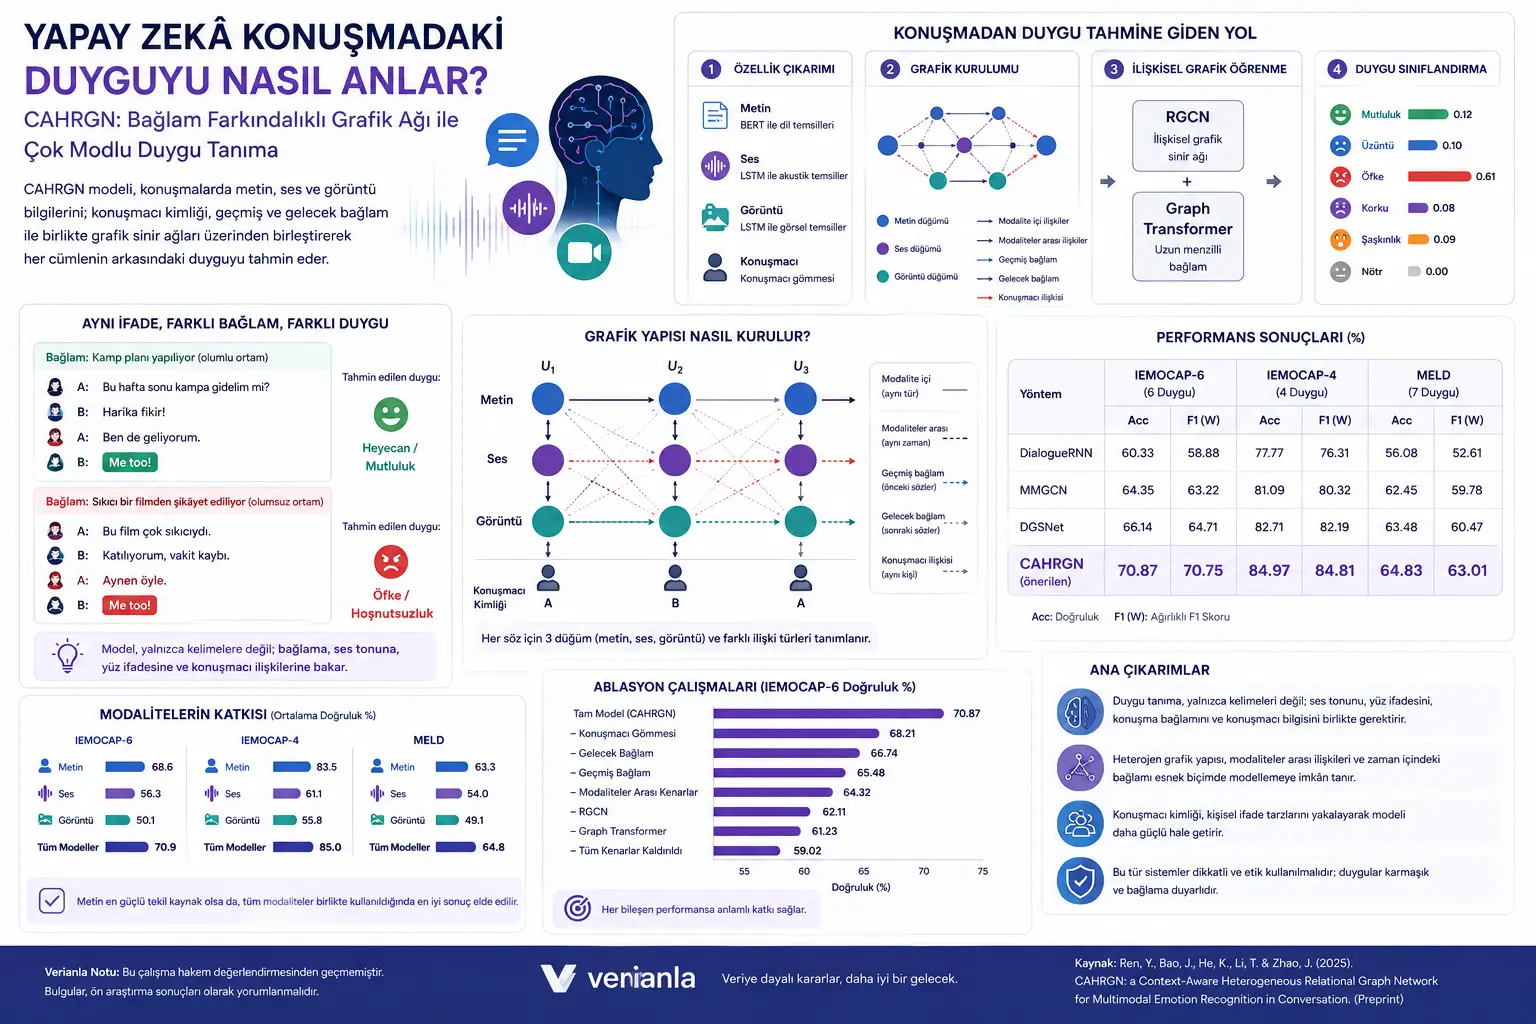
Bir konuşmada duyguyu anlamak çoğu zaman tek bir cümleyi okumaktan ibaret değildir. Aynı cümle, farklı bağlamlarda bambaşka duygular taşıyabilir. Örneğin “Ben de” ifadesi bir sohbette heyecanı, başka bir sohbette öfkeyi veya hayal kırıklığını yansıtabilir. Bu nedenle yapay zekânın konuşmadaki duyguyu anlaması için yalnızca kelimelere değil, konuşmanın akışına, konuşmacıların kim olduğuna, ses tonuna ve görsel ipuçlarına da bakması gerekir.
Bu çalışma, konuşmalarda çok modlu duygu tanıma için CAHRGN adlı yeni bir model öneriyor. CAHRGN, “Context-Aware Heterogeneous Relational Graph Network” ifadesinin kısaltmasıdır. Türkçeye “Bağlam Farkındalıklı Heterojen İlişkisel Grafik Ağı” olarak çevrilebilir. Model, her konuşma birimini metin, ses ve görüntü olmak üzere üç ayrı bilgi kanalıyla temsil eder; sonra bu kanallar arasındaki ilişkileri ve konuşma sırasındaki geçmiş-gelecek bağlamı grafik yapısı içinde işler.
Araştırmanın ana mesajı şudur: Duygu tanıma için yalnızca metni analiz etmek yeterli değildir. Konuşmanın zamansal akışı, konuşmacıların ifade tarzı ve metin-ses-görüntü arasındaki ilişkiler birlikte ele alındığında model daha güçlü sonuçlar verebilir.
Problem Ne?
Duygu tanıma sistemleri çoğu zaman kısa metinlerden, ses kayıtlarından veya yüz ifadelerinden duygu tahmini yapmaya çalışır. Fakat gerçek konuşmalar, tek başına ele alınan bir cümleden çok daha karmaşıktır. İnsanlar önceki cümlelere cevap verir, konuşmacılar birbirini etkiler, bazen sözcükler nötr görünür ama ses tonu veya yüz ifadesi farklı bir duygu taşır.
Bu nedenle konuşma içinde duygu tanıma, klasik duygu sınıflandırmasından daha zor bir problemdir. Model, yalnızca “bu cümlede hangi kelimeler var?” sorusunu değil; “bu cümle kim tarafından söylendi, önce ne denildi, sonra ne geldi, ses ve görüntü bu metni destekliyor mu, yoksa çelişiyor mu?” sorularını da yanıtlamak zorundadır.
Önceki yöntemlerin bir kısmı konuşma sırasını LSTM gibi tekrarlayan ağlarla izler. Bu yöntemler yakın bağlamı yakalayabilir; ancak uzun konuşmalarda uzak bağımlılıkları korumakta zorlanabilir. Grafik tabanlı yöntemler ise konuşmadaki ilişkileri daha esnek modelleyebilir; fakat bazıları metin, ses ve görüntüyü tek bir birleşik düğüm gibi ele aldığı için her modalitenin kendine özgü katkısını yeterince kullanamaz.
Çalışmanın çözmeye çalıştığı sorun tam olarak budur: Yapay zekâ, çok modlu konuşmalarda hem modaliteler arası ilişkileri hem de geçmiş ve gelecek bağlamın farklı etkilerini nasıl daha iyi modelleyebilir?
Yöntem Ne Öneriyor?
CAHRGN modeli konuşmayı bir grafik olarak düşünür. Grafik, düğümler ve kenarlardan oluşan bir yapıdır. Bu çalışmada her konuşma birimi, yani her utterance, üç ayrı modaliteyle temsil edilir: metin, ses ve görüntü. Böylece tek bir cümle için yalnızca bir düğüm oluşturmak yerine, metin düğümü, ses düğümü ve görüntü düğümü oluşturulur.
Bu yaklaşım önemlidir; çünkü bir duygunun işareti her zaman aynı kanalda güçlü olmayabilir. Bazı durumlarda kelimeler duyguya açıkça işaret eder. Bazı durumlarda ses tonu daha belirleyici olur. Bazı durumlarda yüz ifadesi veya görsel davranış metinden daha fazla bilgi taşır. CAHRGN, bu kanalları tek bir torbaya atmadan, aralarındaki ilişkileri ayrı ayrı öğrenmeye çalışır.
Modelin ikinci önemli fikri, konuşmadaki zaman yönünü ayırmasıdır. Geçmiş cümleler ve gelecek cümleler aynı tür bağlam olarak ele alınmaz. Çünkü bir cümlenin duygusunu anlamada önceki sözler başka, sonraki tepkiler başka ipuçları sağlayabilir. Bu yüzden model, geçmiş bağlam ve gelecek bağlam için ayrı ilişki tipleri kurar.
Üçüncü fikir, konuşmacı bilgisidir. Aynı duygu farklı kişilerde farklı ifade edilebilir. Bazı insanlar öfkesini açıkça gösterir, bazıları daha nötr konuşur; bazı konuşmacılar kısa ve keskin ifadeler kullanır, bazıları dolaylı anlatır. Model, konuşmacı kimliğini gömülü temsil olarak ekleyerek bu kişiye özgü ifade tarzlarını yakalamaya çalışır.
Son olarak CAHRGN, RGCN ve Graph Transformer mimarilerini birlikte kullanır. RGCN, farklı ilişki türlerine sahip grafiklerde düğümler arası bilgi aktarımını öğrenir. Graph Transformer ise daha geniş bağlamı ve uzak ilişkileri yakalamaya yardımcı olur. Böylece model hem yerel konuşma ilişkilerini hem de daha geniş diyalog yapısını birlikte işler.
Formüller Ne Anlatıyor?
Çalışmada modelin temel bileşenlerini açıklayan çok sayıda matematiksel ifade yer almaktadır. Aşağıdaki formüller, çalışmadaki sembol yapısına mümkün olduğunca sadık biçimde aktarılmış ve Türkçe açıklamalarla sadeleştirilmiştir.
Metin modalitesi için BERT kullanılır. Burada \(U_i^l\), konuşmadaki \(i\). sözün metin biçimini; \(u_i^l\) ise BERT tarafından çıkarılan metin temsilini gösterir.
Ses ve görüntü kanalları için Bi-LSTM tabanlı kodlayıcılar kullanılır. Bu kodlayıcılar, her konuşma biriminin ses ve görsel özelliklerini sabit uzunluklu temsillere dönüştürür.
Konuşmacı bilgisi ayrı bir gömme katmanıyla temsil edilir. \(S\), konuşmadaki konuşmacı kimliklerini; \(S_{emb}\) ise bu kimliklerden üretilen gömülü temsili ifade eder.
Konuşmacı gömmesi, her modalite temsilini güçlendirmek için kullanılır. \(\eta\), konuşmacı bilgisinin katkı ağırlığını temsil eden öğrenilebilir bir parametredir.
Modelin kurduğu çok modlu grafikte her konuşma birimi üç modalite düğümüne ayrılır. \(N\), konuşmadaki söz sayısıdır. Bu durumda toplam düğüm sayısı üç katına çıkar.
Grafikte aynı sözün metin, ses ve görüntü düğümleri arasında çok modlu ilişkiler kurulur. Bu ilişkiler, modalitelerin birbirini nasıl tamamladığını öğrenmek için kullanılır.
Geçmiş ve gelecek bağlamı ayrı ilişki türleri olarak tanımlanır. \(P\), geçmiş pencereyi; \(F\), gelecek pencereyi temsil eder. Bu yapı, modelin konuşma akışının yönünü daha hassas ele almasını sağlar.
RGCN katmanında her düğüm, farklı ilişki türlerinden gelen komşu bilgilerini toplar. \(W_r^{(k)}\), ilişki türüne özgü ağırlık matrisini; \(W_0^{(k)}\), düğümün kendi bilgisini koruyan ağırlığı; \(\sigma\) ise ReLU aktivasyonunu gösterir.
Graph Transformer katmanında düğümler arası dikkat puanı hesaplanır. Bu yapı, hangi komşunun ilgili düğüm için daha önemli olduğunu öğrenmeye yarar.
Son aşamada metin, ses ve görüntü temsilleri birleştirilir ve her söz için duygu etiketi tahmin edilir.
Eğitimde kullanılan temel kayıp fonksiyonu çapraz entropidir. Modelin tahmini gerçek duygu etiketine yaklaştıkça bu kayıp azalır.
Grafik, Tablo ve Şema Ana Mesajı
Çalışmanın örnek konuşma şeması, aynı ifadenin farklı bağlamlarda farklı duygu taşıyabileceğini gösterir. “Me too” gibi kısa ve yüzeyde nötr görünen bir ifade, kamp hazırlığı yapılan olumlu bir konuşmada heyecan veya mutlulukla ilişkilenebilirken, sıkıcı bir filmden şikâyet edilen başka bir konuşmada öfke veya hoşnutsuzluk taşıyabilir. Bu örnek, duygu tanımada bağlamın neden vazgeçilmez olduğunu sade biçimde gösterir.
Model mimarisi dört ana parçadan oluşur: özellik çıkarımı, grafik kurulumu, ilişkisel grafik öğrenme ve duygu sınıflandırma. Özellik çıkarımı bölümünde metin için BERT, ses ve görüntü için LSTM tabanlı kodlayıcılar kullanılır. Grafik kurulumu bölümünde aynı sözün metin-ses-görüntü ilişkileri ve konuşmanın geçmiş/gelecek bağlamı ayrı kenar türleri olarak modellenir. İlişkisel grafik ağı ve Graph Transformer ise bu karmaşık yapıyı işleyerek her söz için daha zengin bir temsil üretir.
Sonuç tablolarının ana mesajı, CAHRGN modelinin üç farklı veri setinde de güçlü performans göstermesidir. IEMOCAP-6 üzerinde model yüzde 70,87 doğruluk ve yüzde 70,75 ağırlıklı F1 değerine ulaşır. IEMOCAP-4 üzerinde yüzde 84,97 doğruluk ve yüzde 84,81 ağırlıklı F1 elde edilir. MELD üzerinde ise yüzde 64,83 doğruluk ve yüzde 63,01 ağırlıklı F1 değeri raporlanır. Bu değerler, karşılaştırılan temel yöntemlerin üzerinde görünmektedir.
Modalite analizleri, tek başına metnin en güçlü modalite olduğunu gösterir. Ses tek başına orta düzeyde katkı verirken, görüntü tek başına daha zayıf kalır. Ancak üç modalite birlikte kullanıldığında en iyi sonuçlar elde edilir. Bu bulgu, duygu tanımanın yalnızca metin okuma işi olmadığını; ses ve görüntünün de özellikle bağlamla birlikte ek bilgi sağlayabildiğini gösterir.
Ablasyon sonuçları, modelin temel bileşenlerinin gerçekten işe yaradığını gösterir. RGCN veya Graph Transformer çıkarıldığında performans düşer. Çok modlu ilişki kenarları veya bağlam kenarları kaldırıldığında da sonuçlar zayıflar. Bu, modelin başarısının tek bir bileşene değil; modalite ilişkileri, zamansal bağlam, konuşmacı bilgisi ve grafik tabanlı öğrenmenin birlikte çalışmasına dayandığını gösterir.
Konuşmacı bilgisi analizi de önemli bir mesaj verir. Konuşmacı gömmesi kullanıldığında model üç veri setinde de daha iyi sonuç verir. Bu, farklı kişilerin ifade tarzı ve duygu eğilimlerinin duygu tanımada anlamlı bilgi taşıdığını destekler.
Deneyler Nasıl Yapılmış?
Çalışmada üç yaygın çok modlu duygu tanıma veri seti kullanılır: IEMOCAP-4, IEMOCAP-6 ve MELD. IEMOCAP-4 dört duygu etiketini içerir: öfke, üzüntü, mutluluk ve nötr. IEMOCAP-6 ise mutluluk, üzüntü, nötr, korku, şaşkınlık ve öfke olmak üzere altı duygu etiketi kullanır. MELD veri seti de çok konuşmacılı diyaloglarda duygu tanıma için kullanılan yaygın bir karşılaştırma veri setidir.
Metin özellikleri BERT ile çıkarılır. Ses özellikleri IEMOCAP için OpenSmile, MELD için librosa üzerinden elde edilir. Görsel özellikler IEMOCAP için OpenFace kullanılarak çıkarılır. Bu özellikler daha sonra CAHRGN modelinin grafik yapısına aktarılır.
Modelin performansı Accuracy ve weighted F1-score ile ölçülür. Accuracy, doğru tahmin edilen örneklerin oranıdır. Weighted F1-score ise sınıf dengesizliklerini daha iyi dikkate alan bir ölçüdür. Duygu tanıma veri setlerinde bazı duygu sınıfları diğerlerinden daha az görülebildiği için weighted F1 özellikle önemlidir.
Deneylerde CAHRGN, bc-LSTM, DialogueRNN, DialogueGCN, MMGCN, COGMEN, DGSNet, FrameERC ve benzeri önceki yöntemlerle karşılaştırılır. Ayrıca modelin hangi bileşenlerden ne kadar faydalandığını anlamak için ablation çalışmaları yapılır. Bu kapsamda modaliteler tek tek veya birlikte denenir; RGCN, Graph Transformer, çok modlu kenarlar, bağlam kenarları ve konuşmacı gömmesi çıkarılarak performans değişimi gözlenir.
Sonuçlar Ne Gösteriyor?
İlk sonuç, CAHRGN’nin üç veri setinde de güçlü performans göstermesidir. Model, konuşma içindeki duygu tanıma görevinde önceki birçok yöntemi geride bırakır. Bu sonuç, heterojen grafik yapısının ve bağlam farkındalığının duygu tanımada faydalı olabileceğini gösterir.
İkinci sonuç, metin bilgisinin hâlâ en güçlü tekil kaynak olduğudur. Tek başına metin modalitesi, ses ve görüntü modalitelerinden daha yüksek performans verir. Ancak en iyi sonuç yalnızca metinle değil, metin, ses ve görüntünün birlikte kullanılmasıyla elde edilir. Bu, çok modlu yaklaşımın pratik değerini destekler.
Üçüncü sonuç, bağlamın yönünün önemli olduğudur. Geçmiş ve gelecek sözler aynı şekilde ele alınmamalıdır. Model, geçmiş ve gelecek bağlamı ayrı ilişki türleriyle temsil ettiğinde konuşmadaki duygusal akışı daha iyi yakalayabilir.
Dördüncü sonuç, konuşmacı bilgisinin duygu tanımada katkı sağladığıdır. Konuşmacı gömmesi çıkarıldığında doğruluk düşer. Bu da insanların duygu ifade tarzlarının kişiden kişiye değiştiğini ve modelin bu farkı öğrenmesinin faydalı olduğunu gösterir.
Beşinci sonuç, RGCN ve Graph Transformer bileşenlerinin tamamlayıcı çalıştığıdır. RGCN ilişki türlerini ve yerel grafik komşuluklarını işlerken, Graph Transformer daha geniş bağlam ve uzun menzilli bağımlılıkları yakalamaya yardım eder. İki mimarinin birleşimi, tek başına kullanılan yapılara göre daha güçlü temsil üretir.
Bu Neden Önemli?
Konuşmalarda duygu tanıma, müşteri hizmetleri, eğitim teknolojileri, sosyal robotlar, çevrimiçi toplantı analizleri, çağrı merkezi kalite değerlendirmesi ve insan-bilgisayar etkileşimi gibi birçok alanda kullanılabilir. Ancak bu alanlarda güvenilirlik ve etik hassasiyet kritik önemdedir. İnsan duygusu tek bir kelimeye, yüz ifadesine veya ses tonuna indirgenemez.
Bu çalışma, daha bağlamlı ve çok kanallı duygu tanıma sistemleri için önemli bir yön gösterir. Bir kişinin ne hissettiğini anlamak için yalnızca söylediği kelimeye değil, konuşmanın hangi noktasında söylediğine, önceki ve sonraki cümlelere, konuşmacı tarzına ve farklı modalitelerin birbirini nasıl desteklediğine bakmak gerekir.
Modelin grafik tabanlı yapısı da önemlidir. Konuşma, düz bir metin dizisi gibi değil; kişiler, zaman, modaliteler ve ilişkilerden oluşan bir ağ gibi ele alınır. Bu yaklaşım, yapay zekânın insan iletişimini daha ilişkisel ve bağlamsal biçimde modellemesine katkı sağlayabilir.
Ancak bu tür sistemlerin gerçek dünyada kullanımı dikkat gerektirir. Duygu tanıma modelleri hatalı tahmin yapabilir, kültürel farkları kaçırabilir, bireysel ifade tarzlarını yanlış yorumlayabilir veya kişisel veri gizliliği sorunları doğurabilir. Bu nedenle böyle modeller karar destek aracı olarak düşünülmeli; insanı otomatik etiketleyen kesin sistemler gibi kullanılmamalıdır.
Dikkat Noktaları
İlk dikkat noktası, çalışmanın preprint olmasıdır. Hakem değerlendirmesinden geçmediği için model performansı, yöntem açıklamaları ve iddialar ileride değişebilir. Sonuçlar dikkatli ve karşılaştırmalı okunmalıdır.
İkinci dikkat noktası, veri seti sınırlılığıdır. IEMOCAP ve MELD gibi veri setleri araştırma için değerlidir; ancak gerçek dünyadaki konuşmalar çok daha karmaşık, gürültülü, kültürel olarak çeşitli ve bağlama bağımlıdır. Laboratuvar veya derlenmiş veri setindeki başarı, doğrudan gerçek dünya başarısı anlamına gelmez.
Üçüncü dikkat noktası, duygu etiketlerinin doğasıdır. Duygular çoğu zaman keskin sınıflara ayrılmaz. İnsan aynı anda hem üzgün hem öfkeli olabilir; ironik konuşabilir; duygusunu saklayabilir; kültürel olarak farklı ifade edebilir. Bu nedenle duygu sınıflandırma sistemleri her zaman belirsizlik payıyla değerlendirilmelidir.
Dördüncü dikkat noktası, konuşmacı bilgisi ve gizliliktir. Modelin konuşmacı kimliğinden faydalanması performansı artırabilir; fakat kişisel veri ve etik kullanım açısından dikkat gerektirir. Konuşmacı profili, duygu eğilimi veya ifade tarzı gibi bilgiler hassas veri niteliği kazanabilir.
Son olarak, bu içerik psikolojik veya klinik değerlendirme tavsiyesi değildir. Yapay zekâ tabanlı duygu tanıma sonuçları, insan davranışını kesin olarak yorumlamak için tek başına kullanılmamalıdır.
Sonuç
Bu çalışma, konuşmalarda duygu tanımanın yalnızca kelime sınıflandırma problemi olmadığını gösteriyor. Duygu, metin, ses, görüntü, konuşmacı kimliği ve zaman içindeki bağlamın birlikte şekillendirdiği karmaşık bir iletişim sinyalidir.
CAHRGN modeli, bu karmaşıklığı grafik yapısı içinde temsil ederek önemli bir yaklaşım sunar. Her konuşma birimini metin, ses ve görüntü düğümleriyle ele alır; aynı söz içindeki modalite ilişkilerini, geçmiş ve gelecek bağlamı, konuşmacı bilgisini ve uzun menzilli bağımlılıkları birlikte işler. Deneysel sonuçlar, bu tasarımın mevcut yöntemlere göre daha güçlü performans sağlayabileceğini göstermektedir.
Verianla açısından çalışmanın ana mesajı şudur: Yapay zekânın insan duygusunu daha iyi anlaması için yalnızca daha büyük model değil, daha doğru bağlam mimarisi gerekir. Duygu, tek bir cümlede değil; konuşmanın akışında, konuşmacının tarzında ve metin-ses-görüntü arasındaki ilişkide ortaya çıkar.
Kaynak ve Yöntem Notu
Bu içerik, Yuling Ren, Junpeng Bao, Kaiyu He, Tingyu Li ve Jiangjiang Zhao tarafından hazırlanan “CAHRGN: a Context-Aware Heterogeneous Relational Graph Network for Multimodal Emotion Recognition in Conversation” başlıklı preprint araştırma çalışmasına dayalı olarak hazırlanmıştır. Çalışma; çok modlu konuşma duygu tanıma, heterojen ilişkisel grafik ağları, konuşmacı gömmesi, RGCN ve Graph Transformer mimarilerini birleştiren CAHRGN modelini önermektedir.
Bu içerik birebir çeviri değildir; çalışmanın ana fikri Verianla yayın çizgisine uygun biçimde sadeleştirilmiş ve özgün Türkçe editoryal makaleye dönüştürülmüştür.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir