


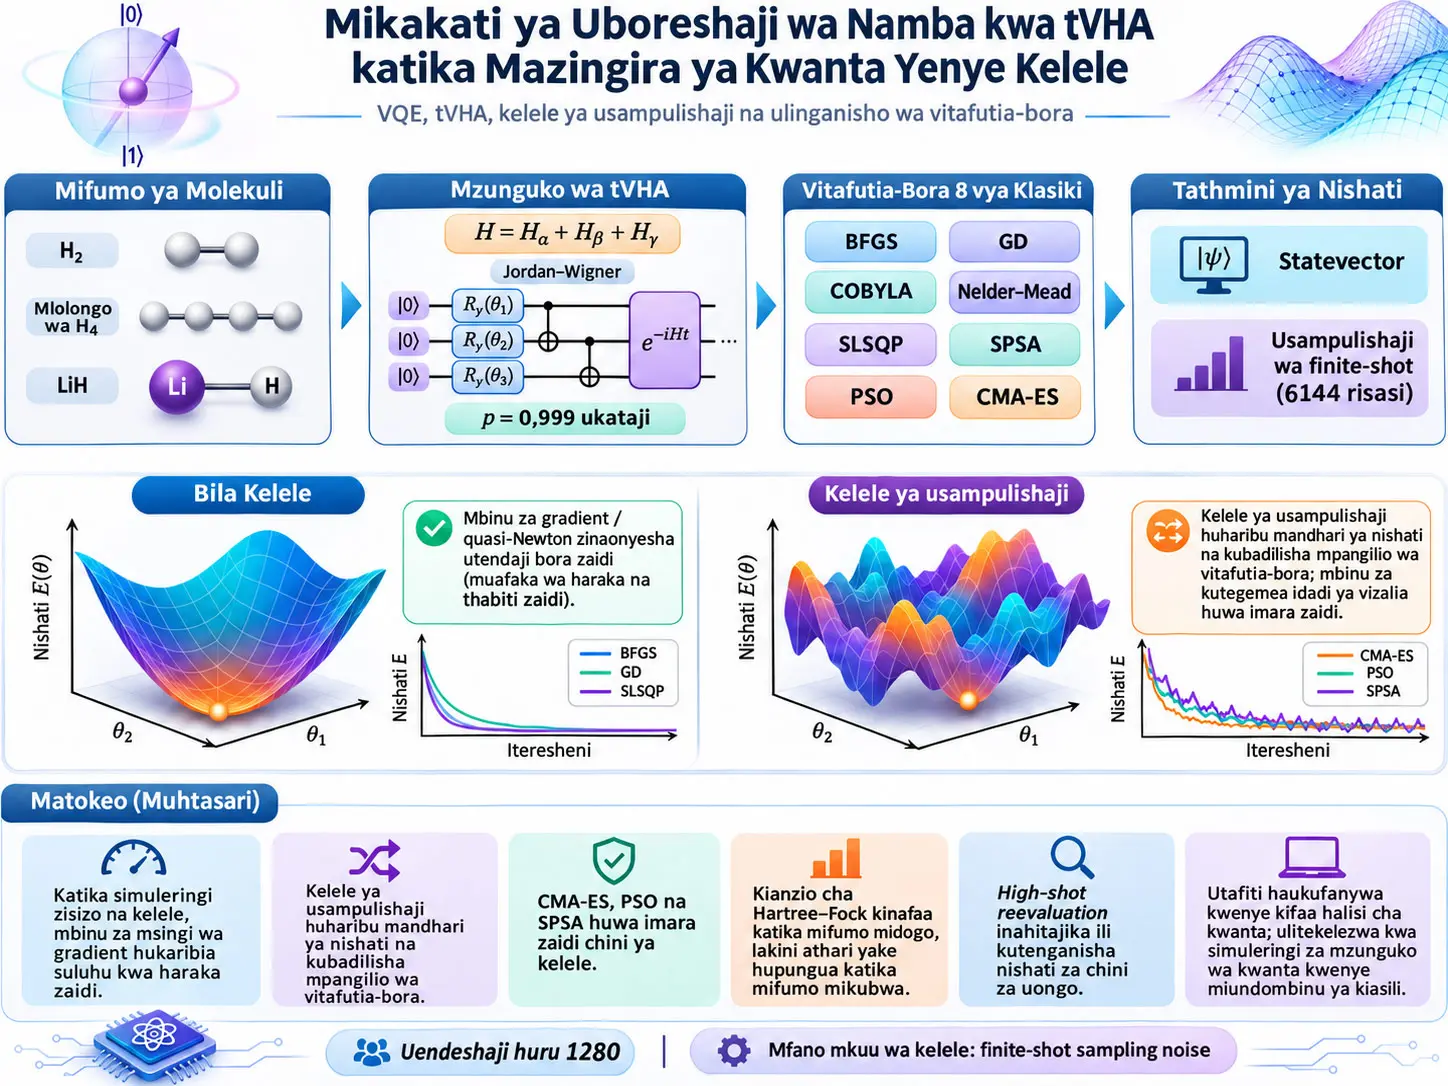
Truncated Variational Hamiltonian Ansatz (tVHA) ni ansatz ya kwanta ya variational iliyoundwa kwa kuzingatia kemia, inayotokana na muundo wa kifizikia wa Hamiltonian ya elektroni za molekuli na inayopunguza kwa udhibiti hasa non-Coulomb two-body terms ili kufanya mzunguko wa kwanta wenye vigezo uwe rahisi zaidi kusimamia. Utafiti huu unalinganisha tabia ya algoriti nane za uboreshaji wa kawaida katika hesabu za Variational Quantum Eigensolver (VQE) zinazotumia tVHA kwenye H2, mnyororo wa mstari wa H4, na uwakilishi wa full-space na active-space wa LiH. Utafiti haukufanywa kwenye vifaa halisi vya kwanta; quantum circuits ziliigwa kwa Qiskit kwenye miundombinu ya kawaida ya kompyuta yenye utendaji wa juu. Kwa hiyo, “ustahimilivu wa kelele” unaopimwa hapa kimsingi ni utendaji wa uigaji dhidi ya finite-shot sampling noise.
Optimizer nane zilizolinganishwa ni BFGS, Covariance Matrix Adaptation Evolution Strategy (CMA-ES), COBYLA, Gradient Descent (GD), Nelder–Mead, Particle Swarm Optimization (PSO), Sequential Least Squares Programming (SLSQP), na Simultaneous Perturbation Stochastic Approximation (SPSA). Kila jozi ya molecule–optimizer ilijaribiwa katika hali nne: mwanzo wa Hartree–Fock + statevector, mwanzo wa Hartree–Fock + finite-shot sampling, mwanzo wa random + statevector, na mwanzo wa random + finite-shot sampling. Kwa kila hali, uendeshaji 10 huru ulifanywa na jumla ya:
\[ 4\ \text{moleküler temsil} \times 8\ \text{optimizer} \times 4\ \text{senaryo} \times 10\ \text{koşu} = 1280 \]
simulation huru zilitolewa.
Katika noisy benchmark kuu, 6144 shot zilitumika kwa kila function evaluation. Qiskit StatevectorEstimator ilitumiwa kama exact reference, na Qiskit Aer Estimator kwa hesabu za finite-shot. Kwa kuwa Aer Estimator huchukua sampuli kulingana na kanuni ya Born, measured expectation values huwa na finite sample variance. Hitimisho kuu la utafiti ni kwamba sampling noise haiongezi tu kosa dogo kwenye matokeo; hubadilisha umbo la cost landscape, minima zinazoonekana, gradient directions, na hivyo mpangilio wa optimizer.
Katika hali za statevector zisizo na kelele, hasa kwa mfumo mdogo wa H2, BFGS na mbinu nyingine za deterministiki hukaribia suluhisho kwa kasi sana na kwa usahihi mkubwa, lakini chini ya finite-shot sampling noise ubora huu hupotea kwa kiasi kikubwa. Kadiri nafasi ya molekuli na vigezo inavyokuwa changamano, mbinu za population-based au stochastic kama CMA-ES, PSO na SPSA huwa thabiti zaidi. Katika full-space LiH noisy benchmark, baada ya high-shot reevaluation, CMA-ES ilitoa matokeo bora zaidi kwenye chanzo kwa kosa la takriban \(8\times10^{-3}\) Ha, huku katika active-space LiH CMA-ES ikifikia \(2.6\times10^{-4}\) Ha, SPSA \(3.9\times10^{-4}\) Ha na PSO \(4.2\times10^{-4}\) Ha.
Kikomo muhimu zaidi cha tafsiri ya kifizikia katika utafiti kinahusiana na variational principle. Kwa exact expectation value:
\[ E(\boldsymbol{\theta})\ge E_0 \]
huendelea kuwa halali. Katika hesabu ya finite-shot, thamani inayoweza kuonekana chini ya hapo ni:
\[ \hat E(\boldsymbol{\theta})
makadirio ya kitakwimu ya nishati. Hii haimaanishi kwamba quantum state halisi ya kifizikia ina nishati ya chini kuliko nishati ya hali ya msingi. Sampling fluctuation inaweza kushusha kwa muda estimator iliyopimwa.
Matokeo ya utafiti si uthibitisho wa moja kwa moja wa utendaji wa quantum hardware halisi. Benchmark haijumuishi coherent gate errors, stochastic gate errors, amplitude damping, thermal relaxation, au readout-assignment bias. Waandishi pia wanaeleza kwamba hardware noise channels hizi za hali halisi zinapaswa kupimwa kando katika future work.
tVHA ni Nini na Hufanya Nini Ndani ya VQE?
Truncated Variational Hamiltonian Ansatz ni ansatz iliyoundwa kwa kuzingatia kemia ambayo hubadilisha moja kwa moja vipengele vya elektroni moja, Coulomb elektroni mbili, na non-Coulomb elektroni mbili vya Hamiltonian ya molekuli kuwa blok za quantum evolution zenye vigezo, na hukata sehemu ya michango ya non-Coulomb kwa mpangilio wa umuhimu ili kupunguza uchangamano wa mzunguko; ndani ya VQE, jukumu lake ni kufafanua familia ya quantum state ambayo classical optimizer inayotafuta nishati ya hali ya msingi itarekebisha.
Kwa nini VQE ni algoriti ya kwanta na ya kawaida kwa pamoja?
Variational Quantum Eigensolver ni mbinu ya hybrid quantum–classical. Upande wa Quantum huandaa hali yenye vigezo:
\[ |\psi(\boldsymbol{\theta})\rangle \]
na hupima expectation value ya Hamiltonian:
\[ E(\boldsymbol{\theta}) = \langle\psi(\boldsymbol{\theta})| H |\psi(\boldsymbol{\theta})\rangle. \]
Classical optimizer hubadilisha vigezo \(\boldsymbol{\theta}\) ili kujaribu kupunguza nishati hii.
Kwa hiyo objective function ambayo optimizer huona ni makadirio ya nishati yanayotolewa na mzunguko wa kwanta. Makadirio haya yanapokuwa na kelele, optimizer inaweza kuona gradient isiyo sahihi, curvature isiyo sahihi, au false minimum ya muda.
Ansatz ni nini?
Ansatz ni familia ya quantum-state yenye vigezo ambayo VQE itafanya utafutaji ndani yake. Ansatz nzuri inapaswa kusawazisha mahitaji mawili yanayokinzana:
- Inapaswa kuwa expressive vya kutosha kuweza kukaribia ground state halisi ya molekuli.
- Inapaswa kuwa na vigezo vichache na kina kidogo cha mzunguko kiasi cha kuweza kuendeshwa katika hali za NISQ.
Ansatz dhaifu sana haiwezi kufikia ground state. Ansatz changamano sana inaweza kuongeza kina cha mzunguko, gharama ya upimaji, na ugumu wa uboreshaji.
Hamiltonian ya molekuli hugawanywaje?
Chanzo kwanza kinafafanua muundo wa tVHA kama:
\[ H=H_{\alpha}+H_{\beta}+H_{\gamma} \tag{1} \]
Inafafanuliwa katika muundo huu.
Hapa:
- \(H_{\alpha}\): huwakilisha one-body terms,
- \(H_{\beta}\): huwakilisha Coulomb two-body terms,
- \(H_{\gamma}\): huwakilisha non-Coulomb two-body terms
.
Chanzo kinatoa Equation (2) katika muundo ufuatao:
\[ H= \sum_{ij} h_{ij}a_i^{\dagger}a_j + \frac{1}{2} \sum_{ij} g_{ijk\ell} a_i^{\dagger}a_j^{\dagger}a_ja_i + \frac{1}{2} \sum_{\substack{ijk\ell\\i\neq k\\j\neq\ell}} g_{ijk\ell} a_i^{\dagger}a_j^{\dagger}a_ka_{\ell}. \tag{2} \]
\(a_i^\dagger\) ni fermionic creation operator na \(a_j\) ni annihilation operator. \(h_{ij}\) ni uwakilishi wa kisimbaji wa one-electron integrals, na \(g_{ijk\ell}\) ni uwakilishi wa kisimbaji wa two-electron interaction coefficients.
Onyo kuhusu notation ya chanzo: Katika term ya Coulomb ya Equation (2), alama ya jumla imeandikwa tu juu ya \(i,j\), ilhali coefficient \(g_{ijk\ell}\) ina faharasa nne. Chanzo hakifafanui kando faharasa \(k,\ell\) katika sehemu hii. Kwa hiyo Verianla haijabadilisha kimya kimya equation kuwa muundo wa faharasa uliozoeleka zaidi; imehifadhi uandishi wa chanzo.
truncation threshold katika tVHA inawakilisha nini?
Baada ya non-Coulomb two-body terms kupangwa kulingana na ukubwa wa umuhimu, chanzo kinafafanua cumulative truncation fraction katika Equation (3) kama:
\[ p= \frac{1} {\sum_s |g_s^{\gamma}|} \sum_{s=1}^{s_{\mathrm{cut}}} |g_s^{\gamma}| \tag{3} \]
inafafanuliwa katika muundo huu.
Hapa:
- \(g_s^\gamma\): non-Coulomb two-body coefficient,
- \(s\): namna ambavyo fermionic index nne zimekusanywa chini ya faharasa moja iliyopangwa,
- \(s_{\mathrm{cut}}\): cutoff ya terms zinazohifadhiwa,
- \(p\): cumulative interaction weight fraction inayohifadhiwa.
Katika benchmark hii:
\[ p=0.999 \]
imetumika.
Yaani, kulingana na ufafanuzi wa chanzo, terms zinazounda %99,9 ya ukubwa wa jumla wa non-Coulomb two-body interaction strength zilijaribiwa kuhifadhiwa, huku michango midogo ikipunguzwa ili kupunguza uchangamano wa mzunguko.
Truncation hii si ya bure. Operator chache zinaweza kusaidia kutengeneza circuit yenye kina kidogo, lakini zinaweza kupunguza state space inayoweza kufikiwa na ansatz na kusababisha reachability deficit. Katika hali kama hiyo, hata optimizer ikifanya kazi kikamilifu, ansatz inaweza isiweze kufikia kikamilifu full-configuration-interaction ground state halisi.
Kwa nini Fermionic Hamiltonian hubadilishwa kuwa qubit operators?
Kwa kuwa elektroni ni fermion, electronic Hamiltonian huandikwa kwa creation/annihilation operators. Gate-model quantum circuit hufanya kazi kwa qubit na Pauli operators. Katika utafiti, fermionic Hamiltonian:
\[ H_{\alpha} = \sum_{\alpha}c_{\alpha}P_{\alpha}, \qquad H_{\beta} = \sum_{\beta}c_{\beta}P_{\beta}, \qquad H_{\gamma} = \sum_{\gamma}c_{\gamma}P_{\gamma} \]
hubadilishwa kuwa miundo ya Pauli-term kwa kutumia Jordan–Wigner transformation.
Chanzo kinaeleza kwamba Bravyi–Kitaev transformation pia inawezekana kimsingi, lakini Jordan–Wigner mapping huruhusu kila qubit state kufasiriwa moja kwa moja zaidi kama spin-orbital occupation number.
Kwa nini Commuting Pauli groups hutumiwa?
Pauli terms zinazocommute zinaweza kushughulikiwa pamoja ndani ya measurement context ileile. Chanzo hugawa Pauli terms kuwa commuting groups kwa graph coloring na hivyo kulenga kupunguza mzigo wa upimaji.
Kwa Hamiltonian fragment tatu, commuting-set families huonyeshwa kama:
\[ \mathcal{G}^{\alpha}, \qquad \mathcal{G}^{\beta}, \qquad \mathcal{G}^{\gamma} \]
.
tVHA unitary transformation hujengwaje?
Chanzo Equation (4):
\[ U(\boldsymbol{\alpha},\boldsymbol{\beta},\boldsymbol{\gamma}) = \prod_{d=1}^{D} \left[ \prod_{G\in\mathcal{G}^{\alpha}} e^{i\alpha_d c_{\alpha,G}P_{\alpha}} \right] \left[ \prod_{G\in\mathcal{G}^{\beta}} e^{i\beta_d c_{\beta,G}P_{\beta}} \right] \left[ \prod_{G\in\mathcal{G}^{\gamma}} e^{i\gamma_d c_{\gamma,G}P_{\gamma}} \right]. \tag{4} \]
Hapa:
- \(D\): idadi ya discretization/Trotter-step na hivyo ni kigezo kinachohusiana na circuit depth,
- \(\alpha_d,\beta_d,\gamma_d\): variational parameters zinazobadilishwa na classical optimizer,
- \(c_{\alpha,G},c_{\beta,G},c_{\gamma,G}\): Pauli-group coefficients,
- \(P\): Pauli operator husika,
- \(\mathcal G\): commuting groups.
Exponential evolution ya sehemu za non-commuting Hamiltonian hukadiriwa kwa Suzuki–Trotter ya daraja la kwanza, inayojulikana pia kama Lie–Trotter expansion.
Chanzo kinatoa mfano gani wa quantum circuit kwa H2?
Kwa tatizo la H2 ground-state, Figure 1 ya chanzo inaonyesha mfano wa tVHA circuit uliotenganishwa kikamilifu wenye 4-qubit na 3 trainable-parameter.
| Gate | Idadi |
|---|---|
| CX | 48 |
| H | 32 |
| \(\sqrt{X}\) | 16 |
| RZ | 16 |
| \(\sqrt{X}^{\dagger}\) | 16 |
| RZZ | 6 |
| U3 | 2 |
Gate count hii inahusu tu mfano wa H2 circuit ulioonyeshwa katika chanzo; si sahihi kudhani idadi ileile ya gate kwa molekuli nyingine.
Hartree–Fock initialization huundwaje?
Chanzo kinatoa mwanzo unaotegemea wazo la adiabatic state preparation kama:
\[ U_{\mathrm{ad}} = \prod_{d=1}^{D} e^{-i\frac{\tau}{D}H_0} e^{-i\frac{\tau}{D}\frac{d}{D}V} \tag{5} \]
Chanzo kinatoa katika muundo huu.
Hapa:
- \(H_0\): non-interacting Hamiltonian component,
- \(V\): interacting component,
- \(\tau\): effective adiabatic-evolution parameter,
- \(d/D\): fractional weight ya interaction inayoongezeka kadiri hatua zinavyoendelea,
- \(D\): idadi ya discretization step.
Chanzo kinatoa vigezo vya mwanzo kwa \(H_{\beta}\) na \(H_{\gamma}\) kama:
\[ \beta_d^{(0)} = \gamma_d^{(0)} = \frac{\tau}{D} \langle V\rangle_{\mathrm{HF}} \frac{d}{D} \]
.
Katika sentensi ya chanzo kuhusu kigezo cha mwanzo cha \(H_{\alpha}\), \(\alpha_d^{(0)}\), \(\tau/D\) na \(\langle H_\alpha\rangle_{\mathrm{HF}}\) zimeandikwa pamoja; hata hivyo, katika maandishi ya PDF iliyochapishwa hakuna alama dhahiri ya usawa inayoonekana katika sehemu hii. Kwa hiyo, uhusiano wa kisimbaji unaoonekana kukosekana haujakisiwa na kujazwa na Verianla.
Random initialization nayo:
\[ \theta_i^{(0)} \sim \mathcal U(0,1) \]
imefanywa kwa uniform distribution.
Kwa Nini Finite-Shot Sampling Noise Huharibu Mandhari ya Nishati?
Finite-shot sampling noise huongeza kosa la nasibu kwenye makadirio ya nishati kwa sababu expectation value hukadiriwa kutoka kwa idadi ndogo ya quantum measurement outcome badala ya wastani wa kipimo usio na kikomo; gradient halisi ikiwa ndogo, kosa hili linaweza kuficha gradient, kuionyesha katika mwelekeo wa kinyume, kufanya mabonde laini yaonekane na mikwaruzo ya bandia na kuonyesha optimizer minima ambazo kwa kweli hazipo.
Tofauti kati ya Statevector na shot-based simulation
StatevectorEstimator huhesabu expectation value kwa njia ya deterministiki kupitia quantum state amplitudes. Hakuna finite-shot sampling variance.
Aer Estimator huchukua measurement outcomes kwa mujibu wa kanuni ya Born. Shot zinapokuwa na idadi yenye kikomo, parameter point ileile ikipimwa tena si lazima itoe estimated energy ileile.
Chanzo kimetumia kwa benchmark kuu:
\[ N_{\mathrm{shots}}=6144 \]
.
Sampling variance kwa ujumla hupungua kwa kiwango cha:
\[ \sigma^2\propto\frac{1}{N_{\mathrm{shots}}} \]
.
Kwa hiyo standard deviation huonyesha takriban tabia ya:
\[ \sigma\propto\frac{1}{\sqrt{N_{\mathrm{shots}}}} \]
. Kuongeza idadi ya shot mara nne, hali nyingine zikiwa sawa, kunaendana na square-root scaling inayopunguza standard deviation kwa takriban nusu.
Energy-landscape slicing ilifanywaje?
Waandishi kwanza walitumia sampling yenye usahihi wa juu kwa:
\[ N_{\mathrm{shots}}\ge10^6 \]
na kupata reference parameter set:
\[ \boldsymbol{\theta}^{\ast} \]
.
Kisha kwa parameter direction mbili zilizochaguliwa:
\[ \delta_i,\delta_j\in[-\Delta,\Delta] \]
nishati ilihesabiwa tena kwenye grid, huku parameters nyingine zikishikiliwa kwenye optimum reference values.
Hivyo ililinganishwa jinsi optimizer “inavyoona” energy surface ileile ya msingi chini ya shot counts tofauti.
Upotoshaji mkuu tatu wa landscape ulioonekana katika chanzo
Ujumbe mkuu wa Figure 2 ya chanzo unaweza kufupishwa chini ya mifumo mitatu:
- False minima: finite-shot fluctuations zinaweza kuunda maeneo ya chini ya ndani ambayo hayapo kwenye uso halisi.
- Gradient reversal: noisy slope inaweza kuonyesha mwelekeo ulio kinyume na slope halisi.
- Noise-induced ruggedness: hasa chini ya quasi-degenerate au flat valley, gradient ndogo halisi huzidiwa na sampling fluctuations.
Katika hali hizi, badala ya deterministic descent, optimizer inaweza kuonyesha stochastic drift au mwendo unaofanana na random-walk ndani ya parameter space.
Barren plateau ni nini?
Barren plateau ni hali ya optimization landscape iliyo tambarare ambapo cost-function gradient za parameterized quantum circuit huwa ndogo sana kadiri mfumo unavyoongezeka, na hivyo kuwa vigumu kwa optimizer kupata descent direction yenye maana.
Chanzo kinaeleza muktadha wa kinadharia kwa:
\[ \ell_{\theta} = \langle\rho(\theta),O\rangle, \qquad \rho(\theta)\in\mathcal B(\mathcal H) \tag{6} \]
na:
\[ \operatorname{Var}_{\theta}(\ell_{\theta}) \in \mathcal O\left(\frac{1}{4^n}\right) \tag{7} \]
.
Hapa:
- \(\rho(\theta)\): parameterized quantum state/operator representation,
- \(O\): observable,
- \(\ell_\theta\): loss inayotokana na observable expectation,
- \(n\): idadi ya qubit.
Hilbert-space dimension:
\[ \dim\mathcal H=2^n \]
na operator-space dimension:
\[ \dim\mathcal B(\mathcal H)=4^n \]
hukua.
Kwa mfano wa 12-qubit LiH, chanzo kinasisitiza ukubwa wa operator-space dimension:
\[ 4^{12}=16\,777\,216\approx1.6\times10^7 \]
.
Equation (6)–(7) si matokeo mapya ya empirical scaling yaliyopimwa katika benchmark hii, bali ni mfumo wa kinadharia unaoeleza kwa nini sampling noise na tatizo la barren-plateau zinaweza kuwa kubwa zikitokea pamoja.
Je, Kanuni ya Variational Inakiukwa Kweli Katika Kipimo cha Finite-Shot?
Exact quantum expectation value haikiuki mpaka wa chini wa variational; \(E(\theta)\ge E_0\) huendelea kuwa halali, lakini estimator ya nasibu \(\hat E\) inayohesabiwa kutoka finite-shot measurement husambaa karibu na expectation halisi na hivyo inaweza kuonekana chini ya \(E_0\) katika baadhi ya sampuli; chanzo kinatumia msemo “variational-bound violation” kwa ukiukaji huu wa kitakwimu unaoonekana.
Exact energy na estimated energy si kitu kimoja
Kanuni ya variational inasema:
\[ E(\boldsymbol{\theta}) = \langle\psi(\boldsymbol{\theta})| H |\psi(\boldsymbol{\theta})\rangle \ge E_0 \]
.
\(E_0\) ni exact ground-state energy.
Katika kipimo cha finite-shot, optimizer huona:
\[ \hat E = E+\text{sampling fluctuation} \]
ambayo ni stochastic estimator.
Ikiwa variational energy halisi tayari iko karibu sana na ground state, sampling fluctuation hasi inaweza kuwa kubwa kuliko energy gap iliyobaki. Hapo:
\[ \hat E
inaweza kuonekana.
Hii haimaanishi “ground state mpya ya kifizikia yenye nishati ya chini imegunduliwa”.
Sampling noise humodeliwaje kihisabati?
Equation (8) ya chanzo ni:
\[ \bar C(\boldsymbol{\theta}) = C(\boldsymbol{\theta}) + \epsilon_{\mathrm{sampling}} \tag{8} \]
.
Hapa:
- \(C(\theta)\): expectation-based objective halisi,
- \(\bar C(\theta)\): finite-shot noisy estimate,
- \(\epsilon_{\mathrm{sampling}}\): sampling error ambayo mean yake inachukuliwa kuwa sifuri.
Chanzo kinatumia uhusiano:
\[ \operatorname{Var} (\epsilon_{\mathrm{sampling}}) = \frac{\operatorname{Var}[C(\theta)]} {N_{\mathrm{shots}}} \]
.
Hamiltonian variance huhesabiwaje?
\[ \hat H = \sum_k c_kP_k \]
Kwa muundo huu, Equation (9) ya chanzo ni:
\[ \operatorname{Var}[C(\theta)] = \langle\hat H^2\rangle - \langle\hat H\rangle^2. \tag{9} \]
Hii ni tofauti kati ya moment ya pili ya observable na mraba wa expectation value.
Chanzo pia kinaeleza kuwa, pamoja na Pauli-term shot noise, covariance contributions ndani ya commuting measurement groups zilezile huchangia estimator variance.
Sampling noise floor hufafanuliwaje?
Chanzo kinakadiria effective noise floor katika optimization trajectory kama:
\[ \sigma_{\mathrm{noise}} \approx \sqrt{ \frac{1}{N} \sum_{i=1}^{N} \frac{ \operatorname{Var}[C(\theta_i)] }{ N_{\mathrm{shots}} } } \tag{10} \]
.
Hapa \(N\) ni idadi ya nukta zilizotathminiwa katika trajectory.
Optimizer inapokaribia noise floor, kupata observed energy ya chini zaidi hakumaanishi tena lazima kuwa imepata parameters bora zaidi; measured differences zinaweza kuwa zimefikia kiwango sawa na noise magnitude.
Katika Figure 3, noise floor hubadilikaje na idadi ya shot?
| Idadi ya Shot | Noise floor (Ha) | Hali ya data |
|---|---|---|
| 8 | ±6,7 × 10⁻² | Lebo ya Figure 3 ya chanzo |
| 16 | ±4,2 × 10⁻² | Lebo ya Figure 3 ya chanzo |
| 32 | ±2,5 × 10⁻² | Lebo ya Figure 3 ya chanzo |
| 64 | ±1,7 × 10⁻² | Lebo ya Figure 3 ya chanzo |
| 512 | ±6,0 × 10⁻³ | Lebo ya Figure 3 ya chanzo |
| 1024 | ±4,0 × 10⁻³ | Lebo ya Figure 3 ya chanzo |
| 6144 | ±1,6 × 10⁻³ | Lebo ya Figure 3 ya chanzo |
| 12.000 | ±1,2 × 10⁻³ | Lebo ya Figure 3 ya chanzo |
| 30.000 | ±7,3 × 10⁻⁴ | Lebo ya Figure 3 ya chanzo |
Idadi ya shot inapoongezeka, noise floor hupungua; lakini kwa sababu ya scaling yenye tabia ya \(1/\sqrt{N_{\mathrm{shots}}}\), kupata uboreshaji uleule wa thamani kamili huhitaji shot zaidi na zaidi. Tathmini ya waandishi kwamba kuna “diminishing returns baada ya takriban 1000 shot” haimaanishi uboreshaji unasimama kabisa; inaonyesha kuwa faida ya ukingo ya usahihi kwa kila shot ya ziada inapungua.
Kwa Nini Population Mean Inaweza Kuwa ya Kuaminika Zaidi Kuliko Mgombea Mmoja “Bora Zaidi”?
Sampling noise ikiwa takriban simetria, wastani wa wagombea wengi katika population unaweza kufuta kwa kiasi measurement fluctuations chanya na hasi; kinyume chake, kuchagua tu mgombea aliyepimwa chini zaidi kunaweza kuongeza uwezekano wa kuchagua “good outlier” aliyepimwa kwa bahati chini kupita kiasi katika population kubwa, na hivyo kufanya optimizer ichukulie noise kama maendeleo halisi.
Population inapokuwa kubwa, athari mbili zinazokinzana zinaweza kutokea kwa wakati mmoja
Mojawapo ya vipengele muhimu vya utafiti huu ni:
- Best-value selection: population inapoongezeka, uwezekano wa kupata lucky noise sample ya chini sana unaweza kuongezeka.
- Population mean: population inapoongezeka, fluctuations huru/zenye uhusiano mdogo zinaweza kufutana vizuri zaidi katika wastani.
Chanzo kinatumia scaling ifuatayo kwa population-average estimation error:
\[ \mathrm{Error} \propto \frac{\sigma_{\mathrm{noise}}}{\sqrt{\lambda}} \]
.
Hapa \(\lambda\) ni population size.
Usemi huu haupaswi kutafsiriwa kama “mpaka wa msingi wa kifizikia wa sampling noise umevunjwa”. Kwa sababu taarifa za kitakwimu zinaunganishwa kutoka kwa population member wengi zaidi, mean estimate huwa sahihi zaidi kuliko noisy evaluation moja.
Mikakati mitatu ya noise-floor inayolinganishwa na chanzo
- Shot escalation: kuongeza idadi ya shot kwa kila evaluation.
- Selective high-shot reevaluation: kupima tena candidates wanaoonekana bora kwa shot nyingi zaidi.
- Population averaging: kutumia CMA-ES steady-state population statistics.
Shot escalation hupunguza variance moja kwa moja lakini huongeza gharama. Selective reevaluation hubeba hatari ya selection bias ikiwa mgombea aliyechaguliwa tayari ni lucky outlier. Population mean inalenga kutumia simetria ya sampling fluctuations ili kupunguza bias ya uchunguzi mmoja wa minimum.
Waandishi hutumia uwezo wa CMA-ES wa kukaribia steady-state distribution inayobainishwa na noise floor; lakini pia wanaeleza wazi kuwa hii haidhamini kufikia global ground-state optimum.
Uchambuzi wa ziada wa Population size ulionyesha nini?
Appendix C:
\[ \lambda=7,\ 25,\ 50,\ 100 \]
inatoa uchambuzi wa ziada kwa population sizes.
Hata katika hali ya \(\lambda=7\), iteration mean inaonyesha mwelekeo wa kosa la chini kuliko best-value selection moja.
Katika \(\lambda=25\) na hasa \(\lambda=50\), population mean hutenda karibu sana na theoretical/empirical noise floor.
Kwa \(\lambda=100\) katika hali ya 30.000-shot, chanzo kinaripoti kwamba karibu na iteration 5 ilifika haraka karibu na zero-error, ikabaki katika eneo hilo hadi karibu iteration 20, na baadaye dalili za noise-induced divergence/overfitting zikaonekana.
Kwa hiyo utafiti hauhitimishi kwamba “population ikiwa kubwa zaidi daima ni bora zaidi”. Waandishi wanapendekeza kuwa kunaweza kuwa na population-size window bora, lakini hawaainishi thamani moja bora ya \(\lambda\) inayotumika kwa matatizo yote.
Mbinu na Matokeo ya Utafiti
Benchmark inalinganisha tabia ya classical optimizer nane katika hali za exact statevector na finite-shot sampling, kwa chaguo za Hartree–Fock na random initialization, kwenye tVHA circuits zilizoigwa katika miundombinu ya classical high-performance computing.
Mifumo ya molekuli
| Sifa | H2 | LiH Active Space | LiH Full Space | Mnyororo wa H4 |
|---|---|---|---|---|
| Bond length / distances (Å) | 0,74279 | 1,596 | 1,596 | 0,7; 0,7; 0,768 |
| Charge | 0 | 0 | 0 | 0 |
| Multiplicity | 1 | 1 | 1 | 1 |
| Basis set | STO-3G | STO-3G | STO-3G | STO-3G |
| Active space | Full | (2,2), 3 orbital | Full | Full |
Footnote ya chanzo kwa LiH active-space hutumia usemi orbitals [1,2,3] na 2 alpha + 2 beta electrons. Uwakilishi huu umehifadhiwa kama ulivyotolewa katika chanzo.
STO-3G basis set inamaanisha nini?
STO-3G ni minimal Gaussian basis family inayotumika katika molecular orbital calculations. Chanzo kinaitumia kama basis ileile kwa mifumo yote, hivyo kulinganisha optimizer kwenye electronic-structure approximation ileile ya msingi.
Kwa nini Active-space reduction ni muhimu?
Mbinu ya Active-space hufanya hesabu kwenye orbitals zilizochaguliwa ambazo ni muhimu kwa electron correlation badala ya molecular orbitals zote. Kwa njia hii:
- mahitaji ya qubit/circuit,
- ukubwa wa parameter-space,
- effective landscape ambayo optimizer inapaswa kuchunguza
vinaweza kupunguzwa.
Hata hivyo, matokeo ya active-space si tatizo lilelile na suluhisho la full molecular Hilbert-space. Ingawa chanzo kinaonyesha kuwa LiH active-space huongeza noise robustness, si sahihi kulitafsiri kama “tatizo la full LiH limetatuliwa kikamilifu na kwa usahihi zaidi”.
Optimizer zilizolinganishwa
| Optimizer | Uainishaji wa chanzo | Kanuni kuu ya utendaji |
|---|---|---|
| BFGS | Gradient-based | Sasisho la quasi-Newton kwa Inverse-Hessian approximation |
| CMA-ES | Metaheuristic / evolutionary | Candidate population na adaptive multivariate Gaussian covariance |
| COBYLA | Gradient-free | Local linear approximations na mbinu ya trust-region kwa objective na constraints |
| GD | Gradient-based | Parameter update katika Negative gradient direction |
| Nelder–Mead | Gradient-free | Matendo ya Simplex reflection, expansion, contraction na shrink |
| PSO | Metaheuristic / swarm | Particles kusogea kulingana na taarifa za individual-best na global-best |
| SLSQP | Gradient-based | Sequential quadratic programming na constrained local approximation |
| SPSA | Gradient-free katika Table 3 ya chanzo | Kufanya perturb kwa parameters zote kwa wakati mmoja na kupata stochastic gradient estimate kwa function evaluation mbili |
Dokezo la uainishaji wa SLSQP: Katika sehemu ya Introduction ya chanzo, COBYLA na SLSQP zinatajwa pamoja chini ya usemi “derivative-free techniques”. Kwa upande mwingine, Appendix A na Table 3 zinaainisha SLSQP kama gradient-based method na kueleza muundo wa sequential quadratic programming. Verianla imetumia uainishaji wenye maelezo zaidi wa Appendix A/Table 3 katika jedwali kuu na haijaficha usemi tofauti wa Introduction.
Ni simulation huru ngapi ziliendeshwa?
Kwa kila jozi ya optimizer–molecule kuna configuration nne na run 10 kwa kila configuration:
| Hali | Initialization | Energy evaluation |
|---|---|---|
| 1 | Hartree–Fock | Statevector |
| 2 | Hartree–Fock | 6144-shot sampling |
| 3 | Random | Statevector |
| 4 | Random | 6144-shot sampling |
Jumla:
\[ 1280 \]
run huru zilifanywa.
Pseudo-random seeds hazikuwekwa thabiti. Kwa mujibu wa chanzo, kwa njia hii starting points, stochastic steps za optimizer na shot sampling zilitokea kama stochastic draw huru katika kila trial.
Chaguo hili lina maana kwa kutathmini ensemble-level robustness; lakini linafanya uzalishaji upya wa bit-bit wa run moja kuwa mgumu zaidi kuliko matumizi ya seed thabiti.
Optimizer hyperparameters zilichaguliwaje?
Chanzo kinaeleza kwamba optimizer hyperparameters hazikufanyiwa tune moja moja kwa kila molecule; badala yake, defaults zinazotumika sana za implementations husika zilichaguliwa. Lengo ni kupunguza case-by-case tuning bias kati ya mbinu.
Kwa upande mwingine, Appendix E inatoa tolerance zilizo wazi kwa stopping/convergence criteria.
Convergence criteria
| Optimizer | Kigezo cha chanzo | Criterion ya chanzo |
|---|---|---|
| BFGS | \(ftol=10^{-10}\) | \(\frac{f_k-f_{k+1}}{\max(|f_k|,|f_{k+1}|,1)}\le ftol\) |
| COBYLA | \(tol=10^{-7}\) | \(\Delta f_k=|f_{k+1}-f_k|\le tol\) |
| GD | \(tol=5\times10^{-4}\) | \(\|\theta_{k+1}-\theta_k\|\le tol\) |
| CMA-ES | \(tolx=10^{-12}\), \(tolfun=10^{-12}\) | \(\max_i\sigma_i\le tolx\) na population objective range \(\le tolfun\) |
| Nelder–Mead | \(xatol=10^{-6}\) | \(\|x_{k+1}-x_k\|\le xatol\) |
| PSO | velocity threshold \(10^{-5}\), cluster threshold 1 | Unclustered-particle count na maximum velocity zinaposhuka pamoja chini ya kikomo |
| SLSQP | \(ftol=10^{-10}\) | Muundo uleule wa normalized function-change kama BFGS |
| SPSA | \(N=100\), \(allowed\_increase=10^{-3}\) | Ukaguzi wa stagnation/termination wakati fitted trend slope ya objective value 100 za mwisho ni chanya |
Kigezo cha SPSA slope katika Appendix E
Chanzo kinatumia Equation (18):
\[ \mathrm{slope} = \frac{1}{N} \frac{df_k}{dk} > 0 \tag{18} \]
.
Slope huamuliwa kwa linear regression juu ya objective values \(N=100\) za mwisho.
Pengo la reproducibility: Chanzo kinasema kuwa maximum function-evaluation limit ni ileile kwa optimizers zote; hata hivyo, katika maandishi ya manuscript yaliyopakiwa, thamani ya namba ya maximum hii ya pamoja haijaripotiwa kwa namna inayoonekana. Katika Ukurasa wa 11 pia, idadi ya iteration haipo katika usemi “running up to optimization iterations”. Thamani hii haijakadiriwa na Verianla.
Software stack
| Python library | Toleo |
|---|---|
| qiskit | 1.0.2 |
| qiskit_algorithms | 0.3.1 |
| qiskit_nature | 0.7.2 |
| qiskit_aer | 0.14.2 |
| pyscf | 2.6.0 |
| scipy | 1.15.2 |
| cma | 3.3.0 |
Miundombinu ya kompyuta
Simulations ziliendeshwa kwenye IT4Innovations Barbora supercomputer. Chanzo kinaeleza mfumo kama:
- 192 standard node: 2 × 18-core Intel Xeon na 192 GB RAM kwa kila node,
- 8 GPU node: 2 × 12-core Intel Xeon + 4 × NVIDIA V100,
- 1 fat node: 8 × 16-core Intel Xeon + 6 TB RAM,
- 200 Gb/s Infiniband HDR,
- 310 TB SCRATCH storage na 28 GB/s throughput
.
Runs ziligawanywa kama Slurm jobs kwa mfumo wa job-level embarrassingly parallel. Vikundi vya 5–10 concurrent run vilitumika kwa LiH na H4.
Chanzo kinaripoti total computational consumption ya takriban:
\[ 4500\ \text{node-hour} \]
.
Kwa nini High-shot reevaluation ilifanywa?
Noisy optimizer wakati mwingine inaweza kuchagua candidate parameters zinazoonekana bora sana kuliko zilivyo kweli kwa sababu ya lucky sampling fluctuation. Figure 4–7 captions zinaonyesha kuwa candidate parameters zilizopatikana wakati wa optimization zilitathminiwa tena kwa:
\[ 10^5\ \text{shot} \]
.
High-shot reevaluation si kuendesha optimizer upya. Lengo ni kupima tena nishati ya parameter point ileile kwa sampling variance ndogo zaidi ili kutofautisha kama mafanikio yanayoonekana yanatokana na parameter quality halisi au low-shot fluctuation.
Matokeo ya H2
Katika hali ya statevector isiyo na kelele, H2 ndiyo benchmark rahisi zaidi.
Chanzo kinaripoti:
- errors chini ya takriban \(10^{-13}\)–\(10^{-14}\) Ha kwa BFGS, CMA-ES, COBYLA, Nelder–Mead na PSO,
- takriban \(10^{-6}\) Ha kwa GD + HF,
- takriban \(3\times10^{-5}\) Ha kwa SPSA
.
Katika hali hii, tofauti kuu kati ya mbinu ni convergence speed zaidi kuliko final accuracy.
Kwa high-shot corrected values chini ya sampling noise, chanzo:
| Optimizer / hali | Kosa lililoripotiwa (Ha) |
|---|---|
| GD + HF | 6,6 × 10⁻⁴ |
| SPSA + HF | 4,1 × 10⁻⁴ |
| CMA-ES | 4,5 × 10⁻⁴ |
| COBYLA | 2,4 × 10⁻³ |
| Nelder–Mead + HF | 3,9 × 10⁻³ |
| BFGS | takriban 4 × 10⁻³ |
| PSO random | 6,5 × 10⁻⁴ |
| PSO HF | 1,0 × 10⁻³ |
SLSQP haiku-converge kwa kuaminika hata kwa H2 katika hali ya sampling-noise.
Onyo la mpangilio wa ndani wa chanzo: Maandishi ya chanzo yanasema “lowest corrected mean errors come from GD ... followed by SPSA ... and CMA-ES”. Lakini namba zilizotolewa zikilinganishwa:
\[ 4.1\times10^{-4} < 4.5\times10^{-4} < 6.6\times10^{-4}. \]
Kwa hiyo mpangilio wa ukubwa wa namba ni SPSA, CMA-ES, GD. Verianla haijapanga upya sentensi ya chanzo kwa uamuzi wake na kisha kusema “chanzo kilisema hivyo”; usemi wa maandishi na thamani za namba zote zimehifadhiwa zionekane.
Matokeo ya H4
H4 chain huzalisha Hamiltonian na optimization landscape changamano zaidi.
Katika hali ya statevector chanzo kinaripoti viwango vya kosa vya:
- takriban \(7\times10^{-3}\) Ha kwa BFGS, COBYLA na SLSQP,
- takriban \(2,5\times10^{-2}\) Ha kwa GD
.
Baada ya sampling-noise high-shot reevaluation:
| Optimizer | Corrected mean error iliyoripotiwa (Ha) |
|---|---|
| CMA-ES + HF | 2,25 × 10⁻² |
| PSO | 2,7 × 10⁻² |
| GD | 3,01 × 10⁻² |
| SPSA | takriban katika kiwango cha 3,5–3,8 × 10⁻² |
| COBYLA | takriban katika kiwango cha 3,5–3,8 × 10⁻² |
| BFGS | >4,5 × 10⁻² |
| Nelder–Mead | >4,5 × 10⁻² |
Onyo la mpangilio wa ndani wa chanzo: Maandishi yanaweka mpangilio “GD na PSO” baada ya CMA-ES; hata hivyo, katika namba zilizotolewa, thamani ya PSO ya \(2,7\times10^{-2}\) Ha ni ndogo kuliko thamani ya GD ya \(3,01\times10^{-2}\) Ha.
Matokeo ya LiH full-space
Chanzo kinaeleza kwamba katika hali ya statevector, BFGS, CMA-ES, COBYLA, Nelder–Mead na SPSA zilifikia takriban:
\[ 4\times10^{-3}\ \mathrm{Ha} \]
, huku GD ikibaki karibu \(2\times10^{-2}\) Ha na PSO karibu \(9\times10^{-3}\) Ha.
Katika sentensi ileile, chanzo kinatumia usemi “sub-millihartree precision” kwa kundi la kwanza.
Hata hivyo:
\[ 4\times10^{-3}\ \mathrm{Ha} = 4\ \mathrm{mHa}. \]
“Sub-millihartree” kihisabati humaanisha chini ya 1 mHa, yaani chini ya \(10^{-3}\) Ha. Kwa hiyo maelezo yaliyotumiwa na chanzo na namba ya takriban \(4\times10^{-3}\) Ha iliyotolewa katika sentensi hiyo hiyo havilingani. Verianla haifichi hili kwa kuipa kipaumbele namba.
Sampling noise + high-shot reevaluation:
| Optimizer / hali | Kosa lililoripotiwa |
|---|---|
| CMA-ES + HF | ~8,0 mHa |
| CMA-ES random | ~10,5 mHa |
| PSO + HF | ~13,2 mHa |
| PSO random | ~13,6 mHa |
| SPSA + HF | ~16 mHa |
| GD | ~19 mHa |
| BFGS + HF | ~19,7 mHa |
| BFGS random | ~22,2 mHa |
| COBYLA / Nelder–Mead | kiwango cha takriban 20 mHa |
Full-space LiH ni mojawapo ya mifumo ambapo, katika hali ya larger parameter-space, population-based CMA-ES ilitoa matokeo thabiti zaidi chini ya sampling noise.
Matokeo ya LiH active-space
Active-space reduction hurahisisha tatizo la optimization kwa kiasi kikubwa.
Katika hali ya statevector, CMA-ES, PSO, Nelder–Mead na SPSA hufikia:
\[ <2\times10^{-4}\ \mathrm{Ha} \]
.
BFGS na COBYLA pia ziko karibu \(2\times10^{-4}\) Ha.
Sampling-noise high-shot reevaluation:
| Optimizer / hali | Kosa lililoripotiwa |
|---|---|
| CMA-ES + HF | 2,6 × 10⁻⁴ Ha |
| SPSA | 3,9 × 10⁻⁴ Ha |
| PSO | 4,2 × 10⁻⁴ Ha |
| Nelder–Mead + HF | 5,3 × 10⁻⁴ Ha |
| COBYLA / BFGS | ~8 × 10⁻⁴–1,1 × 10⁻³ Ha |
| GD | mHa chache |
| SLSQP | >3 × 10⁻¹ Ha |
Katika paragrafu ya baadaye ya literature-comparison, chanzo pia kinaripoti \(6,5\times10^{-4}\) Ha na 486 function evaluation kwa SPSA + HF. Katika paragrafu ya matokeo ya high-shot ya Section 6, hata hivyo, kimeandikwa \(3,9\times10^{-4}\) Ha. Chanzo hakielezi wazi kama namba hizi mbili zinatokana na evaluation stage, aggregation au reporting choice tofauti. Kwa hiyo thamani hizo mbili hazijalazimishwa kuunganishwa.
Tofauti kuu kati ya Full LiH na active-space LiH
Chanzo kinaeleza kuwa active-space reduction hupunguza optimizer demand na noise sensitivity kwa takriban order of magnitude moja.
Katika sehemu ya Discussion, kwa COBYLA sampling baada ya active-space truncation:
\[ 95.2\% \]
error reduction imeripotiwa.
Asilimia hii inahusu LiH/COBYLA comparison maalumu; haipaswi kutafsiriwa kama uboreshaji wa jumla wa %95,2 kwa optimizers zote, molekuli zote, au quantum hardware halisi.
Figure 8 inaonyesha nini?
Figure 8 ya chanzo inalinganisha final errors za mifumo minne kwa optimizers zote katika evaluation category sita:
- Random Init Statevector,
- HF Init Statevector,
- Random Init Sampling Noise,
- HF Init Sampling Noise,
- Random-Sampling High-Shot Reevaluation,
- HF-Sampling High-Shot Reevaluation.
Bars zinawakilisha mean final error, huku error bars zikiwakilisha thamani za %95 confidence interval kulingana na caption ya chanzo.
Chanzo hakiripoti bar heights zote za Figure 8 kama numeric table tofauti. Kwa hiyo Verianla haijasoma pikseli kutoka kwenye grafu na kuzalisha namba mpya zenye usahihi wa bandia.
Hitimisho kuu la optimizer katika chanzo linapaswa kufupishwaje?
| Hali | Tabia iliyoangaziwa katika chanzo | Kikomo cha tafsiri |
|---|---|---|
| Mfumo mdogo + statevector | BFGS na deterministic/gradient methods ni za kasi na usahihi wa juu | Hakuna noise; si tabia ya hardware |
| Finite-shot sampling | Gradient/curvature information huharibika | Sampling noise pekee imejaribiwa |
| Parameter space kubwa zaidi | CMA-ES, PSO, SPSA huwa thabiti zaidi | Hakuna mpangilio mmoja universal kwa kila system |
| Active-space LiH | Optimization hurahisishwa na noise sensitivity hupungua | Tatizo si state space ileile na full-space LiH |
| Population mean | Inaweza kukandamiza symmetric sampling noise vizuri zaidi kuliko Best-value selection | Si dhamana ya global optimum |
Matokeo yanayoungwa mkono na utafiti
- Optimizer ranking inategemea sana uwepo wa sampling noise.
- Katika mifumo midogo isiyo na kelele, mbinu za gradient/quasi-Newton zinaweza kuwa na ufanisi mkubwa.
- Finite-shot sampling inaweza kuharibu gradient na curvature estimates.
- SLSQP imeonyesha divergence kubwa katika hali za tested sampling-noise.
- BFGS imepoteza kwa kiasi kikubwa faida yake kubwa katika hali noiseless chini ya sampling noise.
- CMA-ES, PSO na SPSA zimekuwa thabiti zaidi katika larger/noisy benchmarks.
- Hartree–Fock initialization husaidia mara nyingi katika mifumo midogo lakini faida yake hupungua kadiri complexity inavyoongezeka.
- Random initialization inaweza kuwa sawa au bora kuliko HF kwa baadhi ya population-based methods.
- Active-space reduction imeboresha optimization na noise robustness kwa kiasi kikubwa katika LiH.
- Finite-shot energy estimates zinaweza kuonekana chini ya exact ground-state lower bound.
- High-shot reevaluation imeonyesha kuwa baadhi ya matokeo “mazuri” ya low-shot ni sampling artifact.
- Population mean inaweza kupunguza hatari ya noise-overfitting ikilinganishwa na single best candidate selection.
Matokeo ambayo utafiti hauungi mkono
- Utafiti haujafanya benchmark ya optimizers nane kwenye quantum computer halisi.
- Haijaonyeshwa kuwa CMA-ES ndiyo optimizer bora kabisa katika matatizo yote ya VQE.
- Haijaonyeshwa kuwa sampling noise huzalisha kimwili quantum states halisi zenye nishati ya chini kuliko ground-state energy.
- Variational principle haijakanushwa kwa exact expectation values.
- Gate infidelity, coherent error, depolarizing noise, amplitude damping, thermal relaxation au readout error hazijafanyiwa benchmark.
- Haijathibitishwa kuwa mpangilio wa optimizer utabaki uleule chini ya hardware noise halisi.
- Quantum computational speedup au quantum advantage haijaonyeshwa.
- Matokeo ya STO-3G na molecular systems ndogo zilizochunguzwa hayawezi kujumlishwa kiotomatiki kwa mifumo mikubwa ya kemia.
- Haijaonyeshwa kuwa utendaji utaendelea kuboreka bila kikomo kadiri population size inavyoongezeka.
- Mapendekezo ya optimizer kama “hardware inafaa” katika Source Table 2 si matokeo ya moja kwa moja ya hardware benchmark.
Vikwazo vikuu vya utafiti
Chanzo na mbinu vinapotathminiwa pamoja, vikwazo vikuu ni:
- Quantum circuits ziliigwa kwenye kompyuta ya kawaida/HPC.
- Main noisy condition ni finite-shot sampling noise pekee.
- Real-device gate/readout/calibration noise haijajumuishwa.
- STO-3G minimal basis imetumika.
- Molecular systems zilizochunguzwa zimezuiliwa kwa H2, H4 na LiH.
- Random seeds hazijawekwa thabiti.
- Optimizer hyperparameters zote hazikufanyiwa molecule-specific tuning.
- Thamani ya numeric ya common maximum function-evaluation haijaripotiwa kwa namna inayoonekana katika maandishi ya manuscript.
- Bar values zote za Figure 8 hazijatolewa kama numeric table.
- tVHA truncation inaweza kuunda reachability deficit wakati inapunguza circuit depth.
- CMA-ES steady-state stability si dhamana ya global optimum.
Mwelekeo wa kazi ya baadaye
Waandishi wanapendekeza katika siku zijazo kuchunguza:
- noise-adaptive switching kati ya fast gradient search na population methods,
- dynamic shot allocation kulingana na measured noise floor,
- noise-aware stopping rules,
- thermal relaxation,
- amplitude damping,
- readout assignment errors,
- hardware-backed calibration
pamoja na noise conditions za hali halisi zaidi na hybrid optimization strategies.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Numerical Optimization Strategies for the Variational Hamiltonian Ansatz in Noisy Quantum Environments
Waandishi: Silvie Illésová; Vojtěch Novák; Tomáš Bezděk; Clemens Possel; Martin Beseda.
Mpangilio wa waandishi: Mpangilio wa chanzo umehifadhiwa.
Mchango sawa: Hakuna taarifa wazi ya equal-contribution/equal-first-author inayoonekana katika v4 PDF iliyopakiwa.
Corresponding author: Martin Beseda.
Barua pepe ya corresponding-author: martin.beseda@univaq.it
Taasisi 1: Gran Sasso Science Institute, L’Aquila, Italy.
Taasisi 2: Department of Applied Mathematics, Faculty of Electrical Engineering and Computer Science, VSB-Technical University of Ostrava, Ostrava, Czech Republic.
Taasisi 3: IT4Innovations National Supercomputing Center, VSB–Technical University of Ostrava, Ostrava, Czech Republic.
Taasisi 4: Department of Computer Science, Faculty of Electrical Engineering and Computer Science, VSB–Technical University of Ostrava, Ostrava, Czech Republic.
Taasisi 5: Department of Mathematics, TUM School of Computation, Information and Technology, Technical University of Munich, Garching bei München, Germany.
Taasisi 6: Fraunhofer Institute for Chemical Technology ICT, Pfinztal, Germany.
Taasisi 7: Department of Physics, Saarland University, Saarbrücken, Germany.
Taasisi 8: Department of Information Engineering, Computer Science and Mathematics, University of L’Aquila, L’Aquila, Italy.
Jukwaa: arXiv.
arXiv: arXiv:2505.22398v4 [quant-ph].
Uwasilishaji wa kwanza wa arXiv: 28 Mei 2025.
Toleo lililopakiwa: v4, 22 Januari 2026.
DOI: 10.48550/arXiv.2505.22398.
Kiungo rasmi: https://arxiv.org/abs/2505.22398
Aina ya chanzo: Preprint/manuscript ya kinadharia/ya kihesabu ya quantum-chemistry na numerical-optimization.
Hali ya peer review: Chanzo kilichopakiwa ni toleo la arXiv preprint. PDF inatumia IOP Publishing manuscript template; hata hivyo Journal Name, volume/year/article-number na received/revised dates ziko katika hali ya placeholder. Katika ukaguzi huu, hakuna rekodi iliyothibitishwa ya mwisho ya peer-reviewed journal publication kwa exact title iliyotambuliwa, kwa hiyo makala haijawasilishwa kama final publication iliyopitiwa na wataalamu.
Dokezo la kiolezo cha IOP: PDF ina placeholders kama “Journal vv (yyyy) aaaaaa”, “Journal Name”, “dd Month yyyy”. Hizi hazikutumika kama journal metadata halisi ya bibliografia.
Dokezo la utambulisho wa faili: Ingawa jina la faili iliyopakiwa lina usemi wenye umbo la Research Square DOI, utambulisho wa ndani wa PDF ni arXiv:2505.22398v4 na PDF metadata DOI ni 10.48550/arXiv.2505.22398. Kwa kuwa rekodi ya Research Square haikuthibitishwa kando kutoka ukurasa rasmi wa kuaminika katika ukaguzi huu, haikutumika kama DOI kuu.
Leseni: PDF metadata inaonyesha leseni ya Creative Commons Attribution 4.0 International (CC BY 4.0).
Maneno muhimu: Variational Quantum Eigensolver; Noisy optimization; CMA-ES; Truncated Variational Hamiltonian Ansatz; Quantum chemistry.
Aina ya utafiti: quantum-circuit simulation na optimizer benchmarking kwenye Classical HPC.
Quantum hardware halisi: Haikutumika.
Muundo mkuu wa noise: Finite-shot sampling noise.
Aina za noise ambazo hazikujumuishwa: coherent/stochastic gate errors, thermal relaxation, amplitude damping na readout bias hazikujumuishwa katika benchmark kuu.
Mifumo ya molekuli: H₂, linear H₄ chain, LiH full space, LiH active space.
Basis: STO-3G.
Hamiltonian mapping: Jordan–Wigner.
tVHA truncation: \(p=0.999\), yaani kulingana na tafsiri ya chanzo cumulative %99,9 ya non-Coulomb two-body interaction strength huhifadhiwa.
Sampling budget kuu: 6144 shot / function evaluation.
Landscape reference sampling: \(N_{\mathrm{shots}}\ge10^6\).
High-shot reevaluation: katika Figure 4–7, \(10^5\) shot.
Idadi ya independent run: 1280.
Random seeds: Hazikuwekwa thabiti.
Optimizer tuning: Chanzo kinaeleza kuwa implementation defaults zinazotumika kwa kawaida zilitumiwa badala ya case-by-case hyperparameter optimization; stopping tolerances tofauti zimeripotiwa katika Appendix E.
Miundombinu ya kompyuta: Barbora supercomputer, Bull Sequana X cluster; jumla ya takriban 4500 node-hour.
Programu: Qiskit 1.0.2; qiskit_algorithms 0.3.1; qiskit_nature 0.7.2; qiskit_aer 0.14.2; PySCF 2.6.0; SciPy 1.15.2; cma 3.3.0.
Data Availability: Matokeo yaliyokokotolewa na scripts zilizoyazalisha yameshirikiwa public kwenye Zenodo.
Zenodo DOI: 10.5281/zenodo.15526170.
Conflict of Interest: Waandishi wanatangaza kuwa hakuna competing financial interests au personal relationships zinazojulikana.
Ethical Statement: Ethical approval haikuhitajika kwa sababu hakukuwa na Human participants, human data au animal experimentation.
Funding / msaada: Clemens Possel aliungwa mkono na Baden-Württemberg Ministry of Economic Affairs, Labour and Tourism kupitia miradi ya QC-4-BW, QC-4-BW II na KQCBW24. Tomáš Bezděk alipokea msaada wa SGS No. SP2025/049, na Vojtěch Novák SGS No. SP2025/072. Utafiti pia uliungwa mkono na Czech Ministry of Education, Youth and Sports kupitia e-INFRA CZ ID:90254.
Michango ya waandishi: Chanzo hakina CRediT author-contribution breakdown tofauti.
Takwimu: Kwa kila configuration, 10 independent run zilifanywa. Figure 8 inaonyesha mean final errors na %95 confidence intervals. Chanzo hakijaripoti jedwali pana la formal p-value significance-testing kwa jozi za optimizer.
Dokezo la uandishi wa Equation (2): Katika Coulomb term, jumla imeandikwa \(\sum_{ij}\), ilhali coefficient \(g_{ijk\ell}\) ina indeksi nne. Chanzo hakielezi uandishi huu zaidi; Verianla haijabadilisha indeksi za mlinganyo kwa makisio.
Dokezo la mpangilio wa matokeo ya H₂: Chanzo kinaandika GD + HF \(6,6\times10^{-4}\) Ha kwanza kama “lowest”, lakini kinaripoti numeric values ndogo zaidi za SPSA + HF \(4,1\times10^{-4}\) Ha na CMA-ES \(4,5\times10^{-4}\) Ha.
Dokezo la mpangilio wa H₄: Maandishi yanatumia mpangilio wa GD kisha PSO baada ya CMA-ES, lakini thamani iliyotolewa ya PSO ni \(2,7\times10^{-2}\) Ha na ya GD ni \(3,01\times10^{-2}\) Ha.
Dokezo la LiH unit-language: Aya ya Full-space statevector inaelezea thamani za takriban \(4\times10^{-3}\) Ha kama “sub-millihartree”; kwa kuwa \(4\times10^{-3}\) Ha = 4 mHa, namba na maelezo hayo hayalingani.
Dokezo la uainishaji wa SLSQP: Katika Introduction inatajwa katika muktadha wa derivative-free methods, huku Appendix A na Table 3 ikiifafanua kama gradient-based constrained optimizer.
Dokezo la SPSA active-space: Main result paragraph inatoa high-shot result ya \(3,9\times10^{-4}\) Ha, huku literature-comparison paragraph ya baadaye ikitoa \(6,5\times10^{-4}\) Ha na 486 function evaluations. Chanzo hakielezi tofauti hiyo kwa undani.
Dokezo la Maximum function-evaluation: Inaelezwa kuwa maximum limit ileile ilitumika kwa optimizers zote, lakini kiwango hicho cha juu cha pamoja kwa namba hakionekani wazi katika manuscript text iliyopakiwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *