


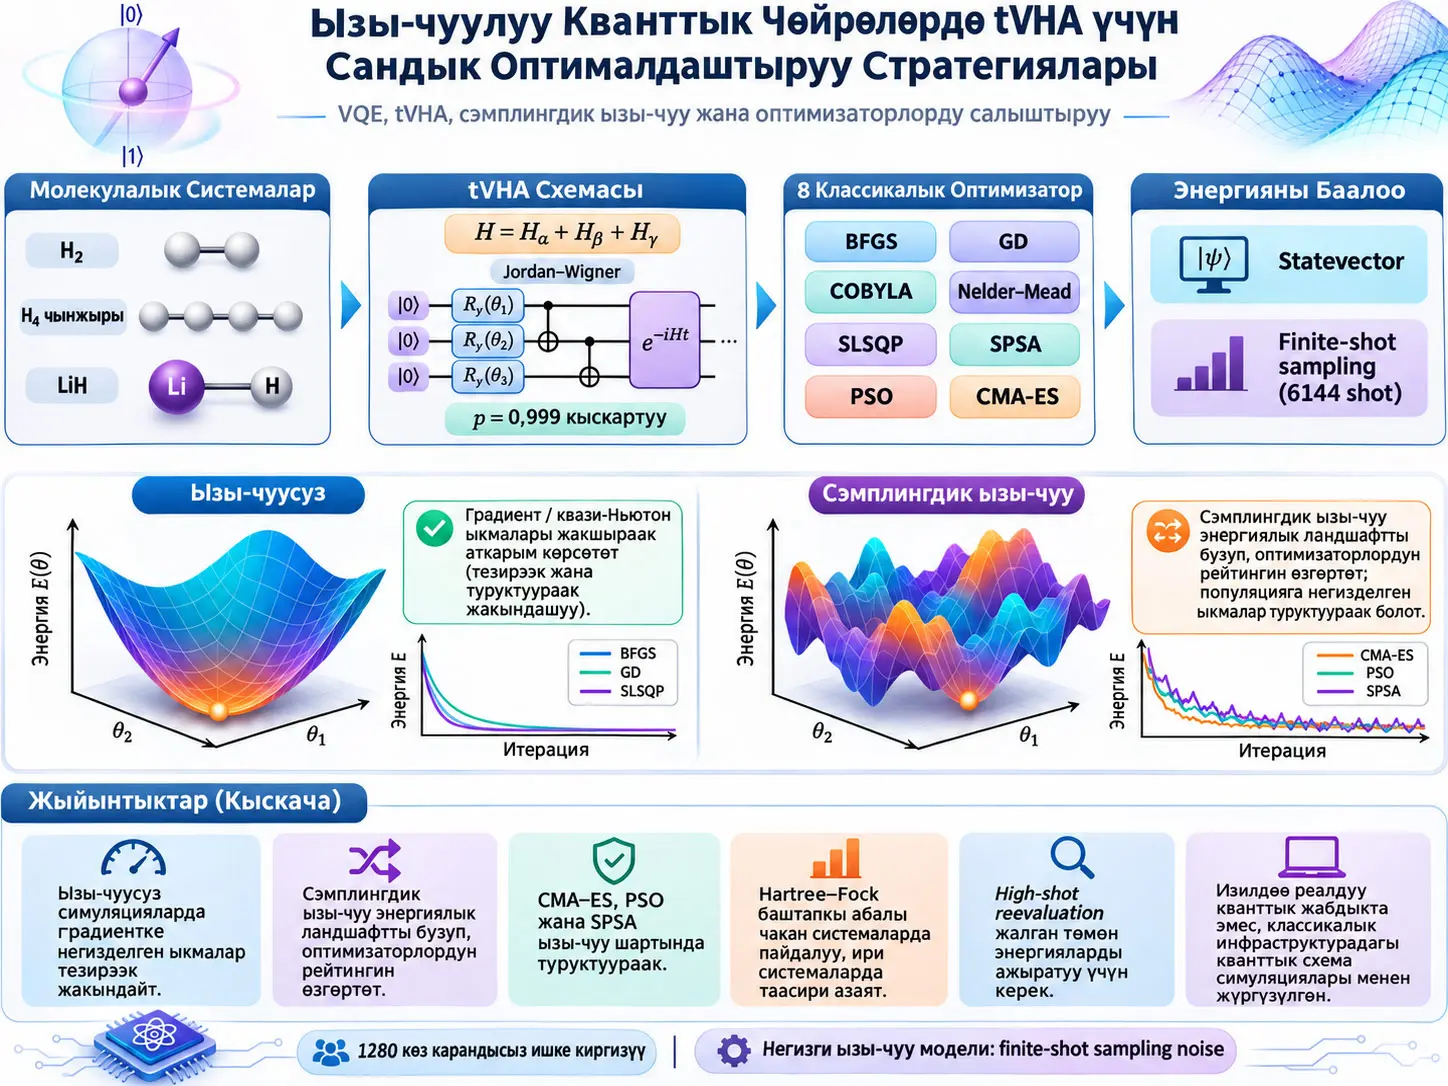
Truncated Variational Hamiltonian Ansatz (tVHA) — молекулалык электрондук Гамильтониандын физикалык түзүлүшүнөн алынган, параметрленген кванттык схеманы башкарууга ыңгайлуураак кылуу үчүн өзгөчө non-Coulomb эки-денелүү мүчөлөрдү көзөмөлдөнгөн түрдө кыскарткан, химиялык жактан түзүмдөлгөн вариациялык кванттык ansatz. Бул изилдөө tVHA негизиндеги Variational Quantum Eigensolver (VQE) эсептөөлөрүндө сегиз классикалык оптималдаштыруу алгоритминин жүрүм-турумун H2, сызыктуу H4 чынжыры жана LiHнин full-space жана active-space көрсөтүлүштөрүндө салыштырат. Изилдөө чыныгы кванттык жабдыкта жүргүзүлгөн эмес; quantum circuits классикалык жогорку өндүрүмдүү эсептөө инфраструктурасында Qiskit аркылуу симуляцияланган. Ошондуктан бул жерде өлчөнгөн “ызы-чууга туруктуулук” биринчи кезекте finite-shot sampling noise шартындагы симуляциянын көрсөткүчү болуп саналат.
Салыштырылган сегиз optimizer: BFGS, Covariance Matrix Adaptation Evolution Strategy (CMA-ES), COBYLA, Gradient Descent (GD), Nelder–Mead, Particle Swarm Optimization (PSO), Sequential Least Squares Programming (SLSQP) жана Simultaneous Perturbation Stochastic Approximation (SPSA). Ар бир molecule–optimizer жуптугу төрт сценарийде сыналган: Hartree–Fock баштапкы абалы + statevector, Hartree–Fock баштапкы абалы + finite-shot sampling, random баштапкы абал + statevector жана random баштапкы абал + finite-shot sampling. Ар бир сценарий үчүн 10 көз карандысыз иштетүү аткарылып, жалпы:
\[ 4\ \text{moleküler temsil} \times 8\ \text{optimizer} \times 4\ \text{senaryo} \times 10\ \text{koşu} = 1280 \]
көз карандысыз simulation алынган.
Негизги noisy benchmark-та ар бир function evaluation үчүн 6144 shot колдонулган. Exact reference үчүн Qiskit StatevectorEstimator, finite-shot эсептөөлөр үчүн Qiskit Aer Estimator колдонулган. Aer Estimator Born эрежеси боюнча үлгүлөгөндүктөн, measured expectation values finite sample variance камтыйт. Изилдөөнүн негизги тыянагы — sampling noise жыйынтыктарга жөн гана аз ката кошпостон, cost landscape формасын, көрүнгөн минимумдарды, gradient directions-ды жана натыйжада optimizer рейтингин өзгөртөт.
Ызы-чуусуз statevector шарттарында, айрыкча кичине H2 системасы үчүн BFGS жана башка детерминисттик ыкмалар өтө тез жана так жакындашса, finite-shot sampling noise шартында бул артыкчылык негизинен жоголот. Молекулалык жана параметр мейкиндиги татаалдашкан сайын CMA-ES, PSO жана SPSA сыяктуу population-based же stochastic ыкмалар туруктуураак боло баштайт. Full-space LiH noisy benchmark-та high-shot reevaluation жүргүзүлгөндөн кийин CMA-ES булакта болжол менен \(8\times10^{-3}\) Ha ката менен эң жакшы жыйынтык берген, ал эми active-space LiHде CMA-ES \(2.6\times10^{-4}\) Ha, SPSA \(3.9\times10^{-4}\) Ha жана PSO \(4.2\times10^{-4}\) Ha деңгээлине жеткен.
Изилдөөнүн эң маанилүү физикалык чечмелөө чеги variational principle менен байланыштуу. Exact expectation value үчүн:
\[ E(\boldsymbol{\theta})\ge E_0 \]
бойдон калат. Finite-shot эсептөөдө мындан төмөн көрүнүшү мүмкүн болгон маани:
\[ \hat E(\boldsymbol{\theta})
түрүндөгү статистикалык энергия баалоосу. Бул чыныгы физикалык quantum state негизги абалдын энергиясынан төмөн энергияга ээ дегенди билдирбейт. Sampling fluctuation өлчөнгөн estimator-ду убактылуу төмөн тартышы мүмкүн.
Изилдөөнүн жыйынтыктары чыныгы quantum hardware иштешин түздөн-түз ырастабайт. Benchmark coherent gate errors, stochastic gate errors, amplitude damping, thermal relaxation же readout-assignment bias камтыбайт. Авторлор да future work алкагында бул реалдуу hardware noise channels өзүнчө текшерилиши керек экенин белгилешет.
tVHA Деген Эмне жана VQE Ичинде Эмне Кылат?
Truncated Variational Hamiltonian Ansatz — молекулалык Гамильтониандын бир-электрондук, Coulomb эки-электрондук жана non-Coulomb эки-электрондук компоненттерин түздөн-түз параметрленген quantum evolution блокторуна айландырган жана схеманын татаалдыгын азайтуу үчүн non-Coulomb салымдардын бир бөлүгүн маанилүүлүгү боюнча кескен, химиялык жактан түзүмдөлгөн ansatz; VQE ичиндеги милдети — негизги абалдын энергиясын издеген classical optimizer жөндөй турган quantum state үй-бүлөсүн аныктоо.
VQE эмне үчүн кванттык да, классикалык да алгоритм?
Variational Quantum Eigensolver — hybrid quantum–classical ыкма. Quantum бөлүгү параметрленген абалды:
\[ |\psi(\boldsymbol{\theta})\rangle \]
даярдайт жана Гамильтониандын expectation value маанисин өлчөйт:
\[ E(\boldsymbol{\theta}) = \langle\psi(\boldsymbol{\theta})| H |\psi(\boldsymbol{\theta})\rangle. \]
Classical optimizer болсо \(\boldsymbol{\theta}\) параметрлерин өзгөртүү аркылуу бул энергияны азайтууга аракет кылат.
Демек optimizer көргөн objective function — кванттык схема чыгарган энергия баалоосу. Бул баалоо ызы-чуулуу болгондо optimizer туура эмес gradient, туура эмес curvature же убактылуу false minimum көрүшү мүмкүн.
Ansatz деген эмне?
Ansatz — VQE издөө жүргүзө турган параметрленген quantum-state үй-бүлөсү. Жакшы ansatz эки карама-каршы муктаждыкты тең салмакташы керек:
- Чыныгы молекулалык ground state-ке жетишерлик жакындай ала тургандай expressive болушу керек.
- NISQ шарттарында иштетүүгө мүмкүн болушу үчүн параметрлери аз жана схеманын тереңдиги төмөн болушу керек.
Өтө алсыз ansatz ground state-ке жете албайт. Өтө татаал ansatz болсо схеманын тереңдигин, өлчөө чыгымын жана оптималдаштыруу кыйынчылыгын жогорулатышы мүмкүн.
Молекулалык Гамильтониан кантип бөлүнөт?
Булак tVHA түзүлүшүн алгач:
\[ H=H_{\alpha}+H_{\beta}+H_{\gamma} \tag{1} \]
түрүндө аныктайт.
Бул жерде:
- \(H_{\alpha}\): one-body мүчөлөрүн,
- \(H_{\beta}\): Coulomb two-body мүчөлөрүн,
- \(H_{\gamma}\): non-Coulomb two-body мүчөлөрүн
билдирет.
Булак Теңдеме (2)ни төмөнкүдөй берет:
\[ H= \sum_{ij} h_{ij}a_i^{\dagger}a_j + \frac{1}{2} \sum_{ij} g_{ijk\ell} a_i^{\dagger}a_j^{\dagger}a_ja_i + \frac{1}{2} \sum_{\substack{ijk\ell\\i\neq k\\j\neq\ell}} g_{ijk\ell} a_i^{\dagger}a_j^{\dagger}a_ka_{\ell}. \tag{2} \]
\(a_i^\dagger\) — fermionic creation operator, \(a_j\) — annihilation operator. \(h_{ij}\) one-electron integrals үчүн, ал эми \(g_{ijk\ell}\) two-electron interaction coefficients үчүн символдук көрсөтмө болуп саналат.
Булактагы нотация боюнча эскертүү: Теңдеме (2)нин Coulomb мүчөсүндө суммалоо белгиси \(i,j\) боюнча гана жазылганы менен coefficient \(g_{ijk\ell}\) төрт индекс алып жүрөт. Булак бул жерде \(k,\ell\) индекстерин өзүнчө түшүндүрбөйт. Ошондуктан Verianla теңдемени кеңири колдонулган индекс түзүлүшүнө үнсүз өзгөрткөн эмес, булактагы көрсөтүлүшүн сактаган.
tVHAдагы truncation threshold эмнени билдирет?
Non-Coulomb two-body terms маанилүүлүгүнүн чоңдугу боюнча иреттелгенден кийин булак Теңдеме (3)тө cumulative truncation fraction-ды:
\[ p= \frac{1} {\sum_s |g_s^{\gamma}|} \sum_{s=1}^{s_{\mathrm{cut}}} |g_s^{\gamma}| \tag{3} \]
деп аныктайт.
Бул жерде:
- \(g_s^\gamma\): non-Coulomb two-body coefficient,
- \(s\): төрт fermionic index бир иреттүү индекске топтолгон форма,
- \(s_{\mathrm{cut}}\): сакталган terms үчүн cutoff,
- \(p\): сакталган cumulative interaction weight fraction.
Бул benchmark-та:
\[ p=0.999 \]
колдонулган.
Башкача айтканда, булактагы аныктама боюнча non-Coulomb two-body interaction strengthтин жыйынды чоңдугунун %99,9 бөлүгүн түзгөн terms сакталууга аракет кылынган, ал эми майда салымдар схеманын татаалдыгын азайтуу үчүн кыскартылган.
Бул truncation акысыз эмес. Азыраак operator тайызыраак circuit түзүүгө жардам бериши мүмкүн; бирок ansatz жетише ала турган state spaceти тарытып, reachability deficit жаратышы мүмкүн. Мындай учурда optimizer кемчиликсиз иштесе да ansatz чыныгы full-configuration-interaction ground state-ке толук жете албай калышы мүмкүн.
Fermionic Гамильтониан эмне үчүн qubit operatorлерине айландырылат?
Электрондор fermion болгондуктан electronic Hamiltonian creation/annihilation operators менен жазылат. Gate-model quantum circuit болсо qubit жана Pauli operators менен иштейт. Изилдөөдө fermionic Hamiltonian:
\[ H_{\alpha} = \sum_{\alpha}c_{\alpha}P_{\alpha}, \qquad H_{\beta} = \sum_{\beta}c_{\beta}P_{\beta}, \qquad H_{\gamma} = \sum_{\gamma}c_{\gamma}P_{\gamma} \]
түрүндөгү Pauli-term түзүлүштөрүнө Jordan–Wigner transformation аркылуу айландырылат.
Булак Bravyi–Kitaev transformation да принципте мүмкүн экенин, бирок Jordan–Wigner mapping ар бир qubit stateти spin-orbital occupation number катары түзүрөөк чечмелөөгө мүмкүндүк берерин белгилейт.
Commuting Pauli groups эмне үчүн колдонулат?
Бири-бири менен commute кылган Pauli terms бир measurement context ичинде чогуу каралышы мүмкүн. Булак Pauli termsти graph coloring аркылуу commuting groupsка бөлүп, ушундай жол менен өлчөө жүгүн азайтууну максат кылат.
Үч Hamiltonian fragment үчүн commuting-set families:
\[ \mathcal{G}^{\alpha}, \qquad \mathcal{G}^{\beta}, \qquad \mathcal{G}^{\gamma} \]
түрүндө көрсөтүлөт.
tVHA unitary өзгөртүүсү кантип курулат?
Булак Теңдеме (4):
\[ U(\boldsymbol{\alpha},\boldsymbol{\beta},\boldsymbol{\gamma}) = \prod_{d=1}^{D} \left[ \prod_{G\in\mathcal{G}^{\alpha}} e^{i\alpha_d c_{\alpha,G}P_{\alpha}} \right] \left[ \prod_{G\in\mathcal{G}^{\beta}} e^{i\beta_d c_{\beta,G}P_{\beta}} \right] \left[ \prod_{G\in\mathcal{G}^{\gamma}} e^{i\gamma_d c_{\gamma,G}P_{\gamma}} \right]. \tag{4} \]
Бул жерде:
- \(D\): discretization/Trotter-step саны жана ошондуктан circuit depth менен байланышкан параметр,
- \(\alpha_d,\beta_d,\gamma_d\): classical optimizer өзгөрткөн variational parameters,
- \(c_{\alpha,G},c_{\beta,G},c_{\gamma,G}\): Pauli-group coefficients,
- \(P\): тиешелүү Pauli operator,
- \(\mathcal G\): commuting groups.
Non-commuting Hamiltonian бөлүктөрүнүн exponential evolution процесси биринчи тартиптеги Suzuki–Trotter, башкача айтканда Lie–Trotter expansion аркылуу жакындатылып аткарылат.
Булак H2 үчүн кандай quantum circuit мисалын берет?
Булак Figure 1де H2 ground-state маселеси үчүн толугу менен decomposed, 4-qubit жана 3 trainable-parameter tVHA circuit мисалын көрсөтөт.
| Gate | Саны |
|---|---|
| CX | 48 |
| H | 32 |
| \(\sqrt{X}\) | 16 |
| RZ | 16 |
| \(\sqrt{X}^{\dagger}\) | 16 |
| RZZ | 6 |
| U3 | 2 |
Бул gate count булакта көрсөтүлгөн H2 circuit мисалына гана тиешелүү; башка молекулалар үчүн ошол эле gate сандарын кабыл алуу туура эмес.
Hartree–Fock initialization кантип түзүлөт?
Булак adiabatic state preparation идеясына негизделген баштапкы абалды:
\[ U_{\mathrm{ad}} = \prod_{d=1}^{D} e^{-i\frac{\tau}{D}H_0} e^{-i\frac{\tau}{D}\frac{d}{D}V} \tag{5} \]
түрүндө берет.
Бул жерде:
- \(H_0\): non-interacting Hamiltonian component,
- \(V\): interacting component,
- \(\tau\): effective adiabatic-evolution parameter,
- \(d/D\): кадам илгерилеген сайын interaction үчүн өсүүчү fractional weight,
- \(D\): discretization step саны.
Булак \(H_{\beta}\) жана \(H_{\gamma}\) үчүн баштапкы параметрлерди:
\[ \beta_d^{(0)} = \gamma_d^{(0)} = \frac{\tau}{D} \langle V\rangle_{\mathrm{HF}} \frac{d}{D} \]
түрүндө берет.
\(H_{\alpha}\) баштапкы параметри тууралуу булактагы сүйлөмдө \(\alpha_d^{(0)}\), \(\tau/D\) жана \(\langle H_\alpha\rangle_{\mathrm{HF}}\) чогуу жазылган; бирок жарыяланган PDF текстинин бул бөлүгүндө ачык барабардык белгиси көрүнбөйт. Ошондуктан жетишпей жаткандай көрүнгөн символдук байланыш Verianla тарабынан болжол менен толукталган эмес.
Random initialization болсо:
\[ \theta_i^{(0)} \sim \mathcal U(0,1) \]
uniform distribution менен жүргүзүлгөн.
Finite-Shot Sampling Noise Энергия Ландшафтын Эмне Үчүн Бузат?
Finite-shot sampling noise expectation value чексиз өлчөө орточосунун ордуна чектелген сандагы quantum measurement outcome аркылуу баалангандыктан энергия баалоосуна кокустук ката кошот; чыныгы gradient кичине болгондо бул ката gradientти жашырып, карама-каршы багытты көрсөтүп, жылмакай өрөөндөрдү жасалма түрдө бүртүктүү кылып жана optimizerге чындыгында жок минимумдарды көрсөтүшү мүмкүн.
Statevector менен shot-based simulation ортосундагы айырма
StatevectorEstimator quantum state amplitudes аркылуу expectation value маанисин детерминисттик эсептейт. Finite-shot sampling variance жок.
Aer Estimator болсо measurement outcomesту Born эрежесине ылайык үлгүлөйт. Shot саны чектелүү болсо, бир эле parameter point кайра өлчөнгөндө ошол эле estimated energy чыгышы милдеттүү эмес.
Булак негизги benchmark үчүн:
\[ N_{\mathrm{shots}}=6144 \]
колдонгон.
Sampling variance жалпысынан:
\[ \sigma^2\propto\frac{1}{N_{\mathrm{shots}}} \]
масштабында азаят.
Ошондуктан standard deviation болжол менен:
\[ \sigma\propto\frac{1}{\sqrt{N_{\mathrm{shots}}}} \]
жүрүм-турумун көрсөтөт. Башка шарттар бирдей болсо, shot санын төрт эсе көбөйтүү standard deviationды болжол менен эки эсе азайткан square-root scaling менен шайкеш келет.
Energy-landscape slicing кантип жүргүзүлгөн?
Авторлор адегенде жогорку тактыктагы sampling аркылуу:
\[ N_{\mathrm{shots}}\ge10^6 \]
шартында reference parameter set:
\[ \boldsymbol{\theta}^{\ast} \]
алышкан.
Андан кийин тандалган эки parameter direction үчүн:
\[ \delta_i,\delta_j\in[-\Delta,\Delta] \]
grid боюнча энергия кайра эсептелип, башка parameters оптималдуу reference valuesда туруктуу кармалган.
Ошентип, бир эле негизги energy surface ар башка shot counts шартында optimizer тарабынан кандай “көрүнөрү” салыштырылган.
Булакта байкалган үч негизги landscape бузулуусу
Булактагы Figure 2нин негизги билдирүүсүн үч механизм менен жыйынтыктоого болот:
- False minima: finite-shot fluctuations чыныгы бетте жок жергиликтүү төмөн аймактарды жаратышы мүмкүн.
- Gradient reversal: noisy slope чыныгы slopeка карама-каршы багытты көрсөтүшү мүмкүн.
- Noise-induced ruggedness: өзгөчө quasi-degenerate же flat valley түбүндө кичине чыныгы gradient sampling fluctuations тарабынан басылып калат.
Мындай шарттарда optimizer deterministic descent ордуна parameter space ичинде stochastic drift же random-walk сыяктуу кыймыл көрсөтүшү мүмкүн.
Barren plateau деген эмне?
Barren plateau — parameterized quantum circuitтин cost-function gradientтери система чоңойгон сайын өтө кичине болуп, optimizer үчүн маанилүү descent direction табуу кыйын болгон жалпак optimization landscape режими.
Булак теориялык контекстти:
\[ \ell_{\theta} = \langle\rho(\theta),O\rangle, \qquad \rho(\theta)\in\mathcal B(\mathcal H) \tag{6} \]
жана:
\[ \operatorname{Var}_{\theta}(\ell_{\theta}) \in \mathcal O\left(\frac{1}{4^n}\right) \tag{7} \]
туюнтмалары менен түшүндүрөт.
Бул жерде:
- \(\rho(\theta)\): parameterized quantum state/operator representation,
- \(O\): observable,
- \(\ell_\theta\): observable expectationтан алынган loss,
- \(n\): qubit саны.
Hilbert-space dimension:
\[ \dim\mathcal H=2^n \]
жана operator-space dimension:
\[ \dim\mathcal B(\mathcal H)=4^n \]
түрүндө өсөт.
Булак 12-qubit LiH мисалы үчүн:
\[ 4^{12}=16\,777\,216\approx1.6\times10^7 \]
operator-space dimension чоңдугун баса белгилейт.
Теңдеме (6)–(7) бул benchmarkта өлчөнгөн жаңы empirical scaling жыйынтыгы эмес, sampling noise менен barren-plateau көйгөйү чогуу эмне үчүн олуттуу болушу мүмкүн экенин түшүндүргөн теориялык алкак.
Вариациялык Принцип Finite-Shot Өлчөөдө Чындап Бузулабы?
Exact quantum expectation value вариациялык төмөнкү чекти бузбайт; \(E(\theta)\ge E_0\) бойдон калат, бирок finite-shot measurementтан эсептелген кокустук estimator \(\hat E\) чыныгы expectationдын айланасында таралгандыктан, айрым үлгүлөрдө \(E_0\) төмөн көрүнүшү мүмкүн жана булак “variational-bound violation” деген сөз айкашын ушул көрүнгөн статистикалык бузулуу үчүн колдонот.
Exact энергия менен estimated энергия бир нерсе эмес
Вариациялык принцип:
\[ E(\boldsymbol{\theta}) = \langle\psi(\boldsymbol{\theta})| H |\psi(\boldsymbol{\theta})\rangle \ge E_0 \]
дейт.
\(E_0\) — exact ground-state energy.
Finite-shot өлчөөдө optimizer көргөн нерсе болсо:
\[ \hat E = E+\text{sampling fluctuation} \]
түрүндөгү stochastic estimator.
Эгер чыныгы variational energy ground stateке ансыз да абдан жакын болсо, терс sampling fluctuation калган energy gapтан чоң болушу мүмкүн. Анда:
\[ \hat E
көрүнүшү мүмкүн.
Бул “андан төмөн физикалык ground state табылды” дегенди билдирбейт.
Sampling noise математикалык жактан кантип моделделет?
Булак Теңдеме (8):
\[ \bar C(\boldsymbol{\theta}) = C(\boldsymbol{\theta}) + \epsilon_{\mathrm{sampling}} \tag{8} \]
түрүндө.
Бул жерде:
- \(C(\theta)\): чыныгы expectation-based objective,
- \(\bar C(\theta)\): finite-shot noisy estimate,
- \(\epsilon_{\mathrm{sampling}}\): mean нөл деп кабыл алынган sampling error.
Булак:
\[ \operatorname{Var} (\epsilon_{\mathrm{sampling}}) = \frac{\operatorname{Var}[C(\theta)]} {N_{\mathrm{shots}}} \]
байланышын колдонот.
Hamiltonian variance кантип эсептелет?
\[ \hat H = \sum_k c_kP_k \]
үчүн булак Теңдеме (9):
\[ \operatorname{Var}[C(\theta)] = \langle\hat H^2\rangle - \langle\hat H\rangle^2. \tag{9} \]
Бул observableдын экинчи моменти менен expectation value квадратынын айырмасы.
Булак ошондой эле Pauli-term shot noiseко кошумча ошол эле commuting measurement groups ичиндеги covariance contributions estimator varianceга салым кошорун белгилейт.
Sampling noise floor кантип аныкталат?
Булак optimization trajectory боюнча effective noise floorду:
\[ \sigma_{\mathrm{noise}} \approx \sqrt{ \frac{1}{N} \sum_{i=1}^{N} \frac{ \operatorname{Var}[C(\theta_i)] }{ N_{\mathrm{shots}} } } \tag{10} \]
деп баалайт.
Бул жерде \(N\) — trajectory боюнча бааланган чекиттердин саны.
Noise floorго жакындаганда optimizerдин төмөнүрөөк observed energy табышы сөзсүз жакшыраак parameters тапты дегенди билдирбейт; measured differences noise magnitude менен бир масштабга келип калышы мүмкүн.
Figure 3тө shot саны менен noise floor кантип өзгөрөт?
| Shot саны | Noise floor (Ha) | Маалымат статусу |
|---|---|---|
| 8 | ±6,7 × 10⁻² | Булактагы Figure 3 белгиси |
| 16 | ±4,2 × 10⁻² | Булактагы Figure 3 белгиси |
| 32 | ±2,5 × 10⁻² | Булактагы Figure 3 белгиси |
| 64 | ±1,7 × 10⁻² | Булактагы Figure 3 белгиси |
| 512 | ±6,0 × 10⁻³ | Булактагы Figure 3 белгиси |
| 1024 | ±4,0 × 10⁻³ | Булактагы Figure 3 белгиси |
| 6144 | ±1,6 × 10⁻³ | Булактагы Figure 3 белгиси |
| 12.000 | ±1,2 × 10⁻³ | Булактагы Figure 3 белгиси |
| 30.000 | ±7,3 × 10⁻⁴ | Булактагы Figure 3 белгиси |
Shot саны көбөйгөн сайын noise floor азаят; бирок \(1/\sqrt{N_{\mathrm{shots}}}\) мүнөзүндөгү scaling себептүү ошол эле абсолюттук жакшырууну алуу үчүн бара-бара көбүрөөк shot талап кылынат. Авторлордун “болжол менен 1000 shotтан кийин diminishing returns” деген баасы жакшыруу толук токтойт дегенди билдирбейт, ар бир кошумча shotка туура келген чектүү тактык өсүшү азаярын көрсөтөт.
Population Mean Эмне Үчүн Бир “Эң Мыкты” Талапкерге Караганда Ишенимдүүрөөк Болушу Мүмкүн?
Sampling noise болжол менен симметриялуу болгондо population ичиндеги көп талапкердин орточосу оң жана терс measurement fluctuationsты бири-бирине каршы баса алат; ал эми эң төмөн өлчөнгөн талапкерди гана тандоо чоң population ичинде кокусунан өтө төмөн өлчөнгөн “good outlier” тандоо ыктымалдыгын көбөйтүп, optimizerдин noiseду чыныгы илгерилөө деп кабыл алышына алып келиши мүмкүн.
Population чоңойгондо эки карама-каршы таасир бир убакта пайда болушу мүмкүн
Бул изилдөөнүн маанилүү нюанстарынын бири:
- Best-value selection: population чоңойгон сайын өтө төмөн lucky noise sample табуу ыктымалдыгы өсүшү мүмкүн.
- Population mean: population чоңойгон сайын көз карандысыз/чектелген корреляциялуу fluctuations орточодо бири-бирин жакшыраак жокко чыгарышы мүмкүн.
Булак population-average estimation error үчүн:
\[ \mathrm{Error} \propto \frac{\sigma_{\mathrm{noise}}}{\sqrt{\lambda}} \]
масштабын колдонот.
Бул жерде \(\lambda\) — population size.
Бул туюнтманы “sampling noiseтун физикалык негизги чеги бузулду” деп чечмелөөгө болбойт. Көбүрөөк population member аркылуу статистикалык маалымат бириктирилгендиктен mean estimate бир noisy evaluationга караганда такыраак болот.
Булак салыштырган үч noise-floor стратегиясы
- Shot escalation: ар бир evaluation үчүн shot санын көбөйтүү.
- Selective high-shot reevaluation: көрүнгөн эң мыкты candidatesти жогорку shot менен кайра өлчөө.
- Population averaging: CMA-ES steady-state population statisticsти колдонуу.
Shot escalation varianceны түз азайтат, бирок чыгымды көбөйтөт. Selective reevaluation тандалган талапкер мурунтан эле lucky outlier болсо selection bias коркунучун алып жүрөт. Population mean болсо sampling fluctuationsтын симметриясын колдонуп, жалгыз minimum байкоосунун biasын азайтууну максат кылат.
Авторлор CMA-ESтин noise floor аныктаган steady-state distributionга жакындай алышын пайдаланышат; бирок бул global ground-state optimumга жетүүнү кепилдебей турганын да ачык белгилешет.
Population size боюнча кошумча анализ эмнени көрсөттү?
Appendix C:
\[ \lambda=7,\ 25,\ 50,\ 100 \]
population sizes үчүн кошумча анализ берет.
\(\lambda=7\) шартында да iteration mean бир best-value selectionга караганда төмөнүрөөк ката тенденциясын көрсөтөт.
\(\lambda=25\) жана өзгөчө \(\lambda=50\) шарттарында population mean theoretical/empirical noise floorго кыйла жакын жүрөт.
\(\lambda=100\) үчүн 30.000-shot режиминде булак болжол менен iteration 5 аймагында zero-error тегерегине тез жеткенин, болжол менен iteration 20га чейин ошол аймакта калганын, андан кийин noise-induced divergence/overfitting белгилери чыкканын билдирет.
Ошондуктан изилдөө “population канчалык чоң болсо, дайыма ошончолук жакшы” деген жыйынтыкка келбейт. Авторлор оптималдуу population-size window болушу мүмкүн деп сунуштайт, бирок бардык маселелер үчүн жарактуу бирдиктүү оптималдуу \(\lambda\) маанисин аныктабайт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Benchmark классикалык high-performance computing инфраструктурасында симуляцияланган tVHA circuits үстүндө сегиз classical optimizerдин exact statevector жана finite-shot sampling шарттарындагы жүрүм-турумун Hartree–Fock жана random initialization варианттары менен салыштырат.
Молекулалык системалар
| Өзгөчөлүк | H2 | LiH Active Space | LiH Full Space | H4 Чынжыры |
|---|---|---|---|---|
| Bond length / distances (Å) | 0,74279 | 1,596 | 1,596 | 0,7; 0,7; 0,768 |
| Charge | 0 | 0 | 0 | 0 |
| Multiplicity | 1 | 1 | 1 | 1 |
| Basis set | STO-3G | STO-3G | STO-3G | STO-3G |
| Active space | Full | (2,2), 3 orbital | Full | Full |
Булактагы footnote LiH active-space үчүн orbitals [1,2,3] жана 2 alpha + 2 beta electrons деген туюнтманы колдонот. Бул көрсөтүлүш булакта кандай берилсе, ошондой сакталган.
STO-3G basis set эмнени билдирет?
STO-3G — молекулалык orbital calculationsда колдонулуучу minimal Gaussian basis family. Булак аны бардык системаларда бирдей basis катары колдонуп, optimizer салыштыруусун бирдей негизги electronic-structure approximation үстүндө жүргүзөт.
Active-space reduction эмне үчүн маанилүү?
Active-space ыкмасы бардык molecular orbitals ордуна electron correlation жагынан маанилүү тандалган orbitals үстүндө эсеп жүргүзөт. Ошентип:
- qubit/circuit талабы,
- parameter-space өлчөмү,
- optimizer изилдөөгө тийиш болгон effective landscape
азайтылышы мүмкүн.
Бирок active-space жыйынтыгы full molecular Hilbert-space чечими менен бир эле маселе эмес. Булак LiH active-space noise robustnessту жакшыртарын көрсөткөнү менен, муну “full LiH маселеси толук жана такыраак чечилди” деп чечмелөө туура эмес.
Салыштырылган optimizerлер
| Optimizer | Булактагы классификация | Негизги иштөө логикасы |
|---|---|---|
| BFGS | Gradient-based | Inverse-Hessian approximation менен quasi-Newton жаңыртуусу |
| CMA-ES | Metaheuristic / evolutionary | Candidate population жана adaptive multivariate Gaussian covariance |
| COBYLA | Gradient-free | Objective жана constraints үчүн local linear approximations жана trust-region ыкмасы |
| GD | Gradient-based | Negative gradient direction боюнча parameter update |
| Nelder–Mead | Gradient-free | Simplex reflection, expansion, contraction жана shrink операциялары |
| PSO | Metaheuristic / swarm | Particles individual-best жана global-best маалыматка жараша кыймылдайт |
| SLSQP | Gradient-based | Sequential quadratic programming жана constrained local approximation |
| SPSA | Булактагы Table 3тө gradient-free | Бардык parametersти бир учурда perturb кылып, эки function evaluation менен stochastic gradient estimate алуу |
SLSQP классификациясы боюнча эскертүү: Булактын Introduction бөлүмүндө COBYLA менен SLSQP “derivative-free techniques” деген аталышта чогуу айтылат. Бирок Appendix A жана Table 3 SLSQPни gradient-based method катары классификациялап, sequential quadratic programming түзүлүшүн түшүндүрөт. Verianla негизги таблицада кененирээк Appendix A/Table 3 классификациясын колдонуп, Introductionдагы айырмалуу сөз айкашын жашырган эмес.
Канча көз карандысыз simulation иштетилди?
Ар бир optimizer–molecule жуптугу үчүн төрт configuration жана ар бир configurationга 10 run бар:
| Сценарий | Initialization | Energy evaluation |
|---|---|---|
| 1 | Hartree–Fock | Statevector |
| 2 | Hartree–Fock | 6144-shot sampling |
| 3 | Random | Statevector |
| 4 | Random | 6144-shot sampling |
Жалпы:
\[ 1280 \]
көз карандысыз run аткарылган.
Pseudo-random seeds туруктуу коюлган эмес. Булакка ылайык, ушундайча starting points, optimizerдин stochastic steps жана shot sampling ар бир trialда көз карандысыз stochastic draw катары болгон.
Бул тандоо ensemble-level robustnessту баалоо жагынан маанилүү; бирок бир runду bit-bit кайра чыгарууну туруктуу seed колдонууга салыштырмалуу кыйындатат.
Optimizer hyperparameters кантип тандалды?
Булак optimizer hyperparameters molecule боюнча өз-өзүнчө tune кылынбаганын; тиешелүү implementations үчүн кеңири колдонулган defaults маанилери тандалганын билдирет. Максат — ыкмалардын ортосундагы case-by-case tuning biasты азайтуу.
Ал эми Appendix E stopping/convergence criteria үчүн так tolerance маанилерин берет.
Convergence criteria
| Optimizer | Булак параметри | Булак criterion |
|---|---|---|
| BFGS | \(ftol=10^{-10}\) | \(\frac{f_k-f_{k+1}}{\max(|f_k|,|f_{k+1}|,1)}\le ftol\) |
| COBYLA | \(tol=10^{-7}\) | \(\Delta f_k=|f_{k+1}-f_k|\le tol\) |
| GD | \(tol=5\times10^{-4}\) | \(\|\theta_{k+1}-\theta_k\|\le tol\) |
| CMA-ES | \(tolx=10^{-12}\), \(tolfun=10^{-12}\) | \(\max_i\sigma_i\le tolx\) жана population objective range \(\le tolfun\) |
| Nelder–Mead | \(xatol=10^{-6}\) | \(\|x_{k+1}-x_k\|\le xatol\) |
| PSO | velocity threshold \(10^{-5}\), cluster threshold 1 | Unclustered-particle count жана maximum velocity чогуу чектен төмөн түшкөндө |
| SLSQP | \(ftol=10^{-10}\) | BFGS менен бирдей normalized function-change формасы |
| SPSA | \(N=100\), \(allowed\_increase=10^{-3}\) | Акыркы 100 objective value үчүн fitted trend slope оң болгондо stagnation/termination текшерүүсү |
Appendix Eдеги SPSA slope критерийи
Булак Теңдеме (18):
\[ \mathrm{slope} = \frac{1}{N} \frac{df_k}{dk} > 0 \tag{18} \]
көрсөтүлүшүн колдонот.
Slope акыркы \(N=100\) objective values үстүндө linear regression менен аныкталат.
Reproducibility боштугу: Булак бардык optimizers үчүн maximum function-evaluation лимити бирдей экенин билдирет; бирок жүктөлгөн manuscript текстинде бул жалпы maximumдун сандык мааниси көрүнүктүү түрдө берилген эмес. 11-бетде да “running up to optimization iterations” деген сөз айкашында iteration саны жетишпейт. Бул маани Verianla тарабынан болжолдонгон эмес.
Программалык stack
| Python library | Версия |
|---|---|
| qiskit | 1.0.2 |
| qiskit_algorithms | 0.3.1 |
| qiskit_nature | 0.7.2 |
| qiskit_aer | 0.14.2 |
| pyscf | 2.6.0 |
| scipy | 1.15.2 |
| cma | 3.3.0 |
Эсептөө инфраструктурасы
Симуляциялар IT4Innovations Barbora supercomputer үстүндө жүргүзүлгөн. Булак системаны:
- 192 standard node: ар бир node үчүн 2 × 18-core Intel Xeon жана 192 GB RAM,
- 8 GPU node: 2 × 12-core Intel Xeon + 4 × NVIDIA V100,
- 1 fat node: 8 × 16-core Intel Xeon + 6 TB RAM,
- 200 Gb/s Infiniband HDR,
- 310 TB SCRATCH storage жана 28 GB/s throughput
деп сүрөттөйт.
Runs job-level embarrassingly parallel түрүндө Slurm jobs болуп бөлүштүрүлгөн. LiH жана H4 үчүн 5–10 concurrent run топтору колдонулган.
Булак жалпы computational consumptionду болжол менен:
\[ 4500\ \text{node-hour} \]
деп билдирет.
High-shot reevaluation эмне үчүн жасалган?
Noisy optimizer кээде lucky sampling fluctuation себептүү чындыгында болгондон өтө жакшы көрүнгөн candidate parameters тандашы мүмкүн. Figure 4–7 captions optimization учурунда табылган candidate parameters:
\[ 10^5\ \text{shot} \]
менен кайра бааланганын көрсөтөт.
High-shot reevaluation optimizerди кайра иштетүү эмес. Максат — ошол эле parameter point энергиясын төмөн sampling variance менен кайра өлчөп, көрүнгөн ийгилик чыныгы parameter qualityденби же low-shot fluctuationданбы айырмалоо.
H2 жыйынтыктары
Ызы-чуусуз statevector шартында H2 эң жеңил benchmark болуп саналат.
Булак:
- BFGS, CMA-ES, COBYLA, Nelder–Mead жана PSO үчүн болжол менен \(10^{-13}\)–\(10^{-14}\) Haдан төмөн errors,
- GD + HF үчүн болжол менен \(10^{-6}\) Ha,
- SPSA үчүн болжол менен \(3\times10^{-5}\) Ha
билдирет.
Бул режимде ыкмалар ортосундагы негизги айырма final accuracyден көрө convergence speed болуп саналат.
Sampling noise шартында high-shot corrected values үчүн булак:
| Optimizer / шарт | Билдирилген ката (Ha) |
|---|---|
| GD + HF | 6,6 × 10⁻⁴ |
| SPSA + HF | 4,1 × 10⁻⁴ |
| CMA-ES | 4,5 × 10⁻⁴ |
| COBYLA | 2,4 × 10⁻³ |
| Nelder–Mead + HF | 3,9 × 10⁻³ |
| BFGS | болжол менен 4 × 10⁻³ |
| PSO random | 6,5 × 10⁻⁴ |
| PSO HF | 1,0 × 10⁻³ |
SLSQP sampling-noise шартында H2 үчүн да ишенимдүү converge болгон эмес.
Булак ичиндеги рейтинг боюнча эскертүү: Булак тексти “lowest corrected mean errors come from GD ... followed by SPSA ... and CMA-ES” деп жазат. Бирок берилген сандар салыштырылганда:
\[ 4.1\times10^{-4} < 4.5\times10^{-4} < 6.6\times10^{-4}. \]
Демек сандык чоңдук боюнча тартип SPSA, CMA-ES, GD. Verianla булактагы сүйлөмдү өз алдынча кайра иреттеп, “булак ушинтип айтты” деп берген эмес; тексттик билдирүү да, сандык маанилер да көрүнүктүү сакталган.
H4 жыйынтыктары
H4 chain татаалыраак Hamiltonian жана optimization landscape жаратат.
Statevector шартында булак:
- BFGS, COBYLA жана SLSQP үчүн болжол менен \(7\times10^{-3}\) Ha,
- GD үчүн болжол менен \(2,5\times10^{-2}\) Ha
ката деңгээлдерин билдирет.
Sampling-noise high-shot reevaluationдан кийин:
| Optimizer | Билдирилген corrected mean error (Ha) |
|---|---|
| CMA-ES + HF | 2,25 × 10⁻² |
| PSO | 2,7 × 10⁻² |
| GD | 3,01 × 10⁻² |
| SPSA | болжол менен 3,5–3,8 × 10⁻² диапазонунда |
| COBYLA | болжол менен 3,5–3,8 × 10⁻² диапазонунда |
| BFGS | >4,5 × 10⁻² |
| Nelder–Mead | >4,5 × 10⁻² |
Булак ичиндеги рейтинг боюнча эскертүү: Текст CMA-ESтен кийин “GD жана PSO” деп иреттейт; бирок берилген сандарда PSOнун \(2,7\times10^{-2}\) Ha мааниси GDнин \(3,01\times10^{-2}\) Ha маанисинен кичине.
LiH full-space жыйынтыктары
Булак statevector шартында BFGS, CMA-ES, COBYLA, Nelder–Mead жана SPSA болжол менен:
\[ 4\times10^{-3}\ \mathrm{Ha} \]
аймагына жеткенин, GD болжол менен \(2\times10^{-2}\) Ha, PSO болсо болжол менен \(9\times10^{-3}\) Ha деңгээлинде калганын билдирет.
Булак ошол эле сүйлөмдө биринчи топ үчүн “sub-millihartree precision” деген сөз айкашын колдонот.
Бирок:
\[ 4\times10^{-3}\ \mathrm{Ha} = 4\ \mathrm{mHa}. \]
“Sub-millihartree” математикалык жактан 1 mHaдан кичине, башкача айтканда \(10^{-3}\) Haдан төмөн дегенди билдирет. Демек булактагы мүнөздөмө менен ошол эле сүйлөмдө берилген болжолдуу \(4\times10^{-3}\) Ha саны шайкеш эмес. Verianla санды негиз кылып, бул айырманы жашырбайт.
Sampling noise + high-shot reevaluation:
| Optimizer / шарт | Билдирилген ката |
|---|---|
| CMA-ES + HF | ~8,0 mHa |
| CMA-ES random | ~10,5 mHa |
| PSO + HF | ~13,2 mHa |
| PSO random | ~13,6 mHa |
| SPSA + HF | ~16 mHa |
| GD | ~19 mHa |
| BFGS + HF | ~19,7 mHa |
| BFGS random | ~22,2 mHa |
| COBYLA / Nelder–Mead | болжол менен 20 mHa деңгээли |
Full-space LiH larger parameter-space шартында population-based CMA-ES sampling noise астында эң туруктуу жыйынтык берген системалардын бири.
LiH active-space жыйынтыктары
Active-space reduction optimization маселесин олуттуу жеңилдетет.
Statevector шартында CMA-ES, PSO, Nelder–Mead жана SPSA:
\[ <2\times10^{-4}\ \mathrm{Ha} \]
деңгээлине жетет.
BFGS жана COBYLA да болжол менен \(2\times10^{-4}\) Ha аймагында.
Sampling-noise high-shot reevaluation:
| Optimizer / шарт | Билдирилген ката |
|---|---|
| CMA-ES + HF | 2,6 × 10⁻⁴ Ha |
| SPSA | 3,9 × 10⁻⁴ Ha |
| PSO | 4,2 × 10⁻⁴ Ha |
| Nelder–Mead + HF | 5,3 × 10⁻⁴ Ha |
| COBYLA / BFGS | ~8 × 10⁻⁴–1,1 × 10⁻³ Ha |
| GD | бир нече mHa |
| SLSQP | >3 × 10⁻¹ Ha |
Булак кийинки literature-comparison абзацында SPSA + HF үчүн \(6,5\times10^{-4}\) Ha жана 486 function evaluation да билдирет. Ал эми Section 6дагы high-shot жыйынтык абзацында \(3,9\times10^{-4}\) Ha деп жазылган. Булак бул эки сан ар башка evaluation stage, aggregation же reporting choice менен байланыштуубу, так түшүндүрбөйт. Ошондуктан эки маани бири-бирине мажбурлап бириктирилген эмес.
Full LiH менен active-space LiH ортосундагы негизги айырма
Булак active-space reduction optimizer demand жана noise sensitivityни болжол менен бир order of magnitude азайтарын билдирет.
Discussion бөлүмүндө COBYLA sampling үчүн active-space truncationдан кийин:
\[ 95.2\% \]
error reduction билдирилет.
Бул пайыз белгилүү LiH/COBYLA comparisonга тиешелүү; аны бардык optimizers, молекулалар же чыныгы quantum hardware үчүн жалпы %95,2 жакшыртуу деп чечмелөөгө болбойт.
Figure 8 эмнени көрсөтөт?
Булактагы Figure 8 төрт системанын бардык optimizers үчүн final errors маанилерин алты evaluation category түрүндө салыштырат:
- Random Init Statevector,
- HF Init Statevector,
- Random Init Sampling Noise,
- HF Init Sampling Noise,
- Random-Sampling High-Shot Reevaluation,
- HF-Sampling High-Shot Reevaluation.
Bars mean final errorду, error bars болсо булактагы captionга ылайык %95 confidence interval маанилерин билдирет.
Булак Figure 8деги бардык bar heights маанилерин өзүнчө numeric table катары бербейт. Ошондуктан Verianla графиктен пиксел окуп, жасалма тактыктагы жаңы сандарды чыгарган эмес.
Булактын негизги optimizer жыйынтыгын кантип кыскача баяндоо керек?
| Шарт | Булакта баса белгиленген жүрүм-турум | Чечмелөө чеги |
|---|---|---|
| Кичине система + statevector | BFGS жана deterministic/gradient methods тез жана жогорку тактыкта | Noise жок; hardware жүрүм-туруму эмес |
| Finite-shot sampling | Gradient/curvature information бузулат | Sampling noise гана текшерилген |
| Чоңураак parameter space | CMA-ES, PSO, SPSA туруктуураак болот | Ар бир system үчүн бир универсалдуу рейтинг жок |
| Active-space LiH | Optimization жеңилдейт жана noise sensitivity азаят | Маселе full-space LiH менен бир state space эмес |
| Population mean | Best-value selectionга караганда symmetric sampling noiseду жакшыраак басышы мүмкүн | Global optimum кепилдиги эмес |
Изилдөө колдогон жыйынтыктар
- Optimizer ranking sampling noise бар-жогуна күчтүү көз каранды.
- Ызы-чуусуз кичине системаларда gradient/quasi-Newton ыкмалары абдан натыйжалуу болушу мүмкүн.
- Finite-shot sampling gradient жана curvature estimatesти бузушу мүмкүн.
- SLSQP tested sampling-noise шарттарында олуттуу divergence көрсөткөн.
- BFGS noiseless шарттардагы күчтүү артыкчылыгын sampling noise астында негизинен жоготкон.
- CMA-ES, PSO жана SPSA larger/noisy benchmarkтарда туруктуураак болгон.
- Hartree–Fock initialization кичине системаларда көбүнчө жардам берет, бирок анын артыкчылыгы complexity көбөйгөн сайын азаят.
- Random initialization кээ бир population-based methods үчүн HF менен тең же андан жакшы болушу мүмкүн.
- Active-space reduction LiHде optimization жана noise robustnessту олуттуу жакшырткан.
- Finite-shot energy estimates exact ground-state lower boundдан төмөн көрүнүшү мүмкүн.
- High-shot reevaluation low-shot “жакшы” жыйынтыктардын бир бөлүгү sampling artifact экенин көрсөткөн.
- Population mean single best candidate selectionга салыштырмалуу noise-overfitting коркунучун азайтышы мүмкүн.
Изилдөө колдобогон жыйынтыктар
- Изилдөө чыныгы quantum computer үстүндө сегиз optimizerди benchmark кылган эмес.
- CMA-ES бардык VQE маселелеринде сөзсүз эң мыкты optimizer экени көрсөтүлгөн эмес.
- Sampling noise физикалык түрдө ground-state energyден төмөн чыныгы quantum states түзөрү көрсөтүлгөн эмес.
- Variational principle exact expectation маанилери үчүн жокко чыгарылган эмес.
- Gate infidelity, coherent error, depolarizing noise, amplitude damping, thermal relaxation же readout error benchmark кылынган эмес.
- Optimizer рейтинги чыныгы hardware noise астында да ошол бойдон калаары далилденген эмес.
- Quantum computational speedup же quantum advantage көрсөтүлгөн эмес.
- STO-3G жана изилденген кичине molecular systems жыйынтыктарын чоң химиялык системаларга автоматтык жалпылоого болбойт.
- Population size өскөн сайын көрсөткүч чексиз жакшырары көрсөтүлгөн эмес.
- Source Table 2деги “hardware үчүн ылайыктуу” сыяктуу optimizer сунуштары түз hardware benchmark жыйынтыгы эмес.
Изилдөөнүн негизги чектөөлөрү
Булак жана ыкма бирге бааланганда негизги чектөөлөр:
- Quantum circuits классикалык компьютер/HPC үстүндө симуляцияланган.
- Негизги noisy condition finite-shot sampling noise гана.
- Real-device gate/readout/calibration noise киргизилген эмес.
- STO-3G minimal basis колдонулган.
- Изилденген molecular systems H2, H4 жана LiH менен чектелген.
- Random seeds туруктуу эмес.
- Бардык optimizer hyperparameters molecule-specific tuningге алынган эмес.
- Common maximum function-evaluation санынын numeric мааниси manuscript текстинде көрүнүктүү түрдө берилген эмес.
- Figure 8деги бардык bar values numeric table түрүндө берилген эмес.
- tVHA truncation circuit depthти төмөндөтүп жатып reachability deficit жаратышы мүмкүн.
- CMA-ES steady-state stability global optimum кепилдиги эмес.
Келечектеги изилдөө багыттары
Авторлор келечекте:
- fast gradient search менен population methods ортосунда noise-adaptive switching,
- measured noise floorго жараша dynamic shot allocation,
- noise-aware stopping rules,
- thermal relaxation,
- amplitude damping,
- readout assignment errors,
- hardware-backed calibration
сыяктуу реалдуураак noise conditions жана hybrid optimization strategies изилдөөнү сунуштайт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: Numerical Optimization Strategies for the Variational Hamiltonian Ansatz in Noisy Quantum Environments
Авторлор: Silvie Illésová; Vojtěch Novák; Tomáš Bezděk; Clemens Possel; Martin Beseda.
Авторлордун тартиби: Булактагы тартип сакталган.
Бирдей салым: Жүктөлгөн v4 PDFде ачык equal-contribution/equal-first-author билдирүүсү көрүнбөйт.
Corresponding author: Martin Beseda.
Corresponding-author электрондук почтасы: martin.beseda@univaq.it
Мекеме 1: Gran Sasso Science Institute, L’Aquila, Italy.
Мекеме 2: Department of Applied Mathematics, Faculty of Electrical Engineering and Computer Science, VSB-Technical University of Ostrava, Ostrava, Czech Republic.
Мекеме 3: IT4Innovations National Supercomputing Center, VSB–Technical University of Ostrava, Ostrava, Czech Republic.
Мекеме 4: Department of Computer Science, Faculty of Electrical Engineering and Computer Science, VSB–Technical University of Ostrava, Ostrava, Czech Republic.
Мекеме 5: Department of Mathematics, TUM School of Computation, Information and Technology, Technical University of Munich, Garching bei München, Germany.
Мекеме 6: Fraunhofer Institute for Chemical Technology ICT, Pfinztal, Germany.
Мекеме 7: Department of Physics, Saarland University, Saarbrücken, Germany.
Мекеме 8: Department of Information Engineering, Computer Science and Mathematics, University of L’Aquila, L’Aquila, Italy.
Платформа: arXiv.
arXiv: arXiv:2505.22398v4 [quant-ph].
Биринчи arXiv тапшыруусу: 28-май 2025.
Жүктөлгөн версия: v4, 22-январь 2026.
DOI: 10.48550/arXiv.2505.22398.
Расмий шилтеме: https://arxiv.org/abs/2505.22398
Булак түрү: Теориялык/эсептөөчү quantum-chemistry жана numerical-optimization preprint/manuscript.
Рецензия статусу: Жүктөлгөн булак arXiv preprint версиясы. PDF IOP Publishing manuscript template колдонот; бирок Journal Name, volume/year/article-number жана received/revised dates placeholder абалында. Бул кароодо exact title үчүн ырасталган акыркы рецензияланган journal publication жазуусу табылган эмес, ошондуктан макала рецензияланган final жарыя катары берилген эмес.
IOP шаблон эскертүүсү: PDFде “Journal vv (yyyy) aaaaaa”, “Journal Name”, “dd Month yyyy” сыяктуу placeholders бар. Алар чыныгы библиографиялык journal metadata катары колдонулган эмес.
Файл идентификациясы боюнча эскертүү: Жүктөлгөн файлдын аты Research Square DOI форматына окшош туюнтманы камтыса да, PDFтин ички идентификациясы arXiv:2505.22398v4, ал эми PDF metadata DOI 10.48550/arXiv.2505.22398. Research Square жазуусу бул кароодо ишенимдүү расмий барактан өзүнчө ырасталбагандыктан негизги DOI катары колдонулган эмес.
Лицензия: PDF metadata Creative Commons Attribution 4.0 International (CC BY 4.0) лицензиясын көрсөтөт.
Ачкыч сөздөр: Variational Quantum Eigensolver; Noisy optimization; CMA-ES; Truncated Variational Hamiltonian Ansatz; Quantum chemistry.
Изилдөөнүн түрү: Classical HPC үстүндө quantum-circuit simulation жана optimizer benchmarking.
Чыныгы quantum hardware: Колдонулган эмес.
Негизги noise модели: Finite-shot sampling noise.
Камтылбаган noise түрлөрү: coherent/stochastic gate errors, thermal relaxation, amplitude damping жана readout bias негизги benchmark-ка киргизилген эмес.
Молекулалык системалар: H₂, linear H₄ chain, LiH full space, LiH active space.
Basis: STO-3G.
Hamiltonian mapping: Jordan–Wigner.
tVHA truncation: \(p=0.999\), башкача айтканда булактын түшүндүрмөсүнө ылайык non-Coulomb two-body interaction strengthтин cumulative %99,9 бөлүгү сакталат.
Негизги sampling budget: 6144 shot / function evaluation.
Landscape reference sampling: \(N_{\mathrm{shots}}\ge10^6\).
High-shot reevaluation: Figure 4–7де \(10^5\) shot.
Көз карандысыз run саны: 1280.
Random seeds: Бекитилген эмес.
Optimizer tuning: Булак case-by-case hyperparameter optimization ордуна кеңири колдонулган implementation defaults пайдаланылганын билдирет; өзүнчө stopping tolerances Appendix Eде берилген.
Эсептөө инфраструктурасы: Barbora supercomputer, Bull Sequana X cluster; жалпы болжол менен 4500 node-hour.
Программалык камсыздоо: Qiskit 1.0.2; qiskit_algorithms 0.3.1; qiskit_nature 0.7.2; qiskit_aer 0.14.2; PySCF 2.6.0; SciPy 1.15.2; cma 3.3.0.
Data Availability: Эсептелген натыйжалар жана аларды чыгарган scripts Zenodoдо public түрдө бөлүшүлгөн.
Zenodo DOI: 10.5281/zenodo.15526170.
Conflict of Interest: Авторлор белгилүү competing financial interests же personal relationships жок экенин билдиришет.
Ethical Statement: Human participants, human data же animal experimentation болбогондуктан ethical approval талап кылынган эмес.
Funding / колдоо: Clemens Possel Baden-Württemberg Ministry of Economic Affairs, Labour and Tourism тарабынан QC-4-BW, QC-4-BW II жана KQCBW24 долбоорлору аркылуу колдоого алынган. Tomáš Bezděk SGS No. SP2025/049, Vojtěch Novák SGS No. SP2025/072 колдоосун алган. Изилдөө ошондой эле Czech Ministry of Education, Youth and Sports тарабынан e-INFRA CZ ID:90254 аркылуу колдоого алынган.
Авторлордун салымы: Булакта өзүнчө CRediT author-contribution breakdown берилген эмес.
Статистика: Ар бир configuration үчүн 10 independent run жүргүзүлгөн. Figure 8 mean final errors жана %95 confidence intervals көрсөтөт. Булакта optimizer жуптары үчүн кеңири formal p-value significance-testing таблицасы берилген эмес.
Equation (2) нотациясы: Coulomb termде сумма \(\sum_{ij}\) түрүндө жазылганы менен coefficient \(g_{ijk\ell}\) болуп төрт индекске ээ. Булак бул жазылышты өзүнчө түшүндүрбөйт; Verianla теңдеме индекстерин божомол менен өзгөрткөн эмес.
H₂ натыйжаларынын ирети жөнүндө эскертүү: Булак GD + HF \(6,6\times10^{-4}\) Haны “lowest” деп биринчи жазат, бирок SPSA + HF \(4,1\times10^{-4}\) Ha жана CMA-ES \(4,5\times10^{-4}\) Ha болуп андан кичине numeric values берет.
H₄ ирети жөнүндө эскертүү: Текст CMA-ESтен кийин GD жана PSO иретин колдонот, бирок берилген PSO мааниси \(2,7\times10^{-2}\) Ha, GD мааниси \(3,01\times10^{-2}\) Ha.
LiH unit-language эскертүүсү: Full-space statevector абзацы болжол менен \(4\times10^{-3}\) Ha маанилерин “sub-millihartree” деп мүнөздөйт; \(4\times10^{-3}\) Ha = 4 mHa болгондуктан сан менен мүнөздөмө шайкеш эмес.
SLSQP классификация эскертүүсү: Introductionда derivative-free methods контекстинде айтылса, Appendix A жана Table 3тө gradient-based constrained optimizer катары аныкталат.
SPSA active-space эскертүүсү: Main result paragraph \(3,9\times10^{-4}\) Ha high-shot result берет, ал эми кийинки literature-comparison paragraph \(6,5\times10^{-4}\) Ha жана 486 function evaluations маанисин берет. Булак айырманы кеңири түшүндүрбөйт.
Maximum function-evaluation эскертүүсү: Бардык optimizers үчүн бирдей maximum limit колдонулганы айтылат, бирок жүктөлгөн manuscript textте жалпы сандык максимум ачык көрүнбөйт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген