


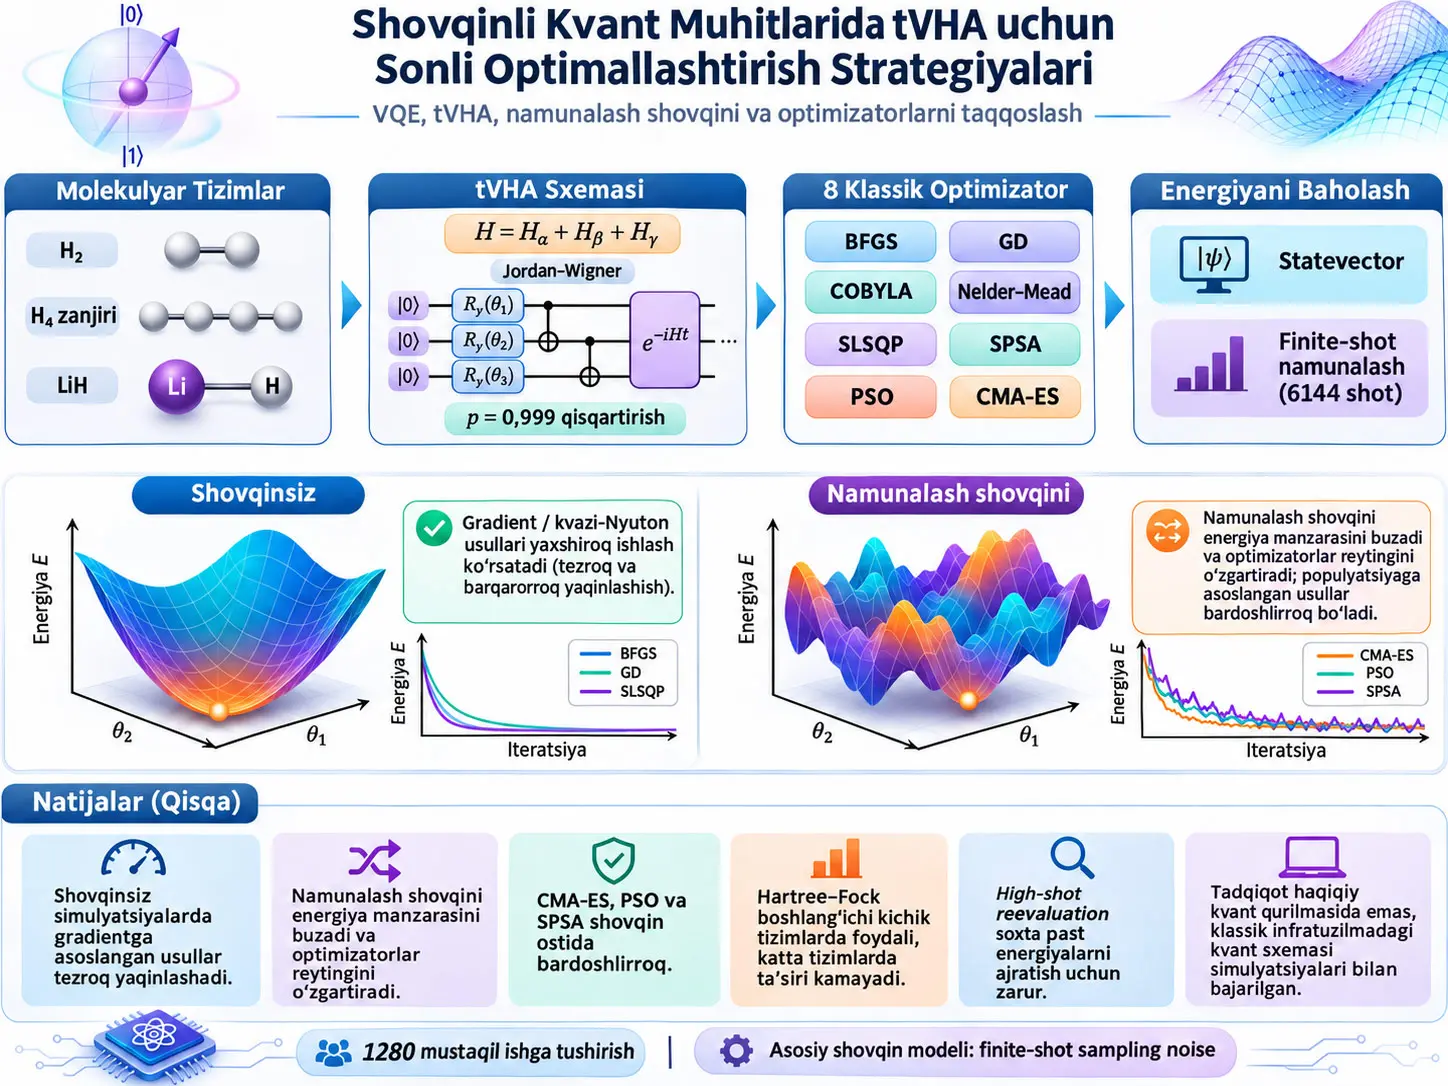
Truncated Variational Hamiltonian Ansatz (tVHA) — molekulyar elektron Hamiltonianining fizik tuzilishidan kelib chiqadigan, parametrli kvant zanjirini boshqarishni osonlashtirish uchun ayniqsa non-Coulomb ikki-jismli hadlarni nazoratli tarzda qisqartiradigan, kimyoviy jihatdan tuzilgan variatsion kvant ansatzidir. Ushbu tadqiqot tVHA asosidagi Variational Quantum Eigensolver (VQE) hisoblarida sakkizta klassik optimallashtirish algoritmining xatti-harakatini H2, chiziqli H4 zanjiri hamda LiHning full-space va active-space tasvirlarida taqqoslaydi. Tadqiqot haqiqiy kvant apparatida o‘tkazilmagan; quantum circuits klassik yuqori unumli hisoblash infratuzilmasida Qiskit yordamida simulyatsiya qilingan. Shu sababli bu yerda o‘lchangan “shovqinga chidamlilik” avvalo finite-shot sampling noise sharoitidagi simulyatsiya ko‘rsatkichidir.
Taqqoslangan sakkizta optimizer: BFGS, Covariance Matrix Adaptation Evolution Strategy (CMA-ES), COBYLA, Gradient Descent (GD), Nelder–Mead, Particle Swarm Optimization (PSO), Sequential Least Squares Programming (SLSQP) va Simultaneous Perturbation Stochastic Approximation (SPSA). Har bir molecule–optimizer juftligi to‘rtta ssenariyda sinovdan o‘tkazilgan: Hartree–Fock boshlanishi + statevector, Hartree–Fock boshlanishi + finite-shot sampling, random boshlanish + statevector va random boshlanish + finite-shot sampling. Har bir ssenariy uchun 10 ta mustaqil ishga tushirish bajarilgan va jami:
\[ 4\ \text{moleküler temsil} \times 8\ \text{optimizer} \times 4\ \text{senaryo} \times 10\ \text{koşu} = 1280 \]
ta mustaqil simulation hosil qilingan.
Asosiy noisy benchmarkda har bir function evaluation uchun 6144 shot ishlatilgan. Exact reference uchun Qiskit StatevectorEstimator, finite-shot hisoblar uchun Qiskit Aer Estimator qo‘llangan. Aer Estimator Born qoidasi bo‘yicha namuna olgani sababli measured expectation values finite sample variancega ega. Tadqiqotning asosiy xulosasi shuki, sampling noise natijalarga shunchaki kichik xato qo‘shmaydi; u cost landscape shaklini, ko‘rinadigan minimumlarni, gradient directionsni va shu orqali optimizerlar reytingini o‘zgartiradi.
Shovqinsiz statevector sharoitida, ayniqsa kichik H2 tizimi uchun BFGS va boshqa deterministik usullar juda tez va aniq yaqinlashsa, finite-shot sampling noise ostida bu ustunlik katta darajada yo‘qoladi. Molekulyar va parametr fazosi murakkablashgani sari CMA-ES, PSO va SPSA kabi population-based yoki stochastic usullar barqarorroq bo‘lib boradi. Full-space LiH noisy benchmarkida high-shot reevaluationdan so‘ng CMA-ES manbada taxminan \(8\times10^{-3}\) Ha xato bilan eng yaxshi natijani bergan, active-space LiHda esa CMA-ES \(2.6\times10^{-4}\) Ha, SPSA \(3.9\times10^{-4}\) Ha va PSO \(4.2\times10^{-4}\) Ha darajalariga yetgan.
Tadqiqotdagi eng muhim fizik talqin chegarasi variational principle bilan bog‘liq. Exact expectation value uchun:
\[ E(\boldsymbol{\theta})\ge E_0 \]
o‘z kuchida qoladi. Finite-shot hisobda bundan past ko‘rinishi mumkin bo‘lgan qiymat:
\[ \hat E(\boldsymbol{\theta})
ko‘rinishidagi statistik energiya bahosi. Bu haqiqiy fizik quantum state asosiy holat energiyasidan past energiyaga ega degani emas. Sampling fluctuation o‘lchangan estimatorni vaqtincha pastga tortishi mumkin.
Tadqiqot natijalari haqiqiy quantum hardware ishlashining bevosita tasdig‘i emas. Benchmark coherent gate errors, stochastic gate errors, amplitude damping, thermal relaxation yoki readout-assignment biasni o‘z ichiga olmaydi. Mualliflar ham future work doirasida ushbu realistik hardware noise channels alohida sinovdan o‘tkazilishi kerakligini ta’kidlaydi.
tVHA Nima va VQE Ichida Nima Qiladi?
Truncated Variational Hamiltonian Ansatz molekulyar Hamiltonianning bir-elektronli, Coulomb ikki-elektronli va non-Coulomb ikki-elektronli tarkibiy qismlarini to‘g‘ridan-to‘g‘ri parametrli quantum evolution bloklariga aylantiradigan hamda zanjir murakkabligini kamaytirish uchun non-Coulomb hissalarning bir qismini muhimlik tartibida kesadigan, kimyoviy jihatdan tuzilgan ansatzdir; VQE ichidagi vazifasi — asosiy holat energiyasini izlaydigan classical optimizer sozlaydigan quantum state oilasini aniqlash.
VQE nima uchun ham kvant, ham klassik algoritmdir?
Variational Quantum Eigensolver — hybrid quantum–classical usul. Quantum tomoni parametrli holatni:
\[ |\psi(\boldsymbol{\theta})\rangle \]
tayyorlaydi va Hamiltonian expectation value qiymatini o‘lchaydi:
\[ E(\boldsymbol{\theta}) = \langle\psi(\boldsymbol{\theta})| H |\psi(\boldsymbol{\theta})\rangle. \]
Classical optimizer esa \(\boldsymbol{\theta}\) parametrlarini o‘zgartirib, ushbu energiyani kamaytirishga harakat qiladi.
Demak, optimizer ko‘radigan objective function kvant zanjiri hosil qiladigan energiya bahosidir. Bu baho shovqinli bo‘lsa, optimizer noto‘g‘ri gradient, noto‘g‘ri curvature yoki vaqtinchalik false minimumni ko‘rishi mumkin.
Ansatz nima?
Ansatz — VQE qidiruv olib boradigan parametrli quantum-state oilasi. Yaxshi ansatz ikki qarama-qarshi ehtiyojni muvozanatlashtirishi kerak:
- Haqiqiy molekulyar ground statega yetarlicha yaqinlasha oladigan darajada expressive bo‘lishi kerak.
- NISQ sharoitida ishga tushirish mumkin bo‘ladigan darajada kam parametrli va zanjir chuqurligi past bo‘lishi kerak.
Juda zaif ansatz ground statega yetolmaydi. Juda murakkab ansatz esa zanjir chuqurligi, o‘lchash xarajati va optimallashtirish qiyinligini oshirishi mumkin.
Molekulyar Hamiltonian qanday qismlarga ajratiladi?
Manba tVHA tuzilishini avval:
\[ H=H_{\alpha}+H_{\beta}+H_{\gamma} \tag{1} \]
ko‘rinishida belgilaydi.
Bu yerda:
- \(H_{\alpha}\): one-body hadlarini,
- \(H_{\beta}\): Coulomb two-body hadlarini,
- \(H_{\gamma}\): non-Coulomb two-body hadlarini
ifodalaydi.
Manba Tenglama (2)ni quyidagi ko‘rinishda beradi:
\[ H= \sum_{ij} h_{ij}a_i^{\dagger}a_j + \frac{1}{2} \sum_{ij} g_{ijk\ell} a_i^{\dagger}a_j^{\dagger}a_ja_i + \frac{1}{2} \sum_{\substack{ijk\ell\\i\neq k\\j\neq\ell}} g_{ijk\ell} a_i^{\dagger}a_j^{\dagger}a_ka_{\ell}. \tag{2} \]
\(a_i^\dagger\) fermionic creation operator, \(a_j\) annihilation operatordir. \(h_{ij}\) one-electron integralsning, \(g_{ijk\ell}\) esa two-electron interaction coefficientsning ramziy ifodasidir.
Manba notatsiyasiga oid ogohlantirish: Tenglama (2)ning Coulomb hadida yig‘indi belgisi faqat \(i,j\) bo‘yicha yozilgan bo‘lsa-da, coefficient \(g_{ijk\ell}\) to‘rtta indeksga ega. Manba bu nuqtada \(k,\ell\) indekslarini alohida izohlamaydi. Shu sababli Verianla tenglamani odatiyroq indeks tuzilishiga jimgina o‘zgartirmagan va manbadagi ifodani saqlagan.
tVHAdagi truncation threshold nimani anglatadi?
Non-Coulomb two-body terms muhimlik kattaligi bo‘yicha tartiblangach, manba Tenglama (3)da cumulative truncation fractionni:
\[ p= \frac{1} {\sum_s |g_s^{\gamma}|} \sum_{s=1}^{s_{\mathrm{cut}}} |g_s^{\gamma}| \tag{3} \]
deb belgilaydi.
Bu yerda:
- \(g_s^\gamma\): non-Coulomb two-body coefficient,
- \(s\): to‘rtta fermionic indexning bitta tartibli indeks ostida jamlangan ko‘rinishi,
- \(s_{\mathrm{cut}}\): saqlanadigan terms uchun cutoff,
- \(p\): saqlanadigan cumulative interaction weight fraction.
Ushbu benchmarkda:
\[ p=0.999 \]
ishlatilgan.
Ya’ni manba ta’rifiga ko‘ra non-Coulomb two-body interaction strengthning jami kattaligining %99,9 qismini tashkil etadigan terms saqlab qolishga urunilgan, kichikroq hissalar esa zanjir murakkabligini kamaytirish uchun qisqartirilgan.
Bu truncation bepul emas. Kamroq operator sayozroq circuit yaratishga yordam berishi mumkin, biroq ansatz yetisha oladigan state spaceni toraytirib, reachability deficit keltirib chiqarishi mumkin. Bunday holatda optimizer mukammal ishlasa ham ansatz haqiqiy full-configuration-interaction ground statega to‘liq yetolmasligi mumkin.
Fermionic Hamiltonian nima uchun qubit operatorlariga aylantiriladi?
Elektronlar fermion bo‘lgani uchun electronic Hamiltonian creation/annihilation operators bilan yoziladi. Gate-model quantum circuit esa qubit va Pauli operators bilan ishlaydi. Tadqiqotda fermionic Hamiltonian:
\[ H_{\alpha} = \sum_{\alpha}c_{\alpha}P_{\alpha}, \qquad H_{\beta} = \sum_{\beta}c_{\beta}P_{\beta}, \qquad H_{\gamma} = \sum_{\gamma}c_{\gamma}P_{\gamma} \]
ko‘rinishidagi Pauli-term tuzilmalariga Jordan–Wigner transformation orqali o‘tkaziladi.
Manba Bravyi–Kitaev transformation ham prinsipial jihatdan mumkinligini, biroq Jordan–Wigner mapping har bir qubit stateni spin-orbital occupation number sifatida to‘g‘ridan-to‘g‘riroq talqin qilish imkonini berishini qayd etadi.
Commuting Pauli groups nima uchun ishlatiladi?
Bir-biri bilan commute qiladigan Pauli terms bir measurement context doirasida birgalikda ko‘rib chiqilishi mumkin. Manba Pauli termsni graph coloring yordamida commuting groupsga ajratadi va shu yo‘l bilan o‘lchash yukini kamaytirishni maqsad qiladi.
Uchta Hamiltonian fragment uchun commuting-set families:
\[ \mathcal{G}^{\alpha}, \qquad \mathcal{G}^{\beta}, \qquad \mathcal{G}^{\gamma} \]
ko‘rinishida belgilanadi.
tVHA unitary o‘zgarishi qanday quriladi?
Manba Tenglama (4):
\[ U(\boldsymbol{\alpha},\boldsymbol{\beta},\boldsymbol{\gamma}) = \prod_{d=1}^{D} \left[ \prod_{G\in\mathcal{G}^{\alpha}} e^{i\alpha_d c_{\alpha,G}P_{\alpha}} \right] \left[ \prod_{G\in\mathcal{G}^{\beta}} e^{i\beta_d c_{\beta,G}P_{\beta}} \right] \left[ \prod_{G\in\mathcal{G}^{\gamma}} e^{i\gamma_d c_{\gamma,G}P_{\gamma}} \right]. \tag{4} \]
Bu yerda:
- \(D\): discretization/Trotter-step soni va shu sababli circuit depth bilan bog‘liq parametr,
- \(\alpha_d,\beta_d,\gamma_d\): classical optimizer tomonidan o‘zgartiriladigan variational parameters,
- \(c_{\alpha,G},c_{\beta,G},c_{\gamma,G}\): Pauli-group coefficients,
- \(P\): tegishli Pauli operator,
- \(\mathcal G\): commuting groups.
Non-commuting Hamiltonian qismlarining exponential evolution jarayoni birinchi tartibli Suzuki–Trotter, ya’ni Lie–Trotter expansion bilan taxminan amalga oshiriladi.
Manba H2 uchun qanday quantum circuit misolini beradi?
Manba Figure 1da H2 ground-state muammosi uchun to‘liq decomposed, 4-qubit va 3 trainable-parameter tVHA circuit misolini ko‘rsatadi.
| Gate | Soni |
|---|---|
| CX | 48 |
| H | 32 |
| \(\sqrt{X}\) | 16 |
| RZ | 16 |
| \(\sqrt{X}^{\dagger}\) | 16 |
| RZZ | 6 |
| U3 | 2 |
Bu gate count faqat manbada ko‘rsatilgan H2 circuit misoliga tegishli; boshqa molekulalar uchun ayni gate sonlarini faraz qilish to‘g‘ri emas.
Hartree–Fock initialization qanday yaratiladi?
Manba adiabatic state preparation g‘oyasiga asoslangan boshlanishni:
\[ U_{\mathrm{ad}} = \prod_{d=1}^{D} e^{-i\frac{\tau}{D}H_0} e^{-i\frac{\tau}{D}\frac{d}{D}V} \tag{5} \]
ko‘rinishida beradi.
Bu yerda:
- \(H_0\): non-interacting Hamiltonian component,
- \(V\): interacting component,
- \(\tau\): effective adiabatic-evolution parameter,
- \(d/D\): qadam ilgarilagan sari interactionning ortib boruvchi fractional weighti,
- \(D\): discretization step soni.
Manba \(H_{\beta}\) va \(H_{\gamma}\) uchun boshlang‘ich parametrlarni:
\[ \beta_d^{(0)} = \gamma_d^{(0)} = \frac{\tau}{D} \langle V\rangle_{\mathrm{HF}} \frac{d}{D} \]
ko‘rinishida beradi.
\(H_{\alpha}\) boshlang‘ich parametriga oid manba jumlasida \(\alpha_d^{(0)}\), \(\tau/D\) va \(\langle H_\alpha\rangle_{\mathrm{HF}}\) birgalikda yozilgan; biroq chop etilgan PDF matnining bu qismida aniq tenglik belgisi ko‘rinmaydi. Shu sababli yetishmayotgandek ko‘ringan ramziy bog‘lanish Verianla tomonidan taxmin qilinib to‘ldirilmagan.
Random initialization esa:
\[ \theta_i^{(0)} \sim \mathcal U(0,1) \]
uniform distribution bilan bajarilgan.
Finite-Shot Sampling Noise Nima Uchun Energiya Landshaftini Buzadi?
Finite-shot sampling noise expectation value cheksiz o‘lchash o‘rtachasi o‘rniga cheklangan sondagi quantum measurement outcomelardan baholanishi sababli energiya bahosiga tasodifiy xato qo‘shadi; haqiqiy gradient kichik bo‘lsa, bu xato gradientni niqoblashi, teskari yo‘nalishni ko‘rsatishi, silliq vodiylarni sun’iy ravishda notekis qilishi va optimizerga aslida mavjud bo‘lmagan minimumlarni ko‘rsatishi mumkin.
Statevector bilan shot-based simulation o‘rtasidagi farq
StatevectorEstimator quantum state amplitudes orqali expectation valueni deterministik tarzda hisoblaydi. Finite-shot sampling variance mavjud emas.
Aer Estimator esa measurement outcomesni Born qoidasi bo‘yicha namunalaydi. Shot soni cheklangan bo‘lsa, ayni parameter point qayta o‘lchanganda ayni estimated energy chiqishi shart emas.
Manba asosiy benchmark uchun:
\[ N_{\mathrm{shots}}=6144 \]
ishlatgan.
Sampling variance umuman:
\[ \sigma^2\propto\frac{1}{N_{\mathrm{shots}}} \]
miqyosida kamayadi.
Shu sababli standard deviation taxminan:
\[ \sigma\propto\frac{1}{\sqrt{N_{\mathrm{shots}}}} \]
xatti-harakatini ko‘rsatadi. Boshqa shartlar bir xil bo‘lsa, shot sonini to‘rt baravar oshirish standard deviationni taxminan yarmiga kamaytiradigan square-root scaling bilan mos keladi.
Energy-landscape slicing qanday bajarildi?
Mualliflar avval yuqori aniqlikdagi sampling bilan:
\[ N_{\mathrm{shots}}\ge10^6 \]
sharoitida reference parameter set:
\[ \boldsymbol{\theta}^{\ast} \]
olgan.
Keyin tanlangan ikkita parameter direction uchun:
\[ \delta_i,\delta_j\in[-\Delta,\Delta] \]
grid bo‘ylab energiya qayta hisoblangan, boshqa parameters optimal reference valuesda o‘zgarmas saqlangan.
Shu tariqa bir xil asosiy energy surfacening turli shot counts sharoitida optimizer tomonidan qanday “ko‘rilishi” taqqoslangan.
Manbada kuzatilgan uchta asosiy landscape buzilishi
Manba Figure 2ning asosiy mazmunini uch mexanizm bilan umumlashtirish mumkin:
- False minima: finite-shot fluctuations sababli haqiqiy yuzada mavjud bo‘lmagan mahalliy past sohalar paydo bo‘lishi mumkin.
- Gradient reversal: noisy slope haqiqiy slopega teskari yo‘nalishni ko‘rsatishi mumkin.
- Noise-induced ruggedness: ayniqsa quasi-degenerate yoki flat valley tubida kichik haqiqiy gradient sampling fluctuations tomonidan bosib ketiladi.
Bunday sharoitlarda optimizer deterministic descent o‘rniga parameter space ichida stochastic drift yoki random-walkga o‘xshash harakat ko‘rsatishi mumkin.
Barren plateau nima?
Barren plateau — parameterized quantum circuitning cost-function gradientlari tizim kattalashgani sari nihoyatda kichiklashadigan va optimizer uchun mazmunli descent direction topish qiyinlashadigan tekis optimization landscape rejimidir.
Manba nazariy kontekstni:
\[ \ell_{\theta} = \langle\rho(\theta),O\rangle, \qquad \rho(\theta)\in\mathcal B(\mathcal H) \tag{6} \]
va:
\[ \operatorname{Var}_{\theta}(\ell_{\theta}) \in \mathcal O\left(\frac{1}{4^n}\right) \tag{7} \]
ifodalari bilan tushuntiradi.
Bu yerda:
- \(\rho(\theta)\): parameterized quantum state/operator representation,
- \(O\): observable,
- \(\ell_\theta\): observable expectationdan kelib chiqadigan loss,
- \(n\): qubit soni.
Hilbert-space dimension:
\[ \dim\mathcal H=2^n \]
va operator-space dimension:
\[ \dim\mathcal B(\mathcal H)=4^n \]
ko‘rinishida o‘sadi.
Manba 12-qubit LiH misoli uchun:
\[ 4^{12}=16\,777\,216\approx1.6\times10^7 \]
operator-space dimension kattaligini ta’kidlaydi.
Tenglama (6)–(7) bu benchmarkda o‘lchangan yangi empirical scaling natijasi emas, balki sampling noise bilan barren-plateau muammosi birgalikda nima uchun jiddiy bo‘lishi mumkinligini tushuntiruvchi nazariy doiradir.
Variatsion Prinsip Finite-Shot O‘lchashda Haqiqatan Buziladimi?
Exact quantum expectation value variatsion quyi chegarani buzmaydi; \(E(\theta)\ge E_0\) o‘z kuchida qoladi, biroq finite-shot measurementdan hisoblangan tasodifiy estimator \(\hat E\) haqiqiy expectation atrofida taqsimlangani uchun ayrim namunalarda \(E_0\)dan past ko‘rinishi mumkin va manba “variational-bound violation” iborasini shu ko‘rinadigan statistik buzilish uchun ishlatadi.
Exact energiya bilan estimated energiya bir xil narsa emas
Variatsion prinsip:
\[ E(\boldsymbol{\theta}) = \langle\psi(\boldsymbol{\theta})| H |\psi(\boldsymbol{\theta})\rangle \ge E_0 \]
deydi.
\(E_0\) exact ground-state energydir.
Finite-shot o‘lchashda optimizer ko‘radigan narsa esa:
\[ \hat E = E+\text{sampling fluctuation} \]
ko‘rinishidagi stochastic estimatordir.
Agar haqiqiy variational energy ground statega allaqachon juda yaqin bo‘lsa, manfiy sampling fluctuation qolgan energy gapdan katta bo‘lishi mumkin. Shunda:
\[ \hat E
ko‘rinishi mumkin.
Bu “yanada past fizik ground state topildi” degani emas.
Sampling noise matematik jihatdan qanday modellashtiriladi?
Manba Tenglama (8):
\[ \bar C(\boldsymbol{\theta}) = C(\boldsymbol{\theta}) + \epsilon_{\mathrm{sampling}} \tag{8} \]
ko‘rinishida.
Bu yerda:
- \(C(\theta)\): haqiqiy expectation-based objective,
- \(\bar C(\theta)\): finite-shot noisy estimate,
- \(\epsilon_{\mathrm{sampling}}\): meani nol deb qabul qilingan sampling error.
Manba:
\[ \operatorname{Var} (\epsilon_{\mathrm{sampling}}) = \frac{\operatorname{Var}[C(\theta)]} {N_{\mathrm{shots}}} \]
munosabatidan foydalanadi.
Hamiltonian variance qanday hisoblanadi?
\[ \hat H = \sum_k c_kP_k \]
uchun manba Tenglama (9):
\[ \operatorname{Var}[C(\theta)] = \langle\hat H^2\rangle - \langle\hat H\rangle^2. \tag{9} \]
Bu observable ikkinchi momenti bilan expectation value kvadrati orasidagi farqdir.
Manba, shuningdek, Pauli-term shot noisega qo‘shimcha ravishda ayni commuting measurement groups ichidagi covariance contributions ham estimator variancega hissa qo‘shishini ta’kidlaydi.
Sampling noise floor qanday aniqlanadi?
Manba optimization trajectory bo‘ylab effective noise floorni:
\[ \sigma_{\mathrm{noise}} \approx \sqrt{ \frac{1}{N} \sum_{i=1}^{N} \frac{ \operatorname{Var}[C(\theta_i)] }{ N_{\mathrm{shots}} } } \tag{10} \]
deb baholaydi.
Bu yerda \(N\) trajectory bo‘ylab baholangan nuqtalar sonidir.
Noise floorga yaqinlashganda optimizerning pastroq observed energy topishi endi albatta yaxshiroq parameters topganini anglatmaydi; measured differences noise magnitude bilan bir xil miqyosga tushgan bo‘lishi mumkin.
Figure 3da shot soni bilan noise floor qanday o‘zgaradi?
| Shot soni | Noise floor (Ha) | Ma’lumot holati |
|---|---|---|
| 8 | ±6,7 × 10⁻² | Manba Figure 3 yorlig‘i |
| 16 | ±4,2 × 10⁻² | Manba Figure 3 yorlig‘i |
| 32 | ±2,5 × 10⁻² | Manba Figure 3 yorlig‘i |
| 64 | ±1,7 × 10⁻² | Manba Figure 3 yorlig‘i |
| 512 | ±6,0 × 10⁻³ | Manba Figure 3 yorlig‘i |
| 1024 | ±4,0 × 10⁻³ | Manba Figure 3 yorlig‘i |
| 6144 | ±1,6 × 10⁻³ | Manba Figure 3 yorlig‘i |
| 12.000 | ±1,2 × 10⁻³ | Manba Figure 3 yorlig‘i |
| 30.000 | ±7,3 × 10⁻⁴ | Manba Figure 3 yorlig‘i |
Shot soni oshgani sari noise floor kamayadi; biroq \(1/\sqrt{N_{\mathrm{shots}}}\) xarakteridagi scaling sababli ayni mutlaq yaxshilanishga erishish uchun tobora ko‘proq shot talab etiladi. Mualliflarning “taxminan 1000 shotdan keyin diminishing returns” degan bahosi yaxshilanish butunlay to‘xtaydi degani emas, balki har bir qo‘shimcha shotga to‘g‘ri keladigan chegaraviy aniqlik yutug‘i kamayishini anglatadi.
Population Mean Nima Uchun Bitta “Eng Yaxshi” Nomzoddan Ishonchliroq Bo‘lishi Mumkin?
Sampling noise taxminan simmetrik bo‘lsa, population ichidagi ko‘plab nomzodlarning o‘rtachasi musbat va manfiy measurement fluctuationsni o‘zaro so‘ndirishi mumkin; aksincha, faqat eng past o‘lchangan nomzodni tanlash katta population ichida tasodifan haddan tashqari past o‘lchangan “good outlier”ni tanlash ehtimolini oshirib, optimizerning noiseni haqiqiy taraqqiyot deb qabul qilishiga olib kelishi mumkin.
Population kattalashganda ikki qarama-qarshi ta’sir bir vaqtda yuz berishi mumkin
Ushbu tadqiqotning muhim nozik jihatlaridan biri:
- Best-value selection: population kattalashgani sari juda past lucky noise sample topish ehtimoli ortishi mumkin.
- Population mean: population kattalashgani sari mustaqil/cheklangan korrelyatsiyali fluctuations o‘rtachada bir-birini yaxshiroq kompensatsiya qilishi mumkin.
Manba population-average estimation error uchun:
\[ \mathrm{Error} \propto \frac{\sigma_{\mathrm{noise}}}{\sqrt{\lambda}} \]
masshtabidan foydalanadi.
Bu yerda \(\lambda\) — population size.
Bu ifodani “sampling noisening fizik fundamental chegarasi buzildi” deb talqin qilmaslik kerak. Ko‘proq population member orqali statistik ma’lumot birlashtirilgani sababli mean estimate bitta noisy evaluationga qaraganda aniqroq bo‘ladi.
Manba taqqoslagan uchta noise-floor strategiyasi
- Shot escalation: har bir evaluation uchun shot sonini oshirish.
- Selective high-shot reevaluation: ko‘rinishda eng yaxshi candidatesni yuqori shot bilan qayta o‘lchash.
- Population averaging: CMA-ES steady-state population statisticsdan foydalanish.
Shot escalation varianceni to‘g‘ridan-to‘g‘ri kamaytiradi, ammo xarajatni oshiradi. Selective reevaluation tanlangan nomzod allaqachon lucky outlier bo‘lsa selection bias xavfini tug‘diradi. Population mean esa sampling fluctuations simmetriyasidan foydalanib, bitta minimum kuzatuvining biasini kamaytirishga qaratilgan.
Mualliflar CMA-ESning noise floor belgilaydigan steady-state distributionga yaqinlasha olishidan foydalanadi; biroq bu global ground-state optimumga erishishni kafolatlamasligini ham ochiq aytadi.
Population size bo‘yicha qo‘shimcha tahlil nimani ko‘rsatdi?
Appendix C:
\[ \lambda=7,\ 25,\ 50,\ 100 \]
population sizes uchun qo‘shimcha tahlil beradi.
\(\lambda=7\) sharoitida ham iteration mean bitta best-value selectionga qaraganda pastroq xato tendensiyasini ko‘rsatadi.
\(\lambda=25\) va ayniqsa \(\lambda=50\) sharoitlarida population mean theoretical/empirical noise floorga ancha yaqin harakat qiladi.
\(\lambda=100\) uchun 30.000-shot rejimida manba taxminan iteration 5 atrofida tez zero-error yaqiniga kelganini, taxminan iteration 20gacha shu sohada qolganini va keyin noise-induced divergence/overfitting belgilarining paydo bo‘lganini bildiradi.
Shu sababli tadqiqot “population qancha katta bo‘lsa, doimo shuncha yaxshi” degan xulosaga kelmaydi. Mualliflar optimal population-size window bo‘lishi mumkinligini taklif qiladi, biroq barcha muammolar uchun amal qiladigan yagona optimal \(\lambda\) qiymatini belgilamaydi.
Tadqiqot Usuli va Natijalari
Benchmark klassik high-performance computing infratuzilmasida simulyatsiya qilingan tVHA circuits ustida sakkiz classical optimizerning exact statevector va finite-shot sampling sharoitidagi xatti-harakatini Hartree–Fock va random initialization variantlari bilan taqqoslaydi.
Molekulyar tizimlar
| Xususiyat | H2 | LiH Active Space | LiH Full Space | H4 Zanjiri |
|---|---|---|---|---|
| Bond length / distances (Å) | 0,74279 | 1,596 | 1,596 | 0,7; 0,7; 0,768 |
| Charge | 0 | 0 | 0 | 0 |
| Multiplicity | 1 | 1 | 1 | 1 |
| Basis set | STO-3G | STO-3G | STO-3G | STO-3G |
| Active space | Full | (2,2), 3 orbital | Full | Full |
Manbadagi footnote LiH active-space uchun orbitals [1,2,3] va 2 alpha + 2 beta electrons iborasini ishlatadi. Bu ifoda manbada berilgan ko‘rinishda saqlangan.
STO-3G basis set nimani anglatadi?
STO-3G molekulyar orbital calculationsda ishlatiladigan minimal Gaussian basis familydir. Manba uni barcha tizimlarda bir xil basis sifatida ishlatib, optimizer taqqoslashini ayni asosiy electronic-structure approximation doirasida olib boradi.
Active-space reduction nima uchun muhim?
Active-space yondashuvi barcha molecular orbitals o‘rniga electron correlation nuqtai nazaridan muhim tanlangan orbitals ustida hisoblaydi. Shu yo‘l bilan:
- qubit/circuit talabi,
- parameter-space o‘lchami,
- optimizer ko‘rib chiqishi kerak bo‘lgan effective landscape
kamaytirilishi mumkin.
Biroq active-space natijasi full molecular Hilbert-space yechimi bilan ayni muammo emas. Manba LiH active-space noise robustnessni oshirishini ko‘rsatsa-da, buni “full LiH muammosi to‘liq va aniqroq yechildi” deb talqin qilish to‘g‘ri emas.
Taqqoslangan optimizerlar
| Optimizer | Manba tasnifi | Asosiy ishlash mantiqi |
|---|---|---|
| BFGS | Gradient-based | Inverse-Hessian approximation bilan quasi-Newton yangilanishi |
| CMA-ES | Metaheuristic / evolutionary | Candidate population va adaptive multivariate Gaussian covariance |
| COBYLA | Gradient-free | Objective va constraints uchun local linear approximations va trust-region yondashuvi |
| GD | Gradient-based | Negative gradient direction bo‘ylab parameter update |
| Nelder–Mead | Gradient-free | Simplex reflection, expansion, contraction va shrink amallari |
| PSO | Metaheuristic / swarm | Particles individual-best va global-best ma’lumotlariga qarab harakat qiladi |
| SLSQP | Gradient-based | Sequential quadratic programming va constrained local approximation |
| SPSA | Manba Table 3da gradient-free | Barcha parametersni bir vaqtning o‘zida perturb qilib, ikki function evaluation orqali stochastic gradient estimate |
SLSQP tasnifi bo‘yicha izoh: Manbaning Introduction bo‘limida COBYLA va SLSQP “derivative-free techniques” iborasi ostida birga tilga olinadi. Bunga qarshi Appendix A va Table 3 SLSQPni gradient-based method sifatida tasniflaydi va sequential quadratic programming tuzilishini tushuntiradi. Verianla asosiy jadvalda batafsilroq Appendix A/Table 3 tasnifidan foydalangan va Introductiondagi farqli iborani yashirmagan.
Nechta mustaqil simulation ishga tushirildi?
Har bir optimizer–molecule juftligi uchun to‘rtta configuration va har bir configuration uchun 10 run mavjud:
| Ssenariy | Initialization | Energy evaluation |
|---|---|---|
| 1 | Hartree–Fock | Statevector |
| 2 | Hartree–Fock | 6144-shot sampling |
| 3 | Random | Statevector |
| 4 | Random | 6144-shot sampling |
Jami:
\[ 1280 \]
ta mustaqil run bajarilgan.
Pseudo-random seeds qat’iy belgilanmagan. Manbaga ko‘ra, shu tariqa starting points, optimizerning stochastic stepslari va shot sampling har bir trialda mustaqil stochastic draw sifatida yuz bergan.
Bu tanlov ensemble-level robustnessni baholash nuqtai nazaridan mazmunli; biroq bitta runni bit-bit qayta ishlab chiqishni qat’iy seed ishlatilgan holatga qaraganda qiyinlashtiradi.
Optimizer hyperparameters qanday tanlandi?
Manba optimizer hyperparameters molecule bo‘yicha alohida tune qilinmaganini; tegishli implementationsning keng tarqalgan defaults qiymatlari tanlanganini bildiradi. Maqsad usullar o‘rtasidagi case-by-case tuning biasni kamaytirishdir.
Buning o‘rniga Appendix E stopping/convergence criteria uchun aniq tolerantliklarni beradi.
Convergence criteria
| Optimizer | Manba parametri | Manba criterion |
|---|---|---|
| BFGS | \(ftol=10^{-10}\) | \(\frac{f_k-f_{k+1}}{\max(|f_k|,|f_{k+1}|,1)}\le ftol\) |
| COBYLA | \(tol=10^{-7}\) | \(\Delta f_k=|f_{k+1}-f_k|\le tol\) |
| GD | \(tol=5\times10^{-4}\) | \(\|\theta_{k+1}-\theta_k\|\le tol\) |
| CMA-ES | \(tolx=10^{-12}\), \(tolfun=10^{-12}\) | \(\max_i\sigma_i\le tolx\) va population objective range \(\le tolfun\) |
| Nelder–Mead | \(xatol=10^{-6}\) | \(\|x_{k+1}-x_k\|\le xatol\) |
| PSO | velocity threshold \(10^{-5}\), cluster threshold 1 | Unclustered-particle count va maximum velocity birga chegaradan pastga tushganda |
| SLSQP | \(ftol=10^{-10}\) | BFGS bilan bir xil normalized function-change shakli |
| SPSA | \(N=100\), \(allowed\_increase=10^{-3}\) | Oxirgi 100 objective value uchun fitted trend slope musbat bo‘lganda stagnation/termination nazorati |
Appendix Edagi SPSA slope mezoni
Manba Tenglama (18):
\[ \mathrm{slope} = \frac{1}{N} \frac{df_k}{dk} > 0 \tag{18} \]
ifodasidan foydalanadi.
Slope oxirgi \(N=100\) objective values ustida linear regression bilan aniqlanadi.
Reproducibility bo‘shlig‘i: Manba barcha optimizers uchun maximum function-evaluation limiti bir xil ekanini bildiradi; biroq yuklangan manuscript matnida ushbu umumiy maximumning sonli qiymati ko‘rinadigan tarzda hisobot qilinmagan. 11-sahifada ham “running up to optimization iterations” iborasida iteration soni yetishmaydi. Bu qiymat Verianla tomonidan taxmin qilinmagan.
Dasturiy ta’minot stacki
| Python library | Versiya |
|---|---|
| qiskit | 1.0.2 |
| qiskit_algorithms | 0.3.1 |
| qiskit_nature | 0.7.2 |
| qiskit_aer | 0.14.2 |
| pyscf | 2.6.0 |
| scipy | 1.15.2 |
| cma | 3.3.0 |
Hisoblash infratuzilmasi
Simulyatsiyalar IT4Innovations Barbora supercomputerda bajarilgan. Manba tizimni:
- 192 standard node: har bir node uchun 2 × 18-core Intel Xeon va 192 GB RAM,
- 8 GPU node: 2 × 12-core Intel Xeon + 4 × NVIDIA V100,
- 1 fat node: 8 × 16-core Intel Xeon + 6 TB RAM,
- 200 Gb/s Infiniband HDR,
- 310 TB SCRATCH storage va 28 GB/s throughput
deb tavsiflaydi.
Runs job-level embarrassingly parallel tarzda Slurm jobs sifatida taqsimlangan. LiH va H4 uchun 5–10 concurrent run guruhlari ishlatilgan.
Manba jami computational consumptionni taxminan:
\[ 4500\ \text{node-hour} \]
deb hisobot qiladi.
High-shot reevaluation nima uchun bajarilgan?
Noisy optimizer ba’zan lucky sampling fluctuation tufayli aslida bo‘lganidan juda yaxshi ko‘rinadigan candidate parametersni tanlashi mumkin. Figure 4–7 captions optimization vaqtida topilgan candidate parameters:
\[ 10^5\ \text{shot} \]
bilan qayta baholanganini ko‘rsatadi.
High-shot reevaluation optimizerning o‘zini qayta ishga tushirish emas. Maqsad ayni parameter point energiyasini pastroq sampling variance bilan qayta o‘lchab, ko‘rinadigan muvaffaqiyat haqiqiy parameter qualitydanmi yoki low-shot fluctuationdanmi kelib chiqqanini ajratishdir.
H2 natijalari
Shovqinsiz statevector sharoitida H2 eng oson benchmarkdir.
Manba:
- BFGS, CMA-ES, COBYLA, Nelder–Mead va PSO uchun taxminan \(10^{-13}\)–\(10^{-14}\) Hadan past errors,
- GD + HF uchun taxminan \(10^{-6}\) Ha,
- SPSA uchun taxminan \(3\times10^{-5}\) Ha
hisobot qiladi.
Bu rejimda usullar o‘rtasidagi asosiy farq final accuracydan ko‘ra convergence speeddir.
Sampling noise ostida high-shot corrected values uchun manba:
| Optimizer / sharoit | Hisobot qilingan xato (Ha) |
|---|---|
| GD + HF | 6,6 × 10⁻⁴ |
| SPSA + HF | 4,1 × 10⁻⁴ |
| CMA-ES | 4,5 × 10⁻⁴ |
| COBYLA | 2,4 × 10⁻³ |
| Nelder–Mead + HF | 3,9 × 10⁻³ |
| BFGS | taxminan 4 × 10⁻³ |
| PSO random | 6,5 × 10⁻⁴ |
| PSO HF | 1,0 × 10⁻³ |
SLSQP sampling-noise sharoitida H2da ham ishonchli converge qilmagan.
Manba ichidagi tartiblash ogohlantirishi: Manba matni “lowest corrected mean errors come from GD ... followed by SPSA ... and CMA-ES” deb yozadi. Ammo berilgan sonlar taqqoslanganda:
\[ 4.1\times10^{-4} < 4.5\times10^{-4} < 6.6\times10^{-4}. \]
Demak sonli kattalik tartibi SPSA, CMA-ES, GD ko‘rinishidadir. Verianla manba jumlasini o‘z qarori bilan qayta tartiblab “manba shunday dedi” deya taqdim etmaydi; matndagi ifoda ham, sonli qiymatlar ham ko‘rinadigan tarzda saqlanadi.
H4 natijalari
H4 chain yanada murakkab Hamiltonian va optimization landscape hosil qiladi.
Statevector sharoitida manba:
- BFGS, COBYLA va SLSQP uchun taxminan \(7\times10^{-3}\) Ha,
- GD uchun taxminan \(2,5\times10^{-2}\) Ha
xato darajalarini bildiradi.
Sampling-noise high-shot reevaluationdan so‘ng:
| Optimizer | Hisobot qilingan corrected mean error (Ha) |
|---|---|
| CMA-ES + HF | 2,25 × 10⁻² |
| PSO | 2,7 × 10⁻² |
| GD | 3,01 × 10⁻² |
| SPSA | taxminan 3,5–3,8 × 10⁻² oralig‘ida |
| COBYLA | taxminan 3,5–3,8 × 10⁻² oralig‘ida |
| BFGS | >4,5 × 10⁻² |
| Nelder–Mead | >4,5 × 10⁻² |
Manba ichidagi tartiblash ogohlantirishi: Matn CMA-ESdan keyin “GD va PSO” tartibini beradi; biroq berilgan sonlarda PSOning \(2,7\times10^{-2}\) Ha qiymati GDning \(3,01\times10^{-2}\) Ha qiymatidan kichik.
LiH full-space natijalari
Manba statevector sharoitida BFGS, CMA-ES, COBYLA, Nelder–Mead va SPSA taxminan:
\[ 4\times10^{-3}\ \mathrm{Ha} \]
atrofiga yetganini, GD taxminan \(2\times10^{-2}\) Ha va PSO taxminan \(9\times10^{-3}\) Ha darajasida qolganini bildiradi.
Manba ayni jumlada birinchi guruh uchun “sub-millihartree precision” iborasini ishlatadi.
Biroq:
\[ 4\times10^{-3}\ \mathrm{Ha} = 4\ \mathrm{mHa}. \]
“Sub-millihartree” matematik jihatdan 1 mHadan kichik, ya’ni \(10^{-3}\) Hadan past degani. Demak manbada ishlatilgan sifatlovchi bilan ayni jumlada berilgan taxminiy \(4\times10^{-3}\) Ha soni o‘zaro mos emas. Verianla sonni asos qilib, buni yashirmaydi.
Sampling noise + high-shot reevaluation:
| Optimizer / sharoit | Hisobot qilingan xato |
|---|---|
| CMA-ES + HF | ~8,0 mHa |
| CMA-ES random | ~10,5 mHa |
| PSO + HF | ~13,2 mHa |
| PSO random | ~13,6 mHa |
| SPSA + HF | ~16 mHa |
| GD | ~19 mHa |
| BFGS + HF | ~19,7 mHa |
| BFGS random | ~22,2 mHa |
| COBYLA / Nelder–Mead | taxminan 20 mHa darajasi |
Full-space LiH larger parameter-space sharoitida population-based CMA-ES sampling noise ostida eng izchil natija bergan tizimlardan biridir.
LiH active-space natijalari
Active-space reduction optimization muammosini sezilarli yengillashtiradi.
Statevector sharoitida CMA-ES, PSO, Nelder–Mead va SPSA:
\[ <2\times10^{-4}\ \mathrm{Ha} \]
darajasiga yetadi.
BFGS va COBYLA ham taxminan \(2\times10^{-4}\) Ha atrofida.
Sampling-noise high-shot reevaluation:
| Optimizer / sharoit | Hisobot qilingan xato |
|---|---|
| CMA-ES + HF | 2,6 × 10⁻⁴ Ha |
| SPSA | 3,9 × 10⁻⁴ Ha |
| PSO | 4,2 × 10⁻⁴ Ha |
| Nelder–Mead + HF | 5,3 × 10⁻⁴ Ha |
| COBYLA / BFGS | ~8 × 10⁻⁴–1,1 × 10⁻³ Ha |
| GD | bir necha mHa |
| SLSQP | >3 × 10⁻¹ Ha |
Manba keyingi literature-comparison paragrafida SPSA + HF uchun \(6,5\times10^{-4}\) Ha va 486 function evaluationni ham hisobot qiladi. Section 6ning high-shot natijalar paragrafida esa \(3,9\times10^{-4}\) Ha yozilgan. Manba bu ikki son turli evaluation stage, aggregation yoki reporting choicedan kelib chiqqanmi, ochiq tushuntirmaydi. Shu sababli ikki qiymat majburan birlashtirilmagan.
Full LiH bilan active-space LiH o‘rtasidagi asosiy farq
Manba active-space reduction optimizer demand va noise sensitivityni taxminan bir order of magnitude kamaytirishini bildiradi.
Discussion bo‘limida COBYLA sampling uchun active-space truncationdan so‘ng:
\[ 95.2\% \]
error reduction hisobot qilinadi.
Bu foiz muayyan LiH/COBYLA comparisonga tegishli; uni barcha optimizers, molekulalar yoki haqiqiy quantum hardware uchun umumiy %95,2 yaxshilanish deb talqin qilmaslik kerak.
Figure 8 nimani ko‘rsatadi?
Manba Figure 8 to‘rtta tizimning barcha optimizers uchun final errors qiymatlarini oltita evaluation category ko‘rinishida taqqoslaydi:
- Random Init Statevector,
- HF Init Statevector,
- Random Init Sampling Noise,
- HF Init Sampling Noise,
- Random-Sampling High-Shot Reevaluation,
- HF-Sampling High-Shot Reevaluation.
Bars mean final errorni, error bars esa manba captionga ko‘ra %95 confidence interval qiymatlarini ifodalaydi.
Manba Figure 8dagi barcha bar heights qiymatlarini alohida numeric table sifatida hisobot qilmaydi. Shu sababli Verianla grafikdan piksel o‘qib, soxta aniqlikdagi yangi sonlarni yaratmagan.
Manbaning asosiy optimizer natijasini qanday umumlashtirish kerak?
| Sharoit | Manbada ajratib ko‘rsatilgan xatti-harakat | Talqin chegarasi |
|---|---|---|
| Kichik tizim + statevector | BFGS va deterministic/gradient methods tez va yuqori aniqlikda | Noise yo‘q; hardware xatti-harakati emas |
| Finite-shot sampling | Gradient/curvature information buziladi | Faqat sampling noise sinovdan o‘tkazilgan |
| Kattaroq parameter space | CMA-ES, PSO, SPSA barqarorroq bo‘ladi | Har bir system uchun bitta universal tartib yo‘q |
| Active-space LiH | Optimization osonlashadi va noise sensitivity kamayadi | Muammo full-space LiH bilan ayni state space emas |
| Population mean | Best-value selectionga qaraganda symmetric sampling noiseni yaxshiroq bostirishi mumkin | Global optimum kafolati emas |
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- Optimizer ranking sampling noise mavjudligiga kuchli bog‘liq.
- Shovqinsiz kichik tizimlarda gradient/quasi-Newton usullari juda samarali bo‘lishi mumkin.
- Finite-shot sampling gradient va curvature estimatesni buzishi mumkin.
- SLSQP tested sampling-noise sharoitlarida jiddiy divergence ko‘rsatgan.
- BFGS noiseless sharoitdagi kuchli ustunligini sampling noise ostida katta darajada yo‘qotgan.
- CMA-ES, PSO va SPSA larger/noisy benchmarklarda izchilroq bo‘lgan.
- Hartree–Fock initialization kichik tizimlarda ko‘pincha yordam beradi, biroq uning ustunligi complexity bilan kamayadi.
- Random initialization ayrim population-based methods uchun HFga teng yoki undan yaxshi bo‘lishi mumkin.
- Active-space reduction LiHda optimization va noise robustnessni sezilarli yaxshilagan.
- Finite-shot energy estimates exact ground-state lower bounddan past ko‘rinishi mumkin.
- High-shot reevaluation low-shot “yaxshi” natijalarning bir qismi sampling artifact ekanini ko‘rsatgan.
- Population mean single best candidate selectionga qaraganda noise-overfitting xavfini kamaytirishi mumkin.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
- Tadqiqot haqiqiy quantum computerda sakkiz optimizerga benchmark o‘tkazmagan.
- CMA-ES barcha VQE muammolarida mutlaq eng yaxshi optimizer ekani ko‘rsatilmagan.
- Sampling noise fizik jihatdan ground-state energydan past haqiqiy quantum states hosil qilishi ko‘rsatilmagan.
- Variational principle exact expectation qiymatlari uchun rad etilmagan.
- Gate infidelity, coherent error, depolarizing noise, amplitude damping, thermal relaxation yoki readout error benchmark qilinmagan.
- Optimizer tartibi haqiqiy hardware noise ostida ayni qolishi isbotlanmagan.
- Quantum computational speedup yoki quantum advantage ko‘rsatilmagan.
- STO-3G va o‘rganilgan kichik molecular systems natijalarini katta kimyoviy tizimlarga avtomatik umumlashtirish mumkin emas.
- Population size oshgani sari samaradorlik cheksiz yaxshilanishi ko‘rsatilmagan.
- Source Table 2dagi “hardware uchun mos” kabi optimizer tavsiyalari bevosita hardware benchmark natijasi emas.
Tadqiqotning asosiy cheklovlari
Manba va usul birga baholanganda asosiy cheklovlar quyidagilar:
- Quantum circuits klassik kompyuter/HPCda simulyatsiya qilingan.
- Asosiy noisy condition faqat finite-shot sampling noisedir.
- Real-device gate/readout/calibration noise kiritilmagan.
- STO-3G minimal basis ishlatilgan.
- O‘rganilgan molecular systems H2, H4 va LiH bilan cheklangan.
- Random seeds qat’iy emas.
- Barcha optimizer hyperparameters molecule-specific tuningdan o‘tkazilmagan.
- Common maximum function-evaluation sonining numeric qiymati manuscript matnida ko‘rinadigan tarzda hisobot qilinmagan.
- Figure 8dagi barcha bar values numeric table ko‘rinishida berilmagan.
- tVHA truncation circuit depthni kamaytirayotganda reachability deficit hosil qilishi mumkin.
- CMA-ES steady-state stability global optimum kafolati emas.
Kelajakdagi tadqiqot yo‘nalishlari
Mualliflar kelajakda:
- fast gradient search bilan population methods o‘rtasida noise-adaptive switching,
- measured noise floorga ko‘ra dynamic shot allocation,
- noise-aware stopping rules,
- thermal relaxation,
- amplitude damping,
- readout assignment errors,
- hardware-backed calibration
kabi realistikroq noise conditions va hybrid optimization strategiesni tadqiq qilishni taklif etadi.
Manba va Usul Haqida Izoh
Asl sarlavha: Numerical Optimization Strategies for the Variational Hamiltonian Ansatz in Noisy Quantum Environments
Mualliflar: Silvie Illésová; Vojtěch Novák; Tomáš Bezděk; Clemens Possel; Martin Beseda.
Mualliflar tartibi: Manbadagi tartib saqlangan.
Teng hissa: Yuklangan v4 PDFda ochiq equal-contribution/equal-first-author bayonoti ko‘rinmaydi.
Corresponding author: Martin Beseda.
Corresponding-author e-pochta: martin.beseda@univaq.it
Muassasa 1: Gran Sasso Science Institute, L’Aquila, Italy.
Muassasa 2: Department of Applied Mathematics, Faculty of Electrical Engineering and Computer Science, VSB-Technical University of Ostrava, Ostrava, Czech Republic.
Muassasa 3: IT4Innovations National Supercomputing Center, VSB–Technical University of Ostrava, Ostrava, Czech Republic.
Muassasa 4: Department of Computer Science, Faculty of Electrical Engineering and Computer Science, VSB–Technical University of Ostrava, Ostrava, Czech Republic.
Muassasa 5: Department of Mathematics, TUM School of Computation, Information and Technology, Technical University of Munich, Garching bei München, Germany.
Muassasa 6: Fraunhofer Institute for Chemical Technology ICT, Pfinztal, Germany.
Muassasa 7: Department of Physics, Saarland University, Saarbrücken, Germany.
Muassasa 8: Department of Information Engineering, Computer Science and Mathematics, University of L’Aquila, L’Aquila, Italy.
Platforma: arXiv.
arXiv: arXiv:2505.22398v4 [quant-ph].
Birinchi arXiv topshirig‘i: 28-may 2025.
Yuklangan versiya: v4, 22-yanvar 2026.
DOI: 10.48550/arXiv.2505.22398.
Rasmiy havola: https://arxiv.org/abs/2505.22398
Manba turi: Nazariy/hisoblashga oid quantum-chemistry va numerical-optimization preprint/manuscript.
Taqriz holati: Yuklangan manba arXiv preprint versiyasidir. PDF IOP Publishing manuscript templatedan foydalanadi; biroq Journal Name, volume/year/article-number va received/revised dates placeholder holatida. Ushbu ko‘rib chiqishda exact title uchun tasdiqlangan yakuniy taqrizdan o‘tgan journal publication qaydi aniqlanmagani sababli maqola taqrizlangan final nashr sifatida taqdim etilmagan.
IOP shablon izohi: PDFda “Journal vv (yyyy) aaaaaa”, “Journal Name”, “dd Month yyyy” kabi placeholders mavjud. Ular haqiqiy bibliografik journal metadata sifatida ishlatilmagan.
Fayl identifikatsiyasi izohi: Yuklangan fayl nomi Research Square DOI formatidagi iborani o‘z ichiga olsa-da, PDFning ichki identifikatsiyasi arXiv:2505.22398v4, PDF metadata DOI esa 10.48550/arXiv.2505.22398. Research Square qaydi ushbu ko‘rib chiqishda ishonchli rasmiy sahifadan alohida tasdiqlanmagani sababli asosiy DOI sifatida ishlatilmagan.
Litsenziya: PDF metadata Creative Commons Attribution 4.0 International (CC BY 4.0) litsenziyasini ko‘rsatadi.
Kalit so‘zlar: Variational Quantum Eigensolver; Noisy optimization; CMA-ES; Truncated Variational Hamiltonian Ansatz; Quantum chemistry.
Tadqiqot turi: Classical HPC ustida quantum-circuit simulation va optimizer benchmarking.
Haqiqiy quantum hardware: Ishlatilmagan.
Asosiy noise modeli: Finite-shot sampling noise.
Kiritilmagan noise turlari: coherent/stochastic gate errors, thermal relaxation, amplitude damping va readout bias asosiy benchmark-ga kiritilmagan.
Molekulyar tizimlar: H₂, linear H₄ chain, LiH full space, LiH active space.
Basis: STO-3G.
Hamiltonian mapping: Jordan–Wigner.
tVHA truncation: \(p=0.999\), ya’ni manba talqiniga ko‘ra non-Coulomb two-body interaction strength-ning cumulative %99,9 qismi saqlanadi.
Asosiy sampling budget: 6144 shot / function evaluation.
Landscape reference sampling: \(N_{\mathrm{shots}}\ge10^6\).
High-shot reevaluation: Figure 4–7-da \(10^5\) shot.
Mustaqil run soni: 1280.
Random seeds: Qat’iy belgilanmagan.
Optimizer tuning: Manba case-by-case hyperparameter optimization o‘rniga keng qo‘llanadigan implementation defaults ishlatilganini bildiradi; alohida stopping tolerances Appendix E-da hisobot qilingan.
Hisoblash infratuzilmasi: Barbora supercomputer, Bull Sequana X cluster; jami taxminan 4500 node-hour.
Dasturiy ta’minot: Qiskit 1.0.2; qiskit_algorithms 0.3.1; qiskit_nature 0.7.2; qiskit_aer 0.14.2; PySCF 2.6.0; SciPy 1.15.2; cma 3.3.0.
Data Availability: Hisoblangan natijalar va ularni hosil qilgan scripts Zenodo-da public tarzda ulashilgan.
Zenodo DOI: 10.5281/zenodo.15526170.
Conflict of Interest: Mualliflar ma’lum competing financial interests yoki personal relationships mavjud emasligini bildiradilar.
Ethical Statement: Human participants, human data yoki animal experimentation bo‘lmagani sababli ethical approval talab etilmagan.
Funding / qo‘llab-quvvatlash: Clemens Possel Baden-Württemberg Ministry of Economic Affairs, Labour and Tourism tomonidan QC-4-BW, QC-4-BW II va KQCBW24 loyihalari orqali qo‘llab-quvvatlangan. Tomáš Bezděk SGS No. SP2025/049, Vojtěch Novák SGS No. SP2025/072 ko‘magini olgan. Tadqiqot shuningdek Czech Ministry of Education, Youth and Sports tomonidan e-INFRA CZ ID:90254 orqali qo‘llab-quvvatlangan.
Muallif hissalari: Manbada alohida CRediT author-contribution breakdown keltirilmagan.
Statistika: Har bir configuration uchun 10 independent run bajarilgan. Figure 8 mean final errors va %95 confidence intervals ko‘rsatadi. Manbada optimizer juftlari uchun keng qamrovli formal p-value significance-testing jadvali hisobot qilinmagan.
Equation (2) notatsiyasi: Coulomb term-da yig‘indi \(\sum_{ij}\) ko‘rinishida bo‘lsa-da, coefficient \(g_{ijk\ell}\) tarzida to‘rtta indeksga ega. Manba bu yozuvni alohida izohlamaydi; Verianla tenglama indekslarini taxmin bilan o‘zgartirmagan.
H₂ natijalari tartibi haqida qayd: Manba GD + HF \(6,6\times10^{-4}\) Ha-ni “lowest” deb avval yozadi, biroq SPSA + HF \(4,1\times10^{-4}\) Ha va CMA-ES \(4,5\times10^{-4}\) Ha sifatida kichikroq numeric values hisobot qiladi.
H₄ tartib qaydi: Matn CMA-ES-dan keyin GD va PSO tartibini qo‘llaydi, ammo berilgan PSO qiymati \(2,7\times10^{-2}\) Ha, GD qiymati \(3,01\times10^{-2}\) Ha-dir.
LiH unit-language qaydi: Full-space statevector paragrafi taxminan \(4\times10^{-3}\) Ha qiymatlarni “sub-millihartree” deb tavsiflaydi; \(4\times10^{-3}\) Ha = 4 mHa bo‘lgani uchun son bilan tavsif mos kelmaydi.
SLSQP tasniflash qaydi: Introduction-da derivative-free methods kontekstida tilga olinadi, Appendix A va Table 3-da esa gradient-based constrained optimizer sifatida ta’riflanadi.
SPSA active-space qaydi: Main result paragraph \(3,9\times10^{-4}\) Ha high-shot result bersa, keyingi literature-comparison paragraph \(6,5\times10^{-4}\) Ha va 486 function evaluations qiymatini beradi. Manba farqni batafsil izohlamaydi.
Maximum function-evaluation qaydi: Barcha optimizers uchun bir xil maximum limit ishlatilgani aytiladi, ammo yuklangan manuscript text-da umumiy sonli maksimum aniq ko‘rinmaydi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan