


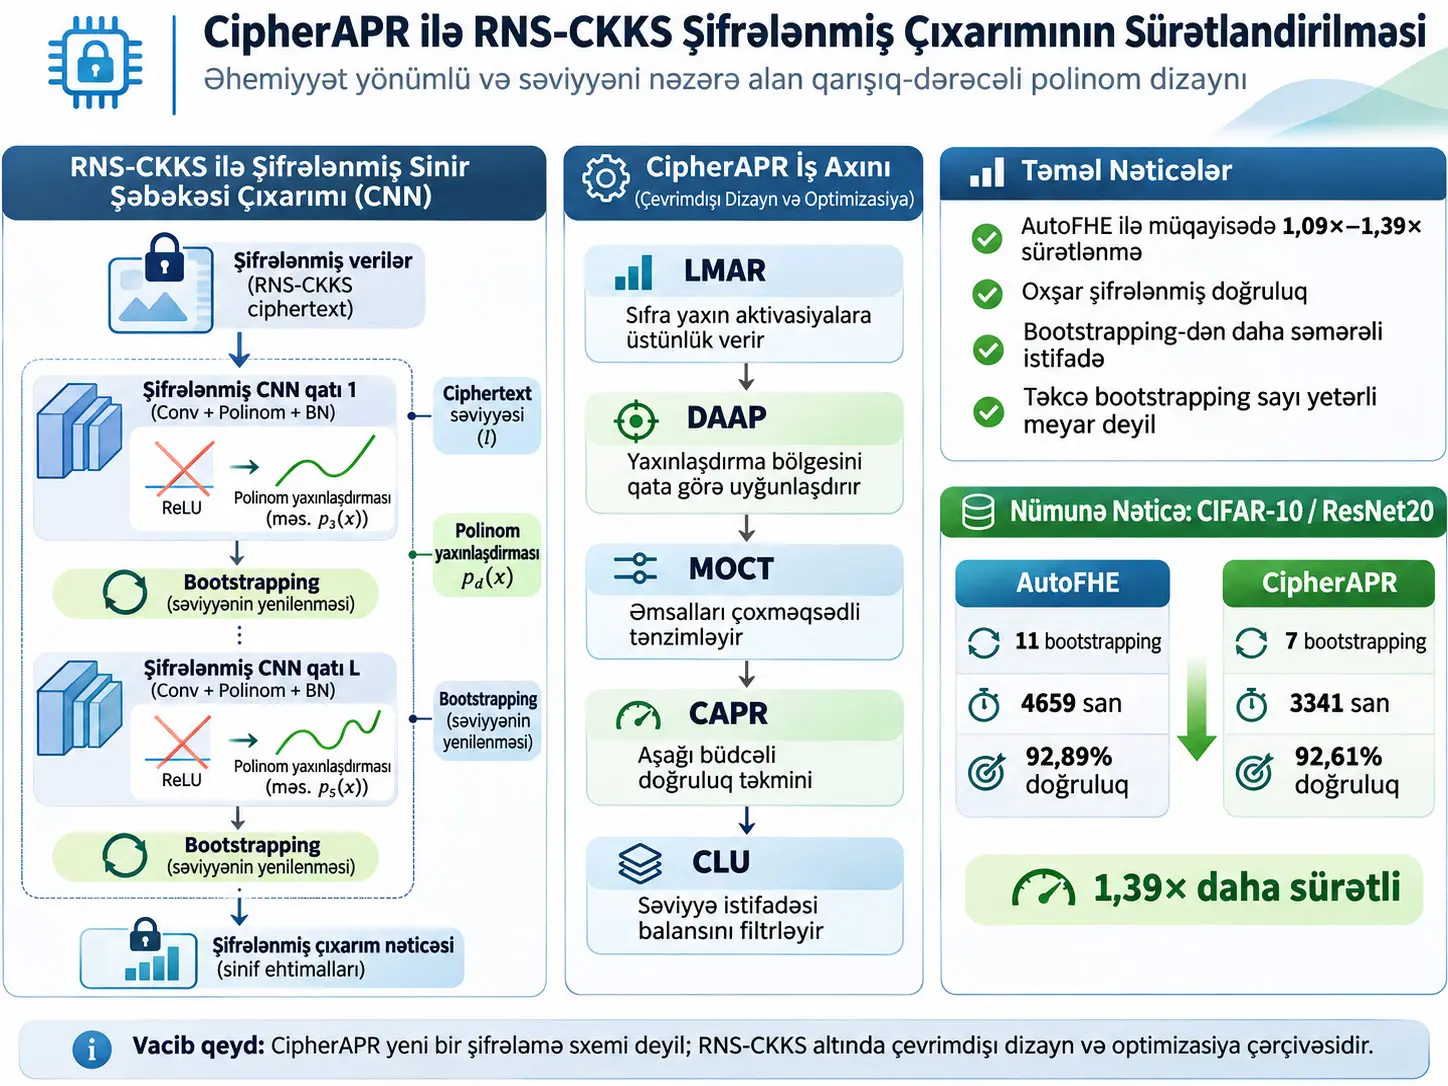
CipherAPR, RNS-CKKS əsaslı tam homomorfik şifrələmə altında işləyən neyron şəbəkələrində ReLU aktivləşdirmələrinin yerinə istifadə ediləcək polinomların dərəcələrini qat-qat seçən və bu seçimi ciphertext-level istifadəsini nəzərə alaraq həyata keçirən çevrimdışı qarışıq-dərəcəli polinom dizayn çərçivəsidir. Tədqiqatın əsas problemi yüksək dərəcəli ReLU yaxınlaşdırmalarının dəqiqliyi qoruyarkən daha çox multiplicative depth sərf etməsi və bahalı bootstrapping əməliyyatlarının sayını artırmasıdır. CipherAPR yalnız bootstrapping sayını azaltmağa çalışmır; bootstrapping-dən sonra bərpa edilən ciphertext səviyyələrinin həqiqətən nə qədər səmərəli istifadə olunduğunu da dizayn qərarına daxil edir.
Çərçivənin dörd əsas komponenti var. Low-Magnitude Activation Ratio (LMAR), girişləri ReLU-nun sıfır ətrafındakı kritik bölgəsində cəmlənən aktivləşdirmə qatlarını müəyyən edərək daha yüksək dərəcə verilməli qatlara üstünlük verir. Domain-Adaptive Approximation (DAAP), hər qatın müşahidə olunan aktivləşdirmə aralığına uyğun polinom yaxınlaşdırma bölgəsi qurur. Multi-Objective Coefficient Tuning (MOCT), yaxınlaşdırma xətasını azaltmaqla yanaşı əmsalların böyüklüyünü və xarici-bölgə davranışını da nəzarətdə saxlamağa çalışır. Ciphertext-Level Utilization (CLU) isə bootstrapping seqmentlərində bərpa olunmuş level büdcəsini qeyri-bərabər istifadə edən namizəd konfiqurasiyaları axtarış prosesində arxa plana keçirir.
Tədqiqatda CIFAR-10 və CIFAR-100 üzərində ResNet20, ResNet32, ResNet44 və VGG11 şəbəkələri qiymətləndirilmişdir. Eyni RNS-CKKS parametrlərində CipherAPR AutoFHE ilə müqayisədə bildirilən konfiqurasiyalarda 1,09×–1,39× sürətlənmə təmin etmiş və oxşar ciphertext dəqiqliyini qorumuşdur. Ən nəzərəçarpan nümunədə CIFAR-10/ResNet20 üçün AutoFHE 11 bootstrapping və 4659 saniyə ümumi gecikmə ilə %92,89 ciphertext dəqiqliyi verdiyi halda, CipherAPR 7 bootstrapping və 3341 saniyə gecikmə ilə %92,61 dəqiqlik vermişdir.
Bu nəticə “daha az bootstrapping hər vəziyyətdə avtomatik olaraq daha sürətlidir” kimi şərh edilməməlidir. Mənbə ciphertext-in hansı level-da olmasının rotation, rescaling və key-switching kimi əməliyyatların xərcinə də təsir etdiyini göstərir. Belə ki, bəzi konfiqurasiyalarda CipherAPR-ın xətti əməliyyat xərci artmış, lakin bootstrapping müddətindəki daha böyük azalma ümumi gecikməni yenə aşağı salmışdır.
CipherAPR yeni bir FHE şifrələmə primitive-i deyil və RNS-CKKS-nin təhlükəsizlik mexanizmini dəyişdirmir. LMAR, DAAP, MOCT, CAPR və CLU çevrimdışı model dizaynında plaintext training/calibration aktivləşdirmələri və ya public model parametrləri üzərində işləyir. Onlayn istifadəçi girişləri standart RNS-CKKS altında şifrəli qalır; mənbə confidentiality-nin istifadə olunan RNS-CKKS parametrlərindən və Ring Learning With Errors təhlükəsizlik fərziyyəsindən miras qaldığını bildirir.
Problem niyə yaranır?
Fully Homomorphic Encryption (FHE), serverə istifadəçi məlumatını açıq mətnə çevirmədən şifrələnmiş məlumat üzərində hesablama aparmağa imkan verir. Bu xüsusiyyət Machine Learning as a Service ssenarilərində vacibdir: istifadəçi girişini şifrələyir, server neyron şəbəkə çıxarımını ciphertext üzərində icra edir və istifadəçi yalnız son şifrələnmiş nəticəni öz tərəfində deşifrə edir.
Tədqiqatın istifadə etdiyi RNS-CKKS, təxmini həqiqi və ya kompleks ədəd arifmetikasını dəstəkləyən FHE sxemidir. Mesaj vektoru plaintext polynomial \(m(x)\) formasında kodlanır və ciphertext kimi şifrələnir. Hesablama:
cyclotomic ring üzərində aparılır.
Burada modulus:
şəklindədir. \(\ell\), ciphertext-in qalan multiplicative capacity-sini göstərən ciphertext level dəyəridir. Hər homomorphic multiplication ciphertext-in miqyasını böyütdüyünə görə adətən rescaling tələb olunur. Rescaling son prime \(q_\ell\)-i modulus chain-dən çıxarır:
və beləliklə bir level sərf olunur.
Level sıfıra yaxınlaşdıqda ciphertext-in daha çox multiplication daşıya bilməsi üçün bootstrapping tələb olunur. Bootstrapping ciphertext-i yenidən istifadə oluna bilən yüksək level-a qaldırır; lakin RNS-CKKS encrypted inference daxilində çox bahalı əməliyyatdır.
Bootstrapping Sayını Azaltmaq Niyə Təkbaşına Kifayət Deyil?
Bootstrapping sayı vacib olsa da, RNS-CKKS əməliyyat xərci ciphertext-in hansı level-da hesablandığından da asılıdır; yüksək level daha çox aktiv RNS prime ehtiva etdiyi üçün rotation, relinearization, multiplication və rescaling kimi əməliyyatlar daha bahalı ola bilər. Buna görə CipherAPR yalnız bootstrapping sayını deyil, bootstrapping-dən sonra bərpa olunan level büdcəsinin seqmentlər boyunca nə qədər səmərəli sərf edildiyini də nəzərə alır.
RNS-CKKS-də level niyə əməliyyat xərcinə təsir edir?
Mənbə aktiv RNS basis-i:
kimi müəyyən edir. Aktiv prime sayı:
olduğuna görə level yüksəldikcə hesablamaya daha çox modulus limb qoşulur.
Level \(\ell\)-dəki primitive homomorphic operation xərcinin cəmi:
şəklində yazılır.
Burada \(\mathcal{P}\), AddCP, AddCC, MulCP, MulCC, Rot, Relin və RS kimi primitive operation növlərini; \(n_k\), müvafiq əməliyyat sayını; \(t_k(\ell)\) isə tək bir əməliyyatın level \(\ell\)-dəki xərcini göstərir.
Mənbənin istifadə etdiyi təxmini level asılılığı:
şəklindədir.
\(N\) ring degree-dir. \(\alpha_k\) və \(\beta_k\) operation-dependent constants-dır. Birinci qrupdakı əməliyyatlar aktiv RNS limb sayı ilə təxminən xətti; key-switching ehtiva edən rotation və relinearization növləri isə mənbənin cost model-ində daha güclü level asılılığı göstərir.
Buna görə bootstrapping-dən sonrakı effective level \(L_{\mathrm{eff}}\)-in azaldılması sonrakı əməliyyatları ucuzlaşdıra bilər; lakin çox aşağı \(L_{\mathrm{eff}}\) kifayət qədər multiplicative-depth saxlamayaraq bootstrapping sayını yenidən artıra bilər.
Mənbə ümumi inference latency-ni konseptual olaraq:
şəklində ifadə edir.
\(N_{\mathrm{boot}}\) bootstrapping sayı; \(T_{\mathrm{boot}}\) bir bootstrapping-in xərci; \(T_{\mathrm{seg}}^{(j)}\) isə iki bootstrapping arasındakı seqmentin hesablama xərcidir. Formula ümumi latency-nin yalnız \(N_{\mathrm{boot}}\)-dan asılı olmadığını açıq göstərir.
ReLU niyə birbaşa hesablana bilmir?
RNS-CKKS əsasən addition və multiplication kimi arithmetic operations təmin edir. CNN-lərdəki:
funksiya birbaşa polynomial deyil. Buna görə ReLU homomorphic evaluation-a uyğun polynomial approximation ilə əvəz olunur.
Mənbə ReLU-nu sign function vasitəsilə:
şəklində ifadə edir.
Sign function sıfır ətrafındakı discontinuity səbəbilə tək bir aşağı dərəcəli polynomial ilə yüksək dəqiqliklə yaxınlaşdırılması çətin olan funksiyadır. Buna görə tədqiqat composite polynomial:
strukturundan istifadə edir.
Hər sub-polynomial-in dərəcəsi:
kimi göstərilir.
Composite polynomial multiplicative depth-i
Baby Step Giant Step (BSGS) polynomial evaluation istifadə edildikdə mənbə \(i\)-ci sub-polynomial üçün depth-i:
ilə yuxarıdan məhdudlaşdırır.
Ümumi composite depth təxminən:
kimi hesablanır.
| Dərəcə çoxluğu | Depth consumption | Multiplication sayı |
|---|---|---|
| {3, 7} | 5 | 7 |
| {7, 7} | 6 | 10 |
| {7, 15} | 7 | 13 |
| {15, 15} | 8 | 16 |
| {7, 7, 13} | 10 | 17 |
| {7, 7, 27} | 11 | 20 |
| {7, 15, 27} | 12 | 23 |
| {15, 15, 27} | 13 | 26 |
Daha yüksək degree set adətən ReLU approximation fidelity-sini artıra bilən, daha yüksək ifadə gücünə malik polynomial yaradır; lakin daha çox multiplicative depth və buna görə daha tez-tez və ya fərqli mövqeləndirilmiş bootstrapping tələb edə bilər.
CipherAPR hansı problemi optimallaşdırır?
Bir encrypted network-də \(L\) activation layer olduğunu düşünək. Qatlara verilən polynomial dərəcələri:
degree vector ilə göstərilir. \(\mathbb{D}\), istifadəsinə icazə verilən polynomial degree set-dir.
Müəyyən degree configuration \(\mathbf{d}\) üçün mümkün bootstrapping placement-ların çoxluğu:
kimi müəyyən edilir. \(\Lambda\), ring degree, modulus chain və security level kimi sabit cryptographic setting-i təmsil edir.
Configuration-ın latency dəyəri:
kimi müəyyən edilir.
Burada \(T(\mathbf{d},\pi;\Lambda)\), müəyyən polynomial degrees və bootstrapping placement altında ucdan-uca encrypted inference latency-dir.
Əsas optimallaşdırma problemi:
şəklindədir.
Yəni CipherAPR yalnız ən sürətli configuration-ı axtarmır. Minimum qəbul edilən accuracy constraint-i qoruyaraq ən aşağı encrypted inference latency verən layer-wise degree assignment-ı axtarır.
CipherAPR-ın üç mərhələli çevrimdışı dizayn prosesi
LMAR: Hansı qatın dərəcə artımına daha çox ehtiyacı var?
ReLU-nun kritik davranışı sıfır ətrafındadır. Giriş mənfi tərəfə keçəndə ReLU çıxışı sıfır olur; müsbət tərəfdə isə giriş ötürülür. Polynomial approximation xüsusilə sıfıra yaxın dəyərlərdə sign/gating qərarını səhv təmsil etməyə daha meyllidir.
CipherAPR buna görə layer \(\ell\) üçün Low-Magnitude Activation Ratio müəyyən edir:
Burada \(x_{\ell,i}\), \(\ell\)-ci activation layer-dəki \(i\)-ci neuron-un girişi; \(k_\ell\), həmin qatdakı ümumi neuron sayı; \(\epsilon\), “sıfıra yaxın” bölgəni müəyyən edən həddir; \(\mathbf{1}(\cdot)\), şərt doğru olduqda 1, yanlış olduqda 0 verən indicator function-dır.
LMAR ölçüsüz nisbətdir və 0–1 aralığındadır. Yüksək LMAR qatda olan activation input-ların daha böyük hissəsinin sıfır ətrafında yerləşdiyini göstərir. Mənbə bunu eyni level budget altında daha yüksək polynomial degree-dən daha çox fayda görə biləcək qatları sıralamaq üçün istifadə edir.
LMAR Nəyi Ölçür və Niyə Vacibdir?
LMAR aktivləşdirmə qatındakı girişlərin nə qədərinin ReLU-nun sıfır ətrafındakı həssas bölgədə yerləşdiyini ölçən ölçüsüz nisbətdir; nisbət yüksəldikcə aşağı dərəcəli polinomun gating davranışını yanlış təmsil etmə riski əhəmiyyət qazanır və CipherAPR bu qatları dərəcə artımı üçün daha yüksək prioritetlə qiymətləndirir.
\(\epsilon\) həddi necə müəyyən edilir?
Mənbə \(\epsilon\)-ni əl ilə sabitləmək əvəzinə bütün qatlarda activation magnitude paylanmasına Otsu metodunu tətbiq edir.
Within-class variance:
Between-class variance:
şəklindədir.
\(w_1,w_2\) iki activation-magnitude sinfinin ehtimallarını; \(\mu_1,\mu_2\) sinif ortalamalarını; \(\sigma_1^2,\sigma_2^2\) isə sinifdaxili dispersiyaları göstərir.
Mənbə optimal \(\epsilon\)-ni:
nisbətini maksimumlaşdıran threshold kimi seçir.
LMAR yalnız eksperimental heuristic-dir?
Appendix A LMAR sıralaması üçün nəzəri sərhəd əsaslandırması da verir. \(\ell\)-ci layer pre-activation \(X_\ell\), polynomial approximation isə \(p_d(x)\) olsun. Polynomial \(|x|\ge\epsilon\) bölgəsində düzgün sign-i qoruyursa, gating sign inconsistency ehtimalı:
ilə yuxarıdan məhdudlaşdırılır.
Bu tənlik LMAR-ın sign inconsistency-nin baş verəcəyi dəqiq ehtimal olduğunu demir. LMAR göstərilən shape constraint altında risk üçün yuxarı sərhəddir.
Mənbə həmçinin approximation error-ın expected loss üzərindəki təsiri üçün:
sərhədini verir.
Burada \(L_\ell\), sonrakı sub-network-ün Lipschitz constant-ı; \(L_{\mathrm{loss}}\), loss function-ın Lipschitz constant-ı; \(c_{\epsilon,d}\) isə sıfıra yaxın approximation region daxilində maksimum polynomial sapmanı təmsil edir. Mənbənin şərhinə görə digər amillər oxşar olduqda yüksək LMAR approximation error-ın expected loss-a töhfəsini artıra bilər.
Degree update necə seçilir?
Activation layer-lar LMAR dəyərlərinə görə böyükdən kiçiyə sıralanır. Qat \(\ell\)-in rank-i \(r_\ell\), ümumi layer sayı \(M\) olduqda normalized rank score:
kimi hesablanır.
Yüksək LMAR-a malik qatlar 1-ə; aşağı LMAR-a malik qatlar 0-a yaxınlaşır.
IncreaseDegree və DecreaseDegree üçün mənbə centered hinge functions istifadə edir:
Burada \(\tau_c=0.5\), \(m\in[0,0.5)\) isə update selectivity margin-dir.
Action probabilities:
kimi hesablanır.
ID degree artımı, DD degree azalması, KD isə degree-nin qorunmasıdır. Əvvəlki iteration-da dəyişdirilmiş layer üçün dynamic coefficients:
ilə azaldılır. Mənbə bu cooling mexanizmini eyni layer-ın ardıcıl iteration-larda davamlı irəli-geri dəyişdirilməsini azaltmaq üçün istifadə edir.
DAAP — approximation domain niyə qata görə dəyişir?
Hər layer-ın activation distribution-ı eyni deyil. Eyni geniş approximation domain-i bütün layer-lara tətbiq etmək bəzi layer-larda lazım olduğundan daha çətin polynomial fitting problemi yarada bilər.
DAAP, layer \(\ell\)-in empirical activation bounds dəyərlərini:
kimi götürür və symmetric core radius-u:
şəklində hesablayır.
\(B>1\) activation-domain normalization üçün istifadə olunan global scaling factor-dur. Mənbə xüsusilə bunun CKKS encryption scale ilə eyni kəmiyyət olmadığını bildirir. \(a>0\), minimum core-domain radius-dur.
Core domain:
extended domain isə:
kimi müəyyən edilir.
\(\rho_{\mathrm{ext}}>1\), normal core domain-dən kənarda qalan, lakin qarşılaşılması mümkün activation tail-ləri üçün təhlükəsizlik ehtiyatı yaradır.
DAAP və MOCT Niyə Birlikdə İstifadə Olunur?
DAAP polinomun yaxınlaşdırma bölgəsini qatın real aktivləşdirmə paylanmasına uyğunlaşdırarkən, MOCT eyni polinomun əmsallarını core error, extended-domain davranışı, əyrilik və əmsal böyüklüyünü birlikdə nəzərə alaraq tənzimləyir; məqsəd eyni polynomial degree altında daha aşağı approximation error və ciphertext arithmetic üçün daha sabit ədədi davranış əldə etməkdir.
MOCT loss function
Son ReLU approximation:
şəklindədir.
MOCT dörd loss komponentindən istifadə edir.
Core Error (CE):
core domain daxilində maksimum approximation error-dur.
Extended Domain Constraint (EDC):
extended domain daxilində polynomial output-un gözlənilən təhlükəsiz aralıqdan kənara çıxmasını cəzalandırır.
Curvature Penalty (CP):
mənbədə polynomial oscillation və Runge-bənzəri davranışı basdırmaq üçün curvature regularization kimi istifadə olunur.
Coefficient Regularization (CR):
polynomial coefficient böyüklüyünü məhdudlaşdırır.
Ümumi loss:
şəklindədir.
Məqalədəki təcrübələrdə:
istifadə edilmişdir.
MOCT yalnız ilk sub-polynomial \(p_1(x)\)-in odd-degree coefficients dəyərlərini trainable edir; digər əmsallar sabit saxlanılır. Mənbə 10.000 MOCT epoch istifadə etmişdir.
CAPR nədir?
Cosine-scheduled Activation Progressive Replacement (CAPR), candidate mixed-degree network-ün yekun dəqiqliyini tam 300-epoch training etməzdən əvvəl aşağı büdcə ilə təxmini qiymətləndirən çevrimdışı screening metodudur.
Ümumi training budget \(T\), stage sayı \(Q\), minimum stage epoch-u \(M_{\min}\) olsun. Hər stage üçün epoch allocation:
şəklində verilir.
Mənbə standart olaraq:
istifadə edir.
Stage \(q\)-də dəyişdirilməsi planlaşdırılan activation sayı:
və kumulyativ dəyişdirilmiş activation sayı:
kimi müəyyən edilir.
CAPR yekun accuracy deyil. Məqalə CAPR-ı yalnız candidate screening üçün low-budget staged accuracy estimate kimi istifadə edir; seçilmiş konfiqurasiyalar daha sonra tam training-ə götürülür.
Latency proxy və dynamic programming
CipherAPR hər candidate-ı real encrypted inference ilə sınaqdan keçirmir; əks halda search həddən artıq bahalı olar. Bunun əvəzinə müəyyən layer-lar ətrafında feasible bootstrapping positions yaradır və dynamic programming ilə minimum proxy latency-ni axtarır.
DP state hansı layer-da olunduğunu və qalan ciphertext level-ı izləyir. Bootstrapping əlavə edilərsə level \(L_{\mathrm{eff}}\)-ə reset edilir və bootstrapping cost əlavə olunur.
Xətti operator cost-ları input ciphertext level-a görə hazırlanmış lookup table-dan götürülür. Polynomial layer cost-u degree ilə əlaqəli monotonic cost model istifadə edir.
Candidate score
Candidate \(\mathbf{d}'\) üçün score:
şəklindədir.
\(\lambda\) böyüdükcə accuracy seçiminin, kiçildikcə latency seçiminin çəkisi artır. Tədqiqat ayrıca accuracy-oriented və latency-oriented candidate pool-lar saxlayır.
CLU — ciphertext-level utilization
Bootstrapping placements network-ü \(S\) seqmentə bölsün. Seqment \(s\)-dəki layer set \(\mathcal{L}_s\), hər layer-ın level consumption dəyəri \(c_\ell\) olarsa:
segment depth consumption-dır.
Segment-level utilization:
kimi hesablanır.
Qonşu seqmentlər arasındakı dəyişmə:
və adjacent variation:
şəklindədir.
Aşağı \(RMS_{\mathrm{adj}}\), bootstrapping seqmentləri arasında daha balanslı level sərfini təmsil edir. CLU yekun latency və ya accuracy-ni əvəz edən objective deyil; score preselection-dan keçmiş candidate-lar arasında conservative structural filter kimi istifadə olunur.
Offline search parametrləri
- Pool width \(W=15\).
- Maximum search iteration \(T_{\max}=30\).
- CLU retention ratio \(\eta_{\mathrm{CLU}}=0.95\).
- Başlanğıc accuracy-oriented preference weight: \(\lambda_{\mathrm{acc}}^{(0)}=1.0\).
- Başlanğıc latency-oriented preference weight: \(\lambda_{\mathrm{lat}}^{(0)}=0.1\).
- Bir iteration-da duplicate removal-dan sonra ən çox \(2W=30\) candidate CAPR qiymətləndirilməsinə gedir.
Tədqiqatın Metodu və Nəticələri
Təcrübə mühiti
| Mərhələ | Mənbədə bildirilən mühit |
|---|---|
| Offline training / degree allocation / polynomial instantiation | Python 3.8, PyTorch 1.13.1 |
| Offline GPU | NVIDIA RTX A6000 |
| Offline əməliyyat sistemi | Ubuntu 20.04 |
| Encrypted inference implementation | C++, AutoFHE infrastrukturu, Microsoft SEAL |
| Encrypted inference CPU | Intel Xeon Platinum 8462Y+ |
| CPU tutumu | 128 vCPU |
| Server yaddaşı | 1 TiB |
| Encrypted inference əməliyyat sistemi | Ubuntu 20.04 |
Mənbə offline design müddəti ilə online encrypted inference latency-ni xüsusilə bir-birindən ayırır. Məqalədəki online performans müqayisələri training/search xərcini inference latency-yə daxil etmir.
Məlumat dəstləri
| Məlumat dəsti | Training görüntüsü | Test görüntüsü | Görüntü ölçüsü | Offline sürətli axtarış alt dəsti |
|---|---|---|---|---|
| CIFAR-10 | 50.000 | 10.000 | 32×32 pixel | 5000 training image |
| CIFAR-100 | 50.000 | 10.000 | 32×32 pixel | 5000 training image |
Offline search müddətini azaltmaq üçün 5000-image fast-training subset istifadə edilmişdir. Yekun ciphertext inference qiymətləndirilməsi isə 10.000-image test set üzərində aparılmışdır. Metrik top-1 accuracy-dir.
RNS-CKKS parametrləri
| Parametr | Dəyər |
|---|---|
| Ring degree \(N\) | \(2^{16}\) |
| Numerical scaling factor \(B\) | 80 |
| Total modulus-chain length | 1552 bit |
| Private-key Hamming weight | 192 |
| Security level | 128-bit |
Modulus-chain quruluşu mənbədə:
bit formasında bildirilmişdir.
Training parametrləri
Original networks:
- Optimizer: SGD.
- Epoch: 200.
- Batch size: 128.
- Initial learning rate: 0,1.
- Learning-rate schedule: cosine decay.
- Momentum: 0,9.
- Weight decay: 0,0005.
- Gradient clipping: 1,0.
Polynomial networks üçün 300 epoch və initial learning rate 0,08 istifadə edilmiş; hər stage üçün ən az 8 epoch tətbiq olunmuşdur.
Final CipherAPR training:
- Batch size: 128.
- Learning rate: 0,01.
- Momentum: 0,9.
- Weight decay: \(5\times10^{-4}\).
- Gradient clipping: 0,1.
- KL-divergence weight: \(\tau=0.9\).
CAPR candidate evaluation üçün yalnız 20 total epoch və hər stage üçün minimum 2 epoch istifadə edilmişdir.
DAAP/MOCT parametrləri
- Approximation-domain minimum: \(a=0.2\).
- Extension factor: \(\rho_{\mathrm{ext}}=1.5\).
- CIFAR-10 domain estimation: 30 image.
- CIFAR-100 domain estimation: 100 image.
- Uniform perturbation: \(\epsilon=0.1\).
- MOCT training: 10.000 epoch.
Əsas encrypted inference nəticələri
| Məlumat dəsti / Şəbəkə | Metod / konfiqurasiya | #Boot | Cipher Acc. | Latency | Amortized latency |
|---|---|---|---|---|---|
| CIFAR-10 / ResNet20 | MPCNN | 18 | %92,59 | 6299 s | 49,21 s |
| CIFAR-10 / ResNet20 | AutoFHE aşağı-BT | 5 | %91,92 | 2751 s | 21,49 s |
| CIFAR-10 / ResNet20 | CipherAPR aşağı-BT | 4 | %92,15 | 2291 s | 17,90 s |
| CIFAR-10 / ResNet20 | AutoFHE yüksək-BT | 11 | %92,89 | 4659 s | 36,40 s |
| CIFAR-10 / ResNet20 | CipherAPR yüksək-BT | 7 | %92,61 | 3341 s | 26,10 s |
| CIFAR-10 / ResNet32 | MPCNN | 30 | %93,39 | 10.231 s | 79,93 s |
| CIFAR-10 / ResNet32 | AutoFHE aşağı-BT | 8 | %93,46 | 4664 s | 36,44 s |
| CIFAR-10 / ResNet32 | CipherAPR aşağı-BT | 7 | %93,14 | 4129 s | 32,26 s |
| CIFAR-10 / ResNet32 | AutoFHE yüksək-BT | 19 | %93,56 | 7294 s | 56,98 s |
| CIFAR-10 / ResNet32 | CipherAPR yüksək-BT | 13 | %93,76 | 6064 s | 47,38 s |
| CIFAR-10 / ResNet44 | MPCNN | 42 | %93,57 | 15.163 s | 118,46 s |
| CIFAR-10 / ResNet44 | AutoFHE aşağı-BT | 8 | %92,55 | 5137 s | 40,13 s |
| CIFAR-10 / ResNet44 | CipherAPR aşağı-BT | 8 | %93,04 | 4728 s | 36,94 s |
| CIFAR-10 / ResNet44 | AutoFHE yüksək-BT | 22 | %93,65 | 8639 s | 67,49 s |
| CIFAR-10 / ResNet44 | CipherAPR yüksək-BT | 16 | %93,71 | 7250 s | 56,64 s |
| CIFAR-10 / VGG11 | MPCNN | 9 | %90,41 | 3157 s | 24,66 s |
| CIFAR-10 / VGG11 | AutoFHE | 4 | %90,68 | 1931 s | 15,09 s |
| CIFAR-10 / VGG11 | CipherAPR | 4 | %90,67 | 1835 s | 14,34 s |
| CIFAR-100 / ResNet32 | MPCNN | 30 | %70,59 | 10.357 s | 80,91 s |
| CIFAR-100 / ResNet32 | AutoFHE | 16 | %71,34 | 7187 s | 56,15 s |
| CIFAR-100 / ResNet32 | CipherAPR | 12 | %71,48 | 5953 s | 46,51 s |
| CIFAR-100 / VGG11 | MPCNN | 9 | %63,95 | 3200 s | 25,00 s |
| CIFAR-100 / VGG11 | AutoFHE | 7 | %64,31 | 2832 s | 22,12 s |
| CIFAR-100 / VGG11 | CipherAPR | 6 | %64,26 | 2348 s | 18,34 s |
Mənbə bu paired settings əsasında CipherAPR-ın AutoFHE-yə nisbətən ümumi sürətlənməsini 1,09×–1,39× aralığında bildirir.
CipherAPR-ın 1,09×–1,39× Sürətlənməsi Nə Deməkdir?
Bu sürətlənmə eyni sabit RNS-CKKS cryptographic setting və müqayisə edilə bilən encrypted accuracy hədəfləri altında seçilmiş ResNet/VGG konfiqurasiyalarında AutoFHE-yə nisbətən ölçülmüş ucdan-uca encrypted-inference latency azalmasını ifadə edir; nəticə bütün şəbəkələr, bütün FHE parametrləri və ya bütün aparat sistemləri üçün universal sürətlənmə zəmanəti deyil.
Runtime breakdown: niyə bəzi xətti əməliyyatlar bahalaşır?
| Məlumat dəsti / Şəbəkə | Metod / konfiqurasiya | #Boot | Total effective levels | Boot | Linear | Polynomial |
|---|---|---|---|---|---|---|
| CIFAR-10 / ResNet20 | MPCNN | 18 | 306 | 4813 s | 786 s | 700 s |
| CIFAR-10 / ResNet20 | AutoFHE aşağı-BT | 5 | 85 | 1370 s | 1304 s | 77 s |
| CIFAR-10 / ResNet20 | CipherAPR aşağı-BT | 4 | 73 | 1095 s | 1162 s | 34 s |
| CIFAR-10 / ResNet20 | AutoFHE yüksək-BT | 11 | 150 | 2995 s | 1411 s | 253 s |
| CIFAR-10 / ResNet20 | CipherAPR yüksək-BT | 7 | 104 | 1907 s | 1335 s | 99 s |
| CIFAR-10 / ResNet32 | MPCNN | 30 | 498 | 7813 s | 1336 s | 1082 s |
| CIFAR-10 / ResNet32 | AutoFHE aşağı-BT | 8 | 96 | 2234 s | 2404 s | 26 s |
| CIFAR-10 / ResNet32 | CipherAPR aşağı-BT | 7 | 118 | 1955 s | 2129 s | 45 s |
| CIFAR-10 / ResNet32 | AutoFHE yüksək-BT | 19 | 235 | 5040 s | 1838 s | 416 s |
| CIFAR-10 / ResNet32 | CipherAPR yüksək-BT | 13 | 195 | 3449 s | 2208 s | 407 s |
| CIFAR-10 / ResNet44 | MPCNN | 42 | 690 | 11.638 s | 1893 s | 1632 s |
| CIFAR-10 / ResNet44 | AutoFHE aşağı-BT | 8 | 120 | 2171 s | 2940 s | 26 s |
| CIFAR-10 / ResNet44 | CipherAPR aşağı-BT | 8 | 131 | 2149 s | 2550 s | 29 s |
| CIFAR-10 / ResNet44 | AutoFHE yüksək-BT | 22 | 277 | 5715 s | 2492 s | 432 s |
| CIFAR-10 / ResNet44 | CipherAPR yüksək-BT | 16 | 234 | 4157 s | 2662 s | 431 s |
| CIFAR-10 / VGG11 | MPCNN | 9 | 160 | 2326 s | 483 s | 348 s |
| CIFAR-10 / VGG11 | AutoFHE | 4 | 72 | 1125 s | 692 s | 114 s |
| CIFAR-10 / VGG11 | CipherAPR | 4 | 68 | 1131 s | 629 s | 75 s |
| CIFAR-100 / ResNet32 | MPCNN | 30 | 498 | 7809 s | 1466 s | 1082 s |
| CIFAR-100 / ResNet32 | AutoFHE | 16 | 230 | 4377 s | 2408 s | 402 s |
| CIFAR-100 / ResNet32 | CipherAPR | 12 | 176 | 3183 s | 2357 s | 413 s |
| CIFAR-100 / VGG11 | MPCNN | 9 | 160 | 2332 s | 511 s | 357 s |
| CIFAR-100 / VGG11 | AutoFHE | 7 | 104 | 1885 s | 719 s | 228 s |
| CIFAR-100 / VGG11 | CipherAPR | 6 | 86 | 1616 s | 611 s | 121 s |
CIFAR-10/ResNet32 yüksək-BT nümunəsi bu qarşılıqlı təsiri aydın göstərir. AutoFHE 19 bootstrapping ilə 5040 s bootstrapping və 1838 s linear cost yaratdığı halda, CipherAPR 13 bootstrapping ilə bootstrapping müddətini 3449 s-ə endirir. Bunun müqabilində linear cost 2208 s-ə yüksəlir. Bootstrapping qazancı daha böyük olduğuna görə ümumi latency yenə 7294 s-dən 6064 s-ə düşür.
Restored-level istifadə nümunəsi
Mənbə CIFAR-10/ResNet32 yüksək-BT konfiqurasiyası üçün hər bootstrapping-in ən çox 16 level restore etdiyini və input ciphertext-in level 18-dən başladığını bildirir.
Ümumi istifadə edilə bilən level:
kimi hesablanır.
AutoFHE üçün:
level istifadə edilə bilər və Table 6-da total effective usage 235-dir. Mənbə buna əsasən 87 level-ın istifadə olunmadan qaldığını hesablayır.
CipherAPR üçün:
level istifadə edilə bilər; effective usage 195-dir və unused budget 31 level-dır.
Mənbəyə görə Table 6-dakı doqquz paired AutoFHE/CipherAPR setting-in yeddisində CipherAPR daha aşağı unused level budget göstərmişdir.
LMAR eksperimental nəticəsi
LMAR qiymətləndirilməsi CIFAR-10/ResNet32 üzərində aparılmışdır. Activation sites-lar mərhələli şəkildə polynomial ilə əvəz edilərkən LMAR sıralaması Forward və Reverse-LMAR sıralamaları ilə müqayisə edilmişdir.
Mənbənin Şəkil 5 üçün əsas nəticəsi xüsusilə az sayda activation dəyişdirilmiş erkən mərhələdə LMAR-based ordering-in accuracy-ni daha sürətli bərpa etməsidir. Eyni fine-tuning prosedurunda bəzi partially replaced modellər %94,05 inference accuracy-yə çatmış və orijinal ReLU network baseline-ını bir qədər üstələmişdir. Bu dəyər CipherAPR-ın encrypted-inference əsas nəticələr cədvəlini əvəz edən nəticə deyil; LMAR-ın degree-prioritization signal kimi qiymətləndirilməsinə aid ayrıca supporting experiment-dir.
DAAP + MOCT approximation error nəticələri
| Depth | Minimax MaxE | DAAP w/o MOCT MaxE | DAAP + MOCT MaxE | MOCT yaxşılaşması vs Minimax |
|---|---|---|---|---|
| 4 | 6,65×10⁻² | 1,42×10⁻² | 9,72×10⁻³ | %85,39 |
| 5 | 3,44×10⁻² | 7,18×10⁻³ | 6,76×10⁻³ | %80,36 |
| 6 | 1,51×10⁻² | 9,37×10⁻³ | 3,62×10⁻³ | %76,03 |
| 7 | 7,58×10⁻³ | 2,62×10⁻³ | 2,41×10⁻³ | %68,22 |
| 8 | 3,82×10⁻³ | 1,85×10⁻³ | 1,71×10⁻³ | %55,33 |
| 9 | 1,87×10⁻³ | 1,25×10⁻³ | 1,13×10⁻³ | %39,44 |
| 10 | 1,73×10⁻³ | 5,74×10⁻⁴ | 5,72×10⁻⁴ | %66,91 |
| 11 | 9,03×10⁻⁴ | 3,88×10⁻⁴ | 3,82×10⁻⁴ | %57,66 |
| 12 | 4,72×10⁻⁴ | 1,88×10⁻⁴ | 1,82×10⁻⁴ | %61,51 |
Mənbə DAAP + MOCT-un Minimax-a nisbətən MaxE dəyərini depth-dən asılı olaraq %39,44–%85,39 azaltdığını bildirir.
DAAP domain trade-off-u
| Depth | Parametr | Core MaxE | Outer MaxE | Max |ai| |
|---|---|---|---|---|
| 6 | \(v=0.12,\rho_{\mathrm{ext}}=1.50\) | 2,85×10⁻³ | 2,19×10⁻³ | 3,89×10² |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| 6 | \(v=0.30,\rho_{\mathrm{ext}}=1.50\) | 2,91×10⁻² | 4,18×10⁻² | 2,54×101 |
| 12 | \(v=0.12,\rho_{\mathrm{ext}}=1.50\) | 1,49×10⁻⁴ | 2,55×10⁻⁷ | 2,77×10⁶ |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 1,88×10⁻⁴ | 4,00×10⁻⁵ | 7,84×10⁴ |
| 12 | \(v=0.30,\rho_{\mathrm{ext}}=1.50\) | 4,28×10⁻⁴ | 6,72×10⁻⁴ | 4,66×10³ |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=1.05\) | 3,87×10⁻³ | 4,21×10⁻³ | 2,46×10² |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=2.50\) | 1,81×10⁻² | 5,37×10⁻² | 1,86×101 |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=1.05\) | 1,61×10⁻⁴ | 1,63×10⁻⁶ | 8,83×10⁵ |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 1,88×10⁻⁴ | 4,00×10⁻⁵ | 7,84×10⁴ |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=2.50\) | 4,27×10⁻⁴ | 1,08×10⁻³ | 4,53×10³ |
Nəticə mühüm approximation-stability trade-off göstərir. Məsələn, depth 6-da \(v\)-ni 0,12-dən 0,30-a artırmaq maximum coefficient böyüklüyünü \(3,89\times10^2\)-dən \(2,54\times10^1\)-ə azaldarkən Core MaxE-ni \(2,85\times10^{-3}\)-dən \(2,91\times10^{-2}\)-yə yüksəldir. Mənbə \(v=0.20,\rho_{\mathrm{ext}}=1.50\) dəyərlərini balanslı default kimi istifadə edir.
MOCT weight ablation
| Vəziyyət | Core MaxE | Outer MaxE | Max |ai| |
|---|---|---|---|
| DAAP baseline | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| MOCT default | 6,60×10⁻³ | 1,84×10⁻² | 8,45×101 |
| \(w_1=0\) | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| \(w_2=0\) | 6,60×10⁻³ | 1,84×10⁻² | 8,45×101 |
| \(w_3=0\) | 3,40×10⁻³ | 7,12×10⁻² | 1,04×10² |
| \(w_4=0\) | 6,60×10⁻³ | 1,84×10⁻² | 8,45×101 |
\(w_1=0\) nəticəsinin DAAP baseline-a qayıtması Core Error term-inin core-domain update-i yönləndirdiyini göstərir. \(w_3=0\) isə Core MaxE-ni azaltmasına baxmayaraq Outer MaxE-ni \(7,12\times10^{-2}\)-yə və maximum coefficient-i \(1,04\times10^2\)-yə yüksəldir. Mənbə bunu curvature penalty-nin yalnız core region-a həddən artıq uyğunlaşmanı əngəlləyərək outer-domain numerical behavior-a töhfə verməsi kimi şərh edir.
Latency proxy, CAPR və CLU qiymətləndirilməsi
Mənbə Şəkil 6a-da latency proxy-nin müxtəlif bootstrapping settings daxilində real encrypted latency ordering-i qoruduğunu bildirir. Proxy-nin vəzifəsi qlobal olaraq saniyə ilə latency kalibrləmək deyil; eyni setting daxilində namizədləri sıralamaqdır.
Şəkil 6b CAPR-ın kiçik training budget daxilində trainable configuration-ları failure regime-dən sürətlə ayıra bildiyini göstərir. Mənbə CAPR-ı final accuracy əvəzinə screening estimate kimi istifadə edir.
| Pool parametri | 210 CAPR qiymətləndirməsindən sonra best-so-far | Normalized final best | CLU-run best-ə çatmaq üçün CAPR eval | Path-dependent qənaət |
|---|---|---|---|---|
| Accuracy-oriented | %99,9 / %97,6 | %99,9 / %100,0 | 210 / 330 | %36,4 daha az |
| Latency-oriented | %100,0 / %95,5 | %100,0 / %100,0 | 180 / 330 | %45,5 daha az |
Cədvəldəki cüt dəyərlər `CLU / without CLU` formasındadır. Mənbə xüsusilə final best score-ların demək olar eyni qaldığını bildirir. Buna görə CLU-nun əsas təsiri “yekun optimumu dramatik şəkildə yaxşılaşdırmaq” deyil, eyni səviyyəli best configuration-a aparan erkən search trajectory-ni daha səmərəli etməkdir.
Offline search xərci
Hər candidate 5000-image fast-training subset üzərində 20 CAPR epoch və batch size 128 ilə fine-tune edilir. Bu, hər candidate üçün 800 mini-batch update-ə uyğundur.
Mənbə serial offline search cost-u:
kimi təxmin edir.
\(N_{\mathrm{eval}}\), CAPR ilə qiymətləndirilən candidate configuration sayı; \(T_{\mathrm{CAPR}}^{20}\), hər candidate üçün 20-epoch CAPR müddətidir.
Pilot ölçmələrdə hər candidate üçün CAPR müddəti ResNet settings üçün təxminən 10–25 dəqiqə, VGG üçün 20–30 dəqiqə səviyyəsindədir. Buna əsasən mənbə 180–210 qiymətləndirməli CLU-guided run üçün ResNet modellərində təxminən 1–3 serial gün, VGG modellərində təxminən 2–4 serial gün hesablayır.
Vacib məhdudiyyət: Bunlar ucdan-uca ölçülmüş full-search wall-clock müddətləri deyil, serial cost estimates-dir. Candidate evaluations müstəqil olduğuna görə kifayət qədər worker olduqda paralel icra real wall-clock müddətini azalda bilər.
Appendix B: qarışıq dərəcə həqiqətən qatlar arasında dəyişirmi?
Bəli. Appendix B-dəki depth profiles CipherAPR-ın bütün activation layer-lara tək polynomial degree tətbiq etmədiyini göstərir. Depth dəyəri 0 olan activation prune/identity; depth 2 shallow polynomial; 2-dən yuxarı dəyərlər isə daha dərin composite approximations deməkdir.
Mənbənin verdiyi nümunədə CIFAR-10/ResNet32 üçün depth>2 activation sayı 7-bootstrapping setting-də 2 ikən 13-bootstrapping setting-də 12-yə yüksəlir. Buna baxmayaraq bəzi activation-lar prune edilir və ya depth 2-də saxlanılır. Bu, mixed-degree yanaşmanın həqiqətən layer-selective olduğunu göstərir.
Tədqiqatın dəstəklədiyi nəticələr
- CipherAPR sabit RNS-CKKS backend altında polynomial degree design-a restored-level utilization məlumatını daxil edir.
- Qiymətləndirilən ResNet və VGG konfiqurasiyalarında AutoFHE-yə nisbətən 1,09×–1,39× encrypted-inference speedup bildirilmişdir.
- Ən böyük bildirilən qazanc CIFAR-10/ResNet20 yüksək bootstrapping setting-də 4659 s-dən 3341 s-ə azalmadır.
- CipherAPR bir çox paired setting-də bootstrapping sayını azaltmışdır.
- Doqquz paired AutoFHE/CipherAPR setting-in yeddisində daha aşağı unused restored-level budget müşahidə edilmişdir.
- LMAR məhdud replacement budget altında activation layer prioritetləndirilməsi üçün faydalı forward-only heuristic kimi dəstəklənmişdir.
- DAAP + MOCT eyni approximation depth altında Minimax-a nisbətən MaxE-ni %39,44–%85,39 azaltmışdır.
- CLU final best score-u böyük ölçüdə dəyişdirmədən erkən search trajectory-də daha az CAPR evaluation ilə eyni CLU-run best səviyyəsinə çatmağa imkan vermişdir.
Tədqiqatın dəstəkləmədiyi nəticələr
- CipherAPR yeni və ya daha təhlükəsiz FHE şifrələmə sxemi deyil.
- CipherAPR RNS-CKKS encryption/decryption və ya bootstrapping primitive-i dəyişdirmir.
- 1,09×–1,39× sürətlənmə bütün şəbəkələr, aparat sistemləri və cryptographic parameter set-ləri üçün zəmanət deyil.
- Bootstrapping sayının təkbaşına encrypted-inference performansını müəyyən etdiyi nəticəsinə gəlmək olmaz.
- CAPR accuracy estimate yekun fully-trained encrypted-network accuracy deyil.
- Latency proxy real latency-nin bütün setting-lər arasında mütləq saniyə proqnozlaşdırıcısı deyil; within-setting ranking signal kimi istifadə olunur.
- CLU-nun final optimum score-u nəzərəçarpacaq dərəcədə yaxşılaşdırdığı deyilə bilməz; əsas faydası search trajectory-dədir.
- Offline search üçün verilən 1–4 günlük dəyərlər ölçülmüş end-to-end wall-clock müddətləri deyil, serial estimates-dir.
- Tədqiqat compiler-side scheduling-i əvəz etmir.
- ResNet/VGG və CIFAR-10/CIFAR-100 nəticələri Transformer arxitekturalarına birbaşa ümumiləşdirilə bilməz.
Əsas məhdudiyyətlər və gələcək iş
Tədqiqat fixed encrypted backend altında offline structural design-a fokuslanır. CipherAPR-ın yaratdığı mixed-degree polynomial network compiler-side bootstrapping scheduling-i əvəz etmir. Müəlliflər structural design ilə compiler scheduling-in birlikdə optimallaşdırılmasını təbii növbəti iş kimi görürlər.
Daha dərin CNN-lərdə degree-assignment search space və CAPR evaluation xərci activation layer sayı ilə artır. Mənbə ResNet-110 kimi daha dərin şəbəkələrdə daha səmərəli accuracy proxies və ya hybrid importance metrics tələb oluna biləcəyini bildirir.
Transformer architecture-lara genişləndirmə də ayrıca tədqiqat problemidir. Softmax, layer normalization və attention blocks CNN ReLU-larından fərqli polynomial approximation və ciphertext-level consumption xüsusiyyətlərinə malikdir. Buna görə mövcud ResNet/VGG nəticələri Transformer-a avtomatik şəkildə ötürülə bilməz.
Təhlükəsizlik əhatəsi
CipherAPR-ın security discussion-ı standart FHE inference confidentiality ilə məhdudlaşır. Çevrimdışı mərhələdə LMAR, DAAP, MOCT, CAPR və CLU istifadəçi inference ciphertext-lərini görmür. Online mərhələdə server:
hesabını standart RNS-CKKS üzərində icra edir.
\(\tilde{f}\), CipherAPR-ın çevrimdışı yaratdığı fixed public polynomial network; \(pk\), public evaluation key; \(ct_{\mathrm{in}}\) şifrələnmiş istifadəçi girişi; \(ct_{\mathrm{out}}\) isə şifrələnmiş çıxarım nəticəsidir.
Mənbə CipherAPR-ın standard encryption, decryption, key-switching və ya bootstrapping mexanizminə yeni cryptographic primitive əlavə etmədiyini vurğulayır. Buna görə confidentiality claim mövcud RNS-CKKS security parameterization və RLWE hardness assumptions ilə məhdudlaşır.
Mənbə və Metod Qeydi
Orijinal başlıq: CipherAPR: Accelerating RNS-CKKS Encrypted Inference via Importance-Guided and Level-Aware Mixed-Degree Polynomial Design
Müəlliflər: Junping Wan; Yucen Liao; Yinglong Liao; Zejiu Tan; Jinming Xu; Zoe L. Jiang; Binxing Fang.
Müəllif sırası: Junping Wan birinci; Yucen Liao ikinci; Yinglong Liao üçüncü; Zejiu Tan dördüncü; Jinming Xu beşinci; Zoe L. Jiang altıncı; Binxing Fang yeddinci müəllifdir.
Məsul müəlliflər: Zoe L. Jiang və Binxing Fang.
Qurum 1: School of Computer Science and Technology, Harbin Institute of Technology, Shenzhen 518055, China.
Qurum 2: Department of Optoelectronic Engineering, Jinan University, Guangzhou 510632, China.
Qurum 3: College of Control Science and Engineering, Zhejiang University, Hangzhou 310027, China.
Qurum 4: School of Cyberspace Security, Guangzhou University, Guangzhou 510006, China.
Bərabər töhfə: Mənbədə bərabər birinci müəlliflik və ya bərabər töhfə bəyanatı yoxdur.
Jurnal: Cryptography.
Nəşriyyat: MDPI.
Cild / nömrə / məqalə: 10(4), Article 44.
Səhifə sayı: 28.
DOI: 10.3390/cryptography10040044.
Göndərilmə: 11 may 2026.
Reviziya: 19 iyun 2026.
Qəbul: 19 iyun 2026.
Nəşr: 2 iyul 2026.
Mənbə növü: Rəyli tədqiqat məqaləsi; FHE altında encrypted neural-network inference üçün çevrimdışı alqoritmik design/search, polynomial approximation, cryptographic execution benchmark və ablation/sensitivity analizlərini birləşdirir.
Rəy prosesi: Cryptography rəyli MDPI jurnalidir; MDPI-nin cari proses izahında single-anonymized peer review istifadə olunur.
Preprint statusu: Verianla-da işlənən fayl dərc edilmiş Version of Record-dur; bu tədqiqatda ayrıca preprint əsas götürülməmişdir.
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Açar sözlər: encrypted inference; bootstrapping; ciphertext-level utilization; fully homomorphic encryption; RNS-CKKS.
Əsas model ailəsi: CIFAR-10 və CIFAR-100 üzərində ResNet20, ResNet32, ResNet44 və VGG11.
Əsas müqayisələr: MPCNN və AutoFHE. DaCapo, Orion və ReSBM compiler-side execution optimizers kimi müzakirə edilmiş, structural-design benchmark-a birbaşa baseline kimi daxil edilməmişdir.
FHE infrastrukturu: RNS-CKKS; Microsoft SEAL; AutoFHE implementation infrastrukturu.
Security setting: Ring degree \(2^{16}\); modulus-chain length 1552 bit; private-key Hamming weight 192; 128-bit security.
Offline training aparatı: NVIDIA RTX A6000, Ubuntu 20.04.
Encrypted inference aparatı: Intel Xeon Platinum 8462Y+, 128 vCPU, 1 TiB RAM, Ubuntu 20.04.
Offline proqram təminatı: Python 3.8, PyTorch 1.13.1.
Online encrypted execution: C++ və Microsoft SEAL.
Əsas metod komponentləri: LMAR, probabilistic degree tuning, DAAP, MOCT, latency proxy, CAPR və CLU.
Əsas performans nəticəsi: AutoFHE-yə nisbətən qiymətləndirilən konfiqurasiyalarda 1,09×–1,39× encrypted-inference speedup; oxşar ciphertext accuracy.
Ən yüksək bildirilən sürətlənmə nümunəsi: CIFAR-10/ResNet20 yüksək bootstrapping setting-də AutoFHE 4659 s və 11 bootstrapping; CipherAPR 3341 s və 7 bootstrapping.
Approximation nəticəsi: DAAP + MOCT, Table 7-də Minimax-a nisbətən MaxE dəyərini depth-dən asılı olaraq %39,44–%85,39 azaltmışdır.
CLU nəticəsi: Accuracy-oriented və latency-oriented search-də CLU final normalized best score-u böyük ölçüdə dəyişdirmədən CLU-run best-ə çatmaq üçün lazım olan CAPR evaluations-ı müvafiq olaraq 210/330 və 180/330 səviyyəsinə endirmişdir.
Maliyyələşdirmə: National Key R&D Program of China (2023YFB3106500); National Natural Science Foundation of China (62272131); Shenzhen Social Science Fund (SZ2025B011); Shenzhen Science and Technology Major Project (KJZD20230923114908017).
Məlumatların əlçatanlığı: Tədqiqatda təqdim edilən məlumatların corresponding author-dan əsaslandırılmış tələb əsasında əldə edilə biləcəyi bildirilmişdir. İstifadə olunan public datasets CIFAR-10 və CIFAR-100-dür.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşmasının olmadığını bəyan edirlər. Mənbə həmçinin funding sponsors-ın tədqiqat dizaynı, məlumat toplama/təhlil/şərh, məqalənin yazılması və ya nəşr qərarında rol oynamadığını bildirir.
Müəllif töhfələri: Conceptualization: Junping Wan, Jinming Xu, Zoe L. Jiang, Binxing Fang; methodology: Junping Wan, Yucen Liao, Yinglong Liao, Zejiu Tan; software: Junping Wan; validation: Junping Wan, Yucen Liao, Zejiu Tan; formal analysis: Junping Wan, Yinglong Liao, Zejiu Tan; investigation və data curation: Junping Wan; resources: Zoe L. Jiang və Binxing Fang; original draft: Junping Wan; review/editing: bütün müəlliflər; visualization: Yucen Liao, Yinglong Liao və Zejiu Tan; supervision/project administration/funding acquisition: Zoe L. Jiang və Binxing Fang.
Etik komitə / məlumatlandırılmış razılıq: Mənbə PDF-də ayrıca Institutional Review Board və ya Informed Consent bəyanatı bildirilməmişdir. Tədqiqat CIFAR benchmark-ları və hesablama əsaslı şifrələnmiş çıxarım təcrübələri üzərində aparılmışdır.
Əsas metodoloji məhdudiyyətlər: Tədqiqat fixed RNS-CKKS backend altında offline structural design-a fokuslanır; compiler scheduling-i əvəz etmir. Offline search xərci activation-layer sayı ilə artır. CAPR və latency proxy screening alətləridir və yekun full evaluation-ın yerini tutmur. Verilən 1–4 günlük search dəyərləri serial estimates-dir. Qiymətləndirmə CIFAR-10/CIFAR-100 və ResNet/VGG arxitekturaları ilə məhduddur; Transformer arxitekturaları ayrıca araşdırılmalıdır.
Security şərh sərhədi: CipherAPR-ın təhlükəsizlik iddiası yeni cryptographic primitive-ə aid deyil. Sistem standart RNS-CKKS encryption/decryption/key-switching/bootstrapping mexanizmindən istifadə edir; confidentiality istifadə olunan RNS-CKKS parameterization və RLWE fərziyyəsindən miras alınır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib