


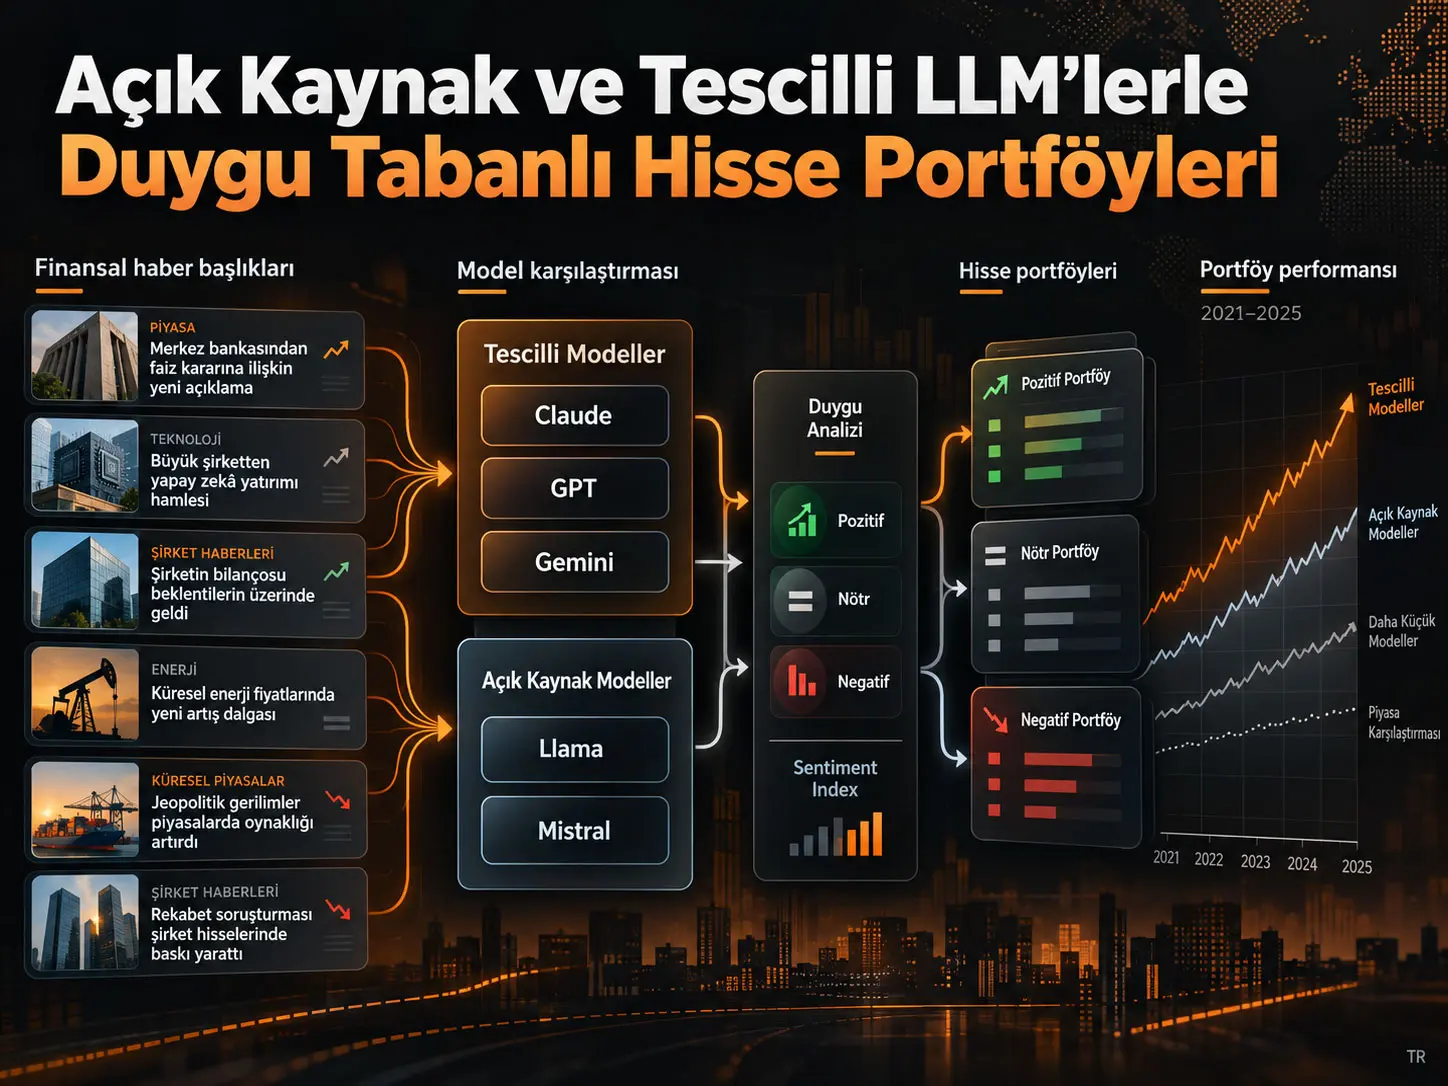
LLM tabanlı duygu portföyü, finansal haber başlıklarının büyük dil modelleri tarafından olumlu, olumsuz veya nötr olarak sınıflandırılması ve bu sınıflardan türetilen aylık şirket duygu puanlarının hisse seçiminde kullanılmasıyla oluşturulan bir portföy yaklaşımıdır. Felipe Affonso ve Marcelo S. Perlin, 2021–2025 döneminde S&P 500 şirketleri için temizleme sonrasında kalan 1.477.385 haber başlığını yedi büyük dil modeliyle sınıflandırmış; dört tescilli modeli ve yerel çalıştırılabilen üç ağırlığı erişilebilir modeli aynı rank-based portföy yöntemi altında karşılaştırmıştır. Kaynak örnekleminde en yüksek risk ayarlı performans Claude 3 Haiku’dan gelirken, Llama 3.1 8B ticari API modellerine yakın sonuç üretmiş; Llama 3.2 1B ise benchmarkı aşamamıştır. Bununla birlikte sonuçlar belirli veri, dönem, prompt, model sürümü ve portföy kuralı için geçerlidir; model stratejileri arasındaki alpha ve Sharpe farkları formal istatistiksel üstünlük testleriyle doğrulanmamıştır.
Çalışmanın önemli yanı yalnız “hangi LLM daha yüksek getiri verdi?” sorusu değildir. Araştırma aynı finansal sınıflandırma görevinde model ailesi, model kapasitesi, yerel çalıştırılabilirlik ve ticari API erişimi arasında pratik bir karşılaştırma yapmaktadır. Proprietary modeller genel olarak en yüksek risk ayarlı getirileri üretse de 8 milyar parametreli Llama 3.1’in Gemini 2.5 Flash’a yakın ve GPT-4.1 Nano’nun üzerinde sonuç vermesi, yerel çalıştırılan bir modelin belirli finansal metin sınıflandırma görevlerinde kullanılabilir alternatif olabileceğini göstermektedir.
Bu sonuç yatırım tavsiyesi veya gelecekte aynı getirilerin elde edileceğinin kanıtı değildir. Çalışma işlem maliyetlerini, komisyonları ve piyasa sürtünmelerini hesaba katmamaktadır; alpha yalnız S&P 500 eşit ağırlıklı benchmarkına karşı tek faktörlüdür; şirket büyüklüğü, değer, momentum ve sektör faktörlerine göre düzeltilmemiştir. Ayrıca model bilgi kesim tarihlerinin veri döneminin bir bölümünü kapsaması, pre-training yoluyla geçmiş olay bilgisinin tamamen dışlanmasını engellemektedir.
Araştırma problemi
Finansal piyasalarda metin uzun süredir yatırım sinyali olarak kullanılmaktadır. Geleneksel sözlük tabanlı yöntemler bir kelimeyi çevresindeki bağlamı yeterince dikkate almadan olumlu veya olumsuz sınıflandırabilir. Büyük dil modelleri ise bir haber başlığının bağlamını daha geniş biçimde işleyebildiği için finansal duygu çıkarımında farklı bir yaklaşım sunmaktadır.
Bununla birlikte önceki çalışmaların önemli bölümü tek bir tescilli model ailesine odaklanmıştır. Bu durum iki soruyu açık bırakır: Farklı ticari LLM’ler aynı finansal haberler üzerinde aynı yatırım sinyalini üretir mi ve yerel çalıştırılabilen daha küçük modeller ücretli ticari API’lere ne kadar yaklaşabilir?
Affonso ve Perlin bu boşluğu, aynı veri seti ve aynı portföy kuralı altında yedi LLM’yi karşılaştırarak ele almaktadır. Amaç bütün mevcut modeller için evrensel bir sıralama oluşturmak değildir. Araştırma, seçilmiş tescilli ve ağırlıkları erişilebilir modellerin aynı finansal metin görevi içinde oluşturduğu sinyallerin portföy sonuçlarını karşılaştırmaktadır.
Veri evreni neden dinamik S&P 500 üyeliğine dayanıyor?
Veri seti EOD Historical Data portalından alınan ABD şirket haber başlıklarına dayanır. Çalışma Ocak 2021–Aralık 2025 dönemini inceler. Her ay yalnız o ay gerçekten S&P 500 üyesi olan şirketler kullanılmıştır; 2025 sonundaki şirket listesinin geçmişe uygulanması tercih edilmemiştir.
Bu nokta yöntemsel olarak önemlidir. Yalnız dönem sonundaki şirketlerin geçmiş performansını incelemek, sonradan endekse giren veya daha önce endeksten çıkan şirketleri yanlış biçimde ele alarak seçim ve hayatta kalma yanlılığı yaratabilir. Point-in-time üyelik yaklaşımı, portföy evreninin her tarihte o tarihte bilinen endeks bileşimine dayanmasını sağlar.
1,69 milyon haber başlığından 1,48 milyonluk analitik örnekleme
| Aşama | 2021 | 2022 | 2023 | 2024 | 2025 | Toplam |
|---|---|---|---|---|---|---|
| Ham çıkarılan başlık | 246.365 | 281.361 | 291.426 | 230.335 | 640.082 | 1.689.569 |
| Çıkarılan metadata artefaktı | 5 | 18 | 1.997 | 6.406 | 0 | 8.426 |
| Çıkarılan yakın kopya | 41.657 | 21.757 | 28.952 | 19.899 | 91.493 | 203.758 |
| Nihai analitik örneklem | 204.703 | 259.586 | 260.477 | 204.030 | 548.589 | 1.477.385 |
Yakın kopyaların belirlenmesinde normalize edilmiş Levenshtein benzerlik oranı kullanılmıştır. Aynı şirkete ve aynı güne ait iki başlığın benzerlik oranı 0,6’nın üzerindeyse çiftlerden biri çıkarılmıştır. Aynı gün ve aynı şirket kısıtlaması, farklı ekonomik olaylara ilişkin fakat dil bakımından birbirine benzeyen haberlerin yanlışlıkla silinmesi riskini azaltmak için kullanılmıştır.
2025’teki haber hacmi sıçraması neden önemli?
2025’te ham haber sayısı 640.082’ye yükselmiş ve önceki yılların hacminin belirgin biçimde üzerine çıkmıştır. Kaynağa göre veri sağlayıcı bu dönemde yapılandırılmamış kaynaklardan haber çıkarmak için bir büyük dil modeli kullanmaya başlamıştır; ancak bu değişikliğin kesin başlangıç tarihi yayımlanmamıştır.
Yazarlar veri setini bu nedenle bölmek yerine tamamını korumuştur. Gerekçeleri, kullanılan Sentiment Index’in her şirket-ay içinde normalize edilmesi nedeniyle yalnız haber sayısının artmasının sinyal seviyesini mekanik olarak değiştirmemesidir. Bununla birlikte veri üretim sürecindeki bu değişiklik, dönemler arası karşılaştırma yapılırken göz önünde bulundurulması gereken bir veri kaynağı özelliğidir.
Sentiment Index Neyi Ölçer?
Sentiment Index, bir şirket hakkında belirli bir ayda sınıflandırılan olumlu ve olumsuz haberlerin göreli dengesini -1 ile +1 arasında ölçen normalize edilmiş bir duygu göstergesidir. +1 yalnız olumlu, -1 yalnız olumsuz sınıflandırmaların baskın olduğu uç durumları temsil eder; gösterge haber hacminin mutlak seviyesinden ziyade pozitif ve negatif haberlerin birbirine oranını kullanır.
Şirket \(i\) ve ay \(t\) için kullanılan denklem:
\[ SI_{i,t} = \frac{\sum POS-\sum NEG} {\sum POS+\sum NEG} \]
Burada \(POS\), ilgili şirket-ay için olumlu sınıflandırılmış haber sayısını; \(NEG\), olumsuz sınıflandırılmış haber sayısını gösterir. Formülün payı net duygu yönünü, paydası ise olumlu ve olumsuz haberlerin toplam hacmini normalize eder. Nötr olarak sınıflandırılan haberler bu formülün pozitif-negatif dengesine doğrudan girmez.
Gösterge mutlak “hisse getirisi tahmini” değildir. Bir sonraki aşamada yalnız şirketlerin birbirine göre sıralanmasını sağlayan göreli bir sinyal olarak kullanılır.
Hangi LLM’ler karşılaştırıldı?
| Grup | Model | Kaynakta verilen parametre bilgisi | Bağlam penceresi | Bilgi kesim tarihi / proxy |
|---|---|---|---|---|
| Tescilli | GPT-4.1 Nano | Açıklanmamış | 1M | Haziran 2024 |
| Tescilli | Claude 3 Haiku | Açıklanmamış | 200k | Ağustos 2023 |
| Tescilli | Claude 4.5 Haiku | Açıklanmamış | 200k | Şubat 2025 |
| Tescilli | Gemini 2.5 Flash | Açıklanmamış | 1M | Ocak 2025 |
| Yazarların “open-source” grubu | LLaMA 3.1 8B Instruct | 8 milyar | 128k | Aralık 2023 |
| Yazarların “open-source” grubu | LLaMA 3.2 1B Instruct | 1 milyar | 128k | Aralık 2023 |
| Yazarların “open-source” grubu | Mistral 7B Instruct v0.2 | 7 milyar | 32k | Aralık 2023 sürüm tarihi proxy olarak kullanıldı |
Kaynak başlık ve ana metinde Llama ile Mistral modellerini “open-source” olarak adlandırmaktadır; teknik özellikler tablosunda ise bu grup ayrıca “Weights Available” olarak tanımlanmıştır. Verianla metni bu terminolojik ayrımı değiştirmeden korumaktadır.
Neden daha ekonomik modeller seçildi?
Yaklaşık 1,5 milyon haber başlığının çok sayıda modelle işlenmesi yüksek hesaplama ve API maliyeti yaratmaktadır. Araştırmacılar bu nedenle çok ağır reasoning modelleri yerine göreli olarak ekonomik Flash, Haiku ve Nano sınıfı ticari modelleri; yerel tarafta ise 1B ile 7–8B parametre aralığındaki modelleri seçmiştir.
Çalışmanın amacı her model ailesinin en büyük sürümünü karşılaştırmak değil, finansal haber sınıflandırması ölçeğinde uygulanabilir modeller arasında pratik karşılaştırma yapmaktır.
Sınıflandırma nasıl yapıldı?
Tüm haber başlıklarında aynı standartlaştırılmış sınıflandırma mantığı kullanılmıştır. Modellerden her başlığı yatırımcı beklentileri açısından olumlu, olumsuz veya belirsiz/nötr olarak sınıflandırmaları istenmiştir. Kaynak iş akışında bu sınıflar YES, NO ve UNKNOWN çıktılarına karşılık gelmektedir.
Hesaplama verimliliği için aynı sorguda en fazla 10 haber başlığı işlenmiştir. Ticari API modellerinde sıcaklık sıfıra ayarlanmış; yerel modellerde örnekleme kapatılarak greedy decoding uygulanmıştır. Böylece aynı girdi için rastgele örnekleme kaynaklı çıktı değişkenliği azaltılmıştır.
Açık ağırlıklı modeller Hugging Face transformers kütüphanesiyle yerel olarak ve FP16 yarım hassasiyette çalıştırılmıştır. Ticari modeller ise sağlayıcı API’leri üzerinden çalıştırılmıştır. Kaynak ayrıca ticari API davranışının sürümler arasında değişebileceğini kabul ettiği için her modelin gerçek erişim dönemini teknik özellikler tablosunda ayrıca raporlamıştır.
Portföye dönüşüm nasıl yapıldı?
Ay \(t\) boyunca toplanan ve sınıflandırılan haberler önce her şirket için aylık Sentiment Index değerine dönüştürülmüştür. Portföy ay \(t+1\)’in ilk iş gününde oluşturulmuştur. Böylece aynı ayın gelecekteki fiyat hareketleri sinyali üretmek için kullanılmamaktadır.
Şirketler Sentiment Index’e göre yüksekten düşüğe sıralanmıştır. Portföy için hedef minimum 15 hisse belirlenmiştir. Kesim noktasındaki şirketlerin aynı duygu puanını taşıması durumunda bütün eşit puanlı hisseler portföye alınmış; dolayısıyla gerçek portföy büyüklüğü bazı aylarda 15’in üzerine çıkabilmiştir.
Her şirketin bir ayda portföy seçimine uygun olabilmesi için en az 15 haber başlığına sahip olması gerekmiştir. Bu kural düşük haber yoğunluğuna sahip şirketlerde aşırı oynak duygu ölçümlerini azaltırken, örneklemi daha fazla haber alan büyük ve görünür şirketlere doğru eğmektedir.
Portföydeki hisseler eşit ağırlıklandırılmış, bir ay tutulmuş ve sonraki ayın ilk iş gününde yeniden dengelenmiştir. Getiriler hem hisse bölünmelerine hem temettülere göre düzeltilmiş kapanış fiyatlarından hesaplandığı için toplam getiri niteliğindedir.
Benchmarklar
İki karşılaştırma noktası kullanılmıştır. Birincisi, her ay o ayki aktif S&P 500 üyelerinden oluşturulan eşit ağırlıklı S&P 500 portföyüdür. İkincisi ise aynı aktif üyelerden rastgele seçilmiş 15 hisselik portföylerin 1.000 Monte Carlo çekiminin ortalamasıdır.
Benchmark evreni yalnız yeterli haber alan şirketlerle sınırlandırılmamıştır. Bu nedenle LLM portföylerinin medya görünürlüğü filtresinin sonuçlarda rol oynayabileceği ayrıca dikkate alınmalıdır.
Çalışmanın Yöntemi ve Bulguları
Performans metrikleri
Çalışma yıllıklandırılmış getiri, yıllıklandırılmış volatilite, Sharpe oranı, maksimum drawdown, tek faktörlü alpha ve beta raporlamaktadır. Sharpe oranında risksiz faiz oranı sıfır kabul edilmiştir.
Alpha ve beta, her LLM stratejisinin aylık getirilerinin aylık S&P 500 EW getirisine karşı OLS regresyonuyla tahmin edilmiştir. Beta piyasa benchmarkına karşı duyarlılığı, alpha ise bu tek faktörlü ilişkide benchmark hareketiyle açıklanamayan getiri bileşenini temsil etmektedir.
2021–2025 ana performans sonuçları
| Strateji | Yıllık getiri (%) | Volatilite (%) | Sharpe | Maksimum düşüş (%) | Alpha (%) | Beta |
|---|---|---|---|---|---|---|
| Claude 3 Haiku | 14,18 | 15,11 | 0,94 | -17,14 | 7,73 | 0,90 |
| Claude 4.5 Haiku | 12,61 | 14,34 | 0,88 | -18,49 | 6,66 | 0,82 |
| Gemini 2.5 Flash | 11,25 | 14,91 | 0,75 | -16,28 | 4,73 | 0,89 |
| GPT-4.1 Nano | 10,41 | 15,87 | 0,66 | -23,20 | 3,82 | 0,89 |
| Llama 3.1 8B | 11,53 | 15,50 | 0,74 | -20,34 | 4,77 | 0,92 |
| Mistral 7B | 7,68 | 15,00 | 0,51 | -20,39 | 0,79 | 0,92 |
| Llama 3.2 1B | 4,61 | 15,44 | 0,30 | -23,59 | -2,18 | 0,91 |
| S&P 500 EW | 7,46 | 15,67 | 0,48 | -21,45 | 0,00 | 1,00 |
| Random 15 ortalaması | 7,42 | 15,69 | 0,47 | -21,58 | -0,05 | 1,00 |
Hangi LLM En Yüksek Portföy Performansını Üretti?
İncelenen 2021–2025 örnekleminde Claude 3 Haiku en yüksek yıllıklandırılmış getiri, Sharpe oranı ve tek faktörlü alpha kombinasyonunu üretmiştir: %14,18 getiri, 0,94 Sharpe ve %7,73 alpha. Ancak çalışma model farklarını formal alpha veya Sharpe anlamlılık testleriyle karşılaştırmadığı için bu sonuç “Claude 3 Haiku istatistiksel olarak bütün modellerden üstündür” biçiminde yorumlanmamalıdır.
Claude 3 Haiku ve Claude 4.5 Haiku
Claude 3 Haiku en yüksek getiri ve alpha değerlerini üretirken halefi Claude 4.5 Haiku %12,61 getiri, 0,88 Sharpe ve %6,66 alpha ile ikinci sırada yer almıştır.
Claude 4.5 Haiku’nun volatilitesi %14,34 ve betası 0,82 ile örneklemdeki en düşük değerler arasındadır. Buna rağmen eski Claude 3 Haiku’nun risk ayarlı getirisi daha yüksek kalmıştır. Çalışma bu durumu, yeni bir model sürümünün aynı finansal sinyal görevi üzerinde otomatik olarak daha güçlü sonuç vermediğinin örneği olarak kullanmaktadır.
Gemini 2.5 Flash ve GPT-4.1 Nano
Gemini 2.5 Flash %11,25 yıllık getiri ve 0,75 Sharpe üretmiştir. GPT-4.1 Nano’nun yıllık getirisi %10,41, Sharpe oranı 0,66’dır. Her iki stratejinin de tek faktörlü alpha değeri pozitiftir.
GPT-4.1 Nano’nun maksimum drawdown değeri -%23,20 ile S&P 500 EW’nin -%21,45 düzeyinden daha kötüdür. Dolayısıyla benchmarktan yüksek ortalama getiri üretmesi her piyasa koşulunda daha düşük kayıp anlamına gelmemektedir.
Yerel Çalıştırılan Llama 3.1 8B Ticari API’lere Yaklaşabildi mi?
Evet, incelenen görev ve dönem içinde Llama 3.1 8B %11,53 yıllık getiri, 0,74 Sharpe ve %4,77 tek faktörlü alpha üretmiş; bu değerlerle GPT-4.1 Nano’nun üzerinde ve Gemini 2.5 Flash’a yakın performans göstermiştir. Sonuç yerel çalıştırılabilen bir modelin bu özel finansal haber sınıflandırma görevinde kullanılabilir alternatif olabileceğini destekler, ancak bütün açık ağırlıklı modellerin veya bütün finansal görevlerin ticari API’lerle eşdeğer olduğunu kanıtlamaz.
Llama 3.1 8B ile Mistral 7B arasındaki fark ne gösteriyor?
Llama 3.1 8B ile Mistral 7B benzer parametre büyüklüğü sınıfında olmasına rağmen portföy performansları belirgin biçimde farklıdır. Llama 3.1 8B %11,53 getiri ve 0,74 Sharpe üretirken Mistral 7B %7,68 ve 0,51 seviyesinde kalmıştır.
Yazarlar bu farkın model büyüklüğünün tek başına yeterli açıklayıcı olmadığını düşündürdüğünü belirtmektedir. Eğitim verisi ve instruction-following yeteneği de finansal metin sınıflandırmasında rol oynayabilir. Bununla birlikte 7–8B aralığında yalnız iki model incelendiği için bu sonuç genel bir model-mimari yasası olarak yorumlanamaz.
1B model neden ayrı değerlendirilmelidir?
Llama 3.2 1B, %4,61 getiri ve 0,30 Sharpe ile hem S&P 500 EW hem rastgele portföy benchmarkının altında kalmış, tek faktörlü alpha -%2,18 olmuştur.
Kaynak, bu sonucun 1B modelin bilgilendirici duygu ile gürültüyü ayırmakta daha sınırlı olabileceğiyle uyumlu olduğunu belirtmektedir. Ancak örneklemde yalnız tek bir 1B model bulunduğu için sonucu “1 milyar parametrenin altındaki modeller finansal duygu analizinde başarısızdır” şeklinde genellemez. Fark, o modelin eğitim verisinden veya instruction-following özelliklerinden de kaynaklanabilir.
Maksimum drawdown ve 2022 ayı piyasası
Claude 3 Haiku, Claude 4.5 Haiku ve Gemini 2.5 Flash’ın maksimum düşüşleri S&P 500 EW benchmarkından daha küçüktür. GPT-4.1 Nano ise benchmarktan daha derin bir maksimum düşüş yaşamıştır.
Beta değerlerinin çoğunun yaklaşık 0,82–0,92 aralığında olması, LLM portföylerinin piyasadan bağımsız olmadığı fakat bazı stratejilerin S&P 500 EW’ye göre daha düşük piyasa duyarlılığı taşıdığı anlamına gelir.
Şekil 1’in bilimsel mesajı
Kaynağın Şekil 1’i bütün stratejilerin 2021 başındaki ortak başlangıç seviyesinden itibaren kümülatif servet gelişimini göstermektedir. En güçlü model çizgileri 2022 piyasa gerilemesi sırasında benchmarklardan ayrılmaya başlamış ve 2024–2025 döneminde fark genişlemiştir.
Ancak yazarlar bu son kısmı tek başına LLM sinyalinin gücü olarak yorumlamamaktadır. 2024–2025 dönemindeki büyük teknoloji şirketlerinin güçlü performansı, medya kapsamı yoğun şirketlere yönelen portföy evreniyle birlikte ölçülen farkın bir bölümünü açıklayabilir.
Şekilde Llama 3.2 1B stratejisinin çizgisi ise örneklemin büyük bölümünde S&P 500 EW’nin altında kalmaktadır. Bu görsel desen Tablo 3’teki düşük yıllık getiri, düşük Sharpe ve negatif alpha ile tutarlıdır.
Alpha neden dikkatli yorumlanmalıdır?
Claude 3 Haiku’nun %7,73 ve Llama 3.1 8B’nin %4,77 yıllıklandırılmış alpha değerleri yalnız S&P 500 EW’nin tek piyasa faktörü kullanılarak hesaplanmıştır.
Regresyon şirket büyüklüğü, value, momentum, sektör ağırlıkları veya başka bilinen varlık fiyatlama faktörlerini kontrol etmemektedir. Bu nedenle pozitif alpha’nın bir bölümü haber duyarlılığı dışında kalan sistematik maruziyetlerden kaynaklanabilir.
Özellikle en çok haber alan şirketlerin büyük ve görünür şirketler olması ve 2024–2025 dönemindeki teknoloji hissesi performansı bu yorum sınırını önemli hale getirmektedir.
Çalışma Gelecek Bilgisinin Kullanılmasını Tamamen Engelliyor mu?
Hayır. Araştırmacılar başlık tarihlerini model girdilerinden kaldırmış, haberleri zamandan bağımsız batch’ler halinde işlemiş ve modellere fiyat verisi vermemiştir; ancak bazı modellerin bilgi kesim tarihleri 2021–2025 örneklem döneminin içine düştüğü için pre-training sırasında belirli şirket olaylarını görmüş olma ihtimali tamamen ortadan kaldırılamamaktadır.
Look-ahead bias azaltma adımları
Birinci önlem, LLM sınıflandırması sırasında haber tarihlerinin model girdilerinden çıkarılmasıdır. İkinci önlem, başlıkların zamansal sıra bilgisi taşımayan batch’ler halinde sınıflandırılmasıdır. Üçüncü olarak LLM’lere hisse fiyatları verilmemiştir.
Bu önlemler modelin sınıflandırma sırasında doğrudan gelecekteki fiyatı görmesini engeller. Fakat model ön eğitiminde belirli bir şirket olayını veya haberini daha önce görmüş olabilir. Bu risk, özellikle modelin bilgi kesim tarihi incelenen haber tarihinden daha sonraysa tamamen giderilemez.
Post-cutoff kontrolü
Yazarlar bu riski değerlendirmek için modelin bilgi kesim tarihinden sonraki dönem üzerinde analizi tekrar etmiştir. En yeni iki modelin post-cutoff dönemi güvenilir karşılaştırma için çok kısa kalmıştır. Diğer modellerde alpha işareti tam örneklemdeki işaretini korumuştur.
Bu kontrol look-ahead sorununu azaltıcı bir sağlamlık analizi sunmaktadır; ancak şirket isimlerinin model belleğinde oluşturabileceği entity-level etkileri ortadan kaldırmamaktadır. Yazarların gelecekteki çalışma önerilerinden biri şirket adlarını anonimleştirerek semantik haber yorumunu öğrenilmiş marka çağrışımından ayırmaktır.
İşlem maliyetleri neden önemli bir eksiktir?
Portföyler her ay yeniden dengelenmektedir; buna rağmen çalışma alım-satım komisyonlarını, bid-ask spread’i, piyasa etkisini veya diğer işlem sürtünmelerini sonuçlardan düşmemektedir.
Bu nedenle Tablo 3 brüt strateji performansını göstermektedir. Çalışma net yatırım kârlılığını kanıtlamaz. İşlem maliyetlerinin eklenmesi kaynak tarafından doğrudan gelecek araştırma alanı olarak belirtilmektedir.
Ticari ve yerel modeller arasındaki maliyet karşılaştırıldı mı?
Hayır. Makale API maliyeti, yerel GPU maliyeti, enerji tüketimi, gecikme veya donanım yatırımını nicel olarak karşılaştırmamaktadır. Ticari modellerin kullanım kolaylığı ile yerel modellerin veri gizliliği ve maliyet kontrolü arasındaki fark tartışılmaktadır; ancak toplam sahip olma maliyeti ölçülmemiştir.
Bu nedenle “Llama 3.1 8B daha ucuzdur” veya “ticari API daha ekonomiktir” biçiminde kaynak-destekli nicel bir sonuç çıkarılamaz.
Çalışmanın desteklediği sonuçlar
- Finansal haber başlıklarından LLM tabanlı duygu sınıflandırması kullanılarak rank-based aylık hisse portföyleri oluşturulabilir.
- İncelenen örneklemde tescilli modeller genel olarak en yüksek risk ayarlı sonuçları üretmiştir.
- Claude 3 Haiku, incelenen modeller arasında en yüksek Sharpe oranı ve tek faktörlü alpha değerini üretmiştir.
- Claude 4.5 Haiku’nun eski Claude 3 Haiku’nun altında kalması, daha yeni model sürümünün aynı görevde otomatik olarak daha güçlü sinyal üretmediğini göstermektedir.
- Llama 3.1 8B, incelenen görevde Gemini 2.5 Flash’a yakın ve GPT-4.1 Nano’dan yüksek performans üretmiştir.
- Llama 3.2 1B benchmarkı aşmamış ve negatif tek faktörlü alpha üretmiştir.
- Benzer parametre büyüklüğündeki Llama 3.1 8B ile Mistral 7B arasındaki fark, parametre sayısının tek başına performansı açıklamadığını düşündürmektedir.
Çalışmanın desteklemediği sonuçlar
- Claude 3 Haiku’nun bütün finansal dönemlerde veya bütün piyasalarda en iyi LLM olduğu kanıtlanmamıştır.
- Model stratejileri arasındaki alpha veya Sharpe farklarının istatistiksel olarak anlamlı olduğu gösterilmemiştir.
- Raporlanan alpha’nın tamamının yalnız haber duyarlılığından kaynaklandığı kanıtlanmamıştır.
- 1B modellerin genel olarak finansal sınıflandırma için yetersiz olduğu sonucuna varılamaz; yalnız tek bir 1B model test edilmiştir.
- Açık ağırlıklı modellerin bütün ticari API modellerinin yerini alabileceği gösterilmemiştir.
- İşlem maliyetleri hesaba katılmadığı için stratejilerin net yatırım kârlılığı kanıtlanmamıştır.
- Pre-training kaynaklı geçmiş olay bilgisinin tamamen giderildiği gösterilmemiştir.
- Sonuçlar bireysel yatırımcı için alım-satım tavsiyesi oluşturmaz.
Gelecek çalışma yönleri
Kaynak üç ana genişleme alanı önermektedir. Birincisi, işlem maliyetlerinin ve diğer piyasa sürtünmelerinin portföy sonuçlarına eklenmesidir. İkincisi, üretken LLM’lerin finans alanına özel diskriminatif modellerle, örneğin FinBERT benzeri encoder yapılarıyla karşılaştırılmasıdır.
Üçüncü alan pre-training kaynaklı şirket kimliği bilgisidir. Şirket adlarının anonimleştirilmesi, modelin gerçekten haber semantiğini mi yorumladığını yoksa daha önce öğrendiği şirket ve marka çağrışımlarından mı yararlandığını daha temiz ayırabilir.
Kaynak ve Yöntem Notu
Tam özgün başlık: Open-Source versus Proprietary LLMs for Sentiment-Based Equity Portfolios.
Yazarlar: Felipe Affonso; Marcelo S. Perlin.
Kurum: Escola de Administração, Departamento de Finanças, Universidade Federal do Rio Grande do Sul (UFRGS), Porto Alegre, Brazil.
Corresponding author: Felipe Affonso.
Kaynak türü: Preprint / hakem değerlendirmesinden geçmemiş çalışma.
Hedef dergi: PDF üzerinde “Preprint submitted to Economics Letters” ifadesi bulunmaktadır.
Platform: SSRN.
SSRN kimliği: 7009844.
DOI: 10.2139/ssrn.7009844.
SSRN yayın tarihi: 27 Haziran 2026.
Hakemlik durumu: Yüklenen PDF açık biçimde çalışmanın henüz hakem değerlendirmesinden geçmediğini belirtmektedir.
Açık lisans: Yüklenen PDF ve doğrulanan SSRN kaydında Creative Commons veya eşdeğer açık yeniden kullanım lisansı doğrulanmamıştır. Bu nedenle Verianla anlatımı bilimsel olgular üzerinden bağımsız kurulmuş; kaynak metin, özgün tablo tasarımı veya Şekil 1’in görsel kompozisyonu kopyalanmamıştır.
Veri kaynağı: EOD Historical Data portalından ABD’de listelenmiş şirketlere ait finansal haber başlıkları.
İncelenen dönem: Ocak 2021–Aralık 2025.
Ham haber sayısı: 1.689.569.
Nihai analitik örneklem: 1.477.385 başlık.
Şirket evreni: Her ay için point-in-time tarihsel S&P 500 üyeleri.
Yakın kopya filtresi: Aynı şirket ve aynı tarihte normalize edilmiş Levenshtein benzerliği 0,6’nın üzerinde olan başlık çiftleri.
LLM görevi: Haber başlıklarının olumlu, olumsuz veya nötr/belirsiz olarak sınıflandırılması.
LLM sayısı: 7.
Tescilli modeller: GPT-4.1 Nano, Claude 3 Haiku, Claude 4.5 Haiku, Gemini 2.5 Flash.
Kaynağın open-source/weights-available grubundaki modeller: LLaMA 3.1 8B Instruct, LLaMA 3.2 1B Instruct, Mistral 7B Instruct v0.2.
Decoding: Tescilli API modellerinde temperature = 0; yerel modellerde greedy decoding ve do_sample=False.
Yerel çıkarım: Hugging Face transformers ve FP16.
Ana sinyal: Aylık şirket düzeyinde Sentiment Index.
Portföy kuralı: Önceki ayın duygu skoruna göre azalan sıralama, minimum hedef 15 hisse, eşit ağırlıklandırma, aylık yeniden dengeleme.
Medya filtresi: Şirket-ay başına en az 15 haber.
Benchmarklar: S&P 500 Equal Weighted ve aktif S&P 500 üyelerinden 1.000 Monte Carlo çekiminin ortalaması olan Random 15 portföyü.
Getiri türü: Bölünme ve temettülere göre düzeltilmiş toplam getiri.
Sharpe varsayımı: Risksiz faiz oranı sıfır.
Alpha/beta yöntemi: Aylık strateji getirilerinin S&P 500 EW aylık getirisine karşı tek faktörlü OLS regresyonu.
Formal model karşılaştırma testi: Alpha ve Sharpe farkları için formal model-arası anlamlılık testi raporlanmamıştır; sonuçlar betimleyici sunulmaktadır.
Look-ahead kontrolü: Haber tarihleri model girdisinden çıkarılmış, sınıflandırma zamansal sıra bilgisi taşımayan batch’lerle yapılmış ve modellere hisse fiyatı verilmemiştir. Bununla birlikte pre-training yoluyla olay bilgisi tamamen dışlanamamaktadır.
Post-cutoff kontrolü: Yeterli post-cutoff gözleme sahip modellerde alpha işareti tam örneklemdeki işaretini korumuştur; en yeni iki model için pencere çok kısadır.
Finansman: Coordenação de Aperfeiçoamento de Pessoal de Nível Superior – Brasil (CAPES), Finance Code 001.
Üretken yapay zekâ beyanı: Yazarlar nihai metnin okunabilirliğini geliştirmek için Google Gemini kullandıklarını, çıktıyı gözden geçirip düzenlediklerini ve makale içeriğinin sorumluluğunu üstlendiklerini beyan etmektedir.
Çıkar çatışması: Yüklenen PDF’de ayrı bir çıkar çatışması bildirimi raporlanmamıştır.
CRediT / yazar katkıları: Yüklenen PDF’de ayrıntılı CRediT katkı beyanı raporlanmamıştır.
Veri erişilebilirliği: Kaynak veri sağlayıcısı belirtilmekle birlikte PDF’de ayrı ve açık bir veri erişilebilirliği bölümü raporlanmamıştır.
Temel sınırlılıklar: İşlem maliyetlerinin dışlanması; yalnız tek faktörlü alpha kullanılması; model bilgi kesim tarihlerinin örneklemle kısmen çakışması; şirket başına minimum haber filtresinin medya görünürlüğü yüksek firmalara yönelmesi; 2025’te veri sağlayıcının haber çıkarım sürecindeki değişiklik; yalnız yedi modelin incelenmesi; yalnız tek 1B model bulunması; API sürümlerinin zaman içinde değişebilmesi; maliyet, gecikme ve donanım gereksinimlerinin nicel olarak ölçülmemesi.
Şekil 1: 2021–2025 kümülatif servet gelişimini model stratejileri, S&P 500 EW ve Random 15 benchmarkı için karşılaştırmaktadır. En güçlü stratejiler 2022 sonrasında benchmarktan ayrılırken Llama 3.2 1B örneklemin büyük bölümünde benchmarkın altında kalmaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir