

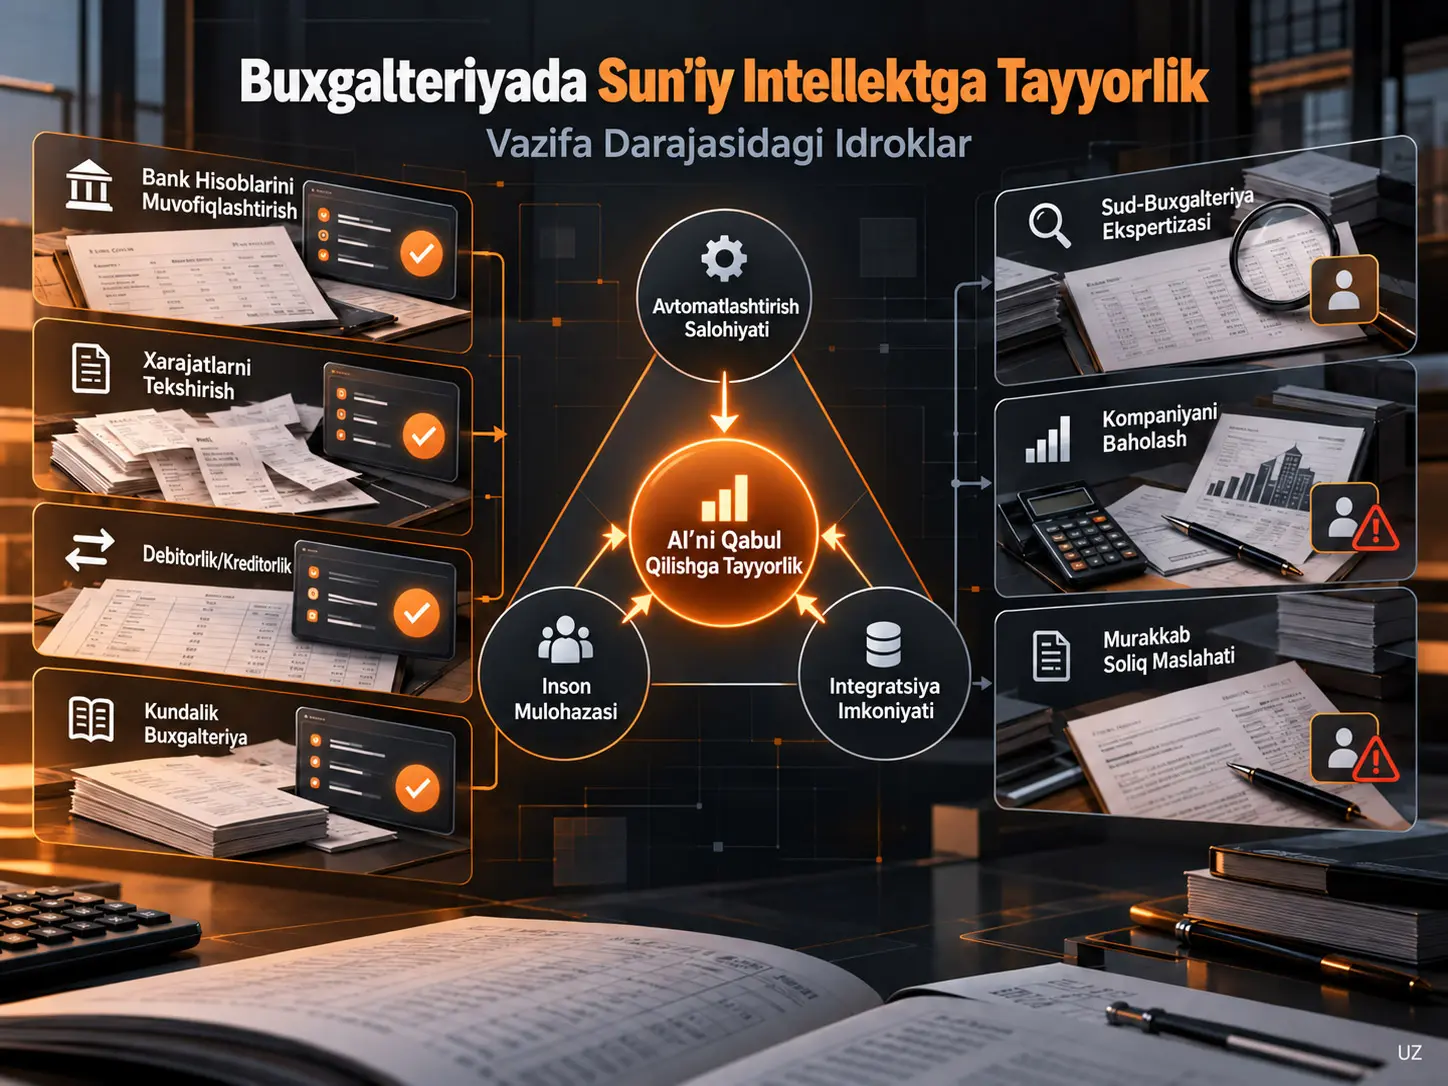
Vazifa darajasida sunʻiy intellektni qabul qilishga tayyorlik (Adoption Readiness, AR), buxgalteriya mutaxassisi muayyan ishni bajarayotganda AI yordami mavjud boʻlganida undan foydalanishga qay darajada tayyor boʻlishini ifodalovchi 1–5 shkalali xulq-atvor niyati oʻlchovidir. Wil Martens tadqiqoti Tayvandagi 24 buxgalteriya mutaxassisi 24 ta namunaviy buxgalteriya vazifasini baholashi natijasida olingan 576 ta vazifa darajasidagi kuzatuv asosida bu tayyorlik qaysi vazifa xususiyatlari bilan bogʻliqligini oʻrganadi. Asosiy ordered logistic regression natijalarida avtomatlashtirish salohiyati va mavjud ish jarayoniga integratsiya qilish qulayligi AIʻdan foydalanishga yuqoriroq tayyorlik bilan ijobiy bogʻliq boʻlgan, GPT tizimlari bilan oldingi koʻproq tajriba esa pastroq tayyorlik bilan bogʻlangan. Inson mulohazasiga ehtiyoj koeffitsiyenti manfiy yoʻnalishda, biroq manba matnida p = 0,160 deb xabar qilingani sababli bu statistik jihatdan qatʻiy tasdiqlangan bogʻliqlik emas.
Tadqiqotning asosiy taklifi shuki, buxgalteriyada AIʻni qabul qilishni faqat texnologiyaning qanchalik kuchli yoki samarali ekani bilan izohlab boʻlmaydi. Vazifani audit qilish mumkinligi, natija manbasini kuzatish mumkinligi, reviewer sign-off mexanizmi mavjudligi va AI natijasini amaldagi nazorat jarayoniga asosli tarzda joylashtirish mumkinligi ham qabul qilishga tayyorlik bilan bogʻliq. Muallif bu tuzilmani task-governance fit, yaʻni vazifa bilan boshqaruv infratuzilmasining muvofiqligi doirasida muhokama qiladi.
Biroq tadqiqot AIʻdan haqiqiy foydalanishni, xatolik darajasini, xarajat tejalishini yoki ish samaradorligini oʻlchamaydi. Ishtirokchilar kichik, maqsadli tanlangan expert panel boʻlib, natija oʻzgaruvchisi haqiqiy foydalanish xatti-harakati emas, balki bildirilgan foydalanish istagidir. Shu sababli natijalar nazariyani rivojlantiruvchi va gipoteza yaratuvchi bogʻliqliklar sifatida talqin qilinishi, umumiy buxgalterlar aholisi uchun qatʻiy yoki sababiy xulosalar sifatida qaralmasligi kerak.
Tadqiqotning asosiy muammosi
Sunʻiy intellekt tizimlaridan buxgalteriya ishlarida texnik jihatdan foydalanish mumkinligi buxgalterlar ushbu tizimlarga bir xil darajada ishonishini anglatmaydi. Bank hisoblarini muvofiqlashtirish, xarajatlarni tekshirish yoki debitorlik-kreditorlik hisoblarini qayta ishlash kabi muntazam vazifalar bilan sud-buxgalteriya ekspertizasi, kompaniyani baholash yoki murakkab audit baholashlari bir xil kasbiy masʻuliyat darajasiga ega emas.
Shu sababli tadqiqot tahlil birligini “foydalanuvchi”dan “vazifa”ga koʻchiradi. Mutaxassisning AIʻga umumiy ijobiy yoki salbiy munosabatini oʻlchash oʻrniga quyidagi savolga eʻtibor qaratadi: Ayni bir mutaxassis turli buxgalteriya vazifalarida AIʻdan foydalanishga nega turli darajada tayyor boʻlishi mumkin?
Technology Acceptance Model (TAM), Unified Theory of Acceptance and Use of Technology (UTAUT) va Diffusion of Innovation kabi shakllangan yondashuvlar odatda foydalanish qulayligi, foyda, ijtimoiy taʻsir yoki individual texnologik tayyorlikka eʻtibor qaratadi. Tadqiqot koʻrsatgan adabiyot boʻshligʻi shundaki, hisobdorlik darajasi yuqori kasblarda vazifaga xos audit qilinuvchanlik, kuzatuvchanlik va reviewer approval tuzilmalarini bu modellar yetarlicha qamrab olmaydi.
Vazifa–boshqaruv muvofiqligi nima?
Vazifa–boshqaruv muvofiqligi AI tizimining muayyan kasbiy vazifaga faqat texnik jihatdan tatbiq etilishi mumkinligini emas, balki uning natijasini kuzatish, tekshirish va mavjud tasdiqlash/koʻrib chiqish jarayonlari ichida kasbiy jihatdan himoya qilish mumkinligini anglatadi. Ushbu tadqiqotda ayniqsa Integration Feasibility oʻzgaruvchisi audit trail, traceability, reviewer sign-off va approval workflow kabi mavjud nazorat mexanizmlari AIʻdan foydalanishni qay darajada qoʻllab-quvvatlashini ifodalaydi.
Bu farq muhim. Texnik jihatdan oson AI ilovasi, natijani kim tekshirishi yoki xato uchun kim javob berishi noaniq boʻlsa, integratsiyaning amalga oshirilish imkoniyati past boʻlishi mumkin. Aksincha, sud-buxgalteriya ekspertizasi kabi mazmunan murakkab vazifa kuchli audit trail va koʻrib chiqish mexanizmlari tufayli AIʻning yordamchi rolini yanada nazoratli tarzda qamrab olishi mumkin.
Beshta asosiy idrok oʻzgaruvchisi
| Oʻzgaruvchi | Oʻzbekcha izoh | Oʻlchov | Modeldagi roli |
|---|---|---|---|
| GPT Exposure | GPT turidagi vositalar bilan oldingi kasbiy tanishlik | 1–5 Likert | Nazorat oʻzgaruvchisi |
| Automation Potential (AP) | Vazifa tarkibiy qismlarini AI bilan almashtirish mumkinligi | %0–100, tahlilda besh guruhga aylantirilgan | Asosiy tushuntiruvchi oʻzgaruvchi |
| Human Judgment Necessity (HJ) | Ixtiyoriy baholash, axloqiy talqin va kasbiy mulohazaga ehtiyoj | 1–5 Likert | Asosiy tushuntiruvchi oʻzgaruvchi |
| Task Complexity (TC) | Vazifaning bilim sohasi kengligi va kontekstual murakkabligi | 1–10, tahlilda 1–5 ga masshtablangan | Kontekstual oʻzgaruvchi |
| Integration Feasibility (IC) | AIʻni mavjud koʻrib chiqish va nazorat jarayoniga joylashtirish mumkinligi | 1–5 integratsiya xarajati; teskari kodlangan | Asosiy tushuntiruvchi oʻzgaruvchi |
| Adoption Readiness (AR) | Muayyan vazifada AI yordamidan foydalanish istagi | 1–5 ordinal shkala | Bogʻliq oʻzgaruvchi |
Adoption Readiness qanday soʻralgan?
Ishtirokchilarga mohiyatan quyidagi xulq-atvor niyati savoli berilgan: hozirgi rollarida tegishli vazifa uchun AI yordami taqdim etilsa, undan foydalanishga qanchalik tayyor boʻlar edilar? Javob 1 = strongly unwilling dan 5 = strongly willing gacha oʻlchangan.
Bu oʻlchov haqiqiy xatti-harakatni emas, foydalanish niyatini ifodalaydi. Ishtirokchining AR = 5 deb javob berishi uning AI tizimidan haqiqiy ishda foydalanganini yoki tizim ishonchli natija berganini koʻrsatmaydi.
Uchta asosiy gipoteza
H1: Yuqoriroq Automation Potential yuqoriroq Adoption Readiness bilan bogʻliq.
H2: Yuqoriroq Human Judgment Necessity pastroq Adoption Readiness bilan bogʻliq.
H3: Yuqoriroq Integration Feasibility yuqoriroq Adoption Readiness bilan bogʻliq.
Task Complexity asosiy modeldan chiqarilgan; chunki manbada uning HJ bilan yuqori kollinearlik koʻrsatishi qayd etilgan. Asosiy bayon va modellashtirish boʻlimida bu sabab r = 0,74 deb berilgan, eʻlon qilingan Spearman Table 3 da esa HJ–TC koeffitsiyenti 0,65. Bu ikki manba qiymati alohida kontekstlarda xabar qilinishi kerak.
Tadqiqotda kimlar ishtirok etdi?
| Xususiyat | Taqsimot |
|---|---|
| CPA | 8 kishi |
| Boshqaruv | 8 kishi |
| Buxgalteriya xodimi | 4 kishi |
| Buxgalteriya oʻqituvchisi | 4 kishi |
| 0–5 yil tajriba | 4 kishi |
| 6–20 yil tajriba | 16 kishi |
| 20+ yil tajriba | 4 kishi |
| Kuzatuv suhbati | 20 kishi |
Ishtirokchilar moliya va bank, texnologiya, mehmondoʻstlik hamda buxgalteriya taʻlimi sohalaridan kelgan. Tanlash maqsadli va referral-based usullar bilan amalga oshirilgan; maqsad statistik aholi vakilligi emas, kasbiy rol va tajriba xilma-xilligini taʻminlashdir.
Nega Tayvan tanlandi?
Tadqiqot Tayvanni ilgʻor texnologik salohiyat bilan kuchli kasbiy hisobdorlik tuzilmasi bir vaqtda mavjud boʻlgan critical case sifatida qoʻllaydi. Buxgalterlar individual sign-off va huquqiy javobgarlikni zimmasiga oladigan muhitda AI nafaqat samaradorlik, balki kuzatuvchanlik va kasbiy jihatdan himoya qilinuvchanlik nuqtayi nazaridan ham baholanishi kutiladi.
Shu sababli mamlakat konteksti tadqiqot dizaynining bir qismidir; biroq natijalarni boshqa mamlakatlarga avtomatik ravishda koʻchirish mumkin emas.
Vazifalar haqidagi idroklar oʻzaro qanday bogʻlangan?
Spearman korrelyatsiya tahlilida GPT Exposure bilan Automation Potential oʻrtasida 0,60 ijobiy bogʻliqlik xabar qilingan. Automation Potential Human Judgment Necessity bilan −0,29, Task Complexity bilan −0,33 va Integration Feasibility bilan −0,36 korrelyatsiya koʻrsatgan. HJ bilan TC oʻrtasidagi Spearman korrelyatsiyasi 0,65, HJ bilan IC oʻrtasidagi korrelyatsiya 0,57, TC bilan IC oʻrtasidagi korrelyatsiya 0,50.
| Oʻzgaruvchilar jufti | Spearman korrelyatsiyasi |
|---|---|
| GPT Exposure – AP | 0,60*** |
| AP – HJ | −0,29*** |
| AP – TC | −0,33*** |
| AP – IC | −0,36*** |
| HJ – TC | 0,65*** |
| HJ – IC | 0,57*** |
| TC – IC | 0,50*** |
*** p < 0,001.
Bu naqsh muntazam va almashtirilishi mumkin boʻlgan vazifalar bilan yuqori mulohaza/murakkablik talab qiladigan vazifalar idrok jihatidan farqlanishini koʻrsatadi; biroq korrelyatsiyalar sababiy yoʻnalishni bildirmaydi.
Buxgalterlar AIʻdan qaysi vazifalarda foydalanishga koʻproq tayyor koʻrinadi?
Tadqiqotning asosiy natijasi shuki, AI vazifaning kattaroq qismini avtomatlashtira oladigan va mavjud audit/koʻrib chiqish oqimiga osonroq joylashtiriladigan vazifalarda bildirilgan AIʻdan foydalanish istagi yuqoriroq. Aksincha, kuchli inson mulohazasi talab qilinadigan vazifalarda tayyorlik koeffitsiyenti manfiy yoʻnalishda, biroq statistik jihatdan qatʻiy tasdiqlanmagan; shu bois tadqiqot “inson mulohazasi oshgani sari AI rad etiladi” degan qatʻiy xulosani qoʻllab-quvvatlamaydi.
Masalan, muntazam buxgalteriya yangilanishlari, xodim xarajatlarini tekshirish va payable/receivable operatsiyalari avtomatlashtirish salohiyati yuqori vazifalar qatorida koʻrilgan, forensic accounting va business valuation esa vazifa murakkabligi hamda inson mulohazasiga ehtiyojning yuqoriligini koʻrsatgan.
Appendix B da eng yuqori Task Complexity oʻrtachalari forensic accounting uchun 4,50 va business valuation uchun 4,17. Eng yuqori Human Judgment Need qiymatlari mos ravishda 4,00 va 3,67. Automation Potential boʻyicha managing cash flow, examining expenses va payables & receivables vazifalarining har biri 4,00 oʻrtachaga erishgan.
Tadqiqot Usuli va Natijalari
Asosiy statistik model
Bogʻliq oʻzgaruvchi Adoption Readiness 1–5 tartibli shkalada boʻlgani uchun asosiy model ordered logistic regression hisoblanadi. Tahlil birligi 576 ta task-level rating. Ayni bir ishtirokchi 24 vazifani baholagani sababli kuzatuvlar bir-biridan toʻliq mustaqil emas; asosiy modelda standart xatolar respondent darajasida cluster-robust tarzda hisoblangan. Qoʻshimcha barqarorlik spetsifikatsiyalarida respondent random intercept ishlatilgan.
| Oʻzgaruvchi | β | Odds Ratio | Standart xato | Manba talqini |
|---|---|---|---|---|
| GPT Exposure | −0,340 | 0,712 | 0,074 | p < 0,001; manfiy bogʻliqlik |
| Automation Potential | +0,476 | 1,610 | 0,086 | p < 0,001; ijobiy bogʻliqlik |
| Human Judgment Necessity | −0,135 | 0,873 | 0,096 | Asosiy matnda p = 0,160; ahamiyatli emas |
| Integration Feasibility | +0,411 | 1,509 | 0,091 | p < 0,001; ijobiy bogʻliqlik |
Modelda 576 ta kuzatuv mavjud. Log-likelihood −899,61, AIC 1815, BIC 1850, McFadden R² 0,026 va Nagelkerke R² 0,084 deb xabar qilingan. Past pseudo-R² qiymatlari muallif tomonidan tadqiqotning izlanish xususiyati va AIʻni qabul qilish qarorlarining koʻp omilli ekaniga mos deb qaralgan.
Manba ichidagi belgilash ogohlantirishi: Table 5 ning HJ qatorida bitta yulduz bosilgan boʻlsa-da, ayni boʻlimda p = 0,160 ekani va bogʻliqlik conventional significance threshold ga yetmagani bir necha bor aniq yozilgan. Shu sababli H2 statistik jihatdan tasdiqlangandek taqdim etilmasligi kerak.
Odds ratio natijalari nimani anglatadi?
Ordered logit modelida odds ratio, boshqa oʻzgaruvchilar oʻzgarmas holda, tushuntiruvchi oʻzgaruvchidagi oʻsishning yuqoriroq Adoption Readiness toifalarida boʻlish odds-i bilan bogʻliqligini koʻrsatadi. AP uchun OR = 1,610 va IC uchun OR = 1,509 yuqoriroq readiness yoʻnalishidagi bogʻliqlikni, GPT Exposure uchun OR = 0,712 esa pastroq readiness yoʻnalishidagi bogʻliqlikni koʻrsatadi; bular sababiy taʻsirlar emas.
Automation Potential taʻsirining kattaligi
Manba faqat koeffitsiyent bermagan, balki oʻzgaruvchilar Q25 dan Q75 ga koʻchirilganda model bashorat qilgan AR toifasi ehtimollarini ham hisoblagan.
| Oʻzgaruvchi | P(AR=1), past | P(AR=1), yuqori | P(AR=5), past | P(AR=5), yuqori |
|---|---|---|---|---|
| Automation Potential | 0,364 | 0,181 | 0,098 | 0,219 |
| Integration Feasibility | 0,306 | 0,162 | 0,123 | 0,242 |
| GPT Exposure | 0,174 | 0,294 | 0,227 | 0,129 |
| Human Judgment Necessity | 0,207 | 0,256 | 0,191 | 0,153 |
Automation Potential Q25 dan Q75 ga koʻtarilganda model P(AR=1) ni 0,364 dan 0,181 ga tushiradi, P(AR=5) ni esa 0,098 dan 0,219 ga oshiradi. Integration Feasibility uchun P(AR=5) 0,123 dan 0,242 ga koʻtariladi. Bu ehtimollar modelga asoslangan bashoratlardir; haqiqiy foydalanish darajalari emas.
Nega GPT tajribasi pastroq tayyorlik bilan bogʻliq boʻlishi mumkin?
GPT Exposure koeffitsiyenti manfiy va statistik jihatdan ahamiyatli. Muallif buni experience-skepticism effect deb talqin qiladi: katta til modellari bilan koʻproq amaliy tajriba foydalanuvchilarning model cheklovlari, tekshirish zarurati va xatolarni realroq koʻrishiga olib kelishi mumkin.
Biroq ushbu tadqiqot bu mexanizmni bevosita sinamaydi. “Koʻproq GPT tajribasi albatta shubha bilan qarashga sabab boʻladi” degan xulosani chiqarib boʻlmaydi. Manfiy koeffitsiyent manba maʻlumotlarida kuzatilgan bogʻliqlikdir; experience-skepticism esa muallifning ushbu bogʻliqlikka mos nazariy talqinidir.
Nega inson mulohazasi natijasi ehtiyotkorlik bilan oʻqilishi kerak?
Human Judgment Necessity koeffitsiyenti kutilgan yoʻnalishda manfiy, biroq manbada p = 0,160 deb xabar qilingan. Shu sababli H2 uchun faqat yoʻnalishli, ammo xulosasiz/inconclusive dalil mavjud.
Muallif ikkita ehtimoliy cheklovni muhokama qiladi: taʻsir bu kichik namunada haqiqatan ham zaif boʻlishi mumkin yoki HJ ning Task Complexity bilan yuqori korrelyatsiyasi mustaqil koeffitsiyentning aniqligini kamaytirgan boʻlishi mumkin. Bundan tashqari, vazifa turi, ish staji yoki mulohaza xususiyati kabi oʻlchanmagan moderatorlar ham rol oʻynashi mumkin.
20 ta kuzatuv suhbati qanday maqsadda ishlatildi?
Kuzatuv suhbatlari asosiy statistik natijalar oʻrnini bosish uchun emas, koeffitsiyentlarning kasbiy kontekstini anglash uchun ishlatilgan. Suhbatlar Mandarin tilida yozib olinib verbatim transcribe qilingan, muayyan qismda back-translation qoʻllangan va qolgan mazmun ikki tilli koʻrib chiqish bilan tekshirilgan.
Back-translation faqat maqsadli transcript quyi toʻplamining %29 iga qoʻllangan. Muallif buni ochiq ravishda dizayn cheklovi sifatida tan oladi. Toʻliq thematic analysis bu maqolaning asosiy natijasi emas; u companion qualitative study da xabar qilingan.
Uchta vazifa profili
Ward linkage dan foydalangan hierarchical clustering GPT Exposure, AP, HJ, TC va IC ning standartlashtirilgan qiymatlari asosida uchta klaster hosil qilgan. 11-sahifadagi dendrogram uchlik yechimni, uning darhol ostidagi kernel density grafiklari esa klasterlarning oʻzgaruvchi profillaridagi farqni koʻrsatadi.
| Klaster | Asosiy profil | Namuna vazifalar | Manbada tavsiya qilingan AI yondashuvi |
|---|---|---|---|
| Cluster 1 — Judgment-first | Yuqori HJ va TC; oʻrta-yuqori IC | Forensic accounting, business valuation, audit leadership | Copilot uslubidagi yordam + majburiy inson sign-off |
| Cluster 2 — Automation-oriented | Yuqori AP va GPT Exposure; past HJ | Xarajatlarni tekshirish, kundalik buxgalteriya ishlari, payable/receivable | AIʻni qabul qilish uchun eng bevosita boshlangʻich soha |
| Cluster 3 — Intermediate | AP, HJ va IC boʻyicha oʻrta daraja | Bank hisoblarini muvofiqlashtirish, tartibga soluvchi talablarga muvofiqlik, moliyaviy bashorat | Qaror firma boshqaruvi va kasbiy tajribaga koʻproq bogʻliq |
Bu klasterlash tavsifiydir. Uch profil tabiiy yoki universal buxgalteriya vazifalari sinflari sifatida isbotlanmagan.
Barqarorlik tekshiruvlari
Tadqiqotchi AP foizlarini qayta guruhlash, GPT Exposure ni ordinal sifatida koʻrib chiqish va TC/IC shkalalarini qayta kodlash kabi muqobil oʻlchov variantlarini sinagan hamda koeffitsiyentlar sezilarli darajada oʻzgarmaganini xabar qilgan.
Ordered logit va OLS spetsifikatsiyalari bir xil umumiy yoʻnalishni bergan; HC3 standart xatolari va nonparametric bootstrap confidence intervals oʻxshash statistik xulosalarga olib kelgan.
Leave-one-respondent-out tahlilida koeffitsiyentlar kutilgan namuna shovqini doirasida barqaror qolgan. Firma hajmiga doir multivariate naqshlar 9999 permutation ishlatgan permutation MANOVA bilan alohida sinovdan oʻtkazilgan. Uch klaster tuzilishi k-means va muqobil distance metrics bilan sifat jihatidan saqlangan.
Oʻlchov diagnostikasi
| Oʻlchov | Qiymat |
|---|---|
| Cronbach's α | 0,441 |
| %95 ishonch oraligʻi | [0,282; 0,573] |
| KMO | 0,643 |
| Bartlett χ²(10) | 274,219; p < 0,001 |
| Factor 1 eigenvalue | 2,006 |
| Izohlangan dispersiya | 0,401 |
Muallif past Cronbach α qiymatini klassik maʻnoda shkalaning muvaffaqiyatsizligi deb talqin qilmaydi; chunki AP, HJ, TC, IC va GPT Exposure bir xil latent tushunchaning bir-birini takrorlovchi reflective koʻrsatkichlari sifatida emas, turli vazifa xususiyatlarini ifodalovchi formative koʻrsatkichlar sifatida ishlab chiqilgan.
Bir omilli tahlilda GPT Exposure loading i 0,117, AP 0,474, HJ −0,813, TC −0,780 va IC −0,706. Belgilar oʻzgaruvchilarni kodlash yoʻnalishlarini aks ettiradi.
Necessary Condition Analysis
Izlanish xususiyatidagi Necessary Condition Analysis da CE-FDH estimator va permutation tests ishlatilgan. Maqsad Adoption Readiness uchun bitta oʻzgaruvchi zarur chegara yoki bottleneck ekanini sinashdir.
Hech bir omil anʻanaviy ahamiyatlilik darajalarida noldan farq qiluvchi necessity threshold ga erishmagan. Shu sababli manba natijalari “yuqori IC boʻlmasa, AI hech qachon qabul qilinmaydi” yoki “GPT tajribasi zarur shart” kabi qatʻiy chegara daʻvolarini qoʻllab-quvvatlamaydi.
Tadqiqot qoʻllab-quvvatlaydigan xulosalar
- Yuqoriroq Automation Potential yuqoriroq AI Adoption Readiness bilan ijobiy bogʻliq.
- Yuqoriroq Integration Feasibility yuqoriroq Adoption Readiness bilan ijobiy bogʻliq.
- Yuqoriroq GPT Exposure pastroq Adoption Readiness bilan bogʻliq.
- Human Judgment Necessity manfiy yoʻnalishda, biroq p = 0,160 boʻlgani sababli statistik jihatdan qatʻiy emas.
- Task-level governance compatibility AIʻni qabul qilish istagini tushunishda faqat samaradorlik mantiqiga qoʻshimcha izohlovchi qiymat beradi.
- Vazifalarni judgment-first, automation-oriented va intermediate tarzida uchta tavsifiy profilga ajratish mumkin.
- Muntazam va kam mulohaza talab qiladigan vazifalar AIʻdan foydalanish uchun ochiqroq boshlangʻich sohalar boʻlib koʻrinadi.
Tadqiqot qoʻllab-quvvatlamaydigan xulosalar
- AI buxgalterlarning ish samaradorligini oshirishi sinovdan oʻtkazilmagan.
- AI xatolik darajasini yoki xarajatni kamaytirishi oʻlchanmagan.
- Ishtirokchilarning AIʻdan haqiqiy foydalanish xatti-harakati kuzatilmagan.
- 24 kishilik panel Tayvandagi barcha buxgalterlarni yoki global buxgalteriya kasbini ifodalamaydi.
- GPT tajribasi sababiy ravishda shubha bilan qarashga olib kelishi isbotlanmagan.
- Inson mulohazasiga ehtiyoj AIʻni qabul qilishni qatʻiy ravishda kamaytirishi statistik jihatdan koʻrsatilmagan.
- Uchta cluster universal buxgalteriya vazifalari toifalari emas.
- Tartibga solish va hisobdorlik tuzilmalari turlicha mamlakatlarda ayni bogʻliqliklar yuzaga kelishi kafolatlanmaydi.
Cheklovlar
Eng muhim cheklov 24 kishilik purposive expert-panel dizaynidir. Jami 576 ta vazifa darajasidagi kuzatuv koʻp koʻrinsa-da, ular faqat 24 kishining takroriy baholashlaridir. Shu sababli 576 ta kuzatuvni 576 nafar mustaqil mutaxassis sifatida talqin qilish notoʻgʻri boʻladi.
Natija oʻzgaruvchisi haqiqiy foydalanish emas, self-reported behavioral intention. Bir bandli AR oʻlchovi technology acceptance adabiyotida foydalanish mumkin boʻlgan proxy boʻlsa-da, tuzilmaning hissiy, kognitiv va xulq-atvor oʻlchamlarini alohida oʻlchamaydi.
Maʻlumotlar koʻndalang kesimli va idrokiydir; sababiy yoʻnalishni aniqlab boʻlmaydi. Integratsiyaning yuqoriroq amalga oshirilish imkoniyati AI tayyorligini oshirishi mumkin yoki AIʻga ochiqroq ishtirokchilar muayyan vazifalar integratsiyasini osonroq deb idrok etishi mumkin.
Suhbatlar kontekstual izoh beradi, biroq toʻliq sifat tahlili ushbu maqolada xabar qilinmagan. Bundan tashqari, transcriptlarning faqat %29 ida back-translation qoʻllanishi lingvistik tekshiruv qamrovini cheklaydi.
Muallif kelajakda keng confirmatory surveys, longitudinal dizaynlar, turli accountability regimes oʻrtasidagi taqqoslashlar va GPT Exposure bilan past readiness bogʻliqligi experience-based skepticism mi yoki cohort/oʻtish taʻsirimi ekanini ajrata oladigan tadqiqotlarni tavsiya qiladi.
Manba va Usul Haqida Izoh
Asl sarlavha: Task-Level Perceptions of AI Readiness Among Accounting Professionals
Muallif: Wil Martens.
Muassasa: College of Management, National Sun Yat-sen University, Kaohsiung 80424, Taiwan.
Jurnal: Accounting and Auditing.
Nashriyot: MDPI, Basel, Switzerland.
Bibliografik qayd: 2026, Volume 2, Issue 2, Article 7.
DOI: 10.3390/accountaudit2020007
Nashr sanasi: 8 may 2026.
Tahririy sanalar: Received 21 January 2026; Revised 1 April 2026; Accepted 20 April 2026.
Manba turi: Taqrizdan oʻtgan izlanish xususiyatidagi task-survey / expert-panel tadqiqoti; tuzilgan vazifa darajasidagi idrok oʻlchovlari qoʻllab-quvvatlovchi qisqa suhbatlar bilan birga ishlatilgan.
Litsenziya: Creative Commons Attribution (CC BY).
Namuna: 24 accounting professional × 24 vazifa = 576 ta vazifa darajasidagi baholash; 20 kishi bilan kuzatuv suhbati.
Asosiy natija oʻzgaruvchisi: Adoption Readiness (AR), 1–5 ordinal behavioral-intention oʻlchovi.
Asosiy tushuntiruvchi oʻzgaruvchilar: Automation Potential (AP), Human Judgment Necessity (HJ), Integration Feasibility (IC); GPT Exposure nazorat oʻzgaruvchisidir. Task Complexity (TC) kollinearlik sababli asosiy modeldan chiqarilgan, tavsifiy va cluster tahlillarida saqlangan.
Asosiy statistik usul: Ordered logistic regression; respondent darajasida cluster-robust standard errors. Robustness tahlillarida random-intercept tuzilmalari, OLS, HC3 standard errors, nonparametric bootstrap, leave-one-respondent-out, permutation MANOVA va muqobil cluster usullari ishlatilgan.
Klasterlash: Standartlashtirilgan GPT, AP, HJ, TC va IC qiymatlarida Ward linkage ishlatgan hierarchical clustering; uchta cluster yechimi.
Qoʻshimcha izlanish usuli: CE-FDH estimator va permutation tests ishlatgan Necessary Condition Analysis.
Moliyalashtirish: Tashqi moliyalashtirish yoʻq.
Etika: Anonim soʻrov maʻlumotlari va koʻngilli suhbatlarni oʻz ichiga olgan minimal-risk tadqiqot sifatida taʻriflangan va amaldagi milliy hamda institutsional qoidalar doirasida rasmiy etika kengashi koʻrigi talab qilinmagani bildirilgan.
Axborot asosidagi rozilik: Barcha ishtirokchilardan olingan.
Maʻlumotlardan foydalanish imkoniyati: Maʻlumotlar axloqiy va maxfiylik cheklovlari sababli ommaga ochiq emas; asosli soʻrov boʻyicha corresponding author orqali foydalanish mumkin boʻlishi ehtimol.
Manfaatlar toʻqnashuvi: Muallif manfaatlar toʻqnashuvi yoʻqligini bildirgan.
Manba ichidagi statistik izoh: Table 5 da Human Judgment Necessity uchun yulduz belgisi bosilgan boʻlsa-da, asosiy matn va jadval izohida p = 0,160 ekani hamda conventional significance threshold ga yetilmagani aytilgan. Verianla talqinida aniq p qiymati va muallifning matniy talqini saqlangan.
Asosiy talqin chegarasi: Natijalar kichik va maqsadli tanlangan expert panel ichidagi vazifa darajasidagi idrok bogʻliqliklaridir. Ular sababiy taʻsir, haqiqiy foydalanish, tizim samaradorligi yoki aholi darajasidagi qabul qilish koʻrsatkichi sifatida talqin qilinmasligi kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan