

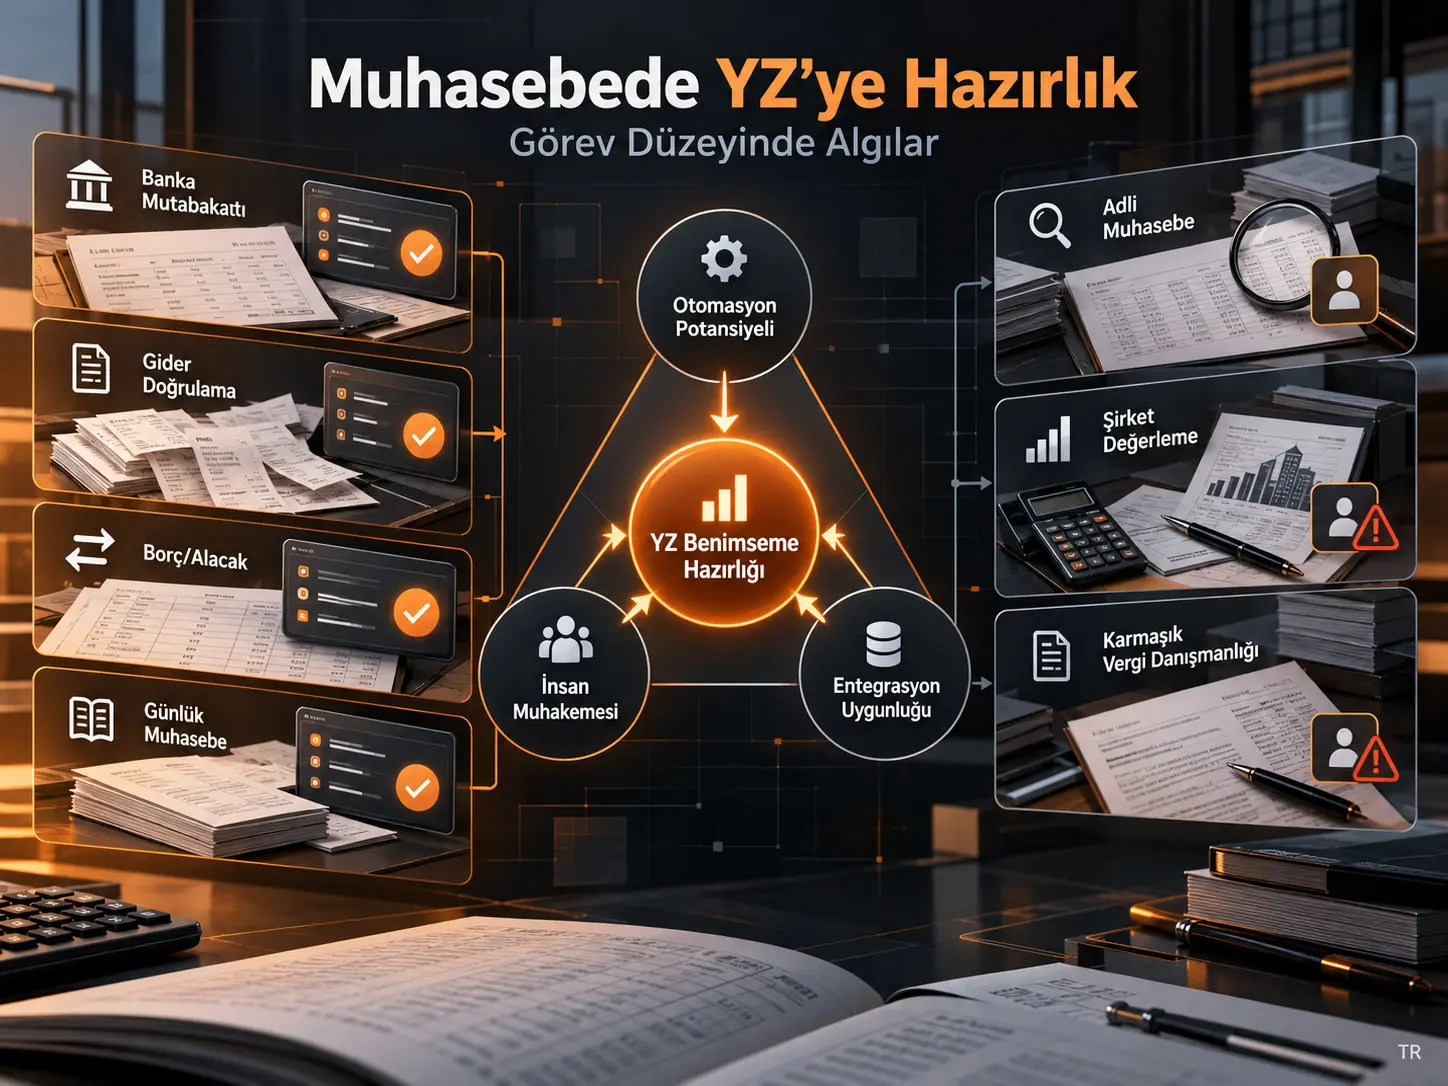
Görev düzeyinde yapay zekâya benimseme hazırlığı (Adoption Readiness, AR), bir muhasebe profesyonelinin belirli bir işi yaparken AI desteği mevcut olsaydı bu desteği kullanmaya ne ölçüde istekli olacağını ifade eden 1–5 ölçekli davranışsal niyet ölçümüdür. Wil Martens'in çalışması, Tayvan'daki 24 muhasebe profesyonelinin 24 temsilî muhasebe görevini değerlendirmesiyle oluşan 576 görev düzeyi gözlem üzerinden, bu hazırlığın hangi görev özellikleriyle ilişkili olduğunu araştırmaktadır. Ana ordered logistic regression sonuçlarında otomasyon potansiyeli ve mevcut iş akışına entegrasyon kolaylığı daha yüksek AI kullanım hazırlığıyla pozitif ilişkili bulunurken, GPT sistemlerine daha fazla geçmiş maruziyet daha düşük hazırlıkla ilişkilidir. İnsan muhakemesi gereksiniminin katsayısı negatif yöndedir fakat kaynak metinde p = 0,160 olarak raporlandığından istatistiksel olarak kesinleşmiş bir ilişki değildir.
Çalışmanın temel önerisi, muhasebede AI benimsemesinin yalnız teknolojinin ne kadar güçlü veya verimli olduğuyla açıklanamayacağıdır. Bir görevin denetlenebilir olması, çıktının kaynağının izlenebilmesi, reviewer sign-off mekanizmasının bulunması ve AI çıktısının mevcut kontrol sürecine savunulabilir biçimde yerleştirilebilmesi de benimseme hazırlığıyla ilişkilidir. Yazar bu yapıyı task-governance fit, yani görev ile yönetişim altyapısının uyumu çerçevesinde tartışmaktadır.
Ancak çalışma gerçek AI kullanımını, hata oranını, maliyet tasarrufunu veya iş performansını ölçmemektedir. Katılımcılar küçük, amaçlı seçilmiş bir expert paneldir ve sonuç değişkeni gerçek kullanım davranışı değil bildirilen kullanma isteğidir. Bu nedenle bulgular teori geliştirici ve hipotez üretici ilişkiler olarak yorumlanmalı; genel muhasebeci nüfusu için kesin veya nedensel sonuçlar olarak görülmemelidir.
Araştırmanın temel problemi
Yapay zekâ sistemlerinin muhasebe işlerinde teknik olarak kullanılabilir olması, muhasebecilerin bu sistemlere aynı ölçüde güveneceği anlamına gelmez. Banka mutabakatı, gider doğrulama veya alacak-borç hesaplarının işlenmesi gibi rutin görevlerle; adli muhasebe, şirket değerleme veya karmaşık denetim değerlendirmeleri aynı profesyonel sorumluluk düzeyine sahip değildir.
Çalışma bu nedenle analiz birimini “kullanıcı”dan “görev”e kaydırmaktadır. Bir profesyonelin AI'ya genel olarak olumlu veya olumsuz yaklaşımını ölçmek yerine şu soruya odaklanmaktadır: Aynı profesyonel farklı muhasebe görevlerinde AI kullanımına neden farklı ölçüde hazır olabilir?
Technology Acceptance Model (TAM), Unified Theory of Acceptance and Use of Technology (UTAUT) ve Diffusion of Innovation gibi yerleşik yaklaşımlar genellikle kullanım kolaylığı, fayda, sosyal etki veya bireysel teknolojik hazırlık üzerinde yoğunlaşır. Çalışmanın literatür boşluğu, yüksek hesap verebilirlik gerektiren mesleklerde göreve özgü denetlenebilirlik, izlenebilirlik ve reviewer approval yapılarını bu modellerin yeterince yakalamadığı iddiasıdır.
Görev-yönetişim uyumu nedir?
Görev-yönetişim uyumu, bir AI sisteminin belirli bir profesyonel göreve yalnız teknik olarak uygulanabilir olmasını değil, çıktısının izlenebilir, doğrulanabilir ve mevcut onay/inceleme süreçleri içinde mesleki olarak savunulabilir olmasını ifade eder. Bu çalışmada özellikle Integration Feasibility değişkeni; audit trail, traceability, reviewer sign-off ve approval workflow gibi mevcut kontrol mekanizmalarının AI kullanımını ne ölçüde desteklediğini temsil etmektedir.
Bu ayrım önemlidir. Teknik olarak kolay bir AI uygulaması, çıktının kimin tarafından doğrulanacağı veya hatanın sorumluluğunun kimde olacağı belirsizse düşük entegrasyon uygulanabilirliğine sahip olabilir. Buna karşılık adli muhasebe gibi içerik olarak karmaşık bir görev, güçlü audit trail ve inceleme mekanizmaları sayesinde AI'nın yardımcı rolünü daha kontrollü biçimde barındırabilir.
Beş temel algı değişkeni
| Değişken | Türkçe açıklama | Ölçüm | Modeldeki rol |
|---|---|---|---|
| GPT Exposure | GPT sınıfı araçlarla önceki mesleki tanışıklık | 1–5 Likert | Kontrol değişkeni |
| Automation Potential (AP) | Görev bileşenlerinin AI tarafından ikame edilebilirliği | %0–100, analizde beş gruba dönüştürülmüş | Ana açıklayıcı değişken |
| Human Judgment Necessity (HJ) | Takdir, etik yorum ve profesyonel muhakeme gereksinimi | 1–5 Likert | Ana açıklayıcı değişken |
| Task Complexity (TC) | Görevin bilgi alanı genişliği ve bağlamsal karmaşıklığı | 1–10, analizde 1–5'e ölçeklenmiş | Bağlamsal değişken |
| Integration Feasibility (IC) | AI'nın mevcut inceleme ve kontrol sürecine yerleştirilebilirliği | 1–5 entegrasyon maliyeti; ters kodlanmış | Ana açıklayıcı değişken |
| Adoption Readiness (AR) | Belirli görevde AI yardımını kullanma isteği | 1–5 ordinal ölçek | Bağımlı değişken |
Adoption Readiness nasıl soruldu?
Katılımcılara özünde şu davranışsal niyet sorusu yöneltilmiştir: mevcut rollerinde ilgili görev için AI yardımı sağlansaydı bunu kullanmaya ne kadar istekli olurlardı? Yanıt 1 = strongly unwilling ile 5 = strongly willing arasında ölçülmüştür.
Bu ölçüm gerçek davranışı değil kullanım niyetini temsil eder. Bir katılımcının AR = 5 vermesi, AI sistemini gerçek bir işte kullandığını veya sistemin güvenilir sonuç verdiğini göstermez.
Üç ana hipotez
H1: Daha yüksek Automation Potential, daha yüksek Adoption Readiness ile ilişkilidir.
H2: Daha yüksek Human Judgment Necessity, daha düşük Adoption Readiness ile ilişkilidir.
H3: Daha yüksek Integration Feasibility, daha yüksek Adoption Readiness ile ilişkilidir.
Task Complexity ana modelden çıkarılmıştır; çünkü kaynakta HJ ile yüksek kollinearite gösterdiği belirtilmektedir. Ana anlatı ve modelleme bölümünde bu gerekçe r = 0,74 olarak verilirken yayımlanan Spearman Table 3'te HJ–TC katsayısı 0,65'tir. Bu iki kaynak değeri ayrı bağlamlarda raporlanmalıdır.
Kimler araştırmaya katıldı?
| Özellik | Dağılım |
|---|---|
| CPA | 8 kişi |
| Yönetim | 8 kişi |
| Muhasebe çalışanı | 4 kişi |
| Muhasebe eğitimcisi | 4 kişi |
| 0–5 yıl deneyim | 4 kişi |
| 6–20 yıl deneyim | 16 kişi |
| 20+ yıl deneyim | 4 kişi |
| Takip görüşmesi | 20 kişi |
Katılımcılar finans ve bankacılık, teknoloji, konaklama ve muhasebe eğitimi bağlamlarından gelmektedir. Örnekleme amaçlı ve referral-based yöntemlerle yapılmıştır; hedef istatistiksel nüfus temsili değil, mesleki rol ve deneyim çeşitliliği sağlamaktır.
Neden Tayvan seçildi?
Çalışma Tayvan'ı ileri teknolojik kapasite ile güçlü mesleki hesap verebilirlik yapısının aynı anda bulunduğu bir critical case olarak kullanmaktadır. Muhasebecilerin bireysel sign-off ve hukuki sorumluluk taşıdığı bir ortamda AI'nın yalnız verimlilik değil, izlenebilirlik ve mesleki savunulabilirlik açısından da değerlendirilmesi beklenmektedir.
Bu nedenle ülke bağlamı çalışmanın tasarımının parçasıdır; ancak sonuçların başka ülkelere otomatik biçimde aktarılması mümkün değildir.
Görevlerin algıları birbirleriyle nasıl ilişkili?
Spearman korelasyon analizinde GPT Exposure ile Automation Potential arasında 0,60 pozitif ilişki raporlanmıştır. Automation Potential ile Human Judgment Necessity −0,29, Task Complexity ile −0,33 ve Integration Feasibility ile −0,36 korelasyon göstermiştir. HJ ile TC arasındaki Spearman korelasyonu 0,65, HJ ile IC arasındaki korelasyon 0,57, TC ile IC arasındaki korelasyon 0,50'dir.
| Değişken çifti | Spearman korelasyonu |
|---|---|
| GPT Exposure – AP | 0,60*** |
| AP – HJ | −0,29*** |
| AP – TC | −0,33*** |
| AP – IC | −0,36*** |
| HJ – TC | 0,65*** |
| HJ – IC | 0,57*** |
| TC – IC | 0,50*** |
*** p < 0,001.
Bu desen rutin ve ikame edilebilir görevlerle yüksek muhakeme/karmaşıklık gerektiren görevlerin algısal olarak farklılaştığını göstermektedir; ancak korelasyonlar nedensel yön belirtmez.
Muhasebeciler AI'yı hangi görevlerde kullanmaya daha hazır görünüyor?
Çalışmanın temel bulgusu, AI'nın görevin daha büyük bölümünü otomatikleştirebildiği ve mevcut denetim/inceleme akışına daha kolay yerleştirilebildiği görevlerde bildirilen AI kullanım isteğinin daha yüksek olmasıdır. Buna karşılık yoğun insan muhakemesi gerektiren görevlerde hazırlık katsayısı negatif yöndedir fakat istatistiksel olarak kesinleşmemiştir; dolayısıyla çalışma “insan muhakemesi arttıkça AI reddedilir” şeklinde kesin bir sonuç desteklememektedir.
Örneğin rutin muhasebe güncellemeleri, çalışan giderlerinin incelenmesi ve payable/receivable işlemleri yüksek otomasyon potansiyelli görevler arasında görülürken; forensic accounting ve business valuation yüksek görev karmaşıklığı ve yüksek insan muhakemesi gereksinimi göstermektedir.
Appendix B'de en yüksek Task Complexity ortalamaları forensic accounting için 4,50 ve business valuation için 4,17'dir. En yüksek Human Judgment Need değerleri sırasıyla 4,00 ve 3,67'dir. Automation Potential açısından managing cash flow, examining expenses ve payables & receivables görevlerinin her biri 4,00 ortalamaya ulaşmaktadır.
Çalışmanın Yöntemi ve Bulguları
Ana istatistiksel model
Bağımlı değişken Adoption Readiness 1–5 sıralı ölçekte olduğu için temel model ordered logistic regression'dır. Analiz birimi 576 task-level rating'dir. Aynı katılımcı 24 görevi değerlendirdiği için gözlemler birbirinden tamamen bağımsız değildir; ana modelde standart hatalar respondent düzeyinde cluster-robust biçimde hesaplanmıştır. Ek sağlamlık spesifikasyonlarında respondent random intercept kullanılmıştır.
| Değişken | β | Odds Ratio | Standart hata | Kaynak yorumu |
|---|---|---|---|---|
| GPT Exposure | −0,340 | 0,712 | 0,074 | p < 0,001; negatif ilişki |
| Automation Potential | +0,476 | 1,610 | 0,086 | p < 0,001; pozitif ilişki |
| Human Judgment Necessity | −0,135 | 0,873 | 0,096 | Ana metinde p = 0,160; anlamlı değil |
| Integration Feasibility | +0,411 | 1,509 | 0,091 | p < 0,001; pozitif ilişki |
Modelde 576 gözlem bulunmaktadır. Log-likelihood −899,61, AIC 1815, BIC 1850, McFadden R² 0,026 ve Nagelkerke R² 0,084 olarak raporlanmıştır. Düşük pseudo-R² değerleri yazar tarafından çalışmanın keşifsel yapısı ve AI benimseme kararlarının çok faktörlü olmasıyla uyumlu görülmektedir.
Kaynak içi işaretleme uyarısı: Table 5'in HJ satırında tek yıldız basılmış olmasına rağmen aynı bölümde p = 0,160 olduğu ve ilişkinin conventional significance threshold'a ulaşmadığı birkaç kez açıkça yazılmıştır. Bu nedenle H2 istatistiksel olarak doğrulanmış gibi sunulmamalıdır.
Odds ratio sonuçları ne anlama geliyor?
Ordered logit modelinde odds ratio, diğer değişkenler sabit tutulduğunda bir açıklayıcı değişkendeki artışın daha yüksek Adoption Readiness kategorilerinde yer alma odds'u ile ilişkisini gösterir. AP için OR = 1,610 ve IC için OR = 1,509 daha yüksek readiness yönünde ilişkiyi, GPT Exposure için OR = 0,712 ise daha düşük readiness yönünde ilişkiyi gösterir; bunlar nedensel etkiler değildir.
Automation Potential'ın etkisinin büyüklüğü
Kaynak yalnız katsayı vermekle kalmamış, değişkenler Q25'ten Q75'e taşındığında modelin tahmin ettiği AR kategorisi olasılıklarını da hesaplamıştır.
| Değişken | P(AR=1), düşük | P(AR=1), yüksek | P(AR=5), düşük | P(AR=5), yüksek |
|---|---|---|---|---|
| Automation Potential | 0,364 | 0,181 | 0,098 | 0,219 |
| Integration Feasibility | 0,306 | 0,162 | 0,123 | 0,242 |
| GPT Exposure | 0,174 | 0,294 | 0,227 | 0,129 |
| Human Judgment Necessity | 0,207 | 0,256 | 0,191 | 0,153 |
Automation Potential Q25'ten Q75'e çıktığında model P(AR=1)'i 0,364'ten 0,181'e düşürürken P(AR=5)'i 0,098'den 0,219'a yükseltmektedir. Integration Feasibility için P(AR=5) 0,123'ten 0,242'ye yükselmektedir. Bu olasılıklar model-tabanlı tahminlerdir; gerçek kullanım oranları değildir.
GPT deneyimi neden daha düşük hazırlıkla ilişkili olabilir?
GPT Exposure katsayısı negatif ve istatistiksel olarak anlamlıdır. Yazar bunu experience-skepticism effect olarak yorumlamaktadır: büyük dil modelleriyle daha fazla pratik deneyim, kullanıcıların model sınırlılıklarını, doğrulama gereksinimini ve hatalarını daha gerçekçi görmesine yol açabilir.
Ancak bu çalışma bunun mekanizmasını doğrudan test etmemektedir. “Daha fazla GPT deneyimi kesin olarak şüpheciliğe neden olur” sonucu çıkarılamaz. Negatif katsayı kaynak veride gözlenen ilişkidir; experience-skepticism ise yazarın bu ilişkiyle uyumlu teorik yorumudur.
İnsan muhakemesi sonucu neden ihtiyatla okunmalı?
Human Judgment Necessity katsayısı beklenen yönde negatiftir, ancak kaynak p = 0,160 raporlamaktadır. Bu nedenle H2 için yalnız yönsel fakat sonuçsuz/inconclusive destek vardır.
Yazar iki olası sınır tartışmaktadır: etki bu küçük örneklemde gerçekten zayıf olabilir veya HJ'nin Task Complexity ile yüksek korelasyonu bağımsız katsayının hassasiyetini azaltmış olabilir. Ayrıca görev türü, kıdem veya muhakemenin niteliği gibi ölçülmeyen moderatörler de rol oynayabilir.
20 takip görüşmesi ne amaçla kullanıldı?
Takip görüşmeleri ana istatistiksel sonuçların yerine geçmek için değil, katsayıların mesleki bağlamını anlamlandırmak için kullanılmıştır. Görüşmeler Mandarin dilinde kaydedilip verbatim transcribe edilmiş, belirli bir bölümde back-translation uygulanmış ve kalan içerik iki dilli inceleme ile kontrol edilmiştir.
Back-translation yalnız hedeflenmiş transcript alt kümesinin %29'una uygulanmıştır. Yazar bunu açıkça tasarım sınırlılığı olarak kabul etmektedir. Tam thematic analysis bu makalenin ana çıktısı değildir; companion qualitative study içinde raporlandığı belirtilmektedir.
Üç görev profili
Ward linkage kullanan hierarchical clustering, GPT Exposure, AP, HJ, TC ve IC'nin standartlaştırılmış değerleri üzerinden üç küme üretmiştir. Sayfa 11'deki dendrogram üçlü çözümü, hemen altındaki kernel density grafikler ise kümelerin değişken profillerindeki farklılığı göstermektedir.
| Küme | Temel profil | Örnek görevler | Kaynakta önerilen AI yaklaşımı |
|---|---|---|---|
| Cluster 1 — Judgment-first | Yüksek HJ ve TC; orta-yüksek IC | Forensic accounting, business valuation, audit leadership | Copilot tarzı yardım + zorunlu insan sign-off |
| Cluster 2 — Automation-oriented | Yüksek AP ve GPT Exposure; düşük HJ | Gider doğrulama, günlük muhasebe işleri, payable/receivable | AI benimsemesi için en doğrudan başlangıç alanı |
| Cluster 3 — Intermediate | AP, HJ ve IC açısından orta düzey | Banka mutabakatı, düzenleyici uyum, finansal tahmin | Karar firma yönetişimi ve profesyonel deneyime daha bağlı |
Bu kümeleme tanımlayıcıdır. Üç profil doğal veya evrensel muhasebe görev sınıfları olarak kanıtlanmamıştır.
Sağlamlık kontrolleri
Araştırmacı AP yüzdelerinin yeniden gruplandırılması, GPT Exposure'un ordinal olarak ele alınması ve TC/IC ölçeklerinin yeniden kodlanması gibi alternatif ölçüm seçeneklerini test etmiş ve katsayıların önemli ölçüde değişmediğini raporlamıştır.
Ordered logit ile OLS spesifikasyonları aynı genel yönü vermiş; HC3 standart hataları ve nonparametric bootstrap confidence intervals benzer istatistiksel çıkarımlarla sonuçlanmıştır.
Leave-one-respondent-out analizinde katsayılar beklenen örneklem gürültüsü içinde kararlı kalmıştır. Firma büyüklüğüyle ilgili multivariate desenler 9999 permutation kullanan permutation MANOVA ile ayrıca sınanmıştır. Üç kümenin yapısı k-means ve alternatif distance metrics ile nitel olarak korunmuştur.
Ölçüm tanıları
| Ölçüm | Değer |
|---|---|
| Cronbach's α | 0,441 |
| %95 güven aralığı | [0,282; 0,573] |
| KMO | 0,643 |
| Bartlett χ²(10) | 274,219; p < 0,001 |
| Factor 1 eigenvalue | 2,006 |
| Açıklanan varyans | 0,401 |
Yazar düşük Cronbach α değerini klasik anlamda ölçeğin başarısızlığı olarak yorumlamamaktadır; çünkü AP, HJ, TC, IC ve GPT Exposure aynı latent kavramın birbirini tekrar eden reflective göstergeleri olarak değil, farklı görev özelliklerini temsil eden formative göstergeler olarak tasarlanmıştır.
Tek faktör analizinde GPT Exposure loading'i 0,117, AP 0,474, HJ −0,813, TC −0,780 ve IC −0,706'dır. İşaretler değişken kodlama yönlerini yansıtmaktadır.
Necessary Condition Analysis
Keşifsel Necessary Condition Analysis'te CE-FDH estimator ve permutation tests kullanılmıştır. Amaç, Adoption Readiness için tek bir değişkenin zorunlu eşik veya bottleneck olup olmadığını test etmektir.
Hiçbir faktör geleneksel anlamlılık düzeylerinde sıfırdan farklı bir necessity threshold'a ulaşmamıştır. Bu nedenle kaynak sonuçları “yüksek IC olmadan AI hiçbir zaman benimsenemez” veya “GPT deneyimi zorunlu koşuldur” gibi sert eşik iddialarını desteklememektedir.
Çalışmanın desteklediği sonuçlar
- Daha yüksek Automation Potential, daha yüksek AI Adoption Readiness ile pozitif ilişkilidir.
- Daha yüksek Integration Feasibility, daha yüksek Adoption Readiness ile pozitif ilişkilidir.
- Daha yüksek GPT Exposure, daha düşük Adoption Readiness ile ilişkilidir.
- Human Judgment Necessity negatif yöndedir fakat p = 0,160 nedeniyle istatistiksel olarak kesin değildir.
- Task-level governance compatibility, AI benimseme isteğini anlamada yalnız verimlilik mantığına ek açıklayıcı değer taşımaktadır.
- Görevler judgment-first, automation-oriented ve intermediate olmak üzere üç tanımlayıcı profile ayrılabilmektedir.
- Rutin ve düşük muhakeme gerektiren görevler AI kullanımına daha açık başlangıç alanları olarak görünmektedir.
Çalışmanın desteklemediği sonuçlar
- AI'nın muhasebecilerin iş performansını artırdığı test edilmemiştir.
- AI'nın hata oranını veya maliyeti azalttığı ölçülmemiştir.
- Katılımcıların gerçek AI kullanım davranışı gözlenmemiştir.
- 24 kişilik panel bütün Tayvan muhasebecilerini veya küresel muhasebe mesleğini temsil etmez.
- GPT deneyiminin nedensel olarak şüpheciliğe yol açtığı kanıtlanmamıştır.
- İnsan muhakemesi gereksiniminin AI benimsemesini kesin biçimde düşürdüğü istatistiksel olarak gösterilmemiştir.
- Üç cluster evrensel muhasebe görev kategorileri değildir.
- Regülasyon ve hesap verebilirlik yapıları farklı ülkelerde aynı ilişkilerin ortaya çıkacağı garanti edilemez.
Sınırlılıklar
En önemli sınırlılık 24 kişilik purposive expert-panel tasarımıdır. Toplam 576 görev düzeyi gözlem yüksek görünse de bunlar yalnız 24 kişinin tekrarlı değerlendirmeleridir. Bu nedenle 576 gözlemi 576 bağımsız profesyonel gibi yorumlamak yanlış olur.
Sonuç değişkeni gerçek kullanım değil self-reported behavioral intention'dır. Tek maddelik AR ölçümü technology acceptance literatüründe kullanılabilir bir proxy olsa da yapının duygusal, bilişsel ve davranışsal boyutlarını ayrı ayrı ölçmez.
Veriler kesitsel ve algısaldır; nedensel yön belirlenemez. Daha yüksek entegrasyon uygulanabilirliği AI hazırlığını artırıyor olabilir veya AI'ya daha açık katılımcılar belirli görevlerin entegrasyonunu daha kolay algılıyor olabilir.
Görüşmeler bağlamsal açıklama sunmaktadır ancak tam nitel analiz bu makalenin içinde raporlanmamıştır. Ayrıca yalnız transcriptlerin %29'unda back-translation uygulanması dilsel doğrulamanın kapsamını sınırlar.
Yazar gelecekte geniş confirmatory surveys, longitudinal tasarımlar, farklı accountability regimes arasında karşılaştırmalar ve GPT Exposure ile düşük readiness ilişkisinin experience-based skepticism mi yoksa cohort/geçiş etkisi mi olduğunu ayırabilecek çalışmalar önermektedir.
Kaynak ve Yöntem Notu
Özgün başlık: Task-Level Perceptions of AI Readiness Among Accounting Professionals
Yazar: Wil Martens.
Kurum: College of Management, National Sun Yat-sen University, Kaohsiung 80424, Taiwan.
Dergi: Accounting and Auditing.
Yayınevi: MDPI, Basel, Switzerland.
Bibliyografik kayıt: 2026, Volume 2, Issue 2, Article 7.
DOI: 10.3390/accountaudit2020007
Yayın tarihi: 8 Mayıs 2026.
Editoryal tarihler: Received 21 January 2026; Revised 1 April 2026; Accepted 20 April 2026.
Kaynak türü: Hakemli keşifsel task-survey / expert-panel çalışması; yapılandırılmış görev düzeyi algı ölçümleri destekleyici kısa görüşmelerle birlikte kullanılmıştır.
Lisans: Creative Commons Attribution (CC BY).
Örneklem: 24 accounting professional × 24 görev = 576 görev düzeyi değerlendirme; 20 kişiyle takip görüşmesi.
Ana sonuç değişkeni: Adoption Readiness (AR), 1–5 ordinal behavioral-intention ölçümü.
Ana açıklayıcı değişkenler: Automation Potential (AP), Human Judgment Necessity (HJ), Integration Feasibility (IC); GPT Exposure kontrol değişkenidir. Task Complexity (TC) kollinearite nedeniyle ana modelden çıkarılmış, tanımlayıcı ve cluster analizlerinde tutulmuştur.
Ana istatistiksel yöntem: Ordered logistic regression; respondent düzeyinde cluster-robust standard errors. Robustness analizlerinde random-intercept yapıları, OLS, HC3 standard errors, nonparametric bootstrap, leave-one-respondent-out, permutation MANOVA ve alternatif cluster yöntemleri kullanılmıştır.
Kümeleme: Standardize GPT, AP, HJ, TC ve IC değerlerinde Ward linkage kullanan hierarchical clustering; üç cluster çözümü.
Ek keşifsel yöntem: CE-FDH estimator ve permutation tests kullanan Necessary Condition Analysis.
Finansman: Harici finansman yoktur.
Etik: Anonim anket verisi ve gönüllü görüşmeler içeren minimal-risk araştırma olarak tanımlanmış, uygulanabilir ulusal ve kurumsal kurallar altında formal etik kurul incelemesi gerektirmediği belirtilmiştir.
Bilgilendirilmiş onam: Tüm katılımcılardan alınmıştır.
Veri erişilebilirliği: Veri etik ve gizlilik kısıtları nedeniyle kamuya açık değildir; makul talep üzerine corresponding author aracılığıyla erişim mümkün olabilir.
Çıkar çatışması: Yazar çıkar çatışması olmadığını beyan etmiştir.
Kaynak içi istatistik notu: Table 5'te Human Judgment Necessity için yıldız işareti basılmış olmasına rağmen ana metin ve tablo notu p = 0,160 ve conventional significance threshold'a ulaşılmadığını belirtmektedir. Verianla yorumunda açık p değeri ve yazarın metinsel yorumu korunmuştur.
Temel yorum sınırı: Bulgular küçük ve amaçlı seçilmiş bir expert panel içindeki görev düzeyi algı ilişkileridir. Nedensel etki, gerçek kullanım, sistem performansı veya nüfus düzeyinde benimseme oranı olarak yorumlanmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir