

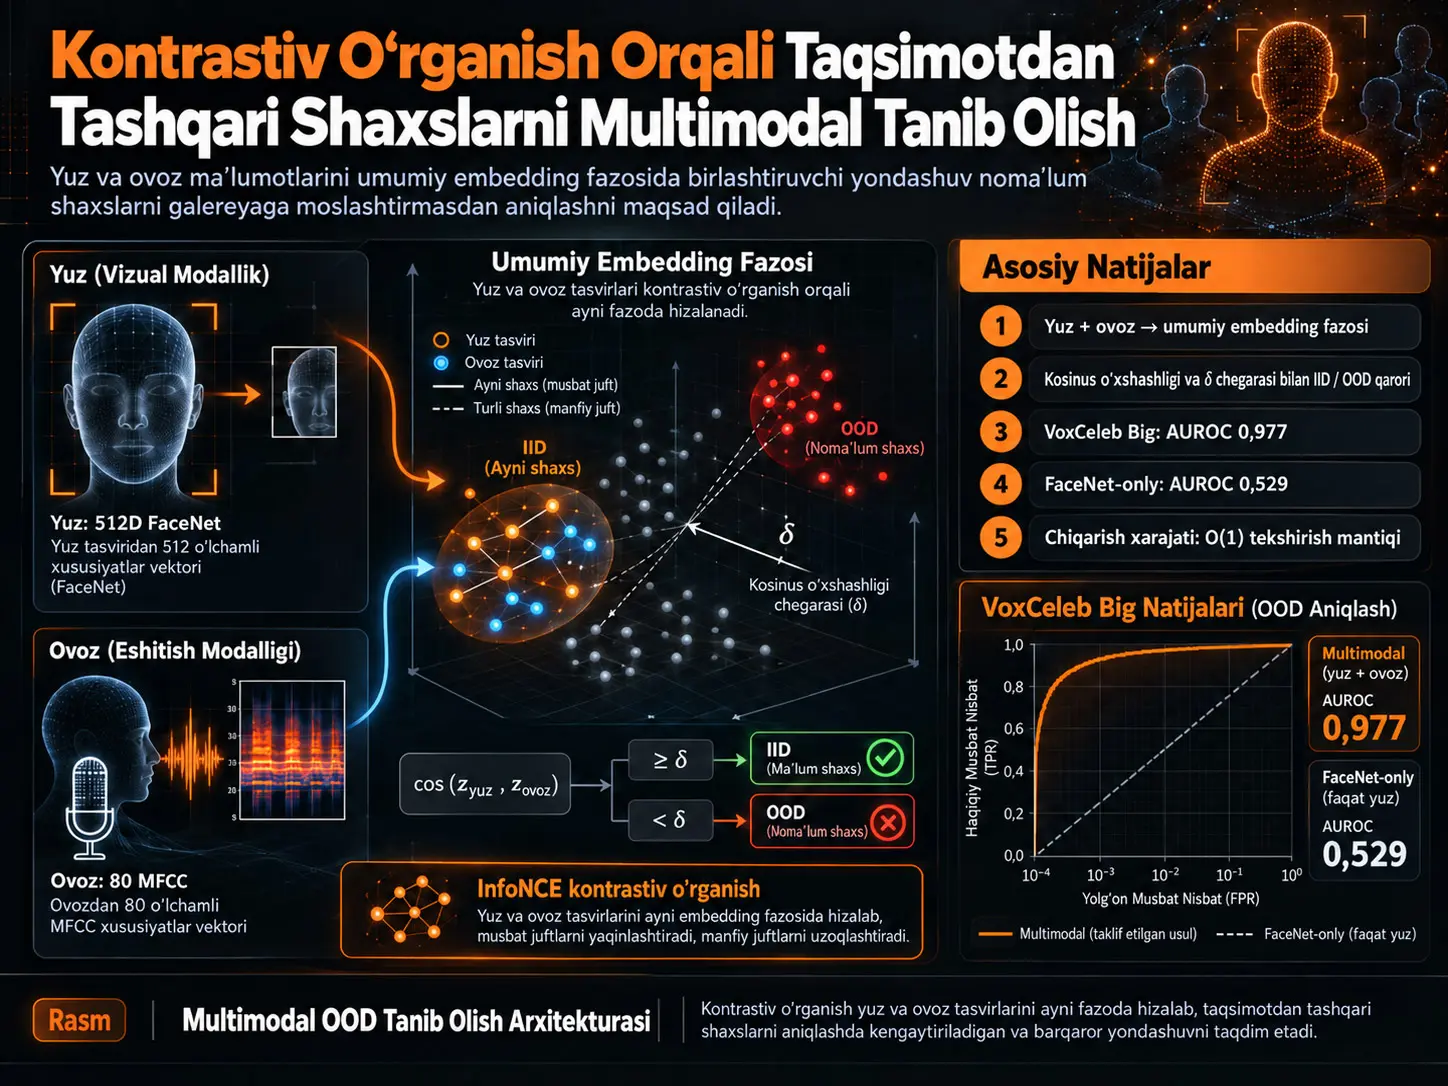
Taqsimotdan tashqari shaxs (out-of-distribution, OOD) shaxsni tanib olish tizimi oʻqitish vaqtida oʻrgangan identifikatsiya taqsimotidan tashqarida qoladigan, ilgari koʻrilmagan shaxsni anglatadi. An’anaviy yopiq toʻplamli tanib olish tizimiga bunday namuna kelganda, model noma’lum shaxsni mavjud sinflardan biriga majburan biriktirishi mumkin. Sergio Garcia, Francisco Gomez-Donoso va Miguel Cazorla tomonidan ishlab chiqilgan usul bu muammoni faqat yuz yoki faqat ovoz orqali hal qilish oʻrniga, ikki biometrik modallikning bir-biriga qanchalik mos kelishini oʻlchaydi.
Model yuz tasviridan FaceNet orqali 512 oʻlchamli xususiyatlar vektorini, ovoz yozuvidan esa 80 ta Mel-Frequency Cepstral Coefficient (MFCC) xususiyatini ajratib oladi. Ikki alohida neyron tarmoq shoxchasi ushbu tasvirlarni 1200 oʻlchamli umumiy embedding fazosiga proyeksiyalaydi. Oʻqitish vaqtida InfoNCE asosidagi kontrastiv yoʻqotish ayni shaxsga tegishli yuz-ovoz juftlarini bir-biriga yaqinlashtirar ekan, turli shaxslarga tegishli juftlarni bir-biridan uzoqlashtiradi.
Chiqarish vaqtida identifikatsiyalar galereyasidan eng yaqin shaxs izlanmaydi. Buning oʻrniga yuz embedding-i bilan ovoz embedding-i oʻrtasidagi kosinus oʻxshashligi oʻlchanadi. Qiymat belgilangan \(\delta\) chegarasidan past boʻlsa, juft OOD, chegaradan yuqori boʻlsa, taqsimot ichidagi namuna sifatida tasniflanadi.
Custom, LombardGrid va VoxCeleb asosidagi tajribalarda usul, ayniqsa identifikatsiyalar soni oshganda, FaceNet-only taqqoslashiga nisbatan barqarorroq natijalar bergan. VoxCeleb Big tajribasida multimodal usulning AUROC qiymati 0,977, FaceNet-only taqqoslashining qiymati esa 0,529 boʻlgan. Biroq natijalar barcha multimodal shaxsni tanib olish usullariga qarshi keng qamrovli state-of-the-art taqqoslash emas va modelni real dunyoda keng koʻlamli axloqiy hamda operatsion validatsiyadan oʻtkazish kelgusi ish sifatida qoldirilgan.
Taqsimotdan tashqari shaxs muammosi nima?
Agar neyron tarmoq faqat oʻqitish vaqtida koʻrgan sinflari orasidan tanlashga moʻljallangan boʻlsa, ilgari hech uchratmagan identifikatsiyani ham ma’lum sinflardan biriga biriktirishi mumkin. Modelning yuqori ishonch hosil qilishi ushbu shaxs haqiqatan tanib olinganini anglatmasligi mumkin.
Bu muammo ayniqsa shaxsni tanib olish tizimlarida muhim. Tizimning “bu shaxs oʻqitishda koʻrgan shaxslarimdan biri emas” deya olishi shunchaki toʻgʻri tasniflay olishdan farqli qobiliyatdir.
Maqolada bu muammo yuz va ovozdan iborat ikkita alohida biometrik modallikni birgalikda qoʻllash orqali koʻrib chiqilgan.
Yuz va Ovoz Birgalikda OOD Aniqlashni Qanday Ta’minlaydi?
Taklif etilgan tizimning asosiy farazi shundan iboratki, ayni shaxsga tegishli yuz va ovoz tasvirlarini kontrastiv oʻqitishdan soʻng umumiy latent fazoda bir-biriga moslashtirish mumkin. Model “shaxs identifikatsiyasini galereyadan topish” oʻrniga, yuz va ovozning oʻrganilgan tasvir fazosida ayni identifikatsiyaga tegishli boʻlishi uchun yetarlicha mos ekanini soʻraydi.
Yuz tomoni: FaceNet
Yuz tasvirlari taklif etilgan kontrastiv tarmoqqa bevosita xom piksellar sifatida berilmaydi. Avval FaceNet tomonidan qayta ishlanadi va har bir tasvir uchun 512 oʻlchamli yuz embedding-i yaratiladi.
Ushbu tasvir yuzning farqlovchi xususiyatlarini ixcham metrik fazoda kodlash uchun ishlatiladi. Soʻng 512 oʻlchamli vektor taklif etilgan multimodal tarmoqning yuz shoxchasiga uzatiladi.
Ovoz tomoni: MFCC
Ovoz ma’lumotlari uchun Mel-Frequency Cepstral Coefficients ishlatilgan. Har bir ovoz parchasidan 80 ta MFCC xususiyati ajratib olingan.
MFCC ni ajratib olishdan oldin ovoz amplitudasi chiziqli gain normalization orqali 0,03 maqsadli qiymatiga normallashtirilgan. Mualliflar bu RMS yoki peak normalization emasligini alohida ta’kidlaydi. Maqsad yozuv ovoz darajasidagi farqlarning spektral xususiyatlarda keraksiz oʻzgaruvchanlik hosil qilishini kamaytirishdir.
Ikki modallik umumiy fazoda uchrashadi
Yuz va ovoz shoxchalari oʻxshash koʻp qatlamli tuzilmalardan foydalanadi. Har ikki shoxchaning oxirida tasvir 1200 oʻlchamli umumiy embedding fazosiga proyeksiyalanadi.
| Shoxcha | Kirish | Oraliq qatlamlar | Chiqish |
|---|---|---|---|
| Yuz | 512D FaceNet embedding | 1024 → 512 → 256 | 1200D embedding |
| Ovoz | 80 ta MFCC xususiyati | 1024 → 512 → 256 | 1200D embedding |
Har bir oraliq blokda Linear, BatchNorm1d, ReLU va Dropout komponentlari mavjud. Manbada model uchun jami 2.544.480 ta oʻqitiladigan parametr qayd etilgan.
Kontrastiv Oʻrganish Bu Yerda Nimani Oʻrganadi?
Kontrastiv oʻrganish ayni shaxsga tegishli yuz-ovoz juftlarini embedding fazosida bir-biriga yaqinlashtirish, turli shaxslar juftlarini esa bir-biridan uzoqlashtirishni maqsad qiladi. Shu tariqa tizim sinf yorligʻini yodlash oʻrniga ikki xil modallik oʻrtasidagi identifikatsiya muvofiqligini oʻrganishga urinadi.
Musbat va manfiy juftlar
Ayni shaxsga tegishli yuz \(f_i\) bilan ovoz \(a_i\) musbat juft hosil qiladi.
Turli shaxslarga tegishli yuz \(f_i\) bilan ovoz \(a_j\), \(i \neq j\) boʻlganda manfiy juft hosil qiladi.
Manba 40 ta yuz va 40 ta ovoz namunasi mavjud bitta shaxs uchun 1600 ta musbat moslik kombinatsiyasi hosil boʻlishi mumkinligini koʻrsatadi. Misol sifatida, 50 kishilik holatda jami 80.000 ta musbat juft va 3.920.000 ta ehtimoliy manfiy juft hisoblanadi. Bu boʻlim metodologik kombinatsiya misolidir; foydalanilgan barcha ma’lumotlar toʻplami haqiqatan ham 50 kishidan iboratligini anglatmaydi.
InfoNCE yoʻqotishi
Oʻqitishda ishlatilgan kontrastiv yoʻqotish:
\[ L_{\text{contrastive}} = -\frac{1}{N} \sum_{i=1}^{N} \log \frac{ \exp(sim(z_{f_i},z_{a_i})/\tau) }{ \sum_{j=1}^{N} \exp(sim(z_{f_i},z_{a_j})/\tau) } \]
koʻrinishidadir.
Bu yerda \(z_f\) yuz embedding-ini, \(z_a\) ovoz embedding-ini, \(N\) batch oʻlchamini va \(\tau\) harorat parametrini bildiradi.
Oʻxshashlik oʻlchovi kosinus oʻxshashligidir:
\[ sim(z_f,z_a) = \frac{z_f \cdot z_a} {\|z_f\|\|z_a\|} \]
Oʻqitish parametrlariga 50 epoch, sinflar soniga teng batch size, 0,0005 learning rate va \(\tau=0,05\) harorat qiymati kiradi.
Tizim Noma’lum Shaxs Boʻyicha Qarorni Qanday Qabul Qiladi?
Chiqarish vaqtida yuz-ovoz juftining ikkita embedding-i hosil qilinadi va ular orasidagi kosinus oʻxshashligi hisoblanadi. Manbada OOD qarori quyidagicha ta’riflanadi:
\[ OOD(z_f,z_a)= \begin{cases} 1, & sim(z_f,z_a)<\delta \\ 0, & \text{aksi halde} \end{cases} \]
\(\delta\) qaror chegarasidir.
Manbada boshlangʻich chegara oʻqitishdagi musbat juftlarning oʻrtacha oʻxshashligining yarmidan foydalanib empirik tarzda yaratilgan. Biroq mualliflar bu qiymatni optimallashtirilgan doimiy model parametri sifatida taqdim etmaydi. Tajribalarda keng threshold oraligʻi koʻrib chiqilib, usulning turli ish nuqtalaridagi sezgirligi alohida tahlil qilingan.
Muhim nozik jihat: “koʻrilmagan shaxs” har doim past oʻxshashlik hosil qilmaydi
Bu jihat usulni tushunishda juda muhim. Model ilgari koʻrmagan shaxsning yuzi va ovozini ham umumiy embedding fazosida yaxshi moslashtirishi mumkin.
Shu sababli tizimning OOD mexanizmi “bu identifikatsiyani ilgari yodlaganmanmi?” degan savolga asoslanmaydi. Oʻlchanadigan narsa yuz va ovoz oʻrtasidagi cross-modal consistency hisoblanadi.
Oʻqitishdan oldingi va keyingi oʻxshashlik taqsimoti
Manbaning 9-sahifasidagi 2-rasm kontrastiv oʻqitishdan oldin yuz va ovoz tasvirlari barcha ma’lumotlar toʻplamlarida taxminan nol atrofida jamlanganini koʻrsatadi. Boshqacha aytganda, FaceNet yuz xususiyatlari bilan MFCC ovoz xususiyatlari tabiiy ravishda ayni koordinatalar fazosida hizalanmagan.
Ayni sahifadagi 3-rasm va 4-rasmda esa oʻqitishdan soʻng LombardGrid musbat yuz-ovoz juftlarining kosinus oʻxshashliklari ham oʻqitish, ham test toʻplamida 1 ga yaqinlashgani koʻrinadi. Bu oʻzgarish kontrastiv model ikki xil modallik oʻrtasida umumiy tasvirni oʻrganganining bevosita vizual koʻrsatkichidir.
Tadqiqot Usuli va Natijalari
Foydalanilgan ma’lumotlar toʻplamlari
Tadqiqot uchta asosiy ma’lumot manbasidan foydalanadi: tadqiqotchilar yaratgan custom ma’lumotlar toʻplami, VoxCeleb1 va Lombard Grid.
Custom ma’lumotlar toʻplami
Maxsus ma’lumotlar toʻplami 15 xil shaxsning yuz va ovoz ma’lumotlarini oʻz ichiga oladi. Manbalar YouTube kabi ommaga ochiq platformalardagi videolarni ham, rozilik bergan shaxslarning real vaqt yozuvlarini ham qamrab oladi.
Har bir shaxsda 3-10 ta ovoz klipi mavjud va ovozlarning oʻrtacha davomiyligi 4-8 soniyadir. Oʻqitish ma’lumotlariga augmentation qoʻllanib, har bir shaxs uchun 40 ta yuz kadri va 40 ta ovoz namunasiga yetkazilgan. Test uchun har bir shaxsga uchta yuz kadri va uchta ovoz namunasi ajratilgan; test yozuvlari oʻqitishda ishlatilgan yozuvlardan boshqa manbalardan olinishiga e’tibor berilgan.
VoxCeleb1
VoxCeleb1 jami 1251 shaxsga tegishli 100.000 dan ortiq ovoz klipini oʻz ichiga olgan keng koʻlamli soʻzlovchilar ma’lumotlar toʻplamidir. Yozuvlar fon shovqini, aksent va mikrofon sharoitlari jihatidan xilma-xildir.
Ushbu tadqiqotda test videolari oʻqitish videolaridan alohida saqlangan. Oʻqitish uchun har bir shaxsga 20 ta yuz kadri va 20 ta ovoz namunasi maqsad qilib belgilangan, augmentation dan soʻng ular 40 ta yuz va 40 ta ovoz namunasiga yetkazilgan.
Lombard Grid
Lombard Grid 54 nafar soʻzlovchini va har bir shaxs uchun 1000 dan ortiq ovoz klipini oʻz ichiga oladi. Ovozlar bilan sinxron video yozuvlari mavjudligi uni yuz-ovoz moslashtirish uchun qulay qiladi.
Ushbu tadqiqotda har bir shaxs uchun oʻqitishga 20 ta yuz va 20 ta ovoz, testga esa boshqa yozuvlardan 5 ta yuz va 5 ta ovoz tanlangan. Nazorat qilinadigan ma’lumot tuzilmasi sababli augmentation qoʻllanmagan.
Custom ma’lumotlar toʻplami natijalari
Custom ma’lumotlar toʻplamida multimodal usul ham, FaceNet-only baseline ham IID va OOD namunalarini yuqori muvaffaqiyat bilan ajratgan. ROC tahlilida:
| Usul | AUROC |
|---|---|
| Multimodal | 0,9928 |
| FaceNet-only | 0,9828 |
Farq juda katta emas; biroq threshold grafiklari multimodal usul qaror chegarasiga nisbatan barqarorroq hudud hosil qilganini koʻrsatadi.
LombardGrid natijalari
Nazorat qilinadigan LombardGrid ma’lumotlar toʻplamida har ikki usul AUROC=1 qiymatiga erishgan. Shu sababli faqat ROC egri chizigʻi asosida multimodal usul ustun deb aytib boʻlmaydi.
Manbada ta’kidlangan farq — multimodal usul yuqori IID/OOD samaradorligini kengroq threshold oraligʻida saqlab qolishidir. Boshqacha aytganda, ular bir xil eng yuqori samaradorlikka erishsa ham, chegara tanloviga sezgirligi bir xil emas.
VoxCeleb Mini
VoxCeleb Mini tajribasida multimodal tizim AUROC=0,974, FaceNet-only usul esa AUROC=0,971 natija olgan. ROC jihatidan usullar bir-biriga yaqin.
Biroq OOD aniqlash maqsadi oshgani sari IID aniqligini saqlash jihatidan multimodal tizim barqarorroq boʻlgan.
| OOD aniqlash | Multimodal IID | FaceNet IID |
|---|---|---|
| %90,0 | %95,0 | %93,0 |
| %91,8 | %95,0 | %88,5 |
| %93,5 | %92,5 | %85,0 |
| %95,2 | %90,0 | %85,0 |
| %97,0 | %87,5 | %66,7 |
VoxCeleb Big: koʻlam kengayganda nima boʻladi?
Maqoladagi eng yaqqol tafovut VoxCeleb Big tajribasida koʻrinadi.
Multimodal usulning AUROC qiymati 0,977, FaceNet-only taqqoslashining qiymati esa 0,529. Ikkinchisi tasodifiy ajratishga yaqin ROC samaradorligini ifodalaydi.
| OOD aniqlash | Multimodal IID | FaceNet IID |
|---|---|---|
| %90,0 | %94,6 | %18,7 |
| %91,8 | %94,3 | %17,8 |
| %93,5 | %93,8 | %16,8 |
| %95,2 | %92,7 | %14,7 |
| %97,0 | %86,2 | %11,7 |
Mualliflarning izohi FaceNet-only tizimining ishlash usuli bilan bogʻliq. Ushbu baseline soʻrov embedding-ini roʻyxatdan oʻtgan identifikatsiyalarning katta galereyasi bilan taqqoslaydi. Galereya kengaygani sari sinflararo oʻxshashlik taqsimotlari ustma-ust tusha boshlaydi va ma’lum-noma’lum ajratishida ishlatiladigan chegara yanada beqaror boʻladi.
Multimodal usul esa roʻyxatdan oʻtgan barcha identifikatsiyalar bilan 1:N taqqoslash oʻrniga berilgan yuz va ovozning oʻzaro muvofiqligini oʻlchaydi.
Hisoblash murakkabligi
Manba taklif etilgan usul chiqarish vaqtida faqat:
- bitta yuz embedding-i,
- bitta ovoz embedding-i,
- bitta kosinus oʻxshashligi hisobi
talab qilishini bildiradi.
Shu sababli har bir tekshiruv uchun hisoblash xarajati galereya hajmidan qat’i nazar O(1) sifatida ifodalangan. Aksincha, klassik 1:N galereyaga asoslangan shaxsni tanib olishda soʻrov roʻyxatdan oʻtgan barcha identifikatsiyalar bilan taqqoslanishi sababli hisoblash hajmi galereya oʻlchami bilan oshadi.
Ushbu murakkablik da’vosi tadqiqotda belgilangan tekshiruv tartibiga tegishli; real tizimdagi kamera, ovozni dastlabki qayta ishlash, FaceNet feature extraction yoki apparat kechikishining barchasi O(1) va doimiy vaqtli ekanini anglatmaydi.
Tadqiqotning muhim cheklovlari
- Asosiy eksperimental taqqoslash faqat FaceNet-only unimodal baseline bilan oʻtkazilgan.
- Boshqa multimodal state-of-the-art usullar bilan toʻliq eksperimental taqqoslash oʻtkazilmagan.
- Oddiy feature concatenation kabi muqobil multimodal fusion baseline-lari asosiy taqqoslashga kiritilmagan.
- Har bir modallikning mustaqil hissasini miqdoriy ajratadigan batafsil ablatsiya tahlili hali bajarilmagan.
- OOD qaror chegarasi empirik ish nuqtasidir; yagona universal optimal chegara sifatida taqdim etilmagan.
- Custom ma’lumotlar toʻplami atigi 15 kishidan iborat.
- Real dunyo sharoitida ancha keng koʻlamli validatsiya kelgusi ish sifatida qoldirilgan.
- Axloq, maxfiylik va real tizimdan foydalanishga doir keng koʻlamli baholash yakunlanmagan.
Kelgusi ishlar
Mualliflar tizimga yurish uslubi va chuqurlik ma’lumotlari kabi qoʻshimcha modalliklarni kiritish, vaqtli modellashtirishdan foydalanish, self-supervised va few-shot oʻrganish usullarini tadqiq qilish hamda ma’lumotlarga ehtiyojni kamaytirishni rejalashtirgan.
Shuningdek, real dunyoda kengroq validatsiya, axloqiy baholashlar va har bir modallikning natijaga hissasini oʻlchaydigan chuqurroq ablatsiya tajribalari kelgusi tadqiqot mavzulari qatoriga kiradi.
Tadqiqot nimani aytadi?
Yuz va ovoz tasvirlarini kontrastiv tarzda ayni embedding fazosida hizalash, ayniqsa identifikatsiyalar galereyasi kengayganda, cross-modal consistency orqali IID/OOD ajratishini barqarorroq bajarish imkonini berishi mumkin. Tadqiqotdagi eng kuchli eksperimental dalil VoxCeleb Big natijalaridan kelib chiqadi.
Tadqiqot nimani aytmaydi?
Tizim ilgari koʻrilmagan barcha shaxslarni xatosiz aniqlaydi degan xulosaga kelib boʻlmaydi. Usul barcha multimodal biometrik tizimlardan ustun ekani koʻrsatilmagan. Ushbu tadqiqotning oʻzi yuz-ovoz biometrikasi xavfsizlik, kuzatuv yoki identifikatsiyani tekshirish ilovalarida joriy etishga tayyor ekanini ham isbotlamaydi.
Manba va Usul Izohi
Asl tadqiqot: Multimodal Recognition of Out-of-Distribution Individuals Using Contrastive Learning
Mualliflar: Sergio Garcia; Francisco Gomez-Donoso; Miguel Cazorla.
Mas’ul muallif: Miguel Cazorla.
Muassasa: University Institute for Computer Research, University of Alicante, Alicante, Spain.
Jurnal: AI.
Nashriyot: MDPI.
Bibliografik qayd: AI 2026, 7, 162.
DOI: 10.3390/ai7050162
Maqola turi: Eksperimental sun’iy intellekt / multimodal shaxsni tanib olish tadqiqoti.
Nashr jarayoni: 31 Yanvar 2026 da qabul qilib olingan; 6 Aprel 2026 da qayta koʻrib chiqilgan; 24 Aprel 2026 da qabul qilingan; 6 May 2026 da chop etilgan.
Litsenziya: Creative Commons Attribution (CC BY).
Moliyalashtirish: Tadqiqot PID2022-138453OB-I00 granti doirasida MICIU/AEI/10.13039/501100011033 va “ERDF A way of making Europe” tomonidan qoʻllab-quvvatlangan.
Axloq: Tadqiqot Helsinki deklaratsiyasiga muvofiq oʻtkazilgan va University of Alicante Ethics Committee tomonidan UA-2023-07-31 protokol kodi bilan Iyul 2023 da tasdiqlangan.
Axborotga asoslangan rozilik: Tadqiqotga kiritilgan shaxslardan axborotga asoslangan rozilik olingan.
Ma’lumotlarning mavjudligi: Natijalarni qoʻllab-quvvatlovchi xom ma’lumotlar mualliflar tomonidan soʻrov asosida taqdim etilishi bildirilgan.
Manfaatlar toʻqnashuvi: Mualliflar manfaatlar toʻqnashuvi yoʻqligini bildiradi.
Metodologik oʻzak: FaceNet dan ajratib olingan 512 oʻlchamli yuz embedding-lari va 80 ta MFCC ovoz xususiyati ikki alohida neyron tarmoq shoxchasi orqali 1200 oʻlchamli umumiy embedding fazosiga proyeksiyalangan. InfoNCE kontrastiv yoʻqotishi yordamida ayni shaxsga tegishli yuz-ovoz juftlari yaqinlashtirilgan, turli shaxslarning juftlari uzoqlashtirilgan. OOD qarori yuz va ovoz embedding-lari orasidagi kosinus oʻxshashligi va empirik threshold asosida qabul qilingan.
Asosiy talqin chegarasi: Tadqiqot keng koʻlamli state-of-the-art multimodal baseline taqqoslashini amalga oshirmaydi. Natijalarning muhim qismi FaceNet-only baseline bilan nazorat qilinadigan taqqoslashga asoslanadi, kengroq ablation, real dunyo miqyosida sinash va axloqiy baholash esa kelgusi ish sifatida qoldirilgan.
Verianla kontent usuli: Ushbu oʻzbekcha matn manba PDF ning gapma-gap tarjimasi emas. Tadqiqotning ma’lumotlar toʻplamlari, yuz va ovoz tasvirlari, tarmoq arxitekturasi, kontrastiv yoʻqotish, OOD chegara mexanizmi, oʻqitish protokoli, ROC/AUROC natijalari, koʻlam tahlili, hisoblash yondashuvi, axloqiy bayonotlar va metodologik cheklovlari saqlangan holda mustaqil oʻzbekcha ilmiy bayon yaratilgan. Manbada mavjud boʻlmagan samaradorlik, shaxslar soni, klinik/xavfsizlik natijasi yoki joriy etish muvaffaqiyati qoʻshilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan