

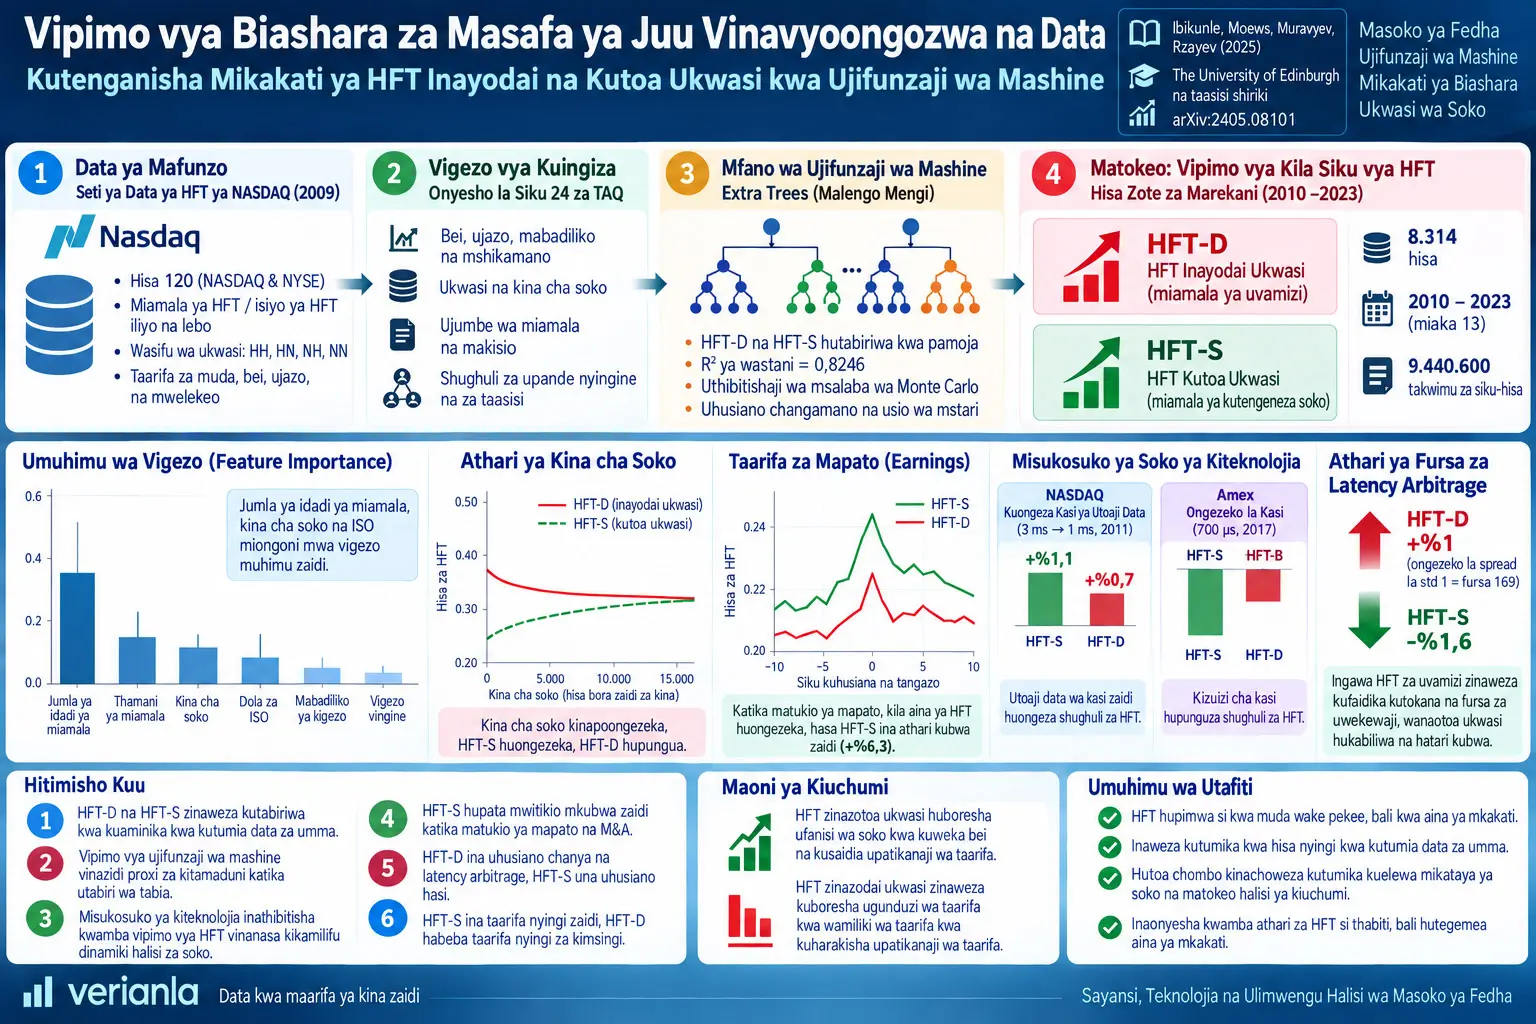
Kupima shughuli za biashara za masafa ya juu ni mojawapo ya changamoto kuu katika utafiti wa masoko ya fedha; kwa sababu data za kawaida za soko zinazopatikana kwa umma hazionyeshi moja kwa moja kama muamala ulifanywa na High-Frequency Trader. Utafiti wa Gbenga Ibikunle, Ben Moews, Dmitriy Muravyev na Khaladdin Rzayev unajaribu kutatua tatizo hili la upimaji kwa mbinu ya ujifunzaji wa mashine inayounganisha seti ndogo lakini ya kina ya data binafsi ya NASDAQ yenye lebo za moja kwa moja za HFT na vigezo vya intraday vya soko vinavyopatikana kwa umma.
Ubunifu mkuu wa utafiti ni kwamba badala ya kutoa kiashiria kimoja cha jumla cha HFT, unakadiria vipengele viwili tofauti vya kimkakati vya HFT kwa kujitegemea. HFT-D inawakilisha miamala mikali ya HFT inayodai ukwasi kutoka sokoni; HFT-S inawakilisha miamala ya HFT inayotoa ukwasi sokoni. Tofauti hii ni muhimu kwa sababu utafiti unaonyesha kwamba shughuli hizi mbili huonyesha mienendo tofauti, na wakati mwingine hata kinyume, mbele ya market depth, intermarket sweep orders, latency arbitrage, exchange speed changes na fundamental information acquisition.
Modeli hutumia seti ya data ya NASDAQ HFT ya mwaka 2009 yenye hisa 120 ili kujifunza lebo za moja kwa moja za HFT kwa kutumia vigezo 24 vya TAQ intraday vya stock-day hiyo hiyo. Mbadala kama Support Vector Regression, feed-forward neural network, Random Forest na Extremely Randomized Trees zililinganishwa; muundo wa mwisho ukachaguliwa kuwa multi-target Extra Trees. Thamani ya wastani ya \(R^2\) ya modeli iliyoboreshwa ni 0,824635 na mkengeuko wa kawaida ni 0,005472.
Kisha modeli iliyofundishwa ilitumika kwenye ulimwengu wote wa TAQ kati ya 4 Januari 2010 na 18 Oktoba 2023 kwa hisa 8.314 za Marekani na kutoa jumla ya uchunguzi 9.440.600 wa stock-day. Kwa njia hii, makadirio ya kila siku ya HFT-D na HFT-S yalipatikana kutoka kwa data za umma zisizo na utambulisho wa moja kwa moja wa HFT.
Matokeo ya validation ya utafiti yanatoa ushahidi mbalimbali kwamba modeli haikukariri tu data za training. Mnamo 2011 NASDAQ ilipunguza ucheleweshaji wa usambazaji wa data kutoka milisekunde 3 hadi milisekunde 1; HFT-D iliyokadiriwa iliongezeka kwa takriban %0,7 na HFT-S kwa takriban %1,1. Baada ya Amex tarehe 24 Julai 2017 kuanzisha round-trip speed bump ya mikrosekunde 700, HFT-D ilipungua kwa takriban %2,8 na HFT-S kwa takriban %4,6.
Katika fursa za latency-arbitrage pia mikakati miwili hutofautiana. Ongezeko la mkengeuko mmoja wa kawaida, yaani fursa 169, linahusishwa na takriban %1 ongezeko la shughuli ya HFT-D na takriban %1,6 kupungua kwa shughuli ya HFT-S. Uhusiano huu unaendana kinadharia na wafanyabiashara wakali wenye kasi kuelekea stale quote na liquidity supplier kujiepusha na hatari ya adverse-selection; hata hivyo waandishi hawatoi hitimisho la kisababishi kutoka kwenye regresha hii.
Katika matumizi ya upataji taarifa ya makala, liquidity-supplying HFT inahusishwa na fundamental information acquisition zaidi, huku liquidity-demanding HFT ikihusishwa na information acquisition kidogo. Matokeo yanaonyesha kwamba “athari ya HFT kwenye soko” haiwezi kuelezewa kwa ishara moja na kwamba kutenganisha mkakati wa HFT unaotumika ni muhimu kwa tafsiri ya kiuchumi.
Kwa Nini HFT Haiwezi Kupimwa Moja kwa Moja katika Data za Umma?
Mifumo ya kawaida ya data za soko inaweza kuonyesha bei, kiasi, muda, thamani za bid na ask au mabadiliko katika kitabu cha oda; lakini kwa kawaida haiweki lebo kama mshiriki aliyefanya muamala ni kampuni ya HFT. Kwa hiyo watafiti hulazimika kupima shughuli za HFT ama kwa seti binafsi za data zenye utambulisho wa moja kwa moja, au kwa proxy zisizo za moja kwa moja zinazotokana na data za umma.
Faida ya seti binafsi za data ni kuwa zina utambulisho halisi wa HFT; hasara yake ni kuwa mara nyingi zina idadi ndogo ya hisa na vipindi vifupi vya muda. Proxy za umma kama quote-to-trade ratio, odd-lot volume au message count zina ufunikaji mpana zaidi, lakini haziwezi kutenganisha moja kwa moja kama HFT inatoa ukwasi au inautumia.
Utafiti unaunganisha njia hizi mbili: data ndogo lakini yenye lebo halisi za HFT hufundisha modeli; vigezo vya TAQ vinavyopatikana kwa umma huwezesha modeli iliyofundishwa kutumika kwa ulimwengu mzima wa hisa za Marekani.
Tofauti Kati ya HFT-D na HFT-S ni Nini?
HFT-D ni sehemu iliyokadiriwa ya miamala ambamo High-Frequency Trader yuko upande mkali na hutumia ukwasi uliopo; HFT-S ni sehemu iliyokadiriwa ya miamala ambamo HFT yuko upande wa passiv na hutoa ukwasi kwa upande mwingine. Madaraja ya miamala HH, HN, NH na NN katika seti ya data ya NASDAQ ndiyo msingi wa utofautishaji huu.
Katika uainishaji wa NASDAQ:
- HH: pande zote mbili za muamala ni HFT.
- HN: upande unaodai ukwasi ni HFT, upande mwingine ni non-HFT.
- NH: upande unaodai ukwasi ni non-HFT, upande unaotoa ukwasi ni HFT.
- NN: pande zote mbili ni non-HFT.
Kulingana na ufafanuzi katika maandishi makuu ya chanzo, uwiano wa liquidity-demanding HFT ni:
na uwiano wa liquidity-supplying HFT ni:
kama ilivyofafanuliwa.
Kwa kuwa miamala ya HH ina HFT upande wa demand na upande wa supply, HFT-D na HFT-S si sehemu mbili za jumla za soko zinazojitenga. Vipimo hivyo viwili havipaswi kujumlishwa kwa urahisi na kutafsiriwa kama “sehemu ya jumla ya HFT”.
Katika takwimu za muhtasari wa chanzo, wastani wa HFT-D uliokadiriwa na ML ni 0,316 na wastani wa HFT-S ni 0,208. Mkengeuko wa kawaida umeripotiwa kuwa 0,112 na 0,101 mtawalia.
Ujifunzaji wa Mashine Hujifunzaje Shughuli za HFT?
Ingizo la modeli lina vigezo 24 vya soko vilivyopatikana kutoka mfumo wa TAQ Intraday Indicators kwa stock-day hiyo hiyo. Vigezo hivyo vinawakilisha sifa tofauti za soko kama bei, kiasi cha biashara, idadi ya miamala, quoted spread, effective spread, realized spread, price impact, market depth, volatility, order imbalance, retail trading na institutional trading.
Matokeo lengwa ya modeli ni thamani za HFT-D na HFT-S zilizozingatiwa moja kwa moja na NASDAQ.
Seti ya data ya Training
Seti ya data ya NASDAQ ya mwaka 2009 inajumuisha hisa 120 za NASDAQ na NYSE zilizochaguliwa kwa nasibu. Sampuli ghafi ina uchunguzi 29.880 wa stock-day. Uchunguzi 2.184, yaani takriban %7 ya data, wenye upungufu katika vigezo huru au tegemezi uliondolewa. Waandishi hawakutumia interpolation au imputation kwa sababu kufanya hivyo kungehitaji dhana kali kuhusu data za HFT.
Modeli zilizojaribiwa
Watafiti walitathmini modeli za Support Vector Regression, feed-forward artificial neural network, Random Forest na Extremely Randomized Trees. Katika modeli za Tree, miundo ya multi-model ambamo kila target ilimodeliwa kivyake pamoja na miundo ya multi-target ambamo HFT-D na HFT-S zilikadiriwa kwa pamoja zilijaribiwa.
| Mbinu | R² ya wastani | Mkengeuko wa kawaida |
|---|---|---|
| SVR | 0,684 | 0,058 |
| ANN | 0,783 | 0,0229 |
| Random Forest - multi-model | 0,784 | 0,055 |
| Random Forest - multi-target | 0,790 | 0,043 |
| Extra Trees - multi-model | 0,804 | 0,036 |
| Extra Trees - multi-target | 0,805 | 0,035 |
Baada ya ulinganisho huu, mbinu ya Extra Trees multi-target ilichaguliwa.
Uboreshaji wa Hyperparameter
Grid search ilifanywa kwa vigezo viwili vikuu:
Idadi ya tree katika Ensemble na idadi ya chini ya sample zinazohitajika kwa node split,
zilijaribiwa kwa michanganyiko yote ya thamani hizo. Hivyo parameter combination 64 ziliundwa na kila jaribio lilirudiwa mara 10.
Katika Jedwali la 3 la chanzo, wastani wa juu zaidi wa \(R^2\), kwa minimum split sample = 5 na ensemble size = 640, umeripotiwa kuwa 0,814442. Katika jaribio la mwisho lililoboreshwa, wastani ulikuwa:
na mkengeuko wa kawaida:
ulipatikana.
Monte Carlo cross-validation
Monte Carlo cross-validation ilitumika katika majaribio. Katika kila iteration, data iligawanywa kwa nasibu katika vikundi vidogo vya training na test. Katika ulinganisho wa awali wa modeli, uchunguzi 10.000 ulitumika na %25 ilitengwa kama test set.
Mbinu hii inalenga kupunguza gharama ya kihesabu ya kutumia k-fold ya kawaida kwenye seti kubwa sana za data.
Ni Vigezo Gani vya Soko Muhimu katika Kukadiria HFT?
Uchambuzi wa feature-importance katika Kielelezo 1 cha chanzo unaonyesha kwamba hasa idadi ya jumla ya trade, thamani za miamala, Intermarket Sweep Orders na viashiria vya market-depth ni muhimu katika makadirio ya modeli. Kielelezo 2 kinaonyesha kwamba uhusiano kati ya vigezo hivi na shughuli ya HFT si wa mstari katika hali nyingi.
Idadi ya jumla ya trade
HFT-D na HFT-S huongezeka kadiri idadi ya jumla ya trade inavyoongezeka; lakini uhusiano si karibu wa mstari, bali ni unaoongezeka na concave. Hii ina maana kuwa athari ya pembezoni ya ongezeko la awali la trade-volume ni kubwa zaidi na katika viwango vya juu zaidi mviringo huanza kusawazika.
Intermarket Sweep Orders
Kadiri kiasi cha ISO dollar kinavyoongezeka, HFT-D huongezeka haraka mwanzoni na kisha mviringo husawazika. Mwitikio wa HFT-S kwa kiasi cha ISO ni mdogo zaidi.
Tofauti hii inaunga mkono tafsiri ya chanzo kwamba shughuli ya HFT ya upande mkali ina uhusiano wenye nguvu zaidi na matumizi ya ISO.
Market depth
Chanzo kinaonyesha katika Kielelezo 2 kwamba aina mbili za HFT huonyesha tabia za mwelekeo tofauti dhidi ya market depth:
HFT-S: huonyesha muundo unaoongezeka na concave kadiri market depth inavyoongezeka.
HFT-D: huonyesha muundo unaopungua na convex kadiri market depth inavyoongezeka.
Kwa maneno mengine, modeli inanasa tabia ambayo HFT huwa na mwelekeo mkubwa zaidi wa kutoa ukwasi katika mazingira yenye order book ya kina zaidi, na kudai ukwasi zaidi katika masoko yenye kina kidogo.
Modeli Ilipanuliwaje kutoka Data za 2009 hadi Soko la 2010–2023?
Baada ya modeli ya mwisho ya Extra Trees kufundishwa kwenye data za 2009 za NASDAQ zenye lebo halisi za HFT, ilitumika kwa hisa zote za Marekani zenye data za TAQ.
Seti ya data iliyopanuliwa:
| Sifa | Thamani |
|---|---|
| Idadi ya hisa | 8.314 |
| Idadi ya uchunguzi wa Stock-day | 9.440.600 |
| Mwanzo | 4 Januari 2010 |
| Mwisho | 18 Oktoba 2023 |
| Input feature | 24 |
| Output kuu | HFT-D na HFT-S |
Thamani kuu ya kimethodolojia ya utafiti inaonekana hapa. Ingawa utambulisho wa moja kwa moja wa HFT unapatikana kwa hisa 120 pekee, uhusiano uliojifunzwa na modeli unatumiwa kwenye data za TAQ za umma ili kuunda paneli pana ya kila siku ya karibu miaka 13.
HFT Hufanyaje katika Matangazo ya Earnings na M&A?
Ili kujaribu kama modeli inanasa tabia yenye maana ya kiuchumi, watafiti walichunguza vipindi vya earnings announcement vilivyopangwa na M&A announcement zisizopangwa.
Earnings announcements
Kielelezo 3 cha chanzo kinaonyesha siku 10 kabla na siku 10 baada ya tangazo. HFT-S na HFT-D zote huanza kuongezeka takriban siku tatu kabla na kufikia kilele siku ya tangazo.
Katika announcement window ya siku tatu, yaani \(t\), \(t+1\) na \(t+2\):
| Aina ya HFT | Mabadiliko yaliyoripotiwa katika chanzo |
|---|---|
| HFT-S | %6,3 ongezeko; kutoka 0,208 hadi 0,221 |
| HFT-D | %2,8 ongezeko |
Mwitikio mkubwa zaidi wa HFT inayotoa ukwasi unatafsiriwa kuwa unaendana na kuongezeka kwa shughuli za market-making katika vipindi vya mtiririko mkubwa wa taarifa.
M&A announcements
Katika Kielelezo 4 cha chanzo, muundo ni tofauti kwa matangazo ya M&A yasiyopangwa. HFT-S huanza kuongezeka takriban siku moja kabla, huku ongezeko dhahiri la HFT-D likitokea kuanzia announcement day.
Katika dirisha la siku tatu:
| Aina ya HFT | Mabadiliko yaliyoripotiwa katika chanzo |
|---|---|
| HFT-S | %3,2 ongezeko |
| HFT-D | %1,2 ongezeko |
Ongezeko zote mbili zimeripotiwa kuwa na umuhimu wa kitakwimu katika kiwango cha %1 katika chanzo.
Je, Mabadiliko ya Kasi ya Soko la Hisa Yanathibitisha Vipimo vya HFT?
Ndiyo. Utafiti unatumia mishtuko miwili tofauti ya kiteknolojia ya soko ili kujaribu kama modeli inanasa mienendo halisi ya HFT: uharakishaji wa data-feed wa NASDAQ wa mwaka 2011 na speed bump ya Amex ya mwaka 2017.
NASDAQ: 3 ms → 1 ms
Uboreshaji wa kiteknolojia uliotekelezwa hatua kwa hatua tarehe 10 na 17 Oktoba 2011 ulipunguza trading-data dissemination latency kutoka milisekunde 3 hadi milisekunde 1.
Katika uchambuzi wa Difference-in-differences, hisa zilizoorodheshwa kwenye exchange nyingine zilitumika kama kundi la udhibiti.
Ukubwa wa kiuchumi uliokokotolewa na chanzo ikilinganishwa na wastani wa pre-upgrade:
| Aina ya HFT | Mabadiliko |
|---|---|
| HFT-D | Takriban %0,7 ongezeko |
| HFT-S | Takriban %1,1 ongezeko |
Amex speed bump
NYSE Amex tarehe 24 Julai 2017 iliweka ucheleweshaji wa round-trip wa jumla ya mikrosekunde 700 ulioathiri mawasiliano ya inbound na outbound.
Mabadiliko yaliyoripotiwa na chanzo ikilinganishwa na wastani wa pre-speed-bump:
| Aina ya HFT | Mabadiliko |
|---|---|
| HFT-D | %2,8 kupungua |
| HFT-S | %4,6 kupungua |
Kwa kuwa tukio la 2017 lilitokea takriban miaka minane baada ya data za training, utafiti hulitumia kama validation muhimu ya nje ya temporal robustness ya modeli.
Kwa Nini Latency Arbitrage Huathiri HFT-D na HFT-S kwa Mielekeo Tofauti?
Latency arbitrage ni uwezo wa trader anayefikia taarifa mpya za umma kwa kasi zaidi kutumia “stale quote” ambazo bado hazijasasishwa. Katika utafiti huu, ongezeko la fursa hizo huongeza shughuli za HFT-D za upande mkali na hupunguza shughuli za HFT-S.
Kwa sababu ya gharama ya kihesabu, uchambuzi wa latency-arbitrage ulifanywa kwa hisa 120 za NASDAQ/NYSE katika kipindi cha 2010–2023.
Wastani wa kila siku wa idadi ya latency-arbitrage opportunity:
mkengeuko wa kawaida:
na kiwango cha juu:
kiliripotiwa.
Ongezeko la mkengeuko mmoja wa kawaida:
| Aina ya HFT | Uhusiano |
|---|---|
| HFT-D | Takriban %1 ongezeko |
| HFT-S | Takriban %1,6 kupungua |
Chanzo kinafafanua utaratibu hivi: stale quote inapotokea, trader wakali wenye kasi hushindana kuichukua quote hiyo, huku liquidity supplier wakiondoa ukwasi ili kuepuka hatari ya adverse-selection.
Katika sehemu hii waandishi wanaeleza wazi kwamba regresha haithibitishi athari ya kisababishi.
Kwa Nini Vipimo Vipya vya HFT Vinatofautiana na Proxy za Kawaida?
Utafiti unalinganisha vipimo vya ML na proxy tano za kawaida:
quote volatility, odd-lot volume, quote intensity, quote-to-trade ratio na jumla ya idadi ya trade/quote message.
Modeli ilifundishwa upya kwa data za Januari–Juni 2009 na kipindi cha Julai–Desemba 2009 kilitumika kikamilifu kwa out-of-sample validation.
Ujumbe mkuu wa matokeo ni kwamba proxy za kawaida zinaweza kunasa baadhi ya tofauti za cross-sectional, lakini zinaeleza kwa udhaifu zaidi mabadiliko ya HFT ya hisa ileile kadiri muda unavyopita. ML-generated HFT-D na HFT-S zinaonyesha uhusiano wenye nguvu zaidi na lebo za moja kwa moja za NASDAQ HFT katika vipimo vya cross-sectional na time-series.
Kwa mfano, katika majaribio yenye day fixed effect pekee, within-\(R^2\) ni %74 kwa ML-HFT-S na %50 kwa ML-HFT-D. Ingawa baadhi ya proxy za kawaida hunasa varians ya cross-sectional, vipimo vya ML huhifadhi maudhui muhimu ya taarifa ndani ya joint regression.
HFT Huathirije Fundamental Information Acquisition?
Baada ya mchango mkuu wa kimethodolojia wa utafiti, fundamental information acquisition karibu na earnings announcements inachunguzwa ili kuonyesha jinsi vipimo vinaweza kutumika katika maswali halisi ya kiuchumi.
Kipimo cha kwanza ni price jump ratio.
Hapa, JUMP kubwa hutafsiriwa kuwa bei ilikuwa na fundamental information kidogo kabla ya announcement, yaani pre-announcement information acquisition ilikuwa ya chini.
Liquidity-demanding HFT
Koeffishenti ya HFT-D ni:
na ina umuhimu katika kiwango cha %1 kulingana na chanzo.
Kuongezeka kwa HFT-D kutoka persentili ya 25 ya 0,222 hadi persentili ya 75 ya 0,414 kunahusishwa na takriban %6,6 ongezeko la JUMP ratio ikilinganishwa na wastani wake.
Kwa kuwa JUMP kubwa ina maana ya pre-announcement information acquisition kidogo, HFT-D inahusishwa na upataji mdogo wa taarifa.
Liquidity-supplying HFT
Koeffishenti ya HFT-S ni:
na ina umuhimu katika kiwango cha %1.
Kuongezeka kwa HFT-S kutoka persentili ya 25 ya 0,131 hadi persentili ya 75 ya 0,259 kunahusishwa na takriban %3,3 kupungua kwa JUMP ratio ikilinganishwa na wastani.
Matokeo haya yanaonyesha kuwa shughuli kubwa zaidi za liquidity-supplying HFT zinahusishwa na upataji zaidi wa taarifa kabla ya announcement.
Kwa nini aina mbili za HFT zinaweza kutoa matokeo tofauti?
Kulingana na maelezo ya kiuchumi ya chanzo, liquidity provider HFT wanaweza kupunguza spread na trading cost na hivyo kurahisisha biashara kwa wawekezaji wanaotafuta fundamental information. Liquidity-demanding HFT, kwa upande mwingine, wakikadiria informed institutional order flow na kufanya biashara kwa ukali, wanaweza kuongeza gharama ya adverse-selection kwa informed trader na kupunguza motisha ya information-acquisition.
Maelezo haya ni utaratibu unaopendekezwa na chanzo; regresha ya jump-ratio peke yake haithibitishi utaratibu huu wa kisababishi.
Future Earnings Response Coefficient
Jaribio la pili la upataji taarifa ni FERC. FERC hutathmini kiwango ambacho stock return ya leo inahusishwa na taarifa za earnings za baadaye.
Katika Jedwali la 10 la chanzo, koeffishenti ya mwingiliano wa earnings za baadaye na HFT-D ni:
na koeffishenti ya mwingiliano wa HFT-S ni:
kama ilivyoripotiwa, na mahusiano yote mawili yana umuhimu katika kiwango cha %1.
Jaribio la FERC linaonyesha mwelekeo sawa na matokeo ya jump-ratio: liquidity supply inahusishwa na information acquisition zaidi, huku liquidity demand ikihusishwa na information acquisition kidogo.
Mbinu na Matokeo ya Utafiti
Vyanzo vikuu vya data
| Chanzo | Jukumu la kisayansi |
|---|---|
| NASDAQ HFT | Lebo za moja kwa moja za HFT / non-HFT na liquidity-side kwa mwaka 2009. |
| WRDS TAQ Intraday Indicators | 24 ML input feature na upanuzi kwa hisa zote za Marekani. |
| Millisecond TAQ | Proxy za kawaida za HFT na granular quote-level robustness. |
| Refinitiv DataScope | Data za intraday quote za kubaini fursa za latency-arbitrage. |
| I/B/E/S | Tarehe za earnings announcement. |
| Thomson Reuters SDC | Tarehe za M&A announcement. |
| CRSP | Data za stock return na trading-volume. |
| MIDAS | Ulinganisho na vipimo mbadala vya HFT vya aina ya Weller. |
Kwa nini Extra Trees ilichaguliwa?
Extra Trees ilitoa kwa pamoja performance ya juu ya out-of-sample na varians ndogo ikilinganishwa na mbinu zilizojaribiwa. Ingawa feed-forward neural network ilionyesha performance inayofanana, waandishi wanasema modeli changamano zaidi inapaswa kuchaguliwa tu ikiwa modeli rahisi hazitoshi.
Muundo wa tree pia unaweza kunasa kwa kawaida nonlinear interaction kati ya HFT na vigezo vya soko.
Je, kuongeza quote-level feature kulibadilisha mengi?
Hapana. Baseline model ilitoa takriban %82 \(R^2\) kwa kutumia TAQ indicator za kila siku, na baada ya kuongeza vigezo vya granular quote-level thamani iliongezeka hadi takriban %84.
Uhusiano kati ya vipimo vya HFT vilivyotolewa na modeli hizo mbili:
| Kipimo | Uhusiano |
|---|---|
| Liquidity-supplying HFT | 0,99 |
| Liquidity-demanding HFT | 0,96 |
Kwa hiyo utafiti unahitimisha kwamba data ghali zaidi za granular quote zinaongeza incremental value ndogo tu kwa baseline model.
Matokeo ya scaled na unscaled HFT
Vipimo vya baseline HFT-D na HFT-S hupima HFT trading volume kwa kuigawa kwa trading volume yote. Ili kujaribu ukosoaji kwamba modeli inaweza kuwa inajifunza mabadiliko ya total volume badala yake, watafiti pia waliunda modeli bila kuscale HFT volume.
Katika uchambuzi wa unscaled wa Online Appendix, mielekeo mikuu ilibaki:
- HFT huitikia information events.
- Hubadilika katika mwelekeo unaotarajiwa chini ya Technology shocks.
- Latency arbitrage huathiri HFT-D na HFT-S kwa mielekeo tofauti.
- Vipimo vya ML vina nguvu zaidi kuliko proxy za kawaida.
- Mahusiano ya HFT-D na HFT-S na information acquisition yanabaki katika mielekeo tofauti.
Kwa nini data za moja kwa moja za NASDAQ HFT hazikutosha kwa uchambuzi wa upataji taarifa?
Seti ya data ya NASDAQ yenye lebo za moja kwa moja imewekewa kikomo cha hisa 120 na mwaka 2009 pekee. Outcome ya masafa ya chini inayopimwa quarterly kama earnings inapotumiwa, sampuli hupungua sana.
Katika Jedwali la 11 la chanzo, uchambuzi wa jump-ratio kwa data za moja kwa moja za NASDAQ HFT una uchunguzi 466 tu; uchambuzi wa FERC una uchunguzi 401. Katika sampuli hii ndogo, hakuna uhusiano wa kitakwimu wenye umuhimu uliopatikana kati ya mikakati ya HFT na information acquisition.
Faida kuu ya paneli ya ML-generated kwa watafiti ndiyo hii: muundo uliojifunzwa kutoka sampuli ndogo ya HFT iliyozingatiwa moja kwa moja huhamishiwa kwenye paneli pana zaidi ya muda-hisa ambamo maswali ya kiuchumi ya masafa ya chini yanaweza kuchambuliwa.
Jaribio la robustness la 2010–2012
Ili kujaribu uwezekano kwamba matumizi ya modeli kwa miaka iliyo mbali sana na kipindi cha training cha 2009 ndiyo yanaendesha matokeo, uchambuzi wa information-acquisition ulirudiwa kwa kipindi cha 2010–2012 pekee.
Ishara za matokeo ni sawa na uchambuzi wa baseline:
HFT-D inahusishwa na information acquisition kidogo, huku HFT-S ikihusishwa na information acquisition zaidi.
Matokeo yanayoungwa mkono na utafiti
Utafiti uliopakiwa unaunga mkono matokeo yafuatayo: vigezo vya intraday vya soko vinavyopatikana kwa umma vinapounganishwa na kiasi kidogo cha data zenye lebo za moja kwa moja za HFT, inawezekana kujenga modeli zinazokadiria shughuli za liquidity-demanding na liquidity-supplying HFT kando. Modeli ya Extra Trees inaonyesha performance nzuri ya out-of-sample miongoni mwa mbinu zilizojaribiwa. Vipimo vya ML-generated HFT vina uhusiano wenye nguvu zaidi na shughuli halisi za NASDAQ HFT kuliko proxy za kawaida na hunasa varians ya cross-sectional pamoja na time-series.
Aina mbili za HFT zinazotolewa na modeli pia zinaonyesha tofauti zenye maana ya kiuchumi. Fursa za latency arbitrage zina uhusiano chanya na HFT-D na hasi na HFT-S. Amex speed bump inayopunguza kasi hupunguza shughuli zote mbili, lakini mabadiliko katika liquidity supply ni makubwa zaidi. Katika uchambuzi wa fundamental information acquisition, HFT-S ina uhusiano chanya na HFT-D uhusiano hasi.
Matokeo yasiyoungwa mkono na utafiti
Utafiti hauonyeshi kwamba modeli ya ML inaweza kutambua kwa uhakika kwa kila muamala binafsi kama ulifanywa na HFT; vigezo vinavyotolewa ni sehemu zilizokadiriwa za shughuli za HFT katika kiwango cha stock-day.
Ingawa uhusiano uliojifunzwa na modeli mwaka 2009 unaonyesha tabia yenye maana katika validation test za 2010–2023, utegemezi kwa training sample ya 2009 ni kikwazo muhimu cha kimethodolojia.
Matokeo ya information-acquisition hayapaswi kutafsiriwa kama athari ya kisababishi. Waandishi hawadai kwamba wametambua causal effect ya HFT kwenye fundamental information acquisition kutokana na uwezekano wa endogeneity.
Regresha ya latency-arbitrage pia si jaribio la sababu.
Utafiti hauonyeshi kwamba HFT-S ni “nzuri” katika kila hali ya soko au kwamba HFT-D ni “mbaya” kila wakati. Matokeo yanategemea outcome na uchambuzi maalum. Kwa mfano, HFT ya upande mkali inaweza kusababisha gharama ya adverse-selection kwa liquidity provider wakati wa latency arbitrage, lakini wakati huo huo inaweza kupeleka taarifa mpya kwenye bei kwa haraka na kuboresha baadhi ya vipengele vya price efficiency.
Haijajaribiwa katika toleo la 2025 lililopakiwa kama vipimo vya ML-generated vitatoa performance sawa katika masoko nje ya Marekani.
Vikwazo vikuu
Kikwazo muhimu zaidi cha utafiti ni kwamba training ground truth inategemea data za NASDAQ HFT za mwaka 2009. Ingawa teknolojia ya HFT na miundombinu ya soko zimebadilika sana baadaye, waandishi wanasema muundo wa msingi wa mikakati ya liquidity-demand na liquidity-supply umebaki thabiti kwa kiasi.
Kikwazo cha pili ni kwamba matokeo ya modeli si participant identity halisi, bali ni makadirio. Hata \(R^2\) kubwa sana haimaanishi kuwa hakuna hitilafu ya upimaji kwa kila stock-day.
Kikwazo cha tatu ni kwamba matumizi ya HFT information-acquisition ni observational. Hakuna causal identification tofauti iliyofanywa katika utafiti ili kusema kwamba mabadiliko katika HFT-D au HFT-S yalisababisha moja kwa moja mabadiliko katika information acquisition.
Kikwazo cha nne ni kwamba uchambuzi wa latency-arbitrage opportunity, kutokana na gharama ya kihesabu, haukufanywa kwa hisa zote 8.314 bali kwa kundi la awali la 120-stock.
Dokezo la Chanzo na Mbinu
Kichwa asili: Data-Driven Measures of High-Frequency Trading.
Waandishi: Gbenga Ibikunle, Ben Moews, Dmitriy Muravyev na Khaladdin Rzayev.
Mwandishi anayewajibika: Khaladdin Rzayev.
Mahusiano ya kitaasisi: Edinburgh Centre for Financial Innovations, The University of Edinburgh; RoZetta Institute, Sydney; Centre for Statistics, The University of Edinburgh; Department of Finance, University of Illinois at Urbana-Champaign; Canadian Derivatives Institute; Koç University; Systemic Risk Centre, London School of Economics.
Aina ya chanzo: Preprint / working paper.
Toleo ambalo makala hii ya Verianla inategemea: Chanzo kilichopakiwa chenye kurasa 78; online appendix ina tarehe ya March 2025.
Kitambulisho cha ArXiv: 2405.08101.
DOI: 10.48550/arXiv.2405.08101.
Kichwa cha zamani: Can machine learning unlock new insights into high-frequency trading? Kichwa hiki kimehifadhiwa katika sehemu ya March 2025 online appendix ya PDF iliyopakiwa.
Dokezo la toleo la baadaye: Waandishi hao hao walitoa toleo jipya zaidi mwezi Agosti 2026 lenye kichwa Data-Driven Measures of High-Frequency Trading na nambari arXiv:2608.00858. Matokeo mapya ya kisayansi ya toleo hilo la baadaye hayajatumika katika maandishi haya ya Verianla.
JEL: G10, G12, G14.
Modeli kuu ya ML: Multi-target Extremely Randomized Trees.
Utendaji wa modeli ya mwisho: Wastani \(R^2=0.824635\), mkengeuko wa kawaida 0.005472.
Data za Ground-truth: 2009 NASDAQ HFT dataset; hisa 120 za NASDAQ na NYSE.
Idadi ya Input feature: 24.
Kipindi kilichopanuliwa: 4 Januari 2010–18 Oktoba 2023.
Ulimwengu uliopanuliwa: Hisa 8.314 za Marekani.
Uchunguzi wa Stock-day: 9.440.600.
Output kuu: Liquidity-demanding HFT, HFT-D; liquidity-supplying HFT, HFT-S.
Miundo kuu ya validation: Earnings announcements, M&A announcements, 2011 NASDAQ latency upgrade, 2017 Amex speed bump, latency-arbitrage opportunities na conventional HFT proxies.
Vipimo vya Information-acquisition: Price jump ratio na Future Earnings Response Coefficient.
Matokeo makuu ya matumizi ya kiuchumi: HFT-S inahusishwa na fundamental information acquisition zaidi, HFT-D na information acquisition kidogo; utafiti hauainishi matokeo haya kama athari ya kisababishi.
Dokezo la upatikanaji wa data: Chanzo kinaeleza kuwa data za NASDAQ HFT zinaweza kutolewa bila malipo kwa wasomi baada ya maelezo ya mradi na nondisclosure agreement.
Kutokuwiana ndani ya chanzo: Katika Jedwali la 1, ufafanuzi wa maandishi wa fomula ya HFT-S umeandikwa HH+HN, huku maandishi makuu ya mbinu yakifafanua HFT-S kama HH+NH. Ufafanuzi mkuu unaoendana na uainishaji wa miamala wa utafiti ni HH+NH.
Dokezo la pili la ndani ya chanzo: Katika Jedwali la 10, t-statistika inayoandamana na koeffishenti hasi −2.018 imechapishwa kama chanya 4.56; tafsiri ya maandishi inaeleza uhusiano kuwa hasi.
Kikomo kikuu cha kimethodolojia: Thamani zote za HFT za 2010–2023 si uchunguzi wa moja kwa moja, bali ni makadirio ya ML yaliyojifunza kutoka lebo za HFT za mwaka 2009. Matumizi yote ya information-acquisition na latency-arbitrage hayapaswi kutafsiriwa kama causal inference.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *