

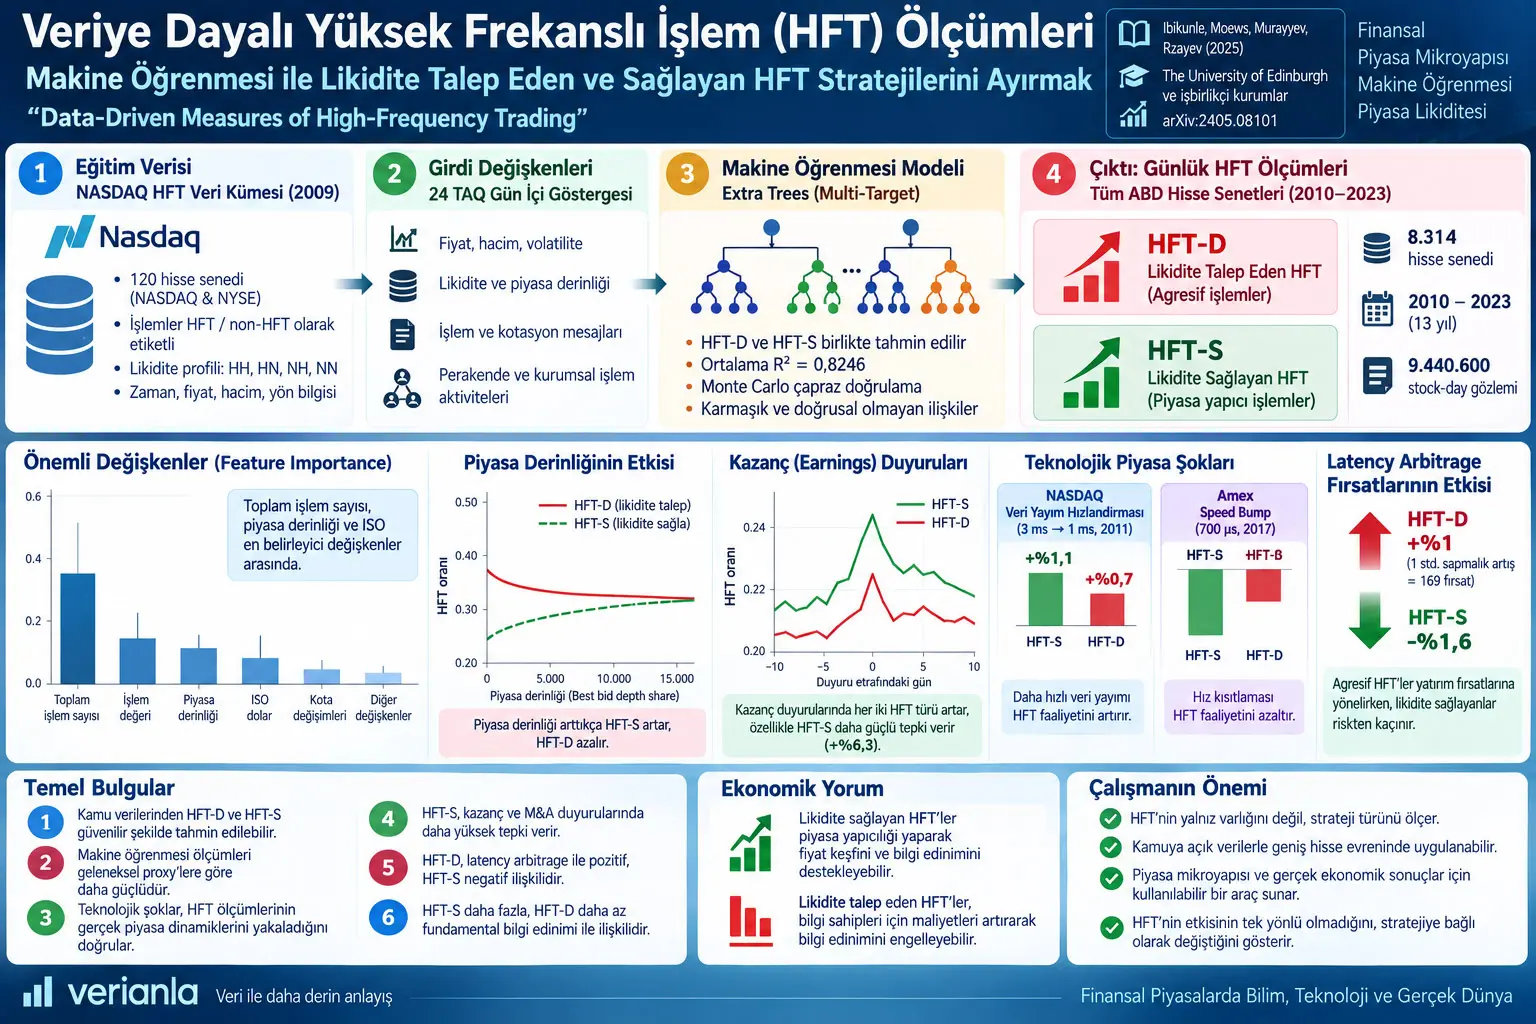
Yüksek frekanslı işlem faaliyetini ölçmek finansal piyasa araştırmalarındaki temel sorunlardan biridir; çünkü kamuya açık standart piyasa verileri bir işlemin High-Frequency Trader tarafından gerçekleştirilip gerçekleştirilmediğini doğrudan belirtmez. Gbenga Ibikunle, Ben Moews, Dmitriy Muravyev ve Khaladdin Rzayev'in çalışması, bu ölçüm problemini doğrudan HFT olarak etiketlenmiş küçük fakat ayrıntılı özel bir NASDAQ veri kümesini, kamuya açık intraday piyasa değişkenleriyle eşleştiren makine öğrenmesi yaklaşımıyla çözmeye çalışmaktadır.
Çalışmanın temel yeniliği tek bir genel HFT göstergesi üretmek yerine iki farklı stratejik HFT bileşenini ayrı ayrı tahmin etmesidir. HFT-D, piyasadan likidite talep eden agresif HFT işlemlerini; HFT-S ise piyasaya likidite sağlayan HFT işlemlerini temsil eder. Bu ayrım önemlidir; çünkü çalışma iki faaliyetin market depth, intermarket sweep orders, latency arbitrage, exchange speed changes ve fundamental information acquisition karşısında farklı, hatta bazı durumlarda birbirine zıt davranışlar gösterdiğini ortaya koymaktadır.
Model 2009 yılına ait 120 hisse senedini içeren NASDAQ HFT veri kümesindeki doğrudan HFT etiketlerini öğrenmek için aynı stock-day'e ait 24 TAQ intraday değişkenini kullanmaktadır. Support Vector Regression, feed-forward neural network, Random Forest ve Extremely Randomized Trees gibi alternatifler karşılaştırılmış; nihai yapı multi-target Extra Trees olarak seçilmiştir. Optimize edilmiş modelin ortalama \(R^2\) değeri 0,824635 ve standart sapması 0,005472'dir.
Eğitilen model daha sonra 4 Ocak 2010 ile 18 Ekim 2023 arasındaki bütün TAQ evrenine uygulanmış ve 8.314 ABD hisse senedi için toplam 9.440.600 stock-day gözlemi üretilmiştir. Böylece doğrudan HFT kimliği içermeyen kamu verilerinden günlük HFT-D ve HFT-S tahminleri elde edilmiştir.
Çalışmanın validation sonuçları modelin yalnız training verisini ezberlemediğine yönelik çeşitli kanıtlar sunmaktadır. NASDAQ'ın 2011'de veri yayım gecikmesini 3 milisaniyeden 1 milisaniyeye indirmesi sonrasında tahmini HFT-D yaklaşık %0,7, HFT-S yaklaşık %1,1 yükselmiştir. Amex'in 24 Temmuz 2017'de uyguladığı 700 mikrosaniyelik round-trip speed bump sonrasında ise HFT-D yaklaşık %2,8 ve HFT-S yaklaşık %4,6 düşmüştür.
Latency-arbitrage fırsatlarında da iki strateji ayrışmaktadır. Bir standart sapmalık, yani 169 fırsatlık artış HFT-D faaliyetinde yaklaşık %1 artışla ve HFT-S faaliyetinde yaklaşık %1,6 azalışla ilişkilidir. Bu ilişki teoride agresif hızlı traderların stale quote'lara yönelmesi ve liquidity supplier'ların adverse-selection riskinden kaçınmasıyla uyumludur; ancak yazarlar bu regresyondan nedensellik sonucu çıkarmamaktadır.
Makalenin bilgi edinimi uygulamasında liquidity-supplying HFT daha fazla fundamental information acquisition ile, liquidity-demanding HFT ise daha az information acquisition ile ilişkilidir. Sonuç, “HFT'nin piyasa üzerindeki etkisi”nin tek bir işaretle açıklanamayacağını ve kullanılan HFT stratejisinin ayrıştırılmasının ekonomik yorum açısından kritik olduğunu göstermektedir.
Kamu Verilerinde HFT Neden Doğrudan Ölçülemiyor?
Standart piyasa veri akışları işlemin fiyatını, miktarını, zamanını, bid ve ask değerlerini veya emir defterindeki değişiklikleri gösterebilir; ancak işlemi gerçekleştiren katılımcının bir HFT firması olup olmadığını normalde etiketlemez. Bu nedenle araştırmacılar HFT faaliyetini ya doğrudan kimlik bilgisi içeren özel veri kümeleriyle ya da kamu verilerinden türetilen dolaylı proxy'lerle ölçmek zorundadır.
Özel veri kümelerinin avantajı gerçek HFT kimliği içermeleridir; dezavantajları ise az sayıda hisse senedi ve kısa zaman dönemleriyle sınırlı olmalarıdır. Quote-to-trade ratio, odd-lot volume veya message count gibi kamuya açık proxy'ler ise daha geniş kapsama sahiptir fakat bir HFT'nin likidite sağladığını mı yoksa likidite tükettiğini mi doğrudan ayıramaz.
Çalışma bu iki yaklaşımı birleştirmektedir: küçük fakat gerçek HFT etiketine sahip veri modeli eğitir; kamuya açık TAQ değişkenleri ise eğitilmiş modelin bütün ABD hisse senedi evrenine uygulanmasını sağlar.
HFT-D ile HFT-S Arasındaki Fark Nedir?
HFT-D, High-Frequency Trader'ın agresif tarafta yer alarak mevcut likiditeyi tükettiği işlemlerin; HFT-S ise HFT'nin pasif tarafta yer alarak karşı tarafa likidite sunduğu işlemlerin tahmini payıdır. NASDAQ veri kümesindeki HH, HN, NH ve NN işlem sınıfları bu ayrımın temelini oluşturur.
NASDAQ sınıflandırmasında:
- HH: işlemin iki tarafı da HFT'dir.
- HN: likidite talep eden taraf HFT, karşı taraf non-HFT'dir.
- NH: likidite talep eden taraf non-HFT, likidite sağlayan taraf HFT'dir.
- NN: iki taraf da non-HFT'dir.
Kaynağın ana metnindeki tanıma göre liquidity-demanding HFT oranı:
ve liquidity-supplying HFT oranı:
olarak tanımlanır.
HH işlemlerinin hem demand hem supply tarafında bir HFT içermesi nedeniyle HFT-D ve HFT-S birbirini dışlayan iki toplam piyasa payı değildir. İki metriğin basitçe toplanması “toplam HFT payı” olarak yorumlanmamalıdır.
Kaynağın özet istatistiklerinde ML tarafından tahmin edilen HFT-D'nin ortalaması 0,316, HFT-S'nin ortalaması 0,208'dir. Standart sapmalar sırasıyla 0,112 ve 0,101 olarak raporlanmıştır.
Makine Öğrenmesi HFT Faaliyetini Nasıl Öğreniyor?
Modelin girdisi, aynı stock-day için TAQ Intraday Indicators sisteminden elde edilen 24 piyasa değişkenidir. Bunlar fiyat, işlem hacmi, işlem sayısı, quoted spread, effective spread, realized spread, price impact, market depth, volatility, order imbalance, retail trading ve institutional trading gibi farklı piyasa özelliklerini temsil eder.
Modelin hedef çıktıları ise NASDAQ'ın doğrudan gözlenen HFT-D ve HFT-S değerleridir.
Training veri seti
2009 NASDAQ veri seti 120 rastgele seçilmiş NASDAQ ve NYSE hisse senedini kapsamaktadır. Ham örnek 29.880 stock-day gözlemidir. Bağımsız veya bağımlı değişkenlerinde eksiklik bulunan 2.184 gözlem, yani yaklaşık %7 veri çıkarılmıştır. Yazarlar HFT verisine ilişkin güçlü varsayımlar gerektireceği için interpolation veya imputation uygulamamıştır.
Test edilen modeller
Araştırmacılar Support Vector Regression, feed-forward artificial neural network, Random Forest ve Extremely Randomized Trees modellerini değerlendirmiştir. Tree modellerinde hem her target'ın ayrı modellendiği multi-model hem de HFT-D ile HFT-S'nin birlikte tahmin edildiği multi-target yapılar test edilmiştir.
| Yöntem | Ortalama R² | Standart sapma |
|---|---|---|
| SVR | 0,684 | 0,058 |
| ANN | 0,783 | 0,0229 |
| Random Forest - multi-model | 0,784 | 0,055 |
| Random Forest - multi-target | 0,790 | 0,043 |
| Extra Trees - multi-model | 0,804 | 0,036 |
| Extra Trees - multi-target | 0,805 | 0,035 |
Bu karşılaştırma sonunda Extra Trees multi-target yaklaşımı tercih edilmiştir.
Hyperparameter optimizasyonu
İki ana parametre için grid search yapılmıştır:
Ensemble'daki tree sayısı ve node split için gereken minimum sample sayısı,
değerlerinin bütün kombinasyonlarıyla sınanmıştır. Böylece 64 parameter combination oluşturulmuş ve her deney 10 kez tekrarlanmıştır.
Kaynak Tablo 3'te en yüksek ortalama \(R^2\), minimum split sample = 5 ve ensemble size = 640 kombinasyonunda 0,814442 olarak raporlanmaktadır. Optimize edilmiş nihai deneyde ise ortalama:
ve standart sapma:
olarak elde edilmiştir.
Monte Carlo cross-validation
Deneylerde Monte Carlo cross-validation kullanılmıştır. Her iteration'da veri rastgele training ve test alt kümelerine ayrılmıştır. İlk model karşılaştırmalarında 10.000 gözlem kullanılmış ve %25 test seti ayrılmıştır.
Bu yöntem çok büyük veri setlerinde bütün veri üzerinde klasik k-fold yapmanın hesaplama maliyetini azaltmayı amaçlamaktadır.
HFT'yi Tahmin Etmekte Hangi Piyasa Değişkenleri Önemli?
Kaynak Şekil 1'deki feature-importance analizi özellikle toplam trade sayısının, işlem değerlerinin, Intermarket Sweep Orders'ın ve market-depth göstergelerinin model tahmininde önemli olduğunu göstermektedir. Şekil 2 ise bu değişkenlerle HFT faaliyeti arasındaki ilişkinin çoğu durumda doğrusal olmadığını ortaya koymaktadır.
Toplam trade sayısı
HFT-D ve HFT-S toplam trade sayısı arttıkça yükselmektedir; ancak ilişki yaklaşık doğrusal değil, artan ve concave biçimdedir. Yani başlangıçtaki trade-volume artışlarının marjinal etkisi daha güçlüdür ve daha yüksek seviyelerde eğri yataylaşmaktadır.
Intermarket Sweep Orders
ISO dollar miktarı arttıkça HFT-D başlangıçta hızlı biçimde yükselmekte ve daha sonra eğri yataylaşmaktadır. HFT-S'nin ISO miktarına tepkisi ise çok daha sınırlıdır.
Bu farklılık, agresif HFT faaliyetinin ISO kullanımıyla daha güçlü biçimde ilişkili olduğuna dair kaynak yorumunu desteklemektedir.
Market depth
Kaynak Şekil 2'de iki HFT türünün market depth karşısında ters yönlü davranışını göstermektedir:
HFT-S: market depth arttıkça artan ve concave bir desen gösterir.
HFT-D: market depth arttıkça azalan ve convex bir desen gösterir.
Başka bir ifadeyle model, daha derin order book koşullarında HFT'lerin likidite sağlamaya; sığ piyasalarda ise likidite talep etmeye daha fazla yöneldiği bir davranış yakalamaktadır.
Model 2009 Verisinden 2010–2023 Piyasasına Nasıl Genişletildi?
Nihai Extra Trees modeli NASDAQ'ın gerçek HFT etiketli 2009 verisinde eğitildikten sonra TAQ verisi bulunan bütün ABD hisse senetlerine uygulanmıştır.
Genişletilmiş veri seti:
| Özellik | Değer |
|---|---|
| Hisse senedi sayısı | 8.314 |
| Stock-day gözlem sayısı | 9.440.600 |
| Başlangıç | 4 Ocak 2010 |
| Bitiş | 18 Ekim 2023 |
| Input feature | 24 |
| Ana output | HFT-D ve HFT-S |
Çalışmanın asıl metodolojik değeri burada ortaya çıkmaktadır. Doğrudan HFT kimliği yalnız 120 hisse için mevcut olmasına rağmen modelin öğrendiği ilişkiler kamu TAQ verisine uygulanarak yaklaşık 13 yıllık geniş bir günlük panel oluşturulmaktadır.
Earnings ve M&A Duyurularında HFT Nasıl Davranıyor?
Modelin ekonomik olarak anlamlı davranış yakalayıp yakalamadığını sınamak için araştırmacılar hem planlı earnings announcement hem de plansız M&A announcement dönemlerini incelemiştir.
Earnings announcements
Kaynak Şekil 3, duyurudan 10 gün önce ve 10 gün sonrasını göstermektedir. Hem HFT-S hem HFT-D yaklaşık üç gün önce yükselmeye başlamakta ve duyuru gününde maksimuma ulaşmaktadır.
Üç günlük announcement window, yani \(t\), \(t+1\) ve \(t+2\) döneminde:
| HFT türü | Kaynakta raporlanan değişim |
|---|---|
| HFT-S | %6,3 artış; 0,208'den 0,221'e |
| HFT-D | %2,8 artış |
Likidite sağlayan HFT'nin daha yüksek tepki vermesi, yüksek bilgi akışı döneminde market-making faaliyetinin artmasıyla uyumlu olarak yorumlanmaktadır.
M&A announcements
Kaynak Şekil 4'te plansız M&A duyurularında desen farklıdır. HFT-S yaklaşık bir gün önce yükselmeye başlarken HFT-D'nin belirgin artışı announcement day'den itibaren ortaya çıkmaktadır.
Üç günlük pencerede:
| HFT türü | Kaynakta raporlanan değişim |
|---|---|
| HFT-S | %3,2 artış |
| HFT-D | %1,2 artış |
İki artış da kaynakta %1 anlamlılık seviyesinde istatistiksel olarak anlamlı raporlanmıştır.
Exchange Hızındaki Değişiklikler HFT Ölçülerini Doğruluyor mu?
Evet. Çalışma modelin gerçek HFT dinamiklerini yakalayıp yakalamadığını sınamak için iki farklı teknolojik piyasa şokunu kullanmaktadır: 2011 NASDAQ data-feed hızlandırması ve 2017 Amex speed bump uygulaması.
NASDAQ: 3 ms → 1 ms
10 ve 17 Ekim 2011'de aşamalı olarak uygulanan teknoloji yükseltmesi trading-data dissemination latency'yi 3 milisaniyeden 1 milisaniyeye düşürmüştür.
Difference-in-differences analizinde diğer exchange'lerde listelenen hisseler kontrol grubu olarak kullanılmıştır.
Kaynağın pre-upgrade ortalamalara göre hesapladığı ekonomik büyüklükler:
| HFT türü | Değişim |
|---|---|
| HFT-D | Yaklaşık %0,7 artış |
| HFT-S | Yaklaşık %1,1 artış |
Amex speed bump
NYSE Amex 24 Temmuz 2017'de inbound ve outbound iletişimi birlikte etkileyen toplam 700 mikrosaniyelik round-trip gecikme uygulamıştır.
Kaynağın pre-speed-bump ortalamalara göre raporladığı değişimler:
| HFT türü | Değişim |
|---|---|
| HFT-D | %2,8 düşüş |
| HFT-S | %4,6 düşüş |
2017 olayı training verisinden yaklaşık sekiz yıl sonra gerçekleştiği için çalışma bunu modelin temporal robustness'ına ilişkin önemli bir dış doğrulama olarak kullanmaktadır.
Latency Arbitrage HFT-D ile HFT-S'yi Neden Ters Yönde Etkiliyor?
Latency arbitrage, yeni kamu bilgisine daha hızlı ulaşan trader'ın hâlâ güncellenmemiş “stale quote”lardan yararlanabilmesidir. Çalışmada bu tür fırsatların artışı agresif HFT-D faaliyetini yükseltirken HFT-S faaliyetini düşürmektedir.
Latency-arbitrage analizi hesaplama maliyeti nedeniyle 120 NASDAQ/NYSE hissesi üzerinde 2010–2023 dönemi için yapılmıştır.
Günlük ortalama latency-arbitrage opportunity sayısı:
standart sapması:
ve maksimum:
olarak raporlanmıştır.
Bir standart sapmalık artış:
| HFT türü | İlişki |
|---|---|
| HFT-D | Yaklaşık %1 artış |
| HFT-S | Yaklaşık %1,6 azalış |
Kaynak mekanizmayı şöyle yorumlamaktadır: stale quote ortaya çıktığında agresif hızlı traderlar quote'u almak için yarışırken liquidity supplier'lar adverse-selection riskinden kaçınmak için likiditeyi geri çekebilir.
Bu bölümde yazarlar regresyonun nedensel etkiyi kanıtlamadığını açıkça belirtmektedir.
Yeni HFT Ölçümleri Geleneksel Proxy'lerden Neden Farklı?
Çalışma ML ölçülerini beş geleneksel proxy ile karşılaştırmaktadır:
quote volatility, odd-lot volume, quote intensity, quote-to-trade ratio ve toplam trade/quote message sayısı.
Ocak–Haziran 2009 verisiyle model yeniden eğitilmiş ve Temmuz–Aralık 2009 dönemi tamamen out-of-sample validation amacıyla kullanılmıştır.
Sonuçların temel mesajı, geleneksel proxy'lerin bazı cross-sectional farkları yakalayabilmesine rağmen aynı hisse senedinin zaman içindeki HFT değişimini daha zayıf açıklamasıdır. ML-generated HFT-D ve HFT-S ise hem cross-sectional hem time-series boyutlarında doğrudan NASDAQ HFT etiketleriyle daha güçlü ilişki göstermektedir.
Örneğin yalnız day fixed effect kullanılan testlerde ML-HFT-S için within-\(R^2\) %74, ML-HFT-D için %50'dir. Geleneksel proxy'lerin bir bölümü cross-sectional varyasyonu yakalasa da joint regression içinde ML ölçümleri önemli bilgi içeriğini korumaktadır.
HFT Fundamental Information Acquisition'ı Nasıl Etkiliyor?
Çalışmanın ana metodolojik katkısından sonra ölçümlerin gerçek ekonomik sorularda nasıl kullanılabileceğini göstermek amacıyla earnings announcements çevresinde fundamental information acquisition incelenmektedir.
İlk ölçüm price jump ratiodur.
Burada yüksek JUMP oranı fiyatın fundamental information'ı announcement öncesinde daha az içerdiği, yani pre-announcement information acquisition'ın daha düşük olduğu şeklinde yorumlanır.
Liquidity-demanding HFT
HFT-D katsayısı:
ve kaynakta %1 seviyesinde anlamlıdır.
HFT-D'nin 25. persentil olan 0,222'den 75. persentil olan 0,414'e yükselmesi, JUMP ratio'da kendi ortalamasına göre yaklaşık %6,6 artış ile ilişkilidir.
JUMP'ın yükselmesi daha az pre-announcement information acquisition anlamına geldiğinden HFT-D daha düşük bilgi edinimiyle ilişkilidir.
Liquidity-supplying HFT
HFT-S katsayısı:
ve %1 seviyesinde anlamlıdır.
HFT-S'nin 25. persentil olan 0,131'den 75. persentil olan 0,259'a yükselmesi, JUMP ratio'da ortalamaya göre yaklaşık %3,3 azalış ile ilişkilidir.
Bu sonuç daha yüksek liquidity-supplying HFT faaliyetinin daha fazla announcement öncesi bilgi edinimiyle ilişkili olduğunu göstermektedir.
Neden iki HFT türü farklı sonuç üretebilir?
Kaynağın ekonomik açıklamasına göre liquidity provider HFT'ler spread ve trading cost'u azaltarak fundamental information arayan yatırımcıların işlem yapmasını kolaylaştırabilir. Liquidity-demanding HFT'ler ise informed institutional order flow'u tahmin edip agresif biçimde işlem yaptıklarında informed traderların adverse-selection maliyetini yükseltebilir ve information-acquisition teşvikini azaltabilir.
Bu açıklama kaynak tarafından önerilen mekanizmadır; jump-ratio regresyonu tek başına bu nedensel mekanizmayı kanıtlamaz.
Future Earnings Response Coefficient
İkinci bilgi edinimi testi FERC'dir. FERC, bugünkü stock return'ün gelecekteki earnings bilgisiyle ne ölçüde ilişkili olduğunu değerlendirir.
Kaynak Tablo 10'da gelecek earnings ile HFT-D etkileşiminin katsayısı:
HFT-S etkileşiminin katsayısı ise:
olarak raporlanmıştır ve iki ilişki de %1 seviyesinde anlamlıdır.
FERC testi de jump-ratio sonucuyla aynı yönü göstermektedir: liquidity supply daha yüksek information acquisition, liquidity demand ise daha düşük information acquisition ile ilişkilidir.
Çalışmanın Yöntemi ve Bulguları
Ana veri kaynakları
| Kaynak | Bilimsel rol |
|---|---|
| NASDAQ HFT | 2009 için doğrudan HFT / non-HFT ve liquidity-side etiketleri. |
| WRDS TAQ Intraday Indicators | 24 ML input feature ve bütün ABD hisselerine genişletme. |
| Millisecond TAQ | Geleneksel HFT proxy'leri ve granular quote-level robustness. |
| Refinitiv DataScope | Latency-arbitrage fırsatlarını belirlemek için intraday quote verisi. |
| I/B/E/S | Earnings announcement tarihleri. |
| Thomson Reuters SDC | M&A announcement tarihleri. |
| CRSP | Stock return ve trading-volume verileri. |
| MIDAS | Weller tipi alternatif HFT ölçümleriyle karşılaştırma. |
Extra Trees neden seçildi?
Extra Trees, test edilen yöntemler içinde yüksek out-of-sample performansı ve görece düşük varyansı birlikte sağlamıştır. Feed-forward neural network benzer performans göstermiş olsa da yazarlar daha karmaşık bir modelin yalnız daha basit modeller yetersiz olduğunda tercih edilmesi gerektiğini savunmaktadır.
Tree tabanlı yapı ayrıca HFT ile piyasa değişkenleri arasındaki nonlinear interaction'ları doğal biçimde yakalayabilmektedir.
Quote-level feature eklemek çok şey değiştirdi mi?
Hayır. Baseline model günlük TAQ indicator'larıyla yaklaşık %82 \(R^2\) üretirken granular quote-level değişkenler eklendiğinde değer yaklaşık %84'e yükselmiştir.
İki modelin ürettiği HFT ölçümleri arasındaki korelasyon:
| Ölçüm | Korelasyon |
|---|---|
| Liquidity-supplying HFT | 0,99 |
| Liquidity-demanding HFT | 0,96 |
Bu nedenle çalışma daha maliyetli granular quote verisinin baseline modele yalnız sınırlı incremental value sağladığı sonucuna ulaşmaktadır.
Scaled ve unscaled HFT sonucu
Baseline HFT-D ve HFT-S ölçümleri HFT trading volume'unu toplam trading volume'a bölerek ölçekler. Bunun modelin aslında toplam volume değişimlerini öğreniyor olabileceği eleştirisini sınamak için araştırmacılar HFT volume'u ölçeklemeden de modeller üretmiştir.
Online Appendix'teki unscaled analizlerde ana yönler korunmuştur:
- HFT information events'e tepki vermektedir.
- Technology shocks altında beklenen yönde değişmektedir.
- Latency arbitrage HFT-D ve HFT-S'yi ters yönde etkilemektedir.
- ML ölçümleri geleneksel proxy'lerden daha güçlüdür.
- HFT-D ve HFT-S'nin information acquisition ile ilişkileri zıt yönlerde kalmaktadır.
Doğrudan NASDAQ HFT verisi neden bilgi edinimi için yetersiz kaldı?
NASDAQ'ın doğrudan etiketli veri seti yalnız 120 hisse ve 2009 yılıyla sınırlıdır. Earnings gibi quarterly ölçülen düşük frekanslı bir outcome kullanıldığında örneklem çok küçülmektedir.
Kaynak Tablo 11'de doğrudan NASDAQ HFT verisiyle jump-ratio analizinde yalnız 466; FERC analizinde 401 gözlem kalmıştır. Bu küçük örneklemde HFT stratejileriyle information acquisition arasında istatistiksel olarak anlamlı ilişki elde edilmemiştir.
ML-generated panelin araştırmacılara sağladığı ana avantaj tam olarak budur: doğrudan gözlenmiş küçük HFT örneğinden öğrenilen yapı, düşük frekanslı ekonomik soruların analiz edilebileceği çok daha geniş bir zaman-hisse paneline taşınmaktadır.
2010–2012 robustness testi
Modelin 2009 training döneminden çok uzak yıllara uygulanmasının sonucu yönlendirdiği ihtimaline karşı information-acquisition analizi yalnız 2010–2012 döneminde tekrarlanmıştır.
Sonuçların işaretleri baseline analizle aynıdır:
HFT-D daha düşük information acquisition, HFT-S daha yüksek information acquisition ile ilişkilidir.
Çalışmanın desteklediği sonuçlar
Yüklenen çalışma aşağıdaki sonuçları desteklemektedir: Kamuya açık intraday piyasa değişkenleri, sınırlı miktardaki doğrudan HFT etiketli veriyle birleştirildiğinde liquidity-demanding ve liquidity-supplying HFT faaliyetini ayrı ayrı tahmin eden modeller kurulabilir. Extra Trees modeli test edilen yöntemler arasında güçlü out-of-sample performans göstermektedir. ML-generated HFT ölçümleri geleneksel proxy'lere kıyasla gerçek NASDAQ HFT faaliyetiyle daha güçlü ilişki göstermekte ve hem cross-sectional hem time-series varyasyonu yakalamaktadır.
Model tarafından üretilen iki HFT türü ekonomik olarak anlamlı farklılıklar da göstermektedir. Latency arbitrage fırsatları HFT-D ile pozitif, HFT-S ile negatif ilişkilidir. Hızın düşürüldüğü Amex speed bump her iki faaliyeti azaltırken liquidity supply üzerindeki değişim daha büyüktür. Fundamental information acquisition analizlerinde HFT-S olumlu, HFT-D olumsuz ilişki göstermektedir.
Çalışmanın desteklemediği sonuçlar
Çalışma ML modelinin her bireysel işlemin HFT tarafından yapılıp yapılmadığını kesin olarak tespit ettiğini göstermemektedir; üretilen değişkenler stock-day düzeyinde tahmin edilen HFT faaliyet oranlarıdır.
Modelin 2009'da öğrendiği ilişki 2010–2023 arasında doğrulama testlerinde anlamlı davranış gösterse de 2009 training sample'ına bağımlılık önemli bir yöntemsel sınırlılıktır.
Information-acquisition sonuçları nedensel etki olarak yorumlanmamalıdır. Yazarlar potansiyel endogeneity nedeniyle HFT'nin fundamental information acquisition üzerindeki causal effect'ini kurduklarını iddia etmemektedir.
Latency-arbitrage regresyonu da nedensellik testi değildir.
Çalışma HFT-S'nin her piyasa koşulunda “iyi”, HFT-D'nin her durumda “kötü” olduğunu göstermemektedir. Bulgular belirli outcome'lara ve analizlere bağlıdır. Örneğin agresif HFT, latency arbitrage sırasında liquidity provider'lara adverse-selection maliyeti yaratabilirken aynı zamanda yeni bilgiyi fiyatlara hızlı taşıyarak price efficiency'nin bazı boyutlarını iyileştirebilir.
ML-generated ölçümlerin ABD dışındaki piyasalarda aynı performansı göstereceği yüklenen 2025 sürümünde test edilmemiştir.
Temel sınırlılıklar
Çalışmanın en önemli sınırlılığı training ground truth'unun 2009 NASDAQ HFT verisine dayanmasıdır. HFT teknolojisi ve piyasa altyapısı daha sonra önemli ölçüde değişmiş olsa da yazarlar temel liquidity-demand ve liquidity-supply stratejilerinin yapısının görece kalıcı olduğunu savunmaktadır.
İkinci sınırlılık, model çıktılarının gerçek participant identity değil tahmin olmasıdır. Çok yüksek \(R^2\) dahi her stock-day için ölçüm hatasının olmadığı anlamına gelmez.
Üçüncü sınırlılık, HFT information-acquisition uygulamasının observational olmasıdır. HFT-D veya HFT-S'deki değişimin information acquisition değişimini doğrudan oluşturduğunu söylemek için çalışma tarafından ayrı bir causal identification yapılmamıştır.
Dördüncü sınırlılık, latency-arbitrage opportunity analizinin hesaplama maliyeti nedeniyle bütün 8.314 hisse yerine orijinal 120-stock grubunda yürütülmüş olmasıdır.
Kaynak ve Yöntem Notu
Özgün başlık: Data-Driven Measures of High-Frequency Trading.
Yazarlar: Gbenga Ibikunle, Ben Moews, Dmitriy Muravyev ve Khaladdin Rzayev.
Sorumlu yazar: Khaladdin Rzayev.
Afiliyasyonlar: Edinburgh Centre for Financial Innovations, The University of Edinburgh; RoZetta Institute, Sydney; Centre for Statistics, The University of Edinburgh; Department of Finance, University of Illinois at Urbana-Champaign; Canadian Derivatives Institute; Koç University; Systemic Risk Centre, London School of Economics.
Kaynak türü: Preprint / working paper.
Bu Verianla makalesinin temel aldığı sürüm: Yüklenen 78 sayfalık kaynak; online appendix March 2025 tarihlidir.
ArXiv kimliği: 2405.08101.
DOI: 10.48550/arXiv.2405.08101.
Eski başlık: Can machine learning unlock new insights into high-frequency trading? Bu başlık yüklenen PDF'nin March 2025 online appendix bölümünde korunmuştur.
Sonraki sürüm notu: Aynı yazarlar Ağustos 2026'da Data-Driven Measures of High-Frequency Trading başlığıyla arXiv:2608.00858 numaralı daha yeni bir sürüm yayımlamıştır. Bu Verianla metninde sonraki sürümün yeni bilimsel bulguları kullanılmamıştır.
JEL: G10, G12, G14.
Ana ML modeli: Multi-target Extremely Randomized Trees.
Final model başarısı: Ortalama \(R^2=0.824635\), standart sapma 0.005472.
Ground-truth veri: 2009 NASDAQ HFT dataset; 120 NASDAQ ve NYSE hissesi.
Input feature sayısı: 24.
Genişletilmiş dönem: 4 Ocak 2010–18 Ekim 2023.
Genişletilmiş evren: 8.314 ABD hisse senedi.
Stock-day gözlemi: 9.440.600.
Ana output'lar: Liquidity-demanding HFT, HFT-D; liquidity-supplying HFT, HFT-S.
Ana validation yapıları: Earnings announcements, M&A announcements, 2011 NASDAQ latency upgrade, 2017 Amex speed bump, latency-arbitrage opportunities ve conventional HFT proxies.
Information-acquisition ölçümleri: Price jump ratio ve Future Earnings Response Coefficient.
Ana ekonomik uygulama sonucu: HFT-S daha yüksek fundamental information acquisition, HFT-D daha düşük information acquisition ile ilişkilidir; çalışma bu sonucu nedensel etki olarak tanımlamamaktadır.
Veri erişim notu: Kaynak, NASDAQ HFT verisinin akademisyenlere proje açıklaması ve nondisclosure agreement sonrasında ücretsiz sağlanabildiğini belirtmektedir.
Kaynak-içi tutarsızlık: Tablo 1'de HFT-S formülünün metinsel tanımı HH+HN olarak yazılırken ana yöntem metni HFT-S'yi HH+NH biçiminde tanımlamaktadır. Çalışmanın işlem sınıflandırmasıyla uyumlu ana tanım HH+NH'dir.
Kaynak-içi ikinci not: Tablo 10'da negatif −2.018 katsayısına eşlik eden t-istatistiği pozitif 4.56 olarak basılmıştır; metinsel yorum ilişkiyi negatif olarak tanımlamaktadır.
Temel yöntemsel sınır: Bütün 2010–2023 HFT değerleri doğrudan gözlem değil, 2009 HFT etiketlerinden öğrenilen ML tahminleridir. Information-acquisition ve latency-arbitrage uygulamalarının tümü causal inference olarak yorumlanmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir